HyperDrone:每秒数百万帧的四旋翼仿真器与视觉策略仿真到现实迁移 HyperDrone: Simulation-to-Reality Transfer at Millions of Frames per Second
用光追硬件实现百万帧每秒的四旋翼仿真,纯仿真训练的视觉偏航策略成功迁移真机。
前置知识
仿真到现实迁移(Sim2Real)
在仿真器中训练控制策略再部署到真实硬件的范式,核心障碍是现实差距:仿真图像的材质、光照、传感器噪声与真实相机不同,动力学也存在偏差。常见缓解手段有域随机化、高保真渲染和特权师生学习。本文走的是极端路线:渲染快到每一帧都从头生成、训练中永不复用同一样本,策略只能依赖合成场景的多样性而非记忆固定数据集。虽然仍可能过拟合仿真器的整体视觉分布与渲染伪影,但对具体样本的过拟合在机制上被排除。
论文的立论和全部实验设计(纯合成数据训练 + Crazyflie 真机验证)就是一次 Sim2Real 概念验证,理解现实差距的来源才能评价其说服力与局限。
光线追踪与 RT 核心
光追从相机每个像素发射光线,求其与 3D 网格的第一个交点再查纹理着色,比光栅化更接近真实成像。RT 核心是 RTX/Blackwell 等现代 GPU 中的固定功能硬件,专用于加速光线-三角形求交与加速结构遍历,但无法通过 CUDA 这类通用计算 API 直接访问,必须经 Nvidia OptiX、Vulkan、Apple Metal 等接口调用;WebGPU 不暴露光追硬件,只能退回软件遍历。
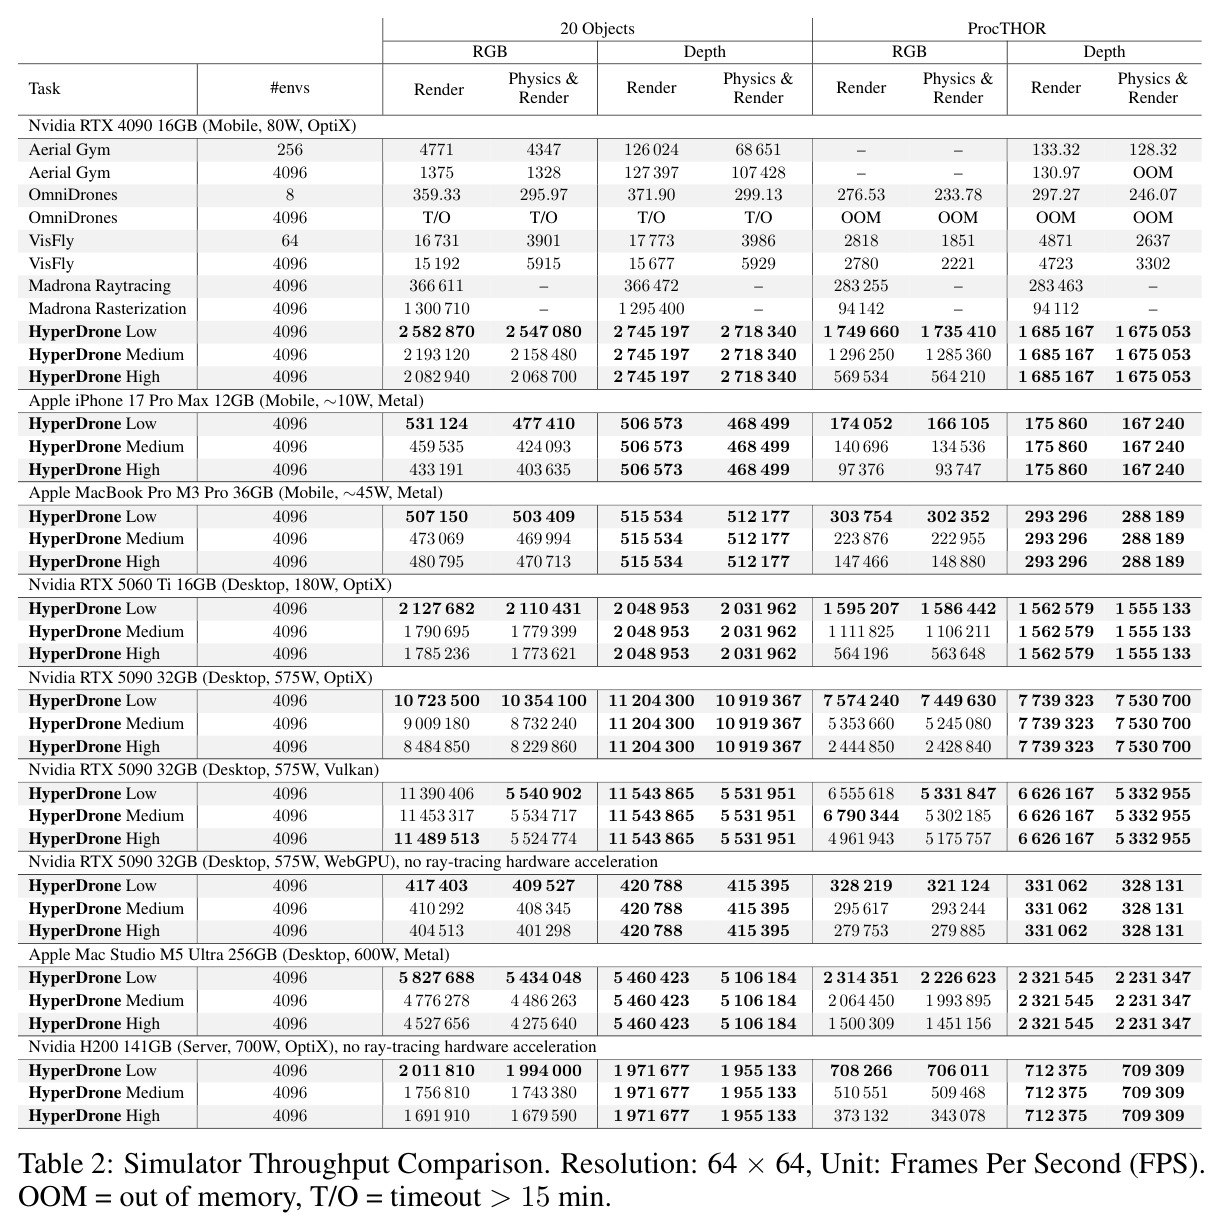
HyperLux 的速度优势直接来自 RT 核心:无光追硬件的 H200 上吞吐从约 1070 万 FPS 跌到约 200 万 FPS,Aerial Gym/Madrona 正是不会调用 RT 核心才落后,不懂这一硬件背景就看不懂性能对比。
批量渲染与 RL 吞吐需求
批量渲染指一次前向同时渲染大量环境(本文 4096 个)的相机画面,是 GPU 并行强化学习的关键。视觉 RL 通常需要数百万乃至数十亿样本:在 100 万 FPS 下一天可产生约 864 亿帧,而 Flightmare 实测仅约 230 FPS,一天约 2000 万帧,训练几乎不可行。吞吐量直接决定消融、调参和规模实验的迭代速度,是视觉策略研究的实际瓶颈。
论文全部动机建立在渲染吞吐决定视觉 RL 可行性之上,表 2 的 FPS 基准是核心证据,需要理解 FPS 与训练样本量之间的换算关系。
特权师生模仿学习与 RAPTOR
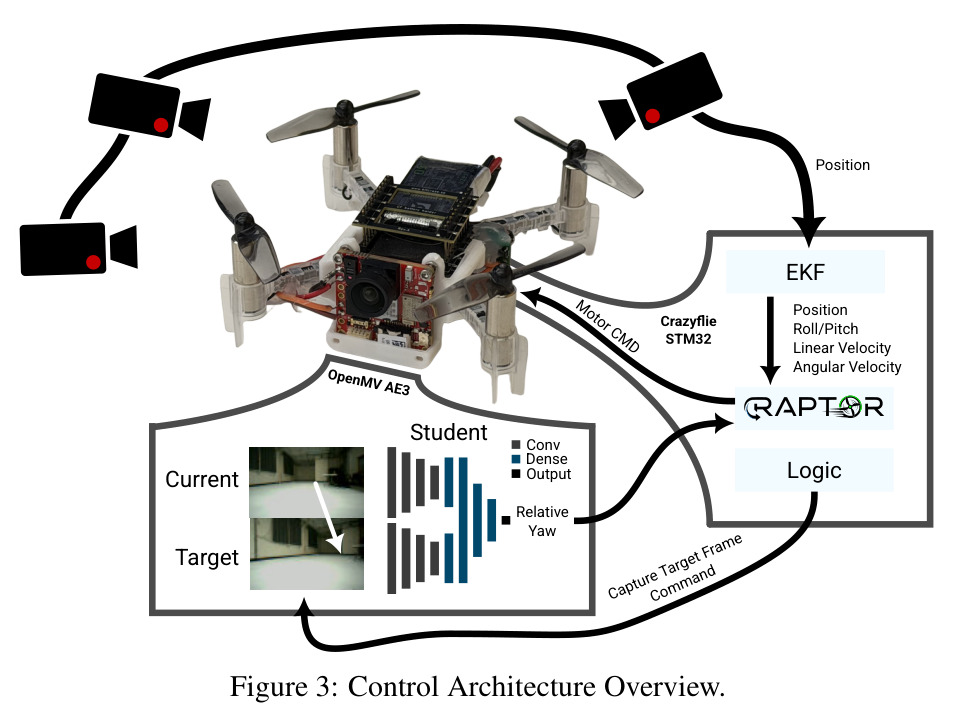
师生范式让教师策略在训练时使用真机上拿不到的特权信息,学生只学习可部署的传感输入。RAPTOR 是预训练的四旋翼基础策略,以 500 Hz 直接输出电机指令,观测来自动捕系统位置与机载扩展卡尔曼滤波(EKF)给出的 roll/pitch、线速度、角速度。本文用 RAPTOR 承担全部低层与位置控制,上层视觉学生网络只需从当前帧与目标帧预测相对偏航角,从而把视觉 Sim2Real 问题与高频控制难度解耦。
第 3.2 节的实验架构完全依赖 RAPTOR 作为低层控制器,不理解这一分工就看不懂学生网络的输入输出设计与真机部署链路。
传感器真实感:抗锯齿与运动模糊
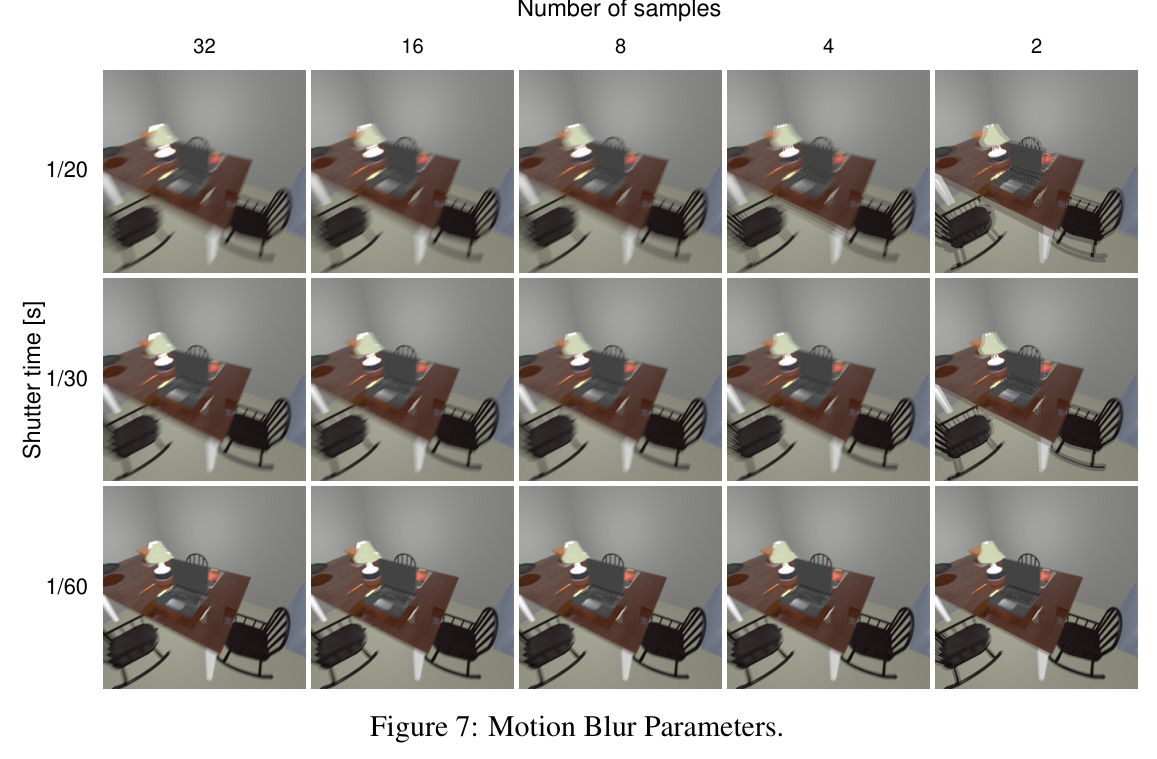
真实像素在一个小视锥内累积光子,而理想窄光线要么命中要么不命中,产生锯齿;HyperLux 用每像素 $2\times 2$ 条光线取平均 $\bar c=\frac{1}{4}\sum_k c_k$ 来近似视锥积分。真实相机曝光期间传感器持续积分,快速旋转的无人机会造成运动模糊;HyperLux 在快门周期内取 $N$ 个子采样帧平均 $\bar I=\frac{1}{N}\sum_{n=1}^{N} I(t_0+n\Delta t)$,$N=32$ 接近真实,实验发现 $N=2$ 已足够支撑 sim2real。
这些按物理过程建模的特征是论文区别于游戏引擎式近似的核心卖点,也是论证合成图像分布更接近真实相机、策略不易学到仿真伪影的依据。
研究动机
视觉强化学习训练四旋翼控制策略通常需要数百万甚至数十亿样本,但现有仿真器渲染吞吐严重不足:Flightmare 不支持批量渲染,实测仅约 230 FPS;Aerial Gym 基于已在 2024 年中被废弃的 Isaac Gym,无法支持 2025 年初发布的 Blackwell/50 系 GPU,且受 Nvidia Warp 限制不能调用光线追踪核心,一般 3D 网格场景的 RGB 渲染也不支持;OmniDrones 依赖 Isaac Sim 4.1.0,同样不兼容 50 系显卡且项目已停止维护,8 个环境下仅 359.33 FPS;VisFly 基于 Habitat 的 OpenGL 光栅化,RTX 4090 上 20 物体场景 RGB 渲染也只有 16,731 FPS,且缺少运动模糊与抗锯齿。更深层的背景是:从人类演示或互联网预训练视觉模型做模仿学习,受制于昂贵的真机数据采集成本和“数据飞轮”式的商业垄断,而视觉基础模型的训练数据多为私有,既不可复现,也难以检视数据分布对策略行为的影响。
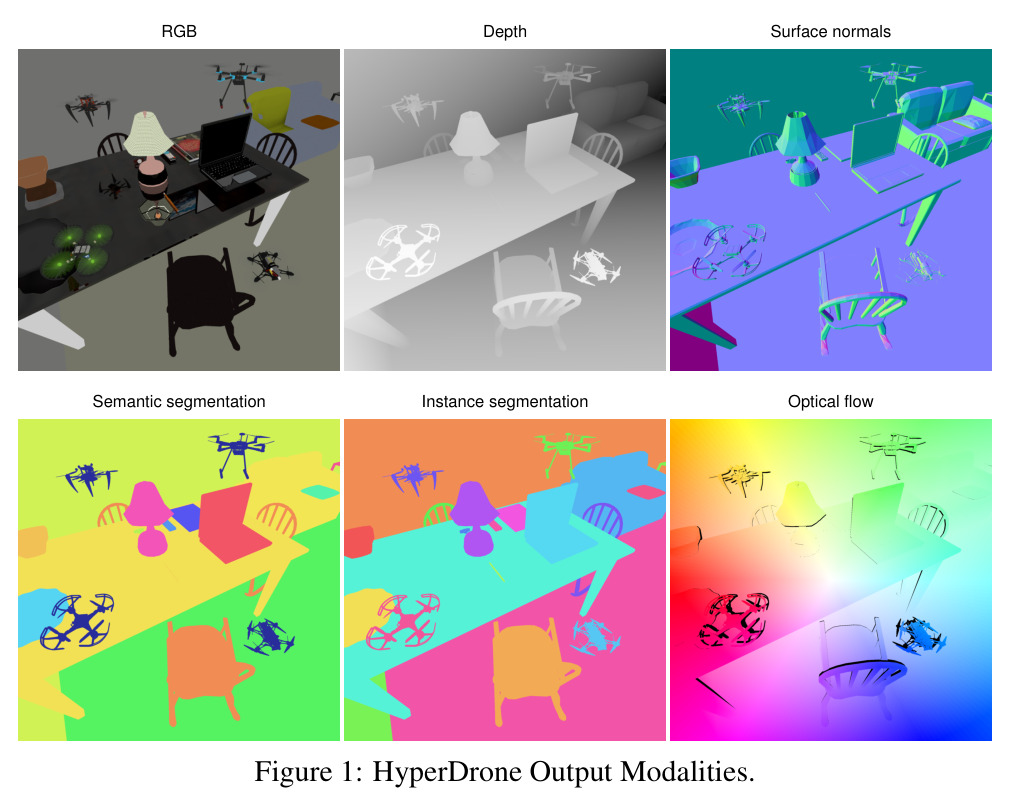
本文的目标是本文的目标是打造一个把渲染吞吐推到极限、同时具备照片级真实感的四旋翼仿真器 HyperDrone,让端到端视觉控制策略可以完全在合成数据上训练并迁移真机。具体量化目标:批量渲染吞吐比现有最快的批量四旋翼仿真器快 20 倍以上,消费级 GPU 上即使最高保真度也达到每秒数百万帧;支持 RGB、深度、语义/实例分割、表面法线、光流五种观测;支持反射、真实光照、运动模糊、抗锯齿与基于物理的渲染(PBR);兼容 Nvidia OptiX、Vulkan、Apple Metal、WebGPU 四种后端,覆盖桌面、移动乃至浏览器;采用开放的 glTF 2.0 场景格式;最后用纯仿真训练的偏航控制策略在真实 Crazyflie 上完全机载运行,验证平台价值。
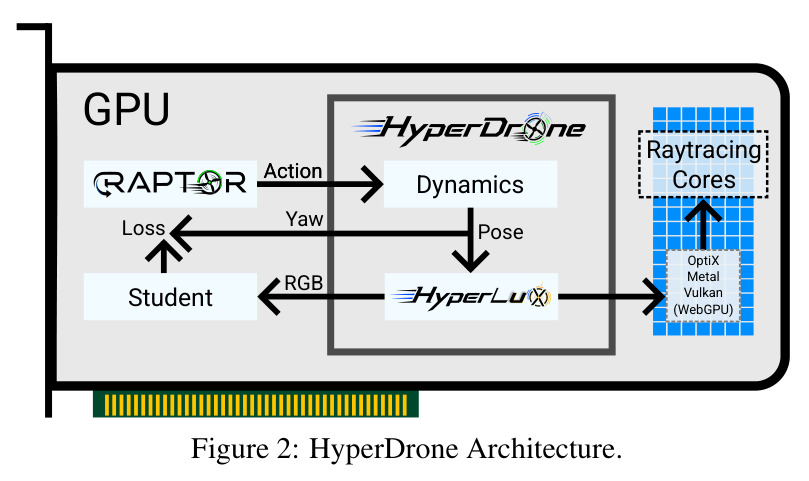
与已有工作不同的是,本文的独特切入是把 GPU 的固定功能光线追踪核心作为批量仿真渲染的第一等公民。已有方案要么走光栅化路线(Isaac 系、Habitat 系),要么做光追但不调用 RT 核心(Madrona 基于 Nvidia Warp 的软件遍历),且普遍把动力学放在 CPU、渲染放在 GPU,造成频繁的主机-设备内存搬运与同步开销。HyperDrone 反其道而行:动力学、渲染、师生网络全部驻留同一 GPU 进程,用 OptiX 的加速结构实现零拷贝闭环;同时强调长期可维护性——开源实现、支持 glTF 开放标准(而非 Flightmare 的专有授权格式)、给定随机种子在相同硬件与后端下结果完全确定,并让 iPhone 这类约 10W 的移动设备也能跑高保真渲染。
核心方法
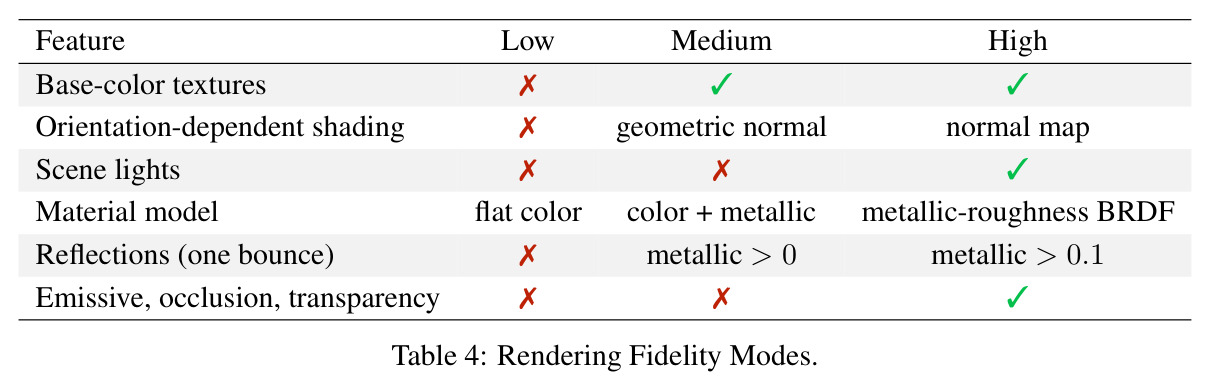
HyperDrone 由两个组件构成:光线追踪渲染器 HyperLux 与高度优化的多旋翼动力学仿真,二者完全运行在 GPU 上以消除 CPU↔GPU 内存传输。HyperLux 不走 CUDA 通用计算,而是借助 OptiX、Vulkan 或 Metal 管理网格加速结构并调用 RT 核心:从每个像素发射光线求第一个交点,再查询纹理着色;WebGPU 后端因拿不到光追硬件而退回软件遍历(比 OptiX 慢 9-27 倍)。渲染分 High/Medium/Low 三档保真度,可输出 RGB、深度、分割、法线、光流。由于渲染不再是瓶颈,训练时每一帧都从头渲染、样本从不复用,机制上排除了对特定样本的过拟合。整个仿真-训练闭环基于 RLtools 构建(GPU 侧精细显存控制、确定性),渲染+物理同时开启时 RTX 5090 上 ProcTHOR 场景仍达 7,449,630 FPS。
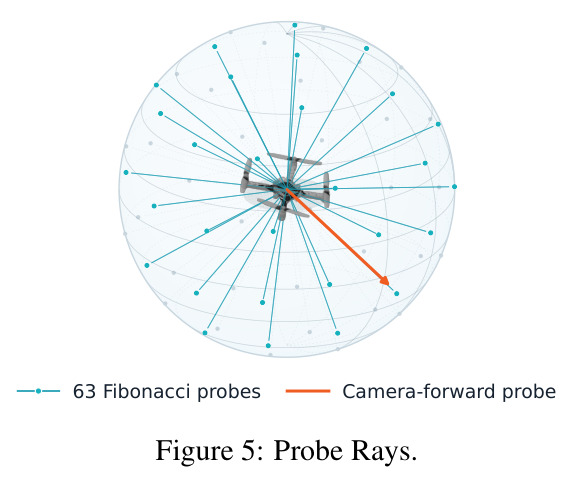
核心创新有四点。第一,用专用光追硬件而非光栅化或软件光追做批量渲染:RT 核心是加速光线-网格求交的固定功能单元,HyperLux 经 OptiX/Vulkan/Metal 调用它,而 Madrona、Aerial Gym 等均无法做到,H200 无 RT 核心时吞吐从 10,723,500 跌至 2,011,810 FPS 佐证其价值。第二,渲染快到可以从零渲染每一步,训练永不重复使用同一样本,改变了依赖固定数据集的传统范式。第三,用探测光线做拒绝采样生成合法初始位置:从相机位置沿 Fibonacci 球面均匀发射 64 条探测光线(63 条 + 相机前方 1 条),保证与任意物体的最小距离,开销仅约 $64/(64\times 64)\approx 1.6\%$,未来可直接用于真实网格的碰撞检测。第四,传感器效应按物理过程建模:抗锯齿用每像素 $2\times 2$ 光线取平均,运动模糊按快门周期内 $N$ 次子采样平均 $\bar I=\frac{1}{N}\sum_n I(t_0+n\Delta t)$ 复现曝光累积。
方法步骤详情
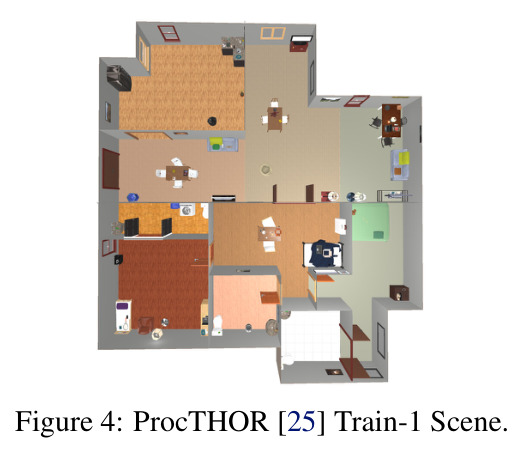
完整流程分五步。(1)场景准备:加载 ProcTHOR 的 10,000 个程序化室内场景(也支持任意 glTF 2.0/.glb 文件),构建光线加速结构。(2)状态采样:用 64 条 Fibonacci 球面探测光线做拒绝采样,筛出与所有物体保持最小间距的合法初始位姿。(3)训练闭环:RAPTOR 教师以 500 Hz 输出电机指令负责位置与低层控制,观测为动捕位置与机载 EKF 的 roll/pitch、线速度、角速度;学生是卷积网络,输入为当前帧与目标帧的通道堆叠 $x=[I_{\text{cur}};I_{\text{tgt}}]$,全连接头预测相对偏航 $\hat y=f_\theta(x)$,损失在 GPU 上端到端反传。(4)训练成本:RTX 5090 约 4 小时、显存约 6 GB,RTX 3060 8GB 约 15 小时也可完成。(5)真机部署:Crazyflie 加装 OpenMV AE3 相机板,学生网络跑在其 NPU 上;UART 协议把偏航指令发给 STM32 供 RAPTOR 消费,反向信道抓取两张目标帧,状态机在其间切换实现往复偏航跟踪。
技术新颖性
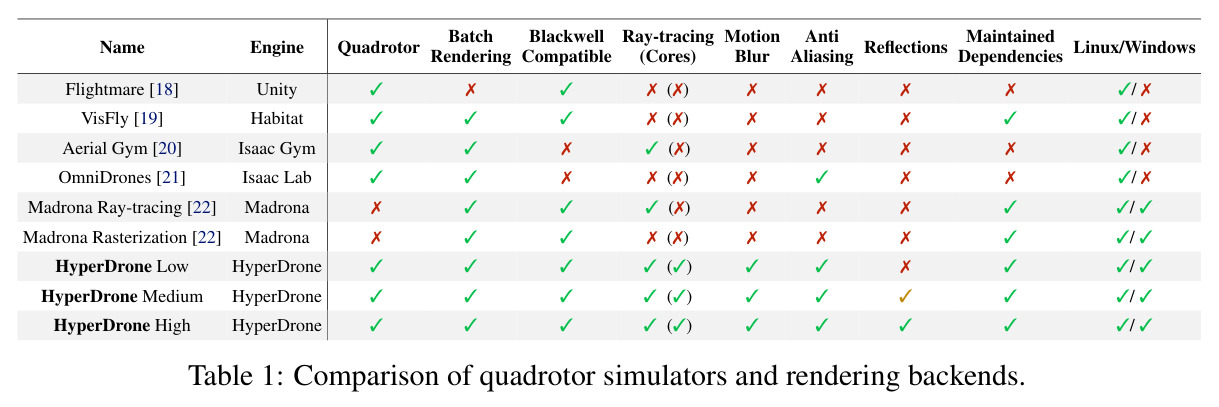
与既有工作的本质区别可从表 1 看出:唯一同时具备批量渲染、四旋翼动力学、Blackwell/50 系兼容、RT 核心加速、运动模糊、抗锯齿且跨 Linux/Windows 的就是 HyperDrone。Flightmare 依赖 Unity 专有软件且不支持批量渲染;VisFly/Habitat 走 OpenGL 光栅化,无运动模糊与抗锯齿;Aerial Gym 的 RGB 只支持简单几何体且底层 Isaac Gym 已废弃;OmniDrones 已停止维护;Madrona 虽开源高效但不调用 RT 核心、也不含四旋翼动力学。技术新颖性在于:把 OptiX 加速结构与 CUDA 动力学放进同一 GPU 进程实现零拷贝闭环,训练器 RLtools 也全驻留 GPU;强调确定性——相同种子、相同硬件与后端下训练结果完全一致,对调试与可复现研究价值巨大;移动端 Metal 后端让 iPhone 17 Pro Max 也能以 97,376 FPS 渲染高保真 ProcTHOR 场景,把准入门槛降到消费级甚至手机级。
实验结果
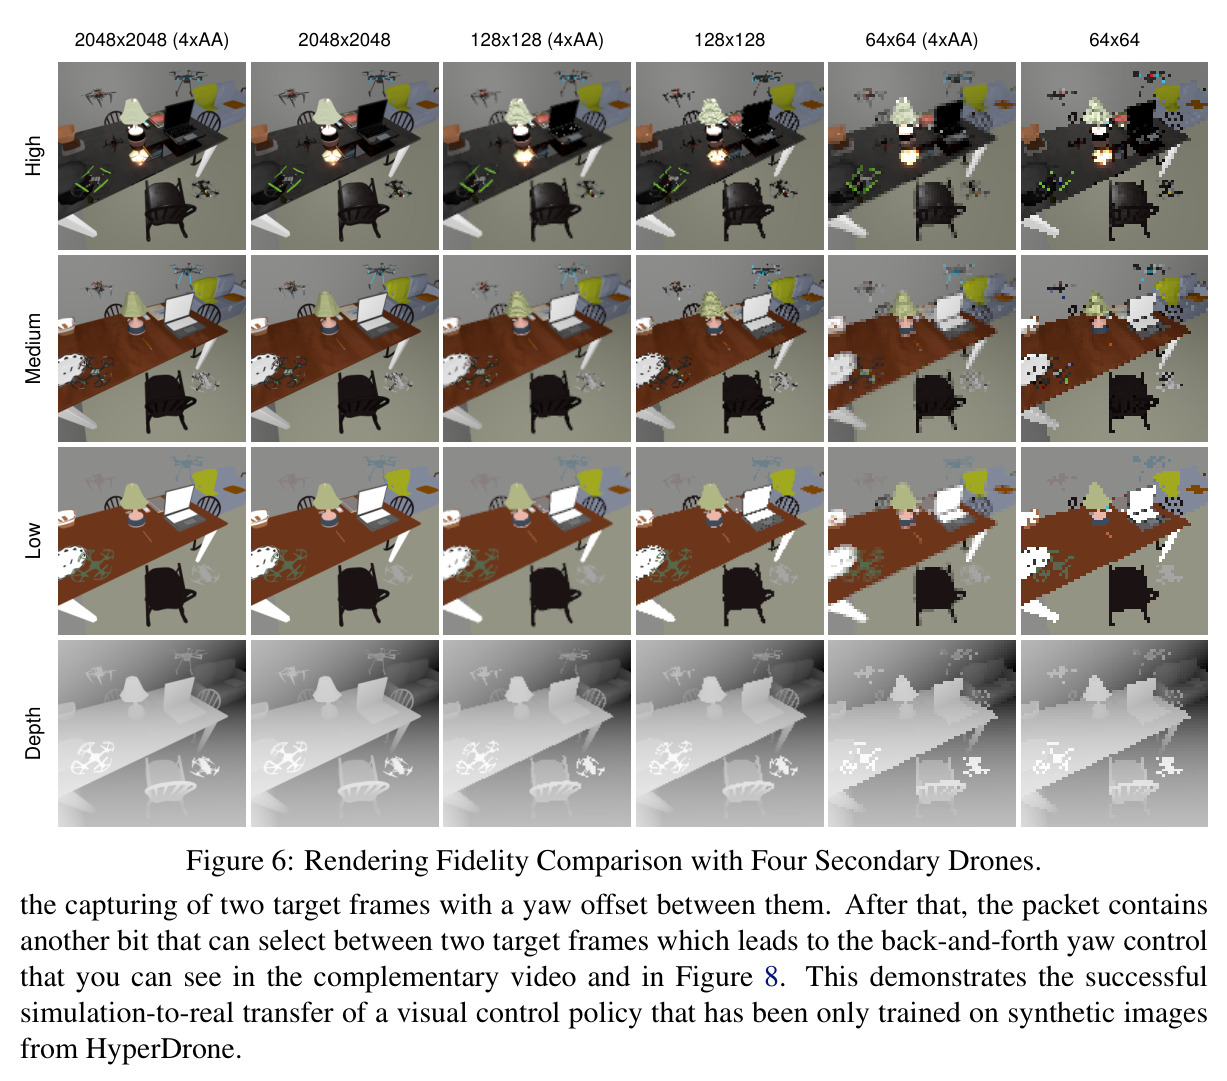
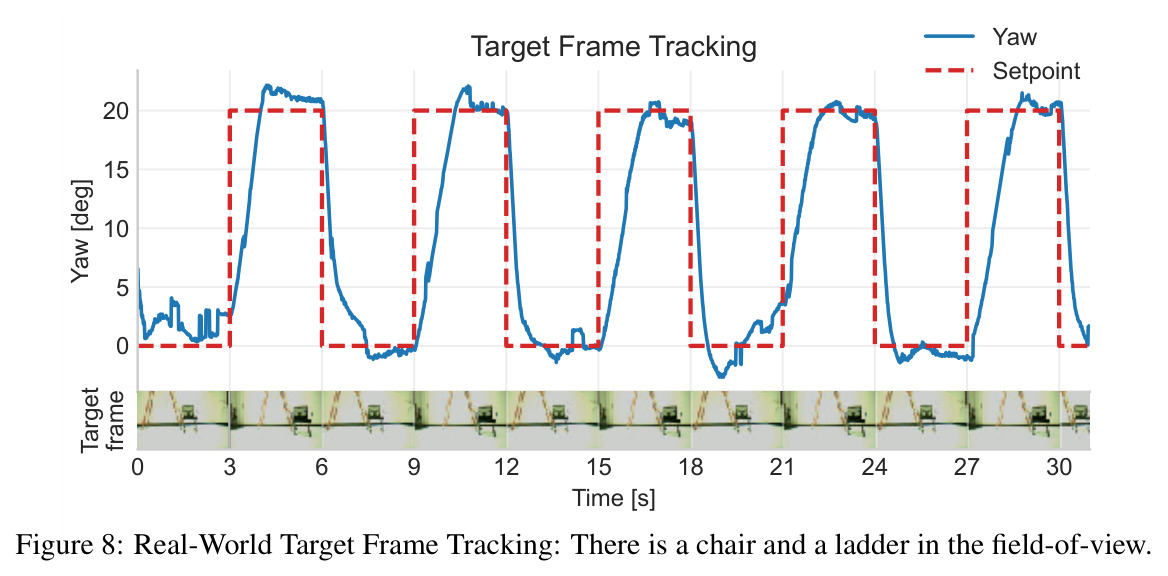
性能方面(表 2,64×64 分辨率、4096 环境):RTX 5090 OptiX Low 档在 20 物体场景渲染 10,723,500 FPS、ProcTHOR 场景开物理仍达 7,449,630 FPS。同硬件对比在 RTX 4090 移动版(80W):HyperDrone Low 渲染 2,582,870 FPS,最快四旋翼仿真器 VisFly 仅 16,731 FPS、Aerial Gym 4,771 FPS、OmniDrones 359.33 FPS,远超 20 倍;最快的 Madrona 光栅化 1,300,710 FPS、光追 283,255 FPS,仍被快 5 倍以上。无 RT 核心的 H200 降至 2,011,810 FPS;iPhone 17 Pro Max 高保真 ProcTHOR 也达 97,376 FPS。视觉上抗锯齿消除低分辨率锯齿;运动模糊 $N=2$ 子采样已够 sim2real,$N=32$ 才接近真实。迁移方面:4 小时纯仿真训练后,真机完成约 30 秒全程视觉偏航跟踪(图 8),实际偏航紧随 0-20° 间切换的目标值,零真机数据完成迁移。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 四旋翼仿真渲染吞吐(64×64,20 物体场景,RGB,4096 环境) | FPS | 2,582,870(RTX 4090 移动版 80W,OptiX,Low 档) | VisFly 16,731 / Aerial Gym 4,771 / OmniDrones 359.33(同卡) | 论文口径 >20×;对最快基线 VisFly 实测约 154× |
| 批量渲染含物理闭环(64×64,ProcTHOR 室内场景,RGB) | FPS | 1,675,053(RTX 4090,OptiX,Low 档);RTX 5090 达 7,449,630 | Madrona 光追 283,463 / Madrona 光栅化 94,112(RTX 4090) | 约 5.9× / 17.8× |
| 峰值吞吐与 RT 核心收益(20 物体,RGB 渲染) | FPS | RTX 5090 OptiX 10,723,500;Vulkan 11,390,406 | H200(无 RT 核心)2,011,810;WebGPU 后端约 417,403 | RT 核心带来约 5.3× 提速;WebGPU 比 OptiX 慢 9-27× |
| 视觉 Sim2Real 偏航控制(Crazyflie + OpenMV AE3,全机载) | 真机任务表现(定性) | 纯仿真训练 4h / 6GB 显存(RTX 5090),真机连续约 30s 视觉偏航跟踪成功 | 不使用任何真机数据,无对比方法 | 在约 10W 的相机板 NPU 上完成机载推理的控制闭环 |
局限与改进
作者承认三点局限:尚不支持卷帘快门仿真(目前只针对全局快门相机);虽有探测光线但没有正式的碰撞检测接口,也未做避碰测试;只演示了简单的低频偏航控制概念验证,仍依赖外部动捕位置参考与 RAPTOR 端到端低层控制器。我的补充观察:所有性能基准固定在 64×64 分辨率,2048×2048 等高分辨率下的吞吐未给出,渲染高保真大图的性能只能推测;>20× 的对比中各基线保真度不一(Madrona 介于 Low 与 Medium 之间),跨保真度的吞吐比较存在口径差异;论文没有消融哪一档保真度、抗锯齿或运动模糊对迁移成功的贡献,High 档吞吐降至 569,534 FPS 的代价是否必要尚不清楚;样本不复用排除了样本过拟合,但过拟合到 ProcTHOR 渲染风格与仿真伪影的风险依然存在;真机验证只有一台无人机、一段轨迹,缺乏跟踪误差的定量统计。
独立分析的弱点
第一,任务过于简单:学生网络只输出相对偏航角,位置与高度全交给动捕 + RAPTOR,距离纯机载全自主还很远;改进方向是把管线扩展到完整位置/轨迹控制的视觉策略。第二,缺乏碰撞与失败处理:训练回路没有碰撞终止条件,策略可能学会穿墙或贴障飞行;论文已有 64 条探测光线,可低成本升级为真实网格碰撞检测并加入终止条件。第三,无定量 sim2real 指标:图 8 只展示单次轨迹,未报告跟踪误差均方根、多机多轮成功率,结论说服力依赖视频;建议给出统计性评估。第四,保真度-性能权衡未消融:High 档 ProcTHOR 渲染只有 569,534 FPS(Low 档 1,749,660),各档对迁移成功率的边际贡献不明,值得系统扫描以找到性价比最优配置。第五,WebGPU 后端比 OptiX 慢 9-27 倍,浏览器端尚不实用,限制了低门槛分发场景。
未来方向
作者计划:增加卷帘快门仿真以匹配真实相机时序;把探测光线发展成正式的碰撞检测与避障接口;超越概念验证任务,走向更高频、更复杂的端到端控制。基于本文成果还可延伸:既然吞吐达数百万 FPS,可系统研究合成数据规模定律——绘制策略性能随仿真帧数、场景多样性(ProcTHOR 之外可换高真实感资产库)与保真度档位的缩放曲线,回答多少合成样本才够;确定性仿真 + 确定性训练器非常适合可复现消融与自动化回归测试;Metal 后端已支持 iPhone,可探索端侧训练或数字孪生;把师生范式换成在线 RL 或世界模型,检验渲染真实感对更复杂任务的必要性;利用探测光线实现基于真实网格(而非简化碰撞体)的碰撞检测本身也是对现有仿真器的改进。
复现评估
复现条件相当友好。代码开源于 github.com/rl-tools/hyperdrone,项目页 hyperdrone.dev 与演示视频公开;场景使用公开的 ProcTHOR 数据集(10,000 个室内场景)与开放的 glTF 2.0 格式,不依赖 Unity 等专有软件。仿真训练门槛低:RTX 5090 约 4 小时、显存约 6 GB,RTX 3060 8GB 约 15 小时也能复现,Vulkan/Metal 后端让 AMD 与 Apple 用户也能运行渲染(论文基准基于 Nvidia OptiX)。真机部分需要 Crazyflie 微型四旋翼、OpenMV AE3 相机板(NPU 推理)、动捕系统与自制 UART 协议,有一定硬件与集成门槛。作者强调仿真器与 RLtools 训练器均为确定性实现,相同种子在相同硬件与后端下结果完全一致,调试与复现体验极佳。综合评估:仿真侧复现难度低,真机侧中等。
论文图表