StyleStream 2.0:快速可控的流式语音风格转换 StyleStream 2.0: Fast and Controllable Streaming Voice Style Conversion
少步MeanFlow与自回归微调把流式语音风格转换延迟降至520毫秒,并统一文本音色设计与编辑
前置知识
语音风格转换(VSC)
Voice Style Conversion 的目标是在保持语言内容不变的前提下,把一段源语音的说话方式整体改造成目标风格。本文沿用 StyleStream 1.0 的定义,将「风格」定义为音色、口音、情绪三者的联合;传统 voice conversion 通常只改说话人身份,口音转换与情绪转换则是独立任务。主流做法是两阶段:先用内容编码器去掉风格得到内容表示,再用目标风格条件重建语音。
本文的全部架构与评测指标(S/A/E-SIM、S/A/E-SMOS)都建立在这一定义和两阶段范式之上。
流匹配与 MeanFlow
Flow Matching 学习一个速度场,把噪声沿插值路径 $z_t=(1-t)x+t\epsilon$ 输运到数据 $x$,瞬时速度为 $v=\epsilon-x$,采样需沿 ODE 多步积分。MeanFlow 把监督目标改为区间 $[r,t]$ 上的平均速度 $u(z_t,r,t)$,借助恒等式 $v=u+(t-r)\frac{d}{dt}u$(用 JVP 计算全导数)训练,使大步长甚至一两步采样也能保证精度,大幅降低迭代成本。
Stylizer 的训练目标 pMF 就建立在 MeanFlow 恒等式上,是实现 4 步采样、520ms 延迟的数学基础。
像素 MeanFlow(pMF)与 CFG 蒸馏
pMF 结合 JiT 风格的 x-prediction 与 MeanFlow 目标:网络预测接近数据流形的干净样本 $\hat{x}_\theta$,再经 $u_\theta=(z_t-\hat{x}_\theta)/t$ 转成平均速度。同时把无分类器引导(CFG)蒸馏进网络——guidance scale $\omega$ 作为网络输入、训练时以概率 $p_{drop}$ 丢弃条件构造目标 $v_{cfg}$,推理时每步只需一次前向而非条件/无条件各一次。
不理解 pMF 就无法理解为什么本文能把 NFE 从 16/12 降到 4 且每步只需一次网络评估。
Self Forcing 与自回归微调
Self Forcing 最初用于自回归视频扩散:让模型在自己 rollout 出的历史帧上训练,而不是只看真实历史,从而对齐训练与推理分布、缓解误差累积。本文把这一思想迁移到流式语音:把整句切成 chunk 顺序生成,用固定长度的生成 mel 窗口 $m_{past}$ 作为过去上下文,损失只在当前 chunk 上计算且历史帧 detach 梯度以保持训练效率。
消融显示去掉 AR 微调后流式 WER 从 12.03% 恶化到 19.54%,它是流式质量的关键保障。
DiT 与 adaLN-zero 条件注入
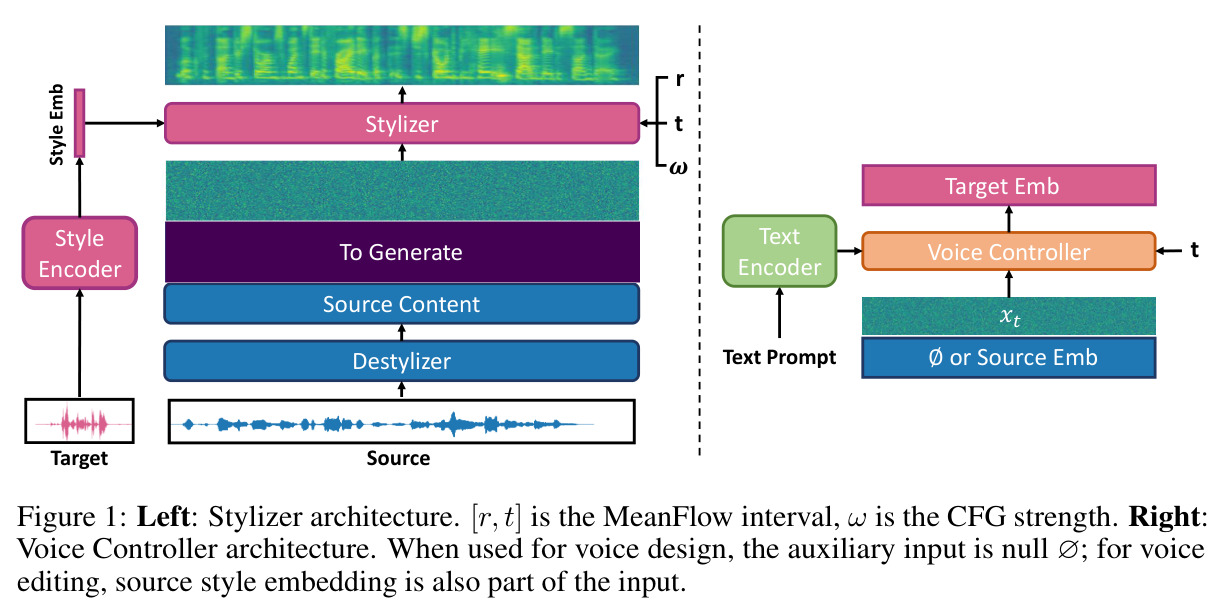
DiT(Diffusion Transformer)是扩散/流模型常用的 Transformer 主干,adaLN-zero 是其全局条件注入方式:把时间步等条件嵌入后以 scale/shift/gate 调制每个 block 的归一化层。本文中 flow 时间 $r,t$、风格嵌入 $e_s$、引导强度 $\omega$ 求和后经 adaLN-zero 注入 Stylizer;Voice Controller 则用冻结 Flan-T5 编码文本并经 cross-attention 注入。
两种模型的条件注入路径决定了风格与文本信息如何进入网络,读架构图(Figure 1)时必需。
研究动机
语音风格转换(VSC)要求在保留语言内容的前提下,把源语音的音色、口音、情绪整体改造成目标风格。StyleStream 1.0 首次实现了可流式推理的零样本 VSC,但在消费级 GPU 上端到端延迟约 1 秒,对延迟敏感的实时交互场景仍然偏高;其多步扩散式 Stylizer 需要 16 步(离线)/12 步(流式)网络评估,采样开销成为瓶颈。另一个限制是目标风格只能通过参考音频指定:用户必须提供一段目标语音示例,无法用自然语言直接描述想要的声音。而 TTS 领域的 prompt 控制系统(如 Qwen3-TTS)虽支持文本指定风格,却是从文本合成语音而非语音到语音转换;已有的文本引导语音编辑工作也大多只针对音色或情绪等单一属性,且在离线设置下评测。整体 VSC + 流式 + 文本控制三者的组合此前是空白。
本文的目标是本文要在保持整体转换质量的前提下同时解决速度与可控性两个问题,且目标都可量化。速度上:把消费级 GPU(RTX 4060)上的端到端流式延迟从约 1 秒降到约 520 毫秒(2 倍加速),采样步数从 16/12 NFE 降到 4 NFE。可控性上:构建一个统一的文本条件模型 Voice Controller,支持两类此前整体 VSC 不存在的新任务——基于自然语言 prompt 的语音设计(从文本预测目标风格嵌入)和基于指令的单属性语音编辑(按指令修改年龄、性别、口音、情绪四个轴之一而保持其余属性),并在参考音频 VSC、语音设计、语音编辑三种设置下都拿到最强的目标风格保真度,同时在可懂度(WER)和未编辑属性保持上保持竞争力。
与已有工作不同的是,本文的独特切入有两个观察。其一是架构层面的:StyleStream 1.0 中目标风格信息同时分布在参考 mel 频谱图上下文(用于 mel 修复)和风格嵌入两个条件通道里,风格空间因此无法直接被文本操控。作者删掉 mel 上下文,把风格完全收拢到一个紧凑嵌入中,于是「用文本设计/编辑声音」被转化为「预测或修改这个嵌入向量」的问题——借鉴图像领域 FLUX Kontext 统一生成与编辑的思路,在嵌入空间训练一个文本条件 DiT,设计时辅助输入为 null 嵌入、编辑时为源嵌入,一个模型统一两种任务。其二是训练层面的:作者注意到 few-step 采样虽快但不保证流式质量,短 chunk 上下文有限、chunk 边界易劣化,于是把 Self Forcing 的自回归 rollout 引入流式语音,对齐训练与逐 chunk 推理行为。这两个观察此前的 VSC 工作都没有同时处理。
核心方法
直觉上整个系统像一个「去风格—再上风格」的翻译器:Destylizer 先把源语音压成只含语言内容、不含音色/口音/情绪的内容特征;Stylizer 再根据目标风格把内容「重新演绎」成 mel 频谱,最后由因果 Vocos 声码器还原波形。2.0 沿用 1.0 的 Destylizer(冻结 HuBERT-Large 编码器 + 6 层 conformer + FSQ 瓶颈,码本大小 45,用 ASR 损失联合训练),改动集中在 Stylizer:一是用少步像素 MeanFlow(pMF)目标训练 DiT,采样只需 4 步,且 CFG 蒸馏让每步只需一次网络评估;二是新增 Self Forcing 式自回归微调,让模型适应逐 chunk 的流式推理。目标风格由冻结 WavLM 特征经 perceiver resampler 压缩成单一嵌入 $e_s$,它既可以来自一段参考音频,也可以由文本条件的 Voice Controller 在嵌入空间直接生成或编辑,从而让同一个 Stylizer 同时支持参考转换、语音设计与语音编辑三种模式。
核心创新有两个层面。第一是把 pMF 与自回归反馈微调结合起来用于流式语音生成:网络预测接近数据流形的干净 mel $\hat{x}_\theta$,经 $u_\theta=(z_t-\hat{x}_\theta)/t$ 转成区间平均速度,用 MeanFlow 恒等式 $v=u+(t-r)\frac{d}{dt}u$ 配合 JVP 监督,再蒸馏掉 CFG 使 4 步采样每步只评估一次;随后按 chunk rollout 自己生成的 mel 历史——past 输出通道填入生成帧、损失只算当前 chunk、历史帧 detach——弥合离线训练与逐 chunk 推理之间的分布差。第二是风格单通道化:删除 mel 上下文后,目标风格完全由嵌入 $e_s$ 承载,文本控制变成嵌入空间里的生成问题——Voice Controller 用 JiT 式 x-prediction 训练文本条件 DiT,设计时辅助输入是可学习的 null 嵌入,编辑时是 patch 化的源风格嵌入,与目标 token 在通道维拼接。这与 1.0 的双通道条件、以及以往只做单属性、离线的文本引导编辑系统有本质区别。
方法步骤详情
流程分四步。① 内容提取:源语音经冻结 HuBERT-Large 与 6 层 conformer,取 FSQ 之前的 50Hz 连续特征作为内容表示 $f_c$。② 风格嵌入提取:冻结 WavLM 的 12 层隐状态沿时间拼接,perceiver resampler 用 $N_q$ 个查询压缩成固定表示,展平过 MLP 得到风格嵌入 $e_s$。③ pMF 训练:对目标 mel $x$ 构造插值 $z_t=(1-t)x+t\epsilon$,条件 $c=(f_c,e_s)$,DiT 输入在通道维拼接 $z_t$、$f_c$ 与 past 通道(离线置零);随机采样 guidance $\omega$、以概率 $p_{drop}$ 丢条件做 CFG 蒸馏,用 JVP 监督平均速度场。④ 自回归微调:冻结风格编码器,逐 chunk rollout,生成 mel 窗口 $m_{past}$ 填 past 通道并置零当前 chunk,掩码 $M$ 只算当前 chunk 损失。流式推理用环形缓冲区重复此过程:300ms chunk + 80ms lookahead + 4 步采样。
技术新颖性
与已有技术的区别体现在四点。对比 StyleStream 1.0:1.0 用 16/12 NFE 的多步扩散且依赖 mel 修复上下文,2.0 用 4 NFE 的 pMF 且完全由嵌入承载风格,流式 chunk 从 600ms 缩到 300ms;AR 微调是全新的训练阶段,1.0 没有。对比 pMF/MeanFlow 原始工作:它们面向图像的离线少步生成,本文首次用于语音到语音的流式转换,并新增 AR 反馈阶段适配 chunk 推理。对比 Self Forcing:本文保留 rollout 机制但把视频扩散的监督目标替换为 pMF 速度目标,且只在当前 chunk 上计损失。对比文本控制系统:Qwen3-TTS 等 prompt-TTS 是文本到语音,无法处理任意输入语音;已有文本引导语音编辑只覆盖单一属性且离线运行。据作者所述,把「嵌入空间统一语音设计+单属性编辑」引入整体流式 VSC 属于首次,评测也只能自建级联基线。
实验结果
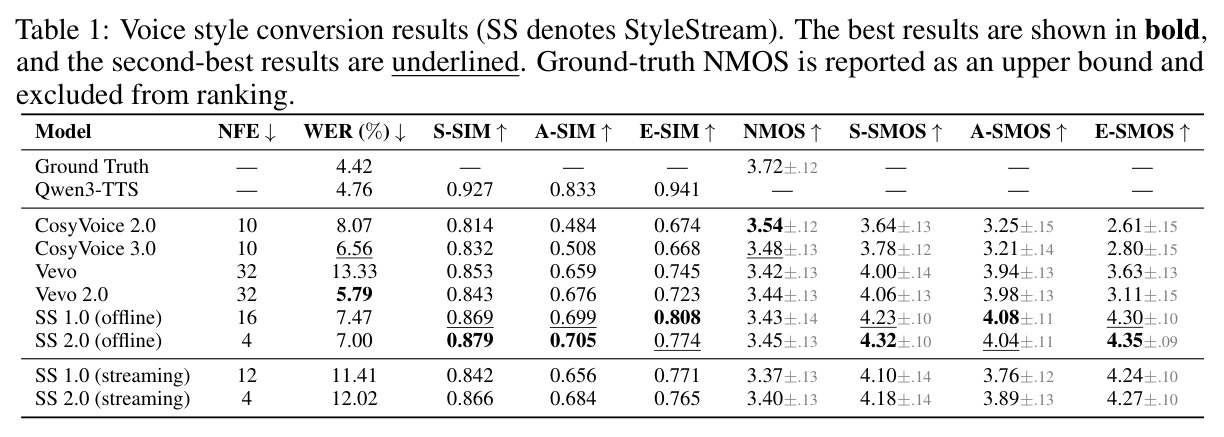
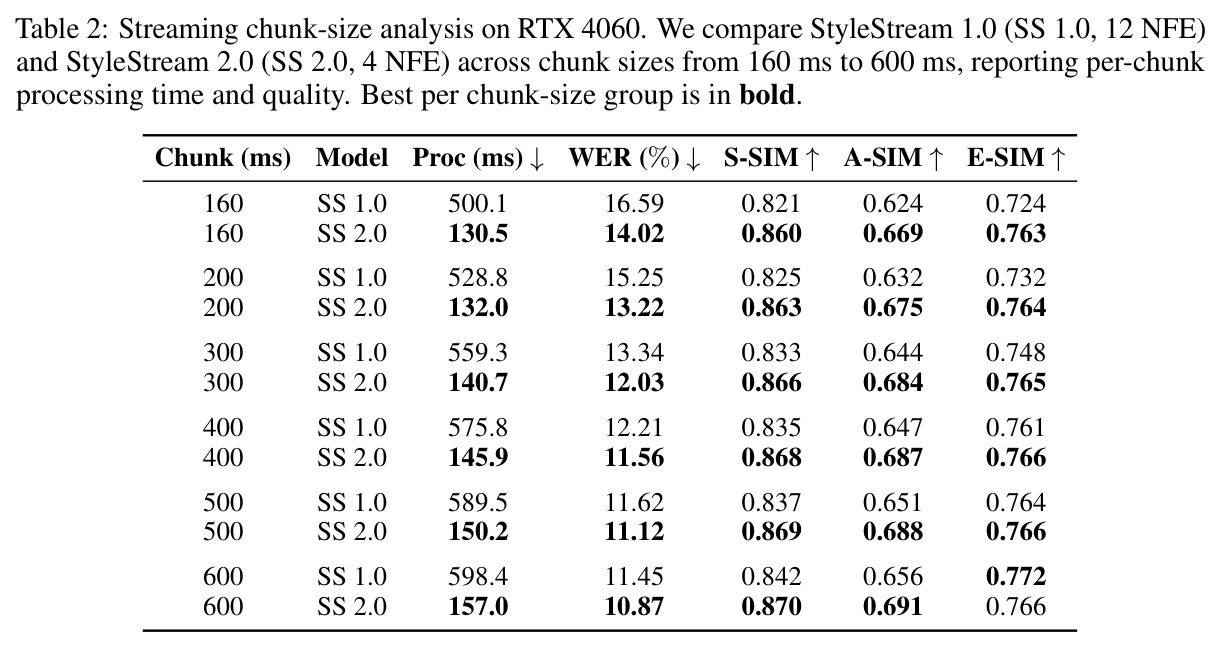
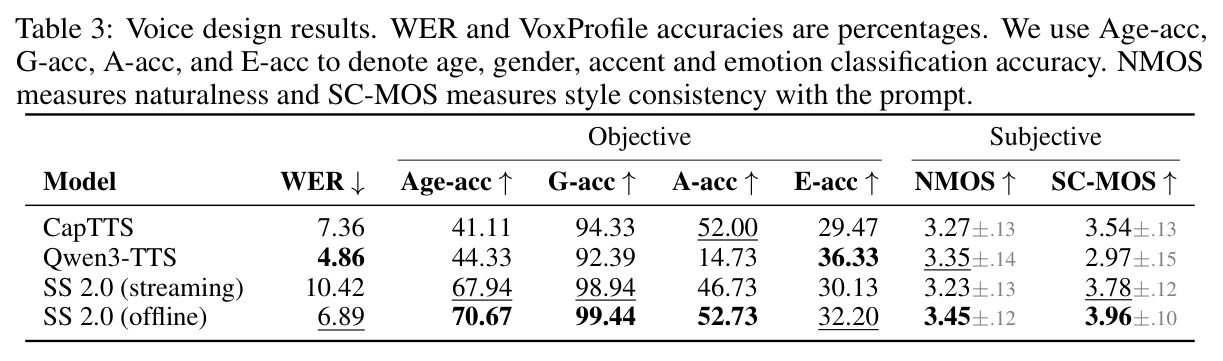
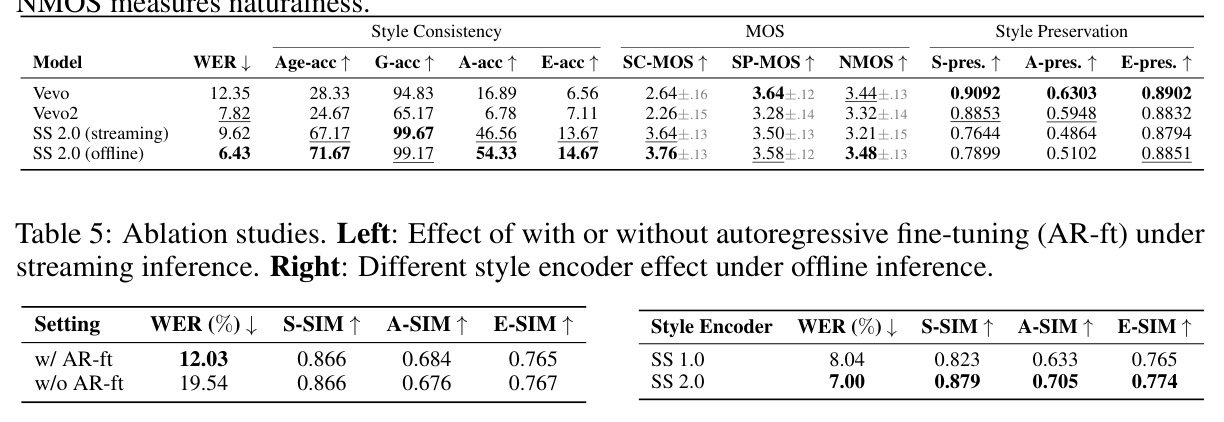
VSC(Table 1):离线 2.0 仅 4 步采样(1.0 为 16 步)即取得最强风格保真——S/A-SIM 0.879/0.705、主观 S/E-SMOS 4.32/4.35 均列第一,WER 7.00% 优于 1.0 的 7.47%;Vevo 2.0 的 WER 最低(5.79%)但风格相似度全面落后。流式下以 300ms chunk 取得 S-SIM 0.866、A-SIM 0.684。流式效率(Table 2):RTX 4060 上 300ms chunk 处理仅 140.7ms,端到端延迟 520.7ms,约为 1.0 的一半;1.0 仅在 600ms chunk 时勉强实时。语音设计(Table 3):离线 Age-acc 70.67%、G-acc 99.44%、A-acc 52.73% 全面领先 CapTTS 与 Qwen3-TTS 级联基线。语音编辑(Table 4):WER 6.43% 最低,Age-acc 71.67%、A-acc 54.33% 远超基线;但 S-pres 0.7899 低于 Vevo 的 0.9092,编辑与保持存在权衡。消融(Table 5):去掉 AR 微调后流式 WER 从 12.03% 恶化到 19.54% 而风格指标不变;编码器换回 TDNN 后 WER 升至 8.04%、A-SIM 跌至 0.633。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 参考音频语音风格转换(离线) | S-SIM 说话人相似度 | 0.879(4 NFE) | StyleStream 1.0 0.869(16 NFE);Vevo 2.0 0.843 | +0.010 / +0.036,同时采样步数减少 75% |
| 参考音频语音风格转换(离线) | A-SIM 口音相似度 | 0.705 | StyleStream 1.0 0.699;CosyVoice 3.0 0.508 | +0.006 / +0.197 |
| 流式端到端延迟 | 端到端延迟(300ms chunk + 80ms lookahead) | 520.7 ms(每 chunk 处理 140.7 ms) | StyleStream 1.0 约 1 秒 | 约 2 倍加速 |
| 文本语音设计 | Age-acc 年龄准确率 | 70.67%(离线) | CapTTS 41.11%;Qwen3-TTS 44.33% | +29.56 / +26.34 个百分点 |
| 文本语音编辑(口音轴) | A-acc 口音准确率 | 54.33%(离线) | Vevo 16.89%;Vevo2 6.78% | +37.44 / +47.55 个百分点 |
| 自回归微调消融(流式) | WER 词错误率 | 12.03%(含 AR-ft) | 无 AR-ft 时 19.54% | 降低 7.51 个百分点,风格相似度基本不变 |
局限与改进
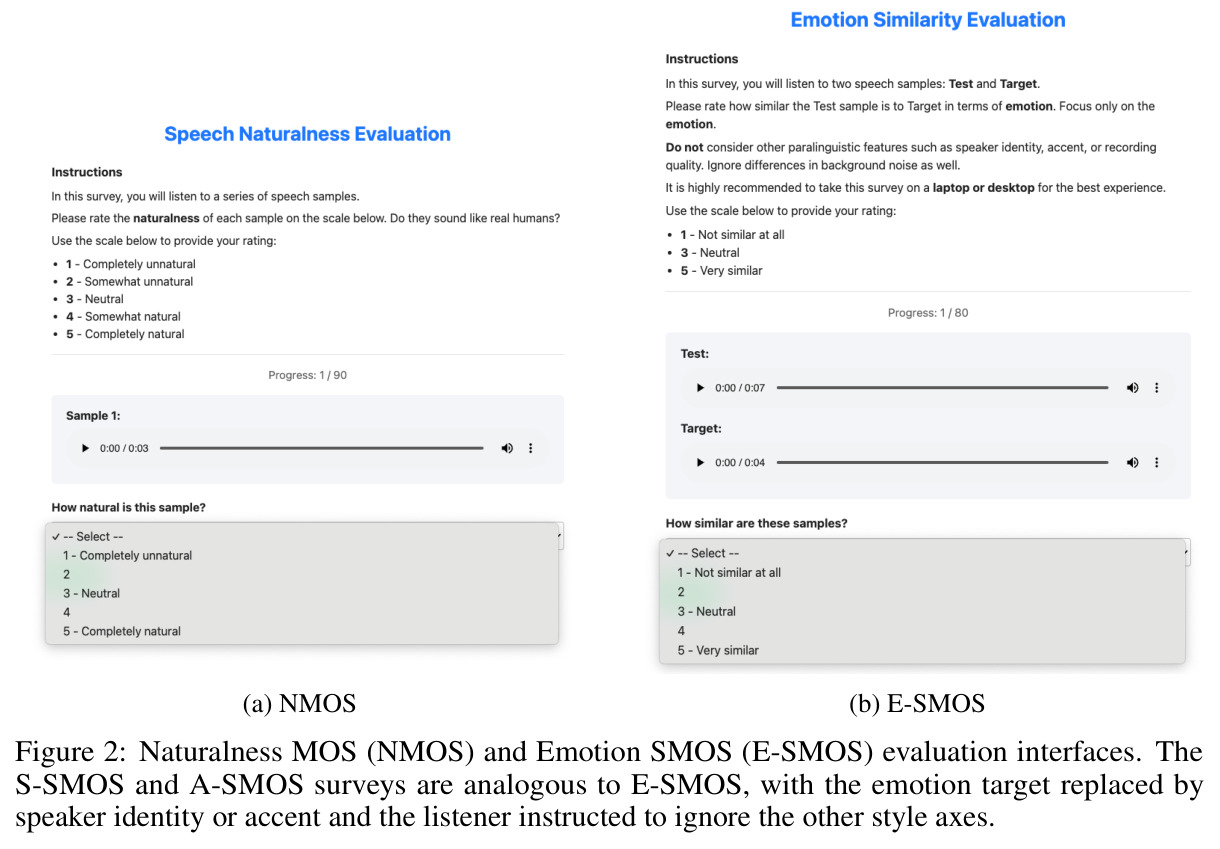
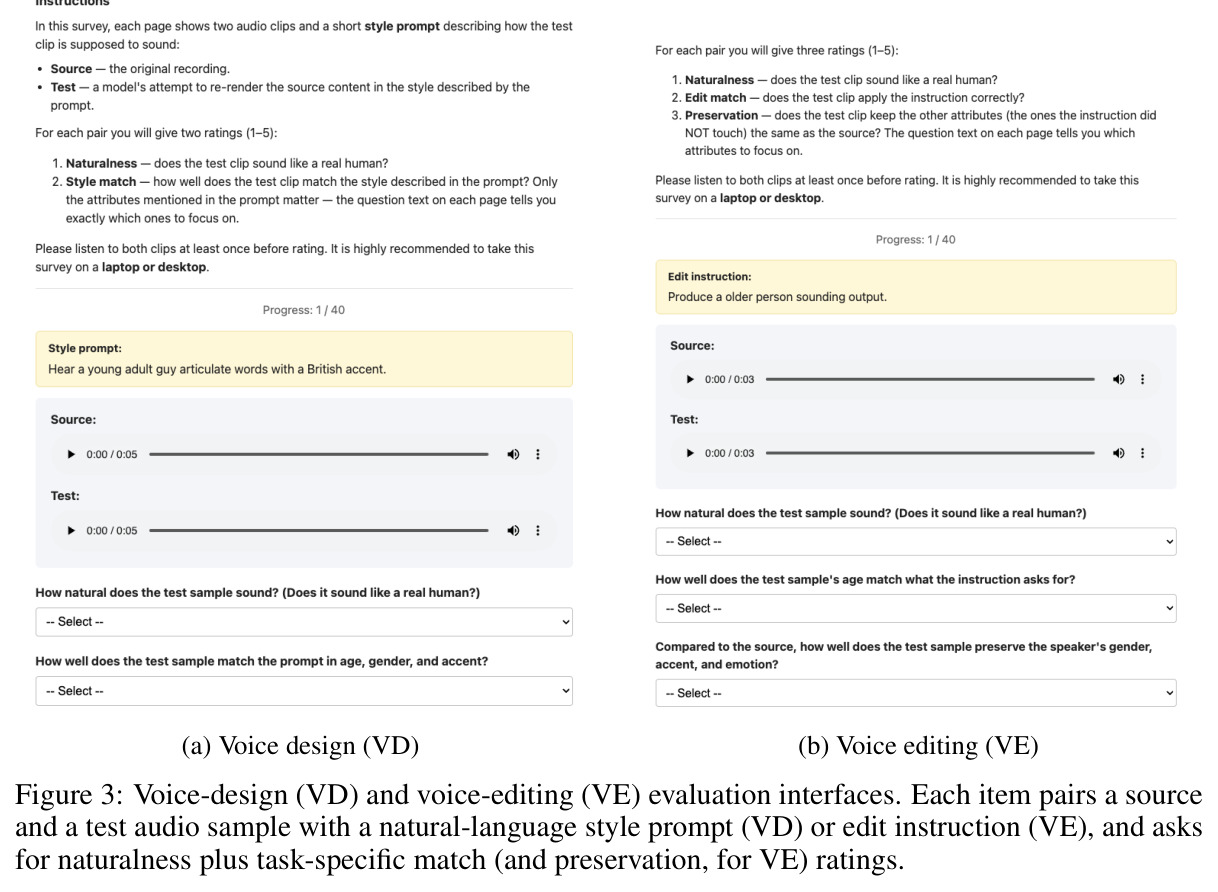
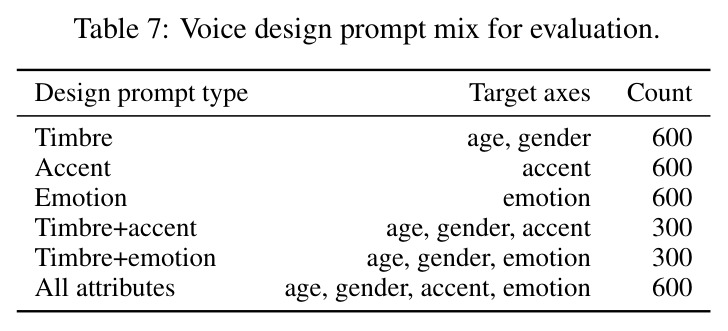
作者承认的局限:流式设置下 E-SIM 略低于 1.0(0.765 对 0.771);编辑任务的属性保持分数低于基线——S-pres 0.7899 对 Vevo 的 0.9092,存在编辑成功与保持未编辑属性的权衡;流式 WER(12.02%)明显高于离线(7.00%)和真值(4.42%);情绪编辑准确率绝对值很低(离线仅 14.67%、流式 13.67%),虽然高于 Vevo 系但远不能算可靠。我自己的观察:评测集中在英语和 5 种口音(英/美/印/阿拉伯/普通话腔),跨语言与低资源口音的泛化完全未验证;风格嵌入是黑盒向量,删除 mel 上下文后对细粒度副语言特征(耳语、唱歌、语速等)的承载能力存疑;Voice Controller 的训练标签来自 CapSpeech caption 模板渲染加 VoxProfile 预测兜底、编辑对靠 CosyVoice3 合成对齐,监督噪声可能封住上限;年龄只有两档编辑指令,属性粒度较粗;主观 MOS 的被试规模与置信区间在正文未详细报告。
独立分析的弱点
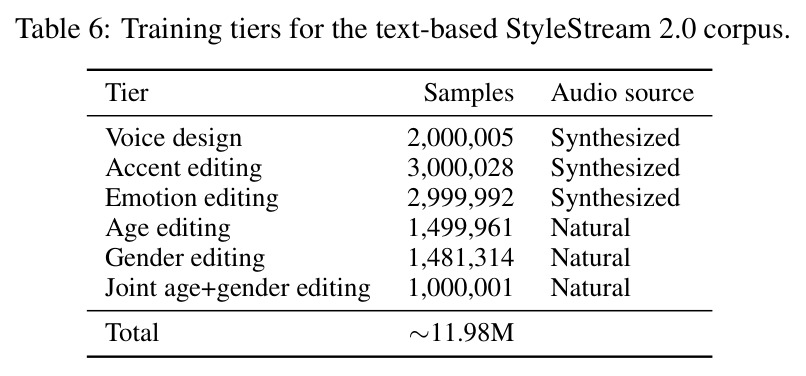
独立分析四个弱点。一、情绪控制明显偏弱:设计任务 E-acc 仅 32.20%、编辑任务 14.67%,与性别轴的 99% 相差悬殊,很可能因为情绪标签从 caption 模板渲染而来、粒度粗且类别不平衡,改进方向是引入连续价-唤醒空间或多参考情绪锚点对比学习。二、嵌入空间属性解耦不充分:编辑成功后 S-pres 掉到 0.7899(A-pres 仅 0.5102),说明改口音/情绪会牵动音色,嵌入各维度存在耦合,改进方向是分轴子空间约束、解耦正则或属性特定的低秩编辑方向。三、流式可懂度损失大:WER 从离线 7.00% 涨到 12.02%,AR 微调只把无 AR 时的 19.54% 拉回一部分,短 chunk 边界上下文不足仍是根因,改进方向是加大 lookahead 或引入 chunk 重叠的边界平滑策略。四、训练数据闭环依赖合成:编辑对由 CosyVoice3 对齐生成,模型可能继承 TTS 的风格偏置与伪影,改进方向是引入真实平行语料、或用「编辑再编辑应还原」的双向一致性做半监督约束。
未来方向
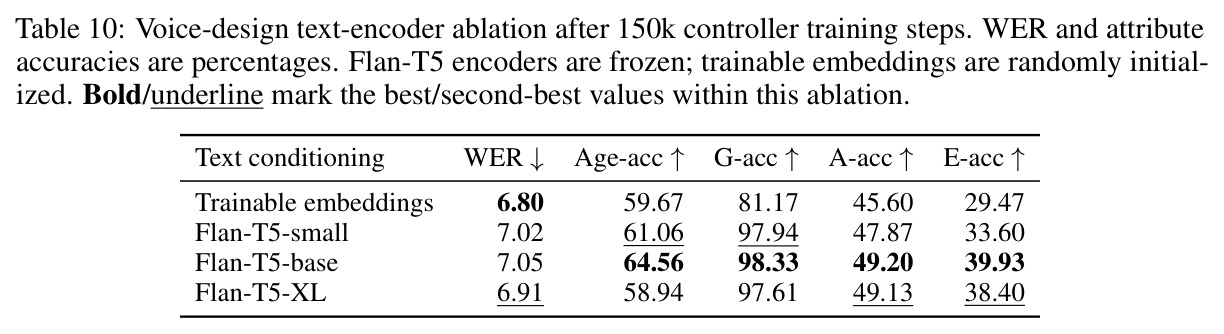
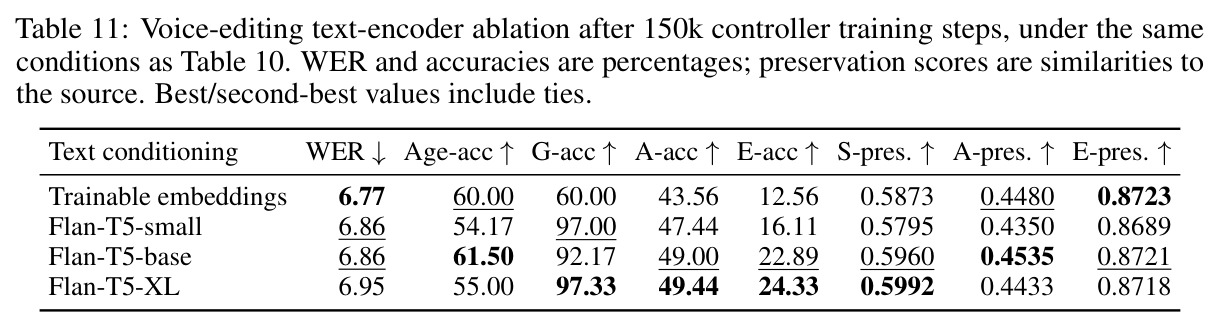
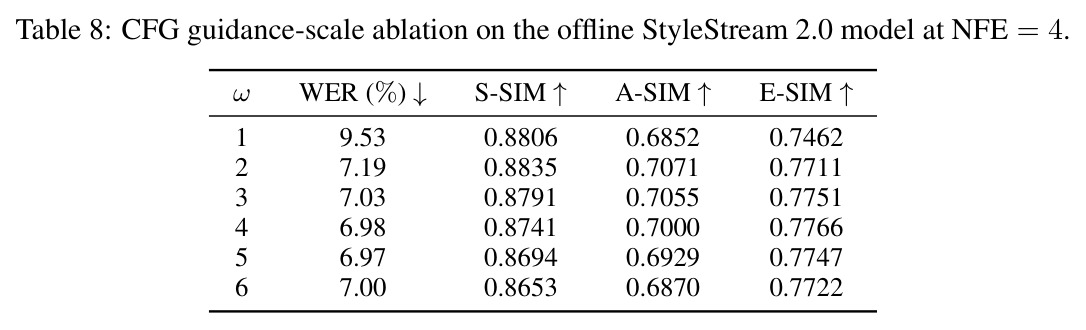
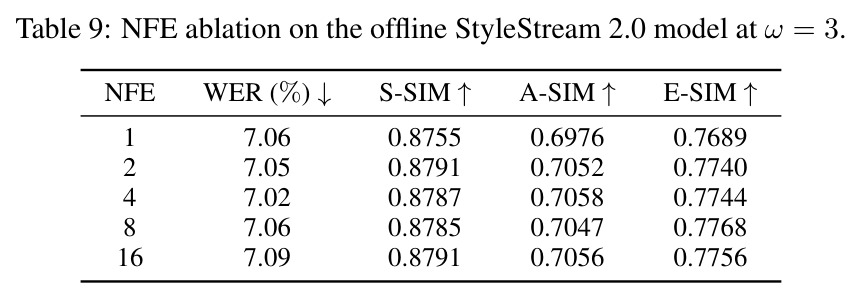
作者方向:附录 C 还留有 NFE、CFG scale 与 Voice Controller 文本编码器的消融空间,说明采样与条件编码仍可调优;把可控属性扩展到年龄/性别/口音/情绪之外(语速、音高、耳语、唱歌等细粒度音质)是自然延伸;Voice Controller 目前用离散标签模板渲染 prompt,扩展到连续属性描述和更自由的开放式指令值得探索。基于成果可延伸:风格嵌入既然是连续向量空间,就可以做属性插值与向量算术,实现「介于两种声音之间」的混合音色或风格迁移的强度旋钮;pMF + 自回归微调这一「少步 + 流式对齐」范式可以直接迁移到其他流式生成任务,如音乐续写、音频事件生成、数字人语音驱动;嵌入空间编辑也可与 ASR 纠错或 downstream TTS 级联,构建端到端可控的语音后期处理流水线;进一步量化蒸馏(INT8 等)有望把 520ms 推向 300ms 以内、进入嵌入式设备。
复现评估
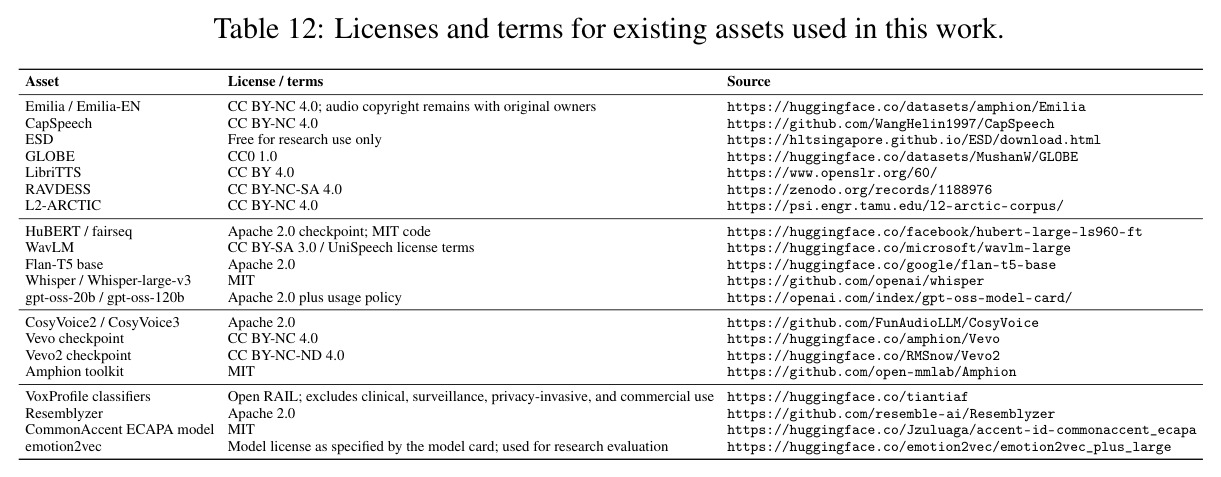
开源情况:论文给出样例页面 https://berkeley-speech-group.github.io/StyleStream2.0,但正文未明确声明代码与权重开源,需关注后续动态。数据与算力:Stylizer 在 Emilia 英文子集约 5 万小时在野语音上训练;Destylizer 复用 1.0(HuBERT-Large + conformer + FSQ + ASR 解码器);Voice Controller 基于 CapSpeech 派生语料,构造流程依赖 CosyVoice3、VoxProfile、Whisper 等外部模型;评测需 ESD、RAVDESS、GLOBE-test、L2-ARCTIC、LibriTTS 加 VoxProfile 分类器与多项人工 MOS。算法细节(附录 B)与数据构造(附录 A)描述较充分,方法有据可循。推理门槛不高:RTX 4060 单卡即可实时流式(4 NFE、300ms chunk 处理 140.7ms);但完整训练是 DiT 规模,需多卡 GPU 数周级投入。若不开源权重,从零复现属中高难度;若开源,工程复用价值很高。
论文图表