游戏中的规模化:面向多样虚拟世界具身智能的持续预训练 Scaling in Games: Continued Pre-Training For Embodied Agents In Diverse Virtual Worlds
120组对照实验揭示游戏具身智能持续预训练中数据量、多样性与模型规模对域内性能与跨世界迁移的影响
前置知识
持续预训练(CPT)
在已完成通用预训练的基座模型(本文为 Qwen3.5 多模态模型)上,用特定领域数据(游戏轨迹)继续做下一词预测训练,不改变目标格式。它把通用视觉-语言能力迁移到交互控制任务,是 VPT、GameTARS、SIMA 等游戏智能体的公共训练阶段。
整篇论文的实验对象就是 CPT:全部 120 个配置都是同一 CPT 配方在不同数据量、多样性与模型规模下的实例,理解 CPT 才能理解三个缩放轴的含义。
Chinchilla 缩放定律
经验公式 $L = E + A/N^{\alpha} + B/T^{\beta}$,把验证损失表示为参数量 $N$ 与训练数据量 $T$ 的幂律之和,$E$ 为不可约损失。它原本假设训练与评估是同一分布、损失随数据单调下降。
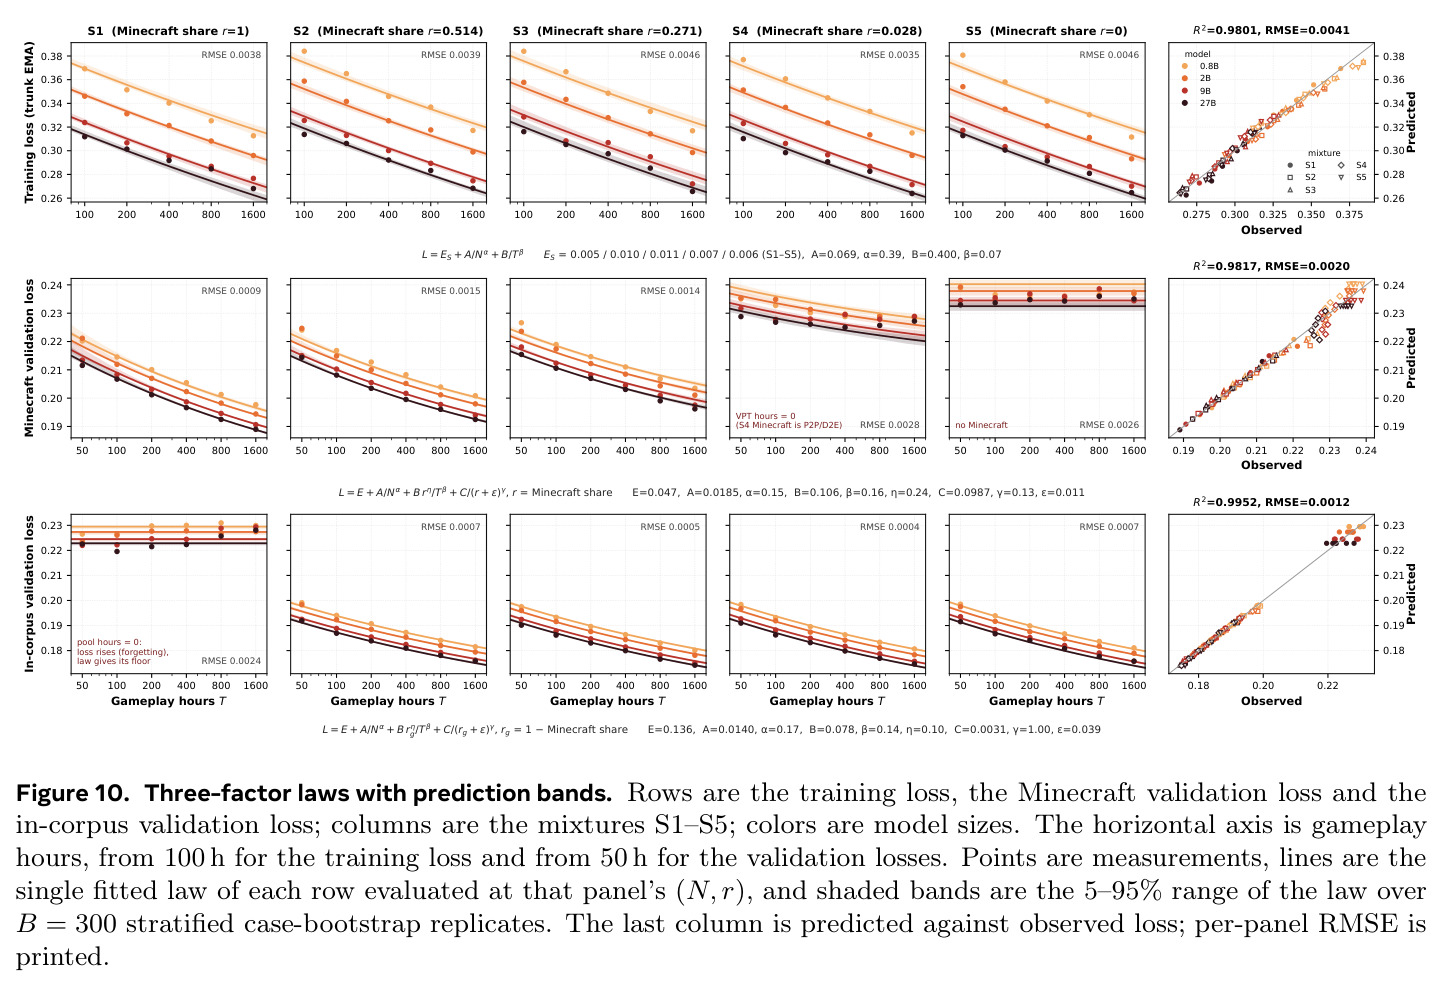
论文的核心定量产出就是把该定律扩展到游戏 CPT 场景(引入世界占比 $\rho$ 与有限地板项),所有“多大规模配多少数据”的结论都来自拟合出的指数。
行为克隆(模仿学习)
从人类演示轨迹中学习“观测→动作”映射,用监督方式最小化动作预测误差,没有环境回报信号。CPT 中的游戏轨迹训练本质是大规模行为克隆:模型学的是“玩家会怎么做”,而非“怎么做才能赢”。
作者把远距世界泛化失败部分归因于行为克隆缺乏任务成败反馈,这是理解论文局限性讨论与未来工作方向的前提。
键鼠统一动作接口
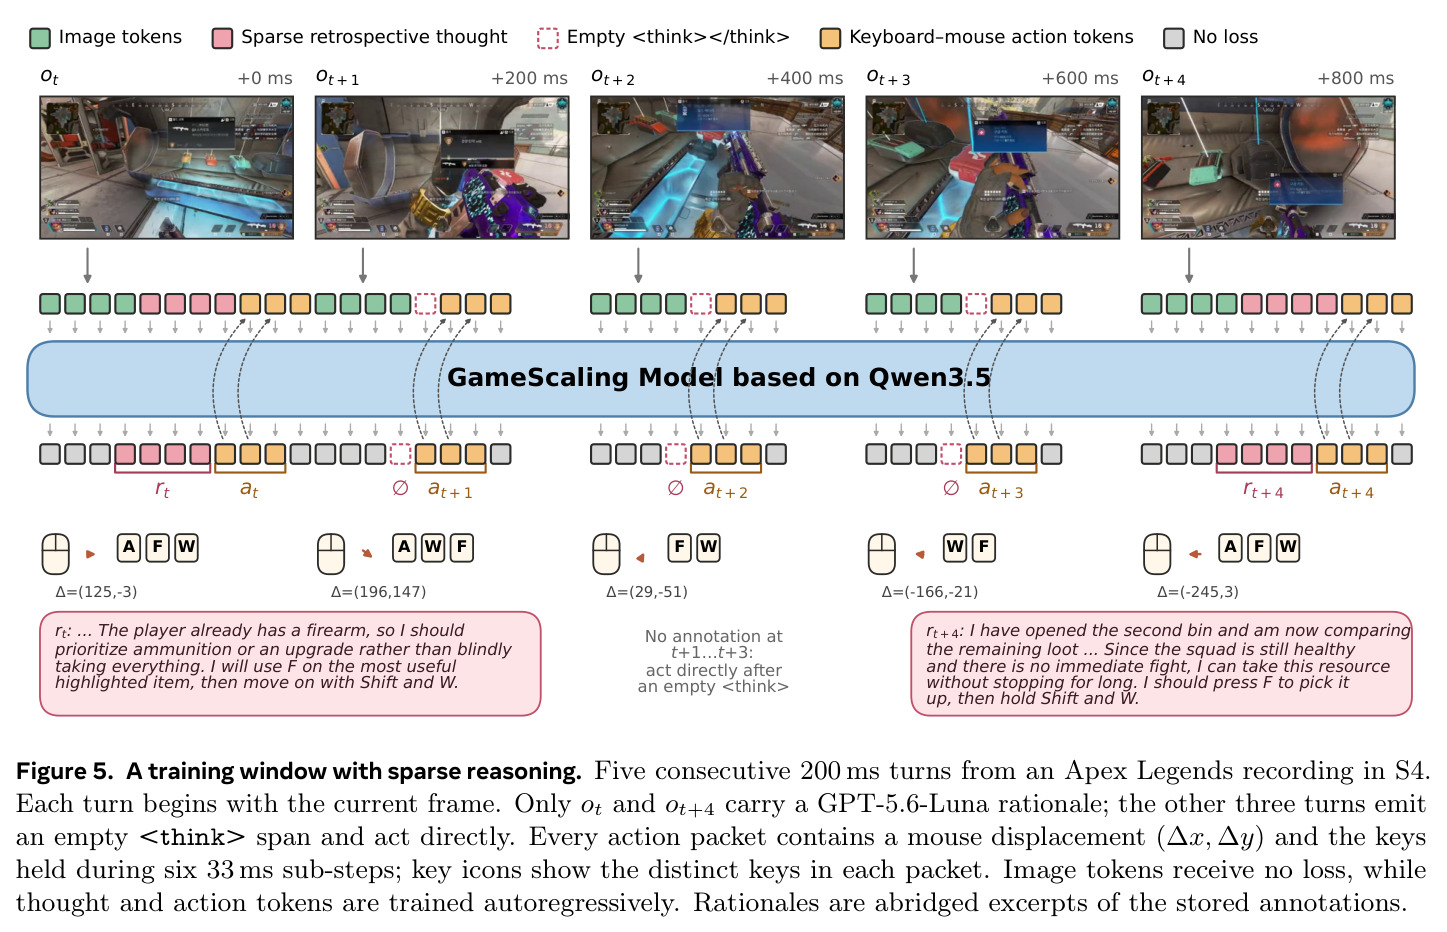
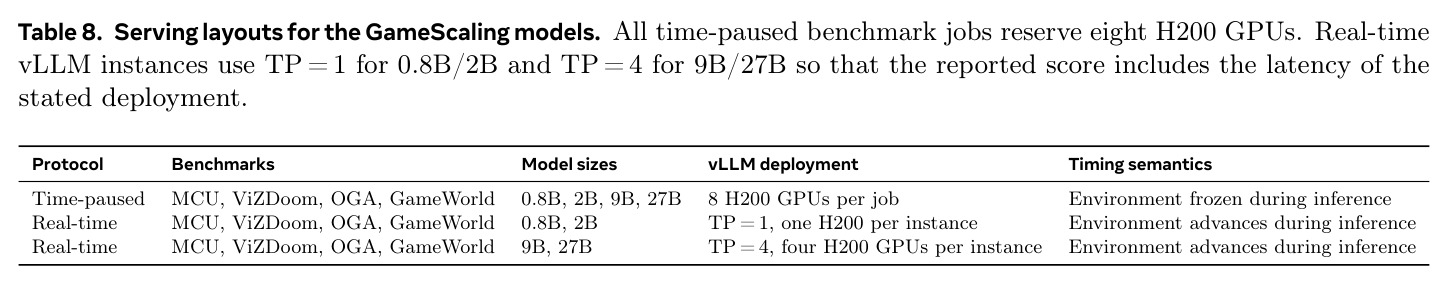
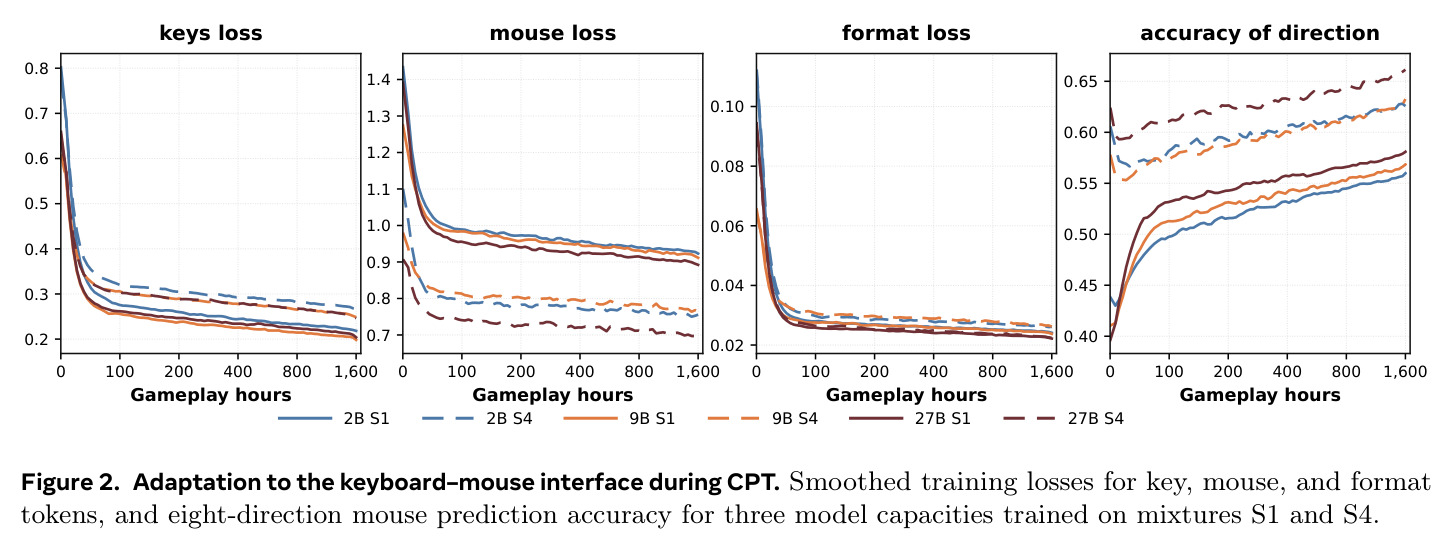
把所有游戏的控制统一成文本化动作包 $a_t=\langle \Delta x,\Delta y,\Delta z;K^{(1)};\dots;K^{(6)}\rangle$:鼠标位移离散到 $[-1000,1000]^2$,6 个 33ms 子步各持 0–4 键,每包覆盖 200ms;模型 5Hz 观测、30Hz 控制。
这是模型的输出空间,也是“接口阶段”所学内容的具体载体;所有评测(含前沿模型对比)都通过同一个动作包语法与适配器进行。
分布外泛化与三级评估
按评估世界与训练分布的距离分层:语料内(Minecraft、DOOM,训练见过)、未见相关世界(OGA:7 个 3D UE5 游戏,动作基元在训练中有对应物)、远距世界(GameWorld:170 个 2D/2.5D 任务,画风、物理、目标迥异)。三级验证损失与三级基准一一对应。
论文最重要的结论——多样性帮助相关世界、对远距世界收效甚微——只有在按距离分层的评估下才能被观察到。
Hill 数(有效世界数)
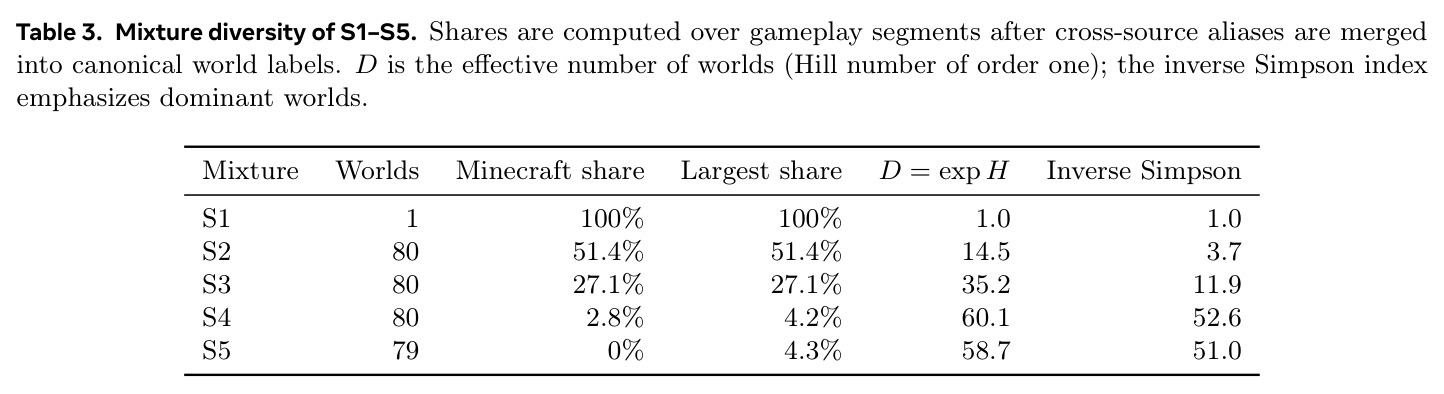
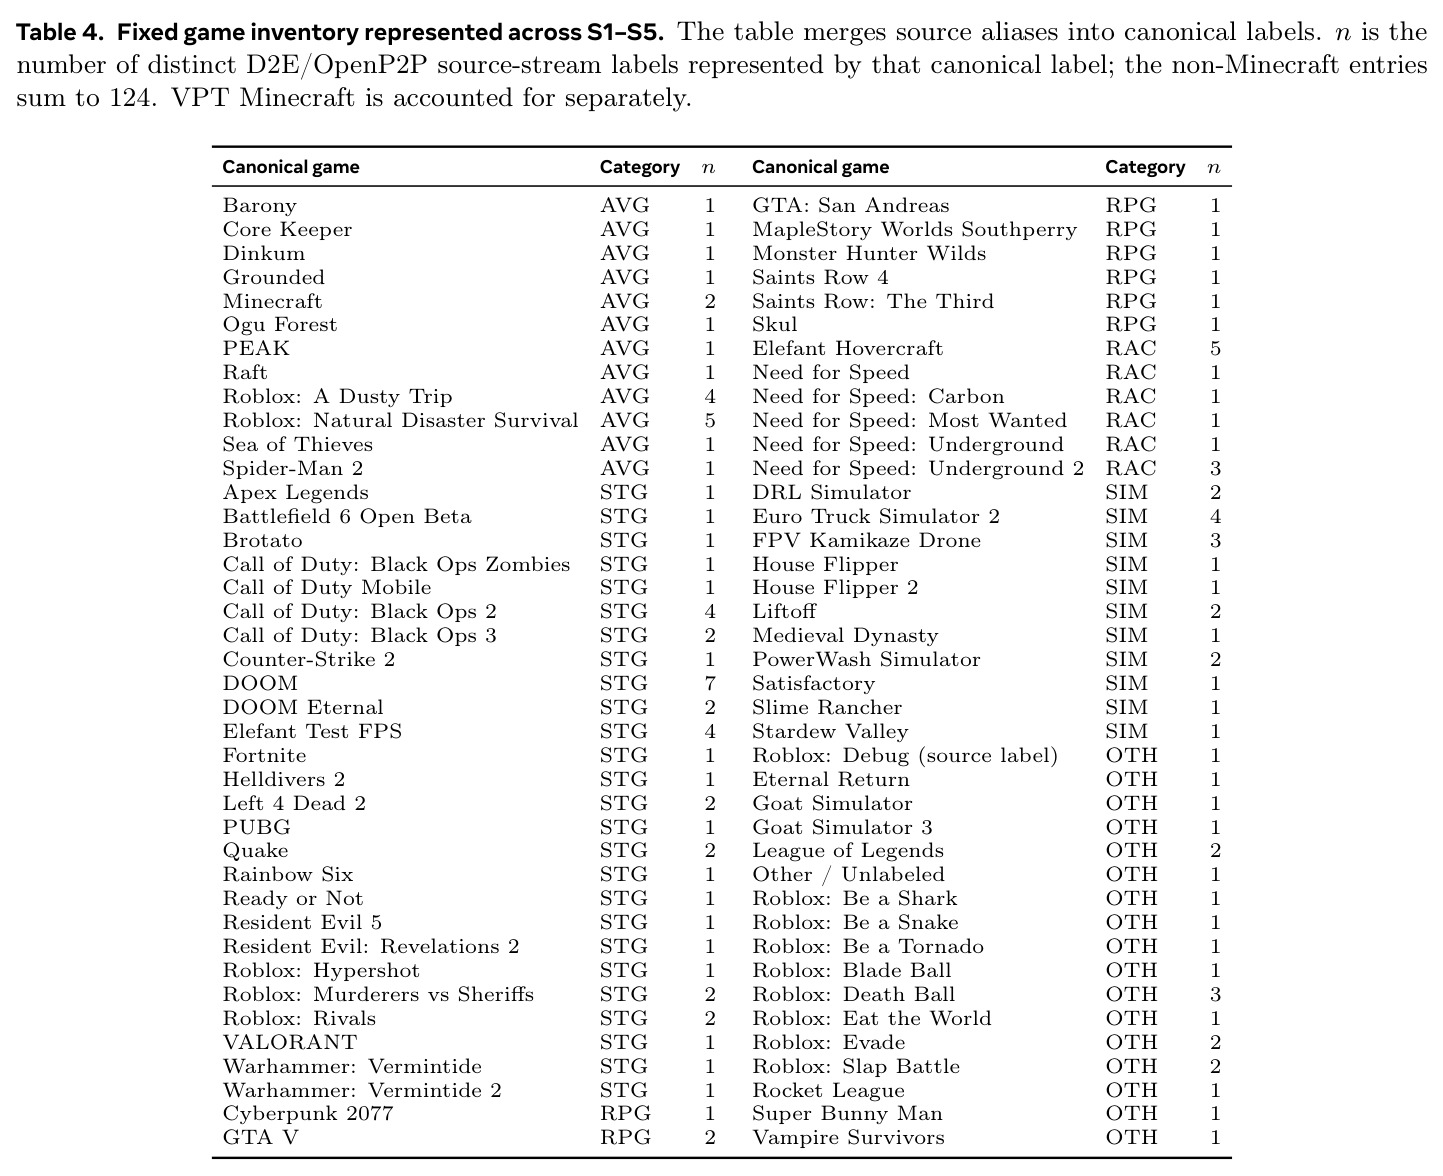
$D=\exp(-\sum_w p_w \log p_w)$,一阶 Hill 数,等于与该混合具有相同香农熵的等权世界数:单一世界 $D=1$,80 个等权世界 $D=80$。本文用它量化 S1–S5 混合多样性(1.0/14.5/35.2/60.1/58.7)。
它是论文中“多样性”这一轴的严格定义,避免把“游戏数量”与“配比均衡度”混为一谈(S2–S4 游戏集合完全相同,只是配比不同)。
研究动机
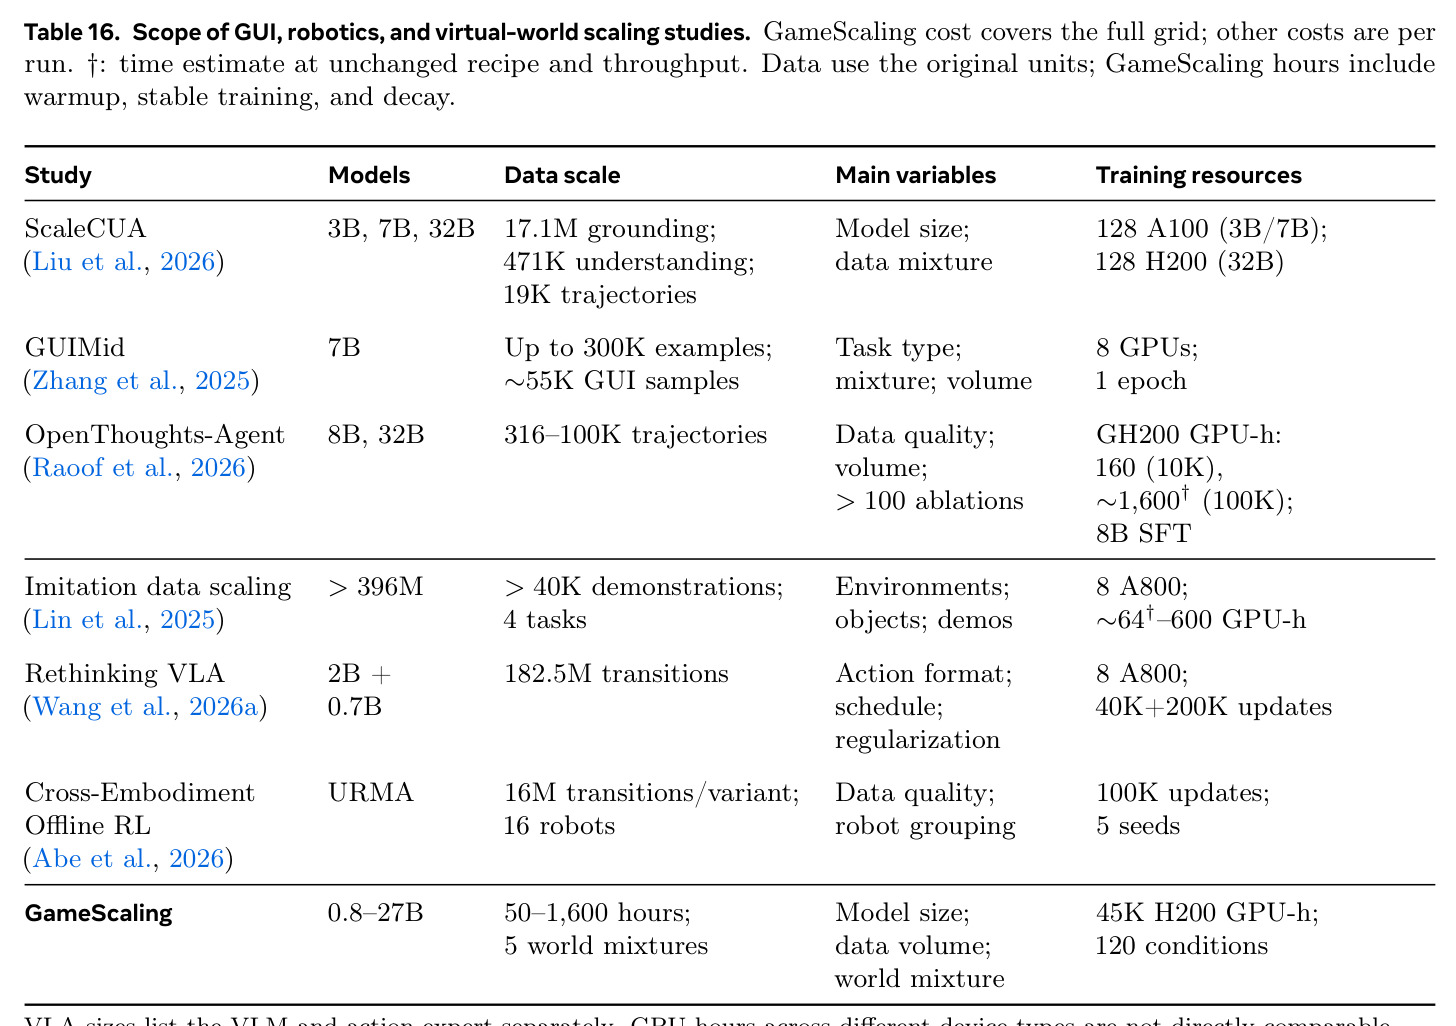
机器人领域的缩放研究表明,更广的经验能带来更通用的具身智能,但其隐含前提是真实世界共享同一套物理规律:重力、接触与物体持久性处处一致,控制指令的物理效果跨任务变化很小,因此一个场景收集的经验可以复用到另一个场景。虚拟世界打破了这个前提:不同游戏可能同时在线条风格、物理引擎、动作空间与目标设定上完全不同,Minecraft 的方块生存和 Dota 2 的团队对抗几乎不共享任何表层结构。已有的游戏智能体(VPT、GameTARS、SIMA、NitroGen 等)普遍采用“在游戏轨迹上做持续预训练”这一配方,但现有工作在改变数据量的同时往往同时改变模型大小与训练时长,三个因素相互纠缠、无法归因;更根本的是,学界一直不清楚异构的游戏经验到底是互补的、能累积成跨世界通用能力,还是相互干扰、损害模型在单个游戏里学到的技能。
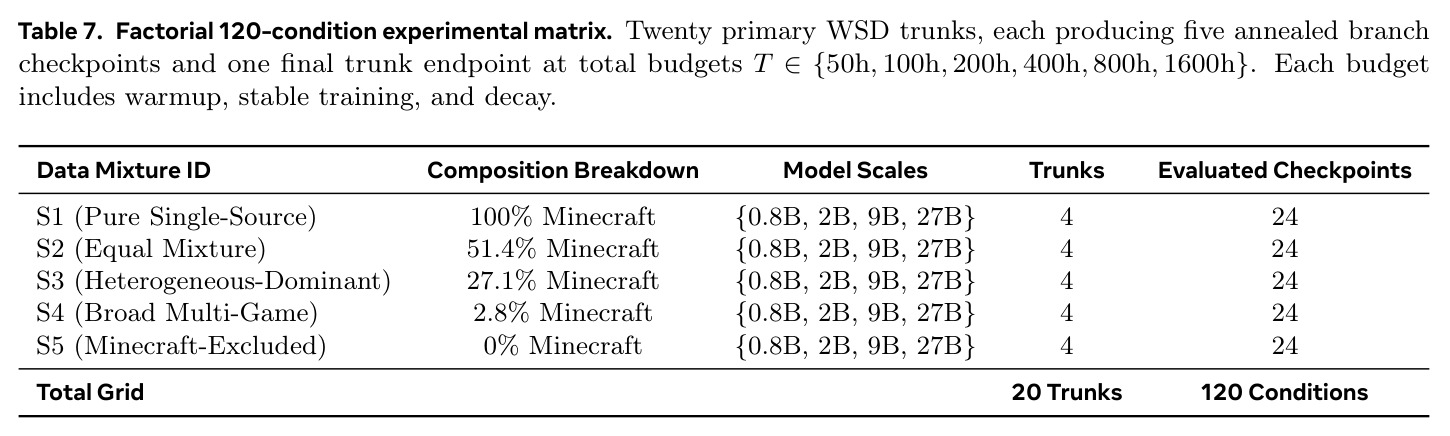
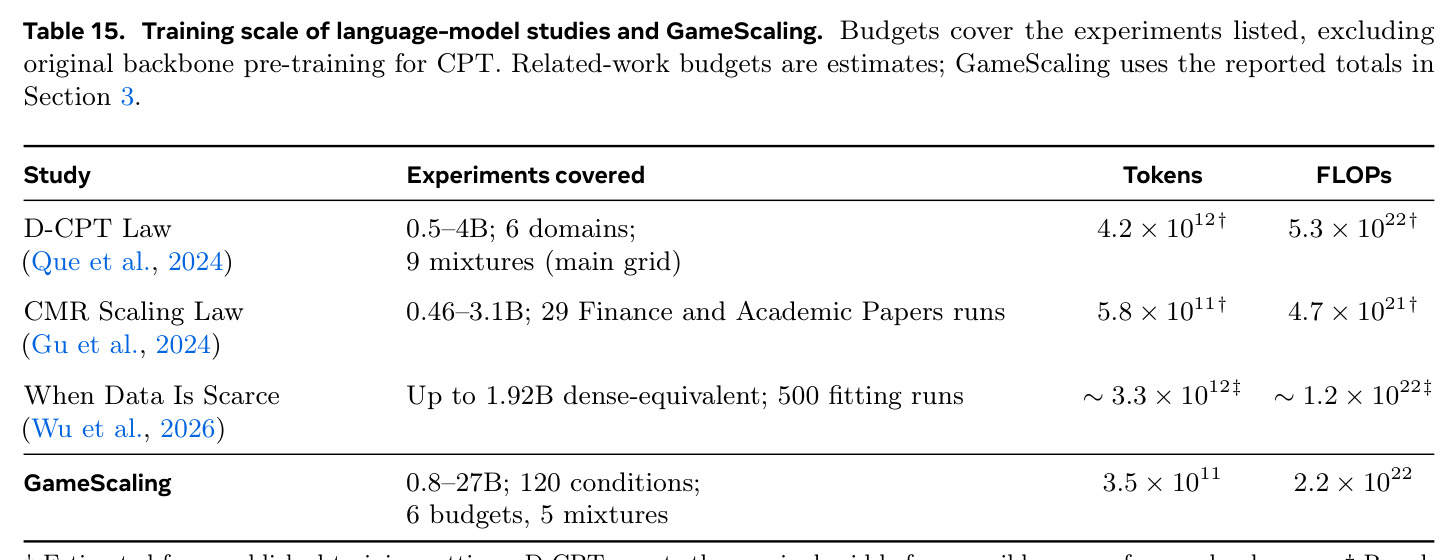
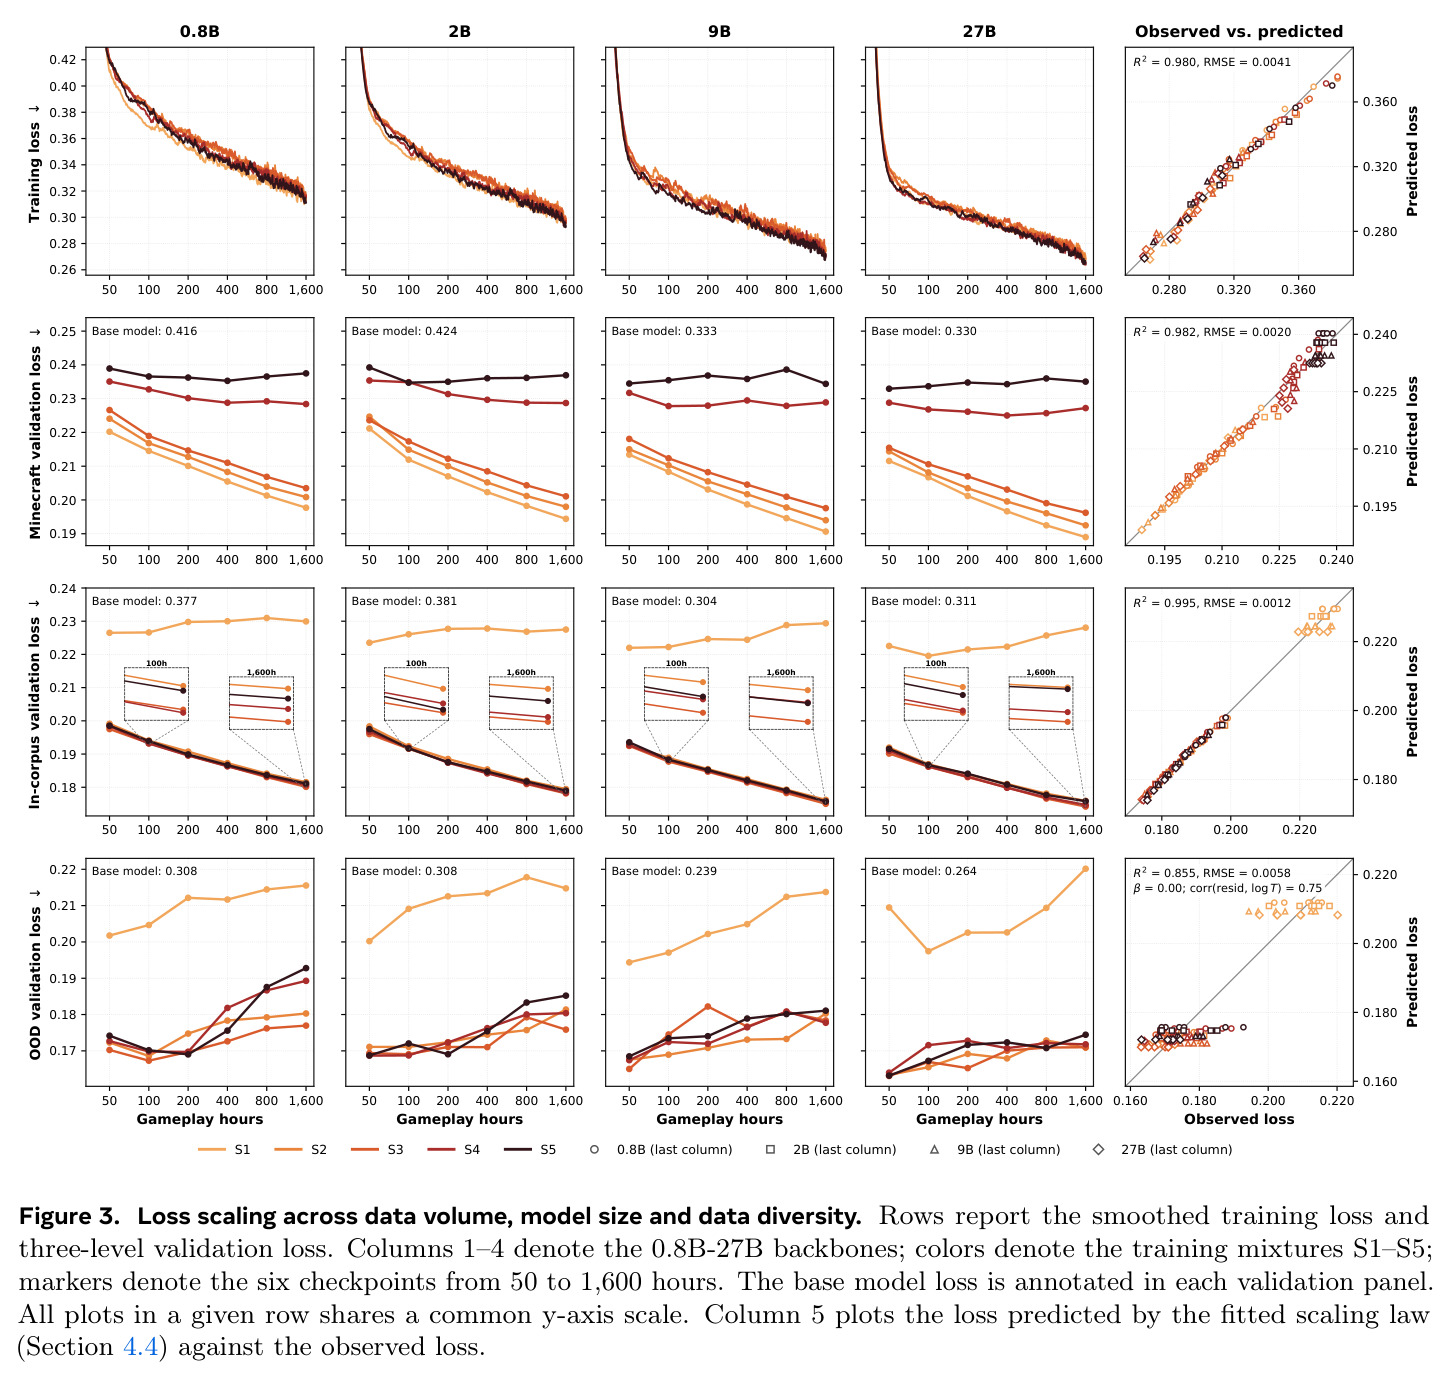
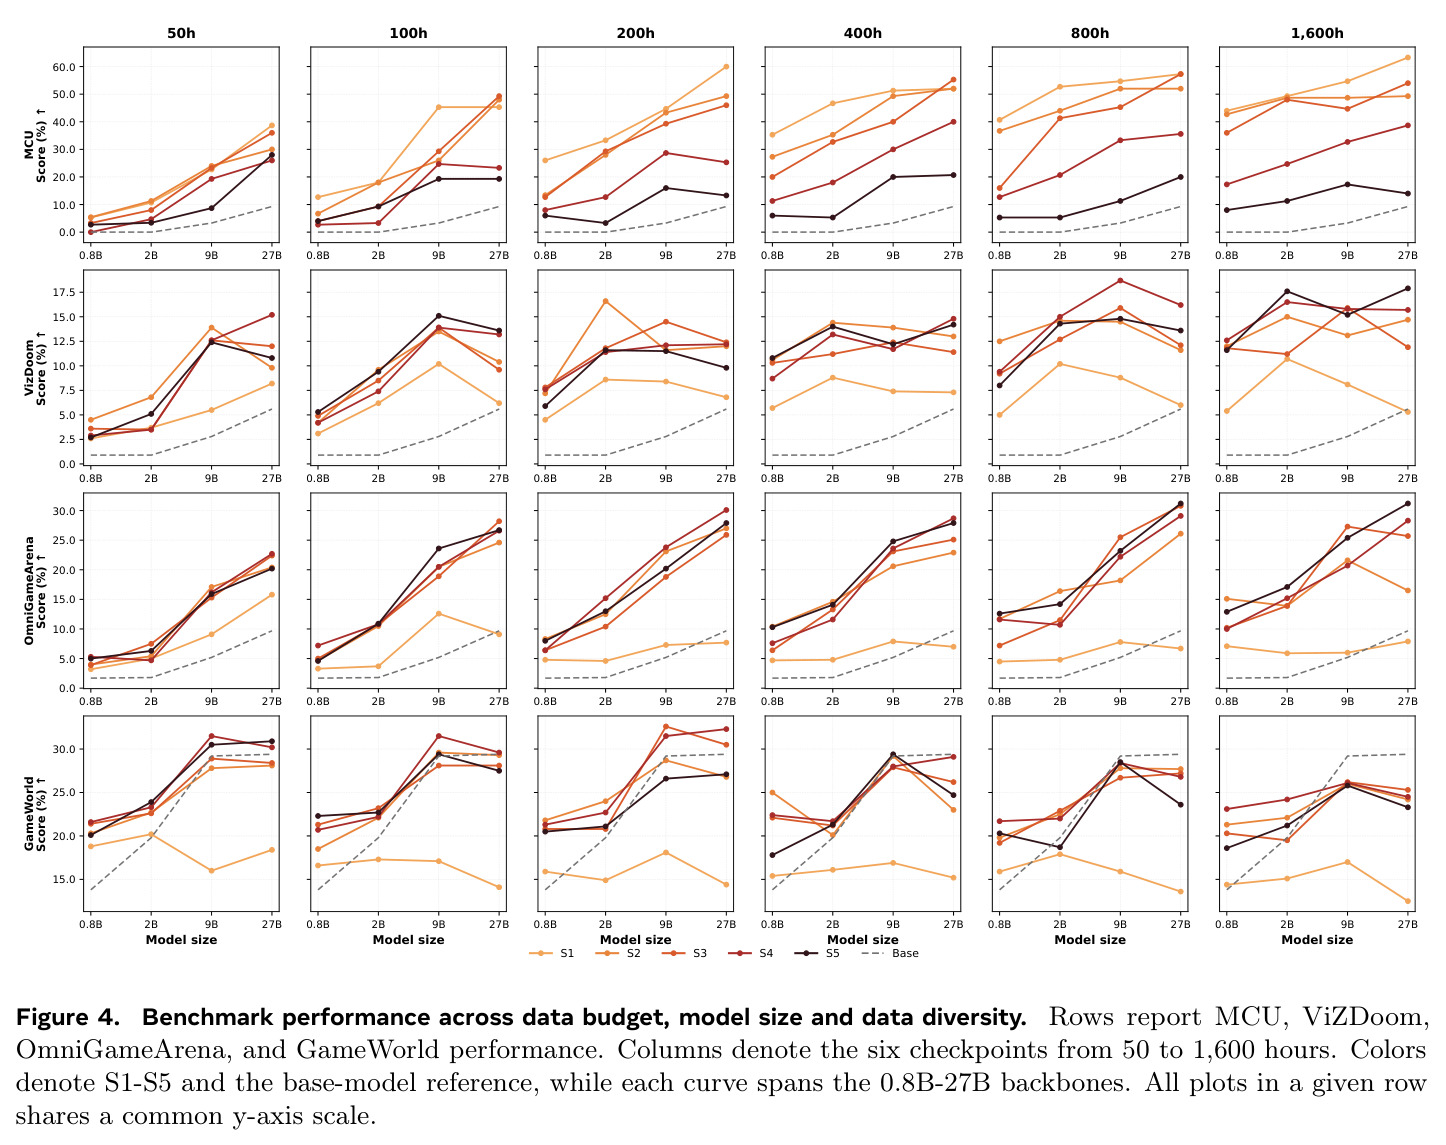
本文的目标是本文要在受控条件下回答“游戏具身智能的 CPT 是否可缩放、如何缩放”。做法是把 CPT 的三个轴做成 4×6×5=120 个配置的因子网格:模型规模取 Qwen3.5 的 0.8B/2B/9B/27B 四档,数据预算取 50/100/200/400/800/1600 游戏小时六档,数据多样性取 S1–S5 五种混合(Minecraft 轨迹占比 100%/51.4%/27.1%/2.8%/0%,其余游戏池完全固定),除这三轴外所有超参与数据格式保持不变。评估采用三级验证损失(Minecraft-only、语料内、分布外)与三级基准阶梯(语料内的 MCU/ViZDoom → 未见相关世界 OmniGameArena → 远距世界 GameWorld),在冻结推理与实时两种交互协议下系统测量每个因素的独立贡献,并拟合统一三轴的经验缩放定律。整个网格消耗 $3.5\times10^{11}$ 训练 token、$2.2\times10^{22}$ FLOPs、约 45,000 H200 GPU 小时。
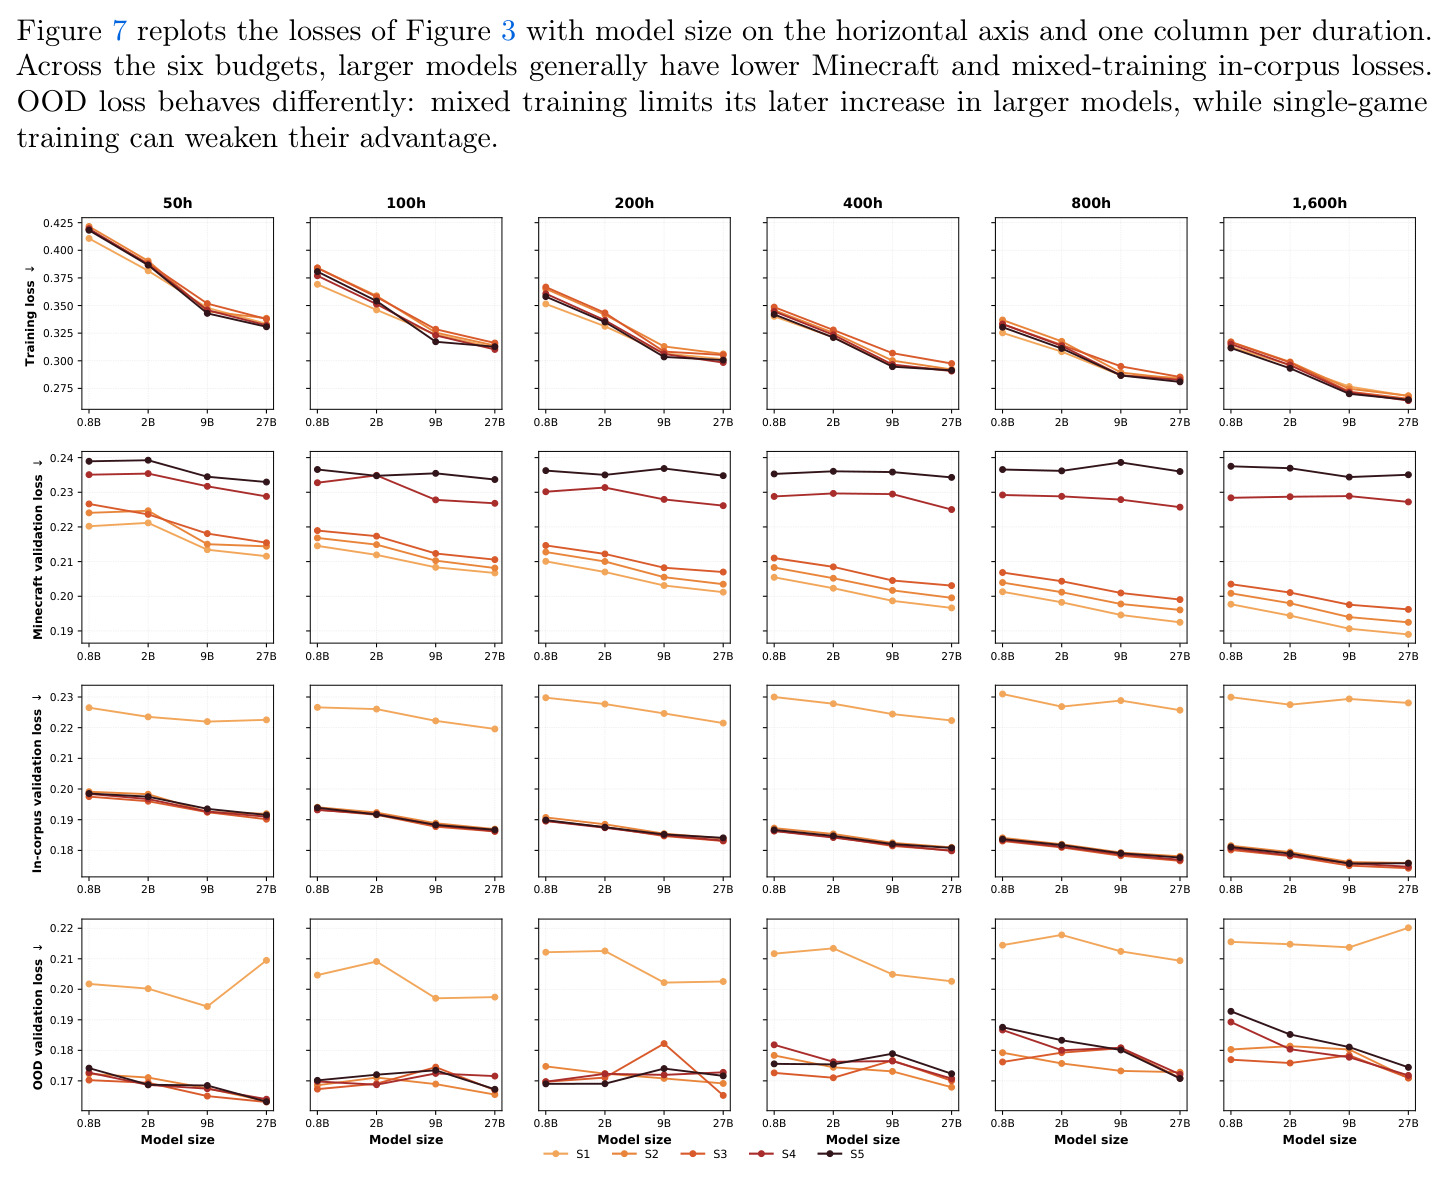
与已有工作不同的是,本文的独特切入是“控制变量 + 按距离分层”的实验设计。以往游戏智能体研究是配方式的:一次只报告一个最终系统,数据、模型、时长同时变动;NLP 的 D-CPT/CMR 缩放定律只处理文本域混合,没有交互环境特有的动作接口与实时延迟维度;机器人缩放研究通常固定模型只动数据。本文第一次在虚拟具身场景系统隔离数据量、多样性、模型大小三轴,并把评估按与训练分布的距离分层为语料内、未见相关、远距三级,从而能把“学会了共享键鼠接口”与“学到了特定世界知识”区分开。一个关键的实证触发点是:完全不含 Minecraft 的 S5 混合仍能把 Minecraft 验证损失降到显著低于基座,说明存在跨混合迁移的有限下界,这促使作者在 Chinchilla 定律中加入 $\rho=0$ 时仍有限的地板项 $C/(\rho+\epsilon)^{\gamma}$,得到带交叉迁移项的三因素缩放定律。
核心方法
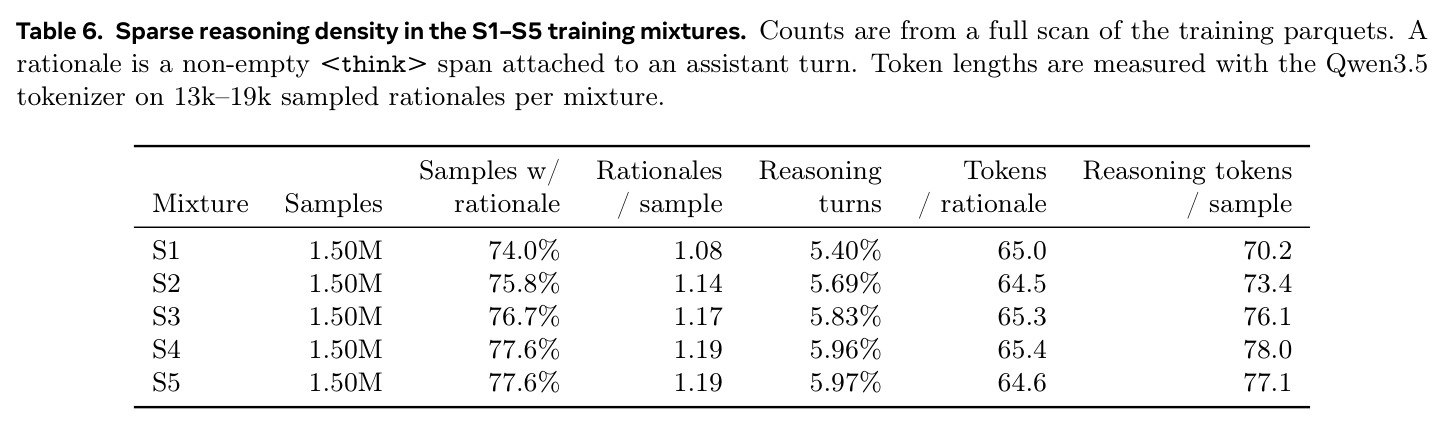
直觉上,论文把“在游戏上做持续预训练”当成一个可以做对照实验的缩放科学问题,而不是调配方。技术路线分四步。第一步统一表示:游戏玩法被形式化为视觉决策过程,每步输入提示上下文 $c$、当前观测 $o_t$ 与交互历史 $H_t$,模型先产生可为空的文本推理 $r_t$,再产生结构化动作 $a_t$;每个动作包覆盖 200ms,含离散鼠标位移 $(\Delta x,\Delta y)\in[-1000,1000]^2$、滚轮 $\Delta z\in[-5,5]$ 与 6 个 33ms 子步的按键集合,模型 5Hz 观测、30Hz 控制,训练用 20 轮窗口、10 轮步长。第二步构建数据:85% 游戏轨迹来自公开的 VPT/D2E/OpenP2P,15% 为固定不变的视觉-语言锚数据(避免与多样性轴混淆),并用 GPT-5.6-Luna 对约 5–6% 的助手轮次做稀疏回溯推理标注,动作标签不变。第三步训练:Qwen3.5 四档规模全参数 AdamW + WSD 调度(峰值学习率 LM 1e-5、ViT 7e-6),20 条干线分支出 120 个检查点。第四步评估:三级验证损失 + 四个基准 + 冻结/实时两种协议,统一动作适配器。
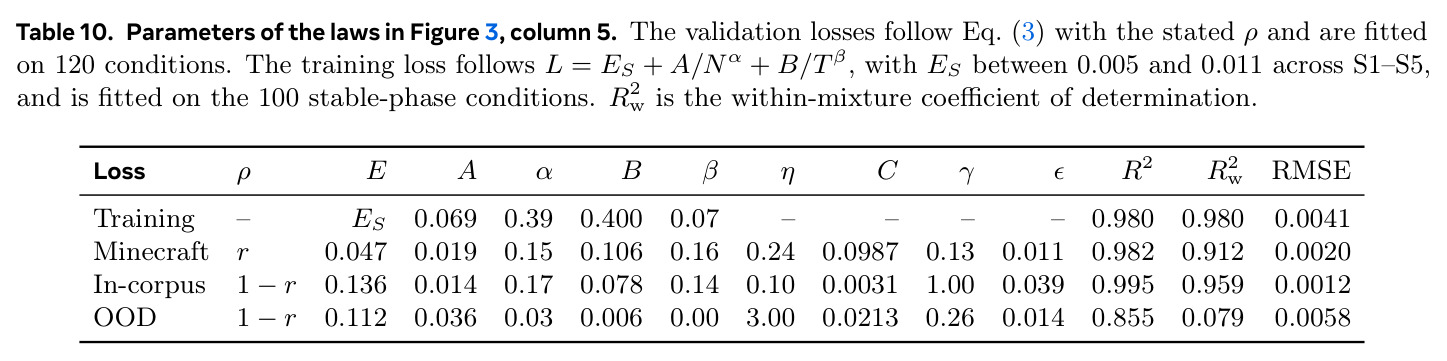
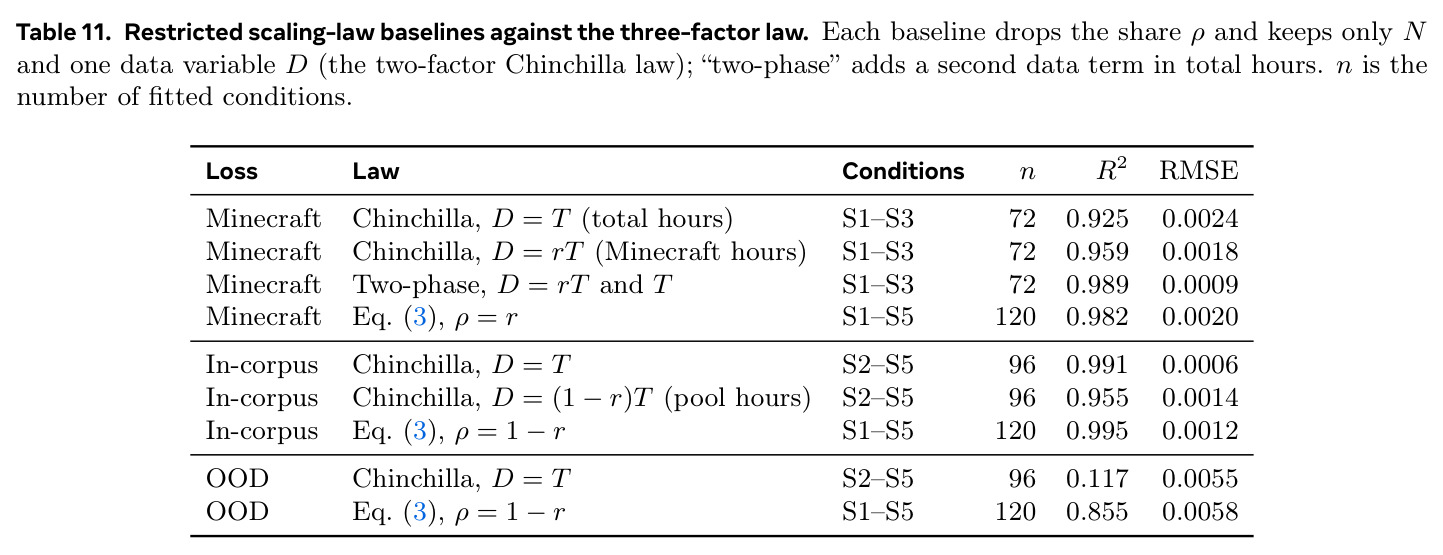
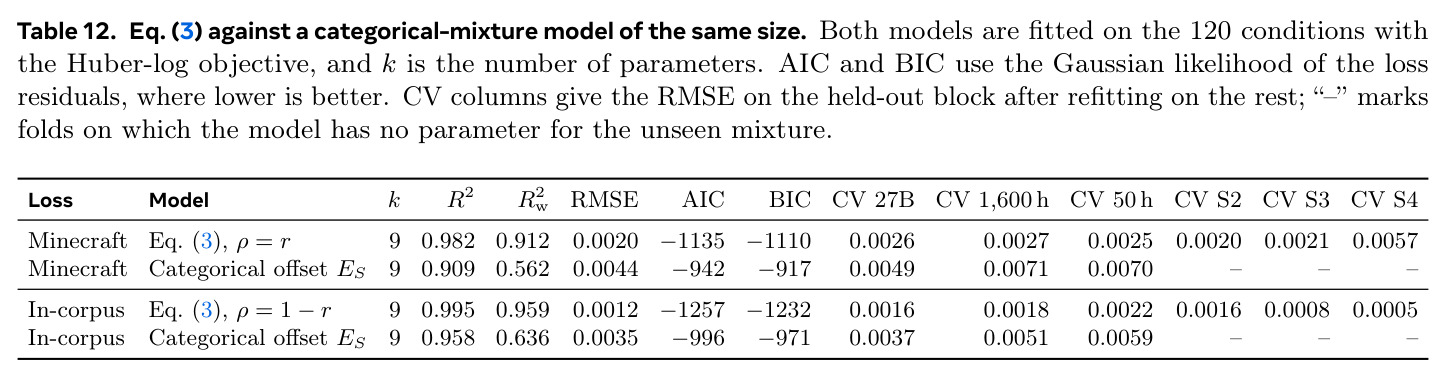
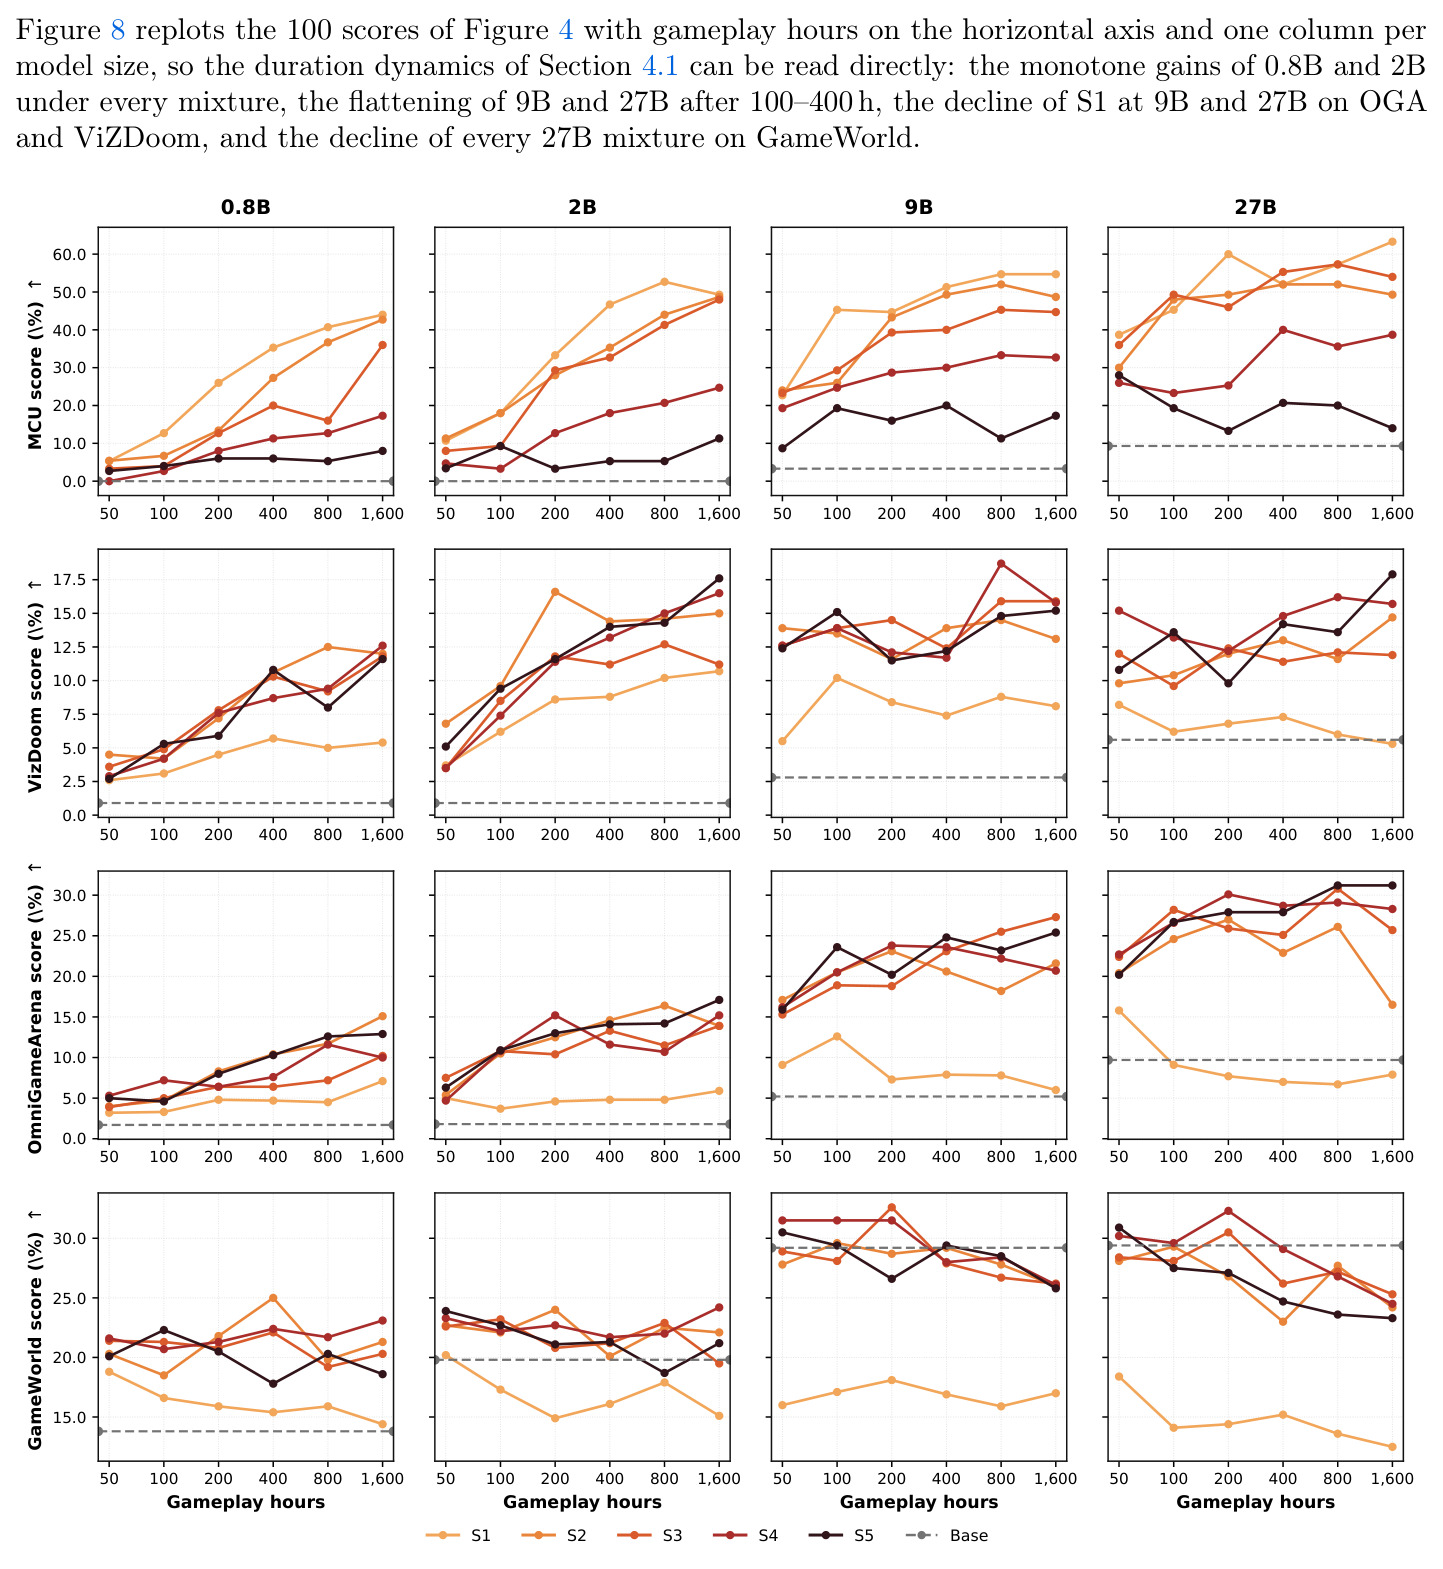
核心创新是把缩放定律从“单一分布”扩展到“多世界混合 + 评估距离”。Chinchilla 定律 $L=E+A/N^{\alpha}+B/T^{\beta}$ 假设训练与评估同分布、损失随数据单调下降;本文引入混合占比 $\rho$(预测 Minecraft 损失时取 $\rho=r$ 即其份额,预测语料内损失时取 $\rho=1-r$),把数据项改写为 $B\rho^{\eta}/T^{\beta}$,再加一个 $\rho=0$ 时仍有限的地板项:$$L(N,T,\rho)=E+A/N^{\alpha}+B\rho^{\eta}/T^{\beta}+C/(\rho+\epsilon)^{\gamma}.$$ 拟合出的 $\eta>0$(Minecraft 为 0.24)说明数据项不能简化为“有效小时数”$\rho T$:占比不仅改变损失幅度,还改变其随 $T$ 下降的斜率——不含 Minecraft 的 S5 损失几乎不随小时数下降,而 S1 明显下降。另一关键概念是两阶段学习动力学:前约 50 小时为“接口阶段”,模型习得各世界共享的键鼠格式与动作基元,收益跨世界普遍;此后进入“世界阶段”,收益收缩到训练过与相近的世界。
方法步骤详情
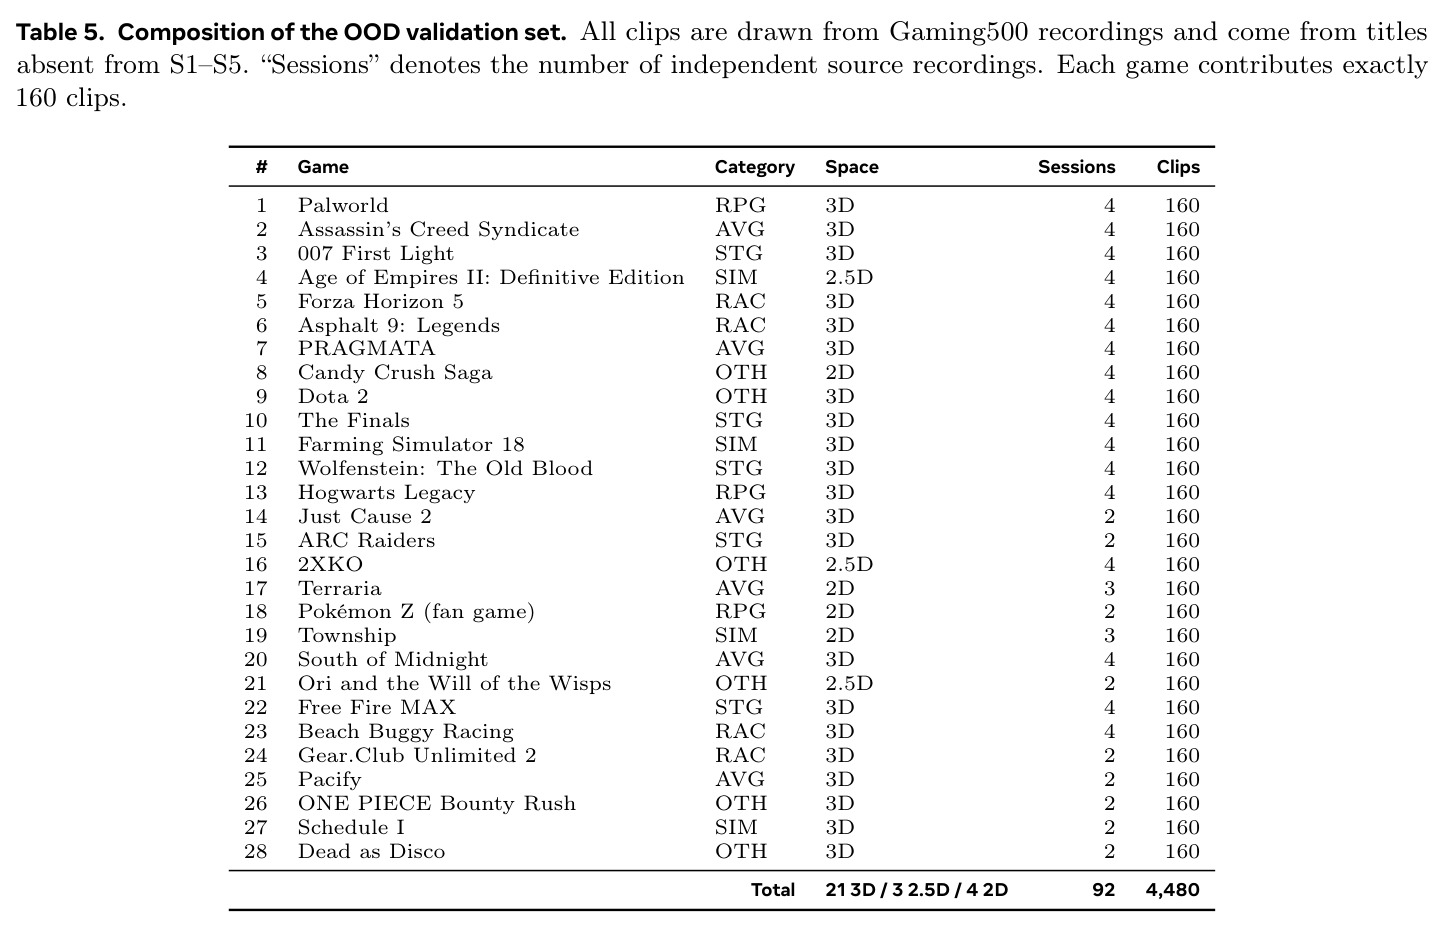
第一步数据构建:从 VPT/D2E/OpenP2P 采样轨迹,鼠标坐标归一化、5Hz 采样观测、切 20 轮窗口(步长 10),动作统一为六子步格式,空闲窗口降采样;固定 124 条非 Minecraft 源流,S2–S4 取嵌套子集、S5 剔除 Minecraft,实测 Minecraft 份额 100%/51.4%/27.1%/2.8%/0%。第二步稀疏推理标注:GPT-5.6-Luna 以玩家视角回溯生成约 65 token 的短解释,注入 5.4–6.0% 的助手轮次且各混合密度一致,动作标签不变。第三步训练:20 条 WSD 干线(4 规模×5 混合),短预算检查点从干线早期分支退火,共 120 个条件;bf16 AdamW,批 2,359,296 token,854×480,种子 3407。第四步评估:三级验证集(VPT 测试划分/游戏均衡留出片段/Gaming500 中 28 款未训练游戏 4,480 段)加四个基准:MCU(30 任务×5 次)、ViZDoom(4 图×10 次)、OGA(7 游戏×10 次)、GameWorld(170 任务×1 次),统一键鼠适配器,前沿模型同协议自测。第五步拟合:Huber 对数残差 + L-BFGS-B 多初始化,附留出预测与 bootstrap 分析。
技术新颖性
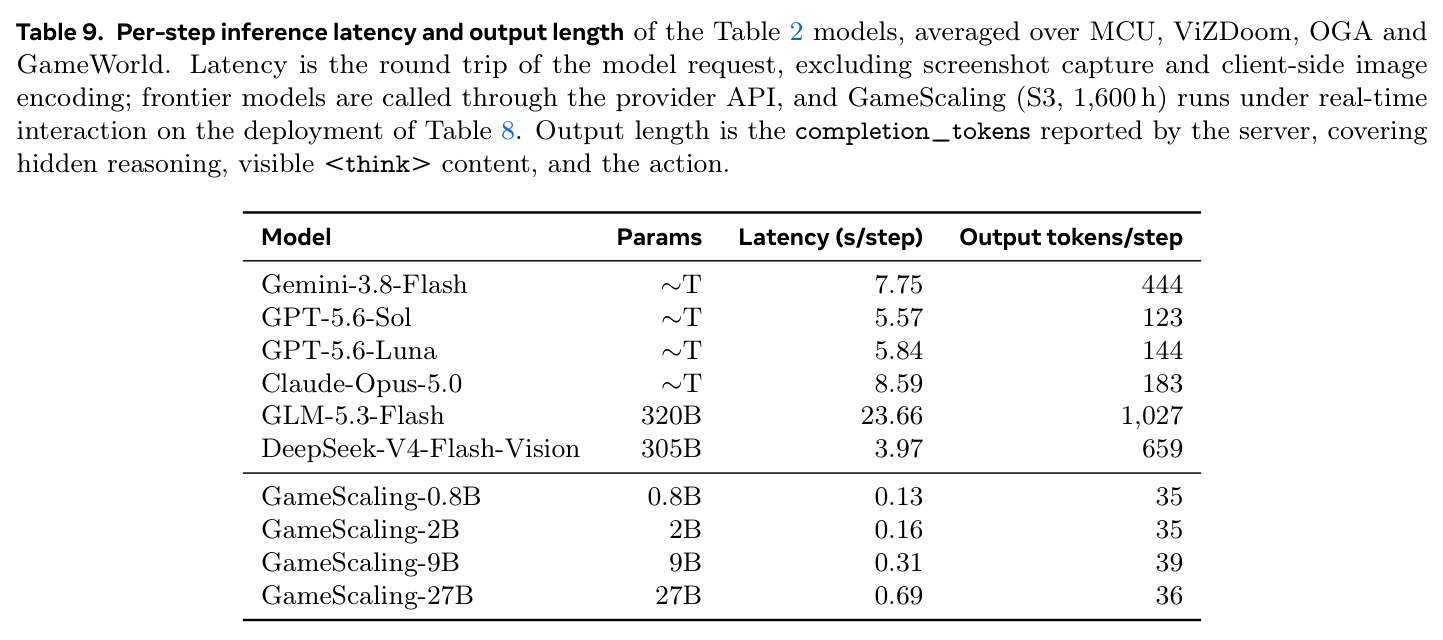
新颖性有四点。其一,规模与控制:这是迄今最大的受控虚拟具身 CPT 研究(120 条件、0.8B–27B、50–1600 小时、五种混合,总计 $2.2\times10^{22}$ FLOPs);对比的 GUI 研究(ScaleCUA 等)通常只动模型与数据混合,机器人研究多固定模型只动数据,缺少同等的因子网格。其二,定律形式:首次把“世界占比”作为缩放定律变量并允许 $\rho=0$ 的有限地板,且用负对照验证形式不会被过拟合制造假数据项——OOD 损失本随训练上升,拟合后 $\beta$ 精确趋于 0,说明定律忠实于数据。其三,现象学发现:命名并刻画了接口阶段/世界阶段的两相动力学,解释了为什么早期数据带来跨世界普遍收益而后期收益局部化。其四,评估维度:提出实时 vs 暂停两种协议,指出前沿模型约 90% 的实时分数损失来自推理延迟与冗长思考(每步 123–1,027 token、4.0–23.7 秒,而 GameScaling 仅 35–39 token、0.13–0.69 秒),这是此前游戏评估普遍忽视的维度。
实验结果
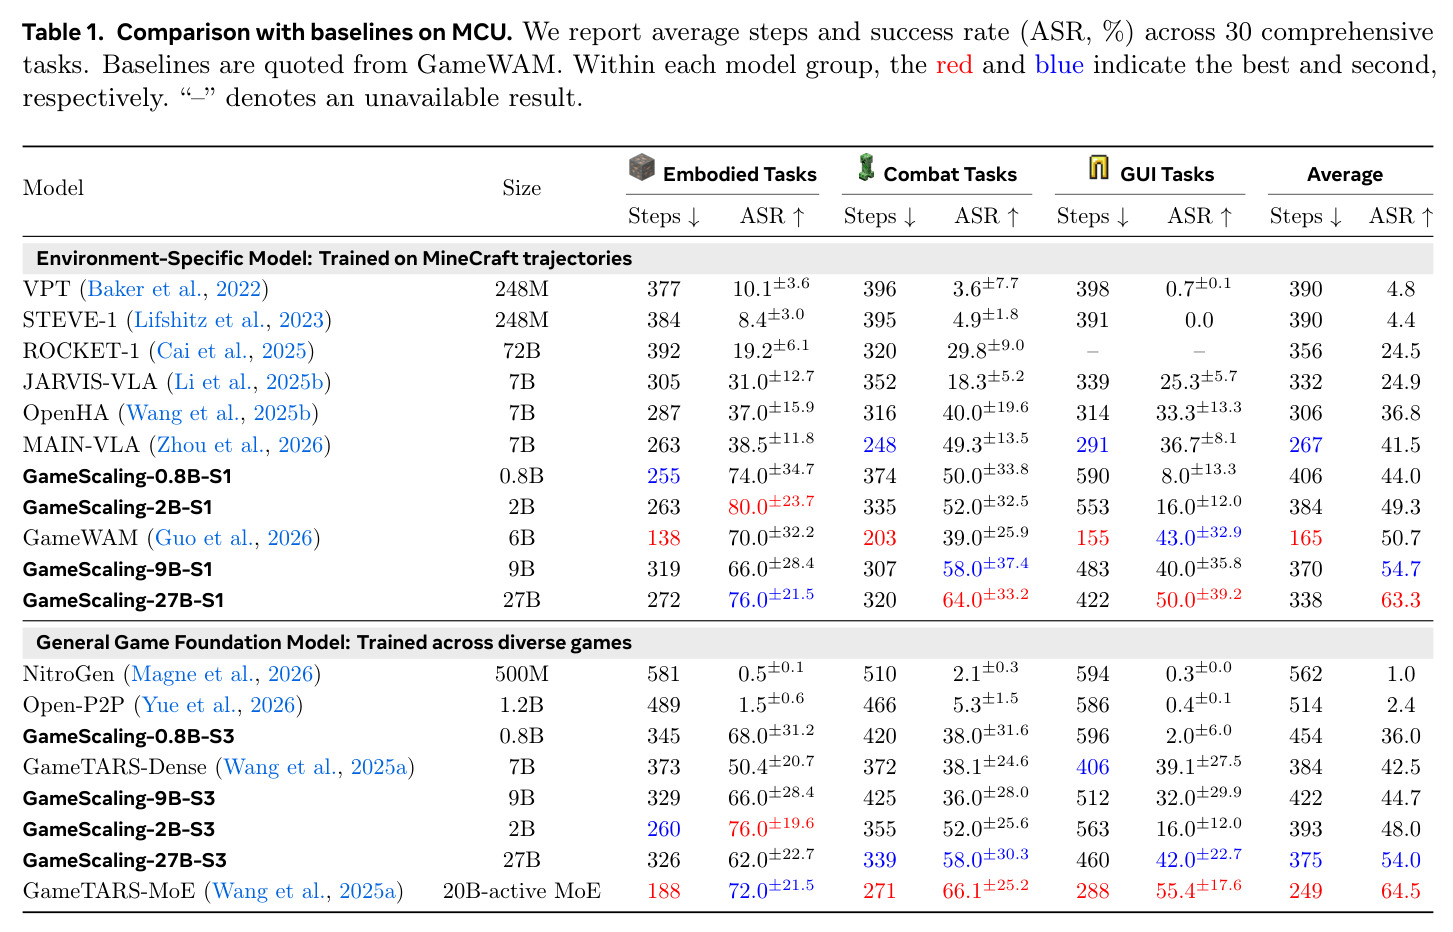
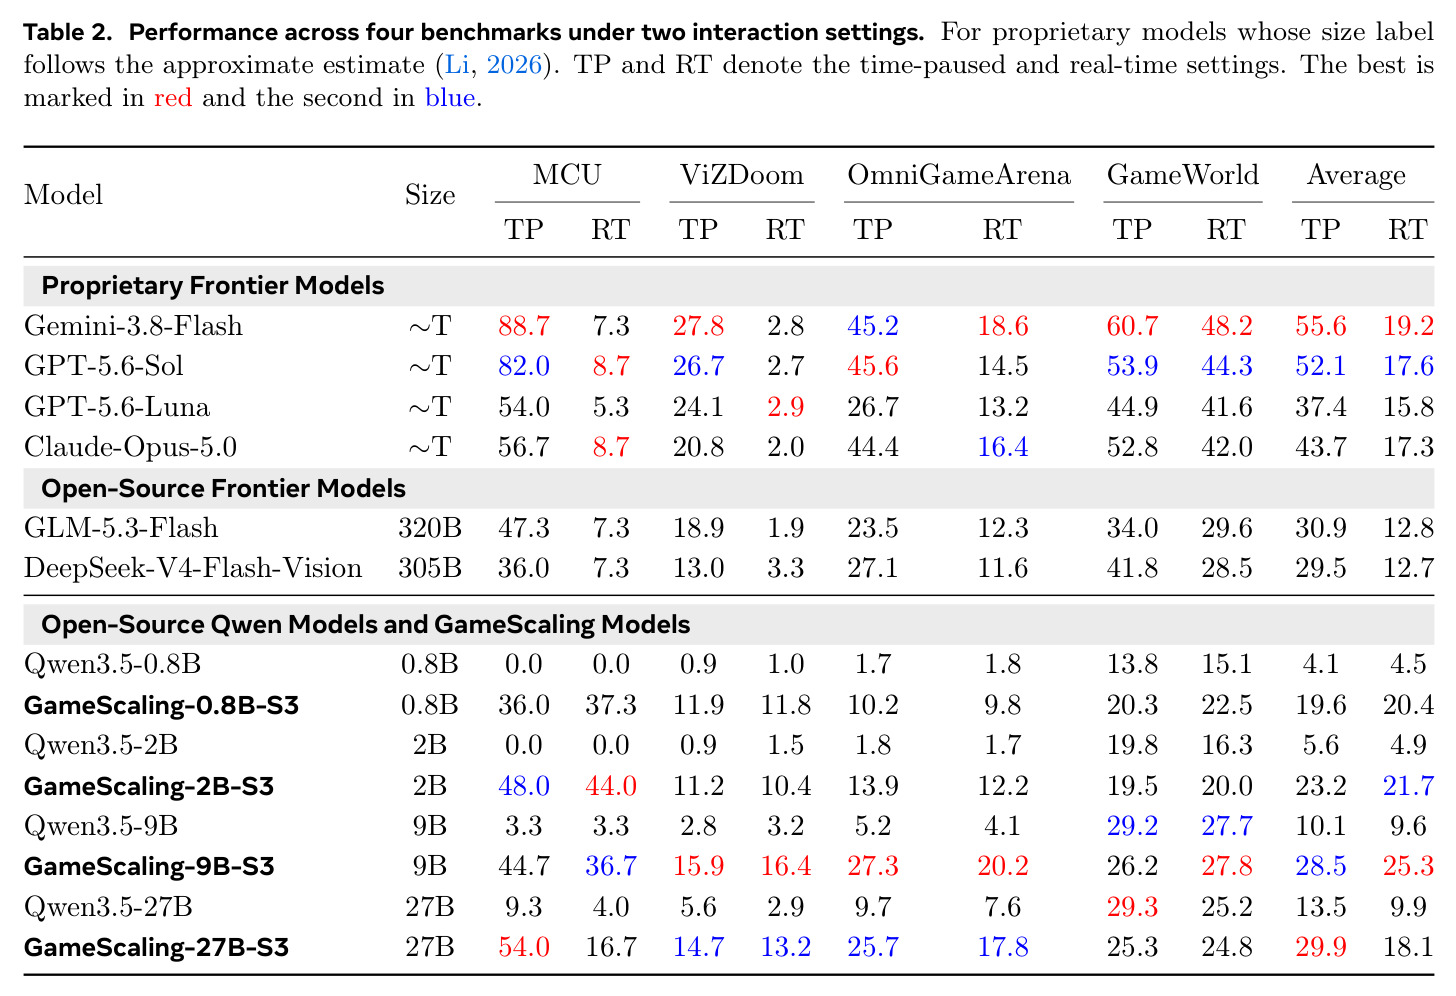
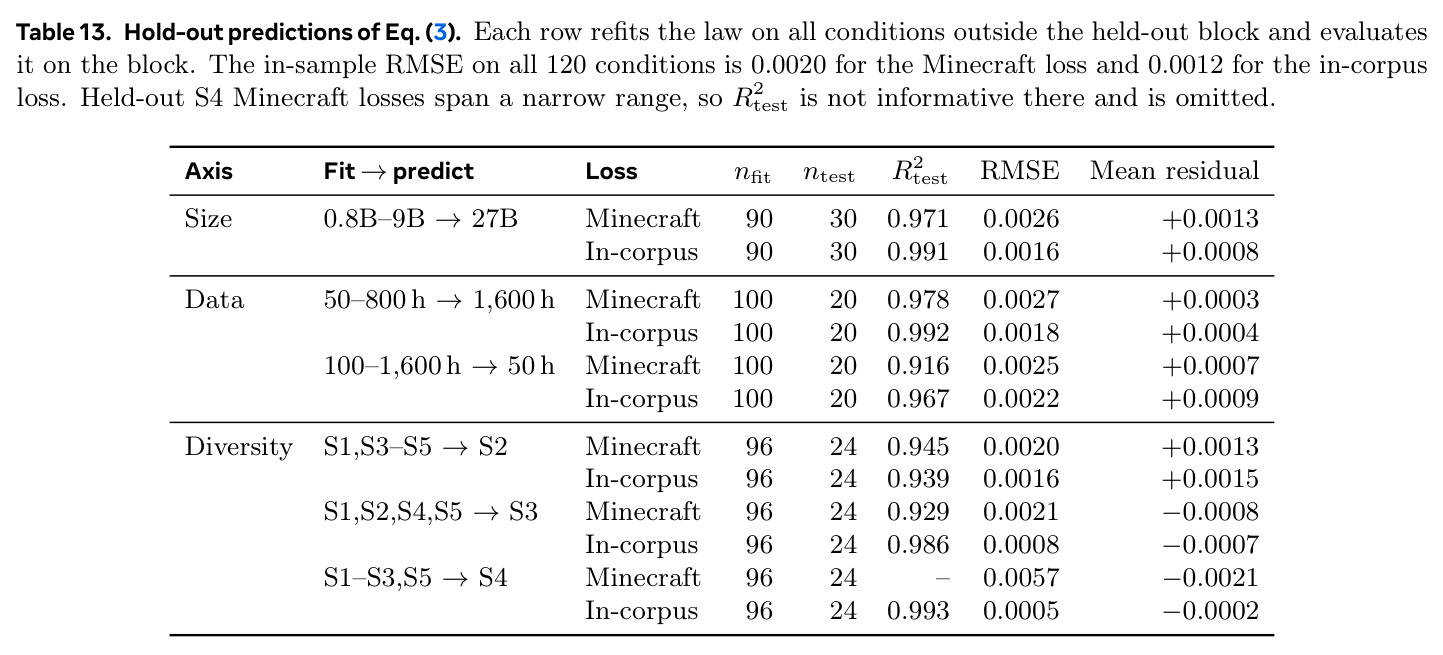
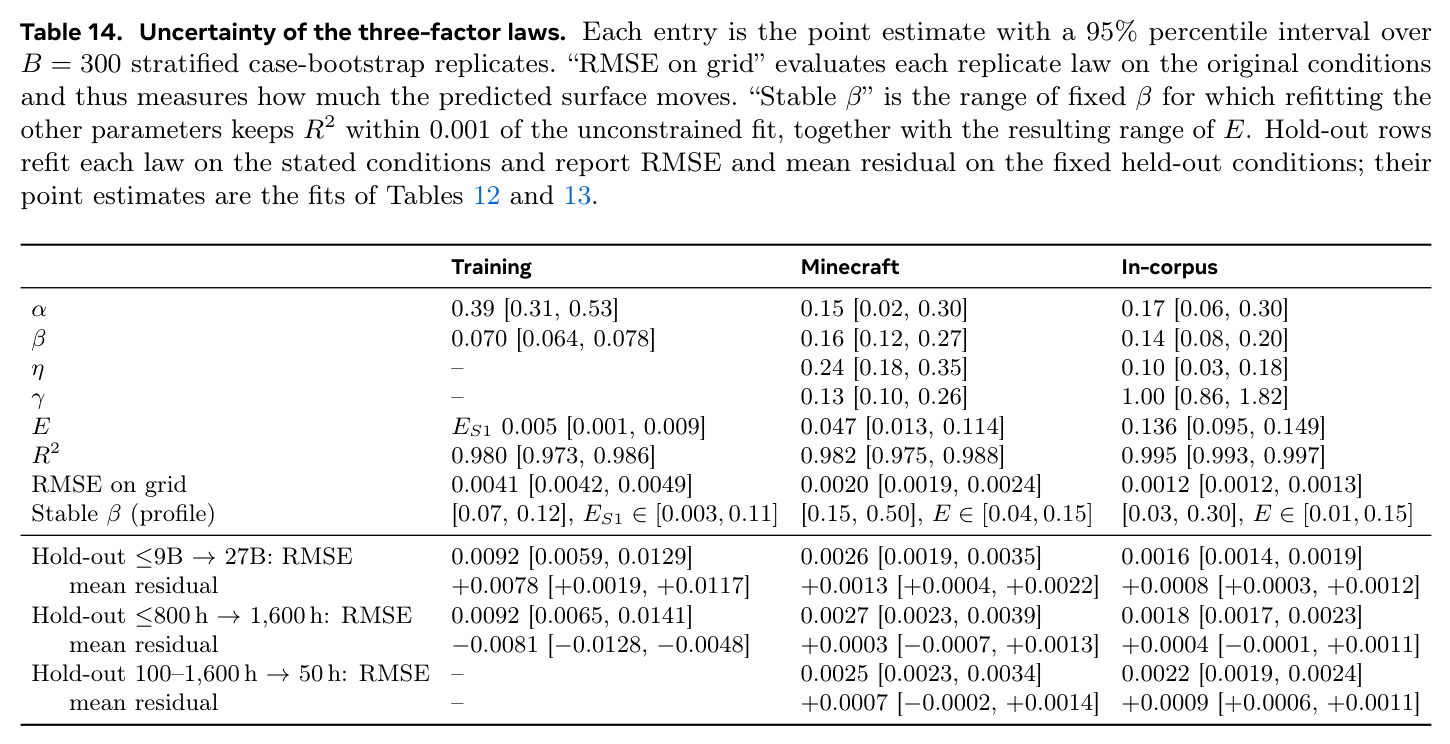
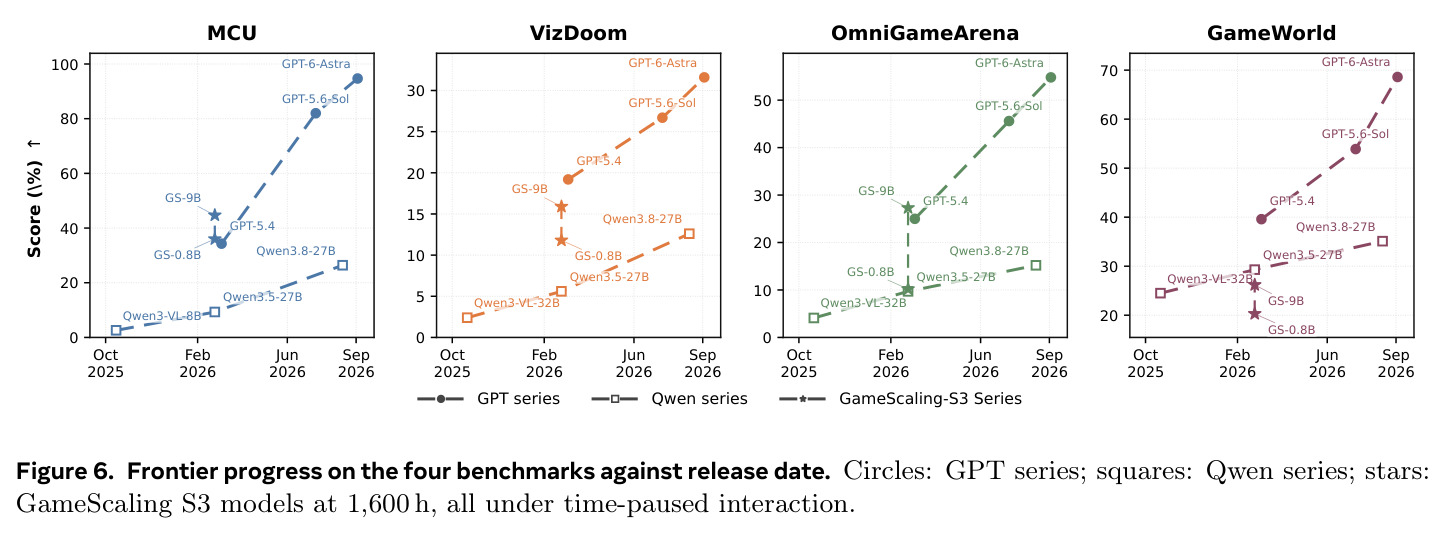
数据缩放:仅 50 小时训练后所有配置的三级验证损失即低于基座;50→1600 小时,S1–S3 下 Minecraft 验证损失平均再降约 10.4%,MCU 随之大涨;但 27B 在 GameWorld 上随数据量增加全面退化。多样性缩放:Minecraft 损失 S1 最低、语料内损失 S3/S4 最低;1600 小时时 S2–S5 的 OGA 平均分约为 S1 的 2.8 倍;0% Minecraft 的 S5 仍把 Minecraft 损失压到基座之下;27B-S1 在 1600 小时于全部三个非 Minecraft 基准低于基座,GameWorld 最多掉约 17 分。模型缩放:50 小时的大模型可胜过 1600 小时的小模型(等效 32 倍数据节省),但 9B 后收益递减,GUI 任务成功率从 0.8B 到 27B 增长约 6 倍。缩放定律:训练/Minecraft/语料内损失拟合 $R^2=0.980/0.982/0.995$,留出预测 RMSE≤0.0027;OOD 损失不服从数据缩放定律(β≈0)。对外对比:27B-S1 在 MCU 达 63.3% 平均成功率、超最佳专用模型约 13 分;0.8B-S3 的 36% 对比 NitroGen 1.0%;CPT 使 27B 的 MCU 提升 5.8 倍;实时协议下 9B-S3 四基准平均 25.3 超最佳前沿的 19.2,前沿实时衰减约 90% 而本文 0.8B–9B 保留 88%;GameWorld 上前沿仍领先约 2 倍。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Minecraft MCU(30 项长程任务:导航/生存/战斗/GUI) | 平均成功率 ASR (%) | GameScaling-27B-S1:63.3% | 最佳专用模型 GameWAM(6B)50.7%;最佳通用模型 GameTARS-MoE 64.5% | 较最佳专用模型 +12.6 分(论文表述约 13 分);0.8B-S1(44.0%)已超 7B 专用模型 OpenHA(36.8%) |
| MCU 指令条件任务:语言主干 vs 大规模行为克隆 | ASR (%) | GameScaling-0.8B-S3:36.0% | NitroGen(500M)1.0%;Open-P2P(1.2B)2.4% | +34 分:语言基座能力比行为克隆数据规模更关键 |
| 未见相关 3D 世界 OmniGameArena(1600 小时检查点) | 平均得分 (%) | S2–S5 混合平均约为 S1 的 2.8 倍;27B-S3 冻结推理 25.7(基座 9.7) | Minecraft-only S1;基座 Qwen3.5-27B 9.7 | 多样性收益约 2.8×;CPT 使 27B 提升约 2.6×,9B/27B 匹敌约 300B 开源模型 |
| 四基准实时(real-time)交互平均 | 四基准平均分 | GameScaling-9B-S3:25.3 | 最佳前沿模型 Gemini-3.8-Flash:19.2(GPT-5.6-Sol 17.6、Claude-Opus-5.0 17.3) | +6.1 分;部分单项较前沿模型最高约 5× |
| MCU/ViZDoom 实时 vs 冻结推理衰减 | 实时得分相对冻结推理得分 | 0.8B–9B 保留约 88% | 前沿模型衰减约 90%(如 27B-S3 MCU 54.0→16.7) | 根本差异在延迟:0.13–0.69 秒/步 vs 4.0–23.7 秒/步 |
| 远距世界 GameWorld(170 任务/34 环境,多为 2D/2.5D) | 冻结推理平均得分 (%) | 27B-S3:25.3,比基座 29.3 反而低 4.0 分 | Gemini-3.8-Flash 60.7(约为本文最佳的 2 倍以上) | CPT 仅在 0.8B/2B 带来提升,远距迁移是通用性主要瓶颈 |
| ViZDoom(4 张 skill-1 地图) | 平均分(每图分数/100 后取均值) | 9B-S3 冻结推理 15.9(基座 2.8) | 基座 Qwen3.5-9B 2.8;前沿模型实时仅 1.9–3.3 | 约 5.7×;DOOM 本体数据不足 2% 仍提升,验证第一人称技能跨游戏迁移 |
| 三因素缩放定律拟合 | R² / RMSE | 训练 0.980/0.0041;Minecraft 0.982/0.0020;语料内 0.995/0.0012 | 受限 Chinchilla(D=T,S1–S3)R²=0.925;分类偏移模型 RMSE 0.0044/0.0035 | 同参数量下拟合更好、且能外推到未见混合与预算 |
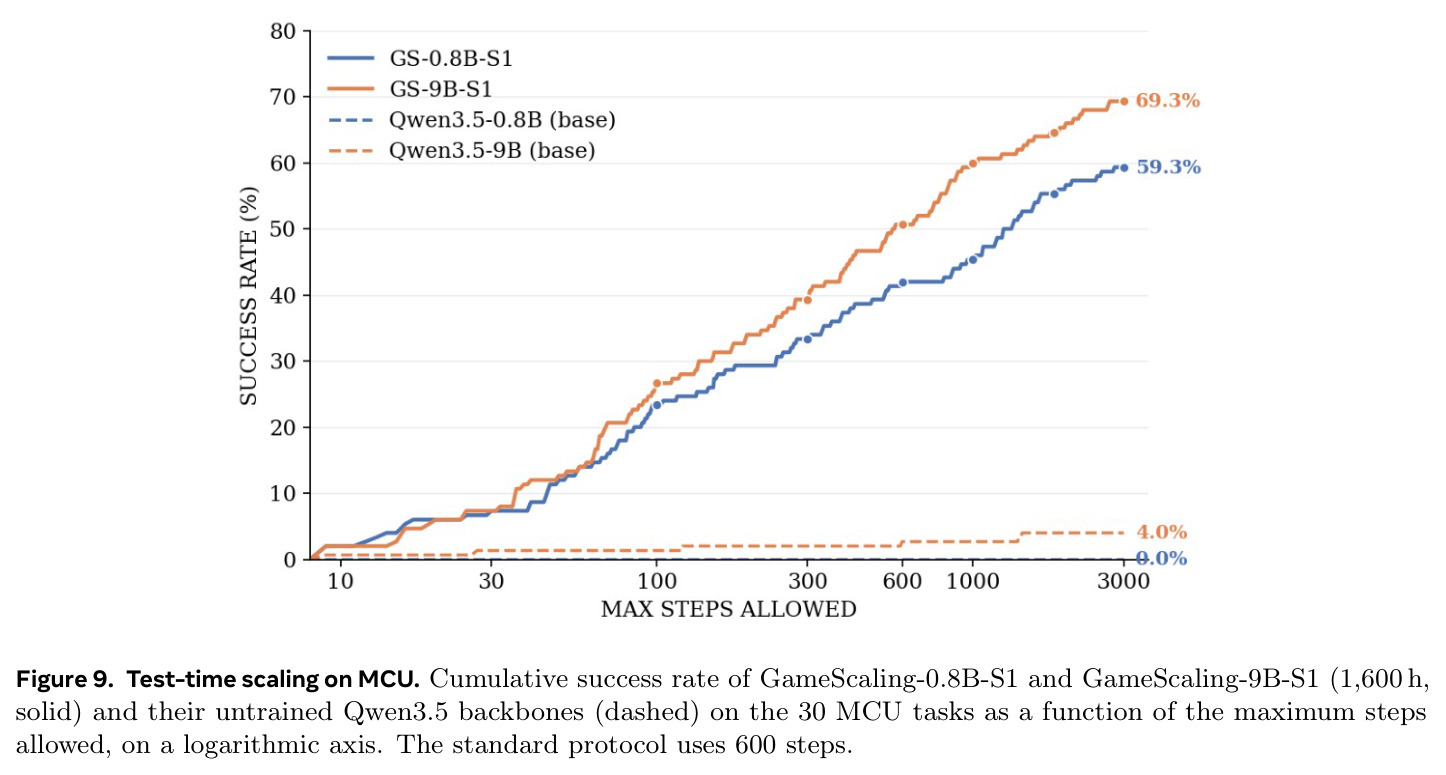
| MCU 测试时缩放(步数上限 600→3000) | 累计成功率 (%) | 0.8B-S1:42→59.3;9B-S1:51→69.3(对数线性) | 基座 Qwen3.5-9B:2→4.0;0.8B 恒为 0 | 更多交互步数只对已具备行动能力的模型有效 |
局限与改进
作者承认的局限:整个网格只用一个训练种子(seed 3407),无法估计种子间方差;多样性轴只改变配比而不改变世界数量(S2–S4 含完全相同的 80 个游戏),因此无法回答“该加新游戏还是调配比”;Table 1 的旧基线为引用数字,主干、接口与评测器均未对齐,只能作参考;语料内验证集含 3.2% 的 Minecraft 切片需近似修正;缩放定律是经验描述而非从学习理论导出,α 只能给出约 0.2 的量级判断(bootstrap 区间 0.02–0.30),β 与 E 存在脊线、渐近下界无法由该网格确定。我的补充观察:远距世界的结论完全建立在 GameWorld 的 170 个 2D/2.5D 任务(含 2048、Sokoban、猜词)上,这些任务可能更依赖符号推理而非键鼠技巧,“CPT 无益远距世界”可能与基准选择混淆;实时对比中前沿模型走提供商 API,GameScaling 用本地 H200+vLLM,虽有硬件辩护但网络延迟与各家不同的推理努力设置(medium/high/max)仍是混杂因素;27B 在大预算下多基准退化的机制(过拟合、灾难性遗忘或分布漂移)未被解释;数据预算只到 1600 小时,定律外推仅验证约一个数量级翻倍。
独立分析的弱点
第一,模仿学习天花板:CPT 是纯行为克隆,没有任务成败的环境反馈,作者也承认这可能是远距世界差距的根源;改进方向是在 Minecraft/OGA 等可自动判分的环境中接入在线强化学习,把 CPT 模型当作 RL 的初始化。第二,数据配比选择是被动的:结论只说“匹配目标域”,但无法在训练前预测新混合的效果;改进方向是用世界的视觉/动力学/控制嵌入距离构造可优化的配比目标,或做先接口后世界的两阶段课程投喂。第三,稀疏推理标注依赖 GPT-5.6-Luna,质量不可控且仅覆盖 5–6% 轮次,推理密度对实时成绩的影响没有消融;改进方向是自举式标注(用自身 rollout 的成功轨迹生成 rationale)并系统消融推理密度。第四,缩放定律对 OOD 损失失效,说明定律缺少“通用能力”维度,可尝试引入世界多样性熵 $D$ 或接口覆盖度作为额外协变量。第五,评测精度:GameWorld 每任务只跑 1 次、MCU 实时仅 3 分钟,方差可能较大;前沿模型的推理努力设置不统一。第六,200ms 动作块对 2D 平台跳跃等高精度离散操作可能粒度过粗,值得按世界节奏自适应调整动作块长度。
未来方向
作者明确提出三个方向:进一步缩放世界多样性(加入新游戏而非仅调配比,因成本留作未来工作);在实际游玩中引入在线反馈(RL);以及两者结合。附录 C.1 还显示前沿基座的代际进步(GPT/Qwen 系列)可超过游戏 CPT 在固定主干上的收益,因此提升主干本身仍是重要路线。基于本文成果可延伸:(1) 把三因素定律用于数据配比规划——给定目标世界集合与算力预算,反解最优 $\rho$ 与 $N/T$ 分配,类似 Chinchilla 最优配比的计算;(2) 接口阶段显式课程化——先用低成本数据教会键鼠接口再上目标世界数据,检验能否放大 50 小时前的普遍收益;(3) CPT+RL 的标准流水线,把本文模型作为可泛化初始化;(4) 实时系统联合设计——对齐 200ms 动作节拍的推理预算控制、投机解码或小模型草稿(论文显示延迟超过 0.5 秒性能劣化超 5 倍);(5) 把三级评估距离协议与实时/暂停双协议推广为社区评测标准;(6) 测试时缩放与模型规模的联合研究——Figure 9 显示步数预算的对数线性收益与模型大小几乎无关,可探索自适应步预算策略。
复现评估
开源情况良好:模型权重在 HuggingFace(THUSI-Lab/GameScaling),代码在 GitHub(THUSI-Lab/GameScaling),项目页 gamescaling.github.io;附录给出完整超参(bf16 AdamW、β1=0.9/β2=0.95、wd 0.01、批 2,359,296 token、WSD 3%/87.3%/9.7%、学习率 LM 1e-5/ViT 7e-6、854×480、种子 3407)、120 条件矩阵、评分公式与延迟测量细节。数据全部来自公开源(VPT/D2E/OpenP2P 与公开视觉-语言数据),但稀疏推理标注需要 GPT-5.6-Luna API 费用。算力是主要门槛:复现完整 120 条件网格约需 45,000 H200 GPU 小时,只有大厂可行;不过单条干线(一个规模×一个混合到 1600 小时)约为总量的 1/20,对关键结论做消融型复现是现实的。评估需要 MCU/ViZDoom/OGA/GameWorld 四套环境,其中 OGA 需 UE5 且每实例独占 GPU。综合判断:协议透明度极高,复现单个模型难度中等,完整复现整个研究难度很高。
论文图表
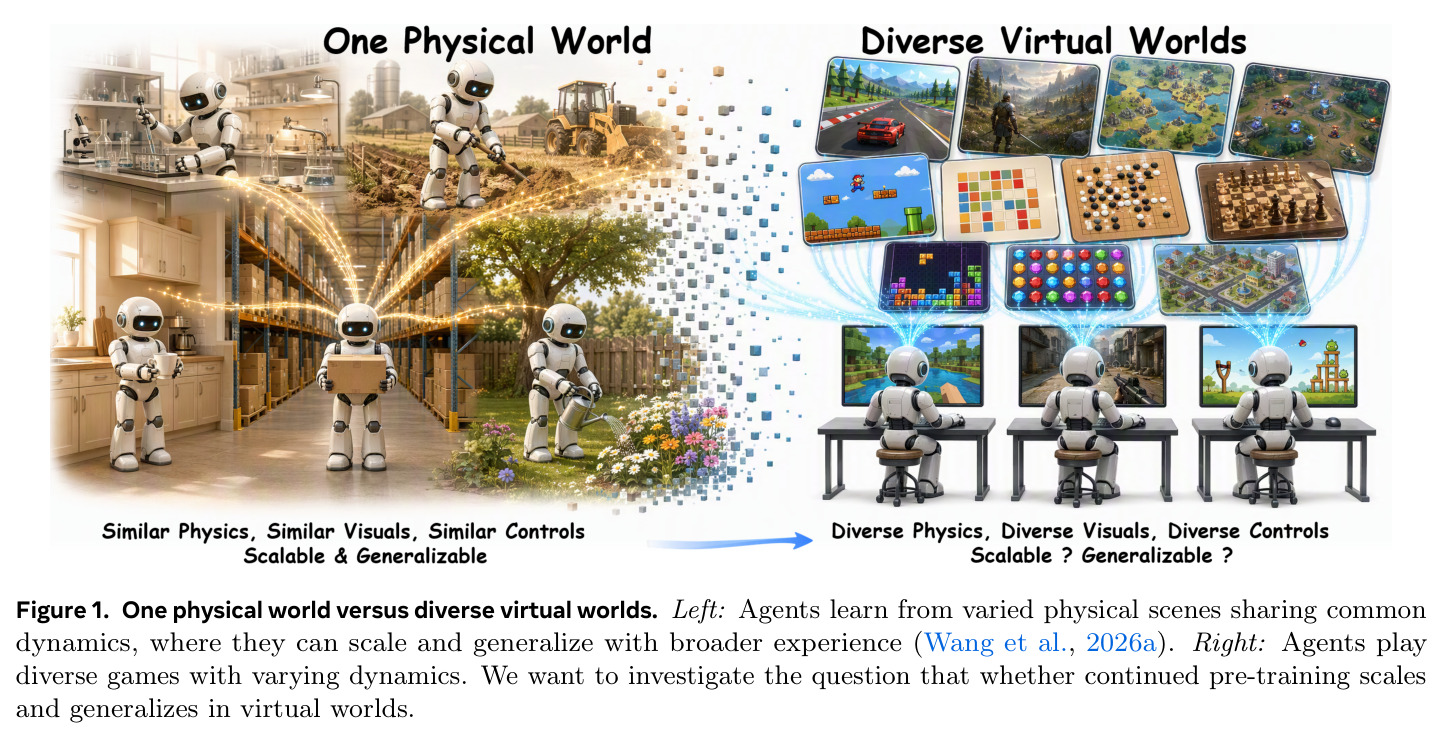
左:物理具身学习中多样场景共享同一物理动力学,经验可跨场景复用并随数据扩展;右:智能体面对画风、动力学、控制与目标各异的多款游戏。文章借此提出核心问题:持续预训练在虚拟世界是否仍能随数据缩放并泛化。
一张图讲清论文动机——物理世界的“共享结构”假设在游戏中失效,这是整个研究设计的出发点。