ProVe:提议者-验证者解码 ProVe: Proposer-Verifier Decoding
反转投机解码角色:大模型一次提议16个token,一次额外前向验证后按前缀提交
前置知识
自回归(AR)解码
大语言模型逐 token 生成的标准方式:每生成一个 token 都要对整个模型做一次前向传播,生成 N 个 token 就需要 N 次串行前向。单请求解码时瓶颈在显存带宽而非算力,GPU 利用率很低,这正是各类推理加速方法的攻击目标。本文所有加速倍数都以微调后 32B 模型的贪心 AR 解码为参照(约 69-70 tok/s)。
ProVe 要加速的对象就是 AR 解码的串行性,理解其成本结构才能看懂 2.5× 等加速数字从何而来。
投机解码(Speculative Decoding)
Leviathan 与 Chen 等人 2023 年提出的加速框架:小草稿模型串行起草 k 个 token(花 k 次廉价前向),大目标模型用一次前向并行打分验证,从左到右保留到第一个不一致的 token。只要草稿接近目标分布,就能在保持输出分布不变的前提下加速。每周期成本为 $1+k\rho$,其中 $\rho$ 是小模型与大模型单次前向的成本比,串行起草是它的软肋。
ProVe 的卖点是把这套「小起草、大验证」的分工整个反转过来,读者需要先知道原方向长什么样、成本卡在哪。
块提议模型与 MARS
MARS(Jin et al., 2026)把普通 AR 模型微调成「块提议者」:在上下文后拼接 B 个 [MASK] 占位符,一次因果前向就能同时产出未来 B 个 token 的分布。位置 1 的预测与普通 AR 的下一个 token 完全一致,位置越深、被占位符替换的中间 token 越多、预测越难,质量随之衰减。关键是不引入独立的草稿网络或预测头,块预测和普通 AR 共用同一个 transformer 和输出头。
ProVe 完全复用 MARS 训出的提议者,只改提交规则;MARS 既是本文的组件基础,又是隔离「验证价值」的对照基线。
Teacher forcing(教师强制)
验证候选序列的标准技巧:把整段候选 token 拼在上下文后面一次性喂入模型,一次前向即可并行得到每个位置的条件概率 $q_i = P_V(y_i \mid x_{\le t}, y_1, \dots, y_{i-1})$,无需逐 token 生成。投机解码对大目标模型的验证、ProVe 对小验证器的调用都用这种方式,因此验证成本恒为一次前向,与块长 B 无关。
这是「验证一遍只花一次前向」的技术前提,ProVe 的每周期成本公式 $1+\rho$ 完全建立在它之上。
AUC(ROC 曲线下面积)
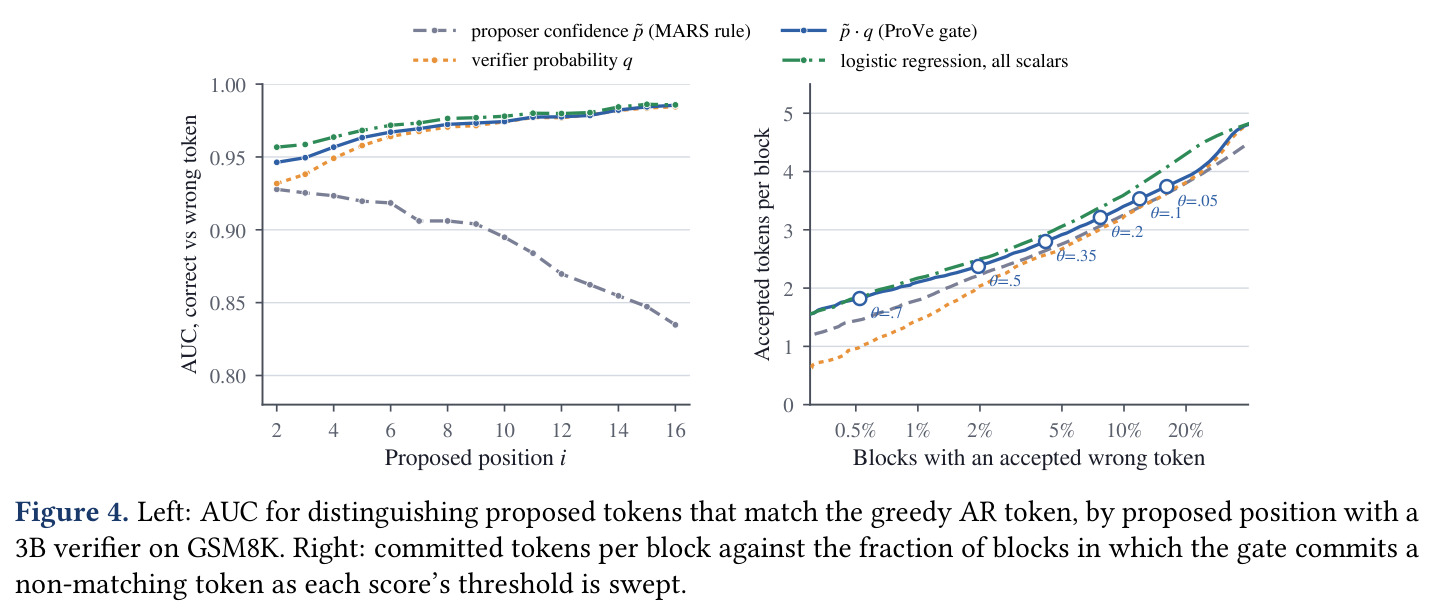
衡量一个分数区分正负样本能力的指标:随机取一个正样本和一个负样本,AUC 是正样本得分更高的概率,0.5 等于随机猜测、1.0 为完美区分。论文用它量化提议者置信度 $\tilde p_i$、验证概率 $q_i$ 及二者乘积对「提议 token 是否匹配贪心 AR 输出」的判别力,分别得到 0.910、0.960、0.964。
论文用 AUC 论证「多花一次验证前向是值得的」,这是理解 Figure 4 和门控分数设计的关键证据。
研究动机
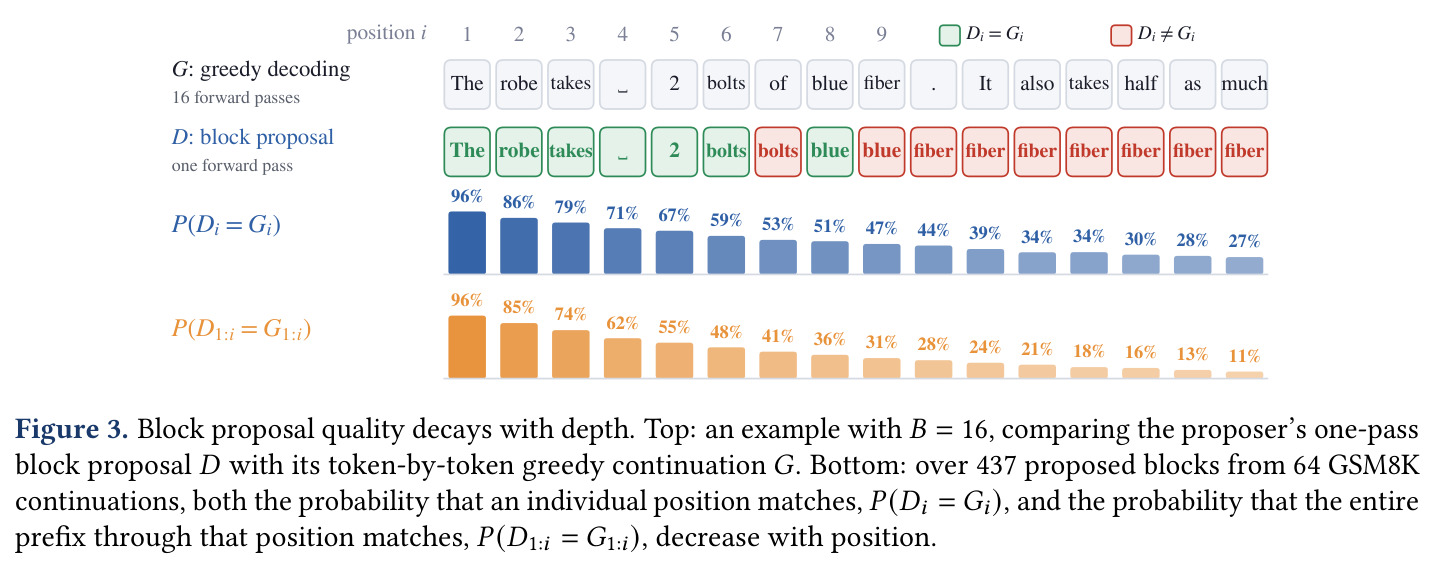
主流加速方案投机解码的角色分工被成本锁死:起草是串行的,k 个 token 要花小模型 k 次前向,所以草稿模型必须远小于目标模型才划算,而这又限制了草稿质量;验证一次即可,于是交给昂贵的大模型。另一条线上,MARS 等方法已能让大模型一次前向预测 B 个未来 token,提议不再是串行链条,但 MARS 的提交规则只依赖提议者自己的占位符置信度(阈值 $\tau=0.95$)。论文在 GSM8K 上量化了这个盲区:提议块平均有 6.6 个 token 与贪心 AR 续写匹配,置信度规则却平均只提交 3.0 个,近一半可用内容被白白丢弃;降低阈值虽能多提交,但提交与贪心 AR 不一致 token 的比例随之上升(Figure 4 右的阈值扫描),说明免费置信度信号本身无法恢复这些被浪费的前缀。
本文的目标是论文的核心问题是:当大模型已经能一次产出 B=16 个候选 token 后,「多花一次前向去验证这个实际生成的块」到底值不值?目标分三个层次。其一,无损档:让提议者自己验证自己的块,严格逐 token 复现提议者的贪心 AR 输出,同时把六基准平均吞吐提到约 2.5×,且不训练任何独立草稿头,对标专门训练的 EAGLE-3。其二,有损档:用 3B/7B 小模型做验证器,通过阈值 $\theta$ 提供可控的速度-精度旋钮,以 -0.3 到 -2.6 分的精度代价换 2.3×-2.7× 吞吐。其三,成本上验证器每周期只调用一次($1+\rho$),要在同一小模型下明显快过串行起草的投机解码($1+k\rho$,实测仅 1.63×)。
与已有工作不同的是,切入点是一次视角反转。从 EAGLE-3 到 ReDrafter、DFlash,几乎所有工作都在沿「小模型起草、大模型验证」的方向优化草稿头与树搜索,无人质疑角色分配本身。论文问的是:一旦大模型能一次写出整块候选,小模型为什么还要串行起草?它可以直接读这个已实现的块、一次判掉该保留多少。更深一层的洞察是两种分数回答不同的问题:提议者置信度 $\tilde p_i$ 是中间未来 token 尚未实例化时给出的「先验」,验证概率 $q_i$ 是读入实际提议前缀后的「后验」,一个 token 可能先验很高却与实际轨迹冲突。把 MARS 当对照——提议者与候选块完全不动,唯一变量是是否花这次验证前向——使「验证的价值」第一次被干净地分离并量化。
核心方法
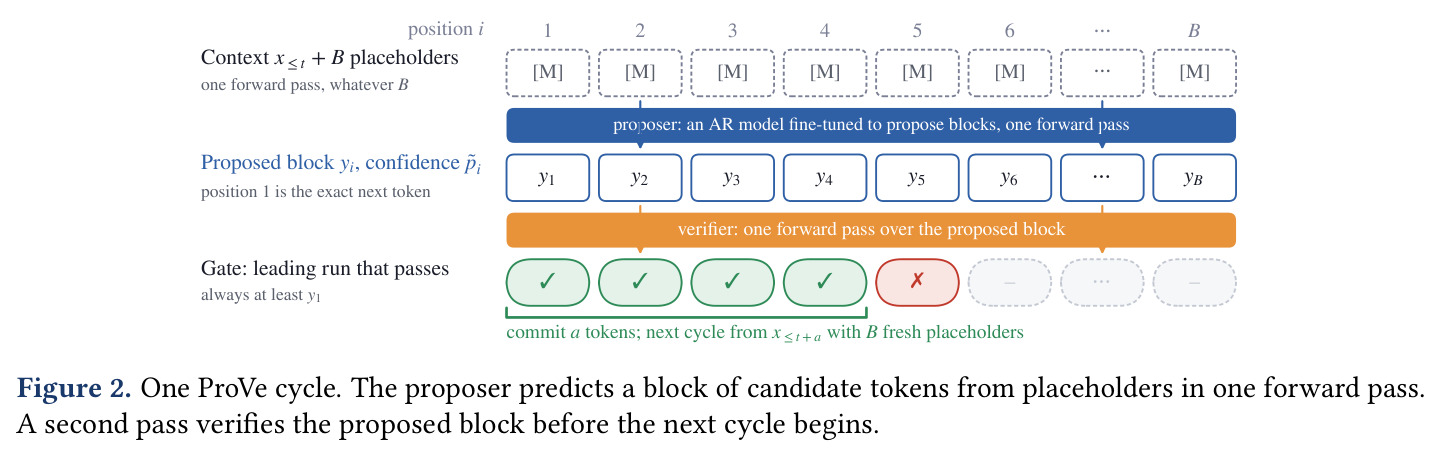
直觉类比:投机解码像实习生逐字打草稿、老板最后通篇批改;ProVe 反过来,老板(微调成块提议者的大模型)一口气写出 16 句草稿,实习生(小验证器)通读一遍、从句首开始划出可信的段落。技术路线:基于 MARS 微调的 Qwen2.5-32B-Instruct 提议者($B=16$),每个解码周期固定两次前向。第一步,上下文接 B 个 [MASK] 占位符做一次因果前向,贪心读出候选块 $y_1,\dots,y_B$ 及各位置置信度 $\tilde p_i$;第二步,验证器对上下文加整块做一次 teacher-forced 前向得到 $q_i$,按乘积门控 $\tilde p_i\cdot q_i\ge\theta$ 提交最长前导前缀(首 token 恒提交,因为它是普通 AR 预测)。无损变体 ProVe-lossless 不用第二模型:把块喂回提议者做第二次前向,与贪心预测逐位比对后提交,由此逐 token 复现贪心 AR 输出。
核心创新有三层。第一是角色反转:提议需要长程预测能力所以必须大模型做,而验证在 teacher forcing 下只需判断局部合理性、小模型即可胜任,且 ProVe 每周期只调用一次小模型(成本 $1+\rho$),投机解码却要串行调用 k 次($1+k\rho$,3B 模型 $\rho\approx0.34$,五步草稿成本约 2.70)——同一个 3B 模型,做草稿只带来 1.63× 加速,做验证器帮 ProVe 达到 2.28×。第二是揭示占位符置信度的盲区:$\tilde p_i$ 看不到已实例化的提议前缀,而 $q_i$ 是轨迹条件化的,两者乘积的判别 AUC 达 0.964,显著高于单独置信度的 0.910,这解释了 GSM8K 上平均 6.6 个匹配前缀只被提交 3.0 个的浪费。第三是自验证的无损性:归纳论证保证 ProVe-lossless 提交的每个 token 都落在提议者的贪心 AR 轨迹上,无需阈值、第二模型或草稿头,每周期恰好两次提议者前向。
方法步骤详情
完整流程按周期循环。步骤一(提议):输入为当前上下文 $x_{\le t}$ 加 B=16 个 [MASK] 占位符,提议者一次因果前向输出 16 个分布,贪心读出候选块 $y_1,\dots,y_{16}$ 及置信度 $\tilde p_i$,其中 $y_1$ 就是普通 AR 的下一个 token 预测。步骤二(验证):验证器 $V$ 对上下文加整块做一次 teacher-forced 前向,得到条件概率 $q_i=P_V(y_i\mid x_{\le t},y_1,\dots,y_{i-1})$。步骤三(门控提交):计算 $s_i=\tilde p_i\cdot q_i$,提交最长的前导连续前缀 a,要求位置 2 到 a 都满足 $s_i\ge\theta$;ProVe 取 $\theta\in\{0.10,0.05,0.01\}$。无损变体:把候选块作为普通 token 喂回提议者做第二次前向,得到各前缀后的贪心预测,从左到右比对,首个不一致处提交该贪心预测并结束周期;整块全匹配则再提交块后的下一个贪心 token。步骤四:从扩展后的上下文开始下一周期。训练分两阶段:先 1 epoch 普通 AR SFT(兼作对照组),再 1 epoch 块预测训练(在占位符污染的回复上加块预测目标),共用同一 transformer 与输出头,无独立草稿网络。
技术新颖性
与已有工作的区别:投机解码家族(EAGLE-3 草稿头加树搜索、LayerSkip、ReDrafter、Amphista、FastEagle、DFlash 等)保持「小起草、大验证」方向且验证严格保分布;Judge Decoding 与 Big Little Decoder 放松了验证规则但没让大模型提议;PaSS、Medusa、多 token 预测、Set Block Decoding、MARS 让模型一次提议多 token,但都用模型自身置信度提交,MARS 默认 $\tau=0.95$ 平均每块只提交 3.0 个。ProVe 的新颖性在于:(a) 首次把「额外一次验证前向」当作被检验的变量,用 MARS 做干净对照,证明验证步骤不可省——同样的块和置信度下 MARS 平均 1.48×,ProVe 3B $\theta=0.10$ 达 2.28×;(b) 门控分数 $\tilde p_i\cdot q_i$ 是先验乘后验的无参数组合,AUC 0.964 与作者试过的最优手工组合相当;(c) 自验证精确性的归纳证明,使无损加速不依赖任何外部组件。
实验结果
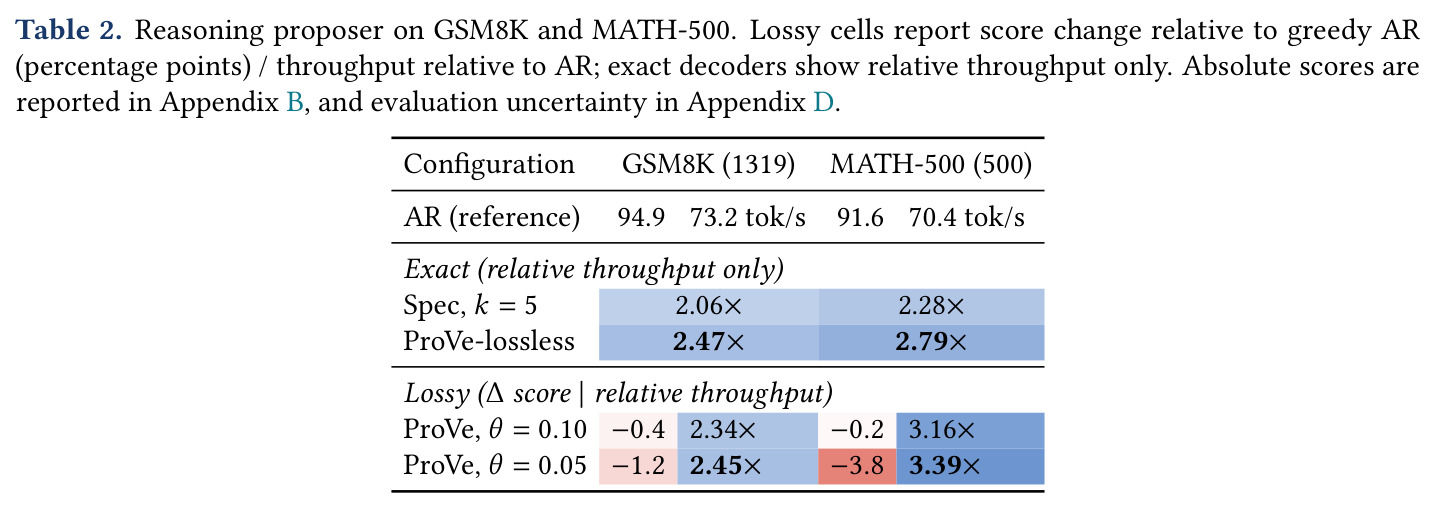
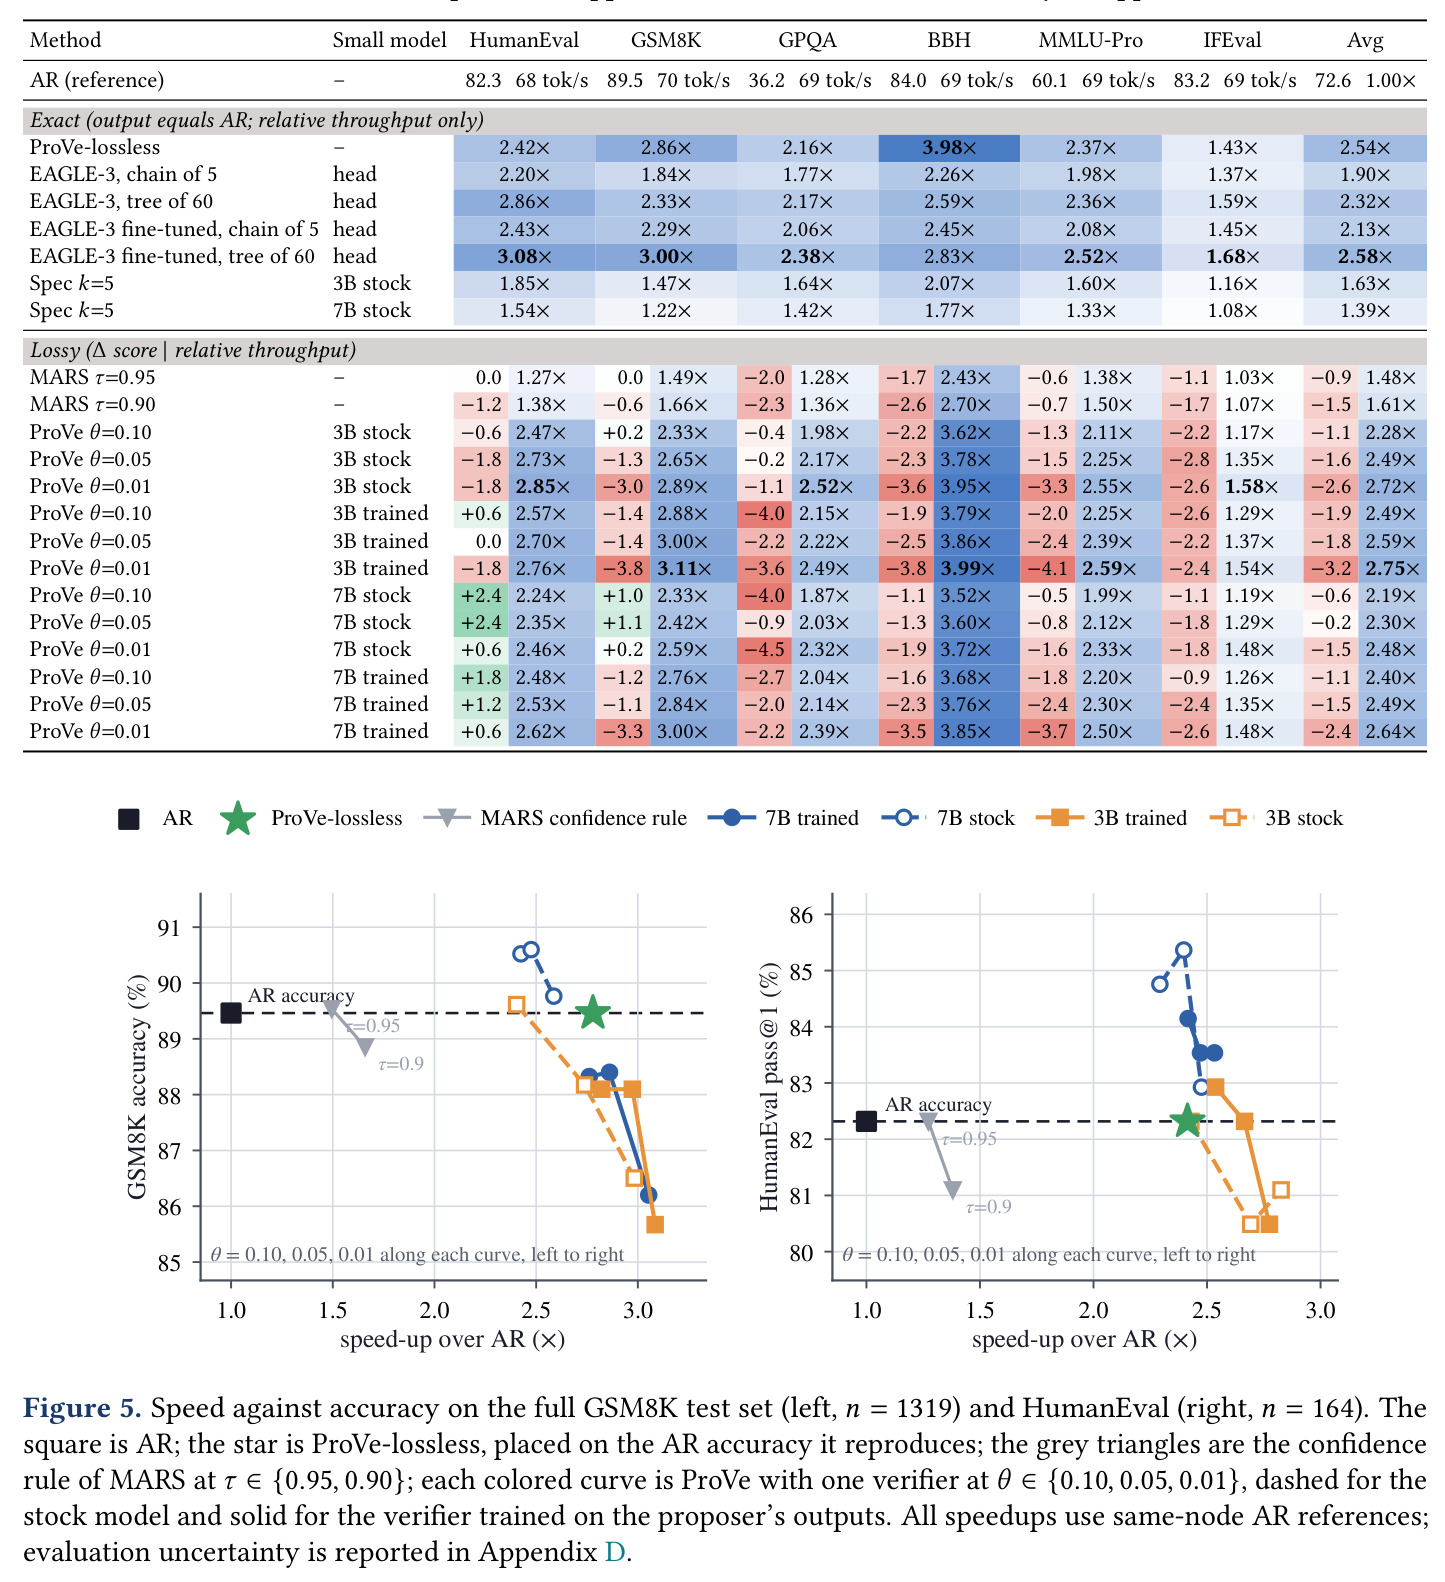
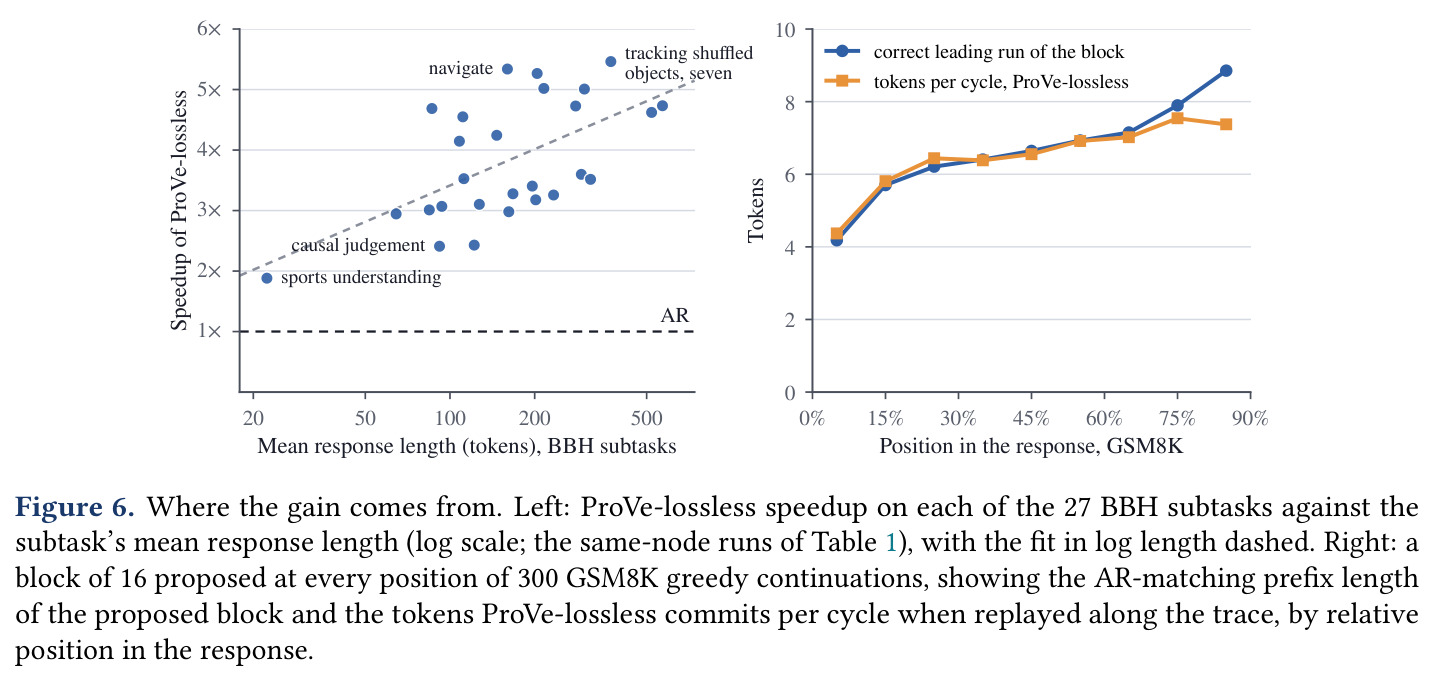
诊断实验先行:在 300 道 GSM8K 问题上沿贪心续写每步提议 B=16 的块,平均 AR 匹配前缀 6.6 个 token,而 MARS 默认规则($\tau=0.95$)只提交 3.0 个;单位置匹配率从位置 1 的 96% 衰减到位置 16 的 27%(前缀匹配降至 11%)。信号质量上,验证概率判别 AUC 0.960 高于提议置信度的 0.910,乘积达 0.964。主实验(Qwen2.5-32B-Instruct 提议者,六基准全测试集,SGLang 双卡单请求):ProVe-lossless 平均 2.54×(IFEval 1.43× 到 BBH 3.98×),优于公共 EAGLE-3 树的 2.32×,接近专门微调的 EAGLE-3 树 2.58×,且未训练草稿头;同款 3B 模型做投机解码草稿(k=5)仅 1.63×,7B 仅 1.39×,做 ProVe 验证器则分别达 2.28×($\theta=0.10$,-1.1 分)和 2.19×(-0.6 分)。有损档旋钮:7B stock $\theta=0.05$ 达 2.30×、约 -0.3 分;3B stock $\theta=0.01$ 达 2.72×、-2.6 分(GSM8K 上 2.89×、-3.0 分);微调验证器在匹配错误率下比 stock 多提交 6-10% token。推理场景(Qwen3-32B 思考模式 + 0.6B 验证器):GSM8K lossless 2.47×、$\theta=0.10$ 时 2.34×(-0.4 分);MATH-500 lossless 2.79×、$\theta=0.10$ 时 3.16×(-0.2 分),同款 0.6B 投机解码仅 2.06×/2.28×。收益机制:BBH 子任务加速与 log 回复长度相关 $r=0.59$(约 1.9× 到 5.5×),GSM8K 回复内匹配前缀从开头 4.2 涨到结尾 8.9。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六基准平均(HumanEval/GSM8K/GPQA/BBH/MMLU-Pro/IFEval) | 相对 AR 吞吐(无损方法输出不变,只报吞吐) | ProVe-lossless 2.54×(无需草稿头) | EAGLE-3 公共树 2.32×;EAGLE-3 微调树 2.58×;同款 3B 投机解码 k=5 仅 1.63× | 较公共 EAGLE-3 树 +9.5%,较投机解码 +56%,且不训练独立草稿头 |
| GSM8K(32B 指令提议者) | 吞吐倍数(精度变化,百分点) | ProVe 3B stock θ=0.01:2.89×(-3.0) | AR 89.5 分 / 70 tok/s;MARS τ=0.95:1.49×(0.0) | 较 MARS 速度 +94%,代价 -3.0 分;lossless 档 2.86× 完全无损 |
| BBH(27 个子任务) | 相对吞吐 | ProVe-lossless 3.98× | AR 1.00×;EAGLE-3 微调树 2.83× | 模板化长思维链上收益最大,超微调 EAGLE-3 约 40% |
| MATH-500(Qwen3-32B 思考模式提议者) | 相对吞吐(精度变化) | ProVe 0.6B θ=0.10:3.16×(-0.2) | 同款 0.6B 投机解码 2.28×(无损);ProVe-lossless 2.79× | 较投机解码 +39%,精度几乎无损 |
| HumanEval | pass@1 / 相对吞吐 | ProVe-lossless 2.42×(pass@1 与 AR 完全一致) | AR 82.3 pass@1 / 68 tok/s | 严格无损前提下加速 2.42× |
| IFEval(短约束输出) | 相对吞吐 | ProVe-lossless 1.43× | AR 1.00× | 六基准中最小增益,揭示方法对短输出场景的适用边界 |
局限与改进
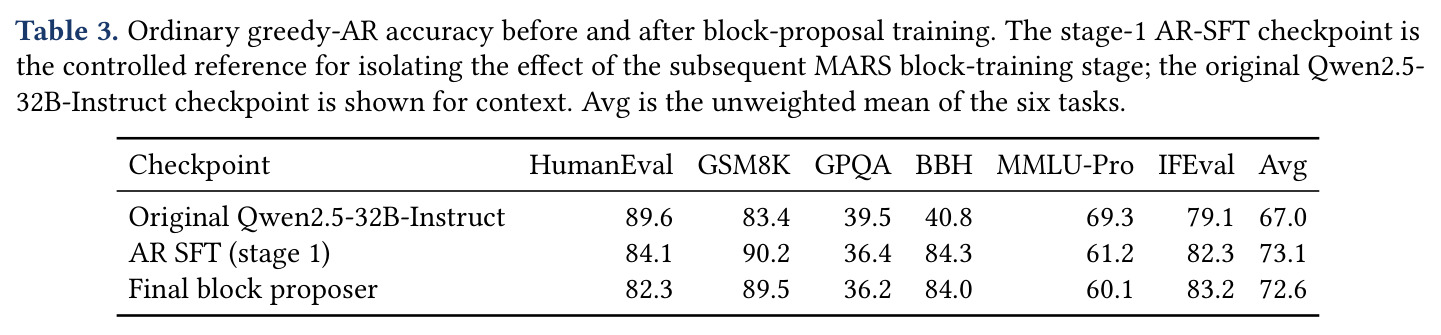
作者承认加速幅度完全由生成内容的结构决定:短约束文本 IFEval 仅 1.43×,而模板化思维链 BBH 达 3.98×,说明方法在高熵、短输出场景收益有限。有损档精度代价不均匀:GPQA 上多个配置掉 4 分以上(7B stock $\theta=0.01$ 达 -4.5),而 GSM8K、HumanEval 反而出现 +1.0 左右的波动,说明门控错误对不同任务的影响差异很大。我自己的观察:第一,lossless 每周期固定两次 32B 完整前向,平均 2.54× 略低于专门微调的 EAGLE-3 树 2.58×,短文本上劣势更明显;第二,所有评测均为单请求在飞、双卡张量并行,未报告批处理服务下验证器的调度与显存开销,生产场景收益存疑;第三,提交规则只取前导连续前缀,块中后段即使有高置信 token 也无法保留;第四,AR 参照是经过 stage-1 SFT 的微调模型而非原版权重,与社区已部署模型的差距需读者自行评估;第五,投机解码基线只扫了 k∈{3,5},未对比树化草稿等更强配置。
独立分析的弱点
独立分析几个弱点。其一,前导前缀规则浪费块内后段:深处单个低分 token 会截断其后所有本可匹配的内容(Figure 3 显示深位置仍有 27-47% 的单位置匹配率),改进方向是允许跳过单个低分 token 继续评估后续位置,或按验证分数做树状接受。其二,阈值与验证器校准耦合:微调会改变概率尺度,同一 $\theta$ 在 stock 与微调验证器上的保守程度不同(附录 C 需要在匹配错误率下对齐才能比较),改进方向是按分数分位数而非绝对值设阈值,或对验证器做温度校准。其三,lossless 成本刚性:两次完整大模型前向对短输出、低吞吐场景不友好,可借鉴 IDLM 把验证与下一块提议融合进单次前向,或用 early-exit 浅层、量化自副本降低第二遍成本。其四,块长固定 B=16 与深度衰减矛盾:位置 16 匹配率仅 27%,短回复时多数深层提议被丢弃,改进方向是根据近期匹配率动态调整 B。其五,单请求评估掩盖了服务场景问题:验证器与提议者的 KV cache 管理、连续批处理调度需要系统层面验证,建议在 vLLM/SGLang 批处理模式下重测端到端时延与吞吐。
未来方向
作者指出的方向是「块提议与验证不必遵循传统投机解码分工」,由此可延伸:一是把验证器换成同模型的 early-exit 浅层或量化副本,把 $\rho$ 压到 0.1 以下,使 ProVe 更接近 1+ε 成本;二是把乘积门控升级为轻量学习型组合(论文提到 logistic regression 与乘积表现相当,说明仍有设计空间),或联合训练验证器与提议者以直接优化提交长度;三是与树接受结合,把 ProVe 块作为 EAGLE 式树搜索的根,兼取块提议与树验证之长;四是长思维链收益最大(MATH-500 达 3.16×),可推广到 agentic 长程任务、仓库级代码补全等更长序列;五是按深度置信度自适应截断提议块或动态选择 B;六是在线学习门控阈值,按任务与位置熵自适应调整速度-精度工作点。
复现评估
复现评估:论文给出项目主页 https://xalp.net/prove,正文未见明确的开源代码与权重链接,属 Preprint。方法组件均可获得:提议者基于 MARS(Jin et al., 2026)管线在 Qwen2.5-32B-Instruct 上两阶段各 1 epoch 训练(先 AR SFT 再块预测训练),验证器用现成 Qwen2.5-3B/7B-Instruct 或在其生成数据上微调;推理栈为 SGLang,32B 张量并行 2 卡,评测用 lm-evaluation-harness 跑六个公开基准全测试集(最长 1024 生成 token)。从头复现需要约 2×80GB 级 GPU 训练 32B 提议者并跑大量评测,难度中等偏高;若能拿到作者发布的提议者 checkpoint,仅复现解码循环与评测则相当直接。附录 A 给出训练与 serving 细节、附录 D 给出评测不确定性,但正文未提供代码仓库,占位符处理、KV cache 管理等工程细节可能需要自行摸索。
论文图表
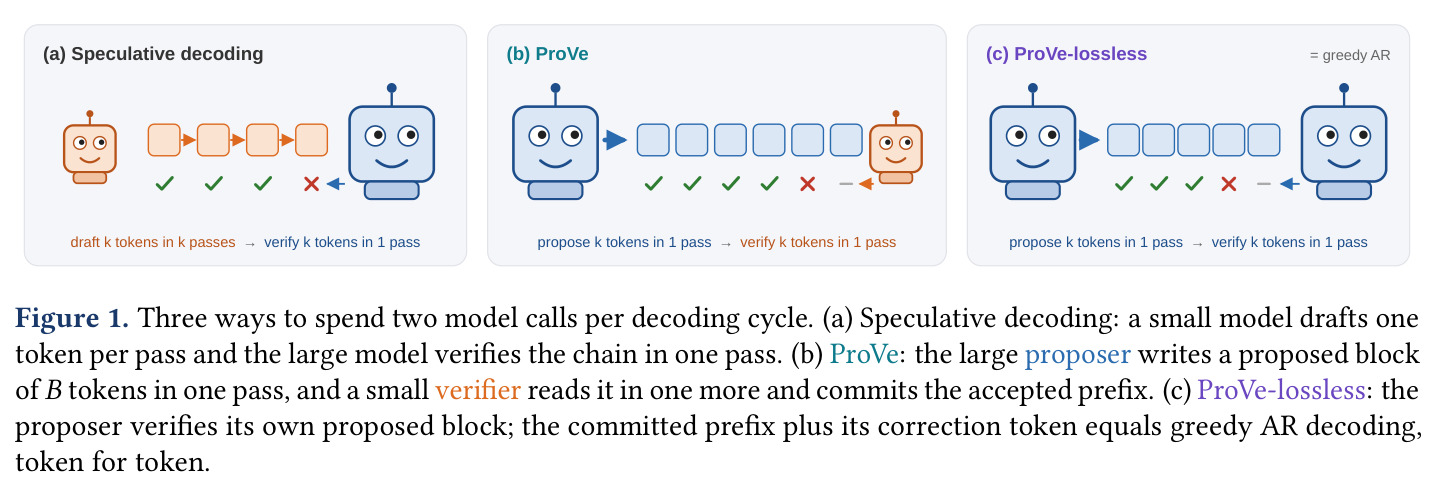
三栏示意图对比每个解码周期花两次模型调用的三种方式:(a) 投机解码让小模型逐 token 起草 k 次、大模型一次验证整链;(b) ProVe 让大提议者一次写出 k 个 token 的候选块、验证者一次读块并提交接受的前缀;(c) ProVe-lossless 由提议者自验证,提交的前缀加纠正 token 与贪心 AR 逐 token 一致。
一图看懂全文核心思想——角色反转以及三种解码循环的成本结构差异,是理解后文所有推导和实验的入口。