RLSplat:前馈式 3D 高斯泼溅的资源线性预算控制 RLSplat: Resource-Linear Budget Control for Feed-forward 3D Gaussian Splatting
学习高斯分配策略直接生成指定数量的高斯,显存与延迟随预算线性下降且画质全面领先
前置知识
3D Gaussian Splatting (3DGS)
用一组各向异性 3D 高斯基元显式表示场景,每个高斯携带中心 $\mu$、不透明度、尺度、旋转和球谐颜色系数,通过可微光栅化(splatting)渲染图像,能以实时帧率做新视角合成。原始 3DGS 需要分钟到小时级的逐场景优化和大量标定视角。
本文的输出表示就是 3DGS,分配策略的奖励信号(渲染质量)也靠 3DGS 的可微光栅化计算,不理解高斯属性与渲染管线就无法理解预算分配的对象和奖励的来源。
Feed-forward 3DGS (FF3DGS)
用一次前向传播直接从图像预测高斯(而非逐场景优化)的模型族。早期方法每像素或每体素固定分配一个高斯;近期基于 3D 基础模型的方法可直接处理未标定图像并同时预测相机参数,代表工作有 NoPoSplat、AnySplat、F4Splat 等。
RLSplat 是 FF3DGS 之上的预算控制框架,其几何骨干(VGGT 类 3D 基础模型)与锚点 token 设计都建立在 FF3DGS 的架构惯例之上,读方法部分需要知道像素对齐与 query-based 两条已有路线的局限。
GSPO(Group Sequence Policy Optimization)
GRPO 的序列级变体:对每个状态采一组(group)候选动作,用组内奖励标准化代替学习价值函数得到优势估计;重要性比不是逐 token 计算,而是对整条序列做长度归一化并在序列级裁剪(clip),该技术已成为大语言模型 RL 微调的标准做法。
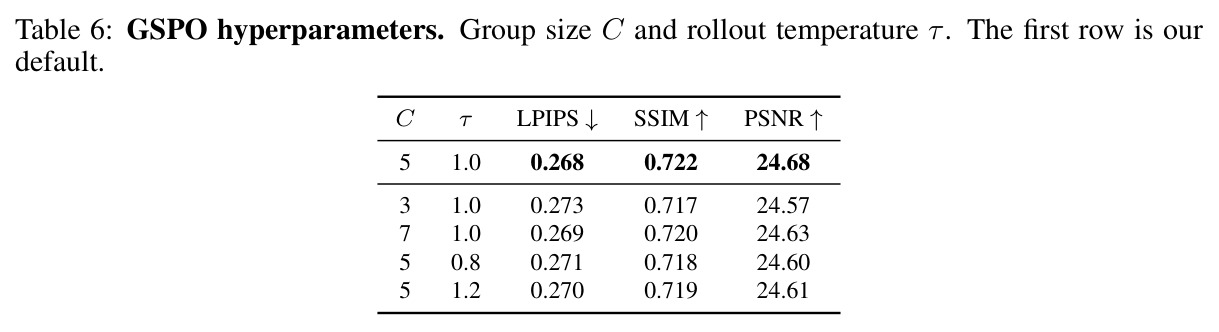
RLSplat 用 GSPO 训练高斯分配策略:把一次分配当作长度为 $B$ 的序列、把渲染质量当作奖励,这是整个方法在优化层面的核心,不懂组相对优势和序列级重要性比就读不懂式 (2)-(4)。
局部交叉注意力与 KNN 稀疏化
把 $O(B^2)$ 的全局自注意力限制为每个 token 只与 $K$ 个最近邻居做交叉注意力,邻居由 K 近邻搜索按几何位置(如高斯中心)在欧氏空间查找,总复杂度降为 $O(BK)$;配合两级层次化搜索(先粗后细)可以把邻居查找本身也做得非常快。
资源线性解码器正是靠层次化 KNN + 局部交叉注意力把解码成本压到与预算 $B$ 成正比,这是标题里「资源线性」二字的直接来源,也是延迟和显存能随预算下降的机制保证。
PSNR / SSIM / LPIPS
三种图像质量指标:PSNR 衡量像素级均方误差,越高越好,单位 dB;SSIM 衡量结构相似性,取值 0 到 1,越高越好;LPIPS 用预训练深度特征衡量感知差异,越低越好,对纹理和细结构更敏感。
论文所有质量结论(表 1、表 2 及全部消融)都由这三个指标刻画,预算-质量权衡必须同时看三者:RLSplat 的优势恰好在 LPIPS/SSIM 上比 PSNR 上更明显。
研究动机
前馈式 3D 高斯泼溅(FF3DGS)因单次前向即可重建场景,天然适合 AR/VR、机器人等资源受限场景,因此近期出现了「预算可控」方法:EcoSplat 先为每个像素预测高斯、再按预算条件化不透明度保留 $B$ 个;F4Splat 在多个尺度上预测高斯再选出 $B$ 个。但这两类方法都只控制了输出表示的体积,而忽略了推理本身的代价——为了得到目标数量的高斯,它们必须先生成远超预算的稠密候选集再做剪枝或筛选,导致无论预算设为 2K 还是 64K,推理延迟和峰值显存都几乎不变(论文 Figure 1(b)(c))。这种浪费在低预算场景下尤为严重:实测在 2K 高斯预算下,F4Splat 的峰值显存是 RLSplat 的 9.6 倍、延迟是 4.1 倍。而更早的像素对齐方法(NoPoSplat 等)每像素固定分配一个高斯,重叠视角会产生大量冗余,且不重训就无法调整高斯数量,难以适配真实部署中千差万别的存储与延迟约束。
本文的目标是论文的目标是构建一个「资源线性」的预算可控 FF3DGS 框架:给定未标定图像和高斯预算 $B$,表示大小、推理延迟、峰值显存三者都随 $B$ 的减小而线性下降,而不是停在常数水平。具体来说,模型必须精确生成恰好 $B$ 个高斯($\sum_n k_n = B$),且解码这些高斯的计算量随 $B$ 线性缩放;同时渲染质量在每个预算点上都要优于现有预算可控方法,尤其在低预算区间保持稳健——因为预算越紧,每个高斯放在哪里就越关键。论文用三个可检验的标准定义成功:(1) 相同预算下 PSNR/LPIPS/SSIM 全面超越 EcoSplat 与 F4Splat,甚至用 4 倍更少的高斯也能超过最强基线;(2) 延迟随 $B$ 近似线性下降(Figure 1(c));(3) 峰值显存随 $B$ 线性下降,在 2K 预算下比 F4Splat 省 9.6 倍显存、快 4.1 倍且 PSNR 高 0.9 dB。
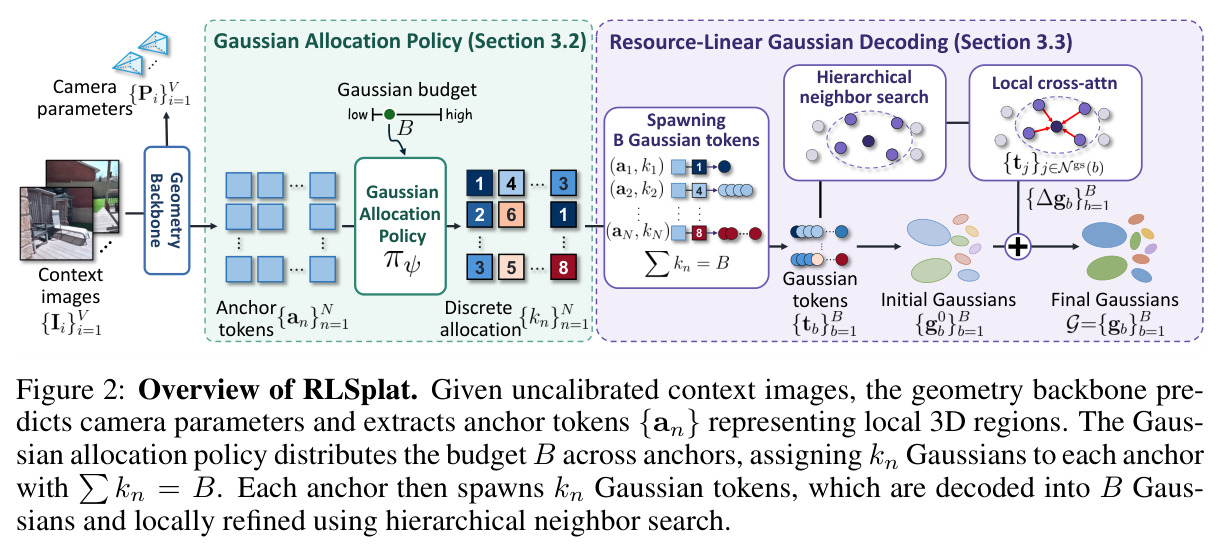
与已有工作不同的是,论文的独特切入点是把「生成 $B$ 个高斯」从剪枝/筛选问题重新表述为资源分配问题:不再先产稠密候选集再丢弃,而是让网络直接学会「每个局部区域该分多少个高斯」,从而从头到尾只实例化 $B$ 个高斯。由于离散分配不可微、且只有渲染后才能评估好坏,作者引入强化学习:把一次分配看作长度为 $B$ 的动作序列,用 GSPO 以渲染质量为奖励训练分配策略。第二个独特之处在解码端:现有 FF3DGS 解码器依赖全局自注意力,代价 $O(B^2)$;RLSplat 设计了局部交叉注意力,每个 token 只关注通过两级层次化近邻搜索(先锚点级、再高斯级)找到的 $K_{gs}$ 个邻居,代价降为 $O(B K_{gs})$。「分配 + 线性解码」的组合使整条流水线的开销首次与预算严格成正比,这是与 EcoSplat、F4Splat 以及同期工作 ZipSplat(靠聚类控制数量但仍处理稠密 token)的本质区别。
核心方法
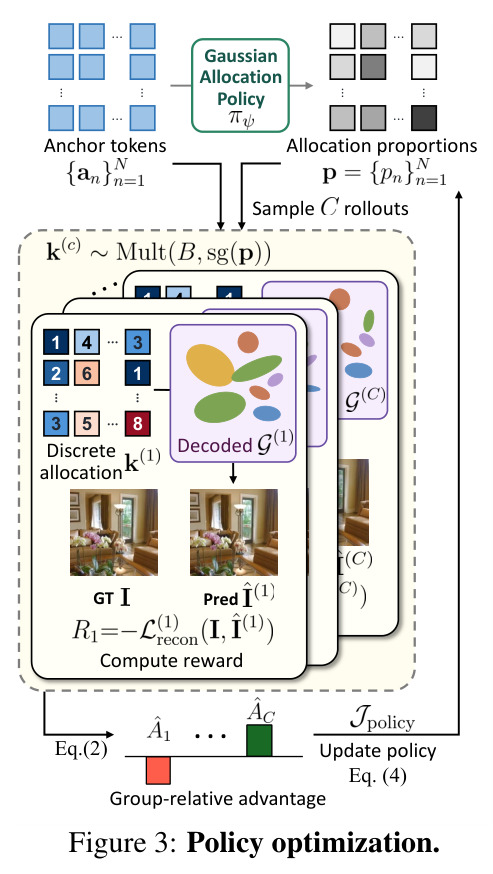
直觉上,RLSplat 把「钱怎么花」和「东西怎么做」分成两个模块:一个策略网络决定预算怎么在场景中分配,一个线性解码器按分配结果把高斯造出来。技术上,给定 $V$ 张未标定图像 $\{I_i\}_{i=1}^V$ 和预算 $B$,几何骨干网络(基于 VGGT 类 3D 基础模型)先预测相机参数 $\{P_i\}$ 并输出 $N$ 个锚点 token $\{a_n\}$,每个锚点代表一个局部 3D 区域。高斯分配策略 $\pi_\psi(k|\{a_n\}, B)$ 预测分配比例 $p=\{p_n\}$,经多项式分布 $k \sim \mathrm{Mult}(B, p)$ 得到整数分配,保证 $\sum_n k_n = B$,并用 GSPO 以渲染质量奖励 $R_c = -\mathcal{L}_{\mathrm{recon}}^{(c)}$ 训练。随后每个锚点按 $k_n$ 生成 $k_n$ 个高斯 token(共恰好 $B$ 个),经资源线性解码器精化:每个 token 只对层次化近邻搜索找到的 $K_{gs}=16$ 个邻居做 $L$ 层交叉注意力,代价为 $O(B K_{gs})$ 而非 $O(B^2)$。整体推理延迟与峰值显存因此随 $B$ 线性下降:在 ACID 零样本评测中每个预算点的 PSNR 都超过 F4Splat,2K 预算下快 4.1 倍、省 9.6 倍峰值显存。
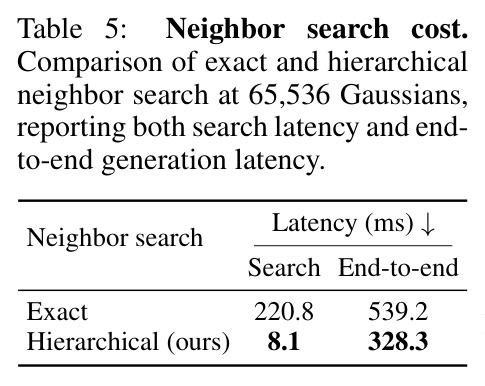
核心创新是用可学习的分配策略取代剪枝/筛选,并用 GSPO 解决「离散分配不可微、只能靠渲染评估」的优化难题。与 GRPO 类似,GSPO 不需要价值函数:每步从当前策略采 $C$ 个候选分配(rollout),组内标准化奖励得到优势 $\hat{A}_c = (R_c - \mathrm{mean}\{R_{c'}\})/\mathrm{std}\{R_{c'}\}$;关键在于它把一次分配视为长度为 $B$ 的序列,重要性比取长度归一化的序列级比值 $s_c = \exp[\frac{1}{B}\sum_n k_n^{(c)} \log \frac{p_n}{\mathrm{sg}(p_n)}]$,并在序列级裁剪。第二个核心是层次化近邻搜索:先对锚点质心 $\bar{\mu}_n$ 做 $K_{anc}=16$ 近邻,再只在候选锚点的高斯中搜 $K_{gs}=16$ 个近邻,搜索耗时从精确搜索的 220.8 ms 降到 8.1 ms(27 倍加速)。为让两级搜索成立,引入 Voronoi 损失 $\mathcal{L}_{\mathrm{vor}}$(每个高斯必须离自己锚点质心最近)和偏移损失 $\mathcal{L}_{\mathrm{offset}}$(残差位移不超过局部锚点间距的 $\delta=0.5$ 倍),使层次搜索对 99.0% 的高斯都能找回与精确搜索一致的近邻,保证局部注意力不丢真邻居。
方法步骤详情
第一步,编码:几何骨干接收 $V$ 张未标定图像,输出相机参数 $\{P_i\}$ 和 $N$ 个锚点 token。第二步,分配:策略头预测比例 $p_n$;推理时确定性地把期望数 $Bp$ 舍入为求和恰为 $B$ 的整数分配 $k$(附录 B);训练时以 $\mathrm{Mult}(B, \mathrm{sg}(p))$ 采 $C$ 个 rollout,渲染得奖励后按 GSPO 更新。第三步,token 生成:TokenGen 以锚点向量加槽位索引为条件,为每个锚点实例化 $k_n$ 个不同高斯 token(共 $B$ 个),头部预测初始高斯 $g_b^0$(含中心 $\mu_b^0$)。第四步,层次近邻搜索:对 $k_n>0$ 的锚点算质心 $\bar{\mu}_n$,先取 $K_{anc}$ 个最近锚点、再在其中取 $K_{gs}$ 个最近高斯;邻居只用 detach 的初始位置算一次、被 $L$ 层共享。第五步,局部精化:$L$ 层「交叉注意力+前馈」更新 $t_b \leftarrow t_b + \mathrm{CrossAttn}(t_b, \{t_j\}_{j\in\mathcal{N}_{gs}(b)})$,残差头给出 $g_b = g_b^0 + \Delta g_b$。第六步,训练:$\mathcal{L}_{\mathrm{recon}}$(MSE+LPIPS)、$\mathcal{L}_{\mathrm{cam}}$、$\mathcal{L}_{\mathrm{proj}}$(含 cheirality 惩罚,把高斯拴在源图像块)加 $\mathcal{L}_{\mathrm{vor}}$、$\mathcal{L}_{\mathrm{offset}}$;先随机分配训练 40,000 步,再加初始化为均匀分布的策略头微调 5,000 步,预算从 $[2048, 16384V]$ 采样且偏向低端。
技术新颖性
技术新颖性体现在四个层面。其一,问题层:首次把预算可控 FF3DGS 的推理代价纳入优化目标,提出「资源线性」这一新评价维度(表示大小、延迟、峰值显存三者随 $B$ 线性缩放),此前 EcoSplat、F4Splat 的延迟与显存均与预算无关。其二,建模层:把高斯数量控制表述为多锚点间的整数分配问题,用多项式分布参数化,使「精确 $B$ 个高斯」成为硬约束而非剪枝后的残差。其三,优化层:将 GSPO 从 LLM 对齐迁移到视觉重建,把一次分配视为长度 $B$ 的序列并做序列级裁剪的重要性比,奖励直接用可微渲染的重建损失,借助 3DGS 的高效光栅化使每步采 $C$ 个 rollout 的训练开销可忽略。其四,效率层:两级层次近邻搜索(锚点级 $K_{anc}$ → 高斯级 $K_{gs}$)把邻居查找从 $O(B^2)$ 降到 $O(B K)$,在 65,536 高斯时搜索耗时从 220.8 ms 降至 8.1 ms;配套的 Voronoi 与 offset 正则把近邻召回率从 60.2% 拉回 99.0%,这是让「局部注意力近似全局注意力」真正成立的关键工程贡献。
实验结果
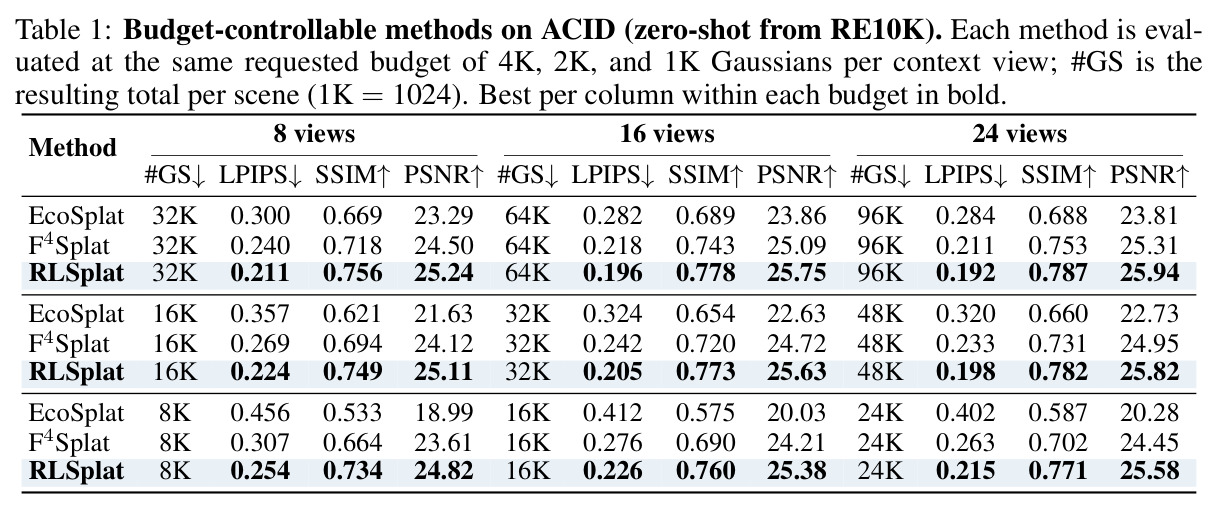
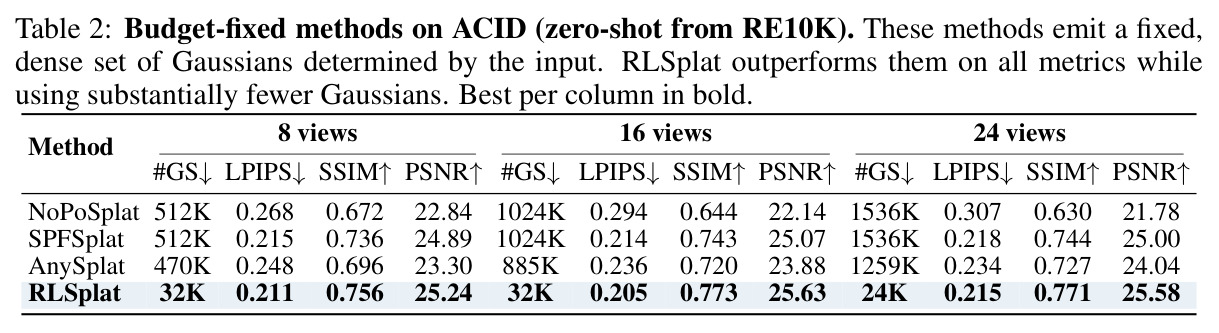
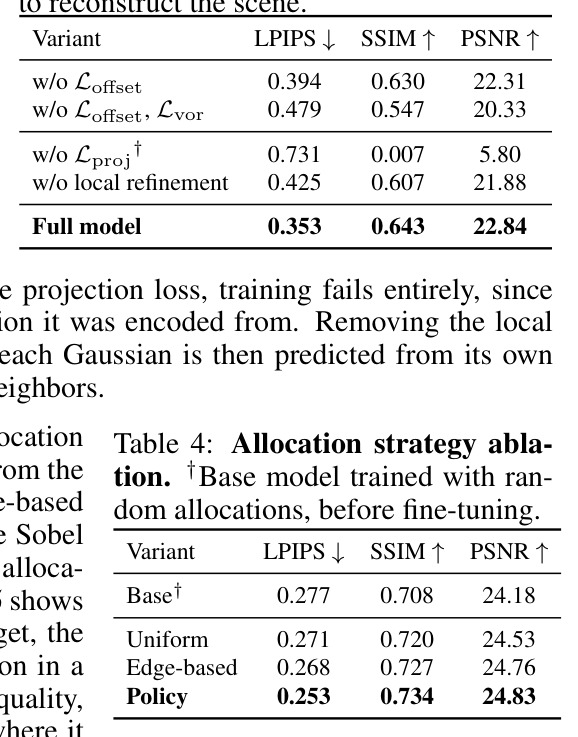
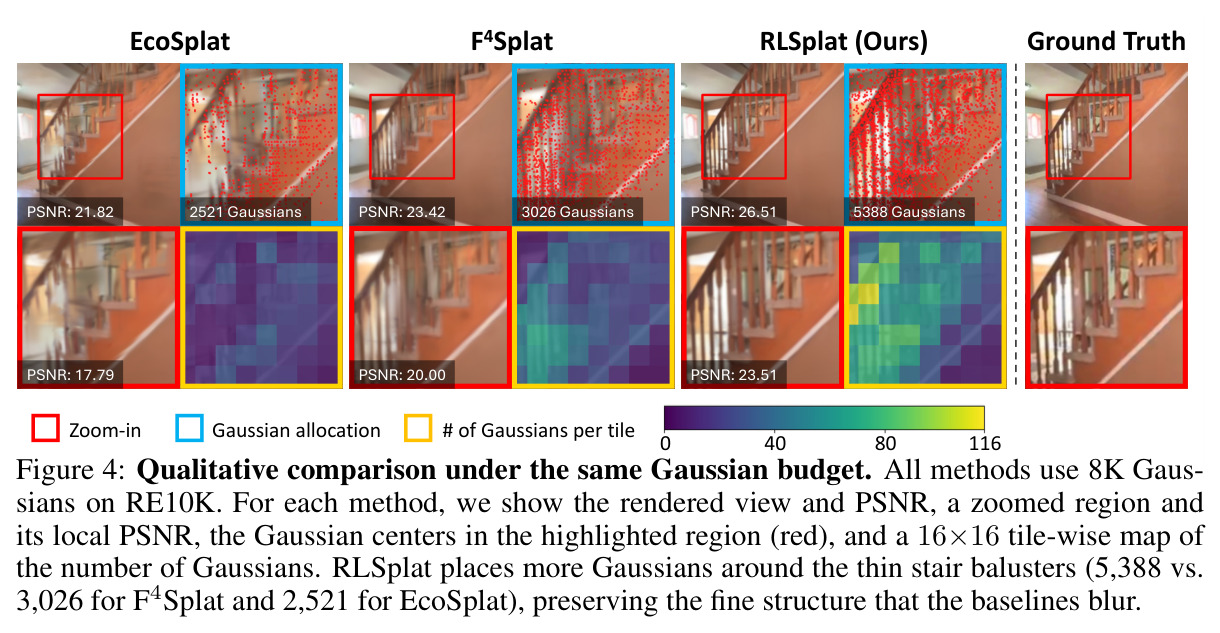
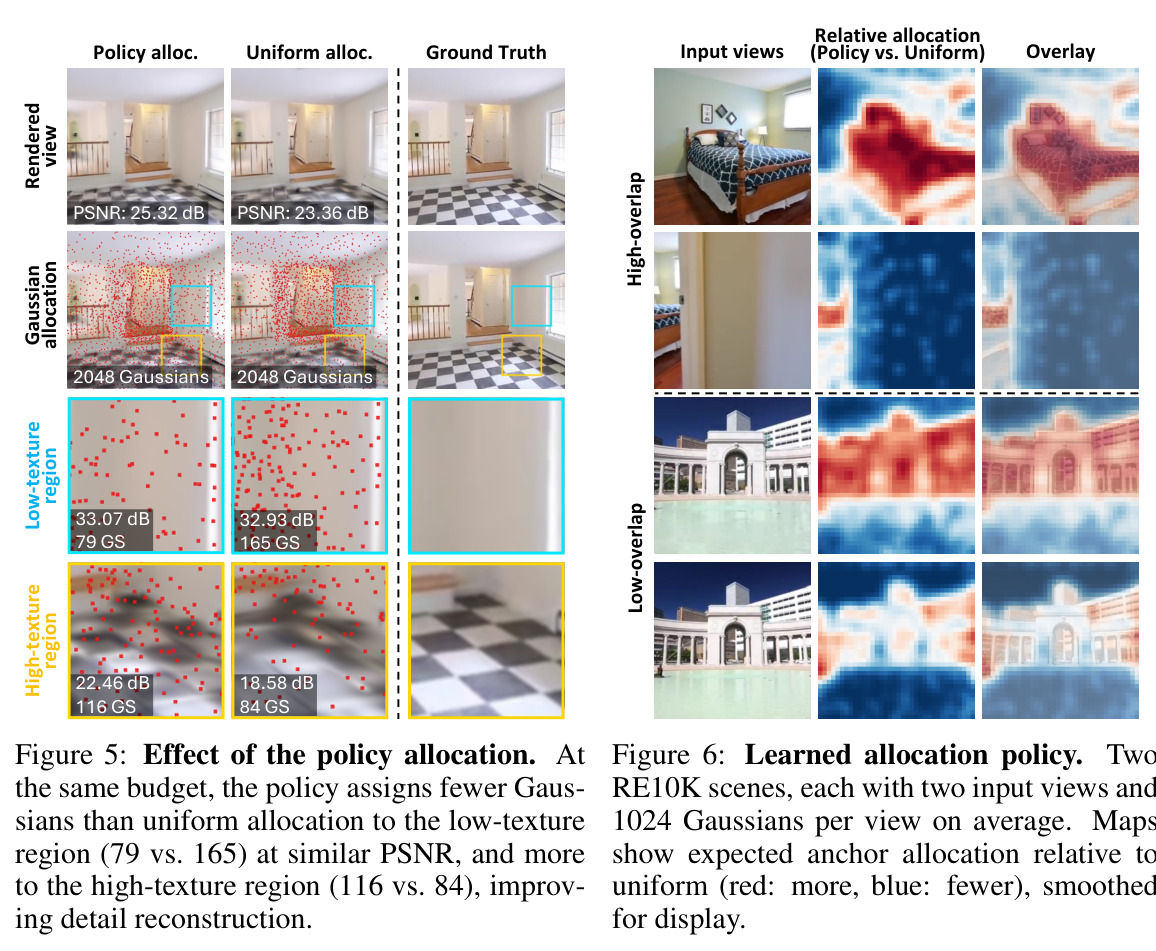
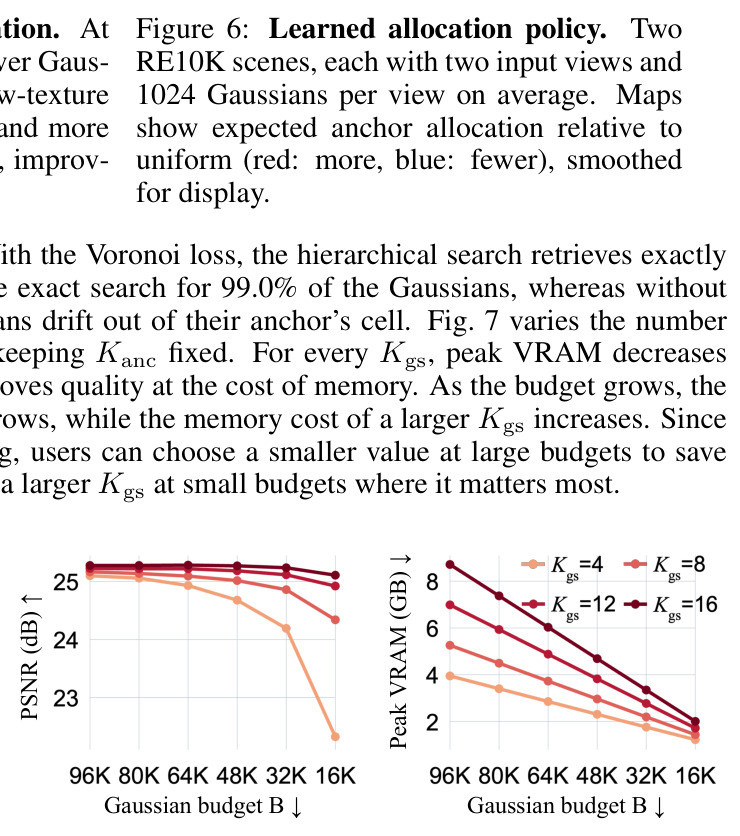
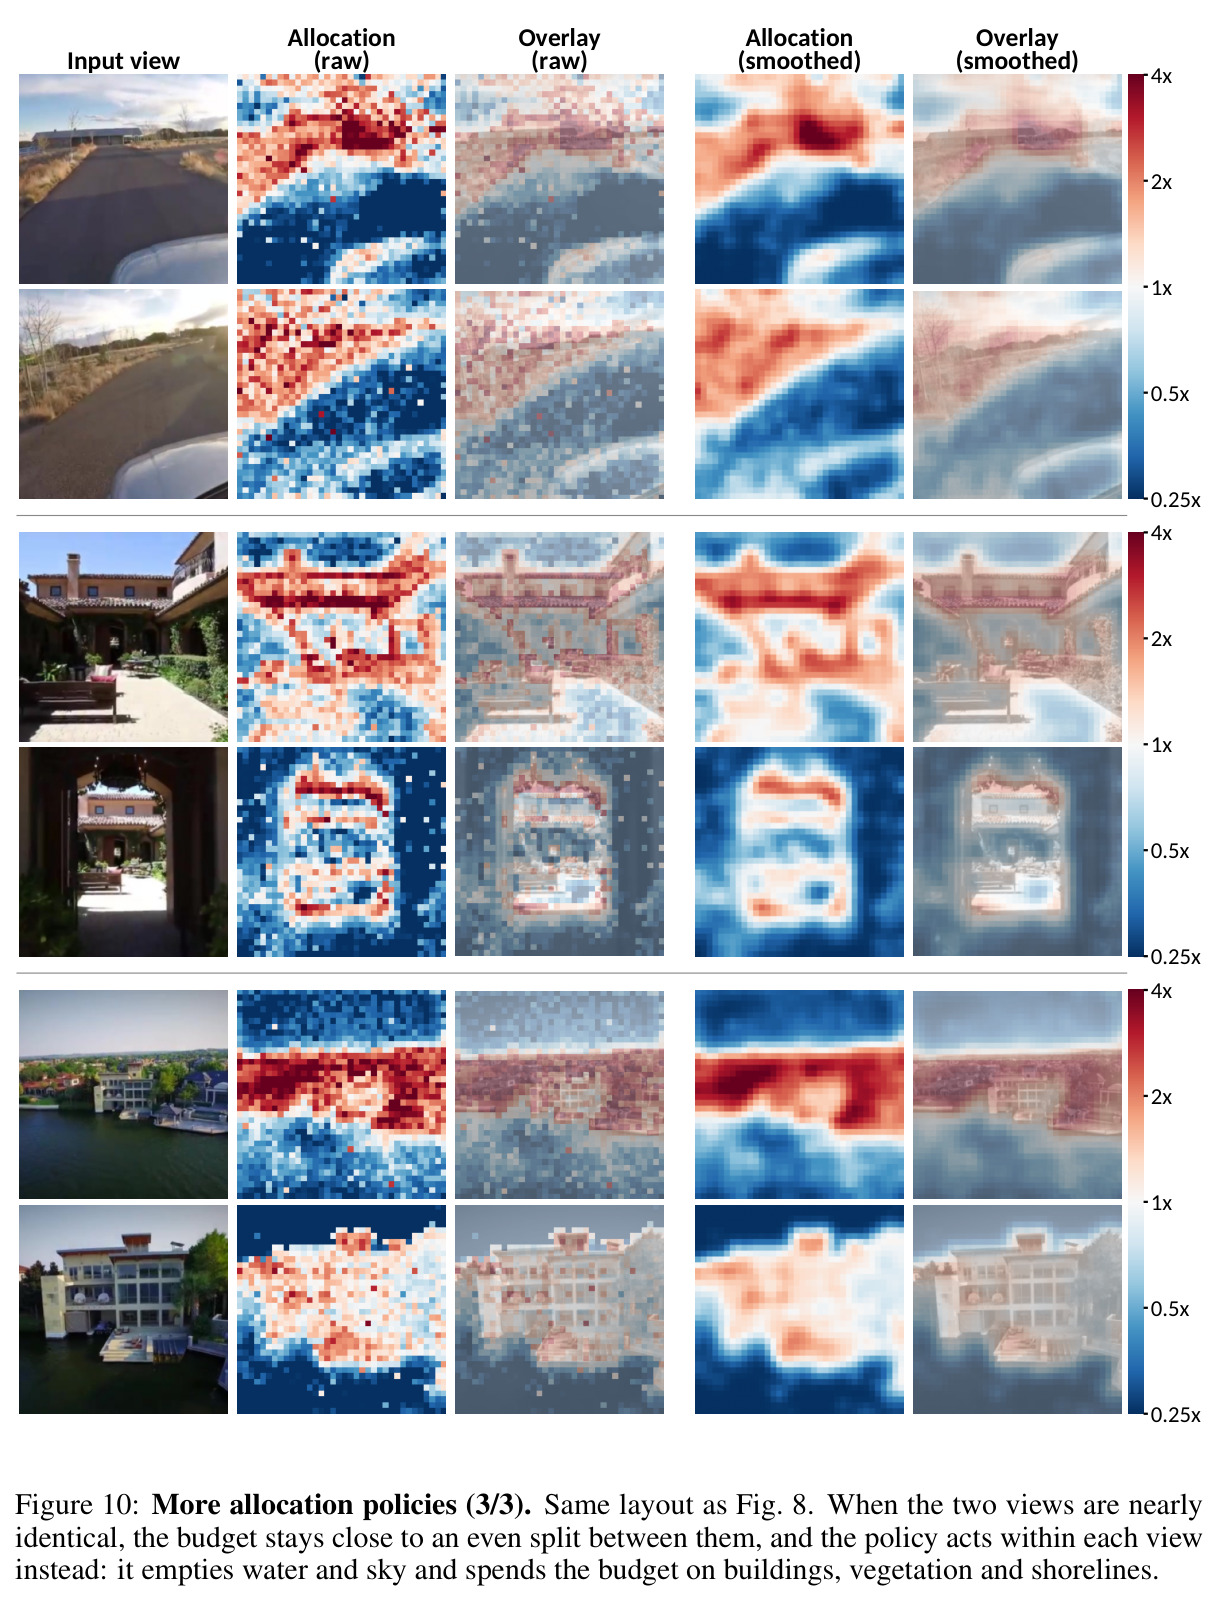
在 RE10K 训练($V\in\{2,...,24\}$ 视角)、ACID 249 场景零样本评估(256×256,单张 RTX A6000)。表 1:RLSplat 在全部预算与视角数下三项指标全面领先——8 视角 32K 高斯时 PSNR 25.24/SSIM 0.756/LPIPS 0.211,优于 F4Splat 24.50/0.718/0.240 与 EcoSplat 23.29/0.669/0.300;且预算越低优势越大:8 视角下对 F4Splat 的 PSNR 领先从 4K/视角的 0.74 dB 增至 2K 的 0.99 dB、1K 的 1.22 dB。表 2:24 视角下 RLSplat 仅用 24K 高斯达 25.58 dB,超过用 1536K 高斯的 SPFSplat(25.00 dB),高斯数少 64 倍。图 4:同 8K 预算下策略给楼梯栏杆细结构分 5,388 个高斯(EcoSplat 2,521、F4Splat 3,026),局部 PSNR 23.51 对 17.79/20.00 dB,全图 26.51 对 21.82/23.42 dB。消融(表 3,$B$=8,192):去 $\mathcal{L}_{\mathrm{offset}}$ 掉 0.53 dB,再去 $\mathcal{L}_{\mathrm{vor}}$ 共掉 2.51 dB,去 $\mathcal{L}_{\mathrm{proj}}$ 训练崩溃(PSNR 5.80),去局部精化掉 0.96 dB。表 4:策略分配 24.83 dB > 边缘启发式 24.76 > 均匀 24.53 > 随机基座 24.18。表 5:层次搜索 8.1 ms 对精确搜索 220.8 ms(27 倍),端到端 328.3 对 539.2 ms;有 Voronoi 损失近邻召回 99.0%,无则 60.2%。图 7:$K_{gs}$ 推理期可调,显存随 $B$ 线性下降。整体:2K 预算下比 F4Splat 快 4.1 倍、峰值显存少 9.6 倍且 PSNR 高 0.9 dB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ACID 零样本新视角合成(8 视角,预算 1K/视角,共 8K 高斯) | PSNR / SSIM / LPIPS | 24.82 dB / 0.734 / 0.254 | F4Splat 23.61 dB / 0.664 / 0.307;EcoSplat 18.99 dB / 0.533 / 0.456 | PSNR +1.22 dB vs F4Splat,预算越低领先越大 |
| ACID 零样本新视角合成(8 视角,预算 4K/视角,共 32K 高斯) | PSNR / SSIM / LPIPS | 25.24 dB / 0.756 / 0.211 | F4Splat 24.50 dB / 0.718 / 0.240 | PSNR +0.74 dB,且 LPIPS/SSIM 同步领先 |
| 对比预算固定方法(24 视角,零样本) | PSNR @ 高斯数 | 25.58 dB @ 24K 高斯 | SPFSplat 25.00 dB @ 1536K 高斯;NoPoSplat 21.78 dB @ 1536K | 高斯数少 64 倍仍高 0.58 dB |
| 推理效率(2K 低预算) | 峰值显存 / 延迟 | 基线的 1/9.6 显存、1/4.1 延迟 | F4Splat(先预测稠密候选集再筛选) | 同时 PSNR +0.9 dB,三项全面占优 |
| 邻居搜索成本(65,536 高斯) | 搜索延迟 / 端到端延迟 | 8.1 ms / 328.3 ms(层次化搜索) | 精确全量搜索 220.8 ms / 539.2 ms | 搜索约 27 倍加速,端到端约 1.6 倍 |
局限与改进
作者承认的局限:评测分辨率仅为 256×256;延迟与峰值显存的统计排除了数据加载、位姿对齐和渲染阶段,只计高斯生成部分,因此 4.1 倍加速不能直接等同端到端应用的提速;训练与评测集中在 RE10K(室内)与 ACID(航拍)两类场景。我的补充观察:其一,锚点数量 $N$ 由骨干的 patch 化决定,超高分辨率或大场景下锚点数远超预算时,分配问题的组合空间急剧变化,资源线性性是否保持未验证;其二,RL 训练引入新超参(rollout 数 $C$、裁剪范围 $\epsilon$、预算采样偏斜),策略阶段只训 5,000 步,长期稳定性与更大规模数据上的可扩展性未知;其三,表 4 显示在纹理较平稳的场景,策略相对均匀分配只带来约 0.3 dB 增益,收益高度依赖场景内容;其四,层次搜索的正确性依赖 Voronoi/offset 正则维持的局部性假设,分布外场景若使高斯漂移超出锚点胞,近邻召回可能退化(消融中无 Voronoi 损失时召回已掉到 60.2%);其五,推理期确定性舍入 $Bp$ 如何在极端倾斜分布下保证求和恰为 $B$ 且无系统性偏差,论文只在附录 B 简述。
独立分析的弱点
第一,奖励信号单一:策略只以 MSE+LPIPS 的重建损失为奖励,缺少感知质量、几何一致性或下游任务(如 3D VLM 理解)导向的信号,改进方向是引入多目标奖励或用偏好模型打分。第二,分配粒度固定在锚点级:预算以整数个高斯在 $N$ 个锚点间划分,锚点自身数量不可控,极端低预算(如 $B < N$)时大量锚点被分到 0,可能产生空间覆盖空洞,可引入层级锚点金字塔允许预算跨尺度调剂。第三,$K_{gs}$、$K_{anc}$ 需用户手工权衡:图 7 显示小预算需要大 $K_{gs}$、大预算可用小 $K_{gs}$ 省显存,但缺乏自动化机制,可训练预算条件化的注意力稀疏度预测器。第四,两阶段训练割裂:基座阶段用随机分配训练解码器,策略阶段再联合微调,随机分配与策略分布的失配可能浪费模型容量,可用课程式采样从均匀分布逐步退火到策略分布。第五,未评估时序一致性:视频流式场景中逐帧独立分配预算可能抖动,导致相邻帧高斯数量与位置跳变,应加入时间平滑正则或递归式预算继承。
未来方向
作者在结论中未展开未来工作,但基于成果可延伸的方向很多。其一,预算自适应的视频流式重建:根据网络带宽实时调整 $B$,利用线性延迟/显存特性做帧级码率控制。其二,奖励函数扩展:在 PSNR 之外加入深度一致性、语义分割一致性或 3D 视觉语言模型的下游任务奖励,使高斯分配服务于理解而非仅重建。其三,把 GSPO 分配思想迁移回逐场景 3DGS 的 densification:用策略网络指导致密化阶段「在哪加高斯」,替代基于梯度的启发式。其四,层次近邻搜索与八叉树/BVH 等空间数据结构结合,进一步把 $K_{anc}$ 搜索做成增量式,支持高斯数量动态增减的在线更新。其五,推理期的确定性舍入可改为可微松弛(如 Sinkhorn 最优传输匹配),以便端到端联合训练分配与解码,省掉 RL 阶段。其六,在更高分辨率(512+)、真实大场景(如 Mill-19)以及 pose-free 视频输入上验证资源线性性与分配策略的泛化。
复现评估
复现条件较好:代码已在 GitHub 开源(https://github.com/mlvlab/RLSplat),训练数据 RealEstate10K 与评测数据 ACID 均为公开数据集,评测协议沿用 F4Splat(256×256 分辨率、PSNR/SSIM/LPIPS),硬件为单张 RTX A6000、batch size 1,测延迟前丢弃首个场景做 warm-up 并重置显存计数器,这些细节都明确写在第 4 节。训练成本方面:基座 40,000 步 + 策略 5,000 步,预算采样自 $[2048, 16384V]$,超参 $K_{anc}=K_{gs}=16$、$\delta=0.5$;论文未给出训练所需 GPU 数量与总天数。复现难点集中在 RL 阶段:需要 3DGS 可微光栅化来计算每步 $C$ 个 rollout 的渲染奖励,GSPO 的实现细节与确定性舍入过程分布在附录 B/D/E/F,需要一定的工程经验。总体难度中等偏上:熟悉 3DGS 与 FF3DGS 代码库(如 NoPoSplat/F4Splat 系)的团队可以复现,关键风险点是策略训练的稳定性和 $\mathcal{L}_{\mathrm{vor}}$、$\mathcal{L}_{\mathrm{offset}}$ 的超参敏感性。
论文图表
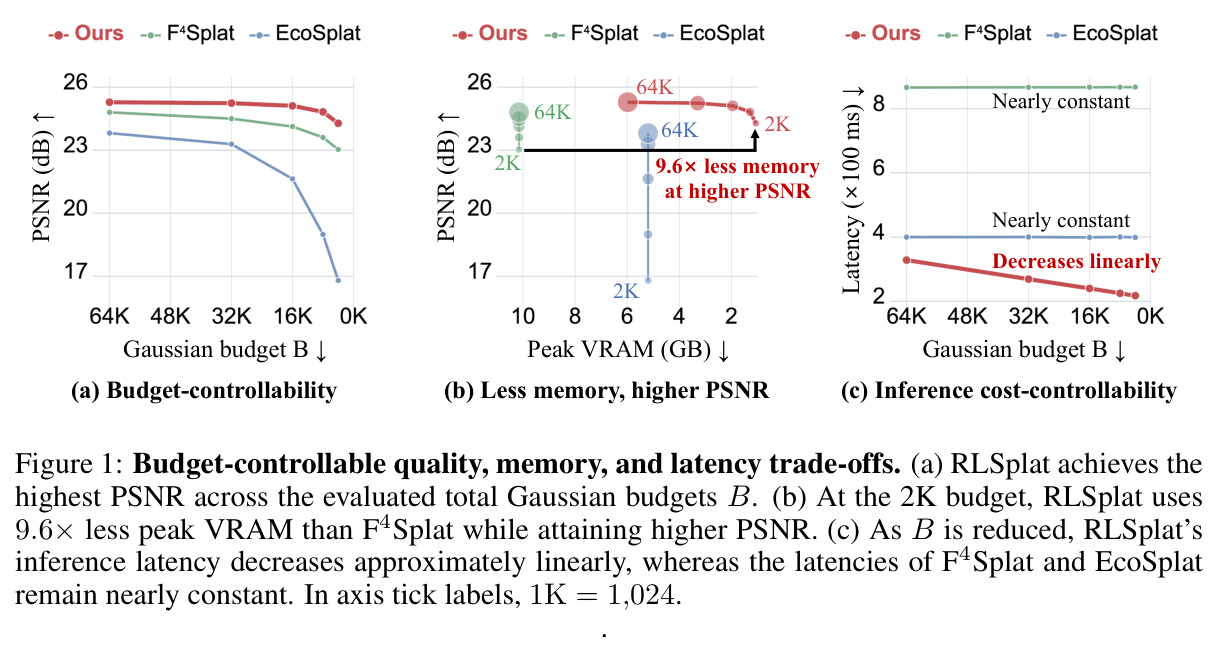
三联图。(a) 不同总高斯预算 $B$ 下各方法的 PSNR 曲线,RLSplat 在所有预算点最高;(b) 在 2K 预算下 RLSplat 的峰值显存比 F4Splat 低 9.6 倍且 PSNR 更高;(c) 延迟随预算 $B$ 减小的变化:RLSplat 近似线性下降,而 F4Splat 与 EcoSplat 几乎保持常数。
一张图概括论文的核心卖点「资源线性」与「每个预算点质量领先」,是读者判断这项工作价值的入口,也直观暴露了现有预算可控方法「只控输出不控成本」的问题。