DECERT:面向生成式奖励模型的决策证书监督 Judging the Justification: Decision Certificate Supervision for Generative Reward Models
不看参考解释,按论证质量审计裁判理由,准确率与位置鲁棒性双提升
前置知识
生成式奖励模型(GenRM)
传统奖励模型输出一个标量分数衡量回答好坏,而 GenRM 先生成一段自然语言理由(rationale),再在其中给出偏好裁决(如「回答 A 更好」)。它把判断过程显式写出来,理论上便于审查和监督,也被 LLM-as-a-Judge 评测广泛采用。
本文全部工作围绕 GenRM 展开:训练的就是一个会写理由的裁判模型,监督对象正是这段理由的质量,而非仅最终裁决。
SFT 与 DPO 两阶段对齐
SFT(监督微调)直接在高质量样本上做最大似然训练,用来给模型热身、教会输出格式;DPO(直接偏好优化)用成对数据(chosen 与 rejected)优化策略,使被偏好回答的概率上升,无需训练独立的价值模型。两者结合是当前偏好对齐的常见高效配方。
DECERT 用最高分候选做 SFT 热身,再用裁决加理由两种偏好对跑 DPO,理解训练流程必须知道这两个阶段各自吃什么数据。
自然语言推理(NLI)验证器
NLI 任务判断一个前提是否蕴含、矛盾或无法推出一个假设,通常输出 0 到 1 的支持度分数。本文用 NLI 模型做两类局部检查:理由中的命题是否被其引用证据支持(g_j),结论是否能从父主张推出(ℓ_j)。
Soundness 维度完全建立在 NLI 验证器之上,主张可靠度沿图传播的 q_j 也由 NLI 分数逐级取最小值得到。
位置偏差与位置一致准确率(PCA)
LLM 裁判普遍偏向某个回答位置:把 A、B 对调后判断可能翻转。PCA(positional consistent accuracy)要求模型在原始顺序和交换顺序下都判对才算正确,是比普通准确率更严格的位置鲁棒性指标;swap agreement 则衡量两种顺序判断的一致程度。
论文的核心卖点之一是不用交换增广就把 HelpSteer3 的 PCA 提升了 14.8 点,理解该指标才能读懂 Table 2 和位置鲁棒性实验。
过程奖励模型(PRM)
PRM 监督解题过程中间步骤的正确性,每一步推理打分,用于提升数学等推理任务的求解质量。它关注的是求解器的推导链,与评估者(judge)的理由监督是两个不同对象。
论文用 PRM 作对照划清边界:DECERT 审计的是裁判的比较性论证是否支持其裁决,而不是求解器每一步对不对。
研究动机
生成式奖励模型(GenRM)在给出偏好裁决前会先生成一段自然语言理由,这本应让监督信号覆盖「判断为什么正确」,但现有训练几乎只看最终裁决:只要裁决正确,理由写得再糟糕也拿到同样的奖励。Wang 等人的 RationaleRM 研究已表明,这类模型在静态偏好基准上准确率很高,生成的理由却充满漏洞,拿去做 RLHF 的奖励信号时表现明显退化。具体失败形态有三类(Figure 1):证据幻觉(声称「我测试过 A,A([]) 返回 None」却与真实代码行为不符)、忽略关键需求(比较匿名化功能时只谈字数长短而不谈隐私保护)、以及理由与结论自相矛盾的不负责任部署(先分析说 A 才满足管理员权限策略,最终却推荐 B)。另一条路线用参考解释做监督——RationaleRM 匹配人类原子理由、R-Align 评估与参考的逻辑对齐、RM-NLHF 用学习到的 MetaRM 做批评匹配——但参考解释获取成本高,且「与参考一致」并不等于「论证有效」:一段理由可以不同于参考却依然成立,也可以形似参考却依赖无根据断言或残缺推理。于是更直接的问题浮现:没有参考解释时,什么才构成对裁决的有效支撑?
本文的目标是本文目标是摆脱对参考解释的依赖,直接回答上面这个问题,并把理由质量评估转化为可优化的训练信号。具体而言,DECERT 想同时约束两件事:裁决正确性(选对哪个回答更好)与论证质量(理由是否可靠、是否覆盖关键议题、是否真的支持结论)。作者构造的偏好数据遵循「结果优先」规则——正确裁决的判断永远排在错误裁决之上,证书质量只在同为正确的样本内部制造区分——从而在不引入人工理由标注的前提下,把同裁决样本中原本被浪费的监督信号利用起来。最终期望训练出的裁判在偏好判断准确率、理由质量、分布外泛化和位置鲁棒性四个方面都超过仅用裁决监督的版本,并且不需要交换增广、成对顺序训练或显式位置一致性目标。实验设定是 Llama-3.1-8B 与 Qwen3-8B 两个基座,在 HelpSteer3 测试集(2k 条)上做分布内评估,在 RM-Bench 与 JudgeBench 两个分布外基准上验证泛化。
与已有工作不同的是,独特之处在于把理由监督重新表述为对「决策证书」的无参考审计:一份判断就是一个意在支持其裁决的比较性论证,其质量不由与任何参考的相似度决定,而由论证自身的有效性决定——证据是否真实、是否覆盖了真正影响比较的议题、结论是否真能从论证导出。技术上,作者从理由中抽取原子主张构成的有向无环图,用三个互补维度审计:Soundness(证据与局部推理是否成立)、Coverage(是否覆盖重要议题)、Decision Support(已验证信息是否足以导出声明裁决)。再配合结果控制的偏好构造:裁决正确性优先于理由质量,全对样本池内才按证书质量构造理由偏好对。这与 PRM 形成清晰分工——PRM 监督解题者的推导步骤,DECERT 审计裁判的比较推理;也与参考匹配路线本质不同——后者问「像不像参考」,前者问「论证是否自洽且有据」。
核心方法
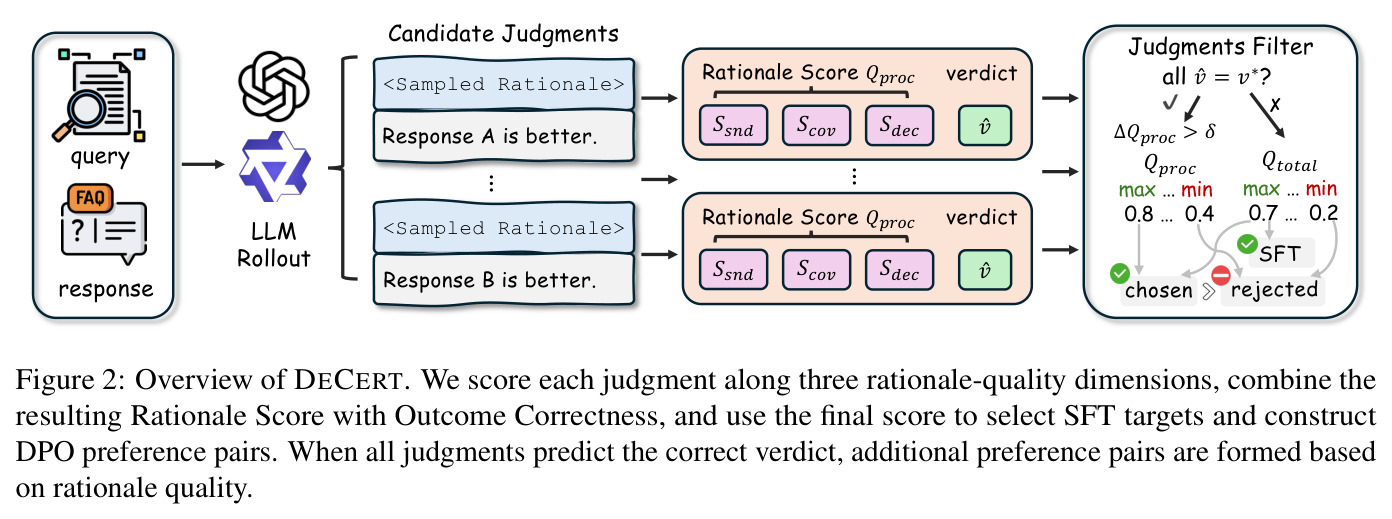
DECERT 是一条「数据构造 + 两阶段训练」的流水线。训练数据来自 HelpSteer3-Preference,采样约 12k 个实例并在 General、STEM、Code、Multilingual 四领域均衡分布。对每个实例,先从 GPT-4o 采 3 条、从 Qwen3-8B 采 5 条判断,构成 8 条候选的样本池;每条判断 $J=(r,v)$ 含理由 $r$ 和裁决 $v\in\{-1,+1\}$。随后计算证书质量分 $Q_{proc}=(S_{snd}S_{cov}S_{dec})^{1/3}$——三个维度的几何平均,任一维度低分都无法被其他维度掩盖——再与结果分 $O(J)=\mathbf{1}[v=v^\star]$ 融合成总分 $Q_{total}=\frac{O+\lambda Q_{proc}}{1+\lambda}$,保证正确裁决的候选永远排在错误裁决之上。用总分挑最高/最低候选构造 DPO 偏好对(约 8k 对,其中约 3k 是理由偏好对),最高分候选兼作 SFT 目标(约 10k 样本)。最后对 Llama-3.1-8B 和 Qwen3-8B 先 SFT 热身再 DPO,全程使用 LoRA 降低算力开销。
核心创新是决策证书的三维审计。Soundness:把理由解析为有向无环的主张图 $G_r=(A_r,E_r)$,每个原子主张 $a_j=(t_j,k_j,p_j,e_j,pa(j))$ 含类型、准则、命题、引用证据与父节点;用 NLI 验证器打证据支持度 $g_j$ 和推理有效度 $\ell_j$,$\nu_j=g_j\ell_j$,再沿祖先链传播 $q_j=\min_{h\in Anc^+(j)}\nu_h$——只要一个前提不可靠,其上所有推断都不可靠。Coverage:由看不到任何采样理由和裁决的 LLM 分析器,仅从问题、候选回答与评估策略中抽取重要议题集 $D_\xi$,用一对一匹配防止一条泛泛之谈给多个议题记功,得分乘 $q_j$ 使无根据主张拿不到覆盖分。Decision Support:把已验证的准则级比较收窄为区间 $I_k(r)=[L_k,U_k]$,在与理由一致的可行集 $\Omega_r$ 上求声明裁决的最小支持度 $B_r(v)=\inf_{d\in\Omega_r}FP(d)$,$S_{dec}=\frac{1+B_r(v)}{2}$——区分「缺证据」与「显式平局」,不把未提及的准则当作中性证据。三维度用几何平均 $Q_{proc}$ 聚合,杜绝短板被平均掉。
方法步骤详情
第一步,候选生成:对约 12k 个 HelpSteer3-Preference 实例各采 8 条判断(GPT-4o 三条、Qwen3-8B 五条)。第二步,主张图抽取:从每条理由抽出原子主张及依赖构成 DAG,只整理已陈述的信息、不补充缺失理由。第三步,Soundness:NLI 验证器逐条检查证据支持与推理有效(叶子观察节点 $\ell_j=1$,纯推断节点 $g_j=1$),沿图传播得到可靠度 $q_j$,去重后按准则聚合出 $S_{snd}$。第四步,Coverage:LLM 分析器只观察问题、两个候选回答和评估策略 $K(\xi)$(含权重 $\omega_k$),输出议题与重要性 $\rho_t$,与主张一对一匹配求最大加权覆盖;无可验证议题的实例被排除出理由监督。第五步,Decision Support:对每条准则收出区间 $[L_k,U_k]$ 并计算 $S_{dec}$。第六步,打分与配对:计算 $Q_{proc}$ 与 $Q_{total}$;混合池取总分最高与最低构造通用偏好对并选 SFT 目标,全对池按 $Q_{proc}$ 分差大于阈值 $\delta$ 构造理由偏好对,全错池丢弃。第七步,训练:SFT 热身(约 10k 样本)加 DPO(8k 对),LoRA 微调两个 8B 基座。
技术新颖性
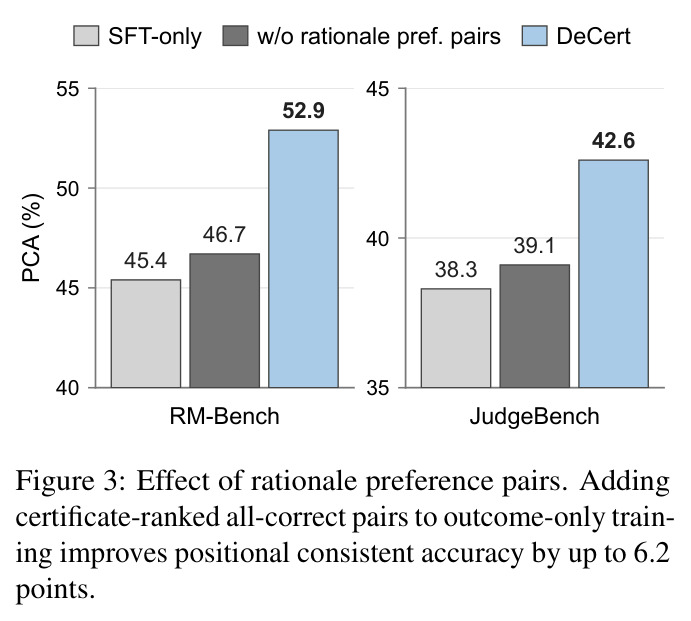
与已有方法的本质区别有三。其一,去参考化:RationaleRM、R-Align、RM-NLHF 都以人类解释或其派生信号为锚,DECERT 的三个维度全部从「理由—输入—裁决」的内部一致性推出,训练不需要任何参考解释,却仍能在参考类指标(HelpSteer3-Atomic)上涨分。其二,一整套防钻空子的机制设计:几何平均杜绝单维度短板被掩盖;一对一匹配杜绝一条主张冒领多个议题的分;覆盖分析器看不到理由和裁决,杜绝用预测器逆向刷分;$q_j$ 乘进覆盖分,杜绝无根据主张借覆盖得分;$S_{dec}$ 把未提及的准则视为未知而非中性证据,杜绝靠沉默过关。其三,同裁决样本池内的对比监督:传统结果监督对全对样本池给零梯度,DECERT 在其中按论证质量构造偏好对,把「判断质量」从裁决标签中解耦出来单独优化——消融实验中 RM-Bench PCA 从 46.7% 提到 52.9%(+6.2)正是这条信号的直接贡献,证明方法抓住的正是结果监督放弃掉的那部分信息。
实验结果
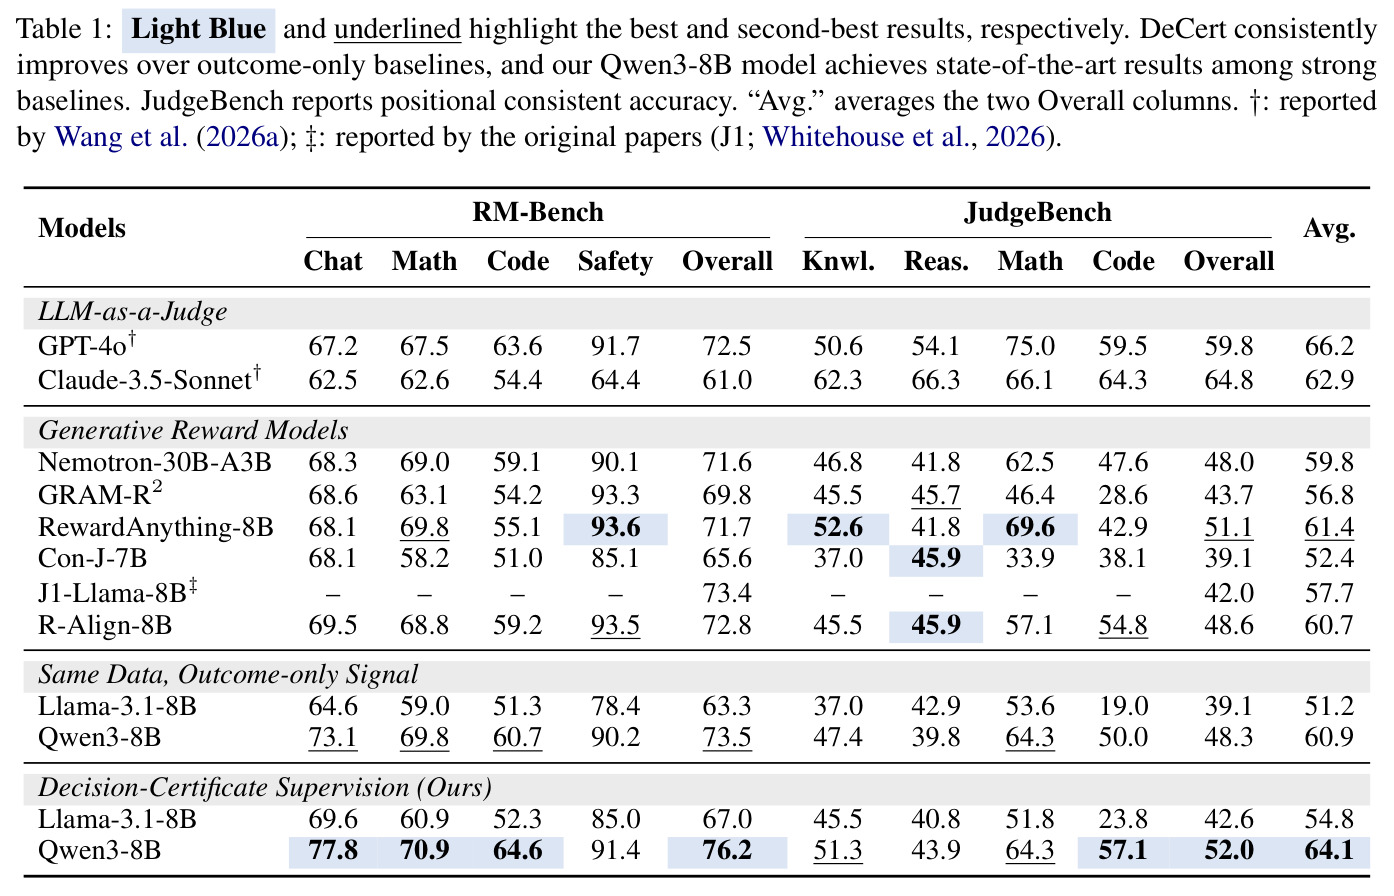
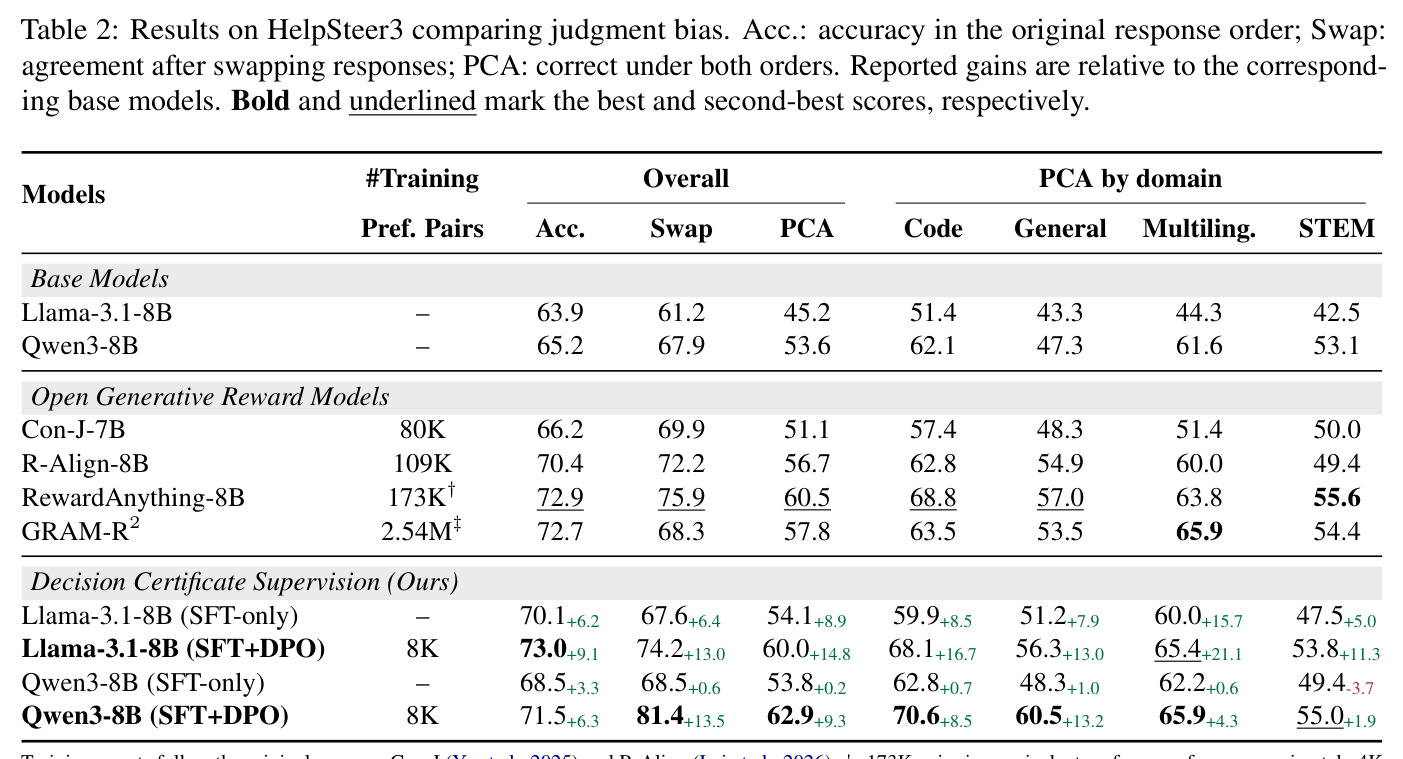
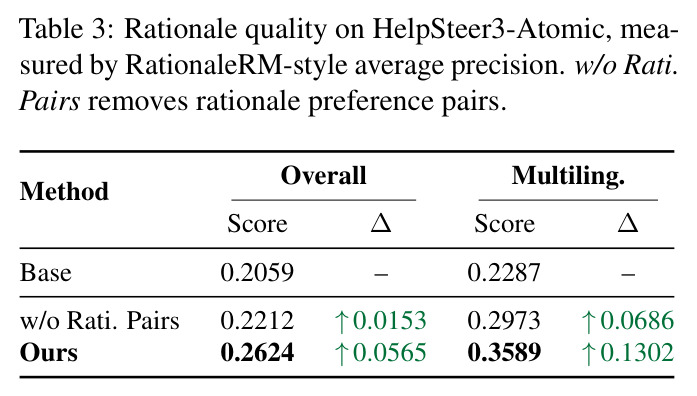
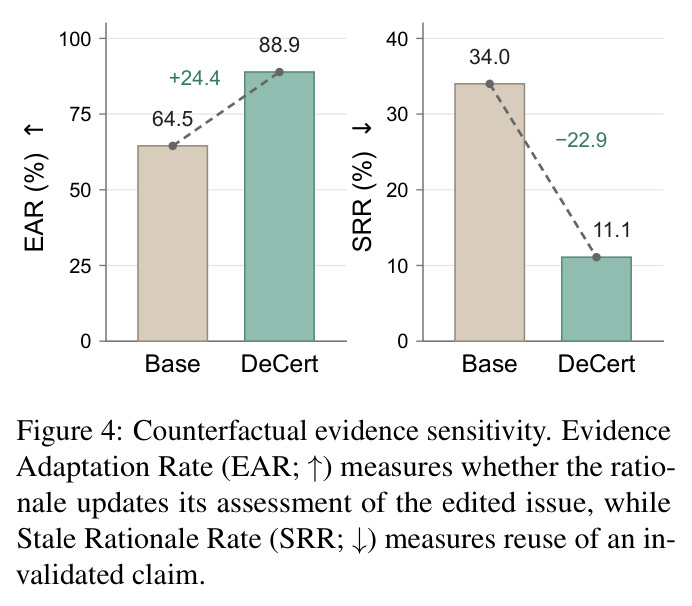
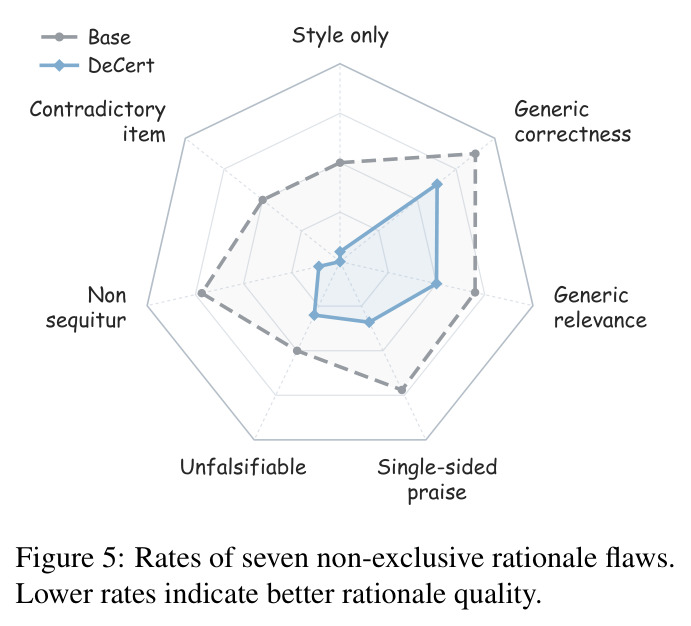
分布内(HelpSteer3,Table 2):Llama-3.1-8B 准确率 63.9 提到 73.0(+9.1,$p<0.0001$),PCA 45.2 提到 60.0(+14.8);Qwen3-8B 准确率 65.2 提到 71.5(+6.3),PCA 53.6 提到 62.9(+9.3)。仅 8k 偏好对就超过用 80K 到 2.54M 对训练的 Con-J-7B(66.2)、R-Align-8B(70.4)、GRAM-R2(72.7),逼近 RewardAnything-8B(72.9)。分布外(Table 1):RM-Bench Overall 从 63.3/73.5 提到 67.0/76.2,JudgeBench PCA 从 39.1/48.3 提到 42.6/52.0,Qwen 版为对比开源裁判两榜最高(平均 64.1)。消融(Figure 3):全对池加理由偏好对使 RM-Bench PCA 46.7% 提到 52.9%(+6.2)、JudgeBench 39.1% 提到 42.6%(+3.5),证明同裁决样本仍有监督价值。理由质量(Table 3):HelpSteer3-Atomic 上 RationaleRM 式 AP 0.2212 提到 0.2624(多语言 0.2973 提到 0.3589),训练未用任何人类参考理由。反事实检验(Figure 4):Llama 的 EAR 64.5% 提到 88.9%(+24.4)、SRR 34.0% 降到 11.1%,Qwen 同向(87.2% 提到 93.4%、30.5% 降到 7.3%)。缺陷率(Figure 5):非 sequitur 21.5% 降到 3.3%,泛泛无据断言 35.0% 降到 25.1%,单边表扬 3.6% 降到 1.7%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HelpSteer3(分布内偏好判断) | 原始顺序准确率 Acc (%) | 73.0(Llama-3.1-8B SFT+DPO) | 63.9(Llama-3.1-8B 基座) | +9.1 |
| HelpSteer3(分布内偏好判断) | 位置一致准确率 PCA (%) | 60.0(Llama)/ 62.9(Qwen) | 45.2 / 53.6(对应基座) | +14.8 / +9.3 |
| RM-Bench(分布外) | Overall 准确率 (%) | 76.2(Qwen3-8B,开源裁判最佳) | 73.5(同数据 outcome-only) | +2.7 |
| JudgeBench(分布外) | 位置一致准确率 (%) | 52.0(Qwen3-8B) | 48.3(同数据 outcome-only) | +3.7 |
| HelpSteer3-Atomic 理由质量 | RationaleRM 式平均精度 AP | 0.2624(多语言 0.3589) | 0.2212 / 0.2973(去掉理由偏好对) | +0.0412 / +0.0616 |
| 反事实证据敏感性(1k 最小编辑样本) | 证据适配率 EAR (%) | 88.9(Llama) | 64.5(基座) | +24.4 |
局限与改进
作者在 Limitations 节承认三点:证书评估依赖 LLM 分析器,抽取的议题受分析器可靠性与偏差影响;实验只覆盖成对偏好判断、两个 8B 模型家族和有限基准,更大模型与其他评判场景是否同样有效未验证;理由质量分析只评估了解释本身的质量与证据敏感性,并未证明理由忠实反映模型的潜在决策过程。我自己的观察还有几点:第一,Qwen3-8B 的 SFT-only 版在 STEM 领域 PCA 反而下降 3.7 点(53.1 到 49.4),说明证书信号在强基座上并非处处为正;第二,Llama 在 JudgeBench Code 上仅从 19.0 升到 23.8,深度代码推理的短板基本没补上;第三,残余缺陷中「泛泛而无根据的正确性断言」仍是最高频(25.1%),证据落地仍不充分;第四,每实例 8 次采样(含 3 次 GPT-4o 调用)外加逐主张 NLI 检查与分析器调用,数据构造的金钱与工程成本不低;第五,找不到可验证议题的实例被排除在理由监督之外,监督覆盖率受任务类型制约。
独立分析的弱点
第一,监督信号质量受上游组件制约:NLI 验证器和 LLM 分析器本身会出错,若分析器系统性漏抽某类议题,Coverage 就会系统性偏置,错误还会经 $q_j$ 传播污染全部分数;改进方向是多个分析器交叉验证与人工抽检校准。第二,一对一匹配依赖语义对齐能力,主张与议题表述差异大时会匹配失败而低估 Coverage,可改用带折扣的软匹配。第三,成本结构不友好:12k 实例需 3 万次 GPT-4o 候选生成加大量 NLI/分析器调用,可探索用已训好的裁判自采样滚动迭代,或用小型开源验证器替代。第四,成对设定限制了应用面,榜单式(listwise)评测与多回答排序未覆盖,可把 $I_k(r)$ 区间推理推广到排序可行集。第五,位置鲁棒性提升是副产品,论文未刻画其边界,在回答长度差异极大或风格差异极强的样本上是否仍成立需要压力测试。第六,$S_{dec}$ 依赖评估策略 $K(\xi)$ 提供准则与权重 $\omega_k$,在策略缺失或权重不当的真实场景中可能退化成噪声。
未来方向
作者提出的方向包括扩展到更大模型与更多评判设定。基于本文成果还能延伸:一是把 DECERT 裁判接入真实 RLHF 流水线做端到端验证——论文证明了静态基准上的裁判质量,但 RationaleRM 指出的「静态高分、RL 阶段失效」问题需要在策略优化中复检;二是把反事实证据敏感性协议(EAR/SRR)本身变成训练信号,主动构造最小编辑样本逼迫理由更新,而不是只在评测时使用;三是研究理由对模型潜在决策过程的忠实性,用干预或探针方法检验「理由是否解释了模型为何这样判」,这是作者承认尚未回答的问题;四是让分析器自举——用训练后裁判与人工校验结果反馈微调议题抽取器和 NLI 验证器,降低对 GPT-4o 的依赖;五是针对残余的泛泛无据断言(仍占 25.1%),引入引用定位、可执行验证(代码运行、检索核查)强化证据落地;六是把证书维度扩展到安全、事实性、长文本一致性等更多准则类型,考察 $S_{dec}$ 在强约束策略下的行为。
复现评估
复现条件总体友好。代码和模型已在 GitHub(UConn-DSIS/DeCert)开源;训练数据基于公开的 HelpSteer3-Preference,评测用的 HelpSteer3、RM-Bench、JudgeBench、HelpSteer3-Atomic 均为公开基准;论文附录提供了主张抽取器细节(A)、一对一匹配与区间构造(A.3/A.4)、训练配置(B.2)、阈值 $\delta$ 选择与几何平均对比实验(C.1/C.2)等实现细节。主要门槛在数据构造阶段:每实例需 3 条 GPT-4o 候选(API 费用)加逐主张 NLI 分析的多次推理,约 12k 实例需要一定预算;模型训练本身是 8B 级 LoRA 的 SFT+DPO,单卡或少量消费级/工作站 GPU 即可完成。难度评估为中等:管线组件多(抽取、NLI、分析器、配对、两阶段训练)但依赖都公开,最大的不确定性是各 LLM 组件的提示词与模型版本——若仓库未附带完整提示词,Soundness/Coverage 的绝对数值可能与论文有出入,不过相对结论(理由偏好对带来增益)应当稳健。
论文图表
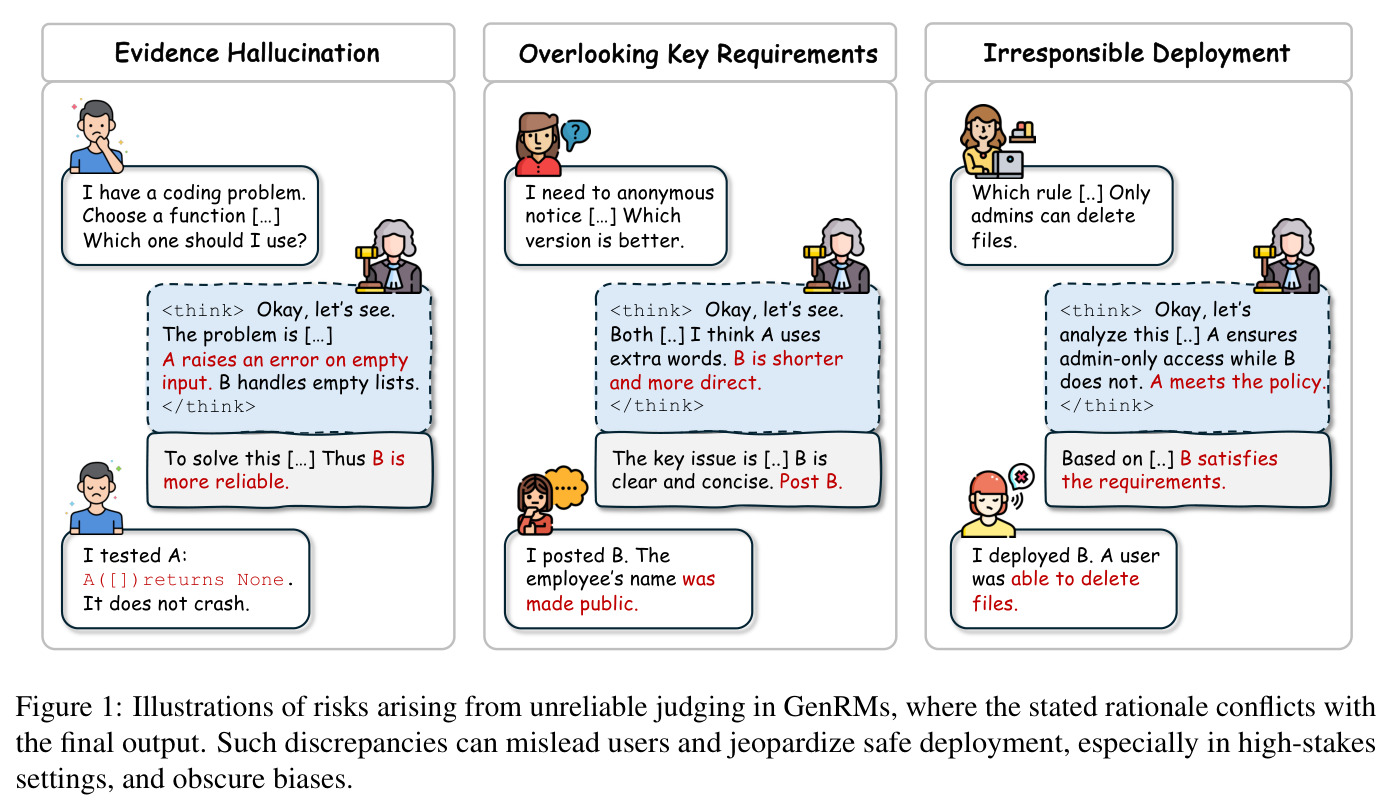
三列并排展示三类不可靠判断的真实风险:证据幻觉(理由声称测试过 A 函数在空输入下返回 None,结论却推荐了相反选项)、忽略关键需求(比较匿名化通知功能时只谈用词多少,无视隐私这一决定性问题)、不负责任部署(推理中承认只有 A 满足管理员权限策略,最终却推荐 B,导致普通用户能删除文件)。
这是全文问题的具象化:GenRMs 的裁决与理由可能脱节,而仅监督裁决无法发现这类缺陷,直接引出 Soundness、Coverage、Decision Support 三个审计维度的动机。