Manga2Animate:基于脚本与分镜规划的多智能体忠实漫画动画化框架 Manga2Animate: An Agentic Framework for Faithful Manga Animation with Script and Storyboard Planning
把漫画先转成脚本和分镜两份“计划”并对照原格反复审校,再交视频模型生成忠实动画
前置知识
Creator–Reviewer 多智能体精炼循环
一种智能体协作模式:每个生成阶段配一个创作者(creator)负责产出候选结果,一个审校者(reviewer)负责按明确标准评审候选、选出最佳并给出改进反馈,反馈再喂给下一轮创作者,形成“生成—评审—修订”的迭代循环。它借鉴了 Self-Refine、Reflexion 等语言智能体的自我反馈思想,用多个候选 + 择优 + 反馈来抑制单次生成的随机错误。
本文整个框架就是三个阶段各配一对 creator/reviewer,理解这个循环的输入输出是看懂方法的前提。
中间表示与任务分解(脚本 + 分镜规划)
把端到端的困难生成任务拆成若干中间产物,让每一步只解决一个问题。本文借鉴真实动画工作室流程,把“漫画页→视频”分解为动画脚本 S(文字规格,规定每格的场景、镜头、角色动作、对白)和视觉分镜 B(图像规格,规定每个镜头的外观与构图)两级中间表示,再由视频模型照计划生成,避免模型直接面对原始漫画。
“先规划再生成”是全文的核心思想,脚本与分镜的分工和对应关系贯穿方法与消融实验。
图生视频(I2V)与参考条件多镜头生成
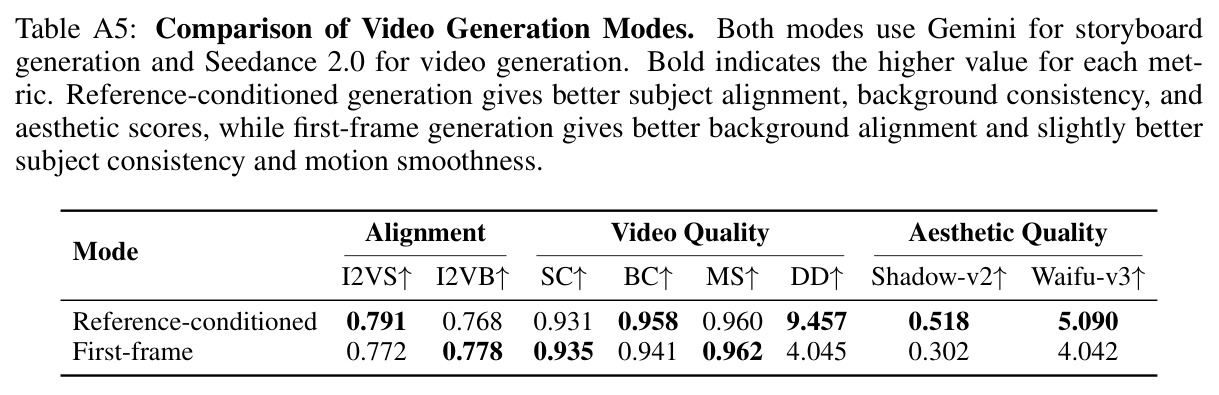
视频扩散模型的两类条件方式:首帧模式(first-frame)把一张图作为视频第一帧、逐段生成再拼接;参考条件模式(reference-conditioned)把完整分镜网格作为参考图、配合完整文本提示一次性生成多镜头视频。本文不训练任何视频模型,而是把现有模型当作可替换后端,Seedance 2.0、MiniMax-H3 走参考条件模式,Index-AniSora 走首帧模式。
理解两种模式才能明白视频生成阶段的接口设计,以及消融中两种模式的指标差异。
漫画理解预处理(面板检测、阅读顺序、OCR)
日本漫画页面布局非规则(分格大小不一、从右到左阅读),机器要先检测出每个分格(panel)、推断阅读顺序、识别对话气泡中的文字。本文使用 Sachdeva & Zisserman 的 MAGI 模型完成这三件事,输出有序分格序列和全篇台词转录,作为后续所有阶段的输入。
预处理质量决定整个流水线上限,阅读顺序错误会让后续所有“忠实”努力建立在错误的叙事序列上。
VBench++ / ViStoryBench 系评估指标
视频生成与故事可视化的自动评测体系:I2VS/I2VB 用 DINOv3/DreamSim 特征度量生成帧与参考图(角色/源漫画格)的相似度;SC/BC 度量帧间主体与背景的时序一致性;MS 基于帧插值度量运动平滑度;DD 原为二值运动幅度判定,本文改为基于 RAFT 光流的连续分数;CIDS/CSD/PA/OCCM 来自 ViStoryBench,度量分镜的角色身份、风格与内容对齐。
论文所有定量结论都用 MangaEval(对上述指标的改编)表达,不懂指标定义就看不懂实验表。
研究动机
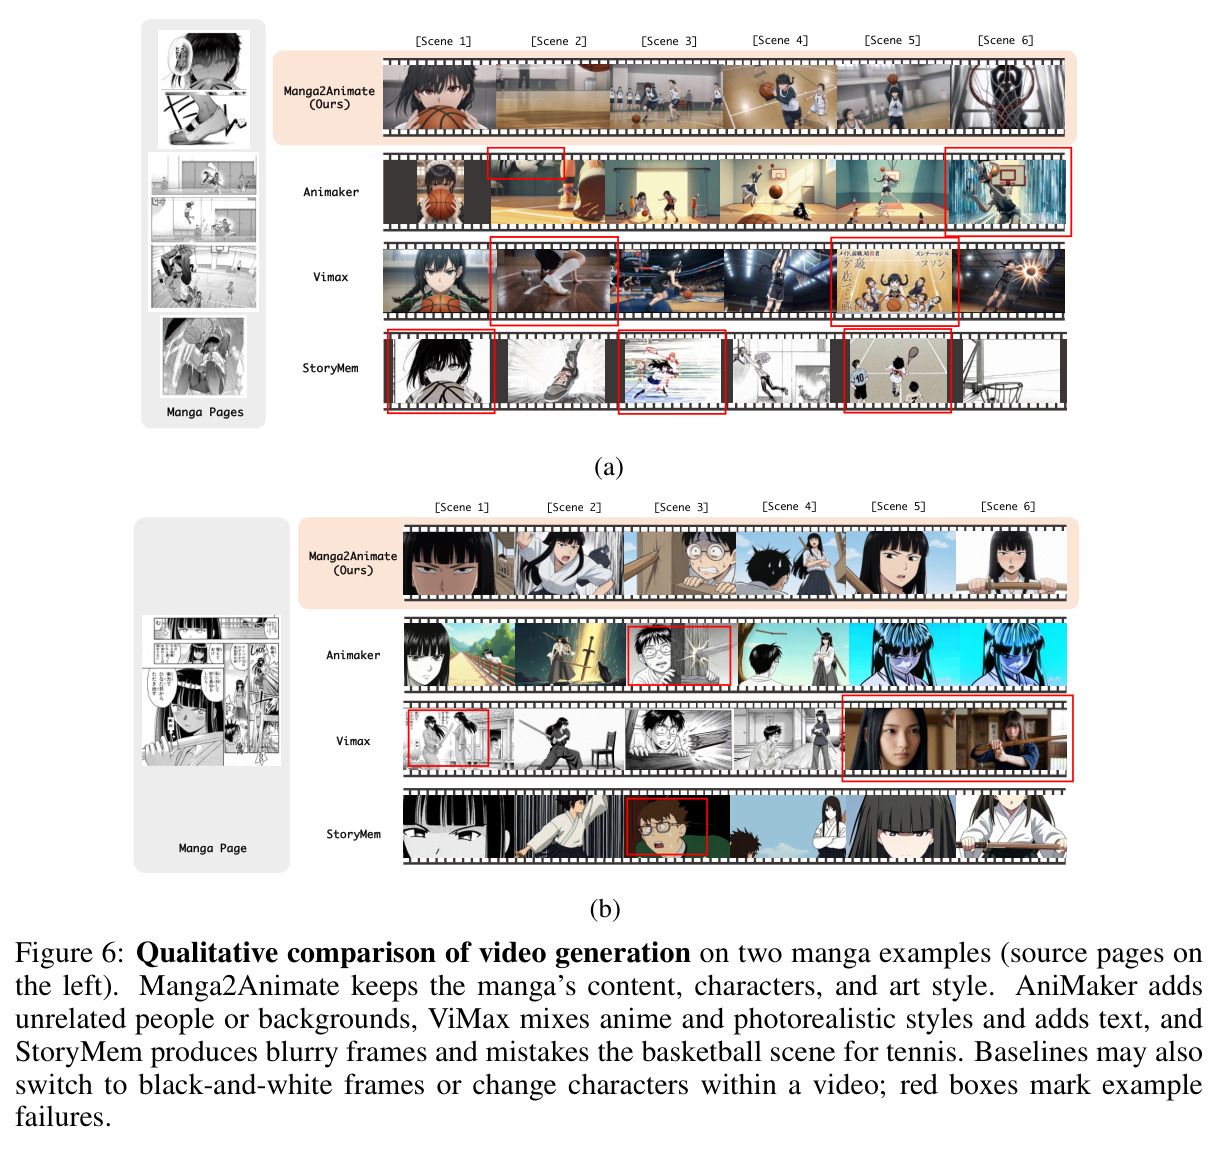
把一部漫画改编成动画,传统上需要大型团队花数月做分镜、原画、中割和上色,因此自动改编极具价值。但现有两条技术路线都在“读懂漫画”这一步失败。第一条是文本中介式的故事讲述系统(AniMaker、ViMax、StoryMem):它们先把漫画转成文字描述再生成视频,而文字无法携带画风信息,导致原作美术风格丢失,角色还会在动漫与照片写实风格之间漂移、五官变形(Figure 2 的失败模式❶❷)。第二条是直接把漫画页喂给视频生成模型(如 Seedance 2.0、MiniMax-H3):这类模型不懂漫画的阅读顺序(从右到左、非规则分格布局),也不理解对话气泡是“台词”而非画面元素,结果要么讲述完全错误的故事线(❸),要么直接把漫画格子甚至整页当成视频帧渲染进成片(❹)。换句话说,能保画风的讲不对故事,能讲故事的保不住画风——两个失败模式互斥,此前没有方法能同时做到忠实与连贯。
本文的目标是本文目标是构建首个能把已有漫画页自动改编成多镜头动画、且忠实于源漫画的框架。“忠实”具体落在三个维度:剧情与原作一致、角色身份与画风保持原貌、镜头之间流畅连贯。作者刻意不训练新的视频模型,而是让框架与底层生成器解耦——既能接闭源商用后端(Gemini 系 + Seedance 2.0),也能接开源后端(FLUX.2-dev + MiniMax-H3 / Index-AniSora),并在两种配置下都超越基线。由于“漫画→动画”此前没有评测标准,论文还建立了 MangaEval 评估协议(改编自 ViStoryBench 与 VBench++),覆盖分镜级的风格一致性(CSD)、角色身份(CIDS)、内容对齐(PA)、在场人数匹配(OCCM)与视频级的主体/背景对齐(I2VS/I2VB)、主体/背景一致性(SC/BC)、运动平滑度(MS)、动度(DD)及两个动漫专用美学分,另以 37 人用户研究交叉验证。
与已有工作不同的是,作者的关键观察是:今天的视频生成模型其实已经“会动”——给定漫画页也能产出流畅美观的运动,但它们“不懂漫画”:不知道分格阅读顺序、看不懂对话气泡。因此与其替换这些模型,不如补上它们缺失的漫画理解。这个视角决定了本文的独特切入:保留视频模型的全部视觉知识,只给它一份“忠实于原作的拍摄计划”,让模型专心做它擅长的事。与既有 agentic storytelling 系统(StoryAgent、AniMaker 等 creator–critic 架构)相比,那些系统从一句提示词出发凭空发明角色、镜头和剧情,审校者只能拿输出和自己的脚本对照,本质是自我检查;本文的审校者拿生成结果与源漫画格逐一核对,是外部事实锚定。此外,更早的漫画→动画工作(如 Cao et al. 2016 的动态漫画)只是让虚拟相机在静态页面上平移或加配音,从未真正生成多镜头动画——本文在该任务上是第一个。
核心方法
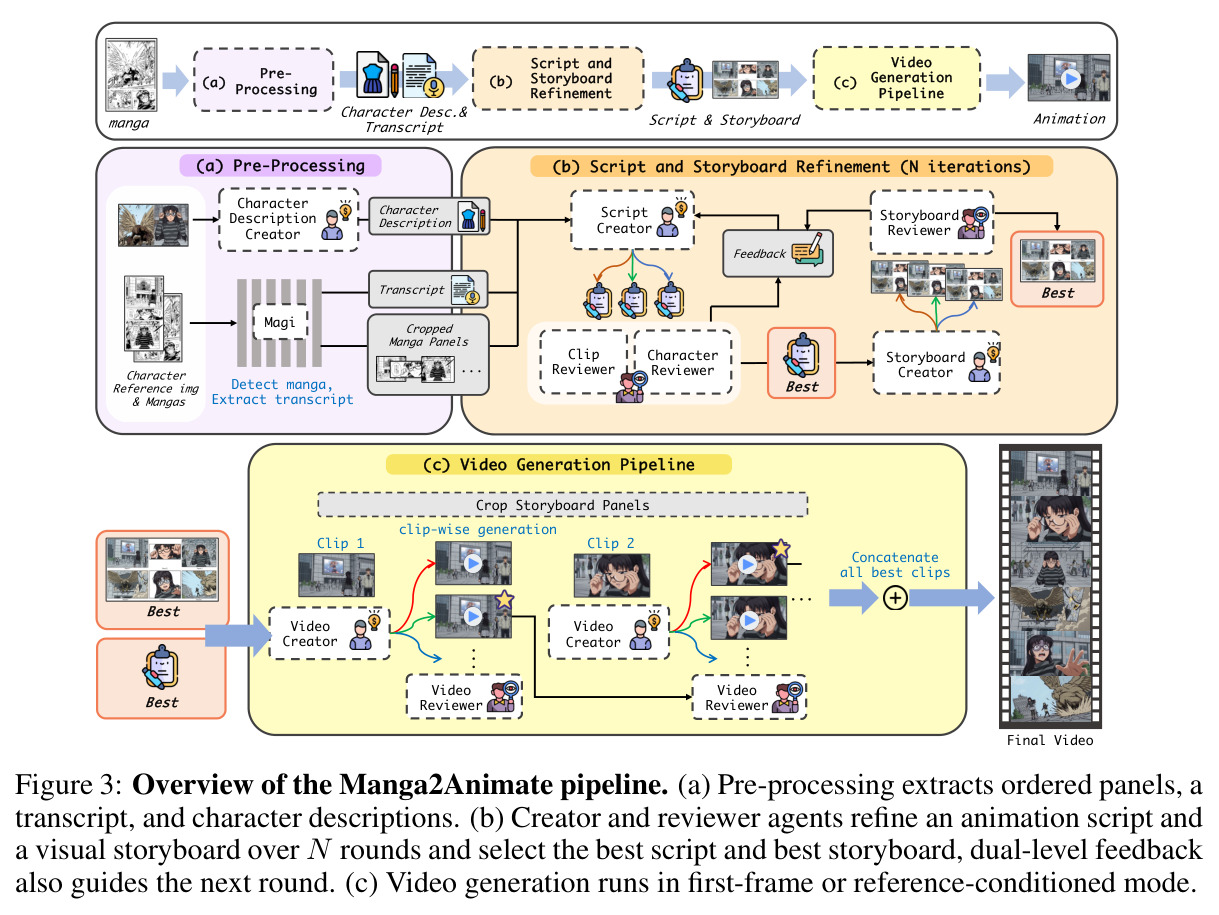
方法直觉完全类比真实动画工作室的生产流程:先写剧本(script),再把剧本画成分镜(storyboard),最后才进入拍摄(视频生成)。漫画本身已经规定了动画所需的大部分信息——角色是谁、长什么样、每个镜头如何取景、剧情如何展开——所以流水线的任务是把“漫画页”翻译成视频模型能正确消费的规格说明,而不是让模型自己猜。技术上分三阶段:(a) 预处理:用漫画专用模型 MAGI 检测分格、推断阅读顺序、OCR 转录台词,并由角色描述智能体从参考图提炼稳定的外观特征;(b) 脚本与分镜精炼:创作者(creator)与审校者(reviewer)两类智能体迭代 $N=2$ 轮——脚本创作者每轮产出 $N_s=3$ 份候选脚本,脚本审校者逐格择优重组并给出反馈;分镜创作者产出 $N_b=3$ 份候选分镜,分镜审校者对照脚本与源漫画格整图评选;(c) 视频生成:支持首帧模式(每个分镜格作为对应片段首帧,逐段生成 $N_v=2$ 个候选贪心择优后拼接)与参考条件模式(完整脚本 + 整张分镜网格一次生成多镜头视频,二选一),主结果采用后者。整条流水线中漫画格 $p_i$、脚本片段 $s_i$、分镜格 $b_i$ 始终一一对应,任何组件都能回溯到源漫画格接受审查。
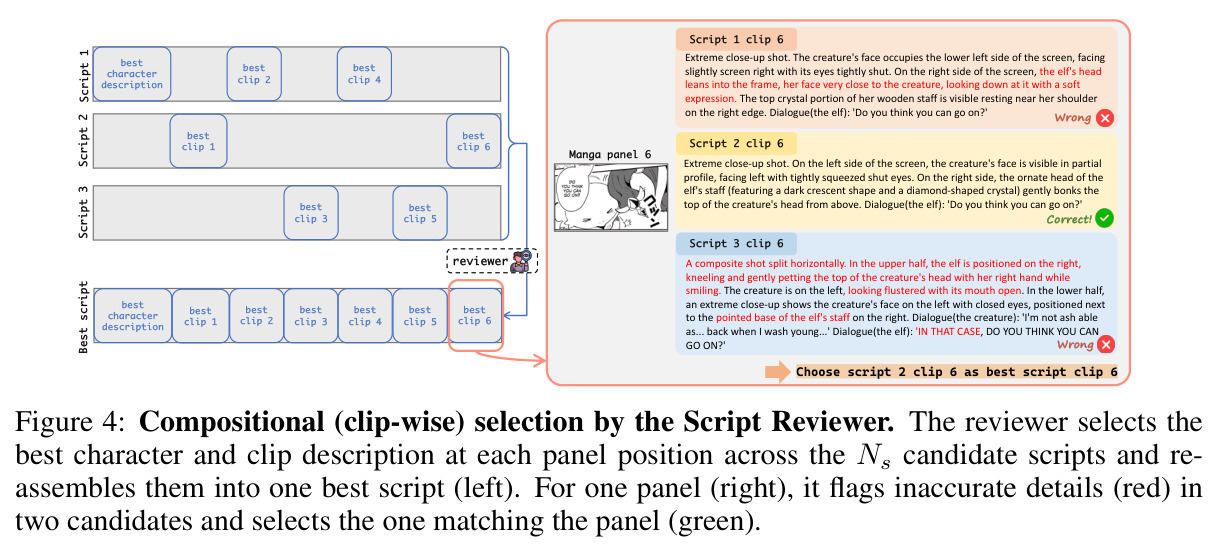
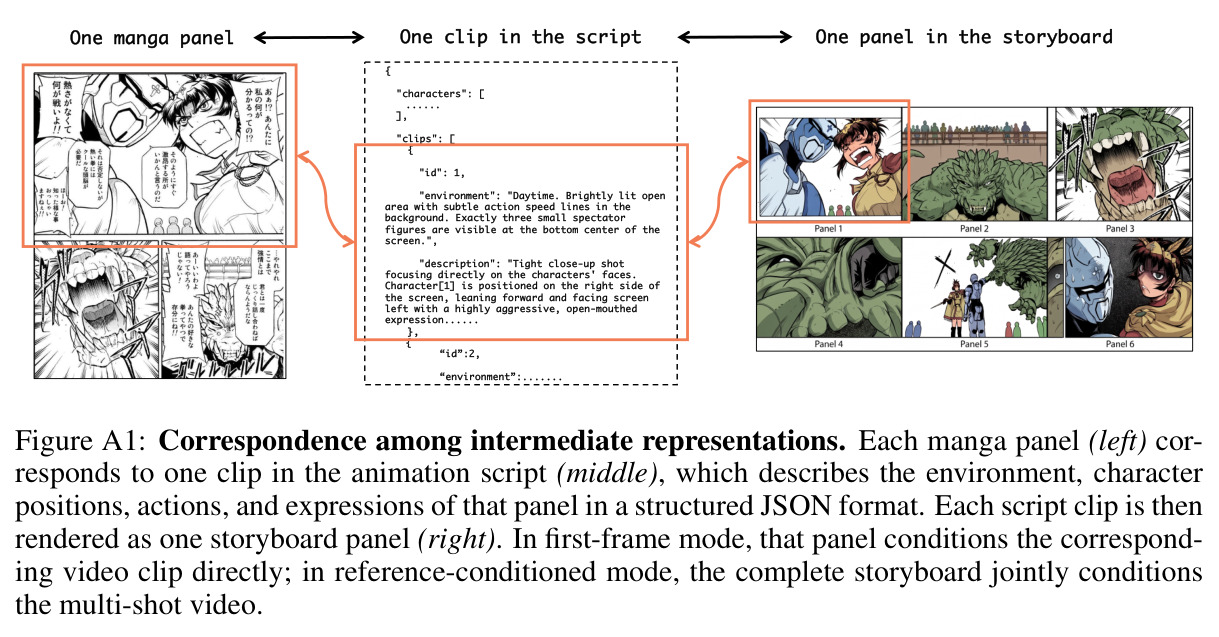
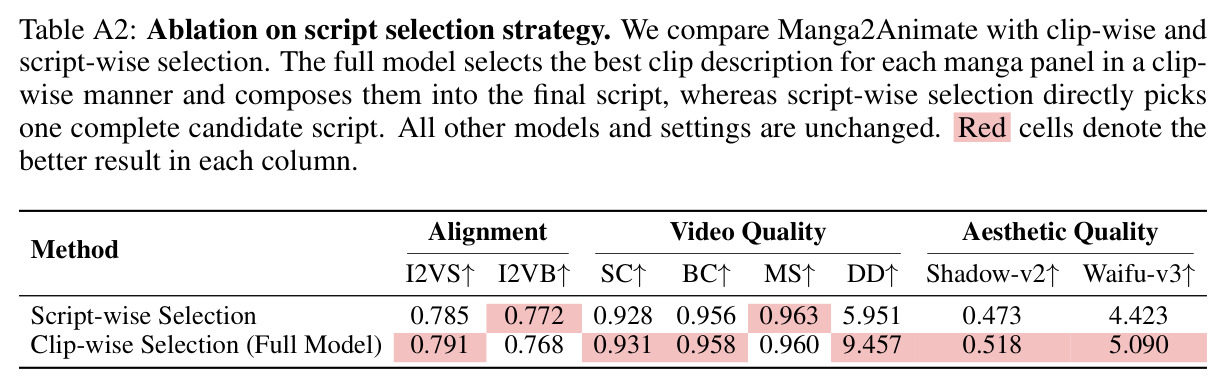
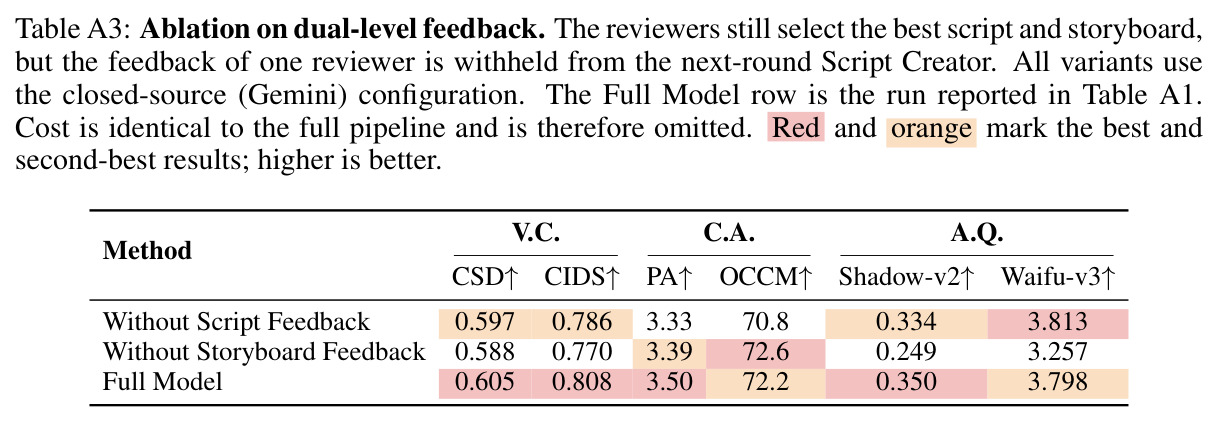
核心创新有三点环环相扣。第一,双中间表示 + 严格对齐:把任务分解为动画脚本 S 和视觉分镜 B,脚本定剧情与对白,分镜定外观、构图与画风,并维持 $p_i \leftrightarrow s_i \leftrightarrow b_i$ 的显式对应(Figure A1),使“忠实”从一个愿望变成一个可检查的性质。第二,表示专属的选择策略:作者发现脚本的错误大多是局部的——某一格可能写得很准而另一格读错,且不同候选往往犯不同的错,整份挑选会丢掉其他候选里的正确描述,因此脚本审校者做组合式(clip-wise)选择,在每个格位挑最佳描述再拼成最佳脚本(Figure 4);而分镜各格由图像模型联合生成、共享风格色彩光影,跨候选重组会引入视觉不一致,所以分镜必须整图评选——两种表示失败方式不同,选择粒度也应不同。第三,双层反馈:下一轮脚本创作者同时收到脚本级与分镜级反馈,分镜审校者发现的问题被视为脚本描述含糊或不准确的“症状”回流给脚本作者定位修订;为避免误伤已正确的内容,只修改被明确标记有问题的片段,多源反馈冲突时以源漫画格为最终裁决。消融证明两层反馈互补:去掉任一层,CIDS 都从 0.808 掉到 0.786 或 0.770。
方法步骤详情
第一步预处理:输入原始漫画页,MAGI 输出有序分格序列(实验中每故事 6 格)与全篇台词转录;角色描述创作者从参考图 R(优先官方彩色设定图,否则从漫画裁剪清晰出现)提取身份定义特征(五官、发型、体型),刻意排除服装配饰等易变属性,输出角色描述 D 供下游保持角色一致。第二步脚本精炼:脚本创作者以漫画格、角色描述、转录文本(第二轮起再加双层反馈与上轮最佳脚本)为条件生成 3 份候选脚本,每份按格结构化描述场景、镜头、角色位置动作、表情与对白;脚本审校者含角色审校(服装、外貌、颜色、不对称特征左右四项标准)与片段审校(小物件、表情、背景、物体朝向、身体朝向空间关系、说话人指派六项标准)两级,在每个格位独立评审择优重组为最佳脚本,剩余弱点记为反馈。第三步分镜精炼:分镜创作者依据入选脚本生成 3 份 3×2 网格分镜(闭源用 gemini-3.1-flash-image,1376×768;开源 FLUX.2-dev 因无法一次生成完整高质量分镜,改为逐格以源格为条件生成 3 候选、按 0–4 分四项标准评分择优再合成网格);分镜审校者按 13 项标准(角色身份保持、画风一致、彩色、无对话框、叙事顺序、背景与位置跨格一致等)第一轮两两对比、之后与现任最佳对比,新候选未胜出则连同其脚本一并保留旧最佳。第四步视频生成:参考条件模式下 Seedance 2.0 以完整脚本为文本提示、整张分镜网格为参考图,一次生成 15 秒 1280×720/24fps 带音频的视频,生成 2 个候选由视频审校者按视觉真实性 0.35、物理常识 0.30、提示对齐 0.35 加权评分,违反硬约束(主体突现消失、无谓转场、异常速度)罚 0.5,加权分差小于 0.05 判为相当取前者;首帧模式则逐段以分镜格为首帧生成、审校时额外加入与前一已选片段的连贯性权重 0.4,最后按故事顺序拼接。
技术新颖性
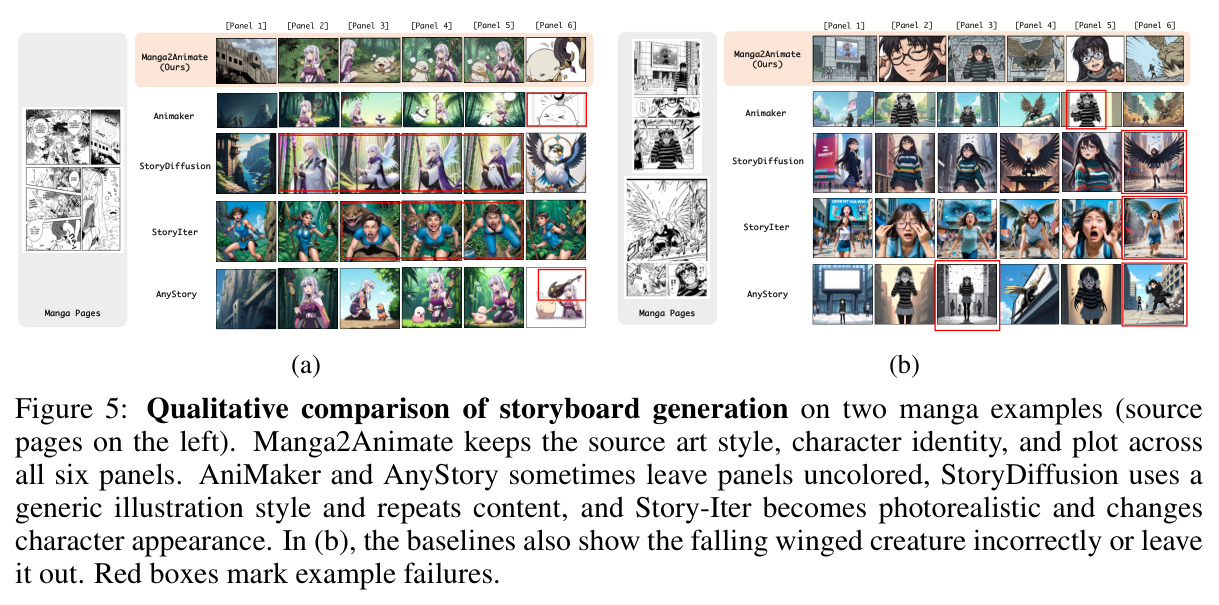
与三个相邻方向的本质区别决定了其新颖性。对 agentic storytelling(StoryAgent、AniMaker、ViMax 等 creator–critic 系统):它们的审校只能拿输出对照自己写的脚本,角色镜头剧情全凭提示词发明;本文审校以漫画格为 ground truth,把“自我反馈”升级为“外部证据反馈”。对 story visualization(StoryDiffusion、AnyStory、Story-Iter):它们从纯文本自由生成,视觉记忆/共享注意力只保证自身内部一致,不保证与源一致;本文分镜以漫画格为条件生成并对照择优。对多镜头视频生成(长上下文微调、关键帧记忆、参考身份注入等):一致性来自模型架构或训练,本文则与“显式状态与生成渲染解耦”的思路一脉相承,用审校过的脚本 + 分镜这一显式计划获得一致性,因而完全模型无关——同一框架在闭源(Gemini+Seedance)与开源(FLUX.2+MiniMax-H3/AniSora)后端上都有效。机制层面,clip-wise 组合式脚本选择与“分镜级问题回流脚本”的双层反馈,都是针对漫画改编任务特性定制的新设计。评估侧同样有贡献:MangaEval 把 ViStoryBench/VBench++ 指标改造到漫画输入场景,例如在场人数匹配 $\mathrm{OCCM}=100\cdot\exp\!\left(-\frac{|D-E|}{\epsilon+\max(E,1)}\right)$ 的期望人数 $E$ 改为对源漫画格跑检测器获得,并换用 GPT-4.1 而非自家审校模型打 PA 以避免自偏好。
实验结果
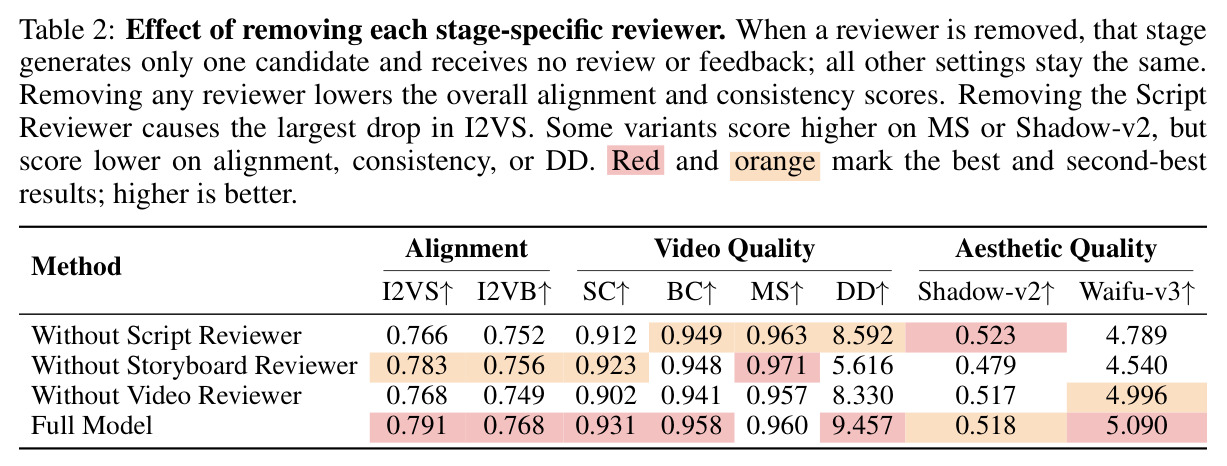
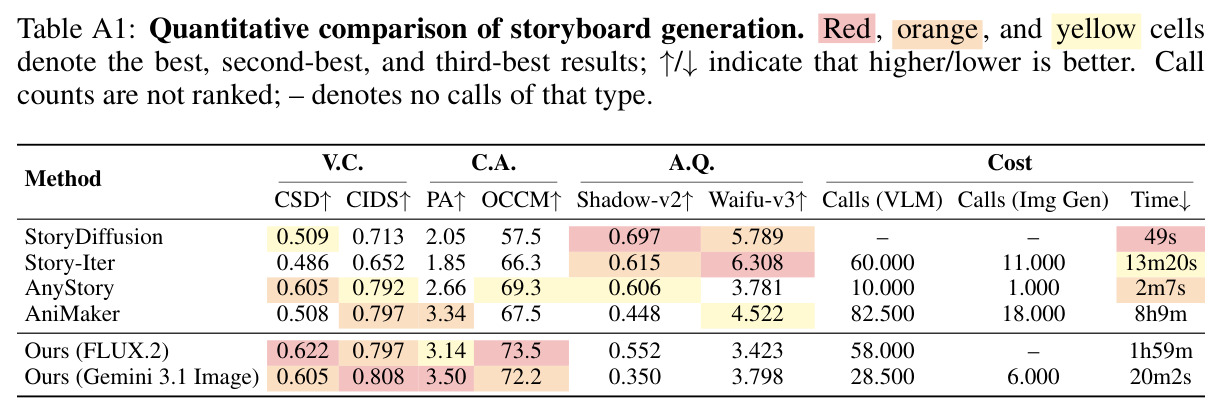
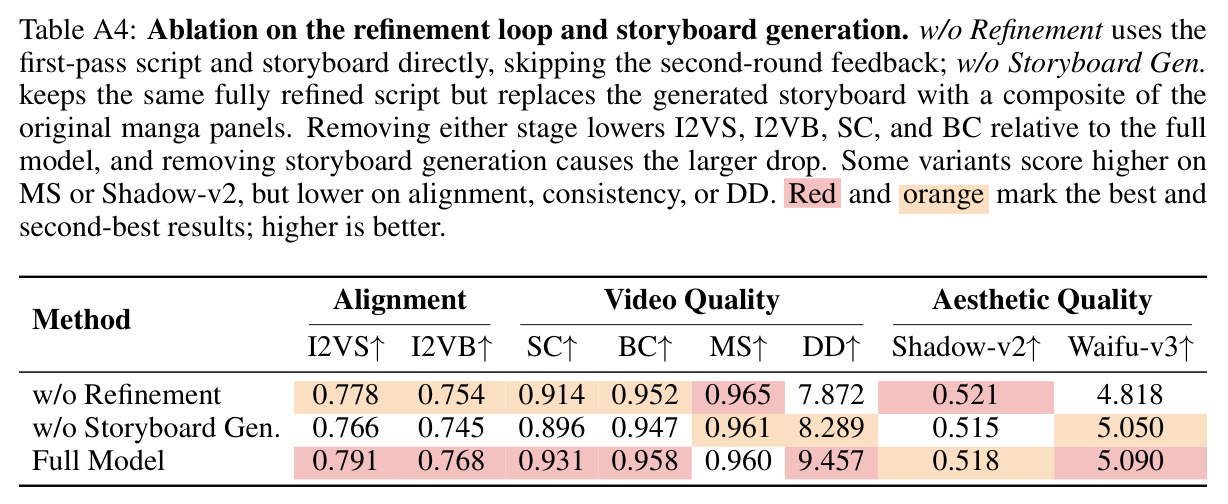
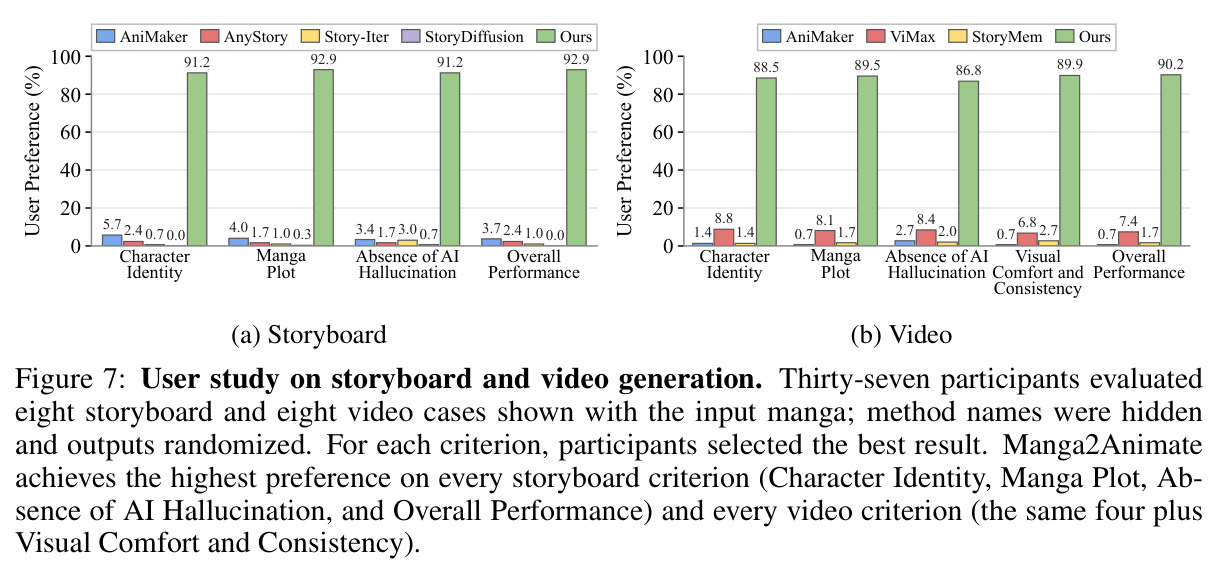
视频主结果(Table 1,Gemini+Seedance 2.0 主设置):Manga2Animate 在对齐与一致性上全面领先——I2VS 0.791(AniMaker 0.775、ViMax+Seedance 0.753、StoryMem 0.728)、I2VB 0.768(StoryMem 仅 0.731)、SC 0.931、BC 0.958,动漫美学 Shadow-v2 0.518 与 Waifu-v3 5.090 亦为最高;端到端耗时 24m49s,远低于 AniMaker 的 8h9m。换后端结论不变:FLUX.2+MiniMax-H3 达 I2VS 0.794、SC 0.943、Shadow-v2 0.549,Gemini+MiniMax-H3 达 I2VB 0.791,证明提升来自脚本/分镜/审校流程而非特定模型。所有脚本类基线都拿到了与本文相同的精炼脚本和角色参考图,差距纯来自“是否有漫画锚定的规划”。直接把漫画页喂视频模型虽然 DD 最高(11.787/13.941),但会动画化页面布局或做错动作——DD 只度量运动量而非运动正确性。分镜结果(Table A1):两种后端包揽四项忠实度指标第一——FLUX.2 后端 CSD 0.622、OCCM 73.5 最高,Gemini 后端 CIDS 0.808、PA 3.50 最高;StoryDiffusion/Story-Iter 美学分虽高(Waifu-v3 5.789/6.308)但忠实度垫底,说明画面美感与改编忠实是两个独立维度。用户研究:37 名参与者在方法名隐藏、输出随机顺序下评选 8 个分镜 + 8 个视频案例,本文在每个标准上偏好率都最高,总体表现获超 90% 选择。消融方面:去掉任一审校者都降低对齐与一致性,去脚本审校者 I2VS 跌幅最大(0.791→0.766,Table 2);clip-wise 选择把 Waifu-v3 从 4.423 提到 5.090、DD 从 5.951 提到 9.457(Table A2);去掉任一层反馈,CIDS 从 0.808 降到 0.786/0.770(Table A3);去掉分镜生成一步(直接用漫画格当分镜)I2VS 跌到 0.766,比跳过第二轮精炼(0.778)跌得更狠(Table A4),说明“把漫画格重画成动画风格分镜”比反馈循环更关键;参考条件模式在 I2VS/BC/美学上优于首帧模式,但首帧模式 I2VB 更高(0.778 vs 0.768,Table A5)。
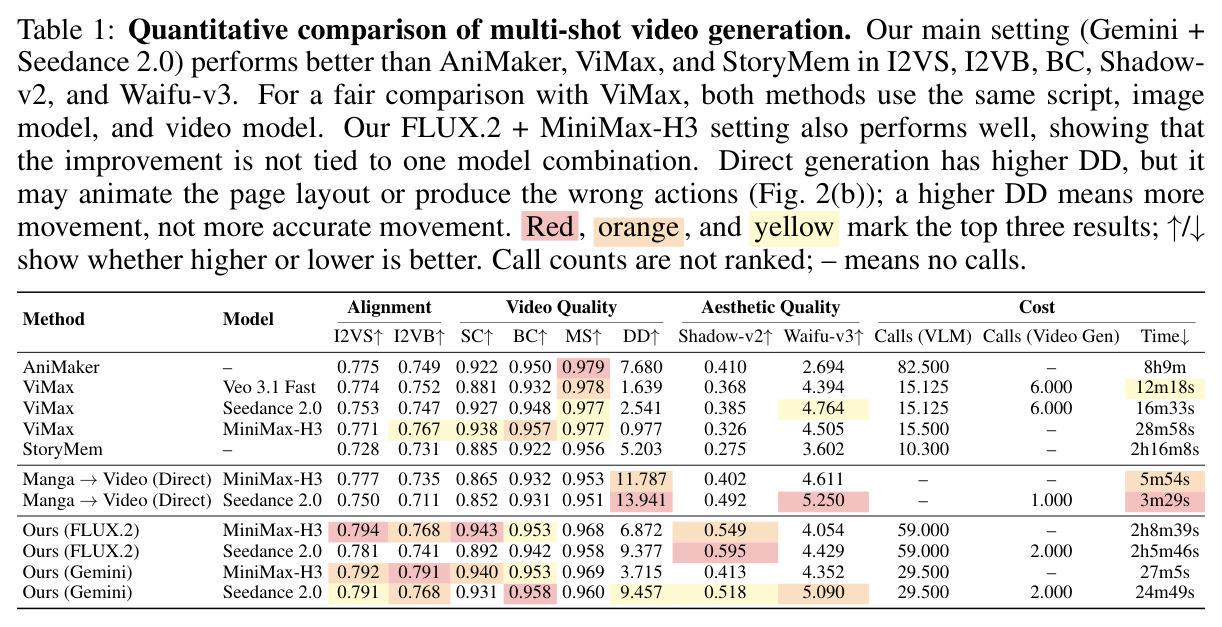
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 漫画→视频主体对齐 | I2VS(DINOv3 特征,1 为最优) | 0.791(Gemini+Seedance 2.0) | AniMaker 0.775;ViMax(Seedance) 0.753;StoryMem 0.728 | 较最强基线 +0.016,较 StoryMem +0.063 |
| 漫画→视频背景对齐 | I2VB(DreamSim 特征) | 0.768 | ViMax(MiniMax-H3) 0.767;StoryMem 0.731 | 较 StoryMem +0.037,基本持平最强基线 |
| 视频跨片段背景一致性 | BC(VBench++) | 0.958 | AniMaker 0.950;ViMax 0.932–0.957 | +0.001–0.026 |
| 动漫美学质量(视频) | Shadow-v2 / Waifu-v3 | 0.518 / 5.090 | 直接生成 Shadow-v2 最高 0.492;ViMax Waifu-v3 最高 4.764 | 两项均为全场最高 |
| 分镜风格一致性 | CSD(ViStoryBench) | 0.622(FLUX.2 后端) | AnyStory 0.605;StoryDiffusion 0.509 | +0.017 |
| 分镜角色身份保持 | CIDS(SigLIP 特征) | 0.808(Gemini 后端) | AniMaker 0.797;AnyStory 0.792 | +0.011 |
| 分镜内容对齐(基线共用同一脚本) | PA(GPT-4.1 评分,0–4) | 3.50 | AniMaker 3.34;AnyStory 2.66 | +0.16 |
| 分镜在场人数匹配 | OCCM(对源漫画格检测期望人数) | 73.5 | AnyStory 69.3;Story-Iter 66.3 | +4.2 |
| 用户研究总体偏好 | Overall 最佳选择占比 | 分镜 92.9%、视频约 90% | 分镜最强基线 91.2%;视频最强基线 89.5% | 全部六个标准上均为第一 |
| 计算成本 | 端到端耗时 / 每故事费用 | 24m49s;约 5.65 美元(其中 Seedance 4.55 美元) | AniMaker 8h9m;ViMax(Seedance) 16m33s | 比 AniMaker 快约 20 倍,费用量级低于多智能体基线 |
局限与改进
作者承认三条局限:其一,作为建立在随机生成模型上的智能体流水线,同一输入多次运行的结果可能不同,缺乏确定性保证;其二,API 化的商用模型可能拒绝生成涉及版权或政策敏感的内容,改编知名商业漫画时可能被拦截;其三,当源漫画画风非常潦草、画面杂乱、构图复杂,或某个镜头的含义依赖故事其他部分的上下文时,流水线会误读分格内容。我的补充观察:评测集只有 8 个故事、每个固定 6 格(来自 Manga109 与自选案例),规模太小,I2VS +0.016 这类差异的统计显著性存疑;角色参考图在可用时取自“官方彩色设定图”,等于给系统注入了源漫画之外的补充信息(尽管基线也拿到了同样的参考图仍落后);成片固定 15 秒,尚未验证一章几十格场景下的误差累积;全程依赖 VLM 审校,而论文自己引用的漫画理解基准表明 VLM 会误读跨格叙事、依赖记忆作答,审校者与创作者可能犯同源错误;对白由视频模型附带音频生成,但没有唇形同步或台词-音频对齐的保障与评测。
独立分析的弱点
第一,预处理是单点故障:MAGI 一旦排错阅读顺序或漏检分格,脚本创作者拿到的就是错误的叙事序列,而所有审校都以“已排序的分格”为事实来源,没有回头质疑排序本身的机制;改进方向是在审校标准中加入顺序一致性校验,低置信时回退人工确认或让多套排序假设并行生成再择优。第二,审校者与创作者同源(都是 VLM),存在共谋失败风险——Figure 4 里审校者能抓到“眼睛紧闭被写错”这类局部细节,但漫画理解基准显示 VLM 对跨格叙事、象征性画面并不可靠,凡遇到需要故事上下文的场景,审校与创作会一起失灵;可引入在漫画数据上微调的专用判别模型,或检索剧情前文做证据增强。第三,成本与闭源依赖:每故事约 5.65 美元,其中 Seedance 占 4.55 美元,主结果全部依赖 Gemini/Seedance 等快速迭代的闭源 API,版本一变复现结果就漂移;开源后端虽可行,但 FLUX.2 路线本地耗时近 2 小时。第四,固定 6 格/15 秒的任务设定回避了真实漫画一章几十格、跨页闪回的难点;分镜固定 3×2 网格也限制了镜头时长与节奏的差异化表达。第五,忠实度评估中 PA 本质上在评“与脚本文本对齐”,对动作时间连续性、镜头衔接节奏、运动是否合理等动画特有问题缺乏度量,DD 的高低也无法区分“动得多”与“动得对”。
未来方向
作者提出的方向:提高对复杂构图或粗糙潦草画风的鲁棒性;开发以源漫画为锚的故事事件级评估——现有 PA 评的是脚本对齐,尚无“叙事事件是否忠实”的度量;把叙事理解扩展到跨页、跨章节。基于其成果可自然延伸的方向:用转录对白驱动唇形同步与配音对齐,把“带音频”升级为“台词可听且对得上口型”;把 reviewer 的成对比较信号收集起来,蒸馏训练一个专用的漫画改编奖励模型,替代昂贵的多轮 API 审校并降低方差;章节级处理时维护跨章角色库与剧情记忆,以支撑闪回、倒叙等需要全局上下文的场景;把框架推广到 webtoon/条漫等竖屏滚动媒介(布局与阅读顺序规则完全不同);以及把 MangaEval 扩充为纳入更多作品、更长故事并配套显著性检验的公开基准。
复现评估
复现难度中等偏高,但论文透明度很高。有利因素:Appendix G 完整列出全部审校者的评审标准与权重(如视频审校的真实性 0.35/物理 0.30/对齐 0.35、违例罚 0.5、平局阈值 0.05),Appendix H 公开所有智能体的完整提示词,超参数明确($N=2$、$N_s=3$、$N_b=3$、$N_v=2$,分镜 3×2 网格 1376×768,视频 15s/24fps),项目页 annchenn.github.io/Manga2Animate/ 有成片展示;评测集是 Manga109 的 8 个故事,MAGI 开源、单卡 RTX A6000 即可运行。不利因素:论文未明确承诺开源代码,流水线胶水逻辑需要自行实现;主结果依赖 gemini-3.7-flash、gemini-3.1-flash-image、Seedance 2.0 等快速迭代的闭源商用版本,数月后可能无法原样调用,指标可比性会随时间漂移;每故事约 5.65 美元,加上十余张消融表的全量复现预计需要数百美元 API 开销;开源路线需 A100 80GB(FLUX.2)与 96GB 级显卡(MiniMax-H3、AniSora)。建议复现者先跑通开源后端(FLUX.2 + MiniMax-H3/AniSora)验证流程,再按需接闭源 API 对齐主表数字。
论文图表
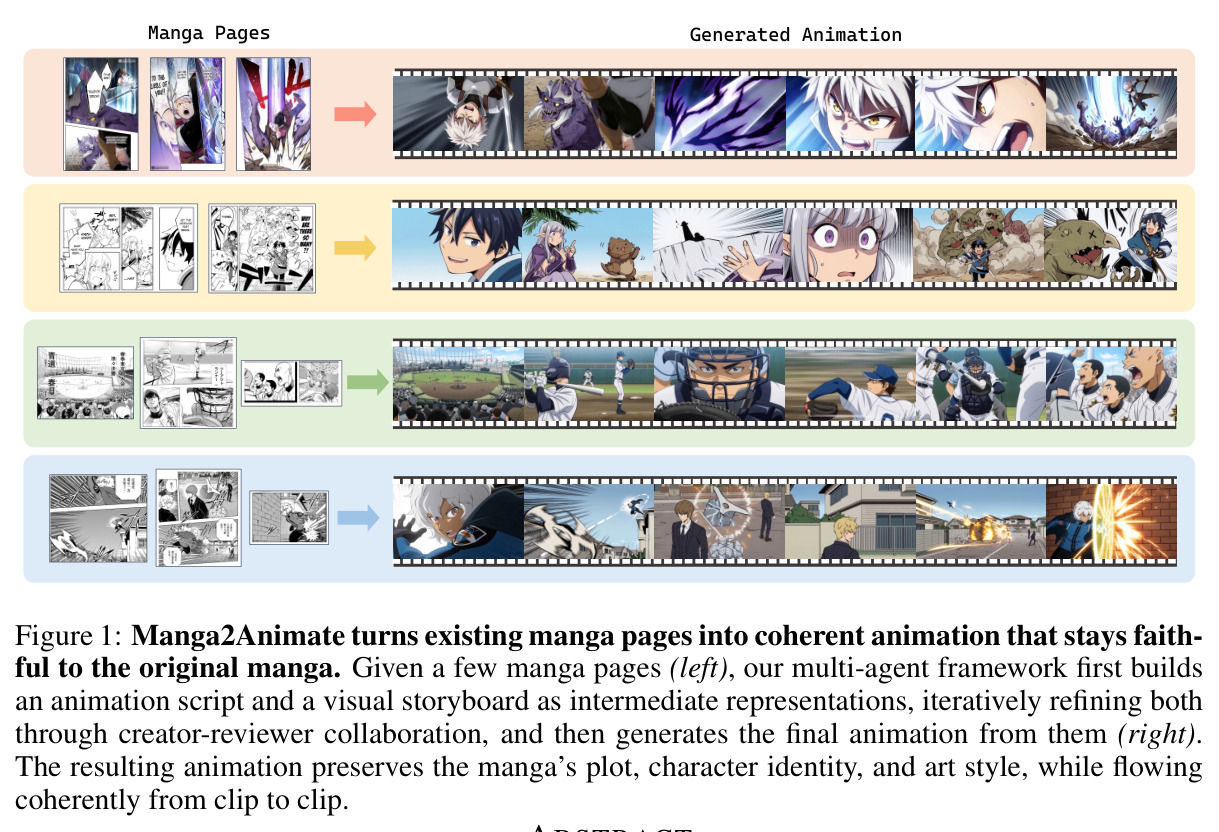
效果总览图:左侧输入少量漫画页,中间是多智能体框架先构建动画脚本和视觉分镜两种中间表示、并通过创作者-审校者协作迭代精炼,右侧输出生成的动画。
一张图讲清整个系统的输入输出与核心思想——以脚本和分镜为中介、忠实还原原作剧情/角色/画风,是论文的 teaser。
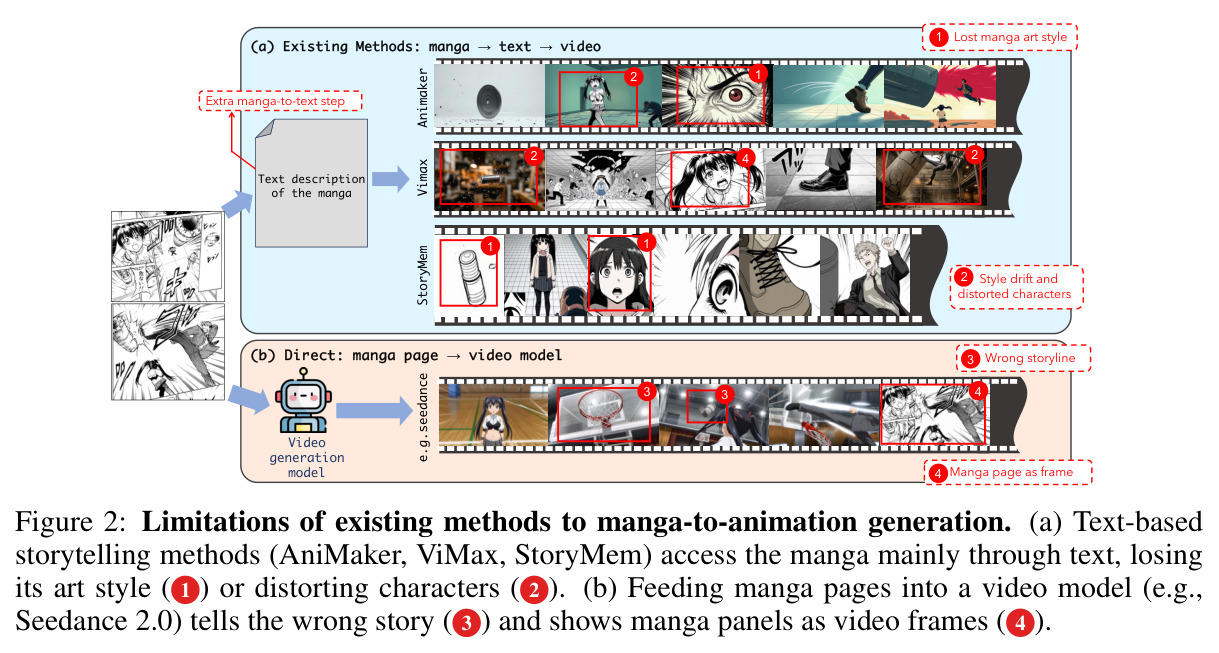
对比两类现有方法的失败模式:(a) 文本中介方法(AniMaker、ViMax、StoryMem)丢失画风❶或导致角色变形与风格漂移❷;(b) 把漫画页直接喂给视频模型(如 Seedance 2.0)会讲错故事❸或把漫画格直接当视频帧❹。
用四种标注清晰的失败模式精确定义了问题空间,是理解“为什么要做双中间表示规划”的动机核心。