AnyGoal:超越专家轨迹的世界模型泛化评测基准 AnyGoal: On World Model Generalization Beyond Expert Rollouts
提出AnyGoal基准,证明世界模型在重组熟悉状态与动作的新目标下系统性失效
前置知识
世界模型(World Model)
学习环境动作条件动力学的模型:给定观测历史 $s_t$ 和动作 $a_t$,预测下一步观测或隐状态 $\hat{T}(s_t,a_t)\approx s_{t+1}$。它不直接输出策略,而是充当环境的可查询模拟器,配合 MPC 等规划器在模型内搜索动作序列。
本文的全部问题是:这样学到的动力学是可复用的,还是只记住了训练时专家的行为偏好?AnyGoal 正是为此设计的压力测试。
JEPA 与生成式世界模型
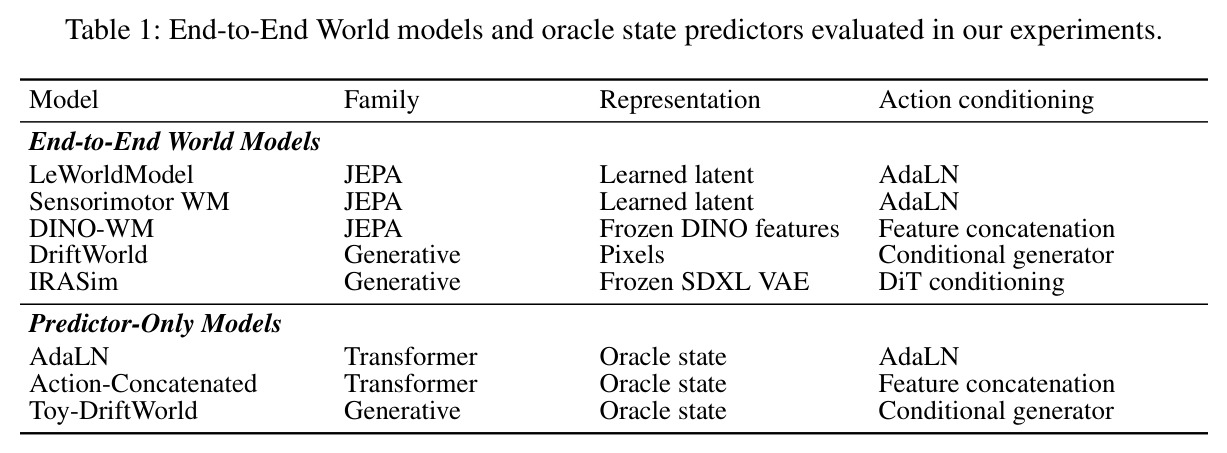
JEPA(联合嵌入预测架构)在潜空间做预测而非重建像素,用防坍缩正则(如 LeWM 的 SIGReg)或冻结编码器(DINO-WM 用 DINOv2)保持表示质量;生成式模型(DriftWorld 的动作条件 U-Net、IRASim 的 SDXL VAE + DiT)则在像素/潜码空间直接生成未来观测。
被评测的 5 个端到端模型横跨两类范式,且两类模型在目标偏移下的退化模式不同(预测空间不同导致指标不可直接比较),这是解读实验结果的关键背景。
组合泛化(Compositional Generalization)
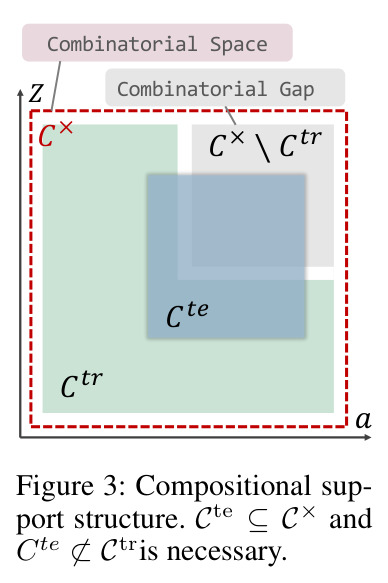
模型把训练中见过的组件重组为未见配置的能力,经典诊断来自 SCAN、CFQ、CLEVR 等基准。数学上可写成:训练联合支撑为 $C^{tr}$,各因子边缘支撑的笛卡尔积为组合空间 $C^{\times}=\prod_k Z^{tr}_k\times A^{tr}$,组合间隙即 $C^{\times}\setminus C^{tr}$。
论文把「世界模型是否学到可复用动力学」这一模糊问题形式化为:能否在组合间隙上正确预测。整个基准的任务设计都围绕这个定义展开。
行为策略与支撑失配(Support Mismatch)
离线数据由行为策略 $\pi$ 采集,观测转移是动作被 $\pi$ 加权后的 $T^{\pi}(s_{t+1}|s_t)=\int T(s_{t+1}|s_t,a)\pi(a|s_t)\,da$。训练损失只约束 $(z,\pi_E(z))$ 这些策略图上的点,导致动作无关的退化预测器 $\hat{T}^{deg}(z,a)=T^\star(z,\pi_E(z))$ 可达零训练误差。
这是论文动机的核心论证:分布内 rollout 精度在原理上就无法区分「学了动力学」和「背了行为」,所以必须换一种评测方式。
Oracle 状态预测器与 CEM-MPC 评测
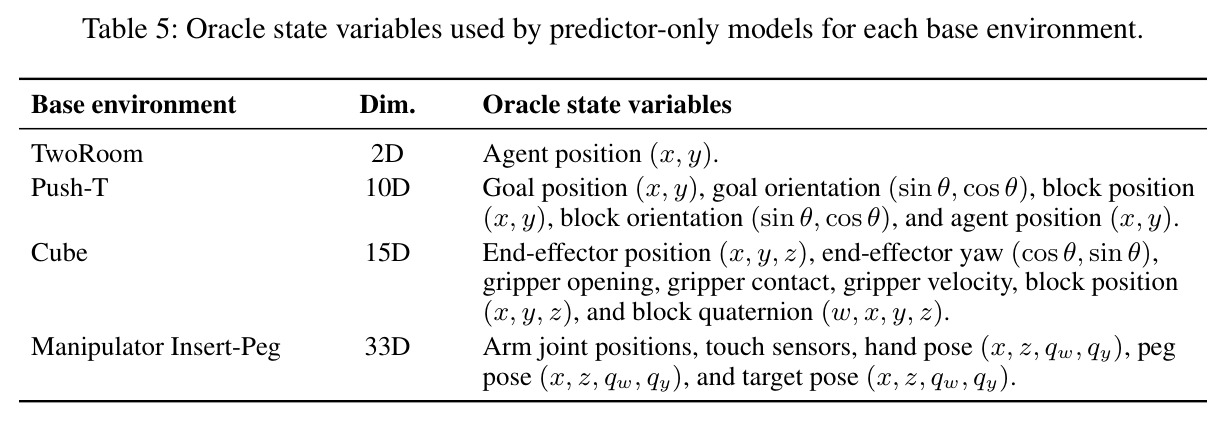
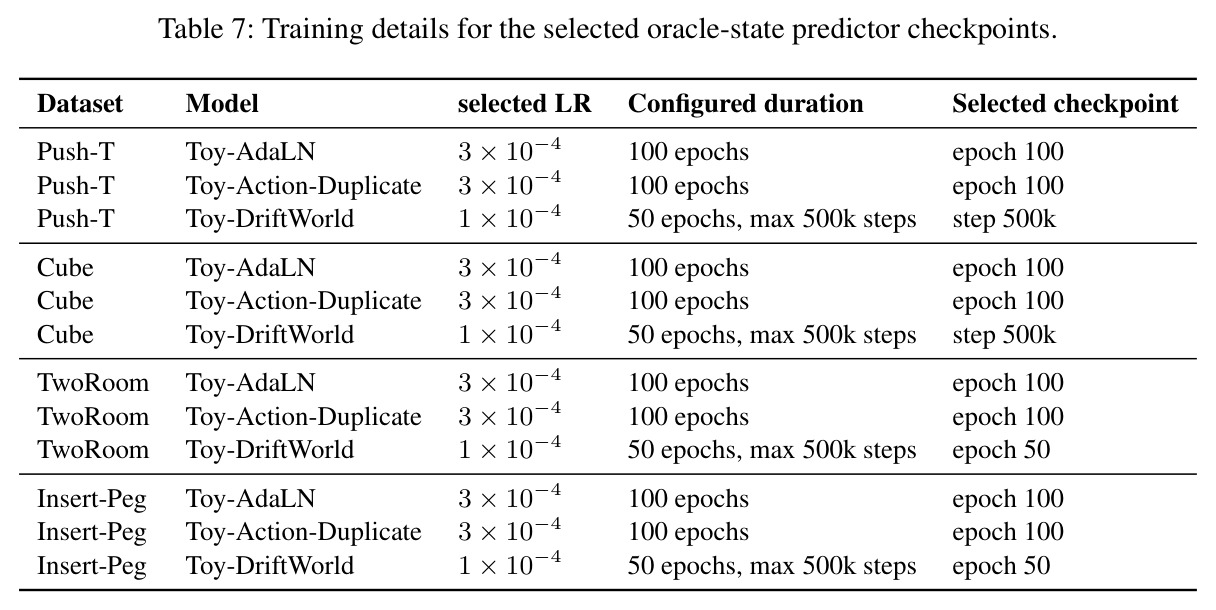
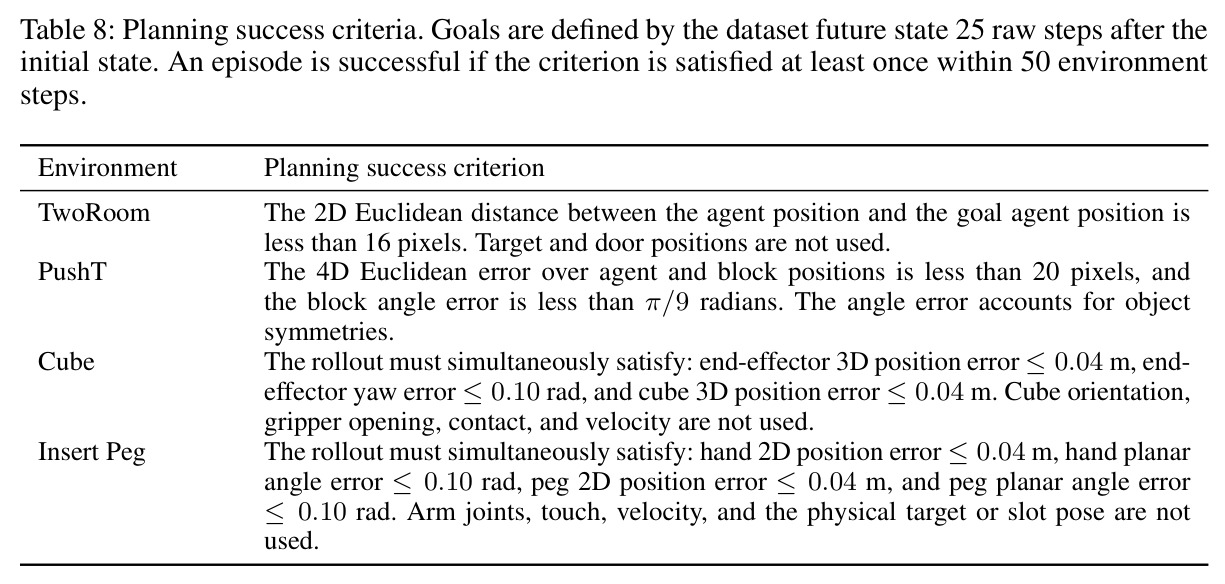
Oracle 状态预测器用真值物理因子(如 Push-T 的 10 维 agent/方块/目标状态)替代视觉编码器,从而把「表示失败」从「动力学失败」中剥离。下游规划用交叉熵法(CEM):300 个候选序列、30 轮迭代、5 个动作块共 25 步视界,最多 50 环境步内两轮重规划。
论文两组最重要的实验(oracle 对照、MPC 成功率)都建立在这两套设计上,不理解它们就看不懂实验如何隔离失败来源。
研究动机
世界模型的卖点是学到环境的动作条件动力学,从而支持规划与模拟,但训练数据几乎都来自目标导向的专家或脚本策略,rollout 中状态与动作被强烈耦合。以 Push-T 为例:专家总要先靠近 T 形方块再推它,因此「远离方块」的状态几乎只与「朝方块移动」的动作共同出现。论文在附录 A 中严格指出:若行为策略为 $a=\pi_E(z)$,训练损失只约束 $\hat{T}(z,\pi_E(z))$,此时动作无关的退化预测器 $\hat{T}^{deg}(z,a)=T^\star(z,\pi_E(z))$ 可以在训练集上达到零误差,却完全忽略输入的动作。也就是说,分布内 rollout 精度无法区分「学到了可复用动力学」与「记住了行为偏好」。而要让数据完整覆盖联合状态-动作空间,在机械臂等高维问题(如 Insert-Peg 的状态-动作向量达 33 维)中并不现实;混合多策略数据也无法判断覆盖是否充分,更难以在离线设定下定向补采。
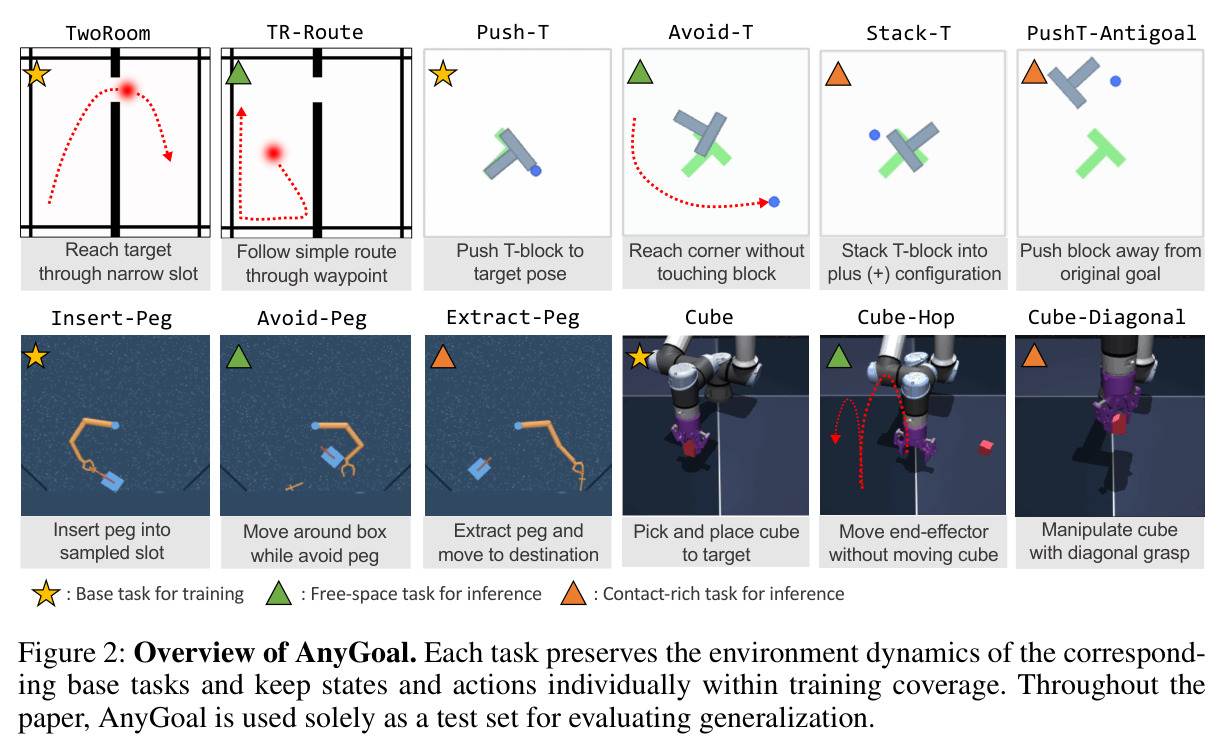
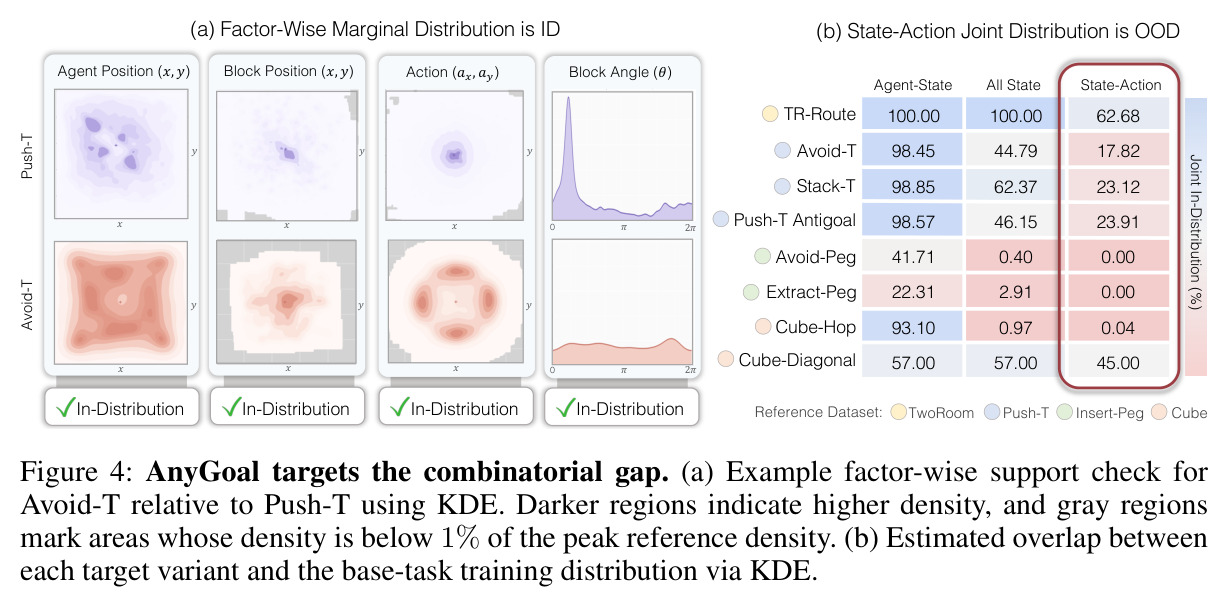
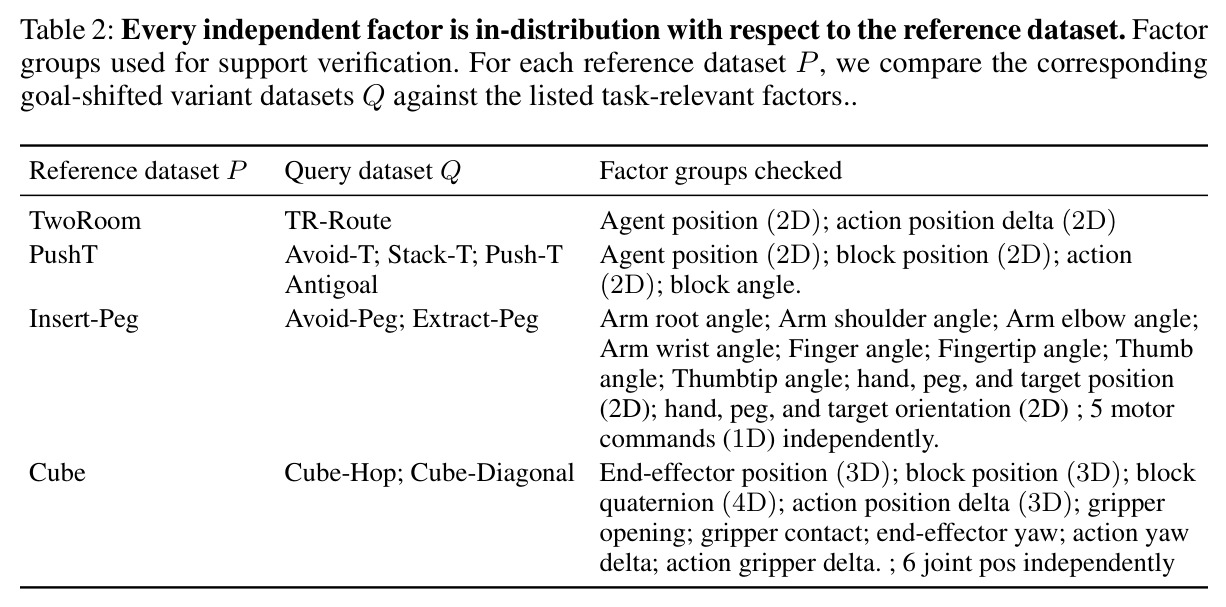
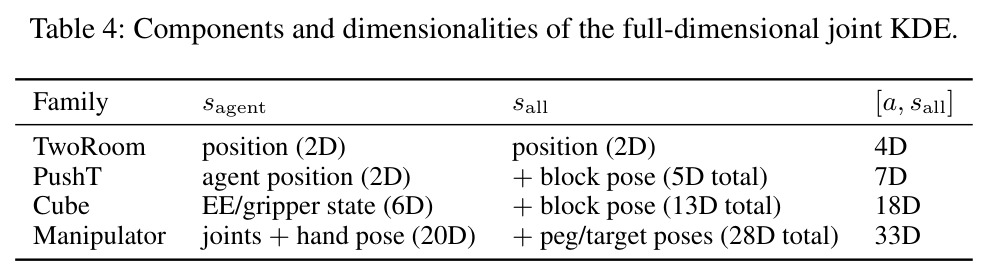
本文的目标是论文的目标是回答:当测试任务只要求重组训练中已见过的状态因子与动作、不引入任何新因子、不需要外推时,当前世界模型还能否可靠地预测与规划?为此作者构建了 AnyGoal 基准:基于 TwoRoom、Push-T、DMC Manipulator Insert-Peg、OGBench Cube 四个常用环境构造 8 个目标偏移变体(每变体发布 400 条轨迹),用统计检验保证每个变体的单个状态因子和动作都落在训练边缘支撑内,同时用全维联合 KDE 量化其状态-动作组合相对专家数据的稀有程度。随后以统一协议评测 5 个端到端世界模型(LeWM、SMWM、DINO-WM、DriftWorld、IRASim)与 3 个真值状态预测器在自回归 rollout 误差和 CEM-MPC 规划成功率上的退化,通过动作干预敏感性定位行为策略捷径,最后给出通向组合泛化的理论方向。
与已有工作不同的是,已有的世界模型 OOD 评测大多把状态、物体或视觉因子推到训练支撑之外,测的是外推与鲁棒性,超出了「可复用动力学」本应达到的要求;Hansen & Wang (2026) 关注的是幻觉的检测与缓解;离线 RL 文献处理支撑失配的方式是把策略约束回已覆盖区域,并不评估动力学模型本身能否重组熟悉组件。本文的独特切入是把 NLP/CV 中的组合泛化诊断(SCAN、CFQ、CLEVR 一脉)引入世界模型:定义组合空间 $C^{\times}=\prod_k Z^{tr}_k\times A^{tr}$,只测落在组合间隙 $C^{\times}\setminus C^{tr}$ 内的目标偏移,并保持环境动力学跨训练/测试不变 $T^{tr}=T^{te}$。关键论据是:训练分布上完全一致的两个预测器在间隙上的延拓可以任意不同,因此无法靠分布内精度推断间隙表现,必须直接评测——这正是 AnyGoal 全部任务设计所遵循的原则。
核心方法
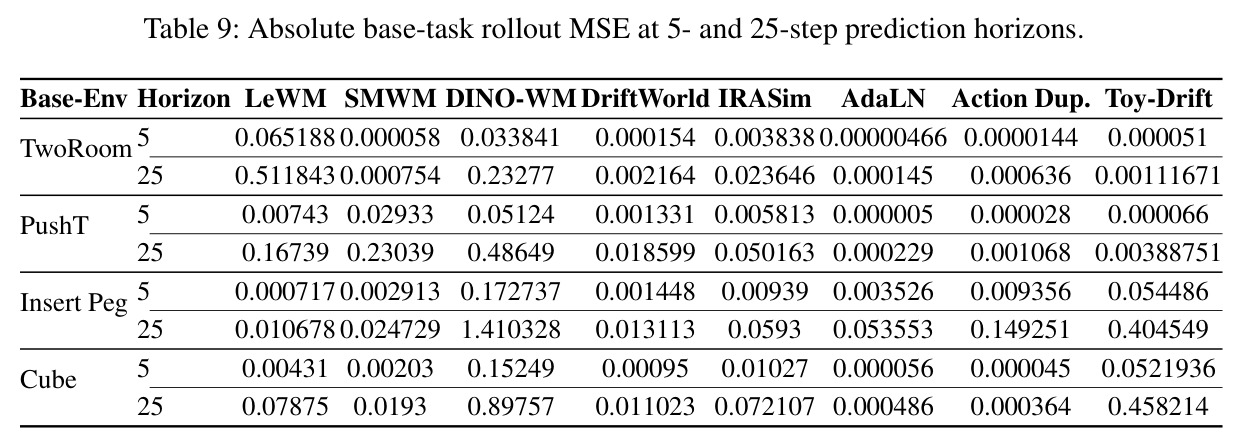
直觉上,一个真正学到动力学的世界模型应该能回答「在这个熟悉状态下执行这个熟悉动作会发生什么」,哪怕专家从未在该状态下选过这个动作。技术路线分六步:第一,把判据形式化为组合泛化,指出动作条件预测会退化为行为预测,即训练数据给出的转移满足 $T^{\pi}(s_{t+1}|s_t)=\int T(s_{t+1}|s_t,a)\pi(a|s_t)\,da$,模型可能拟合 $\hat{T}(s_{t+1}|s_t,a_t)\approx T^{\pi}(s_{t+1}|s_t)$ 而丢失对动作的依赖;第二,构造 4 环境 8 变体的 AnyGoal 基准,用 range、Mahalanobis、KDE 三重因子检验与全维联合 KDE 做支撑验证;第三,在统一协议下训练或加载 5 个端到端世界模型与 3 个 oracle 状态预测器;第四,在 base 任务与目标偏移变体上同时测量自回归 rollout MSE(5/25 环境步,frame skip 5)与 CEM-MPC 规划成功率;第五,用干预动作敏感性 $S_\theta(s)$ 把「行为捷径」变成可测量的量;第六,用 Proposition 1 说明稀疏局部机制加局部覆盖足以支撑组合泛化,为未来模型指明结构条件。
核心创新是把「新目标」重新表述为受控的组合分布偏移:不换环境、不加新物体、不做外推,只改变目标诱导的行为策略,使测试的状态-动作组合落在组合间隙 $C^{\times}\setminus C^{tr}$ 内。与既有 OOD 基准的本质区别在于它测量的是「好的世界模型最低应该做到什么」:训练分布精度完全相同的两个预测器,在间隙上可以任意分歧(Wiedemer et al., 2024b),因此必须直接评测间隙本身。附录 A 还证明了组合评测的逻辑必然性:只要动作在边缘支撑内有因果效应,即存在 $a\neq a'$ 使 $T^\star(z,a)\neq T^\star(z,a')$,任何动作无关模型 $\hat{T}(z,a)=h(z)$ 都不可能在整个重组空间上正确,否则 $T^\star(z,a)=h(z)=T^\star(z,a')$ 自相矛盾。这意味着组合测试能唯一排除「行为复读机」式的退化解,是规划(必须评估行为策略以外的候选动作)的必要条件。
方法步骤详情
第一步,数据:每个 base 任务用目标导向策略采集训练集;每个变体由不同目标的脚本策略采集 400 条轨迹,如 Avoid-T 要避开 T 块走到四角、Stack-T 要摆出十字构型、Extract-Peg 要把 peg 从槽中拔出再放到目的地、Cube-Diagonal 用对角抓取操作立方体。第二步,支撑验证:对每个参考-查询对做三重因子检验——range(逐坐标范围)、Mahalanobis(参考 0.99 分位阈值下 ≥95% 样本通过)、KDE(参考密度 0.01 分位阈值下 ≥95% 通过),全部通过;再用全维联合 KDE(Push-T 7 维、Cube 18 维、Manipulator 33 维,阈值取参考 log 密度 0.01 分位)报告联合分数,如 Avoid-T 的 agent/全状态/状态-动作分数为 98.45%/44.79%/17.82%,Avoid-Peg 为 41.71%/0.40%/0.00%。第三步,模型:LeWM、SMWM、DINO-WM、DriftWorld、IRASim 用官方实现或官方 checkpoint;oracle 预测器(AdaLN、Action-Concatenated、Toy-DriftWorld)直接输入 Push-T 10 维、Cube 15 维、Insert-Peg 33 维真值状态。第四步,评测:自回归 rollout 误差取 5/25 环境步、每个种子 100 条轨迹、seeds 0/1/2;MPC 统一用 CEM(300 候选 × 30 迭代、5 个动作块 × 5 步 = 25 步视界、最多 50 步),成功判据如 Push-T 要求 4 维位置误差 <20 像素且角度误差 <π/9。第五步,诊断:固定状态、把观测动作替换为干预集 $A_{\text{cf}}$,计算 $S_\theta(s)=\frac{1}{|A_{\text{cf}}|}\sum_{a'\in A_{\text{cf}}}\|\phi_\theta(s,a)-\phi_\theta(s,a')\|_2$,并分析其沿环境特定专家偏置坐标的走势。
技术新颖性
技术新颖性体现在四个层面。其一,基准设计:这是首个把组合泛化作为世界模型评测判据的受控基准,并开源为 Python 库(构建在 Stable-WorldModel 之上),一条 CLI 命令即可对比同一模型在 base 任务与目标偏移变体上的表现。其二,统计严谨性:目标偏移不是手工挑的 OOD 样本,而是通过三层因子检验加全维联合 KDE 双重验证,明确区分「边缘在分布内、联合稀有」,并把组合间隙的覆盖度量化成可报告的百分比。其三,诊断方法学:用 oracle 状态预测器把表示失败与动力学失败解耦,用干预动作敏感性把理论上的退化(式 (2))操作化为随状态区域变化的曲线,是把因果干预思想用于模型审计的范例。其四,理论:Proposition 1 给出「机制可辨识 + 稀疏局部依赖 $\|\nabla_x T_{k,r}(x)\|_0\ll\dim(x)$ + 局部覆盖 $U^{te}_{k,r}\subseteq U^{tr}_{k,r}$」时全局误差满足 $\|\hat{T}(z_t,a_t)-T(z_t,a_t)\|_2\le\big(\sum_k\epsilon^2_{k,r_t}\big)^{1/2}$ 的充分条件,把高维全局覆盖难题降维成局部机制输入的覆盖问题,直接回应了「全局覆盖既不现实也无必要」的直觉。
实验结果
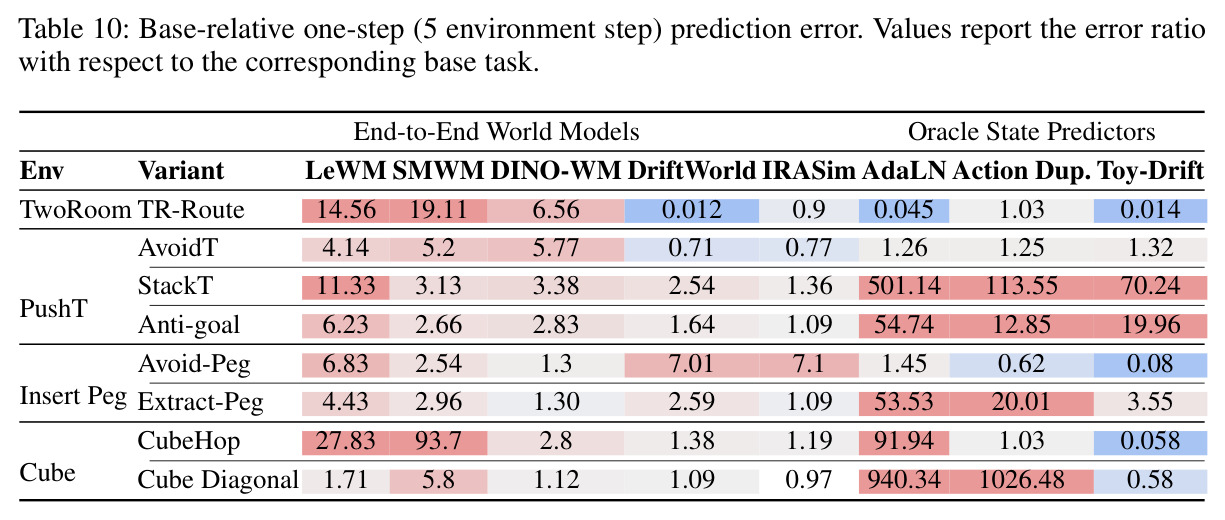
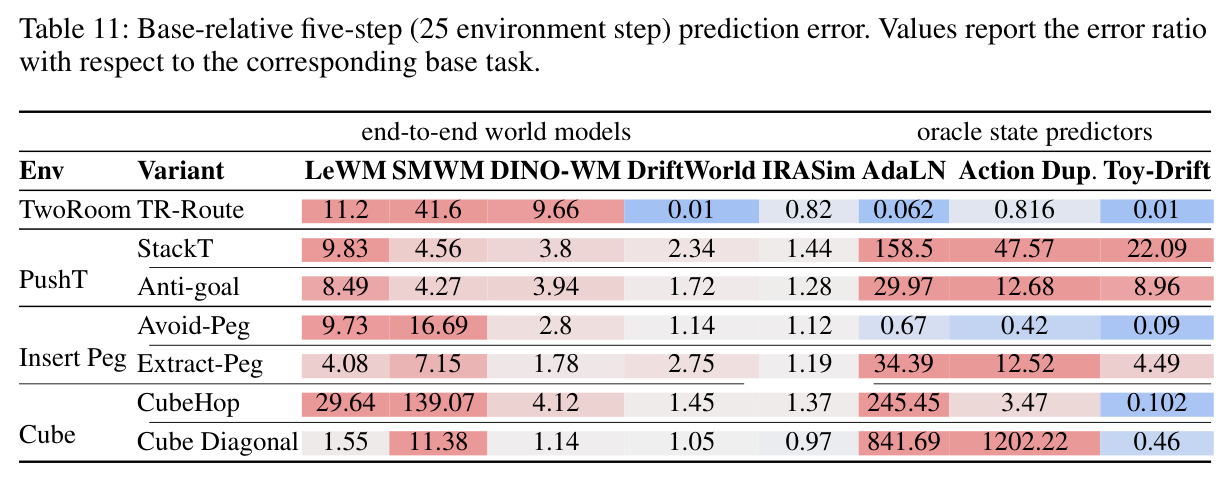
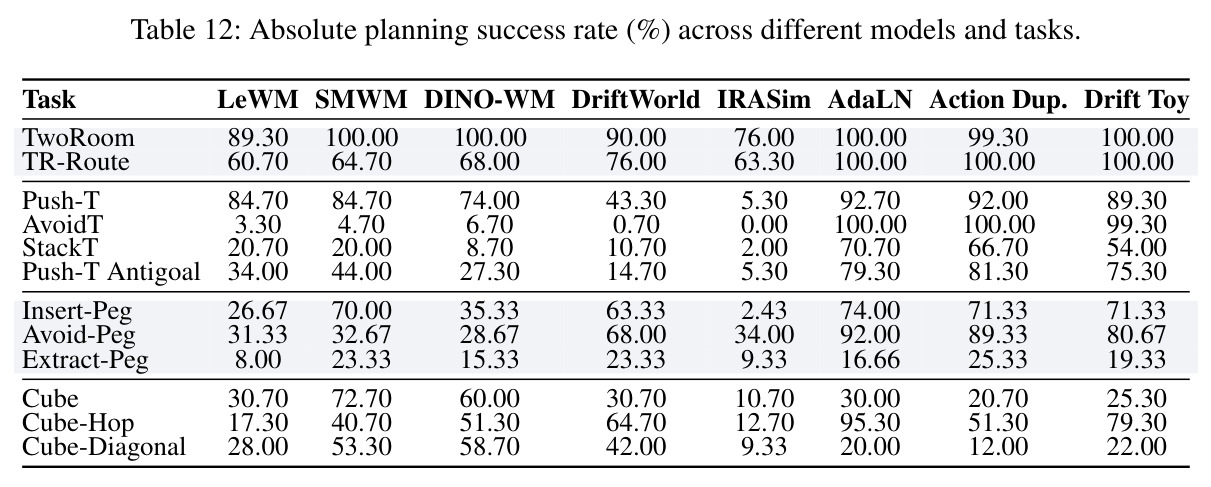
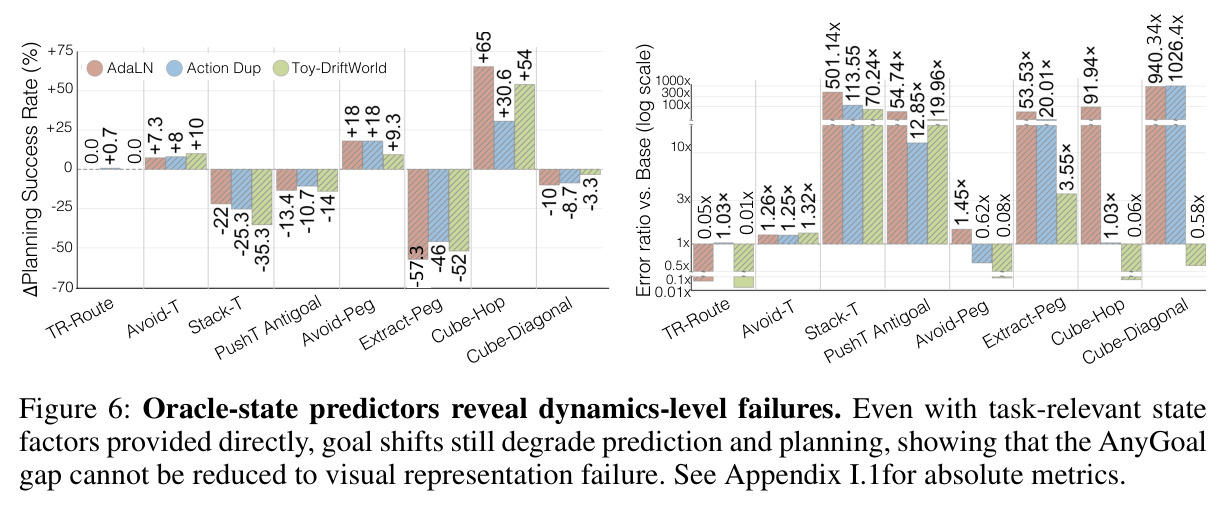
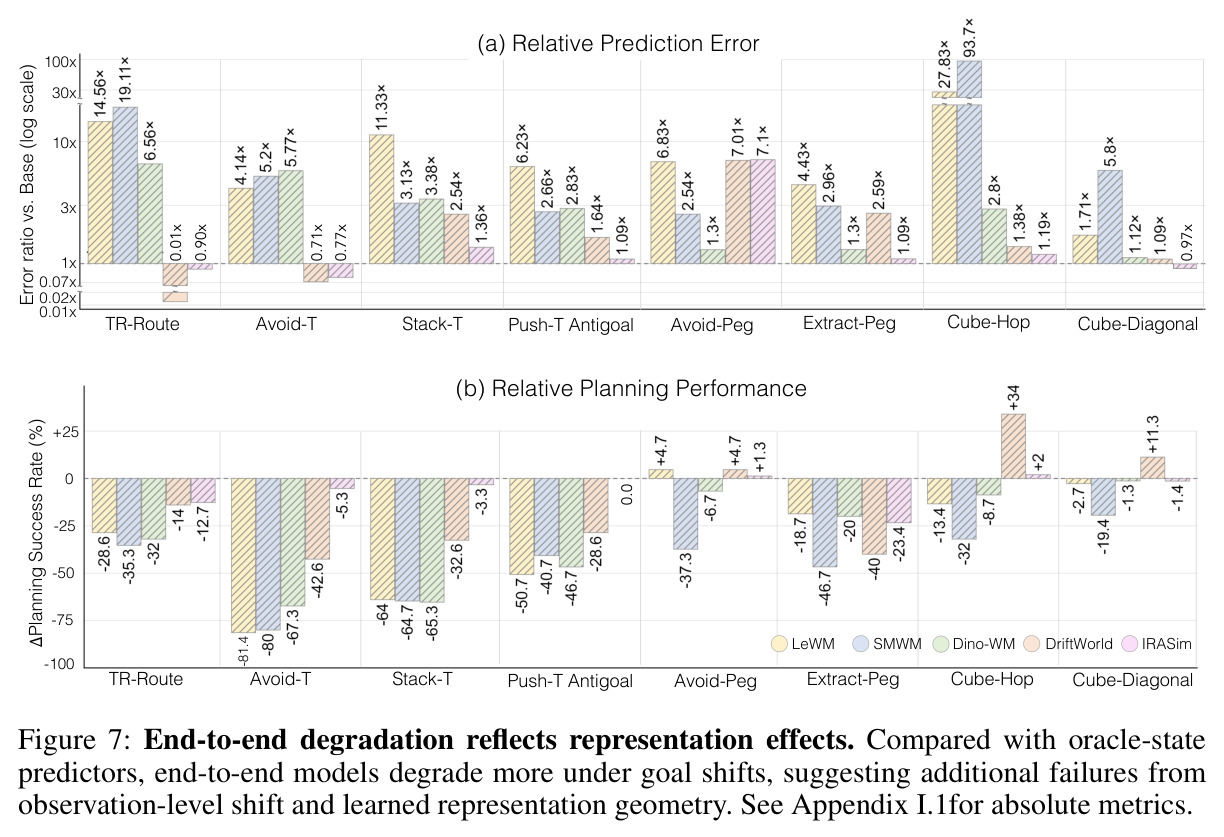
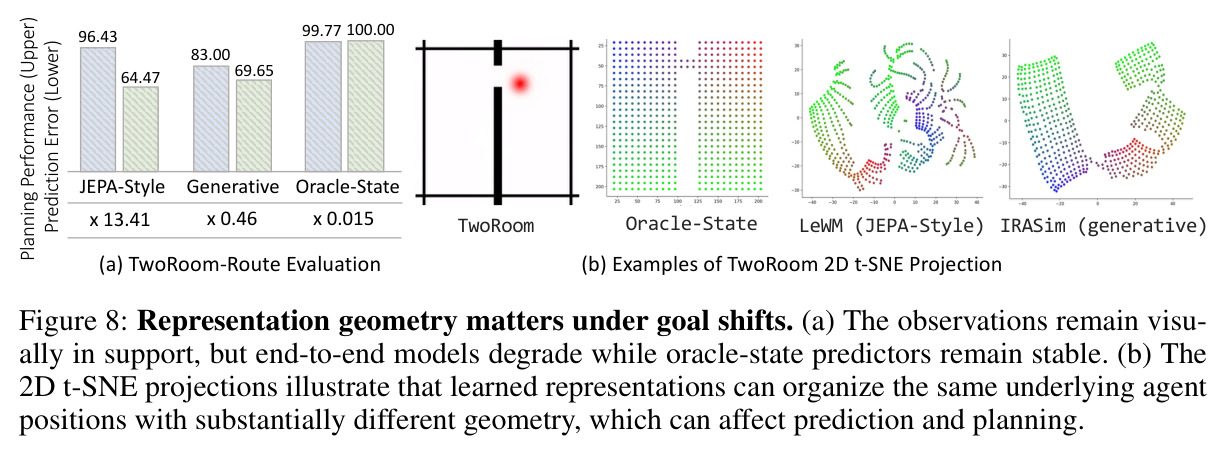
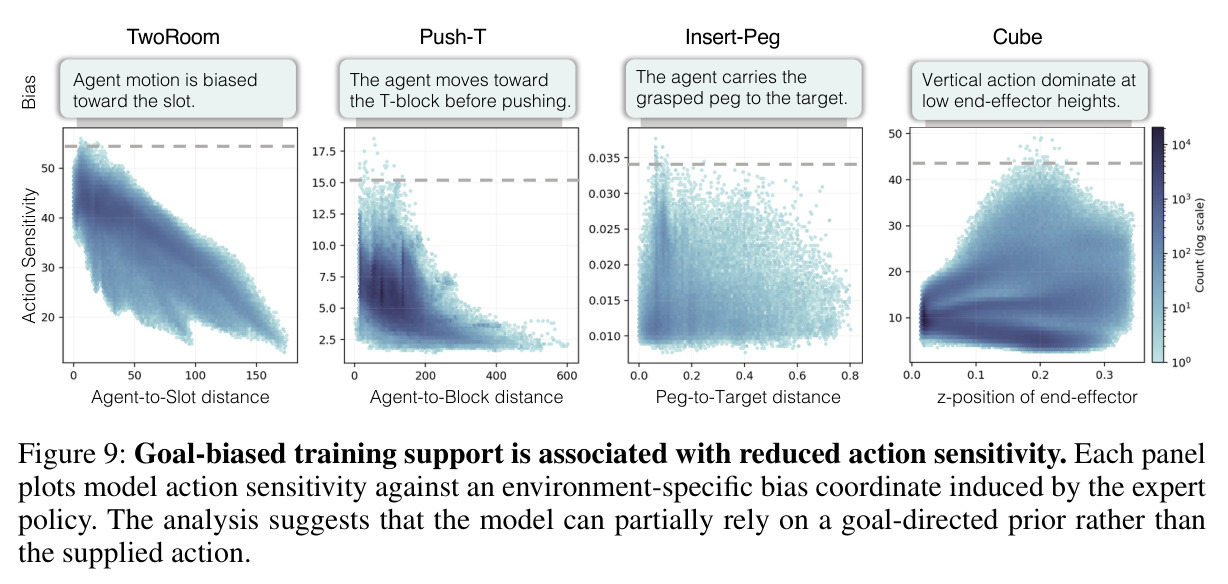
核心发现是「目标偏移下普遍失败,且失败来源异质」。(1)端到端模型连自由空间变体都会崩溃:Push-T→Avoid-T 规划成功率从 LeWM 84.70%→3.30%、SMWM 84.70%→4.70%、DINO-WM 74.00%→6.70%、DriftWorld 43.30%→0.70%、IRASim 5.30%→0.00%,而 oracle 预测器保持 99.3–100%;TwoRoom→TR-Route 上 LeWM 89.30%→60.70%、SMWM 100%→64.70%、DINO-WM 100%→68.00%,oracle 全部保持 100%。(2)给了真值状态也救不了接触密集任务:Stack-T 上 AdaLN 一步预测误差放大 501.14 倍、Push-T Antigoal 放大 54.74 倍、Cube-Diagonal 上 AdaLN 940.34 倍、Action-Concatenated 1026.48 倍(25 步时分别为 841.69 倍与 1202.22 倍);Extract-Peg 规划 SMWM 从 70.00% 跌到 23.33%。相反,自由空间变体(TR-Route、Avoid-T、Avoid-Peg、Cube-Hop)在 oracle 下误差比常低于 1,如 Toy-DriftWorld 在 Avoid-Peg 仅 0.08 倍。(3)表示学习额外加害:TwoRoom 上观测无明显偏移,oracle 预测误差比仅 0.015 倍、规划 99.77%→100%,而 LeWM 误差比 13.41 倍、规划 96.43%→83.00%,t-SNE 显示不同模型的 latent 几何差异巨大。(4)动作敏感性分析显示:沿专家偏置坐标(agent-slot 距离、agent-block 距离、peg-target 距离、末端 z 高度),模型对干预动作的敏感性系统性下降,说明其部分依赖目标先验而非输入动作。(5)度量之间不完全一致:生成式模型 rollout 退化常更小(TR-Route 上 DriftWorld 仅 0.012 倍)但规划未必更好;Cube 上端到端模型规划甚至超过 oracle 对应模型,说明状态可观测性与规划适配性是两个独立属性。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Push-T → Avoid-T(自由空间)下游规划 | MPC 成功率 (%) | LeWM 在 Avoid-T 上 3.30 | LeWM 在 Push-T 基线任务 84.70 | -81.40 个百分点;同设定下 oracle 预测器保持 99.30–100,失效纯因动力学/表示而非任务难度 |
| TwoRoom → TR-Route(自由空间)下游规划 | MPC 成功率 (%) | SMWM 64.70、DINO-WM 68.00、LeWM 60.70 | 各自基线 100.00、100.00、89.30 | 端到端下降 20.6–35.3 个百分点,oracle 预测器三个全部保持 100(0 退化) |
| Push-T → Stack-T(接触密集)下游规划 | MPC 成功率 (%) | LeWM 20.70、DINO-WM 8.70 | Push-T 基线 84.70、74.00 | -64.0 与 -65.3 个百分点,连 oracle 状态输入(AdaLN 70.70)也明显退化 |
| Insert-Peg → Extract-Peg(接触密集)下游规划 | MPC 成功率 (%) | SMWM 23.33、LeWM 8.00 | Insert-Peg 基线 70.00、26.67 | SMWM 下降 46.67 个百分点,说明拔出动作(反转专家插入偏置)最难 |
| Stack-T 一步预测误差(oracle 状态输入) | 相对基线任务 MSE 比值 | AdaLN 预测器 501.14× | Push-T 基线 MSE 0.000005 | 误差放大约 501 倍,证明动力学本身(非视觉表示)无法重组接触动态 |
| Cube-Diagonal 一步预测误差(oracle 状态输入) | 相对基线任务 MSE 比值 | Action-Concatenated 1026.48×、AdaLN 940.34× | Cube 基线 MSE 0.000045 / 0.000056 | 误差放大约千倍,对角抓取构成的新接触 regime 是最难重组的场景 |
| TwoRoom → TR-Route 表示效应对照 | 相对预测误差比值 / MPC 成功率 (%) | LeWM 误差比 13.41×,规划 96.43→83.00;IRASim 误差比 0.46×,规划 64.47→69.65 | oracle 预测器误差比 0.015×,规划 99.77→100.00 | 观测无偏移时 oracle 稳定而端到端显著退化,定位失败源为 latent 几何 |
局限与改进
作者承认的局限:五个模型在不同空间(latent/像素/真值状态)测误差,绝对值不可比,只能做相对退化比较,不能据此为模型族排名;AnyGoal 只作测试集,不提供修复方法;第六节的理论是条件性陈述,依赖马尔可夫不变状态、机制可辨识、稀疏性与局部覆盖四个假设,作者明确不声称可从专家数据辨识机制;Avoid-T 的 episode 太短,无法支持 25 步预测评测。我自己的观察:环境只有 4 个、变体 8 个,且全部是低维平面导航或桌面操作任务,难以外推到高维灵巧手或视频生成世界模型;Insert-Peg 的规划成功判据用「数据集未来状态」(hand/peg 位姿误差阈值 0.04 m、0.10 rad)而非原生任务奖励,可能与任务语义有偏差;每个变体只由单一采集目标生成,目标偏移的「强度」没有被扫描,无法刻画失效边界;全维联合 KDE 在 33 维空间(Manipulator)中的密度估计可靠性存疑;CEM 超参对所有模型统一固定(300 候选 × 30 迭代),对生成式等随机模型可能不友好,规划失败未必全是动力学模型的锅。
独立分析的弱点
独立分析的弱点与改进方向:(1)只诊断不开方——既然确认了行为捷径的存在,最直接的改进是把动作敏感性 $S_\theta(s)$ 变成训练正则,鼓励模型对干预动作的响应均匀;或引入更强的 inverse-dynamics / 动作条件对比目标。SMWM 已含 inverse dynamics 却仍在接触任务上失败(Cube-Diagonal 误差比 5.8 倍),说明现有目标强度不足以打破捷径。(2)接触密集任务的失败可能部分来自 CEM 规划器而非模型——可补充「重放专家动作」或基于模型似然的采样基线,分离模型误差与优化误差。(3)高维联合 KDE 不稳健——可用 normalizing flow、k-NN 覆盖度或极小体积集支撑估计替代,并报告估计方差。(4)变体数量少且每个变体单目标——应系统扫描目标偏移幅度,画出成功率随联合分数变化的曲线,找到「何时开始失效」的边界。(5)缺少数据干预实验——例如在 Push-T 训练集中混入 $\epsilon$ 比例的随机动作数据,量化覆盖修复对组合泛化的边际收益,这能直接检验论文的覆盖假说并把基准变成方法论实验台。(6)成功判据依赖数据集未来状态而非物理任务本体,宜补充原生任务指标交叉验证,避免误判。
未来方向
作者提出的方向:一是机制辨识——刻画在什么条件下能从离线轨迹中辨识可复用的动作条件机制,尤其当动作效果随状态与 regime(自由运动/接触/抓取)变化时,这仍是开放问题;二是支撑外外推——为交互丰富动力学寻找结构假设,Proposition 1 给出了 regime 条件化稀疏局部机制 $z_{k,t+1}=T_{k,r_t}(u_{k,t})$ 的样板,需要发展能发现 regime、辨识局部输入的架构、目标函数与数据采集策略。基于本文成果可延伸的方向:把动作敏感性正则或 regime 门控的机制网络(如接触/自由运动分类器切换的模块化动力学)纳入世界模型训练目标;结合模型基离线 RL 的不确定性估计,主动采集组合间隙中的数据;将 AnyGoal 协议移植到视频生成式世界模型与 VLA 模型,检验其「物理理解」是否同样依赖行为偏置;研究 latent 几何设计(TwoRoom 的 t-SNE 观察表明几何组织直接影响预测与规划)如何让 planner 更易优化;以及把稀疏机制假设转化为可微的结构正则,验证 Proposition 1 在真实环境中的可实现程度。
复现评估
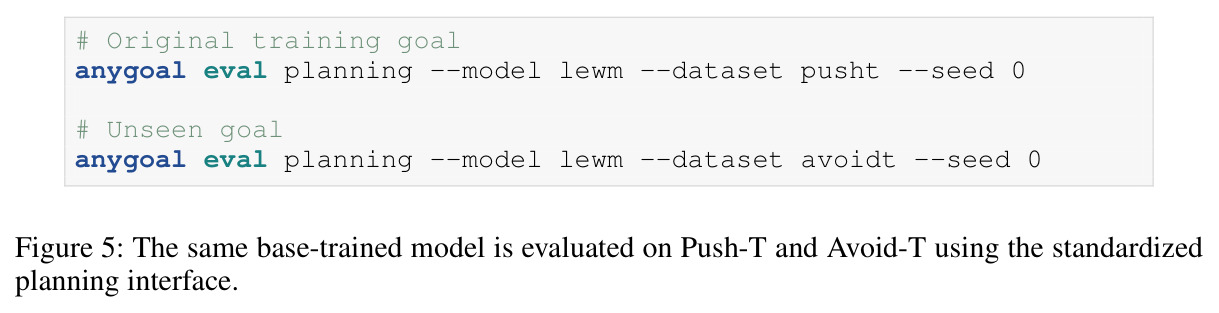
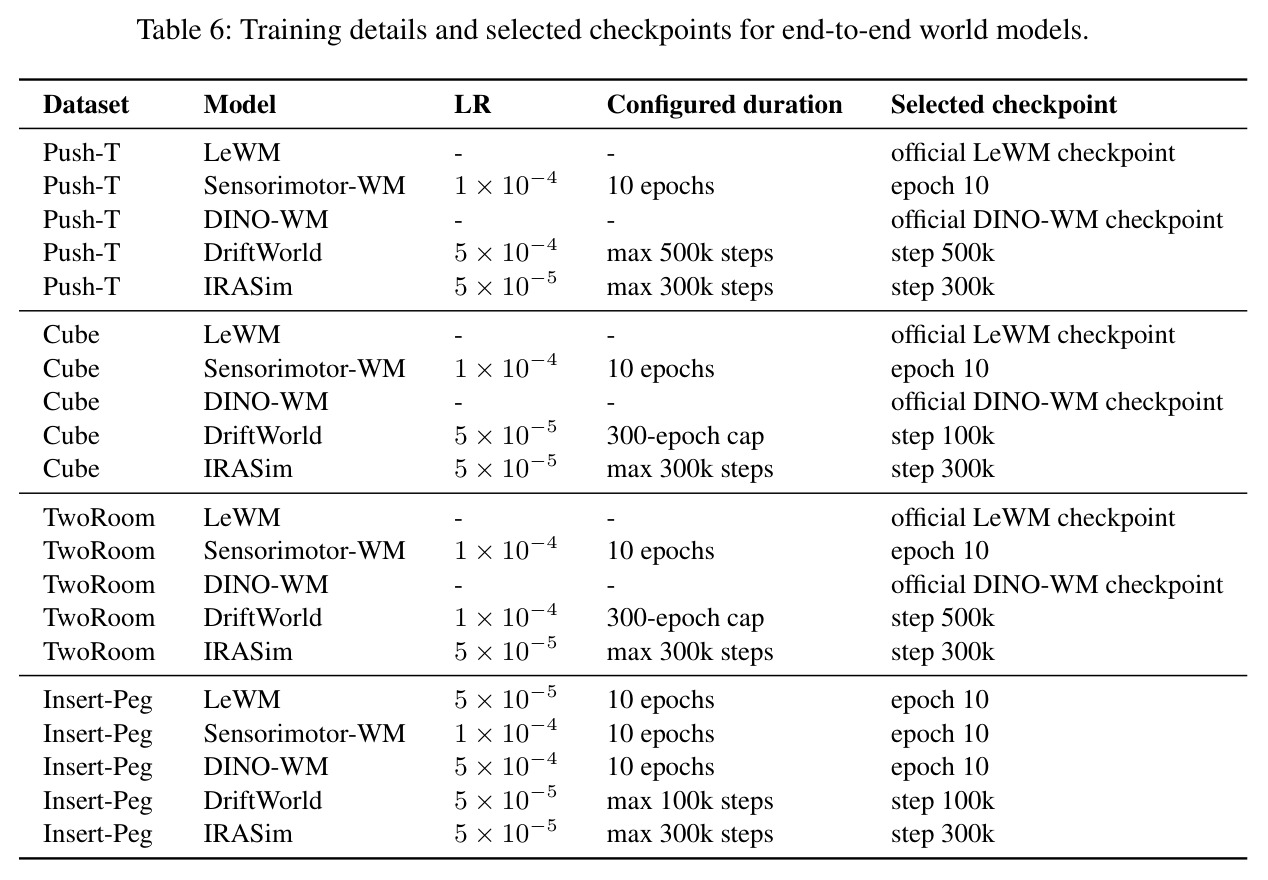
复现条件很好。AnyGoal 以开源库发布(构建于 Stable-WorldModel,源码在 github.com/galilai-group/AnyGoal),数据与 checkpoint 可从 HuggingFace 经 anygoal artifacts download 获取;每个变体随附 400 条轨迹,另有采集工具(如 anygoal collect avoidt --num-episodes 400 --num-parallel 8)可自建更多数据。评测是一条命令的事:anygoal eval planning --model lewm --dataset avoidt --seed 0,rollout 评测同理;协议固定为 seeds 0/1/2、每 seed 100 条轨迹。五个端到端模型均用官方实现或官方 checkpoint(LeWM、DINO-WM 直接用官方权重),训练超参与 checkpoint 选择在附录 Table 6/7 完整列明;oracle 预测器是小模型(AdamW、batch 256、100 epochs、真值状态输入),单 GPU 即可训练。主要算力开销在端到端模型训练(DriftWorld 最多 500k 步、IRASim 300k 步),但可直接下载跳过。难度中低,摩擦点主要是 MuJoCo/DMC 环境安装与生成式模型的 CEM 规划成本。总体属于可复现性优良的诊断型工作。
论文图表
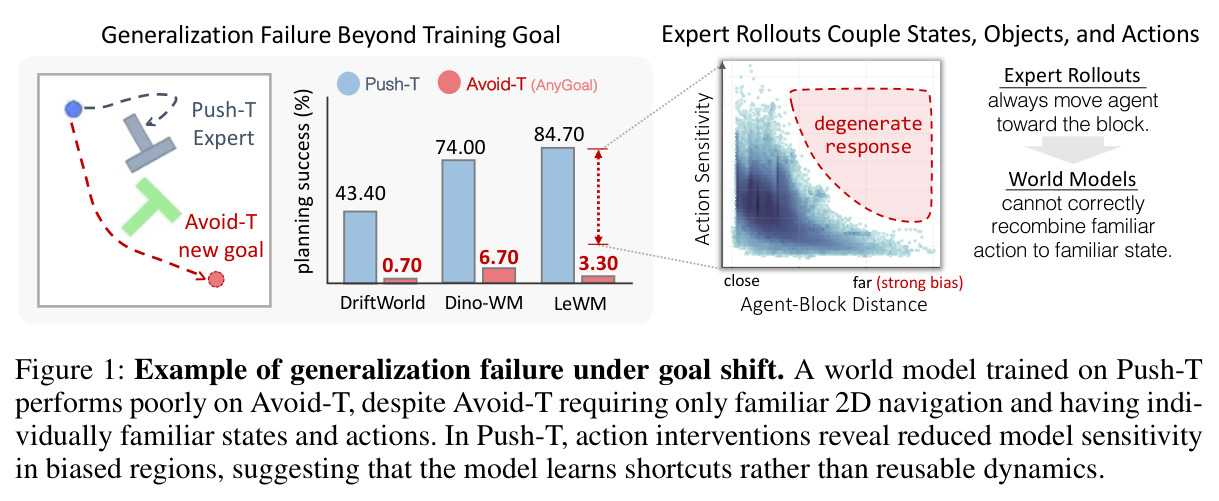
以 Push-T 训练、Avoid-T 评测为引子:LeWM 在 Avoid-T 的规划成功率仅 3.30%(基线 Push-T 84.70%),DriftWorld 0.70%、DINO-WM 6.70%;同时展示动作干预敏感性曲线,显示在专家行为强偏置的区域模型对动作的敏感性明显退化。
一图点题:单个例子直观呈现「熟悉的状态和动作,换个目标组合就失败」以及「模型学到的是捷径而非动力学」两个核心论点,是理解全文动机的入口。
完整报告所有参考-查询对在每个因子上的 Mahalanobis(0.99)、KDE、Range 通过率与最终判定,全部通过(如 TwoRoom→TR-Route 的 agent 位置 0.970/1.000/1.000)。
以逐因子证据支撑「AnyGoal 不引入训练支撑外的新因子」这一前提,是基准合法性的数据背书。