混合架构中的竞争学习 Competing Learning in Hybrid Architectures
混合架构预训练中循环层与注意力层竞争学习检索功能,早期冻结循环层可让注意力赢得分工并显著提升性能
前置知识
混合架构(Hybrid Architecture)
将 softmax 注意力层与线性时间循环层(线性注意力、状态空间模型、KDA 等)按固定比例交替堆叠的语言模型架构。循环层把上下文压缩进固定大小的状态矩阵,训练与推理吞吐高;softmax 注意力保留对所有历史 token 的直接访问,长程检索精确。工业界代表包括 Kimi K3、GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron-3-Ultra,常见堆叠如本文的 Attention–KDA–KDA–KDA(3:1 配比)。
本文的全部问题都发生在两类混合器共存的前提下:架构设计意图是注意力管长程检索、循环层管短程混合,而竞争学习现象说明这一分工在标准预训练下不会自动实现,必须主动干预。
KDA 与线性循环层的短程偏置
KDA(Kimi Delta Attention)是 Kimi 采用的线性 RNN 层,状态更新为 $S_t=(I-\beta_t k_t k_t^\top)\mathrm{Diag}(\alpha_t)S_{t-1}+\beta_t k_t v_t^\top$,读出为 $o_t=S_t^\top q_t$,其中 $\alpha_t$ 是遗忘门。初始化时 $\alpha_t$ 取值较小,历史信息随时间步被指数衰减,使状态天然偏向保留近期 token,形成短距离归纳偏置。
这一偏置使 KDA 在短程模式占多数的自然语言分布下比注意力更快学会检索,是它赢得竞争、抑制注意力学习的根本原因,也是 BLD 方法设计的出发点。
检索头(Retrieval Head)
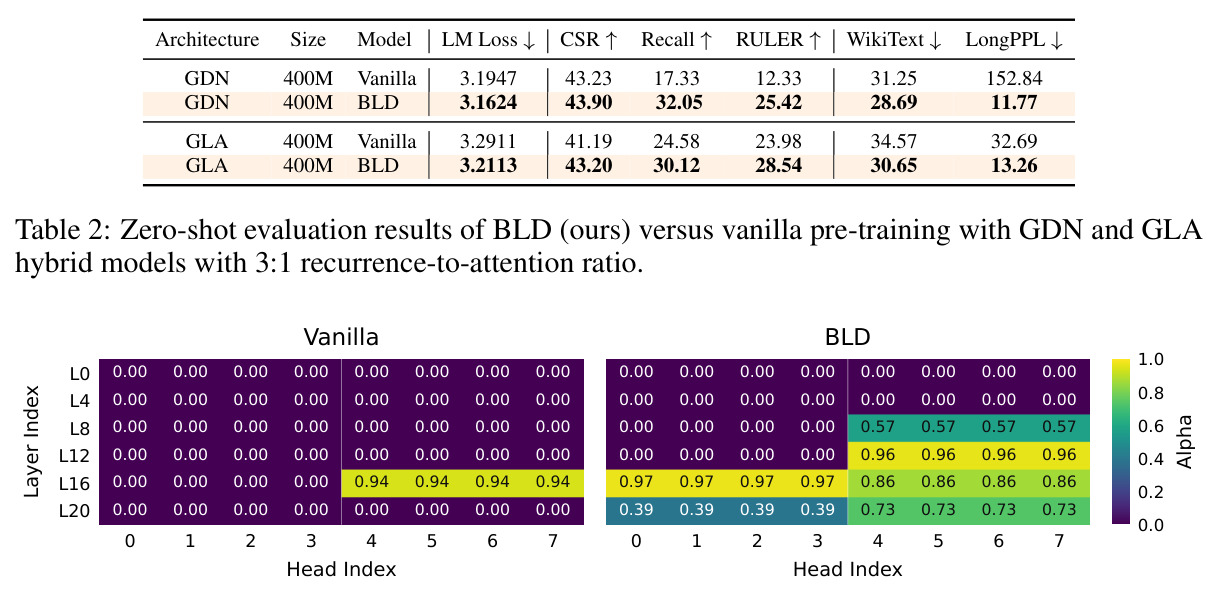
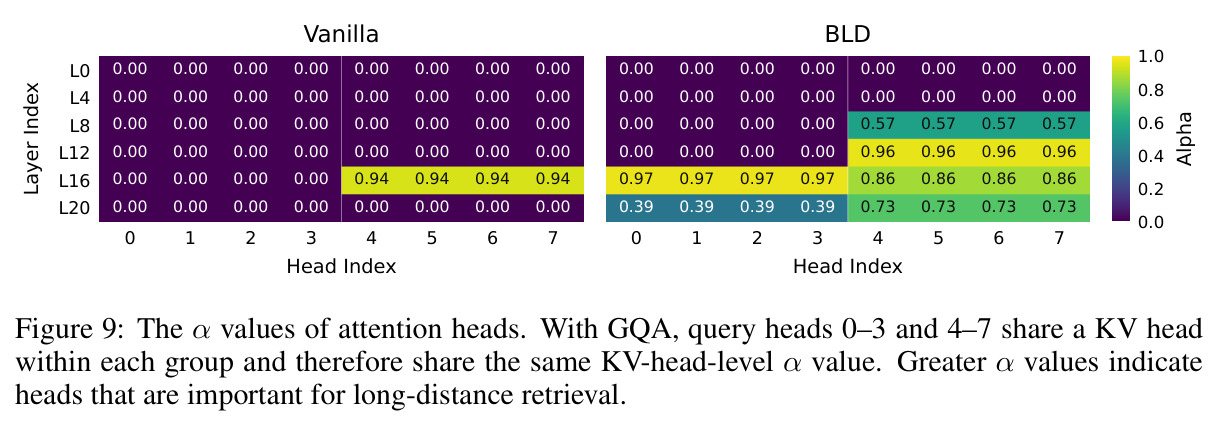
注意力模型中少数专门负责长距离精确复制的注意力头:它们把注意力质量集中在上下文中充当“钥匙”的早期 token 上,配合后续层完成信息搬运;其余头主要做局部短程混合。DuoAttention 用可学习门控 $\alpha\in[0,1]$ 区分检索头(依赖全注意力)与流式头(只看局部窗口),$\alpha$ 越大表示越依赖完整上下文。
检索头数量是分工质量的直接证据:BLD 模型训练出 3 个检索头而 vanilla 基线只有 1 个,说明冻结干预确实让注意力接管了长程检索功能。
层归因与因果干预(activation patching)
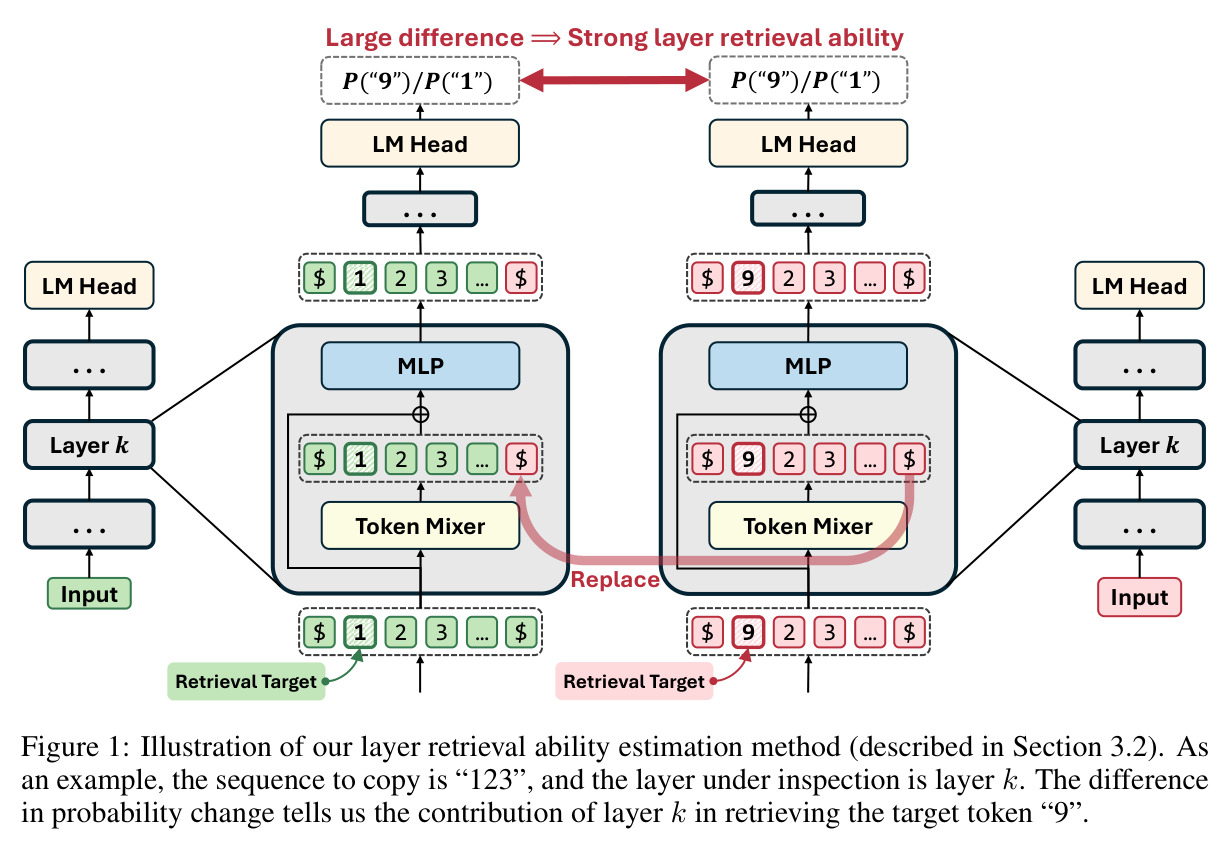
通过替换模型内部某一组件的激活来估计其贡献:对仅源数字不同的输入对 $x_A,x_B$,把第 $l$ 层 mixer 输出在预测位置换成配对输入的输出,度量答案裕度 $m(z;a,b)=[z]_a-[z]_b$ 的下降量 $C^{A\leftarrow B}_l$,下降越多说明该层对检索的贡献越大。这是一种不看参数、直接测功能贡献的因果式度量。
论文用这个分数逐层监测两类混合器检索能力的形成速度,Figure 2–5 中所有竞争学习证据都建立在该度量之上,读懂它才能理解分析部分。
Chinchilla 缩放原则与缩放律拟合
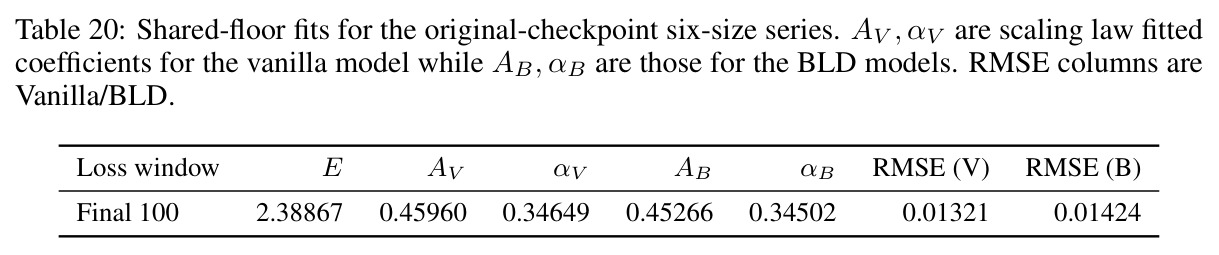
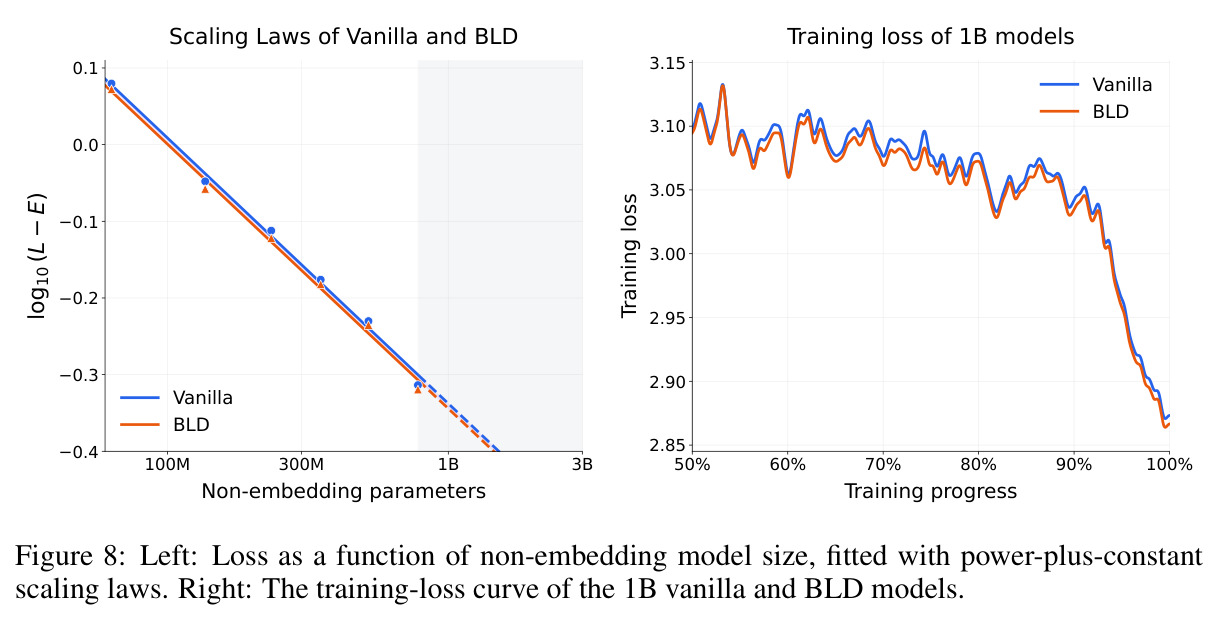
Hoffmann et al. (2022) 提出的计算最优训练原则:参数量 $N$ 的模型约用 $20N$ 个 token 训练最优。本文严格遵循该原则(早期约 $2.05N$ 加后期约 $20.5N$ token),并用幂律加常数形式 $L(N)=E+A(N/10^9)^{-\alpha}$ 拟合六个规模的最终损失,检验方法收益是否随规模保持。
BLD 的关键主张是“收益可扩展”:拟合显示两种方法的指数几乎相同(0.345 vs 0.346),说明这是近似平移的损失改进,可外推到更大的模型规模。
研究动机
混合架构的设计初衷是分工:线性循环层(如 KDA)用固定大小状态做高吞吐的短程混合,softmax 注意力负责长程精确检索,已有研究表明这种分工(如 3:1 的 KDA:注意力配置)在下游任务上最有利。但标准预训练让所有层从零同时训练,没有任何机制保证注意力真的接管长程检索。作者在合成 Spaced Retrieval 任务(复制 5 个数字、中间隔 $g\in\{64,8192\}$ 个空格)上的层归因实验显示:不加干预时 KDA 层凭借遗忘门带来的短程归纳偏置更快学会检索并全程主导(Figure 2)。由于自然语言中短距离依存远多于长距离(Futrell et al., 2015 的 37 种语言依存长度最小化证据),这正是真实预训练的常态——KDA 提前消化了检索相关的预测误差,削弱注意力层收到的学习信号,使其在多数情况下学不会检索,最终分工系统性偏离架构设计意图。
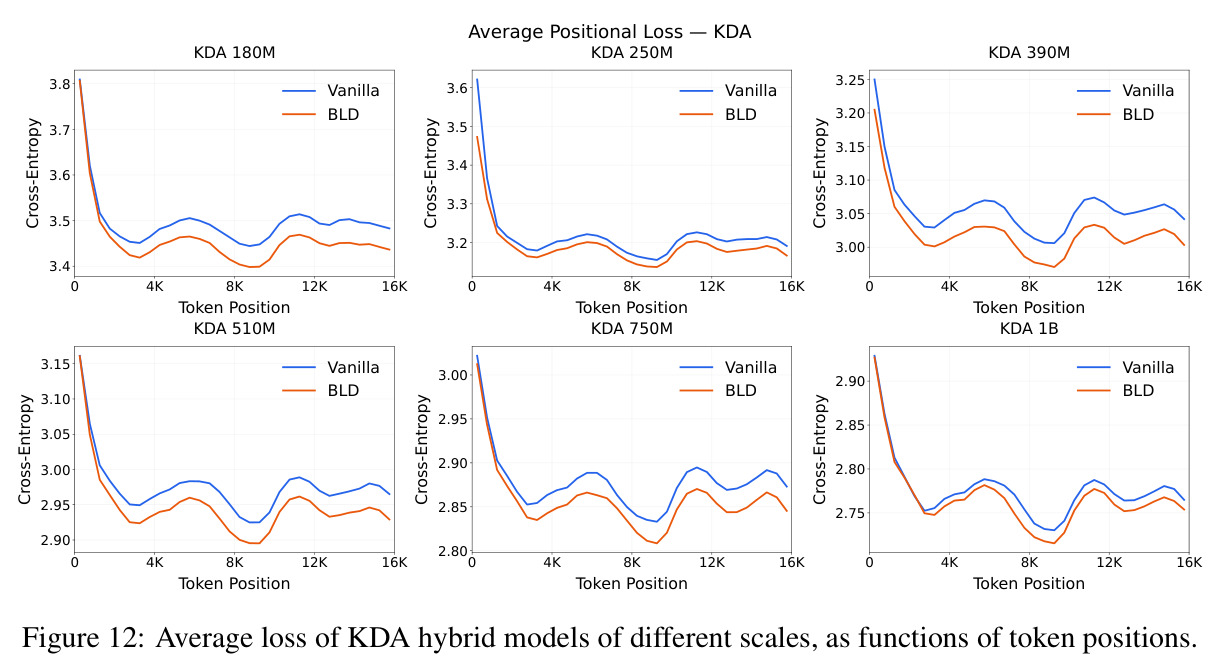
本文的目标是本文目标分三层。第一,确认并刻画“竞争学习”现象:混合模型中循环层与注意力层都会学习上下文检索功能,先学会者会降低检索特定的预测误差、削弱其他层的学习信号,形成先发者恒强的自增强循环。第二,弄清什么决定竞争赢家:通过改变训练数据中长/短距离样本的配比(Figure 3,短距离占比 $p$ 从 0 到 1 扫 11 档),证明数据分布会选择赢家,而自然语言分布天然偏向让 KDA 获胜。第三,在不改动架构、不增加数据与算力的前提下设计训练流程 BLD(Better Layer Division):预训练最初约 1/11 数据量(约 2.05N token)冻结全部 KDA 块,给注意力层先发优势,引导其接管长程检索;在 180M–1B 六个规模和 KDA/GDN/GLA 三种循环架构上验证 BLD 能同时改善语言建模损失、常识推理、召回、RULER 与 LongPPL,并证明收益随规模可扩展。
与已有工作不同的是,已有工作与本文的差别在视角:Bick et al. (2025)、Afendulev et al. (2026) 等只在训练完成后描述分工“已经形成”;Xiao et al. (2025) 的 DuoAttention 利用现成的检索头做推理加速;Chen et al. (2026)、Bick et al. (2026) 等把预训练好的 Transformer 蒸馏改造成混合模型,属于事后补救。最接近的 Qiao et al. (2026) 只观察到高效注意力模块会延迟检索头形成,未揭示机制也未给出训练方案。本文的独特切入是把分工当作训练动力学问题:检索能力被某一层提前习得后,会通过降低残差流中的检索误差而削弱其他层收到的学习信号。作者用冻结/解冻干预(注意力检索能力在冻结瞬间跳升)、梯度范数测量(冻结使注意力梯度达基线约 10 倍)和数据配比实验提供因果证据,并把认识转化为只需冻结 1/11 数据量的可用预训练流程。
核心方法
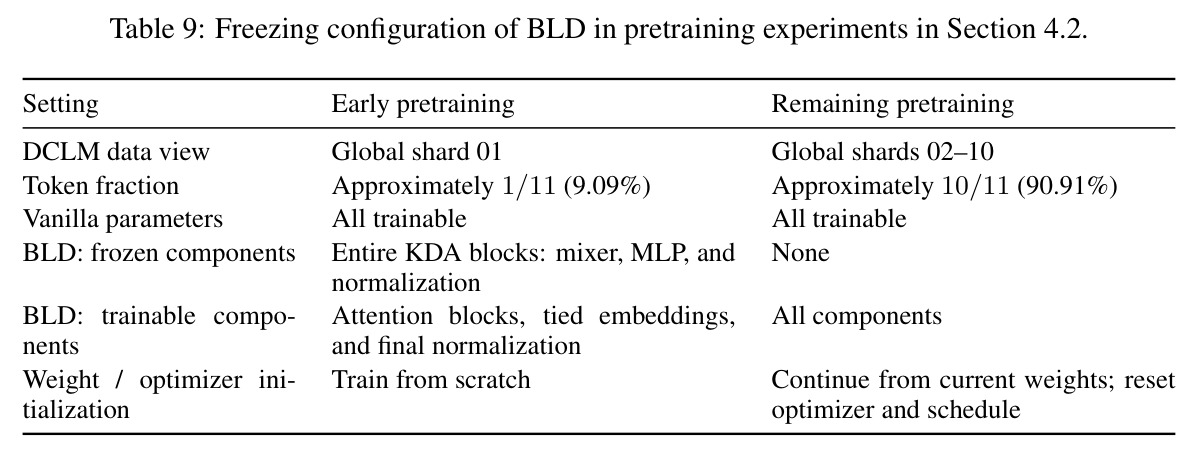
直觉上,混合模型预训练是“谁先学会检索谁赢”的赛跑:赢家持续吸收检索相关学习信号,输家信号被削弱。既然自然语言分布下 KDA 几乎必然先学会,最直接的干预就是让注意力先跑一段。技术路线分三步:第一步构造干净的合成任务 Spaced Retrieval——输入 “$X_1X_2\cdots X_5$” 后跟 $g\in\{64,8192\}$ 个空格再接 “$”,模型需在末尾原样复述 5 个数字,在 3.6M 参数、2 层 KDA 加 2 层注意力的混合模型上训练;第二步用层归因分数量化每层检索贡献:对仅源数字不同的输入对,把第 $l$ 层 mixer 输出在预测位置替换后测答案裕度变化 $C^{A\leftarrow B}_l=m(z(x_A,j);a,b)-m(\tilde{z}^{A\leftarrow B}_{l,j};a,b)$,配合冻结/解冻干预确认竞争学习的因果性;第三步提出 BLD:真实预训练最初约 2.05N token 冻结全部 KDA 块,只训练注意力块、绑定嵌入与最终归一化,随后解冻恢复标准流程,token 总预算与 vanilla 完全一致。
核心创新是把“层间功能分工”从事后观察对象变成可主动干预的训练目标。与已有工作的本质区别有三点。其一,零架构改动:不修改任何模块、不增加数据或算力,只改变参数更新的时间表——前 1/11 数据(约 2.05N token)冻结 KDA 块。其二,利用竞争学习的自增强性:合成实验发现存在临界窗口——KDA 在 step 125 之前被冻结的 run,解冻后注意力优势会继续自我强化,KDA 转向其他功能;冻结过晚则注意力优势不足,解冻后立刻被 KDA 反超(Figure 4)。BLD 正是刻意制造足够大的先发优势让分工“锁定”。其三,机制上给出梯度证据:冻结 KDA 期间注意力梯度范数相对基线渐进放大至约 10 倍,解冻后迅速回落(Figure 5),说明学习信号按当前能力差距动态分配——先学者恒强,而干预可以改写“谁先学”。
方法步骤详情
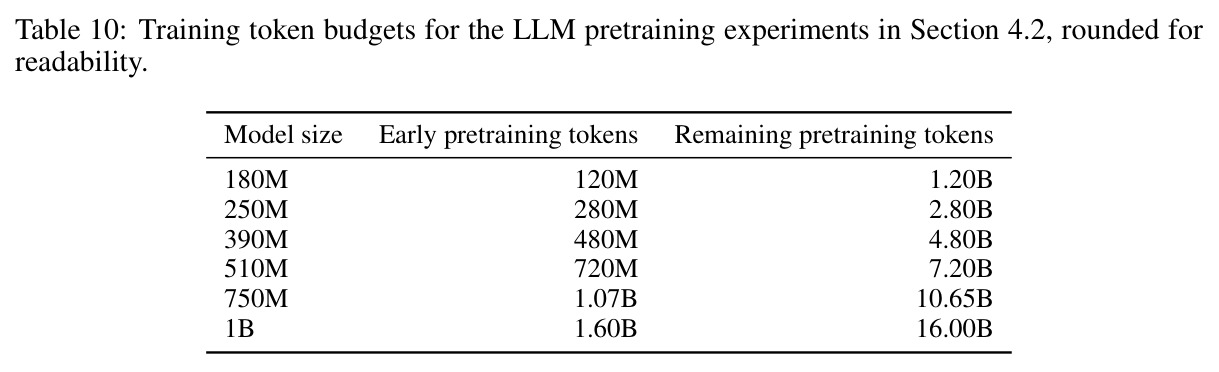
BLD 流程(以 1B 模型为例):(1) 架构准备:Attention–KDA–KDA–KDA 四层一组堆叠、3:1 配比,全部层不用 RoPE(NoPE),Qwen3 词表 153k,SwiGLU FFN、RMSNorm、GQA,DCLM 语料、16,384 上下文。(2) 早期阶段:使用 DCLM 全局分片 01,约 2.05N token(1B 为 1.60B),冻结整个 KDA 块——mixer、MLP、归一化全部停更,仅训练注意力块、绑定嵌入与最终归一化;优化器 AdamW,峰值学习率 $10^{-4}$,线性 warmup 后恒定,批 16 序列(262,144 token/update)。(3) 主体阶段:解冻全部参数,从当前权重继续,重置优化器与调度;换用 Muon(lr 0.02)加辅助 AdamW(lr 0.001),数据用分片 02–10 约 20.5N token(1B 为 16.0B),warmup+恒定+余弦衰减,批 32 序列(524,288 token/update)。vanilla 基线使用完全相同的数据视图、token 预算和调度,仅不做冻结。
技术新颖性
新颖性可从三层看。现象层:首次命名并系统刻画 Competing Learning——先学到的能力通过降低检索特定预测误差抑制其他层的同类学习,并以三类实验支撑:冻结一方立刻刺激另一方(Figure 4)、梯度范数 10 倍渐进放大且解冻即回落(Figure 5)、长短程数据配比决定赢家(Figure 3)。方法层:“冻结弱者给先发优势”看似简单,但此前最相关的 Qiao et al. (2026) 仅停留在观察层面;本文给出可操作的时间表(约 1/11 数据量)并证明解冻后分工因自增强而持续保持,还揭示了临界窗口(合成实验中 step 125 前后冻结导致解冻后命运完全相反)。验证层:在 KDA、GDN、GLA 三种循环架构、180M–1B 六个规模上系统验证,并用共享底座的幂律拟合 $L=E+A(N/10^9)^{-\alpha}$($E=2.389$,$\alpha_B=0.34502$ 对 $\alpha_V=0.34649$)证明优势可外推到评估规模之外,这种消融完整度在训练方法论文中少见。
实验结果
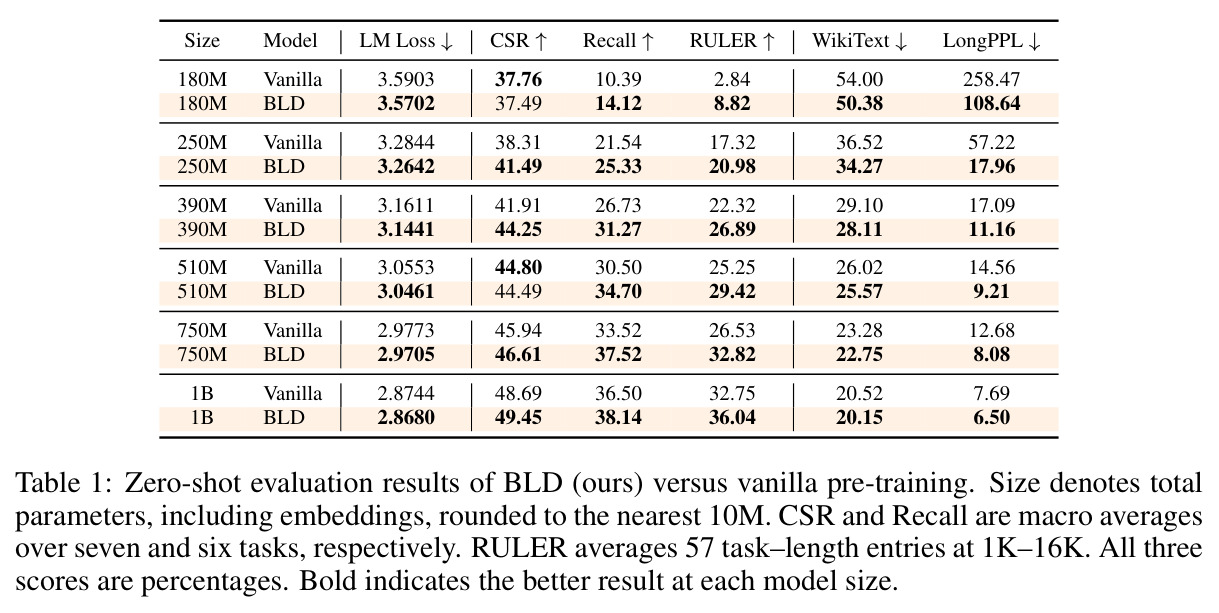
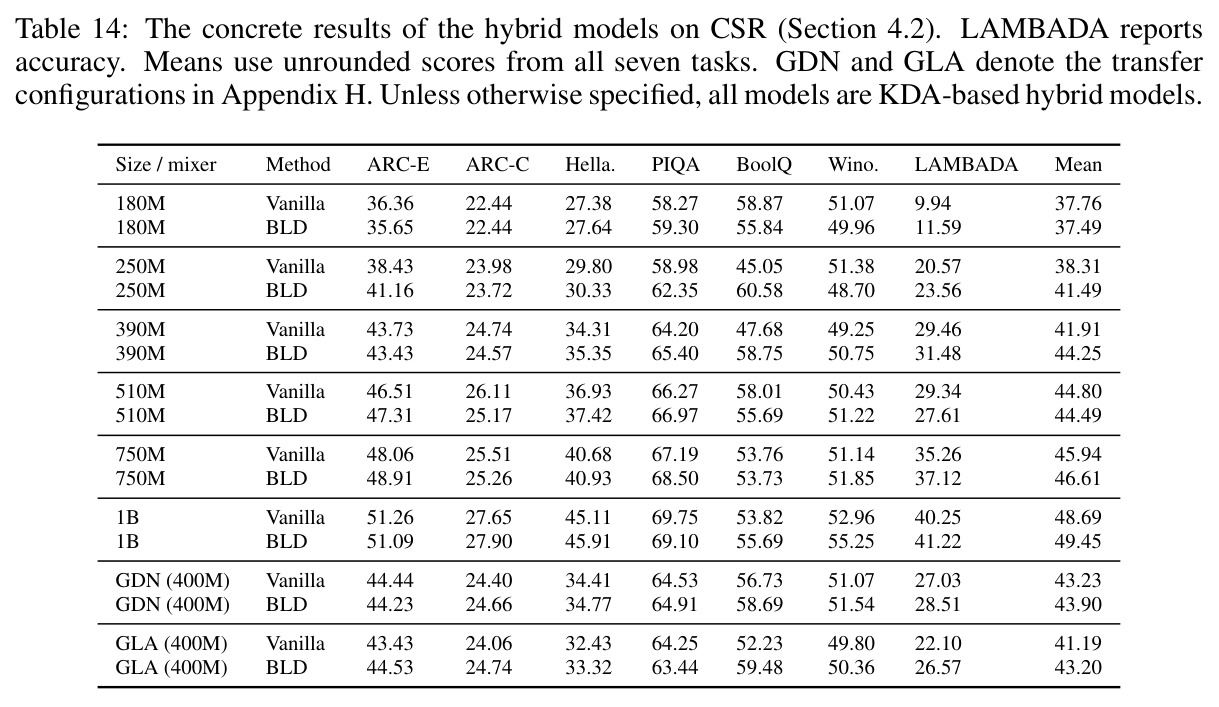
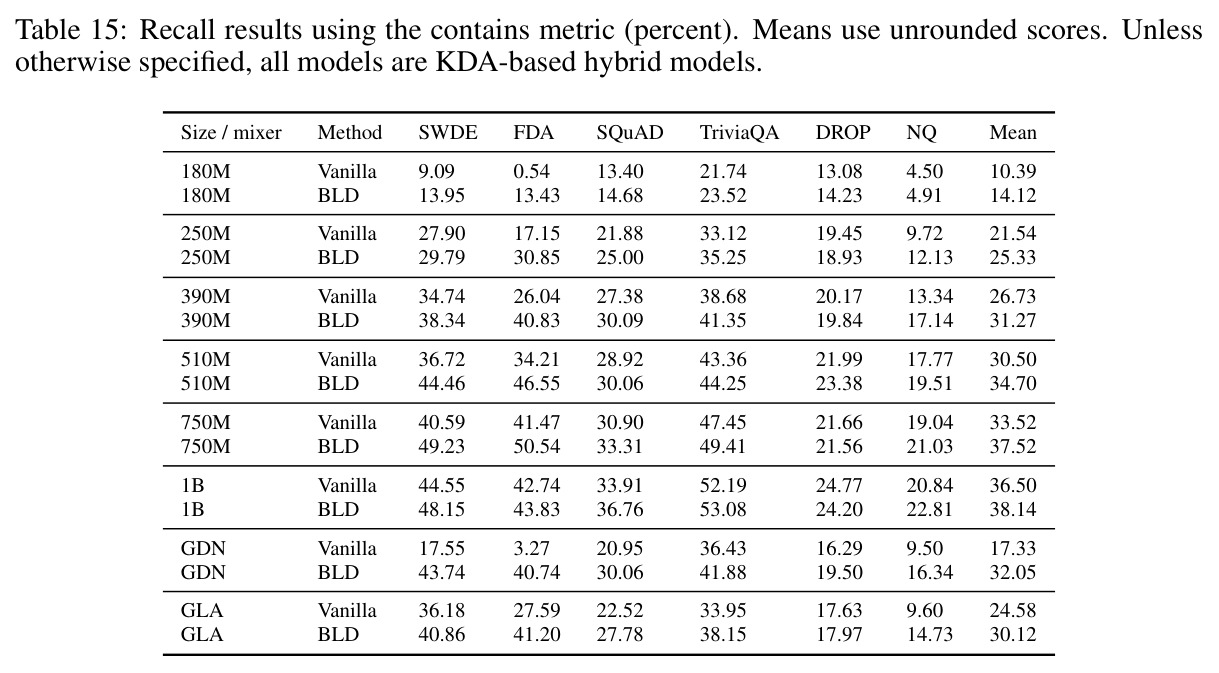
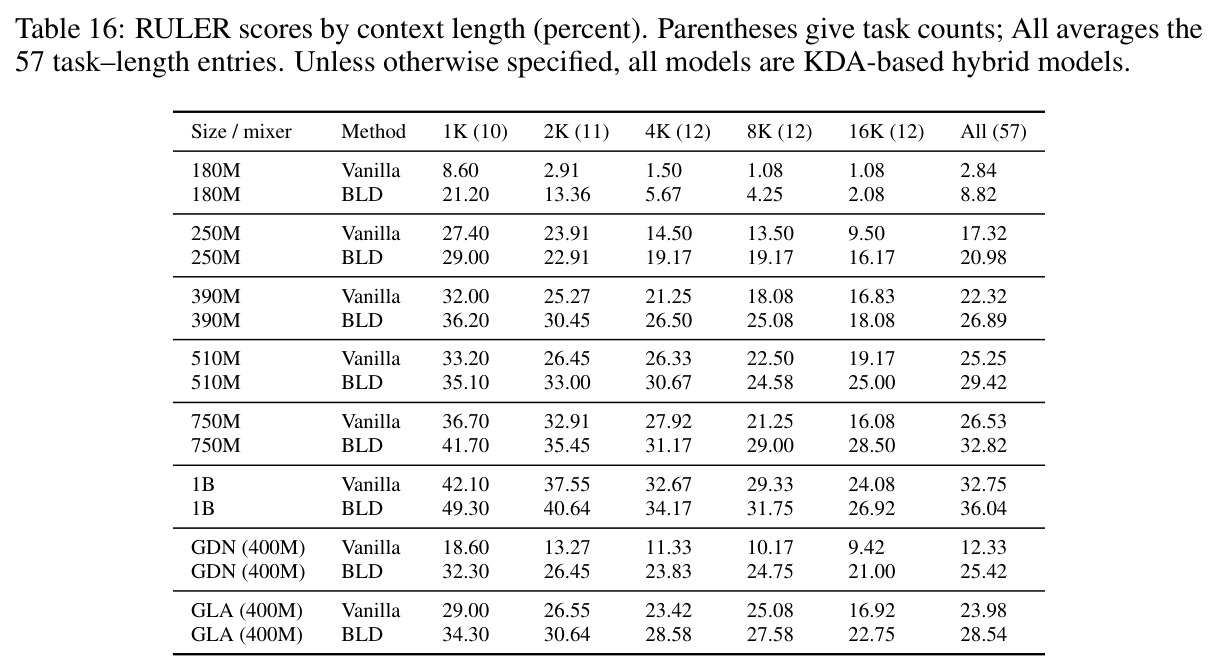
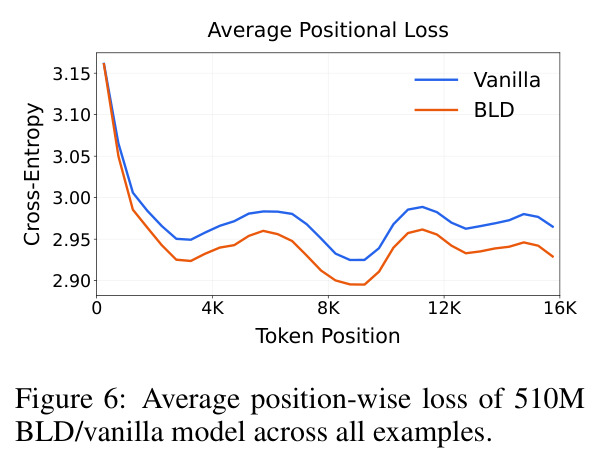
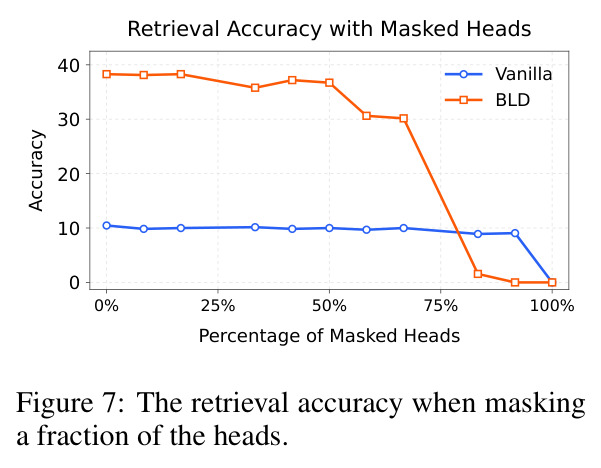
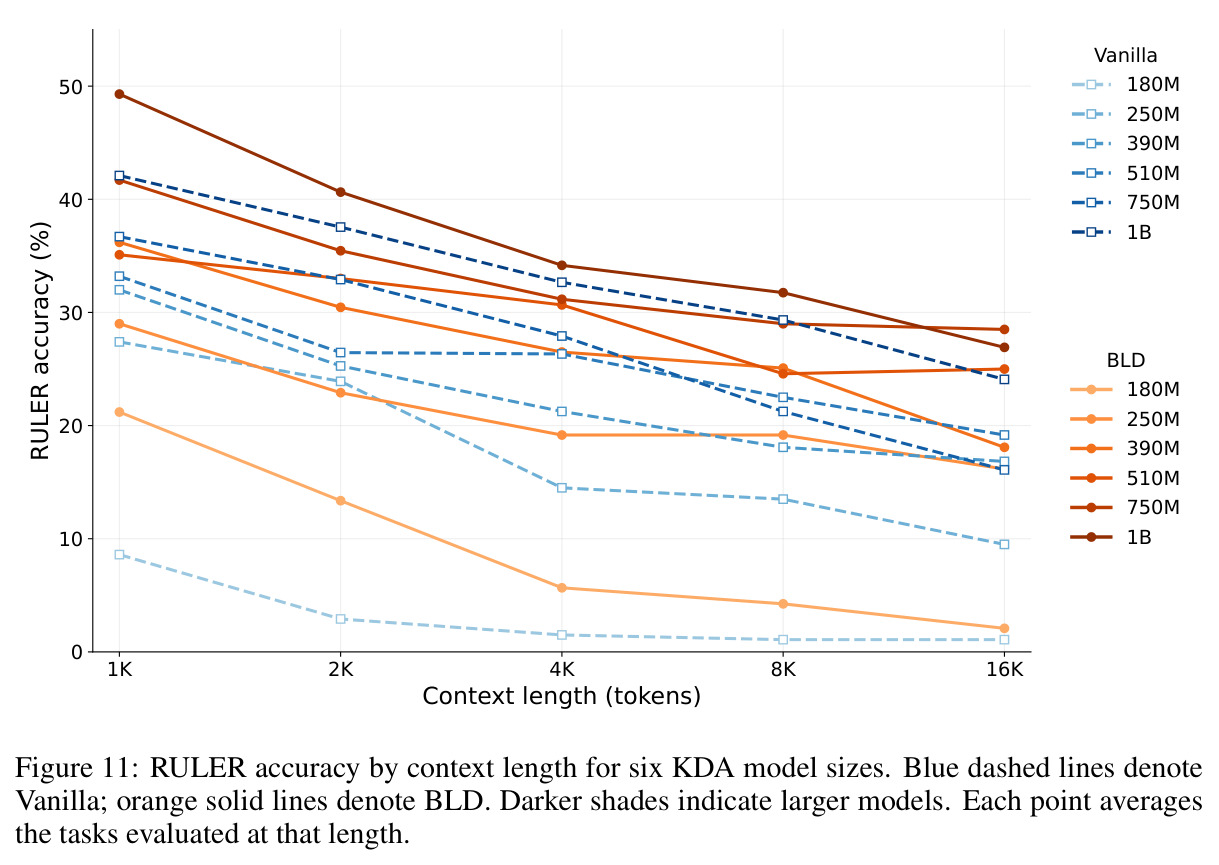
主实验(Table 1,180M–1B 六规模、DCLM 约 20N token、零样本):LM 损失全线更低(1B 2.8680 对 2.8744);CSR 多数规模提升(250M 41.49 对 38.31、1B 49.45 对 48.69,但 180M/510M 略降);检索类任务大幅改善:Recall 均值 750M 37.52 对 33.52、510M 34.70 对 30.50;RULER 1B 36.04 对 32.75、180M 约 3 倍(8.82 对 2.84);LongPPL 改善最显著:510M 9.21 对 14.56(降 36.7%)、180M 108.64 对 258.47(降 58%)。Figure 6 显示 510M BLD 的 16K 逐位置损失全程更低且后段差距扩大。迁移实验(Table 2):GDN 400M Recall 32.05 对 17.33(+85%)、RULER 25.42 对 12.33、LongPPL 11.77 对 152.84;GLA 400M Recall 30.12 对 24.58。机制证据(Figure 9/7):BLD 的 12 个 KV 头含 3 个高 α 检索头而 vanilla 仅 1 个,按 α 升序遮蔽时只在遮掉最后 3 头时准确率骤降。缩放拟合(Figure 8、Table 20)显示两者指数几乎相同,优势可外推到更大规模。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语言建模(训练损失) | LM Loss(最后100次更新平均,越低越好) | 2.8680(1B BLD) | 2.8744(1B Vanilla) | 六个规模一致更低,180M 为 3.5702 对 3.5903 |
| 常识推理 CSR(7任务宏平均) | 准确率 %(越高越好) | 49.45(1B BLD) | 48.69(1B Vanilla) | +0.76;250M 提升 +3.18(41.49 对 38.31) |
| 召回密集任务 Recall(Based 套件 6 任务) | contains 得分 %(越高越好) | 38.14(1B BLD) | 36.50(1B Vanilla) | +1.64;GDN 400M +14.72(32.05 对 17.33,+85%) |
| RULER 长上下文检索 | 57 个任务-长度组合平均 %(1K–16K) | 36.04(1B BLD) | 32.75(1B Vanilla) | +3.29;180M +5.98(8.82 对 2.84,约 3 倍) |
| WikiText-2 语言建模 | 词级困惑度(越低越好) | 20.15(1B BLD) | 20.52(1B Vanilla) | -0.37;180M 50.38 对 54.00 |
| LongPPL 长文选中 token 困惑度 | pooled perplexity(越低越好) | 6.50(1B BLD) | 7.69(1B Vanilla) | -15.5%;510M -36.7%(9.21 对 14.56);180M -58%(108.64 对 258.47) |
局限与改进
作者承认 BLD 只是应对竞争学习的初步方案:冻结时长(约 1/11 数据、2.05N token)是经验超参,没有自适应确定机制;机理分析主要依赖 3.6M 参数合成模型,向真实语言分布的推广靠外推;方法需分阶段切换优化器(AdamW 换 Muon)并重置状态,工程复杂度增加。我自己的观察:(1) 收益不均匀——180M 和 510M 的 CSR 反而略降(37.49 对 37.76、44.49 对 44.80),说明冻结期注意力单独训练可能牺牲部分通用能力;(2) LongPPL 相对改善随规模缩小(180M 降 58%、1B 仅降 15.5%),检索红利可能随模型变大而衰减;(3) 论文没有报告解冻瞬间是否出现损失回弹或表示突变,冻结期的注意力是否对 KDA 形成补偿性依赖未知;(4) 合成任务只有单模式数字复制,真实检索的多跳、聚合、模糊匹配下竞争动态可能不同;(5) 未验证 SFT/RLHF 之后优势是否保持,也未测超过 16K 的上下文。
独立分析的弱点
(1) 冻结时间表完全经验化:为何是 1/11 数据量、2.05N token 没有原理性解释,也没有在线监控机制——改进方向是把 Section 3.2 的层归因分数搬进真实预训练,实时跟踪两类混合器的检索贡献并自适应解冻。(2) 规模验证偏小:最大仅 1B、17.6B token,而 LongPPL 相对收益已从 180M 的 -58% 缩到 1B 的 -15.5%,缩放律外推到 3B/7B 的可靠性需要实证。(3) 数据配比这条线没有被用于方法设计:Figure 3 证明长程样本占比决定赢家,那么在数据侧增加长程检索类语料可能与冻结互补甚至替代冻结。(4) 分工证据集中在注意力头层面(3 对 1 个检索头),缺少每层有效感受野距离谱的直接可视化,无法确认 KDA 确实转向了短程功能。(5) CSR 在两个规模上的轻微退化未被解释,可尝试冻结期给 KDA 极低频更新或对注意力加正则以兼顾通用能力。(6) 早期阶段与主体阶段优化器不同(AdamW 对 Muon),BLD 与 vanilla 的对比未完全解耦“冻结效应”与“优化器切换时机”两个因素。
未来方向
作者展望:对竞争学习的更深入理解将启发更好的混合架构与训练策略。基于本文成果可延伸:(1) 自适应 BLD——用层归因分数作为在线信号动态决定解冻时机,并推广到任意多组混合器场景,如 MoE 专家间、同构 Transformer 层间甚至头间的竞争;(2) 数据课程与竞争学习结合——既然配比决定赢家(Figure 3),可设计先长程后短程的课程来代替或叠加冻结;(3) 在蒸馏式混合化(Chen et al., 2026 的层替换路线)中显式注入竞争学习约束,使蒸馏模型与原生预训练的分工一致;(4) 检验竞争学习能否解释纯 Transformer 中检索头只占少数的现象,把层间竞争与头间竞争统一进一个框架;(5) 理论化:把“先学抑制后学”形式化为数据依赖的梯度信号分配,联系富者愈富动力学与 grokking 现象;(6) 在超过 16K 的长上下文、SFT 与智能体任务上验证分工改善带来的实际下游收益。
复现评估
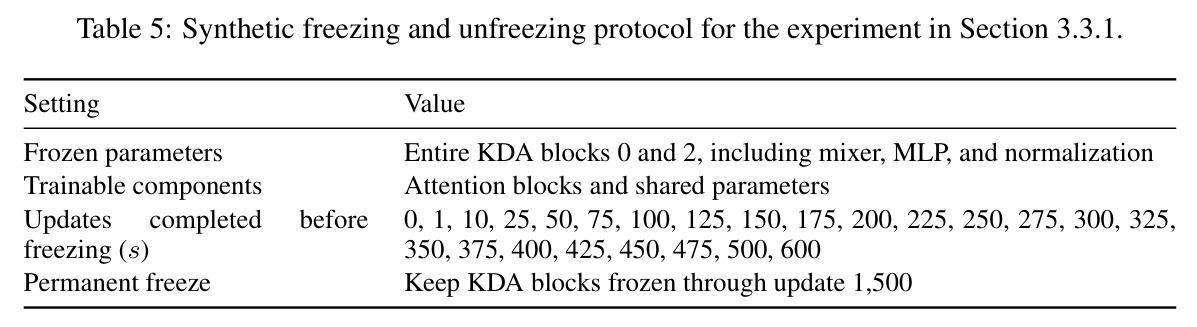
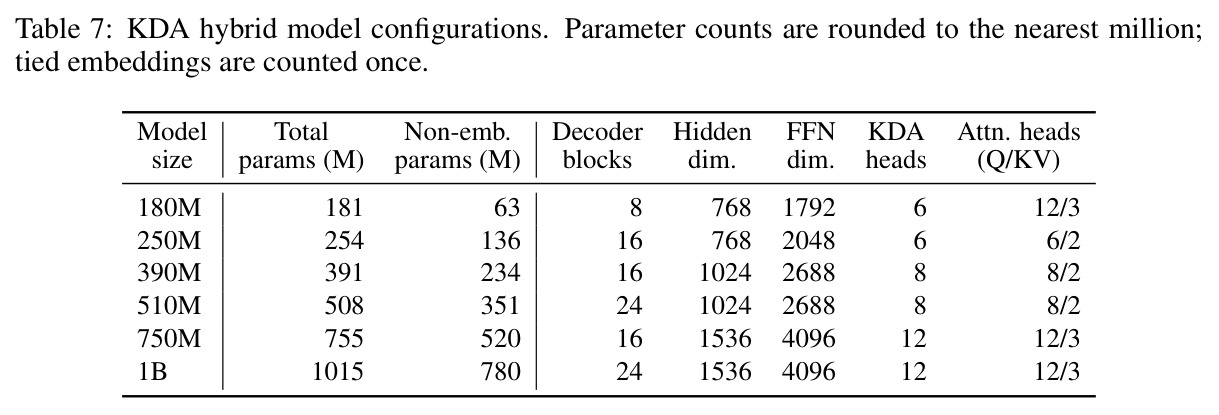
复现条件较好。代码已在 GitHub 开源(github.com/thunlp/competing-learning),作者承诺公开训练/评测代码、实验数据与模型检查点。附录信息极其完备:合成任务数据与模型配置(Table 3/4:12 符号词表、50,000 个训练键、AdamW 1,500 次更新、峰值学习率 3e-4)、冻结/解冻协议(Table 5,24 个冻结时点,梯度实验 10 个随机种子)、六个规模的完整模型配置(Table 7)、BLD 冻结范围与数据分片(Table 9)、token 预算(Table 10)、优化器与分尺寸调度(Table 11/12)、评测协议(Appendix E,含用 Qwen3-8B 作参考模型的 LongPPL 复现细节 Table 13)、检索头识别设置(Table 23)。算力门槛:1B 模型 17.6B token 用 8 卡即可(Table 12),合成实验单卡可跑,中小实验室可承受。风险点主要是 Muon 实现与 DCLM 分片一致性,但均有公开参照。总体难度中等,属同类论文中可复现性上乘之作。
论文图表
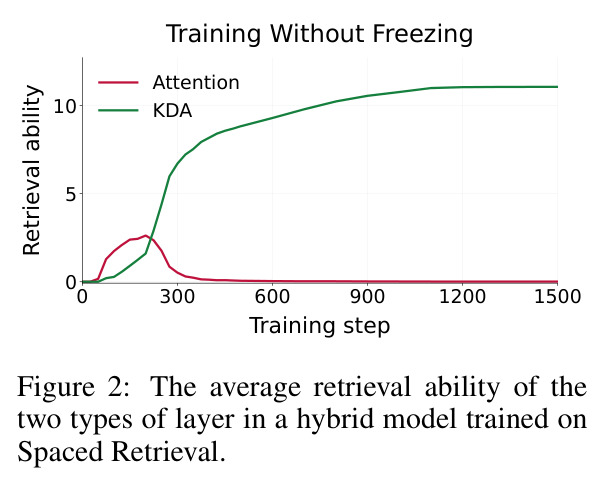
无干预训练时 KDA 层与注意力层平均检索能力随训练步数(0–1500 步)的变化:KDA 曲线早期迅速上升并占据主导,注意力层几乎不增长,直观呈现“KDA 抢占检索功能”的问题起点。
直接展示问题:标准训练下循环层赢得检索竞争,注意力学不到检索,这是提出 BLD 的动机。
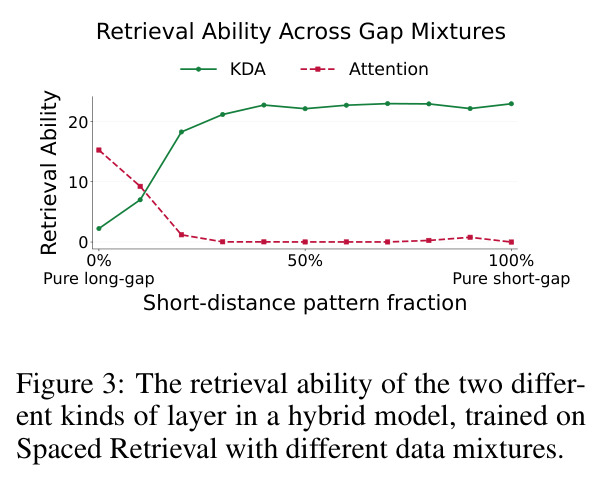
改变训练数据中短距离(g=64)样本占比 $p$(0 到 1 共 11 档,每档至少 3 个种子):长距离样本占比越高注意力层检索能力越强;短距离模式不过分稀少时 KDA 占优。两端分别标注 Pure long-gap 与 Pure short-gap。
解释了为什么自然语言(短程模式占多数)下 KDA 成为赢家,把现象与真实预训练分布联系起来。
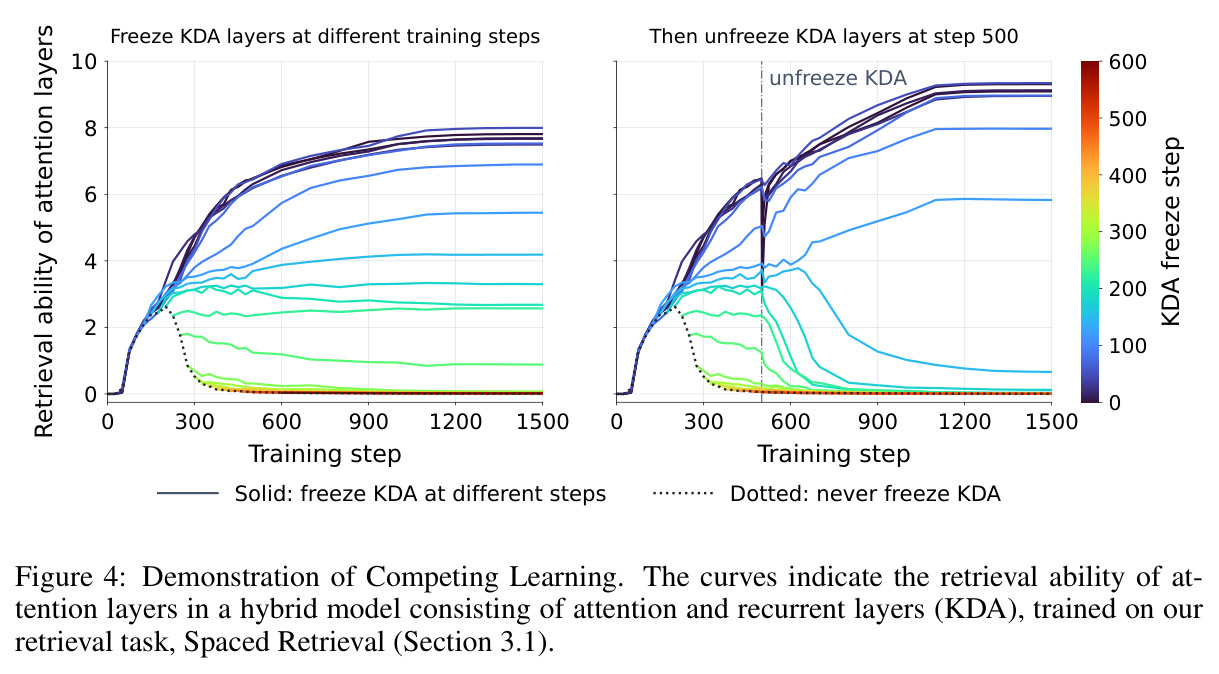
左图:在不同训练步冻结 KDA 层后,注意力层检索能力每次都立刻跳升;右图:在 step 500 解冻 KDA,早于 step 125 冻结的 run 解冻后注意力继续上升(甚至超过永久冻结),晚于 125 冻结的则迅速回落。
提供竞争学习的因果证据,并揭示临界窗口:只有先发优势足够大,解冻后分工才会被锁定。
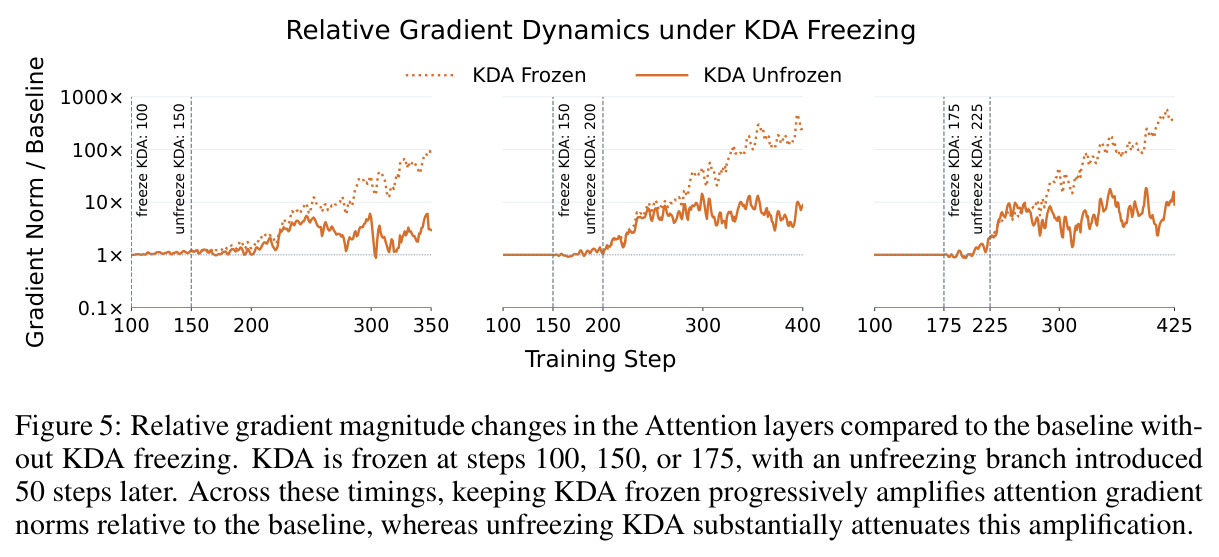
以 10 个种子测量注意力层梯度范数相对“从不冻结”基线的比值:KDA 冻结后注意力梯度范数渐进放大至约 10 倍(对数坐标显示 0.1×–1000× 区间),解冻分支(freeze 后 unfreeze)的放大立即明显减弱。
从优化信号层面证实竞争学习的自增强机制:学习信号按当前能力差距动态分配,冻结弱者会向强者转移梯度。
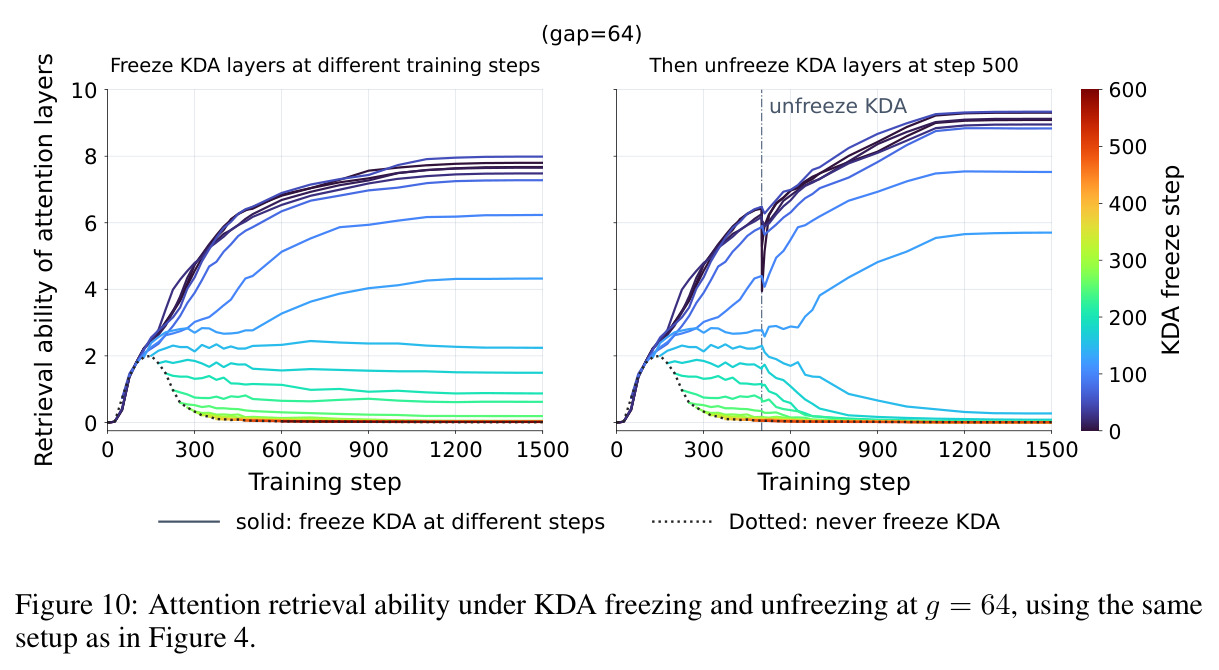
把 Figure 4 的冻结/解冻实验在短距离设定 g=64 下重复:注意力检索能力在每次冻结后同样立刻跳升,解冻后同样出现“早冻结则保持优势、晚冻结则被反超”的分化,与 g=8192 的结果一致。
说明竞争学习现象不依赖特定 gap 长度的选择,是分析结论的稳健性检验。