面向脑编码的参数高效微调扩展(BrainLoRA) Scaling Parameter-Efficient Fine-Tuning for Brain Encoding
用LoRA微调高达104B的多模态骨干刷新脑编码SoTA,单遍特征提取提效350倍
前置知识
脑编码模型(brain encoding model)
给定刺激(视频、音频、文本)预测其诱发的大脑响应(fMRI、EEG 等)的计算模型,通常写作 $\hat{Y} = g_\phi(f_\theta(X))$:预训练骨干 $f_\theta$ 提取刺激特征,读出层 $g_\phi$ 负责时间对齐并映射到各脑区。评价标准是预测与真实响应的 Pearson 相关系数 $r$。主流范式冻结骨干、只用神经数据训练读出层。
本文的核心问题是“该不该、以及如何用神经数据微调骨干”,必须先理解“冻结骨干+读出”这一默认范式及其局限,才能体会 PEFT 路线的意义。
参数高效微调(PEFT)与 LoRA
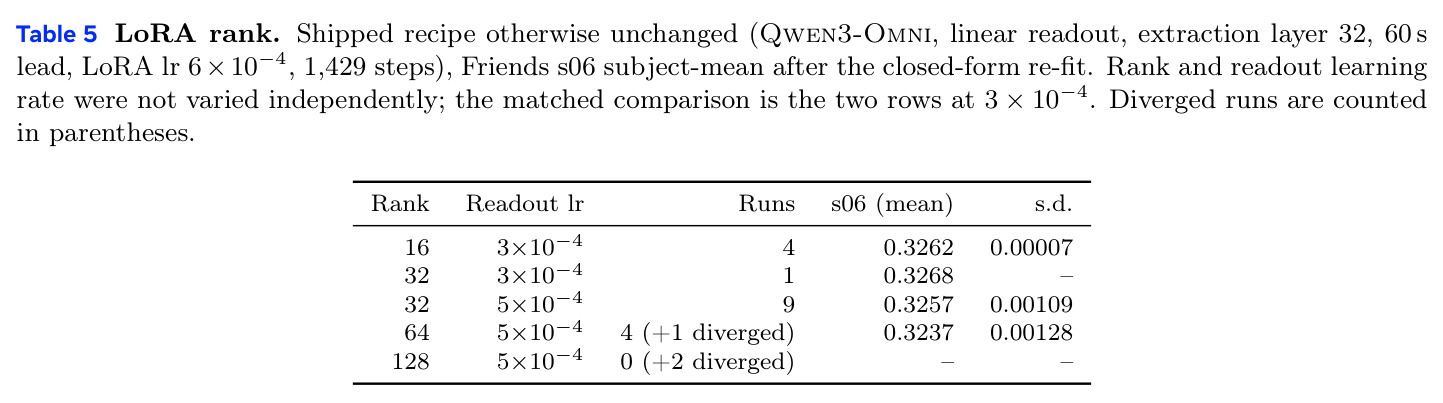
PEFT 冻结预训练权重 $\theta_0$,只训练一个低维更新 $\Delta(\psi)$。LoRA 令 $\Delta W = BA$,其中 $B\in\mathbb{R}^{d\times r}$、$A\in\mathbb{R}^{r\times k}$,秩 $r\ll d$。本文用 $r=16$,只插入注意力的 q/k/v/o 投影,共 8.91M 可训练参数,且可合并回权重、几乎不增加推理开销。
BrainLoRA 的全部性能与效率优势都建立在 LoRA 之上;理解秩、参数预算和可合并性,才能读懂其主实验、消融与多 LoRA 训练核。
fMRI 与脑区划分
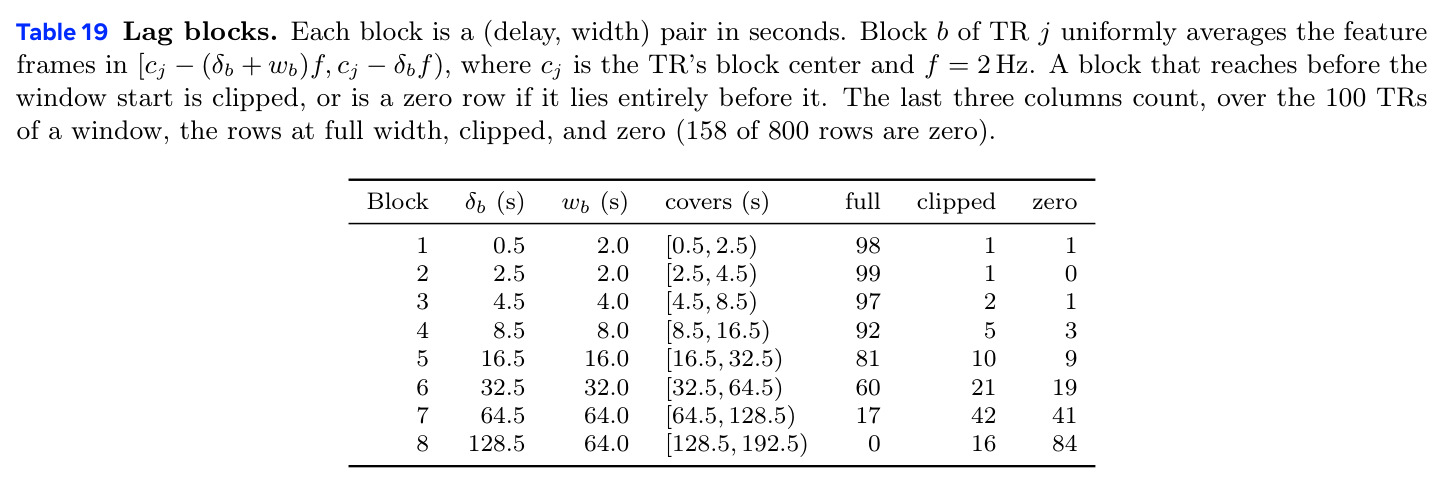
fMRI 以约 1.5 秒(本文 TR=1.49 s)为单位采样全脑血氧信号,空间覆盖全脑但时间分辨率低。Algonauts 基准把每个时间点表示为 1000 个 Schaefer 脑区的平均活动,预测目标即每时间点一个 1000 维向量。血氧响应滞后刺激约 4–6 秒,因此读出层要做血动力学滞后对齐(本文固定移位 4.47 s,并用 8 个对数间隔的滞后块聚合)。
读出层的时间滞后聚合、TR、1000 parcels 等设计都依赖这些基础概念,不看懂它们就无法理解方法部分。
CNeuroMod / Algonauts 2025 挑战赛
目前最大的自然主义全脑 fMRI 基准:被试观看多季《老友记》与多部电影,同步视频、音频和字幕。训练用四季(S1–5)4 名被试,Season 6 验证,Season 7 为分布内测试(ID),新电影为分布外测试(OOD),指标为四被试平均 Pearson $r$。该配置的种子间波动约 0.00077,差距小于此的分数不可靠区分。
本文所有主结果、SoTA 对比和排行榜成绩都在该基准上报告,不了解其数据划分与指标就无法评估结论强度。
因果掩码与单遍特征提取
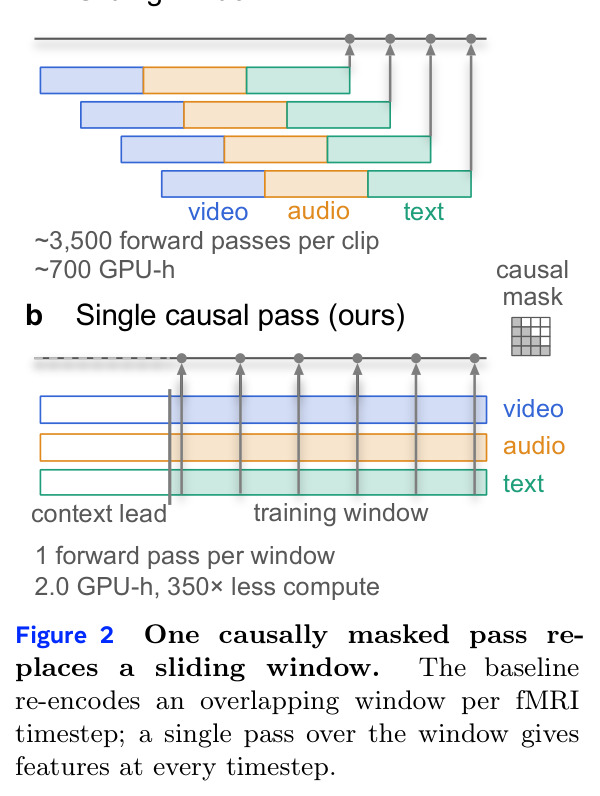
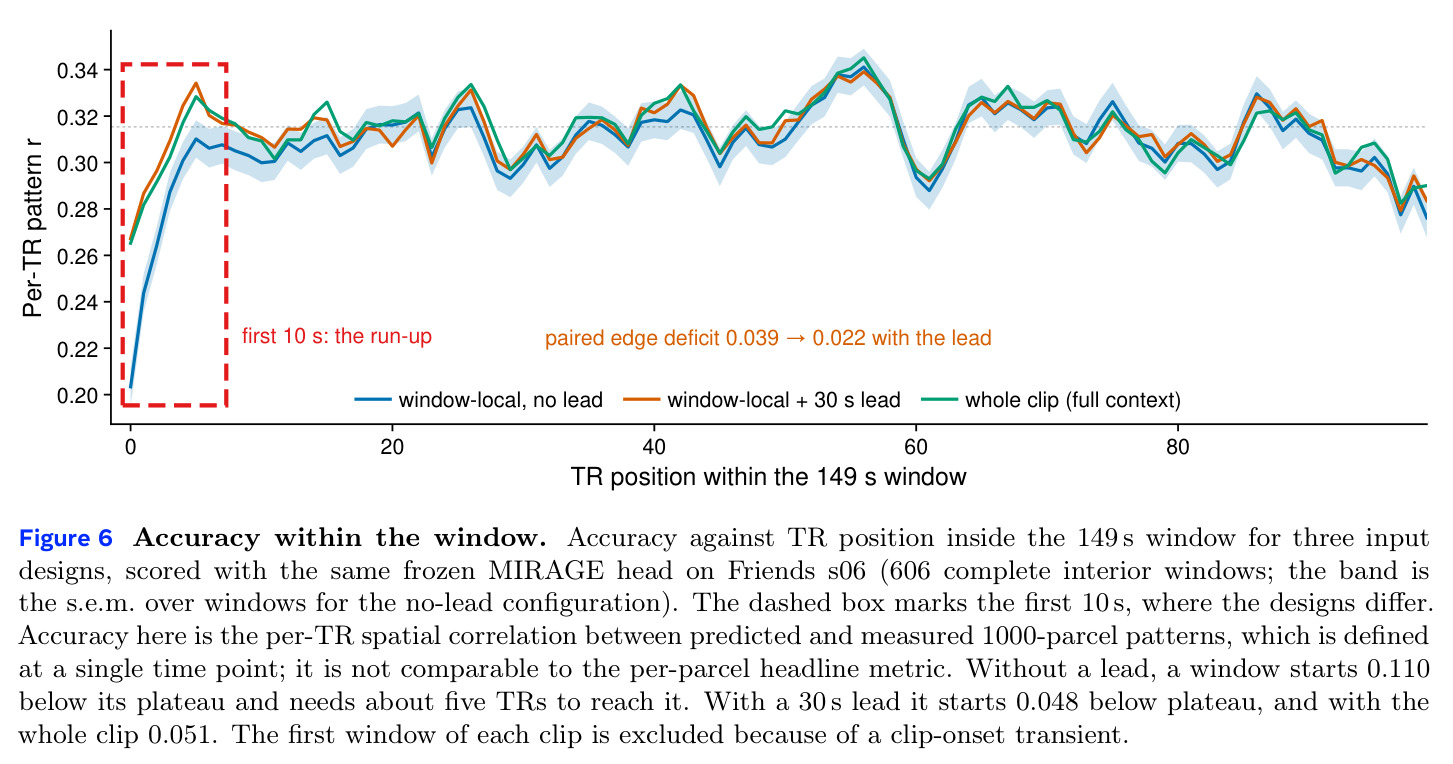
因果(自回归)Transformer 中时间 $t$ 的表示只依赖 $t$ 之前的输入。传统做法用重叠滑窗反复编码同一片段(先前 SoTA 每片段约 2,758 次前向);利用因果性后,对整个 149 s 窗口做一次前向即可同时取出所有时间步的表示,成本降约 350 倍,只需在窗口头部加一段“上下文引导”(context lead)弥补开头缺上下文的问题。
这是让“反向传播穿过百亿骨干”在计算上可行的关键工程创新,也是本文多个消融与对照实验的对象。
Shapley 值模态归因
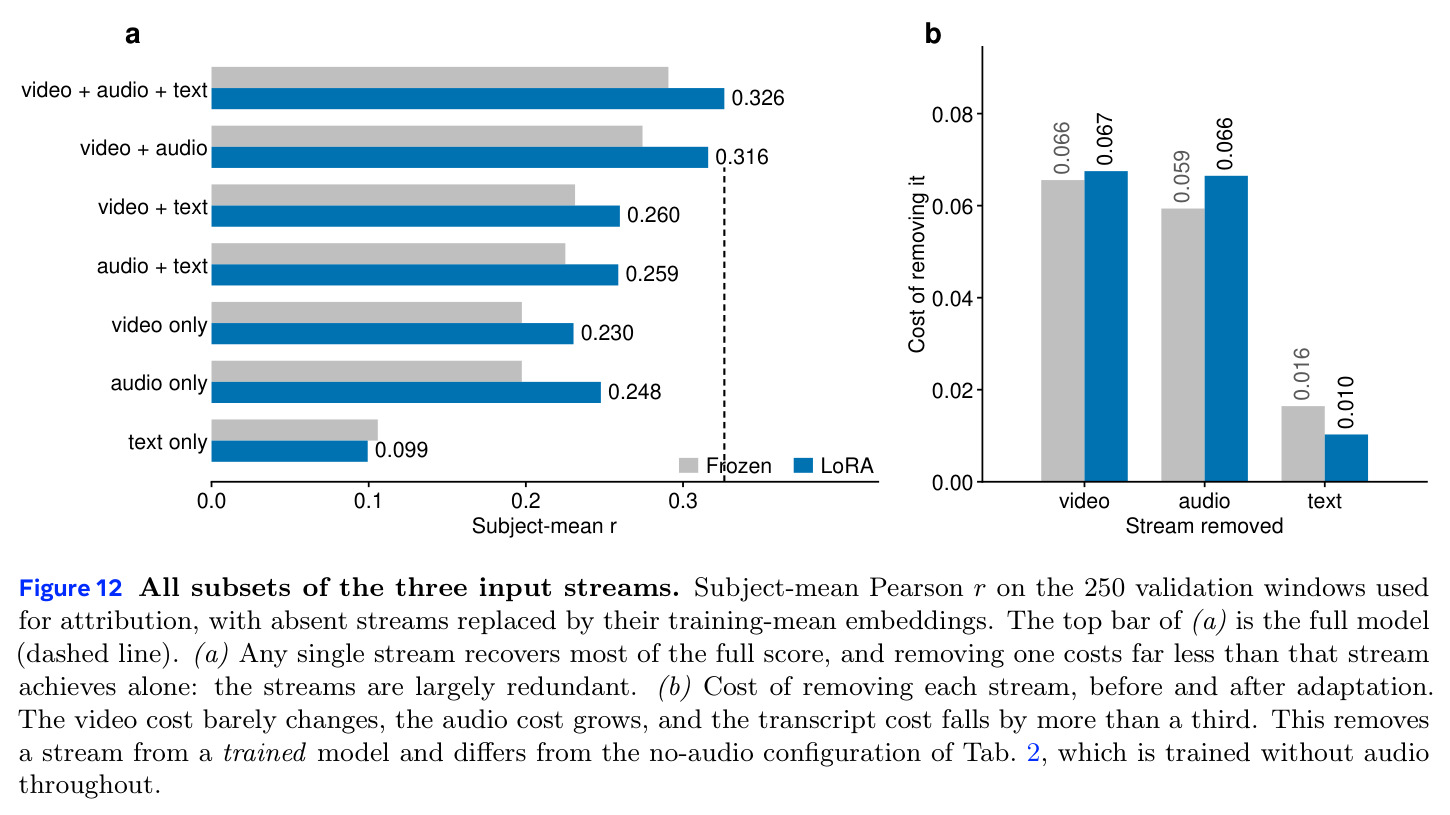
把某个输入模态(视频/音频/文本)的嵌入替换为内容无关的均值嵌入,枚举全部 $2^3=8$ 个模态子集并评估预测表现,可精确分解每个模态对编码精度的贡献(Shapley 值之和恰等于总成绩)。进一步在读出端三种模态 token 位置上分别分解,可得到 $3\times3$ 的“输入模态→读出位置”信息流矩阵。
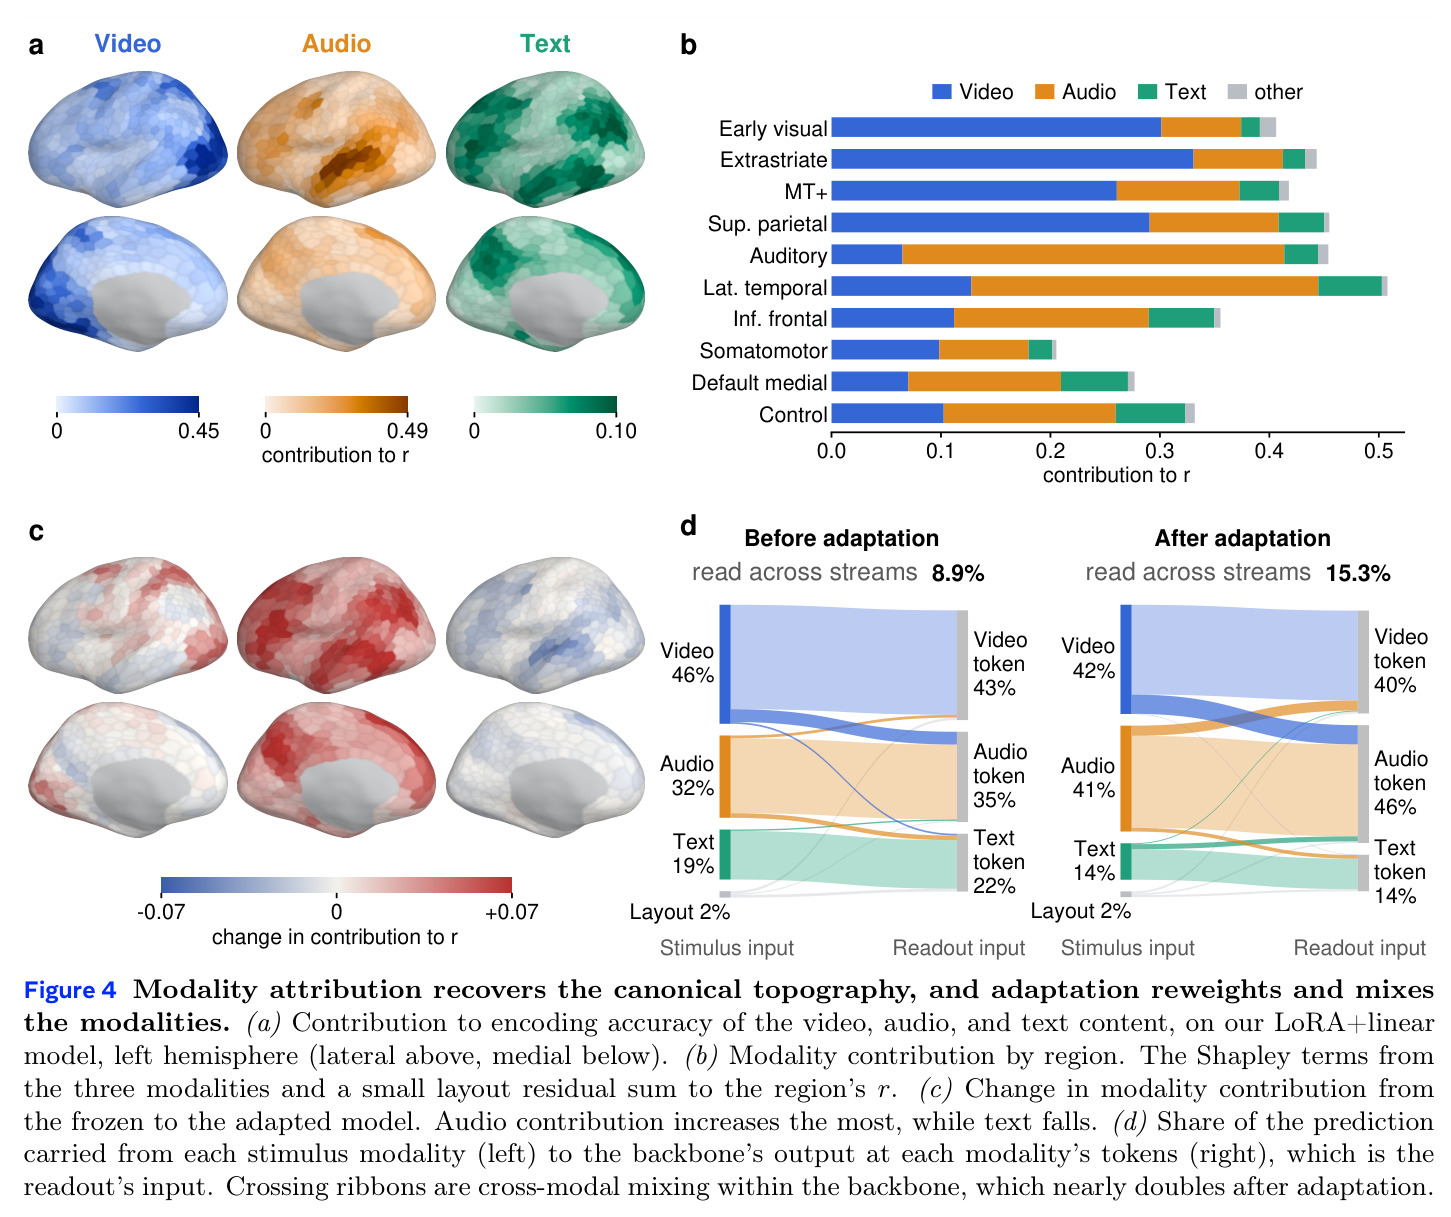
本文用它证明微调后的多模态骨干仍可解释,并发现适配加强了音频贡献与骨干内部的跨模态混合。
集成学习与误差相关性
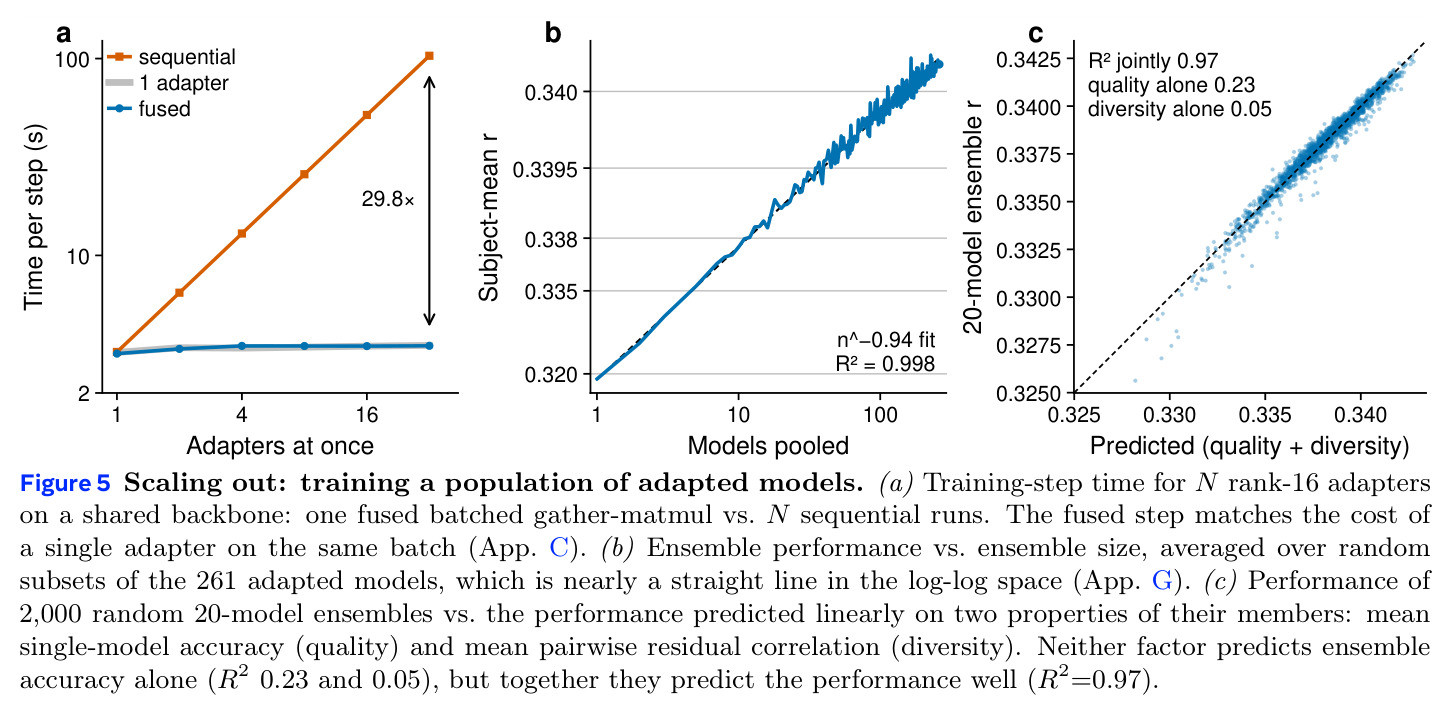
若成员残差的平均两两相关为 $\rho$,集成的残差方差为 $\sigma^2[\rho+(1-\rho)/n]$:第二项随成员数 $n$ 以 $1/n$ 收缩,第一项不缩、决定性能上限 $m_\infty$。本文拟合 $m(n)=m_\infty-An^{-b}$ 得 $b\approx0.94$($R^2=0.998$),并发现成员“质量”与“多样性”联合可解释集成成绩 97% 的方差。
它解释了 261 模型集成为何能登顶、为何换随机种子几乎无增益而换骨干/读出架构才有效。
研究动机
现有 SoTA 脑编码模型几乎都遵循“目标驱动”范式:把在大规模行为任务上预训练的模型当冻结特征提取器,只从神经数据学习读出层。Algonauts 2025 挑战赛的全部顶级方案(如 MIRAGE:冻结 Qwen3-Omni 加 1.1B 参数 Transformer 读出)都属此类,骨干表征从未为脑数据特化。而让神经数据改写表征的尝试屡屡受挫:神经数据昂贵稀缺(本文仅 4 名被试、约 1,429 个训练窗口),从头训练小模型在全脑基准上从未达到 SoTA,对预训练骨干做全量微调据报告反而不如冻结(Yang et al., 2023),15B 以上的大模型此前只被当作冻结特征提取器使用。工程上也算不起:先前 SoTA 用重叠滑窗提取特征,每片段约 2,800 次前向、共约 700 GPU 时,微调穿骨干在计算上不可行。
本文的目标是本文要证明参数高效微调(PEFT)是构建强脑编码模型的一个强大而被忽视的机制,并提出三个互补的扩展方向:Scale up——用越来越强的预训练骨干放大先验;Scale down——只用极少量可训练参数(rank-16 LoRA,8.91M)让有限神经数据适配表征;Scale out——在共享骨干上用专用多 LoRA 核并行训练大量轻量适配器组成集成。具体目标包括:(1)把适配做到算得起,特征提取成本降约 350 倍;(2)在 9 个 4.7B–104B 的多模态骨干上系统验证 LoRA 增益;(3)在 Algonauts 2025 上以约 5% 的可训练参数刷新已发表 SoTA,并让 200+ 模型集成登顶公开排行榜;(4)证明微调后的多模态骨干仍可解释。
与已有工作不同的是,PEFT 在脑编码中并非无人用过,但都停留在小规模:MEM 用 LoRA 适配小型 ViT 赢得 Algonauts 2023;BrainWavLM 用 LoRA 匹敌全量微调;Scholz 等在 3B Llama 上用 LoRA 只排第 10。没有人检验过“大模型 + PEFT”是否同样成立,超过 15B 的模型从未被神经数据直接改写过。本文的独特切入是把三件事拼在一起:借语言编码中的单遍因果提取(Antonello et al., 2023)把特征成本从约 700 GPU 时压到 2 GPU 时,使微调穿骨干变得现实;用与先前 SoTA 完全相同的骨干(Qwen3-Omni)做受控比较,把增益干净地归因于 LoRA;再自研面向训练的多 LoRA 融合核,把“适配器”当作可批量扩展的资源,首次把脑编码适配推到 104B 与 261 个模型的规模。
核心方法
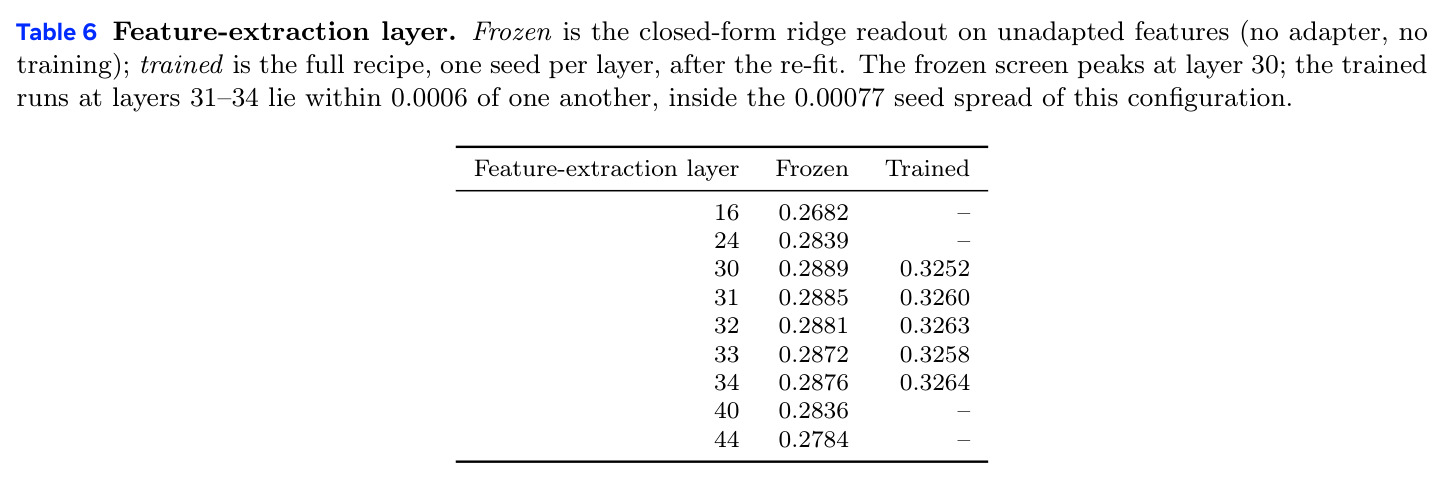
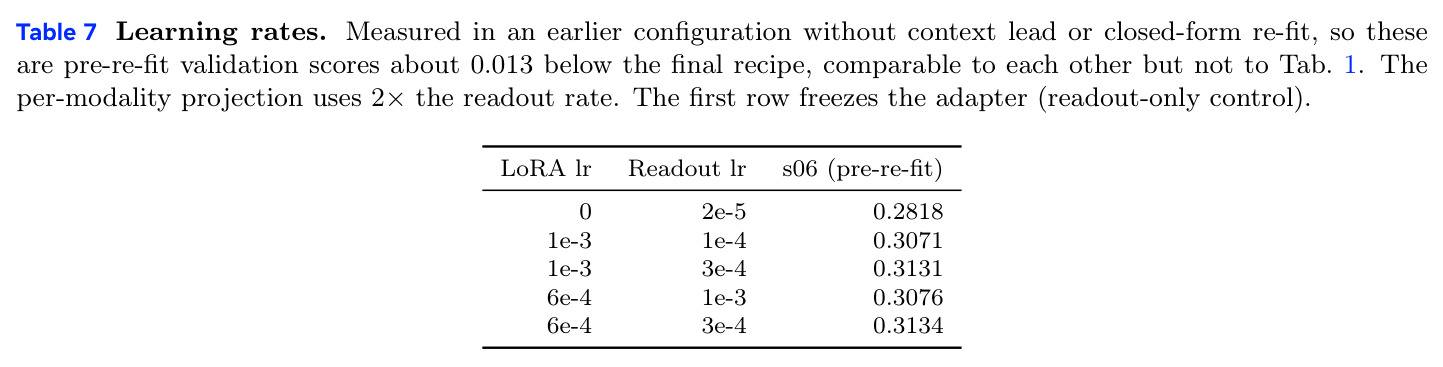
任务设定:在 CNeuroMod/Algonauts 2025 上预测观看《老友记》时的全脑 fMRI(1000 个 Schaefer 脑区,TR=1.49 s),训练用四季 4 名被试,Season 6 验证,Season 7 与新电影分别作 ID/OOD 测试。直觉:预训练多模态骨干已含强先验,只需让少量参数把表征“推向”神经数据,不必重训或全量微调。技术路线为 BrainLoRA:以 Qwen3-Omni(31.7B,MoE,每 token 激活约 3B)为骨干,截断到第 32 层解码器,向所有注意力 q/k/v/o 投影插入 $r=16$ 的 LoRA($\Delta W=BA$,8.91M 参数);刺激经单遍因果前向(149 s 窗口 + 60 s 上下文引导)在每个时间步取出三个模态的隐状态,读出层先做每模态 $2048\to512$ 线性投影,再按 8 个对数间隔滞后块(0.5–192.5 s)聚合到 2 Hz,最后线性映射到 1000 脑区(52.3M 参数);适配器与读出联合训练恰好 1 个 epoch(1,429 步),随后用闭式岭回归重拟合读出。整个单模型流水线在单张 A800 上端到端仅 8.5 GPU 时。
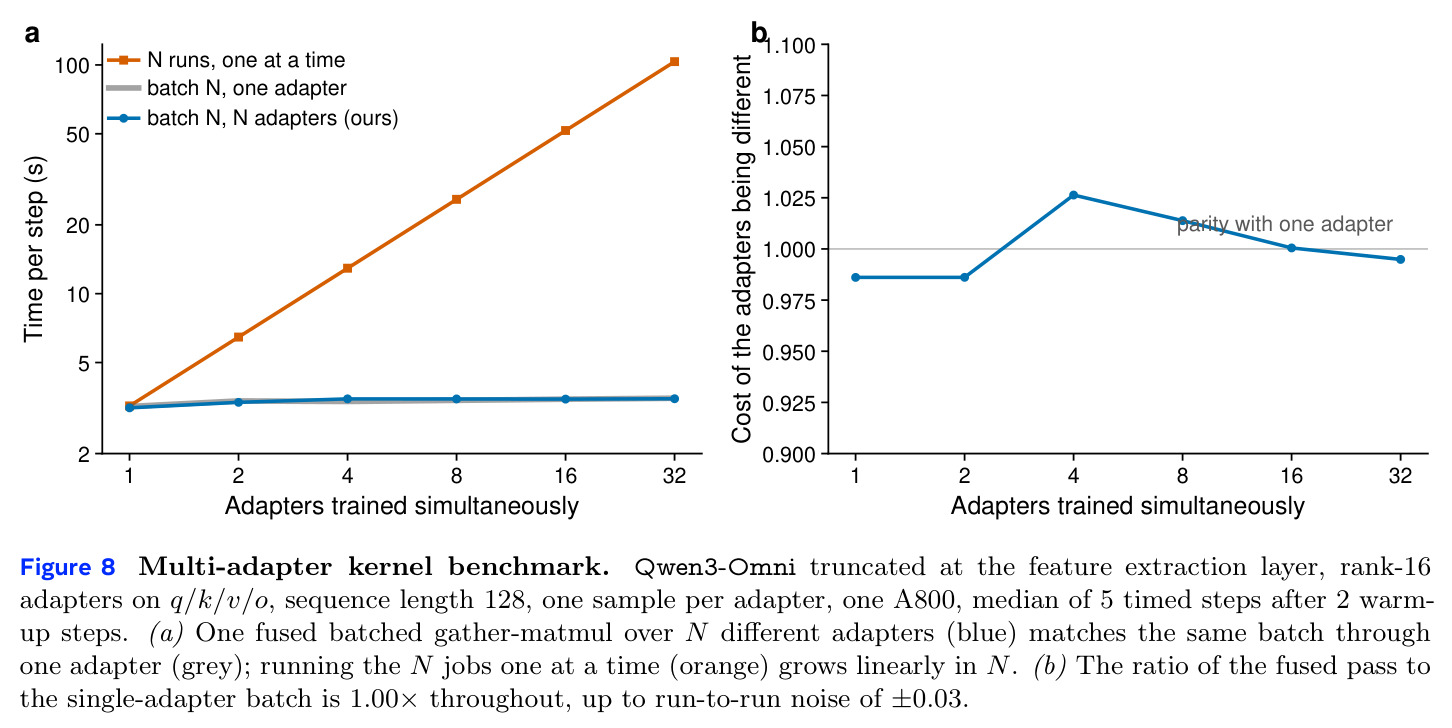
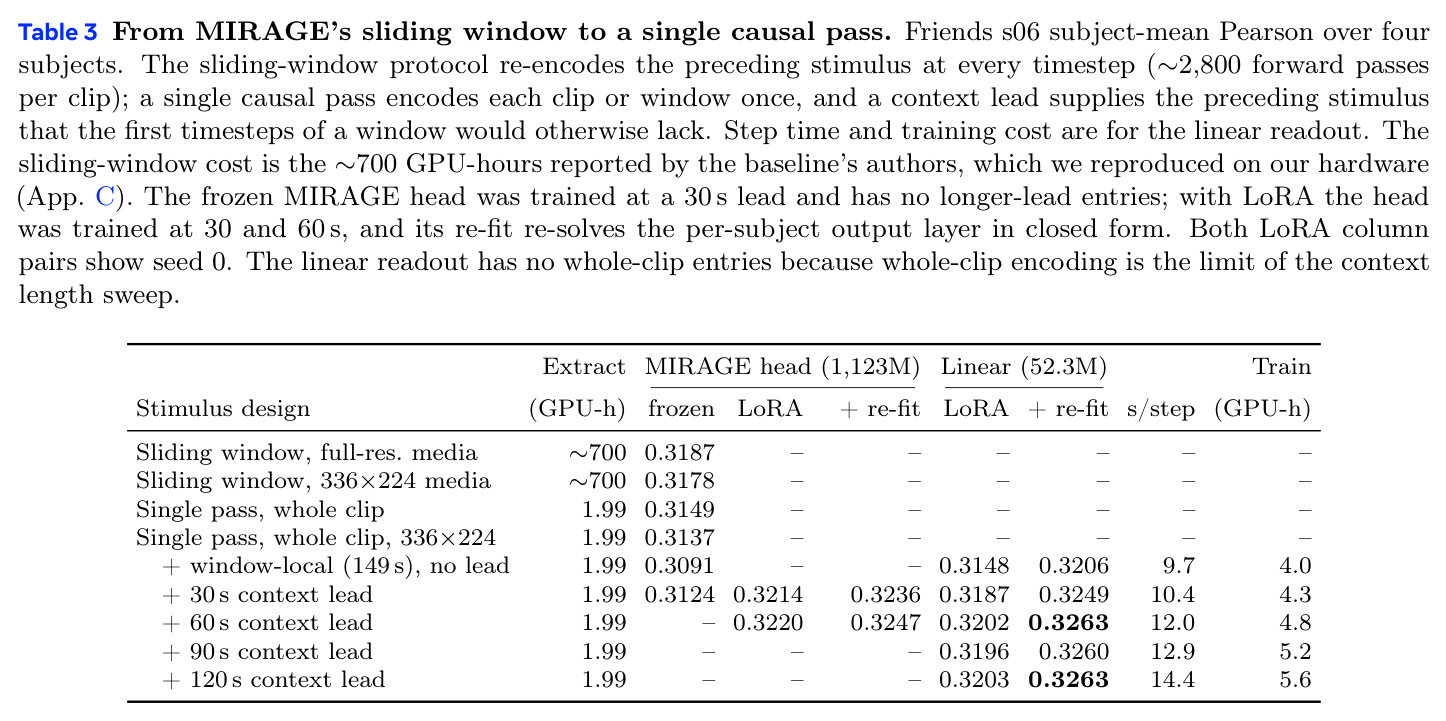
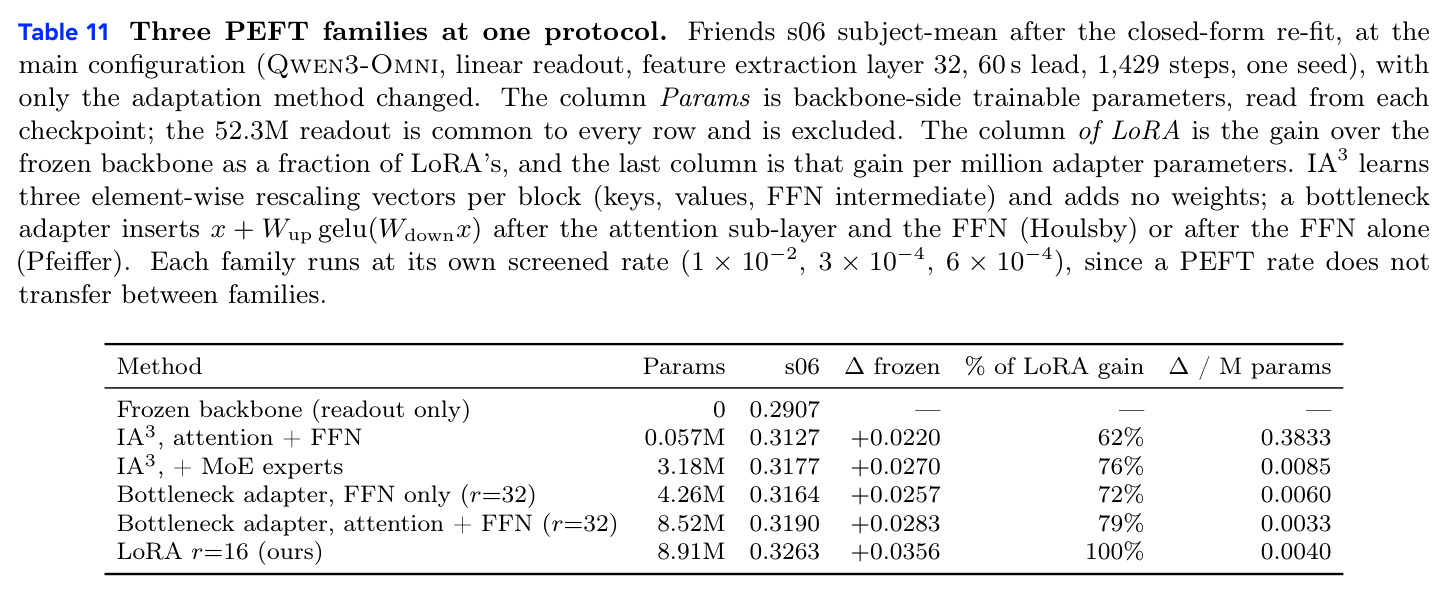
核心创新有二。其一是“算得起”:利用骨干天然因果掩码,把先前 SoTA 的滑窗协议(每片段 2,758 次前向、约 701 GPU 时)换成对每个 149 s 窗口的一次前向(每片段 5.1 次前向、1.99 GPU 时,约 352 倍节省),以 60 s 上下文引导弥补窗口开头的上下文缺失,使反向传播穿过百亿骨干从不可行变为日常操作。其二是“少参数、强适配”:与 MIRAGE 用 1.1B 读出拟合冻结特征相反,本文只用 61.2M 可训练参数(约其 5%)同时微调表征与读出,本质区别在于神经数据被允许(以低秩形式)改写骨干本身,在保留先验的同时获得表达力。配合把 $N$ 个 LoRA 的路由更新融合为一次批式 gather-matmul 的训练核($N=32$ 时较串行快 29.8 倍,成本几乎与单适配器持平),PEFT 首次在脑编码中同时沿“放大骨干、缩小适配、扩展数量”三条轴扩展。
方法步骤详情
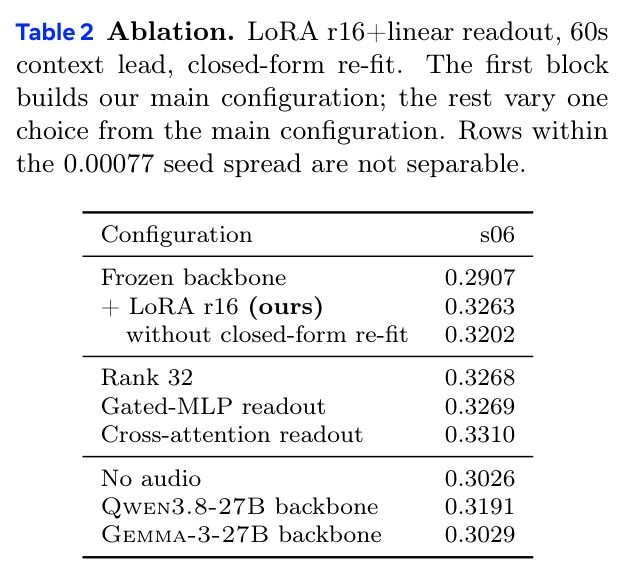
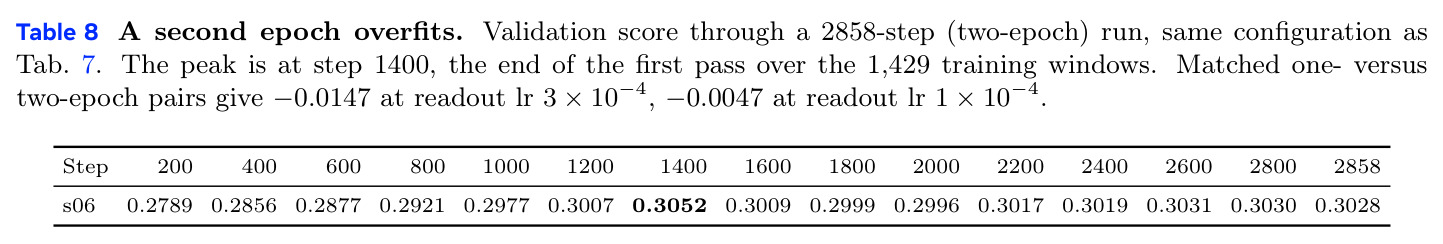
第一步,刺激缓存:视频降到 336×224(仅损失 0.0009),音频、字幕与视频按 2 Hz 特征网格对齐。第二步,单遍特征提取:对每个 149 s(100 TR)训练窗附加 60 s 上下文引导做一次因果前向,取第 32 层每模态的隐状态(每窗约 19.3k token 池化为 894 个向量;交叉注意力读出则读约 3.2k token,只加 0.2M 参数)。第三步,血动力学对齐:按固定 4.47 s 移位和 8 个(延迟,宽度)对(0.5–192.5 s)把帧平均成每 TR 800 维滞后特征。第四步,联合训练:batch 为 1 窗(400 个目标行),AdamW,LoRA 学习率 $6\times10^{-4}$、读出 $3\times10^{-4}$,1,429 步恰好一个 epoch(第二个 epoch 会过拟合,损失 0.0047–0.0147)。第五步,闭式重拟合:前向累积被试各自的 Gram 矩阵,按脑区做岭回归(惩罚从 $10^3$–$10^7$ 网格选取),单独贡献 +0.0061。第六步,Scale out:跨骨干/读出/超参训练 261 个模型,用按脑区最小方差组合器(out-of-fold 拟合)集成,并用贪婪搜索选出 15 模型子集(0.3465,为全集 1/17 推理成本)。
技术新颖性
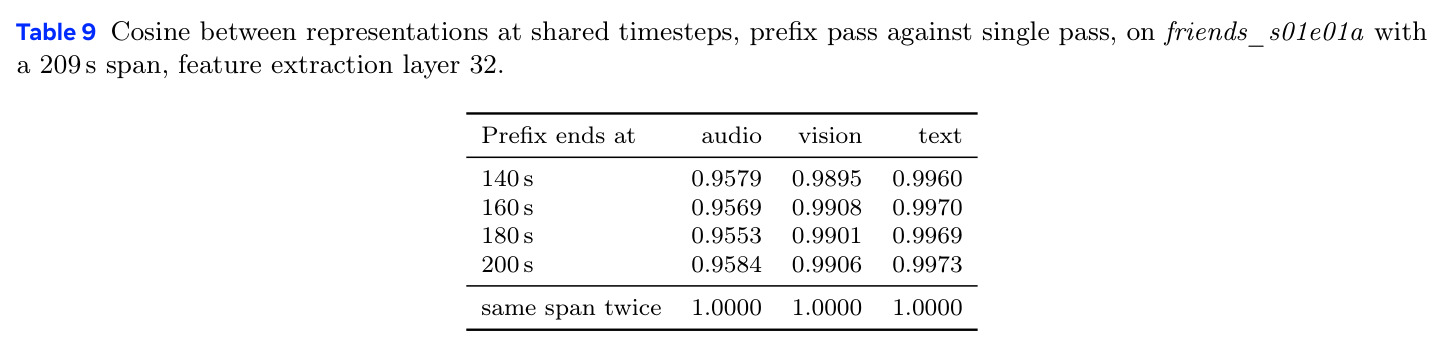
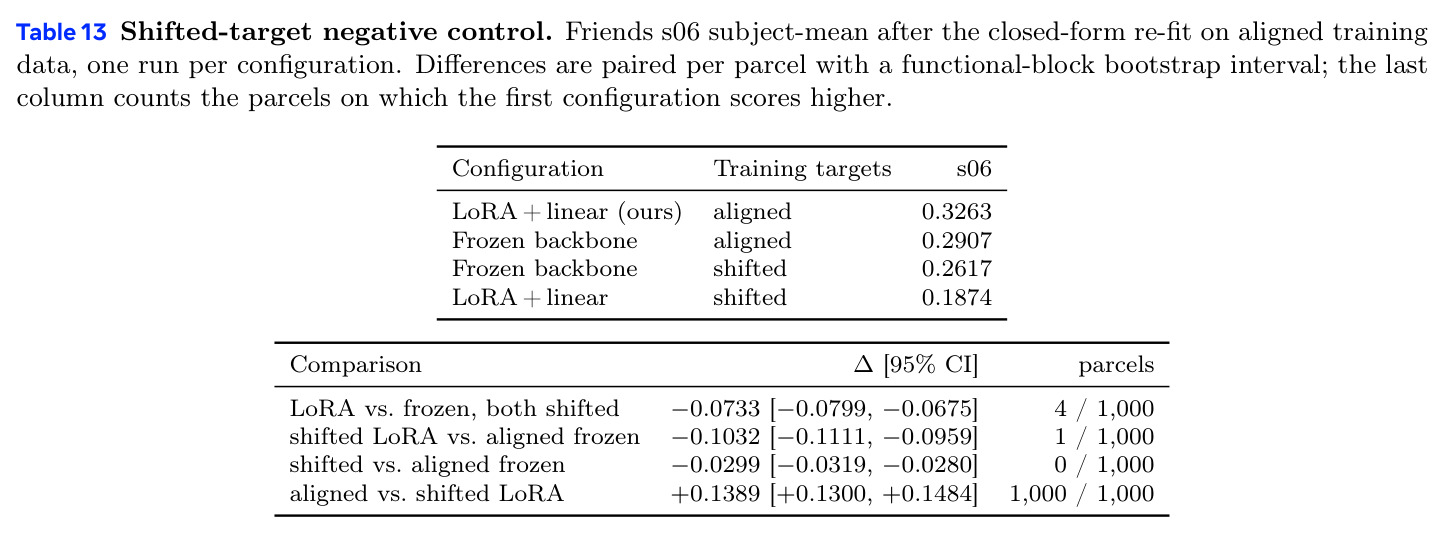
新颖性主要在“规模与系统”而非算法本身。LoRA、IA3、瓶颈适配器皆为已知技术,本文首次把它们推到 104B 的 omni 多模态骨干和全脑基准上,填补了“15B 以上模型只被冻结使用”的空白。单遍因果提取借自语言编码(Antonello et al., 2023),但把它带入 fMRI 编码并量化了代价(冻结读出下仅差 0.0038 且可被 60 s 引导恢复)与局部非因果性的数值来源(bf16 MoE 的长度相关舍入使前缀余弦低至 0.956,而非未来信息泄露)。多 LoRA 核借了 MoE 分组 matmul 与 Punica/S-LoRA 的思路,但面向“每组仅数行”的每模型一适配器训练场景是新机制:融合步成本几乎与池大小无关。可解释性方面,用精确 Shapley 归因从单一多模态骨干恢复感觉拓扑,替代以往靠单模态编码器拼装(by construction)的做法;并用移位目标、前缀重编码、预算匹配的三种 PEFT 家族对照等严格控制把结论钉牢。
实验结果
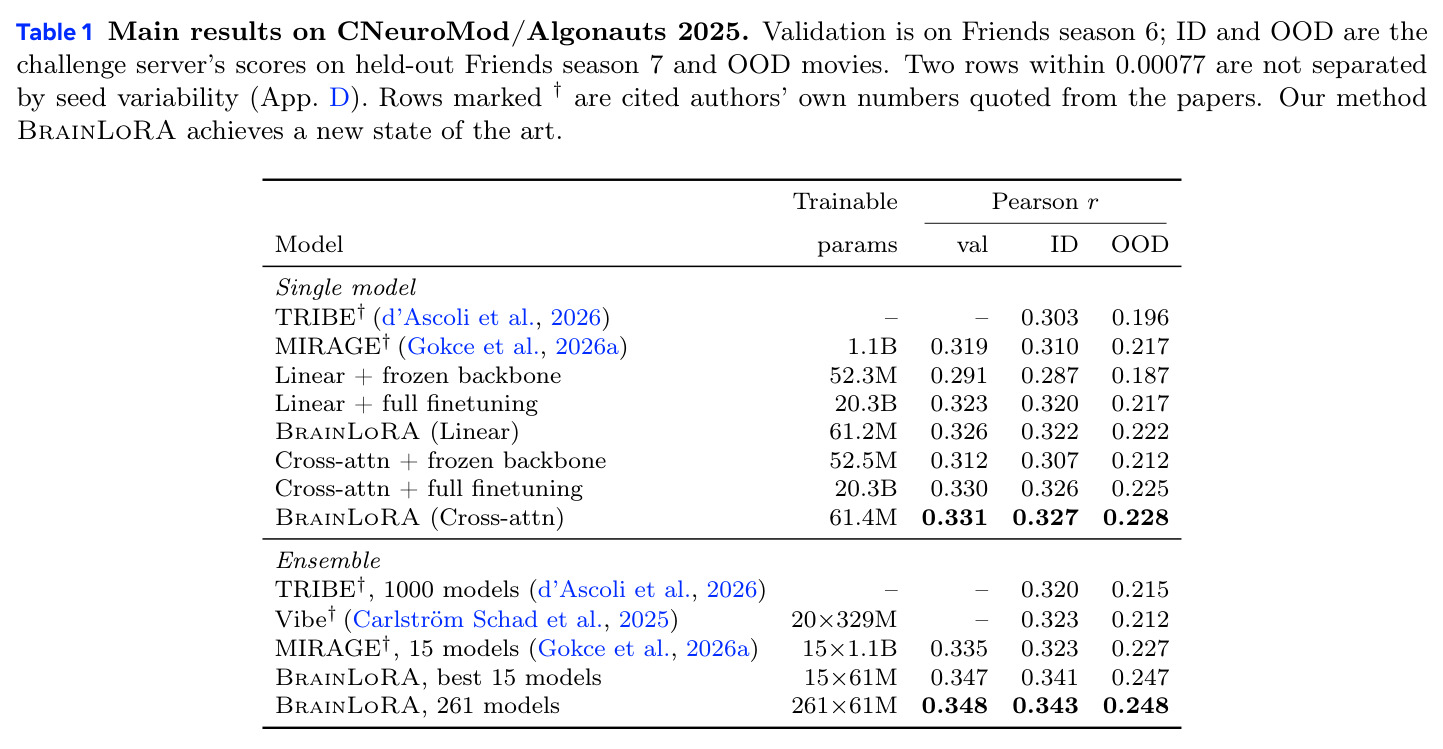
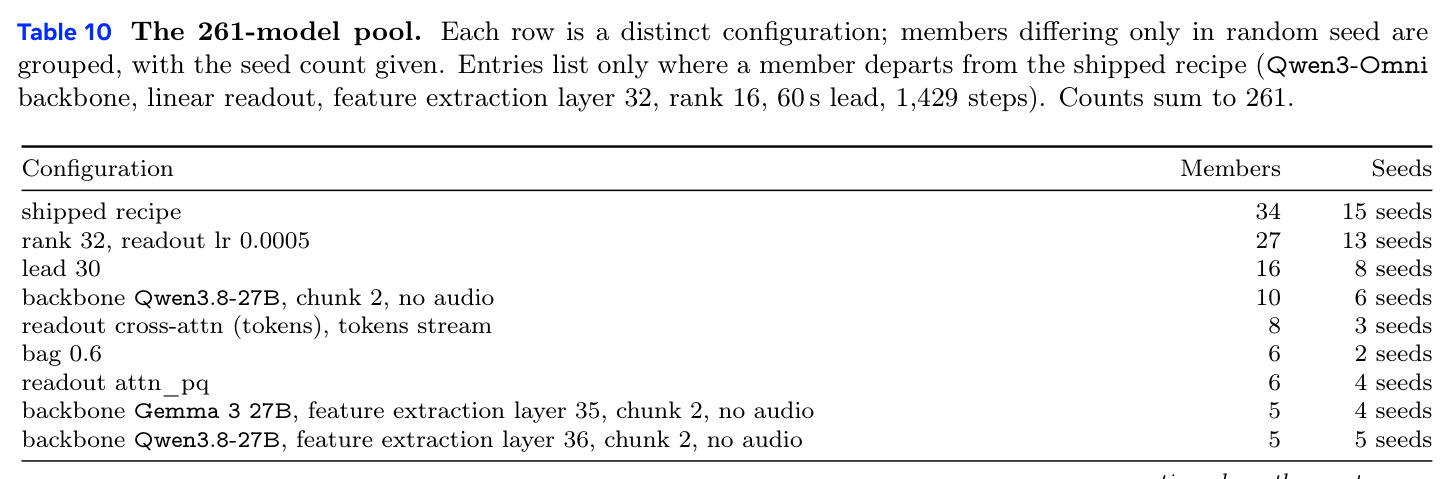
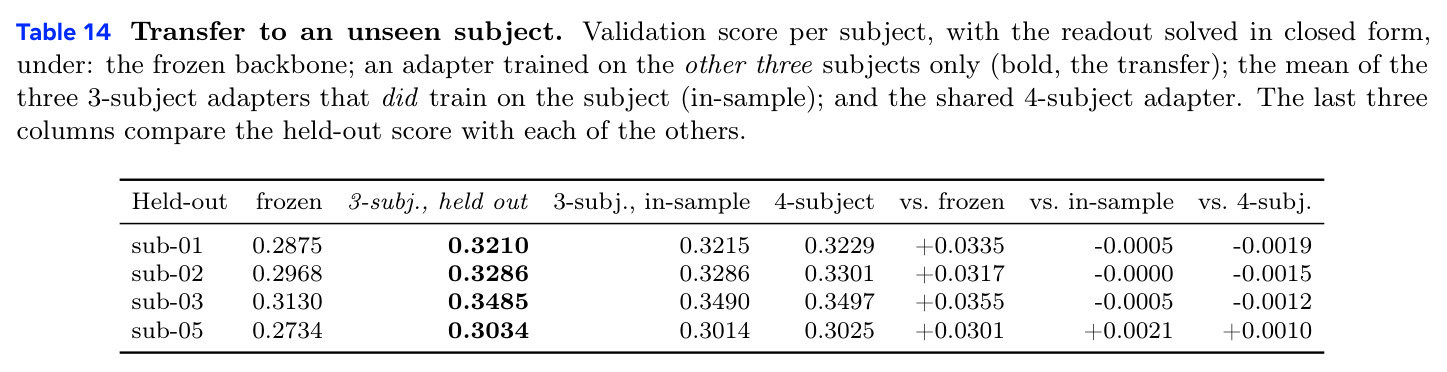
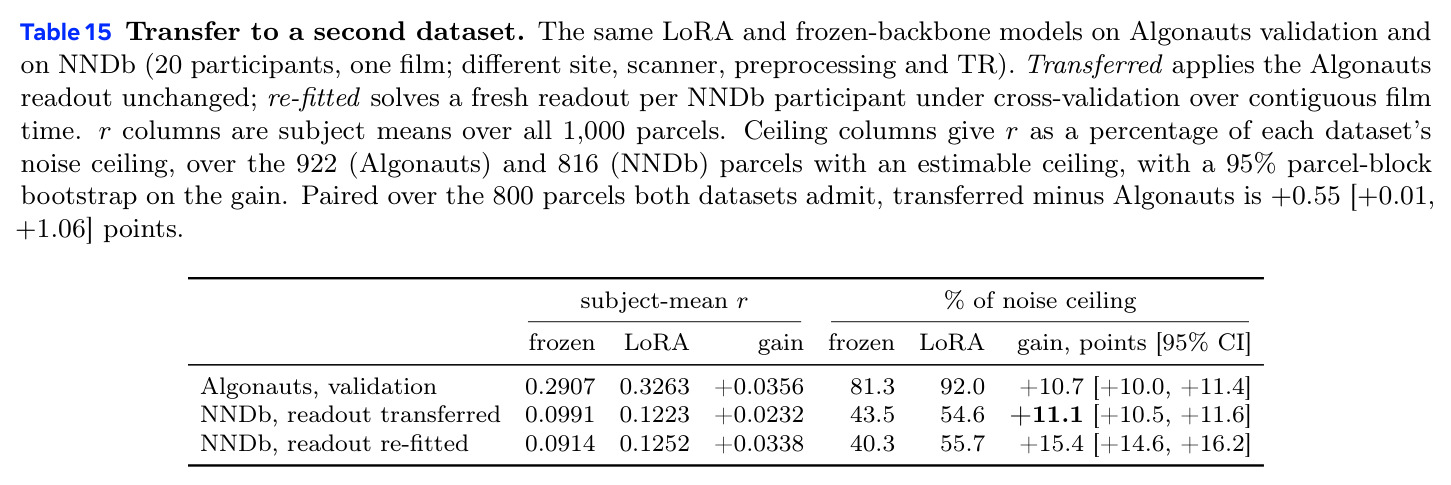
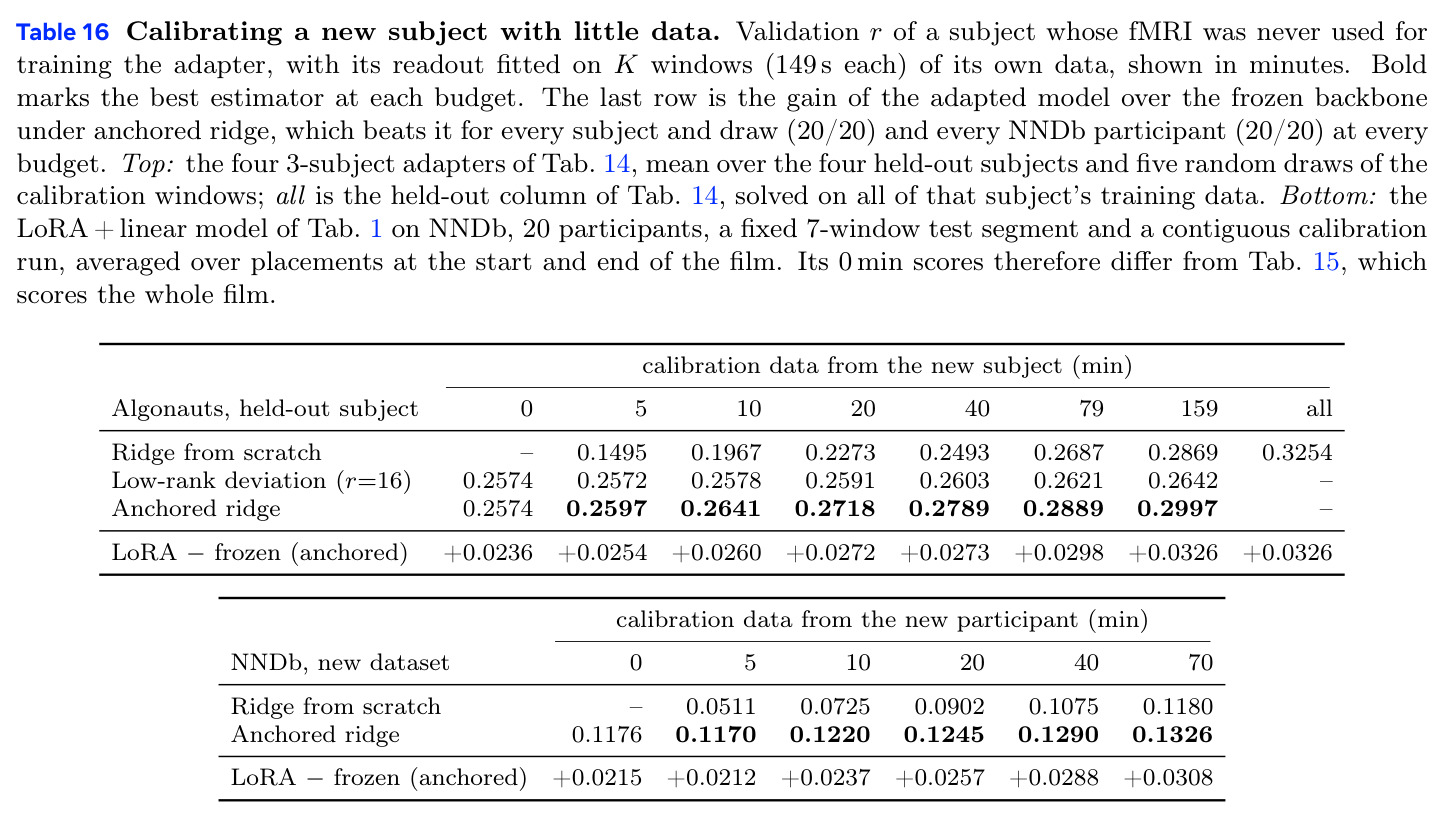
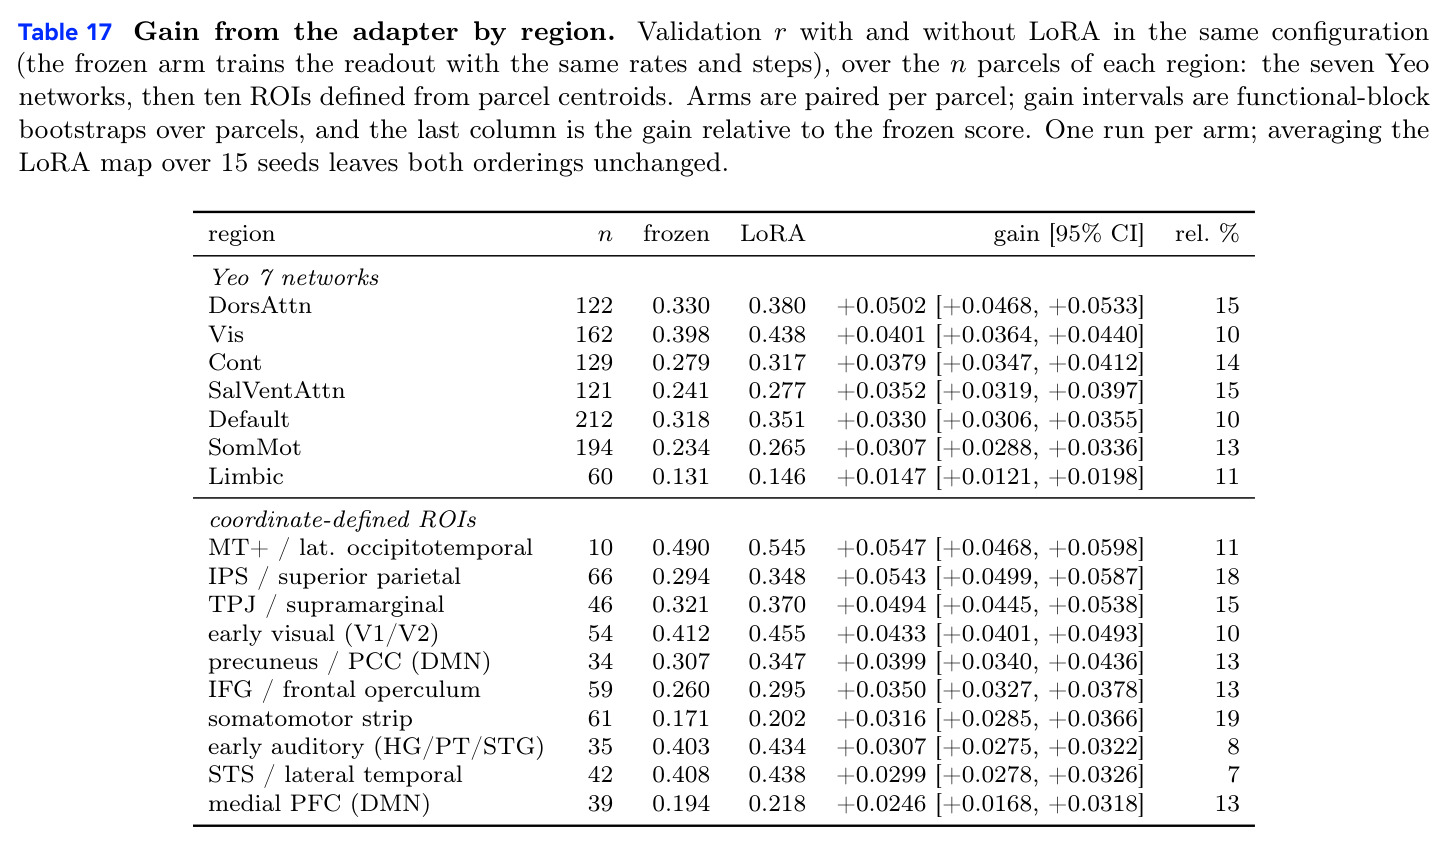
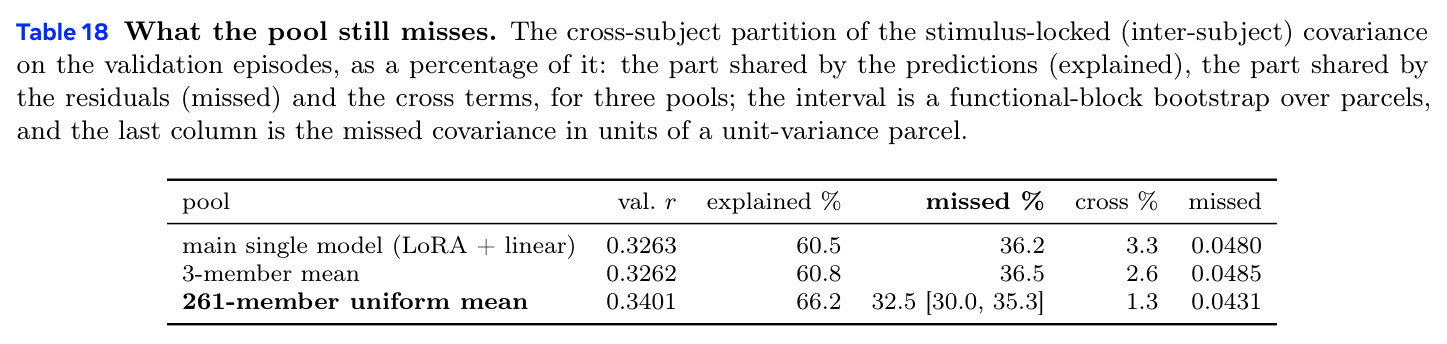
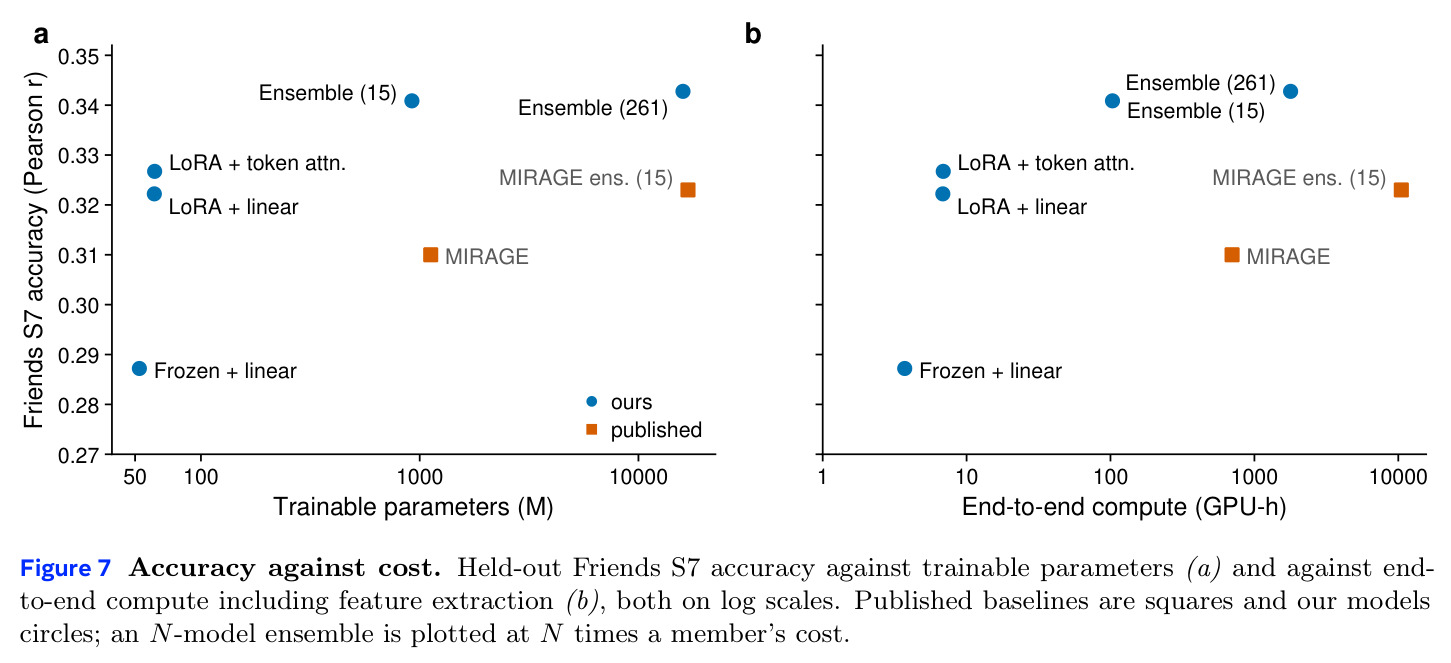
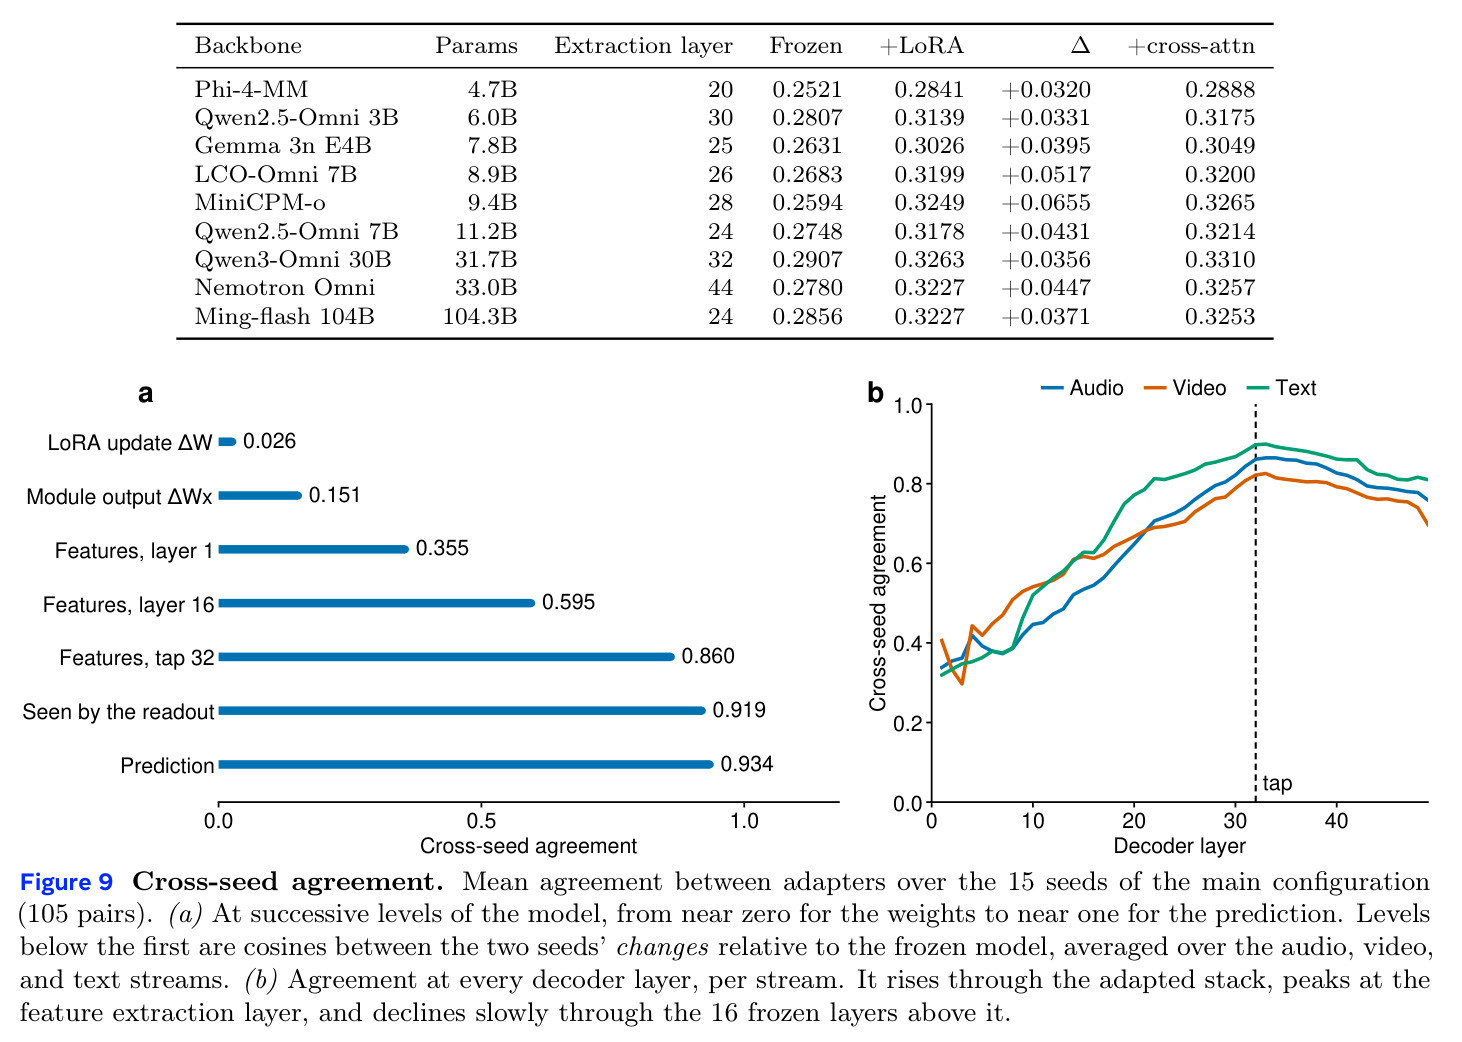
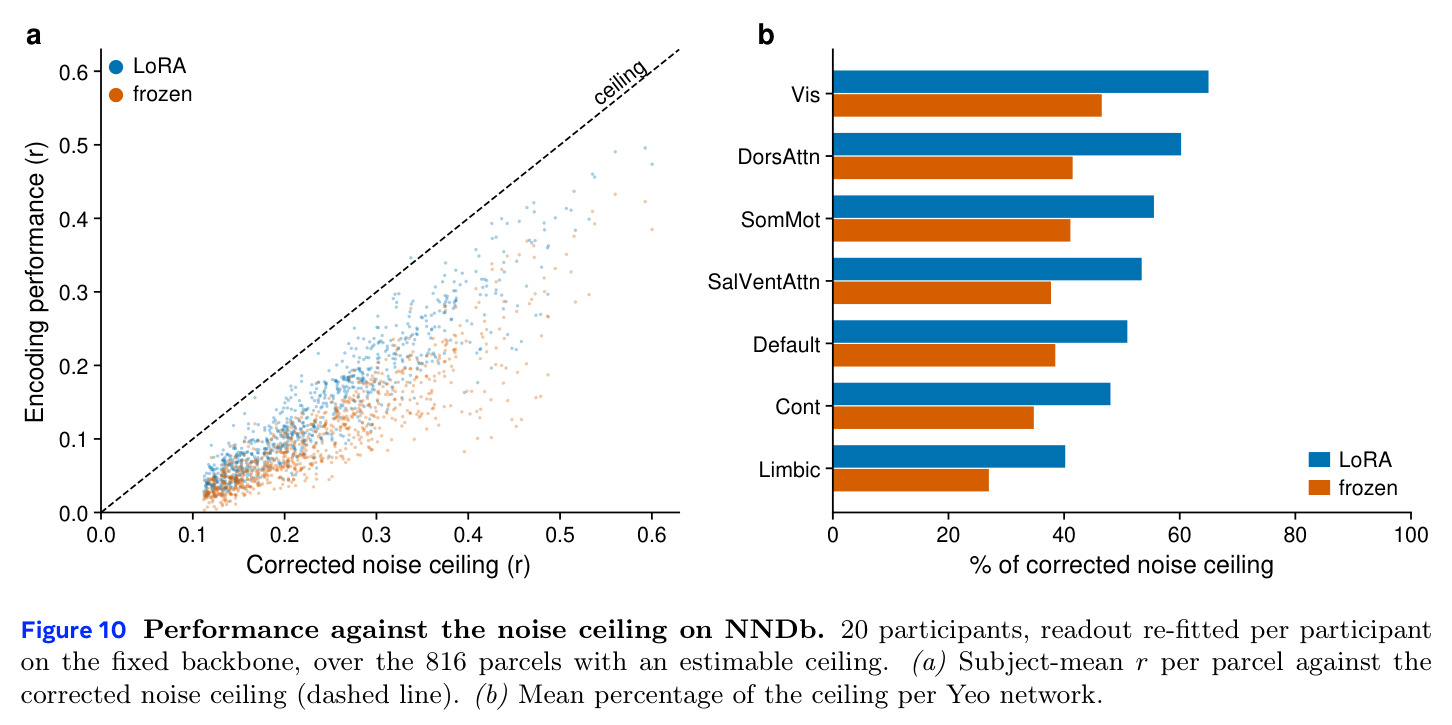
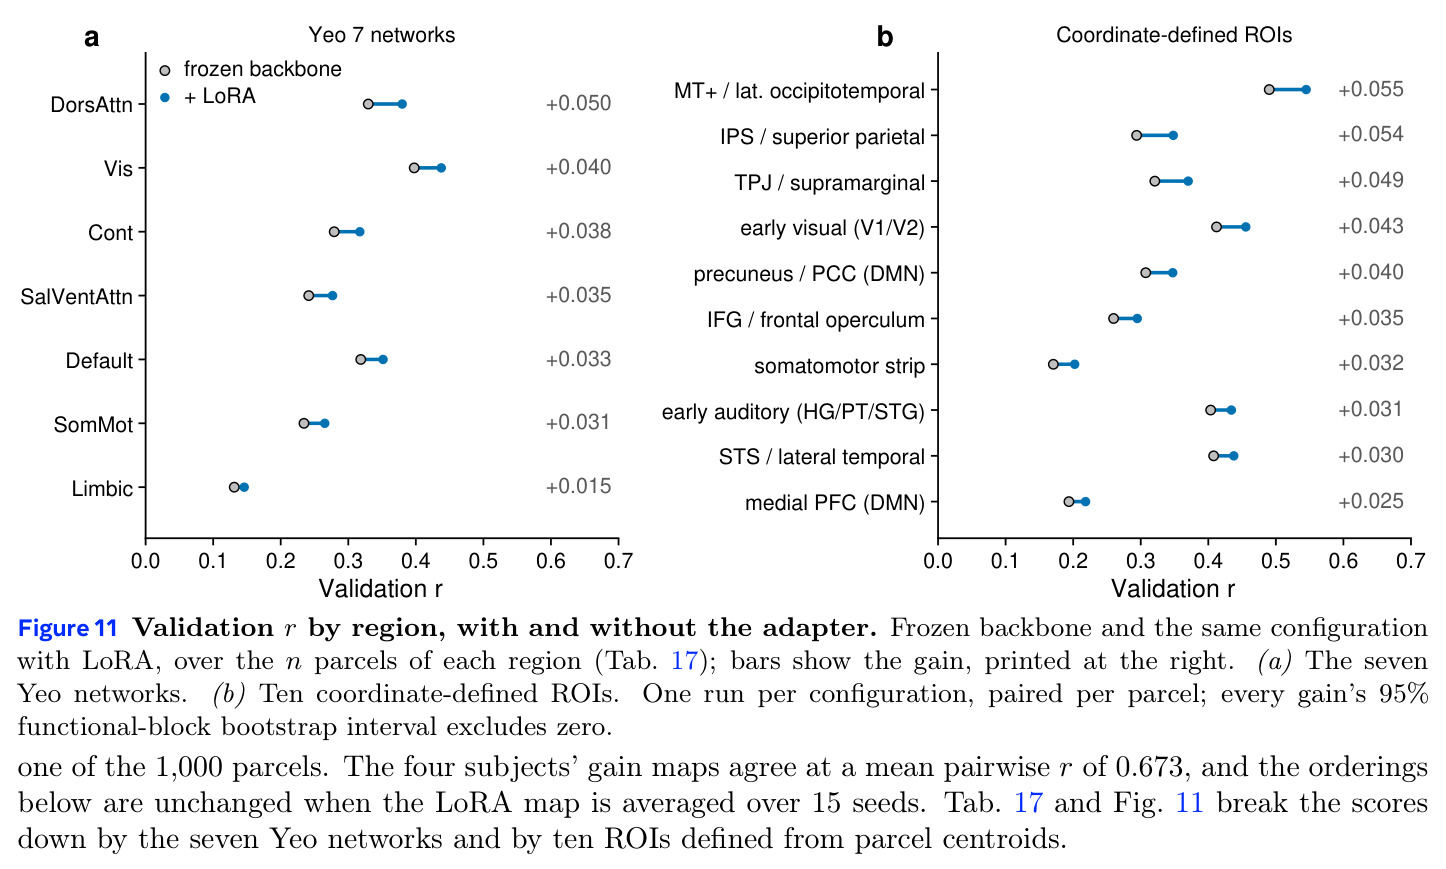
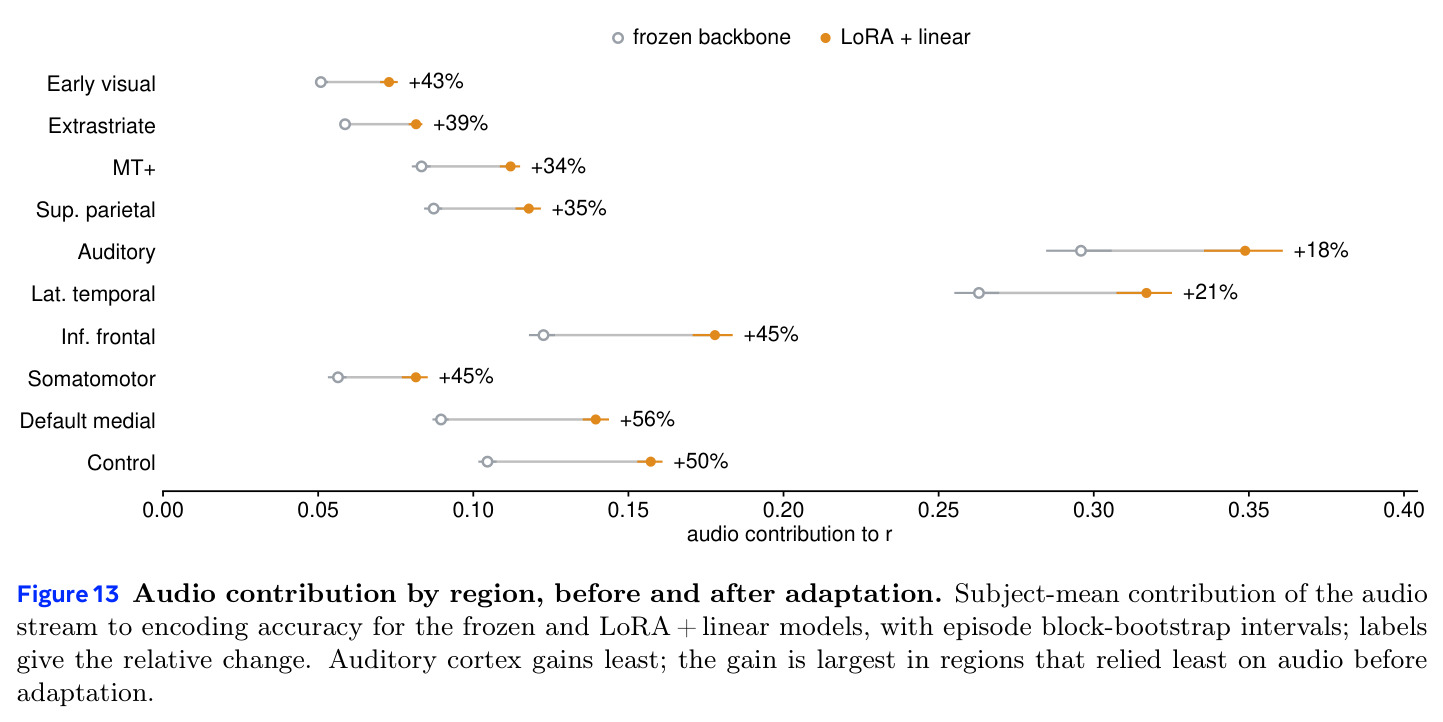
(1)九骨干一致增益:在 4.7B–104B 的九个多模态骨干上,LoRA+线性读出较冻结基线提升 0.032–0.066(Qwen3-Omni 0.2907→0.3263;MiniCPM-o 最大 +0.0655;Phi-4-MM 最小 +0.0320;104B Ming-flash +0.0371),交叉注意力读出再平均 +0.003;性能与骨干规模仅弱相关($r$=0.71 冻结 / 0.60 适配)。(2)主榜:BrainLoRA 线性版(61.2M 参数)达 ID 0.322 / OOD 0.222,超单模型 SoTA MIRAGE(0.310/0.217,1.1B 参数);交叉注意力版 0.327/0.228,在 ID 上已超 MIRAGE 的 15 模型集成(0.323/0.227);261 模型集成达 0.343/0.248,居公开排行榜第一。全量微调 20.25B 参数仅 0.320/0.217(线性)与 0.326/0.225,不敌 LoRA 且 OOD 更差。(3)效率:特征提取 701→1.99 GPU 时(352 倍),端到端 702→8.5 GPU 时(83 倍)。(4)消融:LoRA 贡献 +0.0356,闭式重拟合 +0.0061;交叉注意力收益来自更大的 token 集而非注意力本身(对同样池化特征做交叉注意力仅 +0.0003);rank 16 已足够。(5)可解释性:早期视觉皮层 72.5% 归因视频、听觉皮层 72.9% 归因音频、外侧颞叶 60.3% 归因音频;适配后音频贡献 +39%、文本 −17%,246 个脑区主导模态从视频翻转为音频,跨模态混合从 8.9% 升至 15.3%。(6)严格对照:用打乱配对的 fMRI 训练适配器反而掉 0.0733(996/1000 脑区变差),证明增益确实来自刺激-响应配对。(7)迁移与集成:留一被试仍保留 97% 增益(+0.0301 至 +0.0355);零样本迁移 NNDb 获 +11.1 个噪声天花板百分点(域内为 +10.7);集成规模服从 $m(n)=m_\infty-An^{-b}$($b\approx0.94$,$R^2=0.998$),质量与多样性联合解释 97% 方差,但换种子几乎无多样性(不同种子预测相关 $r$=0.934);整个 261 模型池仍留下 32.5% 的跨被试刺激锁定方差未解释。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Algonauts 2025 ID(held-out Friends S7) | 平均 Pearson r | 0.343(261 模型集成)/ 0.327(单模型 BrainLoRA 交叉注意力) | MIRAGE 15 模型集成 0.323 / 单模型 0.310(TRIBE 0.303) | +0.020 / +0.017,已发表方法中最佳 |
| Algonauts 2025 OOD(新电影) | 平均 Pearson r | 0.248(261 模型集成)/ 0.228(单模型) | MIRAGE 集成 0.227 / 单模型 0.217 | +0.021 / +0.011 |
| 刺激特征提取 | GPU 时(A800,331 片段语料) | 1.99 GPU 时(单遍因果前向,5.1 次前向/片段) | 约 701 GPU 时(滑窗,2,758 次前向/片段) | 约 352 倍 |
| 单模型可训练参数 | 参数量 | 61.2M(LoRA 8.91M + 线性读出 52.3M) | MIRAGE 读出 1.1B;全量微调 20.25B | 约为 MIRAGE 的 5%,性能反超;比全量微调少 330 倍仍更好 |
| 多 LoRA 联合训练(N=32 适配器) | 训练步时加速比 | 29.8 倍加速,融合步仅为单适配器步的 1.08 倍 | 逐个串行训练(成本随 N 线性增长) | 使 261 模型集成在单卡规模上可行 |
| 骨干适配规模 | 被神经数据直接更新的骨干参数量 | 最高 104B(Ming-flash) | 此前文献中被微调的骨干 ≤15B,更大模型仅作冻结特征 | 首次把脑编码适配推到百亿级以上骨干 |
局限与改进
作者承认的:所有模型只在单一基准、4 名被试、观看叙事电影的数据上训练;适配器虽能迁移到留出被试和 NNDb,但两者都未离开“叙事电影”域;多数据集、多记录模态的联合训练留待未来。我自己的观察:(1)主表每行多为单次运行,种子波动 0.00077,许多单项改进(rank 32、门控 MLP 读出、对池化特征的交叉注意力)在闭式重拟合后落入噪声区间,结论分辨率有限;(2)所有设计都在同一验证季(S6)上选择,虽未用排行榜调参,仍存在对验证分布的隐性过拟合风险,OOD 绝对值(0.248)远低于 ID(0.343);(3)261 模型池仍留 32.5% 共享刺激锁定方差,残差慢速、高维、非低层特征也非延迟误差,提示叙事/事件级结构未被捕捉;(4)单遍提取依赖骨干的“准因果”性,音频/视觉局部编码器实为 8 s/1 s 的双向窗口,表示对前缀长度敏感(音频前缀余弦 0.956),只是偏差可归因 bf16 数值而非信息泄露;(5)多 LoRA 核受显存限制,80GB 卡只能放 32–64 个 rank-16 适配器,按脑区训练适配器仍不可行。
独立分析的弱点
(1)域窄:训练与两处迁移测试全部是叙事影视,对静态图片、课堂演讲、多人对话等场景的泛化完全未验证,实际部署前应先在非叙事刺激上检验适配器;(2)增益幅度小、噪声底高:多数单项改进不足 0.001,结论依赖配对 parcel bootstrap 与种子统计,建议在更多被试和第二个验证季上重复以压低噪声;(3)多样性来源单一:集成增益几乎全部来自换骨干/读出架构,训练数据子集、种子、秩几乎无贡献,可探索不同训练目标(时序预测、辅助对齐损失)、不同刺激语料或不同预处理来制造“真多样”;(4)可解释性停留在输入级:Shapley 只回答“哪个模态驱动该脑区”,对 LoRA 在层内改了什么(注意力模式、特征几何)没有机制解释,可接入表示相似性或电路分析;(5)新被试校准中低秩偏差修正几乎无增益(40 分钟仅 +0.0029),说明被试间共享结构未被低秩基封存,可研究分层贝叶斯或元学习读出;(6)单遍提取与 MoE 数值行为耦合(长度相关的 bf16 舍入),换稠密骨干或更高精度可检验该设计的稳健性;(7)集成登顶的是挑战赛后的公开排行榜,并非官方挑战赛名次,与并发工作的可比性有限。每一条都对应明确的改进方向:扩域评测、多种子协议、目标级多样性、机制分析、元学习校准、精度消融和统一评测平台。
未来方向
作者明确提出走向“脑基础模型”:在大型预训练骨干上共享一个跨任务、跨数据集、跨被试甚至跨物种训练的适配器,或按任务/数据集/被试/脑区设置分层适配器并结合元学习,使 PEFT 的三条扩展轴(放大先验、缩小适配、扩展数量)合流。基于本文成果还可延伸:(1)联合多数据集与多记录模态(EEG/MEG/颅内)训练共享适配器,检验表征是否跨模态守恒;(2)用多 LoRA 核构建每脑区或每 ROI 的适配器池,需先解决显存与秩的权衡;(3)把“质量+多样性”联合预测($R^2=0.97$)用作集成成员的主动选择准则,主动搜索低残差相关的新成员;(4)攻坚那 32.5% 未解释方差:残差慢速、高维、刺激锁定,适合引入事件分割、叙事结构建模或更长上下文;(5)机制层面研究不同种子收敛到同一函数的现象(预测间 $r$=0.934,权重空间却近乎正交 cos=0.026),追问是什么数据或先验决定了这个“共识解”;(6)把移位目标、预算匹配 PEFT 家族对照等控制协议推广为脑编码领域的标准评测规范;(7)将锚定岭回归式的新被试快速校准与适配器结合,做成临床或小样本场景的实用流水线。
复现评估
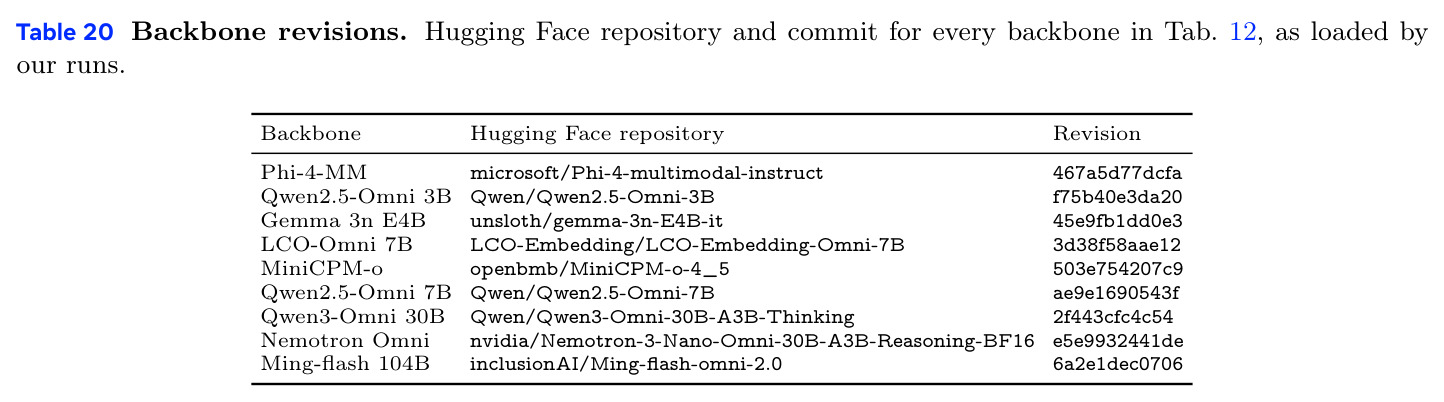
开源情况:代码公开于 github.com/zfying/brain-lora,附录 S 给出几乎全部复现细节:单张 A800-80GB、bf16 + FlashAttention-2 + 梯度检查点(视觉 patch embedding 的 3D 卷积须用 fp32,否则慢约四个数量级)、AdamW、1,429 步单 epoch、LoRA 学习率 $6\times10^{-4}$、读出 $3\times10^{-4}$,并列出每个骨干的 HuggingFace 仓库与 commit(Table 20,如 Qwen3-Omni-30B-A3B-Thinking@2f443cfc4c54)。数据:CNeuroMod 的《老友记》fMRI 需签数据使用协议,NNDb 公开;重跑需要 336×224 媒体缓存、Algonauts fMRI、指定版本的骨干权重和一个冻结特征上的岭回归读出初始化。算力:单模型端到端仅 8.5 GPU 时,非常亲民;261 模型集成靠多 LoRA 核可行,但每张 80GB 卡的适配器池上限 32–64 个(rank 16)。难度:中等偏高——需要熟悉多模态推理栈、闭式岭回归与 out-of-fold 集成流水线,并耐心处理 bf16 数值噪声与 0.00077 的种子波动;论文对随机性、选择协议(全部在 S6 上完成)和负结果交代得异常充分,属于复现友好型工作。
论文图表
对比两种范式:(a) 主流的“冻结预训练骨干+只训练读出”;(b) 本文主张的 PEFT——在共享冻结骨干上插入可训练适配器与读出,让少量参数携带神经适配,并提出三条互补扩展方向:Scale up(换更强骨干放大先验)、Scale down(缩小可训练参数量)、Scale out(在同一骨干上训练多个特化适配器组成集成)。
全文的纲领图:三条扩展轴分别对应多骨干实验(Scale up)、rank-16 小适配器(Scale down)和 261 模型集成(Scale out),是索引所有实验设计的框架。
九个多模态骨干(4.7B–104B)上三种配置的验证分数:冻结骨干、LoRA+线性读出、LoRA+交叉注意力读出。LoRA 对每个骨干都有一致提升(+0.032 至 +0.066),交叉注意力再平均 +0.003;性能与骨干规模仅弱相关(r=0.71 冻结 / 0.60 适配)。
用最直接的证据支撑“PEFT 对大模型普遍有效”的核心主张,也是选择 Qwen3-Omni 作受控比较的依据。
同一 331 片段语料、单张 A800-80GB 上的算力分解:滑窗每片段 2,758 次前向、提取 701 GPU 时 vs 单遍 5.1 次、1.99 GPU 时(352 倍);端到端 702 vs 8.5 GPU 时(83 倍);本文还需对 48 层中的 32 层反传,训练 4.84 + 闭式重拟合 1.67 GPU 时,可训练参数 61.2M 对 1,123M。
精确给出效率主张的出处与统计口径(如何测量、包含什么),是成本估算与复现的依据。
九个骨干的明细(总参数量、各自的特征抽取层、冻结分、+LoRA、增量、+交叉注意力):MiniCPM-o 9.4B 增益最大 +0.0655,Phi-4-MM 4.7B 最小 +0.0320,104B Ming-flash 从 0.2856 到 0.3227(+0.0371),Qwen3-Omni 31.7B 从 0.2907 到 0.3263(+0.0356)。
Figure 3 背后的数据表,是“PEFT 跨四个数量级模型规模普遍有效”这一核心主张的完整证据。