Holi-World:从人类第一视角经验构建整体世界智能 Holi-World: Building Holistic World Intelligence from Human-Ego Experience
把第一视角视频自动转化为可溯源的3D/4D标注生态,大幅提升模型空间与时间推理能力
前置知识
自我中心视觉(Egocentric Vision)
以佩戴在人头/胸前的相机(如 GoPro、Aria 眼镜)拍摄的第一视角视频。与固定机位或第三视角不同,相机随人头转动与身体移动,天然记录了人如何在环境中移动、用手操作物体,因此同时包含场景持久结构(移动中反复看到的家具)和物体状态变化(拿起、放下、推动)。代表作有 Ego4D(3000 小时)、EgoExo4D、Nymeria 等。
本文的全部出发点就是:第一视角经验是学习世界智能最自然的数据源,整个 Holi-World 生态(采集设备、Foundry、Data、VL、Bench)都是围绕'如何把自我中心录像自动变成可学习的监督'设计的。
视觉惯性 SLAM(VI-SLAM)与深度补全
SLAM(同步定位与建图)利用双目立体 RGB 图像和 IMU 惯性测量联合估计相机在每一时刻的 6 自由度位姿 $T_t$(相机坐标到世界坐标的刚体变换)与稀疏地图点。深度估计模型(如 Depth Anything 3, DA3)则从单帧或多帧 RGB 预测稠密深度图 $D_t$。二者结合可以把 2D 图像像素反投影成世界坐标下的 3D 点:$X = T_t D_t(u) K_t^{-1} \bar{u}$。
Foundry 管线第一步就是用 VI-SLAM + DA3 + 3DGS 恢复几何底座 $O=\{(I_t,D_t,K_t,T_t)\}$,后续所有静态 3D 框抬升、动态 mask 反投影、QA 中的距离/方向答案都建立在这个几何基础上,不懂位姿与深度反投影就看不懂方法部分。
3D 高斯泼溅(3D Gaussian Splatting, 3DGS)
一种显式神经渲染表示:用数百万个带位置、协方差、颜色和透明度的各向异性 3D 高斯函数表示场景,可通过可微光栅化高效渲染出任意新视角图像。相比 NeRF 训练和渲染都快得多,且场景表示是显式的点集,便于从其中做几何查询和点云级检测。
本文用 3DGS 优化场景表示 $G$,既用于渲染'补充视角'给 VLM 做框验证,也从中得到重建场景点云 $P$ 供 TR3D 做点云级 3D 检测;数据集里约 100 个场景都带 3DGS 重建,是几何与外观层的核心资产。
3D 检测指标 AP25 / AP50 / mIoU
在 3D 物体检测中,预测框与真值框的重合度用 3D IoU 衡量。AP25/AP50 分别是在 IoU 阈值 0.25/0.50 下计算的平均精度:阈值越严,要求预测框的尺寸和朝向越准。mIoU 则是在 IoU≥0.25 成功匹配的框对上平均 IoU,衡量'匹配上的框画得有多贴'。mIoU 以匹配成功为前提,必须与 AP 联合解读。
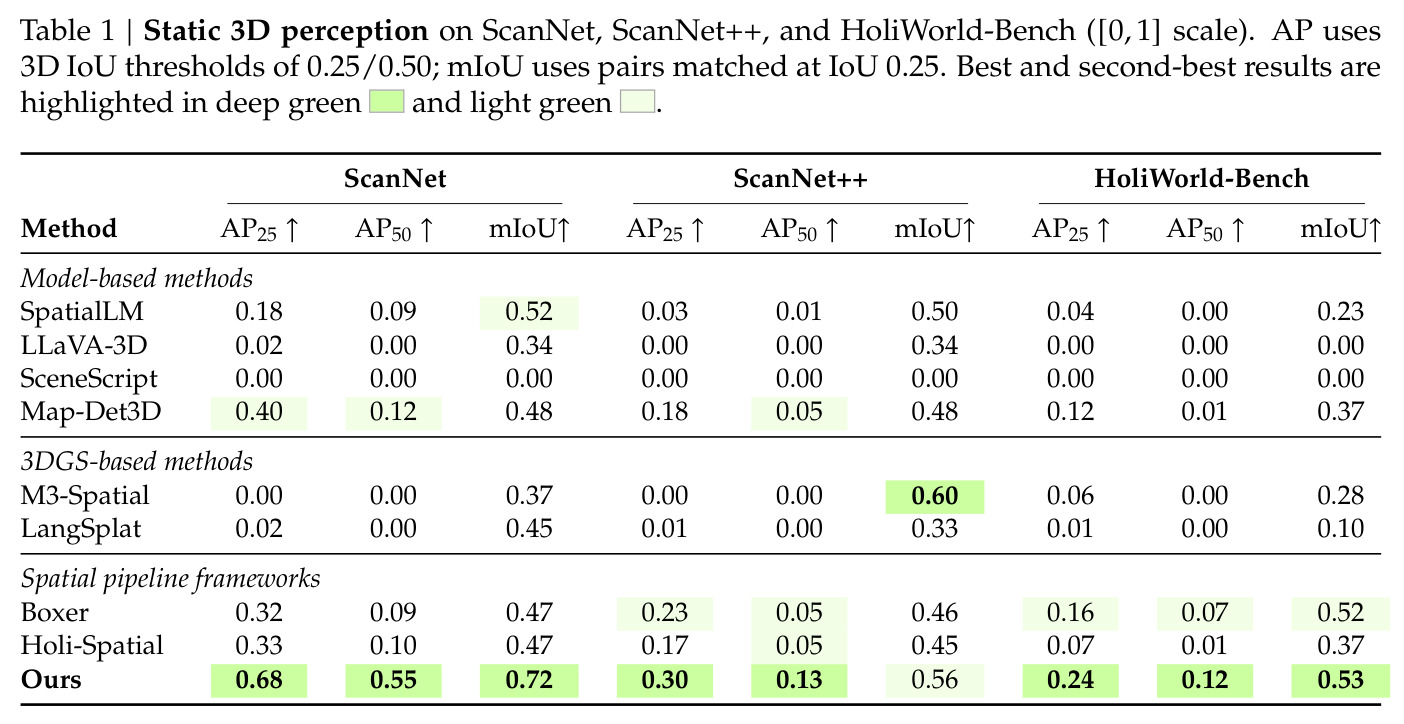
Table 1 的核心结论就是本文在严格阈值下优势更大(ScanNet AP50 0.55 vs 最强基线 0.12),而消融中 VLM 验证'几何指标变化不大但语义被修正'的现象也需要理解 AP 与 mIoU 的分工才能正确解读。
HOTA 与 4D 轨迹跟踪指标
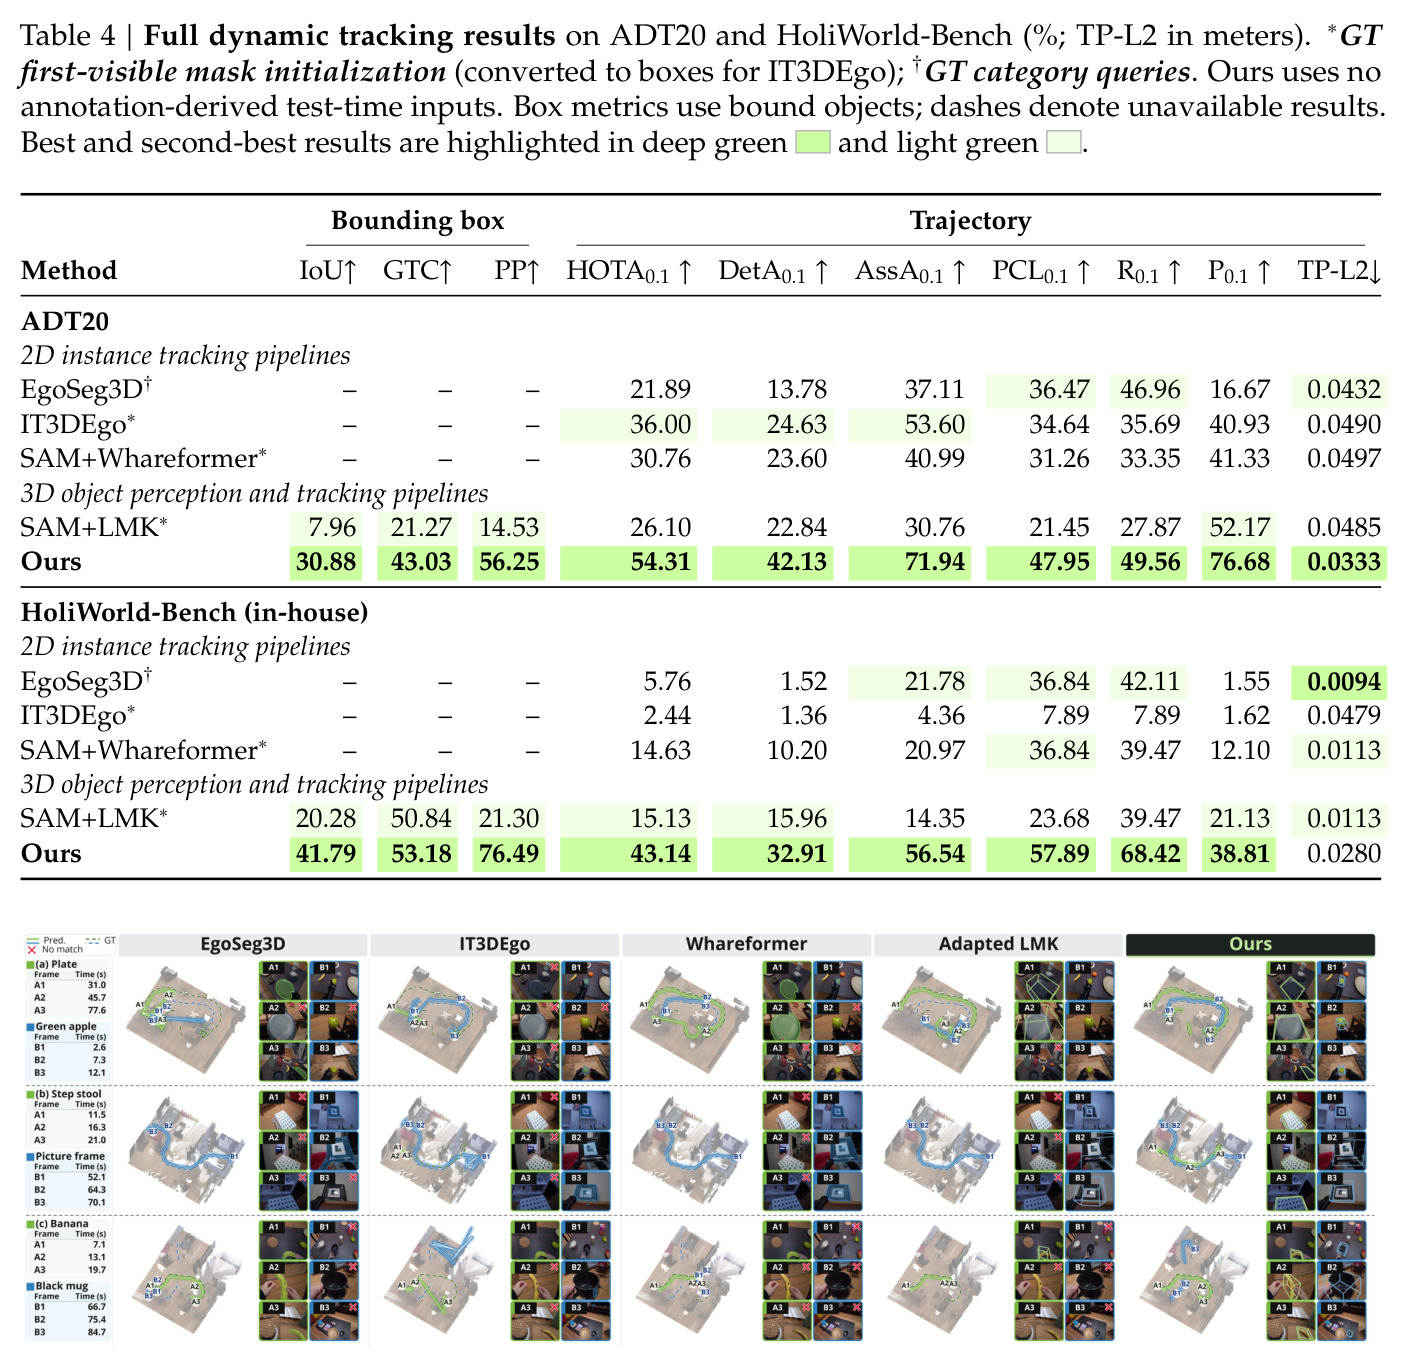
HOTA(Higher Order Tracking Accuracy)把多目标跟踪质量分解为检测精度 DetA 与身份关联精度 AssA 的几何平均,是跟踪领域标准指标。本文在 0.1 米世界坐标中心距离容差下计算 $\mathrm{HOTA}_{0.1}$,另用 PCL(在序列级一对一 GT-预测分配下被正确覆盖的真值实例-帧比例)、召回 R、精度 P 和匹配成功的平均中心误差 TP-L2 共同刻画轨迹质量。
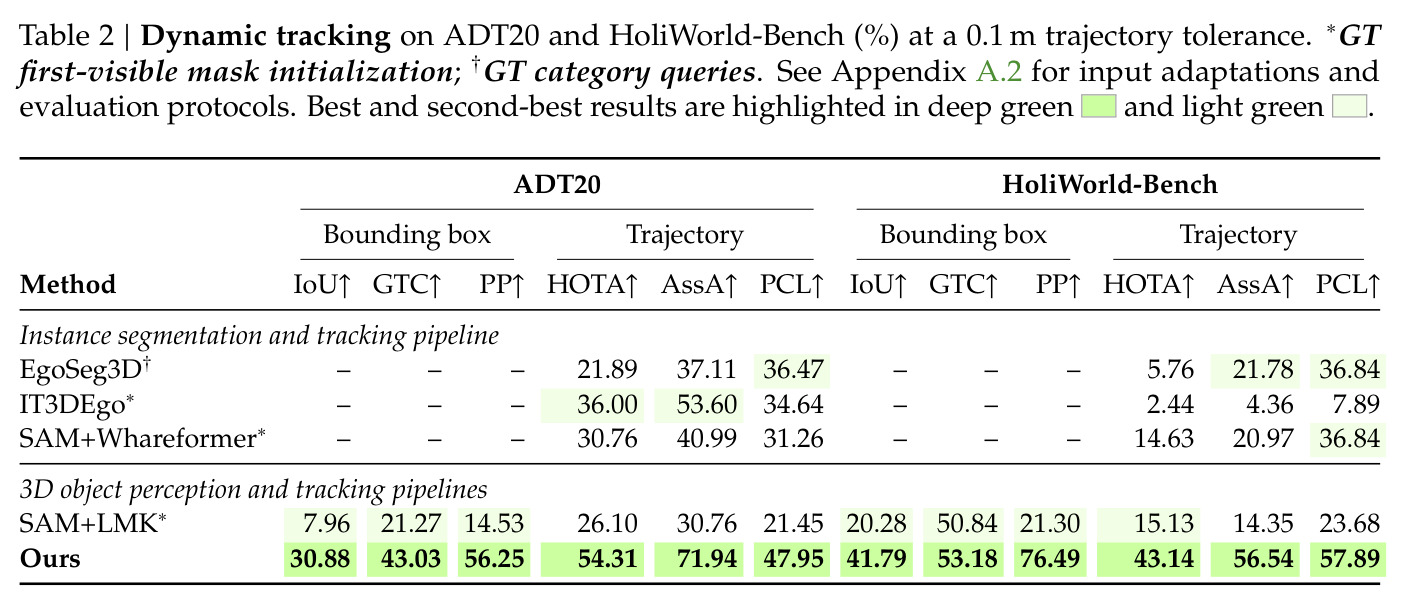
动态跟踪是本文两大感知能力之一,Table 2/4 的全部对比都建立在这套指标上:本文 ADT20 上 HOTA 54.31%、AssA 71.94%、PCL 47.95%,不理解指标含义就无法判断这些数字强在哪。
Token F1(生成式 QA 评测指标)
对于自由文本答案的问答任务,把模型预测与参考答案都切成 token,计算 F1 = $2 \cdot \text{precision} \cdot \text{recall} / (\text{precision} + \text{recall})$,衡量两者词级的重合程度。配合是/否准确率(Y/N)、多选题准确率(MCQ)和数值答案准确率(Num.),可以从多个题型维度评估空间问答能力。
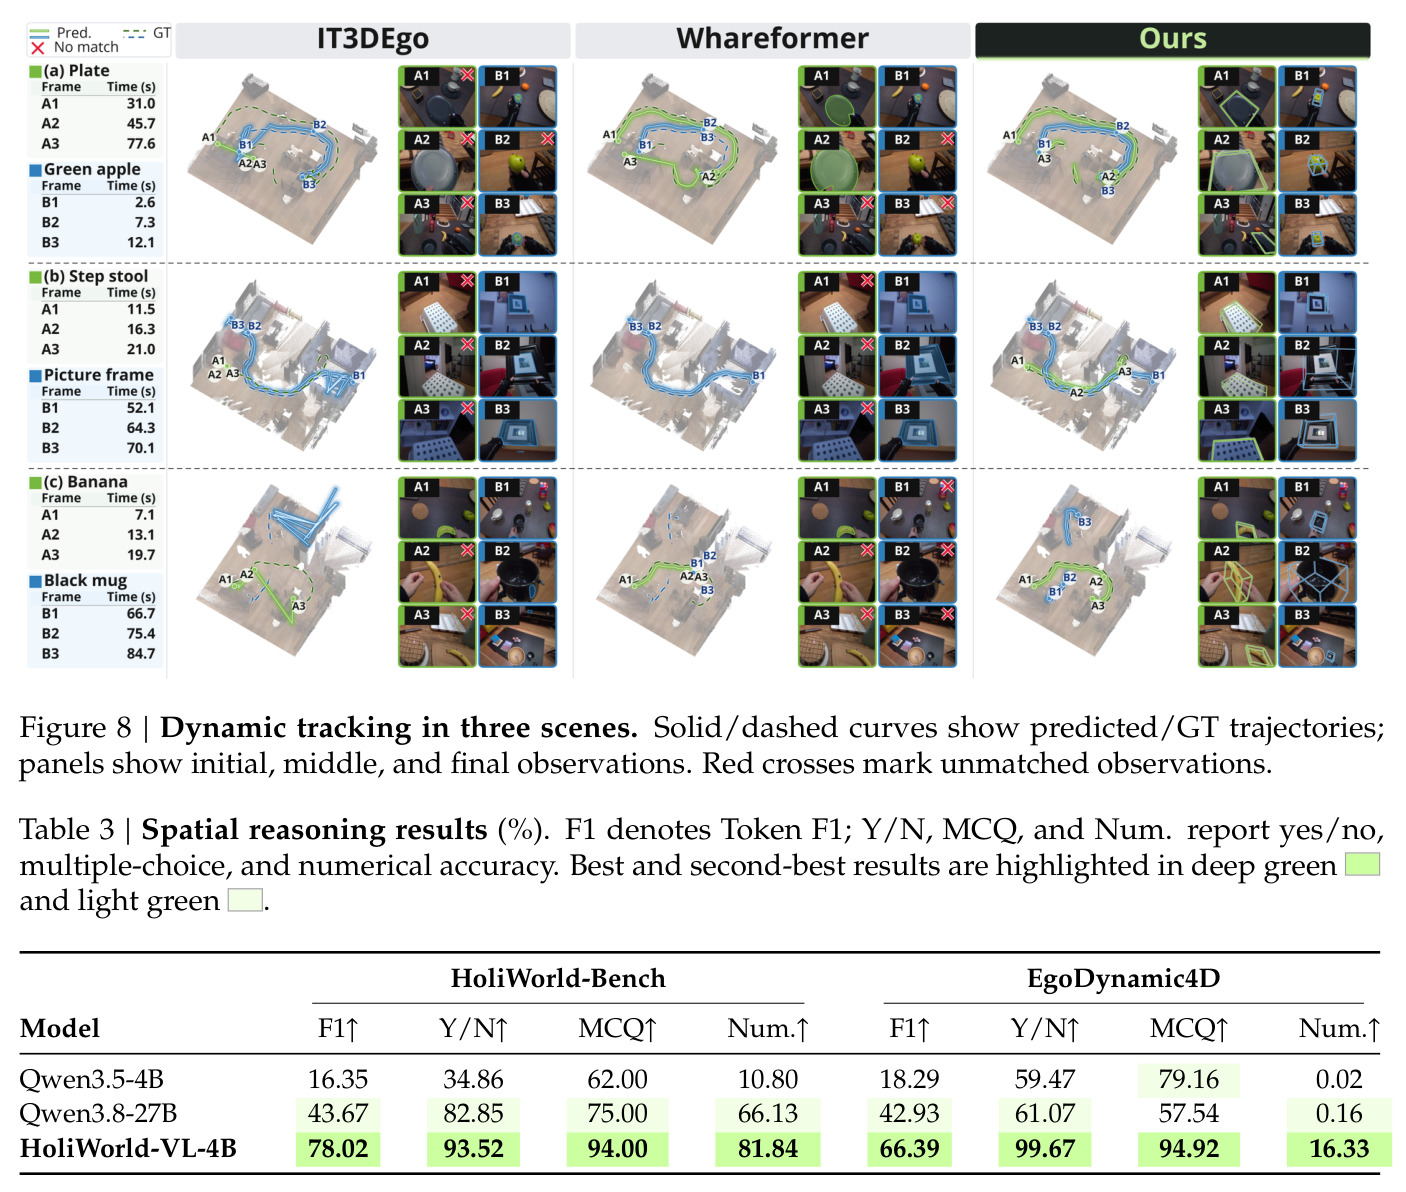
Table 3 用 Token F1 作为主指标展示数据价值:Qwen3.5-4B 微调前后从 16.35% 升到 78.02%,这是'自动生成的数据真的有学习价值'的最直接证据,也是本文叙事闭环的最后一环。
研究动机
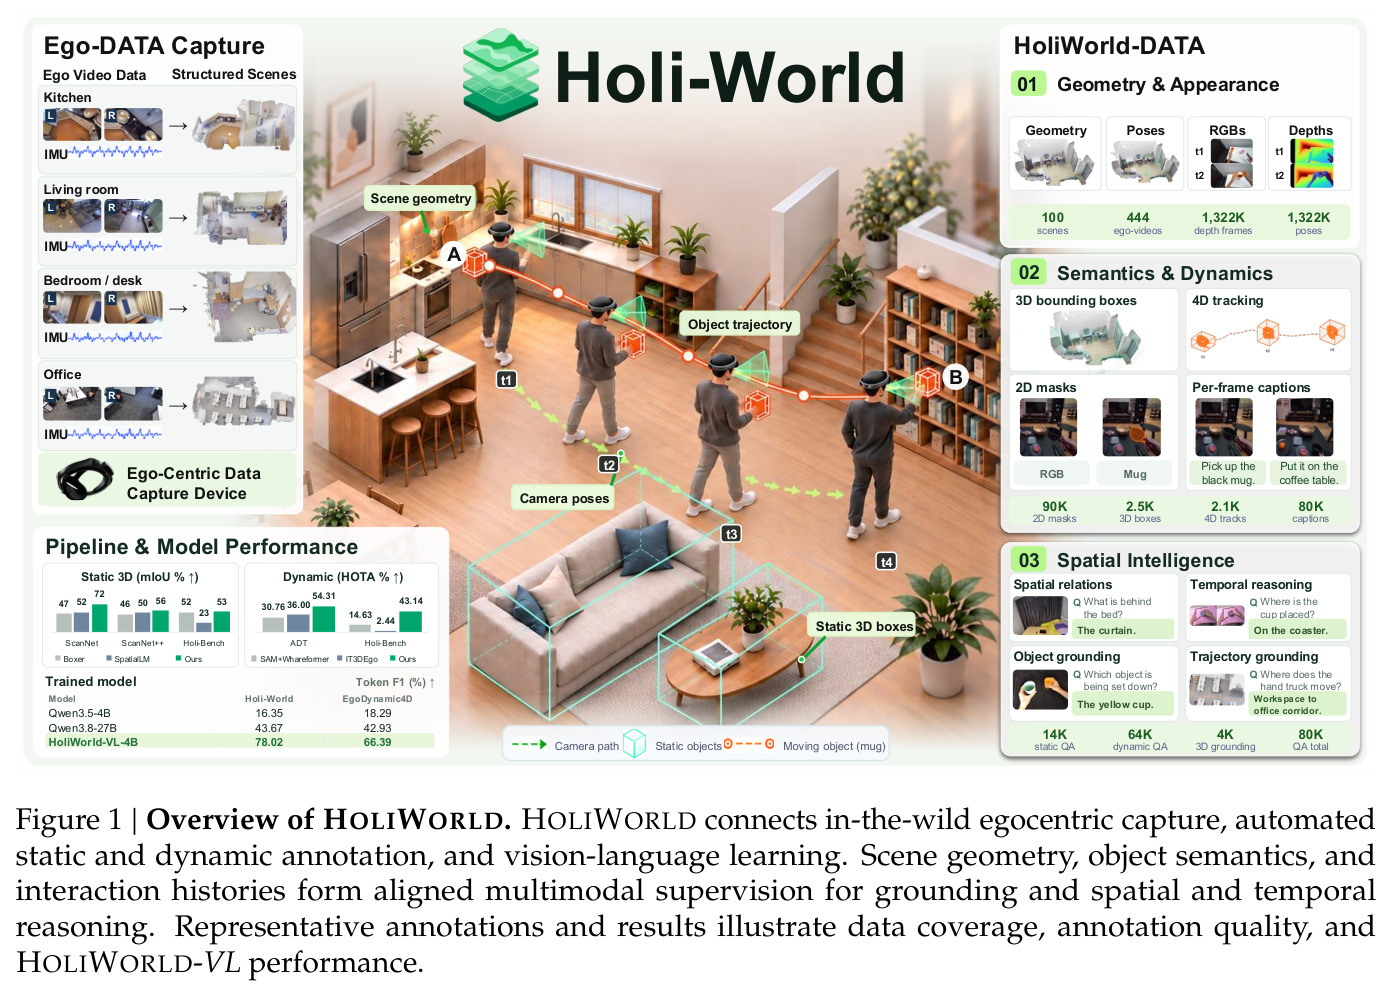
人类第一视角(自我中心)数据是学习世界组织的天然来源:Ego4D(约 3000 小时)、EgoExo4D、Nymeria 等大规模采集已覆盖多样的人群、场所与活动,EPIC Fields 和 Aria Digital Twin(ADT)进一步补上了相机位姿与场景几何。但把原始录像变成可学习的监督信号依赖大量人工:HD-EPIC 为了把动作、物体移动、视线连接到 3D 数字孪生做了极细的人工标注,EPIC-KITCHENS VISOR 等分割标注也反复被指出成本高昂。这造成一个结构性瓶颈——数据增长速度远快于标注速度,新录的像无法自动转化为训练资源。更深层的问题是,现有能力是割裂的:静态场景管线(Holi-Spatial、Boxer)能自动重建场景并标注静态物体,却丢失物体随交互发生的状态演变;自我中心跟踪方法(IT3DEgo、EgoSeg3D、OSNOM 的 LMK)能维持物体身份与位置,却不与场景级几何、语义融合。结果是视觉语言模型的空间-时间理解非常弱:论文实测基座 Qwen3.5-4B 在 HoliWorld-Bench 上 Token F1 仅 16.35%,在 EgoDynamic4D 上仅 18.29%,'杯子后面是什么''杯子何时被拿起'这类问题基本答不对。
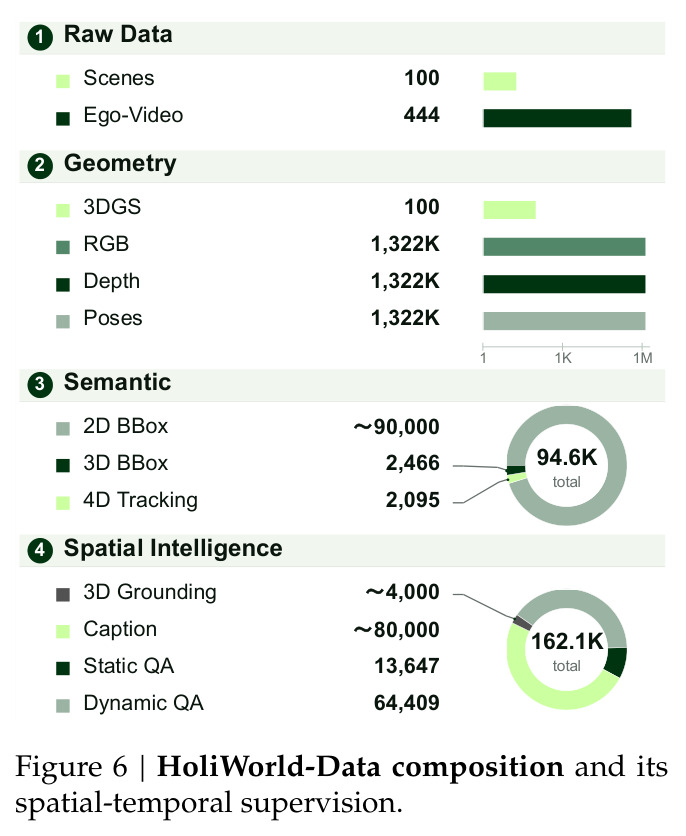
本文的目标是本文要构建一个端到端的生态系统,把'采集第一视角录像'到'训练出空间智能模型'整条链路打通并尽量去掉人工环节。具体目标有四层:(1) 用自制 Eagle 采集设备(同步立体 RGB + IMU)在野外自然场景采集数据,而非依赖受控实验室环境;(2) 开发 HoliWorld-Foundry 自动标注工厂,从录像中同时恢复持久场景结构(静态物体 3D 框、几何、语义)和演化物体状态(动态物体的 4D 轨迹、交互历史),并让每条标注都能溯源到支持它的观测;(3) 把世界记录组织成 HoliWorld-Data——约 100 个自采场景、444 段第一视角视频、约 80K 条证据驱动的 QA 对,用于训练 HoliWorld-VL-4B;(4) 建立独立人工标注的 HoliWorld-Bench(在留出的录像上标注),既能评估 Foundry 自动标注的准确性,又能评估模型学到的空间与时间理解能力,形成'标注质量'与'下游能力'的双重验证闭环。
与已有工作不同的是,本文的独特切入是把此前两条分离的技术路线——静态场景感知(Holi-Spatial、Boxer 做重建+语义标注+空间 QA 生成)与动态自我中心跟踪(IT3DEgo、EgoSeg3D、LMK 维护物体身份与 3D 位置)——在一个自动化数据工厂里用'共享世界坐标 + 持久物体身份'焊接起来,使场景几何、物体语义、交互历史指向同一批物体和同一套支持观测。与最近的 EgoDynamic4D 相比,后者是从已有 4D 标注资源出发构造动态 QA,本文则解决更上游也更难的问题:如何从一段全新的原始录像零标注地自动构建出这些 4D 标注本身。与 HD-EPIC 的重人工路线相反,本文主张标注能力随新录像的流入而自动扩张,把'扩数据'从人力问题变成算力问题。此外它还引入独立人工基准来审计自动标注的质量,这在自动数据构造类工作中并不常见——多数工作只报告下游提升,不回答'标注本身对不对'。
核心方法
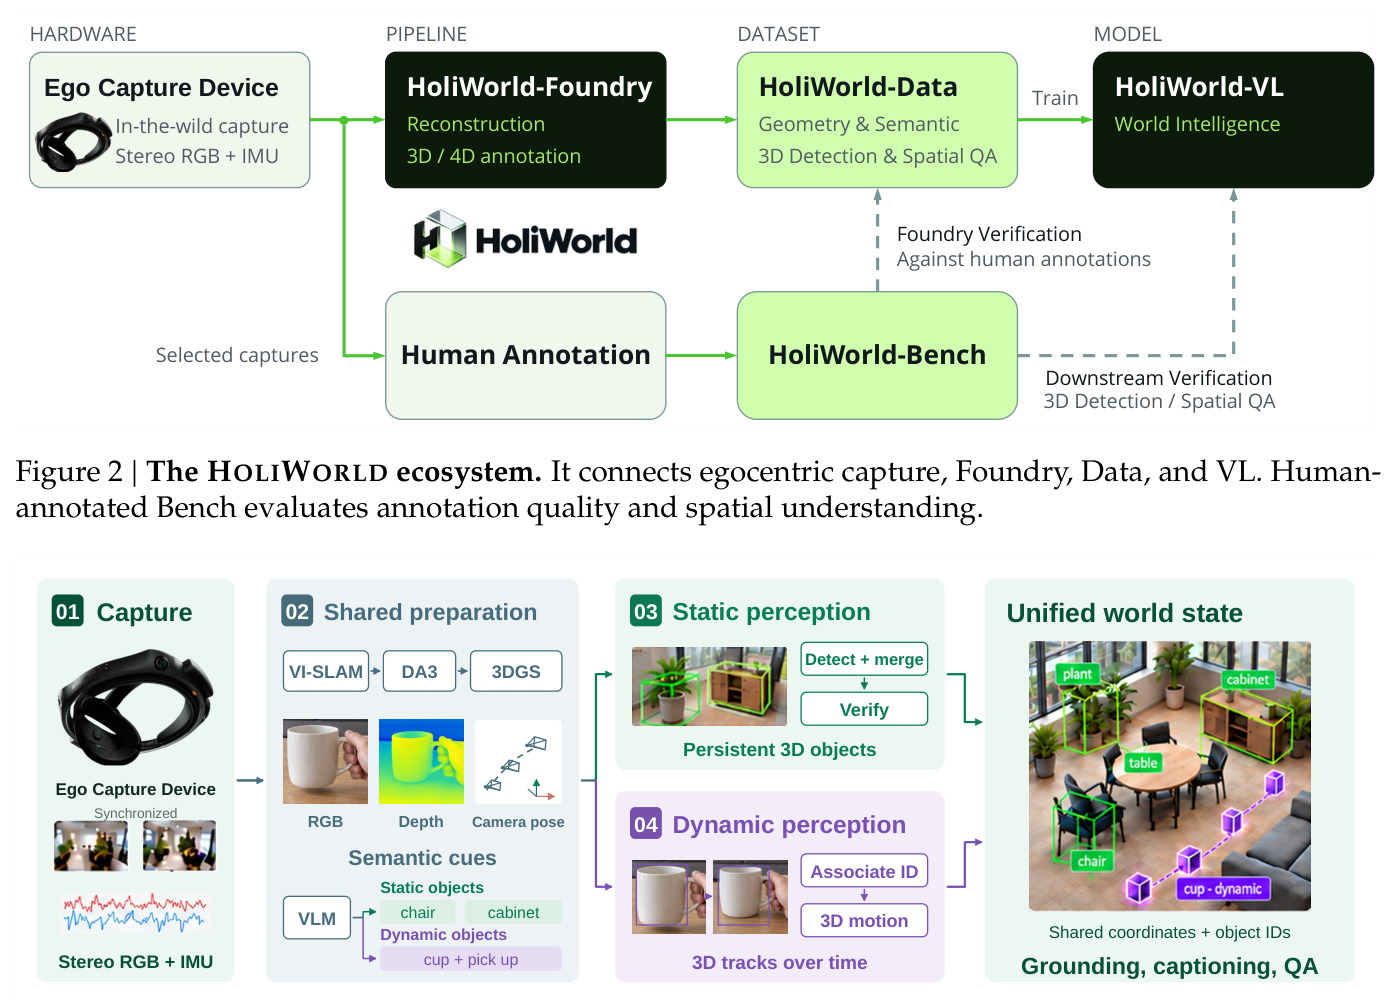
直觉上,人在环境中移动会揭示持久的场景结构(反复看到的墙、柜子、床),而用手操作物体揭示它们如何被使用、状态如何改变(拿起杯子、放到桌上)。因此本文把感知拆成互补的静态与动态两支,再融合成统一的世界状态。技术路线分四步:第一步,采集与几何准备——Eagle 设备记录同步立体 RGB 与 IMU,视觉惯性 SLAM 恢复相机位姿与稀疏点,Depth Anything 3(DA3)从关键帧和位姿估计深度与稠密点云,再用 3D 高斯泼溅优化场景表示 $G$、渲染精化深度,并用逐帧 DA3 深度补全动态区域,得到观测集 $O = \{(I_t, D_t, K_t, T_t)\}_{t=1}^{T}$,其中 $I_t$ 是 RGB 帧、$D_t$ 是深度图、$K_t$ 是相机内参、$T_t$ 是相机到世界的刚体变换。第二步,语义分流——用视觉语言模型(VLM)从 RGB 关键帧提取类别、属性、运动线索与交互描述:类别引导静态检测提议,运动与交互线索确定动态跟踪目标。第三步,静态感知(图像路径 Boxer + 点云路径 TR3D 双路检测、几何合并过滤、VLM 验证)与动态感知(跨段身份关联、SAM mask 传播、3D 反投影与逐帧 OBB 拟合成 4D 轨迹)并行执行。第四步,所有输出融合为统一世界表示 $S(t)$,再由 HoliWorld-Data 组织成 grounding、caption 和约 80K 条 QA 监督,训练 HoliWorld-VL-4B,最后用人工标注的 HoliWorld-Bench 做双重评估。
核心创新是'世界记录(world records)'这一中间表示加双路径互补感知,让自动标注既准确又可溯源。与已有方法的本质区别有三点。其一,Holi-Spatial 与 Boxer 只处理静态场景,不保留物体的相继状态;IT3DEgo、EgoSeg3D、LMK 只做动态跟踪,不与场景级几何语义融合;Foundry 把两者接在一个管线里,用同一世界坐标系和持久实例 ID 把静态 3D 框 $B_{\mathrm{sta}}$ 与动态 4D 轨迹 $B_{\mathrm{dyn}}(t)$ 绑定,使空间监督和时间监督指向同一物体。其二,用 VLM 的运动与交互线索做智能分流:这是让系统知道'什么东西该跟、什么东西该进静态库'的关键,纯几何方法无法区分'被拿起的杯子'和'桌上的杯子'。其三,每条输出的 QA 答案都链接到支持它的观测帧、检测框或轨迹段,形成证据链——这使数据可以审计、错误可以定位,也是他们敢于用人工基准检验自动标注质量的底气。静态侧的'双路径+备选框+VLM 验证'设计与动态侧的'跨交互段身份连续性'分别解决了小物体漏检和物体出视野再入镜的身份断裂问题。
方法步骤详情
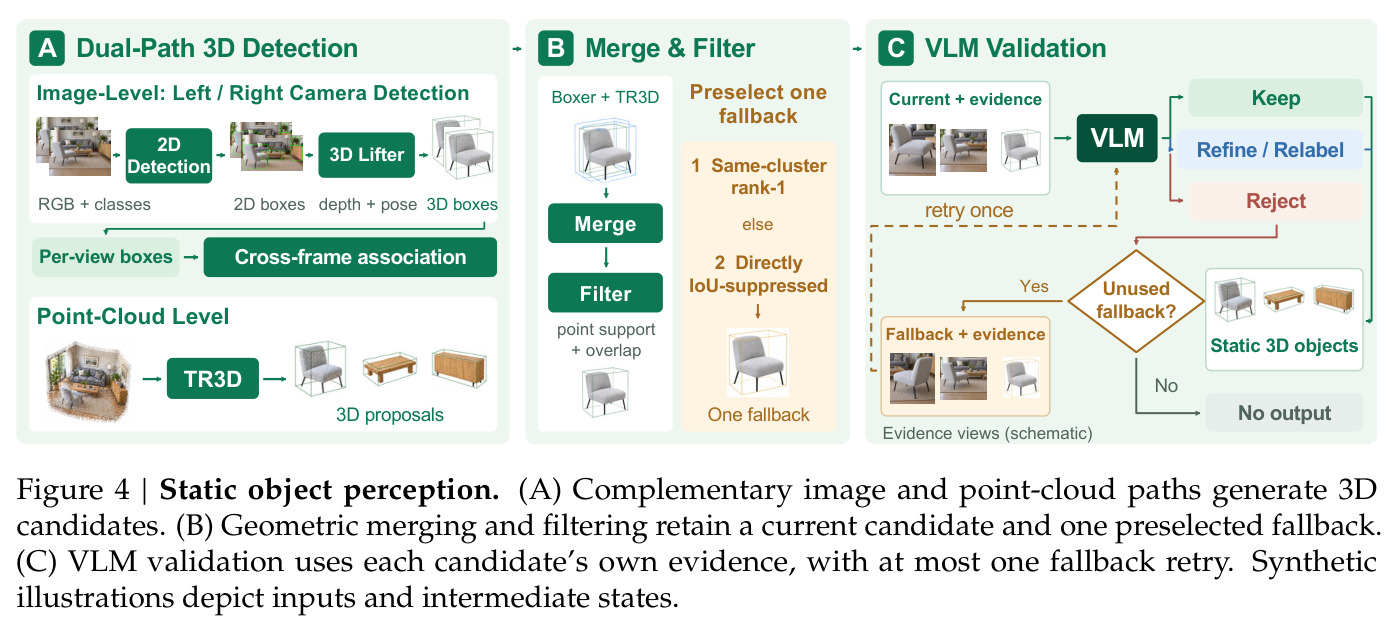
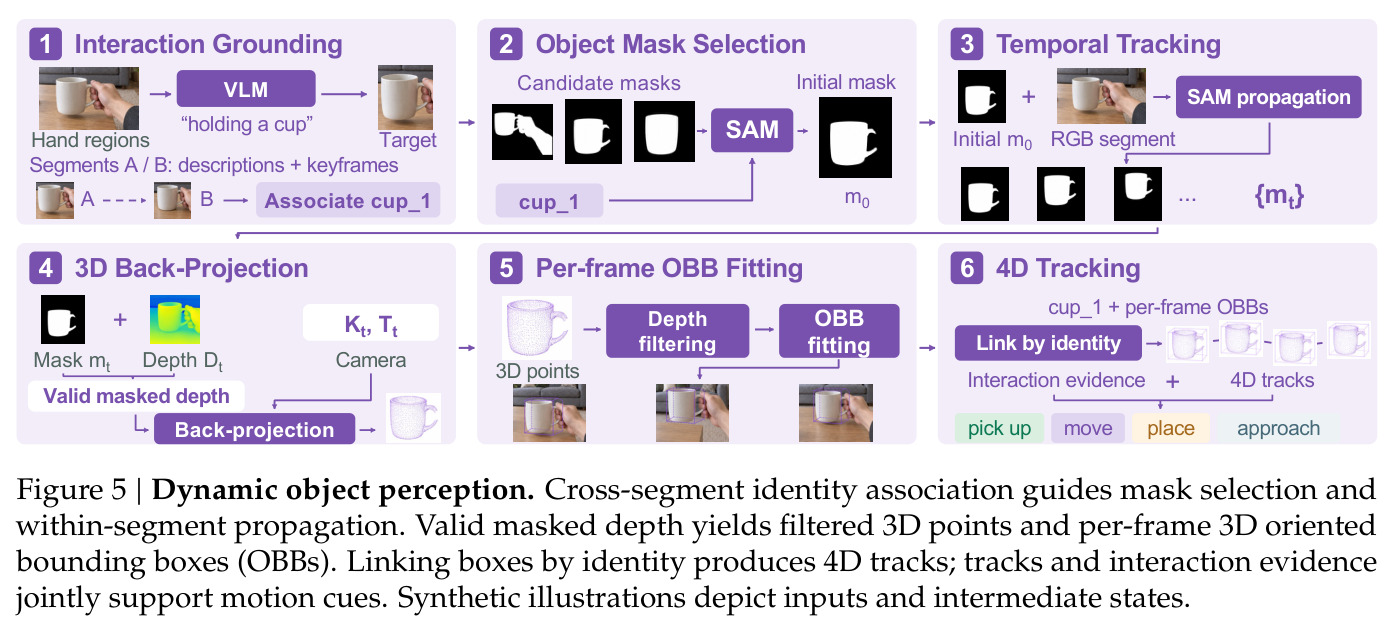
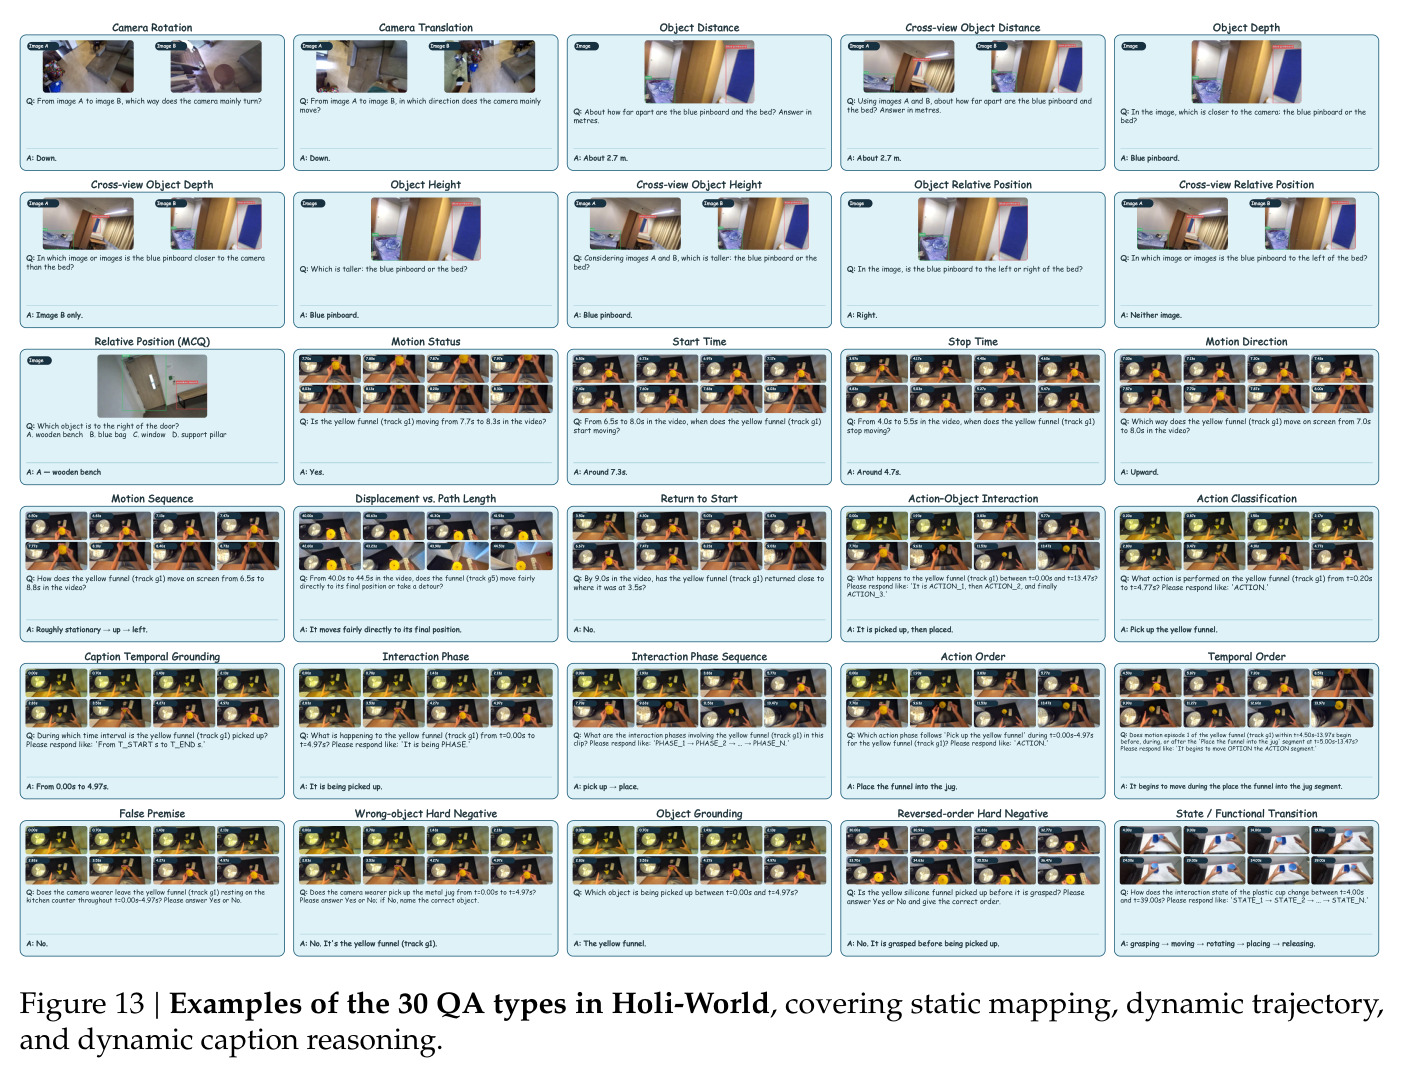
整个管线可拆为六步。步骤一(几何准备):输入立体 RGB + IMU 流,VI-SLAM 输出相机位姿与稀疏点;DA3 在关键帧和位姿上估计深度与稠密点;3DGS 优化场景表示 $G$ 并渲染观测位姿下的精化深度,动态区域用逐帧 DA3 深度补全;输出 $O=\{(I_t,D_t,K_t,T_t)\}$ 与点云 $P$。步骤二(语义分流):VLM 读取 RGB 关键帧,输出物体类别/属性(供静态提议)、运动与交互线索(如'拿起杯子',供动态目标确定)。步骤三(静态感知):图像路径上,Boxer 分别在左右目 RGB 流上做开放词汇 2D 检测,借助深度和位姿抬升为公制 3D 框并跨帧关联;点云路径上 TR3D 在 $P$ 中检测大物体;随后用低成本几何检查合并空间相容的框、剔除点支撑不足的框,并为每个入选框预选一个备选(同簇 rank-1 或 IoU 抑制链上的候选);VLM 依据原始观测和从 $G$ 渲染的补充视角逐框验证,可保留、精修几何、改类别或拒绝,拒绝时用备选框重试一次,仍失败则不保留;输出带证据链接的 $B_{\mathrm{sta}}$。步骤四(动态感知):先用 VLM 交互描述加手部区域在每段交互中定位目标,再跨交互段比较描述与关键帧证据以关联身份(解决物体消失再出现);由身份引导 SAM 初始化目标 mask 并在段内传播得 $\{m_t\}$(假设每时刻至多一个移动物体);用补全的动态深度把 mask 像素反投影到世界坐标 $X^t = \{T^t D^t(u) K_t^{-1} \bar{u} : u \in m^t,\ D^t(u)\ \text{有效}\}$,过滤无效深度后逐帧拟合有向包围盒(OBB),按身份连成 4D 轨迹 $B_{\mathrm{dyn}}(t)$。步骤五(统一世界表示):$S(t) = (O_t, U(t), G, P, B_{\mathrm{sta}}, B_{\mathrm{dyn}}(t), Z(t))$,其中 $U(t)$ 是 2D 框与 mask,$Z(t)$ 记录标签、身份、置信度、交互语义与证据链接。步骤六(数据构造与训练):按 EgoDynamic4D 的 QA 模式,从几何(方向、距离、包含、支撑、视角关系)、轨迹(运动状态、事件顺序、时长、起止时间)和交互语义(操作对象、状态转移)生成 30 种共约 80K QA 对(静态 13,647 + 动态 64,409),微调 Qwen3.5-4B 得到 HoliWorld-VL-4B。
技术新颖性
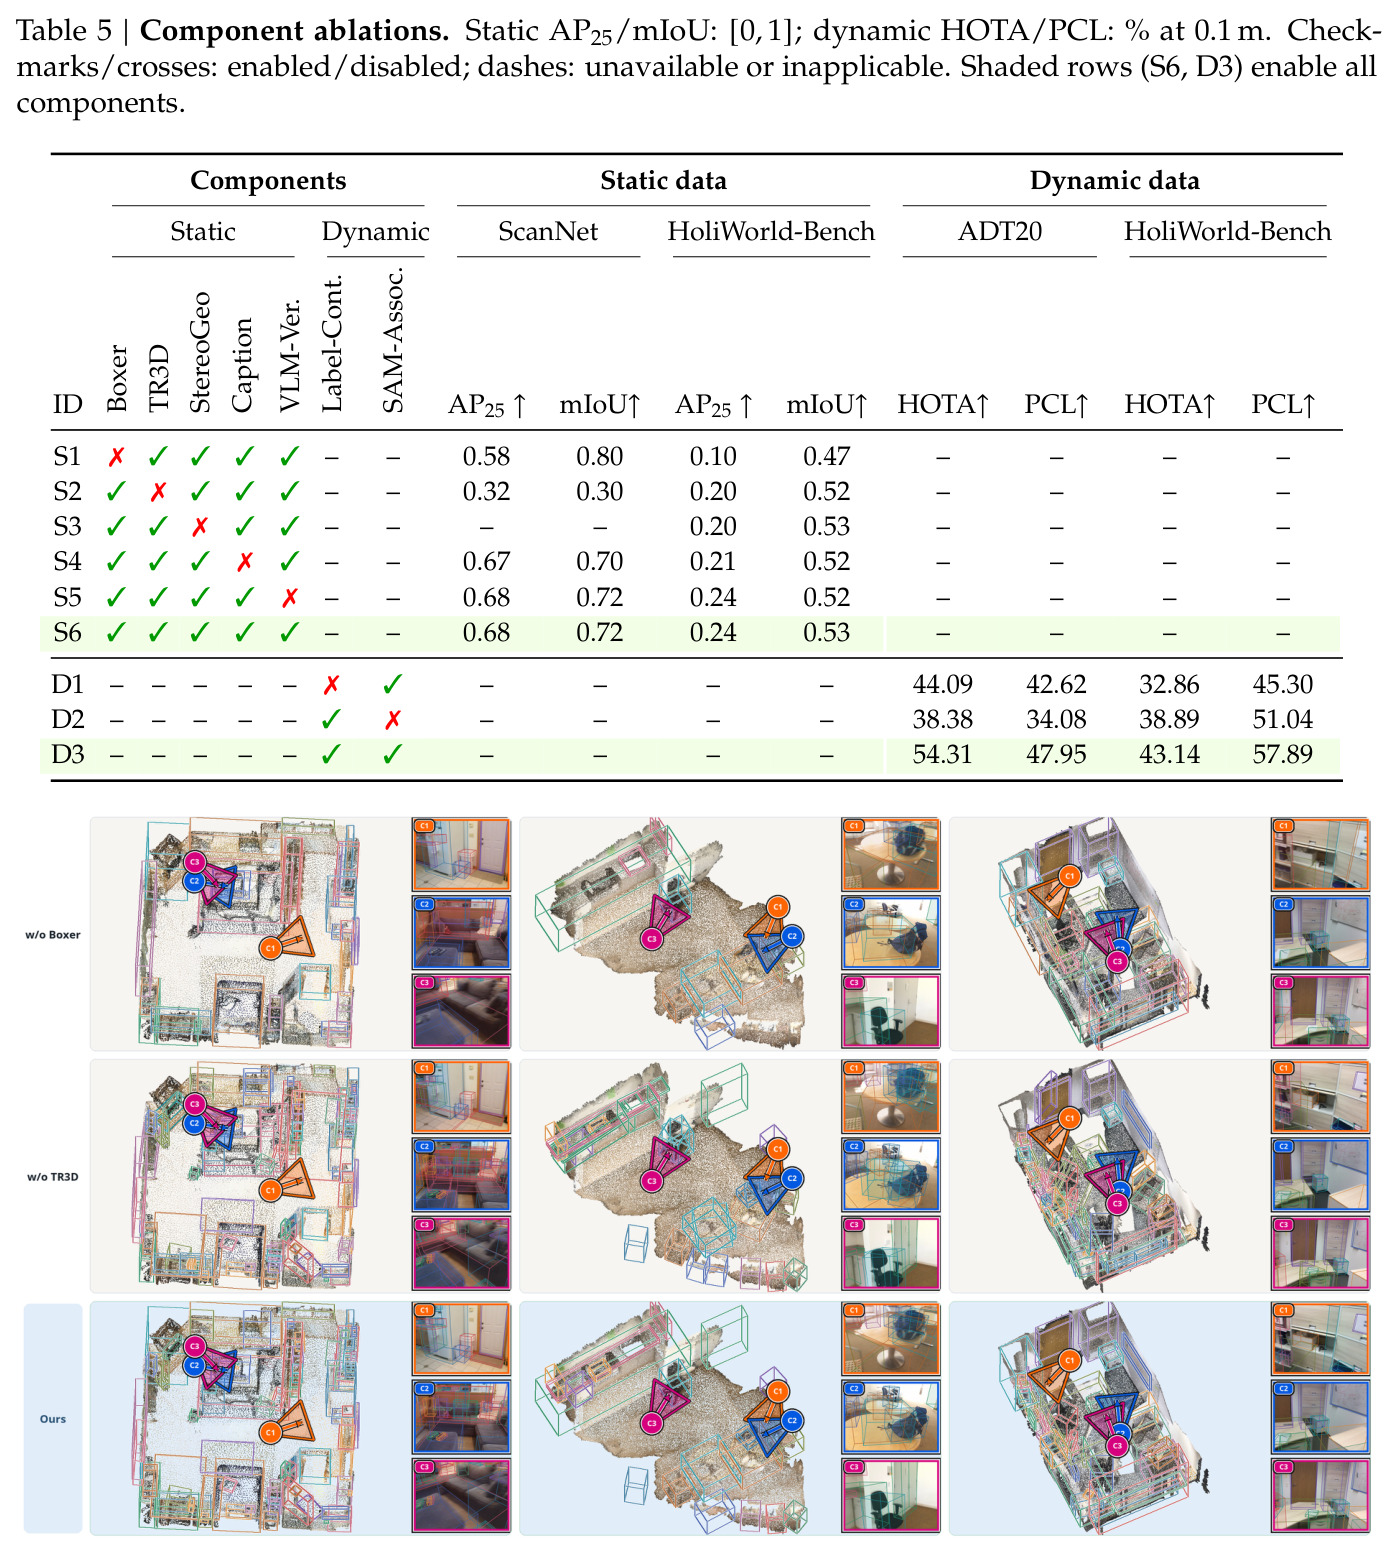
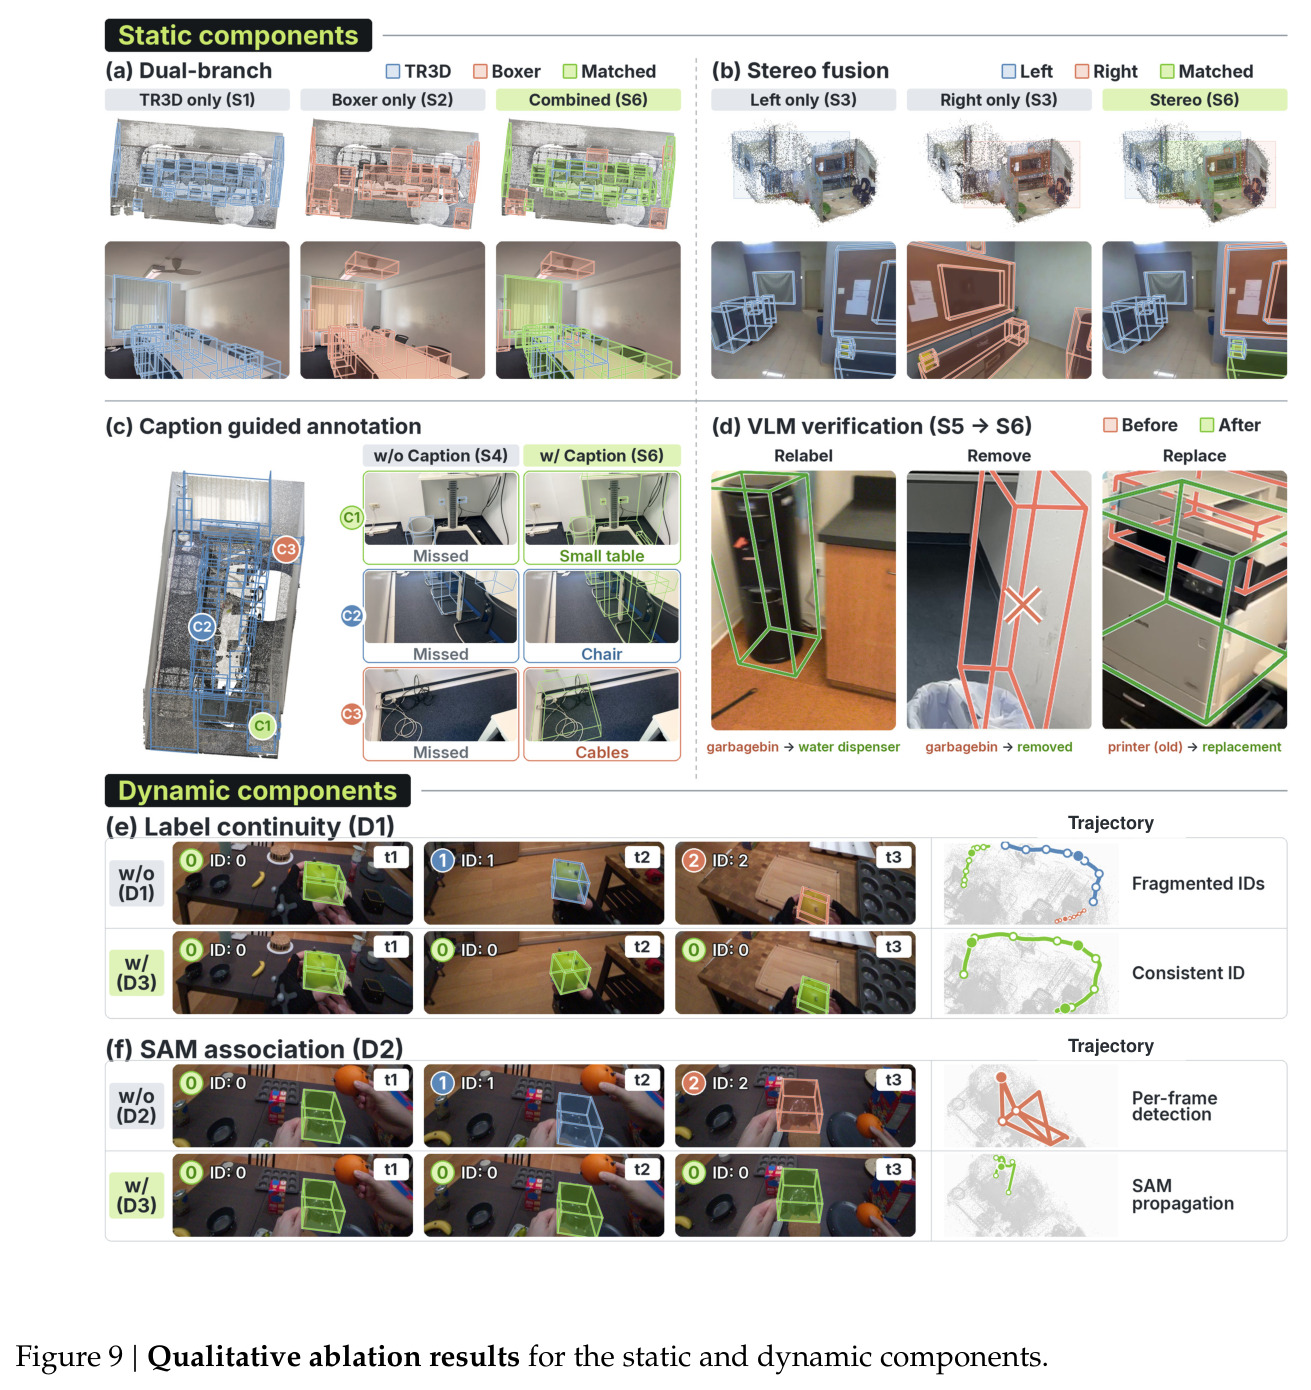
技术新颖性体现在四个层面。第一,系统级整合而非单点算法:把 VI-SLAM、DA3、3DGS、Boxer、TR3D、SAM、VLM 串成一条可对任意新录像重跑的自动标注流水线,并设计了工程上关键的容错细节——每个候选框预选一个备选、VLM 拒绝后仅重试一次、失败则宁缺毋滥不保留,这在自动数据构造工作中少见地正视了'错误标注会污染训练数据'的问题。第二,静态/动态互补融合的形式化:以共享世界坐标和持久 ID 为粘合剂,静态实例跨观测持久存在、动态实例保留时间索引状态,统一进 $S(t)$,使同一物体既能回答空间问题(在哪、多远)又能回答时间问题(何时动、怎么动)。第三,动态侧的两个关键设计有明确消融支撑:跨交互段标签连续性(label continuity)把物体出视野再入镜导致的身份碎片化接回来,SAM 身份引导关联提供时间一致的 mask 供 3D 抬升;去掉任何一个,ADT20 上 HOTA 分别从 54.31% 掉到 44.09% 或 38.38%。第四,评测方法学:用同一套人工标注既评标注工厂又评下游模型,并把基线的输入适配(如 IT3DEgo 用 GT 首帧 mask 初始化、EgoSeg3D 用 GT 类别查询)明确写出,同时强调本文不用任何标注衍生的测试期输入——对比因此更严格。局限在于动态感知基于'每时刻至多一个移动物体'的假设,以及 VLM 的类别命名与验证能力会成为标注质量的上限。
实验结果
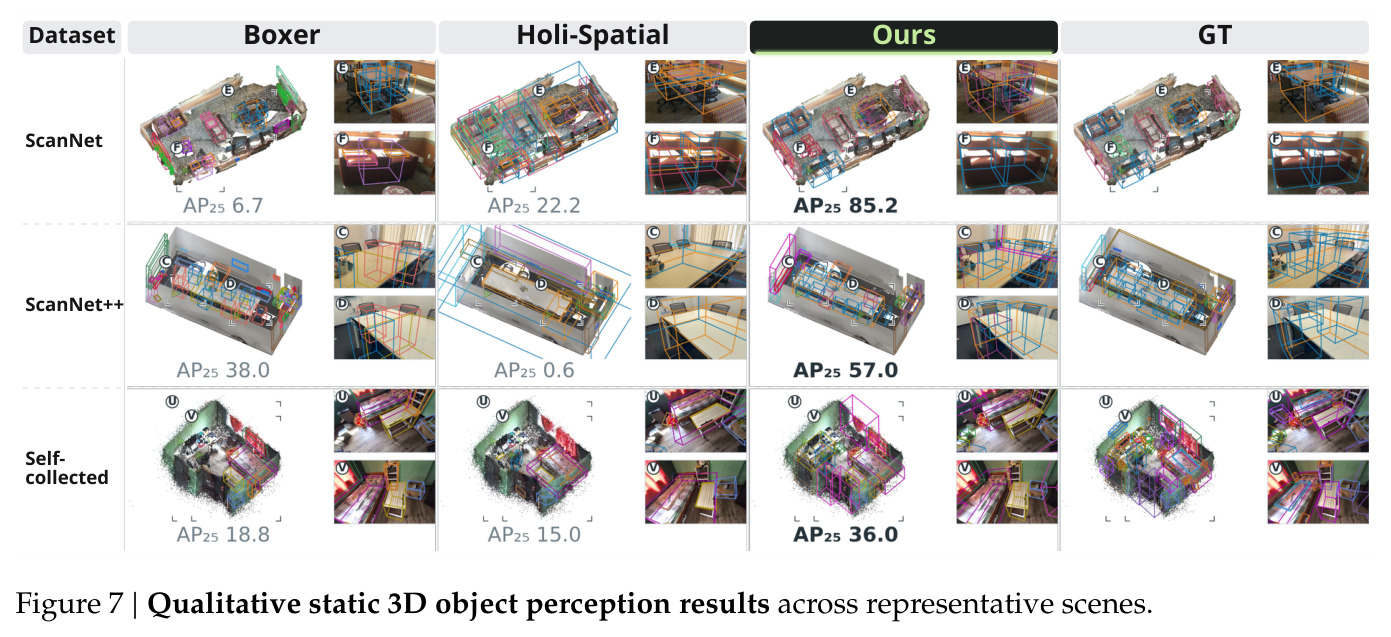
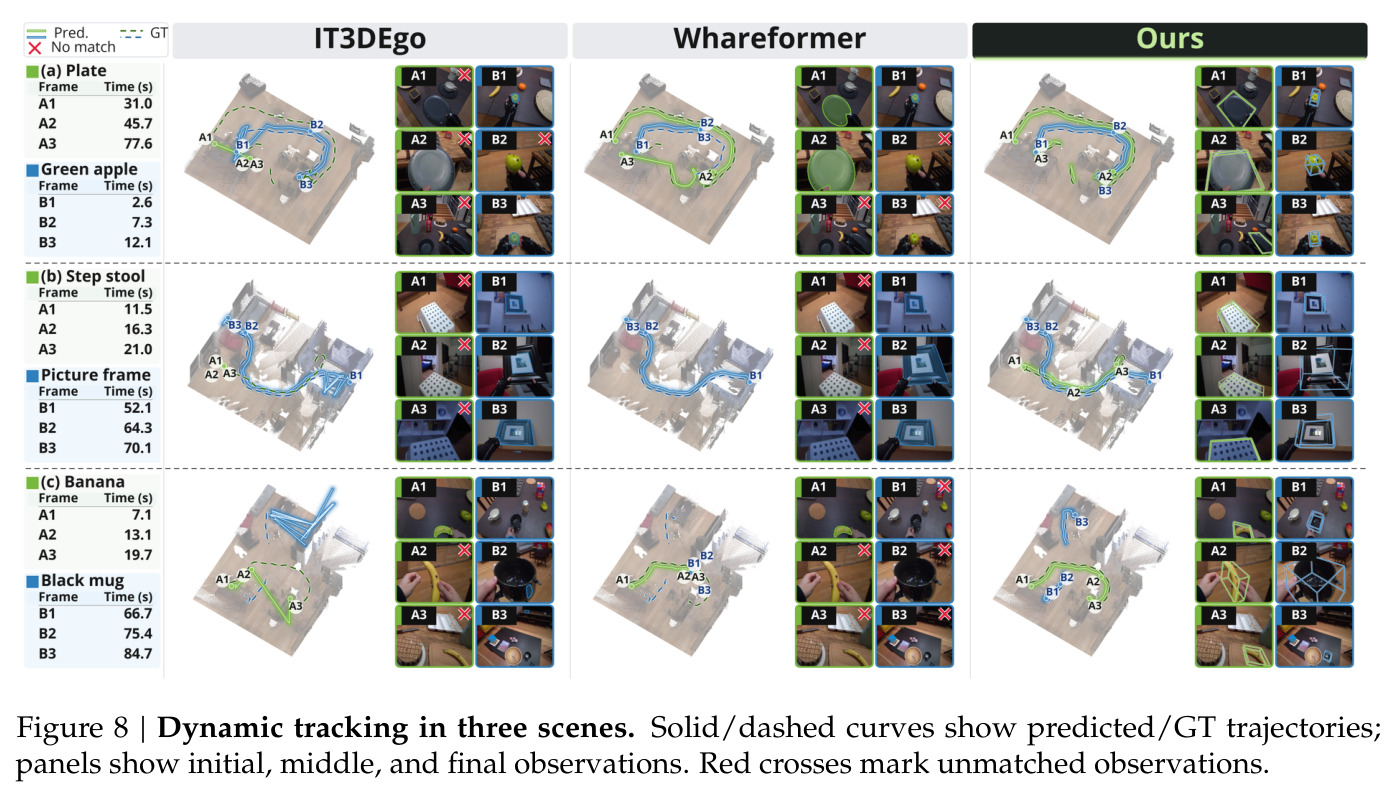
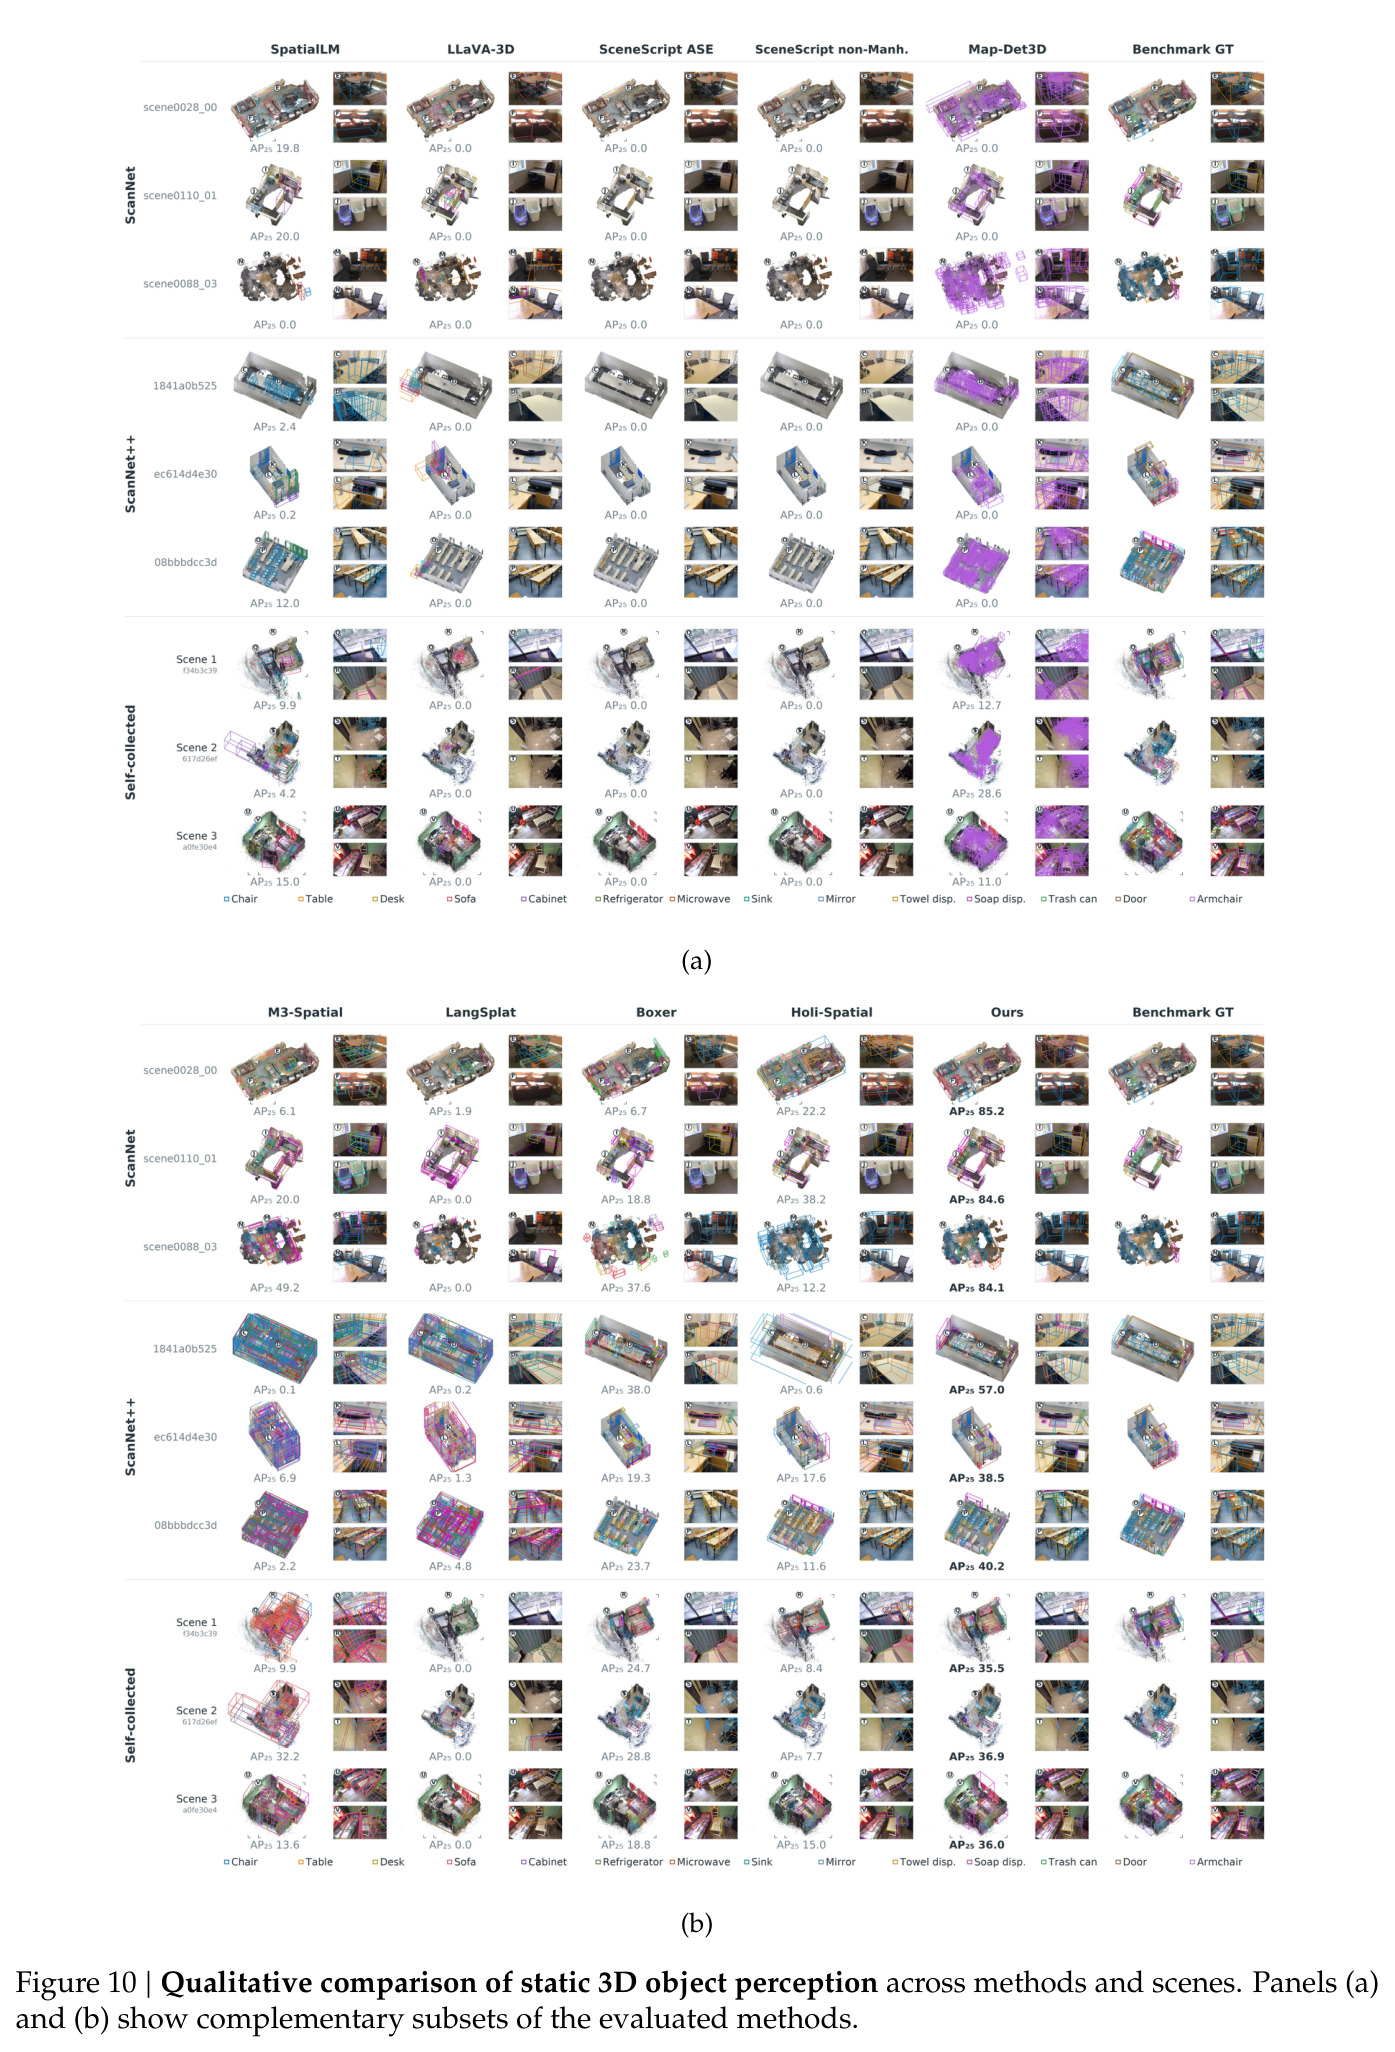
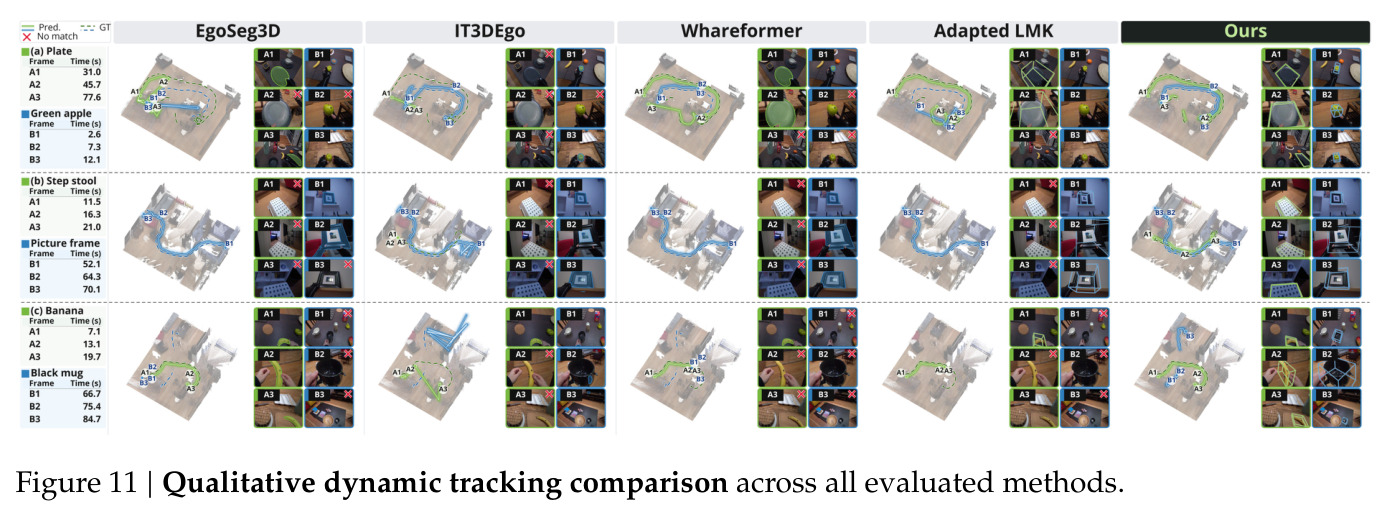
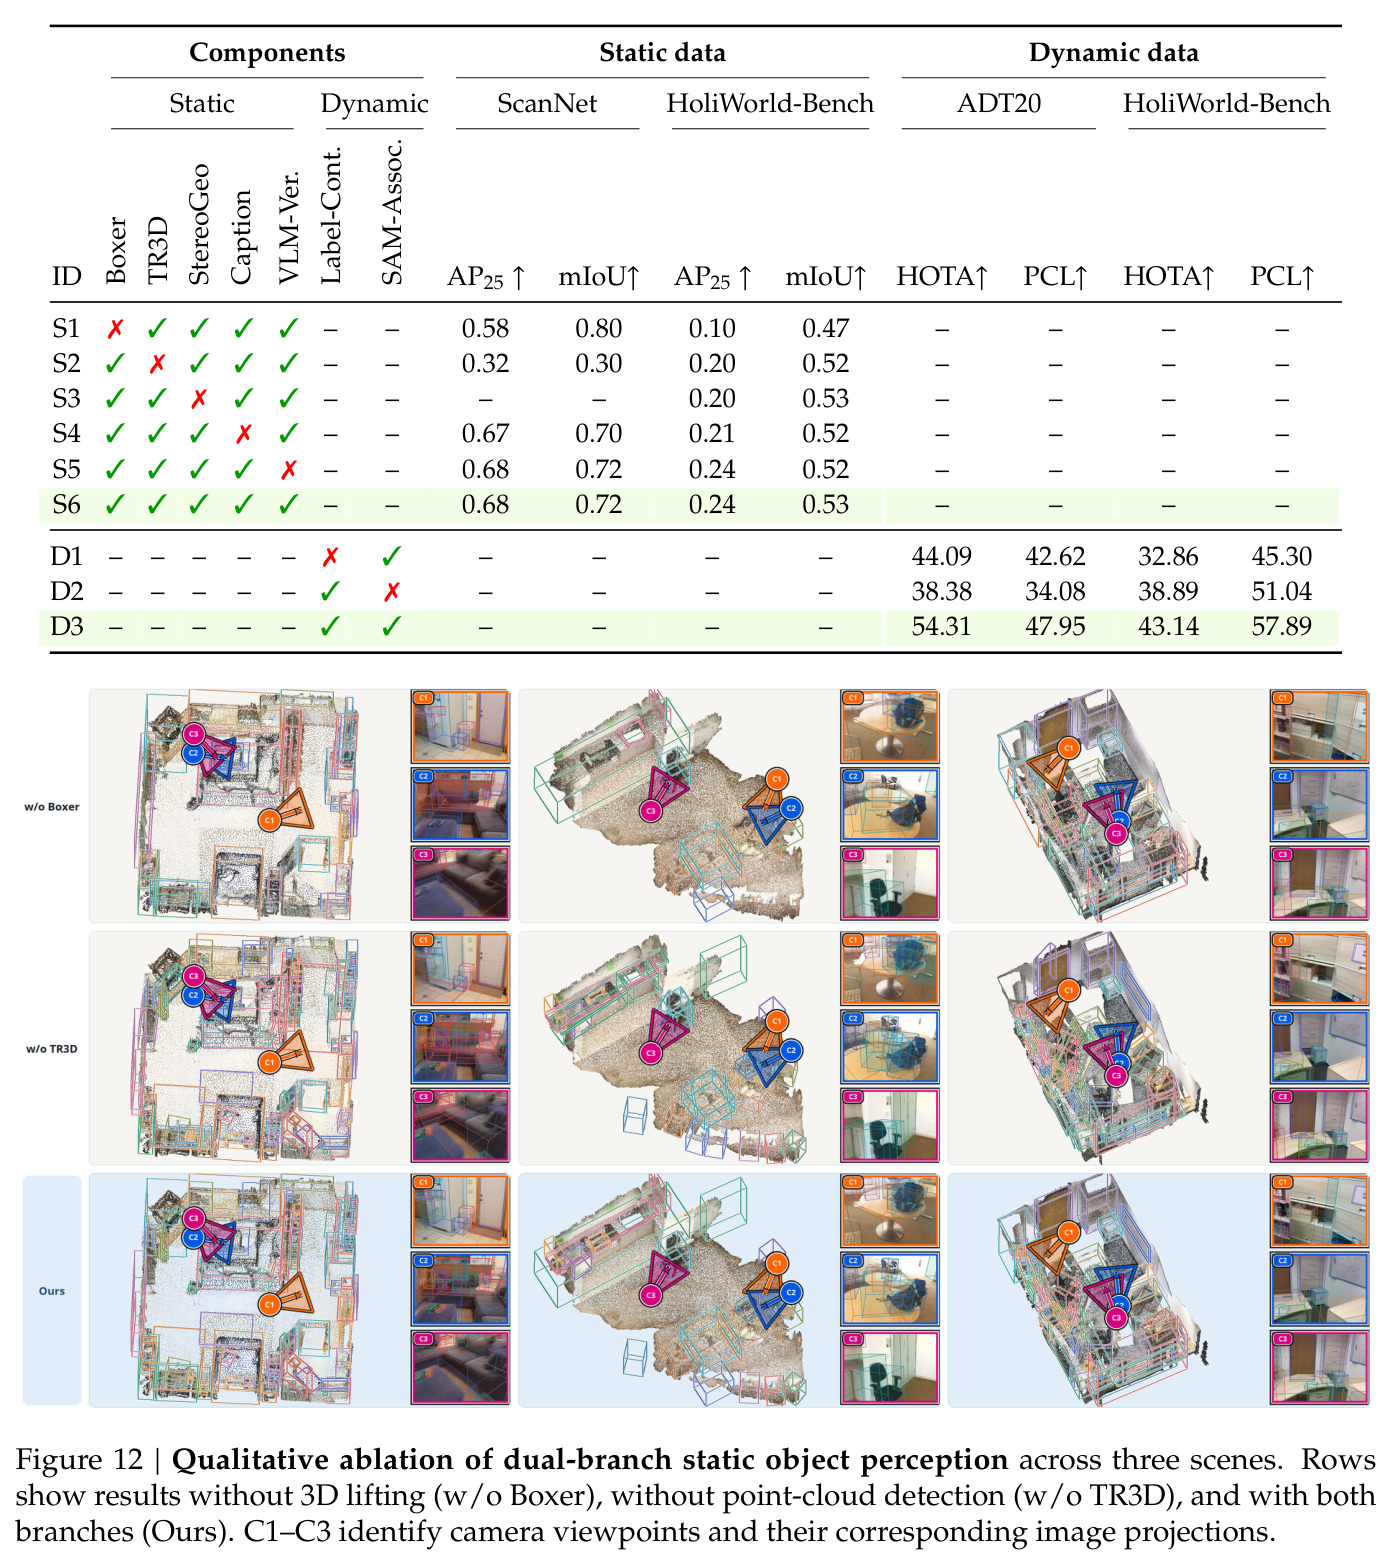
论文从三个层面验证生态的有效性。静态 3D 感知(Table 1,各 20 序列):HoliWorld-Foundry 在 ScanNet 上 AP25 达 0.68,远超最强基线 Map-Det3D 的 0.40;严格阈值 AP50 达 0.55,是最强基线 0.12 的四倍以上;mIoU 0.72。在更高保真的 ScanNet++ 上 AP25 0.30 vs 0.18、AP50 0.13 vs 0.05;在自采的 HoliWorld-Bench 上 AP25 0.24 vs 0.16(Boxer)、AP50 0.12 vs 0.07。这说明双路径融合在严格几何匹配下优势更大,且能迁移到自己采集的野外数据。动态跟踪(Table 2,0.1m 容差):ADT20 上 HOTA 54.31%、AssA 71.94%、PCL 47.95%、框 IoU 30.88%,而用 GT 首帧 mask 初始化的 IT3DEgo 只有 36.00%/53.60%/34.64%——本文不用任何标注输入仍高出 18.31 个百分点;自采 HoliWorld-Bench 上 HOTA 43.14% vs SAM+LMK 的 15.13%,PCL 57.89% vs 23.68%,召回 68.42% vs 39.47%。下游推理(Table 3):Qwen3.5-4B 在 HoliWorld-Data 上微调后,HoliWorld-Bench 的 Token F1 从 16.35% 升至 78.02%,EgoDynamic4D 上从 18.29% 升至 66.39%;4B 模型全面超过零样本的 Qwen3.8-27B(43.67%/42.93%);分题型看,是/否准确率 34.86%→93.52%,多选 62.00%→94.00%,数值 10.80%→81.84%(EgoDynamic4D 数值题仅 0.02%→16.33%,说明数值推理仍是最弱项)。消融(Table 5)解释了各组件贡献:静态侧仅用点云路径(S1)ScanNet AP25 0.58/mIoU 0.80 但 Holi-Bench 只剩 0.10,仅用图像路径(S2)0.32/0.30,双路径全开(S6)0.68/0.72,证明两路互补;去掉 caption 引导(S4)漏掉实体,去掉 VLM 验证(S5)几何指标几乎不变但语义错误未被修正;动态侧去掉跨段身份连续(D1)ADT HOTA 降至 44.09,去掉 SAM 关联(D2)降至 38.38。值得注意的是 TP-L2:Holi-Bench 上本文 0.0280m 反而大于 SAM+LMK 的 0.0113m,原因是本文覆盖了多得多的高难样本(召回 68.42% vs 39.47%),匹配集合不可比。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 静态 3D 物体检测(ScanNet,20 序列) | AP25 / AP50 | 0.68 / 0.55 | Map-Det3D:0.40 / 0.12 | AP25 +0.28,AP50 +0.43(约 4.6 倍) |
| 静态 3D 物体检测(ScanNet++,20 序列) | AP25 / AP50 | 0.30 / 0.13 | Map-Det3D:0.18 / 0.05 | AP25 +0.12,AP50 +0.08 |
| 静态 3D 物体检测(HoliWorld-Bench 自采,20 序列) | AP25 / AP50 / mIoU | 0.24 / 0.12 / 0.53 | Boxer:0.16 / 0.07 / 0.52 | AP25 +0.08,AP50 +0.05 |
| 动态 4D 物体跟踪(ADT20,0.1m 容差) | HOTA / AssA / PCL | 54.31% / 71.94% / 47.95% | IT3DEgo*(GT 初始化):36.00% / 53.60% / 34.64% | HOTA +18.31pt,且本文不使用任何标注输入 |
| 动态 4D 物体跟踪(HoliWorld-Bench,0.1m 容差) | HOTA / PCL | 43.14% / 57.89% | SAM+LMK*(GT 初始化):15.13% / 23.68% | HOTA +28.01pt,PCL +34.21pt |
| 空间时间问答(HoliWorld-Bench) | Token F1 | 78.02%(HoliWorld-VL-4B) | Qwen3.5-4B:16.35%;Qwen3.8-27B 零样本:43.67% | +61.67pt,超 27B 模型 34.35pt |
| 空间时间问答(EgoDynamic4D) | Token F1 | 66.39%(HoliWorld-VL-4B) | Qwen3.5-4B:18.29%;Qwen3.8-27B 零样本:42.93% | +48.10pt,超 27B 模型 23.46pt |
局限与改进
作者明确承认的局限:动态监督建立在'每个时刻至多一个移动物体'的假设上,双人协作或多物体同时被操作的场景无法处理;VLM 验证对几何指标(AP/mIoU)的提升有限,主要作用是语义修正(改类别、剔除不合理候选),说明验证环节的判别能力受制于 VLM 本身;mIoU 以成功匹配为条件,必须与 AP 联合解读,作者在附录中专门提醒读者不要单看 mIoU。我自己观察到的局限:(1) 数据规模仍小——约 100 场景、444 段视频、80K QA,与 Ego4D 的 3000 小时相差两个数量级,'可扩展'目前只是架构上的可行性而非已验证的规模;(2) 场景以室内日常环境为主,采集依赖专用 Eagle 双目+IMU 设备,普通手机单目视频能否走通整条管线未验证;(3) 数值推理依旧薄弱,EgoDynamic4D 数值题准确率只有 16.33%,说明生成的 QA 在数值多样性上不足;(4) Holi-Bench 上匹配成功的 TP-L2 为 0.0280m,比 SAM+LMK 的 0.0113m 差,动态物体 3D 定位精度仍有提升空间(DA3 补全的动态深度是误差源之一);(5) 基线均需 GT 初始化而本文不需,虽然这让对比更有利,但不同方法信息输入不对等,绝对数字的横向可比性需谨慎;(6) 自动标注的类别语义来自 VLM,VLM 的幻觉与命名习惯会系统性传导进训练数据。
独立分析的弱点
弱点一:单移动物体假设是动态感知最大的天花板。现实交互中常见双手同时操作两个物体、或多人传递物品的场景,此时身份关联和 OBB 拟合都会失效。改进方向是引入现代多目标跟踪范式(如跟踪查询、3D MOT 的滤波关联),把'至多一个'放宽为'任意多个但有交互语义约束',并让 VLM 在多物体场景输出目标集合而非单一目标。弱点二:数据规模与多样性不足。100 个场景集中在少数环境类型,QA 的分布也偏向可由几何直接推导的模板题。改进方向是把 Foundry 作为'标注器'接到 Ego4D、Nymeria 等公开大规模数据上离线跑批,验证标注质量随数据类型多样性衰减的程度,并把 30 种 QA 类型扩展到组合式、反事实和规划型问题。弱点三:动态物体的 3D 定位精度受制于 DA3 补全深度(Holi-Bench 上 TP-L2 0.0280m)。改进方向是对每个动态物体实例做局部 3DGS/可微渲染优化,用多帧光度一致性精化物体几何,而不是逐帧依赖单目深度先验。弱点四:数值推理能力提升有限(EgoDynamic4D Num. 仅 16.33%),因为 QA 中数值答案多来自几何计算、分布偏窄。改进方向是引入答案为连续量的回归监督或工具调用(让模型显式查询 3D 坐标再计算),并增加数值答案的颗粒度多样性。弱点五:整条管线串联了 VLM、SAM2、DA3、Boxer、TR3D、3DGS 等多个大模型,处理 1,322K 帧的推理成本高,且任何一环失败都会阻断下游;可研究轻量化蒸馏版本与分阶段质量门控。
未来方向
作者在结论与责任使用部分指出的方向:把 HoliWorld 作为'实际基础'持续吸纳新录像扩展有据可依的学习资源(数据飞轮),让机器通过与人类经验的连接学习'世界如何组织、如何随交互变化';同时强调数据采集需获得同意、审查并去除可识别内容,不得用于非自愿监控。基于本文成果可以自然延伸的方向:(1) 机器人操作——世界记录里的交互语义(拿起/放置/状态转移)与持久物体 ID 可以直接喂给操作策略做 affordance 学习和任务规划,把'看懂交互'变成'执行交互';(2) 与预测式世界模型结合——4D 轨迹监督可为 V-JEPA 2 类视频预测模型提供显式状态对齐信号,让预测从像素级走向物体状态级;(3) 多物体与多人动态场景的自动标注,把生态从单人厨房/卧室推广到社交与协作场景;(4) 跨视角与跨具身迁移——验证在第一视角学到的世界表示能否零样本迁移到第三视角监控或机器人相机;(5) 增量式世界记忆——结合 OSNOM 式的空间记忆,把每次采集增量写入一个持续更新的个人级 3D 语义地图;(6) 用 HoliWorld-Bench 的双用途协议(评标注+评模型)推动自动数据构造领域的质量审计标准化。
复现评估
开源情况相当好:论文首页给出三个入口——代码 github.com/Ropedia/holi-world、模型 huggingface.co/ropedia-ai/holiworld-vl、数据 huggingface.co/datasets/ropedia-ai/holiworld-data,附录 B 专设 Reproducibility 一节,正文与附录 A 详细写明了评测数据(ScanNet/ScanNet++/ADT 各 20 序列 + 20 条自采)、指标定义(HOTA 系列的 0.1m 容差、PCL 的序列级一对一分配、20ms 位姿有效容差)、每个基线的输入适配方式(IT3DEgo 用 GT 首帧 mask、EgoSeg3D 用 GT 类别查询、SAM+Whareformer 与 SAM+LMK 共享 SAM2 前端)以及消融配置(Table 5 的 S1–S6/D1–D3)。复现门槛评估:评测侧门槛低——静态与动态对比都在公开数据集上进行,协议完整;数据侧门槛中——HoliWorld-Data 本身开源,但约 100 个自采场景依赖 Eagle 立体 RGB+IMU 设备,第三方难以完全复现自采数据的采集条件,Bench 的自采部分标注也无法独立重做;算力侧门槛中——HoliWorld-VL-4B 是 4B 模型微调,单节点多卡即可,但 Foundry 管线要串联 VLM、SAM2、DA3、3DGS、Boxer、TR3D 处理 1,322K 帧,工程与推理成本不低,且论文未给出各阶段耗时与总算力数字。总体判断:复现评测结论(Table 1–3)难度中等偏低,复现整条自采-标注管线难度中等偏高,主要不确定性在 VLM 版本与自采硬件差异。
论文图表
Foundry 管线总览:01 Capture(Eagle 设备输出同步立体 RGB+IMU)→ 02 Shared preparation(VI-SLAM、DA3、3DGS 恢复 RGB/深度/相机位姿,VLM 提取语义线索并区分静态物体如椅子柜子与动态物体如'杯子+拿起')→ 03 Static perception(检测、合并、验证得到持久 3D 物体)与 04 Dynamic perception(关联 ID、恢复 3D 运动得到随时间的 3D 轨迹)→ 汇入 Unified world state(共享坐标 + 物体 ID,支撑 grounding、captioning、QA)。
这是方法核心的鸟瞰图,展示了'共享几何准备 + 语义分流 + 静/动双支 + 统一融合'的架构逻辑,理解了它就理解了 Foundry 的设计哲学。