RoAR-VAE:通过鲁棒预测提升潜空间扩散可学习性的视觉分词器 RoAR-VAE: Improving Latent Diffusability through Robust Prediction
从损坏latent预测干净目标,让VAE潜空间既保真又易被扩散模型学习
前置知识
视觉分词器(Visual Tokenizer / VAE)
把图像压缩成低维潜变量的编码器-解码器,例如把 $256^2$ 图像压成 $32\times32\times32$ 的 latent。潜在扩散模型不在像素上而去噪,而是先由分词器压缩,生成在 latent 空间进行,再解码回图像。训练目标是像素重建、感知损失(LPIPS)、KL 正则与对抗损失的加权和。
本文全部贡献都发生在分词器的潜空间上,理解它的结构、训练目标和压缩率是读懂一切实验设计的前提。
可扩散性(Diffusability)
指潜变量表示被下游扩散模型学习的难易程度。高容量或弱正则的 latent 虽然重建更好,但对扩散模型更难拟合。通行度量方式是:冻结分词器,用相同 backbone、相同数据、相同预算从头训练一个扩散模型,比较其在固定步数(如 32k 步)时的生成得分。
这是本文优化的核心属性;论文所有对比实验都围绕固定预算下的下游生成得分展开,不懂这个概念就无法理解实验动机。
REPA 与 REPA-E
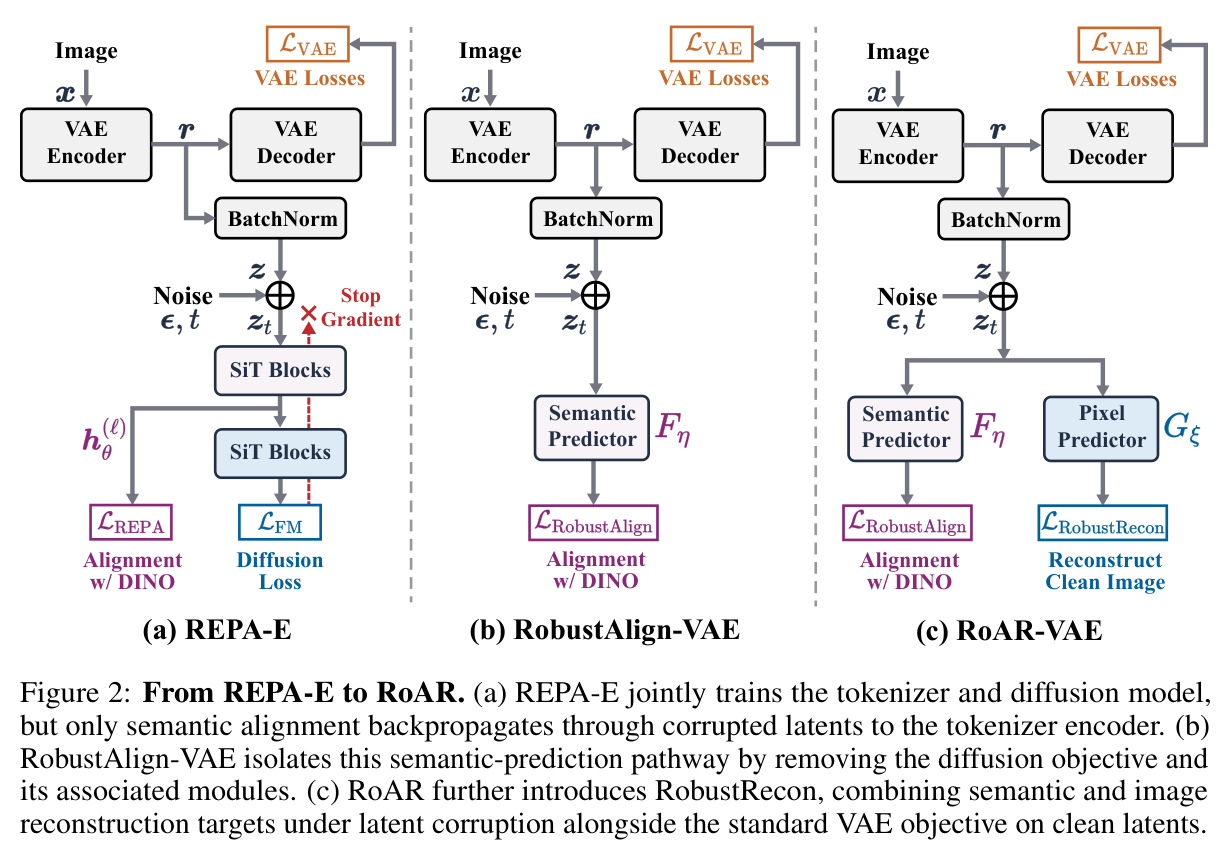
REPA 把扩散 Transformer 的中间层特征与预训练视觉编码器(DINOv2)的 patch 特征做余弦相似度对齐,从而加速扩散训练;REPA-E 进一步把 VAE 与扩散模型联合训练,其中 flow-matching 损失对 VAE 编码器是 stop-gradient 的,只有语义对齐损失 $\mathcal{L}_{REPA}$ 经加噪 latent 回传给编码器。
本文正是通过删掉 REPA-E 的扩散部分来隔离出真正起作用的监督信号,REPA-E 是全文分析的参照系和出发点。
流匹配与加噪潜变量
流匹配用线性插值 $z_t=(1-t)z+t\epsilon$($t\in[0,1]$,$\epsilon\sim\mathcal{N}(0,I)$)构造噪声样本,训练网络预测速度 $(\epsilon-z)$。$t$ 越小越接近干净 latent,$t=1$ 为纯噪声。扩散模型在整个 $t$ 区间上学习从噪声恢复信号。
RoAR 的两个辅助头都以同一个 $z_t(\phi)$ 为输入,『从损坏 latent 预测干净目标』正是方法的核心机制,$t$ 的采样方式($t\sim U(0,1)$)也是关键超参。
谱偏差与方向性信噪比
扩散/流模型的学习动力学存在谱偏差:潜变量协方差方差越大的模式被学得越早(Wang & Pehlevan, 2025)。沿第 $i$ 个特征方向,加噪后信号方差为 $(1-t)^2\nu_i$、噪声方差为 $t^2$,故 $\mathrm{SNR}_i(t)=(1-t)^2\nu_i/t^2$——高方差方向在固定噪声水平下天然更抗噪。
这是论文解释『鲁棒预测为何能提升 diffusability』的理论支柱:预测目标迫使生成相关信息住进高方差的主导方向,而扩散模型最先学的正是这些方向。
研究动机
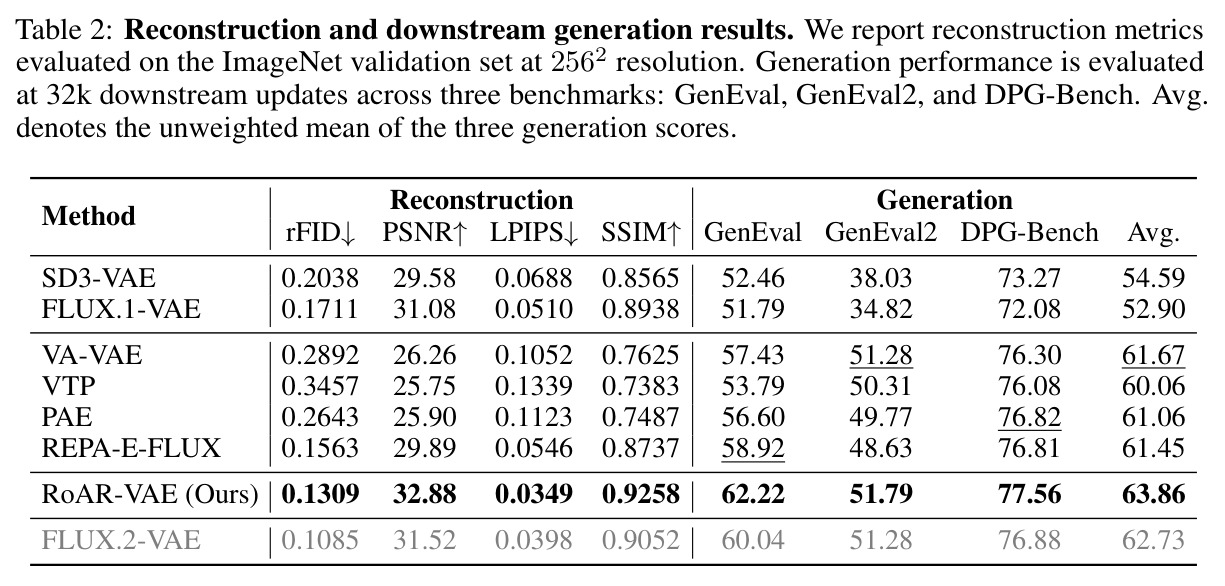
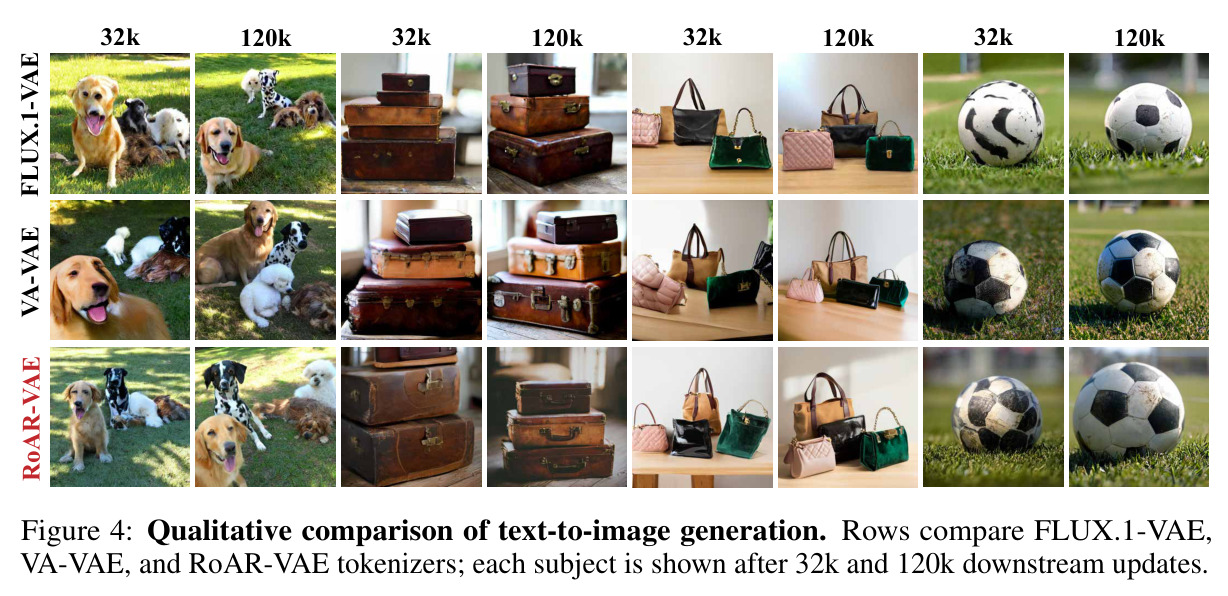
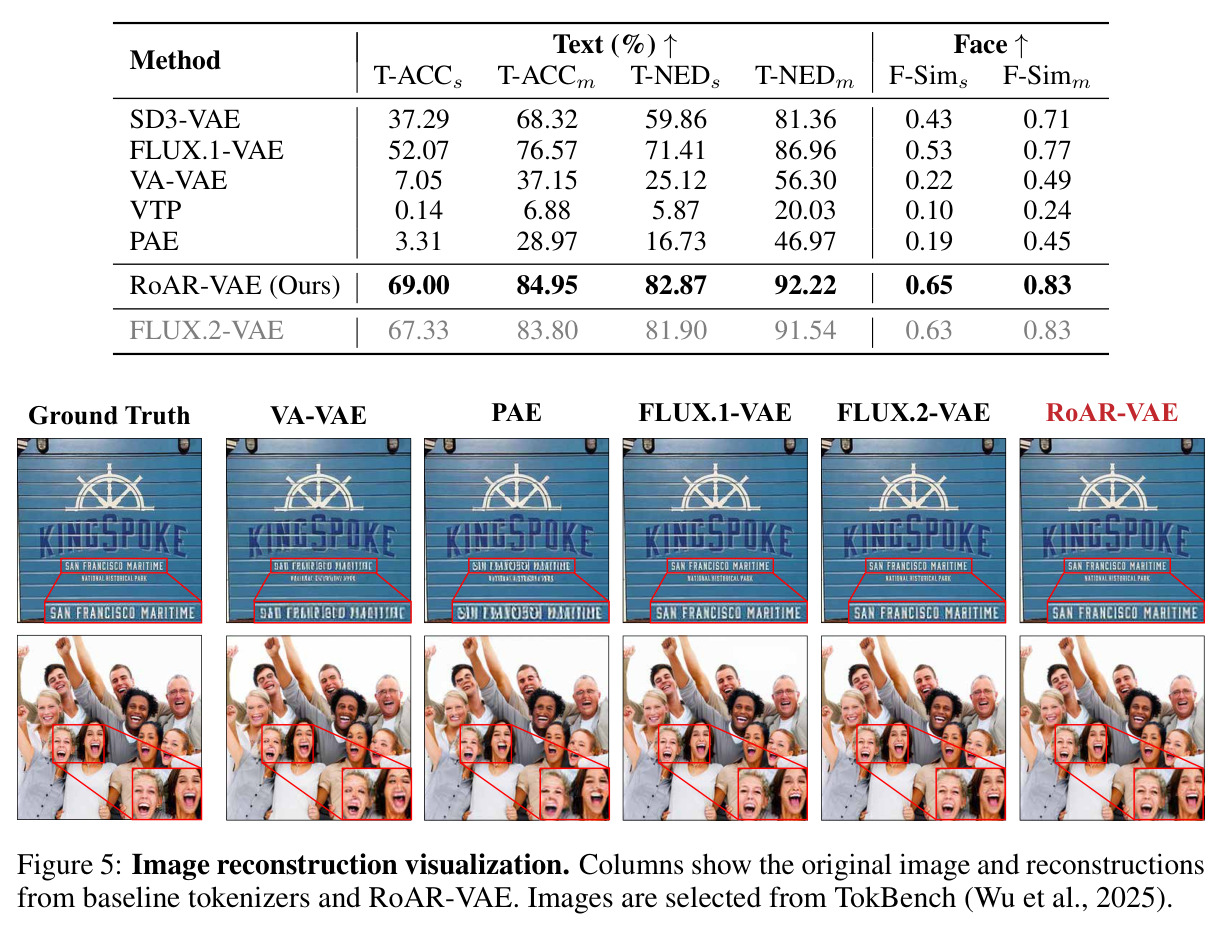
潜在扩散模型的视觉分词器长期面临重建保真与可扩散性(diffusability)的矛盾。重建导向的分词器细节虽好,但潜空间对扩散模型不友好:用同一下游 MMDiT 训练 32k 步后,FLUX.1-VAE 的 GenEval 仅 51.79,甚至低于 SD3-VAE 的 52.46。反过来,面向可学习性设计的分词器(VA-VAE、VTP、PAE)生成得分虽可达 53-57,重建却严重退化:VA-VAE 的 LPIPS 高达 0.1052,小字识别率只有 7.05%,VTP 更是跌到 0.14%,小脸相似度仅 0.10-0.22,说明细粒度信息几乎被丢光。现有改进路线要么在 VAE 训练中直接对齐语义特征(VA-VAE),要么把分词器与扩散模型联合训练(REPA-E);后者必须维护一个完整生成器、无法缓存 latent 做大规模训练,而且一直没人讲清楚 diffusability 的收益究竟来自联合训练本身,还是来自语义监督这一路信号。
本文的目标是本文目标分三层。其一,通过受控拆解弄清 REPA-E 的收益来源:用同一 VAE 架构分别训练 Vanilla-KL-VAE、完整 REPA-E 分词器,以及只保留『从加噪 latent 预测语义特征』的 RobustAlign-VAE,再在完全相同的下游扩散训练设置下比较。其二,把实验发现上升为一条通用设计原则——鲁棒预测(robust prediction):与生成相关的信息,应当能从被强噪声损坏的 latent 中恢复出来。其三,用两个互补目标实例化该原则,训练新分词器 RoAR-VAE(ImageNet 256²、8× 下采样、约 84M 参数),要求它同时做好两件事:下游三基准平均分超过最强基线(论文实测 +2.19 分),同时 PSNR 达到 32.88 dB、小字识别率比 FLUX.1-VAE 高 16.93 个百分点,打破『保真与可学习性不可兼得』的局面。
与已有工作不同的是,独特切入点是『反向工程』 REPA-E。作者抓住一个被忽视的关键细节:REPA-E 的 flow-matching 损失对 VAE 编码器是 stop-gradient 的,唯一穿过加噪 latent $z_t$ 回传到编码器的扩散侧监督只有语义对齐损失 $\mathcal{L}_{REPA}$。于是他们干脆删掉扩散目标、SiT 生成块与 BatchNorm,只保留从 $z_t$ 预测 DINO 特征,得到极简的 RobustAlign——匹配设置下 32k 步 GenEval 达 60.89,与完整 REPA-E 的 60.60 相当。这把问题从『如何联合训练』重构为『什么样的预测目标能让生成信息住进潜空间的主成分方向』,并进一步用方向性信噪比 $\mathrm{SNR}_i(t)=(1-t)^2\nu_i/t^2$ 与扩散模型的谱偏差给出机理解释,消融链条完整,兼具方法论反思与工程价值。
核心方法
直觉上:信息若在被噪声损坏的 latent 中仍可被预测,就必然占据高方差的主导方向;扩散模型恰恰最先学习高方差模式,故把生成相关信息组织进主导模式,下游就学得快。做法是在标准 $\mathcal{L}_{VAE}$ 外加两个从损坏 latent $z_t=(1-t)z+t\epsilon$($t\sim U(0,1)$)出发的预测头。RobustAlign 用 8 层 Transformer 头 $F_\eta$ 从 $z_t$ 预测冻结 DINOv2-B 特征 $T(x)$(余弦距离),保住高层语义;RobustRecon 用参数独立的辅助解码器 $G_\xi$ 从 $z_t$ 重建干净图像 $x$(L1+LPIPS),保住纹理等细粒度外观。总损失 $\mathcal{L}_{RoAR}=\mathcal{L}_{VAE}+\lambda_A\mathcal{L}_{RobustAlign}+\lambda_R\mathcal{L}_{RobustRecon}$,$\lambda_A=1.5$、$\lambda_R=0.5$;两个辅助头训练后即丢弃。
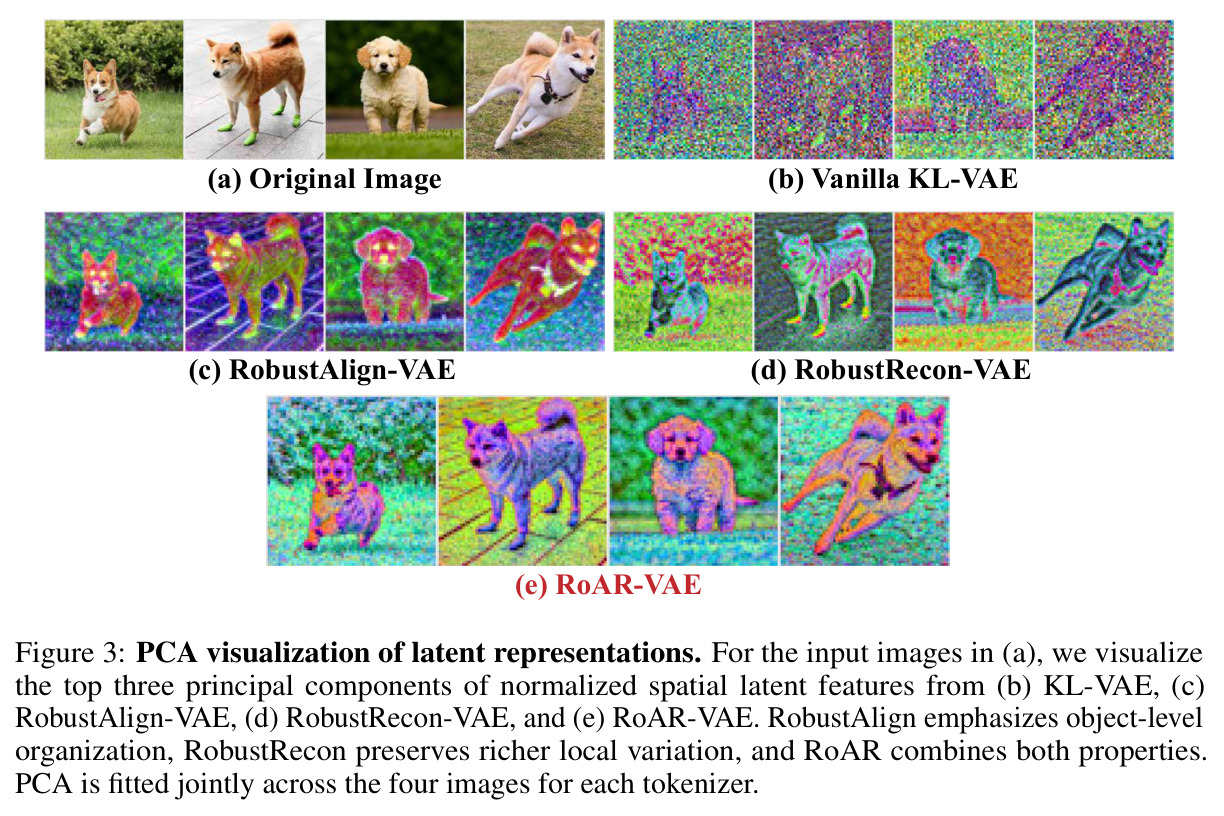
核心创新是把 diffusability 收益归因于『鲁棒预测』而非联合训练。与 REPA-E 的本质区别有三点。第一,去掉了联合训练所需的整个扩散 Transformer(SiT blocks、BatchNorm、噪声分支),只保留语义预测路径,训练成本低得多,且 latent 可以离线缓存做大规模训练。第二,引入 RobustRecon,把『从损坏 latent 预测干净目标』从语义层面推广到像素层面,弥补语义教师对纹理、小字、人脸等细粒度信号的欠表达——PCA 可视化显示 RobustAlign 的潜空间前景/背景分离清晰但局部变化贫乏,RobustRecon 局部变化丰富但对象组织弱,二者结合才兼得。第三,给出机理:加噪下第 $i$ 个方向的信噪比为 $\mathrm{SNR}_i(t)=(1-t)^2\nu_i/t^2$,高方差方向更抗噪,鲁棒预测因此把关键信息推向扩散模型最先学习的主导模式,从理论上串起『目标设计—潜空间几何—下游学习速度』的因果链。
方法步骤详情
第一步预热:ImageNet 256² 上用 $\mathcal{L}_{VAE}$(L1+LPIPS、KL $10^{-6}$、DINOv2-S 判别器)训练 200k 步。第二步精炼 250k 步:每步把编码输出按 $t\sim U(0,1)$ 加噪得 $z_t(\phi)$;语义头 $F_\eta$(8 层 Transformer+MLP)以余弦损失从 $z_t$ 预测 DINOv2-B patch 特征;像素头 $G_\xi$(预热解码器初始化、参数独立)以 L1+LPIPS 从 $z_t$ 重建原图;两者经 $z_t$ 回传更新编码器,权重 $\lambda_A=1.5$、$\lambda_R=0.5$,AdamW、batch 256、lr $10^{-5}$。第三步,丢弃辅助头、冻结分词器。第四步,下游评测:训练 24 层 MMDiT(1024 隐维、0.8B),冻结 Qwen3-0.6B,LAION 重描述 256²、batch 1024、lr $2\times10^{-4}$,32k 步后以 Euler 50 步、CFG 5.0 在三基准评 4 种子均值。
技术新颖性
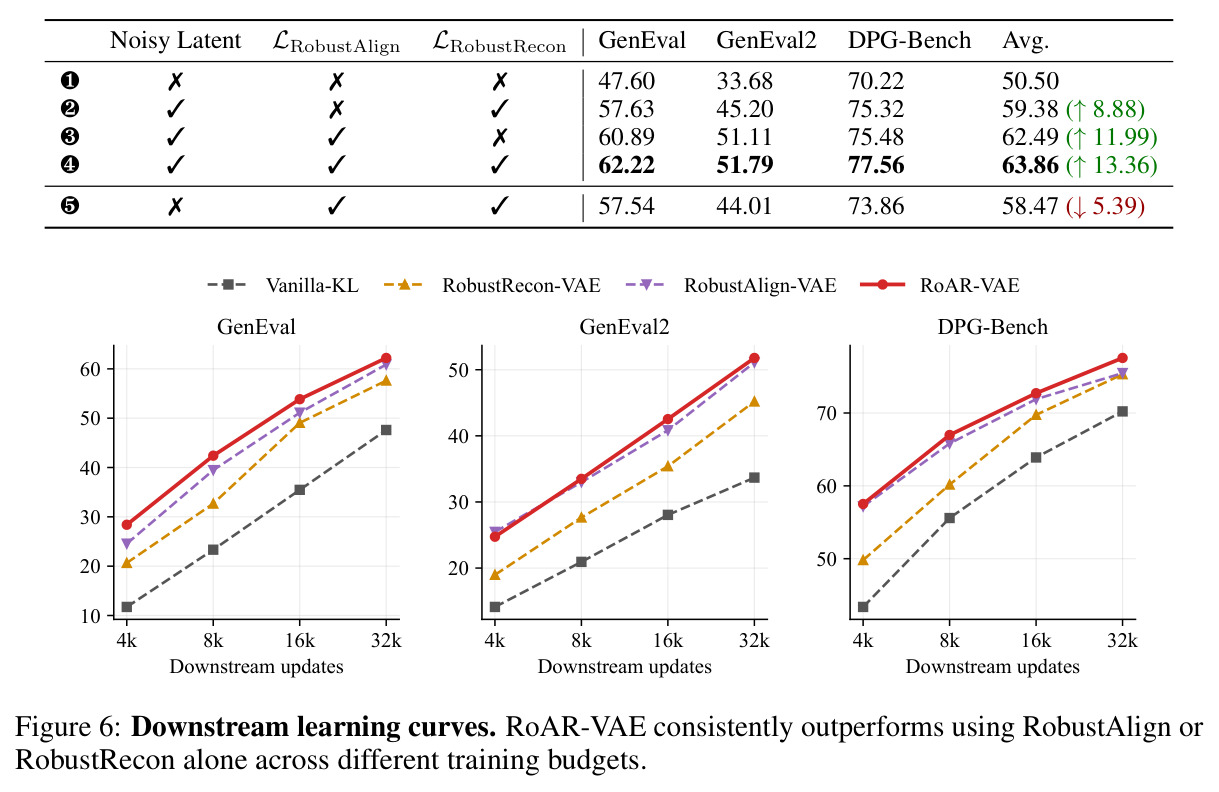
技术新颖性体现在三处。第一,结论层面的新:首个受控证据表明 REPA-E 的 diffusability 收益不依赖联合训练——去掉扩散模型后性能不降反微升(60.89 vs 60.60),这直接挑战了『端到端联合调优是必要条件』的流行叙事,也解释了为何此前多种语义正则方法(VA-VAE、PAE 等)殊途同归。第二,目标设计的新:RobustRecon 把去噪式辅助目标从特征空间搬到像素空间,与 RobustAlign 形成语义/外观互补;Table 4 显示两者分别带来 +11.99 和 +8.88 的平均分提升,组合 +13.36,互补性被干净地量化。第三,解释框架的新:用方向性信噪比和谱偏差把『鲁棒预测有效』与『扩散模型先学高方差模式』两条已知事实接起来,把经验技巧升级为可迁移的设计原则,为后续 tokenizer 研究提供了统一视角。
实验结果
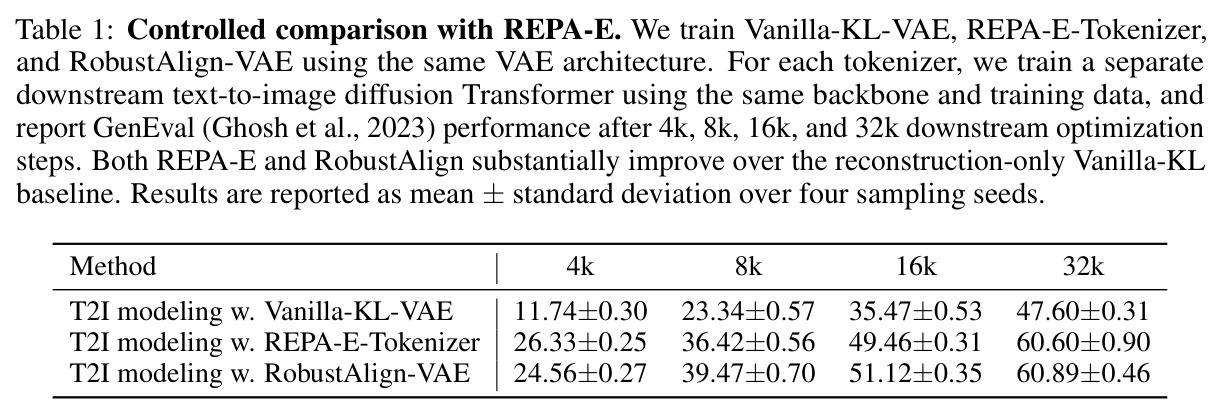
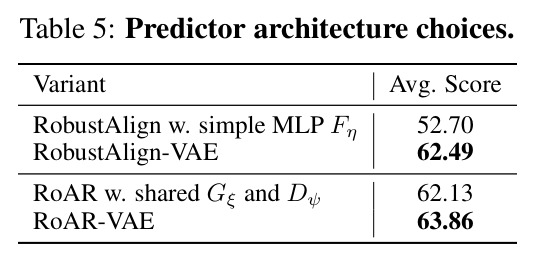
四组结果。(1) 受控对比(Table 1):同架构下 Vanilla-KL 的 32k 步 GenEval 仅 47.60,REPA-E 为 60.60,去掉扩散组件的 RobustAlign 达 60.89,收益来自语义预测。(2) 主对比(Table 2):重建 rFID 0.1309、PSNR 32.88、LPIPS 0.0349 领先(FLUX.1 0.0510);下游 32k 步三基准平均 63.86,超 VA-VAE(61.67)2.19 分,逼近 FLUX.2(62.73)。(3) TokBench 细节保真:小字识别率 69.00%(FLUX.1 52.07%,+16.93pp),小脸相似度 0.65 对 0.53;VA-VAE/VTP/PAE 生成分好,小字识别率仅 7.05%/0.14%/3.31%,细节几乎丢光。(4) 消融(Table 4):去掉 latent 腐蚀后平均分从 63.86 跌到 58.47;RobustRecon/RobustAlign 单独 +8.88/+11.99,组合 +13.36(基线50.50);语义头换 MLP 掉到 52.70。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生图下游生成(32k 步冻结分词器重训 MMDiT) | 三基准平均分(GenEval/GenEval2/DPG-Bench 均值) | 63.86(GenEval 62.22 / GenEval2 51.79 / DPG 77.56) | VA-VAE 61.67;REPA-E-FLUX 61.45;FLUX.1-VAE 52.90 | 较最强基线 +2.19 分,较 FLUX.1-VAE +10.96 分 |
| 图像重建(ImageNet 验证集 256²) | rFID ↓ / PSNR ↑ / LPIPS ↓ | 0.1309 / 32.88 dB / 0.0349 | FLUX.1-VAE 0.1711 / 31.08 / 0.0510;REPA-E-FLUX 0.1563 / 29.89 / 0.0546 | PSNR +1.80 dB(对 FLUX.1-VAE),LPIPS 降低约 31% |
| 小字与文本重建(TokBench) | T-ACC_s (%) / T-NED_s (%) | 69.00 / 82.87 | FLUX.1-VAE 52.07 / 71.41 | 小字识别率 +16.93 个百分点 |
| 人脸重建(TokBench) | F-Sim_s / F-Sim_m | 0.65 / 0.83 | FLUX.1-VAE 0.53 / 0.77;FLUX.2-VAE 0.63 / 0.83 | 小脸相似度 +0.22(对 FLUX.1-VAE),追平 FLUX.2-VAE |
| 与 REPA-E 的受控对比(同 VAE 架构 + 同下游训练) | GenEval @32k 步(4 种子均值) | RobustAlign-VAE 60.89±0.46 | REPA-E-Tokenizer 60.60±0.90;Vanilla-KL-VAE 47.60±0.31 | 去掉扩散模型仍 +0.29,相对 Vanilla-KL +13.29 |
局限与改进
作者承认的局限不多,隐含的有:语义目标绑定冻结的 DINOv2-B,继承了预训练编码器的归纳偏差;机理解释(SNR + 谱偏差)是启发式的,缺少把『高方差方向信息可访问性』与下游加速直接挂钩的干预实验。我自己的观察:第一,分词器只在 ImageNet 256² 上训练,更大分辨率与真实网络数据分布下的扩展性未验证,而 FLUX.2-VAE 这类工业分词器的训练数据规模远超 ImageNet;第二,下游模型固定为 0.8B MMDiT 与 256²,更大模型、更高分辨率、多分辨率生成场景下结论是否保持是未知数;第三,与 REPA-E 的对比移除了后者的 BatchNorm 缓存机制,公平但意味着『更优』只在本文匹配设置内成立;第四,$\lambda_A=1.5$、$\lambda_R=0.5$ 只报告单点取值,缺超参敏感性分析;第五,辅助头带来的 250k 步额外训练与 DINOv2 前向开销,相对 vanilla VAE 的成本增加没有量化报告。
独立分析的弱点
弱点一:语义教师单一。DINOv2 特征偏物体级语义,对小字、人脸这类细粒度信号引导有限,这正是需要 RobustRecon 补位的原因;可以探索多教师(DINOv2 + OCR/人脸专用编码器)或多尺度目标。弱点二:噪声水平用 $t\sim U(0,1)$ 均匀采样未必最优,低信噪比区间可能浪费大量梯度,可改为按 SNR 加权或可学习的 $t$ 分布。弱点三:对预测器容量敏感——8 层 Transformer 换成 MLP 后平均分从 62.49 崩到 52.70,说明收益部分依赖『足够强的预测路径』,这削弱了『原则简单』的叙事,也留下一个开放问题:多强的预测器才算够,是否存在容量与收益的标度律。弱点四:没有对 latent 通道数与压缩率(固定 32 通道、8×)做消融,无法判断鲁棒预测的收益如何随压缩强度变化,迁移到 16× 或视频 tokenizer 时缺乏指导。弱点五:PCA 可视化只用了 4 张图,『信息移入主导模式』的说法缺少方差谱、模式级线性探针等定量证据,机理部分仍偏定性叙事。
未来方向
作者层面的延伸:把鲁棒预测用于更高分辨率与视频分词器(其引用的谱偏置工作正是针对视频 VAE);由于 latent 可缓存,『先离线训练强分词器、再做大规模扩散训练』可能成为比联合训练更划算的配方,值得系统比较。可延伸的研究方向:其一,把 SNR 分析变成可优化目标,例如显式最大化目标信息在高方差方向的可解码性,形成带谱约束的信息瓶颈式训练目标;其二,用自监督或数据驱动目标替代 DINO 教师,摆脱预训练编码器偏差,并检验教师质量与下游收益的关系;其三,在离散/自回归 tokenizer 上验证同一原则(作者团队此前有 InsightTok 的工作脉络);其四,训练过程动态调度 $t$ 的采样分布,或在训练后期对两个辅助头做退火关闭以压缩训练成本;其五,与工业规模数据结合检验 scaling 行为,并研究鲁棒预测潜空间对编辑、可控生成等下游任务的适配性。
复现评估
复现友好度较高:代码承诺开源(GitHub: LeapLabTHU/RoAR-VAE),超参在附录 A 披露充分——架构(8× 下采样、32 通道、84M 参数)、两阶段训练(200k+250k 步、batch 256、AdamW、lr $10^{-5}$、$\lambda_A=1.5$、$\lambda_R=0.5$)、教师(冻结 DINOv2-B)、判别器(DINOv2-S)、噪声采样($t\sim U(0,1)$)均已给出。下游协议:MMDiT 24 层/1024 隐维/0.8B、Qwen3-0.6B、LAION 重描述、batch 1024、lr $2\times10^{-4}$、logit-normal $\mu=1.5$、Euler 50 步、CFG 5.0、4 种子均值。难点在算力:分词器要 450k 步 ImageNet 训练,每个基线还需从头训 0.8B 扩散模型(LAION、32k 步起评),估计需数十张高端 GPU 周级投入;数据需 ImageNet/TokBench/LAION。若只复现核心结论,优先跑 Table 4 五行消融(约 5 个下游模型)性价比最高。
论文图表
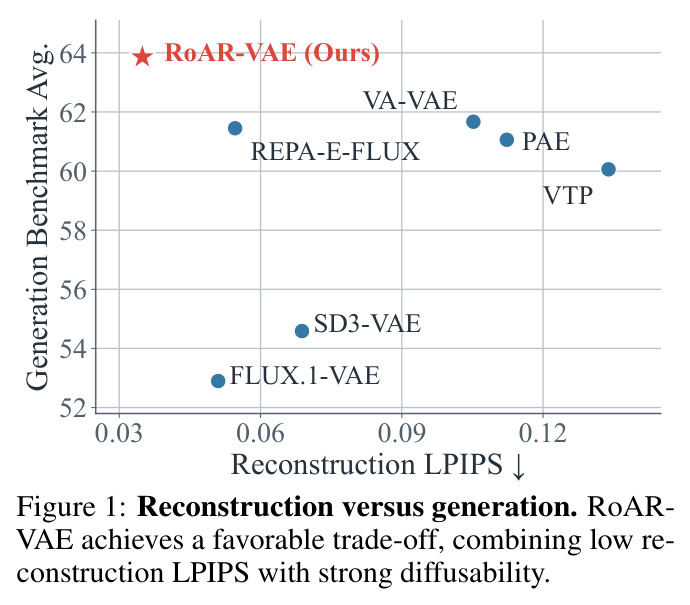
以重建 LPIPS(横轴,越低越好)和三基准平均生成得分(纵轴)为坐标的散点图,放入 SD3-VAE、FLUX.1-VAE、VA-VAE、VTP、PAE、REPA-E-FLUX 与 RoAR-VAE。RoAR-VAE 位于左上角:LPIPS 0.0349 最低的同时平均分 63.86 最高,而其他方法都分布在『重建好则生成差、生成好则重建差』的权衡曲线上。
一图道出全文主旨:RoAR-VAE 不是在既有 trade-off 曲线上移动,而是把 Pareto 前沿整体外推,这是理解论文贡献价值的最直观入口。
细粒度保真对比:RoAR-VAE 小字识别率 69.00%、全量文字 84.95%、小字编辑距离 82.87、小脸相似度 0.65、全量 0.83,所有文字与人脸指标最佳;VA-VAE/VTP/PAE 的小字识别率仅 7.05%/0.14%/3.31%,FLUX.1-VAE 为 52.07%,FLUX.2-VAE 为 67.33%。
揭示纯生成得分掩盖的细节丢失问题:生成基准上表现不错的可学习性方法在文字/人脸上几乎全军覆没,而 RoAR-VAE 仅凭 ImageNet 训练即超越工业级 FLUX.1-VAE 16.93 个百分点。
五行消融:❶ Vanilla-KL 平均 50.50;❷ 加噪+仅 RobustRecon 59.38(+8.88);❸ 加噪+仅 RobustAlign 62.49(+11.99);❹ RoAR 63.86(+13.36);❺ 不加噪+双损失 58.47(比❹低 5.39)。
分解贡献来源的关键表:证明两目标互补、且 latent 腐蚀是框架成立的必要条件——同样的损失若用在干净 latent 上会损失约 5.4 分,鲁棒预测的『鲁棒』二字由此坐实。