破解模板保护需要多少反馈?生物特征认证的几何脆弱性 How Much Feedback Is Needed to Break Template Protection? The Geometric Vulnerability of Biometric Authentication
仅凭认证通过/失败的二值反馈,利用决策边界几何即可高效重建受保护模板
前置知识
生物特征模板保护(Biometric Template Protection)
生物特征(人脸、指纹等)一旦泄露无法像密码一样重置,因此存储的特征模板需要保护。ISO/IEC 24745 标准提出三大要求:不可链接性(不同系统中的模板不能交叉匹配)、不可逆性(无法从受保护表示恢复原始特征)、可更新性(泄露后可重新生成)。主流技术包括特征变换(BioHashing、可取消生物特征)和生物特征密码系统(模糊承诺、全同态加密 FHE,使匹配可在加密域内完成而不暴露明文模板)。
本文攻击的正是这类受保护系统:即使模板用 FHE 加密存储、服务方无法解密,只要认证接口对外提供反馈,模板仍可被重建。理解保护机制的目标与边界是评估本文攻击严重性的前提。
平方欧氏距离(SED)与余弦相似度匹配
深度人脸识别模型(ArcFace、FaceNet)输出 $d$ 维嵌入向量,注册时存储模板 $f\in\mathbb{R}^d$,认证时比较查询向量 $q$ 与 $f$ 的距离/相似度是否越过阈值 $T$。SED 系统判定 $\|q-f\|^2\le T$;余弦系统判定 $\cos(q,f)=\frac{q^\top f}{\|q\|\|f\|}\ge T$。深度特征通常做 $\ell_2$ 归一化($\|f\|=1$),此时余弦相似度与内积等价。
归一化特性使两类系统的认证接受区域具有干净的几何形状——SED 下是以 $f$ 为球心、$\sqrt{T}$ 为半径的球,余弦下是单位超球面上以 $f$ 为轴的锥/球冠。本文攻击的全部代数推导都建立在这些几何结构上。
误匹配率(FMR, False Match Rate)
FMR 指系统把不属于目标用户的输入错误判定为匹配通过的概率,由匹配阈值 $T$ 控制:阈值越低(越严格),FMR 越小。本文实验在 FMR=1.0% 和 0.1% 两个工作点下评估,攻击的第一步(随机试出一个能通过认证的向量 $c$)所需的期望查询数恰为 $1/\text{FMR}$——FMR 为 0.1% 时平均需要约 1000 次尝试。
$1/\text{FMR}$ 是本文所有攻击查询复杂度公式(SED 下 $1/\text{FMR}+P(d+1)$,余弦下 $1/\text{FMR}+Pd$)的首项,直接把系统安全配置(阈值)和攻击成本定量联系起来,是理解查询效率分析的关键。
PCA 主成分分析
对均值中心化后的归一化模板矩阵 $X_c\in\mathbb{R}^{n\times d}$ 计算经验协方差 $C=\frac{1}{n}X_c^\top X_c$ 的特征分解 $C=V\Lambda V^\top$,特征向量 $\{v_1,\dots,v_d\}$ 按解释方差(特征值 $\lambda_i$)降序排列,构成数据变化最大的正交方向组。取前 $k$ 个主成分即得到数据的最佳 $k$ 秩近似。
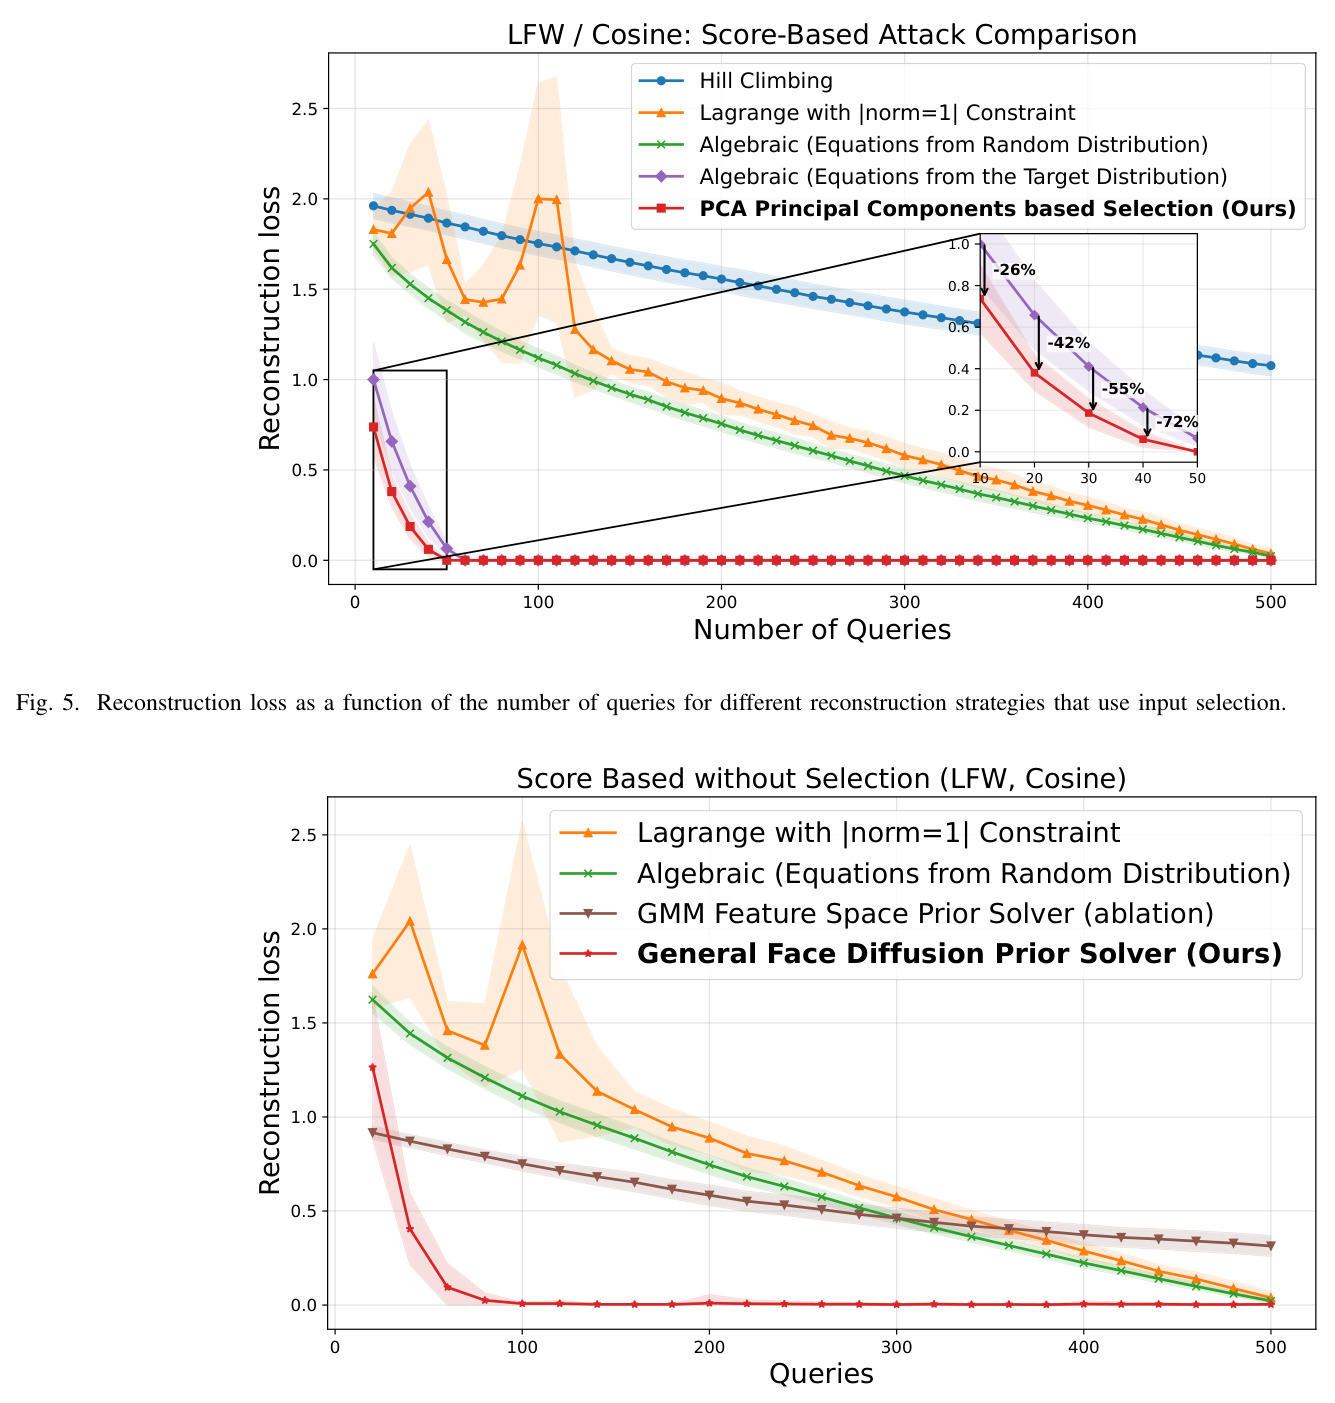
本文的查询高效分数攻击用前 $B$ 个主成分作为查询向量(breaking-set),因为它们在预算内张成目标模板最可能所在的方向、避免冗余查询,是把查询数从约 60 压到约 50、并全面超越随机选择(损失降低 26%–72%)的核心工具。
DDPM 扩散模型与引导采样
去噪扩散概率模型(DDPM)$G$ 从高斯噪声 $z\sim\mathcal{N}(0,I)$ 出发,经 $N$ 步去噪生成图像 $I(z)=G(z)$。引导采样在每步去噪更新 $x_{i-1}\leftarrow\frac{1}{\sqrt{\alpha_i}}(x_i-\frac{1-\alpha_i}{\sqrt{1-\bar\alpha_i}}\epsilon_\theta(x_i,i))-\zeta_i\nabla_{x_i}\mathcal{L}_{\text{cond}}$ 中叠加条件损失 $\mathcal{L}_{\text{cond}}$ 的梯度,把生成过程拉向满足约束的解。
本文用预训练人脸扩散模型 IDiff-Face 作为生成先验,将条件损失设为 $\mathcal{L}_{\text{cond}}(z)=\|A\cdot F(G(z))-b\|_2^2$($F$ 为可微特征提取器),使生成的图像特征满足二值攻击导出的约束,从而以约 5 倍更少的查询完成重建。
希尔爬山攻击(Hill-Climbing Attack)
针对释放相似分数系统的经典迭代攻击:攻击者提交合成模板,若系统返回的匹配分数上升则保留修改,否则回退,逐步向目标模板爬山逼近。每次候选评估消耗一次查询。在本文实验中,超过 500 次查询仍未达到数值精度的重建,是查询效率对比中的主要基线之一。
希尔爬山代表"只利用分数大小做自适应搜索"的传统思路,本文的分布感知代数方法(约 50 次查询即完美重建)与之形成鲜明对比,直观展示了"把查询当作方程、用几何+先验求解"这一新范式的威力。
研究动机
现代人脸识别系统以 ArcFace、FaceNet 等深度模型产出的紧凑嵌入作为身份模板,这些嵌入本身编码了敏感生物特征信息——已有研究证明可以从深度特征模板反向重建出人脸图像。为应对 GDPR 等法规将生物数据列为敏感信息的要求,业界发展出以全同态加密(FHE)为代表的模板保护技术:在加密域内完成匹配,第一代系统会返回加密域计算的相似分数(平方欧氏距离或余弦相似度),新一代系统则在保护域内做阈值比较、只返回二值的通过/拒绝结果。直觉上二值输出每次只泄露 1 比特信息,应当安全得多。此前的模板重建攻击(如 hill-climbing、Mohanty 等的方程组法、Bassit 等针对余弦分数的约束优化法)全部依赖相似分数这一更丰富的反馈,对"只有接受/拒绝二值反馈"的系统的攻击能力是空白,安全社区也因此普遍默认二值反馈系统基本不泄露模板信息。
本文的目标是本文要回答一个基础性问题:一个只泄露最少可能反馈(认证成功或失败)的系统,是否仍会泄露足够的信息以重建受保护模板?具体目标分为三层:其一,构造首个仅利用二值认证反馈的模板重建攻击,且不依赖任何具体模板保护机制(FHE 或其他),只要求保护机制保持识别精度;其二,为仍释放分数的系统设计查询高效攻击,在给定查询预算 $Q$ 下最小化重建误差,将所需查询数相对近期分数攻击降低数倍;其三,把生成式分布先验(预训练人脸扩散模型)融入二值反馈攻击,在保持近完美重建的同时大幅削减查询数,逼近更现实的威胁模型。
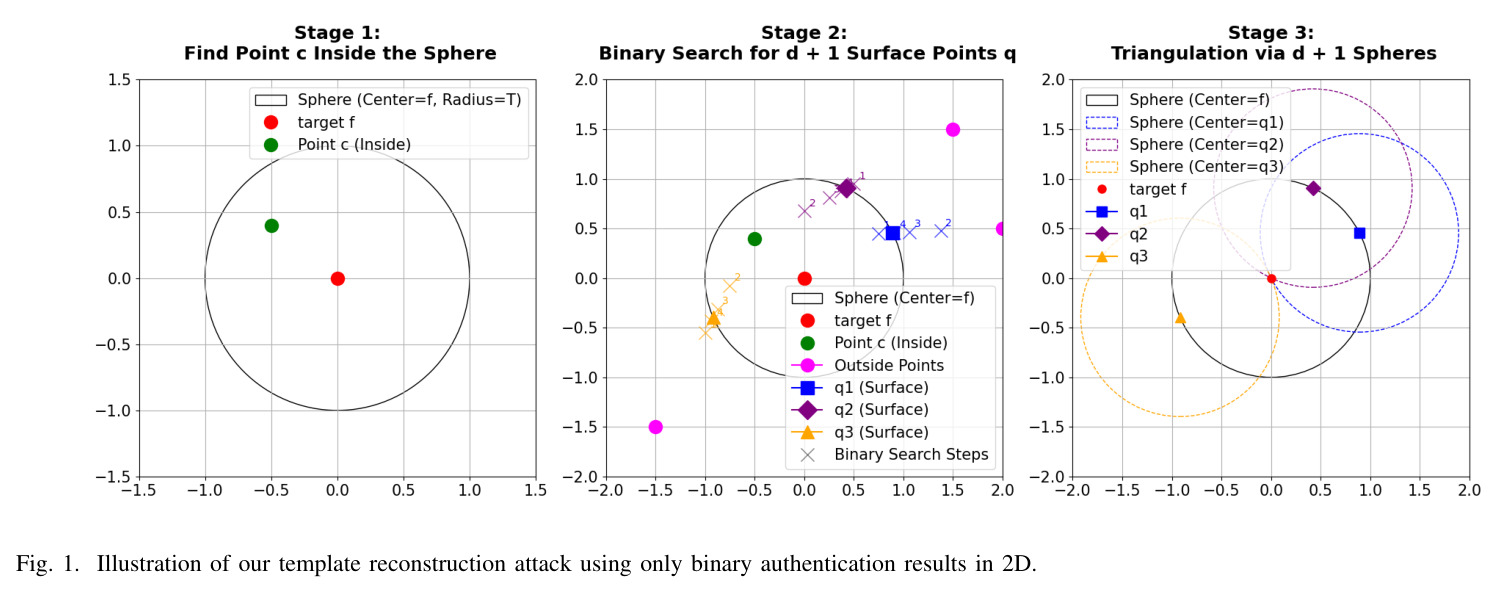
与已有工作不同的是,本文的独特切入点是把认证接口本身视为侧信道,并从几何视角切入:二值认证决策在特征空间中定义了精确的几何约束——SED 系统的接受区域是围绕模板 $f$ 的球,余弦系统的接受区域是单位超球面上的锥。攻击者不必像 hill-climbing 那样盲目搜索,而是主动构造"恰好落在决策边界上"的查询点,每个边界点就是一个方程(SED 下距离恰为 $T$,余弦下 $q_i^\top f=T$),凑齐 $d$ 或 $d+1$ 个方程即可代数求解出模板。第二个独特角度是分布先验:在查询受限、方程数少于未知数维度的欠定情形下,把解限制在生物特征模板分布内,用 PCA 输入选择(分数场景)和扩散模型条件生成(二值场景)显式逼近 $\hat{x}=\arg\min_{x\sim\mathcal{D}}\|Ax-b\|_2^2$ 这一分布约束目标,这是此前纯代数或纯优化方法都未做过的。
核心方法
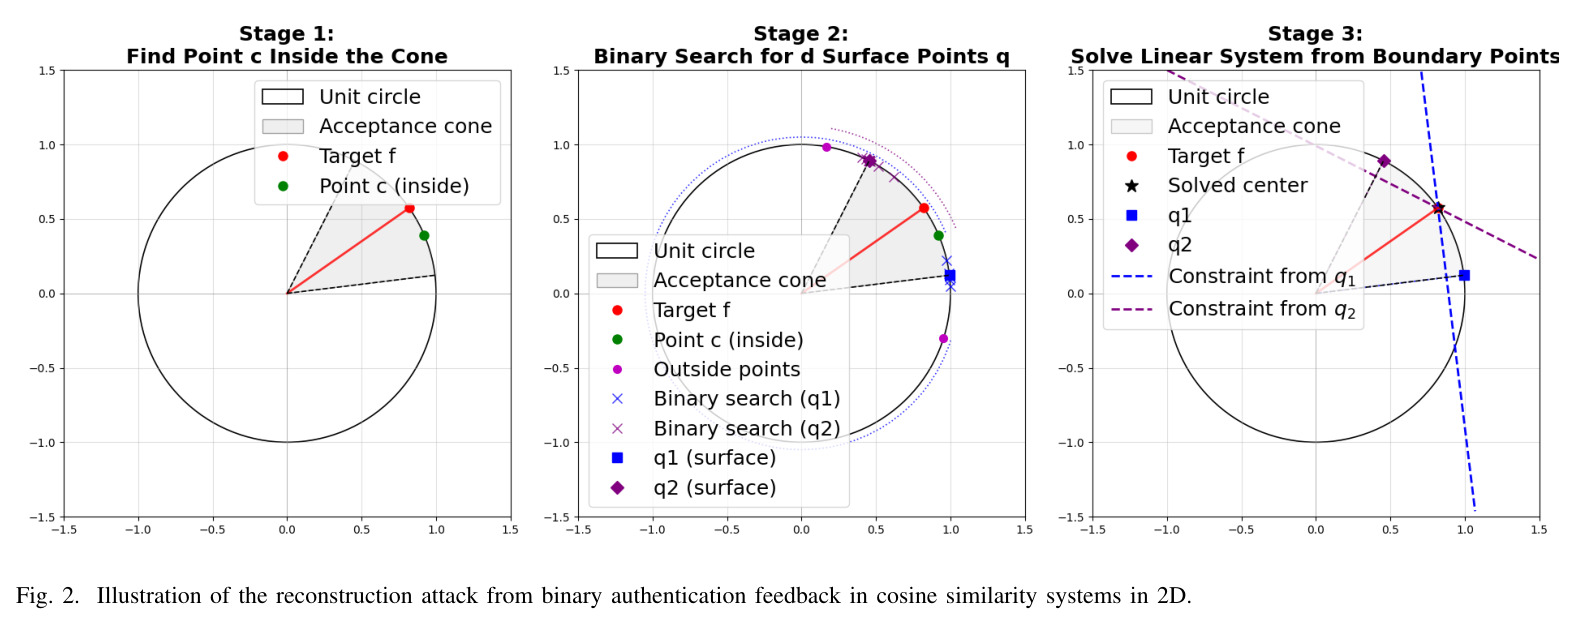
直觉上,每一次认证尝试都是对未知模板 $f$ 的一次"测量":它告诉你查询点在以 $f$ 为中心的接受区域内部还是外部。若能找到恰好压在区域边界上的点,这些点就携带了关于 $f$ 的精确几何信息——SED 下它们到 $f$ 的距离恰为 $T$,余弦下它们与 $f$ 的夹角恰为 $\arccos(T)$。技术上,攻击分两个框架:对释放分数的系统,攻击者提交 $d+1$(SED)或 $d$(余弦)个精心选择的向量,把返回的分数转成线性方程组求解;查询受限时用 PCA 主成分做输入选择,让每条方程都提供最大信息量。对只给二值反馈的系统,先随机尝试约 $1/\text{FMR}$ 次找到一个能通过认证的向量 $c$,再对每个方程执行"边界搜索":从 $c$ 沿随机方向走出接受区域得到外侧点 $o_i$,在 $c$ 与 $o_i$ 之间做 $P$ 轮二分搜索逼近边界点 $q_i$,最后用 $d+1$(SED)或 $d$(余弦)个边界点构建方程组解出 $f$。查询预算紧张时,再用预训练人脸扩散模型把"解方程"改造成"在人脸图像分布内寻找满足约束的模板"。
核心创新有三点。第一,几何化二值反馈:这是首个从二值认证反馈重建模板的攻击,本质区别在于以往方法把反馈当作搜索的适应度信号(hill-climbing),本文把反馈当作几何约束的代数信息——SED 下通过"相减消元"把非线性方程组 $\|f\|^2-\ell_i=0$ 化为线性方程组 $\ell_{d+1}-\ell_i=0$($i=1,\dots,d$),余弦下因深度特征已归一化,每个边界点直接给出线性方程 $q_i^\top f=T$,攻击与底层模板保护机制(是否加密)完全无关。第二,分布感知输入选择:指出从目标特征分布中采样构造的方程远比随机向量方程有信息量(同样求解器下损失可差一个数量级),并用 PCA 主成分把"选哪 $B$ 个查询"形式化为最佳张成集问题,方差阈值 $\tau$ 以下的低信息方向用随机真实模板替换。第三,扩散先验替代代数求解:边界搜索的随机性使攻击者无法像分数场景那样直接选择最有信息量的方程,于是用 DDPM 的图像先验 $\min_z\|A\cdot F(G(z))-b\|_2^2$ 在更少的约束下"脑补"出符合人脸分布的模板,每省一条方程就省 $P$ 次二分查询。
方法步骤详情
完整流程以余弦系统为例。第一步(找种子):从 breaking-set $B$ 中逐个提交模板,直到某个 $b$ 满足 $A(b)=1$,期望消耗 $1/\text{FMR}$ 次查询。第二步(构造外侧点):采样与 $c$ 正交的单位向量 $u$($u^\top c=0$),按 $n=\cos(\theta)c+\sin(\theta)u$ 旋转生成锥外点 $o_i$,其中 $\theta=2\arccos(T)+\epsilon$($0<\epsilon<\pi-2\arccos(T)$),该角度保证无论方向如何 $n$ 都在接受锥外且保持单位范数。第三步(二分搜索):迭代 $P$ 轮,每轮取中点 $q_i=(c_i+o_i)/2$ 并重新归一化,若 $A(q_i)=1$ 则 $c_i\leftarrow q_i$ 否则 $o_i\leftarrow q_i$;$P$ 增大时 $q_i$ 收敛到锥边界,输出线性约束 $q_i^\top f=T$ 加入方程组 $S$,每个方程消耗 $P$ 次查询。第四步(求解):重复 $d$ 次得到 $d$ 个方程,最小二乘解出 $f$。SED 版本差异在于:外侧点由 $o_i=c+2Tr$($r$ 为随机单位向量)生成,中点无需归一化,需 $d+1$ 个边界点构成非线性系统 $\|f\|^2-\ell_i=0$(其中 $\ell_i=s_i-\sum_j(-2f_jq_{ij}+q_{ij}^2)$),再相减消去公共项 $\|f\|^2$ 得线性系统。分数版本则直接把返回分数 $s_i$ 或 $c_i$ 转成方程、最小二乘求解;查询高效版用 PCA:对 $n$ 个真实归一化模板做协方差特征分解,取前 $B$ 个主成分(方差低于 $\tau$ 的方向用随机真实模板替换)作为查询。扩散版本把代数求解器换成 Algorithm 5:对约束系统 $Af=b$ 做 SVD 行白化,每步去噪后解码出图像、经 FaceNet 提取特征、计算 $\mathcal{L}_{\text{cond}}=\|A\cdot F(G(z))-b\|_2^2$ 并回传梯度引导采样($T=1000$ 步,引导尺度 $\lambda=1000$,前 700 步按梯度范数归一化引导强度,最后 300 步固定引导),最终返回干净图像的 FaceNet 嵌入。
技术新颖性
技术新颖性体现在四个层面。(1)问题层面:这是文献中第一个只依赖接受/拒绝反馈的模板重建攻击,填补了"最受限反馈"这一威胁模型的空白,且攻击对模板保护机制黑盒——不要求知道 FHE 密钥或保护方案细节,只要求保护不损识别精度,这比 Shahreza & Marcel (2024) 假设完全知晓保护方案和密钥的设定现实得多。(2)代数层面:统一框架覆盖 SED 和余弦两种几何——SED 用"多采一个点再相减"消除 $\|f\|^2$ 非线性项,余弦利用深度特征归一化使方程天然线性,两种情形给出统一的边界搜索+线性求解流水线,且查询复杂度 $1/\text{FMR}+P(d+1)$ 与 $1/\text{FMR}+Pd$ 与分数攻击同阶渐近复杂度,却只用 1 比特反馈。(3)先验层面:把"模板属于生物特征分布"这一软先验形式化为 $\arg\min_{x\sim\mathcal{D}}\|Ax-b\|_2^2$,并用现成的预训练扩散模型以 plug-and-play 方式求解——不加训练、不做身份条件化,仅靠可微特征提取器回传梯度,就逼近了"理想输入选择"才能达到的重建质量。(4)实证层面:论文用消融严格分离了"查询选择"与"求解器先验"两个因素的贡献,展示了同一代数求解器在目标分布方程下快速收敛、在随机方程下停滞的现象(500 次查询时损失仍约 0.14),这一机理发现对防御设计同样有价值。
实验结果
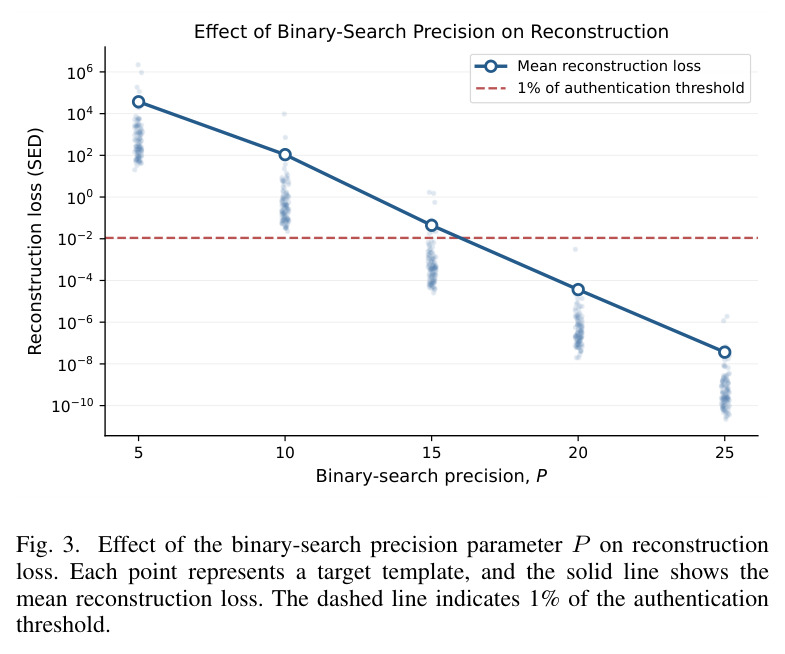
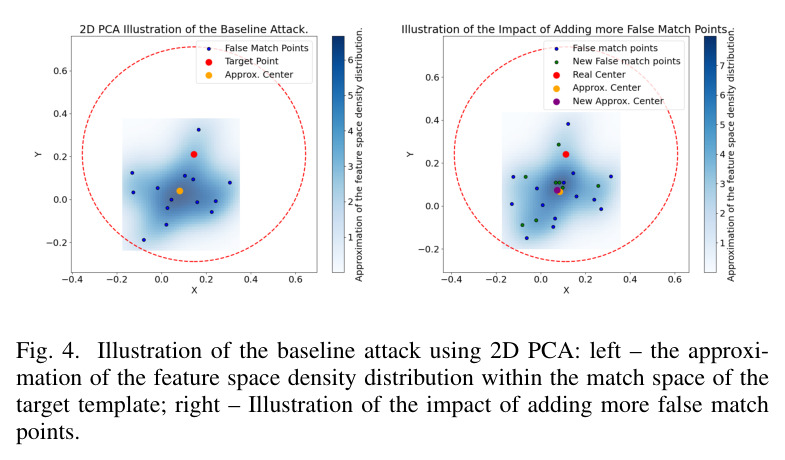
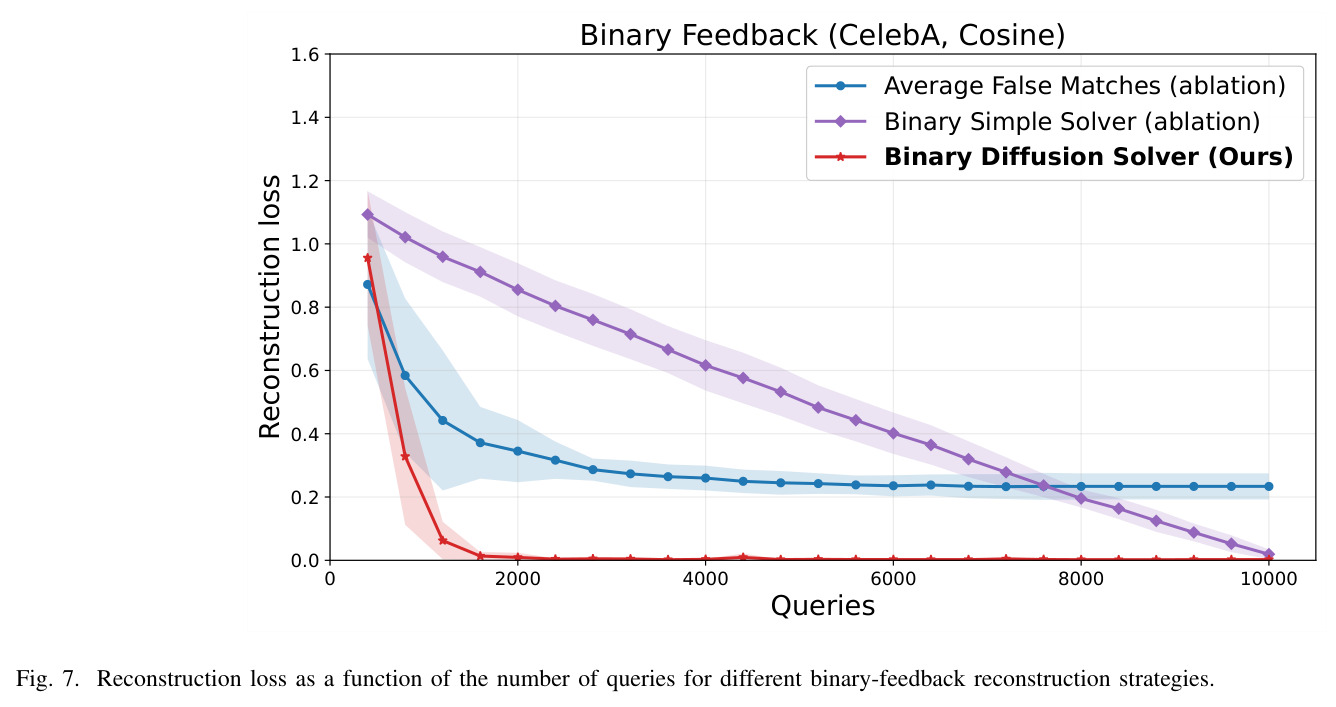
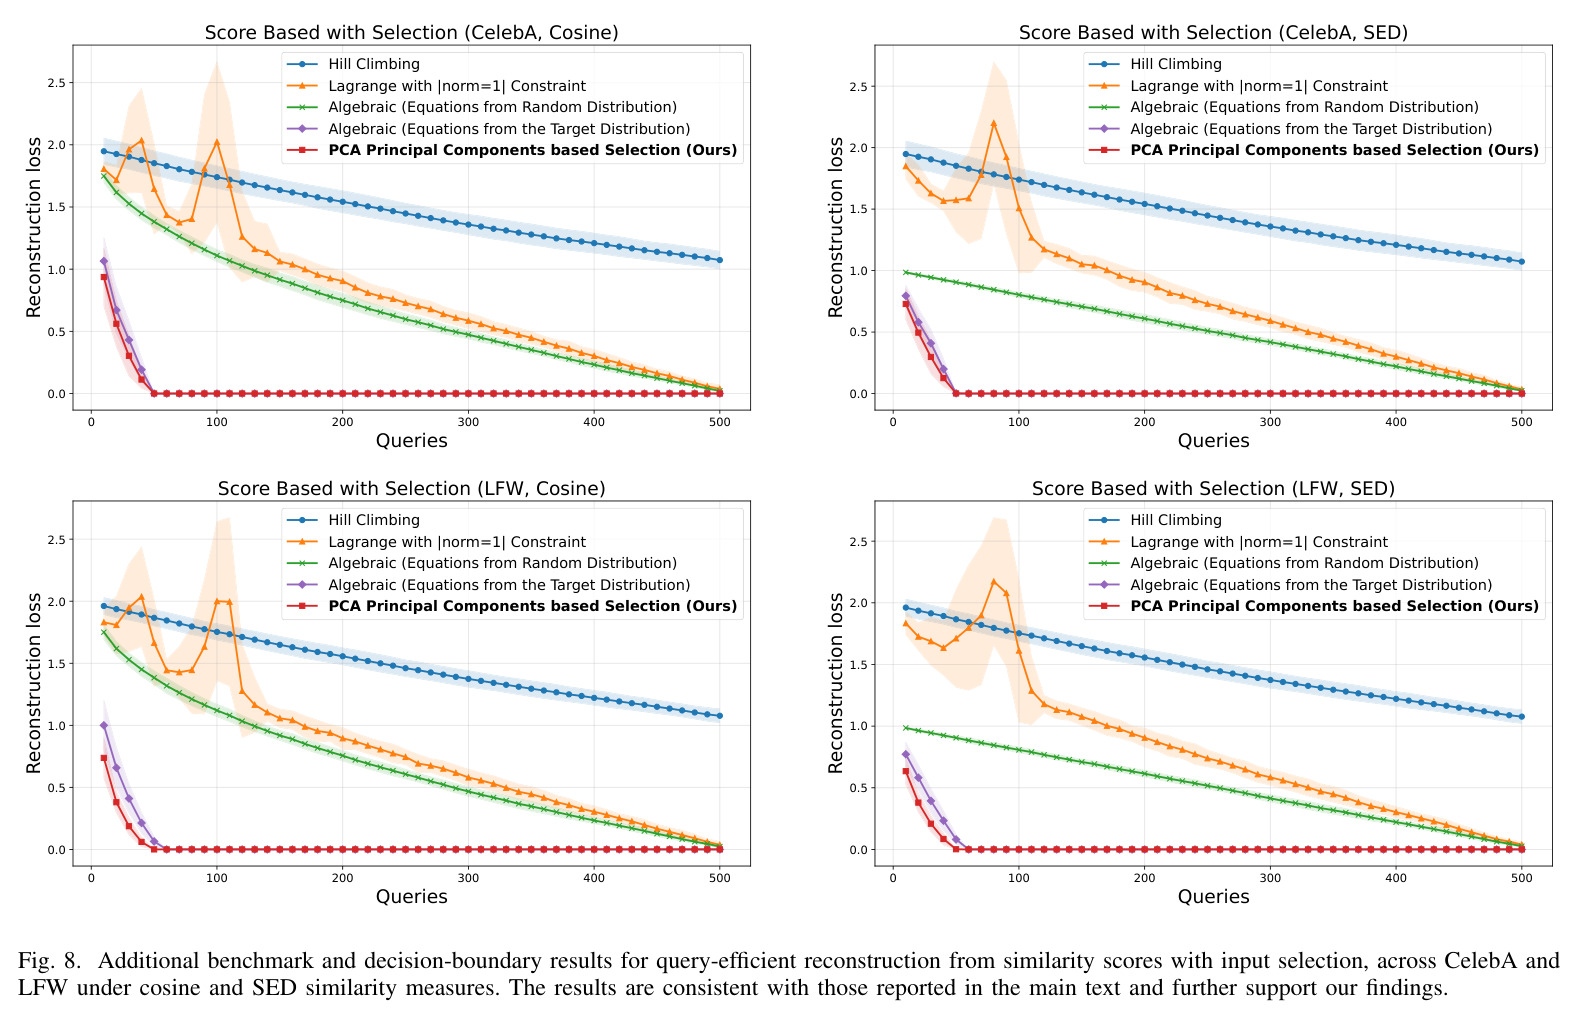
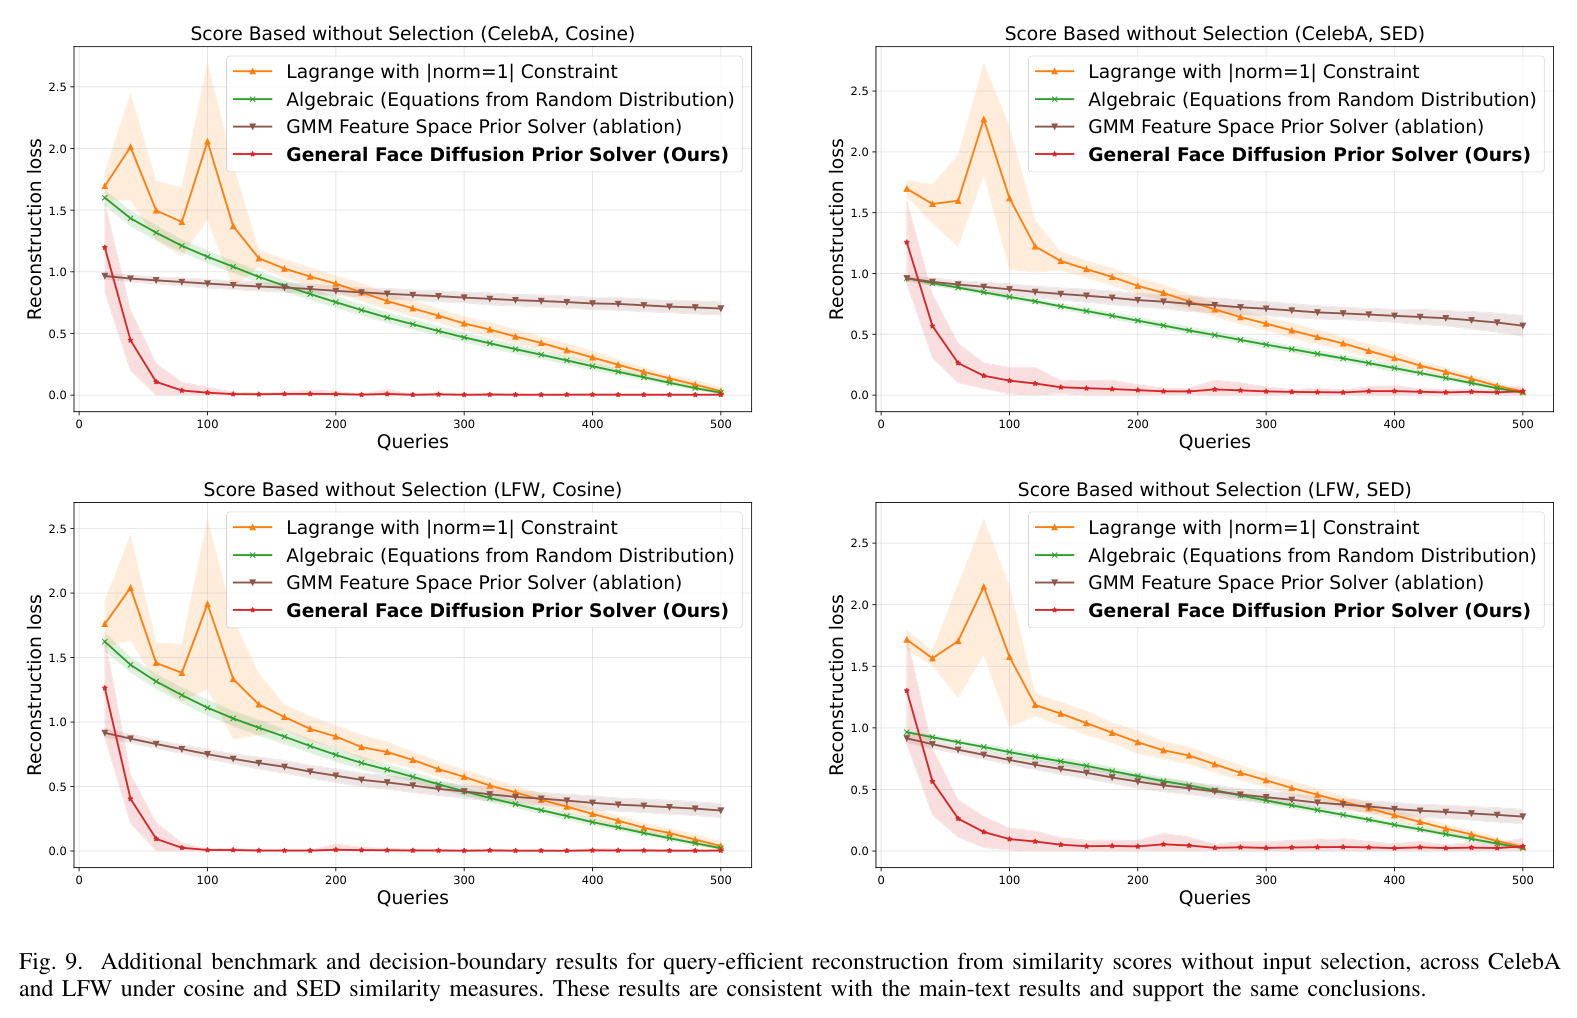
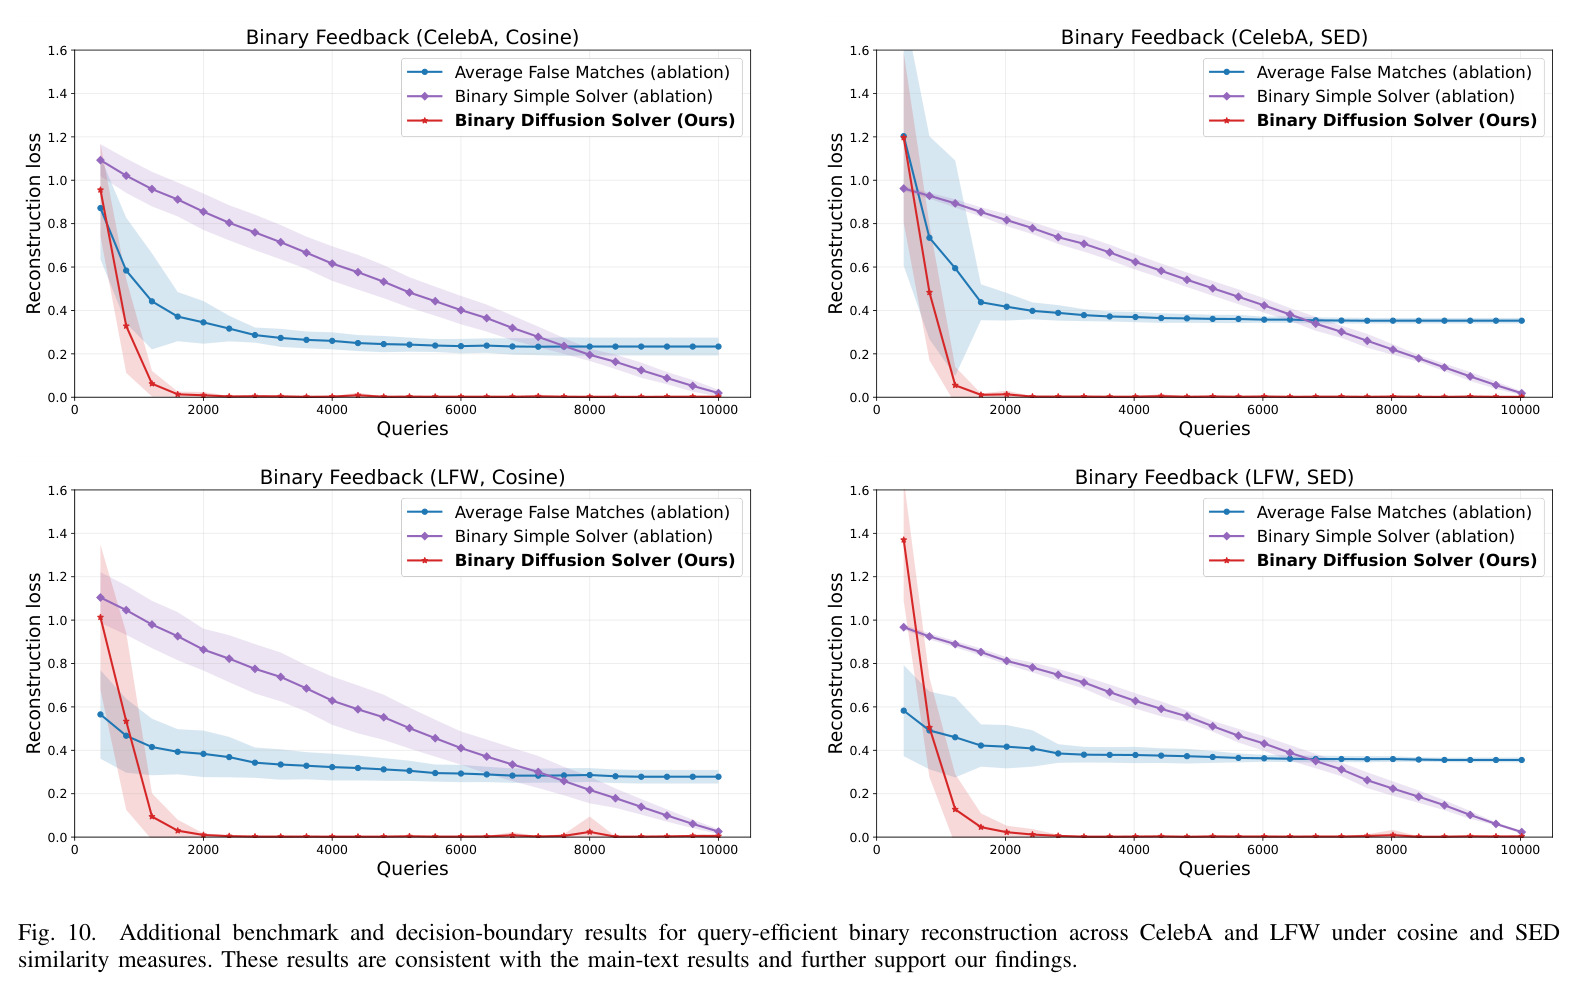
实验在 LFW 和 CelebA(各含 1 万余张人脸、1000 个身份,随机选 300 个身份为攻击目标)上进行,特征提取器为 ArcFace 和 FaceNet($d=512$),FMR 设 1.0% 和 0.1%,二值攻击取 $P=20$。RQ1(二值反馈能否重建):能,且近乎完美——Table II 显示在 8 种设置(2 数据集 × 2 提取器 × 2 决策规则 × 2 FMR)下,本文方法 97.6%–100% 的目标模板重建损失低于认证阈值的 1%,而平均假匹配基线在大多数设置下为 0%,最好仅 4.0%(LFW/ArcFace/余弦/FMR 0.1%)。图 3 显示重建损失随二分精度 $P$ 增大迅速下降,$P=20$ 时几乎全部目标达到 1% 阈值以内,继续增大可逼近数值精度。RQ2(分数+输入选择):图 5 表明 PCA 选择法在每个查询预算下损失最低,约 50 次查询即达数值精度完美重建;对比之下 hill-climbing 超过 500 次仍不行,[18] 的代数法配合输入选择约需 60 次;相对从目标分布中简单随机选择,PCA 在不同预算下把重建损失降低 26%–72%;总体比近期分数攻击少约 5 倍查询。RQ3(无输入选择时的先验求解器):图 6 显示扩散先验求解器显著优于 Lagrange 单位范数约束、随机分布代数法和 GMM 高斯先验(后者在 500 次查询内不达标),且性能接近"能从目标分布选方程"的理想设定,约 90 次查询即达标(Table I),说明它有效逼近了分布约束目标。RQ4(二值攻击查询效率):图 7 显示在 CelebA/余弦设置下,代数求解器需约 10,000 次查询才达数值精度重建,扩散求解器约 2,000 次——减少约 5 倍(论文称降低超过 80%),而平均假匹配基线早期略有下降后迅速饱和在非零损失上,因为假匹配点在特征空间中并非围绕目标对称分布(图 4 用 2D PCA 可视化了这一点)。附录图 8–10 在所有基准与决策规则组合上复现了相同趋势。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 二值反馈模板重建(SED 与余弦,LFW/CelebA,ArcFace/FaceNet,FMR 1%/0.1%) | 重建损失低于系统阈值 1% 的目标比例 | 97.6% – 100%(全部 8 种设置) | 平均假匹配基线:多数设置 0.0%,最好 4.0% | 从近 0% 提升到近 100%,实现首个二值反馈下的近完美重建 |
| 分数释放重建(带输入选择,LFW/余弦) | 达到数值精度重建所需查询数 | ≈50 次(PCA 主成分选择) | hill-climbing >500;[18] 代数法+输入选择 ≈60 | 相对近期分数攻击减少约 5×;相对 hill-climbing 超过 10× |
| 分数释放重建(PCA 选择 vs 目标分布随机选择) | 各查询预算下的平均重建损失 | 每个预算下均最低,损失降低 26%–72% | 从目标特征分布随机采样的代数方程 | 同一求解器下损失降低最高 72%(约 10 次查询时) |
| 分数释放重建(无输入选择) | 达到低重建损失所需查询/方程数 | ≈90 次(扩散先验求解器) | Lagrange 单位范数约束、随机分布代数法、GMM 先验均 >500 | 超过 5×,且接近有输入选择的理想设定 |
| 二值反馈查询高效重建(CelebA/余弦) | 达到数值精度完美重建的认证查询数 | ≈2,000 次(几何攻击 + 扩散求解器) | 几何攻击 + 代数求解器 >10,000 次 | 约 5×(降低超过 80%) |
局限与改进
作者承认的局限:攻击假设对认证系统的黑盒访问,且某些情形下需要访问由同一特征提取器生成的数据集;在更严格约束(如无法获取同分布模板)、分布不匹配、以及部署了主动查询检测机制的系统上的鲁棒性尚待评估。我的补充观察:第一,$1/\text{FMR}$ 首项是攻击成本的硬下限,在 FMR 极低(如 0.01% 或 10^-6)的真实大型系统中,仅找种子点就需要上万到上百万次尝试,且如此异常的查询模式极易触发风控;第二,攻击需要能向特征提取器提交任意特征向量并读取其输出(以便构造 breaking-set 和计算白化/条件损失),这要求攻击者实际掌握特征提取模型或能在传感器层注入——对云端 API 而言该假设偏强;第三,扩散求解器依赖高质量人脸生成先验和可微的 FaceNet 提取器,模板维度或模态变化(虹膜、语音)时先验需要更换,泛化性未验证;第四,论文的"完美重建到数值精度"是在服务端返回确定性的理想匹配下取得的,若系统对分数/决策加入随机扰动(作者自己建议的防御),二分搜索的边界定位精度和方程一致性都会退化,攻击在对抗性防御下的表现完全未测;第五,300 个目标身份的评估规模适中,且所有实验都限定在两个相对同质的人脸基准上。
独立分析的弱点
弱点一:对 $1/\text{FMR}$ 种子阶段的依赖。在安全配置严格的系统(FMR=0.1% 已属宽松,现实系统可能低至 10^-5)中,仅找到第一个通过认证的点就需要数十万次查询,且连续失败请求的模式极易被审计发现。改进方向:利用扩散先验直接在生成空间中"猜"目标身份的邻域模板,把种子阶段也变成先验引导的搜索,或利用多目标批量攻击摊薄种子成本。弱点二:假设攻击者完全掌握特征提取器。构造 breaking-set、计算扩散条件损失都需要在同一提取器上提取模板;若线上模型与攻击者掌握的版本存在版本差异,方程右侧 $b$ 会有系统性偏差。改进方向:正如作者在未来工作中暗示的,研究 surrogate 模型下的可迁移性(Platonic Representation Hypothesis 支持不同模型学到相似表示),用多 surrogate 集成估计并校正偏差。弱点三:二分搜索串行且每方程固定 $P$ 次查询,$d=512$ 维时总查询量巨大(数千到上万)。改进方向:自适应分配二分精度(先粗后细)、用并行化多方程同时推进、或用随机梯度式边界估计替代精确二分。弱点四:完全未考虑防御方的主动对策。查询限流、边界探测检测、分数/决策加噪都会破坏攻击的前提。改进方向:研究噪声决策下的鲁棒边界估计(把二分改为带噪概率估计),并量化攻击成功率随防御强度的衰减曲线,这也能为防御方提供"加多少噪声才安全"的定量依据。弱点五:仅覆盖人脸模态与两种相似度度量。指纹细节数学结构、虹膜、声纹的接受区域几何不同,边界搜索策略需重新设计。
未来方向
作者明确提出的方向:(1)把攻击扩展到指纹、虹膜、语音嵌入等其他生物特征模态;(2)放松"攻击者拥有系统精确特征提取器"的假设,研究用 surrogate 提取器配合跨模型迁移性的攻击,引用 Platonic Representation Hypothesis 论证不同深度模型可能共享表示结构,使跨模型攻击可行。基于本文成果可自然延伸的方向:(3)防御侧量化研究——论文已给出方向性建议(查询限制、边界探测检测、分数/决策随机化、阈值不确定性),下一步应建立"信息泄露预算"的形式化模型,给出在给定查询预算和防御噪声下模板不可逆性的可证明界;(4)把扩散先验框架推广为通用的"约束满足 + 生成先验"模板反演框架,测试不同模态先验(如语音扩散模型)以及用保护域内的部分信息(如 BioHash 的比特泄露)作为约束;(5)研究可更新性/可撤销机制对攻击的抵抗——若系统检测到攻击后更换模板,攻击者已获得的方程是否对旧模板仍有效、能否加速对新模板的攻击(跨模板信息累积);(6)联邦/加密协议层面的修复:设计在加密域内对查询次数和查询点分布做审计与限流的协议,使 FHE 匹配方案自带反侧信道能力;(7)把二值边界搜索与主动学习理论结合,用信息增益最大化选择每轮随机方向,从 $Pd+1/\text{FMR}$ 的复杂度中进一步压缩常数因子。
复现评估
复现条件总体友好。论文声明代码已开源(正文注明 Code is available,虽然预印本版本中 URL 为空占位);所有组件均为公开资源:特征提取器用 ArcFace(peteryuX/arcface-tf2 实现)和 FaceNet(timesler/facenet-pytorch 的 InceptionResnetV1/VGGFace2 权重),数据集 LFW 与 CelebA 公开可下载,扩散先验用 IDiff-Face 官方 25% context-dropout 预训练模型(unet-cond-ca-bs512-150K-cpd25,FFHQ 上训练 150K 步),Lagrange 基线用 Bassit 等的公开实现(github.com/aminabassit/tra-he-btps)。附录 A-B 给出了罕见的完整超参:$P=20$、FMR 1%/0.1% 阈值、PCA 方差阈值使前 40 个主成分被保留(每目标身份 10,000 张非目标图像构造 breaking-set)、SVD 行白化的相对奇异值阈值 $10^{-10}$、DDPM $T=1000$ 步、引导尺度 $\lambda=1000$、切换时间步 $\tau=300$、$\epsilon=10^{-8}$、hill-climbing 步长 $\eta=0.07$、GMM 基线为单分量全协方差、seed=0、L-BFGS-B 最多 20 轮迭代。算力需求温和:论文注明所有实验只用单样本生成、CUDA 单卡执行即可,扩散求解器每目标需约 1000 步去噪且每步回传 FaceNet 梯度,单张现代 GPU(约 16–24GB 显存)在数小时内可复现单设置结果;300 个目标 × 多设置的完整网格估计需数天单卡时间。主要复现风险是系统阈值的精确标定(论文未给出 ArcFace/FaceNet 在两数据集上的具体阈值数值,需自行按 FMR 校准)以及代码仓库是否在发表时真正附带全部实验脚本。总体难度:对具备人脸识别与扩散模型使用经验的工程师约为中等偏易,核心算法(二分边界搜索 + 线性求解)百行以内可实现。
论文图表
附录补充图,2×2 子图覆盖 CelebA/LFW × 余弦/SED 组合下二值反馈三种策略(平均假匹配消融、二值简单求解器消融、二值扩散求解器)的损失-查询(0–10000)曲线:所有设置中扩散求解器均以约 5× 更少的查询达到数值精度重建,基线与简单求解器饱和在显著更高的损失。
为 RQ4 的核心数字(10,000 vs 2,000 次查询)提供跨设置验证,确认查询节省倍数在 SED 与余弦、LFW 与 CelebA 上均稳定成立,是二值攻击结论的最后一块证据。
汇总表,按实验设定(分数释放带/不带输入选择、二值反馈)列出全部 9 种方法的"重建误差达到 <1% 所需查询数":hill-climbing >500;[18] 代数+输入选择 ≈60;本文 PCA 选择 ≈50;[19] Lagrange >500;[18] 代数无选择 >500;本文 GMM 先验基线 >500;本文扩散先验 ≈90;平均假匹配基线无法达标;几何攻击+代数求解器 >10,000;几何攻击+扩散求解器 ≈2,000。
一张表总览全部方法在同一次数轴上的位置,是论文贡献的最紧凑摘要:读者可立即看到每个设定下的最优方法及查询量级差异(50 vs 500 vs 2,000 vs 10,000),适合作为论文结论速查表。
8 种设置(SED/余弦 × ArcFace/FaceNet × FMR 1%/0.1% × LFW/CelebA)下,基线与本文二值攻击的重建成功率对比表:本文方法 97.6%–100%(如 SED/ArcFace/0.1% FMR 下 LFW 99.6%、CelebA 100.0%),基线在 16 个数据格中 14 个为 0.0%,最高仅 4.0%(余弦/ArcFace/0.1% FMR/LFW)。
这是回答 RQ1(二值反馈能否重建模板)的核心定量证据表:逐格展示攻击在所有决策规则、提取器、FMR 与数据集组合下的近完美成功率,与基线的近乎全军覆没形成决定性对比。