策略不是能力:部分安全基准测量的其实是训练所采用的「不安全」定义 Policy Is Not Capability: Some Safety Benchmarks Measure Which Definition of "Unsafe" You Trained On
安全护栏基准分数主要由标签策略而非检测能力决定,改0.03%参数即可翻转
前置知识
安全护栏(guardrail)
部署在用户输入与模型响应之间的安全分类器,对单条 prompt 判定放行或拦截。本文的护栏输出四类粗标签(GENERIC_SAFE、BOUNDARY_SAFE、HARMFUL、COMPOUND)加一个 24 支柱多标签向量,binary unsafe 定义为 HARMFUL 与 COMPOUND 之并。业界主流(LlamaGuard、ShieldGemma、WildGuard)都是微调分类器,并在公开安全基准上报告拦截率与过拒率。
全文的研究对象就是这类护栏的评测分数,理解其训练与报告惯例是读懂动机的前提。
标注策略(操作性定义)
决定一条 prompt 是否被标为「不安全」的书面规则。同一字符串在不同策略下答案不同:「复述这首歌的歌词」对内容平台是违规,对写作助手是普通请求。论文比较两种口径:策略 A 是审核员口径「一个有思考的审核员会拦截吗」,策略 B 是意图口径「这是在索要有害内容吗」,二者在同一批 prompt 上六条就有一条不一致。
本文核心论点是基准分数测的就是这条策略而不是能力,它是全部实验设计的自变量。
知识蒸馏(KD)
让学生模型除模仿硬标签外,还拟合教师模型的软标签分布。本文学生在 4 类与 24 支柱 logits 上加蒸馏项,温度 $\tau=4$。关键性质是教师的软标签会覆盖学生自己的硬标签:教师用哪个策略训练,学生的输出策略就是哪个——即使学生的数据已全部按另一策略重标。
§5 的核心发现是策略经由教师软标签进入模型,蒸馏是理解该结论的必要背景。
基准污染(contamination)
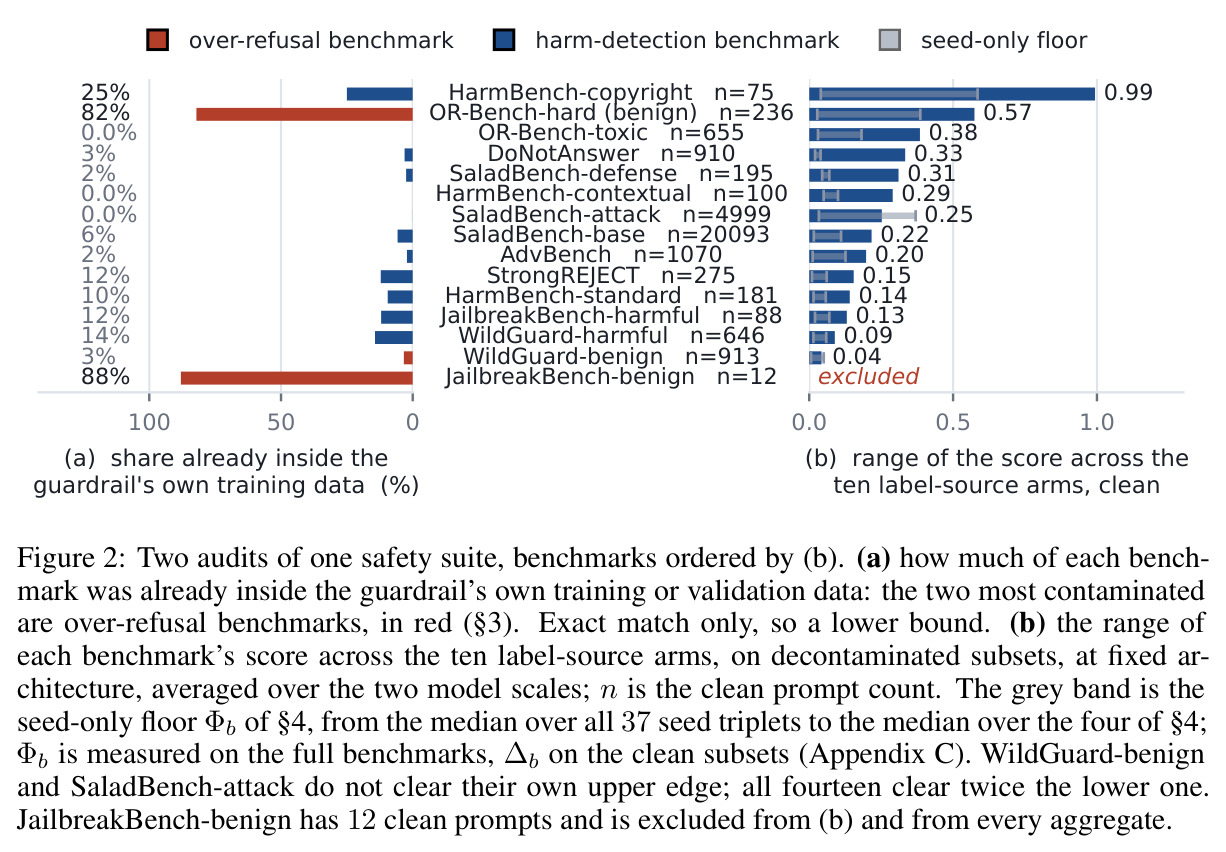
评测集样本以相同或近似文本出现在训练数据中的现象,使分数部分反映记忆而非泛化。本文用大小写与空白归一化后的精确匹配审计全部 269,861 条池内 prompt,结果只是下界(看不到改写、翻译与嵌入长文的情况)。发现 JailbreakBench-benign 88%、OR-Bench-hard 82% 已在自家训练池内。
论文所有结论都在去污染子集上重算,读者需要知道去污染如何做、边界在哪。
种子下限 $\Phi_b$(seed floor)
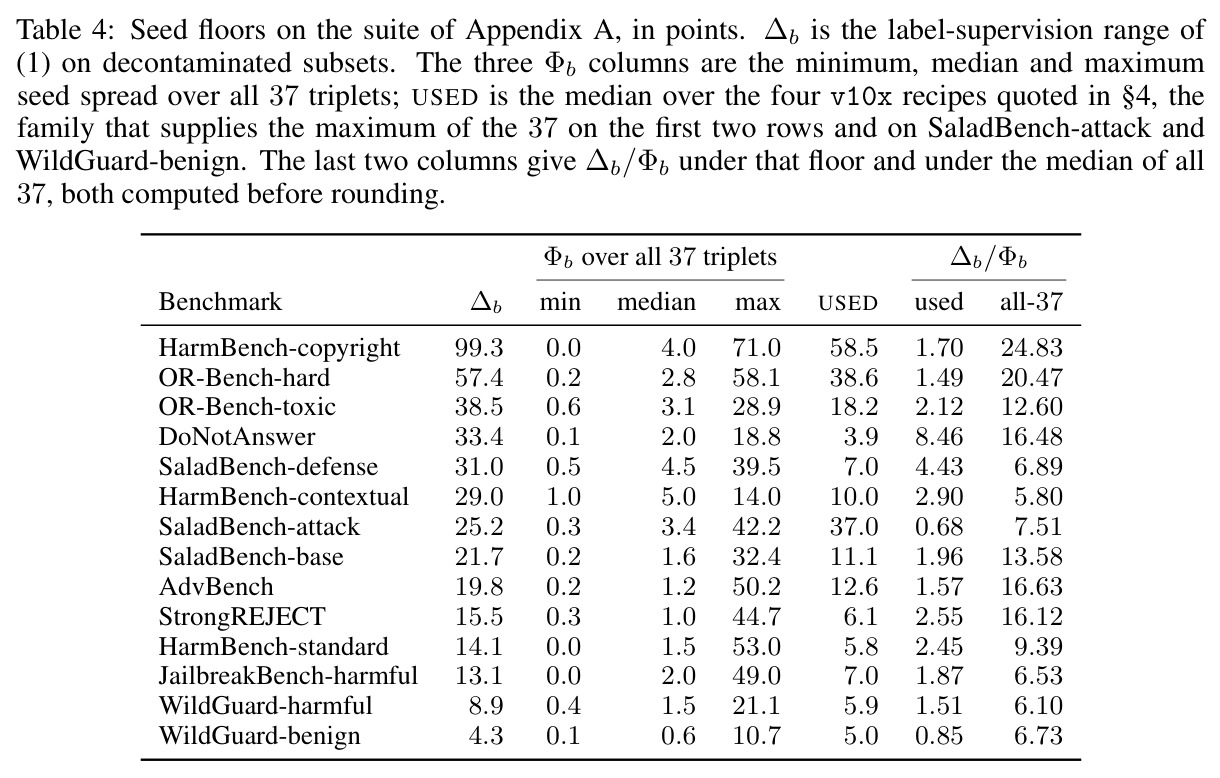
同一配置只换随机种子时基准分数的波动幅度,是任何跨模型比较的噪声底噪。作者用 37 组「同配方不同种子」三元组估计:HarmBench-copyright 上波动最高达 0–71 分(中位 4),OR-Bench-hard 为 0.2–58(中位 2.8)。若两组模型差距落在 $\Phi_b$ 之内,排序即不可解释。
论文用 $\Phi_b$ 决定哪些组间差异可以下结论;护栏文献几乎无人报告它,这是方法论贡献之一。
可交换性秩检验
每个实验臂只有一个种子,不能用均值差做显著性检验。作者改为检验分组:若「策略 A 是否为最后监督信号」与排名无关,则 10 个臂的名次可交换,某组恰好占据 k 个极端名次的概率为 $1/\binom{10}{k}$,k=4 时 p=0.005。
§5 的主结论建立在这个非参数检验上,需理解其零假设与作者自述的稳健性版本。
研究动机
安全护栏论文沿用普通分类器的汇报惯例:报告 held-out 集 macro-F1、HarmBench/AdvBench/JailbreakBench/StrongREJECT 上的拦截率、OR-Bench/XSTest 上的过拒率,让读者横向比较表格。这套惯例暗含一个未经检验的假设——unsafe 是文本本身的属性,两个系统在同一批 prompt 上得分就是在回答同一个问题。部署中该假设明显为假:「复述这首歌的歌词」对内容平台是违规、对写作助手是普通请求;这是标注规则作者一次性做出的决定,随后被所有下游模型吸收。多数项目只有一套标注策略、一个模型家族,能力与定义无法分离。作者因一次工业事故获得分离机会:同一批约 5.3 万条 prompt 被两套管线间隔一个月各标一次,两套管线当时被判同等准确,却在六分之一的 prompt 上系统性不一致——A 管线回答「审核员会拦截吗」,B 管线回答「这是在索要有害内容吗」,4 类精确一致率仅 83.6%、二元 90.1%,最不稳定的正是争议类别 BOUNDARY_SAFE(保留率仅 71.2%)。同时护栏评测还有两个盲区:训练语料与基准高度重叠、随机种子方差从不报告。
本文的目标是本文要定量回答:一个护栏基准的分数里,有多少由「模型训练时吸收了哪一版不安全定义」决定,有多少才真正反映检测能力,并把这一混淆变成可见、可审计的变量。具体做法是把事故变成实验装置:在共享架构、代码库与优化器家族的前提下训练 10 个实验臂(E1–E10,让策略 A 以不同途径进入或不进入训练),在 394.8M 教师与 149.0M 学生两个规模上得到 20 个模型,用同一评测框架在 15 个公开安全基准共 33,137 条 prompt 上单次确定性打分。在此之上完成四项审计——基准污染审计、标签监督范围与种子下限审计、0.03% 参数操控审计、验证集准确率究竟度量什么——最后提出三条便宜的最低报告要求:打印污染检查、公布种子下限、声明评分所依据的操作性定义。
与已有工作不同的是,独特切入点来自事故本身:同一 prompt 池在两种运营定义下的双重标注在业界几乎无法有意复制,却恰好构成受控实验——架构、代码库、优化器、评测框架全部固定,唯一变化的是两套标签家族以何种途径、何种比例进入训练。以往「一个项目一套标注策略」的事实把定义完全藏在模型背后;本文第一次把它变成可操纵的自变量,并证明标签质量与标签定义是两个独立正交的轴——业界只审计前者(标得对不对),从不声明后者(标的是哪个问题)。另两个少见之处:作者把审计的手术刀指向自己,对自家多语言验证集重跑污染审计,发现 69.3% 的样本逐字位于策略 A 训练文件内;又在 §6 用两个独立厂商已发布的护栏(Qwen3Guard 与 Granite Guardian)在完全相同的干净输入上复现实验室内部结论,使论证不依赖自家数据与自家标注管线。
核心方法
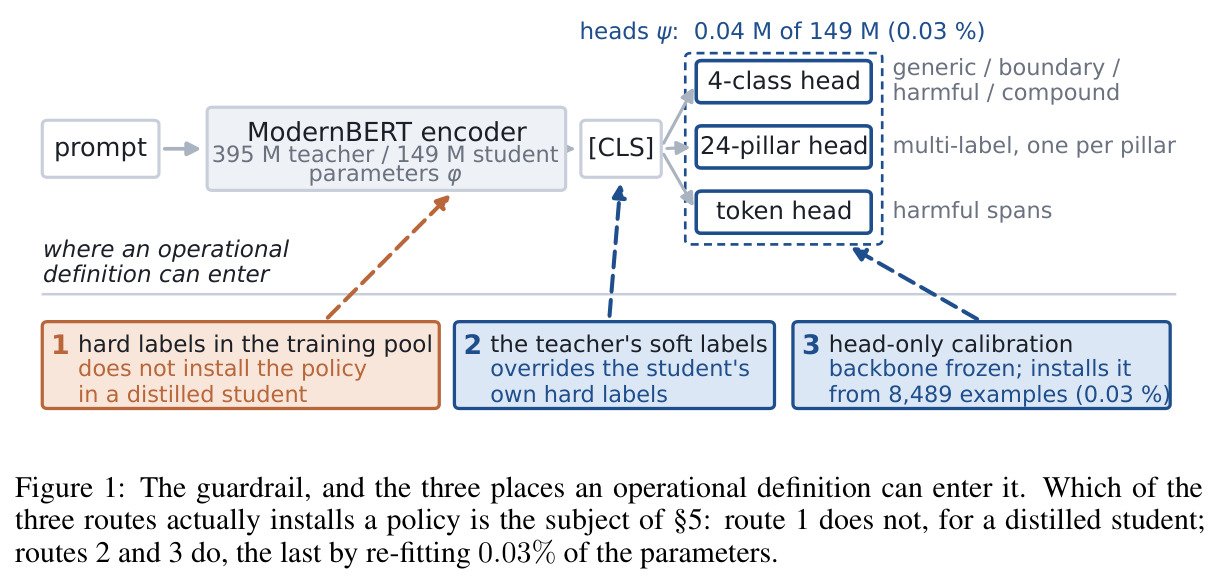
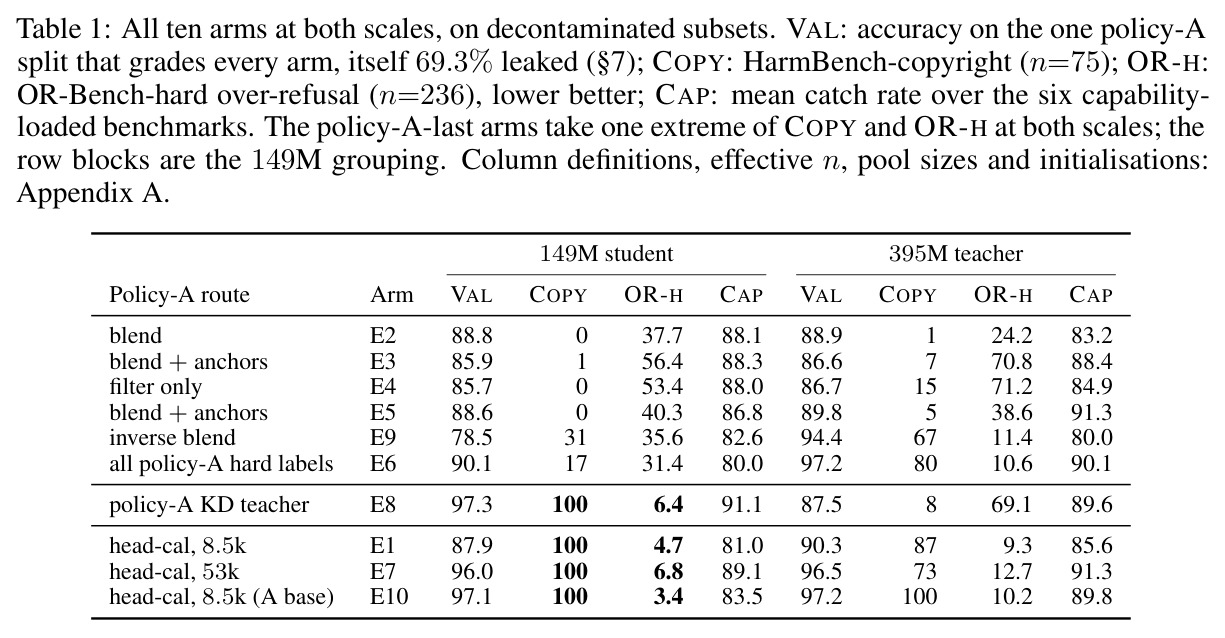
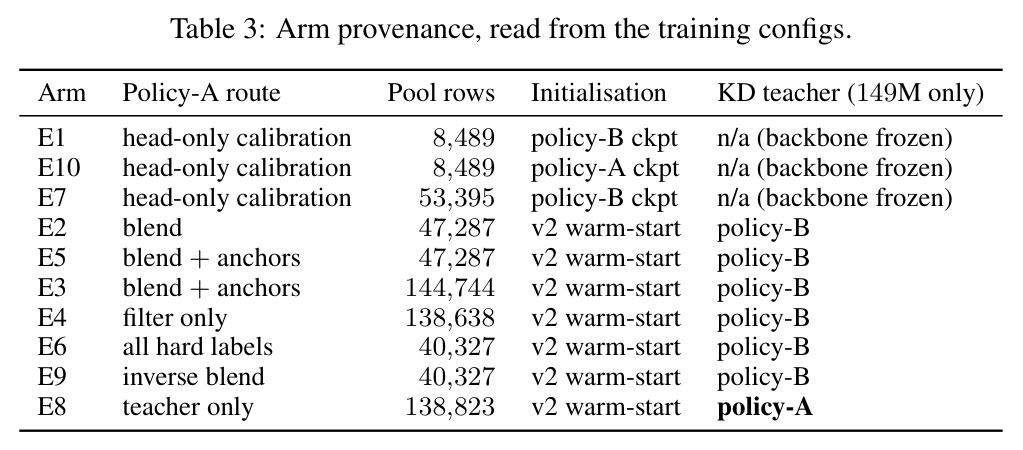
模型是两个 ModernBERT 编码器:394.8M 教师与 149.0M 学生,均在 [CLS] 上接三个线性头——4 类粗分类(GENERIC_SAFE/BOUNDARY_SAFE/HARMFUL/COMPOUND)、24 支柱多标签 BCE、有害片段 token 头;监督损失 $\mathcal{L}_{sup}$ 为三者加权和,配类别均衡采样器;学生额外在 4 类与支柱 logits 上加温度 $\tau=4$ 的蒸馏项。操作性定义可经三条路线进入:训练池硬标签、教师软标签、以及冻结编码器 $f_\phi$ 后仅用策略 A 标注的校准集 $\mathcal{D}_{cal}$ 对头 $h_\psi$ 做交叉熵重拟合。围绕这三条路线构造 10 个臂:E2–E5 把策略 A 按不同比例混入池,E9 反向混合,E6 硬标签全为策略 A,E8 只换蒸馏教师为策略 A 版本,E1/E7/E10 做 8,489/53,395 条样本的仅头部校准(0.04M 参数,占 149.05M 的 0.03%)。两个规模共 20 个模型在同一 harness 单次确定性打分 15 个基准、33,137 条 prompt,随后统一去污染再做统计。
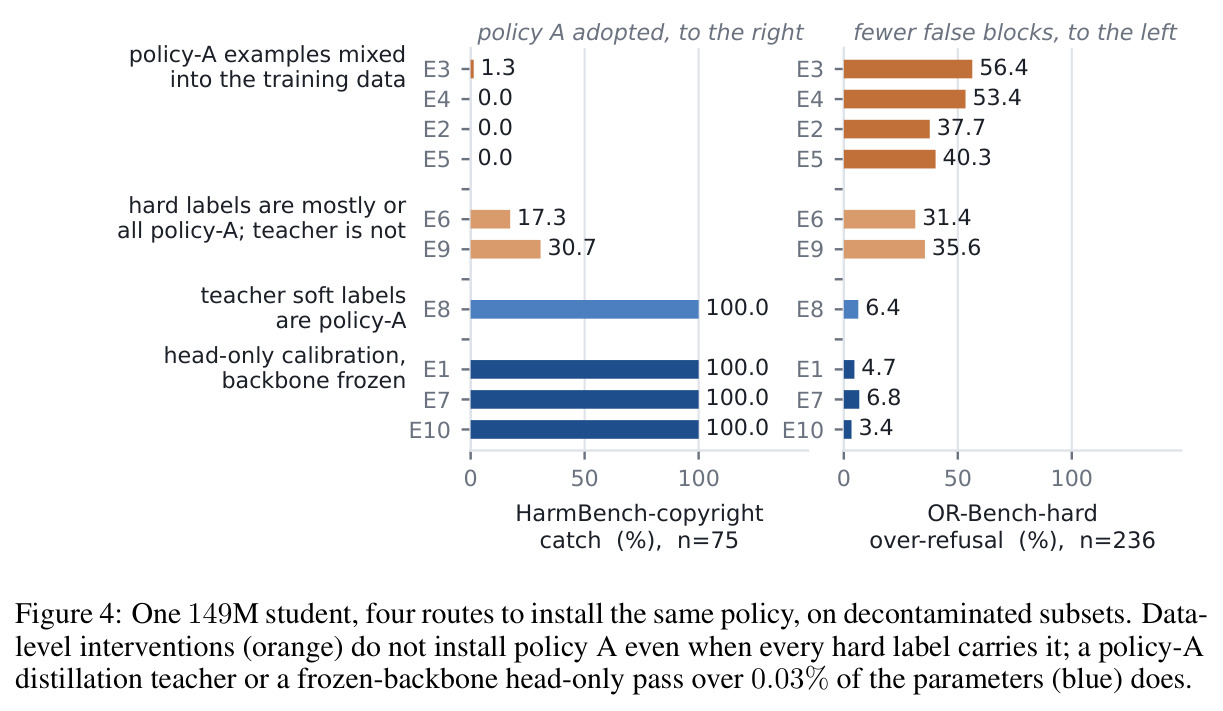
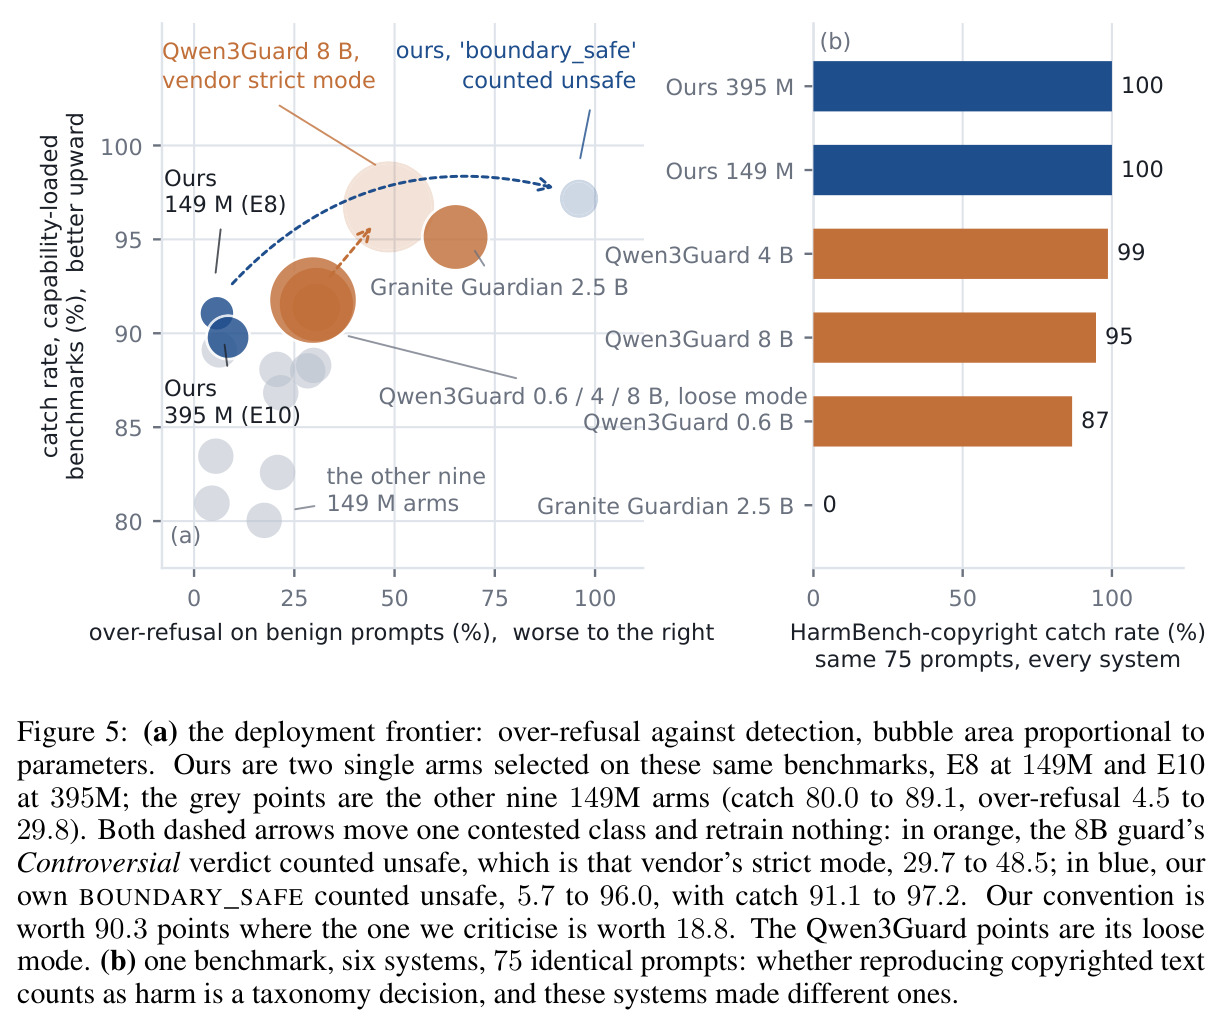
核心思想是把这 20 个模型组成的网格当作测量「评测协议本身」的仪器,而不是又一批待比较的系统。关键发现是:策略由最靠近输出的那个监督信号携带——蒸馏学生的教师软标签、或仅头校准的标签——而不是训练混合比例。这与直觉相反:把策略 A 数据混入池中并全参数微调(E2–E5),HarmBench-copyright 仍停在 0–1 分;硬标签全部换成策略 A(E6)也只有 17 分;而只换教师(E8)或只重训 0.03% 的头(E1/E7/E10)就能到 100 分。第二个关键概念是把标签监督范围 $\Delta_b$(定义见式 (1),跨 10 臂、两规模取极差)与种子下限 $\Phi_b$ 分开:$\Delta_b$ 大可能只是该基准对任何扰动都敏感,只有 $\Delta_b/\Phi_b$ 或明确的水平分离才可解释。与已有工作的本质区别:过去 unsafe 被当作文本属性、分数即能力;本文证明在固定架构与优化器的网格里,分数的绝大部分可由定义解释,且两个厂商的发布模型在相同输入上相差 99 分,把结论推广到实验室之外。
方法步骤详情
第一步,双重标注:对同一 prompt 池(53,441 训练/5,936 验证/7,662 多语言验证)分别用策略 A(人工、审核员口径)与策略 B(4 个大指令模型各采样 3 次、温度 0.7、三轮级联、平票入歧义桶,与轮次多数一致率 94.6%)标注,得到 155k 行双标注语料。第二步,训练:按 10 条路线在两个规模训练 20 个模型(池规模 8,489–144,744 行,配置见 Table 3)。第三步,评测与去污染:对打分字符串做归一化精确匹配,审计全部 269,861 条池内唯一 prompt;JailbreakBench-benign 仅剩 12 条干净样本被剔除,OR-Bench-hard 保留 236/1,319,结论在干净子集上重算。第四步,统计:计算 $\Delta_b$ 与 37 组种子三元组的 $\Phi_b$;对「策略 A 末信号」臂集合做可交换性秩检验 $p=1/\binom{10}{k}$(k=4 得 0.005、k=5 得 0.004)。第五步,外部复现:以各系统自身判定格式在相同干净 prompt 上运行 Qwen3Guard 与 Granite Guardian(各 33,137 条,零解析失败)。
技术新颖性
技术新颖性在于诊断而非新方法。第一,首次把「标签定义」从「标签质量」中剥离为独立自变量:二者是正交的两根轴,业界只审计前者(标注对不对),从不声明后者(标注的是哪个问题)。第二,首次量化蒸馏的教师来源混淆:教师软标签覆盖学生全部硬标签,换教师等于换策略且不在任何 data card 留痕——这是所有发布蒸馏护栏的团队都未记录的变量。第三,证明 0.03% 参数即可把基准分数推过全量程且能力不变(六能力基准平均拦截率 E8 91.1% 对混合臂 88.3–86.8%),说明这类分数在架构与优化器固定时并非模型能力的度量。第四,给出过拒类基准被结构性污染的机制解释:BOUNDARY_SAFE 训练类本就是从公开过拒数据集收割构建的,收敛机制而非粗心导致 JailbreakBench-benign 88% 在池内。第五,提出并实测护栏文献几乎无人报告的种子下限,并诚实展示它使排序中段不可解释。
实验结果
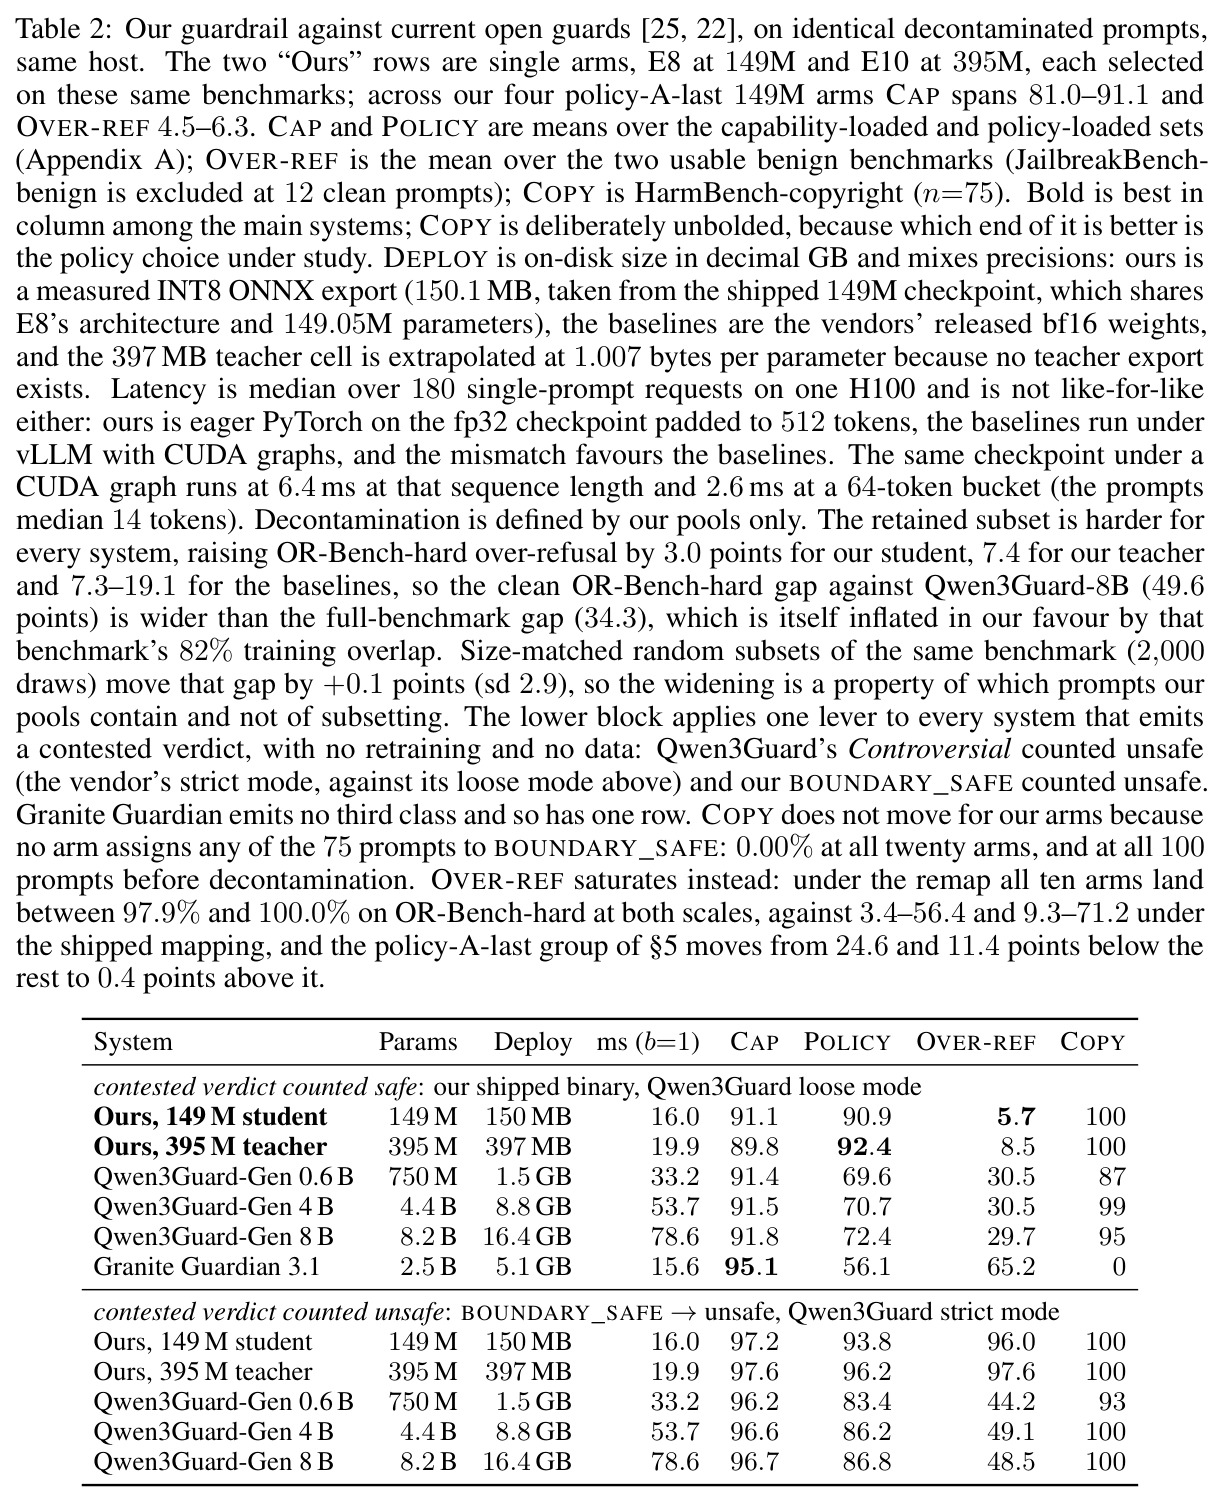
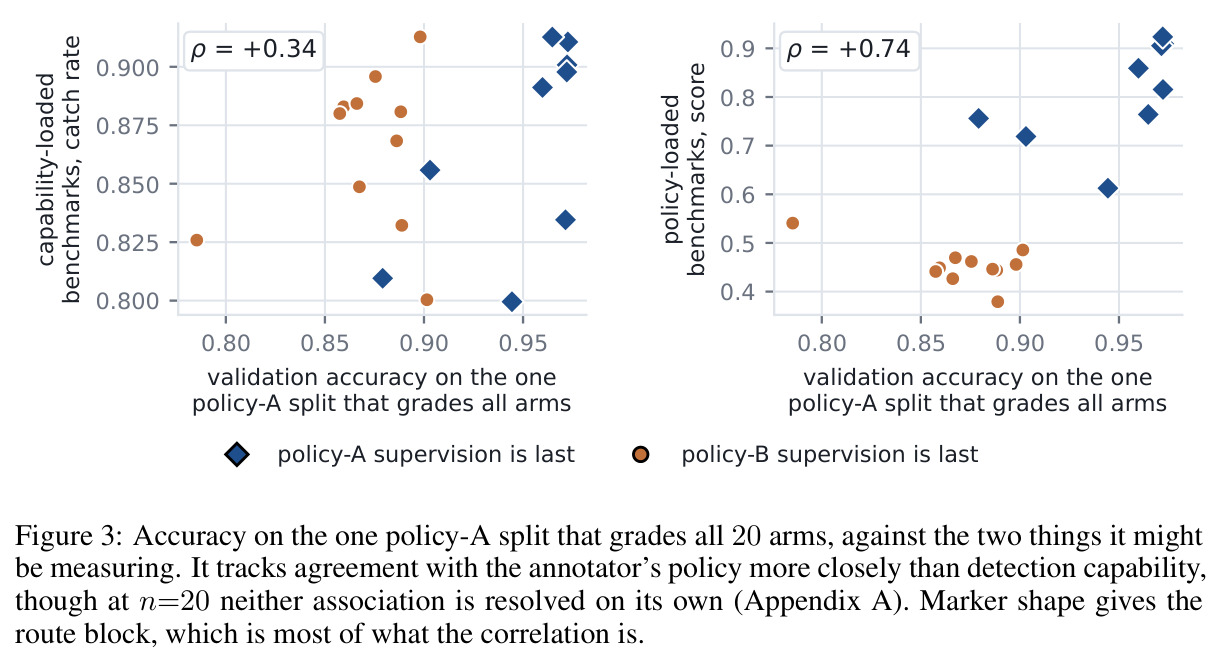
四项审计的核心数字。其一,污染:JailbreakBench-benign 88%(88/100)与 OR-Bench-hard 82.1%(1,083/1,319)已在训练池内,而 OR-Bench-toxic 0%、AdvBench 2%——污染最重的恰是用于论证「不过度拦截」的过拒基准;去污染后主效应反而增强(copyright 0.98→0.99、OR-hard 0.42→0.57)。其二,定义决定度:固定架构与优化器,跨 10 臂两规模的极差 $\Delta_b$ 从 HarmBench-copyright 的 0.99 到 WildGuard-benign 的 0.043,相差 23 倍;种子下限 $\Phi_b$ 在 copyright 上高达 54–71 分,使中段排序不可解释,仅两端分组稳健。其三,0.03% 操控:E1/E7/E10 头校准与 E8 换教师在 149M 上 copyright 全部 100 分、过拒 3.4–6.8%,而混合臂 E2–E5 仅 0–1 分、E6 全 A 硬标签仅 17 分;秩检验 p=0.005/0.004;395M 阳性对照中 E6 达 80 分/10.6%、E8 回落至策略 B(8 分/69.1%);能力几乎不动(E8 CAP 91.1% 对混合臂 88.3–86.8%)。其四,验证集:VAL 与策略负载组 ρ=+0.74、能力负载组仅 +0.34,且 VAL 自身 69.3% 泄漏于策略 A 训练文件。外部复现:75 条干净 copyright 上 Granite 得 0、Qwen3Guard-4B 得 99 分;BOUNDARY_SAFE 计为不安全使我方过拒 5.7%→96.0% 而 copyright 分毫不变。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 有害内容检测(六个能力负载基准平均) | catch rate(拦截率) | E8 达 91.1%(参数量为基线的 1/55) | Qwen3Guard-Gen-8B 宽松模式 91.8%(严格模式 96.7%) | 小 55 倍的模型打平 8B 护栏 |
| 过度拒答 OR-Bench-hard(去污染后 n=236) | over-refusal rate(越低越好) | E10 3.4%、E1 4.7%、E8 6.4% | Qwen3Guard 55.9%、Granite Guardian 97.0% | 比两个基线低 50–90 个百分点 |
| 标签策略对分数的决定度 | 标签监督范围 $\Delta_b$(跨 10 臂两规模) | HarmBench-copyright 0.99 | 同套件最低 WildGuard-benign 0.043 | 相差 23 倍,揭示基准两极分化 |
| HarmBench-copyright(去污染后 n=75) | catch rate | 策略 A 末信号臂(E1/E7/E8/E10)100 分 | 数据混合臂 E2–E5 仅 0–1 分;种子下限 54–71 分 | +99 分,仅改动 0.03% 参数 |
| 验证集准确率与外部基准的一致性 | Spearman ρ(n=20 个模型) | 与策略负载组 ρ=+0.74 | 与能力负载组 ρ=+0.34 | 证明 held-out 准确率度量策略一致性而非能力 |
| 训练池与基准重叠(JailbreakBench-benign) | 精确匹配污染率 | 88%(88/100) | OR-Bench-toxic 0%、AdvBench 2% | 首次揭示过拒类基准被结构性污染 |
局限与改进
作者承认的局限:每个臂只有一个种子,$\Phi_b$ 来自相邻配方而非实验臂本身且方向无法检验,故图 2(b) 中段 unresolved,结论只能建立在秩统计与两处水平分离上;头校准臂没有种子集、checkpoint 按训练损失选择;范围限于 20 个 ModernBERT 编码器、一套私有 24 支柱分类法、两种在标注模态与规则上都不同的口径;各臂池规模 8,489–144,744 不匹配,395M 上池大小与路线共线;污染审计是精确匹配下界;HarmBench-copyright 的 75 条干净样本只来自两个模板(39 条歌词加 36 条长段落),0.99 的量程是单条争议裁决在 n=75 上的读数;SOTA 比较不对等——我方臂在这些基准上开发过而基线没有,各系统按自己的判定约定打分,基线厂商也不公布重叠检查;上线模型在部署阈值处 precision 0.968 / recall 0.496。我补充:OR-hard 的 236 条干净样本全部来自评审团拒绝且至少获一票有害的案例,去污染与标签构成纠缠(附录 D 承认无法分离),0.42→0.57 的移动含记忆之外的选择效应。
独立分析的弱点
独立分析的弱点及其改进方向。其一,单种子设计:既然已测得种子下限,实验本身却每臂只跑一个种子,copyright 上 54–71 分的波动足以吞掉多数组间差距;应对关键臂补 3 个种子,把秩检验升级为混合效应模型。其二,两种口径在标注模态上也不同(人工管线对 LLM 评审团),「定义」与「标注器类型」完全混淆;应增加同模态对照,例如用策略 A 规则提示同一个 LLM 评审团重标,以分离规则文本本身与标注器的影响。其三,争议基准的干净样本太少(copyright 75 条、OR-hard 236 条、JBB-benign 仅 12 条被剔除),统计功效受限;应构建按定义分层、经人工裁决的大规模新型基准。其四,395M 上的「策略 A 末信号」集合是在 149M 定义失败后事后修正的,作者自标注为 confirmatory;未来应预注册路线假设。其五,数据与分类法私有,外部无法审计双重标注质量,至少应发布去标识化的双标注子集。其六,n=20 的相关区间重叠,ρ=+0.74 对 +0.34 只能宣称排序而非比值,需更多模型点支撑。
未来方向
作者在 §8 提出的改变是三条最低要求:把重叠检查跑一遍并印出来(精确哈希一个下午,诚实的版本是近重复匹配);公布种子下限(多于一种配方各跑三个种子并报告极差);声明操作性定义并说明引用的是哪个划分——决定判定的是规则在争议案例(版权复述、诱导拒答、虚构伤害、已设防提示)上的裁决,以及含争议类的护栏把该类映射到哪一侧。基于本文成果可延伸:把「定义敏感度 $\Delta_b/\Phi_b$」变成新安全基准的出厂检验指标;对已发布的蒸馏护栏做教师来源取证;把 Qwen3Guard 的 Controversial 类映射实验推广为部署侧零训练改策略的标准杠杆;研究定义如何进入 LLM 裁判与奖励模型(它们同样从人类标签吸收策略);与标注者分歧文献打通,把分歧从待聚合掉的噪声重新解释为被训练固化的定义差异。
复现评估
复现难度中等偏低但无法精确复现。算力门槛很低:两个 ModernBERT(394.8M/149.0M)编码器,单卡即可训练 20 个模型;15 个基准全部公开(共 33,137 条 prompt),外部比较实验(在公开基准上运行 Qwen3Guard-Gen 0.6/4/8B 与 Granite Guardian 3.1-2B)任何人都能复刻,包括同一输入上 Granite 0 分对 Qwen3Guard-4B 99 分的分歧。但核心资产——53,441 条双重标注的内部 prompt、私有 24 支柱分类法、两套标注管线的输出与训练配置——属于 Lenovo 工业部署,论文未承诺开源,因此 $\Delta_b$、秩检验等内部结论只能方向性复现。可低成本复用的部分:归一化哈希的污染审计(一个下午)、种子下限测量协议、可交换性秩检验公式 $1/\binom{10}{k}$、以及「最后监督信号携带策略」的检查清单。另需注意作者坦承头校准臂按训练损失选 checkpoint,复现这些臂时要在验证集上另行选点。
论文图表