UniAVC:基于渐进式训练与非对称调度的统一音视频创作模型 UniAVC: Unified Audio-Video Creation via Progressive Training and Asymmetric Scheduling
单一模型统一音视频联合生成、双向跨模态合成与指令编辑,靠渐进训练和模态解耦双噪声调度。
前置知识
矩形流 / 流匹配 (Rectified Flow / Flow Matching)
一类生成建模框架:在干净样本 $x_0$ 和噪声 $\epsilon$ 之间定义直线路径 $x_t=(1-t)x_0+t\epsilon$,训练网络回归速度场 $u=\epsilon-x_0$,采样时沿直线ODE从噪声走到数据。相比DDPM训练目标简单、路径笔直、采样步数少,是当前视频/音频生成主流基座(如SD3、LTX系列)的标准选择。
UniAVC 的全部公式都建立在矩形流之上:两模态各有噪声水平 $\sigma_a,\sigma_v$,分支回归目标 $\epsilon_i-x_0$,双调度扭曲也作用在矩形流的线性网格上。不懂此框架就看不懂损失函数与采样流程。
噪声调度与二维噪声平面
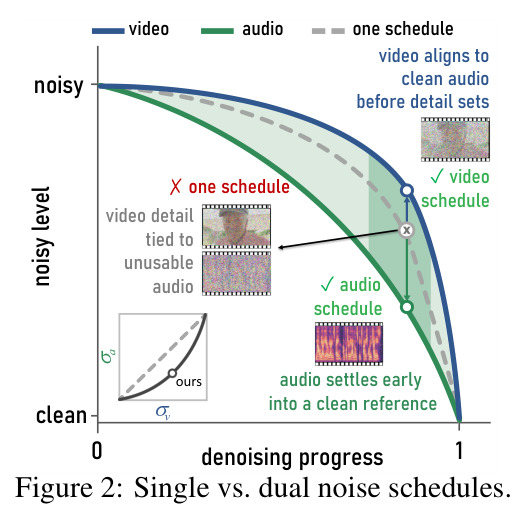
扩散模型用噪声水平 $\sigma$(或时间步 $t$)控制加噪程度,传统做法整条轨迹、所有模态共用一个调度,即任意时刻 $\sigma_a=\sigma_v$。但多模态联合扩散的真实状态空间是两个独立噪声水平 $(\sigma_a,\sigma_v)$ 张成的二维平面,共享调度只覆盖其对角线;非对角区域(一干净一噪)对应跨模态条件生成与单边编辑所需的训练状态。
本文核心论点是:只在对角线上训练的模型,推理时遇到'音频干净、视频噪'这类非对角输入会分布外漂移。理解二维噪声平面才能理解为何需要解耦调度器和 clean-branch 子任务。
分类器自由引导 (CFG) 与条件 dropout
训练时以一定概率随机丢弃条件输入(置空文本提示或参考图像),推理时把有条件与无条件预测外推:$\hat v = v_{uncond} + s\,(v_{cond}-v_{uncond})$,引导尺度 $s$ 控制条件服从强度。若训练时独立丢弃多个条件,推理时就有多条可分别调节的引导轴。
UniAVC 独立以 0.1 概率丢弃文本与参考潜变量,得到文本(指令服从)和参考(源保真)两条独立引导轴,推理时视频用 (3.0, 2.0)、音频用 (1.5, 3.0) 分别权衡,是编辑保真与指令服从兼得的关键。
In-context 条件化(DiT 上下文编辑)
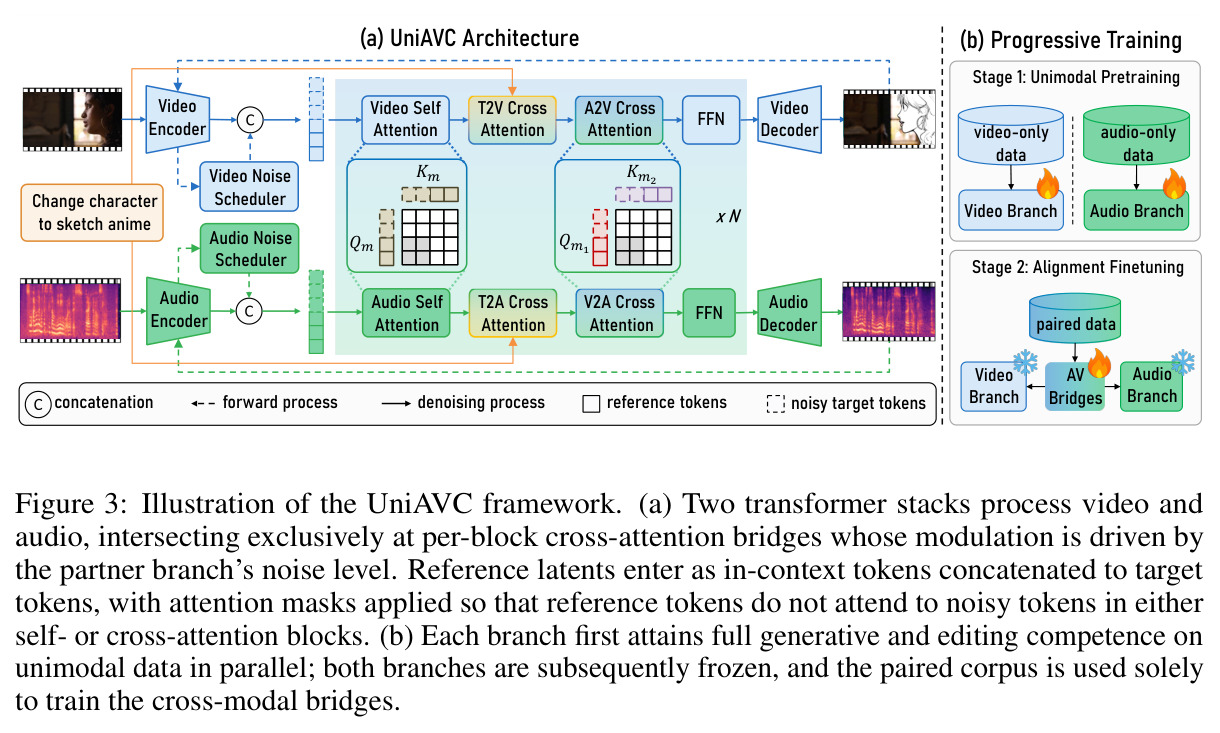
不给扩散 Transformer 加额外输入分支,而是把参考图像/视频经同一编码器 patchify 后拼接到目标 token 序列前作为上下文,靠注意力学会'照着参考改'。配合注意力掩码可控制 token 间的可见性,配合 rotary 位置偏移和 token-type embedding 区分参考段与目标段。
UniAVC 用 in-context 方式注入参考潜变量,但发现以往做法(参考 token 占据目标精确位置、且能看到含噪目标)会让条件信号随噪声漂移,因此设计了'目标可看全部、参考只看参考段'的掩码方案,是理解其编辑架构的前提。
音视频评价体系 (FVD / FAD / DeSync / LSE-C)
FVD 用 VideoMAE 等骨干上的 Fréchet 距离衡量生成视频真实感,FAD 是其音频版(VGGish 嵌入);DeSync(SyncFormer)和 LSE-C(SyncNet)衡量唇动与语音的时间同步;AVS/IC/VF 等由 Qwen3-Omni 等多模态大模型按维度打分。不同基准的缩写含义不同,需按各自协议解读。
论文结果横跨 JAVEditBench、InsAVE-80K、Verse-Bench、VGGSound 四套协议,指标含义各异;不先弄清这些指标,就无法判断哪些数字在比'同步'、哪些在比'画质'。
研究动机
现有音视频创作工具沿三条独立路线成熟:联合生成器(Ovi、UniVerse-1、LTX-2 等)一次生成带音轨的视频;跨模态模型(MMAudio、AVTok 等)从一种模态生成另一种;指令引导编辑器(JAVEdit、InstructAV2AV 等)按文字修改已有片段。实际工作流必须级联这些独立模型——先联合生成、再编辑——而编辑器感知不到音轨,会立即破坏已建立的音画同步;改环境声、重绘场景等迭代编辑使漂移累积,用户被迫引入重同步模块修补。数据层面:同时提供精确音画对齐与编辑配对的语料远小于海量单模态数据,直接在有限配对数据上训练统一模型要同时学源保留、指令服从、跨模态同步多个目标,收敛很差;且稀缺配对样本被大量浪费在教模型'渲染逼真运动''合成清晰声音'这类单模态数据本就管够的基础能力上。此外主流联合架构都对两模态用同一条噪声调度:视频 token 数比音频多一个数量级以上,视频需长时间高噪声组织全局纹理与运动,音频却早早收敛;迁就视频则音频长期虚假含噪,迁就音频则视频过早定型——单一刚性调度两边都不讨好。
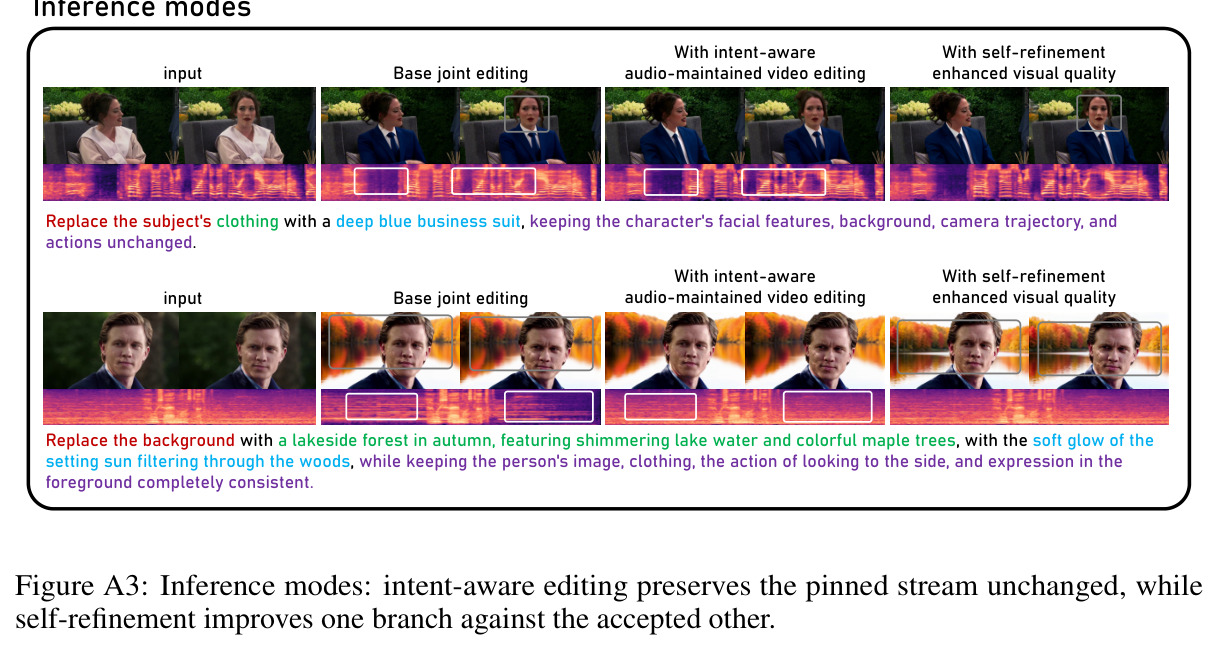
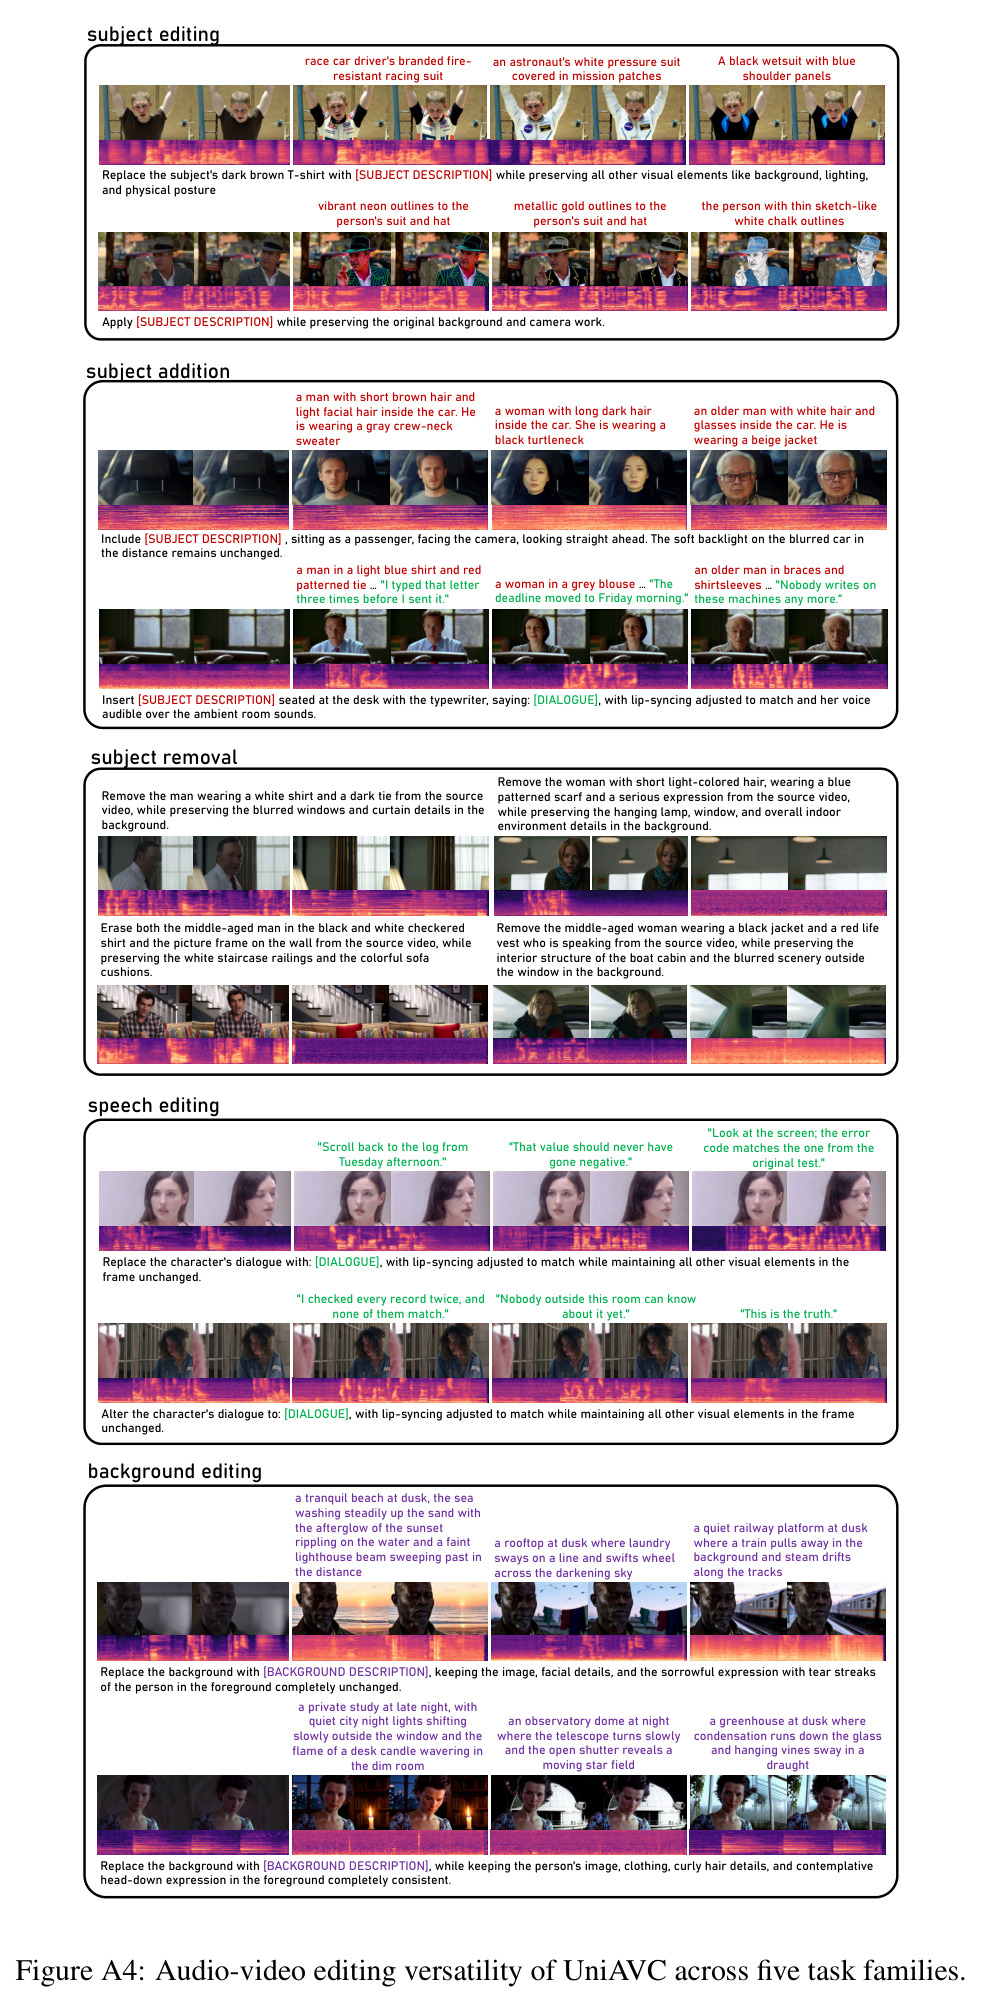
本文的目标是构建 UniAVC:一个只用一组权重、无需任务专属适配器或第二组检查点的统一音视频创作模型,原生支持四类任务——文本条件的音视频联合生成、音频到视频生成、视频到音频生成、对任一或两个模态的指令引导编辑(含主体编辑/添加/移除、背景编辑、语音编辑五族),并在每种模式下达到与各领域专门 SOTA 相当的水平。拆成三个子目标:其一,让海量单模态语料承担单模态生成与编辑能力的全部学习,把稀缺配对数据全部留给跨模态耦合与时间同步;其二,让训练覆盖二维噪声平面 $(\sigma_a,\sigma_v)$ 的非对角区域,消除推理时的分布外漂移;其三,由此解锁两种推理模式——意图感知编辑(把保留模态钉在 $\sigma=0$ 作为干净约束去约束另一模态,被保留侧按构造逐位不变)和推理后自精炼(联合生成后若只有一个模态满意,保留它、只对另一分支再加噪重去噪)。
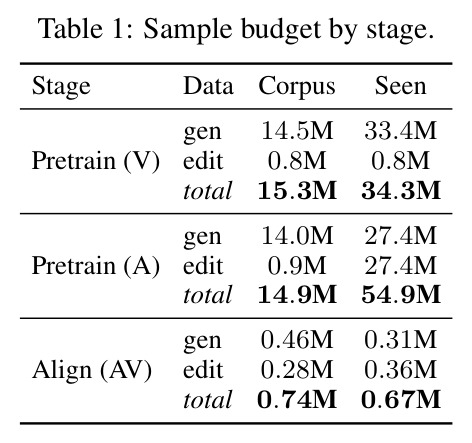
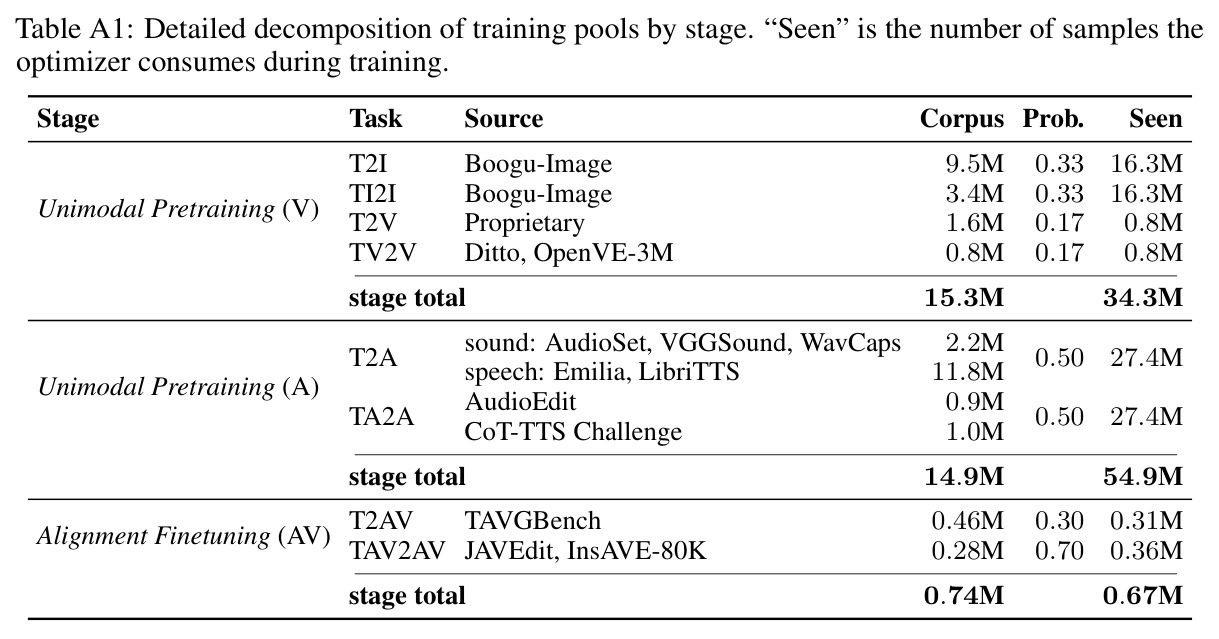
与已有工作不同的是,与既有工作的本质差异有两个。训练范式上,JAVEdit、InstructAV2AV、JoVA、MiniMax-H3 等模型都在稀缺配对语料上端到端同时学单模态能力与对齐;UniAVC 反其道而行:先在单模态语料上把两分支各自练满生成与编辑(视频消费 34.3M、音频消费 54.9M 样本),再冻结两分支、只训练轻量跨模态桥,配对阶段预算不足预训练的 1%,把'数据该教什么'的分配问题显式化。调度设计上,UniDiffuser 与 MoNL 早已指出多模态扩散的噪声状态是二维的,MoVA 为音频/视频独立采样时间步,但独立采样破坏了'噪声对与步计数器'的确定性联系,推理时模型失去结构化进度条件;UniAVC 用单一共享步索引 $i$ 映射到两条独立扭曲的噪声轨迹,幅度分岔但相位锁定,既离开对角线又保留确定性步进时钟,再以 clean-branch 子任务显式监督连续扭曲曲线到不了的 $\sigma=0$ 边界面。这与 SpongeBob 在固定离散配置间切换的做法也不同——UniAVC 在连续噪声空间内由统一时钟动态定位每个去噪步。
核心方法
直觉:视频信息稠密、音频稀疏,两者应有不同的去噪节奏——音频先'落定'成干净参考,让后续步骤的视频参考它对齐节奏、口型与时序,而不是被同一条噪声时间表绑着齐步走。技术上,UniAVC 基于 LTX-2.3 双分支 Transformer:视频、音频各有独立堆栈(各自的自注意力、前馈层与自适应归一化),共享文本嵌入,仅在每层的交叉注意力桥相遇——A2V 桥让视频 query 读音频 key/value,反之亦然;每个桥是门控残差模块,其 scale/shift/gate 由自适应归一化从'对方分支'的噪声水平导出。参考潜变量以 in-context token 拼接并用注意力掩码隔离。训练目标为矩形流匹配 $\mathcal{L}_{FM}=\sum_{i\in\{a,v\}}\mathbb{E}[w_i M_i\,\|\,v_\theta^{(i)}-(\epsilon_i-x_0)\,\|_2^2]$,掩码 $M_i$ 决定监督哪个分支,生成与编辑统一在同一公式下。整体配方 = 两阶段渐进训练 + 非对称解耦调度器 $S_k(\sigma)=\frac{k\sigma}{1+(k-1)\sigma}$($k_v=9,k_a=2$)+ clean-branch 子任务 + 两种专用推理模式。
核心创新有三。第一,渐进式训练:先用互不重叠的单模态语料把两分支分别练满生成与编辑,再冻结两分支,配对数据只训练跨模态桥及其归一化参数(0.67M 样本,不足预训练预算 1%),保证配对监督完全花在单模态数据给不了的跨模态耦合上,与以往端到端联合学一切本质不同。第二,非对称解耦调度:保持单一同步步时钟 $i$,每模态独立扭曲基线性网格 $\bar\sigma_i=1-i/T$:$\sigma_v^{(i)}=R(S_{k_v}(\bar\sigma_i))$、$\sigma_a^{(i)}=R(S_{k_a}(\bar\sigma_i))$;因 $S_k$ 随 $k$ 严格递增,$k_v>k_a$ 保证每个内部步 $\sigma_a<\sigma_v$,训练轨迹离开对角线——音频先收敛,桥把越来越干净的声学表征送入视频分支,仅凭两条扭曲曲线即形成自然时间次序。第三,clean-branch 子任务显式监督边界面(如 $\sigma_a=0,M_a=0$ 的音频条件视频生成),被钉住流的损失被掩码以声明它是条件而非回归目标;这使'按构造逐位保留一个模态'的意图感知编辑与自精炼在推理时处于分布内。另有精巧细节:A2V 桥的门是 $\sigma_a$ 的函数,音频越干净,视频分支对它的信任门开得越大。
方法步骤详情
第一步,形式化:样本为五元组 $(c, v_0, a_0, \tilde v, \tilde a)$——文本条件、干净目标潜变量、编辑参考潜变量(生成时置空),掩码 $M_v,M_a$ 决定监督哪个分支;联合生成与联合编辑都设 $M_v=M_a=1$,区别仅在参考是否非空;跨模态/单模态任务监督一支、掩掉另一支使其保持干净。第二步,阶段一单模态预训练:视频分支在 Boogu-Image、Ditto、OpenVE-3M 等构成的 15.3M 池上消费 34.3M 样本(T2I/TI2I 采样概率各 0.33、T2V/TV2V 各 0.17);音频分支在 AudioSet、VGGSound、WavCaps、Emilia、LibriTTS 等构成的 14.9M 池上消费 54.9M 样本(T2A/TA2A 各 0.5)。统一 720p、121 帧、24fps、16kHz 单声道,AdamW lr $1\times10^{-5}$、bf16,文本与参考 dropout 各 0.1,混入零编辑重建子任务(参考即目标、指令为不修改)作为源保留的显式监督。第三步,阶段二对齐微调:冻结两分支,在 TAVGBench、JAVEdit、InsAVE-80K 的 0.74M 池上消费 0.67M 样本(生成 0.3、编辑 0.7);混合比:生成=0.7 标准+0.1 重建+0.1×2 clean-branch,编辑=0.8 标准+0.1×2 自精炼。第四步,推理:30 步去噪,CFG 视频 (3.0, 2.0)、音频 (1.5, 3.0);意图感知编辑把保留模态钉在 $\sigma=0$;自精炼把生成的 $\hat a_0$ 再加噪到 $\sigma_a=\lambda=0.5$,沿 $\lambda\sigma_a^{(i)}$ 去噪,另一分支全程干净。
技术新颖性
新颖性可从四个对比面看清。(1)对比共享调度的联合模型(LTX-2 及多数 JAV 生成器):首次把'音视频信息密度不对称'从观察落实为显式的每模态调度设计,且扭曲函数 $S_k$ 是 $[0,1]$ 上严格递增的双射并经 $R$ 重缩放到共同终端噪声,只弯内部、不动端点,数学上干净。(2)对比 UniDiffuser、MoNL、MoVA 的独立时间步采样:它们覆盖更多二维噪声空间,却破坏了噪声对与步计数器的确定性联系,推理时缺乏结构化条件;UniAVC 的'单一索引→双轨迹'同时保住离对角覆盖与确定性时钟,这是关键分野。(3)对比 SpongeBob 的固定离散配置切换:UniAVC 在连续 $(\sigma_a,\sigma_v)$ 空间内由统一时钟动态定位非对角对,仅边界状态用离散子任务补足,是连续+边界的混合覆盖。(4)对比 JoVA、MiniMax-H3 等统一生成+编辑模型:它们仍用稀缺配对数据学单模态能力,UniAVC 的冻结-桥接策略让配对预算全部花在对齐上。此外,桥门控由对方噪声水平调制、参考 token 不得读含噪目标的掩码细节,都是把不对称性贯彻到架构每个角落的体现。
实验结果
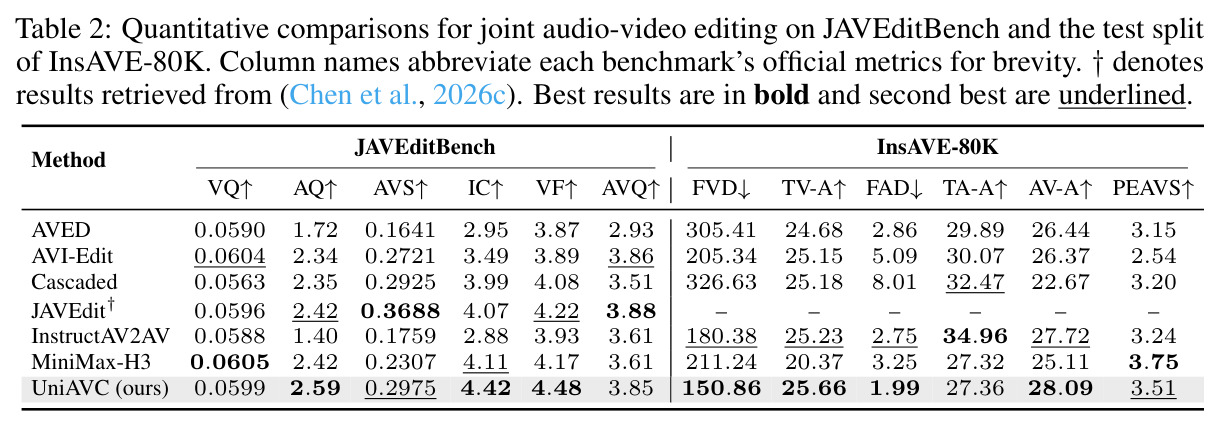
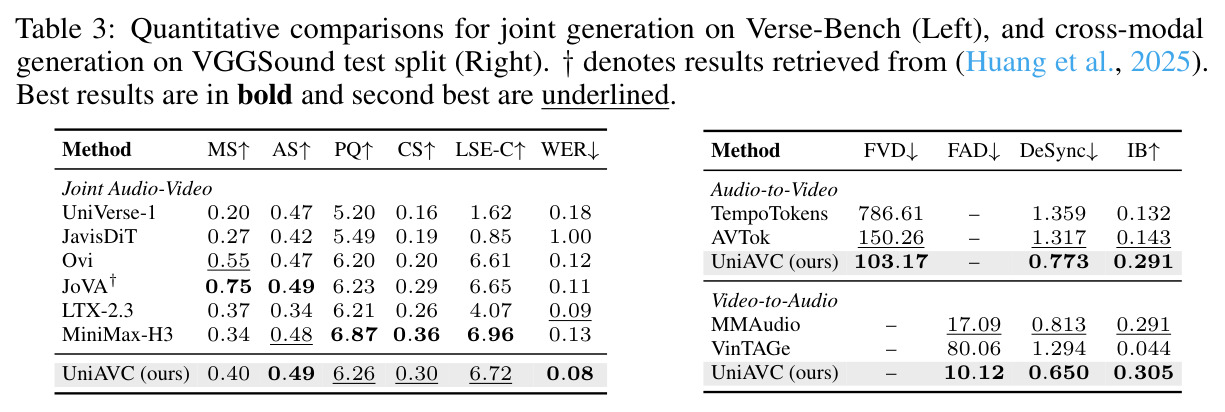
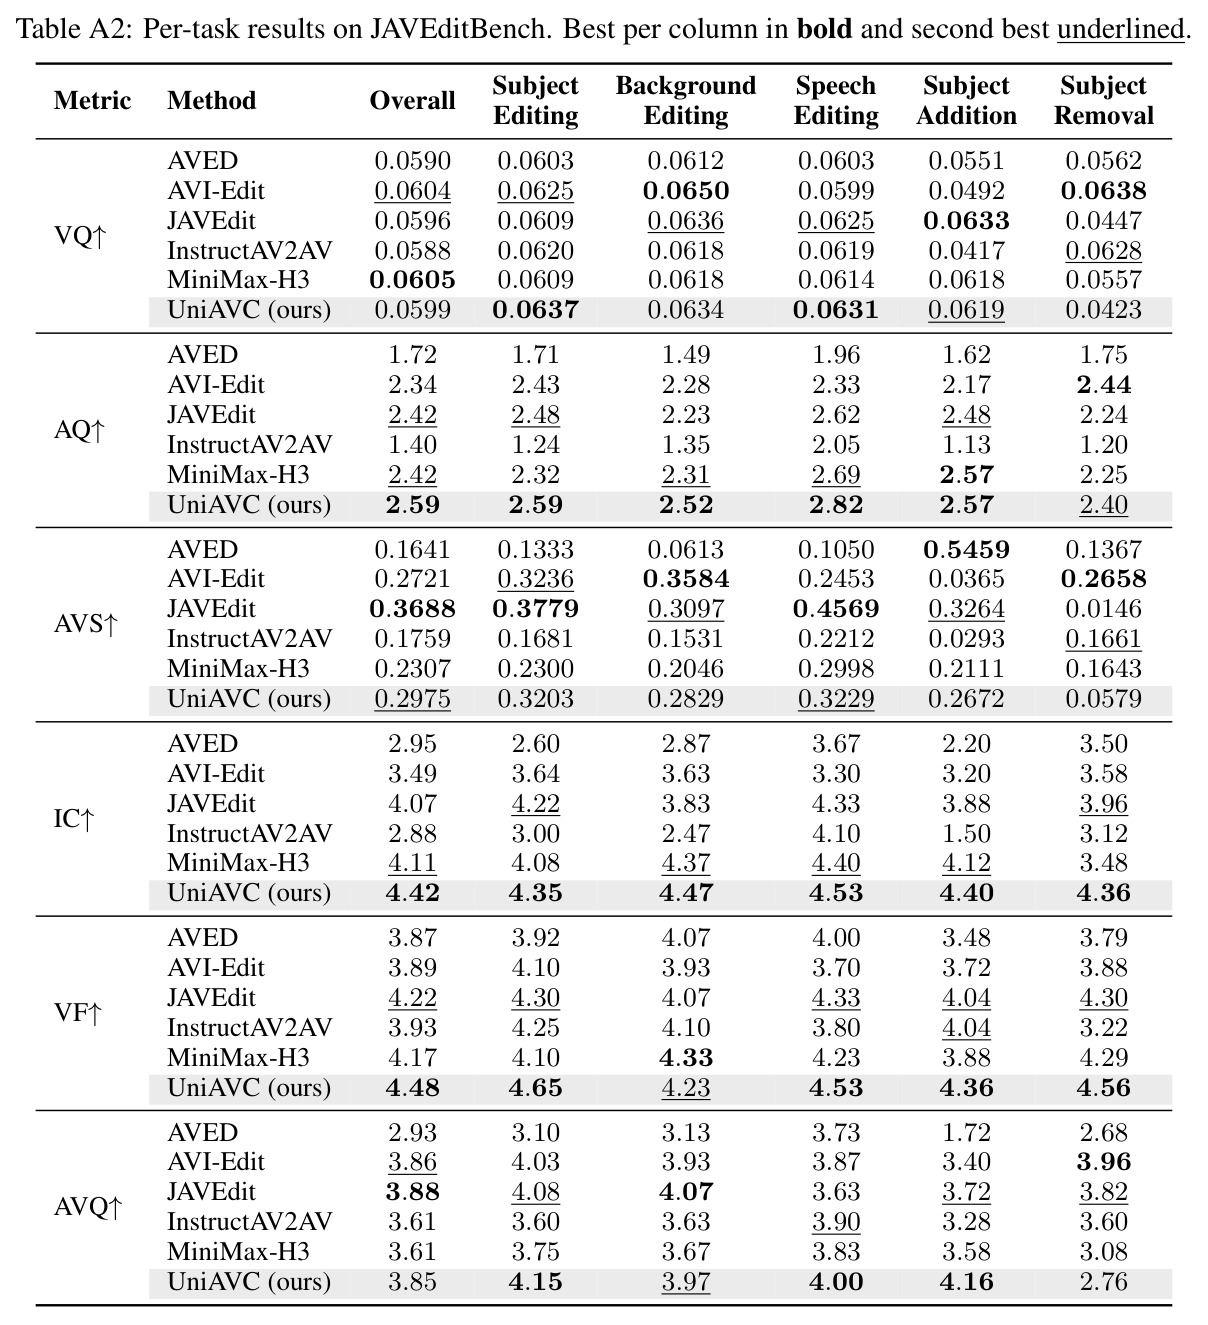
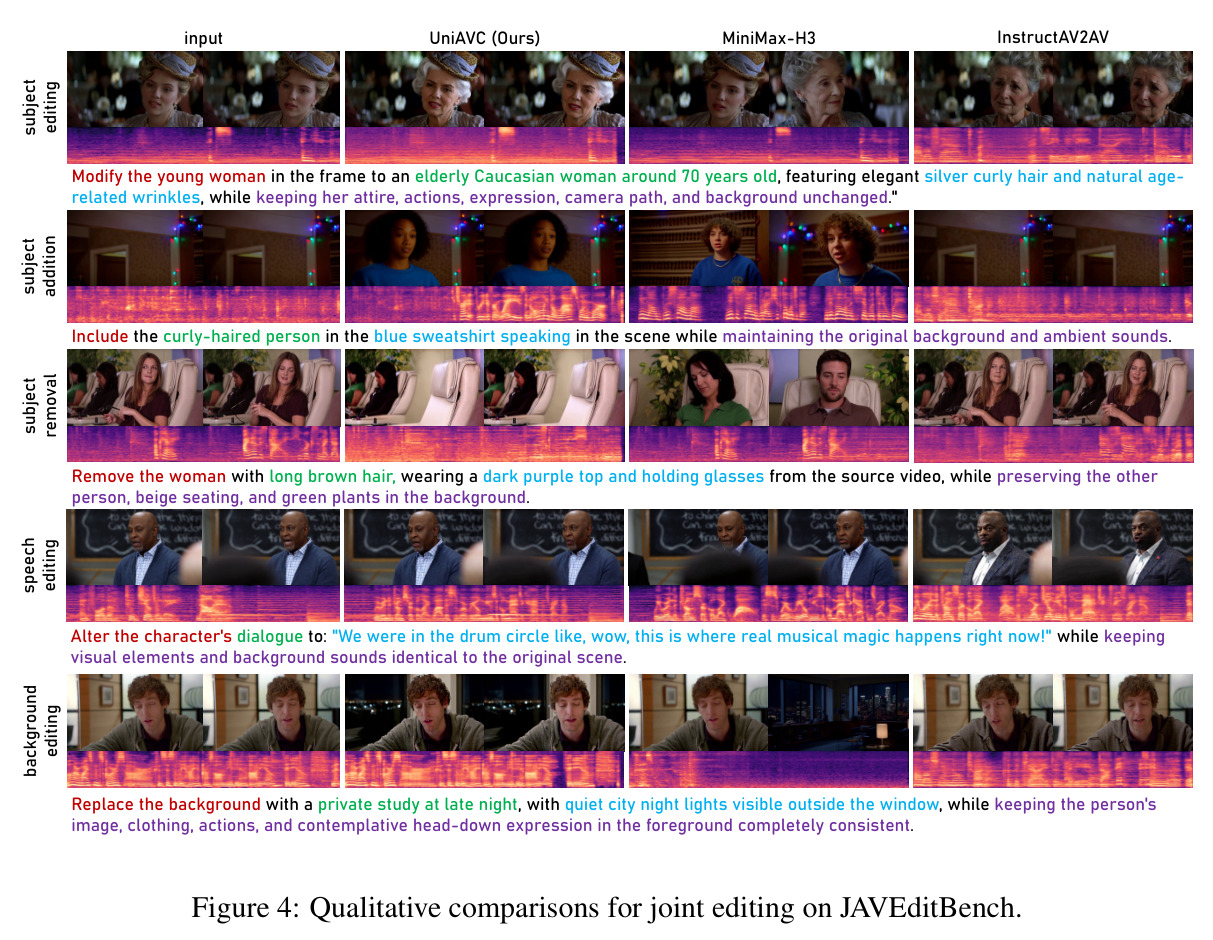
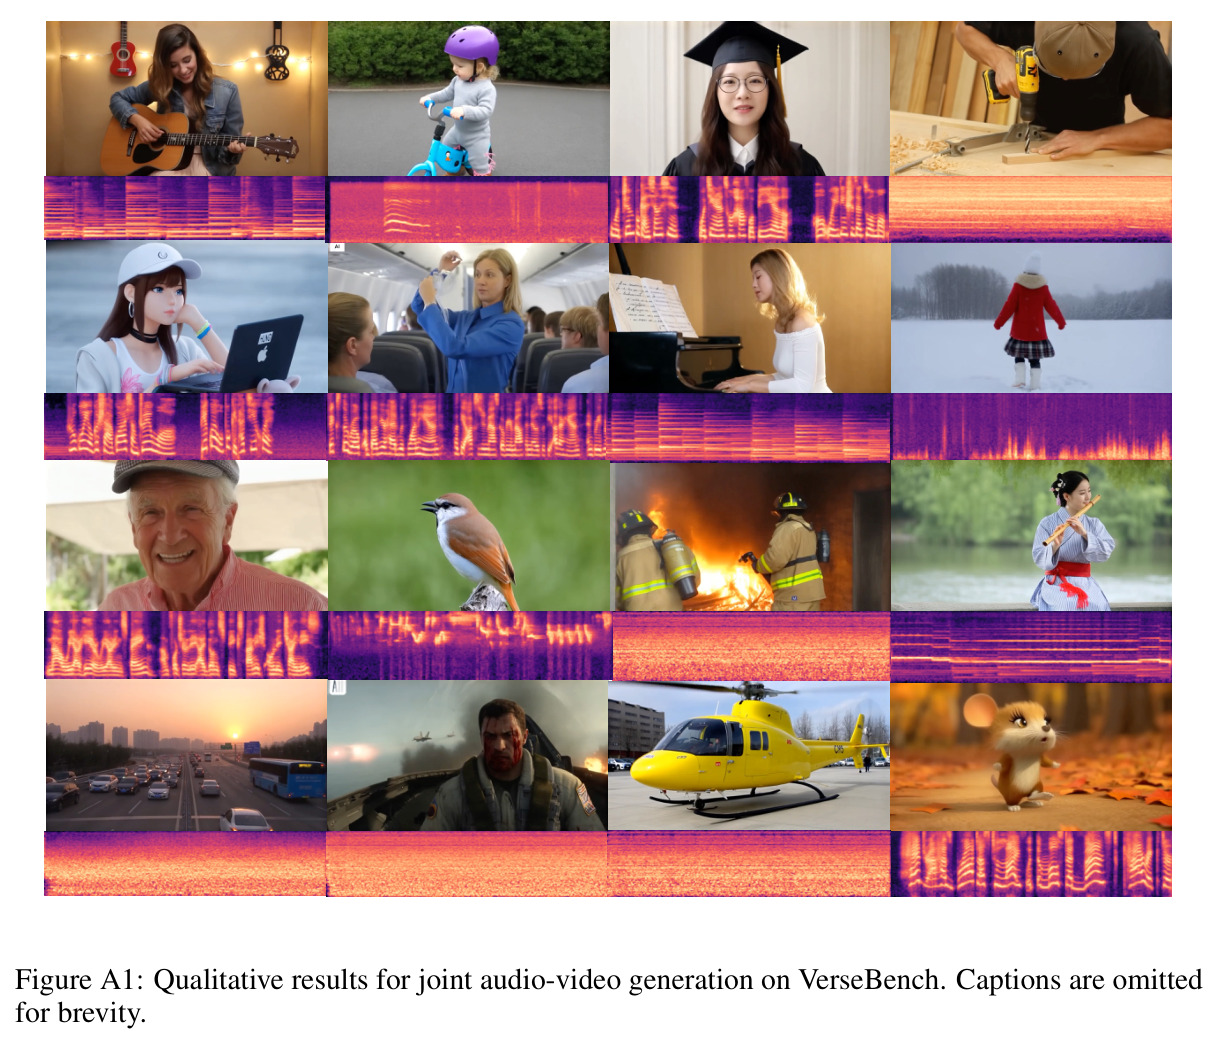
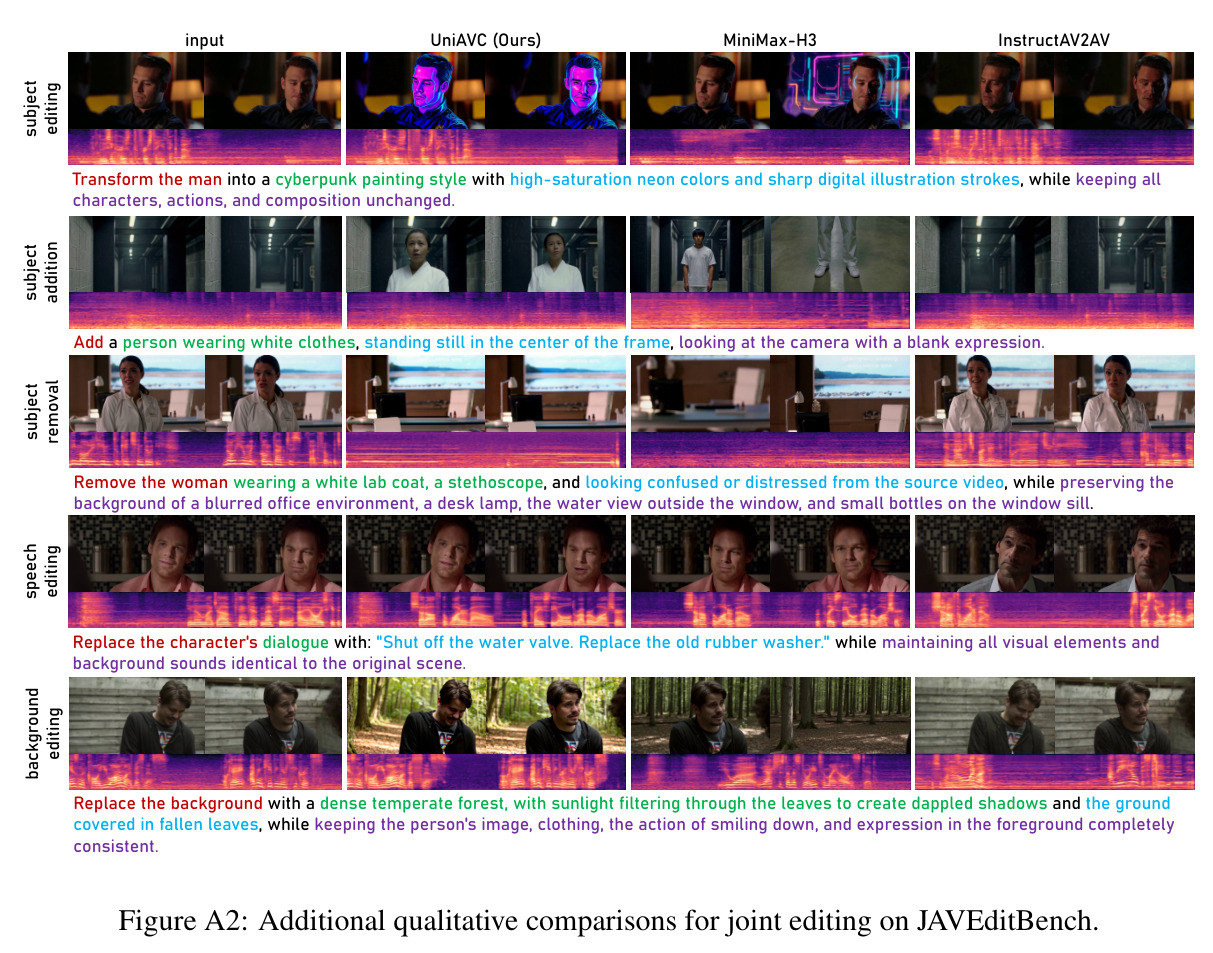
联合编辑(Table 2):JAVEditBench 上 UniAVC 的 AQ 2.59、IC 4.42、VF 4.48 均为全场最佳,AVQ 3.85 第一梯队;AVS 0.2975 仅次于 JAVEdit(0.3688),VQ 0.0599 微弱落后 MiniMax-H3(0.0605)。InsAVE-80K 上横扫四指标:FVD 150.86(对比 InstructAV2AV 180.38)、FAD 1.99(对比 2.75)、TV-A 25.66、AV-A 28.09 全部第一。联合生成(Verse-Bench):WER 0.08 全场最佳(LTX-2.3 为 0.09),LSE-C 6.72 次于 MiniMax-H3 的 6.96,运动分数 MS 0.40 明显低于 JoVA 的 0.75,暴露运动偏保守。跨模态生成(VGGSound):音频到视频 FVD 103.17 大幅优于 AVTok 150.26 与 TempoTokens 786.61,DeSync 0.773、IB 0.291 均最佳;视频到音频 FAD 10.12 优于 MMAudio 17.09 与 VinTAGe 80.06,DeSync 0.650、IB 0.305 最佳。消融(Table 4):渐进训练相对单阶段在 AQ、AVQ 各 +0.32(2.59 vs 2.27、3.85 vs 3.53),收益集中在跨模态指标,验证配对预算专用假说;意图感知编辑把 AQ 提到 2.53,自精炼把 IC 提到 4.39,合用后 AVS 0.2975、AVQ 3.85 达峰值;移除调度不对称使 AQ 掉到 2.48、AVQ 掉到 3.67,过激的 (3,12) 也回退,说明扭曲强度存在适中最优。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 音视频联合编辑 (JAVEditBench) | 指令服从 IC ↑ (Qwen3-Omni 评判) | 4.42 | MiniMax-H3 4.11 / JAVEdit 4.07 | +0.31 (~+7.5%) |
| 音视频联合编辑 (JAVEditBench) | 音频质量 AQ ↑ (UTMOSv2) | 2.59 | JAVEdit 2.42 / AVI-Edit 2.34 | +0.17 (~+7%) |
| 音视频联合编辑 (JAVEditBench) | 视频保真 VF ↑ | 4.48 | JAVEdit 4.22 / MiniMax-H3 4.17 | +0.26 (~+6%) |
| 音视频联合编辑 (InsAVE-80K) | FVD ↓ (VideoMAE 骨干) | 150.86 | InstructAV2AV 180.38 / MiniMax-H3 211.24 | −29.52 (~−16.4%) |
| 音视频联合编辑 (InsAVE-80K) | FAD ↓ (VGGish 嵌入) | 1.99 | InstructAV2AV 2.75 / AVED 2.86 | −0.76 (~−27.6%) |
| 音频→视频生成 (VGGSound) | FVD ↓ | 103.17 | AVTok 150.26 / TempoTokens 786.61 | −47.09 (~−31.3%) |
| 视频→音频生成 (VGGSound) | FAD ↓ | 10.12 | MMAudio 17.09 / VinTAGe 80.06 | −6.97 (~−40.8%) |
| 音视频联合生成 (Verse-Bench) | WER ↓ (Whisper-large-v3 转写) | 0.08 | LTX-2.3 0.09 / JoVA 0.11 / Ovi 0.12 | −0.01~−0.04 |
局限与改进
作者明确承认四点:其一,训练与推理开销显著——两阶段配方要求先消耗 89.2M 单模态样本预训练才开始对齐;推理时每个请求都要对双流跑完整 30 步去噪轨迹,自精炼还要对目标模态再来一遍,无法实时部署。其二,性能受训练指令复杂度制约:配对语料中鲜有同时指定多个并发修改的组合式指令,模型执行多目标指令并不完美。其三(结论段),训练覆盖仅是一条一维扭曲轨迹加两个边界面,远非完整二维噪声对空间。其四,跨模态桥只做表征对齐,无法修复单模态分支自身缺陷。我的补充观察:模型强依赖 LTX-2.3 预训练权重,范式在其它基座上的可移植性未验证,且 1.6M 专有 T2V 数据使严格复现不可能;编辑基准大量依赖 Qwen3-Omni 主观打分,VQ 上 0.0599 vs 0.0605 的差距几乎在指标噪声内;JAVEditBench 的 AVS 仍显著落后 JAVEdit(0.2975 vs 0.3688),按构造保留并不自动等于主观同步最优;冻结策略意味着若阶段一某分支存在能力短板,阶段二无法弥补;论文未披露参数量与 GPU 预算,与 JoVA、MiniMax-H3 之间缺乏算力对齐的公平比较。
独立分析的弱点
独立分析出五个弱点。一、运动质量保守:Verse-Bench 上 MS 仅 0.40,不足 JoVA(0.75)的六成,生成的运动幅度偏小,对动作剧烈的场景可能显得呆滞;改进方向是在视频分支预训练中提高视频任务占比(当前图像任务占了 0.66 采样概率)、引入运动感知损失或运动强度奖励微调。二、噪声空间覆盖只有一条曲线:训练对全部满足 $\sigma_a<\sigma_v$,反向次序(视频先干净、音频后收敛)从未被见过,对'以视频为条件生成音频但视频还在去噪中'的场景是盲区;改进方向是混合多条扭曲曲线或设计二维噪声对采样课程。三、组合式编辑弱:一条指令同时改主体+背景+语音时执行不完整,根源是配对数据缺乏此类样本;改进方向是用 agent 合成组合指令-编辑对,或对编辑任务做偏好优化。四、推理成本:双流 30 步加自精炼二遍,交互式场景不可用;改进方向是把双调度与轨迹蒸馏结合、自精炼只跑目标分支的部分轨迹。五、冻结策略刚性:桥无法反哺分支,若下游发现某分支能力不足只能回炉重训阶段一;改进方向是桥训练收敛后以极低学习率解冻分支或加 LoRA 短暂联合微调。
未来方向
作者在结论与附录中提出三个方向:降低分阶段训练成本、加速推理轨迹、扩充指令混合以改进组合式编辑。可延伸的路:第一,把'每模态解耦调度'推广为通用原则——音乐、多说话人语音、深度、姿态各有自己的信息密度与收敛节奏,可为 N 模态统一模型配置 N 条相位锁定的扭曲轨迹。第二,系统探索完整二维噪声对空间:当前只覆盖 $\sigma_a<\sigma_v$ 的一条曲线加两个边界面,值得研究 $\sigma_a>\sigma_v$ 的反向课程能否让视频条件音频生成也享受'干净视觉参考'红利。第三,把双调度与滑窗式时序方法(Diffusion Forcing 类)结合,走向流式/实时的音视频创作与直播级编辑。第四,把自精炼循环化:多轮'保留满意分支、只重生成不满意分支'直至收敛,作为测试时算力扩展手段。第五,评估层面引入人评与长时序同步测量,正面回应 AVS 与 JAVEdit 的差距及 MS 偏低问题。第六,把意图感知编辑从'整条流'细化到'局部时空区域'——只改某一帧某区域而不动其余,需要把钉住机制与时空掩码调度结合。
复现评估
复现评估:偏难。开源情况:论文未声明开源代码或权重,项目页(hkust-longgroup.github.io/UniAVC)按惯例仅提供视频演示;基座 LTX-2.3 的开放程度也直接影响复现上限。数据披露极详尽(Table A1 逐任务给出池大小、采样概率与消费量):视频侧 Boogu-Image、Ditto、OpenVE-3M,音频侧 AudioSet、VGGSound、WavCaps、Emilia、LibriTTS、AudioEdit、CoT-TTS,对齐侧 TAVGBench、JAVEdit、InsAVE-80K 均公开可得,但 1.6M 专有 T2V 数据不可得,严格复现不可能。超参数披露完整:$k_v=9,k_a=2$、dropout 0.1、AdamW lr $1\times10^{-5}$、bf16、30 步推理、双轴 CFG、$\lambda=0.5$、子任务混合比例。算力是主要门槛:720p×121帧×24fps 双分支训练、预训练消费约 89.2M 样本,论文未披露 GPU 数量与时长,量级上只有工业界集群可承担。务实的低成本路径有两条:跳过阶段一,从开源 LTX-2 权重出发只复现阶段二对齐微调(0.67M 样本);或只复现双调度+clean-branch 子任务的核心消融,验证'离开对角线'这一中心主张。总体难度:完整复现高、核心思想验证中。
论文图表
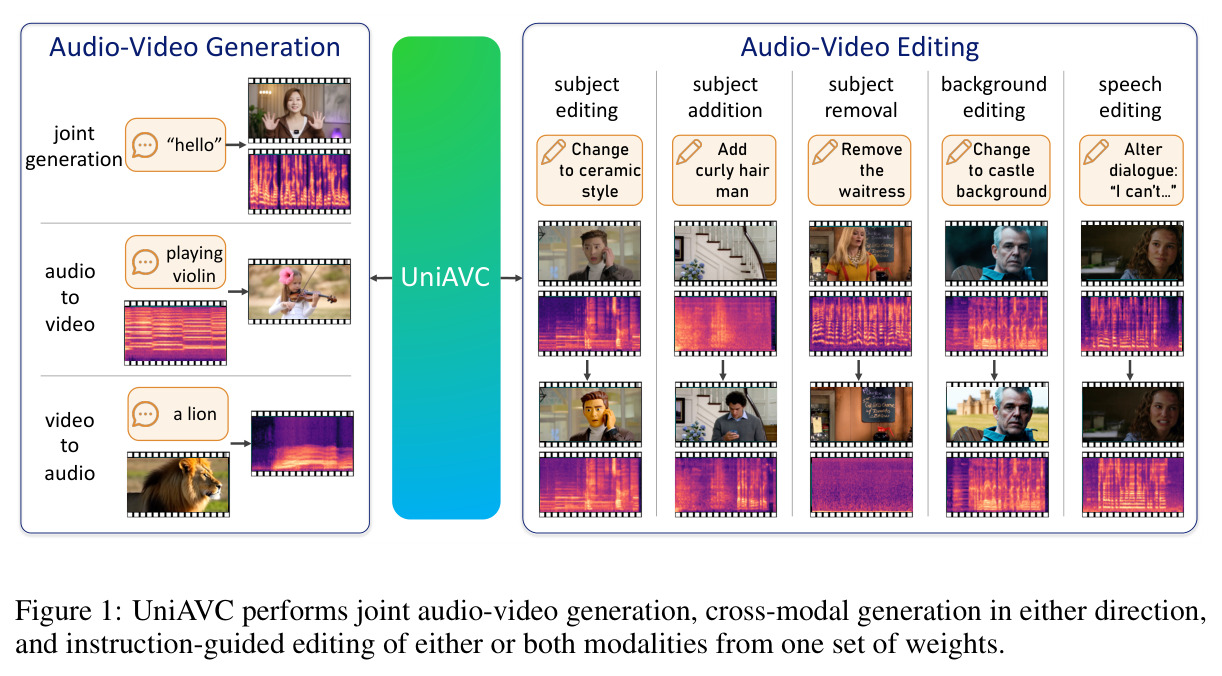
总览图:上半部展示音视频编辑五族任务(主体编辑、主体添加、主体移除、背景编辑、语音编辑)的输入输出示例,下半部展示音频到视频(拉小提琴)与视频到音频(狮子吼)两个方向的跨模态生成,中央的 UniAVC 表示所有任务由同一组权重完成。
一张图界定'统一'的确切含义:四类任务、两个方向、五族编辑全部收进单一模型且无需适配器,是理解论文动机与贡献范围的最直观入口。
三组消融:训练范式(单阶段 vs 渐进,渐进在 AQ/AVQ 上各 +0.32)、推理模式(Base→意图感知→自精炼→全开,AVS 0.2643→0.2975)、调度偏移强度((1,1)/(3,12)/(2,9),(2,9) 最优,移除不对称使 AQ 掉至 2.48)。
逐项归因论文三个技术贡献各自的增益,验证渐进训练与调度不对称性主要提升跨模态指标这一核心叙事。