HSPR:基于层次后验推断恢复软件智能体的基准分数 HSPR: Recovering Software-Agent Benchmark Scores via Hierarchical Posterior Inference
用历史响应层次模型与自适应查询,仅执行10%任务即可精确恢复完整基准分数
前置知识
层次贝叶斯模型
把参数分成多层、低层参数依赖高层超参数的贝叶斯模型:先对全局状态 $z$ 设先验,再条件于 $z$ 为各组局部参数(如成功率 $q_g$)设先验,观测数据同时更新所有层的后验。层间条件共轭的部分可解析更新,非共轭部分用采样近似。
HSPR 的全部推导建立在两层结构上:全局潜在状态 $z=(\theta,u)$ 与目标特定组率 $q_g$,理解一次观测如何同时更新两层后验是读懂方法的前提。
Beta 分布与共轭更新
Beta 分布是定义在 $[0,1]$ 上的成功率分布,$\mathrm{Beta}(A,F)$ 的均值为 $A/(A+F)$。它是伯努利/二项似然的共轭先验:观测到 $s$ 次成功、$n$ 次失败后,后验仍是 Beta,只需把参数更新为 $A+s$ 与 $F+n-s$,无需数值积分。
HSPR 的组成功率 $q_g\mid z,D_t\sim\mathrm{Beta}(A_g,F_g)$ 的闭式更新(式 7)正是利用共轭性,使每次查询后重算后验的开销很小。
项目反应理论(IRT)
心理测量学中用题目参数与被试能力解释答对概率的模型,如 $p=\sigma(b+a\theta)$:$b$ 是截距(难度)、$a$ 是斜率(区分度)、$\theta$ 是被试能力;Fisher 信息可指导下一题选择,即计算机自适应测试的核心思想。
HSPR 的源拟合层就是逻辑斯蒂 IRT 模型 $p_i(z)=\sigma(b_i+a_i\theta+v_i^\top u)$,两个主要基线 ATLAS 与 PTA-IRT 也是 IRT 方法,理解参数含义才能看懂层次设计的动机。
SWE-bench 与智能体评测成本
SWE-bench 用真实 GitHub issue 评测代码智能体,家族含 Lite(300 题)、Verified(500)、Full(2294)、Pro(730)四个任务库。每个任务要求智能体探索仓库、修改代码并通过测试,单次执行耗时长、费用高,因此子集评测与分数恢复有直接的应用价值。
论文所有实验对象就是这四个库的存档响应矩阵,任务数与预算(如 Full 上 229/2294)直接对应实验设置,不看懂评测成本就无法理解问题动机。
后验中位数与绝对损失
在绝对误差损失 $\mathbb{E}[|S-x|]$ 下,贝叶斯最优点估计是后验分布的中位数,而非平方损失下的均值。对整数分数 $S$,HSPR 通过采样完整的分数 draws(含已观测成功数)再取经验中位数来近似 $S_{.5}$。
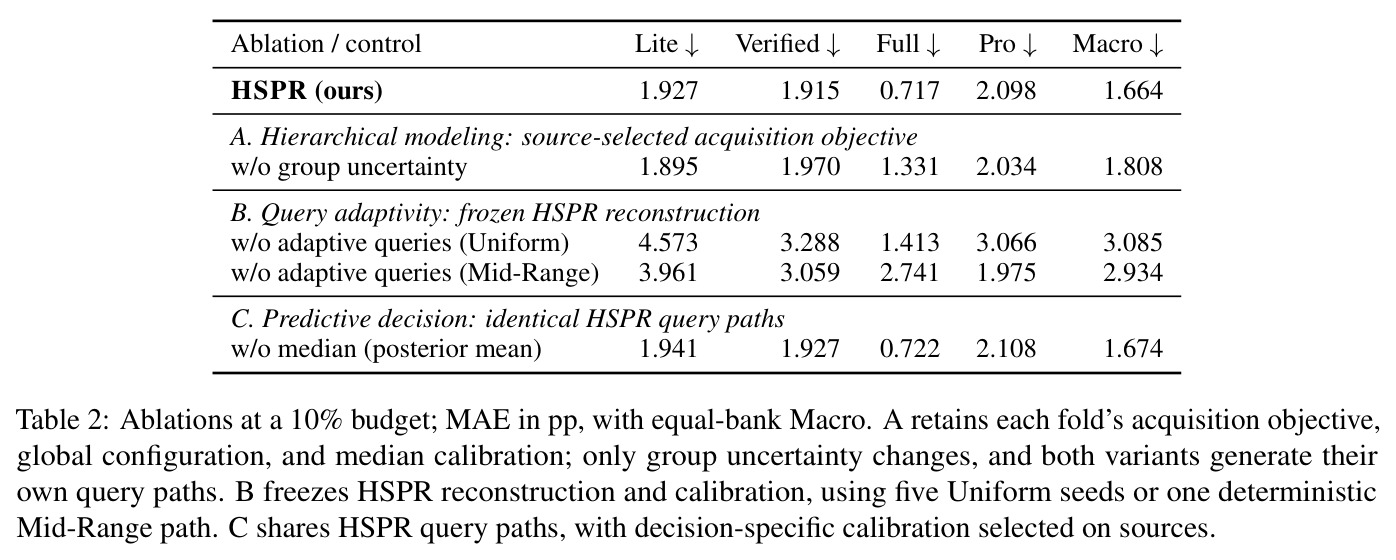
这解释了为什么 HSPR 最终输出后验中位数:表 2C 显示换成后验均值后宏 MAE 从 1.664 变为 1.674 pp,中位数略优,是理解'预测决策'模块的关键。
主动测试与采集函数
主动测试(active testing)在有限查询预算下按采集函数逐个选择信息量最大的样本进行观测,典型准则包括方差缩减与互信息等;与主动学习不同,其目标通常是估计某个整体指标而非训练模型。
HSPR 的采集准则 $G^S_g=\mathrm{Cov}(S,Y_g\mid D_t)^2/\mathrm{Var}(Y_g\mid D_t)$ 是分数方差缩减型采集函数,命题 1 证明它等于分数后验方差的一步期望缩减。
研究动机
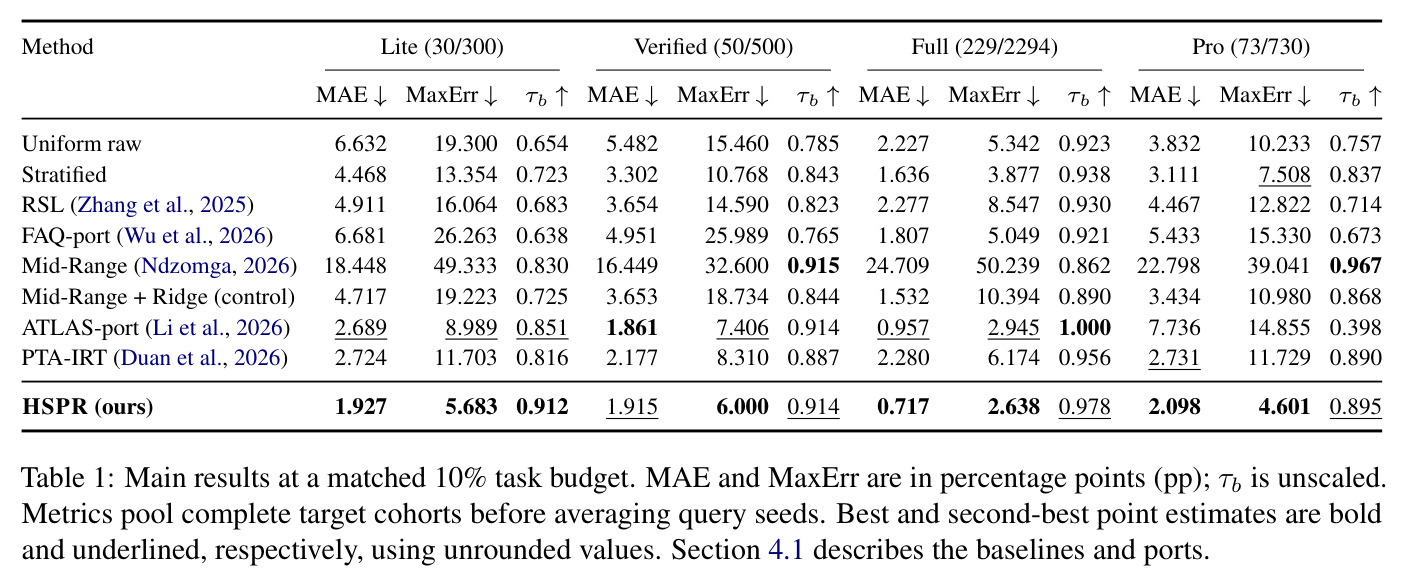
在 SWE-bench 这类智能体基准上评测一个软件智能体,需要它在数百到数千个真实仓库任务中完成仓库探索、代码编辑、工具调用与执行验证。SWE-bench Full 有 2294 个任务,完整跑一遍成本极高,实践中常退而求其次用小子集评测。但论文数据显示,子集方法在'保排序'与'保分数'之间严重失衡:在 SWE-bench Pro 上以 10% 预算选出的 Mid-Range 子集虽然很好地保住了模型排序(Kendall $\tau_b=0.967$),其原始子集均值的平均绝对误差(MAE)却高达 22.798 个百分点(pp)。更麻烦的是历史响应结构并不可靠:源智能体上响应模式完全相同的任务,对新目标智能体可能有不同结果——Full 和 Pro 上分别有 41.3% 和 36.7% 的任务在所有源智能体上零成功,但这些任务集对新目标智能体的实际成功率仍有 1.84% 和 2.07%,说明'同签名 ⇒ 同结果'的硬绑定不成立,不确定的传递关系必须被显式建模。
本文的目标是本文的目标是:给定 $N$ 个任务的完整基准与一个目标智能体,在最多执行 $B$ 个不同任务(主实验取 $B=\mathrm{round}(0.1N)$,如 Full 上 229 题、Pro 上 73 题)的约束下,精确恢复该智能体的完整基准分数 $S=\frac{1}{N}\sum_{i=1}^{N}Y_i$,并给出量化不确定性的分数后验分布 $p(S\mid D_B)$。具体包括三点:(1) 点估计误差低——在 MAE 与最大绝对误差 MaxErr 上超越现有子集选择与重建方法;(2) 同时保持较高的排序保真度(Kendall $\tau_b$);(3) 全部模型配置(残差秩 $r$、先验精度 $P$、组不确定性强度 $\kappa$、采集目标 $\rho$、校准系数 $\lambda$)在接触任何目标智能体之前,仅用历史源智能体数据通过源内留一验证确定并冻结,避免目标信息泄露。
与已有工作不同的是,现有路线各有盲区:Mid-Range、tinyBenchmarks 等固定子集法只选任务、不建模不确定性,子集均值误差巨大(Pro 上 22.798 pp);RSL 与 Mid-Range+Ridge 在采到的结果上做平坦回归重建,忽略任务间依赖与历史结构传递的不确定性;ATLAS、PTA-IRT 借用心理测量学 IRT,但 Fisher 引导的采集目标是潜在能力 $\theta$,而非最终要交付的分数 $S$ 本身;FAQ 虽结合历史因子与自适应查询,重建仍是平坦的。HSPR 的独特切入是:把'分数恢复'当作有限总体的贝叶斯推断问题,直接维护完整分数 $S$ 的后验;用组内可交换性刻画同签名任务间'相近但不确定'的传递关系;并让采集准则等于分数后验方差的一步期望缩减——查询什么,由'最能缩小分数不确定度'决定,而不是由能力估计决定。
核心方法
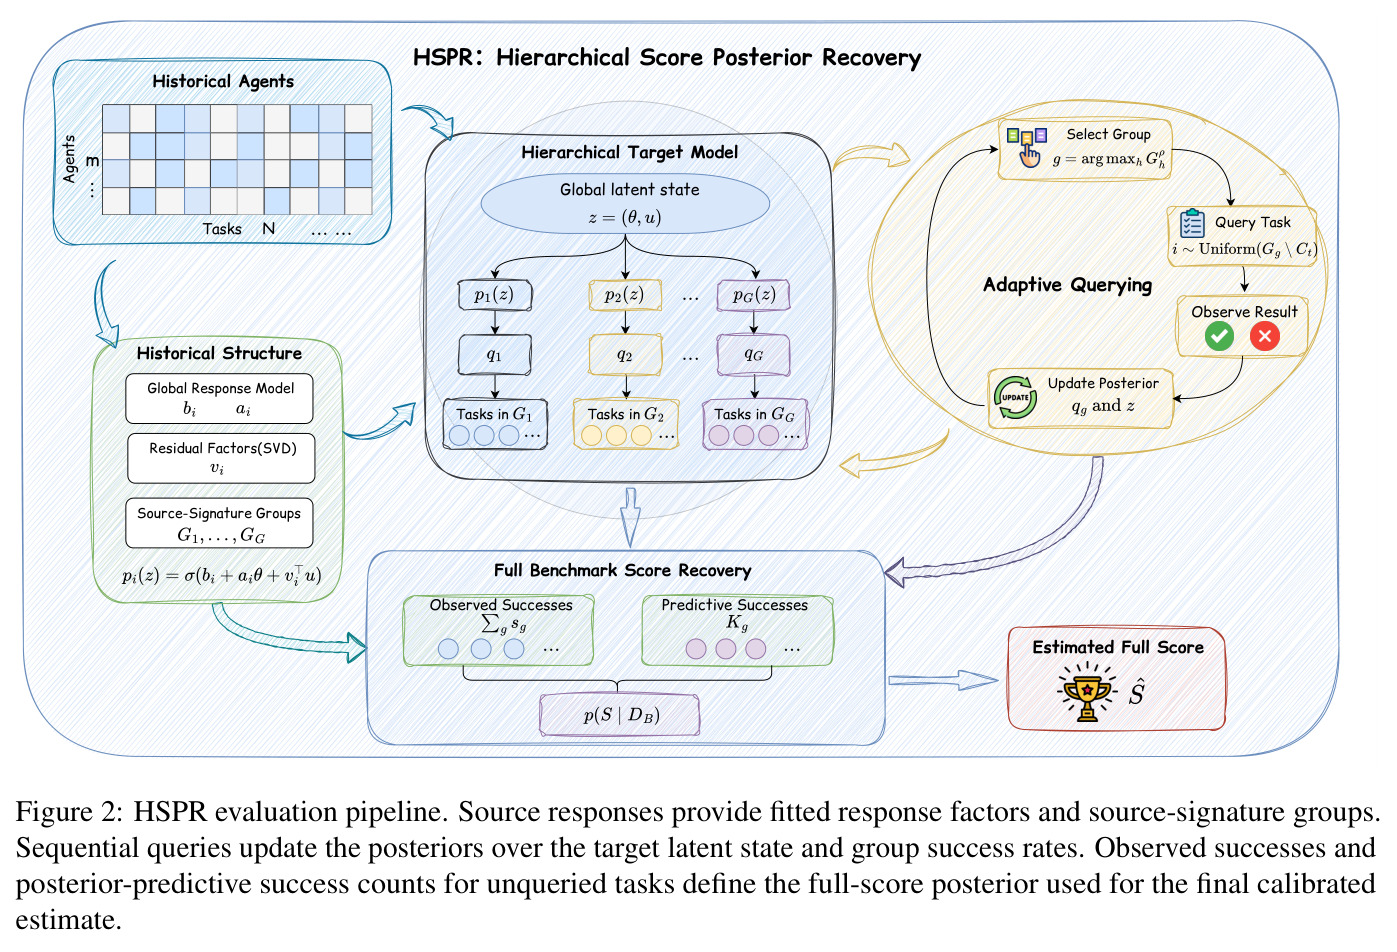
HSPR 把评测视为“历史结构 + 少量自适应查询 + 后验推断”三段流水线。直觉上:每个任务在历史源智能体矩阵中留下一行 0/1 响应签名,签名相同的任务在源数据上不可区分,对新智能体大概率行为相近但不保证相同——HSPR 用一个不确定的组成功率 $q_g$ 表达这种“相近但不确定”。技术路线分四步:(1) 在 $M\in\{0,1\}^{m\times N}$ 上拟合正则化逻辑斯蒂项目模型,得到截距 $b_i$、能力斜率 $a_i$ 与 SVD 残差方向 $v_i$,并按签名精确相等划分任务组 $G_1,\dots,G_G$;(2) 目标智能体由全局潜在状态 $z=(\theta,u)$ 与各组成功率 $q_g$ 双层刻画,每次观测同时更新两层后验;(3) 用分数方差准则选组、组内均匀抽样,执行 $B$ 次查询;(4) 由观测与 Beta-Binomial 预测成功数合成 $S$ 的后验,取中位数 $S_{.5}$ 并校准输出 $\hat{S}$。连续后验用高斯提议的重要性采样近似,CPU 即可完成。
核心创新是“双层不确定性 + 分数方差采集”。与 ATLAS/PTA-IRT 把任务结果钉死在潜在能力上不同,HSPR 认为签名相同的组内任务只共享一个未知的目标特定成功率 $q_g\mid z\sim\mathrm{Beta}(c_gp_g,\,c_g(1-p_g))$:组基线 $p_g(z)=\sigma(b_g+\ell_g^\top z)$,浓度 $c_g=\kappa/(p_g(1-p_g))$ 在基率接近 0 或 1 时自动收紧先验。于是组内一次观测既解决被查任务,又通过 $q_g$ 把证据共享给同组其余 $U_g-1$ 个未查任务。命题 1 证明采集准则 $G^S_g=\mathrm{Cov}(S,Y_g\mid D_t)^2/\mathrm{Var}(Y_g\mid D_t)$ 恰好等于分数后验方差的一步期望缩减,把“查询哪里”与“最终要估准什么”严格对齐;这是与 Fisher 引导的能力采集、平坦 Ridge 重建的本质区别。
方法步骤详情
第一步(源拟合):在历史矩阵 $M$ 上拟合逻辑斯蒂项目模型 $p_i(z)=\sigma(b_i+a_i\theta+v_i^\top u)$;源能力取平滑全分的标准化 logit,残差经中心化 SVD 得 $r$ 个方向 $v_i$,截距用混合先验正则化,$r$ 与先验精度 $P$ 源内选定后冻结。第二步(分组):按源响应行精确相等定义签名组,组内平均参数得基线 $p_g(z)$。第三步(自适应查询):每步按 $g^\star=\arg\max_h G^\rho_h$ 选组(16 折中 13 折源内选定 Score),组内均匀抽一任务执行;组率后验 $q_g$ 经 Beta 共轭闭式更新,$z$ 经联合似然更新,共 $B$ 次。第四步(分数判定):未查任务组成功数 $K_g\sim\mathrm{BetaBinomial}(U_g,A_g,F_g)$,与观测成功数合成为整数分数的后验分布,取中位数 $S_{.5}$,校准 $\hat{S}=\mathrm{clip}_{[0,1]}[S_{.5}+\lambda(1-B/N)R_B]$,$\lambda$ 源内选定。
技术新颖性
技术新颖性体现在四点。其一,有限分数后验:把 $S$ 当作 $N$ 个 0/1 变量之和,用 Beta-Binomial 预测计数显式保留未观测结果间的依赖(条件于 $z$ 各组独立,边缘上共享对 $z$ 的不确定性),而回归式基线只输出点估计、无分布可言。其二,目标特定组率:签名组内用不确定的 $q_g$ 而非硬绑定结果,一次观测可修正整组预测,同时允许组内成员最终结果不同——这直接回应了'同签名不同结局'的经验事实。其三,分数方差采集:$G^S_g$ 与潜变量准则 $G^z_g=\sum_k \mathrm{Cov}(z_k,Y_g\mid D_t)^2/\mathrm{Var}(Y_g\mid D_t)$ 共用同一层次后验,且采集目标在源内验证阶段即冻结(13/16 折选 Score),部署前无需目标数据调参。其四,中位数决策与轻量校准 $\lambda(1-B/N)R_B$ 配套,随预算增大自动衰减修正,满预算退化为真值。
实验结果
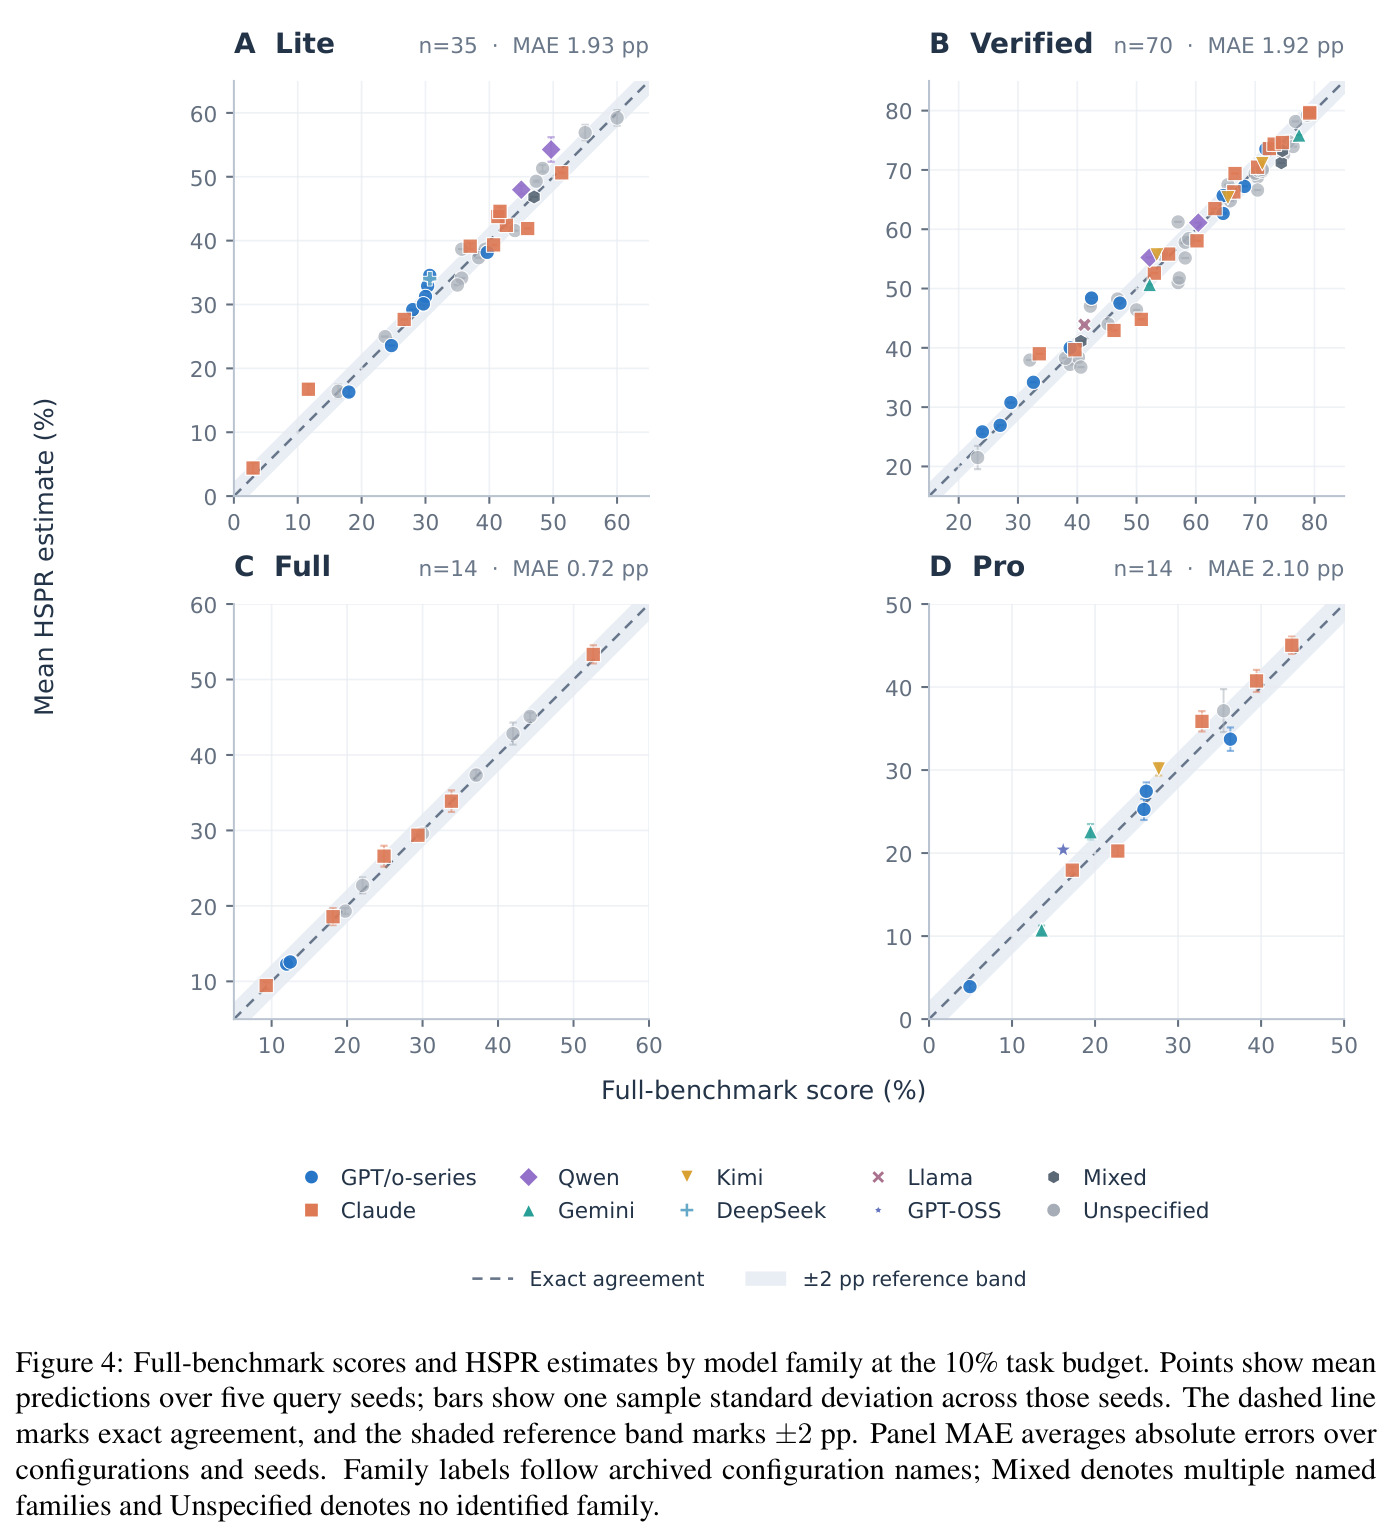
主实验在 SWE-bench 四库 Lite/Verified/Full/Pro(300/500/2294/730 题)上以 10% 预算对比 8 个方法。HSPR 在 Lite/Full/Pro 取最低 MAE(1.927/0.717/2.098 pp),Verified 1.915 pp 距最优 ATLAS-port(1.861)仅 0.055 pp;四库 MaxErr 全部最低(5.683/6.000/2.638/4.601 pp),12 项指标全进前二、8 项第一。宏 MAE 1.664 对最强基线 PTA-IRT 2.478 pp。消融:去组不确定性升至 1.808(Full 0.717→1.331);去自适应查询升至 3.085/2.934 pp;中位数换均值仅 1.674。机制上,Full 平均组 8.32 题、源零任务占 41.3%,层次建模让其拿到 13.2% 查询(无层次 0.19%);Verified 平均组仅 1.17 题。5–20% 预算下宏 MAE 从 2.562 降至 1.262 pp;统计检验支持对 RSL/Stratified 的显著优势。
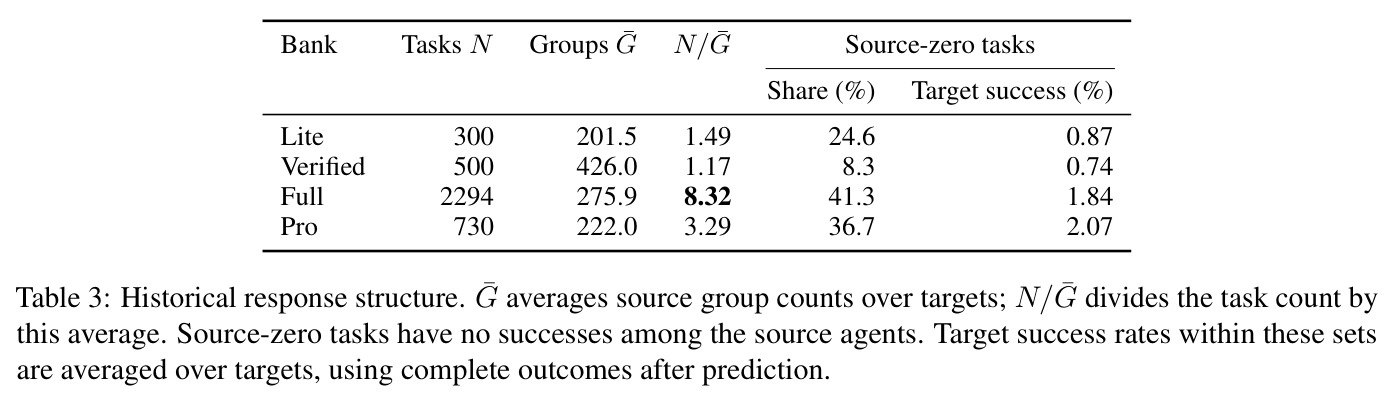
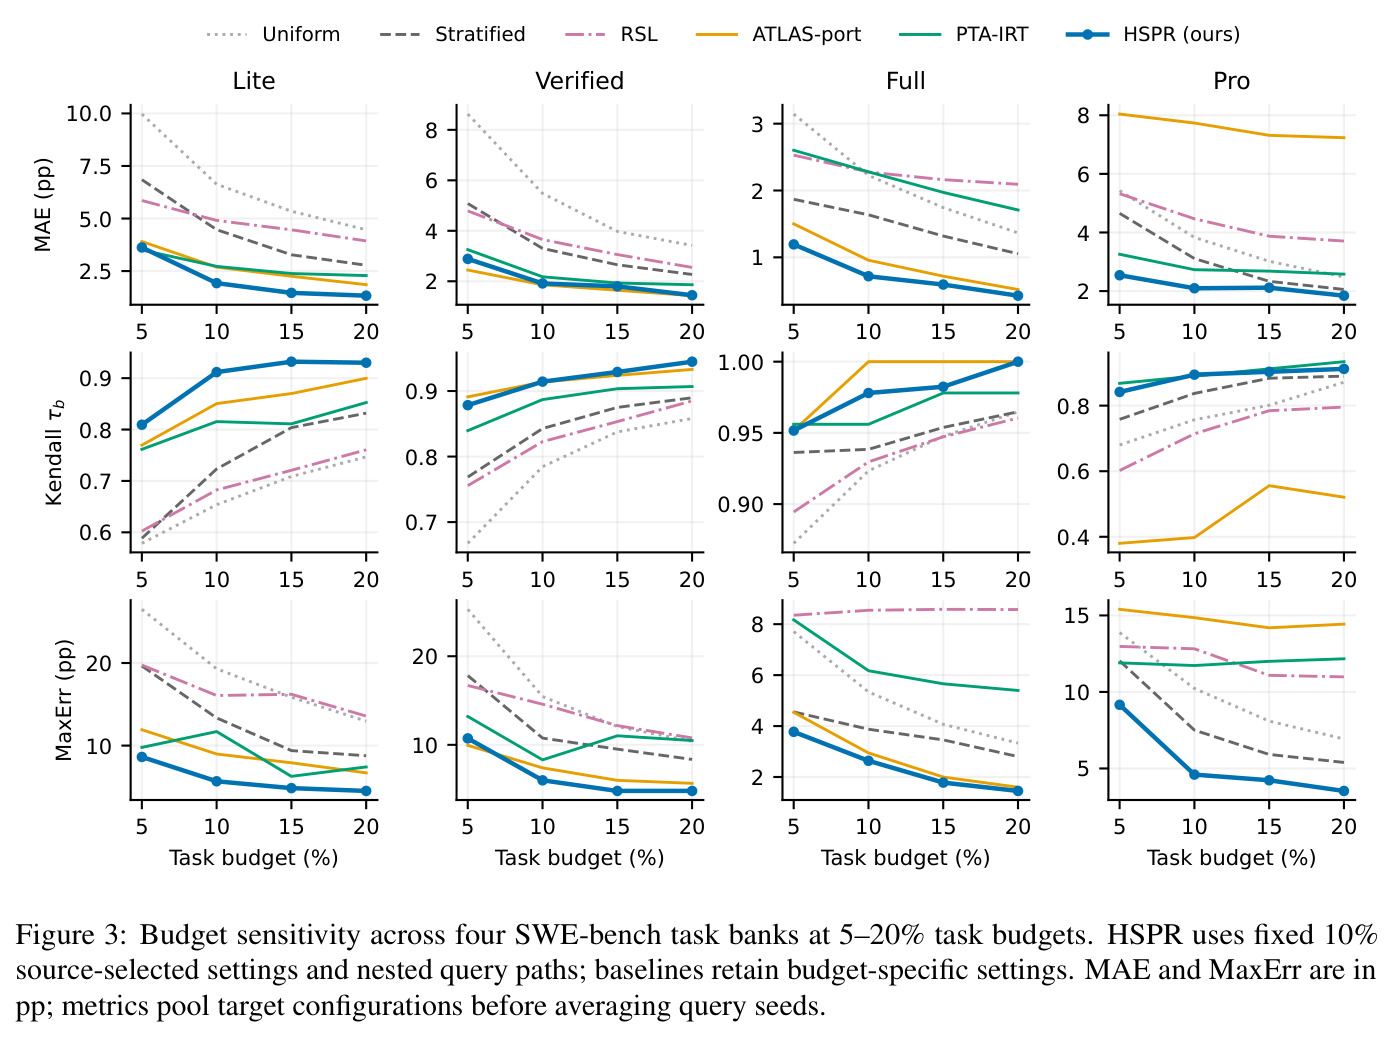
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-bench Lite 子集分数恢复(10% 预算,30/300 题) | MAE (pp) | 1.927 | ATLAS-port 2.689(次优) | 降低 0.762 pp(约 28%),MaxErr 5.683 亦为全场最低 |
| SWE-bench Verified(10% 预算,50/500 题) | MAE (pp) | 1.915 | ATLAS-port 1.861(最优) | 次优,差距仅 0.055 pp;但 MaxErr 6.000 优于 ATLAS-port 的 7.406 |
| SWE-bench Full(10% 预算,229/2294 题) | MAE (pp) | 0.717 | ATLAS-port 0.957 | 降低 0.240 pp(约 25%);MaxErr 2.638 亦最低(ATLAS-port 2.945) |
| SWE-bench Pro(10% 预算,73/730 题) | MAE (pp) | 2.098 | PTA-IRT 2.731 / ATLAS-port 7.736 | 对次优 PTA-IRT 降低 0.633 pp,对 ATLAS-port 降低 5.638 pp(约 73%) |
| 四任务库等权宏平均(10% 预算) | 宏 MAE (pp) | 1.664 | PTA-IRT 2.478(最强聚合基线) | 降低 0.814 pp(约 33%);5–20% 预算下宏 MAE 从 2.562 降至 1.262 |
局限与改进
作者承认的局限:实验仅覆盖 SWE-bench 家族四个任务库,对模型家族或智能体脚手架发生大幅分布漂移时的泛化未验证;响应因子与签名组完全依赖历史源库的覆盖面,源库代表不了新目标时,恢复出的分数仍可能误导模型比较(作者建议明确区分'恢复分数'与'全量实测分数'并报告预算口径);后验不确定性以组内可交换性等响应模型假设为条件;预算按'不同任务执行次数'计,token、时间与费用节省取决于单任务成本,且历史数据采集、源拟合与配置筛选本身有额外开销。我的补充观察:Verified 上平均组大小仅 1.17(426 组/500 题),层次共享空间有限,方法收益强依赖'大签名组'的存在,这在组结构稀疏的新基准上可能失效;校准只有 $\lambda\in\{0,.5\}$ 两档,较为粗糙;正文未提及开源代码,基线又多为移植版(如 ATLAS-port、FAQ-port),横向对比的保真度取决于移植质量。
独立分析的弱点
独立分析四点弱点。(1) 组内可交换性是强假设:签名只编码 0/1 响应行,忽略仓库、文件路径、测试类型等元信息,大组(如 Full 上平均 8.32 题/组)内部可能存在隐藏异质,均匀抽样会浪费查询——改进方向是把组内交换先验换成带协变量的 Beta 回归,或在组内按预测难度排序抽样。(2) 采集准则只看方差缩减、不看执行成本:不同任务运行时间可差几个数量级,可引入成本加权准则(期望方差缩减/预期运行时间),逼近单位成本下的最优信息获取。(3) 推断用高斯提议的重要性采样,在 $1+r$ 维上可行,但组数 $G$ 大时每步逐组更新与重采样的评估器开销需要关注(附录 G 有报告),可换 Laplace 近似、变分推断或并行化预测计数采样。(4) 校准项 $R_B$ 是启发式插值、$\lambda$ 只有两档,且校准复用了推断所用的同一批观测,存在轻度自拟合风险;可改用共形预测或源内学习的收缩系数,输出带覆盖率保证的分数区间。
未来方向
作者指出的方向之外,基于本文成果还有很大延伸空间。作者提出的:跨模型家族/脚手架漂移下的泛化评估,以及把任务数预算换算成 token、时间与费用节省的实测。可延伸的:(1) 融合轨迹信息——PTA-IRT 已利用历史轨迹,而 HSPR 只用最终 0/1 结果,把执行轨迹嵌入残差因子有望改善冷启动目标的初始预测;(2) 在线持续评测:新智能体不断到来时,把每个目标的查询结果回流为新源数据行,滚动更新项目参数与签名组,形成自我增强的评测基础设施;(3) 跨库迁移:用同一目标在 Lite 上的少量结果预热 Full/Pro 的后验,检验层次结构能否跨任务库共享;(4) 与 EarlyEval 式的早期结果预测结合,在任务内部提前停止执行,进一步压缩单任务成本;(5) 推广到 SWE-bench 之外的智能体基准(Web、OS、多轮对话),检验'签名组'结构在不同任务空间上的普适性,并研究自适应测试与基准污染检测的结合。
复现评估
复现可行性中等偏上。数据:四个任务库的响应矩阵来自公开的 PTA-IRT 发布物(Duan et al., 2026),Lite/Verified/Full/Pro 分别为 300/500/2294/730 题、35/70/14/14 个配置,历史数据无需重跑智能体;评测为存档回放,预算指揭示不同目标任务结果的次数,实验协议明确(4 折配置级划分、源与目标配置不相交、每目标 5 个种子,采样类基线 10 个种子)。方法细节:附录 A 给出初始化、缩放与配置网格($r$、$P$、$\kappa$、$\rho$、$\lambda$),附录 B 推导方差恒等式,附录 D 给出自助区间与校正检验,附录 E 验证重要性采样数值正确性,附录 G 报告评估器开销,可对照的基线包括 RSL、FAQ-port、ATLAS-port、PTA-IRT 等。算力:推断是 CPU 级重要性采样,无模型训练,门槛很低。风险点:正文未给出开源代码链接,从公式到实现仍有细节要自行补齐(如辅助 logistic-normal MAP 提议的构造、分阶段源内验证的搜索顺序),初次复现预计需要数天工程量。
论文图表
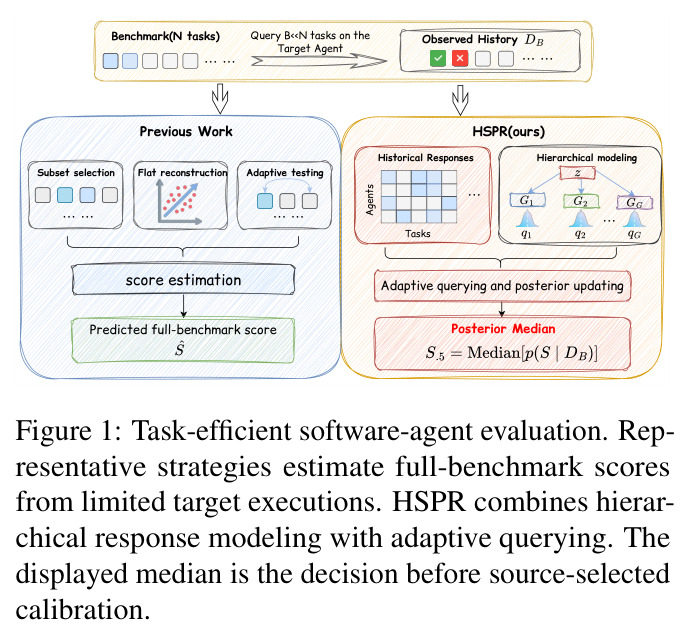
概念对比图:左侧展示历史响应 $D_B$ 与智能体先前工作,右侧展示目标智能体在 $N$ 个任务上的观测历史;中间对比两类代表策略——子集选择 + 平坦重建,与 HSPR 的层次建模 + 自适应查询和后验更新,并标出源拟合响应因子(组 $G_1,\dots,G_G$ 的 $q_1,\dots,q_G$)、目标潜在状态 $z$ 与最终预测的全基准分数 $\hat{S}$(后验中位数 $S_{.5}=\mathrm{Median}[p(S\mid D_B)]$)。
一张图看懂论文要解决的问题(花小预算估准全分)以及 HSPR 相对已有策略的位置差异,是最适合导读全文的总览图。