IF-MAP:影响函数启发的多智能体系统智能体优先级排序方法 IF-MAP: Influence-Function-Inspired Agent Prioritization in Multi-Agent Systems
用语义扰动探测各智能体对系统损失的局部响应强度,找出最值得优先改进的智能体
前置知识
影响函数(Influence Functions)
经典统计工具(Koh & Liang, 2017),用一阶近似估计『扰动训练数据中的某个样本会如何改变学到的模型及其预测』,核心是扰动—响应的局部线性化视角,通常需要访问模型参数、梯度或 Hessian 矩阵。
IF-MAP 只借用其『扰动—响应』思想而不计算经典影响:把训练数据换成智能体提示词,把模型预测换成端到端系统损失。理解影响函数才能明白为什么局部响应向量的范数可以作为改进潜力的分数。
LLM 多智能体系统与失败归因
多个基于 LLM 的智能体按固定工作流分工(生成、检索、协调、验证)共同完成复杂任务。失败归因方法(如 Who&When、A2P、CHIEF、FAMAS)从执行轨迹中定位导致任务失败的智能体或步骤,输出的是『事后责任』。
本文的出发点正是:责任大小 ≠ 改进潜力。文中所有对比基线都是失败归因/调试方法被改造成智能体排序器,理解这一范式才能看懂 IF-MAP 的差异化定位和实验对比设计。
文本嵌入与语义扰动
嵌入模型把文本映射为向量(本文用 Qwen3-Embedding-8B,512 维,L2 归一化),语义相近的文本向量距离近。语义扰动指在保留智能体角色和输出接口的前提下改写提示词(如澄清歧义、精化指令),扰动大小用嵌入空间位移 $\|v\|_2$ 度量。
IF-MAP 的全部证据来自『提示词扰动→系统损失变化』的配对,并把扰动表示为嵌入空间的方向 $u$ 与归一化响应 $y$。嵌入几何是整个评分的度量基础,不懂嵌入就无法理解 G-norm。
岭回归与 SVD 低维子空间
岭回归求解 $\hat{\beta} = (Z^\top Z + \lambda I)^{-1} Z^\top y$,通过 $\lambda$ 惩罚抑制不稳定的大系数。当样本数远小于特征维度时,先对居中后的方向矩阵做奇异值分解(SVD),只在其主子空间(正交基 $Q$)内回归,再把系数映射回原空间。
IF-MAP 每个智能体最多只有约 10 个探测样本,而嵌入有 512 维,必须依赖 SVD 子空间 + 岭回归($\lambda=1.0$)才能稳定估计局部响应向量 $\hat{g}_i$,这是方法可用的数学前提。
Kendall $\tau_b$ 秩相关系数
度量两个排序一致性的统计量,取值 $[-1, 1]$,能正确处理并列(tie):值越高说明两个排序越一致。本文用它比较『优先级分数排序』与『实测改进增益排序』。
论文用选定增益(只看第一名选得准不准)和 Kendall $\tau_b$(看整个排序准不准)双重评价选择器,这是解读所有结果表的关键指标;注意 2 节点工作流 DROP 的 Kendall 天然容易到 1.0。
TextGrad/ProTeGi 式提示词优化
用 LLM 生成文本反馈来迭代改写提示词的自动优化方法:给优化器看原始提示词、失败/成功样例和方向描述,生成多个候选改写,在开发集上评估并按接受规则保留更优者。
提示词优化是论文用来验证优先级的两条真实干预路线之一。所有选择器共用同一优化器和接受规则,保证比较公平;IF-MAP 只优化排第一的智能体,从而节省约 74% 的 token。
研究动机
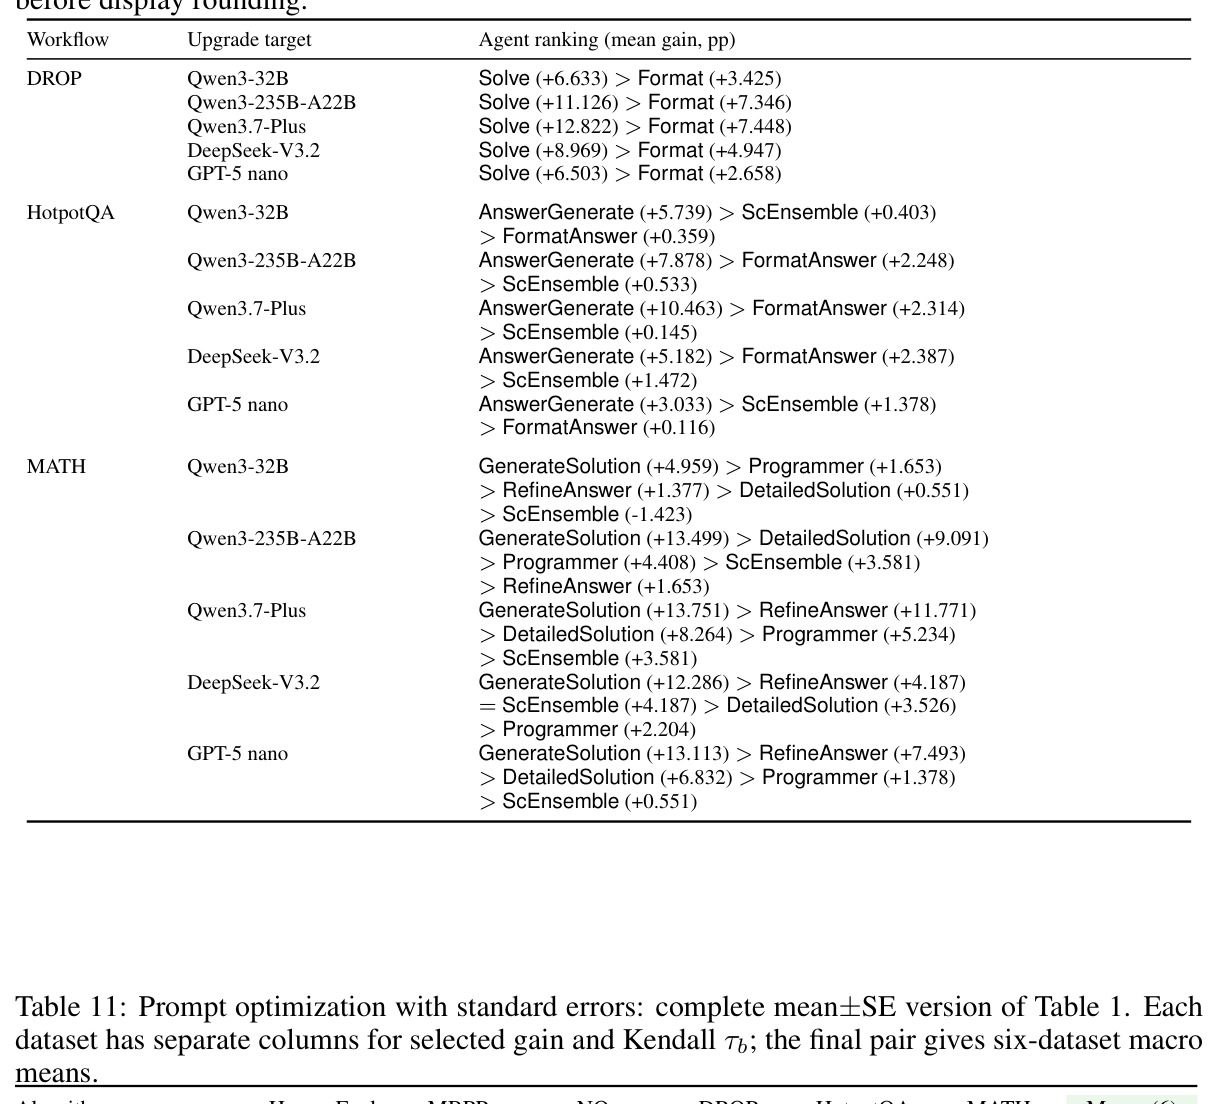
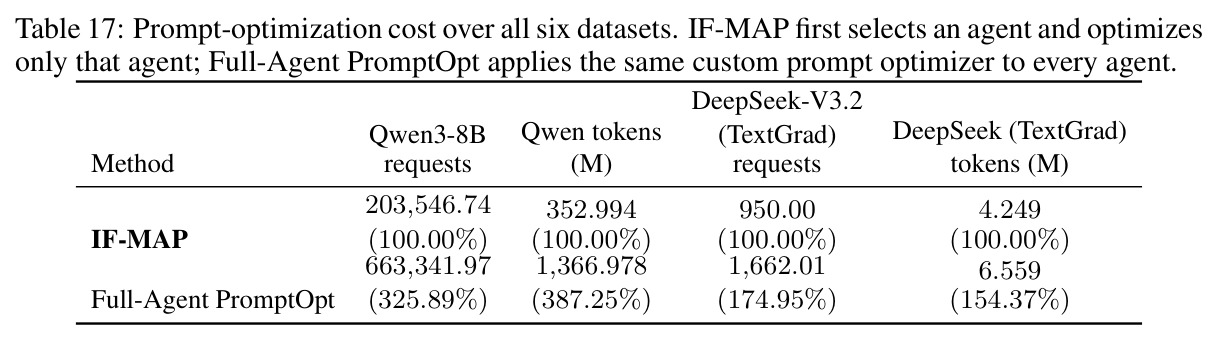
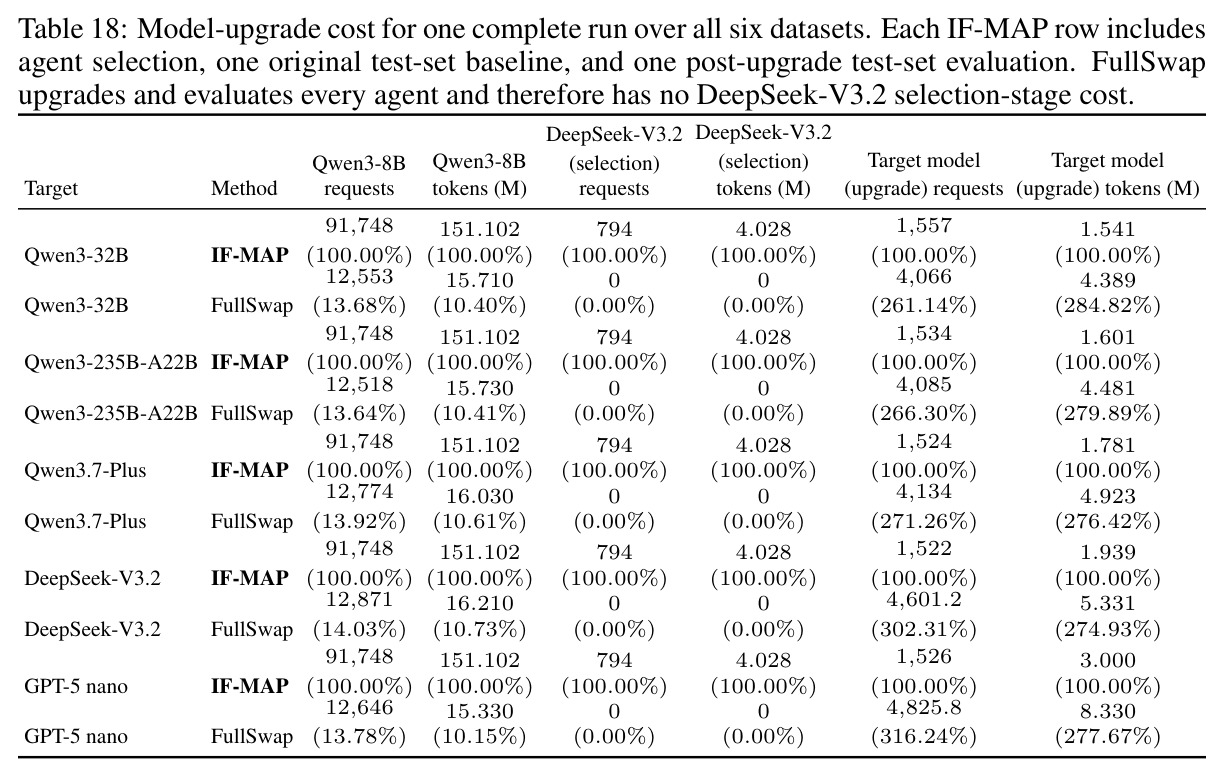
LLM 多智能体系统把复杂任务分给专门化智能体,其性能既取决于单个智能体的能力,也取决于它们之间的交互方式。改进手段很多——换成更强的模型、微调、精修提示词、改进工具——但对不同智能体的收益并不相同:例如问答工作流里精修答案生成智能体的提示词可能提升整体准确率,而精修负责合并候选答案的智能体可能收益甚微甚至降低准确率。在算力、评测预算与部署资源受限时,改进所有智能体往往不可行:把每个智能体都升级为更强模型会大幅抬高每次工作流执行的推理成本。本文的实测数据很直观:对全部智能体跑同一套提示词优化器需要约 13.67 亿 Qwen3-8B token,而只优化一个选定智能体仅需约 3.53 亿;把所有智能体都升级为目标模型,目标模型 token 是只升级一个智能体的 2.75–2.85 倍。已有的失败归因方法(Who&When、A2P、AgentRx、CHIEF、FAMAS 等)只能指出谁对失败负有责任,但责任不等于改进潜力:一个频繁出错却已无提升空间的智能体,可能不如一个很少被追责、稍加修改就能大幅改善下游表现的智能体;论文引用 CICA 的结论——责任最大的模块未必是修复后收益最大的模块。
本文的目标是本文提出并形式化『智能体优先级排序』(agent prioritization)问题:给定一个固定的多智能体系统 $\mathcal{W}$($n$ 个智能体,固定角色、连接与模型分配),在有限改进预算下,找出哪个智能体的改进能带来最大的端到端性能增益。形式化地,设 $\mathcal{A}_i$ 为施加在智能体 $i$ 上的改进算子(改提示词、升级模型或微调),其期望效用为 $U_i = \mathbb{E}_{x,\xi}[\ell(\mathcal{W},x) - \ell(\mathcal{A}_i(\mathcal{W};\xi),x)]$,其中 $\ell = 1 - s$ 是任务损失。目标是构造黑盒评分 $S_i$,选 $\hat{\imath} \in \arg\max_i S_i$,在不为每个候选完整执行改进流程的前提下让 $\hat{U}_{\hat{\imath}}$ 尽量大。作者用两条真实的下游干预来检验优先级的有用性:基于文本反馈的提示词优化,以及把选定智能体的模型升级为五个更强的目标模型之一;同时以『不改进(零增益)』『均匀随机选』『事后最优』为参照,用选定增益和 Kendall $\tau_b$ 排序一致性做双重评估。
与已有工作不同的是,本文的独特切入是把『事后追责』变成『前瞻性改进潜力估计』。此前所有定位类工作(Who&When-AAO、A2P、locator、AgentRx、CHIEF、FAMAS)都从失败轨迹出发做归因,回答的是『谁错了』;而开发者真正要回答的是『改谁最划算』,这两个量在原则上就不同——作者引用 DoVer 与 CICA 说明干预验证的重要性:被归因最多的模块修复后收益未必最大。作者从经典影响函数(Koh & Liang, 2017)借来『扰动—响应』视角,但完全不需要模型参数、梯度或 Hessian:把每个智能体的提示词当作可主动干预的输入,施加受控的语义扰动,测量扰动效应沿整个工作流传播后的端到端损失变化,再从黑盒执行记录和提示词嵌入中拟合局部响应模型。这使评分天然包含智能体间交互效应(下游传播),而非只看该智能体自身的中间行为,弥补了归因方法只看局部过错的盲区。
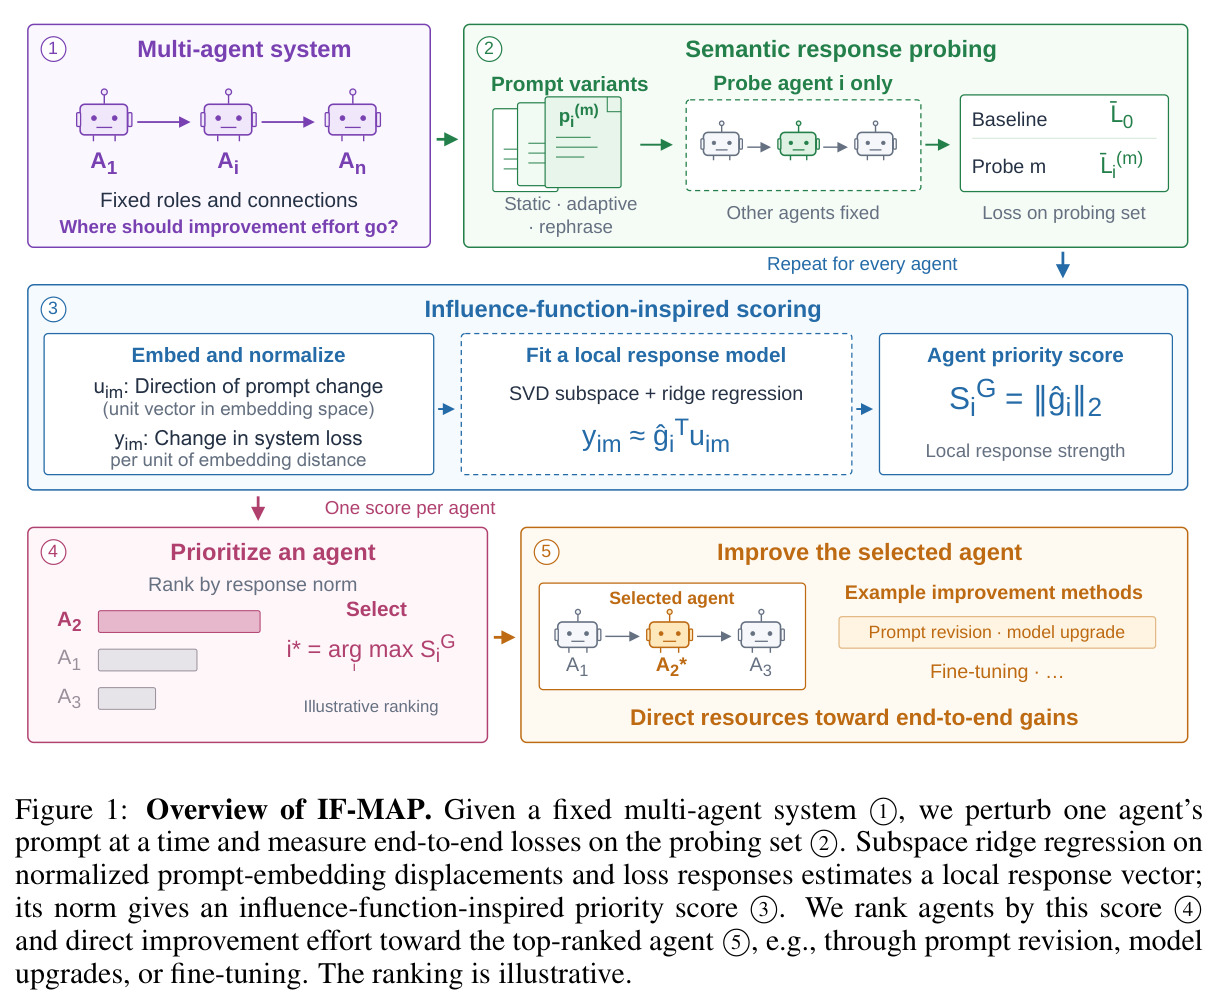
核心方法
直觉上,IF-MAP 把每个智能体看作系统损失函数的一个『输入旋钮』:在提示词嵌入空间里给这个旋钮一个小的语义扰动,观察端到端损失如何变化;若损失对扰动方向的一阶敏感度(局部斜率)陡峭,说明改进该智能体的收益上限更大。技术路线分五步(对应 Figure 1):第一步,逐个智能体构造至多 10 个语义提示词扰动,每次只改该智能体的提示词,其余智能体的提示词、所有模型与工作流结构全部固定,在整个工作流上测量探测集的平均损失,得到端到端响应;第二步,用 Qwen3-Embedding-8B 把提示词映射为 L2 归一化向量,把每次探测表示为嵌入位移方向 $u_i^{(m)}$ 与单位嵌入距离下的损失变化 $y_i^{(m)}$;第三步,在探测方向张成的 SVD 低维子空间内做岭回归,拟合局部响应向量 $\hat{g}_i$;第四步,以响应范数 $S_i^G = \|\hat{g}_i\|_2$ 作为优先级分数并对所有智能体排序;第五步,把真实改进(TextGrad 式提示词优化或模型升级)只施加给最高分智能体,在冻结的测试集上验证收益。整个过程是纯黑盒的:只需工作流执行与提示词嵌入,无需参数、梯度或 Hessian。
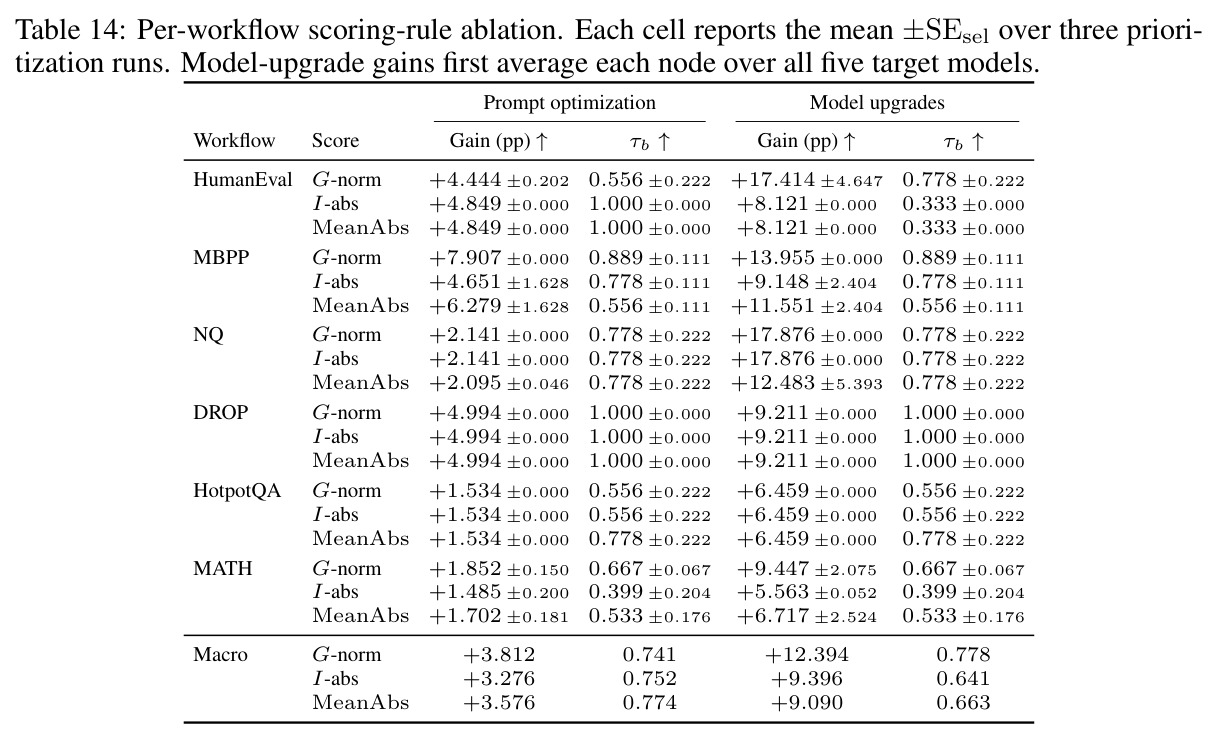
核心创新是几何感知的局部响应评分 G-norm,而非失败归因、也非简单的响应幅度统计。与 I-abs(最大绝对响应)和 MeanAbs(平均绝对响应)等只看响应大小的消融基线不同,G-norm 同时利用扰动的嵌入方向与位移大小:把各探测的单位方向 $u_i^{(m)}$ 与归一化响应 $y_i^{(m)}$ 拟合成线性模型 $y \approx \hat{g}_i^\top u$,向量 $\hat{g}_i$ 是估计的局部坡度,指明哪些方向增损、哪些方向减损以及强度如何。由 Cauchy–Schwarz 不等式,在共同干预半径 $r$ 下,模型隐含的最大干预机会为 $\hat{U}_i(r) = \max_{\|\delta\|_2 \le r} -\hat{g}_i^\top \delta = r\|\hat{g}_i\|_2$,最优方向在 $\delta_i^* = -r\hat{g}_i / \|\hat{g}_i\|_2$ 处取得,因此按 G-norm 排序等价于按『拟合子空间内可预测的最大一阶损失下降』排序。这把影响函数的局部近似思想从训练数据层面迁移到智能体提示词层面,并让分数与真实干预(提示词优化、模型升级)之间建立起可检验的联系。
方法步骤详情
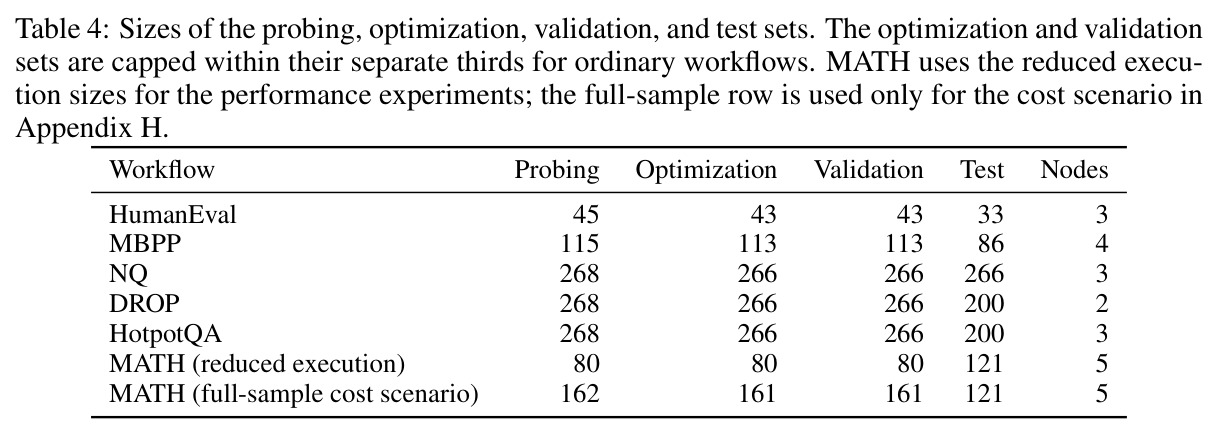
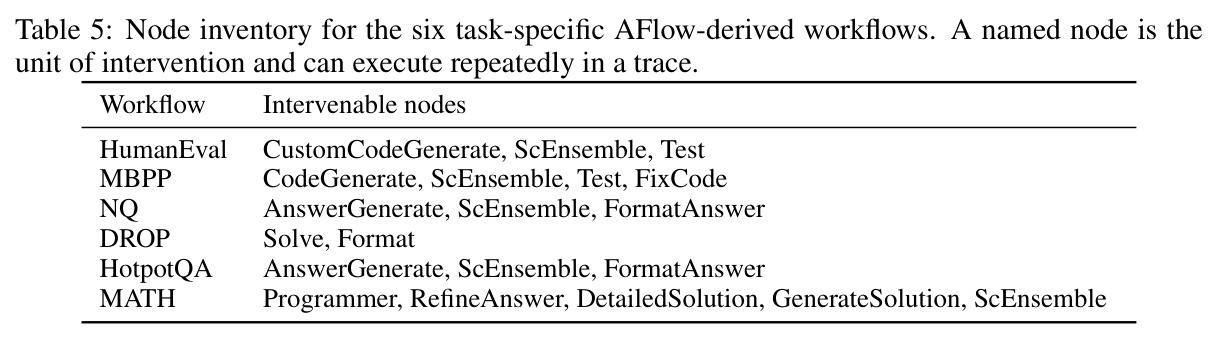
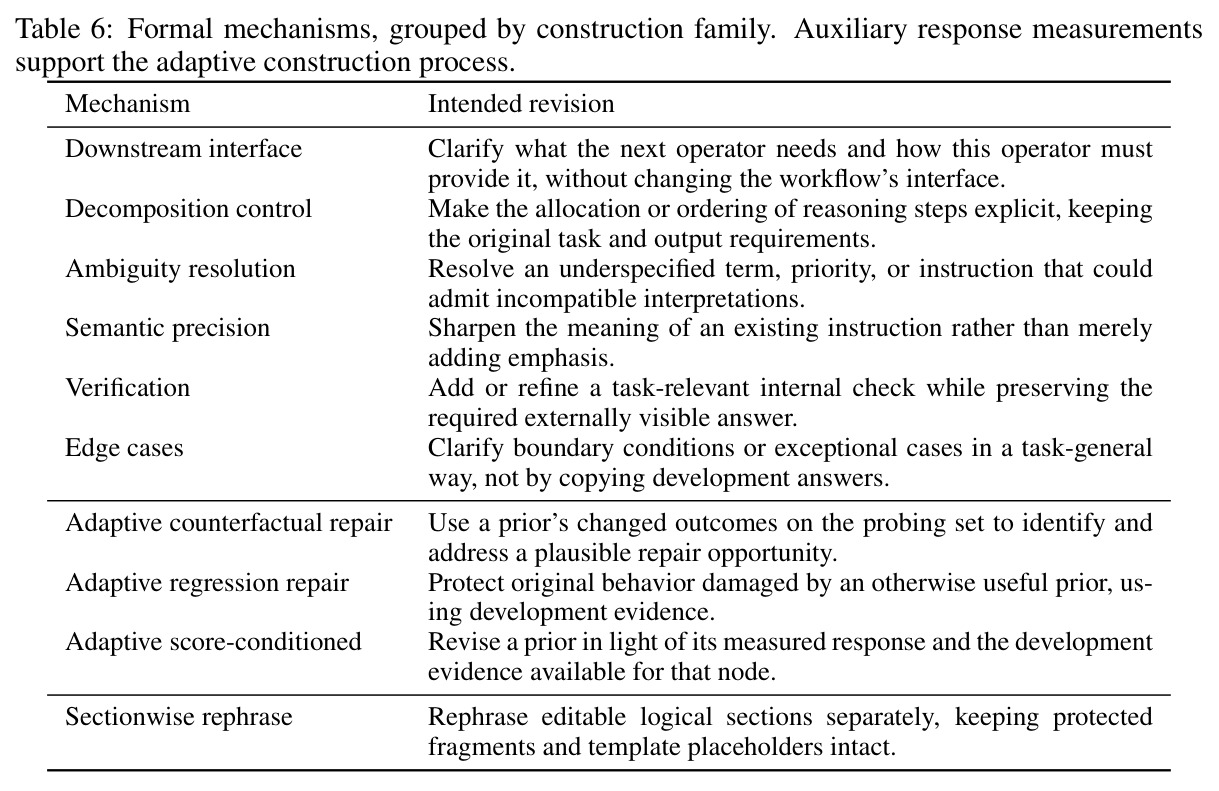
完整流程如下。(1) 数据划分:把 AFlow 基准的开发集切成探测/优化/验证/测试四份(HumanEval 为 45/43/43/33,NQ 为 268/266/266/266,MATH 探测集用 80 例,种子 42)。(2) 构造扰动:每个智能体最多 10 个正式扰动,涵盖六类静态机制(下游接口澄清、分解控制、歧义消解、语义精化、内部验证、边界情况)、逐节改写,以及三类自适应机制(反事实修复、回归修复、分数条件修订;自适应候选从最多 36 个辅助候选中筛出,辅助评估只做一次)。(3) 探测:每次只改智能体 $i$ 的提示词,跑完整工作流,计算符号效应 $\Delta_{im} = \bar{L}_0 - \bar{L}_i^{(m)}$,正值表示改善。(4) 表示:位移 $v_{im} = E(p_i^{(m)}) - E(p_i)$,方向 $u_{im} = v_{im}/\|v_{im}\|_2$,归一化响应 $y_{im} = (\bar{L}_i^{(m)} - \bar{L}_0)/\|v_{im}\|_2$;嵌入用 512 维 Qwen3-Embedding-8B,剔除近零位移。(5) 拟合:对居中后的方向矩阵做 SVD 得正交基 $Q_i$,令 $Z_i = V_i Q_i$,岭回归 $\hat{\beta}_i = (Z_i^\top Z_i + \lambda I)^{-1} Z_i^\top y_i$($\lambda = 1.0$),映射回原空间 $\hat{g}_i = Q_i \hat{\beta}_i$,分数 $S_i^G = \|\hat{g}_i\|_2$,子空间维度默认 $\max(1, M_i - 1)$。(6) 干预与评估:只对最高分智能体做共享的 TextGrad 式提示词优化(按探测方向排序逐条尝试,DeepSeek-V3.2 每轮生成 4 个候选,最多 6 次接受更新,带优化/验证集双阈值接受规则),或保持原提示词仅升级模型;每个选择器独立运行 3 次,每个智能体的干预运行 5 次,最终配置冻结后在测试集评估。
技术新颖性
新颖性体现在四个层面。问题层面:首次把『在固定多智能体系统中选哪个智能体改进』形式化为独立于失败归因的决策问题,并用真实干预收益(而非归因准确率)作为评价标准,填补了归因研究与系统优化之间的空白。方法层面:影响函数只借其『扰动—响应』思想,估计完全来自黑盒工作流执行与提示词嵌入,不碰参数、梯度或 Hessian;响应测量是端到端的,扰动效应沿下游工作流传播,天然编码智能体间交互——这是与只看单智能体过错的归因方法的本质区别。统计层面:在探测数(约 10)远小于嵌入维度(512)的极端欠定情形下,用居中方向矩阵的 SVD 子空间加岭回归稳定估计响应向量,范数分数具有 Cauchy–Schwarz 意义下的一阶最优干预解释,且与只看幅度的 I-abs/MeanAbs 形成可控消融。系统层面:同一套由提示词探测得到的优先级无需针对目标模型重新计算,就能在提示词优化与五个强度不同的模型升级之间迁移,实验显示升级收益达均匀选择的 1.86–2.05 倍,证明探测识别的是智能体层面的『杠杆』而非特定干预的偶然信号。
实验结果
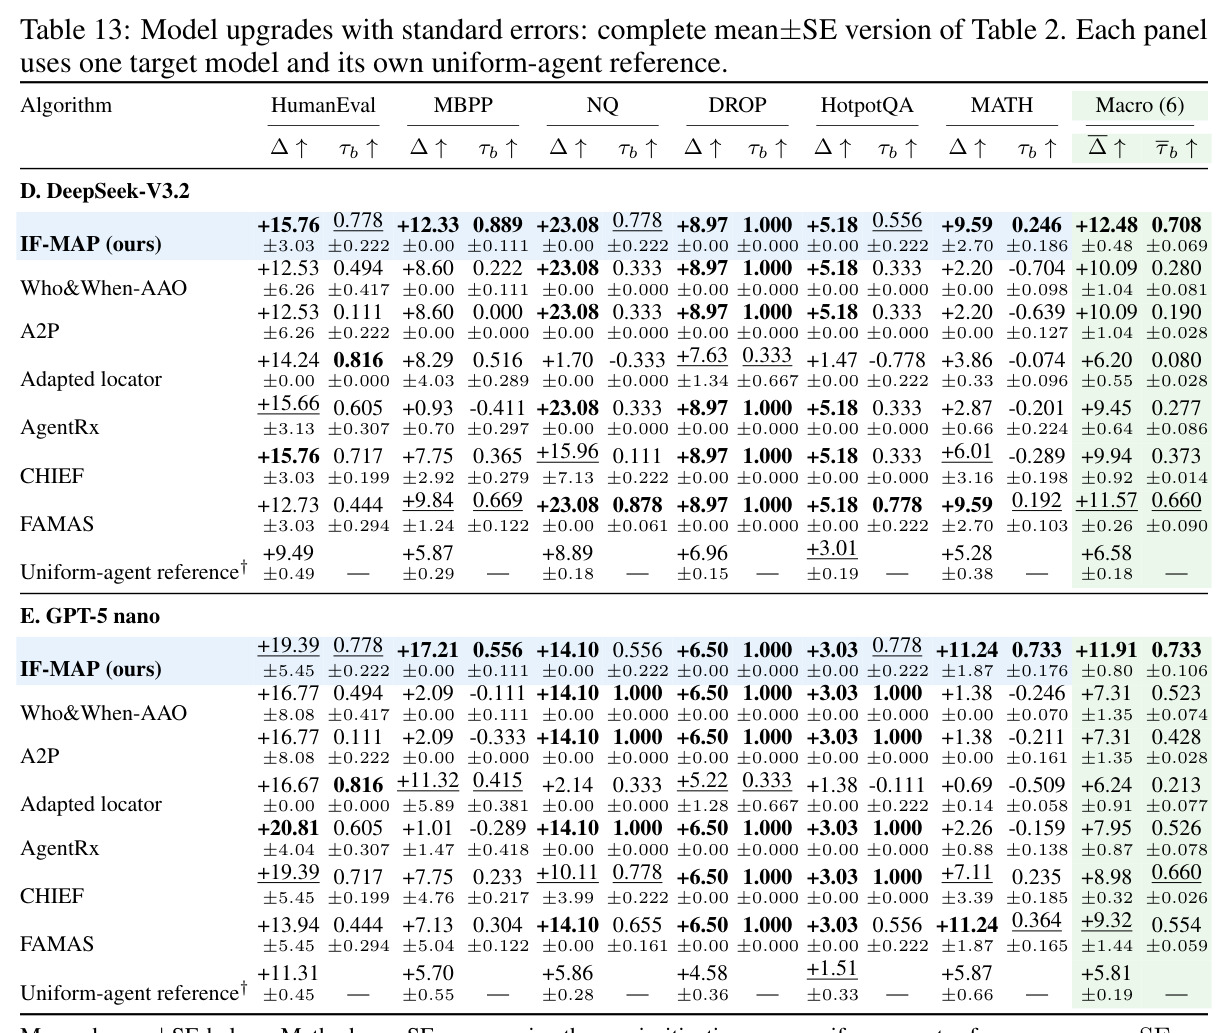
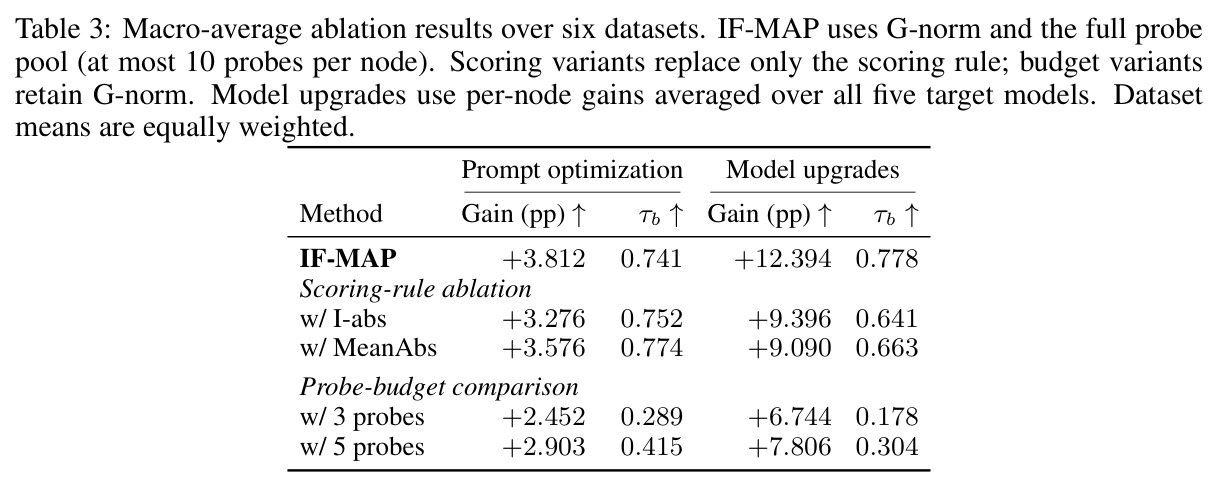
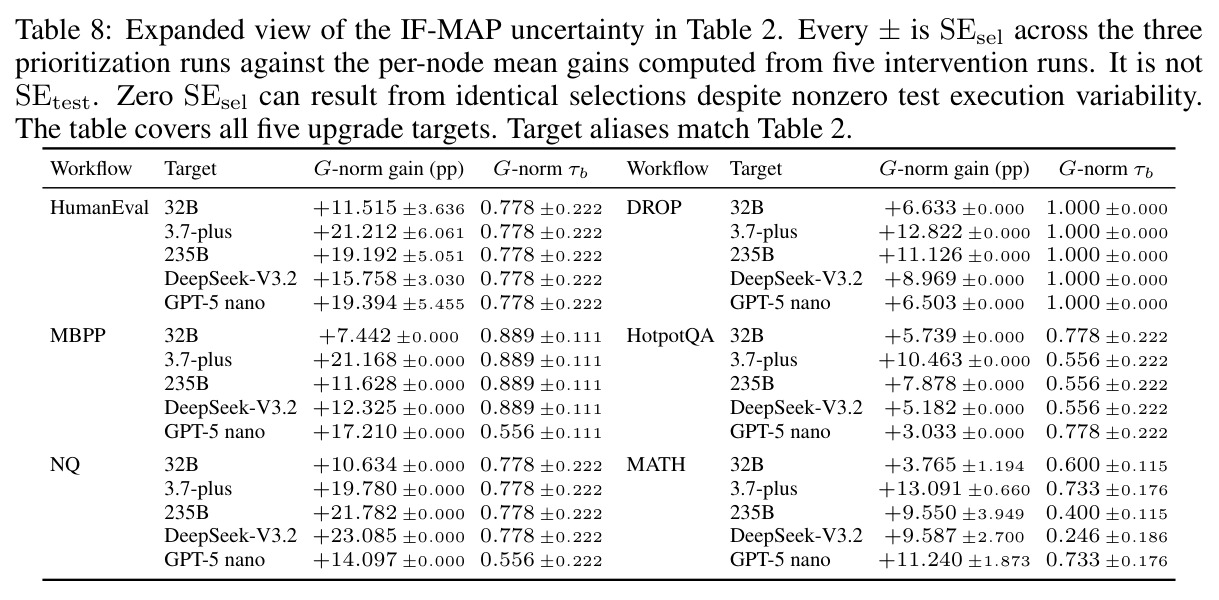
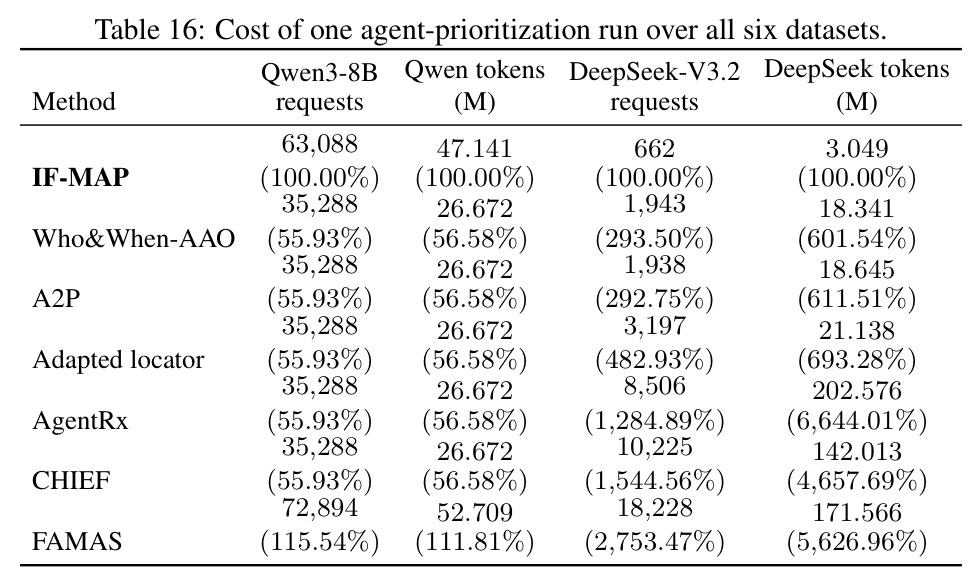
实验覆盖六个 AFlow 派生工作流(HumanEval、MBPP 代码生成;NQ、HotpotQA、DROP 问答;MATH 数学推理),工作流执行用 Qwen3-8B,提示词操作用 DeepSeek-V3.2。提示词优化(Table 1):IF-MAP 宏平均选定增益 3.81 个百分点(pp),比均匀选择参考(1.85 pp)高 1.96 pp,比最强外部基线 FAMAS(3.30 pp)高 0.51 pp;在全部六个工作流上超过均匀参考,MBPP(+5.06 pp)与 DROP(+3.01 pp)优势最大;平均 Kendall $\tau_b$ 0.741 全场最高(FAMAS 0.710),说明不只第一名选得准,整体排序也更好。模型升级(Table 2):五个目标模型(Qwen3-32B、Qwen3-235B-A22B-Instruct-2507、Qwen3.7-Plus、DeepSeek-V3.2、GPT-5 nano)上宏平均增益 7.62–16.42 pp,均匀参考仅 3.81–8.62 pp,达到均匀选择的 1.86–2.05 倍;三个展示面板(Qwen 三目标均值/DeepSeek/GPT-5 nano)分别为 12.52、12.48、11.91 pp,且分别超过最强外部基线 1.45、0.91、2.59 pp,Kendall $\tau_b$ 0.775、0.708、0.733 均为面板最高;同一套优先级跨五个目标复用,说明识别的是跨模型迁移的杠杆。消融(Table 3):G-norm 增益最优(提示词 3.812 pp / 升级 12.394 pp),优于 I-abs(3.276/9.396)与 MeanAbs(3.576/9.090);探测预算 3→5→10 使提示词增益从 2.452→2.903→3.812 pp、Kendall 从 0.289→0.415→0.741,升级增益从 6.744→7.806→12.394 pp,说明五个探测的方向覆盖不足。成本分析:探测阶段只用归因基线 3.6–34.1% 的 DeepSeek 请求与 1.5–16.6% 的 DeepSeek token(AgentRx 需 202.58M 诊断 token,约为 IF-MAP 3.05M 的 66 倍);下游只需全智能体优化的 30.69% Qwen 请求、25.82% Qwen token(省 74.2%)与 64.78% DeepSeek token(省 35.2%);模型升级只调用 FullSwap 的 35.1–36.4% 目标模型 token(省 63.6–64.9%)、31.6–38.4% 的目标模型请求。
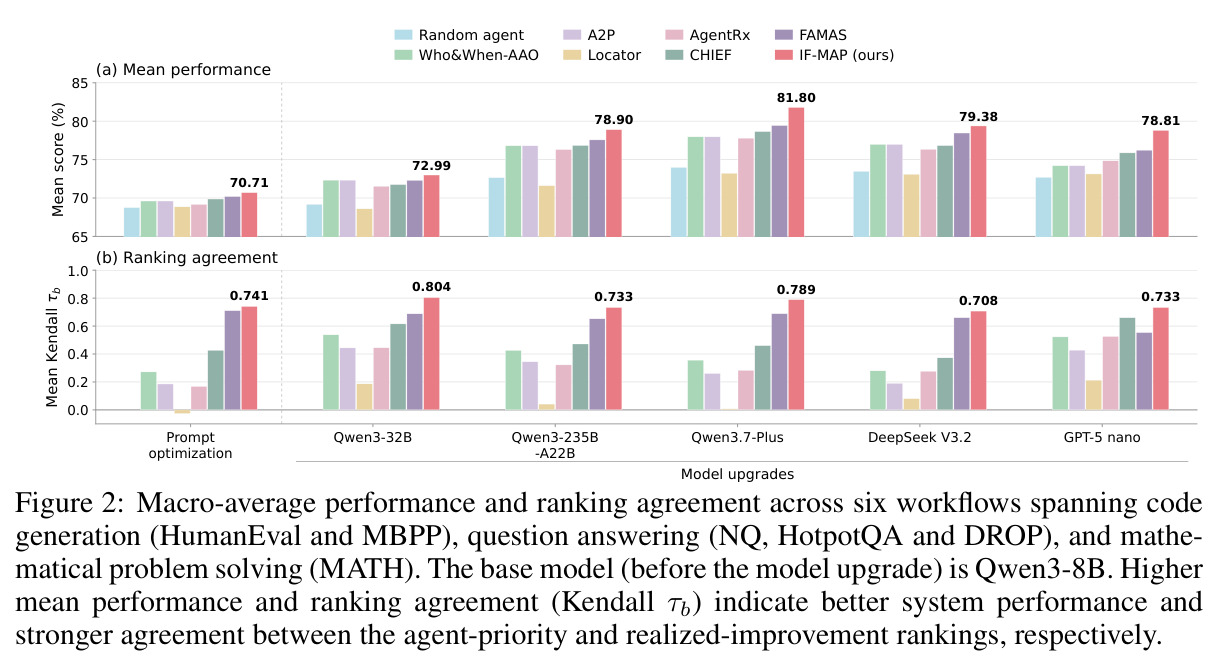
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 提示词优化:六工作流宏平均选定增益 | 选定增益 Δ (pp) | 3.81(IF-MAP) | 均匀选择参考 1.85;最强外部基线 FAMAS 3.30 | 较均匀 +1.96 pp,较 FAMAS +0.51 pp,六个工作流全部超过均匀参考 |
| 模型升级:Qwen3-32B/235B-A22B/Qwen3.7-Plus 三目标均值 | 宏平均选定增益 (pp) | 12.52 | 均匀选择参考 6.57;最强外部基线 11.07(FAMAS) | 较均匀 +5.95 pp(约 1.91 倍),较最强基线 +1.45 pp |
| 模型升级:DeepSeek-V3.2 | 宏平均选定增益 (pp) | 12.48 | 均匀选择参考 6.58;最强外部基线 11.57(FAMAS) | 较均匀 +5.90 pp(约 1.90 倍),较最强基线 +0.91 pp |
| 模型升级:GPT-5 nano | 宏平均选定增益 (pp) | 11.91 | 均匀选择参考 5.81;最强外部基线 9.32(FAMAS) | 较均匀 +6.10 pp(约 2.05 倍),较最强基线 +2.59 pp |
| 排序一致性(提示词优化,六工作流宏平均) | 平均 Kendall τ_b | 0.741 | FAMAS 0.710;其余基线 0.169–0.427 | 全场最高,比最强基线高 0.031 |
| 下游提示词优化成本(六数据集) | 相对全智能体优化的用量 | Qwen 请求 30.69%、Qwen token 25.82%、DeepSeek 请求 57.16%、DeepSeek token 64.78%(IF-MAP=100% 基准下全量优化为 325.89%/387.25%/174.95%/154.37%) | 对每个智能体都跑同一优化器(Full-Agent PromptOpt) | Qwen token 省 74.2%,DeepSeek token 省 35.2% |
| 模型升级成本(六数据集,五个目标) | 目标模型 token 相对 FullSwap | 1.0(IF-MAP 含选择开销) | FullSwap(升级所有智能体)目标模型 token 为 IF-MAP 的 2.75–2.85 倍、请求为 2.61–3.16 倍 | 目标模型 token 省 63.6–64.9% |
局限与改进
作者承认的局限:实际收益取决于嵌入模型的选择、局部线性假设是否成立、探测覆盖度,以及可用干预与拟合出的减损方向之间的对齐程度;语义探测需要在 Qwen3-8B 上为每个扰动执行完整工作流,探测本身的请求与 token 开销高于多数归因基线(一次六数据集优先级排序需 63,088 次 Qwen 请求、47.14M token,而 Who&When 等仅 35,288 次/26.67M token,FAMAS 更达 72,894 次)。我自己的观察还有五点。(1) 每个智能体最多 10 个探测、子空间维度至多 $M_i - 1$,相对 512 维嵌入极其稀疏,$\hat{g}_i$ 在子空间方向之外的准确性没有任何保证。(2) 五个工作流是链式结构(DROP 仅 2 个节点,许多基线在其上 Kendall 恒为 1.000,指标区分度低),作者还明确排除了 HiveMind 与 Agents-that-Matter 等联盟/移除基线,理由是缺乏语义保持的移除执行器,这削弱了基线比较的完备性。(3) 测试集偏小(HumanEval 仅 33 例),部分升级收益的标准误较大(如 HumanEval+Qwen3-32B 为 ±3.64 pp),小样本下的结论需谨慎。(4) 一阶线性模型无法刻画提示词改写与模型能力之间的非线性协同:MATH 上对 DeepSeek-V3.2 目标的 Kendall 仅 0.246,说明优先级并不总与实测收益排序一致。(5) DROP 的 Format 节点提示词优化增益为负(−1.04 pp)但模型升级增益 +3.4~+7.4 pp,说明同一优先级对不同干预类型并非完全一致,而论文只用一套探测分数服务两类干预。
独立分析的弱点
独立分析的弱点与改进方向。(1) 方向—干预错配:G-norm 假设存在共同干预半径 $r$ 且改进能落在 $\delta_i^* = -r\hat{g}_i/\|\hat{g}_i\|_2$ 方向上,但实际提示词优化器并不保证沿该方向改写,模型升级更是与方向无关的离散替换;改进方向是把 $\hat{g}_i$ 显式注入优化器做方向条件生成,或在升级决策中引入方向与目标模型能力的匹配度。(2) 探测协议依赖人工设计的十类扰动模板,若真正的高杠杆改动(如工具调用格式、上下文组织方式)不在模板覆盖范围内,评分会系统性低估该智能体;可引入主动学习,按后验不确定性挑选下一批扰动方向,而非固定十槽。(3) 探测成本随智能体数线性增长($n \times 10$ 次全工作流执行、每次都是完整探测集),对 10 节点以上的大工作流不友好;可用共享子样本、序贯早期停止(响应明显平坦即停)或轻量代理模型分摊开销。(4) 嵌入模型单一(Qwen3-Embedding-8B)且嵌入距离被当作扰动大小的代理,论文未做编码器消融;嵌入几何一旦与语义距离脱节,归一化响应 $y_{im}$ 的解释就会失真,应报告对多个嵌入模型的敏感性。(5) 统计功效有限:每个选择器仅 3 次优先级运行、每智能体 5 次干预运行,若干工作流上 SE 覆盖了方法间差距,如 IF-MAP 与 MeanAbs 的提示词增益差 0.236 pp 而两者 Kendall 之差方向相反,宜做更多重复或配对检验。
未来方向
作者提出的方向:把连续响应方向转化为离散改进,包括方向条件生成(让优化器沿 $\hat{g}_i$ 指示的方向改写提示词)、迭代式『编辑—测量』闭环、自适应探测(按需增加探测)与不确定性感知选择;拓扑研究上扩展到不同交互图的工作流,如带执行反馈的代码生成、带证据检查的问题分解、独立数学解验证,以检验节点响应分数在信息路由与纠错机会变化时是否依然有效。基于本文成果可自然延伸:第一,把 IF-MAP 分数接入 AFlow 式工作流搜索,联合决定『改哪个节点』与『改什么结构』,实现结构—参数两级优化的资源分配;第二,从提示词扰动推广到工具配置、上下文长度、采样温度等更广的干预轴,把单向量 $\hat{g}_i$ 升级为多维响应面,刻画不同干预类型的差异化杠杆;第三,在持续演化的生产系统中做在线优先级更新(贝叶斯岭回归、时间衰减加权),让评分随系统漂移自我修正;第四,建立理论保证,例如在局部光滑性与探测覆盖假设下给出 G-norm 与真实干预增益之间的高概率排序一致性界;第五,与 DoVer 式干预验证结合,形成『归因→优先级→小规模验证→改进』的完整闭环,并研究多轮预算下的序贯分配(类似 best-arm identification)。
复现评估
复现条件较好。代码已在 GitHub 公开(https://github.com/s1412/IF-MAS),附录 A–I 完整给出数据角色与规模(含划分种子 42)、六工作流的节点清单、全部模型配置(Qwen3-8B 本地执行、DeepSeek-V3.2 提示词操作、五个升级目标的具体 checkpoint 与 OpenRouter 标识、Qwen3-Embedding-8B 512 维)、关键超参(岭回归 $\lambda = 1.0$、子空间维度规则、上下文与温度设置)、十槽扰动协议、提示词优化器接受规则(含精确阈值)与统计聚合方式(3 次优先级运行 × 每智能体 5 次干预运行)。作者承诺发布完整 artifact:样例 ID、生成提示词快照、逐次响应缓存、收益矩阵、以及逐调用的 token/延迟/费用台账。算力方面无需训练 GPU,全部为 API 调用,但费用不小:一次六数据集优先级排序约 63k 次 Qwen3-8B 请求(47.14M token),完整 IF-MAP 流水线(选择 + 下游优化)约 353M Qwen token 与 4.25M DeepSeek token;若还要复现全部六个归因基线(AgentRx、CHIEF、FAMAS 各需 142–203M 诊断 token),总费用相当可观。实现难度中等:环节多(扰动生成、结构校验、嵌入、SVD 岭回归、TextGrad 优化器、双阈值接受规则、锁步评估协议),但每一步在附录中都有精确说明,工程能力强的研究生团队预计数周可复现核心结果。
论文图表