Transformer 的条件无毛定理:语言模型如何遗忘提示词 A Conditional No-Hair Theorem for Transformers: How Language Models Forget Their Prompt
提示词印记按幂律 $t^{-\alpha}$ 衰减、训练反而加速遗忘,幸存信息全由生成文本本身携带。
前置知识
pre-LN Transformer 与残差流
解码器架构中每个子层先做层归一化再计算注意力或 MLP,其输出以 $h_l = h_{l-1} + \mathrm{Attn}(\mathrm{LN}(h_{l-1}))$ 的形式写入残差流;残差流本身从不被归一化,范数随深度增长。Pythia 用并行残差形式,Qwen 用串行形式。
定理 1 的证明依赖 pre-LN 结构:归一化只作用于分支内部、残差流不坍缩,'pre-norm 激活非退化'假设才可能成立,逐层递推不等式才能展开。
教师强制(teacher forcing)
让两个不同提示词后接完全相同的人工续写文本分别前向传播、比较隐状态。由于续写在两次运行中逐 token 相同,隐状态之差只能来自提示词,从而把'提示的影响'与'文本不同的影响'干净分离。
这是全文的测量基础:prompt offset、信号 $S_l$、指数 $\alpha$ 全部定义在共享续写之上;没有它就无法排除隐状态差异只是对不同文本的反应。
注意力稀释与 attention sink
softmax 注意力权重和为一,位置 $i$ 的 query 要在 $P+i$ 个 key 上分配权重,固定 $P$ 个提示 token 分到的份额至多按 $Pe^{2B}/i$ 衰减,称为稀释。sink 指训练后模型把大量注意力集中到个别 token(如句首)却不携带信息的现象。
稀释是遗忘的几何机制与定理核心;用训练时序区分'遗忘始于稀释/中继泄漏'还是'始于 sink 形成'是本文机制归因的关键论证。
幂律衰减与局部指数
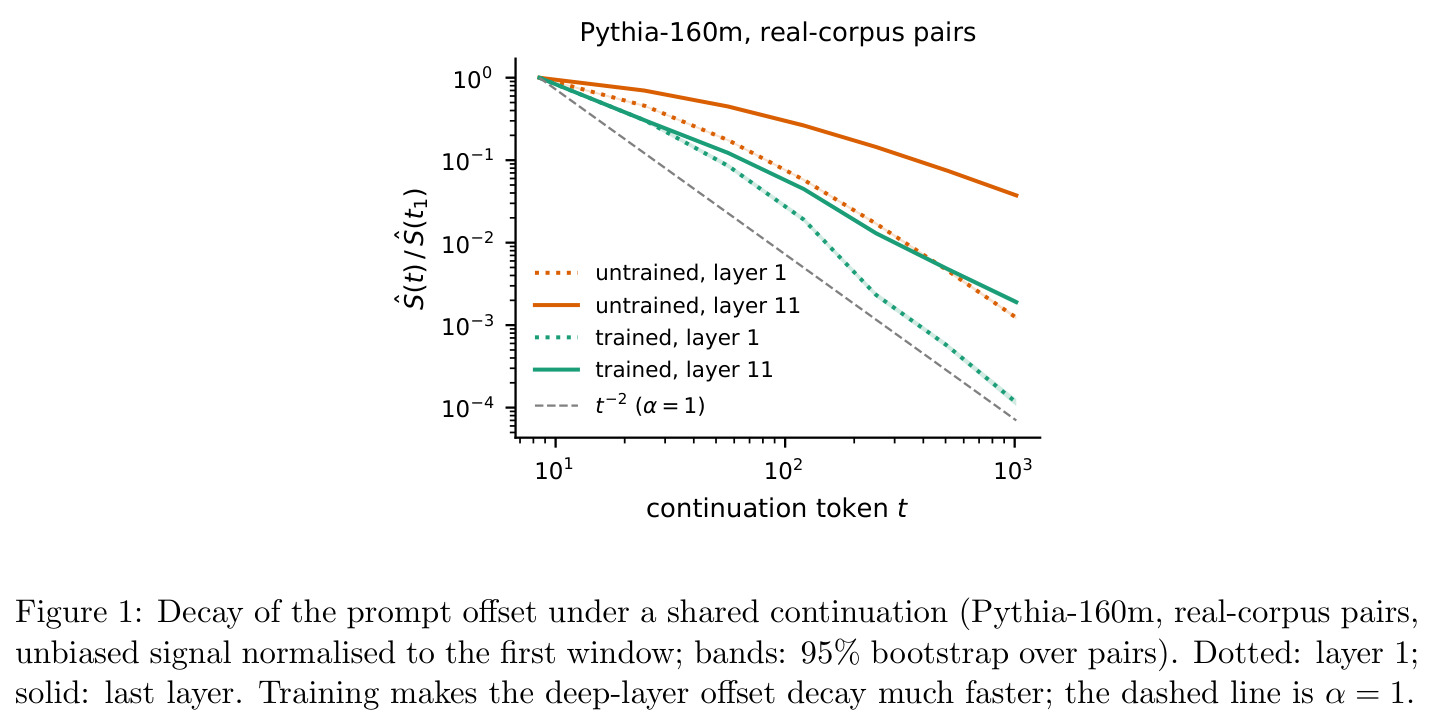
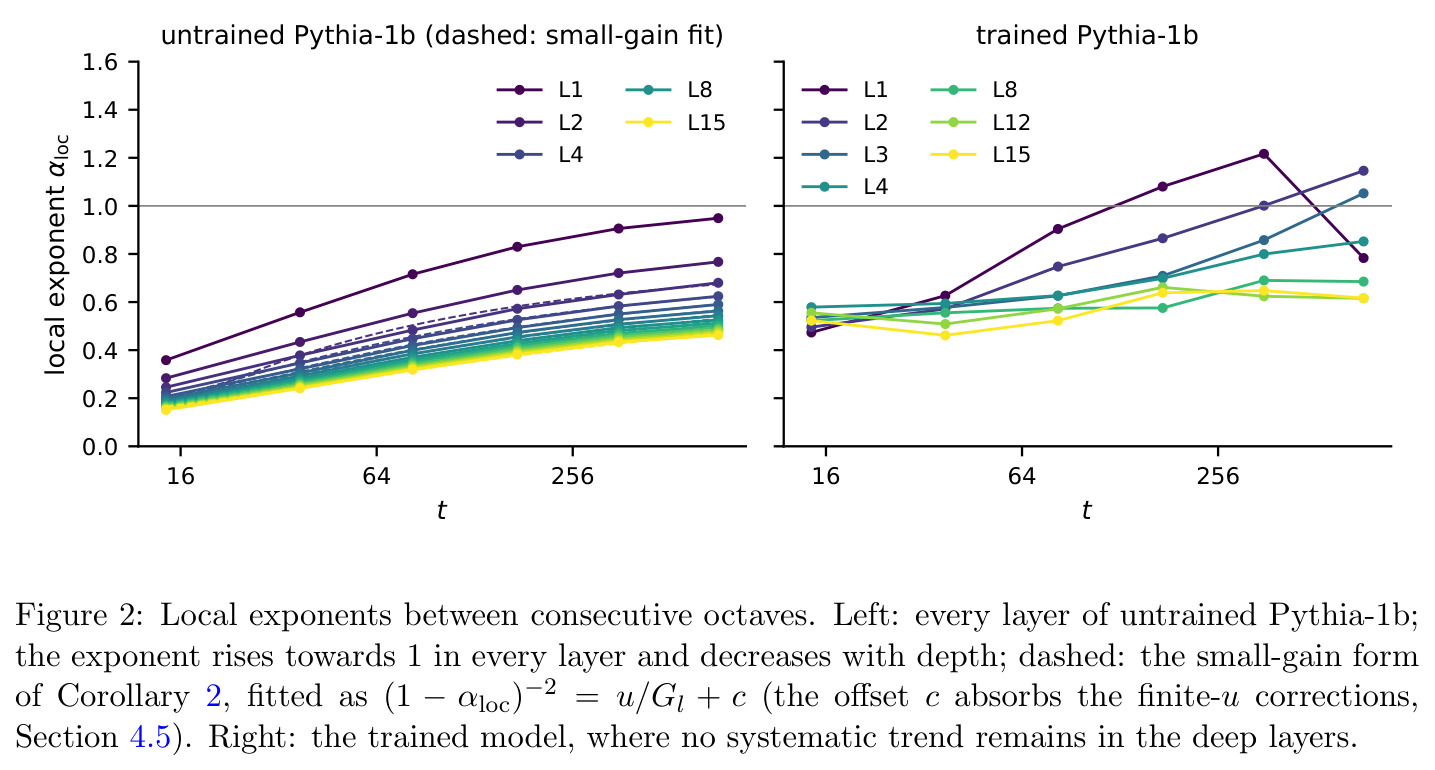
若信号满足 $S_l(t) \propto t^{-2\alpha_l}$,$\alpha_l$ 就概括遗忘快慢;相邻倍频程窗口间拟合的斜率称局部指数 $\alpha_{\mathrm{loc}}$。纯幂律对应常数 $\alpha_{\mathrm{loc}}$;若 $\delta \propto (\ln t)^k/t$,则 $\alpha_{\mathrm{loc}}$ 随 $t$ 缓慢升向 1。
论文所有实验结果都用 $\alpha$ 报告,且'未训练网络 $\alpha_{\mathrm{loc}}$ 单调升向 1'正是对数修正存在的证据,是区分训练/未训练机制的核心观测量。
全变差距离(total variation)
衡量两个概率分布差异的度量 $\mathrm{TV}(p,q)=\sup_A|p(A)-q(A)|$,值域 $[0,1]$。推论 1 用它陈述:给定相同历史 $c_{<t}$,两个提示词导致的下一 token 分布差异不超过 $\varepsilon_t = O(P(\ln t)^{L-1}/t)$。
它把隐状态层面的 offset 上界转化为'下一 token 分布几乎与提示词无关'的行为学陈述,是'条件无毛'命题的确切含义,也是第 8 节外部通道实验的理论出发点。
研究动机
大模型的实际使用中,system prompt 位于上下文最前端,其后所有 token 都能通过注意力'看见'它,但行为上人设与约束会在几轮对话内漂移(Li et al., 2024 实测 adherence 数轮内退化);agent 场景里轨迹开头一次性给定的约束同样被逐渐侵蚀——没有任何 token 被截断或删除,模型却'不再听提示的话'。由此产生三个自然问题:提示词的信息在隐状态里还剩多少?随生成长度 $t$ 按什么规律衰减、多快?什么性质能幸存、靠什么幸存?此前工作要么只测输出分布对提示的敏感性(Marklová et al., 2026 rescore 固定生成),要么用注意力权重当信息流代理——而注意力权重会被 sink 扭曲;也没有人回答衰减是训练造成的还是架构固有的,更没有定量下界说明遗忘最慢能有多慢。
本文的目标是本文要给提示词遗忘一个可测量、可证明、可干预的定量理论。具体目标四步:(1)定义可测量——共享续写下的 prompt offset 及其信号/噪声分解,使'隐状态里还剩多少提示'可逐层、随 $t$ 追踪,并用单一指数 $\alpha$ 概括衰减率;(2)证明上界——对有限深度 pre-LN softmax transformer(含 RoPE、LayerNorm/RMSNorm),在 pre-norm 激活非退化的附加条件下,offset 至多按 $O(P(\ln t)^{L-1}/t)$ 衰减,且该界在均匀注意力下渐进达到、不可改进;(3)定位机制——把注意力贡献精确分解为直接路径(query 直读提示)与中继路径(query 读取已携带提示信息的续写 token),并扫描训练检查点确定机制何时出现;(4)因果验证与应用——用 logit 偏置 $\gamma\log\frac{q+1}{P}$ 抵消稀释检验机制的必要性,再把温和版本作为'抗遗忘旋钮',量化其对指令遵循的收益与困惑度、指令复读的代价。
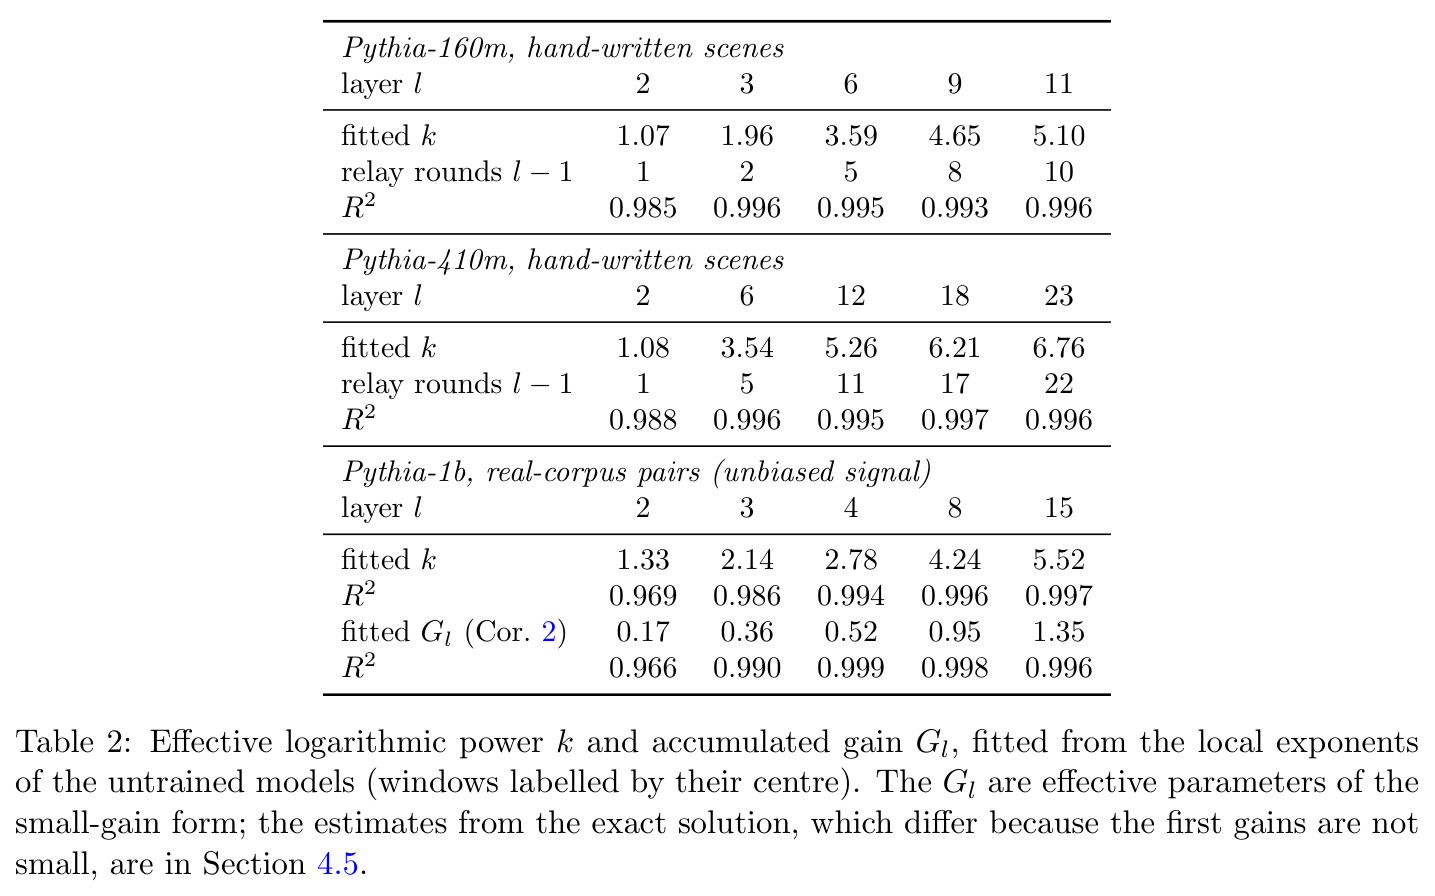
与已有工作不同的是,独特切入角度有三。其一,测量设计:首个在隐状态层面、逐层、随生成进程追踪提示印记的受控实验,'两提示 + 同一人工续写'保证差异只能归因于提示;进一步把 offset 分解为跨续写共有的信号与随续写变化的噪声,实践证明两者同速率衰减,故单个 $\alpha$ 即可概括可解码性的丧失。其二,物理类比严格化:把黑洞无毛定理改写成可证的条件命题——给定已生成文本,提示对下一 token 的影响按 $O(P(\ln t)^{L-1}/t)$ 消失;凡幸存的性质(如语言)必由'外部场'(文本本身)携带,并用探针实验验证这条外部通道。其三,机制归因方式:不做单点观测而是沿训练轴扫描,用时间顺序(中继泄漏 → 深层遗忘 → 第一层变 recency → sink 形成)排除 sink 等竞争解释;再用可精确求解的线性中继模型证明 $t^{-1}$ 率不可改进,并参数无关地预测未训练网络逐层曲线,使理论既有上界又有匹配的实例。
核心方法
方法是一条'测量—定理—机制—干预—应用'的闭环。直觉:提示占固定 $P$ 个位置,位置 $i$ 处的 query 要在 $P+i$ 个 key 上做 softmax,提示的注意力份额必然被稀释;而注意力的'写入'还会被续写 token 反复读取——它们已带上提示信息再传给更后面的 token,这就是中继(relay)。技术上:(1)测量层:定义偏移 $\Delta_l(t)=h_l(x'\circ c,t)-h_l(x\circ c,t)$,在 16-token 窗口、倍频程采点上计算归一化信号 $S_l$ 与噪声 $N_l$,拟合 $S_l\propto t^{-2\alpha_l}$;(2)定理层:由 logit 有界与 LayerNorm 的 Lipschitz 性质得单层递推 $\delta_l(i)\le K_1\delta_{l-1}(i)+\frac{K_2}{i}\sum_{j\le i}\delta_{l-1}(j)+\frac{K_3P}{i}$,归纳出 $\delta_L(t)\le C_L P(L+\ln t)^{L-1}/t$;(3)机制层:把注意力写按 key 属于提示或续写精确分解为 direct/relay;(4)因果层:加 logit 偏置 $\gamma\log\frac{q+1}{P}$ 抵消稀释,观察 $\alpha$ 是否消失;(5)应用层:$s\log\frac{q+1}{P}$ 的温和提升作为'抗遗忘旋钮',量化指令遵循收益与困惑度、指令复读的代价。
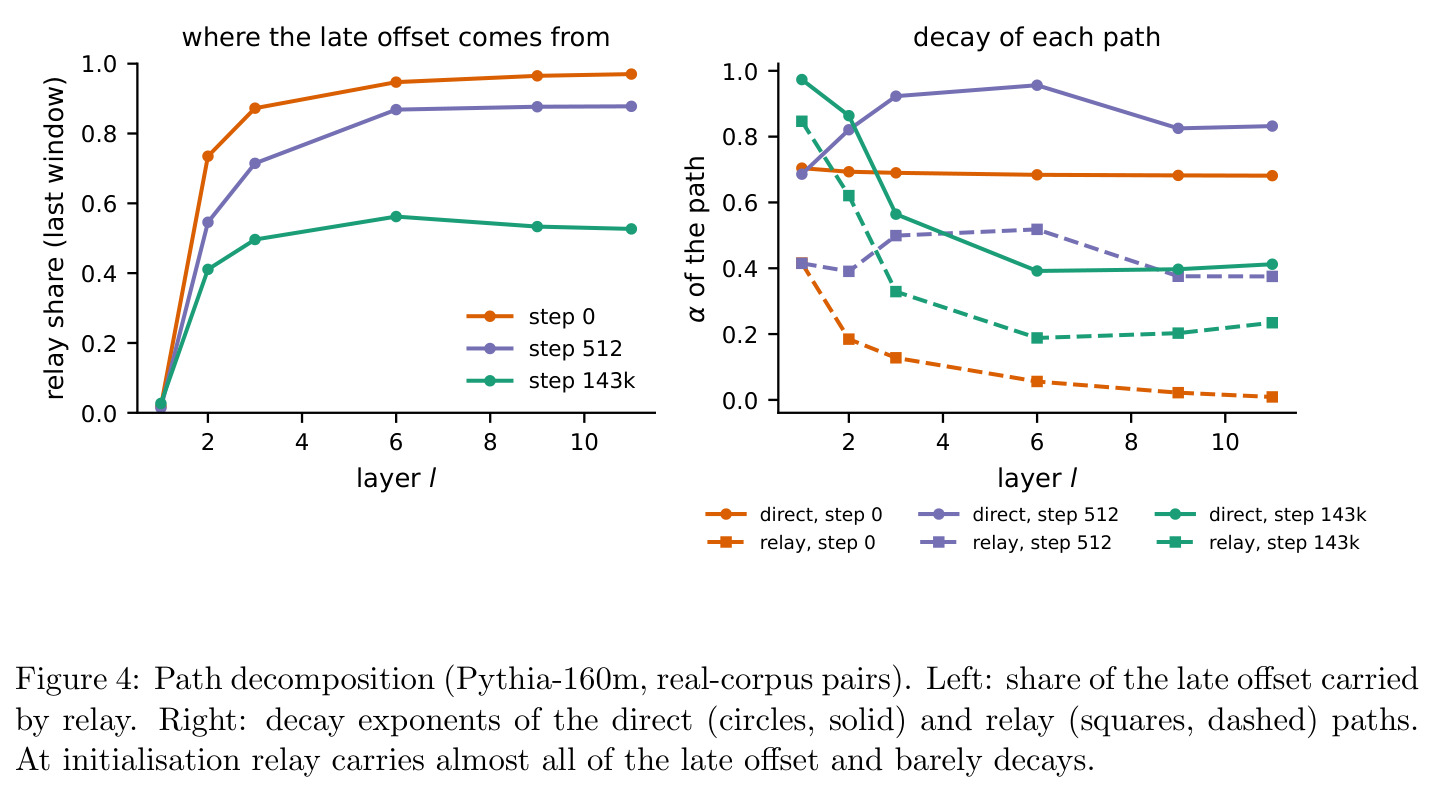
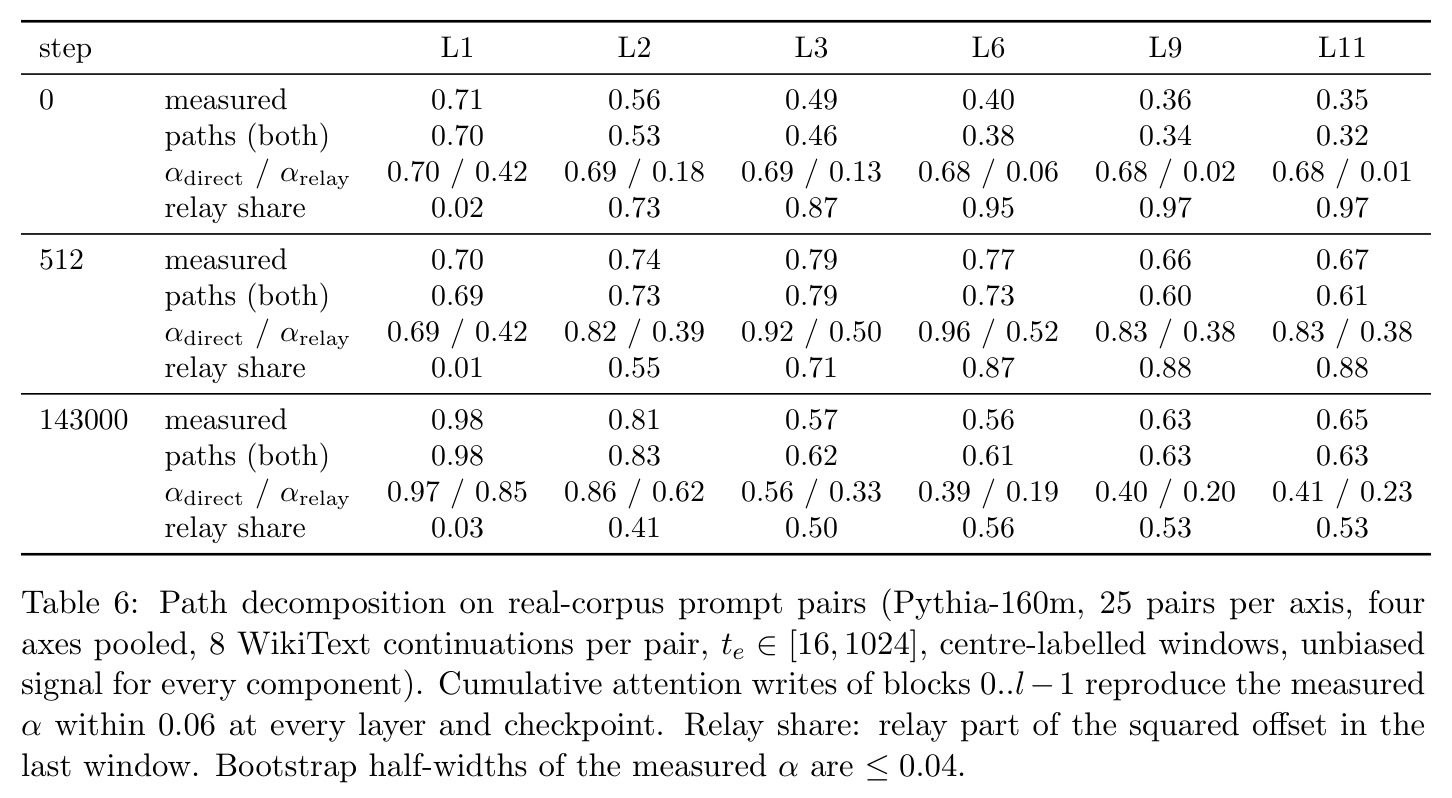
核心创新是'条件无毛定理'这一表述及其支撑机制。与已有工作的本质区别:(1)与指令漂移文献(如 split-softmax)不同,本文证明注意力权重是误导性代理——sink 吸走权重却不携带提示特异信息,真正决定遗忘的是隐状态中 offset 的衰减率;(2)与 over-squashing 文献不同,本文给出定量律并证明其紧性:构造均匀注意力的线性中继模型,精确解 $\delta_l(i)=\frac{P}{P+i}\sum_k e_k(\mathbf{g})h_{k-1}(\mathbf{x})$(初等/完全齐次对称多项式)渐进为 $\Theta(P(\ln i)^{l-1}/i)$,说明定理中的对数幂无法去除——衰减下限由'中继轮数=深度'这一架构事实决定;(3)反直觉发现:训练不是对抗遗忘而是加速遗忘——训练在前约 10 亿 token 内让中继开始泄漏,使深层 $\alpha$ 从未训练的 0.2–0.5 升至 0.55–0.7;未训练网络遗忘慢恰恰因为其中继几乎不衰减($\alpha_{\mathrm{relay}}$ 低至 0.01)。这把'模型为何忘记系统提示'从工程观察提升为有机制、有界、可干预的定量问题。
方法步骤详情
第一步,构造数据:20 个手写场景(每场景基础提示 + 4 变体:改一词/改写/换文体/换语言)与每轴 100 对真实语料(WikiText 换词、MRPC 改写、WMT14 英法、无关句),续写取自 WikiText-103 验证集(每对 8–16 条、$\ge$1920 token)、两提示共享;需要时加共同 <|endoftext|> 以共享 sink。第二步,前向采点:16-token 窗口、端点 $t_e=16,32,\dots,1024/2048$ 倍频程,窗口用中心标记(端标记会使 $\alpha$ 偏高 0.05–0.10)。第三步,统计量:按坐标用跨续写标准差 $\sigma_{l,j}$ 归一,信号 $S_l=\frac1d\sum_j(\mathbb{E}_c\Delta_{l,j})^2$ 用去偏成对乘积估计,噪声 $N_l$ 为续写间方差,最小二乘拟合 $\alpha_l,\beta_l$ 并给 bootstrap 区间。第四步,理论:引理 1–3 归纳出定理 1;对线性中继模型用对称多项式求精确解并逐层拟合增益($\hat g_1=\hat g_2=0.66$,深层 $\hat g_l\propto l^{-1.4}$)。第五步,机制分解:把注意力写拆成 direct/relay,分别拟合 $\alpha_{\mathrm{direct}},\alpha_{\mathrm{relay}}$ 与 relay 份额。第六步,因果干预:对提示 token 加 $\gamma\log\frac{q+1}{P}$(均匀或逐头校准)重测 $\alpha$。第七步,行为实验:自由生成文本上用哈希 unigram 直方图 + 逻辑回归探针区分两提示;对指令加 $s\log\frac{q+1}{P}$ 测法语遵循率、困惑度与指令复读。全部实验 float32 单台笔记本完成。
技术新颖性
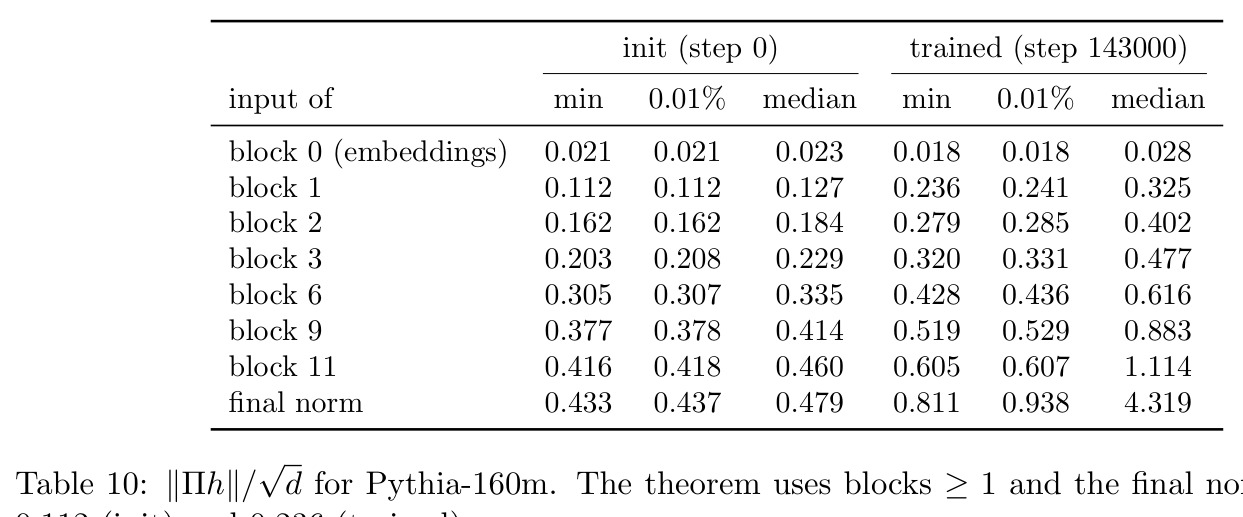
技术新颖性体现在四处。(1)测量学:首个隐状态层面受控测量;无偏信号估计器(成对乘积平均代替平方均值)与窗口中心标记是两个方法学贡献,分别消除晚期采样偏置(会把衰减看得过慢)与最高 0.19 的局部指数偏差。(2)理论:在有限深度 pre-LN、有界 logit(覆盖 RoPE,因为位置只进 logits)、pre-norm 非退化($\|\Pi h\|\ge r$)的最弱假设集下证明 $O(P(\ln t)^{L-1}/t)$ 上界,又用精确可解模型证明该界渐进紧——上界与下界在同一模型中重合,这在 LLM 现象的理论化工作中少见;推论 1 进一步把隐状态界转化为下一 token 分布的全变差界。(3)机制:direct/relay 分解是注意力流方法的定量化升级,且用'累计注意力写重构 offset 误差 $\le$0.06'验证分解忠实性;用训练时间顺序确立因果次序而非仅相关性。(4)干预与证伪:补偿稀释作为因果检验——去掉稀释即去掉遗忘(必要性),未训练网络与可解模型中均匀注意力单独产生衰减(充分性),构成完整因果论证;同时报告两个否定结果(注意力权重不可靠;$\log t$ 形状不优于同强度常数提升),显示方法论上的自我约束。
实验结果
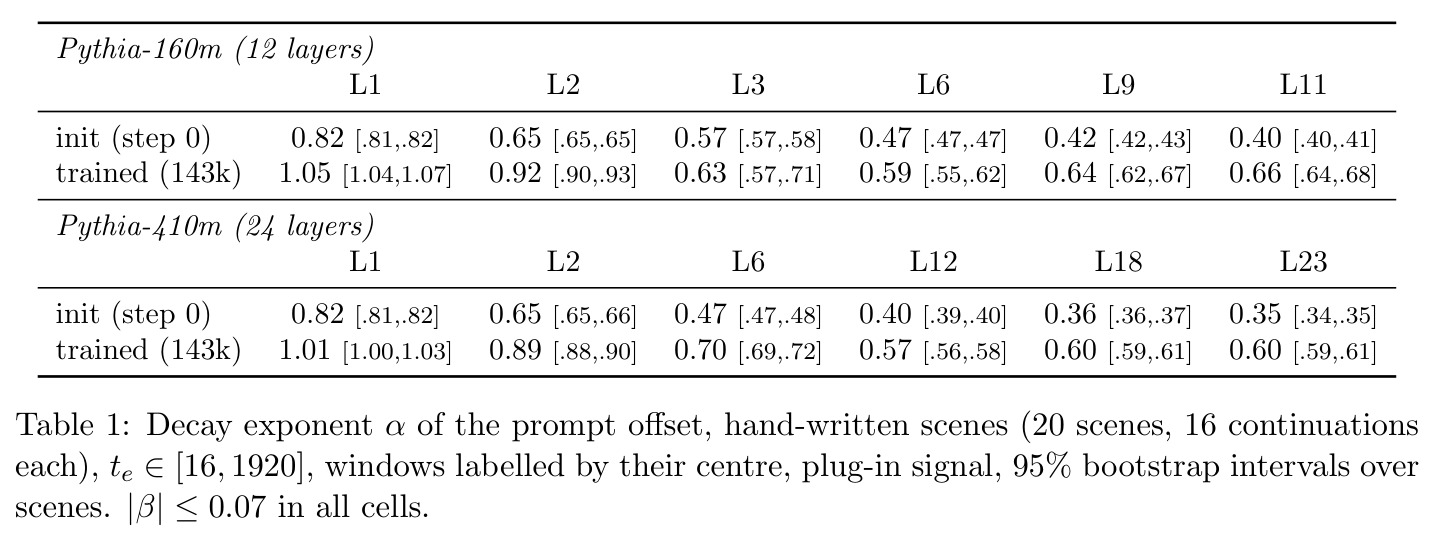
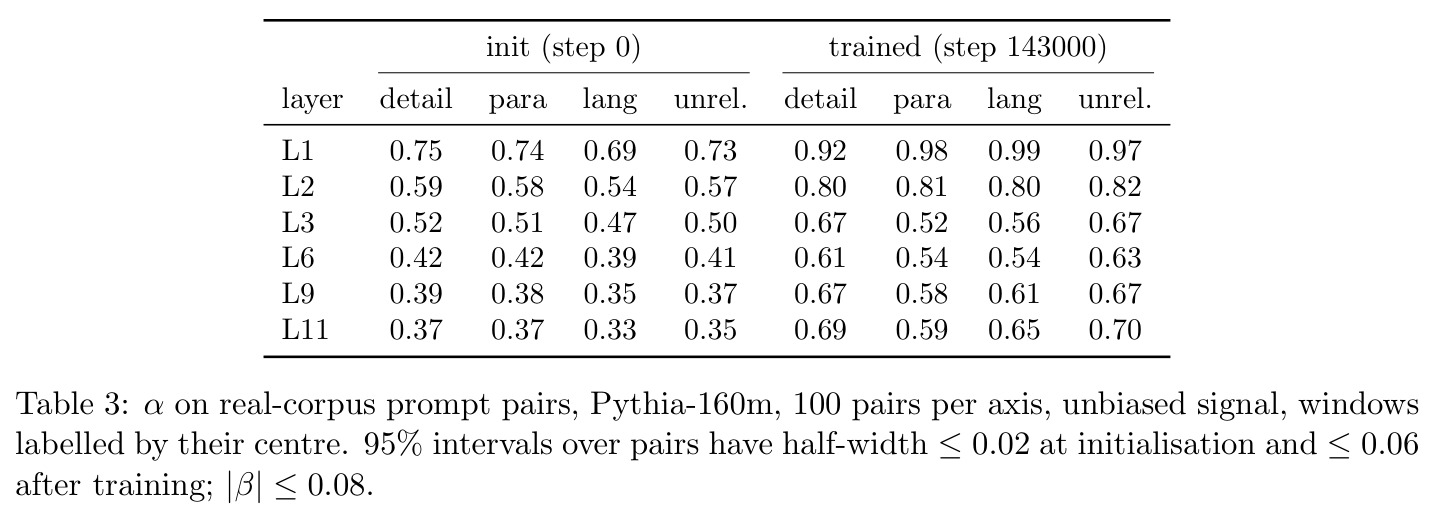
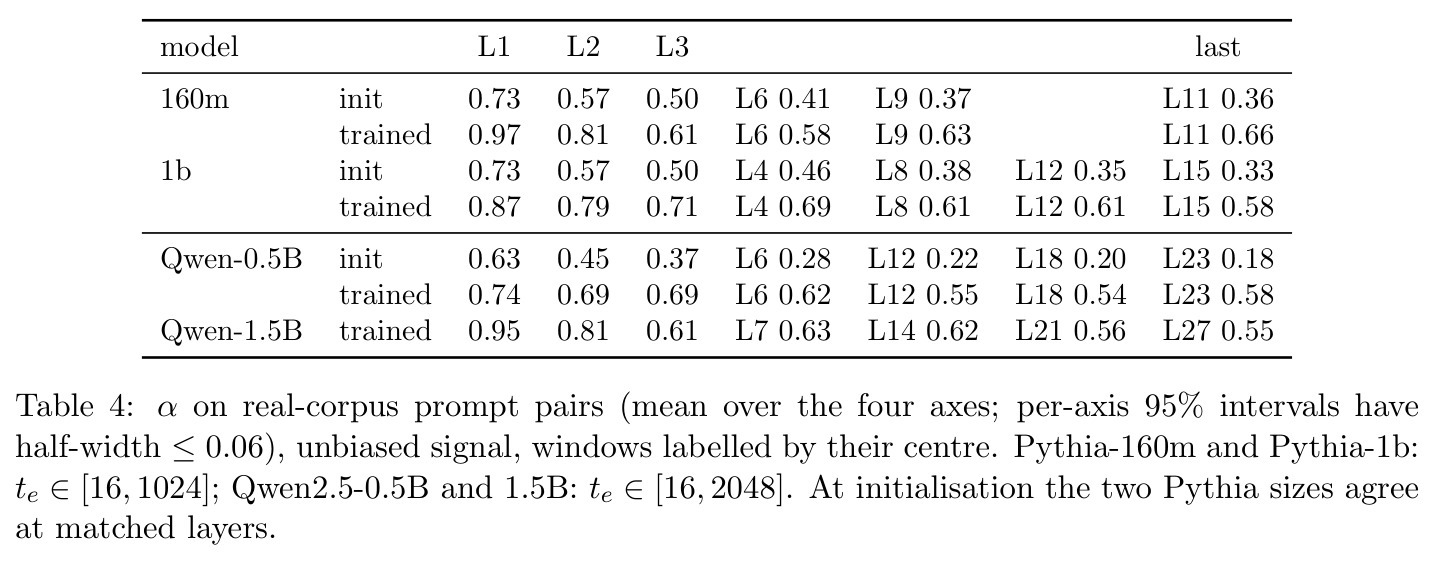
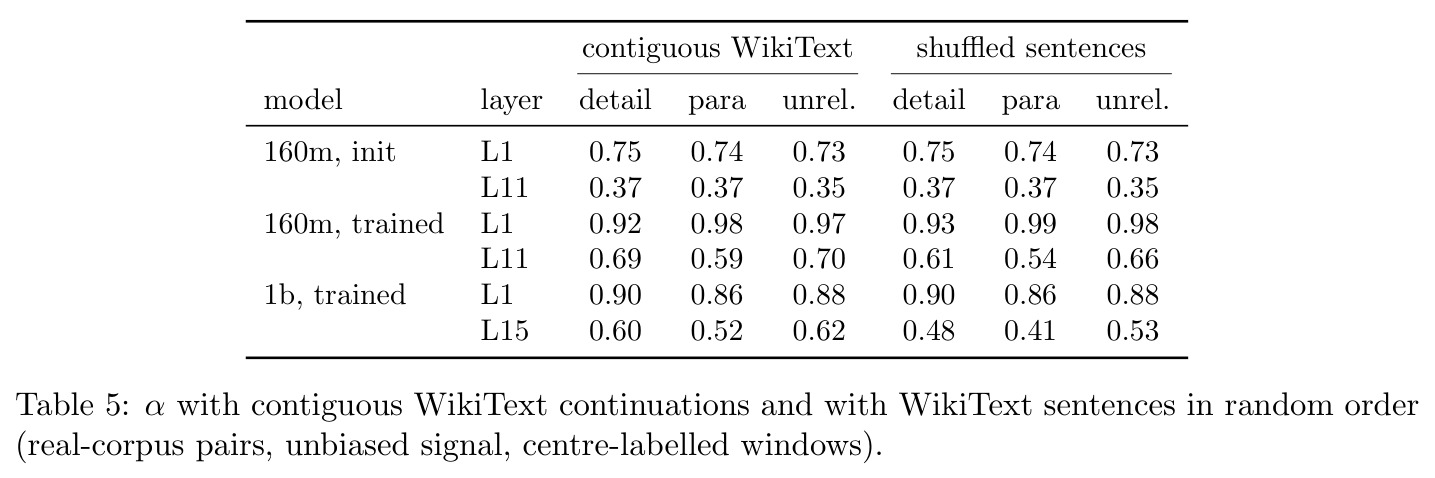
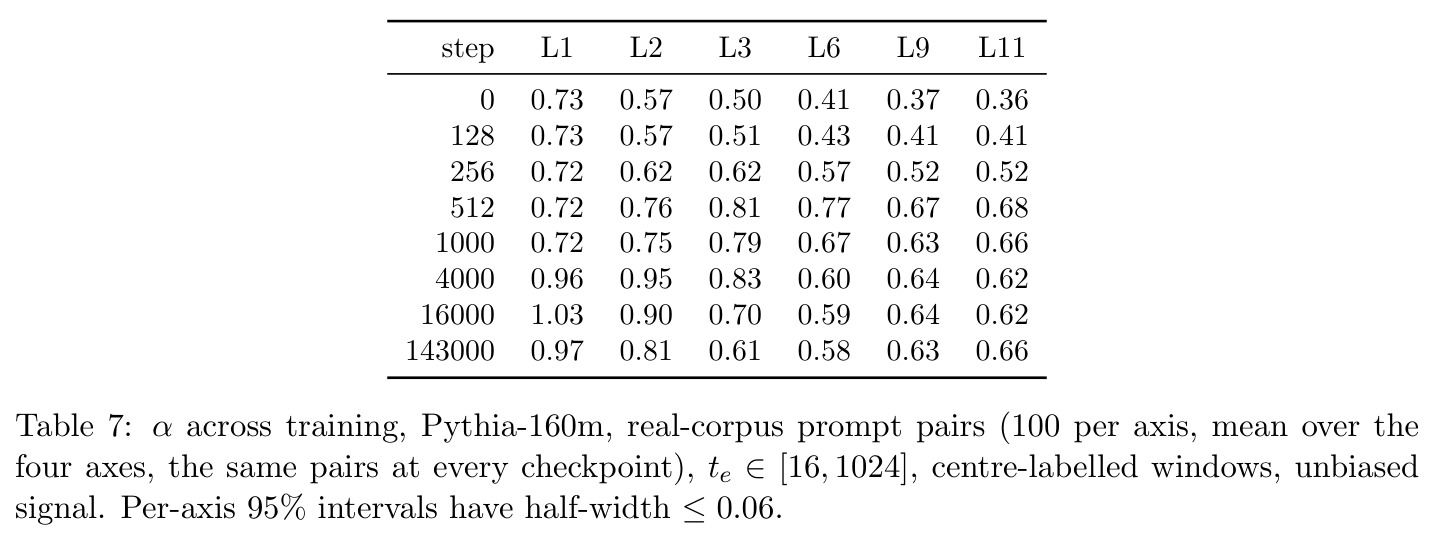
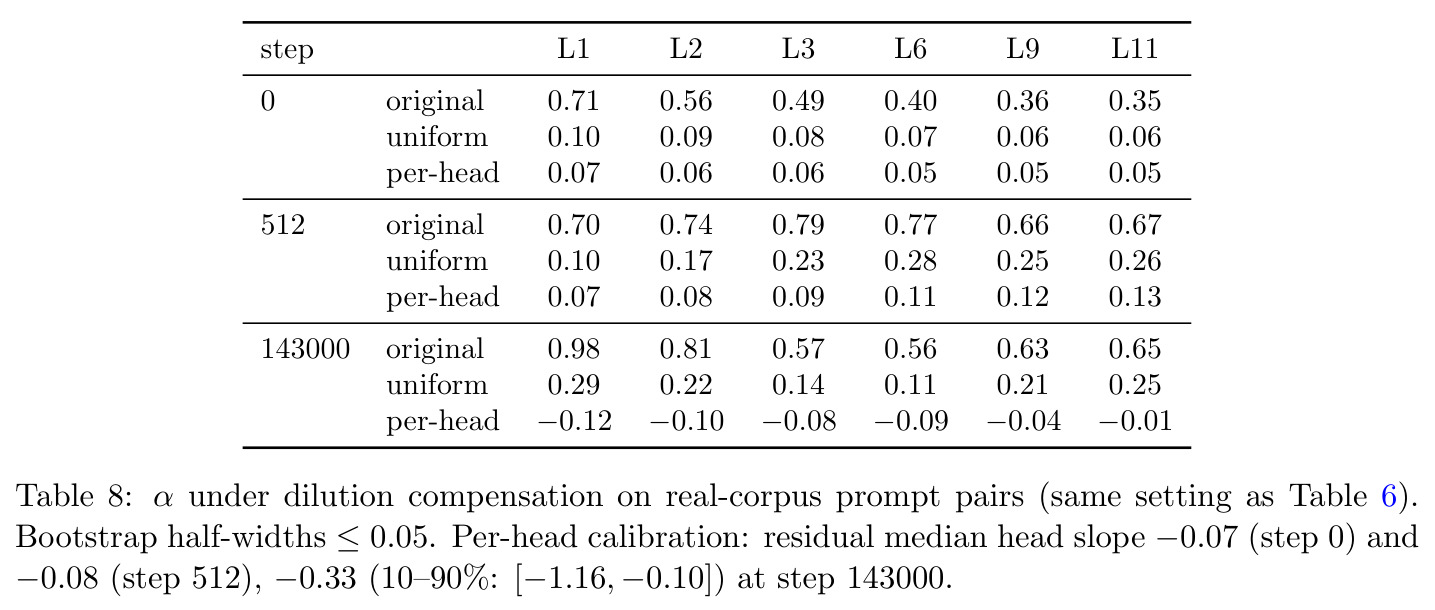
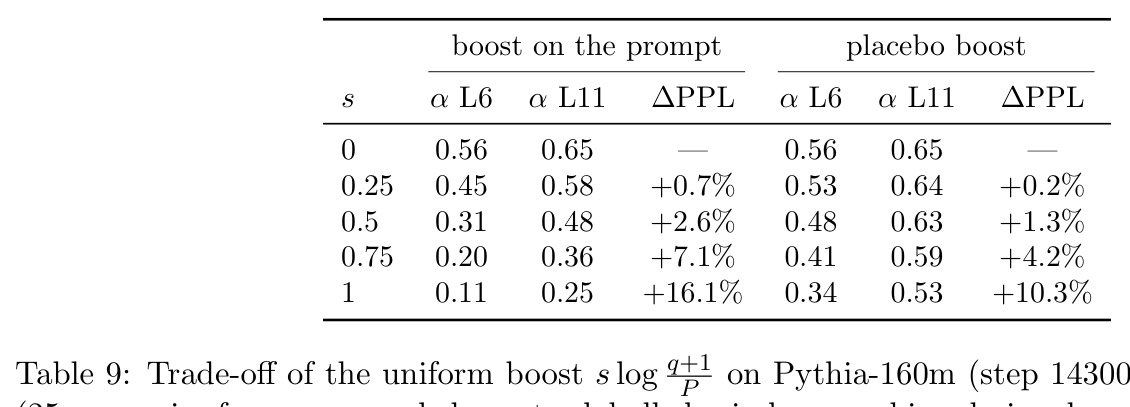
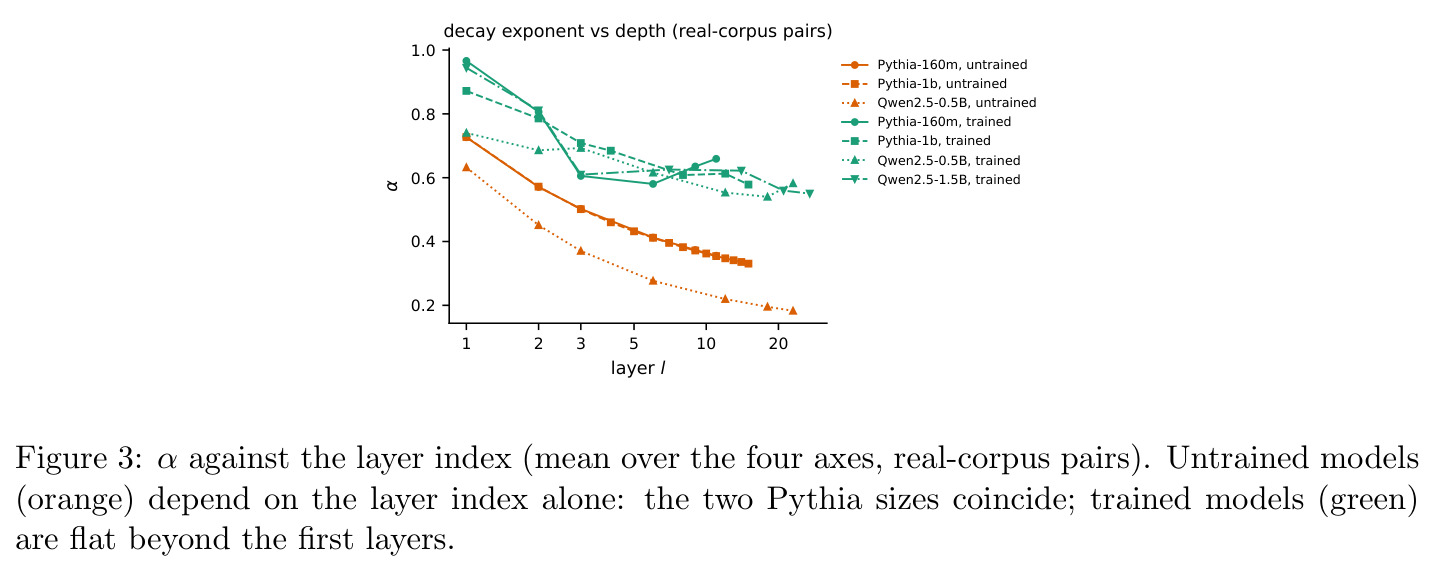
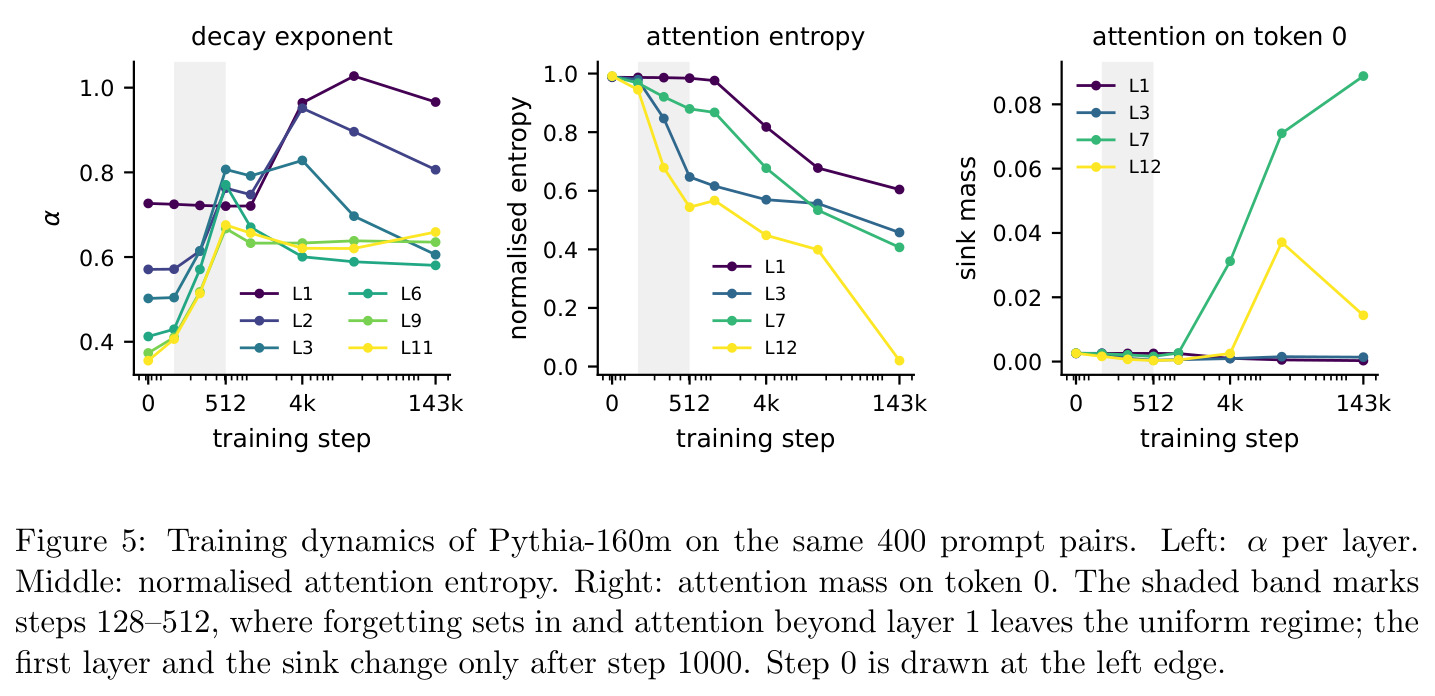
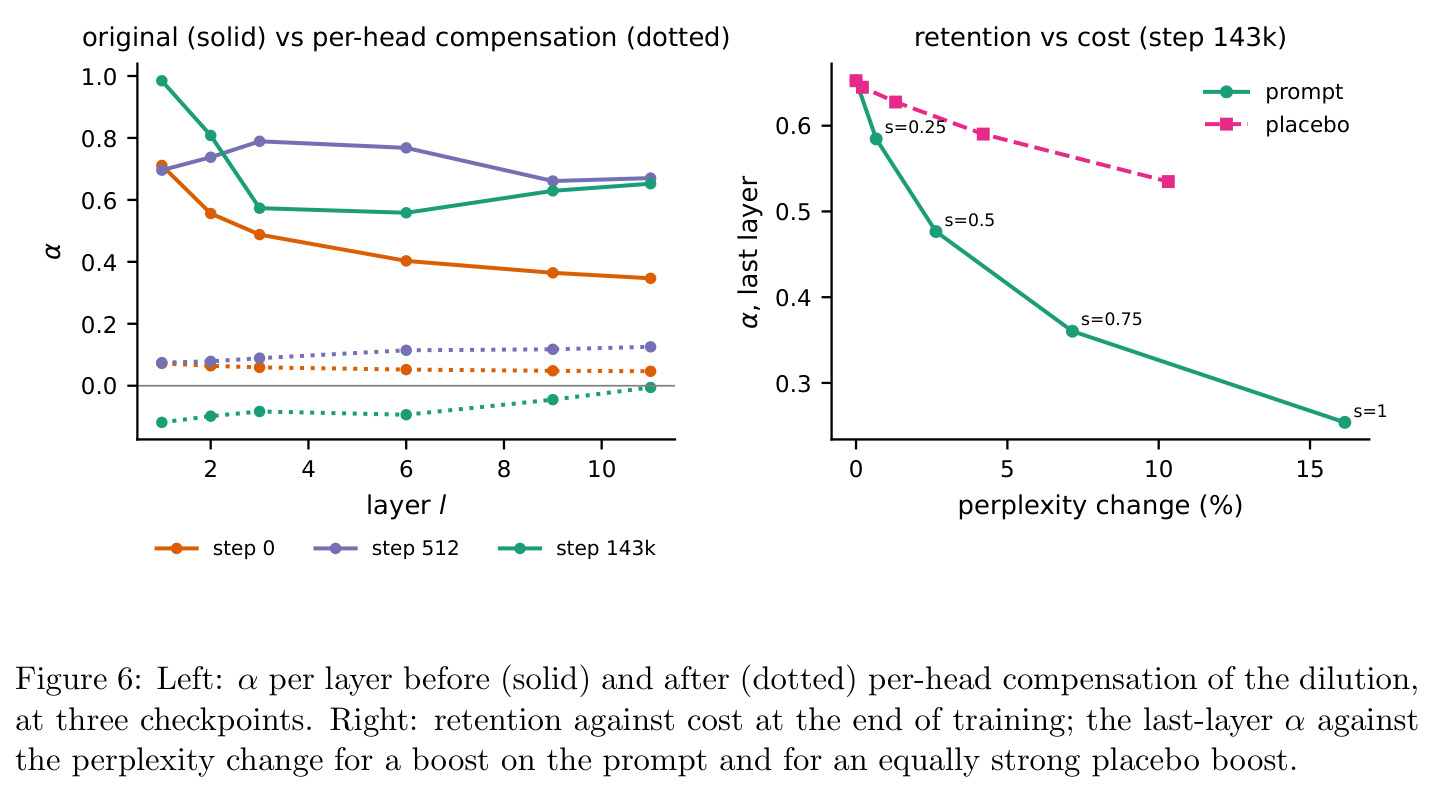
五个核心发现。(1)衰减近似幂律、训练加速遗忘:训练后 Pythia-160m 深层 $\alpha\approx$0.58–0.66、前两层 0.81–1.05;未训练时从 0.82(L1)降到 0.33–0.40;$\beta\approx$0(例外:未训练 Qwen),故可解码性由单一 $\alpha$ 支配。(2)尺度与架构稳健:未训练 Pythia-160m 与 1b 同层指数吻合到两位小数(L1–L3 均 0.73/0.57/0.50);训练后 Qwen 深层 0.54–0.63;'无关句'与'换一词'同速率(L11:0.70 vs 0.69),差异大小只改幅度不改速率。(3)未训练网络有对数修正:$\alpha_{\mathrm{loc}}$ 随 $t$ 升向 1,拟合对数幂 $k$ 在 L2≈1.07、L3≈1.96;线性中继模型精确解逐层拟合 15 层 $R^2\ge$0.992,第一层拟合 $P=$28.8 对实际均长 25.7。(4)机制与训练动力学:路径分解重构 $\alpha$ 误差 $\le$0.06;未训练时晚期 offset 的 73–97% 由 relay 携带且几乎不衰减;step 128–512(约 0.3–1B token)relay 开始泄漏、深层 $\alpha$ 跳升(L11:0.41→0.52→0.68),而第一层到 step 1000 后才变 recency、token-0 注意力质量 $\le$0.003 直到 step 1000——遗忘早于 sink 形成。(5)因果与应用:补偿稀释使 step 0/512 的 $\alpha$ 从 0.56–0.79 降到 0.05–0.13,训练后逐头补偿使其变负;$s=$0.5 提升把深层 $\alpha$ 降 0.17–0.25 仅花 +2.6% 困惑度,Qwen2.5-0.5B-Instruct 法语遵循率 31%→94%,代价是指令复读(19%→56–69%),且同强度常数提升效果相当。自由生成中语言可从文本探出(0.81/0.84 对随机 0.5),而教师强制下语言轴 offset 仍按 $\alpha\approx$0.54–0.65 衰减——幸存信息由文本外部通道携带,而非内部记忆。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 提示偏移衰减指数(真实语料对,Pythia-160m 第 11 层,四轴) | 衰减指数 $\alpha$(越大遗忘越快) | 训练后 0.59–0.70 | 未训练(step 0)0.33–0.37 | 训练使深层 $\alpha$ 提高 0.26–0.33,即同样信息约快 2 倍时间尺度被遗忘 |
| 提示偏移衰减指数(手写场景,Pythia-410m 深层 L18–L23) | $\alpha$ | 训练后 0.60 | 未训练 0.35–0.36 | +0.24~0.25,与 160m 一致,宽度无关 |
| 路径分解重构偏移衰减(Pythia-160m,全层全检查点) | $\alpha$ 重构误差 | $\le$0.06 | 原始注意力权重代理:仅在 step 512–1000 附近预测 $\alpha$,早期漏掉 relay、晚期被 sink 主导 | 全阶段可靠的机制量化 |
| 自由生成文本上的提示属性探针(语言轴,$t=$512) | 逻辑回归 5 折分类准确率 | Qwen2.5-0.5B 0.81;Pythia-160m 0.84 | 随机水平 0.5(零假设 95 分位 0.58–0.63) | 语言信息几乎完全由外部文本携带;细节/改写/文体则不可分 |
| 指令遵循(Qwen2.5-0.5B-Instruct,'只用法语回答',2048 token 生成) | 全程法语的样本占比 | $s=$0.5 的 $\log t$ 提升:94% | 无提升 31% | +63 个百分点;Pythia 上同设置困惑度仅 +2.6% |
| 稀释补偿因果检验(真实语料对,step 512,深层 L2–L11) | $\alpha$ | 逐头补偿后 0.08–0.13 | 无补偿 0.66–0.79 | 遗忘基本消失;训练后逐头补偿使 $\alpha$ 为负($-$0.12~$-$0.01),证明稀释是必要条件 |
| 抗遗忘旋钮的成本收益(Pythia-160m 训练后,L6/L11) | $\alpha$ 与困惑度变化 $\Delta$PPL | $s=$0.5:$\alpha_{L6}$ 0.56→0.31、$\alpha_{L11}$ 0.65→0.48,+2.6% PPL | 同强度安慰剂(加在续写开头):$\alpha_{L11}$ 0.63,+1.3% PPL | 同等保持率($\alpha_{L11}\approx$0.5)下提示提升 +2.6% vs 安慰剂 +10.3% |
局限与改进
作者承认的限制:定理 1 的常数 $C_L$ 可随深度指数增长,界只在 $t\gg Pe^{\Delta}$ 后才提供数值信息——训练后网络 logit 极差 $\Delta$ 达 17–18 甚至饱和 float32($e^\Delta>10^7$),故定理只约束渐进形状而非可拟合的指数;非退化假设($\|\Pi h\|\ge r$)靠经验验证而非推导,Qwen 首块裕度仅 0.012;核心测量止于 Pythia-1b、行为实验止于 Qwen2.5-1.5B,不能排除更大规模的变化;提示为英语(附法语、初步中文),自由生成只用温度 1;续写为 WikiText 连续或乱序句,训练后深层衰减形状依赖续写结构(乱序句使 1b 深层 $\alpha$ 降 0.09–0.18);单轮行为测试强制生成长度致后段为填充文本,多轮测试每条件仅 32 段对话、差异只是趋势;指数最多在 7 个倍频程上拟合,无法区分对数修正与小增益两种描述。我的补充观察:教师强制是测量装置而非失效场景本身,自由生成实验只用了 3 个场景、规模小;被测模型均为纯预训练,指令微调/RLHF 是否改变中继抑制完全未知;补偿干预在整提示上加偏置,无法只'保住'关键指令子集;Qwen 晚期 $\alpha$ 震荡(层 1 注意力绕 $1/t$ 以 ±30% 振荡、层 1 局部指数在 0.24 与 >1 之间摆动)未能与旋转位置编码频率挂钩,说明理论对有限 $t$ 局部行为预测力有限。
独立分析的弱点
独立分析的弱点及改进方向:(1)理论—实验脱节:定理常数过大($e^{2B}$ 级、随深度指数增长),对训练后网络在任何可测窗口都无数值预测力,实际指数靠可解模型事后拟合;改进方向是发展'有效常数'理论,用实测 logit 极差 $\Delta$ 或注意力熵替代 $e^{2B}$ 给出有限 $t$ 的近似式。(2)干预代价过高:均匀补偿 $s=$1 使困惑度 +16.1%,逐头校准 +140%~+376%,无法实用;改进方向是把稀释补偿写进训练目标(如按头门控的可学习 $\log n$ 缩放)。(3)行为收益不专属于 $\log t$ 形状:同强度常数提升同样有效甚至指令 echo 更少(12.9 vs 8.6 泄漏词/千词),说明'旋钮'本质是注意力预算再分配;改进方向是只对 system prompt 的关键 span 加偏置,或训练轻量适配器学习'指令保持头'。(4)外部通道机制未完全刻画:语言靠轨迹自锁幸存,但 32 条轨迹中仍有 4–11 条切换语言且多滑向主导语言;可把'外部携带'形式化为轨迹吸引子加以研究。(5)规模外推缺失:$\alpha$ 是否随参数量、深度系统变化无数据。(6)中继抑制的训练驱动力未被识别:只知道发生在 0.3–1B token、早于 sink,是什么损失压力使 relay 泄漏值得专门研究。
未来方向
未来方向:作者提出的——(1)规模外推:用将发布的工具箱在更大模型上测 $\alpha$,检验未训练网络的深度依赖是否幸存;(2)把 Qwen 层 1 注意力绕 $1/t$ 振荡的周期与旋转位置编码频率联系起来;(3)指令微调/对话训练是否改变中继抑制与遗忘率(所有被测模型均为纯预训练)。基于成果可延伸的——(4)架构设计:既然稀释是必要且充分的机制,可设计显式补偿稀释的训练目标或位置门控注意力;论文已预测 Scalable-Softmax 类 $\log n$ 缩放(logits 随上下文增长而使引理 1(a) 失效)保留提示信息更久,这可直接按本文指标($\alpha$、困惑度、遵循率、echo)系统评估;(5)长程 agent 的工程含义:把约束写进'外部'(周期性重述、草稿本)而非依赖内部记忆,重述频率可由 $\alpha$ 定量指导;(6)理论延伸:未训练网络对乱序文本完全不敏感(指数差 $\le$0.01)而训练后深层敏感(差 0.09–0.18),说明训练在文本长程统计与注意力几何之间建立了联系,可与自然文本互信息幂律的工作形式化打通;(7)与 KV cache/记忆增强结合:中继路径提示可以在续写 token 的 KV 中低成本'刷新'提示信息,或成为长上下文记忆写入的机制基础。
复现评估
复现评估:论文宣布将发布测量工具包,可对任意 HuggingFace 因果语言模型测 $\alpha$;模型全部公开(Pythia-160m/410m/1b 含 8 个训练检查点,Qwen2.5-0.5B/1.5B 及其随机初始化——Qwen 用库默认方案 σ$=$0.02、seed 0,Pythia 用发布 step-0 检查点);数据公开(WikiText-103 验证/测试、MRPC、WMT14),20 个手写场景列于附录 C。算力门槛极低:全部实验在单台 Apple 芯片笔记本上以 float32 完成,无 GPU 集群需求,这是本文对独立研究者格外友好的地方。复现难度中等:方法直接,但有三处易踩的坑——窗口必须用中心标记(端标记使全局 $\alpha$ 偏高 0.05–0.10);晚期信号必须用去偏估计器(成对乘积平均),否则采样偏置使衰减显得过慢;按倍频程采点并报告 bootstrap 区间。风险点是代码'将发布'而非已发布,届时需核对路径分解与逐头校准的实现细节;行为实验(多轮对话 32 条/条件、探针仅 3 场景)样本量小,复现应预期较大方差;理论部分(定理 1 与可解模型)证明完整、附录含全部常数,数学复现无障碍。
论文图表