面向扩散草稿推测解码的因子分解引导训练与推理 Factorization-Guided Training and Inference for Diffusion-Drafted Speculative Decoding
用损失与吞吐双因子分解指导扩散草稿训练和推理配置,加速至4.14倍
前置知识
推测解码 (Speculative Decoding)
用轻量草稿模型一次提出多个候选 token,再由大目标模型在单次前向中并行验证:只接受第一个被拒绝 token 之前的连续前缀,并在该处补一个替换 token(全接受则追加奖励 token)。接受/替换规则可严格保持目标模型的输出分布,因此加速不以牺牲生成质量为代价。
本文的一切设计都围绕这套草稿-验证循环展开:训练目标要对齐'前缀被接受'的机制,推理配置要优化'每轮接受多少、每轮花多久',不理解验证规则就无法理解损失因子分解与 AWL 的动机。
块扩散草稿器 (Block-Diffusion Drafter)
以 DFlash 为代表的草洪架构:草稿块由最新目标 token 加 $bs-1$ 个 mask token 组成,块扩散模型在给定上下文下单次前向并行预测所有掩码位置,而非像传统草稿模型逐 token 自回归生成。训练时按一定掩码模式随机遮蔽块内 token 做去噪式监督。
DScout 直接沿用 DFlash 的目标条件化块扩散架构,其贡献不在架构本身,而在这类草稿器'该怎么训练、该配什么参数'。所有策略(混合视野、去掩码、AWL)都作用在这种模型的训练损失上。
平均接受长度 MAT ($\tau$)
每轮验证平均接受的 token 数,$\tau = 1 + \mathbb{E}[N] = 1 + \sum_{k=1}^{bs-1} S(k)$,其中前缀存活概率 $S(k)=\prod_{j=1}^{k} a_j$ 由各位置条件接受概率 $a_j$ 连乘而成。乘积结构体现了前缀依赖:位置 $k$ 只有在前缀全部被接受时才贡献长度。
MAT 是本文训练侧的核心优化指标,也是常见误区所在:MAT 高不等于吞吐高,因为更长草稿会拉高每轮延迟。论文反复用 $G=\tau/T$ 提醒读者两个指标必须联合考虑。
目标条件化 (Target Conditioning)
草稿器不是独立的,而是读取冻结目标模型若干层的隐状态:把 $t$ 个选定层的特征拼接后经线性投影 $h_{ctx}=W_f[h^{(\ell_1)};\dots;h^{(\ell_t)}]+b_f$ 融合进草稿器,使草稿分布尽量贴近目标分布在同一前缀上的分布,从而提高接受率。$t$ 称为目标条件化深度。
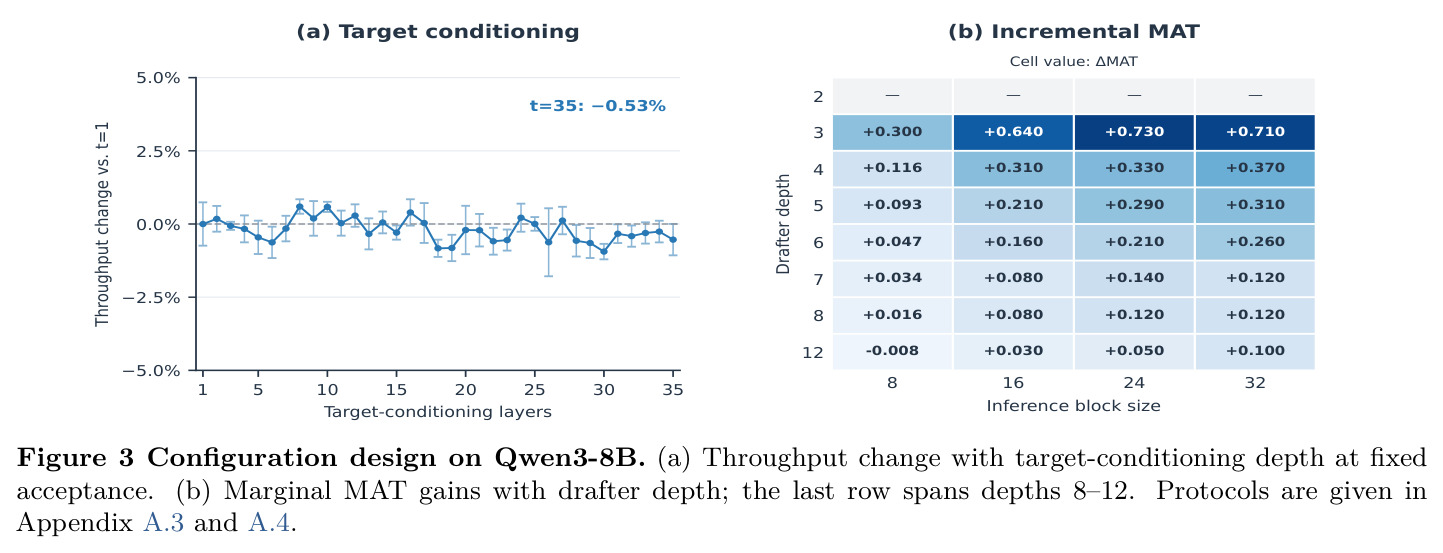
条件化深度 $t$ 是本文推理配置三维度之一。论文证明取满全部层(Qwen3-8B 为 35 层)几乎无额外开销(FLOPs 仅增 2.75%、吞吐变化 <1%),最终配置 35t6d 中的 35 即指此。
接受加权损失 AWL 与推测采样接受规则
标准推测采样中草稿 token $\hat y_j$ 的接受概率为 $\alpha_j=\min(1, P_j(\hat y_j)/Q_j(\hat y_j))$,$P_j$ 是目标分布、$Q_j$ 是草稿分布。AWL 把各位置接受分数的累积乘积 $w^{AWL}_k=\mathrm{sg}[\prod_{j<k}\alpha_j]$(带 stop-gradient)作为该位置损失权重,替代与样本无关的固定位置衰减。
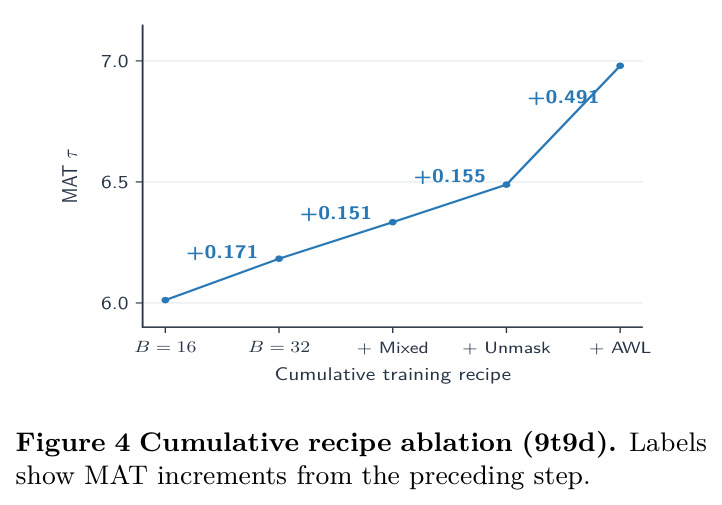
AWL 是本文训练配方中消融贡献最大的组件(单项 +0.491 MAT),其本质是把验证器的接受规则直接搬进训练目标,理解接受规则才能理解权重为何随前缀质量动态伸缩。
研究动机
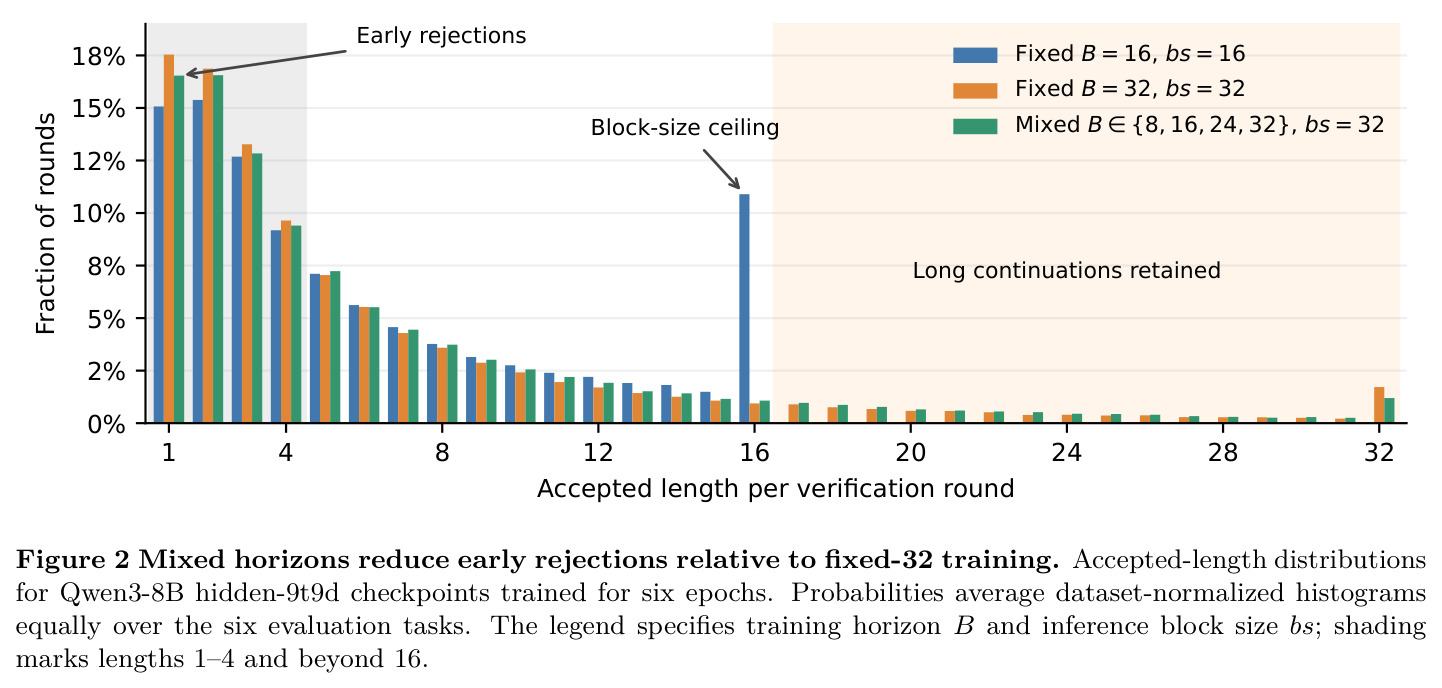
扩散草稿器(如 DFlash)能在一次前向中并行生成整块草稿 token,但'草稿预测得更多更好'并不直接等于'吞吐更高'。原因有二:其一,验证只接受第一个被拒绝 token 之前的连续前缀,位置 $k$ 的正确预测只有在前面所有位置都被接受时才能计入接受长度,训练监督与实际收益存在系统性错位;其二,即使平均接受长度 MAT $\tau$ 提高,若每轮草稿-验证延迟 $T$ 同步上升,吞吐 $G=\tau/T$ 反而可能下降。论文给出了具体证据:DFlash 在训练/推理块大小均为 16 时,整块草稿被全部接受的比例仅 10.9%,说明还有更长接受空间的潜力;把训练与推理块都扩到 32 后,接受长度确实能突破 16 个 token,但只接受 1–4 个 token 的'早期拒绝'轮次比例明显上升,两头难以兼顾。现有方法在训练监督怎么分配、推理块大小和草稿深度怎么选这两个环节都缺乏原则性指导,只能靠逐一训练、逐一实测的昂贵试错。
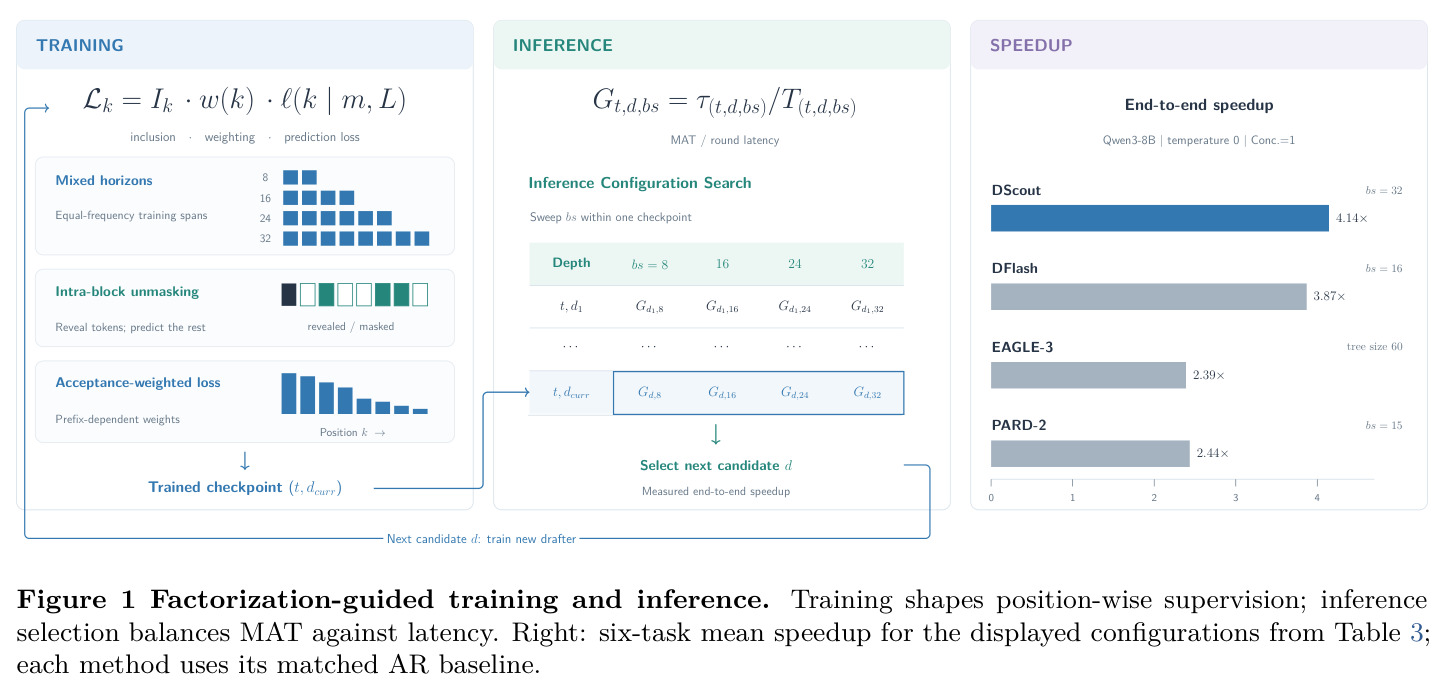
本文的目标是本文的目标是把扩散草稿器的'预测质量'真正转化为'端到端解码吞吐',且不引入任何额外推理开销。具体拆成两个互补目标:训练侧,让监督信号的分配与前缀接受机制对齐——哪个位置参与损失(inclusion)、权重多大(weighting)、损失怎么算(prediction),都要考虑该位置被验证实际到达的概率,从而提升 MAT;推理侧,在目标条件化深度 $t$、草稿器深度 $d$、推理块大小 $bs$ 三个配置维度上,基于 MAT 与每轮延迟的联合权衡,为不同目标模型、不同基准任务和不同并发负载选出高吞吐配置,并希望块大小切换无需重新训练。最终量化目标是在 Qwen3-4B 和 Qwen3-8B 上相对自回归解码大幅提速,并全面超过 EAGLE-3、DFlash、PARD-2 等现有最强基线——实际达成 3.84× 与 4.14× 平均加速,较 DFlash 分别再提升 9.1% 和 7.1%。
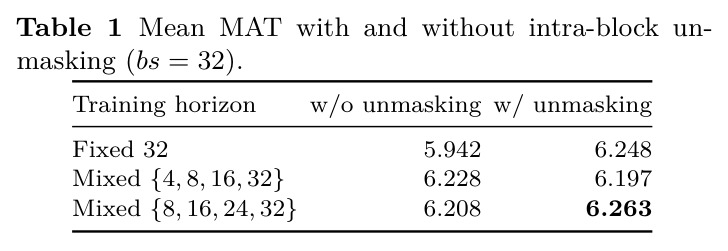
与已有工作不同的是,本文的独特切入点是把两个看似独立的优化问题统一到两个'因子分解'上,形成先分解、再归因、后设计的分析框架。训练侧,把每个位置的损失贡献分解为 $L_k = I_k \cdot w^{(k)} \cdot \ell^{(k)}|_{m,L}$,即'是否纳入监督 × 权重多少 × 预测损失怎么算'三因子;这使不同训练策略可归因到不同因子上单独研究,而共享因子的策略必须联合评估——论文发现混合视野与块内去掩码的配伍就很敏感(Table 1)。推理侧,把吞吐分解为 $G=\tau/T$,即 MAT 与每轮延迟之比,据此在'MAT 增益递减 + 延迟随深度线性增长'两条温和假设下推出草稿深度吞吐曲线的单峰性,把昂贵的深度搜索变成可高效定位的峰值查找。已有工作(DFlash、PARD-2、EAGLE-3 等)要么只改架构、要么只堆训练技巧,既没有对训练策略做因子化归因,也无法在不重训的情况下跨推理块大小迁移,本文同时补上了这两块。
核心方法
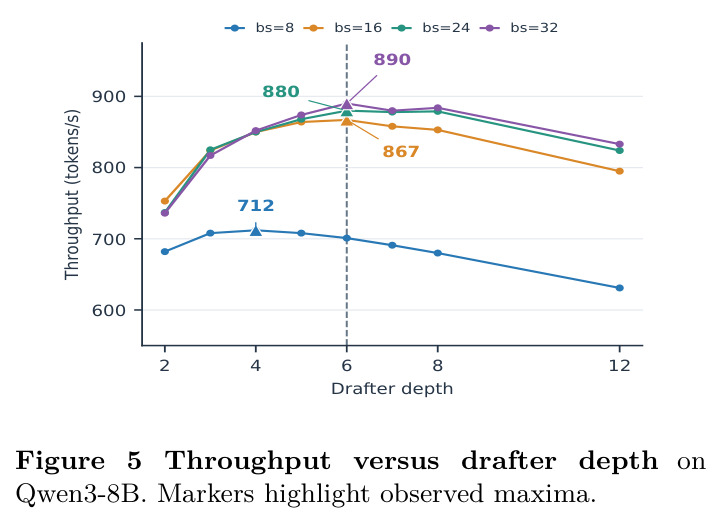
DScout 建立在 DFlash 的目标条件化块扩散架构上:冻结目标模型 $t$ 个层隐状态经 $h_{ctx}=W_f[h^{(\ell_1)};\dots;h^{(\ell_t)}]+b_f$ 融合后作为条件,草稿块由最新目标 token 加 $bs-1$ 个 mask token 组成,单次前向并行预测全部掩码位置。方法分两条线。训练线以位置级损失因子分解 $L_k=I_k\cdot w^{(k)}\cdot \ell^{(k)}$ 为指南,组合三项策略:混合视野训练($B\in\{8,16,24,32\}$ 等频采样,抬高早期位置监督频率同时保留长视野)、块内去掩码(按 Beta 分布采样掩码率、随机揭示互补位置作上下文)、接受加权损失 AWL(按前缀接受概率 $\prod_{j<k}\alpha_j$ 动态加权),在不增加推理计算的前提下提升 MAT。推理线以吞吐分解 $G=\tau/T$ 为指南:条件化深度取满全部 35 层(开销可忽略);草稿深度借单峰性定位,实测 $d=6$($bs\ge16$)或 $d=4$($bs=8$);推理块大小借助混合视野在单一 checkpoint 上按负载在 {16,32} 间选择。Qwen3-8B 最终配置 35t6d。
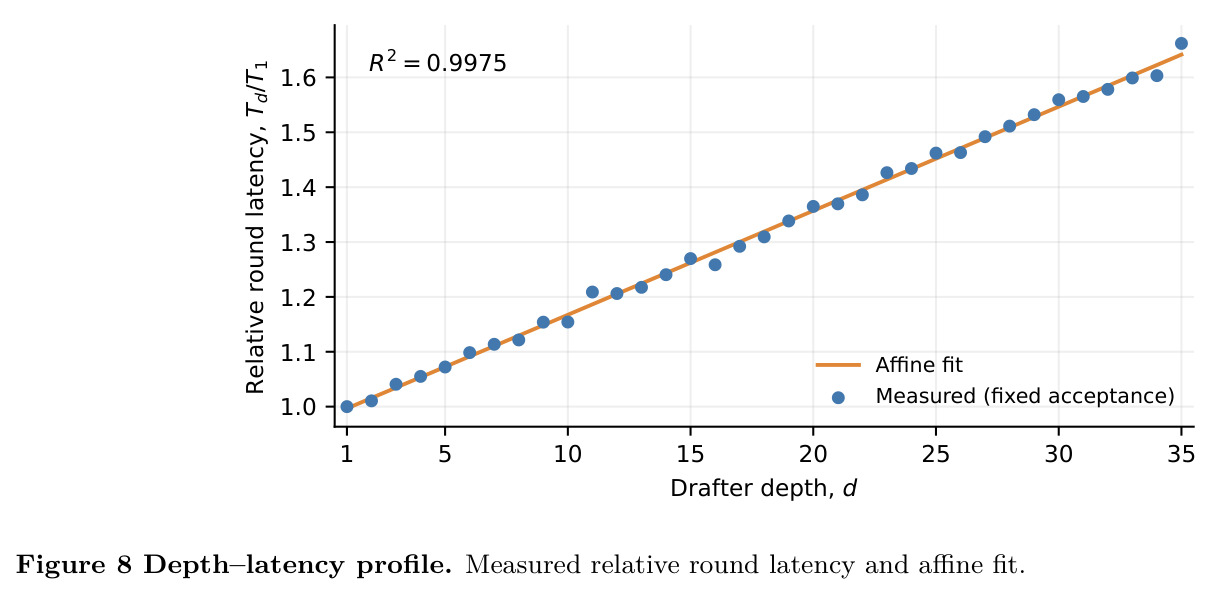
核心创新是把'监督分配'显式建模并与验证的连续前缀接受规则对齐。已有扩散草稿器用固定位置衰减或全位置均等监督,隐含'每个位置学得好都同样有用';DScout 指出位置 $k$ 的正确预测只有在前缀 $\prod_{j=1}^{k-1}a_j$ 被接受时才有价值,于是先拆出 inclusion/weighting/prediction 三因子,再首次提出接受加权损失:用接受分数 $\alpha_j=\min(1,P_j(\hat y_j)/Q_j(\hat y_j))$($P_j$、$Q_j$ 分别为目标与草稿分布)的累积乘积(带 stop-gradient)替代固定衰减。训练早期草稿弱、接受分低,梯度自动集中在前几个位置;随早期位置学扎实,监督逐步推向更长前缀——优化进程与验证过程同构。推理侧的本质区别是把配置选择从'每个配置训练一个模型'变为'一次训练 + 低开销搜索':混合视野天然支持不同 $bs$;在 $\Delta_{d+1}\le\Delta_d$ 且 $T_d=T_{fix}+dT_{layer}$ 下可证吞吐 $G_d$ 关于深度单峰,无需穷举即可定位峰值。
方法步骤详情
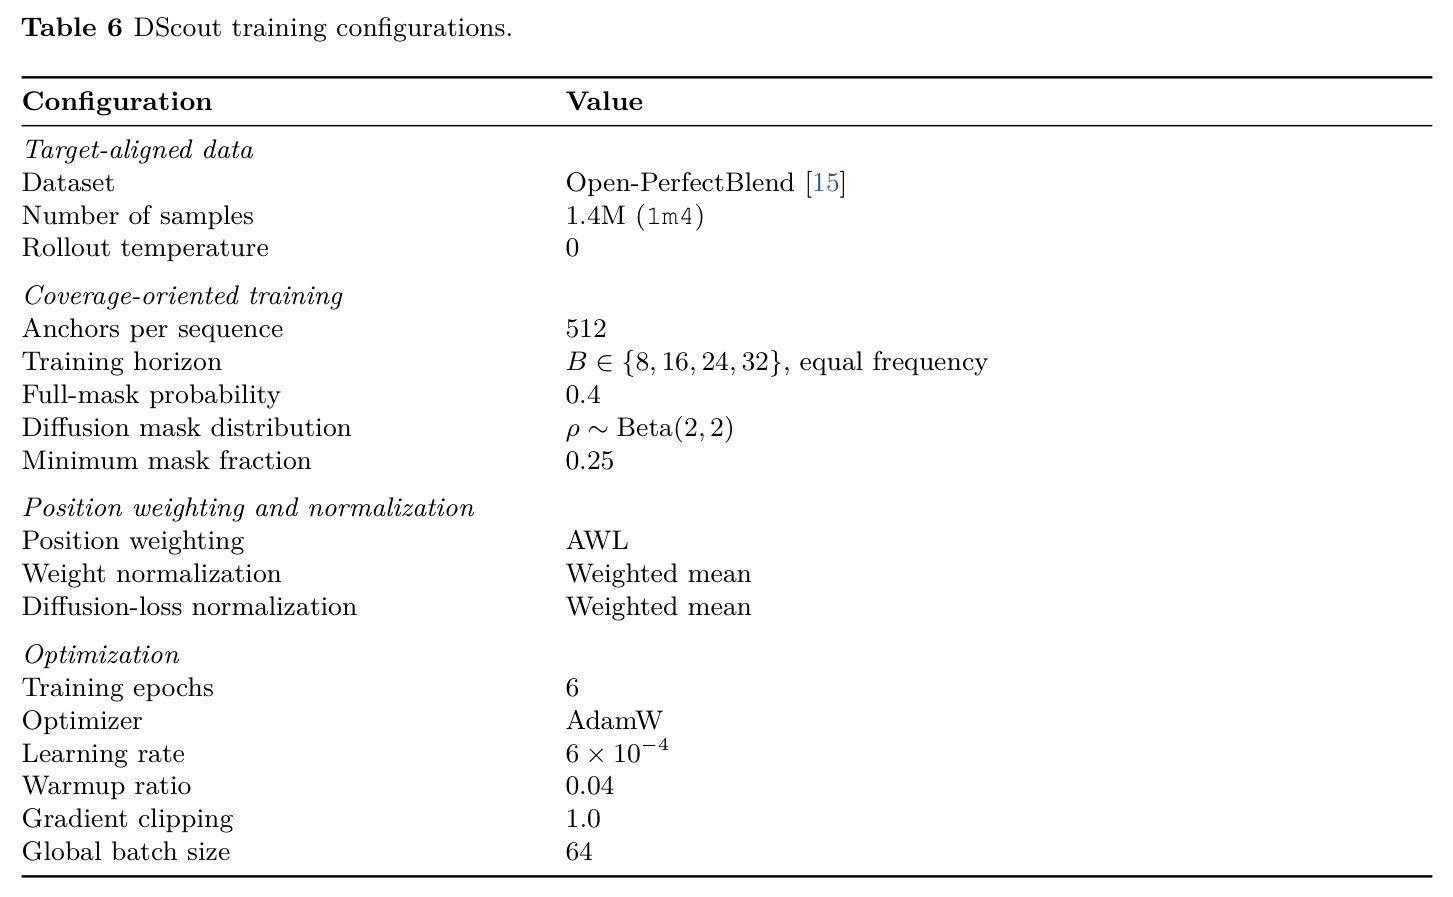
第一步,数据与底座:沿用 DFlash 配方,用 1.4M 条 Open-PerfectBlend 样本配目标模型生成的回答训练,Qwen3 关闭思考模式,训练块含 1 个锚 token 与 $B-1$ 个未来 token。第二步,混合视野训练:每次更新从 $B\in\{8,16,24,32\}$ 等频抽取视野,使早期位置纳入频率 $\pi(k)$ 更高并保留长视野,实测减少早期拒绝且保留 16 以上长接受(Figure 2)。第三步,块内去掩码:以固定概率保留全掩码块,其余按 Beta 分布采样掩码率并随机揭示互补位置,被揭示位置只作上下文不进损失。第四步,AWL:取 $w^{AWL}_k=\mathrm{sg}[\prod_{j<k}\alpha_j]$,优化 $\mathcal{L}_{train}=\frac{\sum I_{r,k}w^{AWL}_{r,k}\,\mathrm{CE}(Q_{r,k},y^\star_{r,k})}{\sum I_{r,k}w^{AWL}_{r,k}+\epsilon}$($\epsilon=10^{-6}$)。第五步,推理配置:条件化从 9 层增至 35 层仅增 2.75% 相关 FLOPs、吞吐变化不足 1%,故取满 35 层;深度上吞吐在 $d=6$($bs\ge16$)与 $d=4$($bs=8$)达峰;块大小在同一 checkpoint 上按目标模型与并发度扫描选择。
技术新颖性
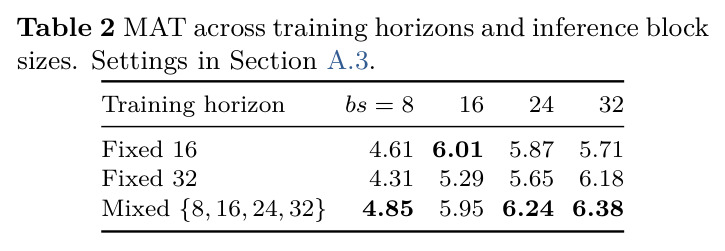
新颖性有三层。其一,损失因子分解是可复用框架:此前训练技巧被当孤立 tricks,本文用三因子给策略'归类',共享因子的策略必须联合调——Table 1 显示去掩码配短视野 $\{4,8,16,32\}$ 反而把 MAT 从 6.228 降到 6.197(短块揭掉几个 token 后剩余掩码位太少),配 $\{8,16,24,32\}$ 才升至 6.263,这种相互作用只有因子化视角能预警。其二,AWL 把推测采样接受规则搬进训练目标:权重 $\prod_{j<k}\alpha_j$ 恰是验证器到达该位置的概率,与固定衰减有本质区别,消融中贡献最大单步增量 +0.491 MAT。其三,推理侧单峰性有理论支撑($\Delta_{d+1}\le\Delta_d$ + 线性延迟 ⇒ $G_{d+1}-G_d$ 一旦为负便无法回正),并以 Table 2 证明混合视野 checkpoint 在所有 $bs$ 上优于或接近专用模型,支撑免重训配置选择。端到端 +9.1%/+7.1% 来自训练与配置的叠加。
实验结果
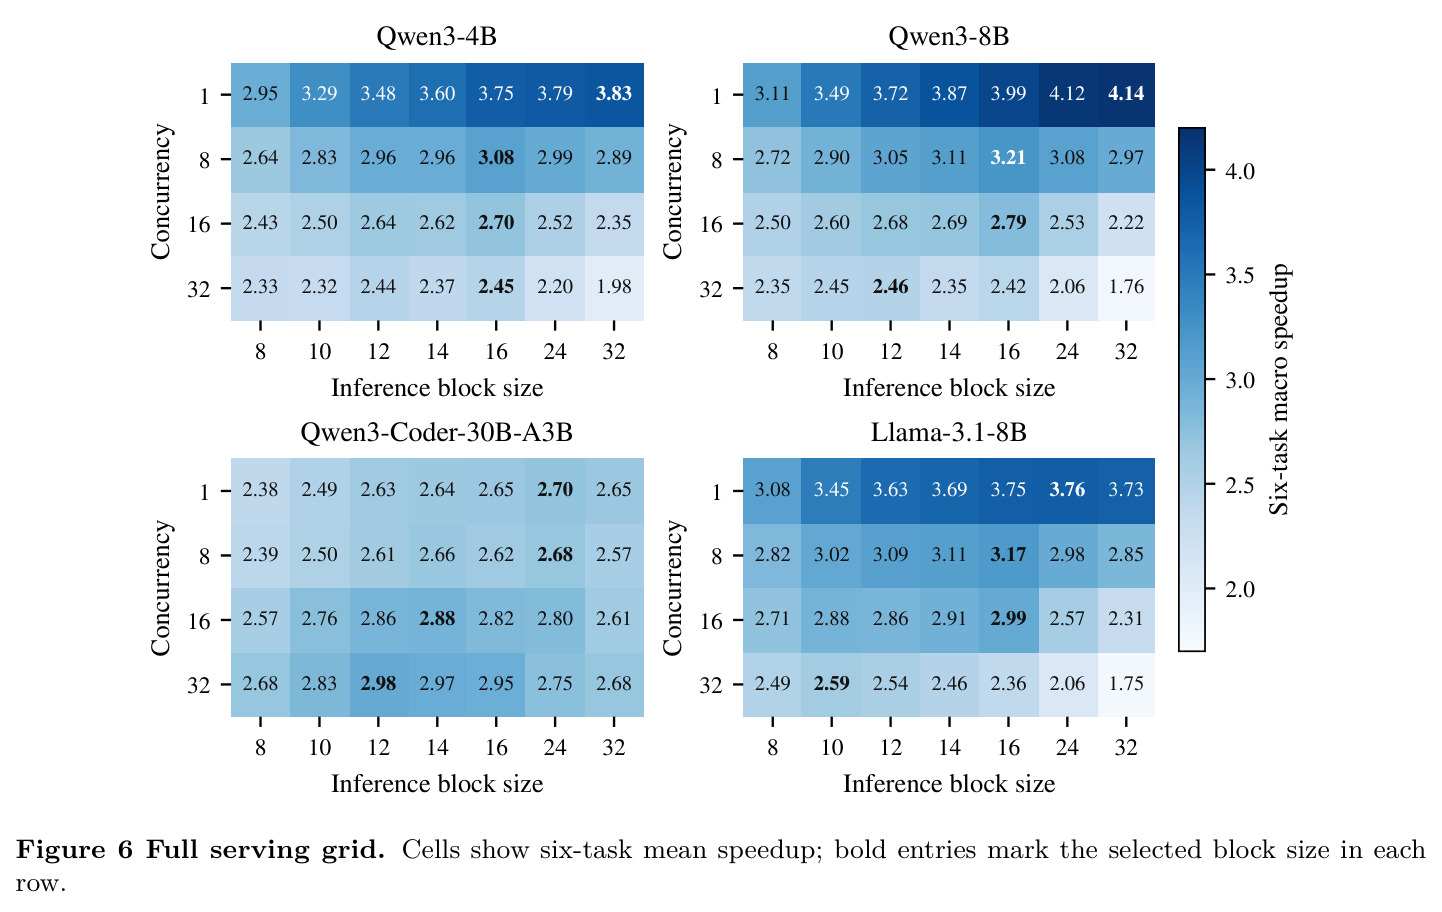
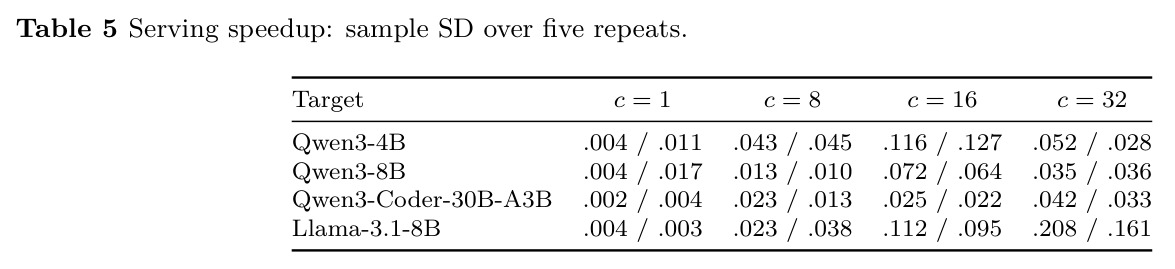
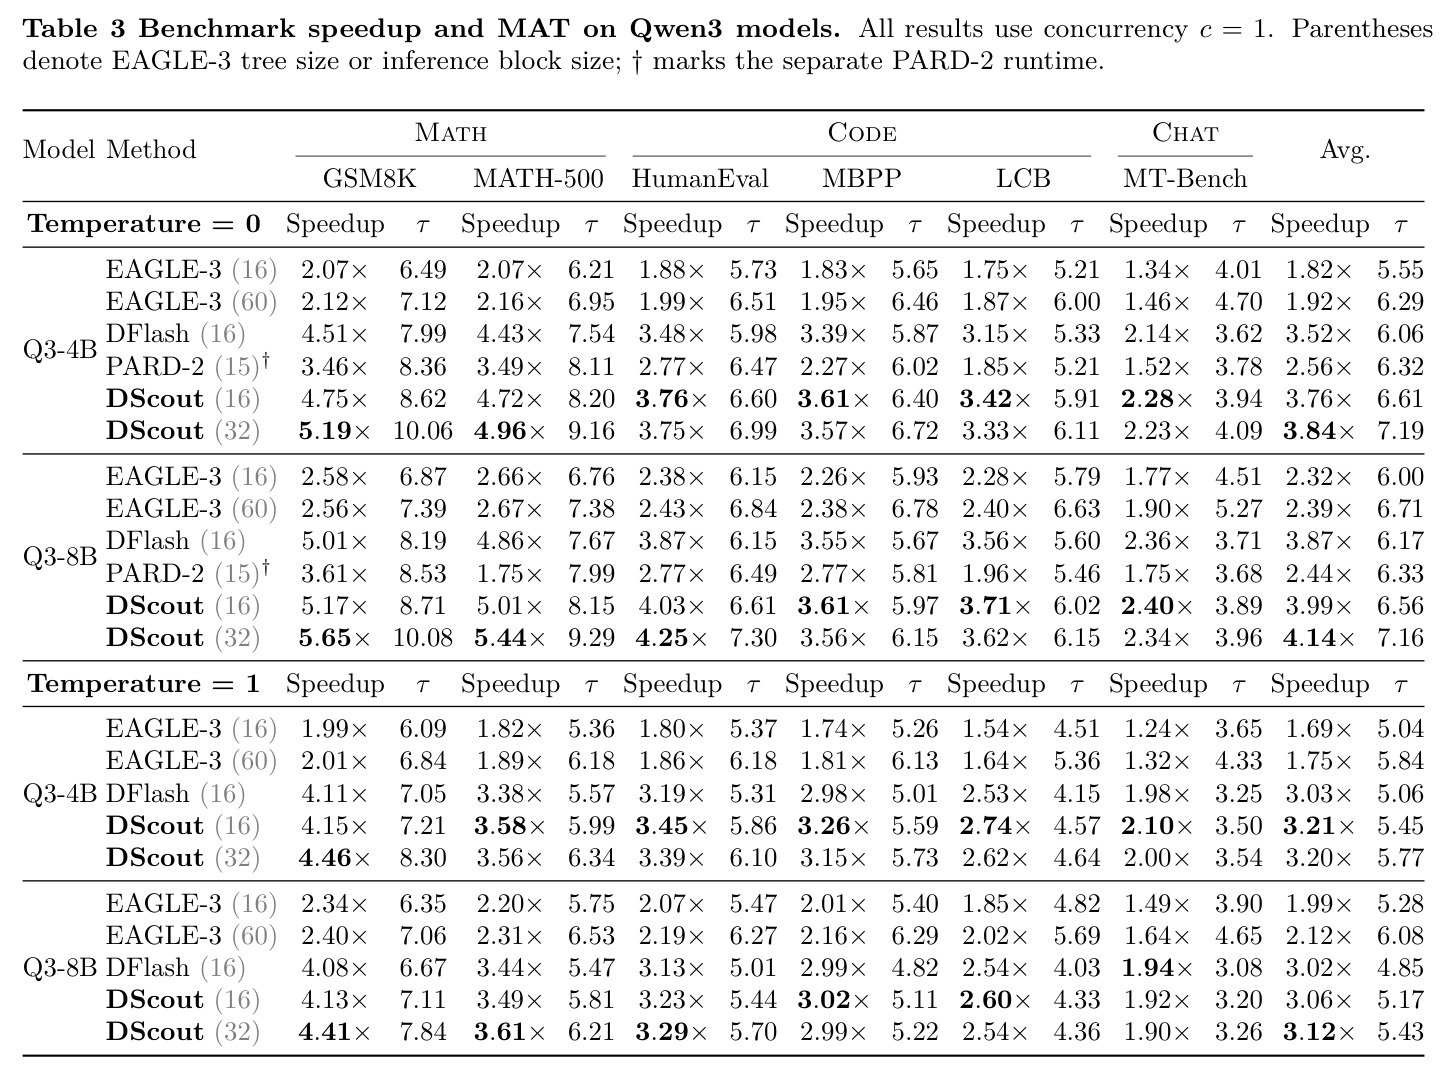
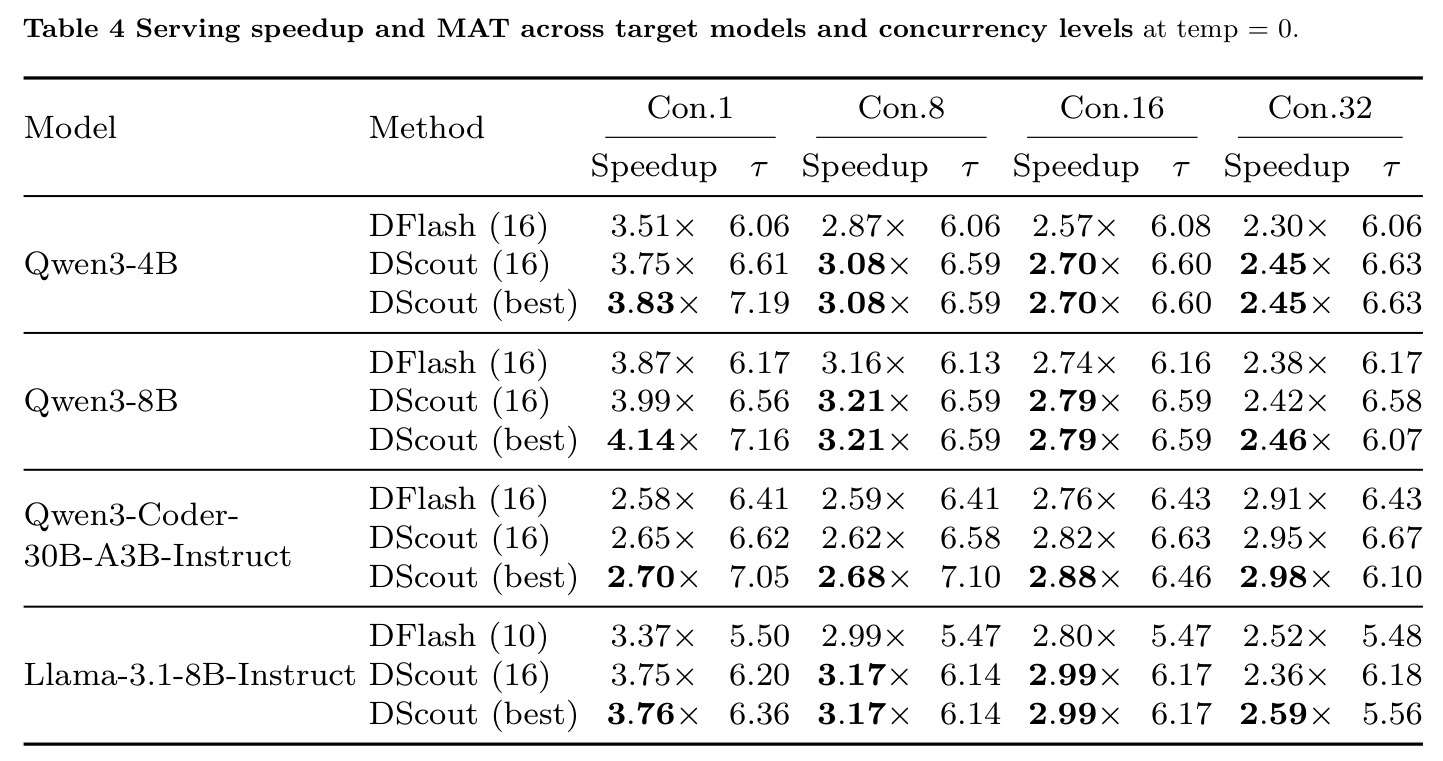
主实验覆盖 GSM8K、MATH-500、HumanEval、MBPP、LiveCodeBench、MT-Bench 六个基准,对比 EAGLE-3、DFlash(bs=16)、PARD-2,各方法配对相同模型/硬件/运行时/并发的 AR 基线,重复 5 次。温度 0、并发 1 时:Qwen3-4B 上 DScout(32) 平均 3.84×(MAT 7.19),较 DFlash 3.52× 提升 9.1%;Qwen3-8B 上达 4.14×(MAT 7.16),超 DFlash 3.87× 约 7.1%,EAGLE-3(60) 仅 2.39×、PARD-2 2.44×。分任务看,GSM8K 最高 5.65×(MAT 10.08,DFlash 5.01×/8.19),MT-Bench 仅约 2.4×,且数学任务 bs=32 占优、MBPP/LiveCodeBench/MT-Bench bs=16 更快,直接验证'高 MAT 不等于高吞吐'。温度 1 下优势保持(3.12× vs 3.02×)。服务场景(Table 4,$c\in\{1,8,16,32\}$)扩展到 Llama-3.1-8B 与 Qwen3-Coder-30B-A3B:DScout(best) 全部设置超 DFlash,达 2.45–4.14×;Llama-3.1-8B 在 $c{=}32$ 处固定 bs=16 落后(2.36× vs 2.52×),改选更短块后反超至 2.59×;配置选择相对固定 DScout(16) 最高 +9.75%。训练消融(bs=16)显示三策略累计提升 MAT 16.1%,单步 +0.151/+0.155/+0.171/+0.491。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 六基准平均(Qwen3-8B,temp 0,并发 1) | 相对 AR 平均加速 | DScout(32) 4.14×(MAT 7.16) | DFlash(16) 3.87×;EAGLE-3(60) 2.39×;PARD-2 2.44× | 较最强基线 DFlash +7.1%,较 EAGLE-3 约 +73% |
| 六基准平均(Qwen3-4B,temp 0,并发 1) | 相对 AR 平均加速 | DScout(32) 3.84×(MAT 7.19) | DFlash(16) 3.52×;EAGLE-3(60) 1.92×;PARD-2 2.56× | 较 DFlash +9.1% |
| GSM8K(Qwen3-8B,temp 0) | 加速 / MAT | DScout(32) 5.65× / 10.08 | DFlash 5.01× / 8.19 | 加速 +12.8%,MAT +2.3 个 token |
| MT-Bench(Qwen3-8B,temp 0) | 加速 / MAT | DScout(16) 2.40× / 3.89(bs=32 时 2.34× 反而更慢) | DFlash 2.36× / 3.71 | bs=16 时 +1.7%;说明最优块大小随任务而变 |
| 服务并发(Llama-3.1-8B,c=32,temp 0) | 六任务平均加速 | DScout(best) 2.59×(MAT 5.56) | DFlash(10) 2.52×;DScout(16) 2.36× | 块大小选择反超 DFlash +2.8%,较固定 bs=16 +9.7% |
| 训练配方消融(Qwen3-8B 9t9d,bs=16) | MAT 累计增益 | +16.1%(+0.151 / +0.155 / +0.171 / +0.491 逐步叠加) | DFlash 原始训练配方 | 无任何额外推理开销,AWL 单项贡献最大 |
局限与改进
作者承认的主要局限是推理配置粒度:当前对每个'目标模型 × 并发档位'只选一个共享块大小,无法在单次生成内随接受率与负载变化在线调整;讨论节提出可用近期接受统计与实测轮延迟做在线策略,但未实现。其次,单峰性定理依赖 MAT 增益递减与延迟线性增长两条假设,实测曲线存在局部波动(Figure 5),不能严格保证找到全局最优;深度搜索的每个候选仍需单独训练一个草稿器,成本不低。还可观察到:实验集中在 4B–30B 的开源权重模型与六类通用任务,未覆盖超长上下文、多模态与思考模式(实验明确关闭 Qwen3 思考模式);温度 1 下部分任务 DScout(32) 略逊于 bs=16,块大小敏感性依然存在;AWL 训练需要目标模型参与前向以计算 $P_j$,训练开销高于标准扩散草稿训练,且接受分数在分布外工作负载上的稳定性未做分析;'每并发度一个块大小'的粒度对混合负载在线服务仍显粗糙。
独立分析的弱点
独立分析有四个弱点。第一,配置选择是离线查表式的:需要预先在每个并发档位扫描,且每个深度候选都要单独训练草稿器,新模型或新硬件上线时搜索成本高,改进方向是把单峰性搜索做成在线 bandit 或基于接受率预测的自适应控制器。第二,AWL 的接受分数来自训练分布,服务时若用户提示分布漂移(如代码任务突增),权重与真实接受概率可能脱节,可在训练中加入任务混合采样,或周期性用真实服务轨迹校准权重。第三,Table 3 显示 MT-Bench 等开放对话任务加速仅约 2.3–2.4×,远低于数学任务的 5.65×,说明草稿器对自由生成任务的建模仍是短板,可针对聊天数据增加训练混合比例或引入任务感知的块大小路由。第四,吞吐分解 $G=\tau/T$ 把每轮延迟当作常数,忽略了批处理下延迟随并发与 KV 缓存状态的非线性变化——Llama-3.1-8B 在 $c{=}32$ 处 bs=16 被 DFlash 反超、需换更短块挽回即是例证——更精细的分解应引入并发相关的延迟模型 $T(t,d,bs,c)$,把调度器状态纳入配置决策。
未来方向
作者在讨论节明确提出:利用混合视野 checkpoint 天然支持不同块大小的特性,构建在线块大小自适应策略——用最近的接受统计与实测轮延迟,在单次生成内按 MAT-延迟权衡动态调整 $bs$,并在变化负载下评估相对固定配置能否持续占优、适应开销几何。在此基础上可延伸多个方向:其一,把深度选择与块大小选择合并为在线多臂老虎机问题,联合探索 $(d,bs)$ 组合以消除逐深度训练的成本;其二,将 AWL 推广到树形草稿或非均匀块结构,让权重与草稿拓扑联合优化;其三,把 inclusion/weighting/prediction 因子框架迁移到其他并行草稿范式(Medusa/Hydra 多头预测、PARD 并行掩码预测),检验其普适性;其四,与 SGLang/vLLM 的连续批处理调度器协同,把块大小选择下沉到请求级调度,按批内负载实时切换;其五,研究混合视野训练与蒸馏、量化草稿器的组合,进一步压缩每轮延迟 $T$,以及把在线策略与推测采样在温度 1 下接受率下降的应对相结合。
复现评估
论文未声明开源代码或权重,复现门槛中等偏高,但可复现要素较完整。数据侧:训练集为公开的 1.4M 条 Open-PerfectBlend 样本(配目标模型生成回答),六个基准全部公开,目标模型 Qwen3-4B/8B、Llama-3.1-8B、Qwen3-Coder-30B-A3B 均开源。方法侧细节充分:损失公式与 $\epsilon=10^{-6}$、视野集合 $\{8,16,24,32\}$、Beta 去掩码、35t6d 配置、6 epoch 训练均有交代,基线 EAGLE-3/DFlash/PARD-2 有官方代码与训练配方。算力需求不低:训练 GPU 需 80GB HBM,服务基准用 192GB HBM3 显卡,DScout/DFlash/EAGLE-3 依赖 SGLang + FlashInfer 定制集成,PARD-2 用独立 Transformers 运行时且需另配对齐 AR 基线。主要不确定性在于 AWL 训练需目标模型参与每步前向、成本高,端到端数字对 SGLang 版本与内核敏感;若作者放出代码复现难度可降为中等,纯按论文复现估计需多卡数周工程投入。
论文图表