StopWatch:物体目标导航中的显式目标接地 StopWatch: Goal Grounding for Object-goal Navigation
诊断出 VLM 导航策略败在目标接地,以双模型显式接地文本在六项基准全部登顶
前置知识
物体目标导航(Object-goal Navigation, ObjectNav)
具身导航任务:智能体被放进从未见过的室内场景,只给定一个目标物体类别名(如 towel、ottoman),需要在有限步数内自主搜索场景、找到该类别的一个实例并在其附近停下。与点目标导航不同,它同时考验开放语义识别、长时程空间搜索记忆以及到达目标后的停止判断。开放词汇版本进一步要求测试时的目标类别可以是训练中从未作为目标出现过的。
本文的全部诊断、系统设计与六个基准评测都建立在这个任务的定义之上,理解任务的两个成功条件(到达并停下)是理解全文的前提。
行为克隆(Behavior Cloning, BC)
最直接的模仿学习方法:把专家轨迹中的(观测, 动作)对当作监督数据,训练策略在每一步模仿专家动作,本质是最小化负对数似然 $\mathcal{L} = -\sum_t \log \pi(a_t \mid o_{\le t})$ 的监督学习。它无需设计奖励、训练稳定,但对专家未覆盖的状态分布偏移敏感,而且策略只能学到专家动作标签中显式包含的技能,标签之外的判断能力难以习得。
本文证明 BC 存在一个结构性盲区:专家演示只在结尾出现一次 STOP 动作,导致停止决策所需的目标接地能力监督极其稀疏,这正是现有策略失败的根源。
视觉语言模型与 VLA 微调(VLM / VLA fine-tuning)
VLM 指在网页级图文数据上预训练的多模态大模型(如 Qwen3-VL),具备开放世界的视觉语义知识。VLA(视觉-语言-动作)范式把预训练 VLM 用行为克隆端到端微调成直接输出动作的策略,是当前具身导航的主流做法。已有研究表明这种微调会损害模型原有的语义先验与语言理解能力,即预训练知识在被微调后未必还能被策略调用。
本文诊断的对象正是微调后的 VLM 导航策略:预训练的物体识别知识没有被激活用于停止判断,而显式接地文本的设计正是为了绕过这一退化。
开放词汇感知(Open-vocabulary)
指模型在测试时能够处理训练类别集合之外的词汇。对感知模型,意味着可以按任意文本查询来定位或分割物体;对导航任务,意味着目标词可以是训练演示中从未作为目标出现过的类别,策略必须依靠预训练语义知识而非记忆目标专属特征来完成泛化。
停止动作恰恰需要对未见目标的开放词汇识别能力,这是端到端 BC 策略最难泛化的部分,也是接地文本中 in_view 字段要直接解决的问题。
前沿探索(Frontier Exploration)
一种经典机器人探索策略:在已知区域与未知区域的边界(frontier)中选一个前进,逐步覆盖整个环境,直到发现目标。本文用它作为自动演示专家:在训练场景中不断探索,直到能接近某个可接受的目标实例,面向物体并停在 0.15 m 内。
它生成了 3.1M 条演示(约 2.5 亿帧),是策略与感知模型共同的训练数据来源;其探索行为容易被克隆而停止行为难以被克隆,这构成了本文失败诊断的经验基础。
链式思考与显式中间推理(Chain-of-Thought)
让模型在给出最终输出前先显式写出中间推理文本,已被证明能提升语言模型和 VLA 模型的表现。导航中的 NavCoT、Nav-R2 等工作让策略先生成计划或推理再行动,但这些自由文本通常由更大的 VLM 撰写,需要额外标注与质量控制,且文本内容的选择缺乏对策略缺什么的诊断依据。
本文的接地文本形似 CoT 但本质不同:只包含诊断实验发现的停止必需的两项信息,且从场景标注自动编译,零标注成本、每帧都有监督。理解这一对照才能把握本文的定位。
研究动机
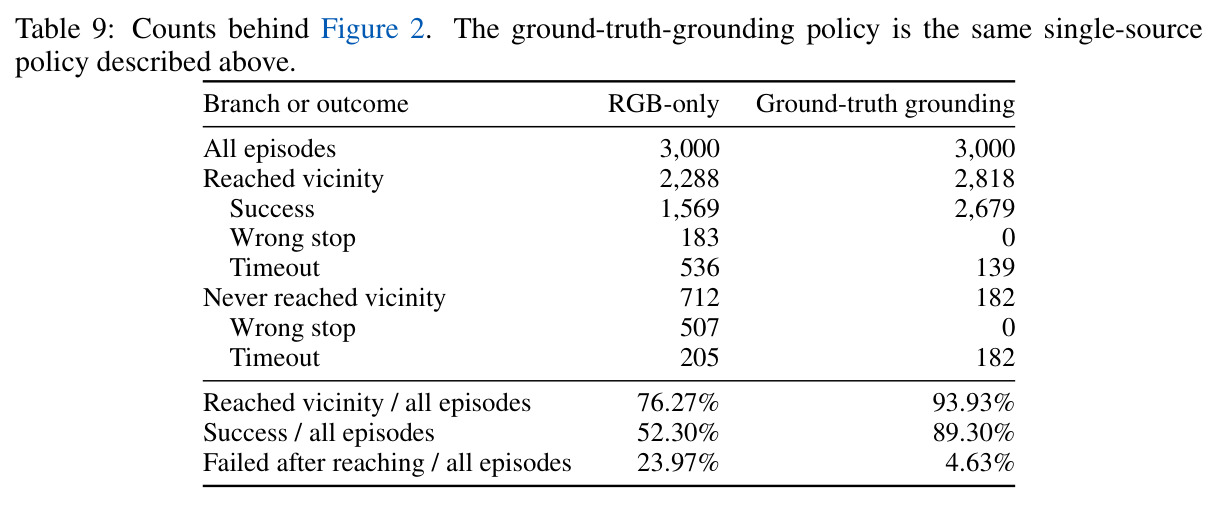
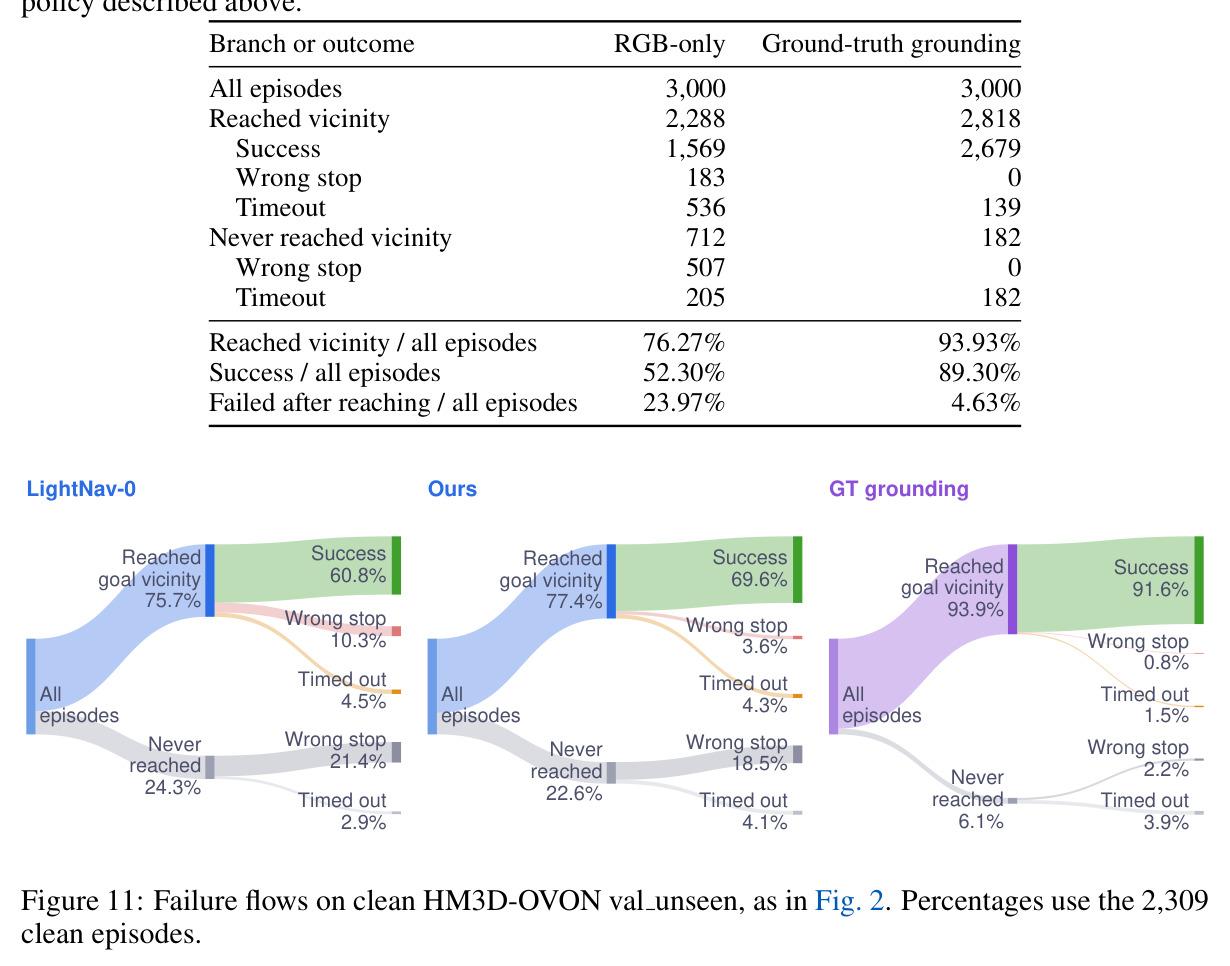
近年主流做法是把预训练 VLM 用行为克隆微调成导航策略(Uni-NaVid、LightNav-0、Nav-R2 等),靠更多演示和更好的观测历史建模来涨点,但在未见目标类别上成功率仍然很低,继续扩大数据规模收益递减,而且没有人说清楚这些策略到底缺哪一种能力。本文用 HM3D-OVON val unseen 的 3000 个回合做了精确解剖:一个端到端 RGB 策略在 76.3% 的回合中曾进入目标 0.25 m 范围内,最终成功率却只有 52.3%——它像专家一样探索并找到了目标,却径直走过不停。细拆失败类型:到达后错误停止占 6.1%、到达后超时占 17.9%、从未到达区间内乱停的占 16.9%。根源在于任务的两部分对模仿学习极不对称:探索行为在每条演示的每一帧都密集出现,容易克隆;而停止依赖“目标是否在视野内、距离多远”的判断(作者称之为 goal grounding,目标接地),监督却极稀疏——每条演示只有结尾一个 STOP 动作,且只有训练目标类别才有此标签,模仿学习因此无法把 VLM 的预训练语义知识激活到未见类别上。此外评测本身也不可靠:HM3D/MP3D/HSSD 的物体标注是自由文本,picture 这一个物体类型就有 14 种写法(picture 54.8%、painting 29.4%、photo 5.4% 等),而官方判据只认与目标词精确匹配的标注名,导致把 couch 判给 sofa、picture 判给 painting 的正确停止都被记为失败;标注还有两类错误——可见目标没有标注(假阴性)、名字标错(假阳性,如书架被标成 dresser),人工审计发现 HM3D-OVON val unseen 约 23%(691/3000)的回合受影响。
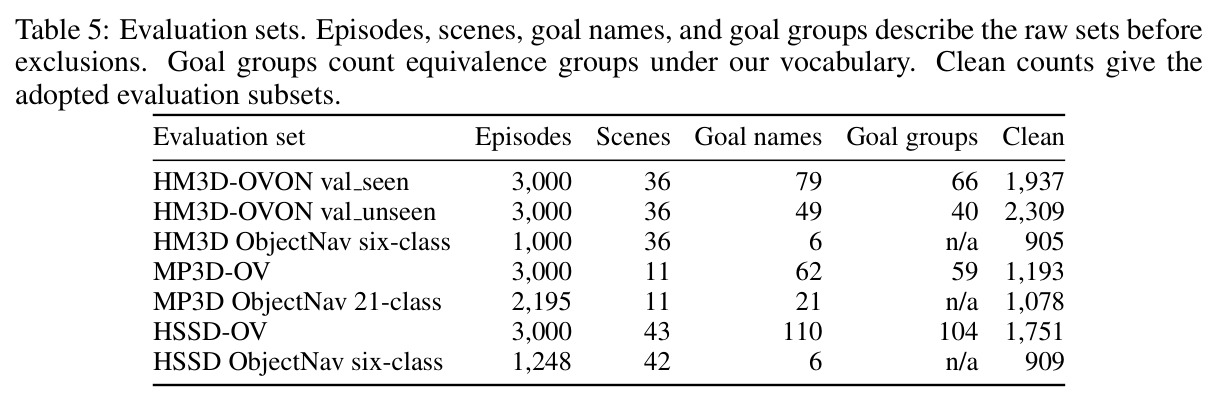
本文的目标是本文有三层目标。第一,诊断:明确指出微调 VLM 导航策略缺失的能力是目标接地,即判断目标是否在视野内(goal visibility)以及目标距离多远(goal distance),并把这一原本隐含在策略权重里的过程变成可测量、可干预的科学问题。第二,求解:设计一个让目标接地显式化的导航系统——在每步动作之前先给出“视野内有哪些物体、目标是否可见、目标距离处于哪个区间”的结构化文本,再基于它决定动作——使系统在六个物体目标导航基准(覆盖 HM3D、MP3D、HSSD 三套场景)上全部达到 SOTA。第三,纠偏:修复现有基准的评测缺陷,把 2,408 个原始标注名合并为 540 个物体等价类、人工审计剔除有标注错误的回合、改用“停在距能看清目标的视点 0.25 m 内”的判据,并发布两个新的开放词汇基准 MP3D-OV 与 HSSD-OV,让未来方法的对比更忠实。
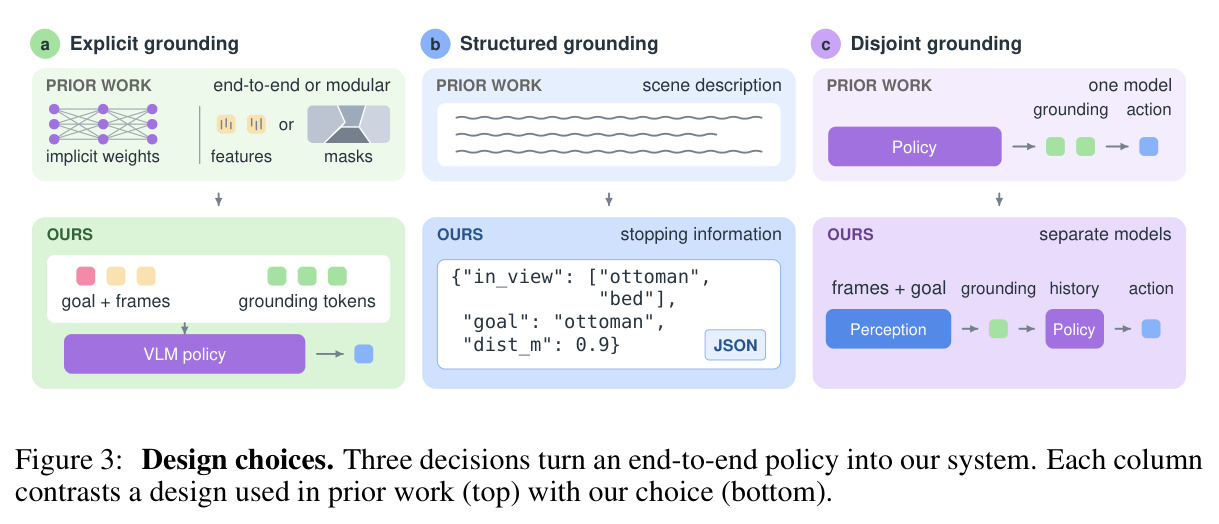
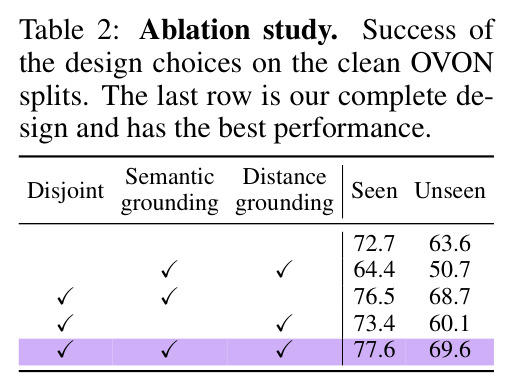
与已有工作不同的是,独特的切入角度是“先诊断、后开药”。此前让策略在动作前生成文本的工作(NavCoT、Nav-R2、Aux-Think、OctoNav 等)都属于中间推理路线,其文本内容——计划、子任务、指令进度——由设计者凭直觉选择、由更大的 VLM 撰写,既昂贵又有噪声,且没有任何证据说明策略缺的正是这些信息。本文反其道而行:先用 ground-truth 接地做对照实验定位瓶颈——同一策略加上真实接地文本后,成功率从 52.3% 跳到 89.3%,到达后失败从 24% 降到 4.6%,错误停止从 183 例降到 0——确认缺的就是“视野内语义 + 目标距离”这两项,然后直接从训练场景已有的语义与几何标注中编译出这两项作为监督信号,每帧一条、零额外标注成本,类别清单还顺带覆盖了从未作为训练目标的类别。另一个反直觉发现是:接地不应在单一模型内以 CoT 方式自产自销——单模型联合输出接地与动作只有 50.7%,比不加接地的 63.6% 还低——而应拆成感知与策略两个独立模型,这打破了端到端一体化的流行范式。
核心方法
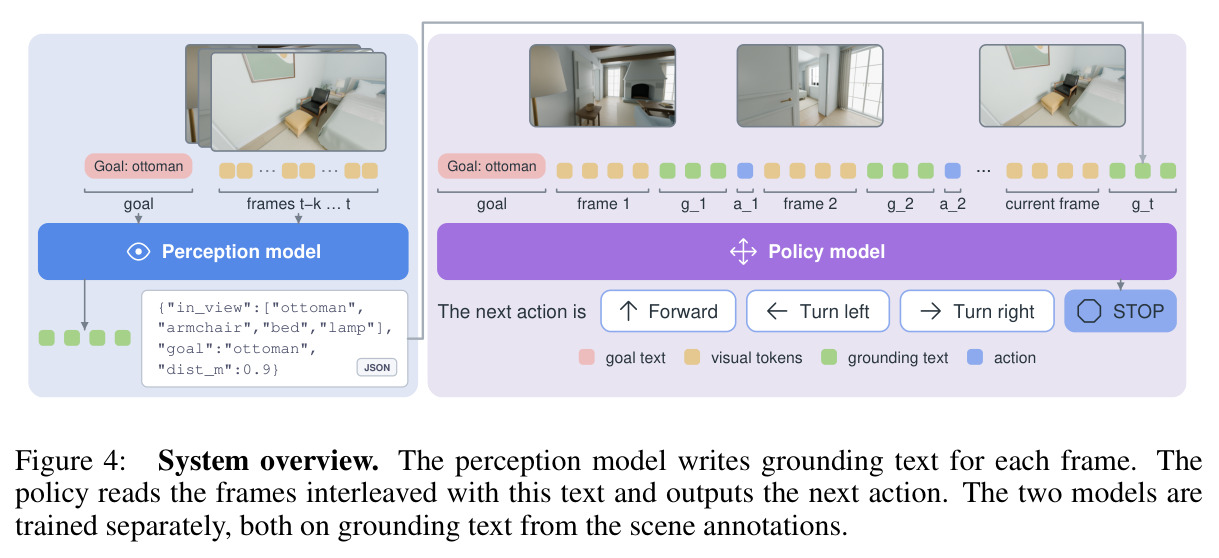
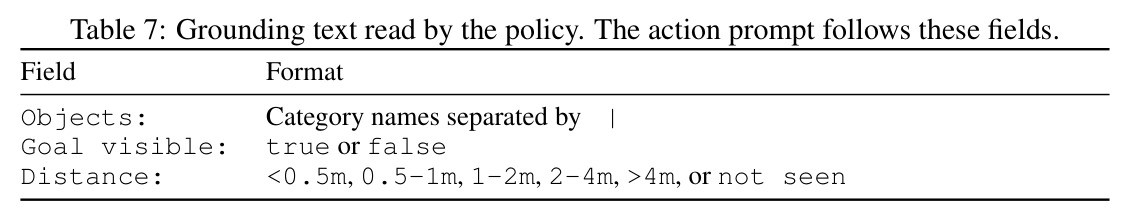
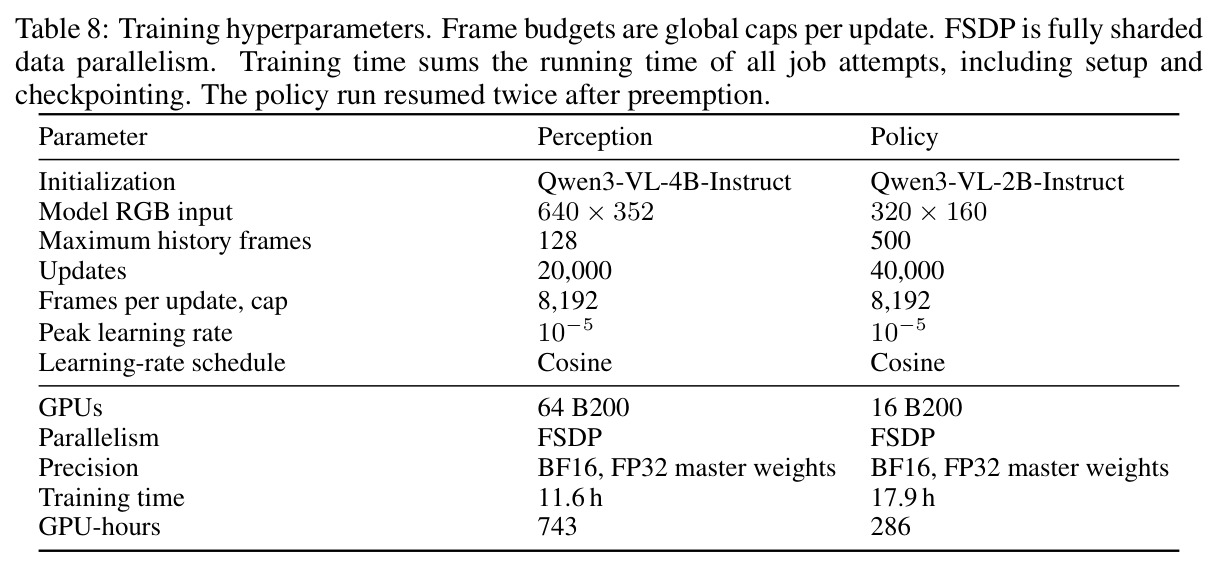
直觉上,系统把导航拆成两个可以各自独立训练、独立改进的子问题:看得懂(这个画面里有什么、目标多远)和走得对(下一步去哪、该不该停)。技术路线是一个以结构化文本为接口的两模型流水线。感知模型由 Qwen3-VL-4B 微调而来,输入最近的 RGB 帧(640×352,训练时另有专家动作历史,最多 128 帧),输出一条 JSON 接地文本,例如 {"in_view": ["ottoman", "armchair", "bed", "lamp"], "goal": "ottoman", "dist_m": 0.9},包含三个字段:视野内物体类别清单、目标是否可见、目标距离档位(<0.5m / 0.5-1m / 1-2m / 2-4m / >4m / not seen)。策略模型由 Qwen3-VL-2B 微调,输入目标词与“帧-接地文本”交错的历史序列(最多 500 帧,模型输入 320×160),输出四个离散动作之一:前进、左转 30°、右转 30°、STOP。两个模型分别用同一套来自场景标注的接地文本做监督、用行为克隆独立训练:感知模型学习逐帧预测由标注编译出的接地文本,策略模型在真实接地文本条件下学习模仿前沿探索专家的动作。训练数据为 145 个 HM3D、61 个 MP3D、123 个 HSSD 训练场景中的约 3.1M 条演示(约 2.5 亿帧),评测场景与训练完全不重叠。部署时感知模型每帧写一次接地文本,策略模型边读边走;评测时把预测文本换回真实文本即可测出设计上限(GT grounding 行),两者之差就是感知不完美付出的代价。
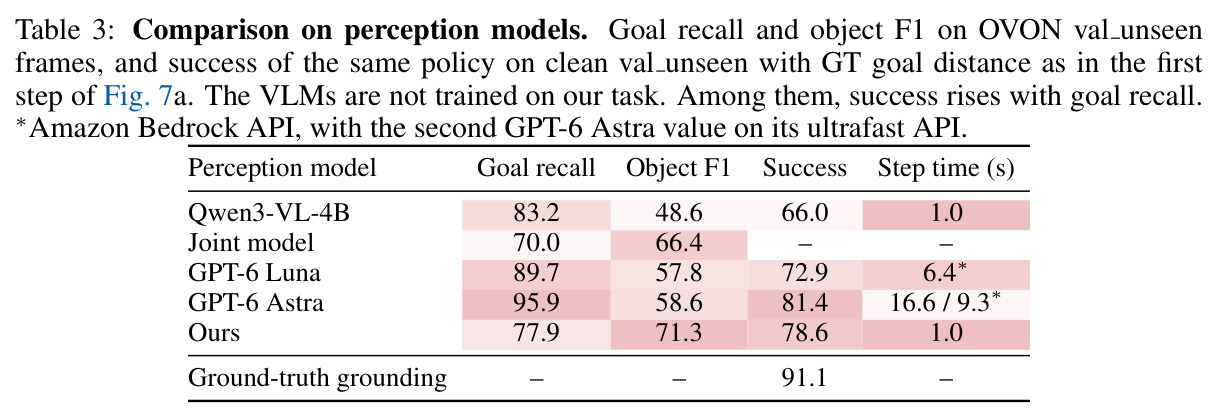
核心创新是“显式、结构化、分离”三个设计决策(Fig. 3)。显式:把接地从策略权重中的隐式计算变成策略每一步都读得到的输入文本——模仿学习只能从每条演示唯一的一个 STOP 动作中隐式学接地,监督太稀疏,无法把 VLM 的预训练知识用于未见类别;显式文本让每一帧都成为接地监督,且文本是 VLM 本来就会读的输入形态,不需要新增编码器。结构化:与自由形式的 CoT 推理不同,文本内容被压缩为停止决策真正需要的两项——视野内物体类别清单和目标距离档——直接由场景语义与几何标注编译而成,无需大模型撰写、天然无噪声;清单中包含非目标物体,等于免费获得了对非训练目标类别的开放词汇监督,监督密度从每回合一条变成每帧一条。分离(disjoint grounding):测试时接地必须被预测出来,最自然的做法是单模型“自言自语再行动”,但实验表明这样反而更差(50.7% vs 不接地的 63.6%);本文让专职感知模型写文本、专职策略模型读文本行动,各自只面对单一任务的纯净监督。感知由此变成可独立扩展和替换的模块——把感知模型换成 GPT-6 Astra,同一策略成功率从 78.6% 升到 81.4%,无需重训策略。与经典模块化导航系统的本质区别在于:策略不是按固定规则消费接口信号,而是仍然端到端地看每一帧、从演示中学习搜索与停止。
方法步骤详情
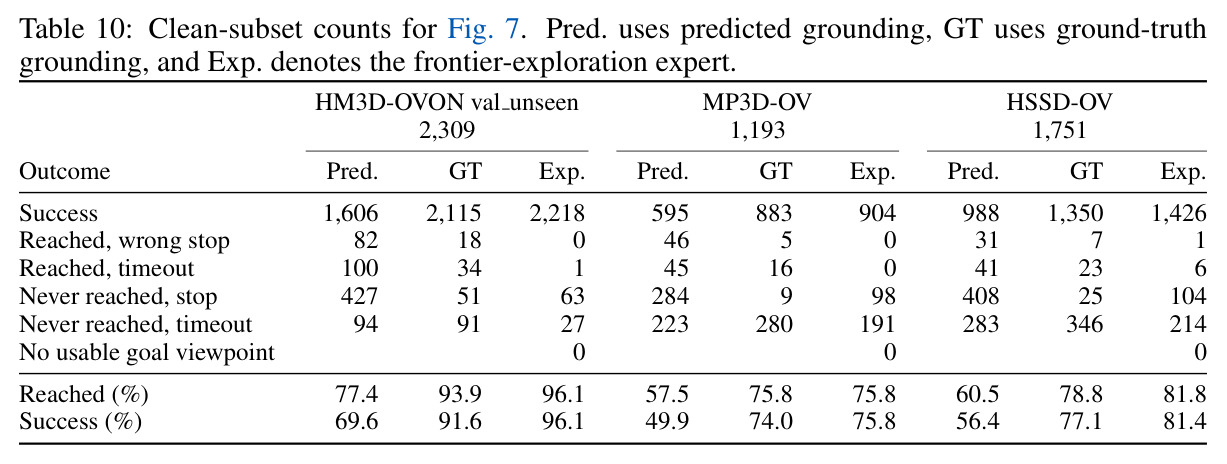
第一步,诊断实验(Sec. 3.2):在 HM3D-OVON val unseen 全部 3000 回合上,用同一套前沿探索专家演示各训练一个 Qwen3-VL-2B 策略 20000 步,一个只读 RGB 与历史动作,另一个额外在每步动作前读入真实接地文本(距离档边界 0.15/0.25/0.5/1/2/4 m)。结果:到达率 76.3%→93.9%,成功率 52.3%→89.3%,到达后失败 24.0%→4.6%,错误停止 183→0 例,确认接地是缺失能力。第二步,编译接地文本(附录 F):对每条演示的每一帧从场景语义标注编译三个字段——视野内物体类别清单(按画面面积降序、至多 16 类、需通过由训练实例几何导出的面积阈值)、目标可见性(是否在清单内)、目标距离档(到最近可接受目标视点的测地距离分箱)。第三步,训练感知模型:Qwen3-VL-4B-Instruct 初始化,输入 640×352 RGB 与最多 128 帧历史,20000 次更新、每次至多 8192 帧,峰值学习率 $10^{-5}$ 余弦退火,64 张 B200 训 11.6 小时(743 GPU 时)。第四步,训练策略模型:Qwen3-VL-2B-Instruct 初始化,输入 320×160 RGB 与最多 500 帧的“帧+真实接地文本+动作”交错历史,40000 次更新,16 张 B200 训 17.9 小时(286 GPU 时)。第五步,测试组装(Fig. 4):感知模型逐帧输出预测接地文本,策略模型读目标词与交错历史输出下一动作(Forward/Left/Right/STOP),Stretch 本体,动作预算 500 步。第六步,修正评测(Sec. 3.4、附录 E):合并 2,408 个原始标注名为 540 个等价类;人工审计剔除标注假阴性/假阳性的回合(HM3D-OVON val unseen 剔除 691/3000,留 2,309 干净回合);成功判据为停在距任一可接受目标视点(从该视点看目标占画面超过 5%)0.25 m 测地距离内。
技术新颖性
技术新颖性体现在四个对比维度。对比自由文本 CoT 导航(NavCoT、Aux-Think、Nav-R2):它们的推理文本由大模型撰写、内容凭设计者直觉选定且没有诊断依据;本文的接地内容由诊断实验反推得出、只含停止必需的两项信息、从场景标注零成本编译,监督从每回合一条变成每帧一条。对比端到端 VLA 一体化范式:本文用消融证明单模型联合输出接地与动作反而损害导航(50.7% vs 63.6%),而感知/策略分离让感知成为可即插即用的模块——GPT-6 Astra 直接接入就从 78.6%→81.4%——这与社区一窝蜂做更大端到端模型的路线形成方法论对照。对比经典模块化系统(SemMap、VLFM 等):模块化方法把检测/语义图等信号喂给固定规则的规划器,本文的策略则继续以演示学习的方式消费全部视觉历史,只在停止决策上引入显式文本信号,兼得模块化的可诊断性与学习的灵活性。对比开放词汇检测器直连(Grounding DINO、OWLv2、SAM 3):作者尝试过用现成开放词汇检测器生成语义字段,但因标签体系与开放词汇标注不一致、预测不够准确反而干扰策略——这说明任务定制微调仍有价值(本文感知模型 object F1 71.3,远高于未微调 Qwen3-VL-4B 的 48.6)。此外,对基准标注缺陷的系统修复(2,408→540 类合并加 23% 回合审计剔除)本身也是对社区评测方法学的独立贡献。
实验结果
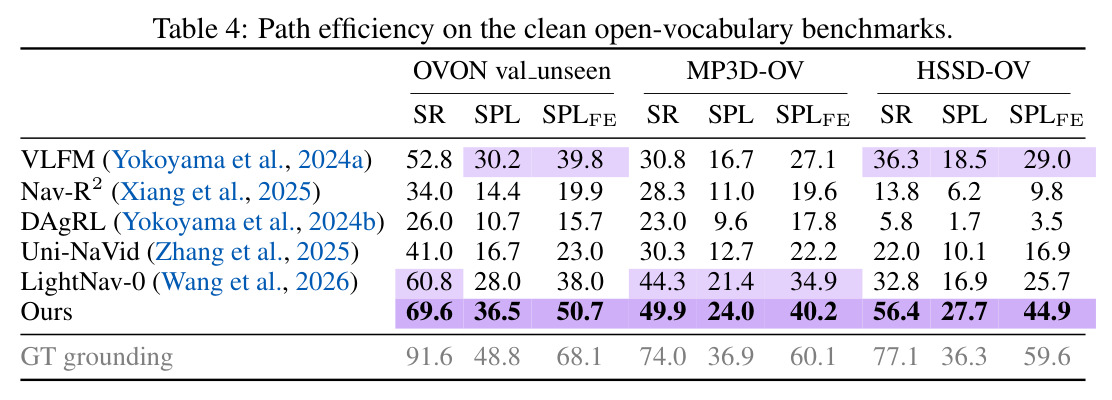
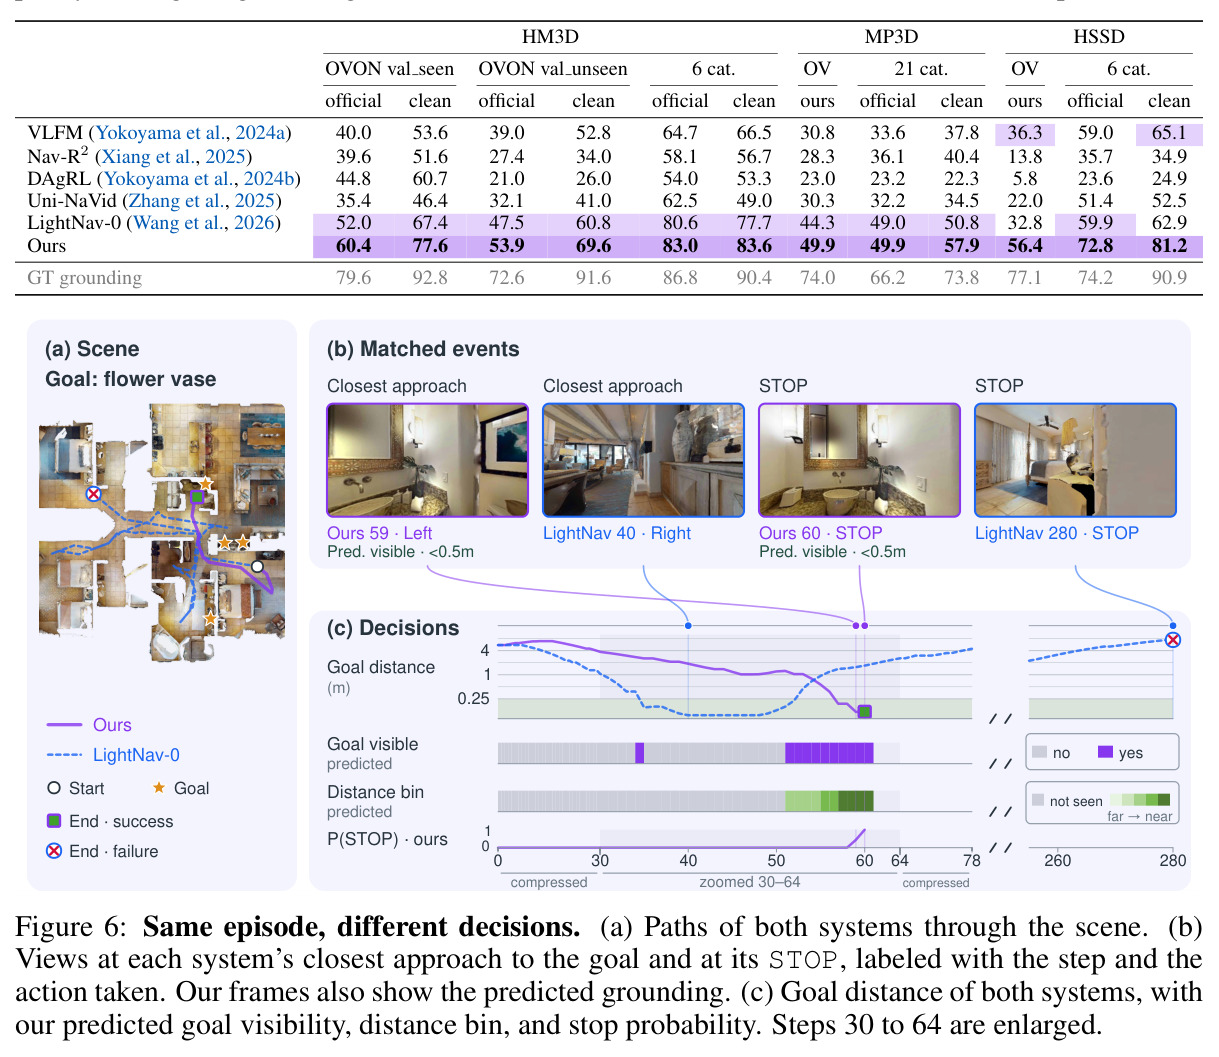
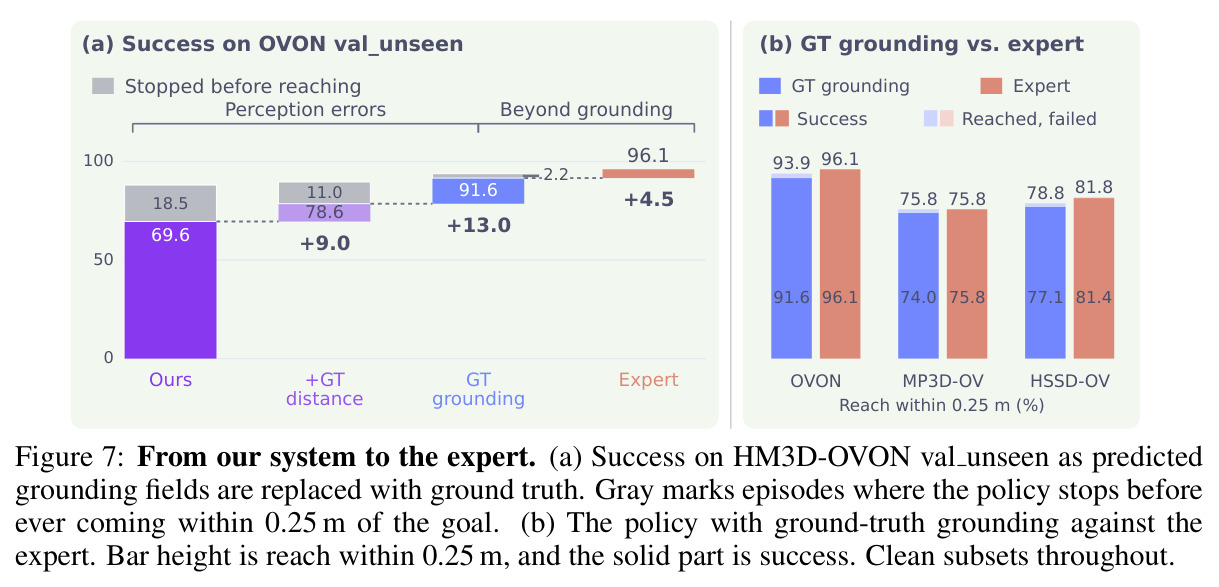
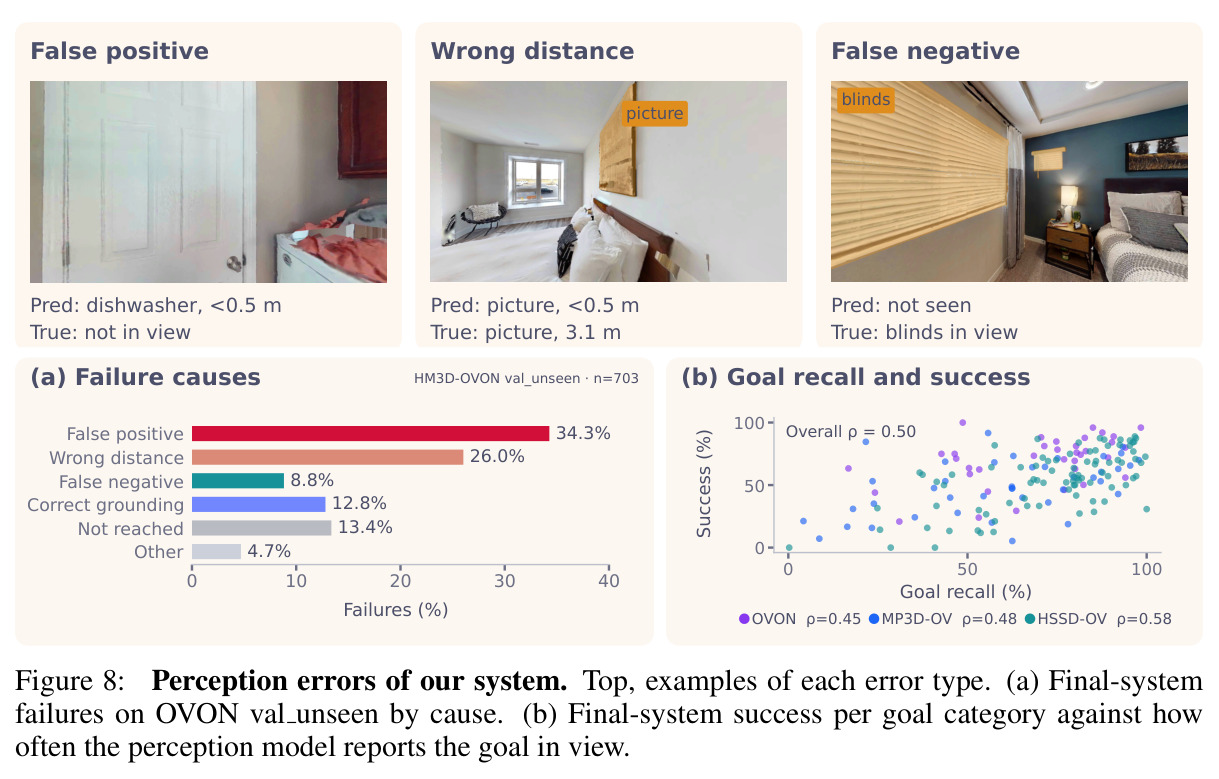
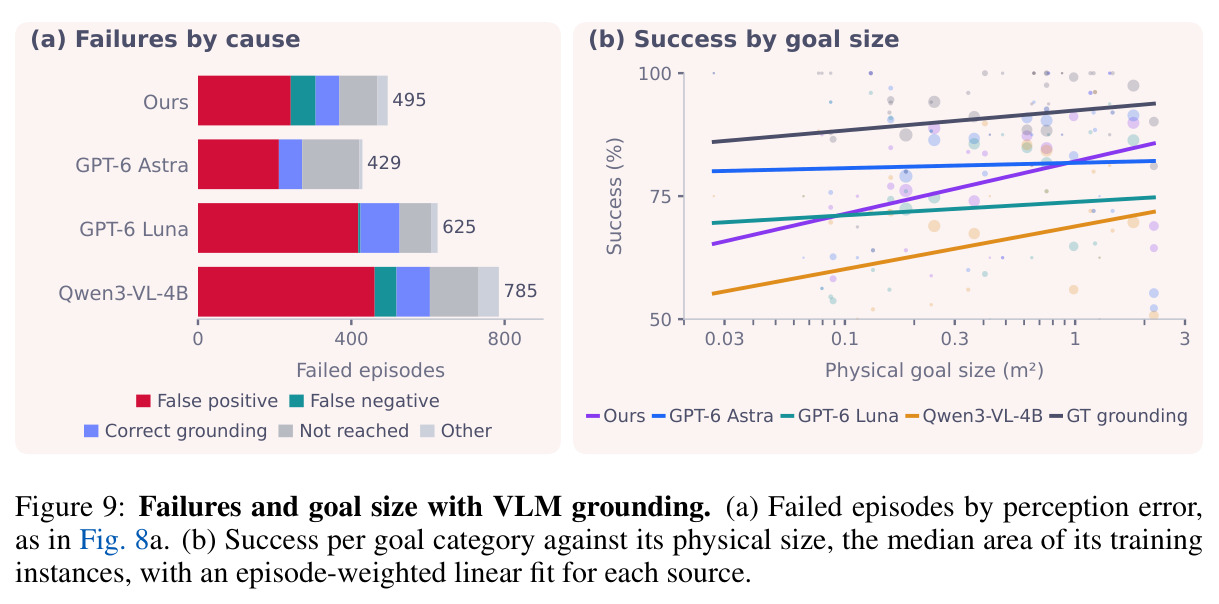
六个基准、两种协议全胜(Tab. 1)。HM3D-OVON val unseen 干净协议下本文 69.6%,最强基线 LightNav-0 60.8%,领先 8.8 个百分点(官方协议 53.9% vs 47.5%,领先 6.4);val seen 干净 77.6% vs 67.4%;HM3D ObjectNav 6 类干净 83.6% vs 77.7%;自建 MP3D-OV 49.9% vs 44.3%;MP3D 21 类干净 57.9% vs 50.8%;自建 HSSD-OV 56.4% vs 32.8%;HSSD 6 类干净 81.2% vs 62.9%。路径效率同样领先:OVON val unseen 上 SPL 36.5 vs 28.0、SPLFE 50.7 vs 38.0(Tab. 4)。胜利主要来自停止:一旦进入目标 0.25 m 内,本文系统 90% 成功,LightNav-0 只有 80%;干净协议下 LightNav-0 到达后错误停止占 10.3%,本文降到 3.6%(Fig. 11)。设计消融(Tab. 2,干净 val unseen):无接地 63.6%;单模型自产接地 50.7%(反而最差);分离+仅语义字段 68.7%;分离+仅距离字段 60.1%;完整设计 69.6%——分离最重要、语义字段贡献最大。感知是剩余瓶颈(Fig. 7a):把预测接地逐步换成真实值,仅换真实距离 69.6%→78.6%(+9.0),再换真实类别清单→91.6%(+13.0),距专家的 96.1% 只差 4.5 个点;有真实接地时策略的到达率在三套场景上几乎追平生成演示的专家(93.9% vs 96.1% 等,Fig. 7b),说明策略已饱和、剩余提升空间在感知。感知错误归因(Fig. 8a,703 个失败回合):假阳性 34.3%、距离低估 26.0%、假阴性 8.8%,可见性判断错误合计 43%;各类别成功率与感知目标召回率正相关(总体 ρ=0.50),小而薄的物体(衣架、瓶子、书)最难。换更强感知即涨点(Tab. 3):未微调 Qwen3-VL-4B 66.0%、GPT-6 Luna 72.9%、GPT-6 Astra 81.4%(但每步 16.6 s,慢 9-17 倍)、本文感知模型 78.6%(1 s/步),真实接地上限 91.1%。评测修正的影响:干净协议把专家成功率从官方 72% 抬到 96%,说明官方判据下的“剩余提升空间”大半是评测假象。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| HM3D-OVON val unseen(开放词汇,干净协议) | 成功率 SR (%) | 69.6 | LightNav-0:60.8 | +8.8 |
| HM3D-OVON val seen(开放词汇,干净协议) | 成功率 SR (%) | 77.6 | LightNav-0:67.4 | +10.2 |
| HM3D ObjectNav 6 类(封闭词汇,干净协议) | 成功率 SR (%) | 83.6 | LightNav-0:77.7 | +5.9 |
| MP3D-OV(开放词汇,本文新建) | 成功率 SR (%) | 49.9 | LightNav-0:44.3 | +5.6 |
| MP3D ObjectNav 21 类(封闭词汇,干净协议) | 成功率 SR (%) | 57.9 | LightNav-0:50.8 | +7.1 |
| HSSD-OV(开放词汇,本文新建) | 成功率 SR (%) | 56.4 | LightNav-0:32.8 | +23.6 |
| HSSD ObjectNav 6 类(封闭词汇,干净协议) | 成功率 SR (%) | 81.2 | LightNav-0:62.9 | +18.3 |
局限与改进
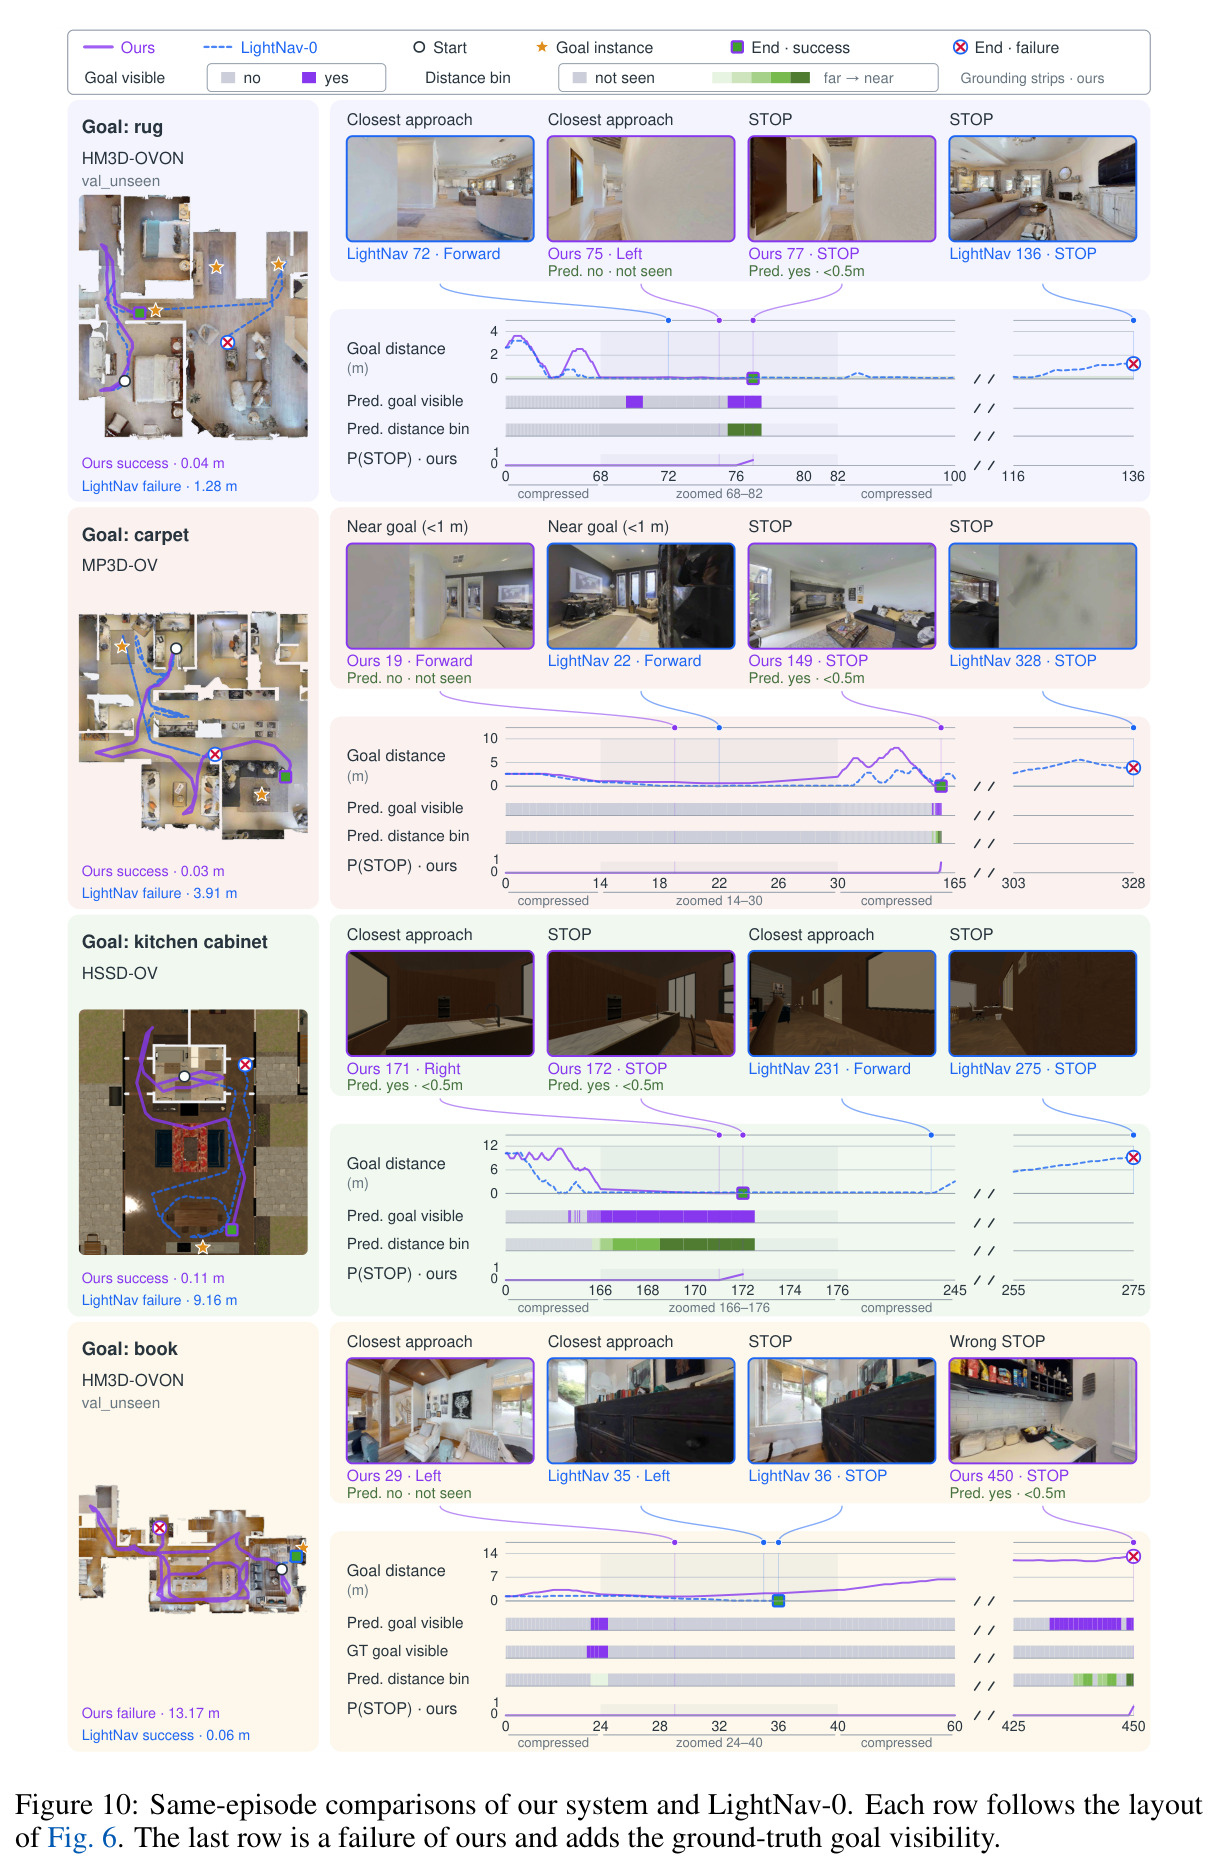
作者承认两条局限(Sec. 5):其一,接地监督完全依赖 3D 场景的语义与几何标注,训练数据被锁定在有标注的场景合集(HM3D/MP3D/HSSD),无法利用真实机器人视频等更大规模的无标注数据源;其二,只在静态室内仿真环境中评测、未做真机验证(作者推断增益可迁移,因为主要在同一批仿真场景上训练的 LightNav-0 已能真机零适配运行)。我自己的观察还有几点:其一,策略对感知文本是无条件信任的——假阳性占失败的 34.3%,策略一读到“目标可见 <0.5m”就停,缺少置信度校验或多帧一致性检查(Fig. 10 的 book 回合正是感知在 13.17 m 外误报导致失败);其二,距离只有 5 个粗档且低估普遍(占失败 26%),相对 0.25 m 的成功判据,分辨率是明显瓶颈;其三,修正后的评测使用自定义 540 类词表和“目标占画面 >5%”的视点判据,虽然更忠实,但数字与官方排行榜不可直接比较,且干净子集剔除了约四分之一回合(多数基准不足 2000 回合),统计功效有所下降;其四,双模型串联带来双倍前向开销,感知模型每步 1 s,对实时机器人部署偏慢。
独立分析的弱点
弱点一:感知假阳性是最大失败源(34.3%),而策略对文本零怀疑。改进方向:让感知输出附带置信度,或在策略训练时向接地文本注入少量噪声,让策略学会“连续多帧确认再停”,也可引入跨帧投票机制。弱点二:距离分箱太粗且低估普遍(26% 失败)。改进方向:把分箱分类改为连续距离回归,或直接融合深度信息——0.25 m 的判据意味着半米内的距离误差就足以决定成败。弱点三:单模型联合接地彻底失败(50.7%),暴露了动作 token 与接地 token 联合训练的互相干扰,但本文只验证了“分离”这一种解法;冻结 VLM 主干、用 LoRA 分支输出接地的辅助损失方案,或课程式先接地后动作训练,可能兼得一体化架构的效率与分离架构的性能。弱点四:小目标召回低(衣架、瓶子、书等细薄物体),类别成功率与召回的相关性 ρ=0.50;改进方向是主动注视——靠近可疑区域多视角确认,或训练时对小目标过采样。弱点五:训练依赖 3D 标注这一硬约束尚未破除,显见的出路是用 GPT-6 Astra 级别的强模型为视频数据生成伪接地标签做蒸馏,摆脱对场景标注的依赖。弱点六:干净评测剔除了大量回合并依赖自定义词表,与官方数字不可比,社区采纳和第三方复现审计都有摩擦成本。
未来方向
作者提出的方向:一是脱离 3D 场景标注、从真实视频学习接地,打开互联网级数据源;二是真机验证,把仿真中的增益搬到家庭机器人;三是替代架构探索——单模型加接地目标函数、或具备目标推理能力的 agentic 系统——作者明确希望其发布的干净基准成为这些路线的公平赛场。基于本文成果可自然延伸的:其一,系统化利用感知-策略解耦的即插即用特性,把 GPT-6 Astra 级别的接地能力蒸馏进 4B 快速感知模型,有望把干净 val unseen 从 78.6% 推向 85% 以上;其二,把接地文本从两项扩展到更多停止相关线索(遮挡程度、目标朝向、实例计数),并沿用“诊断实验驱动内容选择”的方法论;其三,迁移配方到其他具身任务——视觉语言导航(指令指定目标)、移动操作(找到后还要抓取)、室外导航——“显式任务关键中间量 + 双模型文本接口”的思路具有普适性;其四,把修正评测发现的标注缺陷反馈给 HM3D/MP3D/HSSD 数据集维护方,从源头修复;其五,让接地反哺探索:目前感知只在“该不该停”上发言,未来可让接地文本参与前沿选择,判断哪个 frontier 更可能藏着目标。
复现评估
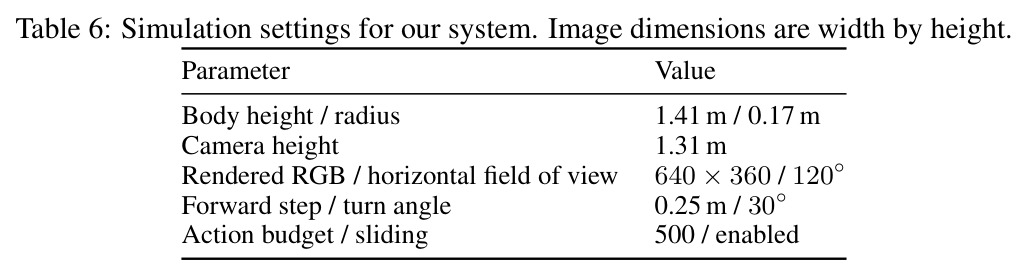
复现条件较为友好但也有门槛。有利因素:项目主页 https://stopwatch-nav.github.io;基础模型 Qwen3-VL-4B/2B-Instruct 开源;训练数据来自公开场景数据集(HM3D、MP3D、HSSD)加全自动的前沿探索专家,无需人工标注演示;作者承诺发布修正后的评测协议与两个新基准(MP3D-OV 1,193 回合、HSSD-OV 1,751 回合)及 540 类词表。算力需求明确且不算夸张:感知模型 64 张 B200 共 743 GPU 时(11.6 h),策略模型 16 张 B200 共 286 GPU 时(17.9 h),合计约 1,030 GPU 时,有 B200/H100 集群的实验室一两天即可完成;没有集群也可用 GPT-6 API 部分复现核心结论(但每步 6-17 s)。仿真在 Habitat 中用 Stretch 本体,全部参数公开(Tab. 6:相机 640×360、水平视场 120°、前进 0.25 m、转角 30°、预算 500 步)。主要门槛:HM3D-OVON 等数据集需签署使用协议;干净评测的回合审计(剔除 23%)依赖作者发布的审计结果,自行重做成本高;论文未逐项确认代码与权重的开放范围,若只放评测不放权重,复现 SOTA 数字需自行重训。总体评估:架构与数据管线不复杂、训练预算中等,难度中等,适合有 GPU 集群与 Habitat 经验的团队复现。
论文图表
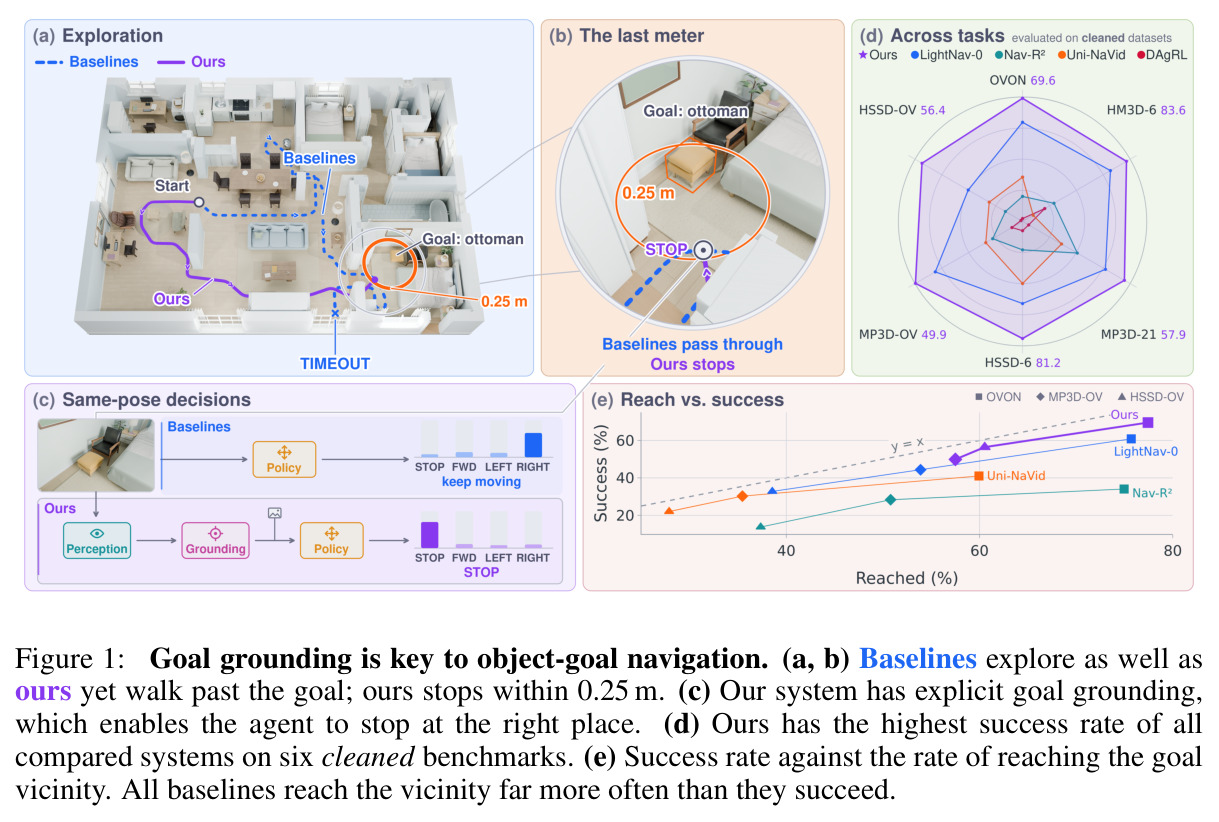
五联总览图:(a)(b) 同一场景的对比回合,基线(如 LightNav-0)走近目标却径直走过,本文系统停在 0.25 m 内;(c) 展示系统的显式接地机制使智能体停在正确位置;(d) 六个清洗后基准上各系统成功率柱状图,本文全面最高;(e) 成功率对“进入目标附近比率”的散点图,所有基线的到达率都远高于其成功率。
一图总括论文的诊断(到达却不停)、方案(显式接地)与结果(六基准 SOTA),是全文叙事的缩影,读图即可把握核心论点。
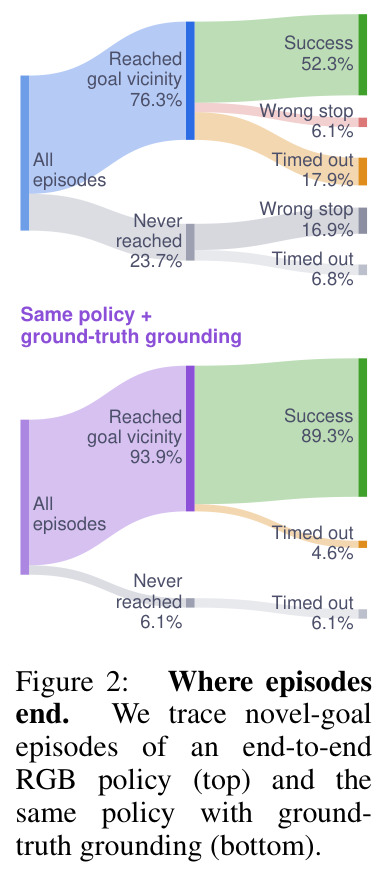
同一 Qwen3-VL-2B 策略在 HM3D-OVON val unseen 3000 回合上的结局分流树:上图为只读 RGB 的端到端策略——76.3% 曾到达目标 0.25 m 内但成功率仅 52.3%,到达后错误停止 6.1%、超时 17.9%,另有 23.7% 从未到达;下图为同一策略加真实接地文本——到达率 93.9%、成功率 89.3%、到达后失败降至 4.6%、错误停止完全消失。
全文诊断的核心证据:仅补上接地信息即可挽回约 37 个点的成功率,直接确立 goal grounding 是缺失的能力。
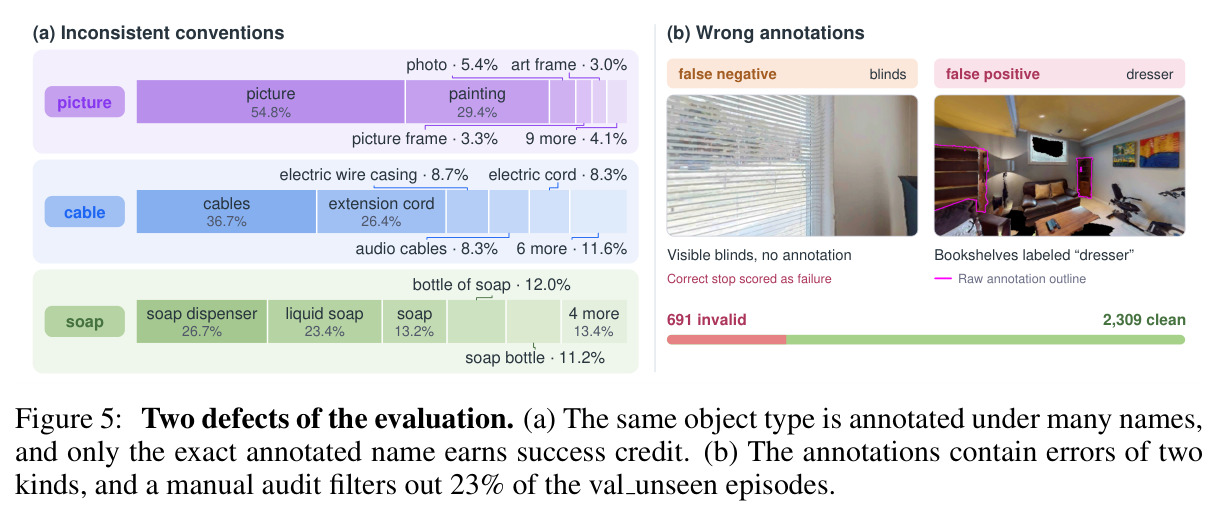
(a) 命名不一致:picture 有 14 种标注写法(picture 54.8%、painting 29.4%、photo 5.4% 等),cable 与 soap 同样碎片化,而官方判据只认与目标词精确匹配的标注名;(b) 标注错误两例:假阴性(可见的 blinds 无任何标注,正确停止被判失败)与假阳性(书架被标成 dresser);人工审计从 HM3D-OVON val unseen 的 3000 回合中剔除 691 个无效回合,保留 2,309 个干净回合。
论证现有基准评测不可信,这是作者重评所有基线、发布干净协议的依据,也是理解论文中 official 与 clean 两列数字差异的前提。
六个基准(HM3D-OVON val seen/unseen、HM3D ObjectNav 6 类、MP3D-OV、MP3D 21 类、HSSD-OV、HSSD 6 类)× 官方/干净两种协议的成功率总表。本文在所有基准所有协议下领先:干净 OVON val unseen 69.6 对 LightNav-0 的 60.8,HSSD-OV 56.4 对 32.8;GT grounding 行给出真实接地上限(val unseen 达 91.6);VLFM、Nav-R2、DAgRL、Uni-NaVid、LightNav-0 为对比基线。
论文的主结果表,SOTA 声明的全部证据所在,同时量化展示了官方判据系统性低估强方法(LightNav-0 被 +13、本文 +16、GT +19)的现象。