学会判别场景结构使自监督深度学习可扩展 Learning to Discriminate Scene Structures Makes Self-Supervised Depth Learning Scalable
解耦场景结构表征并用对比学习判别场景结构,让自监督深度估计首次从混合域训练中获益
前置知识
自监督单目深度估计(SSMDE)
从单目视频学习深度的范式:模型预测目标帧的深度图,结合相邻帧间估计的相机位姿把附近帧 Warp 到目标视角(新颖视角合成),用光度重建误差作为训练信号,全程无需深度真值。由于深度与相机平移存在尺度歧义,模型学到的是尺度不变的相对深度,评测时需用中值缩放对齐。
本文研究的问题正是这种弱监督信号下模型学到了什么表征——理解该范式才能理解混合域训练崩塌的根源。
视觉基础模型与 DINOv2
DINOv2 是在约 1.4 亿张图像上以自蒸馏方式预训练的 ViT,特征具有强语义泛化能力,被广泛用作深度基础模型的骨干。但在自监督深度任务中直接微调它会因训练信号噪声大而破坏预训练表征,冻结使用则因缺少几何线索而不利于结构建模——这是 MaSS 架构设计的直接动因。
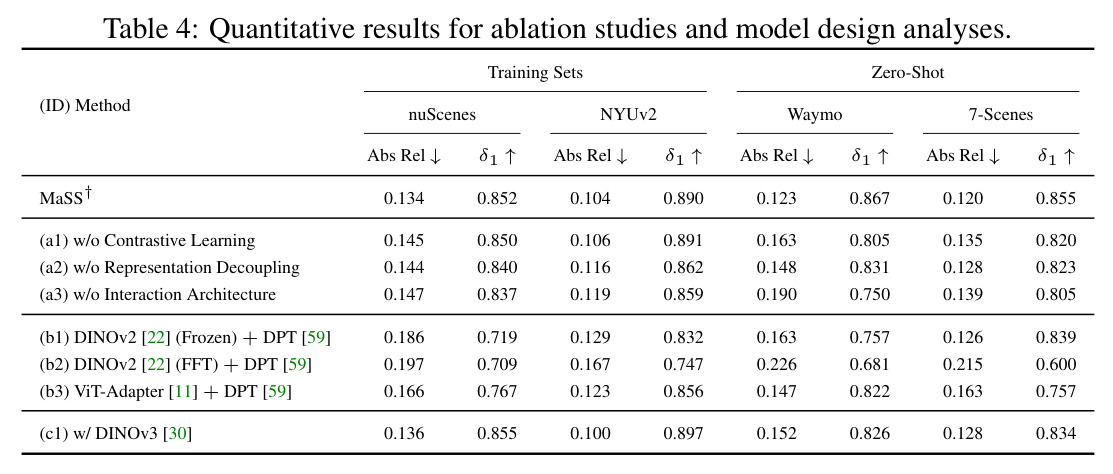
MaSS 的整个架构围绕「如何利用冻结的 VFM 又补足几何线索」展开,消融实验的对照组也围绕这一对比设计。
对比学习与多正例 InfoNCE
通过拉正例、推负例来组织特征空间的自监督方法。多正例 InfoNCE 把每个锚点对所有正例的相似度求和后做 log-softmax,温度参数 τ 控制嵌入空间的集中程度,无需人工标签即可按相似度关系监督表征,是本文结构判别目标的优化形式。
本文的关键一步是把「学结构表征」改写成一个对比学习任务,只有理解正负对如何定义,才能看懂其创新所在。
对称 KL 散度与软分箱直方图
KL 散度度量两个概率分布的差异,对称化后消除方向偏置。软分箱用 sigmoid 差值让每个深度值以连续权重落入相邻多个 bin:$\Psi_k(d)=\sigma((d-c_k+\Delta/2)/\tau_h)-\sigma((d-c_k-\Delta/2)/\tau_h)$,既可微又能抑制高频伪影,把深度图汇总成分布直方图 $h$。
这是论文定义「场景结构相似度」的核心度量,正负例集合完全由它决定,是结构判别目标的基石。
ViT-Adapter 式双向交互
让 ViT token 与 CNN 多尺度特征 token 互相做交叉注意力:ViT 侧注入空间几何信息,CNN 侧获得语义上下文,两路异构特征在共享潜空间对齐。该设计原用于分割等密集预测任务,作为预训练骨干的辅助插件。
MaSS 借用它连接深度编码器与冻结 DINOv2,并证明该模块在此不是辅助组件,而是结构表征学习的前提(a3 消融)。
研究动机
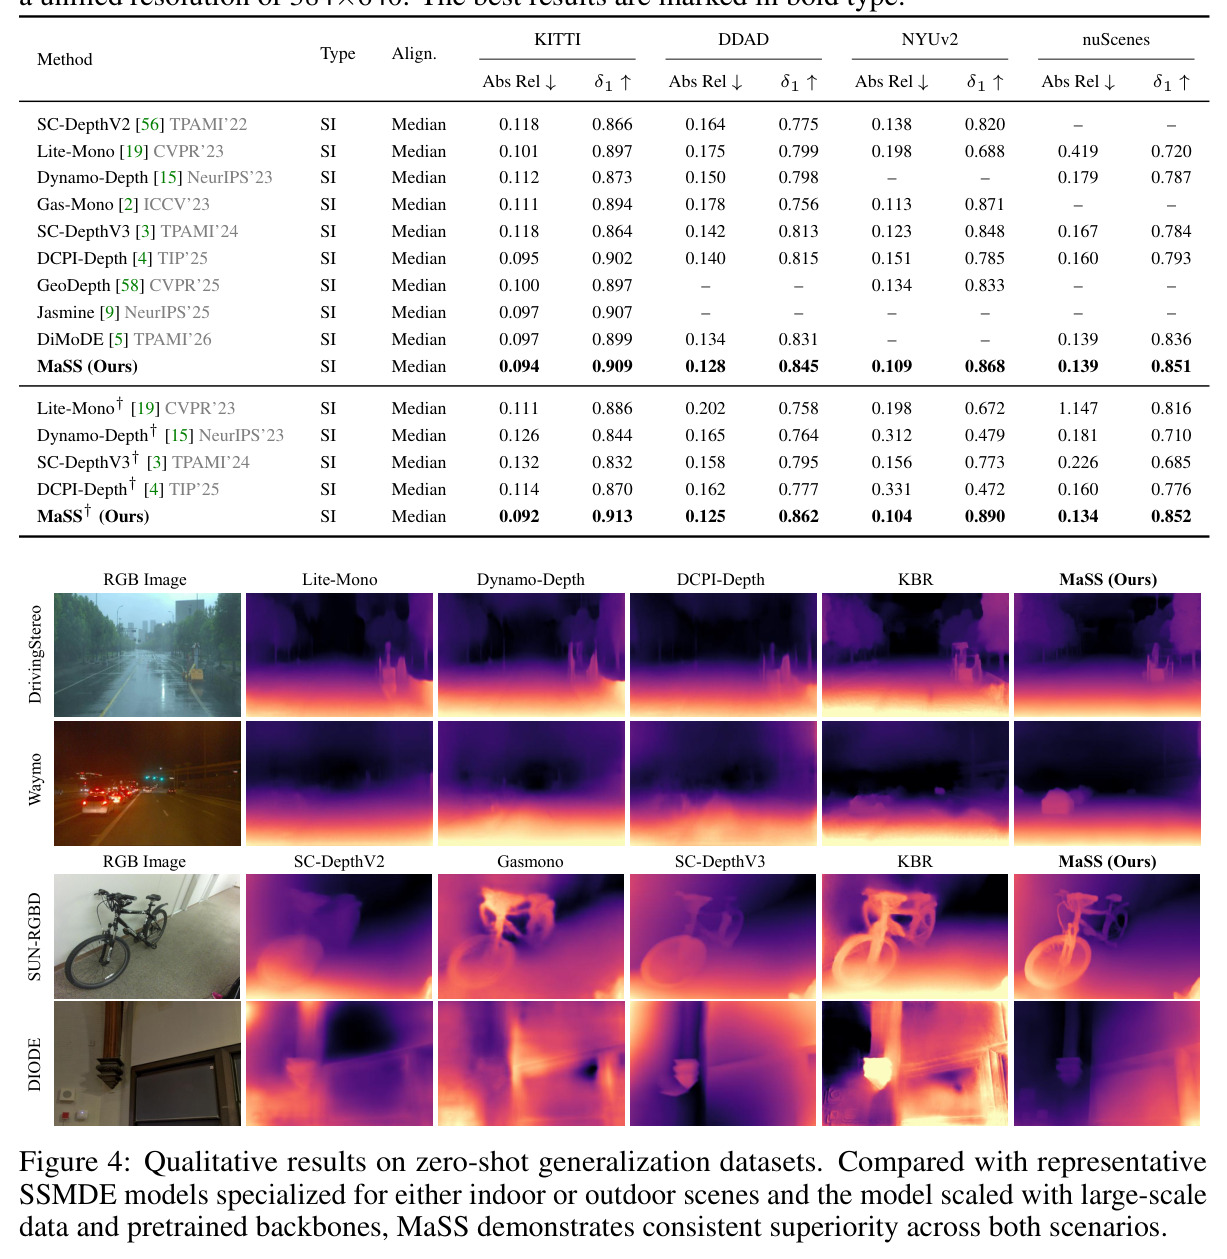
自监督单目深度估计(SSMDE)的卖点是无需标注即可随无标签数据扩展,但现实是:现有方法几乎都在单一同质数据集上训练,这一潜力从未兑现。作者的前置实验显示,把现有 SoTA 方法(SC-DepthV3、DCPI-Depth、Lite-Mono、Dynamo-Depth 等)直接放到室内(NYUv2)、室外驾驶(KITTI)、动态(nuScenes/DDAD)等异质数据上混合训练时,性能不升反降:DCPI-Depth 在 NYUv2 上 Abs Rel 从 0.151 恶化到 0.331、δ1 跌至 0.472,Lite-Mono 在 nuScenes 上 Abs Rel 飙到 1.147,对完全分布外(OOD)场景的泛化也没有改善。根源在于新颖视角合成监督在遮挡、无纹理、光照变化区域天然引入噪声信号,梯度无法忠实反映深度误差,优化本就易陷入局部极小;在单一数据集上网络还能靠记忆该数据特有的结构偏置(如驾驶场景的灭点、小房间的均匀深度分布)来补偿弱监督,而混合训练时不同域要求的偏置互相冲突,最终导致跨域优化冲突和性能崩塌。
本文的目标是本文的目标是让自监督深度学习真正「可扩展」:构建一个统一模型,在 KITTI、DDAD、NYUv2、nuScenes 四个覆盖室外驾驶、室内、动态与恶劣天气的异质数据集上,无论单独训练还是混合训练都达到 SoTA,更关键的是混合域训练下性能不降反升——成为首个能持续受益于数据多样性的自监督深度方法。量化目标包括:混合训练后在四个训练域全面超越单域 SoTA(如 KITTI Abs Rel 降至 0.092);在 8 个未见数据集(Waymo、DrivingStereo、Cityscapes、iBims-1、SUN-RGBD、7-Scenes、DIML、DIODE)上零样本超越专门的单域模型和大规模训练的 KBR/KBR++ 系列,并在 DIML、DIODE 等完全 OOD 场景上逼近有监督深度基础模型;同时把开销控制在单张 RTX 4090、150K 帧训练数据的量级。
与已有工作不同的是,已有改进大多盯着光度损失、遮挡处理、尺度一致性等「局部」问题,或直接堆数据、换大骨干(如 KBR++ 用 2.2M 帧加大模型)。本文的独特切入是一个诊断性发现:深度编码器最粗糙的高层特征并不编码前景-背景关系、透视几何等深度相关线索,而是主要反映数据集特有的结构偏置(Fig. 2a 中驾驶数据训练的 DepthNet 编码器激活图存在与场景几何无关的固定低激活区)。作者据此把跨域学习冲突归结为「语境信息与场景结构纠缠在单一表征通路中」——同一表征既要保留语义语境又要承载全局布局,混合域下必然发生表征冲突甚至塌缩。解法不是更强的监督或更大的模型,而是显式把结构表征从语境表征中解耦出来,再用一个可明确定义的场景结构判别任务去监督它。这种「先诊断表征、再设计目标」的路线是以往 SSMDE 工作没有走过的。
核心方法
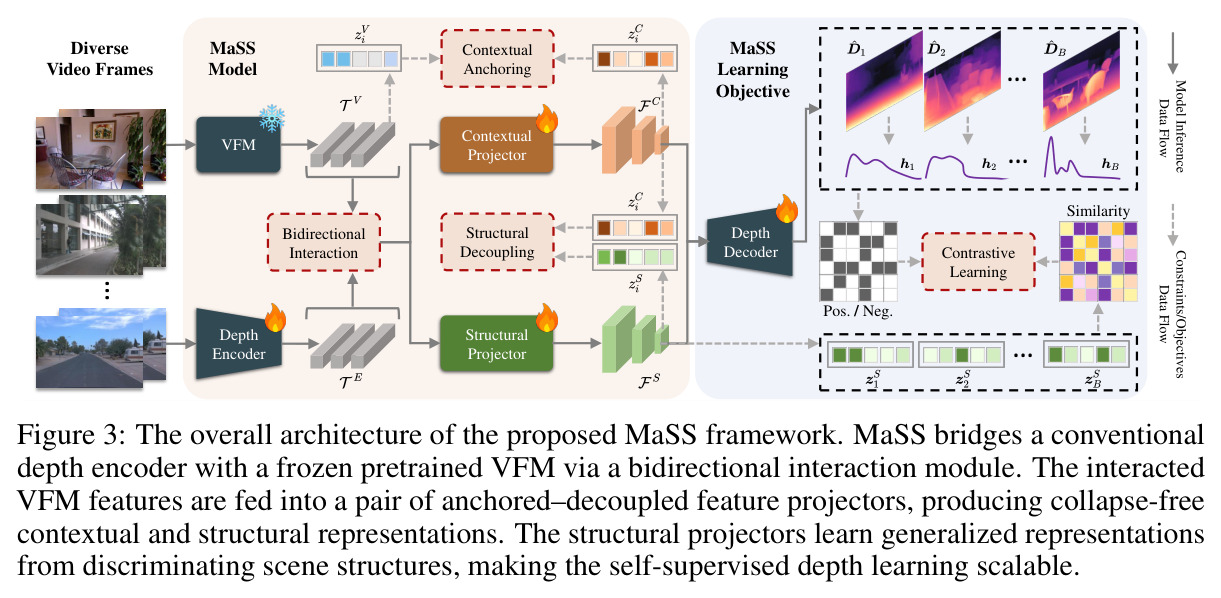
直觉上,MaSS 是把「语义通才」(冻结的 DINOv2)和「几何专科生」(传统深度编码器)配对工作:前者见过海量场景、语义先验强但几何线索弱,后者擅长从多尺度卷积特征提取几何但容易过拟合单一域。两者经 ViT-Adapter 式双向交叉注意力互补融合后,特征再分流进两条投影通路:语境通路用 VFM 的样本间语义关系做「锚定」防止漂移,结构通路被显式约束与语境解耦,专门承载场景布局与透视几何。结构通路没有深度真值可监督,作者把它转化为对比学习任务:用预测深度图的软直方图(降采样 8 倍、K=20 个 bin)之间的对称 KL 散度定义结构相似度,深度分布相似的样本互为正例(相似度阈值 γ=0.95),用多正例 InfoNCE(τ_c=0.1)拉近推远。解码前两条通路的特征金字塔拼接、经 1×1 卷积降维送入深度解码器,与常规光度自监督联合端到端训练。由于结构判别目标依赖当前深度预测,训练先做 1 个 epoch 的初始化再启用该目标;全部训练只需单张 RTX 4090、batch size 6、约 2.5 天。
核心创新是「场景结构判别目标」加「锚定-解耦」双通路表征,与已有工作的本质区别有三点。第一,以往自监督深度方法即便用对比学习,也是在通用实例层面构造正负对(按天气变化、颜色一致性、历史预测或语言引导),本文把正负对定义在一个专为结构设计的度量上:对降采样 $s=8$ 的预测深度图做 $K=20$ 个 bin 的可微软分箱直方图(分箱权重 $\Psi_k(d)=\sigma((d-c_k+\Delta/2)/\tau_h)-\sigma((d-c_k-\Delta/2)/\tau_h)$,抑制高频伪影),样本间用对称 KL 散度 $D_{kl}(h^i\|h^j)$ 度量全局深度分布差异。第二,结构表征不是从语境特征里「顺便」学出来的,而是通过锚定-解耦损失强制其与语境描述子内积为零、并与 VFM 语义关系解绑,独立成路。第三,正负对的构造成本极低——直接用当前 batch 的深度预测计算,不需要额外标注、检索或 memory bank。三者合起来,把「学一个跨域稳定的深度模型」改写成了「学一个会区分场景结构的表征空间」,这正是模型能从混合域数据中持续受益的根本原因。
方法步骤详情
完整流程分五步。(1)特征提取:冻结的 DINOv2 ViT-B/14 的 ViT block 被分成三段,取出三组中间 token $T^V$;可训练的深度编码器输出 1/8、1/16、1/32 三级特征金字塔 $F^E$,经 1×1 卷积统一通道、展平拼接成 token $T^E$。(2)双向交互:VFM token 对 depth token 做交叉注意力注入几何线索,depth token 再对更新后的 VFM token 做交叉注意力并过 FFN,两者在共享潜空间对齐,得到几何增强的 VFM 特征图 $F^V$。(3)双投影头:两个结构相同的投影头(转置卷积逐级上采样加 BN 和 ReLU)分别把 $F^V$ 上采样为语境金字塔 $F^C$ 与结构金字塔 $F^S$;对最高层特征做全局平均池化加归一化得到描述子 $z^C, z^S, z^V$,用 $\mathcal{L}_{ac}=\sum_i\sum_{j\neq i}(z^{C_i\top}z^{C_j}-z^{V_i\top}z^{V_j})^2+\sum_i(z^{C_i\top}z^{S_i})^2$ 锚定语境、解耦结构。(4)结构判别:先经 1 epoch 初始化获得合理深度预测 $\hat{D}$,将每张图降采样 8 倍、软分箱成 20 维直方图 $h^i$,样本对做对称 KL 得差异度,$\exp(-D_{kl})>\gamma=0.95$ 者入正例集 $P_i$,用多正例 InfoNCE 更新结构通路。(5)深度解码:$F^C$ 与 $F^S$ 沿通道拼接、1×1 卷积降维后进深度解码器,配合既有光度自监督与动态场景处理端到端训练。
技术新颖性
与相近技术的具体区别:(1)相比直接微调 DINOv2+DPT(消融 b2:Waymo Abs Rel 0.226、7-Scenes 0.215,全面崩盘)或冻结 DINOv2 只训解码头(b1),本文证明自监督信号太噪声,VFM 必须冻结、几何线索必须由独立深度编码器经双向交互注入——交互模块在深度领域常被当作辅助插件,本文证明它是结构表征学习的前提(去掉后 Waymo Abs Rel 从 0.123 恶化到 0.190)。(2)相比语义引导或语言引导的对比深度方法,本文的判别对象是「全局布局」而非语义类别:直方图相似度只看深度分布形状,作者在补充材料中展示了超参选择能避免退化为仅区分室内/室外这类粗类别。(3)相比 KBR/KBR++ 靠 1.9M-2.2M 帧数据加更大模型换取泛化,MaSS 用 150K 帧取得更优结果,把扩展性问题从「堆数据」转化为「表征目标设计」,这是范式层面的差异。
实验结果
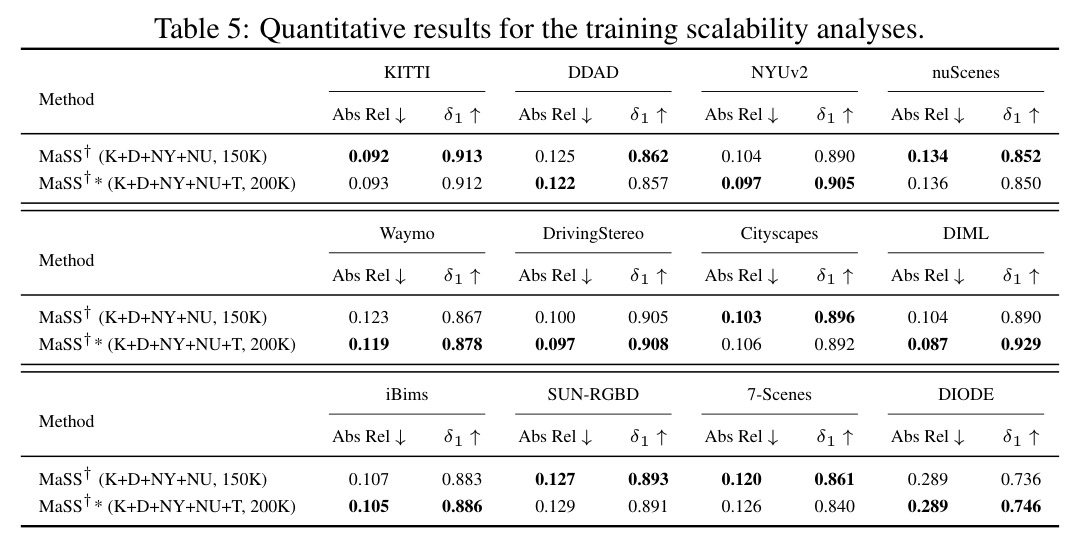
核心发现分四块。(1)单域训练全面 SoTA(Table 1):MaSS 在 KITTI 0.094/0.909(Abs Rel/δ1)、DDAD 0.128/0.845、NYUv2 0.109/0.868、nuScenes 0.139/0.851,全部超越 DCPI-Depth、DiMoDE、Jasmine 等最新方法。(2)混合域训练首次受益(Table 1 带†行):对照方法集体崩塌——DCPI-Depth 在 NYUv2 上 Abs Rel 从 0.151 恶化到 0.331、δ1 跌至 0.472,Dynamo-Depth 在 NYUv2 上 0.312/0.479,Lite-Mono 在 nuScenes 上 Abs Rel 高达 1.147;MaSS 反而全面超越自己的单域版本:KITTI 0.092/0.913、DDAD 0.125/0.862、NYUv2 0.104/0.890、nuScenes 0.134/0.852。(3)零样本泛化(Table 2):MaSS 在 Waymo 0.123/0.867、DrivingStereo 0.100/0.905、Cityscapes 0.103/0.896、DIML 0.104/0.890、iBims 0.107/0.883、SUN-RGBD 0.127/0.893、7-Scenes 0.120/0.861、DIODE 0.289/0.736;以 93.2M 参数、81.6 GFLOPs、150K 帧训练数据(Table 3)全面优于 KBR++ 的 266.6M/381.7G/2.2M 帧配置,并在 DIML(0.104 vs 有监督 Lotus 的 0.099)等 OOD 域接近深度基础模型,但标准室内数据集仍明显落后 DAv2(iBims 0.107 vs 0.045)。(4)消融与扩展(Table 4/5):去掉对比学习后 Waymo Abs Rel 从 0.123 恶化到 0.163;去掉表征解耦后 NYUv2 从 0.104 恶化到 0.116;去掉交互架构后 Waymo 恶化到 0.190;换用更强的 DINOv3 仅带来边际变化(NYUv2 0.100),说明增益来自框架而非骨干。往训练集加入 50K TartanAir 样本(150K→200K)后,训练域平均 Abs Rel 再提升 1.5%,最难的 OOD 域(DIML/DIODE)平均提升 4.3%/3.0%,DIML δ1 从 0.890 升到 0.929,是可扩展性的直接证据。
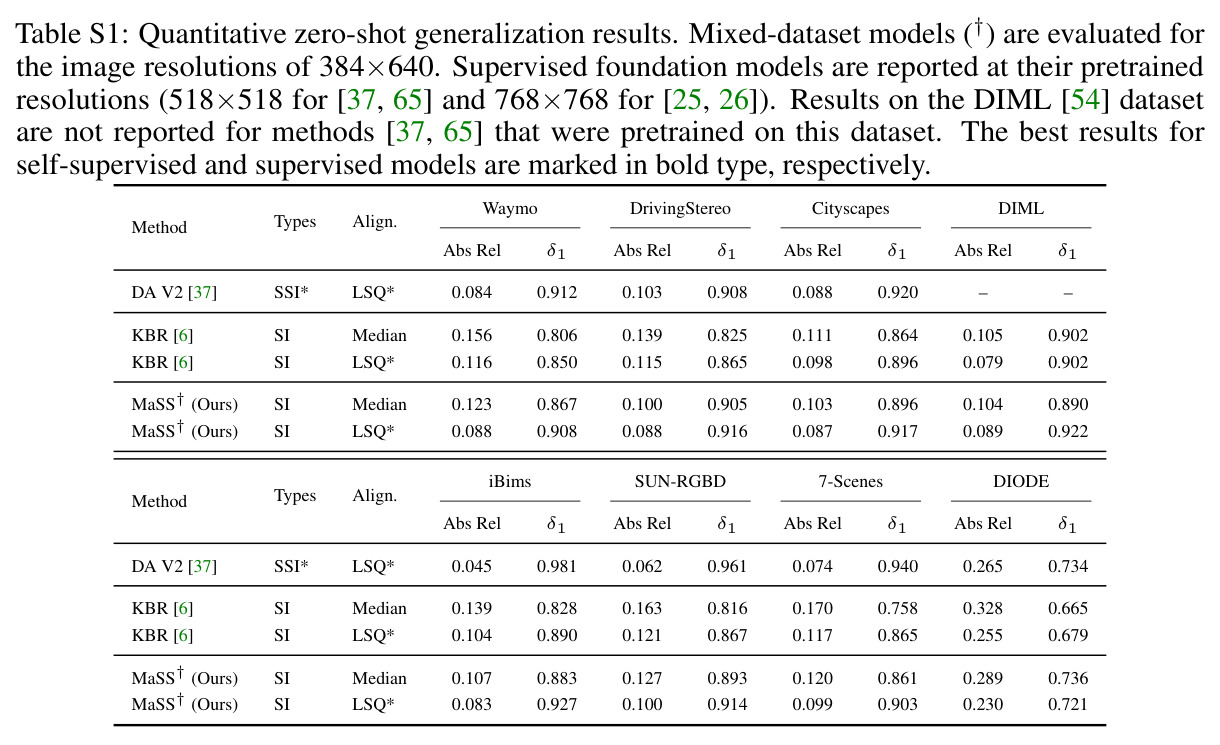
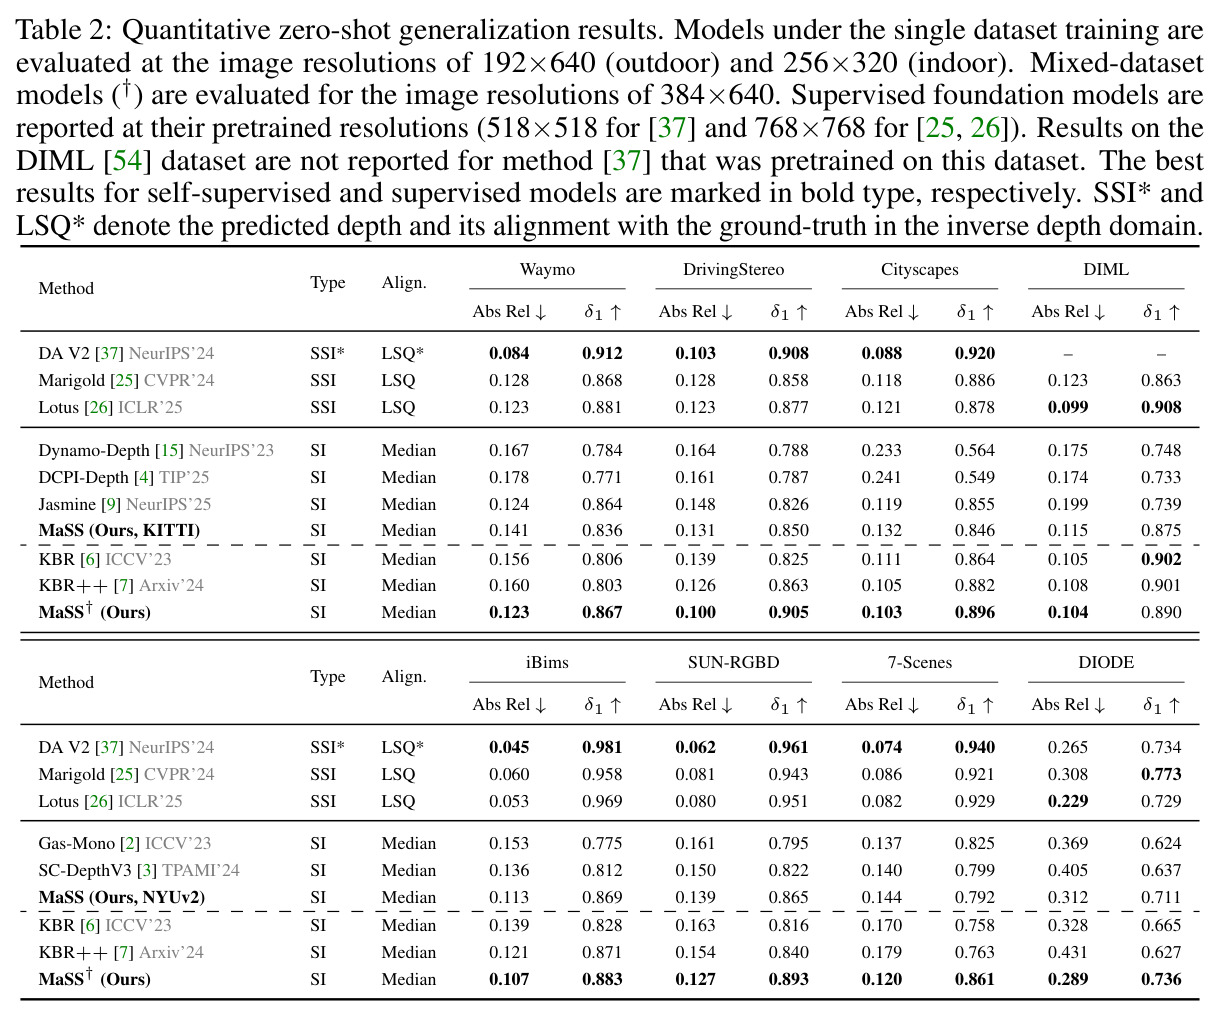
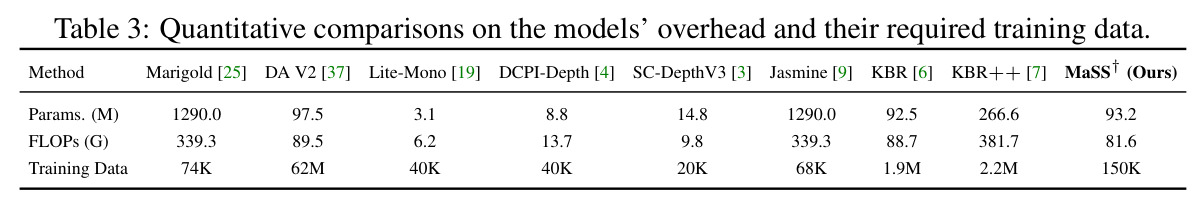
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 混合域训练-室内(NYUv2) | Abs Rel ↓ / δ1 ↑ | MaSS† 0.104 / 0.890 | DCPI-Depth† 0.331 / 0.472 | Abs Rel 降低 68.6%,δ1 提升 41.8 个百分点 |
| 混合域训练-室外驾驶(KITTI) | Abs Rel ↓ / δ1 ↑ | MaSS† 0.092 / 0.913 | DCPI-Depth† 0.114 / 0.870 | Abs Rel 降低 19.3%,且优于自身单域版本(0.094) |
| 混合域训练-动态场景(nuScenes) | Abs Rel ↓ | MaSS† 0.134 | Lite-Mono† 1.147 | 对照方法灾难性崩溃,MaSS 保持稳定(训练域中还优于自身单域的 0.139) |
| 零样本泛化-驾驶(DrivingStereo) | Abs Rel ↓ / δ1 ↑ | MaSS† 0.100 / 0.905 | KBR++(2.2M 帧训练)0.126 / 0.863 | Abs Rel 降低 20.6%,训练数据仅为基线的 7% |
| 零样本泛化-完全 OOD(DIML) | Abs Rel ↓ / δ1 ↑ | MaSS† 0.104 / 0.890 | DCPI-Depth 0.174 / 0.733;有监督 Lotus 0.099 / 0.908 | 较最强自监督对照 Abs Rel 降低 40.2%,接近有监督基础模型 |
| 零样本泛化-室内(7-Scenes) | Abs Rel ↓ / δ1 ↑ | MaSS† 0.120 / 0.861 | KBR++ 0.179 / 0.763 | Abs Rel 降低 32.9%,δ1 提升 9.8 个百分点 |
| 训练数据扩展(150K→200K,加 TartanAir) | OOD 域(DIML)δ1 ↑ | 0.890 → 0.929 | 扩展前 MaSS† 0.890 | δ1 提升 3.9 个百分点;DIML Abs Rel 从 0.104 降至 0.087 |
局限与改进
作者承认的局限:(1)在标准室内数据集上仍不及有监督深度基础模型——iBims 上 DAv2 Abs Rel 0.045 而 MaSS 为 0.107;作者解释是简单且同质的室内深度分布对用 Hypersim/NYUv2 大规模室内真值训练的监督模型特别有利,且 Median 与 SSI* 对齐方式的差异也造成部分表观差距。(2)可扩展性证据仍是初步的:只验证到 200K 帧规模,远小于 Depth Anything(62M 帧)等监督模型的训练规模,SSMDE 在真正大数据制度下的表现留作未来工作。(3)结构判别目标依赖当前深度预测质量,必须先跑 1 个 epoch 的初始化,冷启动阶段该目标不可用。我自己的观察:(1)正负对按 batch 内深度直方图相似度定义而 batch size 只有 6,batch 内结构多样样本有限,正例集可能稀疏,该目标如何随 batch 规模扩展未被讨论;(2)软直方图只比较全局深度分布,「深度分布相似但空间布局相反」的样本(如左右远近互换的对称场景)会被错误判为正例,这是度量的固有盲区;(3)评测以 Median 对齐的尺度不变指标为主,自监督方法本就缺绝对尺度,对机器人等需要米制深度的落地场景价值需要额外说明。
独立分析的弱点
(1)batch 内对比的规模化瓶颈:结构判别目标在 batch 内构造正负对,batch size 6 意味着每个锚点只有 5 个候选,γ=0.95 阈值下正例可能极少,对比信号方差大;若要真正大规模扩展,需要跨 GPU 的结构特征库或动量编码器维持足够的结构样本。改进方向:引入跨 batch 的结构描述子 memory bank,或用直方图嵌入做检索式正例扩充。(2)直方图度量的空间盲区:KL 散度只比较深度值分布,丢失全部空间布局信息——「左墙近右墙远」与「左墙远右墙近」的两个场景直方图几乎相同,会被判为正例但结构截然不同。改进方向:在全局直方图之外加入粗粒度空间分块(把深度图分成若干 patch 分别做直方图再拼接),或将结构描述子与预测深度的低频金字塔做对齐。(3)室内窄分布判别力不足:iBims/SUN-RGBD 上与监督模型差距明显,除监督数据优势外,也暴露均匀深度分布挤在少数 bin 时直方图区分度下降。改进方向:对 bin 做自适应划分或按对数深度分箱,提升室内场景的判别粒度。(4)1 个 epoch 的临时初始化阶段可能引入早期数据偏置且引入两阶段超参,改进方向:用课程式渐降光度损失权重或 EMA 教师(如 Mean Teacher)平滑过渡到结构目标。
未来方向
作者明确提出的方向:把 SSMDE 扩展到与监督深度基础模型(Depth Anything 系列、MoGe,千万至亿帧级数据)相当的规模,检验该框架在真正大数据制度下的表现;补充材料中还探讨了能否利用预训练深度/几何基础模型的几何先验、甚至反哺增强这些模型。基于本文成果可延伸的:(1)把结构判别目标迁移到其他自监督几何任务——自监督光流、SLAM/位姿估计等,凡是「全局分布可定义」的任务都能套用该对比范式;(2)用预训练几何基础模型的预测作为伪结构标签,做教师-学生式的结构蒸馏,绕开对当前预测质量的依赖;(3)探索解耦表征的下游复用,例如结构通路直接用于场景检索、布局估计或机器人导航中的拓扑地图构建;(4)结合更强的 VFM(DINOv3 已在消融中验证兼容)与多模态大模型,测试表征解耦能否进一步放大基础模型能力,并研究结构目标与语义目标在多任务下的相互作用。
复现评估
复现友好度较高。代码已开源(https://mias.group/MaSS),训练配置完全透明:VFM 为预训练 DINOv2 ViT-B/14(冻结),深度编码器沿用 Lite-Mono,交互模块按 ViT-Adapter 实现;数据增广与优化器设置沿用先前工作(SC-DepthV3/DCPI-Depth 一系),无需额外调参。数据方面使用 13 个公开数据集,训练/评测划分沿用既有文献的标准 split,混合训练协议也写明(每个 batch 从四个数据集随机采样、epoch 减到 1/3 以对齐总迭代数)。算力门槛低是亮点:单张 RTX 4090、batch size 6、约 2.5 天即可完成一次训练,个人研究者或小团队完全可以复现。需要注意的坑:(1)启用结构判别目标前必须先跑 1 个 epoch 初始化,否则早期深度预测不可靠会污染表征学习;(2)动态场景与极端条件的处理沿袭 SC-DepthV3 方案,需按其引用的实现处理;(3)γ=0.95、τ_c=0.1、K=20、s=8 等超参在正文未给敏感性分析,复现遇阻需查补充材料(其中也给了正负例的量化示例)。
论文图表
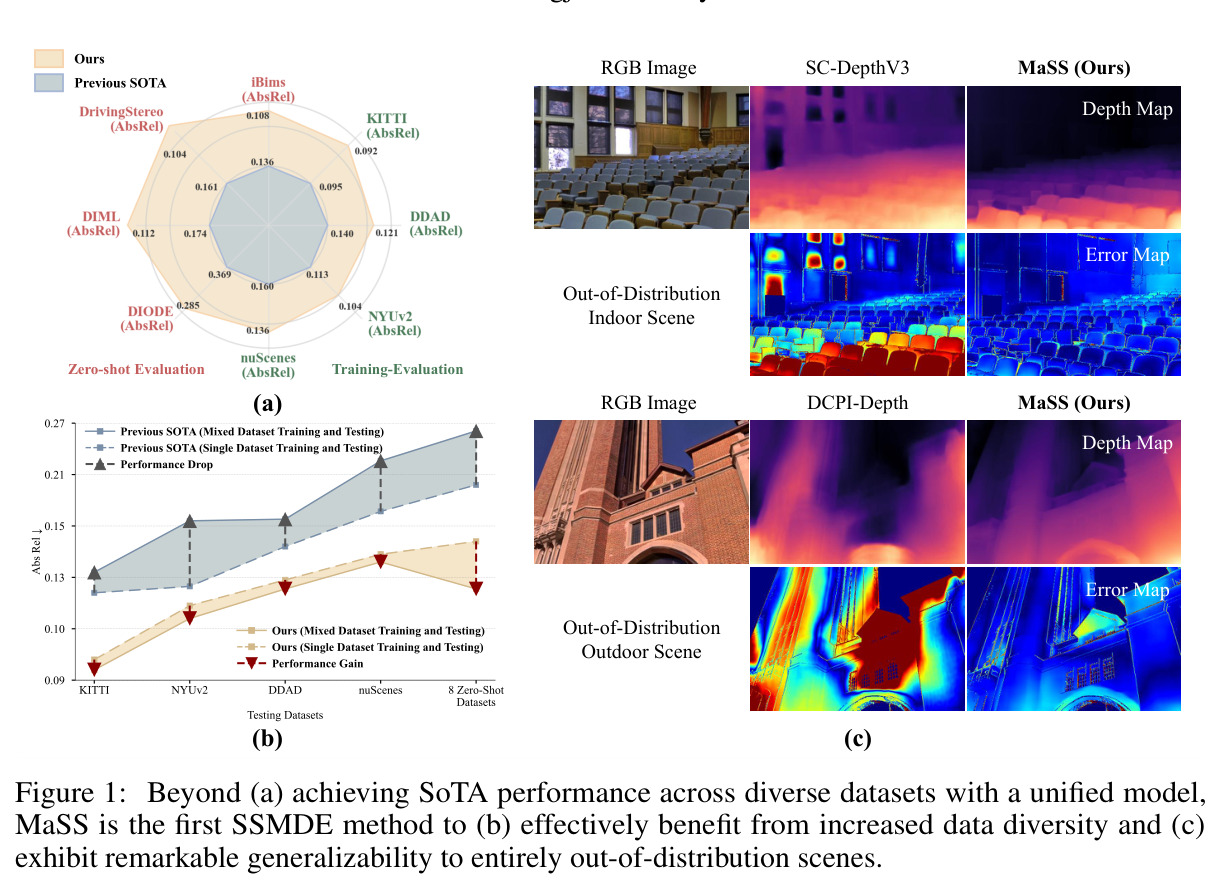
三联图: 统一模型在多个数据集上达到 SoTA; 混合域训练下 MaSS 性能上升而已有方法下降; 对完全 OOD 的室内/室外场景做零样本预测,与 SC-DepthV3、DCPI-Depth 对比,MaSS 的误差图明显更干净。
一图总结论文三大卖点:SoTA、数据多样性正收益、OOD 泛化,是判断「可扩展性」这一核心主张是否成立的直观证据。
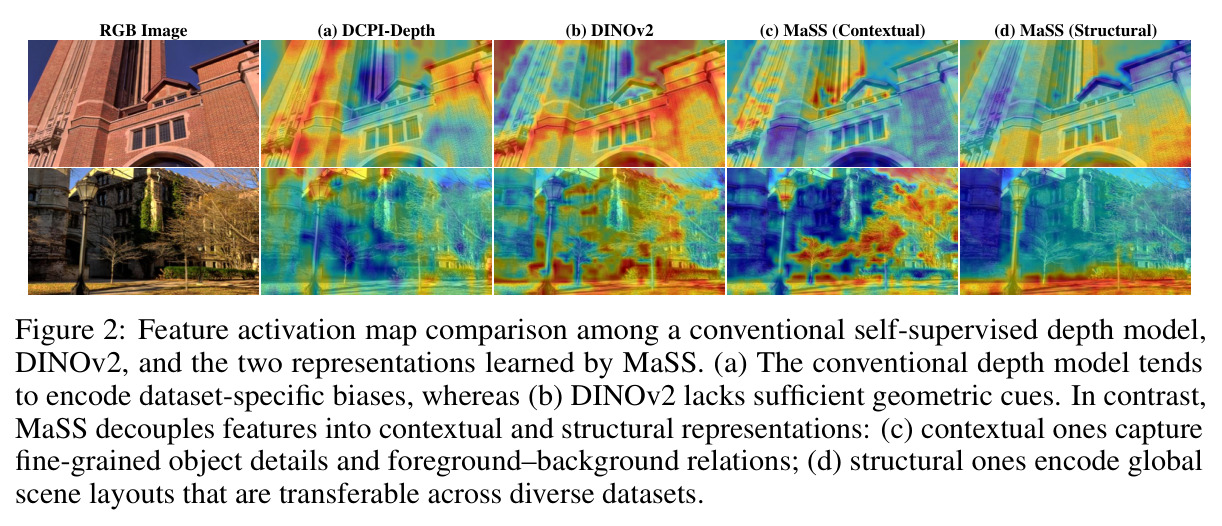
对比四列特征激活图:常规自监督深度模型(DCPI-Depth)的激活图存在与场景几何无关的固定低激活区,暴露数据集偏置;DINOv2 特征缺几何线索;MaSS 的语境通路捕捉细粒度物体细节与前后关系,结构通路编码可跨域迁移的全局场景布局。
这是「问题根源在于数据集偏置编码进中间表征」这一诊断的直接可视化证据,也是「语境-结构解耦」设计的动机来源,不看此图难以理解问题诊断链条。