先执行,后记忆:诊断视频世界模型的记忆失败 Execution Before Memory: Diagnosing Memory Failures in Video World Models
提出MIST评测分离场景设置与延迟揭示,发现视频世界模型记忆低分主因是未执行动作而非遗忘
前置知识
视频世界模型
指把大规模视频生成模型当作可交互环境或模拟器使用的范式,如 Genie、GameNGen、Wan 系列。模型根据当前画面和动作指令生成后续视频帧流,理想情况下物体关系在镜头移开后仍保持,动作能正确更新世界状态(谁坐下了、盒子里放了什么)。
本文检验的正是这类模型在被遮挡后能否「记住」并执行状态变化,先搞清对象才能理解实验设计。
延迟揭示评估范式
类似「视频壳游戏」:先展示场景,再用不透明遮挡(镜头移开、盒盖关闭)把关键变化隐藏一段时间,最后要求模型展示变化结果。考察重点是状态在遮挡下是否持久、揭示时是否正确执行,而非画面好不好看。
MIST 把这一范式拆成可分别打分的门控,是全文方法论的地基。
门控式分解评分
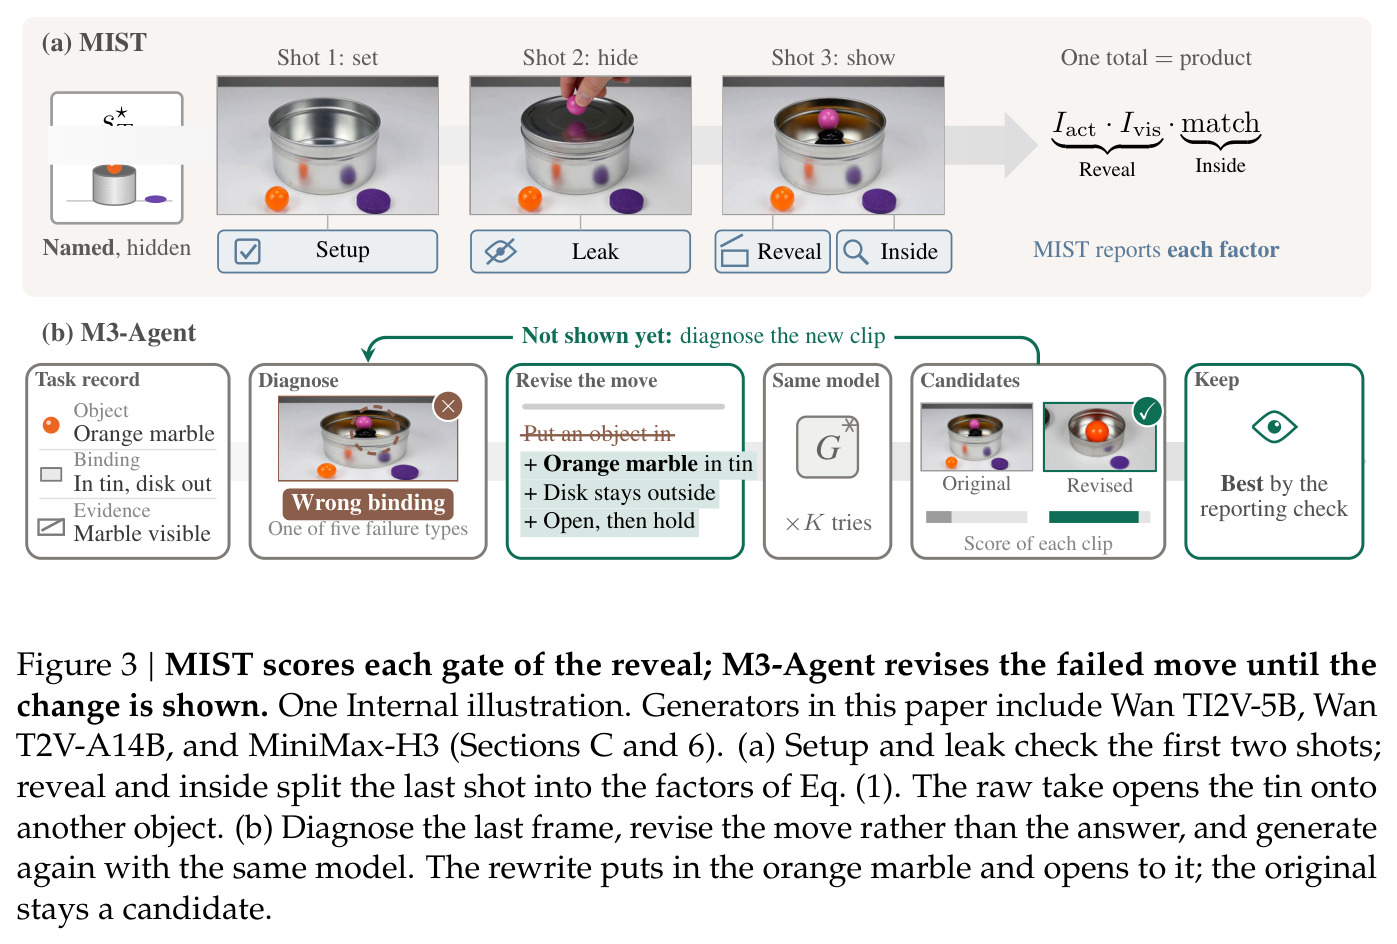
把总分写成三个可观测因子的乘积 $\mathrm{score}(x, s^\star_T) = I_{\mathrm{act}}(x)\cdot I_{\mathrm{vis}}(x)\cdot \mathrm{match}(x, s^\star_T)$:动作是否发生、末帧是否可读、末帧是否匹配目标状态 $s^\star_T$。任一因子为零总分即坍缩,因此必须分列报告各因子,才能区分「没执行」与「执行错了」。
论文核心论点「执行先于记忆」完全依赖这种分解评分,不理解乘积式就无法理解实验解读。
测试时指令重写与候选选择
不训练、不修改模型权重,而是在推理时用 VLM 诊断生成结果的失败模式,改写提示词后用同一冻结模型重新生成 $K$ 个候选,再按评分函数保留最优,原始候选始终留在候选集内。与 LLM 推理中的 best-of-N 和自我修正同源。
M3-Agent 的全部增益来自这种免训练的测试时搜索,且论文坦承这是 oracle 式 keep-best,理解这点才能正确评估结果。
VLM 裁判
用视觉语言模型按自然语言判据对生成视频的末帧打分或分类,是当前视频生成评测的主流做法。但其可靠性(与人类的一致性、是否存在文本捷径、能否不看视频猜答案)需要单独审计。
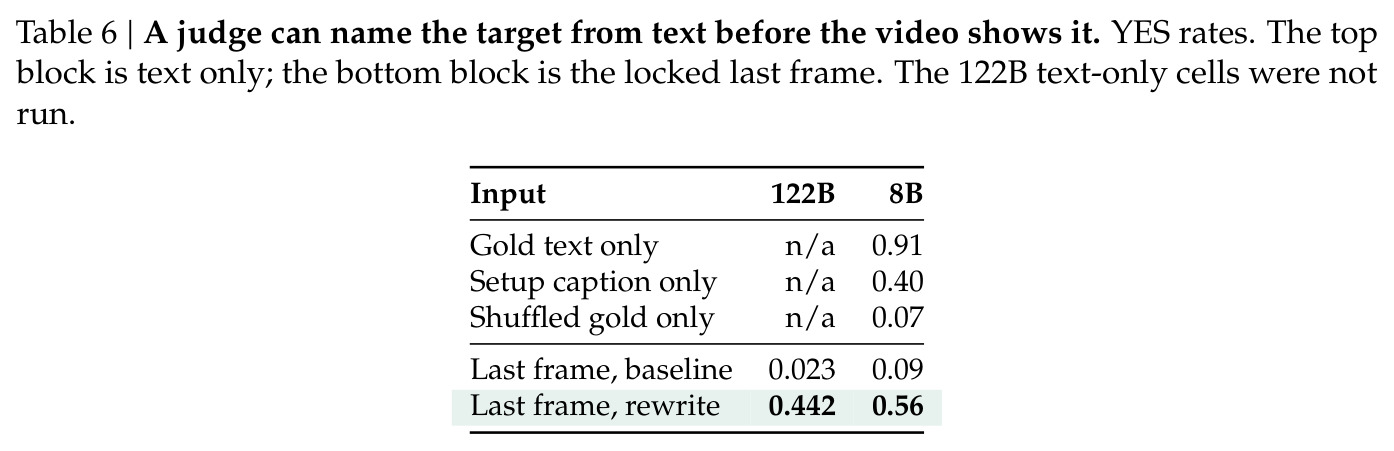
MIST 的每个门控和 M3-Agent 的诊断环节都依赖 VLM 裁判,论文专门做了文本-only 对照实验排除捷径。
研究动机
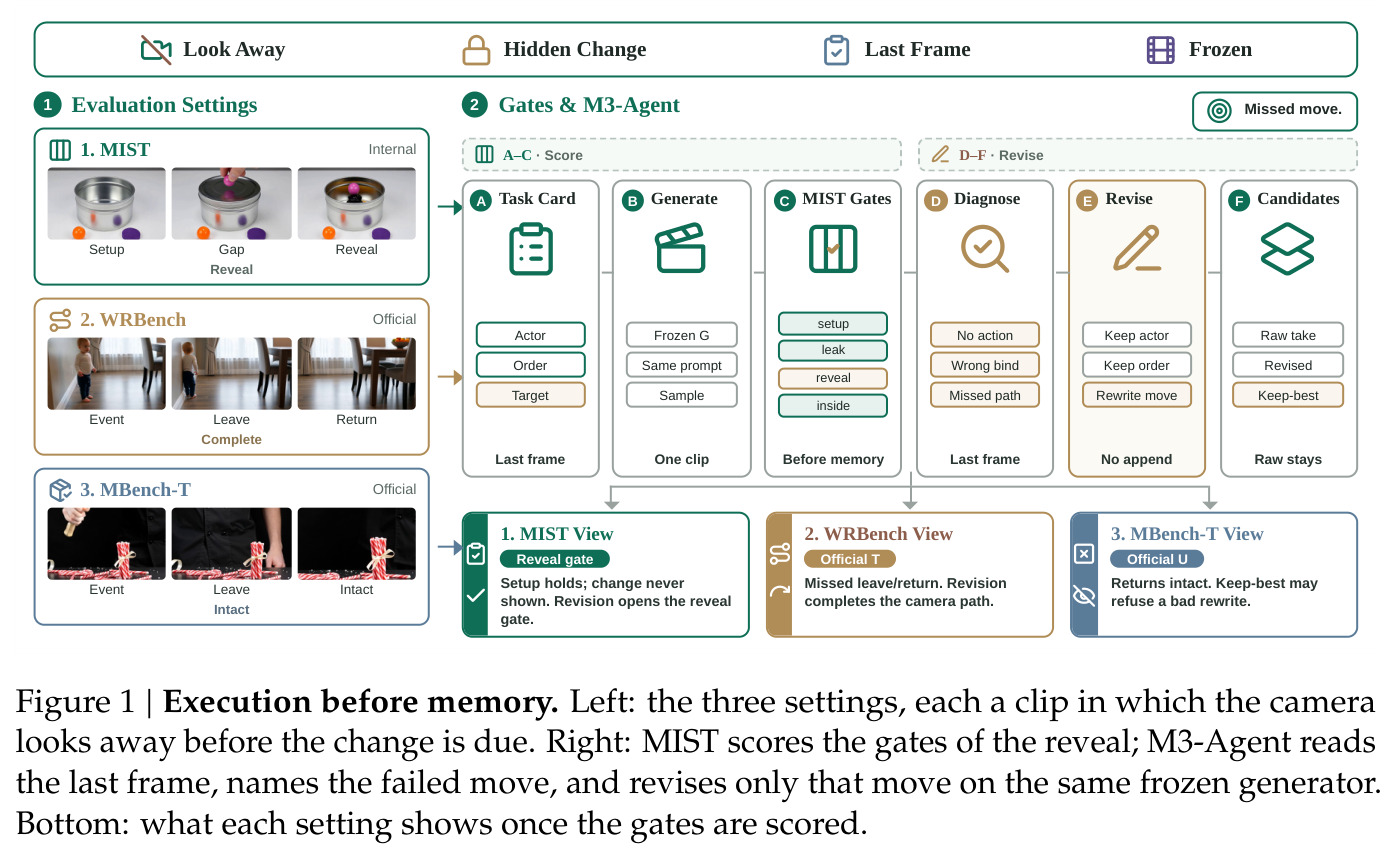
当前视频世界模型的记忆测试(WRBench、MBench、视频壳游戏等)把「场景是否设置好」「要求的动作是否执行」「末帧是否呈现结果」折叠成一个总分。分数一低就容易被解读为「模型遗忘了」。但作者逐帧检查官方协议生成的失败片段后发现:WRBench 里小孩在镜头移开前根本没坐下,镜头回来时椅子还是空的;MBench-T 里镜头回到糖果时糖果完好如初;MIST 案例里盒子从头到尾没打开。在 Wan TI2V-5B 的 43 个延迟揭示案例中,41 个基线视频从未打开容器,平均 reveal 分只有 0.147。当要求的动作从未发生时,被遮挡的状态转换根本无从出现,此时测试测的不是记忆,而是执行——「遗忘」这个结论在因果上就不成立。
本文的目标是本文要回答两个问题:第一,记忆评测的低分究竟丢在哪个环节——场景设置、动作执行还是末帧匹配?第二,能否在不训练、不加记忆模块的前提下修复丢分环节?为此作者提出 MIST 评测:用三段各 5 秒的镜头把「设景—隐藏—揭示」结构化分开,分别打 setup、leak、reveal、inside 四个门控分,让「未执行」不再被误报为「遗忘」;并提出 M3-Agent,在测试时读末帧、诊断失败动作、只改写失败的那一步指令,用同一冻结模型重新生成。目标是在 Internal MIST 与官方 WRBench、MBench-T 三套协议上同时验证「执行先于记忆」这一诊断。
与已有工作不同的是,已有工作分三条线,却都没有追问「要求的动作是否被展示出来」:一是把视频生成器当世界模型或模拟器;二是阶段性评测(StEvo-Bench、MemoBench、视频壳游戏)研究遮挡下的状态更新,但不拆执行门控;三是视频修复工具(VideoRepair、PhyT2V、Video-T1、VQQA)重写视频是为了画质、物理合理性或人类偏好,从不检查指令要求的动作是否发生。WRBench 和 MBench 虽然引入了镜头离开再回来的协议,却仍只报一个总分。本文的独特切入是把「执行」从「记忆」中剥离:先用门控分解证明 43 例中 41 例基线失败发生在动作门而非记忆门,再从执行侧设计 M3-Agent 补上缺失的那个动作,而不是去修记忆。
核心方法
直觉上,一次合格的记忆测试应该回答三个问题:场景设置好了吗?要求的动作执行了吗?末帧显示结果了吗?MIST 用三段各 5 秒的镜头结构化这三问:第一镜建立场景,第二镜穿过不透明间隙隐藏变化,第三镜要求揭示,所有对比复用同样的锁定前两镜。评分用可观测因子乘积 $\mathrm{score}(x, s^\star_T) = I_{\mathrm{act}}(x)\cdot I_{\mathrm{vis}}(x)\cdot \mathrm{match}(x, s^\star_T)$(Eq. 1),但分别报告 setup、leak、reveal、inside 各门而非乘积,never-open 是阈值化的动作类别计数而非均值。M3-Agent 则是测试时三步循环:读末帧、诊断失败动作、只改写失败的那一步指令,用同一冻结模型(Wan TI2V-5B、T2V-A14B)再生成候选,并按 Eq. 3 的 $\hat{x}=\arg\max_{k\le K}\mathrm{score}(x^{(k)}, s^\star_T)$ 保留最优,原始候选始终留在候选集内。整个流程不加、不训练任何记忆模块。
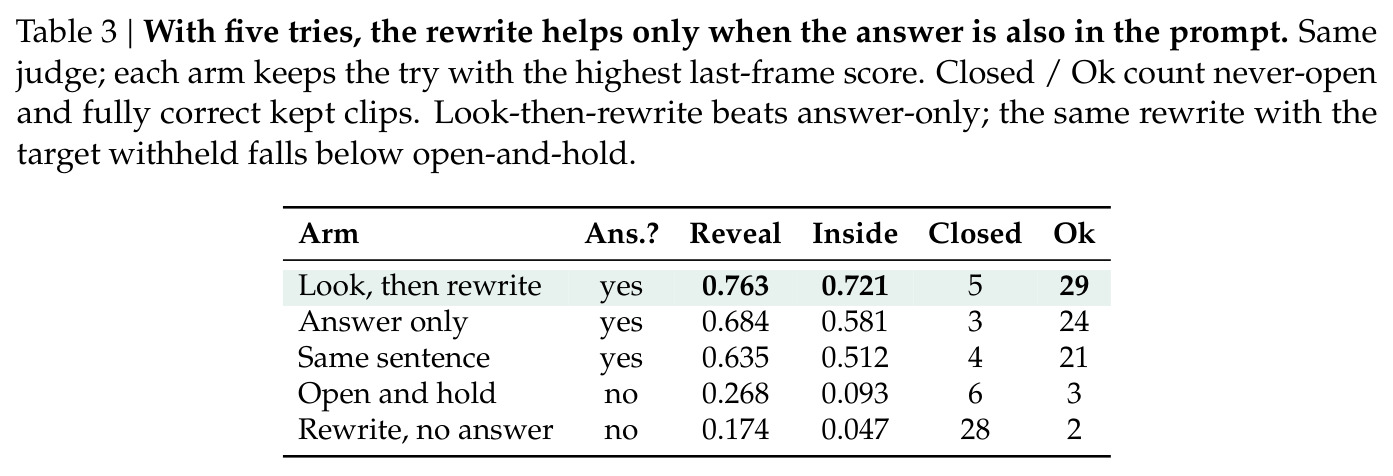
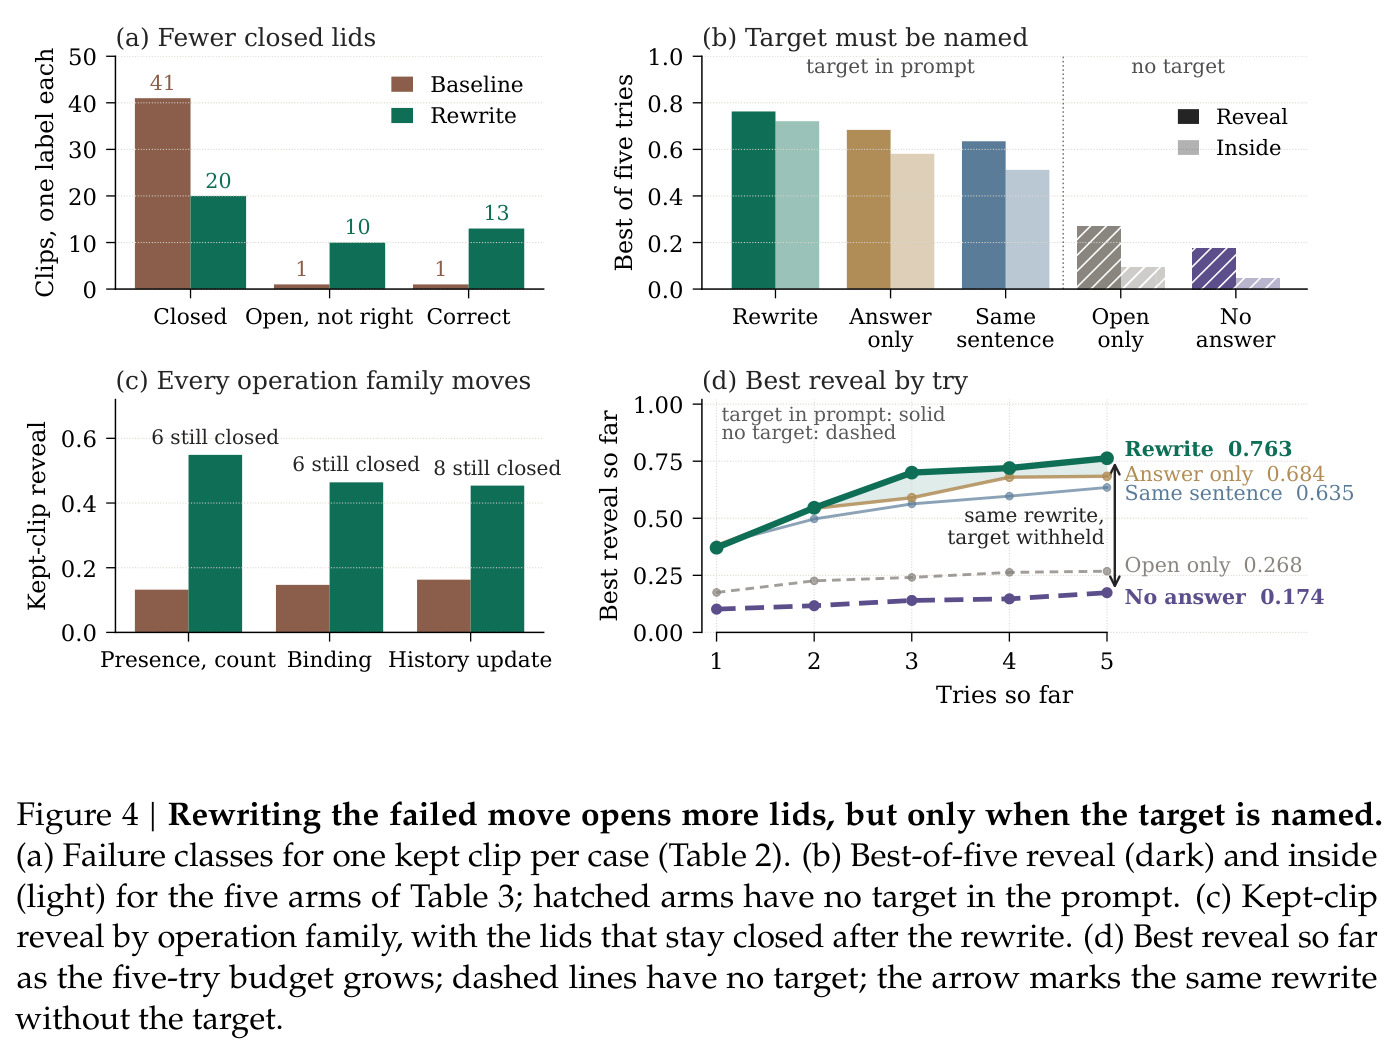
核心创新是把「记忆失败」这个笼统判断拆成可定位的执行门。总分是乘积,任何一环为零总分即坍缩,所以低分既可能来自「没执行」也可能来自「记错」,单看总分无法区分——这是对现有记忆基准一票否决式计分的直接批评。M3-Agent 的本质区别同样在「改什么」:它改写的是失败的动作描述而非答案本身,也不做无诊断的同句重采样。Table 3 的五臂消融精确锁定这一点:无诊断的「open and hold」只拿到 reveal 0.268;只给答案句子(answer-only)拿到 0.684;看末帧后诊断改写(look-then-rewrite)拿到最高的 0.763;而同样的改写方法若在提示词中隐去目标,掉到 0.174、43 个案例中 28 个盖子纹丝不动。也就是说,「诊断定位」与「目标命名」二者缺一不可,这一细粒度归因是已有测试时重写方法从未给出的。
方法步骤详情
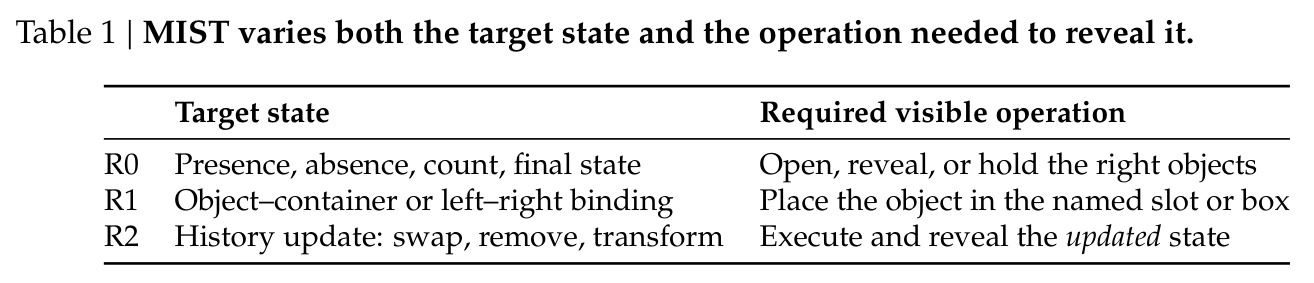
流程分评测与修复两半。MIST 侧:(1) 从任务卡生成三段式案例,目标状态 $s^\star_T$ 分为 R0(存在/缺失/计数/终态)、R1(物体—容器或左右绑定)、R2(历史更新:交换/移除/变换)三类,所需的可见操作分别是开盖揭示、放对位置、执行并展示更新后状态;(2) 生成并锁定前两镜,审计确认间隙不泄漏答案(基线与改写均 0/43 泄漏);(3) 生成揭示镜,VLM 裁判分别打 setup、leak、reveal、inside 四门。M3-Agent 侧:(1) 从任务卡构建任务记录,列出主体/物体、必需绑定、操作、以及末帧 $x_T$ 必须出现的证据;(2) VLM 对照记录检查末帧,指派失败类型:无动作、错误绑定、缺少离开、返回时物体完好、视野被遮挡;(3) 只改写失败的操作及其末帧证据子句,保留主体、物体、目标状态与时间顺序,冻结模型重新生成。在官方套件上各有侧重:WRBench 的改写要保证离开—返回相机路径完成;MBench-T 的候选集必须包含原片段,以防强制改写损害已正确的案例。
技术新颖性
与 WRBench/MBench 等单分记忆基准相比,MIST 首次把延迟揭示拆成设置、泄漏、执行、匹配四个门并分列报告,使「缺失动作」不再被记成「遗忘」;与 StEvo-Bench、MemoBench 等阶段性基准相比,MIST 把「转换是否发生」与「终态是否正确」的分离原则落到延迟揭示场景,并显式控制间隙泄漏、锁定前两镜做配对分析;与 VideoRepair、Video-T1 等视频重写工具相比,M3-Agent 重写的对象是「缺失的动作」而非画质或物理,且全程不修改模型权重;与 LLM 的测试时搜索(best-of-N、自我修正)相比,本文把搜索空间限制在单步动作改写,并用五臂消融证明增益来自「诊断+目标命名」的组合而非算力堆叠。作者也诚实标注:keep-best 是用上报评分器选出的 oracle 覆盖估计,不是可部署的 critic。
实验结果
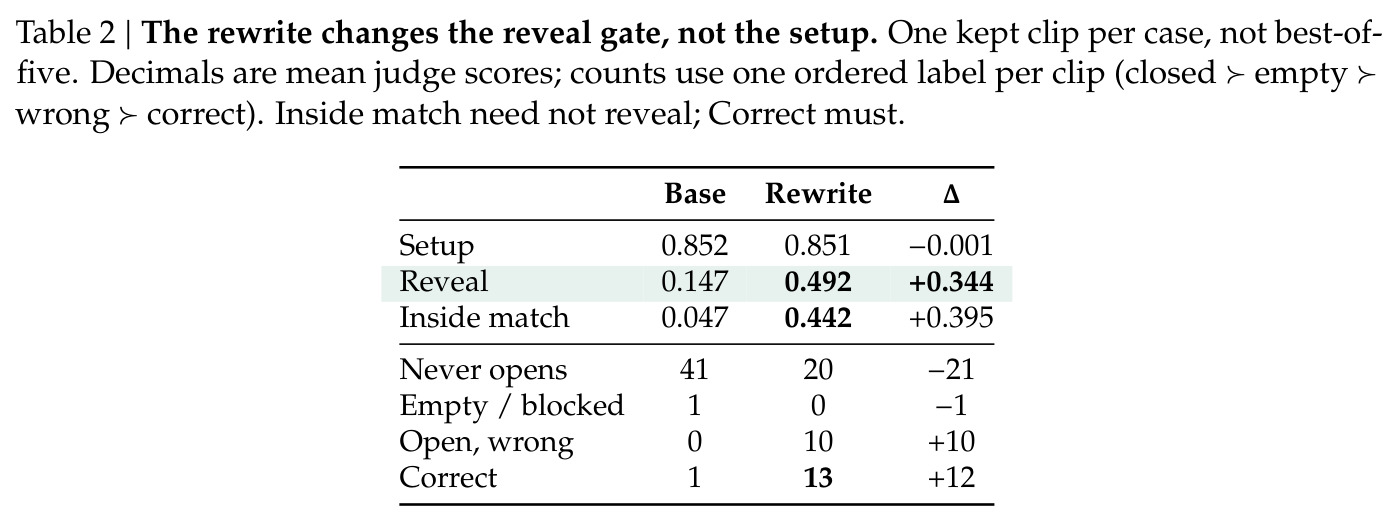
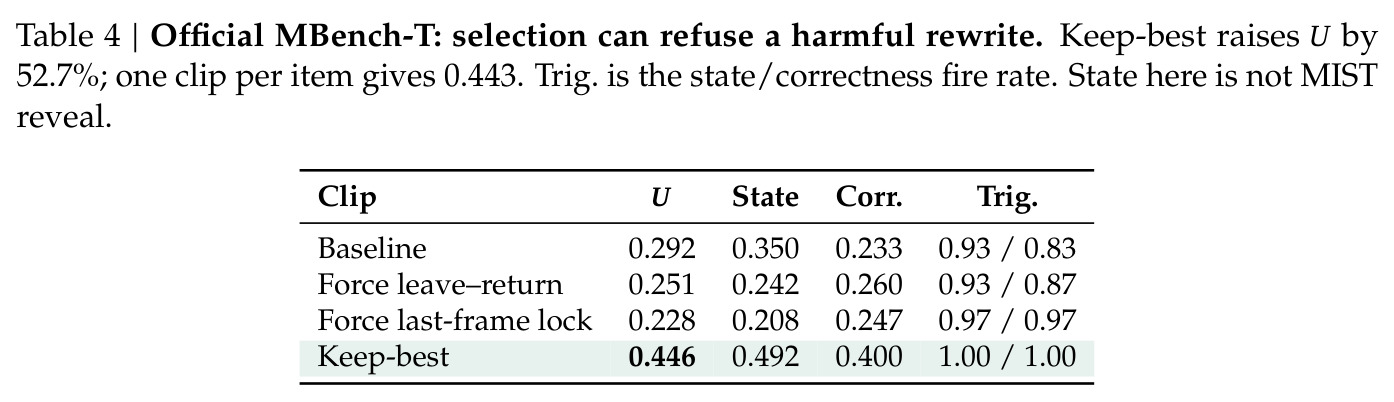
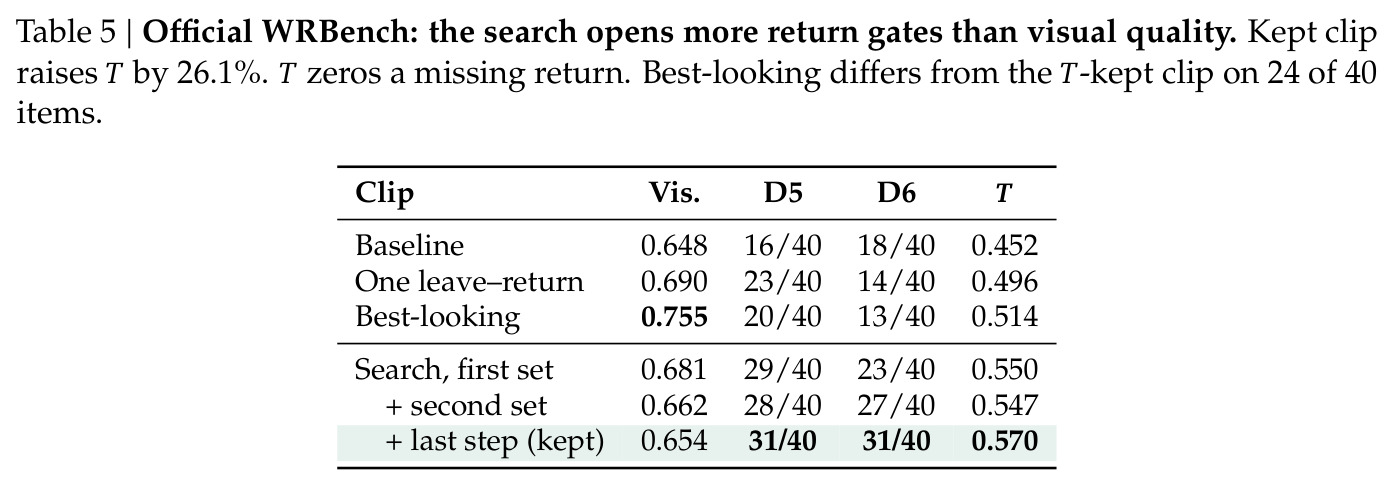
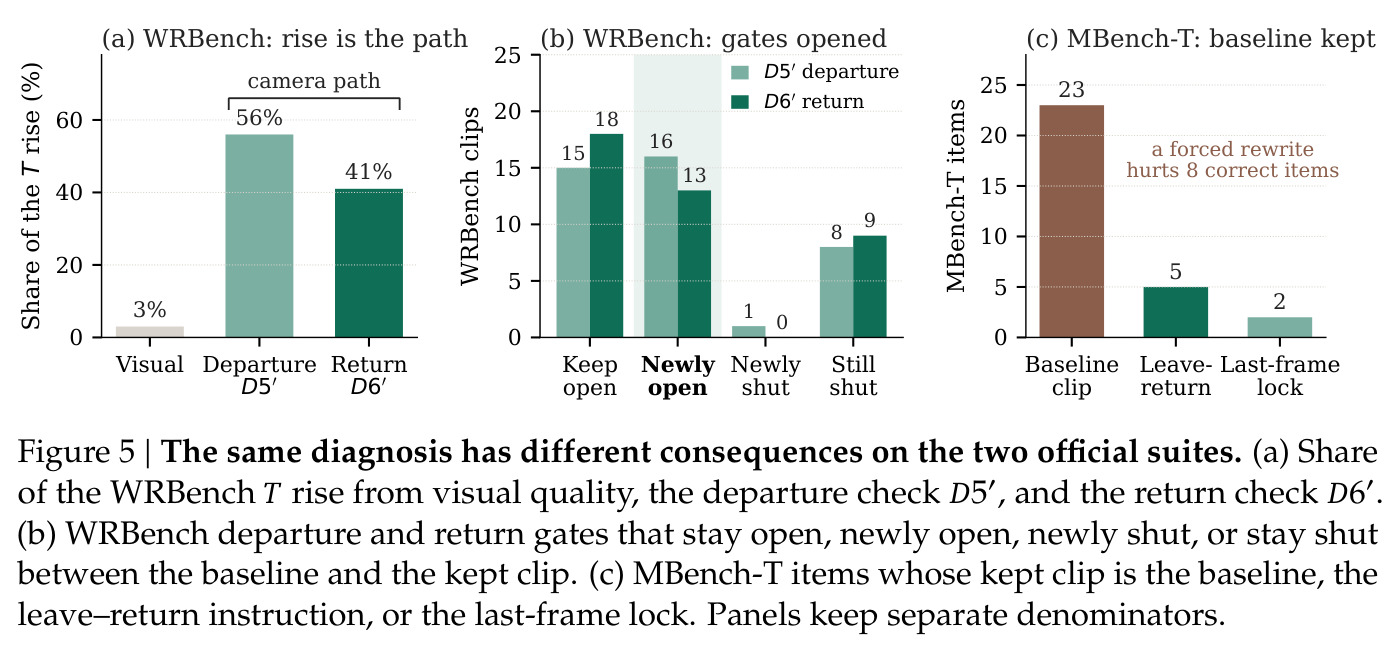
四组关键结果。(1) MIST 预实验(Wan TI2V-5B,43 例):setup 高达 0.852(38/43 例 ≥0.8)、间隙零泄漏(0/43),但 41/43 个基线视频从不打开容器,reveal 仅 0.147——失败在动作门而非记忆门。改写后 reveal 升至 0.492(per-case 配对变化 0.34,95% CI 0.24–0.45;35 升/6 平/2 降),inside match 从 0.047 升至 0.442,never-open 41→20,correct 1→13,但 open-but-wrong 0→10,说明改写暴露状态却不保证正确。三类操作家族同向移动:presence/count 0.132→0.549、binding 0.147→0.464、history update 0.163→0.454。(2) 五臂消融(各 5 次尝试):look-then-rewrite 0.763 > answer-only 0.684 > same-sentence 0.635 >> open-and-hold 0.268 > 无目标改写 0.174。(3) 官方 WRBench(T2V-A14B,n=40):$T$ 从 0.452 升至 0.570(+26.1%,95% CI +0.070–0.166),归因显示仅 3–4% 来自画质、55–56% 来自离开检查 $D_5'$、41% 来自返回检查 $D_6'$;40 个返回门 18 开/13 新开/9 仍关;最好看片段与按 $T$ 保留的片段在 24/40 条目上不同。(4) 官方 MBench-T(n=30):$U$ 从 0.292 升至 0.446(+52.7%,单片段 0.443),23/30 保留基线片段;固定 leave-return 降到 0.251 并损害 8 个满分案例,末帧锁定单独仅 0.228。文本-only 对照:8B 裁判从金句文本答对 0.91、从基线末帧仅 0.09、从改写末帧 0.56。MiniMax-H3 打包 15 秒镜头上 never-open 降至 3/43 但开错 24/43。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Internal MIST 延迟揭示(Wan TI2V-5B,43 例) | reveal 均值 | 0.492(M3-Agent 改写后) | 0.147 | +0.345,3 倍以上 |
| Internal MIST 末帧匹配 | inside match | 0.442 | 0.047 | +0.395 |
| Internal MIST 动作执行 | never-open 片段数 | 20/43 | 41/43 | 减少 21 例 |
| Official WRBench(T2V-A14B,n=40) | 总分 T | 0.570 | 0.452 | +26.1%(95% CI +0.070–0.166) |
| Official MBench-T(n=30) | 总分 U | 0.446(单片段 0.443) | 0.292 | +52.7% |
| 五臂指令消融(best-of-5) | reveal | look-then-rewrite 0.763 | answer-only 0.684;无目标改写 0.174;open-and-hold 0.268 | 诊断改写最优,但隐去目标后反低于 open-and-hold |
局限与改进
作者明确承认:keep-best 是用与上报相同的评分器在小候选池上做的 oracle 选择,不是可部署的 critic——看不到分数的末帧阅读器打不过基线;改写后的提示词可以点名目标,隐去目标后方法失效(0.174、28/43 仍关闭);因此全部结果不能证明骨干模型存储了 $s^\star_T$,只能证明冻结模型「一旦指令点名就能执行」;主研究集中在 Wan 一族生成器,MiniMax-H3 打包镜头只做了 Internal 定性试点;MBench-T 上 14/30 个案例依然无解,只让模型「保持更新」的提示修不了它们;WRBench 上第二个指令集还会把分数从 0.550 拉低到 0.547,说明加技能不单调。我的补充观察:三个评测的样本量都很小(43/40/30),置信区间宽;所有门控依赖 VLM 裁判,与官方门的一致性偏低且未做人类验证;官方分 $T$、$U$ 本身的判据有效性是被绕开而非被修正。
独立分析的弱点
最脆弱的一点是 oracle keep-best:Eq. 3 用上报评分器选片段,等于拿着考试答案挑卷子,部署时并不存在这个裁判,报告的 0.570 和 0.446 都是覆盖上界而非可达性能。改进方向是训练一个目标盲的失败分类器或基于多次生成一致性的候选排序,替代评分器选片。其次是 VLM 裁判的单点依赖:setup/reveal/inside 与失败诊断全由固定裁判完成,裁判出错会同时污染测量与选择两端,论文自认与官方门一致率不高且无人类标注,可引入多裁判投票与人类校准子集。第三,规模太小:MIST 43 例、WRBench 40、MBench-T 30,且集中在 Wan 一族与少数容器类场景,结论对交互式长时程世界模型的外推存疑,应在多模型、数百案例上复核。第四,方法依赖提示词点名目标,意味着系统外部仍需知道答案,这与「记忆」的本意相悖——真正的记忆系统应支持无答案的检索式提示,这是后续工作最应该攻克的消融缺口。
未来方向
作者指出的方向:要声称模型存储了 $s^\star_T$,需要目标盲选择器胜过基线、held-out 案例和人类标注的暴露状态,三者都尚未实现;记忆评测应把「场景是否设置」「动作是否执行」「末帧是否正确」三查分开上报,而不是报一个总分。基于成果可延伸的方向:(1) 把 M3-Agent 的诊断—改写循环训练成轻量 critic,替代 oracle keep-best,让增益可部署;(2) 在带记忆模块的长时程交互世界模型上用 MIST 门控定位模块真正的收益环节,检验记忆模块到底改善的是执行还是持久性;(3) 在 R0–R2 之外扩展多步组合操作与因果链状态更新;(4) 以 MiniMax-H3 的 15 秒打包镜头为主协议,研究「不打开」如何随时长转化为「开错」;(5) 用同一门控框架审计其他记忆基准,绘制跨基准的失败类型分布图,推动社区把三查分离变成报告规范。
复现评估
复现门槛中等。论文给出网站 hku-mmlab.github.io/MIST 与代码库 github.com/HKU-MMLab/MIST;主模型 Wan TI2V-5B 与 Wan T2V-A14B 均为开源权重,5B 版本单张 24GB 级显卡即可推理,A14B 需要多卡或量化;MiniMax-H3 是内部试点,权重可得性需另行确认。若 43 个 MIST 案例与任务卡随代码发布,五臂消融每臂 5 次尝试约 $43\times5\times5$ 次生成,加上官方套件 40+30 例的多候选生成,总生成量在千段 5–10 秒视频量级,属于中小规模实验,一张 A100 数天可完成。主要不确定性在裁判复刻:需要照搬其 VLM 裁判、官方 scorers 以及文本-only 审计流程,否则门控分数不可比。总体判断:有开源代码与开源模型,熟悉视频生成的工程师两周内可复现主表。
论文图表
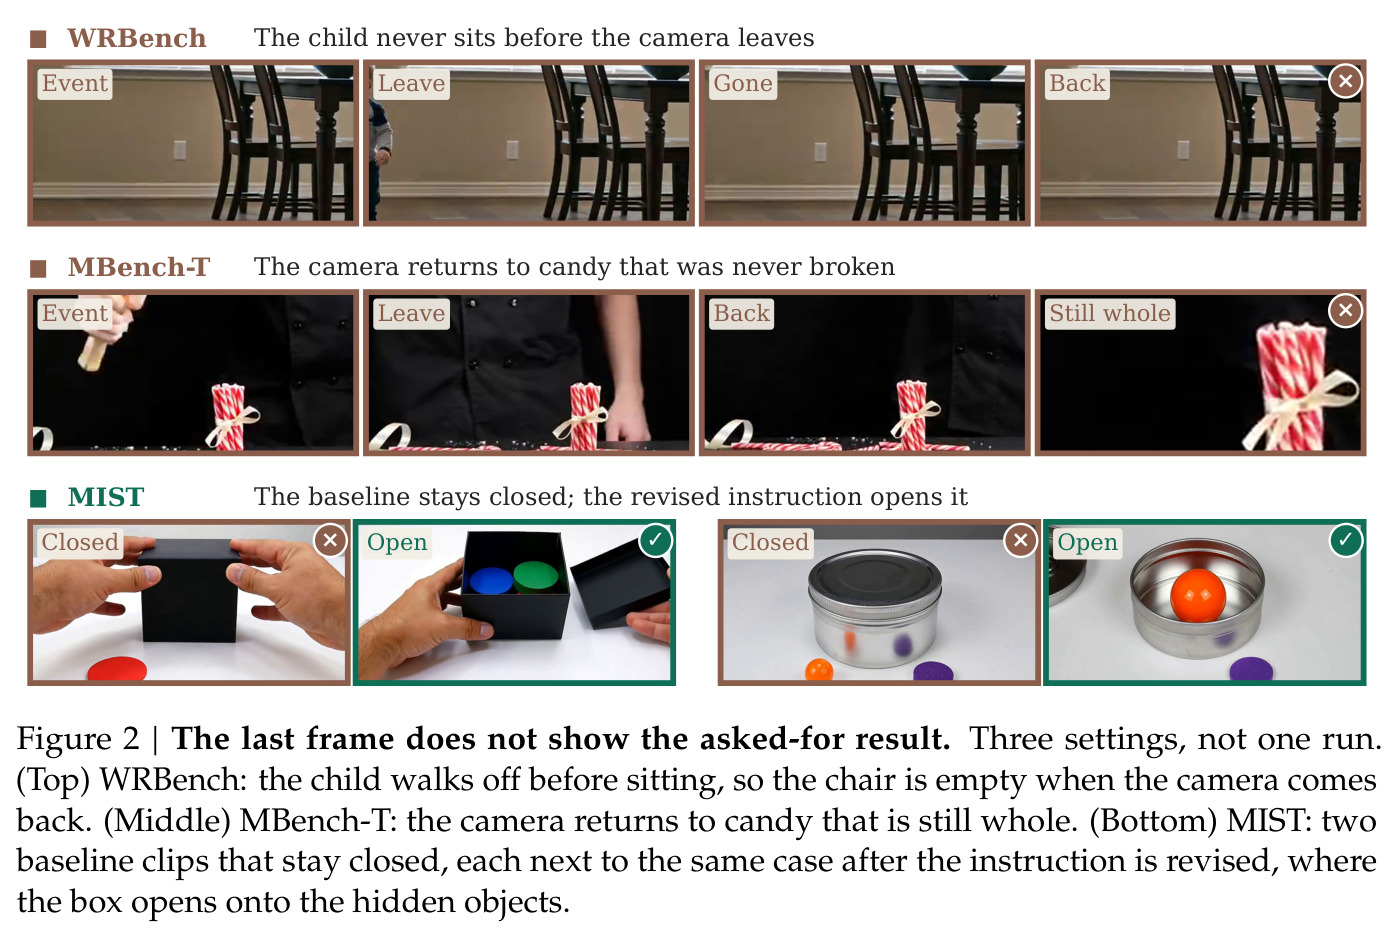
三组真实生成帧的失败实例:WRBench 中小孩在镜头离开前从未坐下,镜头回来时椅子空着;MBench-T 中镜头回到完好无损的糖果;MIST 中两个基线盖子始终关闭的案例,与同一案例改写指令后打开露出内部物体的对比。
用肉眼可验证的生成帧直观展示「分数丢在执行而非记忆」这一核心论点,比任何数字都更有说服力。