语言模型学会改进语言模型(LM2LM) Language Models Learn to Improve Language Models
用研究世界模型预测实验增益作 RL 奖励,配合在线校准训练出会提出模型改进的 LLM
前置知识
RLVR 与 DAPO
可验证奖励强化学习(RLVR)用可自动核验的信号(如数学答案对错)作为奖励训练 LLM。DAPO 是其代表性算法:对每个状态从当前策略采样一组 $G$ 个回答,用组内奖励的均值归一化得到优势 $\hat{A}_i = (R_i - \text{mean})/\text{std}$,再做带非对称裁剪的 token 级策略梯度更新,奖励无变化的组被丢弃。它无需训练价值函数,适合奖励可精确计算的场合。
LM2LM 的训练骨架就是 DAPO,其全部创新在于把『奖励从哪来』换成了研究世界模型的预测,理解 DAPO 的组相对优势机制才能看懂第 4.5 节的奖励可靠性分析。
研究世界模型(RWM)
指一个冻结的 LLM,输入是研究任务描述、候选提案和一组历史实验记录(提案与实测增益),输出是对该提案实验增益的预测 $\hat{g}(e, a; M)$,记录以 in-context 方式提供。它相当于一个『读过大量实验日志的虚拟研究员』,能在不真正跑实验的情况下预判某个训练配方改动的效果,源自同期工作 Wang et al. 2026b。
RWM 是本文奖励信号的来源,把一次提案评估的成本从完整模型训练(数十 GPU 小时)降为一次 LLM 调用;文中所有关于反馈可靠性的讨论都围绕它展开。
奖励过度优化(reward overoptimization)
当 RL 优化的奖励是真实目标的代理(surrogate)时,策略会先提升真实目标,随后转向钻代理的空子:代理分数持续上涨而真实收益停滞甚至下降(Goodhart 定律,Gao et al. 2023 的 scaling law 刻画)。原因是代理模型只在训练分布内可靠,策略一旦移出该分布,预测误差就变成可被利用的漏洞。
这是本文第二大挑战的理论根源:随 RL 推进提案分布漂移,静态 RWM 的预测会系统性高估,论文用偏差分解 $\bar{J}(\theta) = \Delta_M(\theta) + \hat{J}_M(\theta)$ 定量刻画并设计在线校准来压制 $\Delta_M$。
BPB 与扩散语言模型的 NLL
BPB(bits per byte)衡量编码每字节文本所需的平均比特数,与 tokenizer 无关,便于跨模型家族比较,是自回归预训练的标准评估之一。扩散语言模型则沿其贪心解掩码顺序累加真实 token 的精确负对数似然,以 nats per token 报告。两者数值越低模型越好,提案增益即参考配置损失减去提案配置损失。
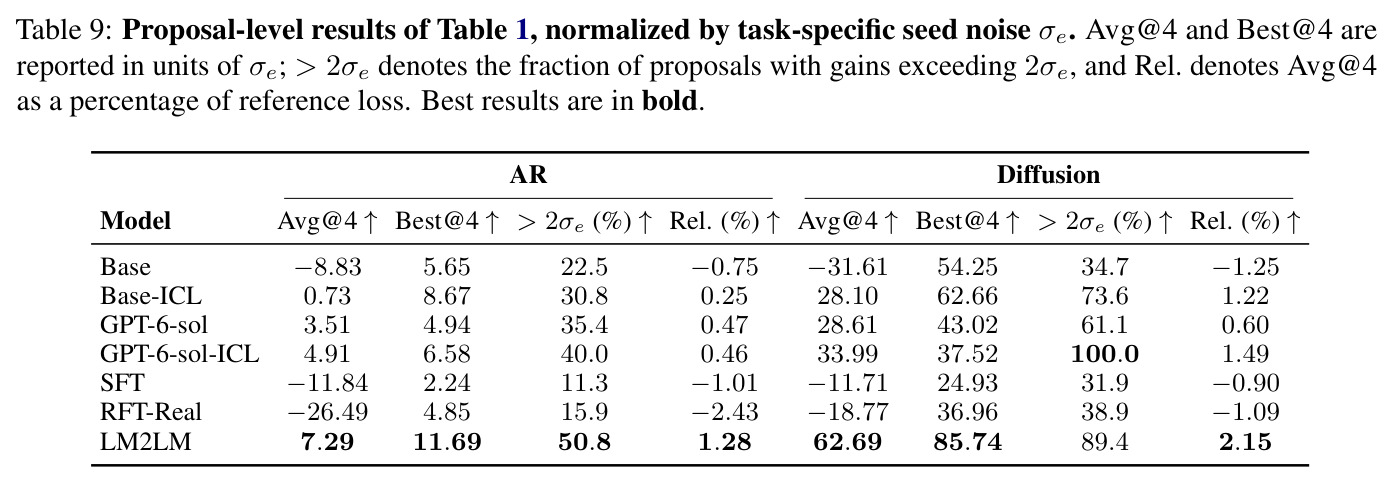
论文所有实验增益以 $10^{-3}$ BPB(AR)和 $10^{-2}$ nats/token(扩散)计,且用任务级种子噪声 $\sigma_e$ 做归一化,不了解这些度量就无法判断增益到底有多大、是否显著。
AutoResearch 与递归自改进(RSI)
AutoResearch 指用 LLM agent 自动化实证研究全流程:提出想法、实现代码、跑实验、分析结果。递归自改进(RSI)是其激进目标——系统改进自身或下一代模型,形成能力增强的正反馈循环。当前 agent 能执行复杂实验,但『决定下一步试什么』的研究判断仍明显弱于人类专家。
本文把『研究判断』形式化为提案生成策略 $\pi_\theta$ 并用 RL 训练它,正是通往 RSI 的一条具体技术路径,引言和结论均以此为定位。
研究动机
让 LLM 从历史实验中学会『提出有效的模型改进提案』面临两个具体瓶颈。其一是真实反馈贵得离谱:评估一个提案意味着按该配方从头训练一次目标模型,例如训练一个 486M 参数模型到 8B tokens 约需 45 个 B200 GPU 小时;一次 GRPO 风格的 RL(100 次更新 × 每次更新 32 个训练状态 × 每状态 8 个提案)需要评估 25,600 个提案,按同一成本估算要烧掉约 1,152,000 GPU 小时、超过 1600 万美元,直接用真实执行做奖励完全不可行。其二是廉价替代反馈会随训练失效:如果用一个固定在历史实验记录上的预测器当奖励,RL 初期还有效,但随着策略更新,它开始大量生成历史记录未覆盖的新提案,预测器在这些提案上系统性高估,于是 RL 会提拔『预测收益高但真实收益差』的提案,代理奖励上涨而真实增益不动。作者还指出,仅仅把几百条实验记录塞进上下文(ICL)或拿它们做 SFT/RFT 微调,都无法把这种经验转化为跨模型、跨配置可迁移的提案能力。
本文的目标是本文的目标是训练一个提案生成器 $\pi_\theta$,使其在给定研究状态 $s = (e, h)$(任务 $e$ 加历史实验记录 $h$)时,生成实验增益 $g(s,a) = b_e - \ell_t$(参考验证损失减去提案配置的验证损失)尽可能高的提案,形式化即最大化训练任务上的期望增益 $J_{train}(\theta)$ 并在 held-out 任务上取得高 $J_{test}(\theta)$。约束条件是:整个训练过程只允许极少量真实执行——初始 100 条实验记录加三次校准共 200 次训练运行,远低于 RL 采样的 14,000+ 个提案数;同时反馈必须在策略漂移后仍然可靠,且学到的提案能力要能泛化到训练时完全未见过的模型家族(如 held-out 的 Qwen3)。
与已有工作不同的是,已有自动化研究工作(AI Scientist、AlphaEvolve、Frontis-MA1 等)要么保持 agent 固定、只靠执行反馈迭代候选方案,要么用执行反馈训练 agent,共同点是训练信号最终都来自昂贵的真实执行。把 LLM 当世界模型给 agent 生成合成训练环境的想法存在于 web 导航等领域,但本文抓住了两个被忽视的点:第一,在 LM 开发这种『单次评估即一次完整训练』的超贵环境里,世界模型不应只用来合成环境,而应直接充当 RL 的验证器(verifier),把奖励成本压到一次 LLM 调用;第二,静态世界模型必然随策略漂移而失效,而缓解手段不应是随机补充记录,而是定向执行『当前策略生成且被 RL 即将强化』的高分提案——把真实实验预算精确花在过估计风险最高的地方。这个 on-policy 校准视角与并发工作 WMRL 的每步单调重标定也有本质区别。
核心方法
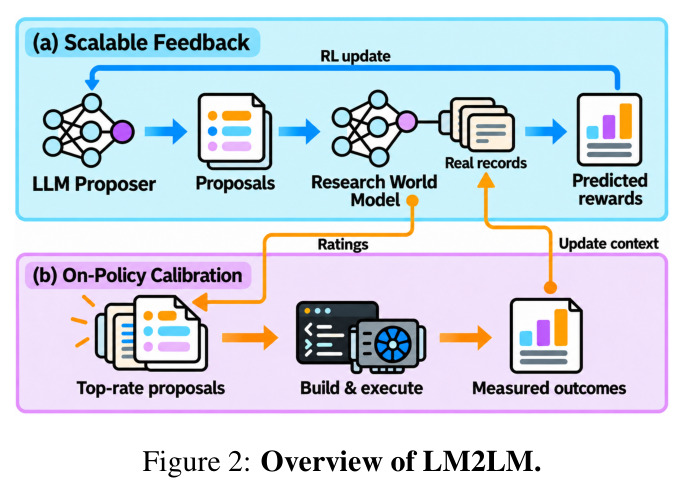
直觉上,LM2LM 像一个『带虚拟实验室的导师制培训』:学员(Qwen3.8-27B 提案者)不断提出训练配方改进方案;一位博览群书的老研究员(冻结的 GPT-6-sol 研究世界模型,RWM)根据档案室里 100 份真实实验记录,对每份方案快速给出预期增益评分;学员按 DAPO 算法围绕这些评分做组相对策略梯度更新。但老研究员的知识局限于已有档案,当学员的方案越来越新,他的估价会失真。于是每隔一段训练,实验室会真实执行一批学员当前最被看好(RWM 打分最高)的方案,把实测结果放回档案室——校准不是随机的,而是专门验证那些 RL 马上要强化的判断。技术上整条流水线是:初始记录 $M_0$ 构造训练状态 → 每状态采 $G=8$ 个提案 → RWM 预测增益 → 经任务尺度归一化、裁剪、有效性/重复/多样性修正后得到奖励 $R_i$ → DAPO 更新;每 8 步把采样过的提案连同 RWM 预测增益作为合成记录扩入历史池;在 step 16/40/64 执行 top-rated 提案扩充 $M$,四次训练段各自使用固定的 RWM 奖励函数。
核心创新有两层。第一层是『世界模型即验证器』:LM 开发中每个提案的 ground-truth 评估等于一次从头训练,RLVR 无法直接套用;LM2LM 用冻结 LLM 以 in-context 记录为依据预测增益 $\hat{g}(e, a; M) = W(e, a; M)$,把奖励成本从数十 GPU 小时降到一次 API 调用,使 25,600 量级的提案评估在 $40k 美元级别成为可能。第二层是『在线策略校准』:作者把归一化真实目标分解为 $\bar{J}(\theta) = \Delta_M(\theta) + \hat{J}_M(\theta)$,其中 $\hat{J}_M$ 是期望归一化预测增益(RL 实际优化的量),$\Delta_M$ 是当前提案分布下的预测偏差(RL 看不见的量);RL 完全可能只抬高 $\hat{J}_M$ 而不动真实目标。对策是在每个校准点从当前策略的候选中贪心选取 RWM 评分最高的提案执行,将实测结果并入记录。这与固定记录世界模型的本质区别在于:校准样本的分布紧跟策略演化,恰好覆盖 RL 即将强化、因而过估计危害最大的提案;案例显示这种定向校正能把一个被高估的有害 NanoChat 改动的训练份额从 79% 砍到 8%。
方法步骤详情
流程如下。(1)数据准备:在 40 个训练任务上执行机制库采样的 300 个提案得到真实记录,选 100 条作为初始 RWM 记录 $M_0$;训练状态 $s=(e,h)$ 的历史含 0–8 条该任务记录。(2)RL 采样:DAPO 每 rollout 采 277 个状态保留 256 个,每状态采 $G=8$ 个提案,温度 1.0。(3)RWM 打分:每提案调用一次 GPT-6-sol(高推理档、无工具)返回预测增益 $\hat{g}$。(4)奖励计算:先按 $r = \text{clip}(\hat{g}/\tau_e, -c, c)$ 做任务尺度归一化,其中 $\tau_e = \max(\sigma_e, 1.4826\,\text{MAD}_e)$ 由参考运行的种子噪声与预测增益的中位绝对偏差估计,$c=6$;无效提案得 $-c$(完全无改动得 $-3$),重复提案得组内最小奖励减间隔 $\delta=1$,有效提案另获多样性奖励 $b_i = \lambda \sigma_G \tilde{d}_i$($\lambda=0.3$,$d_i=1/n_i$ 为组内同机制方向提案数的倒数)。(5)策略更新:用组均值中心化优势(不除标准差以保留跨组差异)做 DAPO 更新,非对称裁剪 $\epsilon_{low}=0.2, \epsilon_{high}=0.28$。(6)合成状态扩展:每 8 步把本 rollout 提案连同 RWM 预测增益并入记录池并重采样历史。(7)在线校准:在 step 16/40/64 求解 $Q_u = \arg\max_{Q \subseteq C_u, |Q|=B_u} \sum_{(s,a)\in Q} r(s,a;M_u)$,由 builder 实现并执行 $B_0=31, B_1=38, B_2=31$ 个提案,实测结果按 $M_{u+1} = M_u \cup \{(e, a, g(s,a))\}$ 并入记录;共训练 96 步(可延至 128),合计 200 次真实运行。
技术新颖性
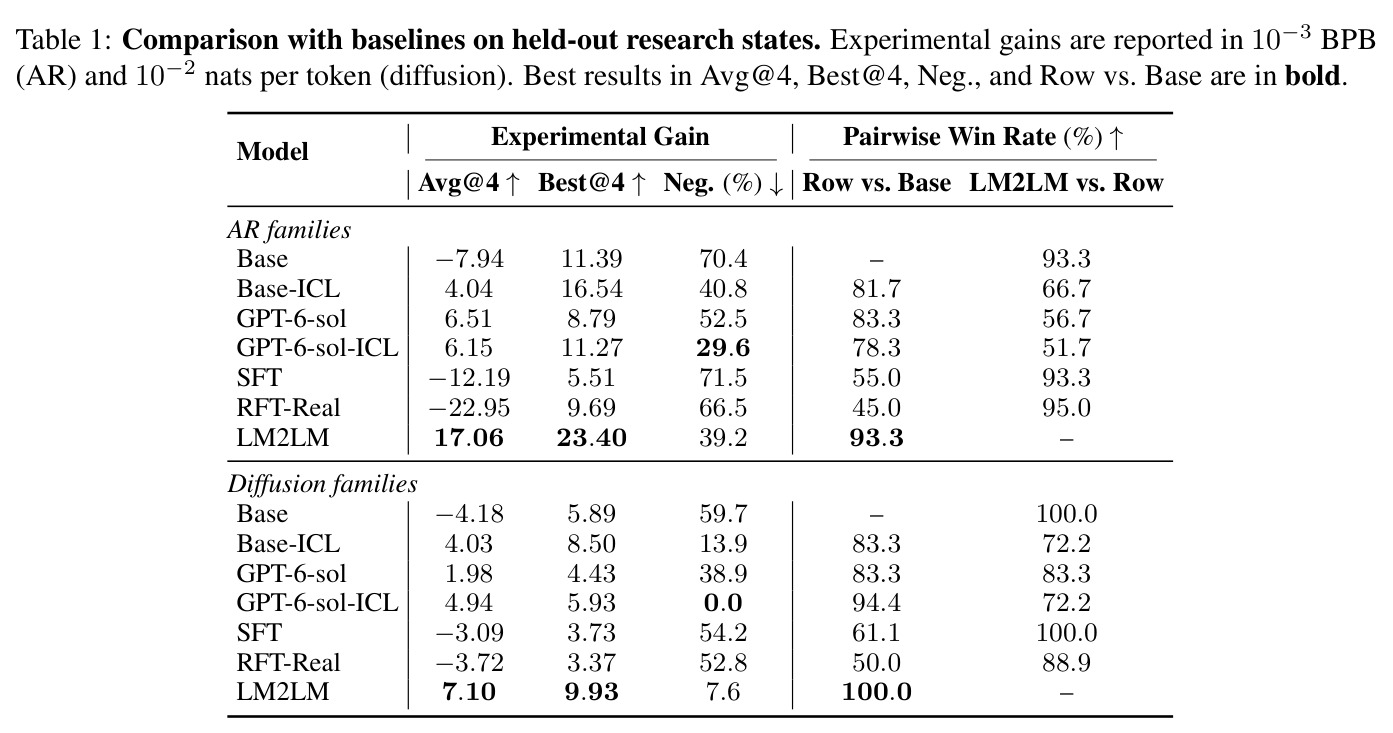
与三条已有路线的差异都很清晰。相对『固定 agent + 执行反馈』(AlphaEvolve、Karpathy 的 AutoResearch 等):本文训练 agent 本身,且训练反馈主要来自世界模型预测而非真实执行。相对『执行反馈训练 agent』(Si et al. 2026、Frontis-MA1):本文把 RL 需要的真实执行从每个采样提案一次压缩到仅校准批 200 次,数据生成成本降低约 33%。相对并发工作 WMRL(同样用冻结 LLM 世界模型供奖励):WMRL 每步用拟合于真实执行的单调映射重标定预测,LM2LM 则通过扩充 RWM 的 in-context 记录来校准——保留世界模型的语义知识而非只做数值矫正,且 top-rated 选择直接瞄准 RL 即将强化的提案。相对 SFT/RFT-Real:同样的几百条记录直接微调反而伤害提案质量(SFT 使 AR Avg@4 从 $-7.94$ 降到 $-12.19$),说明经验需要经 RL + 世界模型间接蒸馏而非参数直灌。此外奖励工程中的任务尺度归一化、多样性红利与重复惩罚也是针对研究提案这一动作空间的新设计。
实验结果
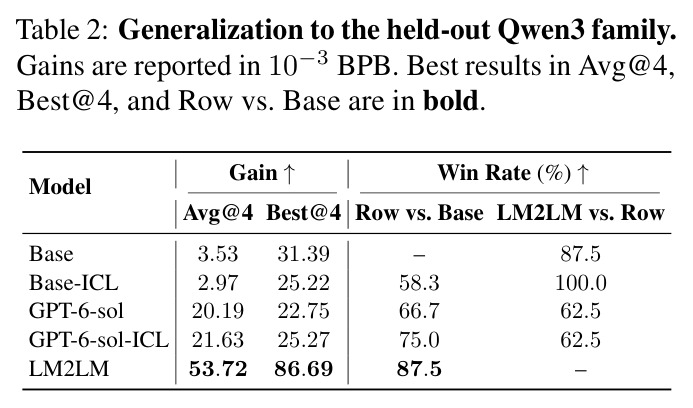
评估覆盖 10 个 held-out 任务的 60 个 AR 与 18 个扩散研究状态,真实执行、每状态生成 4 个提案。AR 上 LM2LM 的 Avg@4/Best@4 达 17.06/23.40($10^{-3}$ BPB),远超 Base($-7.94$)、Base-ICL(4.04)与 GPT-6-sol-ICL(6.15);SFT/RFT-Real 反而拖到 $-12.19$/$-22.95$,证明几百条记录直接微调学不会提案能力。LM2LM 在 93.3% 状态上胜过 Base,负增益率从 70.4% 降到 39.2%(扩散任务从 59.7% 降到 7.6%),且 Avg@4 更高说明它在追求更大增益而非单纯避险。扩散任务上以 7.10/9.93 全面第一。成本上:step 96 用 200 次真实运行、$40.1k 达 17.06,ICL 需 300 次、$60.0k 才到 4.04,成本与时间各省约 33%(343h vs 510h);算入 $16.1k RL 训练费(总 $56.1k)仍更便宜;step 40→96 只追加 $11.8k 即把 AR Avg@4 从 10.85 提到 17.06。泛化上:完全排除 Qwen3 记录训练后,LM2LM 在 held-out Qwen3 上达 53.72/86.69,远超 GPT-6-sol-ICL 的 21.63/25.27,而 Base-ICL 仅 2.97。消融:同样 200 次预算,top-rated 校准 17.06 优于加 100 条随机记录的 14.76,换随机校准则降到 10.84。可靠性分析(延至 128 步):静态 RWM 优势余弦从 0.69 跌到 $-0.42$、pairwise 准确率从 0.72 跌到 0.37(低于随机 0.5)、预测-真实奖励差在 step 96 冲到约 2.0;LM2LM 保持余弦为正、pairwise 0.61、差距从 0.85 降至 0.17。案例证实机制:初始 RWM 将某 NanoChat 优化器改动高估为 $+0.7$–$+1.25$(真实约 $-1.46$),静态变体令其训练份额升至 79%,LM2LM 首次校准执行 7 个此类提案后 RWM 改评 $-1.66$,份额跌至 8%。按种子噪声归一化,AR Avg@4 达 7.29$\sigma_e$(基线最高 4.91$\sigma_e$),50.8% 提案增益超 $2\sigma_e$,相当于参考损失降低 1.28%。
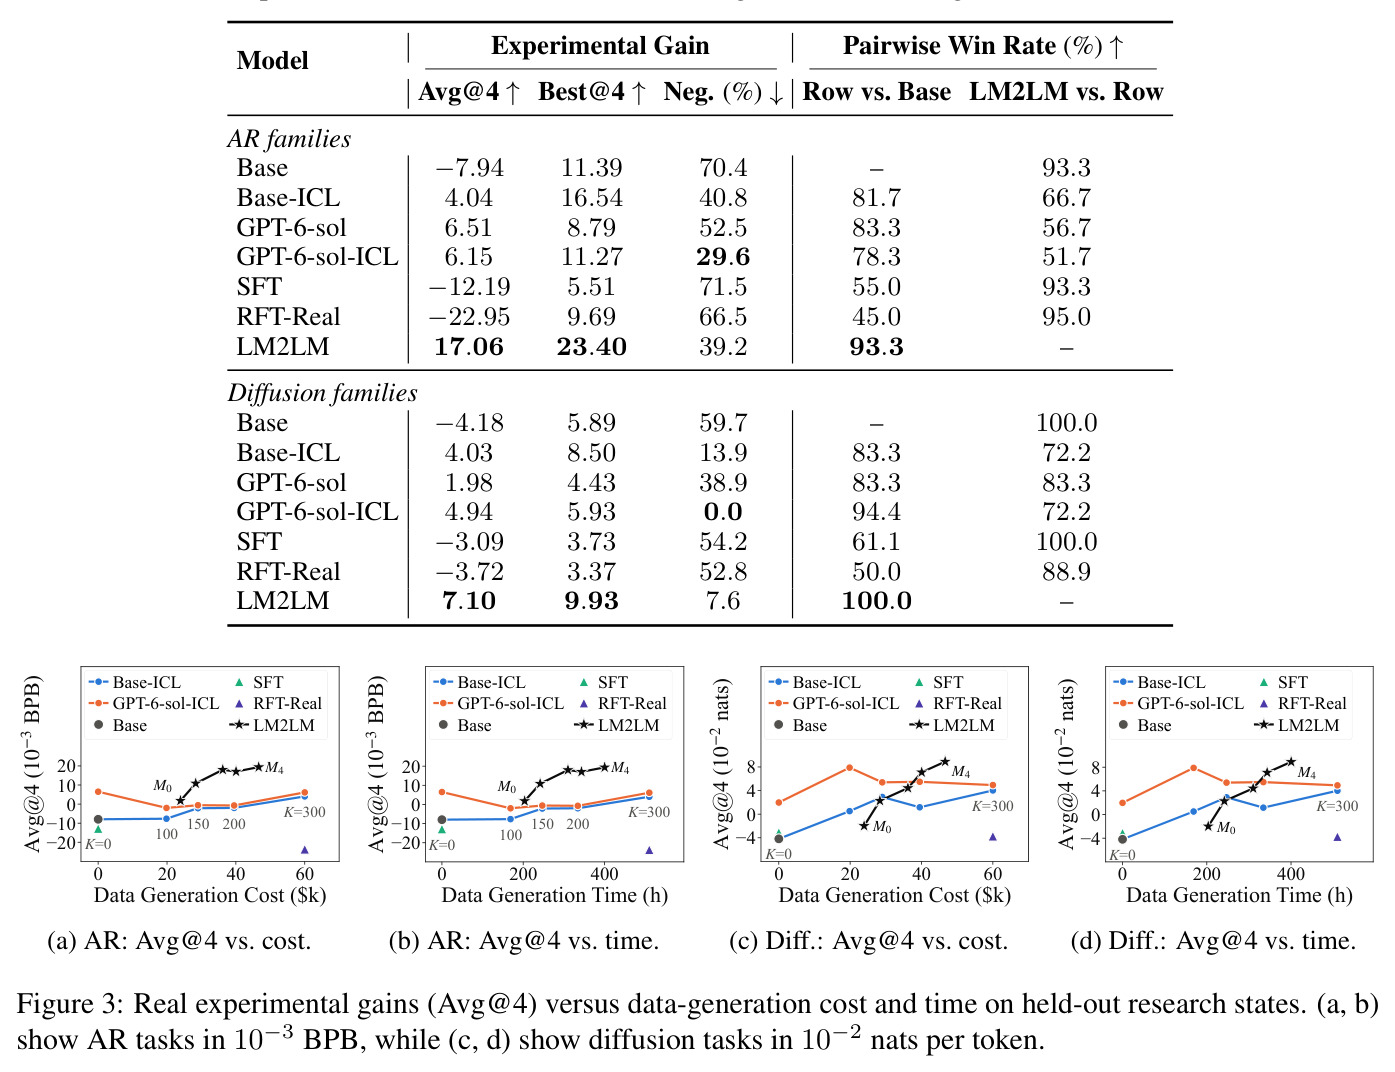
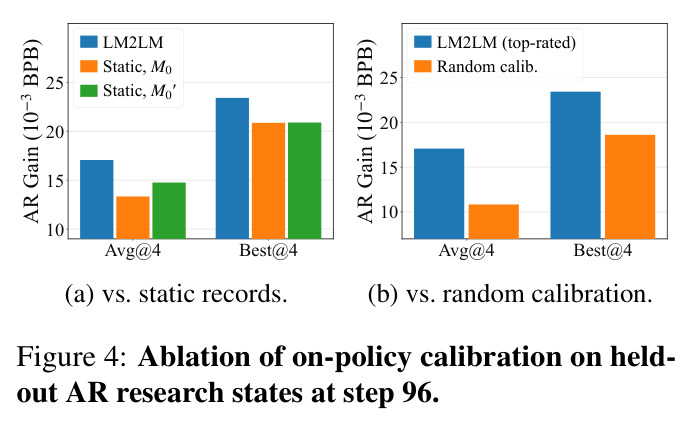
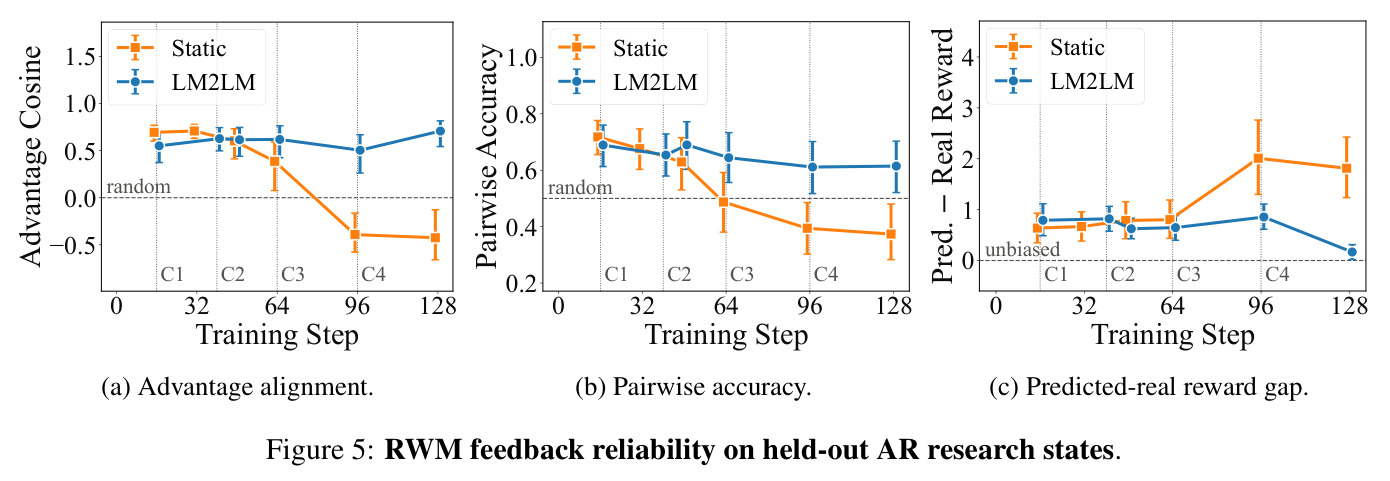
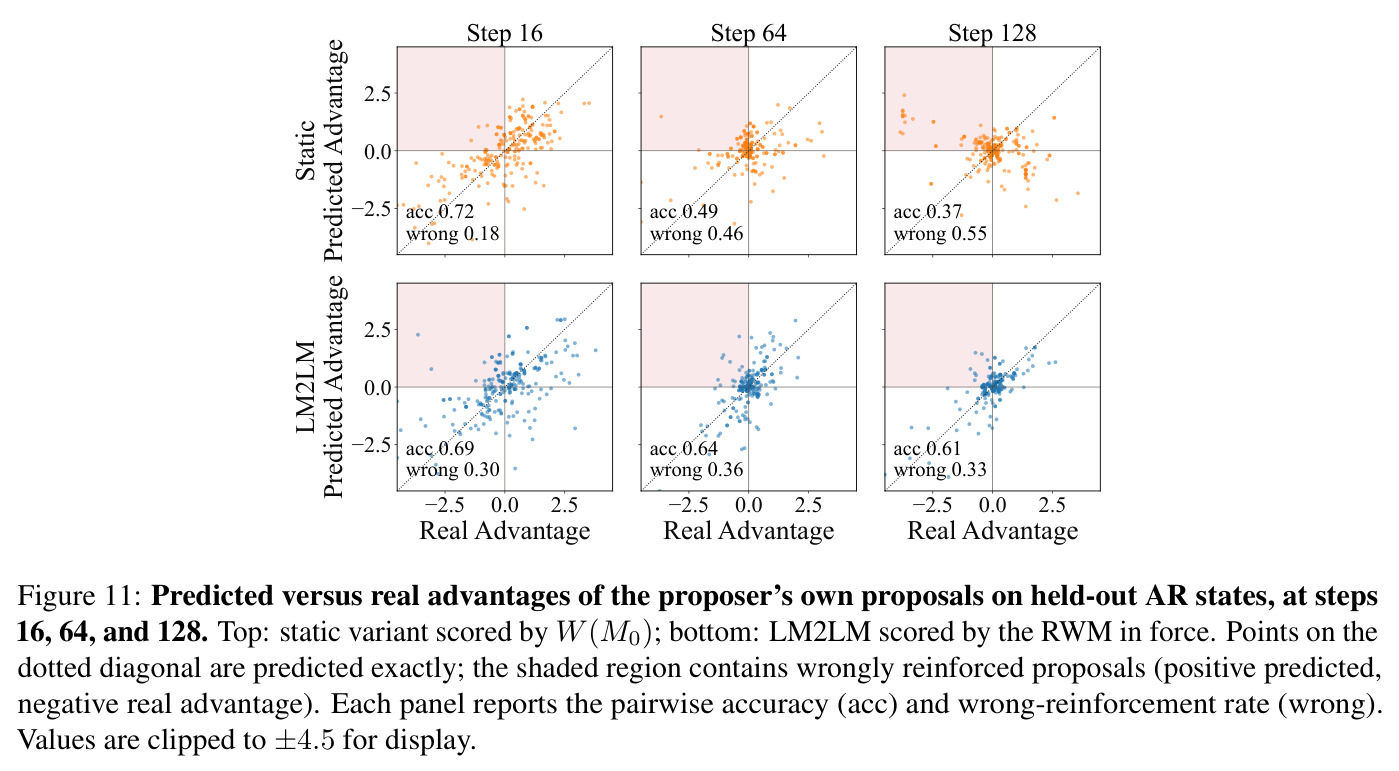
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AR held-out 研究状态提案(60 状态) | Avg@4 真实增益($10^{-3}$ BPB) | 17.06 | GPT-6-sol-ICL 6.15;Base-ICL 4.04;Base $-7.94$ | 较最强 ICL 基线提升约 2.8 倍(+10.91) |
| 扩散 held-out 研究状态提案(18 状态) | Avg@4($10^{-2}$ nats/token) | 7.10 | GPT-6-sol-ICL 4.94;Base $-4.18$ | +2.16,负增益率从 59.7%(Base)降至 7.6% |
| 未见家族泛化(held-out Qwen3) | Avg@4 / Best@4($10^{-3}$ BPB) | 53.72 / 86.69 | GPT-6-sol-ICL 21.63 / 25.27 | Avg@4 提升 2.5 倍,Base-ICL 仅 2.97 |
| 数据生成成本效率 | 达到 17.06 Avg@4 的成本 | 200 次真实运行,$40.1k / 343h | ICL K=300:300 次运行,$60.0k / 510h 仅达 4.04 | 成本与时间均降约 33%,增益反而更高 |
| 校准策略消融(AR) | Avg@4 | top-rated 校准 17.06 | 随机校准 10.84;静态加随机记录 $M'_0$ 14.76 | 同预算下 +6.22 / +2.30 |
| 奖励可靠性(step 96–128,AR) | 优势余弦 / pairwise 准确率 / 预测-真实奖励差 | 保持正向余弦;0.61;0.85→0.17 | 静态 RWM:余弦跌至 $-0.42$;0.37;升至 2.0 | pairwise 从低于随机(0.37 vs 0.5)拉回 0.61,奖励差降约 10 倍 |
| 种子噪声归一化(AR) | Avg@4(单位 $\sigma_e$)/ 超过 $2\sigma_e$ 比例 | 7.29$\sigma_e$;50.8% | GPT-6-sol-ICL 4.91$\sigma_e$;40.0%;Base 22.5% | 增益相当于参考验证损失降低 1.28% |
局限与改进
作者承认:研究仅覆盖提案级改进而非端到端研究活动;RWM 预测仍不完美,在线校准仍需有限次额外训练运行。我的独立观察:(1)绝对增益量级很小——增益以 $10^{-3}$ BPB 计,AR 平均仅相当于参考损失降低 1.28%,而任务种子噪声 $\sigma_e$ 在 $0.0005$–$0.006$ BPB 之间,许多差异处在噪声边缘;(2)NanoChat 家族上所有方法几乎无提升(Best@4 至多 1.23),LM2LM 的 Avg@4 为 $-1.89$ 仍为负,任务本身没留改进空间时方法无从发力;(3)MARIN 与 E2D2-SW 的 Avg@4 被 GPT-6-sol-ICL 反超(15.15 vs 16.56;6.70 vs 7.96),优势并非在所有家族成立;(4)框架深度绑定闭源前沿模型——RWM 是 GPT-6-sol、builder 是 GPT-6-astra,API 价格变动或模型下线都会影响可复现性与成本结论;(5)动作空间受限于人工整理的 40 张机制卡,提案者无法提出库外的真正新想法,与『研究判断』的宏大叙事有距离;(6)校准次数($U=3$)、批大小 $B_u$ 与时点均为手工设定,缺乏自适应准则。
独立分析的弱点
(1)对闭源前沿模型的深度依赖:RWM 用 GPT-6-sol、builder 用 GPT-6-astra,预测质量上限被 API 模型锁死,且 RWM 打分对应 14k+ 次持续调用;改进方向是蒸馏出开源世界模型,或让校准数据同时用于微调本地 RWM。(2)统计功效不足:多数任务仅 3 次参考运行估计 $\sigma_e$,提案增益与噪声同量级,关键对比缺乏显著性检验;改进方向是校准批次和关键对比增加多 seed 重复或序贯检验,让 RWM 预测分布(q10/q90)进入奖励以显式处理不确定性。(3)动作空间封闭:40 张机制卡限定了可组合的改动类型,RL 只是库内学排序,无法产生新机制假设;改进方向是允许自由形式代码级改动,由 builder 的冒烟测试(论文已有 400 行上限 overlay 机制)兜底。(4)校准调度静态:固定在 step 16/40/64 各执行一批,与策略漂移速度无关;改进方向是监测 RWM 预测-实测残差的在线估计,超阈值即触发校准。(5)外部效度未知:所有任务都是 100M–500M 级模型的从头预训练,结论未必迁移到后训练或更大规模,至少应在一个 post-training 环境试点。(6)随机校准对照只在 AR 上做,扩散任务上 top-rated 选择的收益未单独隔离验证,削弱核心机制主张的普适性。
未来方向
作者提出的方向:把框架扩展到更广的研究环境,特别是 LM 后训练(post-training)任务;在更长周期、端到端的研究活动(多轮提案-实验-分析闭环)中评估有效性。基于本文成果可延伸的方向:(1)递归自改进闭环——让被 LM2LM 训练出的提案者改进的模型反过来充当 RWM 或提案者骨干,检验正反馈是否稳定或发散,这是论文标题的终极含义;(2)把 on-policy 校准思想推广为通用『世界模型在环 RL』配方,用于任何真实评估昂贵但存在文本记录的领域(芯片设计、生物实验、数据库调优);(3)校准预算分配的优化——将 $B_u$ 次执行视为主动学习问题,用期望信息增益而非预测分数选择执行对象,可能比 top-rated 更省;(4)多提案者/多 RWM 集成,用预测分歧度作为不确定性信号过滤高估提案;(5)机制库的自动扩充——利用 RWM 对库外想法的预测与少量验证执行的对比,自动发现值得加入库的新机制方向。
复现评估
复现门槛较高。数据与代码:论文未给出开源代码链接,8 个模型家族(OLMo-3、Qwen3、NanoChat、Marin、E2D2、E2D2-SW、MDM、BD3LM)的训练环境、40 张机制卡和 builder overlay 机制都需自行搭建;300 条实验记录的收集本身就要约 $23.9k(1,665 B200 GPU 小时)。算力:真实执行累计约 2,758 GPU 小时(M3),RL 训练另需约 1,131 B200 小时(按 1.198 比例从 H200 折算),合计约 $56k,外加持续调用的 GPT-6-sol/GPT-6-astra API 费用;对个人或小团队不现实,中等规模工业实验室可以承受。难度:核心超参数披露完整(DAPO 配置、$\tau_e$ 公式、$\delta=1$、$\lambda=0.3$、$c=6$、校准批次大小等,RWM 与 builder 的完整 prompt 见附录 Table 13/14),方法论层面可复现;主要风险在 API 模型版本漂移和各家族训练管线的工程琐碎度。好消息是核心思想可低成本验证:在 1–2 个小模型家族上用几万美元以内复刻『RWM 奖励 + 2 次校准』的最小版本,检验 top-rated 校准相对随机校准的增益是否依然成立。
论文图表
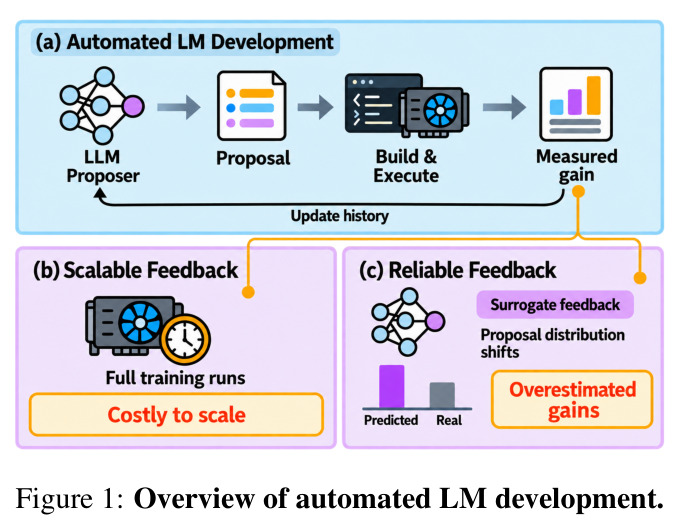
概览图:LLM agent 自动化 LM 开发的闭环——agent 探索架构、优化器与训练配方选择,通过提案-执行-反馈循环产生实验反馈;(b)(c) 部分点出从反馈中学习的两大挑战:真实反馈成本与代理反馈可靠性。
一图定位全文问题域:为什么『会跑实验』不等于『会做研究判断』,以及把实验反馈变成可学习能力时成本与可靠性两个瓶颈从何而来。