Xiaomi-Lens-0:从自身视觉表征解码掩码的多模态大模型技术报告 Xiaomi-Lens-0 Technical Report
4B多模态模型直接从自身视觉表征解码掩码,让掩码监督反哺共享骨干的感知与推理
前置知识
指代表达理解(REC)与指代分割(RES)
REC 要求模型根据一句自然语言描述(如“左边戴红帽子的人”)在图中框出被指代的目标,输出边界框,常用指标为 Prec@0.5(预测框与真值框 IoU≥0.5 的比例);RES 进一步要求输出像素级掩码,指标为 cIoU/gIoU。RefCOCO、RefCOCO+、RefCOCOg 是这两个任务的标准基准,RefCOCO+ 刻意排除了绝对位置词,必须靠外观属性区分目标。
本文的主要结果表(Table 1–3)与 LensBench 全部建立在这两类任务上,核心数字 Prec@0.5 与 cIoU 都来自它们,不了解任务定义就无法解读论文结论。
ViT patch 网格与 spatial merger
Vision Transformer 把图像切成 patch,输出与 patch 一一对应的空间特征网格;其残差结构 $x^l=x^{l-1}+F_l(x^{l-1})$ 让早期层的细粒度信号沿恒等通路累积保留。Qwen 系多模态模型在 patch 特征进入语言模型前,用 $s\times s$ 的 spatial merger 把相邻 patch 特征合并降采样以减少 token 数,但这一步会丢弃高频细节。
本文的关键设计是取 merger 之前的 patch 网格作为掩码解码器的空间输入,理解 merger 前后的差别,才能理解“掩码损失为何能直达共享视觉特征”。
视觉潜变量(visual latent)
在语言模型词表中加入特殊 <|mask|> token,它第 $k$ 次出现位置的上下文隐藏状态 $m_k=h_{t_k}$ 就是一个 visual latent:token 身份相同,但因依赖于图像、指令和前文而表示不同区域。轻量解码器把每个 latent 作为查询向量,与 patch 特征做点积打分后解码出该区域的掩码。
这是全文的核心机制:它既是掩码预测的查询,也是“thinking with visual latents”——在思维链中用视觉潜变量标记每个所谈区域的载体。
BCE 与 Dice 损失
二元交叉熵(BCE)逐像素监督前景/背景分类;Dice 损失直接优化预测集合与真值集合的重叠率 $2|P\cap G|/(|P|+|G|)$,对前景像素极少的不平衡情况更稳健。二者加权组合是分割训练的标准配置,分别约束像素归属与区域整体形状。
本文的 $\mathcal{L}_{mask}$ 正是这两项的加权和,掩码监督带来的全部收益(定位、感知提升)都经由这个损失反传进共享骨干。
cIoU 与 gIoU
gIoU 是每对预测/真值掩码 IoU 的算术平均,每张图权重相同;cIoU 把整个数据集的像素交集与并集分别累加后再相除,因此大目标权重更高。消融和分析时常把两者一起报告,以免单一指标掩盖尺寸偏差。
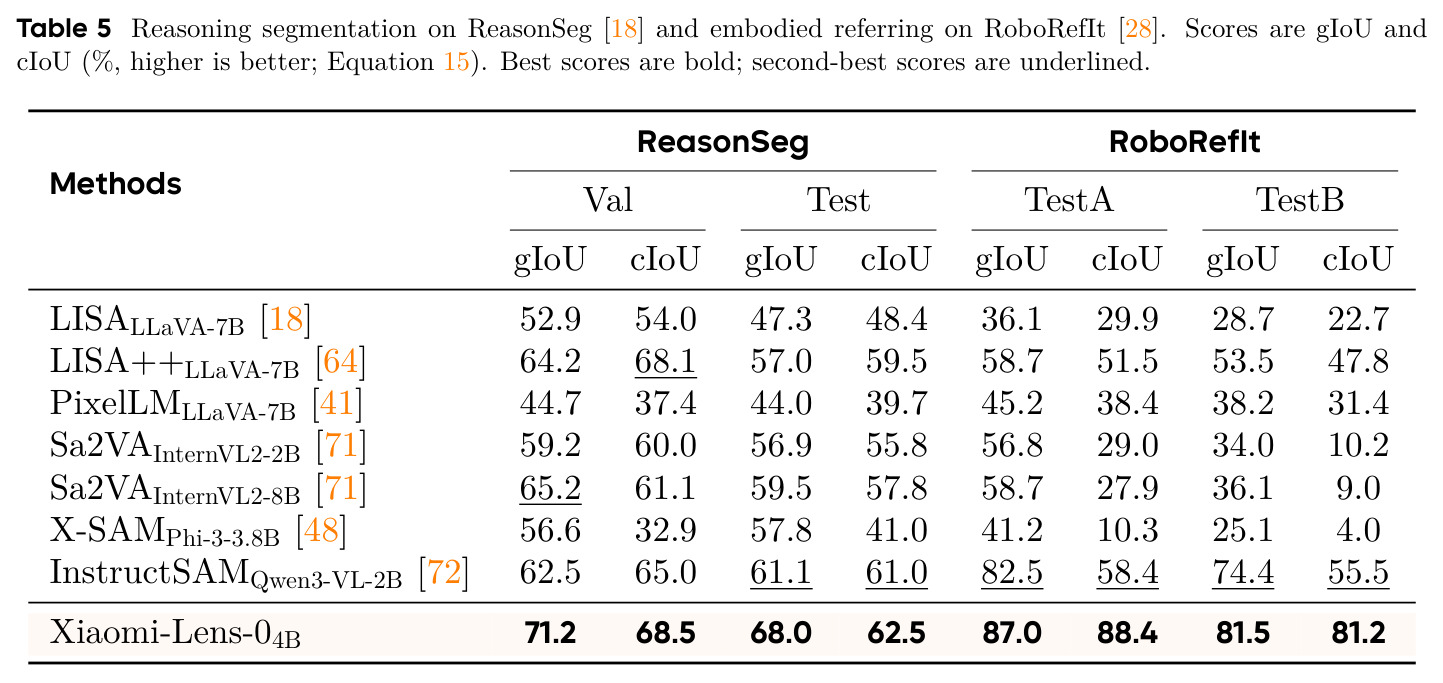
RES、ReasonSeg、RoboRefIt 与 LensBench 的掩码成绩都以这两个数报告,例如本文在 ReasonSeg 上 gIoU 领先 6.9 而 cIoU 只领先 1.5,不懂定义就会误读优势大小。
SAM 3 与分割基础模型
SAM(Segment Anything Model)系列是可通过点、框或文本提示对任意物体输出高质量掩码的通用分割模型,SAM 3 是其最新版本。它不依赖语言模型,专精于“给定提示→输出掩码”,通常作为独立分割分支或数据标注工具使用。
本文的数据管线用 SAM 3 为推理轨迹中的每个区域引用补齐掩码标注(以紧致框 IoU 阈值验收),LensBench 和 RES 实验也把它作为对比基线(本文超出其 7.0–12.9 cIoU)。
研究动机
当前多模态大模型回答整图问题已经很强,但在细粒度区域理解上仍频繁出错:数错紧挨着的物体、认错小区域的属性。本文把根源归结为纯文本监督——图像只是条件输入,训练信号完全来自文本答案,从未指明究竟是哪些图像区域支撑了答案、这些区域的范围有多大。虽然 LISA、Sa2VA 等模型已引入掩码训练,但空间细节大多来自额外编码器:LISA 和 Sa2VA 依赖层级式分割编码器,Qwen3-VL-Seg 用补充图像编码器做多尺度融合,这使得 MLLM 自身的视觉表征并不被要求编码掩码损失所监督的区域细节。另一条线(PixelLM、MLLMSeg)虽然从自身视觉编码器特征解码掩码,但视觉编码器被冻结,掩码损失无法回传塑造共享特征。此外,这两条线都把掩码监督当作完成分割任务的手段,只在 RES 和定位任务上评估;掩码监督能否同时改善细粒度感知与视觉推理,始终没有被系统检验过。
本文的目标是本文的目标是构建 Xiaomi-Lens-0——一个基于 Qwen3.5 的 4B 多模态大模型,在不引入任何额外层级视觉编码器或多尺度特征融合的前提下,直接从自身的视觉表征预测区域掩码,让像素级掩码监督直接作用于与语言生成共享的骨干特征。具体分解为四点:其一,从视觉编码器 spatial merger 之前的 patch 网格解码掩码,为掩码损失提供直达共享特征的路径;其二,把掩码解码器同时用作 visual latent 解码器,让模型在思维链中交错插入区域潜变量(thinking with visual latents),并构造 grounded reasoning traces 把像素监督扩展到推理的中间区域;其三,在八个感知基准上检验掩码监督能否惠及纯文本输出的任务;其四,构建覆盖一般/航拍/驾驶/全景四种视觉域、显式/隐式指令、单/多目标的 LensBench,补足现有指代基准的评测空白。
与已有工作不同的是,本文的独特切入是把“掩码从哪里来”反转成“监督到哪里去”。先前工作把掩码视为分割任务的输出,用额外的分割编码器或冻结特征提供空间细节,掩码只是下游产物;本文反过来要求共享视觉表征自己承担区域范围的编码,使掩码损失成为改进感知表征的训练信号,分割反而成了副产品。方法上,它把 LISA 式特殊 token 从“仅查询最终目标”推广为语言模型上下文状态构成的 visual latent,可在思维链中反复出现,每个中间区域引用都被解码成可检查的掩码。评估上,它是首个通过 BBox-only 对照实验严格归因、系统验证“共享表征上的掩码监督能提升细粒度感知”的工作(掩码监督在 RefCOCO+ 上额外贡献 2.4 点 REC、感知基准上再贡献 0.2–1.4 点),并以全人工复核的 LensBench 补上指令语义与视觉域两个维度的评测空白。
核心方法
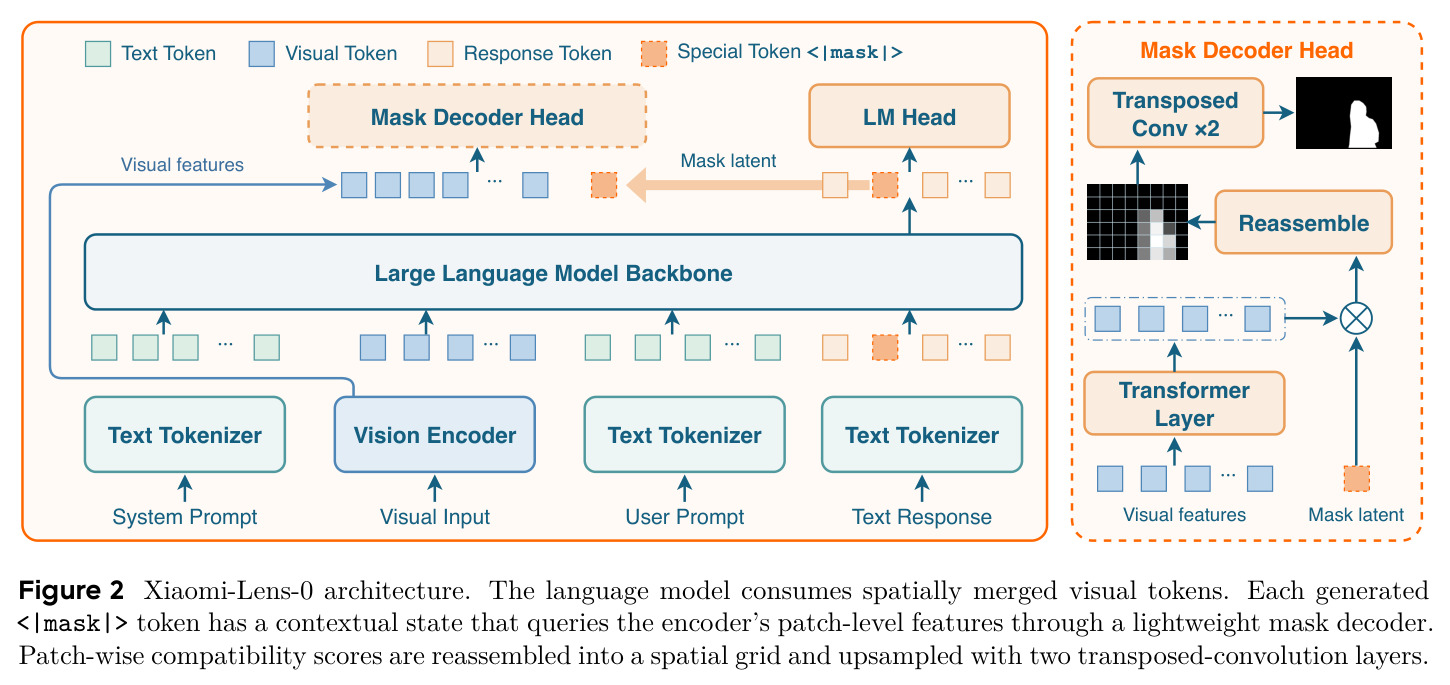
直觉上,模型数错物体、认错小区域,是因为其内部表征从未被迫携带“区域范围”这一像素级概念;让模型自己输出掩码并按像素打分,梯度会迫使它用于感知和语言生成的视觉特征编码目标的确切范围。技术路线分四步。(1) 共享特征:图像 $I$ 经视觉编码器得 patch 网格 $V_0\in\mathbb{R}^{N_p\times d_v}$($N_p=h_v w_v$),再经 $s\times s$ spatial merger 与投影 $\phi$ 得合并 token $V$ 供语言模型使用。(2) 视觉潜变量:词表加入特殊 <|mask|> token,第 $k$ 次出现处的上下文状态 $m_k=h_{t_k}$ 即为 visual latent,代表当前指令请求或前文引用的区域。(3) 掩码解码:一层 Transformer 精炼 $V_0$ 后线性投影得 $F=P_v\,\mathrm{T}_{mask}(V_0)$;查询 $q_k=P_m(m_k)$ 逐 patch 打分 $z_{k,p}=q_k^\top f_p/\sqrt{d_m}$,重排为网格后经两层转置卷积上采样并取 sigmoid 得 $\hat{M}_k\in[0,1]^{H\times W}$;$F$ 每图只算一次、所有 latent 复用。(4) 联合目标 $\mathcal{L}=\mathcal{L}_{ntp}+\mathcal{L}_{mask}$,$\mathcal{L}_{mask}$ 为 BCE 与 Dice 的加权和,掩码梯度经 $F$ 更新视觉编码器、经 $m_k$ 更新语言模型。
核心创新有二。第一是“掩码监督直达共享骨干”:只用 merger 前的单尺度 patch 网格,既不加层级分割编码器(LISA、Sa2VA),也不加补充编码器与多尺度融合(Qwen3-VL-Seg),且联合训练让 $\mathcal{L}_{mask}$ 同时更新视觉编码器与语言模型——这与冻结编码器的 PixelLM/MLLMSeg 有本质区别。可行性来自残差结构:$x^L=x^0+\sum_l F_l(x^{l-1})$ 的恒等通路使早期细粒度信号不被高层语义覆写,merger 前的网格保有对原图的高互信息通路(作者引 LongCat-Next 的 intrinsic information recovery:随机初始化的 ViT 甚至比预训练版更易重建粗结构,说明可恢复性源自网络结构而非语义)。第二是 thinking with visual latents:解码器同时是 visual latent 解码器,响应中文本与 <|mask|> 交错出现,计数可为每个实例分配一个潜变量,空间比较可为被比较对象各分配一个;推理时掩码是旁路输出分支,不回喂任何裁剪或区域特征。配套的 grounded reasoning traces 用 $\mathcal{L}_{ntp}$ 监督推理文本与答案、用 $\mathcal{L}_{mask}$ 监督每个中间区域的范围,把像素监督从最终目标扩展到思维链沿途访问的区域。
方法步骤详情
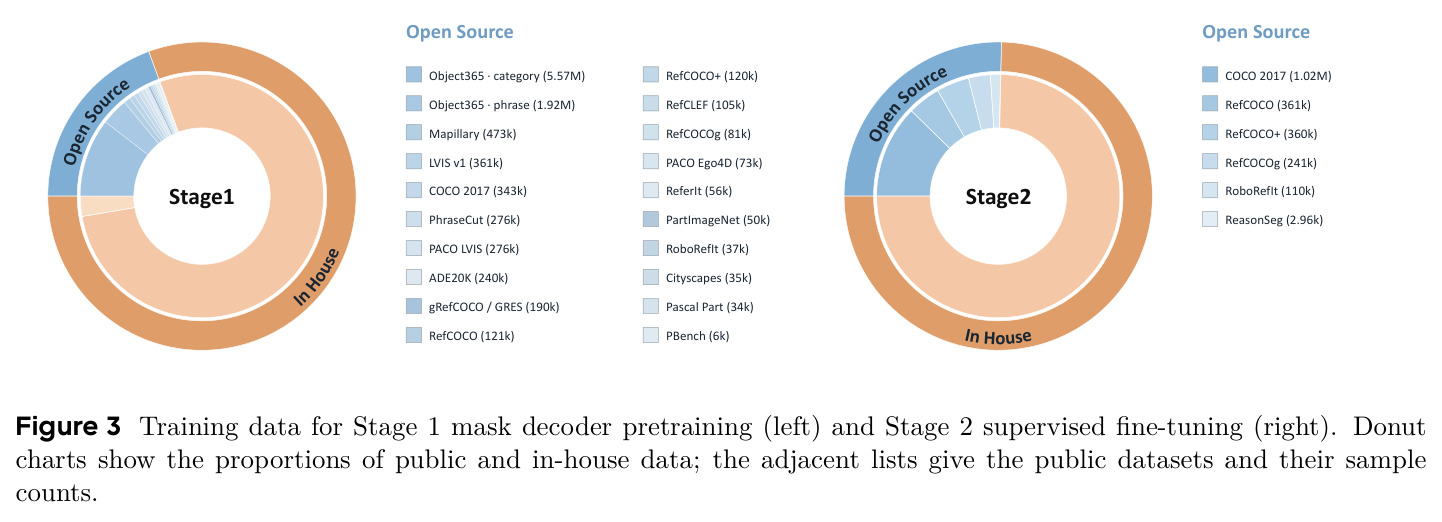
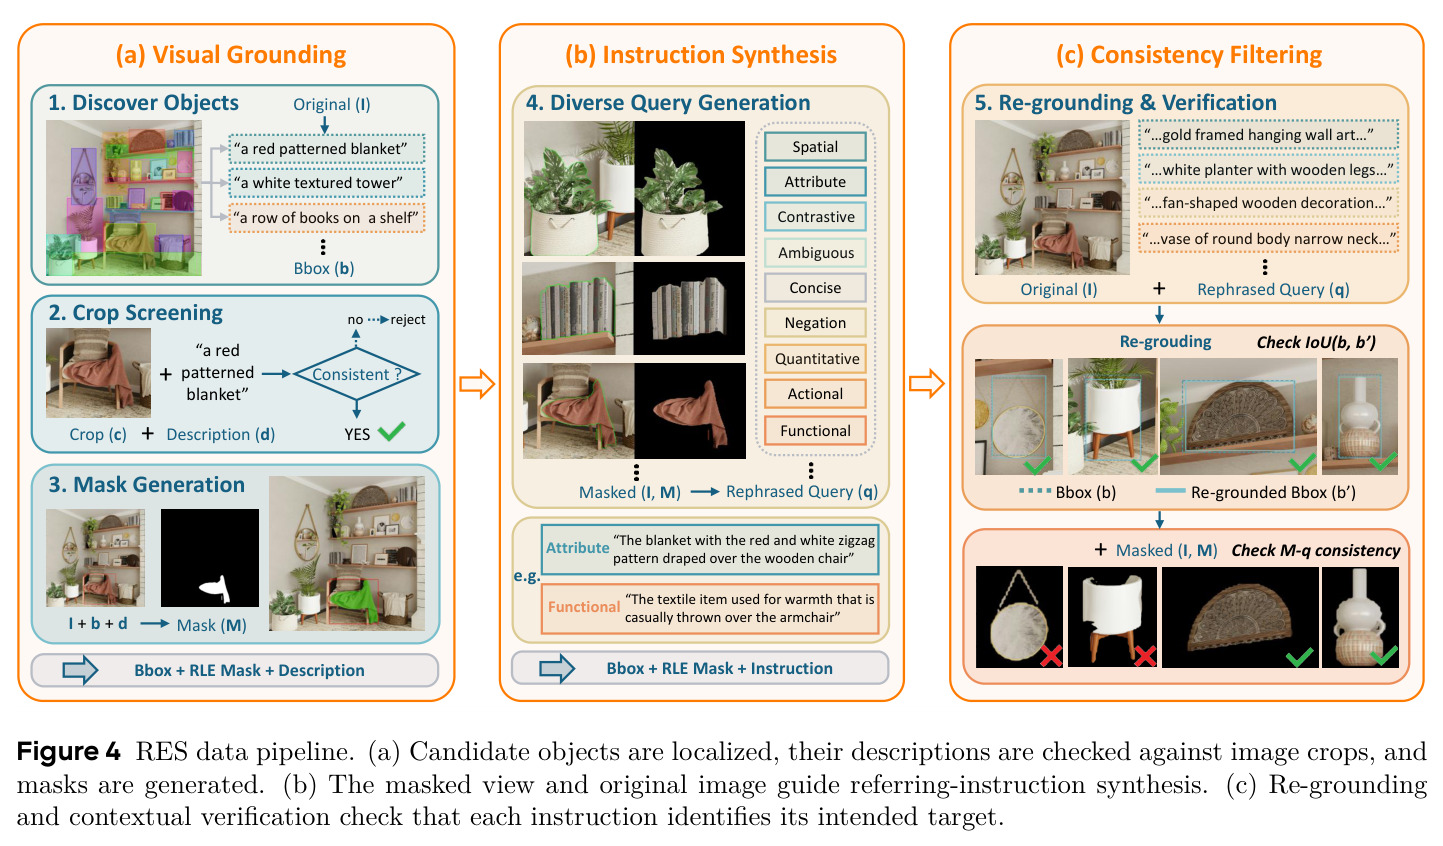
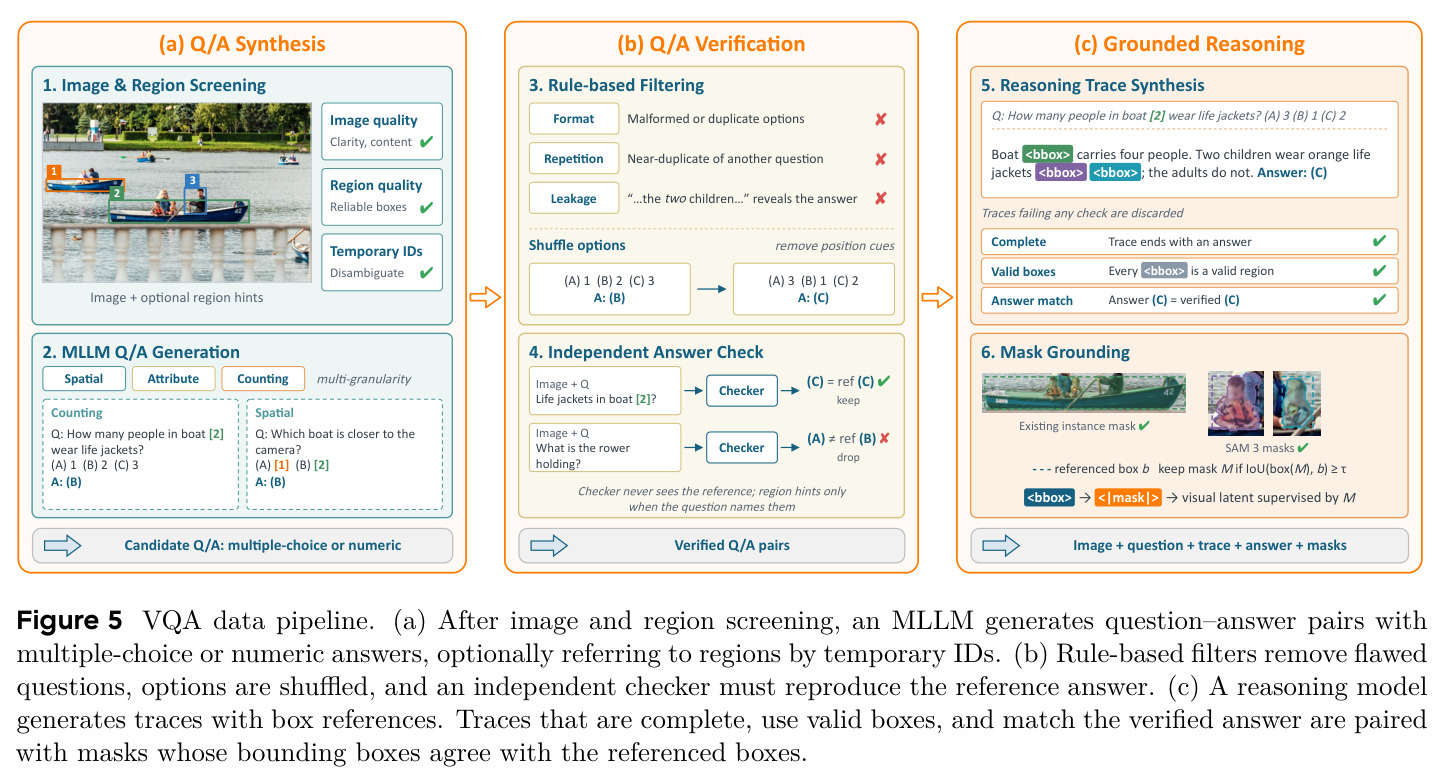
训练分两阶段。Stage 1(解码器预训练):冻结骨干,仅用 $\mathcal{L}_{mask}$ 优化解码器,数据为自建数据加 Objects365、LVIS、PACO、PhraseCut、RefCOCO/+、RefCOCOg。Stage 2(监督微调):解冻骨干,用 $\mathcal{L}=\mathcal{L}_{ntp}+\mathcal{L}_{mask}$ 联合优化,数据含自建指代与推理数据及 COCO 2017、RefCOCO/+、RefCOCOg、RoboRefIt、ReasonSeg。数据管线三部分。(a) 指代表达数据:物体发现给出框 $b_i$ 与描述 $d_i$,crop 级检查 $V_{crop}$ 淘汰不一致候选后生成掩码 $M_i$;用掩码视图 $\tilde{I}_i=I\odot M_i$(背景置黑)加原图合成多样化指令(空间、属性、对比、否定、数量、功能等);重定位 $R(I,q)$ 须恰好返回一框且 $\mathrm{IoU}(b_i,b'_{ij})\ge\tau$ 并通过语义检查 $V_{ref}$,保留 $(I,q,\mathrm{box}(M),M)$。(b) 推理数据:MLLM 生成计数/属性/空间关系的多选或数值 QA,规则过滤并洗牌选项后由独立 checker 盲答复现才保留;推理模型生成带 引用的 trace,取最短通过者;每个引用配既有实例掩码或 SAM 3 掩码(紧致框 IoU 达标才接受),并在引用后附加 <|mask|>。(c) LensBench:四域各 300 单元,每单元 1 图、2 个目标掩码、4 条指令(单/多目标 × 显式/隐式),共 1200 单元 4800 样本,全部经人工复核。
技术新颖性
与最近邻工作的本质差异:LISA 系的 [SEG] token 只查询 SAM 分割分支,骨干本身不接触掩码损失;PixelLM/MLLMSeg 虽从自身编码器特征解码掩码但将其冻结,掩码监督无法塑造共享表征;Qwen3-VL-Seg 依赖补充编码器的多尺度融合与迭代精化;UniPixel 有中间掩码指针但未做共享表征的归因分析;Mirage/LVR 在视觉 latent 空间推理却不落地为可检查的掩码。本文的贡献是把三个要素组合并系统化:(1) 证明单尺度 pre-merger 网格足以取得 SOTA 掩码(RES 八折 cIoU 全部第一,均值 81.4),挑战了“必须层级/多尺度特征”的默认假设;(2) 把掩码损失当作表征学习信号而非任务输出,用同数据关闭掩码损失的 BBox-only 对照严格归因,显示其在需要外观消歧的 RefCOCO+ 上额外贡献 2.4 点 REC;(3) 以 visual latent 把像素监督延展到 CoT 中间区域,形成推理过程可检查的新接口,且推理开销极小(解码器仅一层 Transformer 加两层转置卷积,$F$ 每图只算一次)。三者互为支撑:共享监督保证 latent 有信息量,latent 机制让监督有处可施。
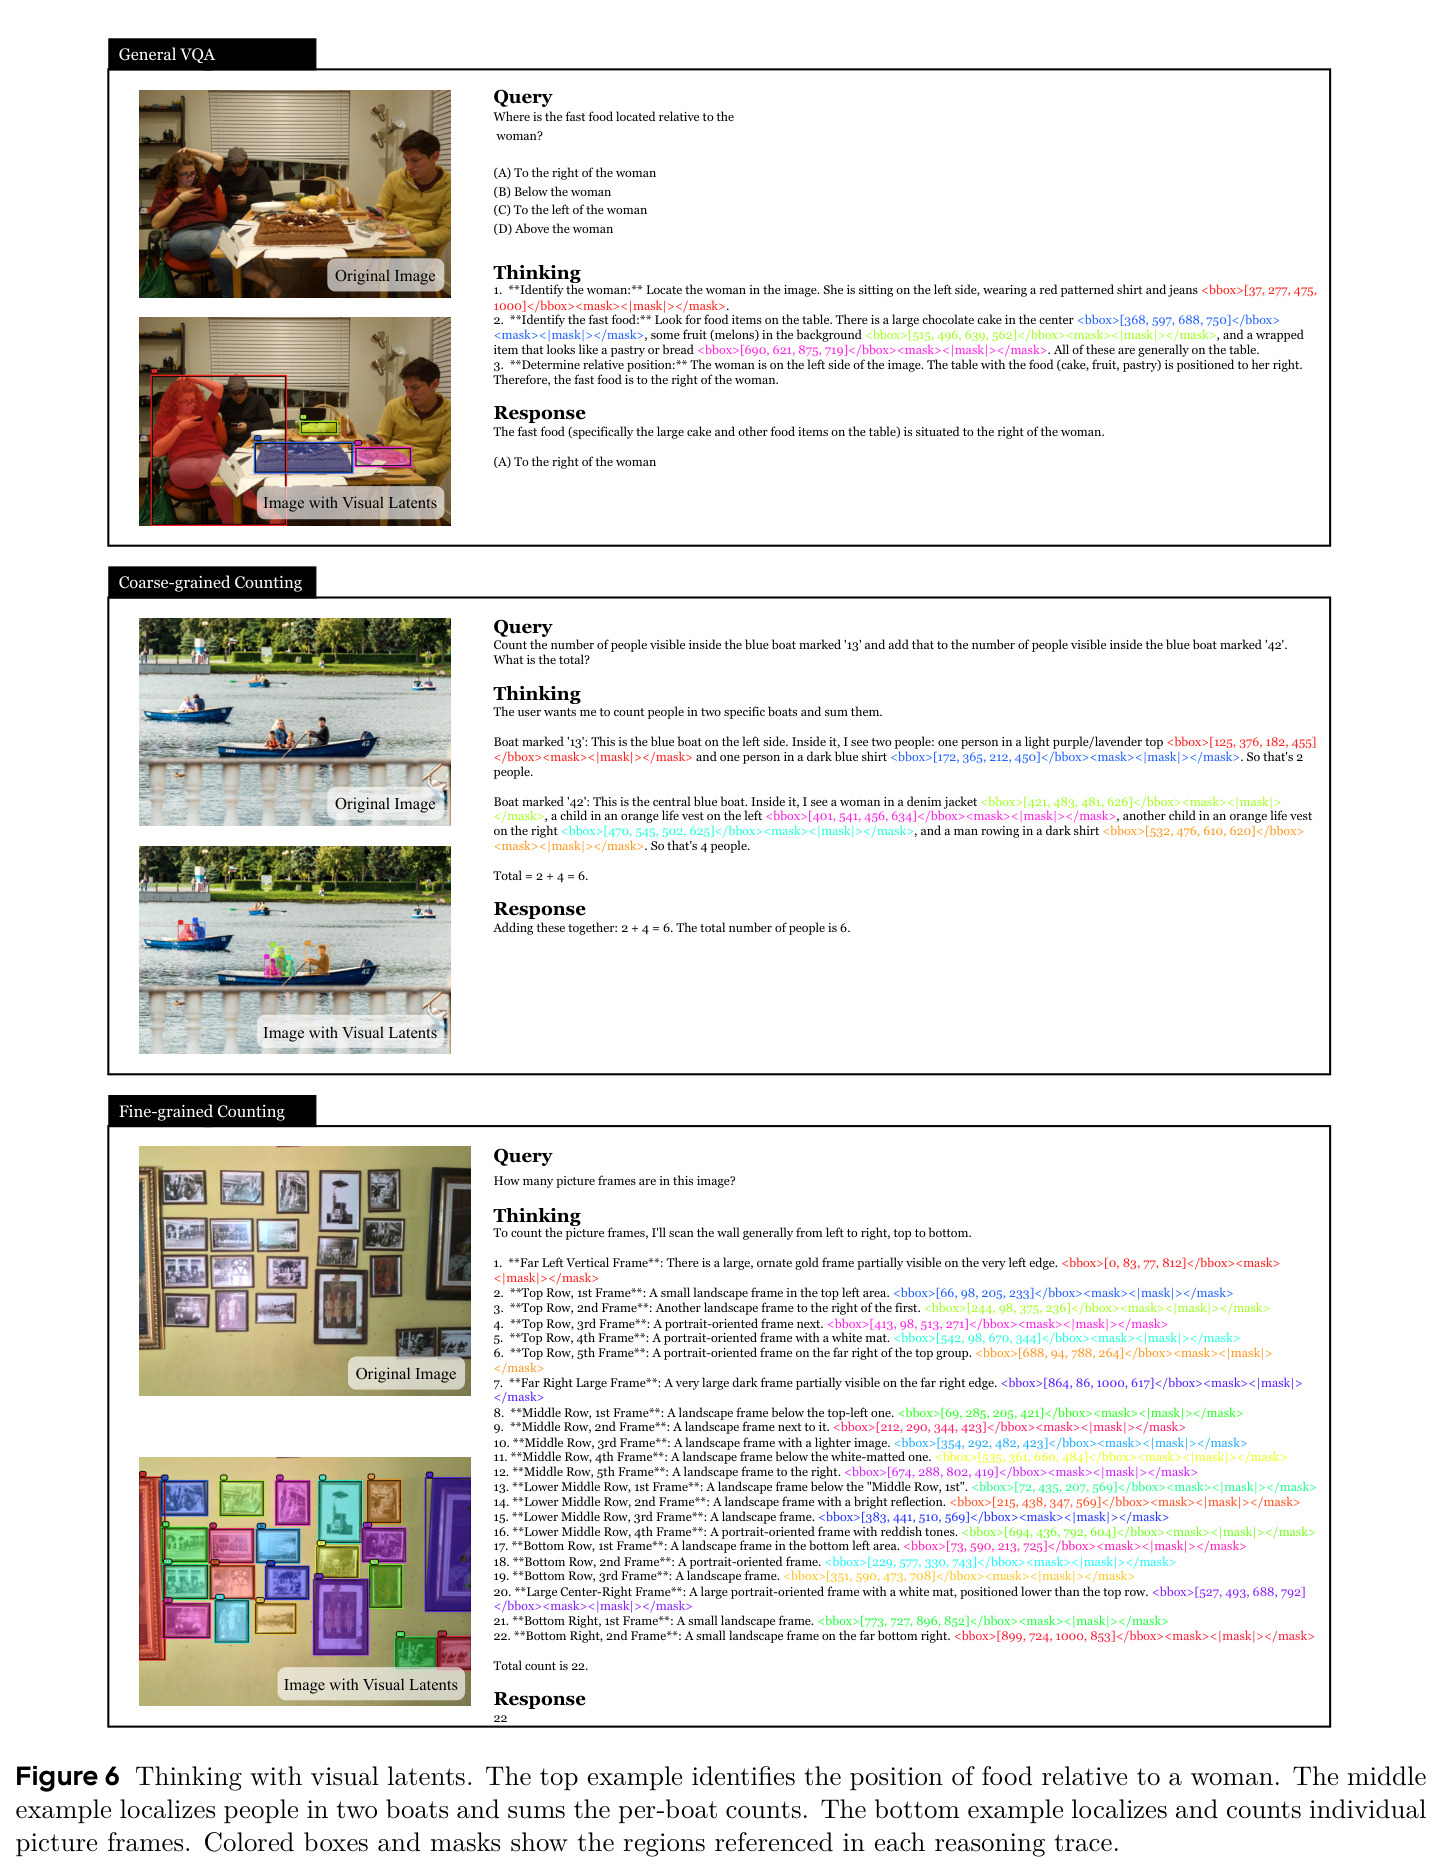
实验结果
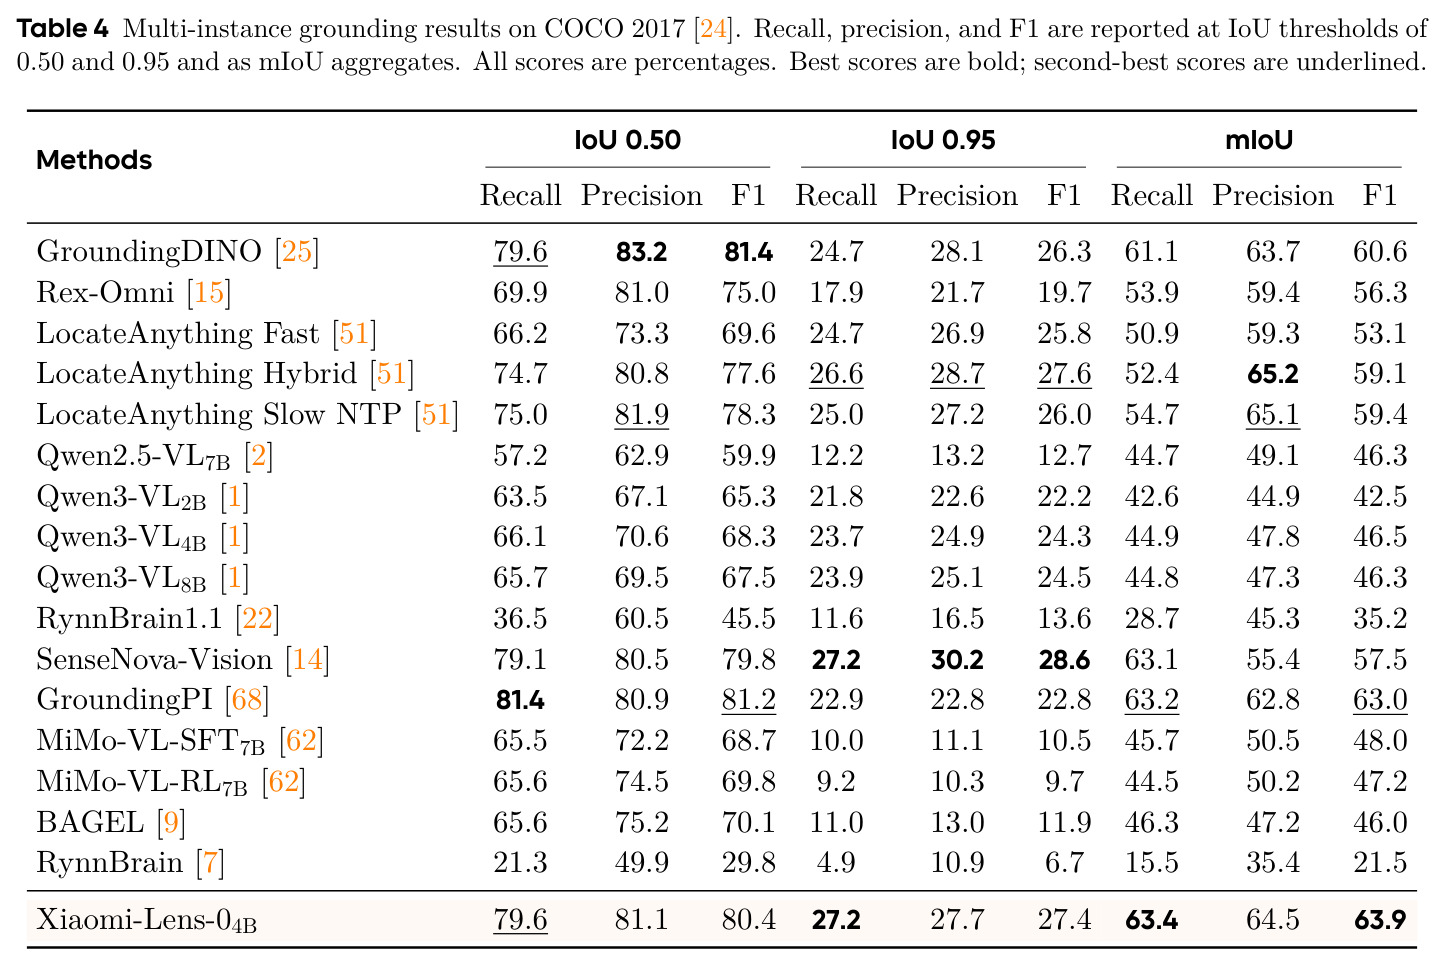
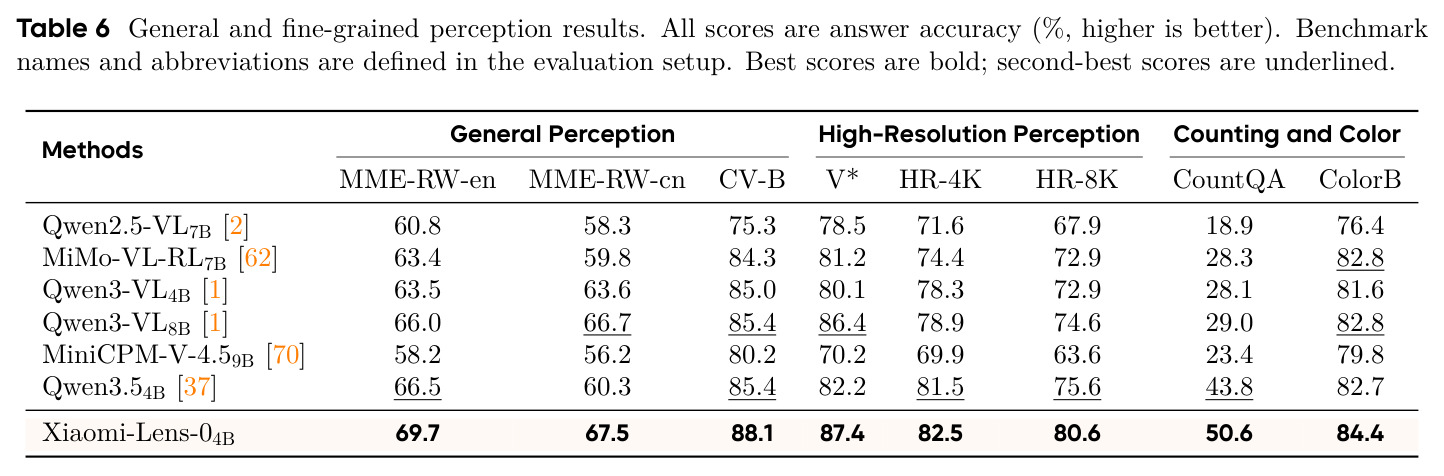
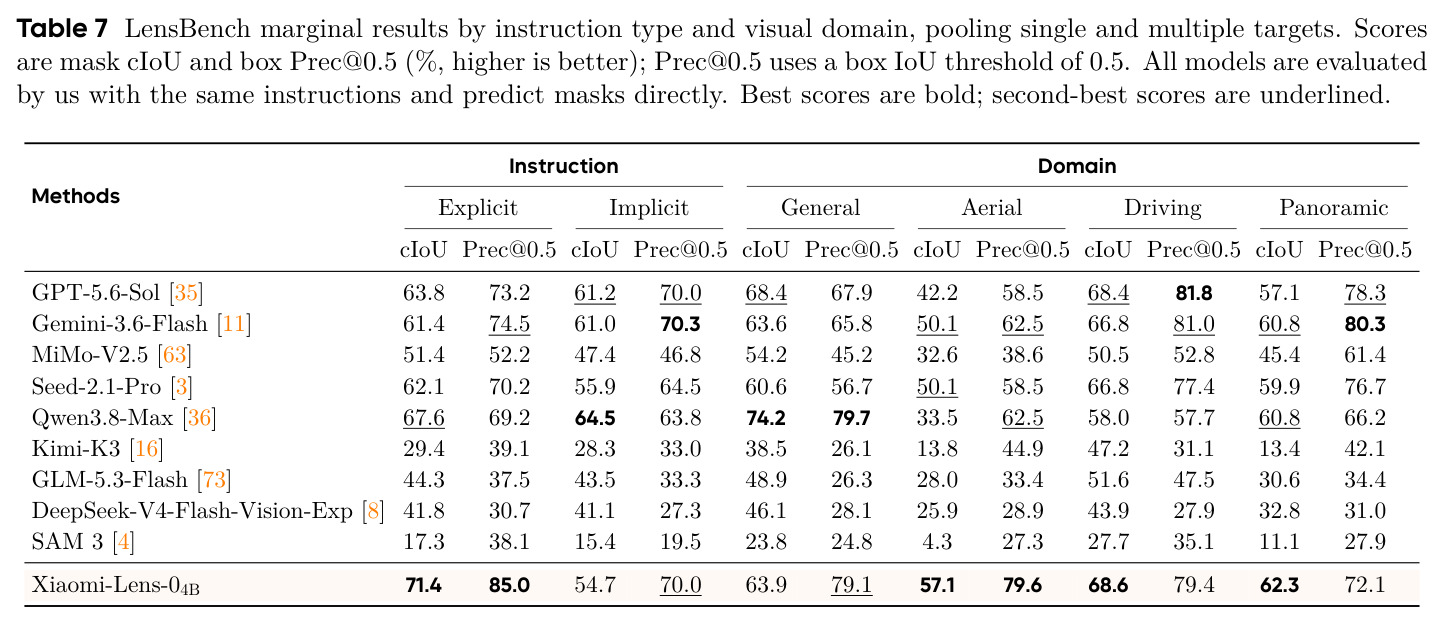
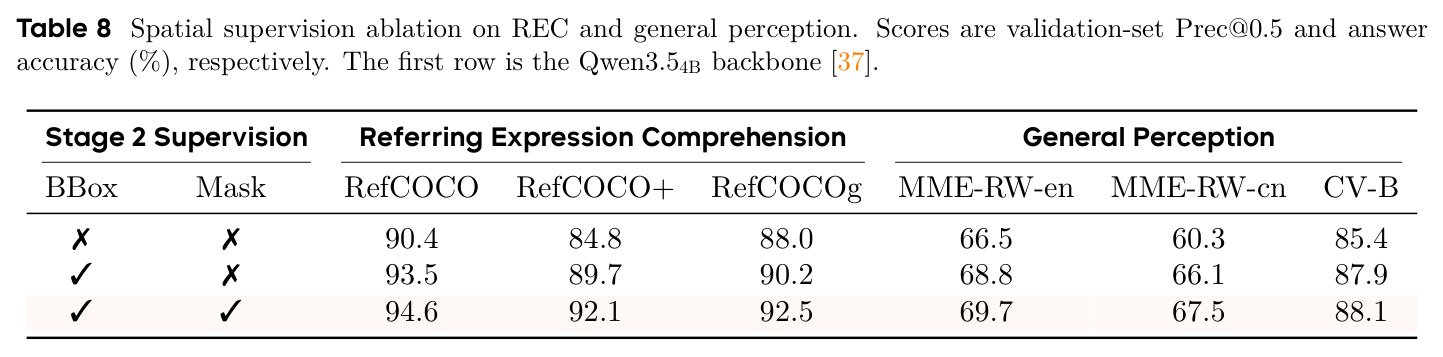
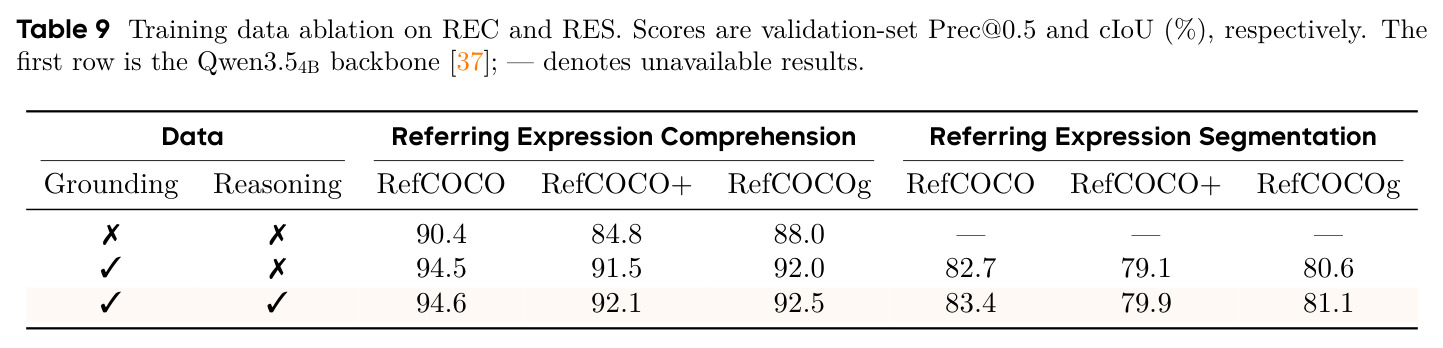
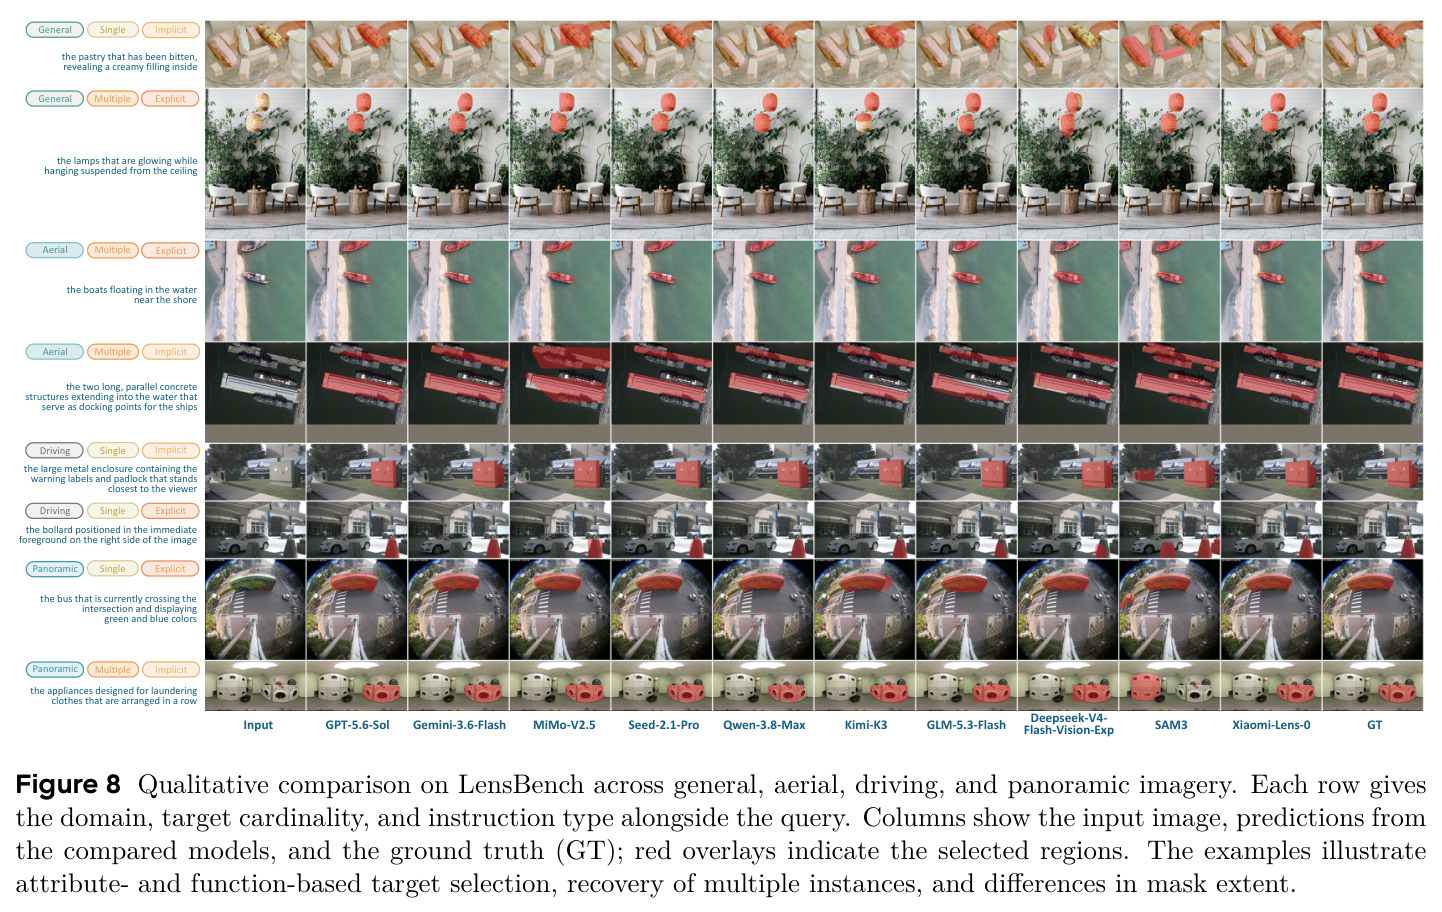
全文实验回答三个问题,结果如下。空间预测上,REC(Table 1)八折全部超过 Qwen3.5 骨干,平均 +5.6 点:RefCOCO val/TestA/TestB 达 94.6/96.2/92.3,RefCOCO+ 达 92.1/94.9/88.5,RefCOCOg 达 92.5/92.4;七折第一,RefCOCOg test 以 0.5 点之差居 Youtu-VL 之后;由于 RefCOCO+ 排除绝对位置词、必须靠外观消歧,其增益也最大(平均 +7.6,TestB +9.4)。更严格的阈值下(Table 2),F1@mIoU 达 83.3/81.1/81.1 全部第一,超骨干 8.8/11.6/9.5 点,IoU=0.95 时骨干相对增益高达 15.5–16.8 点,说明提升同时覆盖目标选择与精确框放置。RES(Table 3)八折 cIoU 全部第一,均值 81.4 对 Qwen3-VL-Seg 的 78.6,超过专用分割模型 SAM 3 达 7.0–12.9 点,验证了单尺度共享网格足以替代额外分割编码器。多实例定位(Table 4)在 COCO 2017 上 F1@mIoU 63.9 第一(超 GroundingPI 0.9、GroundingDINO 3.3),IoU=0.95 时 F1 27.4 反超两者(+4.6/+1.1),说明优势来自更紧的框而非找回更多实例。推理分割与具身(Table 5):ReasonSeg test 达 68.0 gIoU/62.5 cIoU,超 InstructSAM 6.9/1.5 点;RoboRefIt TestA/TestB gIoU 87.0/81.5、cIoU 88.4/81.2,cIoU 领先高达约 30 点。细粒度感知(Table 6)是本文最独特的证据:八个纯文本基准全部第一且超骨干——CountQA 43.8→50.6(+6.8)、MME-RW-cn +7.2 至 67.5、V* +5.2 至 87.4、HR-8K +5.0 至 80.6,高分辨率三项全部超过 8B 的 Qwen3-VL,说明掩码监督确实改善了共享视觉表征。LensBench(Table 7):aerial/driving/panoramic 三域 cIoU 第一(57.1/68.6/62.3,领先 7.0/0.2/1.5),general 域落后 Qwen3.8-Max(63.9 对 74.2);隐式指令 cIoU 54.7 仅列第五,全景多目标隐式的 Prec@0.5 从显式的 81.3 跌至 48.7,点明剩余短板。消融(Table 8/9)完成归因:BBox-only 已带来 REC +3.1/+4.9/+2.2 与感知 +2.3/+5.8/+2.5,掩码监督再各加 1.1–2.4 与 0.2–1.4 点;grounded reasoning 数据再增 REC 0.1–0.6、RES 0.5–0.8 点,且收益集中在掩码质量——基础指代数据贡献了绝大部分增益。
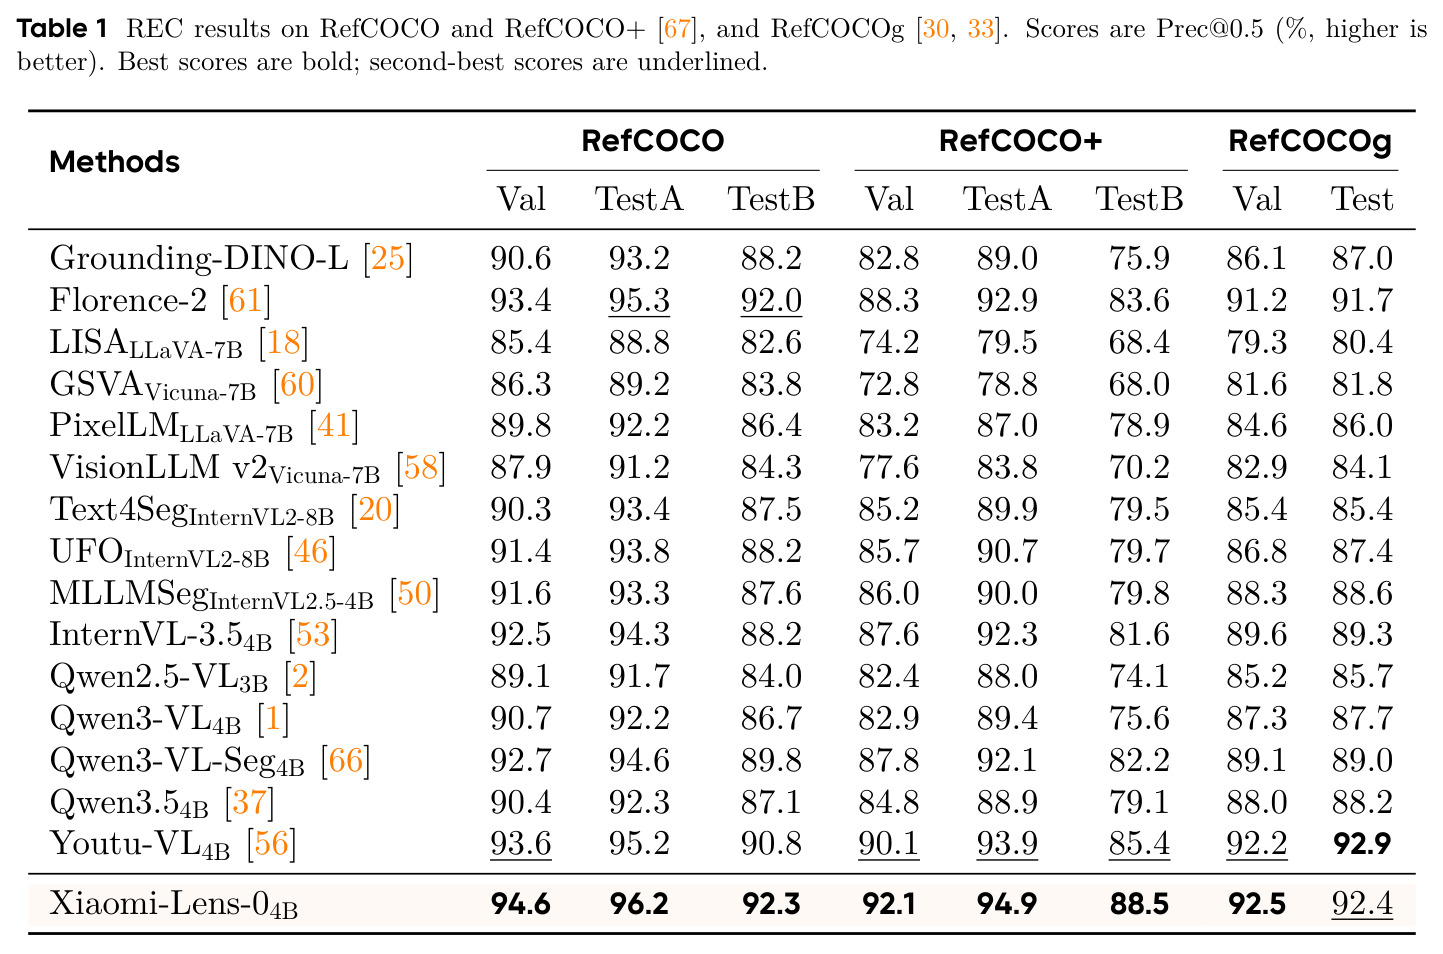
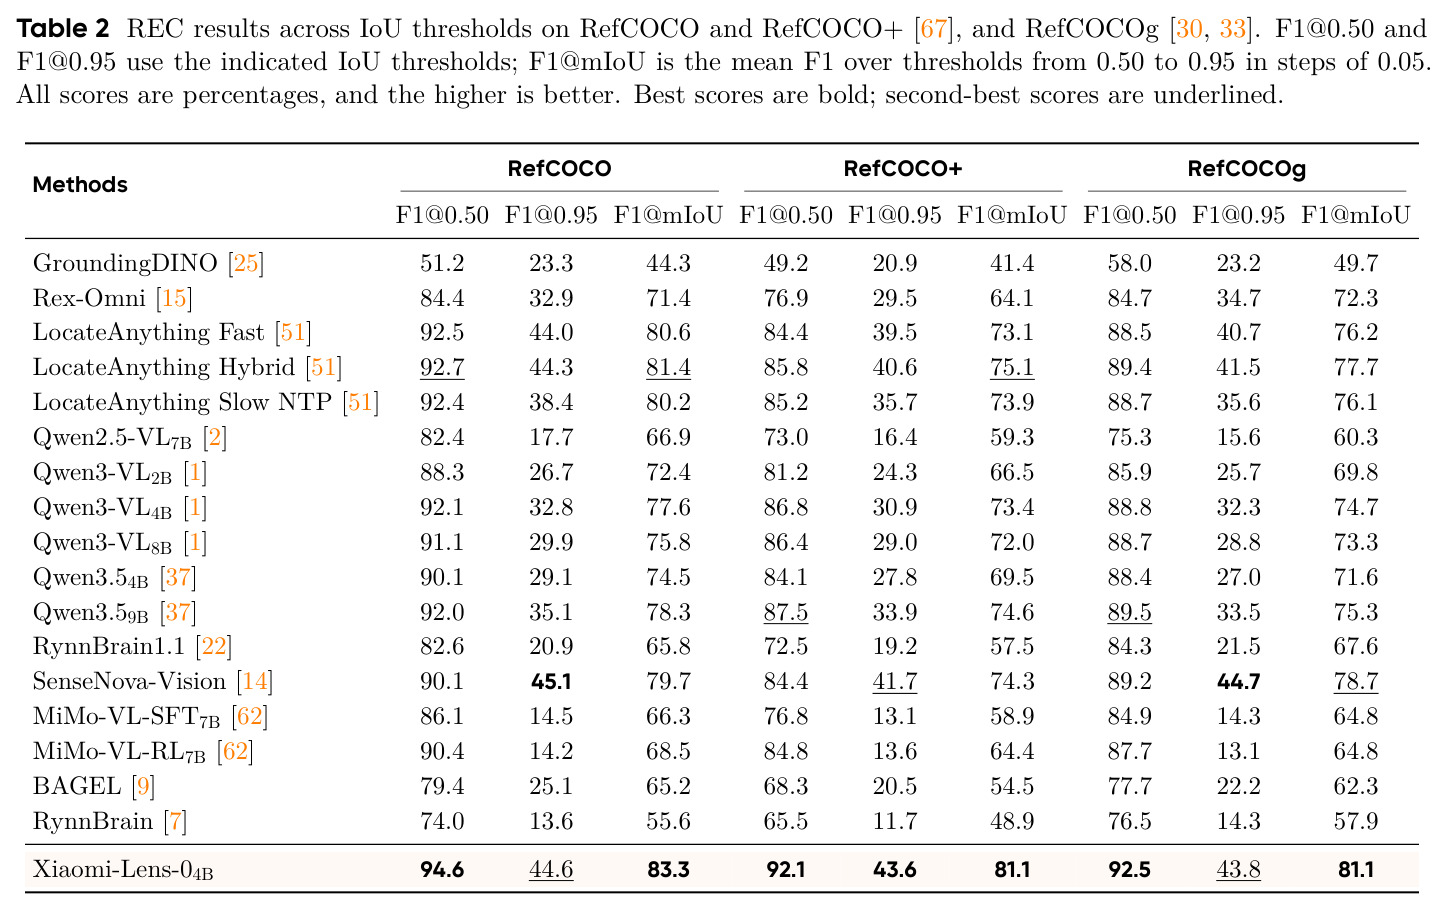
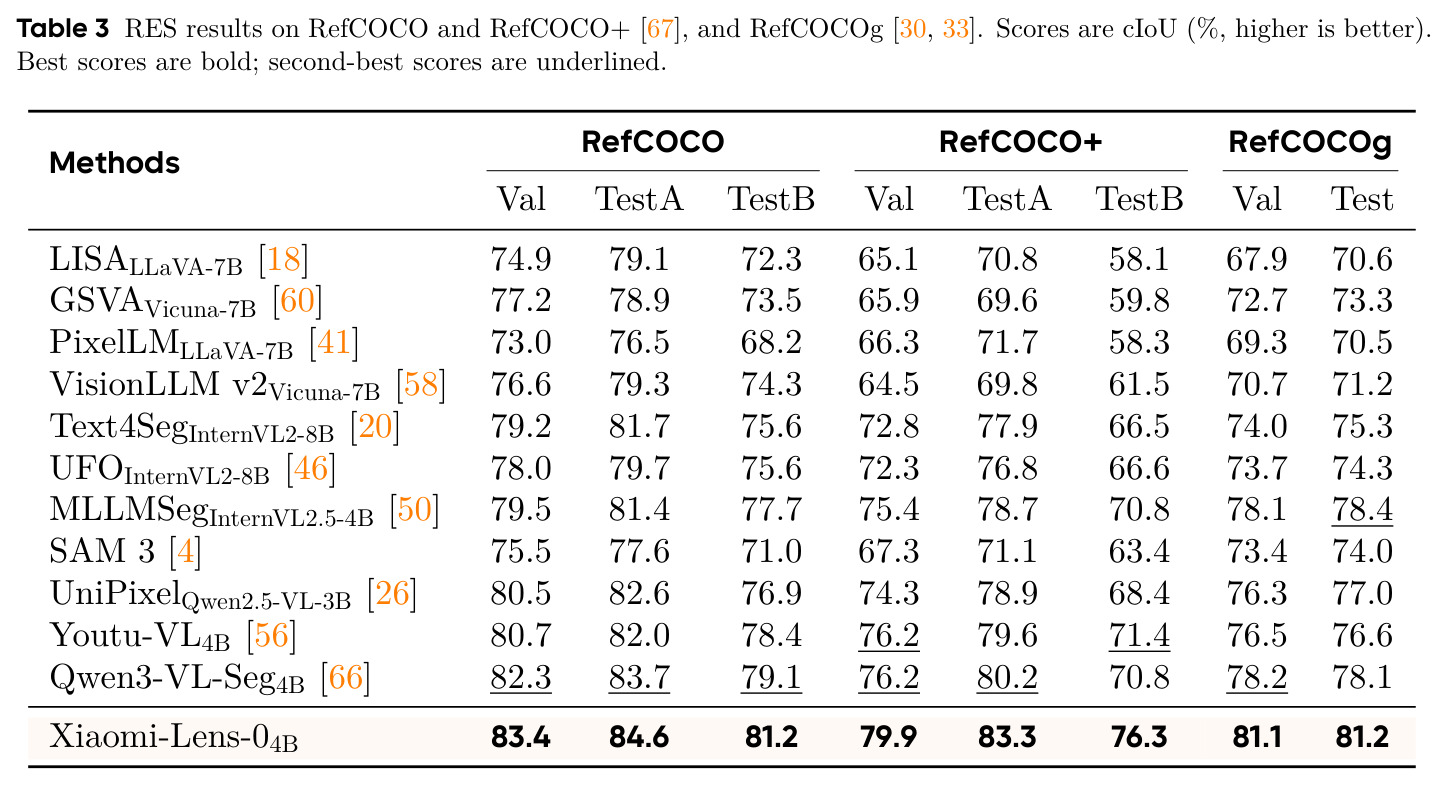
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 指代表达理解 REC(RefCOCO/+/g 八折) | Prec@0.5 | RefCOCO 94.6/96.2/92.3,RefCOCO+ 92.1/94.9/88.5,RefCOCOg 92.5/92.4,七折第一 | Qwen3.5-4B 骨干(如 RefCOCO val 90.4);最强基线 Youtu-VL-4B | 超骨干平均 +5.6(RefCOCO+ TestB 达 +9.4);超 Youtu-VL 在 RefCOCO+ 三折 +2.0/+1.0/+3.1 |
| REC 严格阈值(RefCOCO) | F1@mIoU(0.50–0.95 步长 0.05) | 83.3(F1@0.95 达 44.6) | Qwen3.5-4B 74.5(F1@0.95 29.1) | +8.8(IoU=0.95 时骨干相对增益 15.5–16.8 点) |
| 指代分割 RES(八折平均) | cIoU | 81.4,八折全部第一(RefCOCO val 83.4) | Qwen3-VL-Seg-4B 平均 78.6;SAM 3 最低 71.0 | +2.8(各折对最强对手领先 0.9–4.9;对 SAM 3 领先 7.0–12.9) |
| COCO 2017 多实例定位 | F1@mIoU | 63.9(IoU=0.95 时 F1 27.4) | GroundingPI 63.0;GroundingDINO 60.6 | +0.9 / +3.3;IoU=0.95 时 +4.6 / +1.1 |
| 推理分割 ReasonSeg(test) | gIoU / cIoU | 68.0 / 62.5 | InstructSAM 61.1 / 61.0 | +6.9 / +1.5 |
| 具身指代 RoboRefIt(TestA) | gIoU / cIoU | 87.0 / 88.4 | InstructSAM 82.5 / 58.4 | +4.5 / +30.0 |
| 细粒度感知(8 个基准) | 答案准确率 | CountQA 50.6、MME-RW-en 69.7、MME-RW-cn 67.5、CV-B 88.1、V* 87.4、HR-4K 82.5、HR-8K 80.6、ColorB 84.4,全部第一 | Qwen3.5-4B 骨干(CountQA 43.8、MME-RW-cn 60.3、V* 82.2) | 对骨干 +6.8 / +3.2 / +7.2 / +2.7 / +5.2 / +1.0 / +5.0 / +1.7 |
| LensBench(航拍域) | cIoU / box Prec@0.5 | 57.1 / 79.6 | 最强基线 50.1(Gemini-3.6-Flash 等)/ 62.5 | +7.0 / +17.1,为四个域中优势最大者 |
局限与改进
作者承认的局限集中在 LensBench 上:隐式指令仍明显偏难,隐式 cIoU 仅 54.7、排第五(落后 Qwen3.8-Max 的 64.5、GPT-5.6-Sol 的 61.2 等);一般域 cIoU 63.9 落后 Qwen3.8-Max 的 74.2;最差的组合是全景影像+多目标+隐式指令,box Prec@0.5 从显式的 81.3 跌到 48.7、cIoU 从 71.8 跌到 48.9。我自己的观察还有几点:其一,grounded reasoning traces 的边际收益很小(REC 仅 +0.1–0.6),说明“中间掩码监督”的价值可能被摘要式宣传略微高估,主要增益其实来自基础指代数据;其二,推理时掩码是开环旁路,解码出的掩码若暴露选错区域,也无法反馈修正后续推理;其三,计数靠逐一枚举实例,22 个相框的例子要生成 22 组框和掩码 token,长 trace 消耗大量生成预算(上限 16,384 token);其四,单尺度 pre-merger 网格受 ViT patch 分辨率限制,极小目标仍依赖骨干本身的高分辨率能力;其五,LensBench 为自建自评基准,构建管线的自动筛查与人工复核虽严格,但仍带自偏置风险;其六,报告未给出训练算力、超参数与成本细节。
独立分析的弱点
第一,开环 latent 设计:解码掩码只是输出分支,不参与后续计算,若某步掩码显示模型选错了区域(如把旁边物体圈进来),推理无法自我纠正。改进方向是把掩码 latent 或其池化特征回喂语言模型(如 Q-Former 式压缩或区域特征裁剪),形成闭环的 visual search。第二,隐式多目标选择弱:全景域多目标隐式 Prec@0.5 仅 48.7,功能/常识描述选出多个实例时目标集合经常缺失或多余。改进方向是在数据管线中扩充“功能—实例集合”对齐的隐式多目标样本,或用目标集合 IoU 作为可验证奖励做强化学习。第三,解码器容量极小(一层 Transformer + 两层转置卷积):掩码边界受 patch 分辨率与上采样方式限制,转置卷积易产生粗糙边界。改进方向是融合浅层高分辨率特征或引入迭代掩码精化。第四,逐实例枚举式计数代价高且易在长 trace 中漂移,可学习分组计数或 latent 复用机制。第五,感知收益均在多选/短答基准上测得,掩码监督在开放式问答、真实机器人任务上的迁移尚未验证;此外感知提升幅度(+0.2–1.4 来自掩码)远小于指代任务,说明“掩码改进通用感知”的叙事需要更谨慎的表述。
未来方向
作者明确指出的方向是攻克隐式指令理解,尤其是全景影像中多目标的隐式选择,这是 LensBench 数据揭示的最大短板。基于其成果可自然延伸的方向包括:(1) 闭环推理——把解码掩码作为下一步输入,与 o3 式裁剪/缩放工具结合,latent 提供全局定位、裁剪提供高分辨率细节,两者互补;(2) 视频扩展——visual latent 加上 SAM 式记忆机制可做时序目标跟踪与具身操作中的指代;作者已用 RoboRefIt 验证了具身场景,视频是顺理成章的下一步;(3) 以掩码 IoU 为可验证奖励做 RL(类似 GRVO/GRPO 的做法),替代昂贵的逐实例掩码标注;(4) 规模实验——在 8B/30B 骨干上检验“共享表征掩码监督”的规模效应是否保持,目前只有 4B 一个规模点;(5) 数据开源与推广——grounded reasoning 管线若开源,可迁移到文档、UI、医学图像等需要中间区域引用的领域;(6) 与 DeepEyes/Pixel Reasoner 等图像交互方法做受控比较,厘清 latent 推理与裁剪推理各自的适用边界。
复现评估
这是一份技术报告,附有项目主页,但正文未明确承诺开源权重、代码或训练数据。方法描述本身相当完整:架构(公式 2–8)、两阶段训练配方、数据管线(含公式 9–14 的过滤判据)都写得可以照做,但关键壁垒在数据——自建数据达数百万量级(图中标注约 5.57M/1.92M/1.02M 等),grounded reasoning 数据依赖 MLLM 生成 QA、独立 checker 验证、推理模型生成 trace、SAM 3 补掩码的四步流水线,独立复现需重建整条管线并调好各阈值。训练为 4B 模型两阶段全参微调,报告未给 GPU 型号、卡时数或成本,估计需要多卡集群。评测协议清晰(8 折 REC/RES、COCO 多实例、LensBench 16 个分区各 300 样本、主结果为三个 Stage 2 checkpoint 等权平均),若 LensBench 与模型权重开源,复现评测部分难度中等;完整复现训练则难度高,数据工程是主要门槛。
论文图表
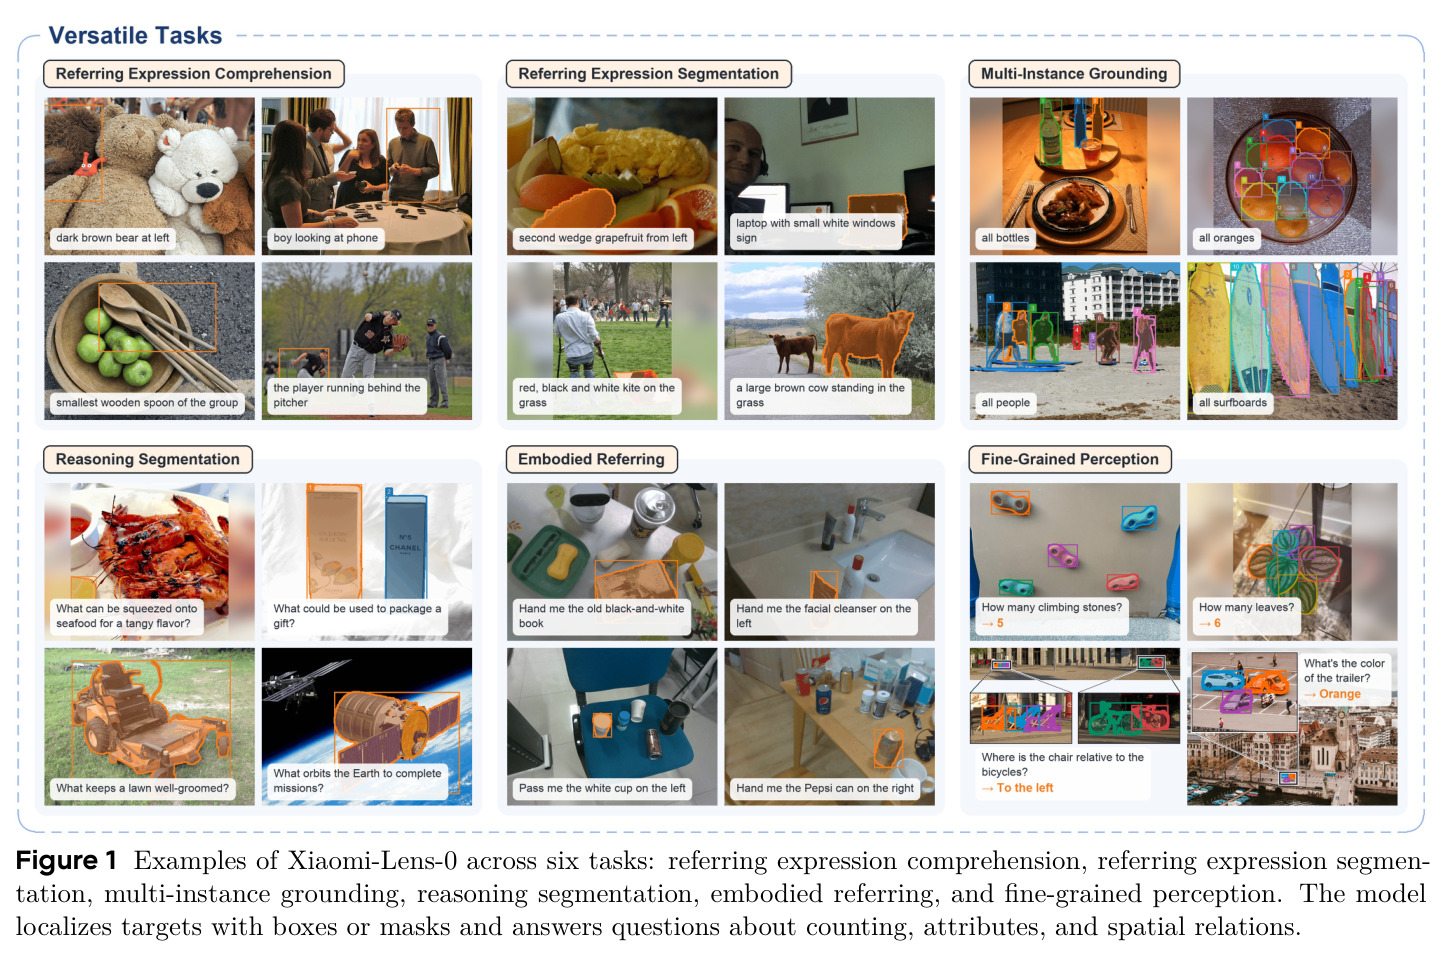
展示模型在六类任务上的输出示例:指代表达理解、指代分割、多实例定位、推理分割、具身指代和细粒度感知。模型用框或掩码定位目标,并回答有关计数、属性和空间关系的问题。
一图总览论文覆盖的全部评测任务面,帮助读者在进入方法细节前建立“这个模型到底能做什么”的整体印象。
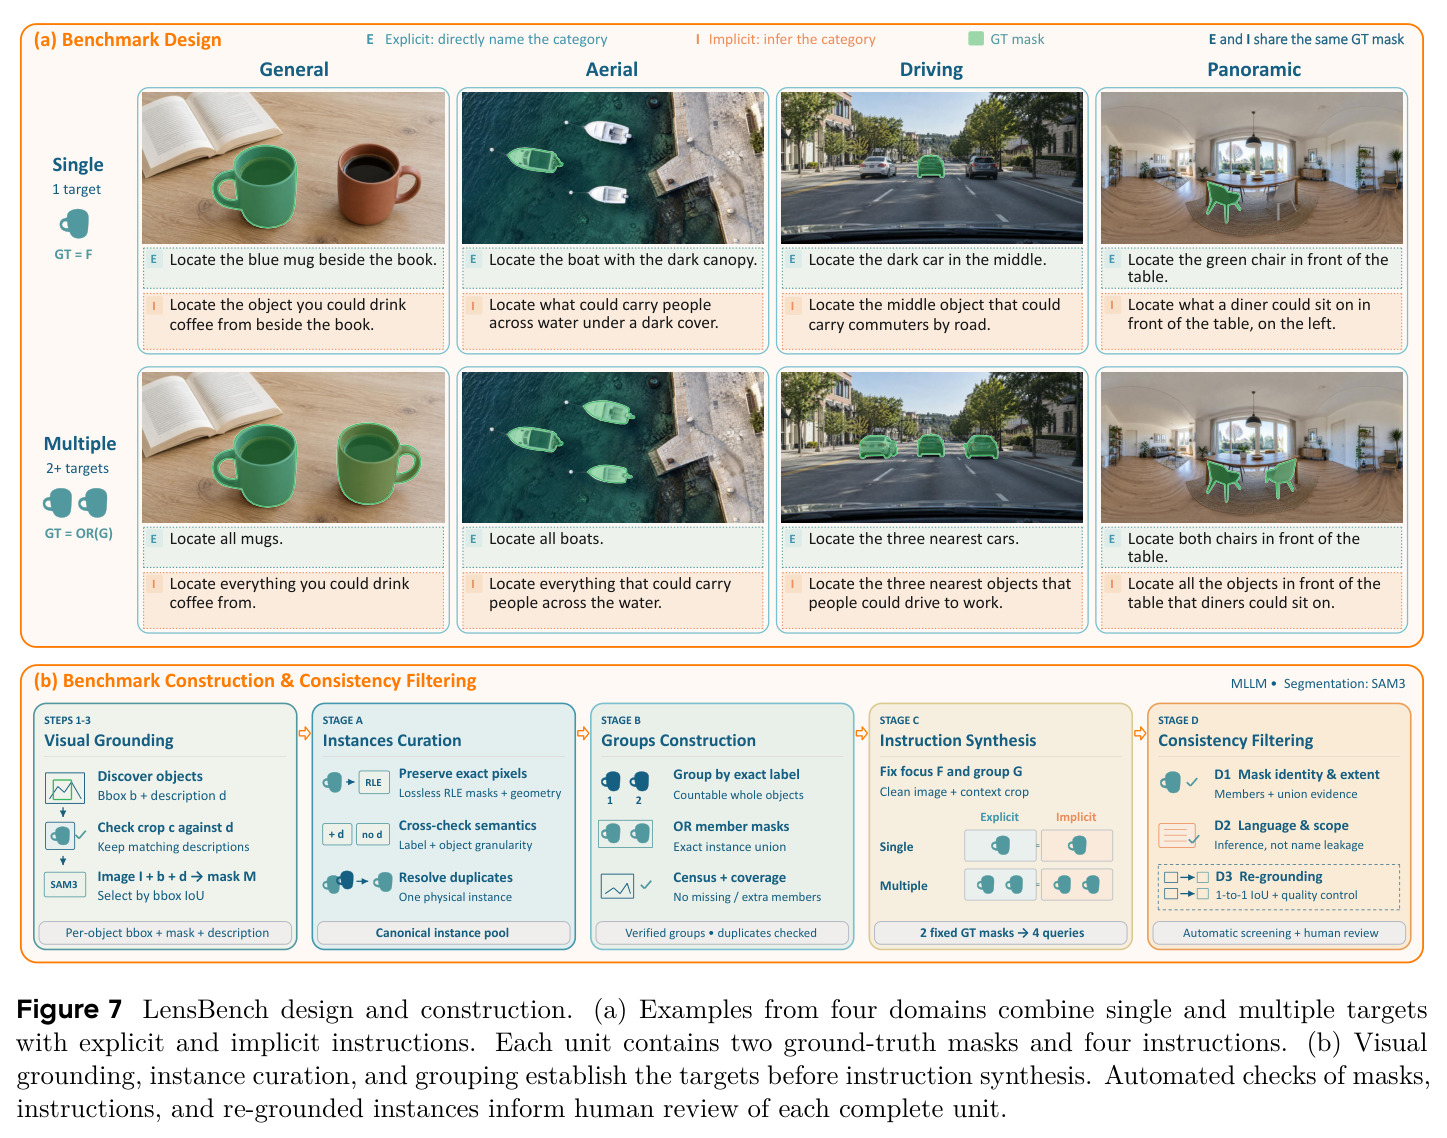
LensBench 的设计与构建:(a) 一般/航拍/驾驶/全景四域 × 单/多目标 × 显式/隐式指令的示例矩阵,每单元两个真值掩码、四条指令共享同一掩码以支持配对比较;(b) 从视觉定位、实例整理、分组构建到指令合成与一致性筛查(自动检查+人工复核)的完整流程。
LensBench 是论文的三大贡献之一,此图解释了评测矩阵如何做到“同图同掩码、只变指令语义”,这是解读 Table 7 结论的前提。