去中心化智能体集群中的自编排学习 Learning Self-Orchestration in Decentralized Agent Swarms
用拍卖出价机制让智能体集群同时学会“怎么做事”与“谁该出手”。
前置知识
LLM 智能体后训练(post-training)
在预训练/指令微调后的 LLM 上,用强化学习(如 REINFORCE、PPO)根据环境返回的奖励继续更新模型权重,使模型学会完成多步决策任务。通常先做监督微调(SFT)冷启动,再用 RL 探索改进。本文中每个智能体都是独立全参微调的 LLM。
MPT 的核心就是在后训练阶段同时优化“行动策略”和“出价策略”,理解后训练流程是读懂方法的前提。
密封出价拍卖(sealed-bid auction)
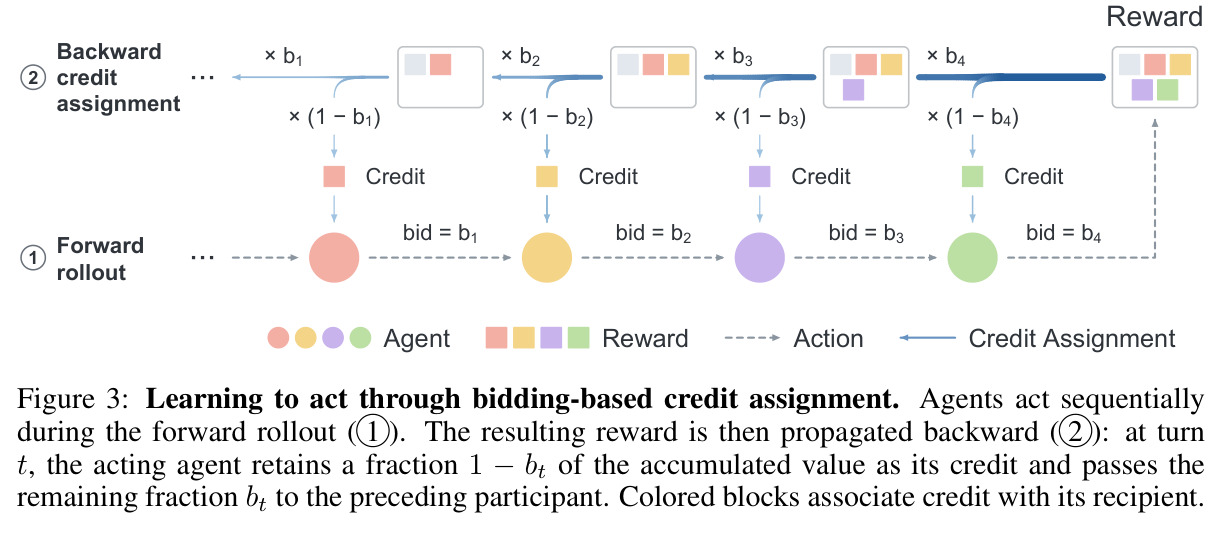
一种 decentralized 的资源分配机制:所有参与者同时秘密提交出价,出价最高者获得“行动权”。本文中每个回合所有智能体各自根据本地上下文提交一个出价 $b_i$,最高出价者执行动作,无需中央调度器判断谁该行动。
出价机制是 MPT 自编排的核心载体,谁行动、功劳如何分配都由出价决定。
信用分配(credit assignment)
多智能体强化学习中的经典难题:团队最终拿到奖励后,如何把功劳(或责任)分给链条上各个智能体的动作。分得不准则学习信号就是噪声,训练会失败。COMA 用反事实基线、VDN/QMIX 用价值函数分解来解决这个问题。
MPT 最独特之处是用同一个出价标量同时解决“谁行动”和“功劳归谁”两个耦合问题。
桶队列算法(bucket brigade)
Holland 在分类器系统中提出的经济式信用传递机制:链条上每个环节从下游获得的价值中,按比例留下一部分给自己,其余传给上游,像救火队传水桶一样让奖励沿行动链向后流动。Baum 的 Hayek Machine 进一步将其发展为经济型智能体信用分配。
MPT 的价值回传公式 $v_t = \hat{r}_t + b_{t+1}v_{t+1}$ 正是桶队列思想的现代 LLM 版,理解它才能看懂信用分配。
REINFORCE 与均值基线
最朴素的政策梯度算法:$\nabla_\theta J = \mathbb{E}[(r - \bar{r})\nabla_\theta \log \pi(a|s)]$,用实际回报减去基线(这里是该智能体批内平均信用 $\bar{r}_i$)作为优势估计,减方差、稳定训练。本文用它更新每个智能体的动作 token。
这是 MPT “学会行动”部分的优化器,公式 (2) 全文训练都依赖它。
Bradley–Terry 偏好目标
成对偏好学习模型:给定两个候选响应,人类(或信号)偏好其一的概率为 logistic 函数。损失 $\mathcal{L} = -\log\sigma(\log\pi(y_w|h) - \log\pi(y_l|h))$ 与 DPO 同源,直接提升偏好响应的相对似然,无需训练奖励模型。
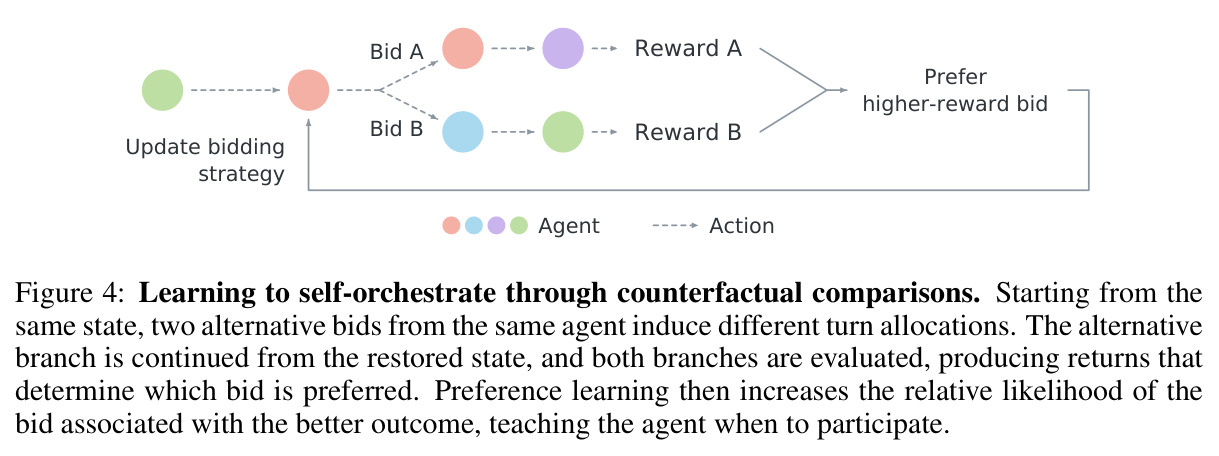
MPT 用它从反事实对比中学习出价:哪个出价导向更好结果就提升哪个的似然。
反事实重演(counterfactual rollout)
在关键决策点保存环境与智能体状态,改变一个决策(这里是让出价第二高的智能体行动)后从同一状态继续推演到底,比较两条分支的结果差异,从而估计“如果当时换成别人行动会怎样”。COMA 的反事实基线是它的单步近似版本。
出价学习的全部监督信号都来自反事实分支对比,这是理解 Fig. 4 和训练开销的关键。
研究动机
现有多智能体 LLM 系统(MetaGPT、ChatDev、AutoGen、AgentVerse、多智能体辩论等)普遍把模型放进人工预设的交互结构里:manager 派活给 worker、verifier 检查 generator、按固定工作流轮转(round-robin)。即使参与智能体可以训练,决定“下一个由谁行动”的编排策略在整个训练过程中也是固定的——例如 Feng et al. (2026) 的 Dr. MAS 虽然稳定了多智能体 RL,编排仍不动。这种“个体能力学习”与“集体组织方式”的分离忽略了二者的耦合:某个状态下谁行动,不仅决定集群轨迹,还决定哪些智能体获得经验和学习信号;反过来,随着智能体变强,有效的参与模式也会改变——训练早期必须频繁出手的智能体后期可能变得多余,某个原本无用的动作在下游智能体进步后可能变得关键。在固定编排下训练个体,等于只优化了这对耦合关系中的一面;而 monolithic 单体后训练则把 Logger、Miner、Smith 等所有角色的演示和数据混进一个模型,训练信号互相干扰,在三角色的 Minecraft 铁镐任务上只能拿到约 20 的回合奖励。
本文的目标是本文要回答的问题是:去中心化的智能体集群能否从经验中同时学会“如何行动”和“如何自我组织参与”——不依赖中央协调者,让每个智能体自己决定何时该参与、何时该让位,并让参与模式随个体能力的提升而共同演化。具体目标拆成三层:(1) 提出一个把“轮次分配”与“信用分配”耦合在一起的可训练机制,使自我编排成为可学习、可复用的组件;(2) 在具身制造(Minecraft 铁镐)、机器人导航(VLN-CE)和深度研究(OpenResearcher)三类任务上验证其相对 monolithic 后训练的优势;(3) 证明训练出的集群在换新任务时适应更快、推理时扩大种群能提升性能、成员掉线时更加鲁棒。
与已有工作不同的是,本文的独特切入是把经济学协调机制变成 LLM 智能体的可训练策略。思想源头是 Hayek 的“价格传递分散知识”、Minsky 的《心智社会》、Holland 的桶队列信用传递和 Baum 的 Hayek Machine;最近 Economy of Minds(Qi et al., 2026)和 SALE 用拍卖协调 LLM 智能体,但它们只演化 prompt、权重全程冻结;GPTSwarm、AgentNet、Graph-of-Agents 等编排优化方法只在推理时调整图结构或路由,不做权重更新;经典多智能体 RL(MADDPG/MAPPO 的 CTDE、VDN/QMIX 的价值分解、COMA 的反事实基线)也从未把“选择下一个行动者”与“奖励如何在智能体间分配”连成同一个可学习量。MPT 抓住的正是这个空档:让出价同时充当参与门槛和信用分配阀门,两者随训练共同演化,且全程无中央智能体。
核心方法
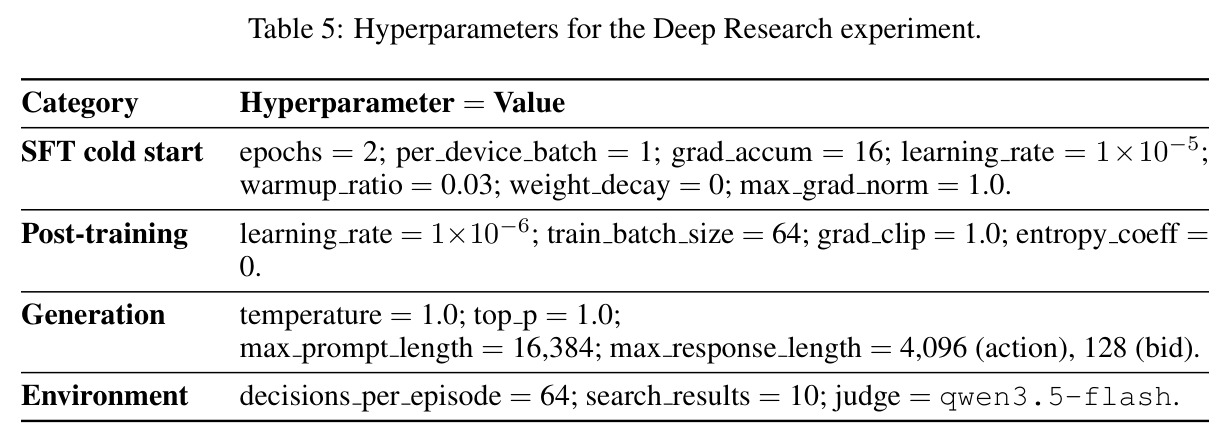
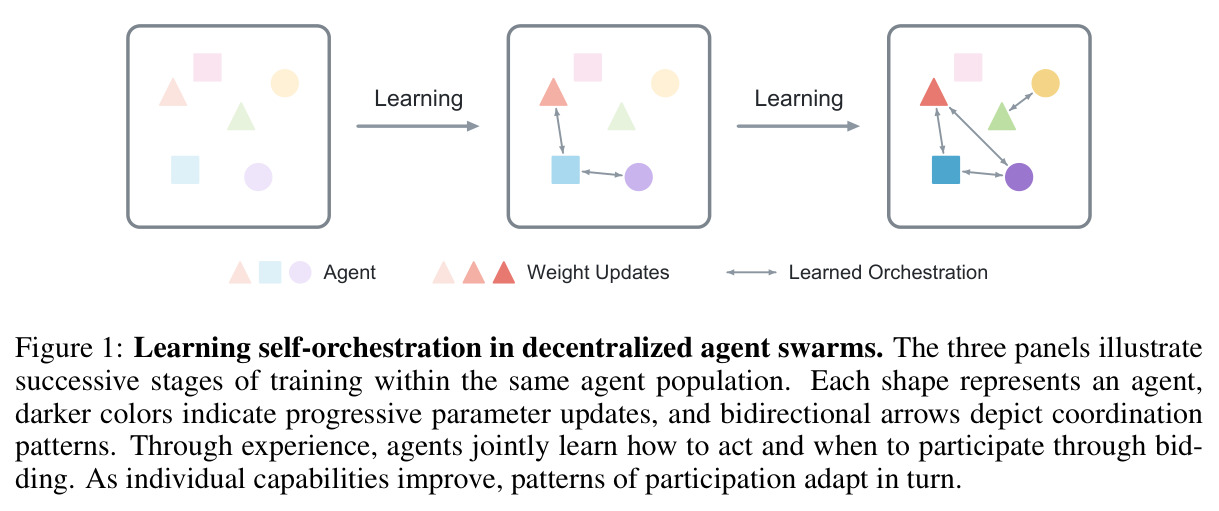
直觉上,MPT 把一个智能体集群组织成一个小型市场经济:每一次行动机会都是一件被拍卖的商品,智能体通过出价表达“我现在参与能推进任务的程度”,价高者得。出价不只是门票,还是一份收益分成承诺——你赢得这一轮,就必须把自己这轮产生价值中的出价比例回传给上一位行动者,等于“买下了它为你准备的状态”。这样,价值会像救火传水桶一样沿行动链向后流动,谁报高价谁就对上游欠下更多“债”,自然抑制了无意义的抢戏。技术路线上分三块:(1) §2.1 的拍卖式自编排——$N$ 个参数各自独立的智能体,每个策略 $\pi_i$ 同时生成动作和出价,每回合最高出价者行动,平局随机,全员出零则跳过回合;(2) §2.2 的行动学习——回合结束时按桶队列公式反向传播价值,每个智能体用带均值基线的 REINFORCE 只更新自己行动过的回合的动作 token;(3) §2.3 的出价学习——在“有争议回合”上做反事实分支对比,用 Bradley–Terry 偏好损失提升导向更好结果的出价。训练时 4 步行动学习配 1 步出价学习交替进行,行动和出价共享同一套模型参数,从而使能力与参与模式共同适应。
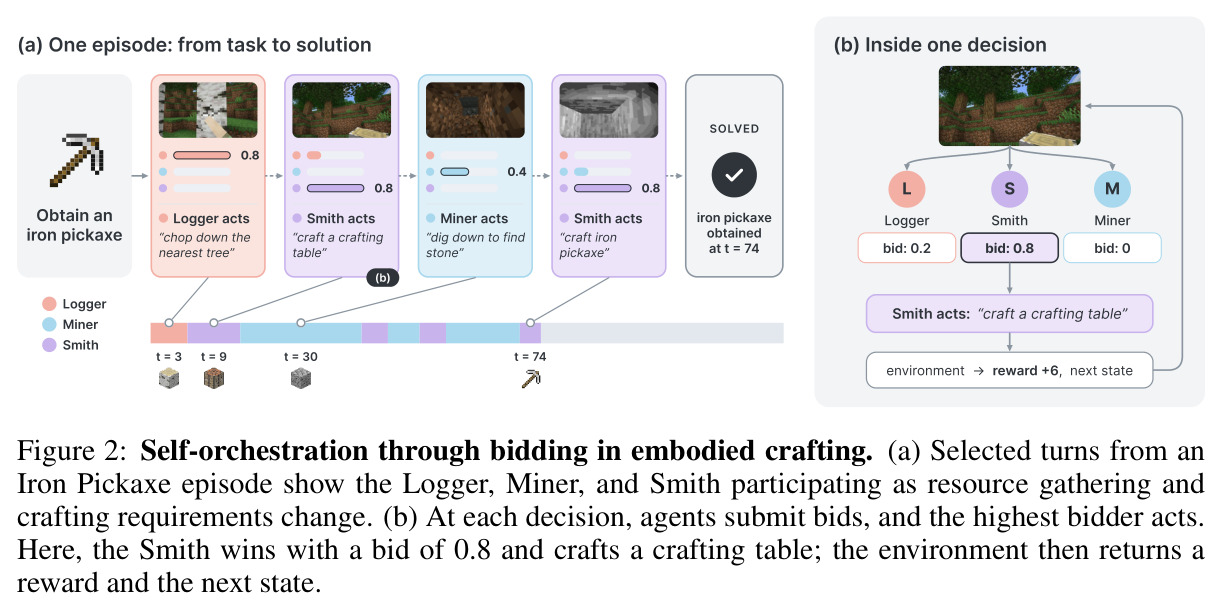
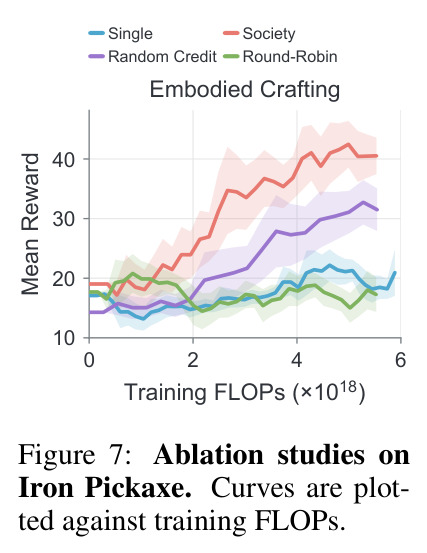
核心创新是出价(bid)的双重身份。在 MPT 中,选中的出价 $b_t$ 有两个作用:一是向前决定参与——出价最高的智能体获得行动权;二是向后决定信用——按 $v_t = \hat{r}_t + b_{t+1}v_{t+1}$、$\tilde{r}_t = (1-b_t)v_t$,该智能体只保留积累价值的 $1-b_t$ 份额用于自身动作更新,把 $b_t$ 份额传给上一位行动者。于是“我多想行动”和“我愿为前人铺垫付多少分成”变成了同一个可学习标量,参与决策与信用分配被机制性地焊在一起:抢一个自己不擅长的回合,不但浪费轮次,还要为下游不确定性买单。这与已有方法的本质区别在于:CTDE、价值分解、COMA 都假设“谁行动”由外部给定,只学给定编排下的策略;EoM、SALE 等经济系统权重冻结;GPTSwarm/AgentNet/GoA 只做推理时编排。MPT 是第一个通过权重更新让“行动能力”与“自我编排”联合演化、且完全去中心化的后训练框架。消融也验证了这一设计的必要性:把信用分配中的出价换成随机数(保留出价学习和拍卖),约 $5\times10^{18}$ FLOPs 处奖励从约 42 掉到 31,说明学到的出价本身就是更好的信用信号。
方法步骤详情
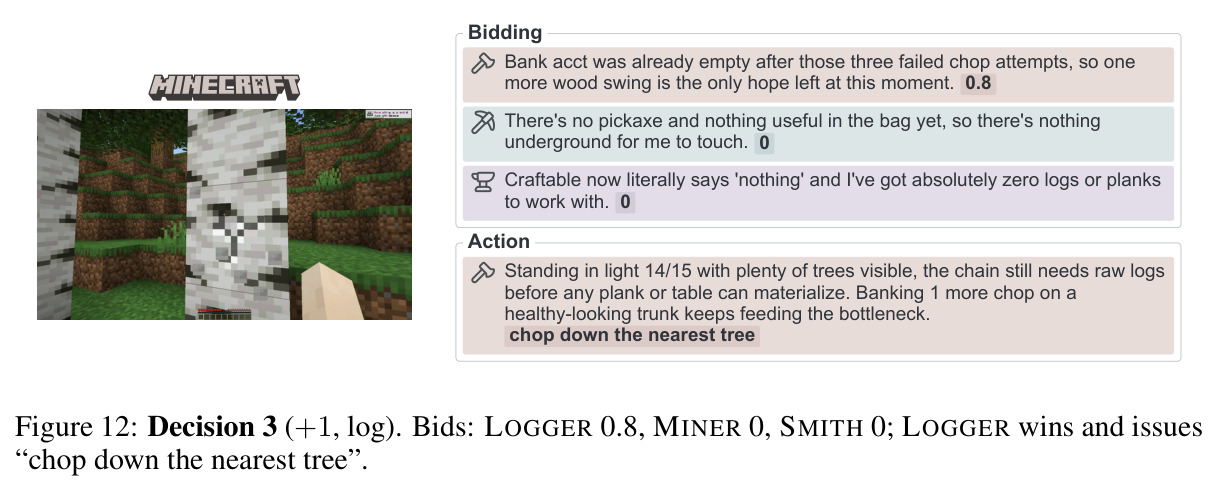
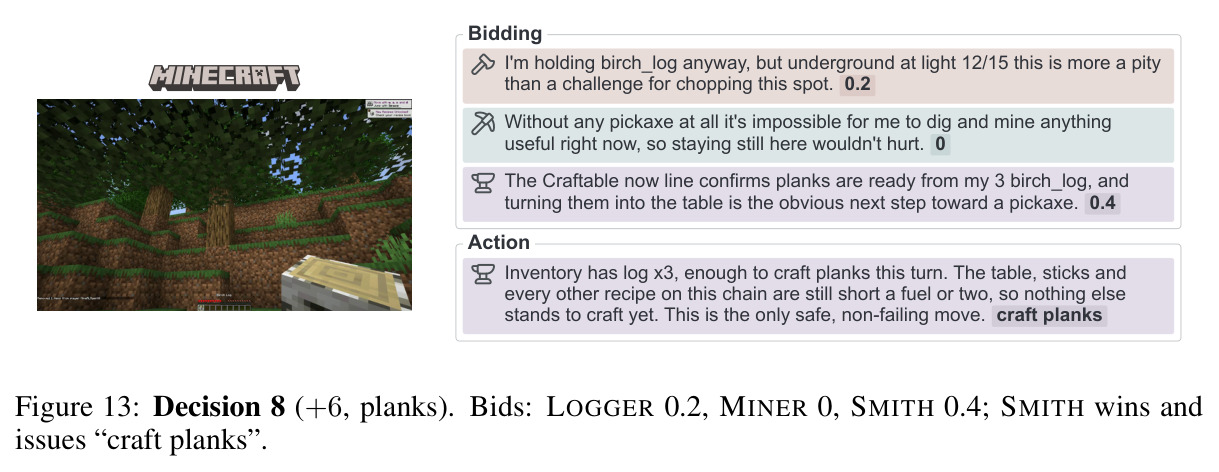
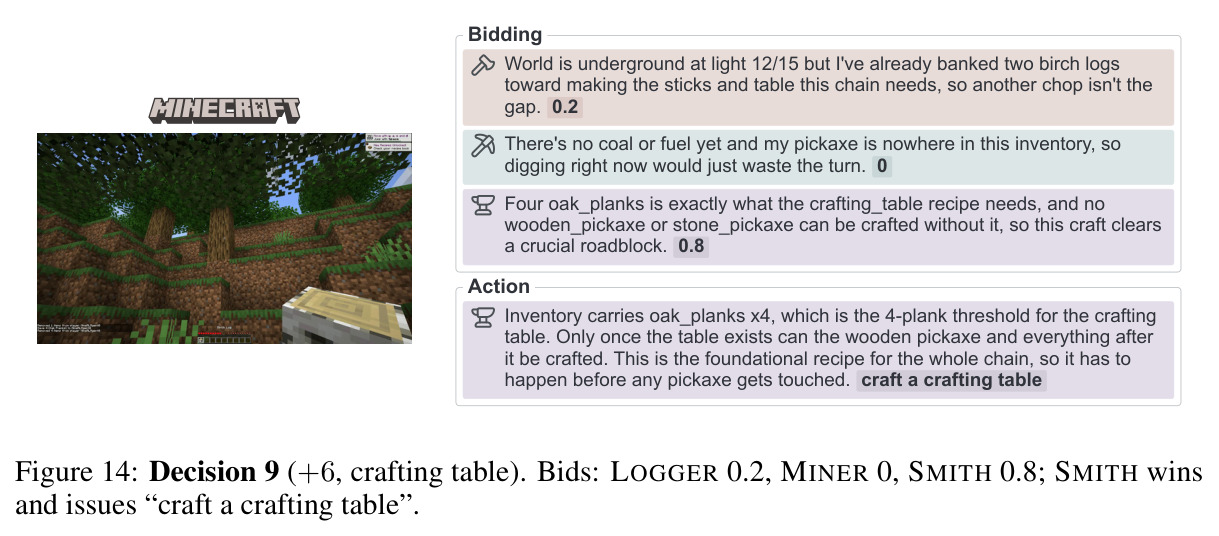
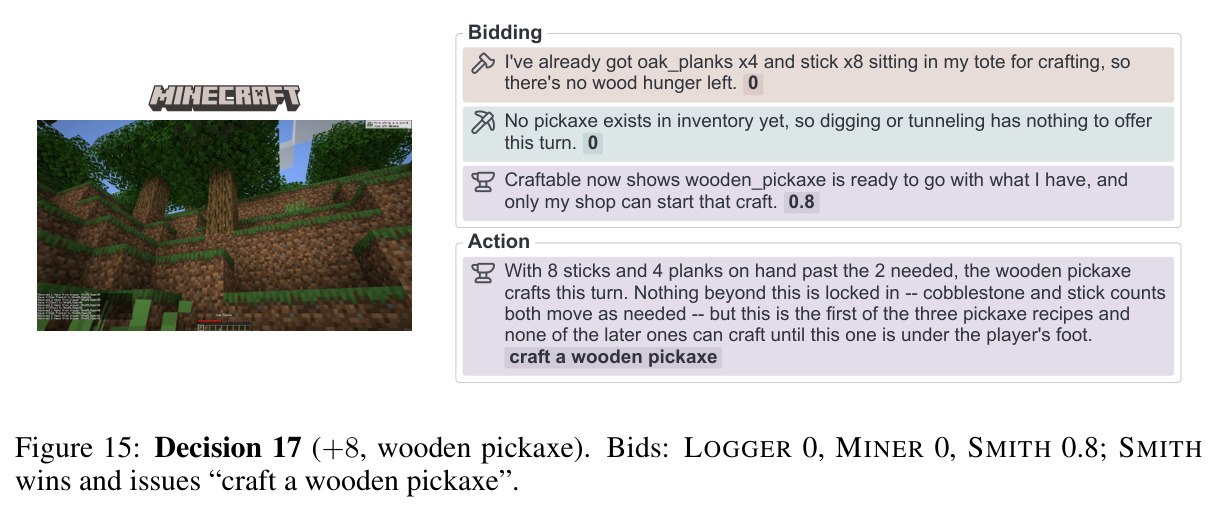
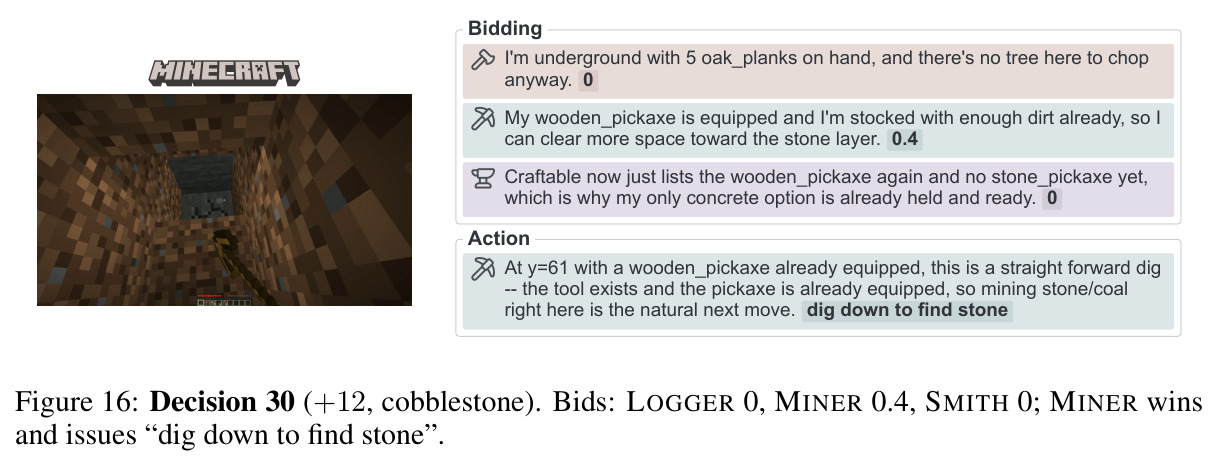
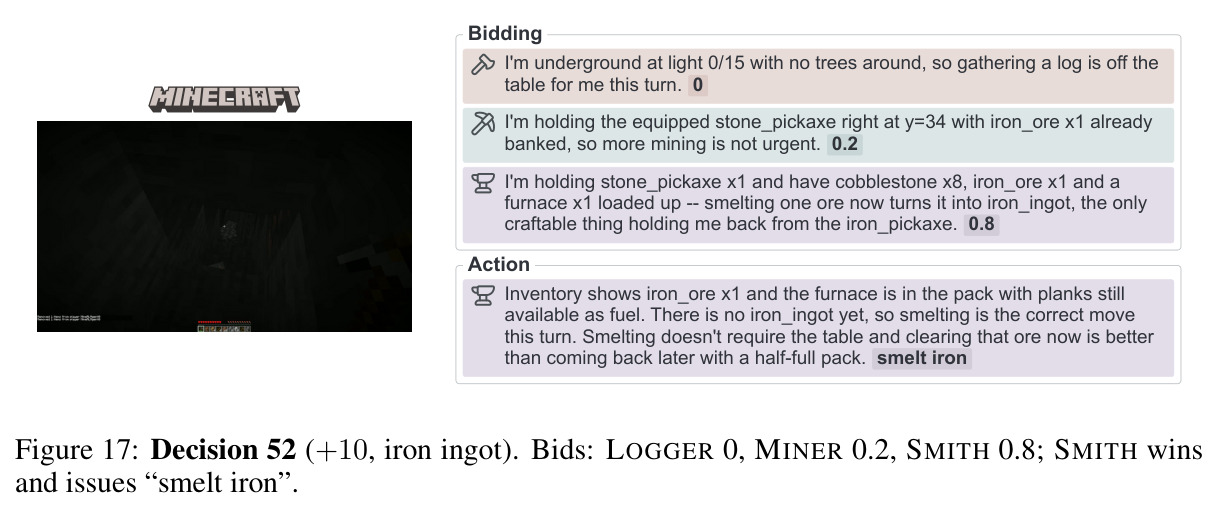
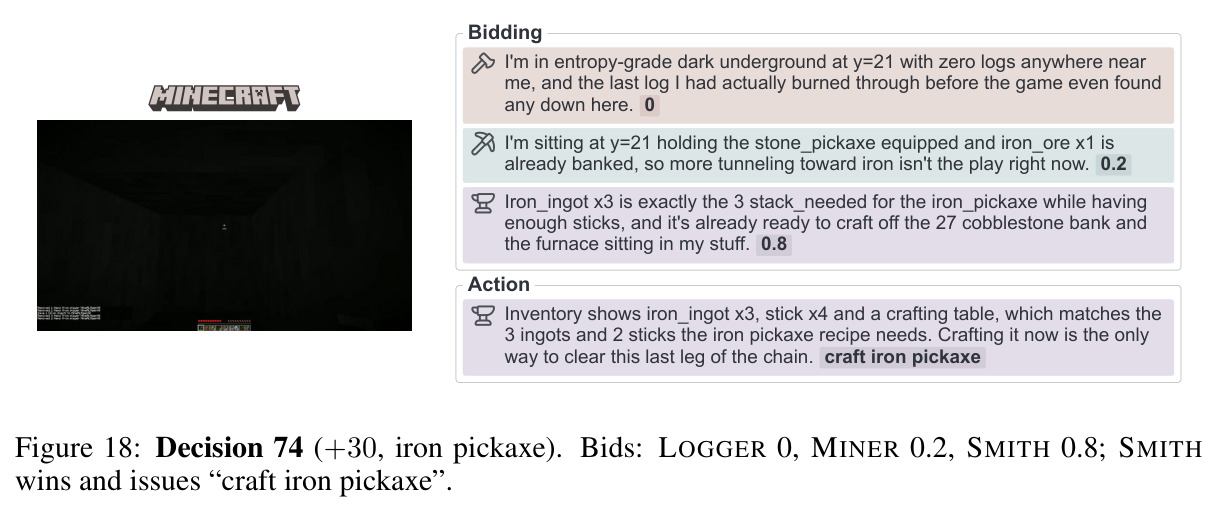
完整流程如下。第 0 步 SFT 冷启动:每个智能体只在自己角色的演示上全参微调(如 Logger 只学砍树、种树类指令),单体的 SFT 计算总量与之匹配以保证公平。第 1 步采样:一批任务上做 on-policy rollout,每回合 $t=1,\dots,T$ 所有智能体看本地上下文 $h_{i,t}$ 各报一个出价(具身任务中量化为 0/0.2/0.4/0.6/0.8 五级),最高者生成带思考的动作指令(如 Smith 出价 0.8 赢得回合并执行“craft a crafting table”),交给冻结的低层控制器(STEVE-1 执行 40 帧)或直接执行。第 2 步行动学习(每 5 步中的 4 步):回合结束后从 $T$ 反向扫到 1,计算 $v_t = \hat{r}_t + b_{t+1}v_{t+1}$($v_{T+1}=0$)与 $\tilde{r}_t = (1-b_t)v_t$,首位行动者传出的份额作废;随后每个智能体 $i$ 用公式 (2) 的 REINFORCE 加每智能体均值基线 $\bar{r}_i$,只对自己行动过的回合的动作 token 做梯度更新。第 3 步出价学习(第 5 步):找出“有争议回合”——亚军出价非零的回合;在副本中恢复该回合的环境与智能体状态,对选中者的出价重采样最多 3 次直到低于亚军出价、让亚军接管行动,若 3 次不成则丢弃该回合;两条分支都推演到回合结束,从争议回合起累加环境奖励作为分支得分,分高者记 $y_w$、分低者记 $y_l$,相等则丢弃;用公式 (3) 的 Bradley–Terry 损失更新出价响应的相对似然。第 4 步循环:交替 4+1 两种更新,所有智能体的动作和出价能力在同一次后训练中共同进步。
技术新颖性
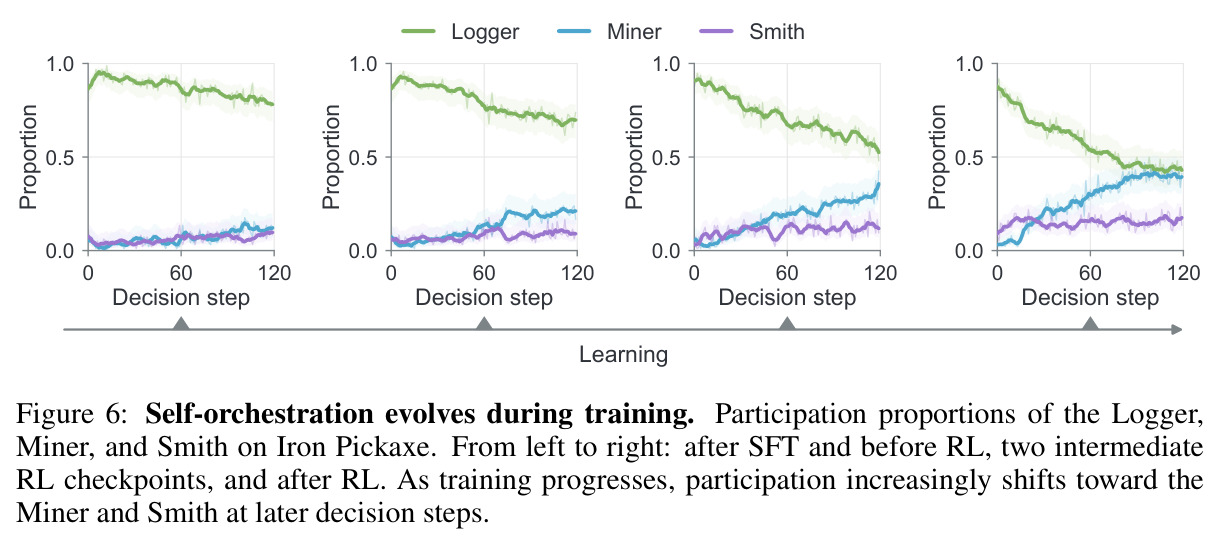
技术新颖性有四点。第一,把“自编排”从推理时的结构搜索(GPTSwarm 优化连接、AgentNet 演化路由、GoA 图协作)变成后训练阶段的可学习参数化策略,编排随能力共同演化,Fig. 6 的参与比例迁移(Logger 在第 120 步的份额从 RL 前约 80% 降到 45%,Miner 从约 10% 升到 40%)是这种行为涌现的直接证据。第二,单一标量出价统一了两个原本独立的难题——轮次分配与信用分配,机制上继承了桶队列/Hayek Machine,但首次把它嫁接到梯度训练的 LLM 上。第三,出价学习不依赖中央 critic 或显式价值函数:它把“换人行动是否更好”变成一个可执行的 A/B 实验(反事实分支对比),再转成 Bradley–Terry 成对偏好,形式上接近用环境回报做标注的 DPO。第四,严格的去中心化:每个智能体只依赖本地上下文出价与行动、参数独立、无调度器,这直接带来了推理时种群可复制扩展(3→12 个智能体)和掉线鲁棒性的工程优势。
实验结果
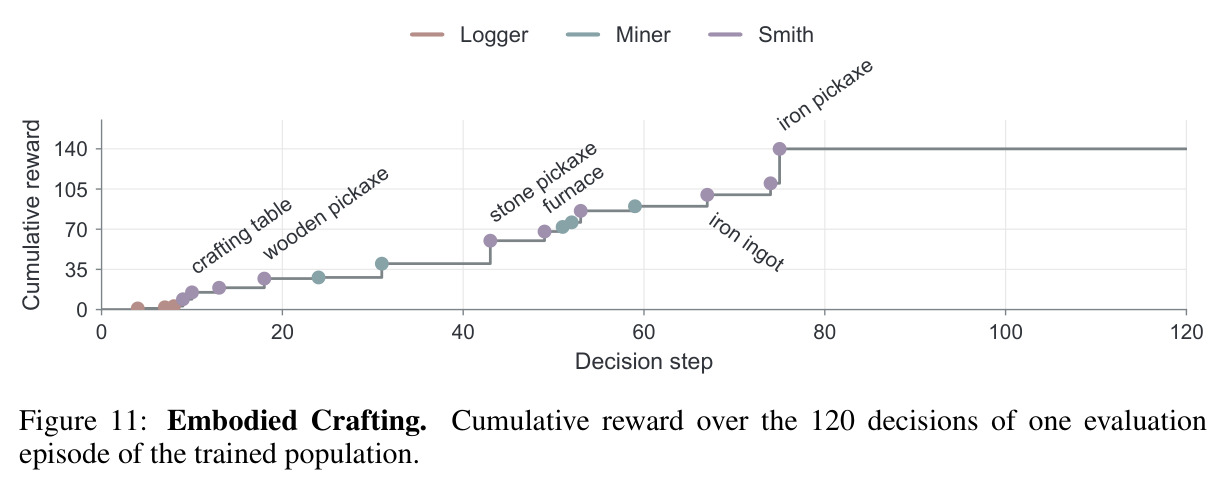
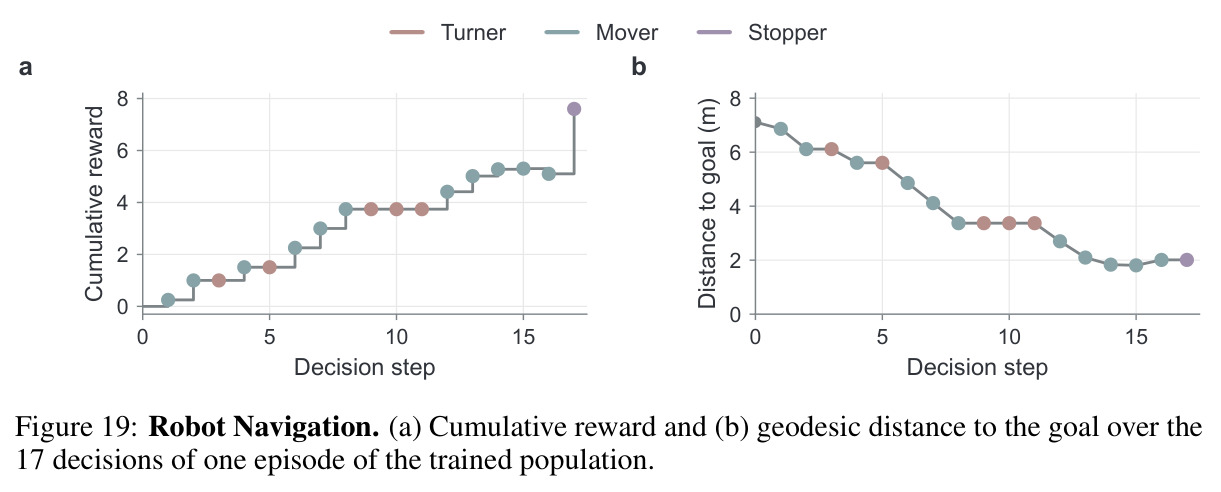
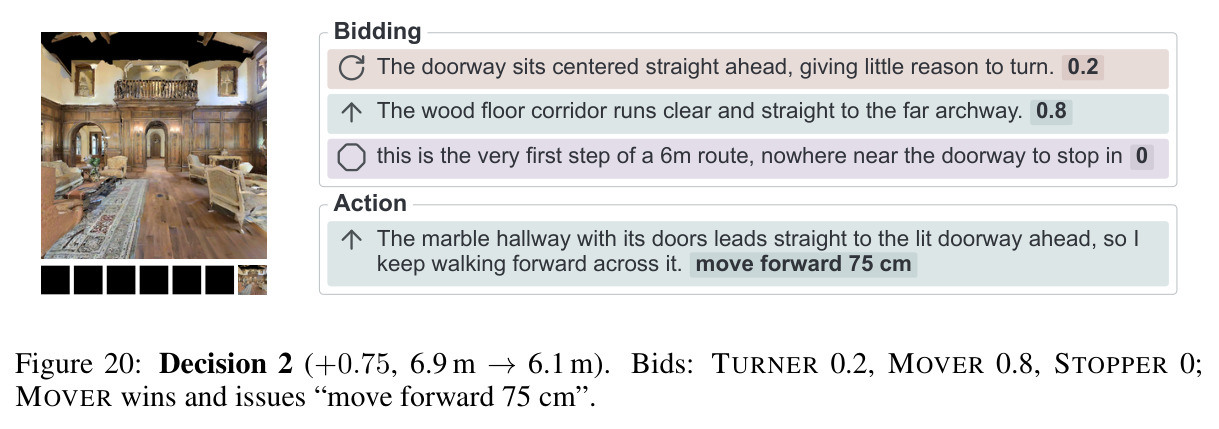
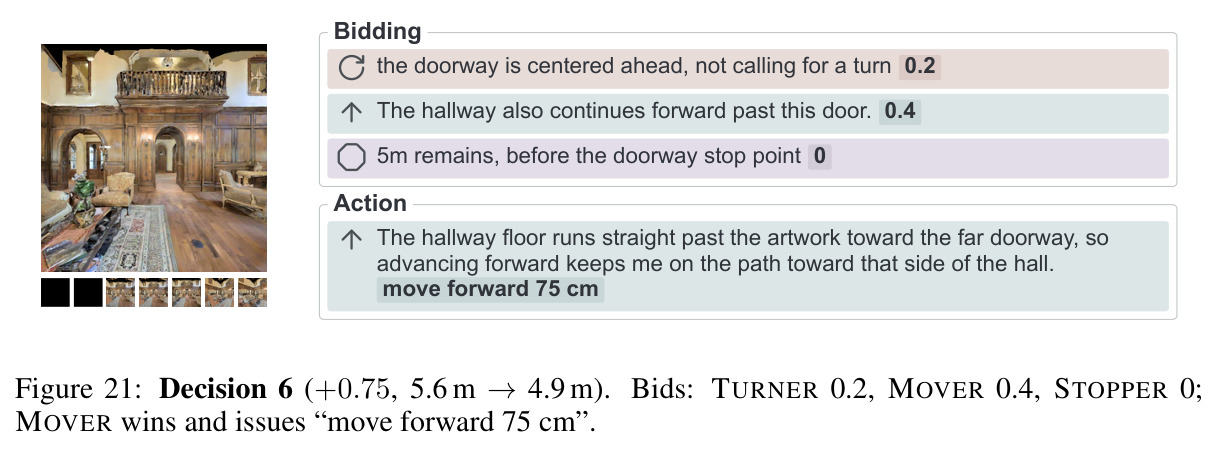
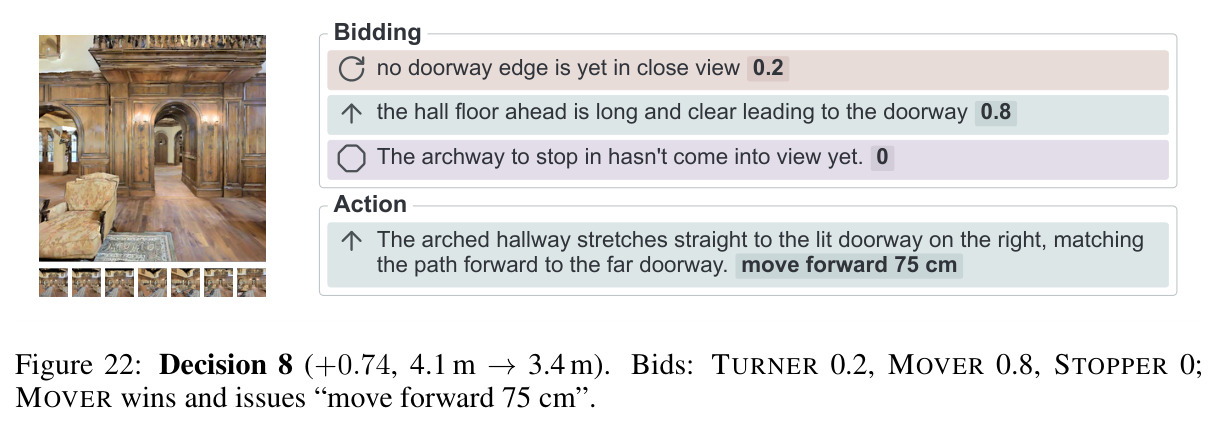
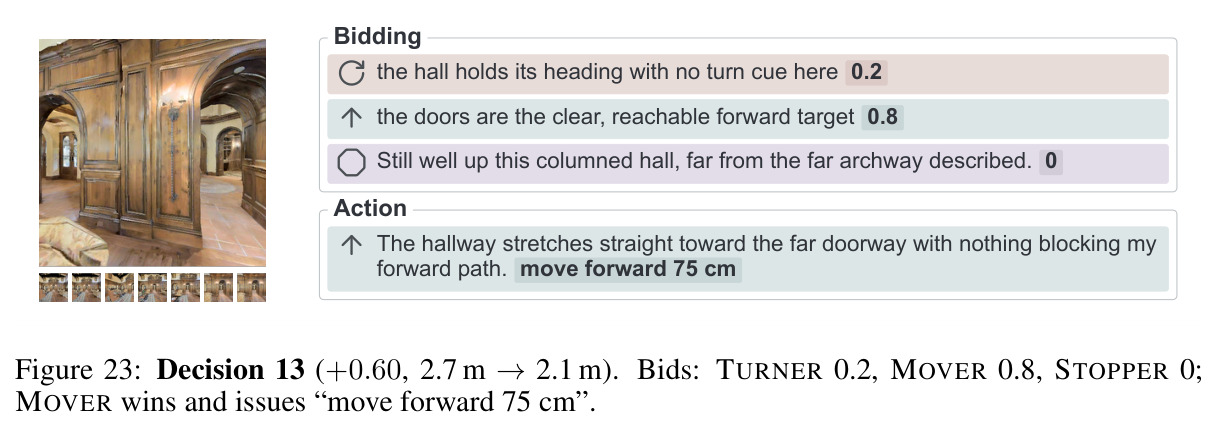
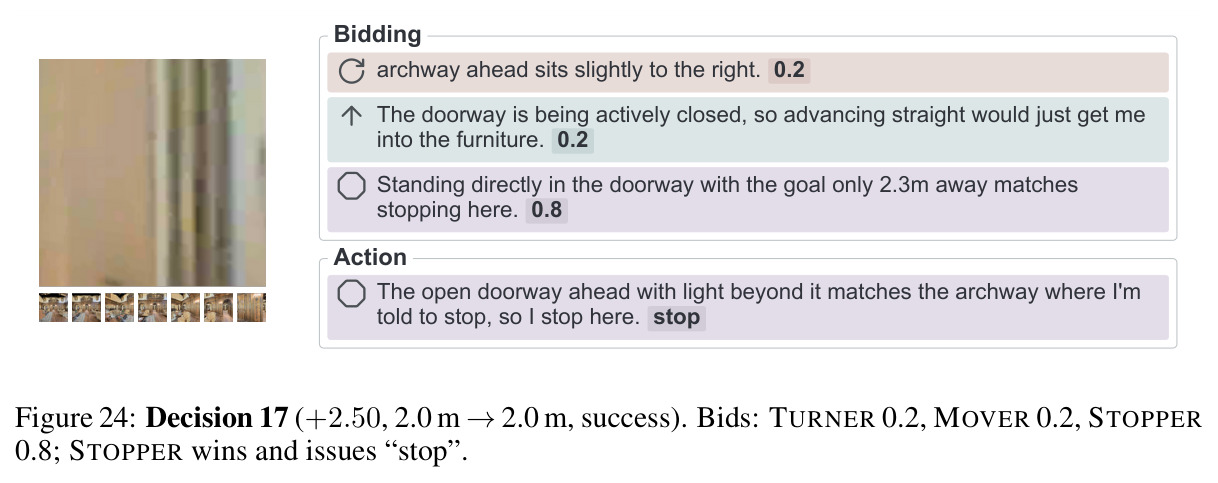
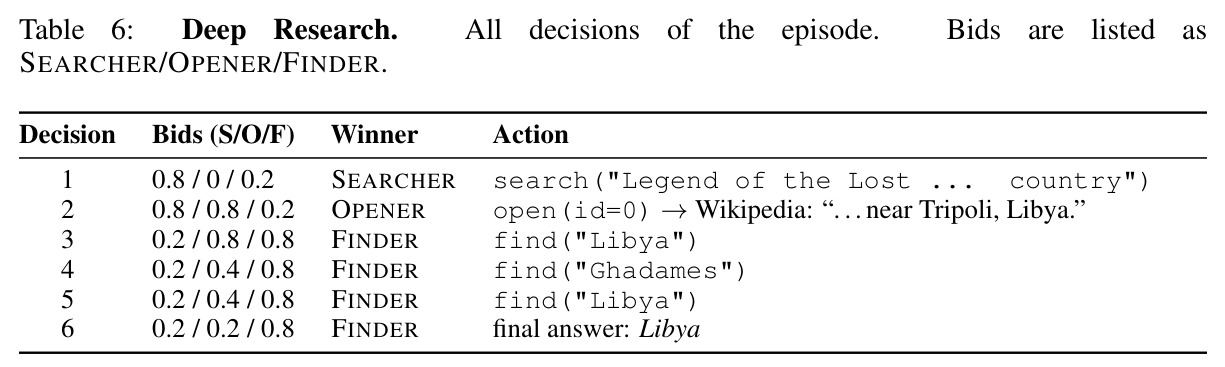
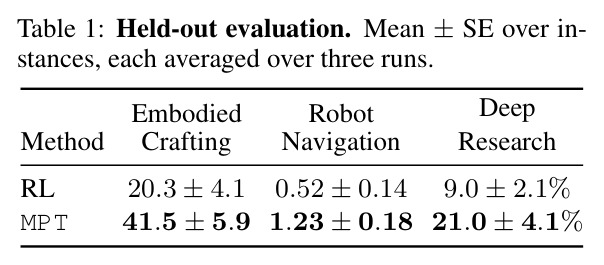
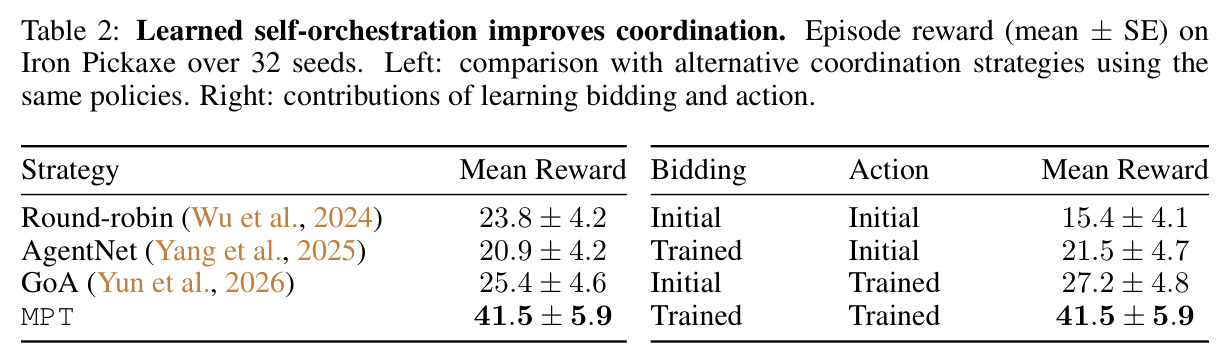
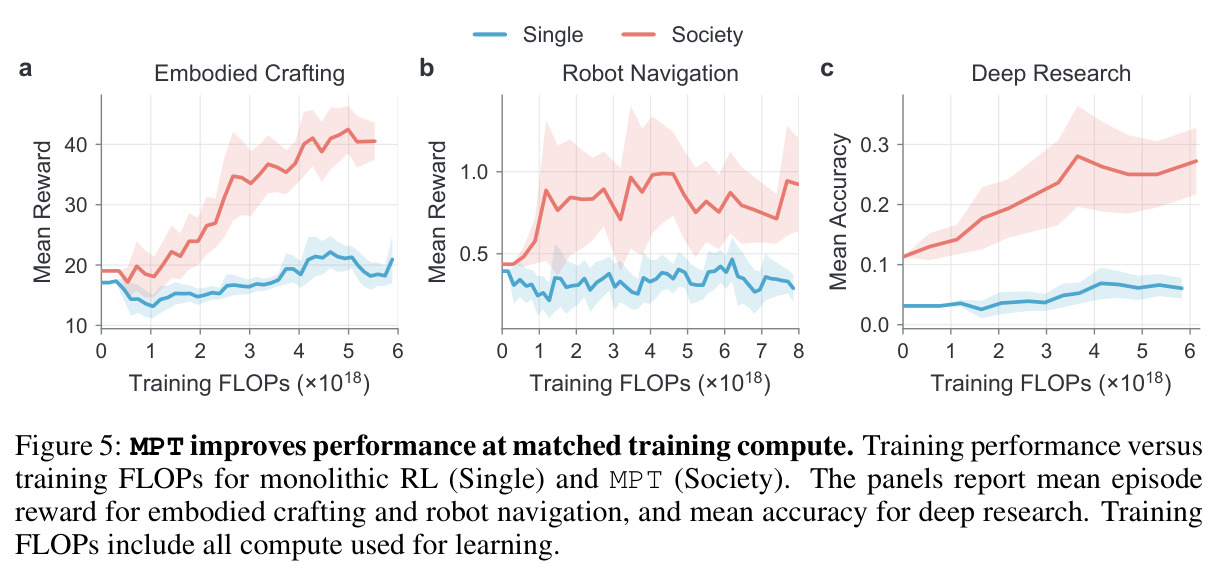
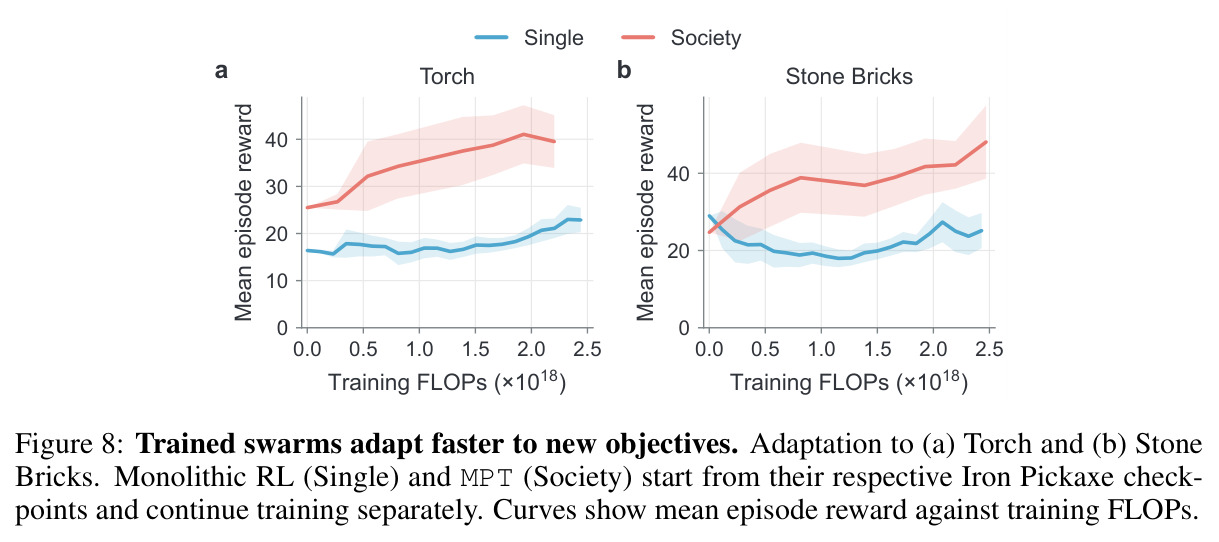
实验横跨三类任务,每个任务三个角色互补的智能体:具身制造用三个 Qwen3-VL-4B(Logger/Miner/Smith 在 Minecraft 从空背包打造铁镐,120 决策/回合,奖励上限 140);机器人导航用三个 NaVILA-8B(Turner 管转向、Mover 管前进、Stopper 管停止,VLN-CE R2R,64 决策上限);深度研究用三个 gemma-4-E2B-it(Searcher/Opener/Finder 分管 browser.search/open/find,OpenResearcher,二值最终奖励由 qwen3.5-flash 判定)。逐一来看:(1) Fig. 5 匹配训练 FLOPs 的训练曲线——制造任务最终平均回合奖励 MPT 约 41 对单体 20;导航约 0.9 对 0.3;深度研究平均准确率约 27% 对约 6%,三类任务全面领先且随算力投入差距拉大。(2) Table 1 留出集(32 个未见世界种子 / 88 条 val-unseen 导航 / 50 道留出研究题,各跑 3 次):MPT 41.5±5.9 对 RL 20.3±4.1、1.23±0.18 对 0.52±0.14、21.0±4.1% 对 9.0±2.1%。(3) §3.3.1 参与演化:第 120 决策步 Logger 份额从 RL 前约 80% 降到 45%,Miner 从约 10% 升到 40%,Smith 从约 10% 升到 15%,证明编排真的在训练中被改写。(4) §3.3.2 固定同一套训练后动作策略、只换协调方式(32 个种子):MPT 41.5 对最强替代 Graph-of-Agents 25.4(相对提升 63.4%)、Round-robin 23.8、AgentNet 20.9。(5) §3.3.3 组件消融:双训练 41.5,训练出价+初始动作 21.5,初始出价+训练动作 27.2,双初始 15.4,完全训练是初始的 2.69 倍,说明动作与出价都强才有效。(6) §3.3.4 消融:约 $5\times10^{18}$ FLOPs 处 MPT 约 42、随机信用约 31、Round-robin 约 15,出价作为信用信号显著有效。(7) §3.4 复用与扩展:从铁镐检查点继续训练,约 $10^{18}$ 适应 FLOPs 时 Torch 任务集群 35 对单体 17、Stone Bricks 38 对 19;种群从 3 扩到 12(每角色复制 1–4 份),pass@3 在 Wooden Pickaxe 78%→97%、Stone Pickaxe 69%→94%、Furnace 66%→91%;90% 掉线概率下 12 智能体仍保约 33 奖励,3 智能体只剩约 19。
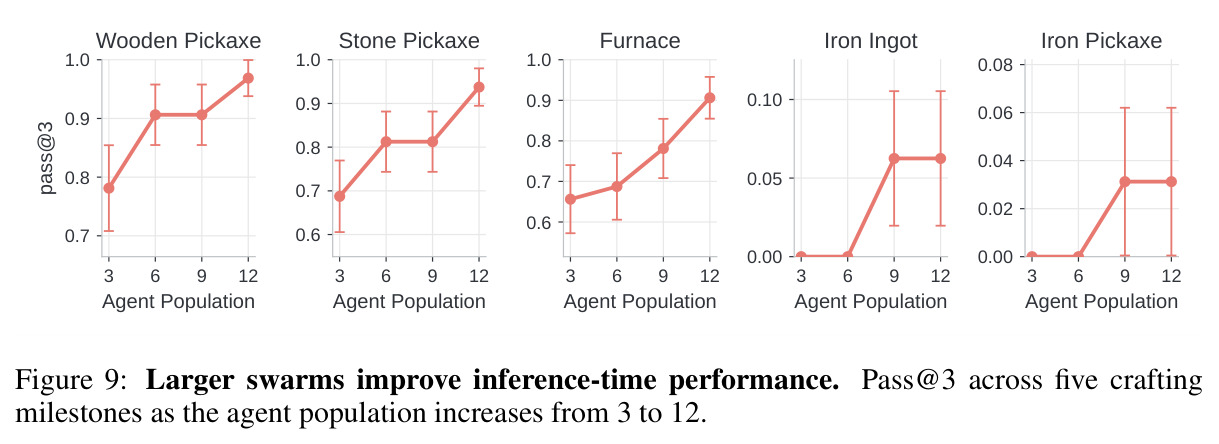
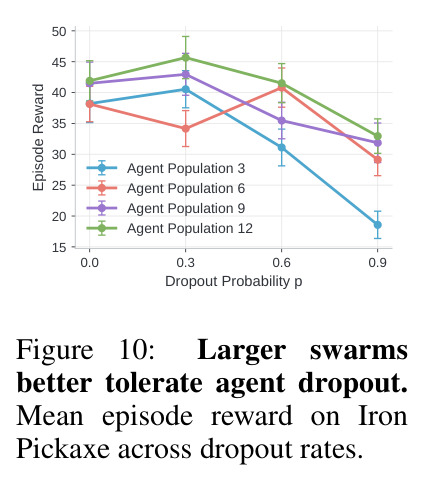
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 具身制造(Minecraft 铁镐,32 个留出世界种子) | 平均回合奖励(上限 140) | 41.5 ± 5.9 | Monolithic REINFORCE:20.3 ± 4.1 | 约 +104%(相对) |
| 机器人导航(VLN-CE R2R val-unseen,88 回合) | 平均回合奖励 | 1.23 ± 0.18 | Monolithic REINFORCE:0.52 ± 0.14 | 约 +137%(相对) |
| 深度研究(OpenResearcher,50 道留出问题) | 答案准确率 | 21.0 ± 4.1% | Monolithic REINFORCE:9.0 ± 2.1% | 约 +133%(相对) |
| 协调策略对比(铁镐任务,同一套训练后动作策略,32 种子) | 平均回合奖励 | MPT 出价:41.5 ± 5.9 | Graph-of-Agents 25.4 ± 4.6;Round-robin 23.8 ± 4.2;AgentNet 20.9 ± 4.2 | 对最强基线 GoA 相对提升 63.4% |
| 出价×动作学习消融(铁镐,32 种子) | 平均回合奖励 | 训练出价+训练动作:41.5 ± 5.9 | 双初始 15.4 ± 4.1;训练出价+初始动作 21.5;初始出价+训练动作 27.2 | 2.69 倍于全初始配置 |
| 信用分配消融(约 5×10^18 训练 FLOPs) | 平均回合奖励 | 约 42 | 随机信用约 31;Round-robin 约 15 | 比随机信用高约 35%,证明学到的出价是更有效的信用信号 |
| 推理时种群扩展(铁镐,3→12 个智能体) | pass@3(五个制造里程碑) | 木镐 78%→97%,石镐 69%→94%,熔炉 66%→91% | 3 智能体基线 | 无额外训练,扩大种群即全面提升 |
| 智能体掉线鲁棒性(掉线概率 p=0.9) | 平均回合奖励 | 12 智能体:约 33 | 3 智能体:约 19 | 冗余使严重掉线下奖励差距约 74% |
局限与改进
作者在附录 D 承认三点局限:(1) MPT 依赖外部可验证的任务奖励来同时训练行动与出价,未评估结果主观或反馈难获得的场景;(2) 出价更新需要在相同环境与智能体状态下做反事实重演,这要求环境可重置、状态可恢复,如何推广到不可逆的真实世界交互仍是开放问题;(3) 受算力限制,未探索超过 10B 参数的模型构成的集群,也未训练明显更大的种群。我自己的观察补充如下:出价在具身任务中被量化为 5 级(0–0.8),分辨率很粗,且高度依赖 prompt 中的语义锚定;出价学习只利用“亚军出价非零”的有争议回合,若集群角色分工过早固化、竞争稀疏,反事实样本会很稀缺(论文也未报告有争议回合的比例);桶队列价值随链条增长被 $\prod_j b_j$ 连乘衰减,长视野早期动作的信号可能非常微弱;三个任务都只有 3 个智能体且角色划分(谁管砍树/挖掘/锻造)仍是人工先验,角色自动分化未被触及;深度研究的奖励由 qwen3.5-flash 判分,本身带噪声;反事实重演还引入了可观的额外计算与工程复杂度。
独立分析的弱点
独立分析几个具体弱点。其一,反事实依赖可重置模拟器:Minecraft/Habitat 可以存档回滚,但真实机器人一经行动无法复原,这在家庭机器人等最需要自编排的场景直接失效——改进方向是用训练出的世界模型做想象 rollout 替代真实回滚,或只用单步反事实近似(类似 COMA)降低对完整重演的依赖。其二,角色结构仍是人工设计:Logger/Miner/Smith 的划分、动作空间的分区(转向/前进/停止)都是先验给定,若初始角色切错,市场机制只能在被划定的选项间选择——可引入开放种群或允许智能体克隆/消亡,让角色本身也在市场中演化。其三,出价量化为 5 级且语义写在 prompt 里(0=pass、0.8=瓶颈),出价策略的表达能力受限,也可能让模型只是学会了 pattern matching 这几档含义——应尝试连续出价或更多档位并检验是否仍能学到合理分工。其四,训练开销大:每回合 $N$ 个智能体都要生成出价,有争议回合还要重采样最多 3 次加整条替代分支,计算成本约为单体的数倍(论文用匹配 FLOPs 的方式做公平比较,但实际工程成本更高)——可蒸馏出轻量出价头,或只在不确定回合触发反事实。其五,桶队列无折扣地依赖连乘 $\prod b_j$ 传递,链条一长早期信用指数衰减,120 步的制造任务首尾之间信号可能已经很弱——可与显式价值估计或回报归因方法(如 attention 归因)混合。
未来方向
作者提出的可延伸方向加我的推演:(1) 规模与异构性——训练超过 10B 参数的模型、混合不同大小/厂商模型的种群、以及远大于 3 的种群联合训练,检验拍卖机制是否仍稳定;(2) 主观与弱验证任务——把可验证奖励换成 LLM 偏好判断、人类反馈或成对比较,出价学习天然吃成对信号,理论上可直接迁移;(3) 不可逆环境——结合基于模型的想象 rollout 或真实世界的“低成本试错”分桶来逼近反事实对比;(4) 编排技能的可迁移性——本文已展示铁镐检查点加速 Torch/Stone Bricks 适应,进一步可把学到的出价策略当作可复用的“组织先验”库,跨任务族迁移甚至零样本重组;(5) 机制设计与激励相容——分析该拍卖的均衡性质:智能体是否可能学会压价串通或虚假出价,何时需要防操纵机制;(6) 与通信学习结合(RIAL/DIAL、IC3Net 一脉)——出价决定“谁说”,通信内容决定“说什么”,两者联合学习值得探索;(7) 理论侧给出桶队列信用在随机环境下的收敛或偏差界,以及出价分布随训练的动力学刻画。
复现评估
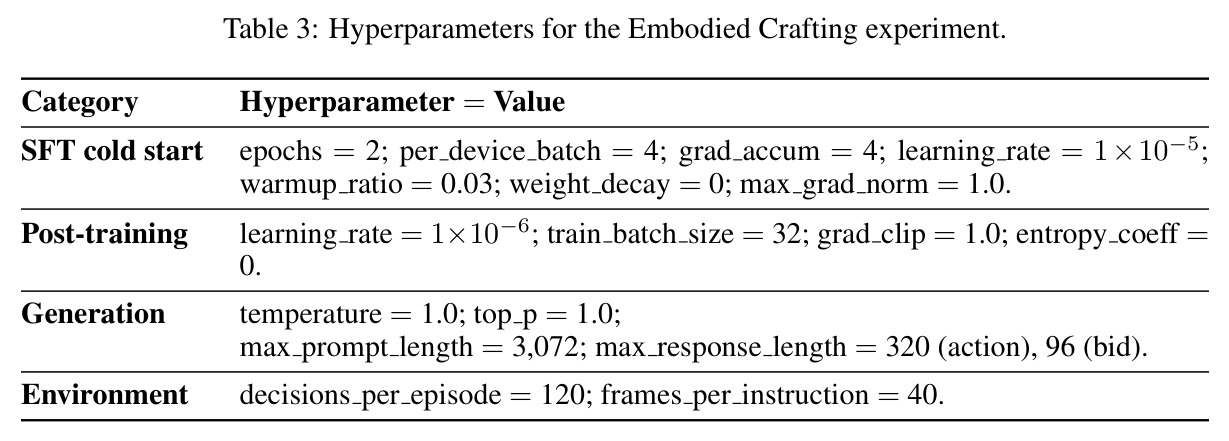
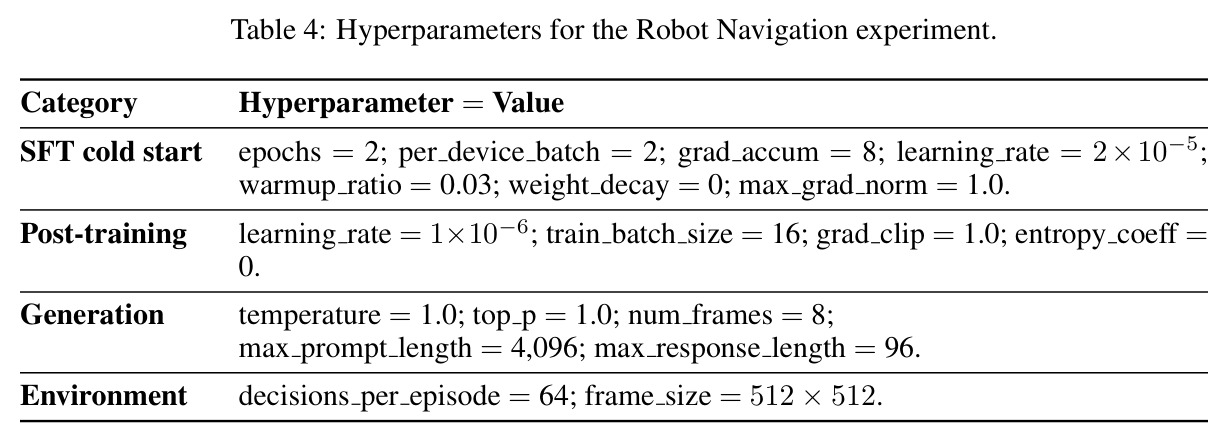
复现条件相当好。代码与训练好的模型已在 GitHub 开源(Embodied-Minds-Lab/MPT),附录给出完整伪代码(Algorithm 1)、三类任务的全部 prompt 模板(单体、出价、行动)和逐项超参数表(Tables 3–5):全任务后训练学习率 $1\times10^{-6}$、SFT 学习率 $1\times10^{-5}$(导航 $2\times10^{-5}$)、2 个 epoch 冷启动、AdamW + cosine 调度、bf16 全参微调;数据全部来自公开资源——Minecraft 走 MineStudio + 冻结 STEVE-1(1614 个训练种子),导航用 VLN-CE R2R(10744 条训练回合),研究用 OpenResearcher(5000 题、BM25 语料)。算力门槛中高:制造任务需 4 块 RTX PRO 6000 跑 32 个并行 Minecraft 环境加 4 块 B200 做 RL;导航需 2 块 RTX PRO 6000 加 4 块 B200;深度研究需 4 块 H200。模型规模 4B–8B 全参微调,还要并行托管模拟器和反事实重演,工程管线复杂度明显高于普通单智能体 RL。总体评估:代码、数据、超参齐备,复现门槛主要在算力(至少多卡 A100/H100 级)与分布式环境管理工程,对有小集群的团队难度中等偏上,跑深度研究子任务(纯 CPU 搜索服务 + 4×H200)是三者中最容易起步的切入点。
论文图表