AVC-Reward:以事件为中心的音视频一致性评估 AVC-Reward: Event-Centric Audio-Video Consistency Evaluation
把音视频解耦为事件并双向验证,三级指标既是可解释评估器又是RL奖励,大幅提升音视频一致性
前置知识
联合音视频生成(JAVG)
由单一模型同时产出视频画面与其配套音轨的生成范式,不再固定某一模态作为输入条件。早期方法是单向驱动:音频驱动视频(如 Wav2Lip 只管口型同步)或视频生成音频(如 HunyuanVideo-Foley 生成拟音)。以 Veo 3、MiniMax H3、Seedance 2.0、LTX-2、Ovi 为代表的联合生成则能直接输出包含多事件并发、画外音、背景音乐等复杂元素的视听场景。
本文评估对象的三大复杂性(多事件组合、多层音频混合、非对称跨模态关系)正是联合生成带来的,不理解 JAVG 的能力边界就无法理解旧指标为何失效、新指标要解决什么。
画内/画外/叙事层音频(diegetic、off-screen、narrative)
影视声音设计的角色分类:画内物理声来自画面可见的发声源,必须与画面严格同步;画外声来自画面之外的三维世界(如隔壁房间响起的电话),只需其后果在画面中合理(如厨师闻声回头);叙事层(非剧情内)音频如旁白和背景音乐服务于叙事与氛围,不需要可见发声源,只需语义情绪契合。
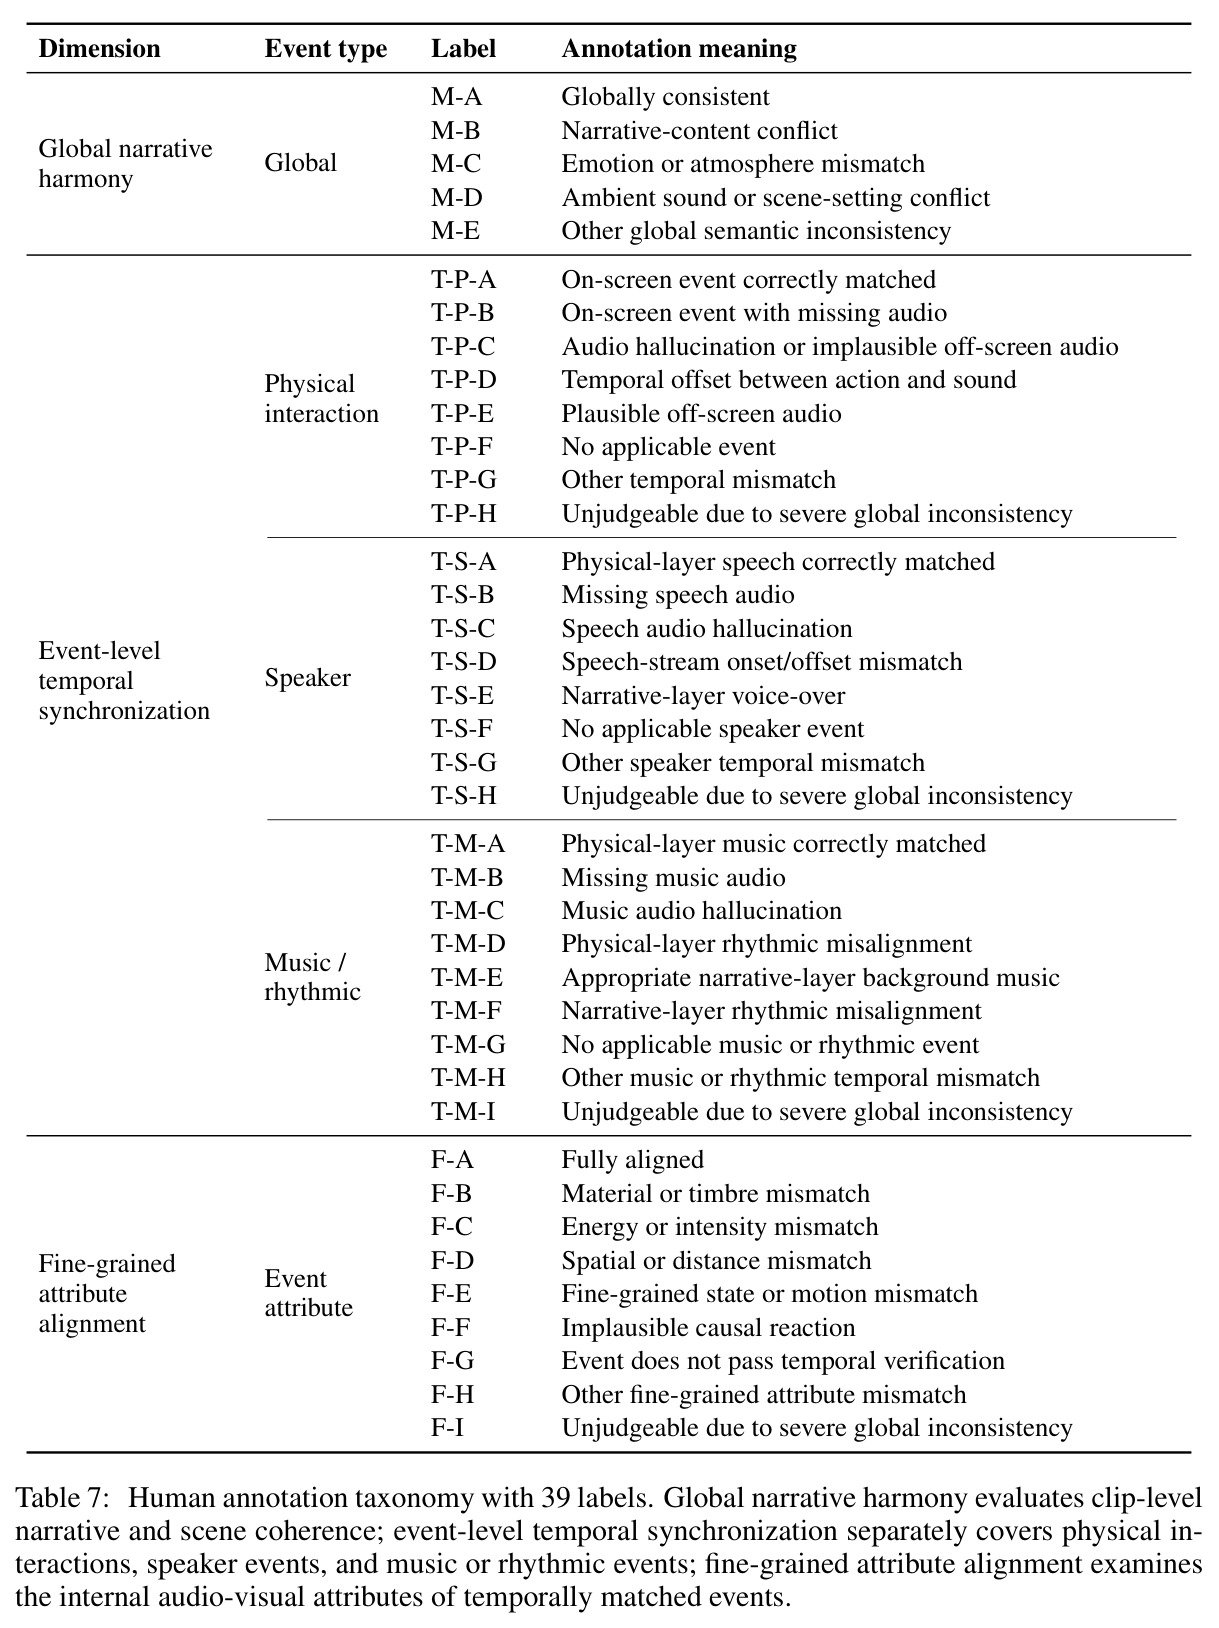
AVC-Reward 的核心设计是给每个音频事件标注来源角色 $\lambda \in \{\text{physical}, \text{narrative}\}$ 并按角色检查不同的跨模态关系,这正是避免把合法画外音误判为错误、以及把 BGM 与音效混在一起评估出错的关键。
奖励模型与 GRPO
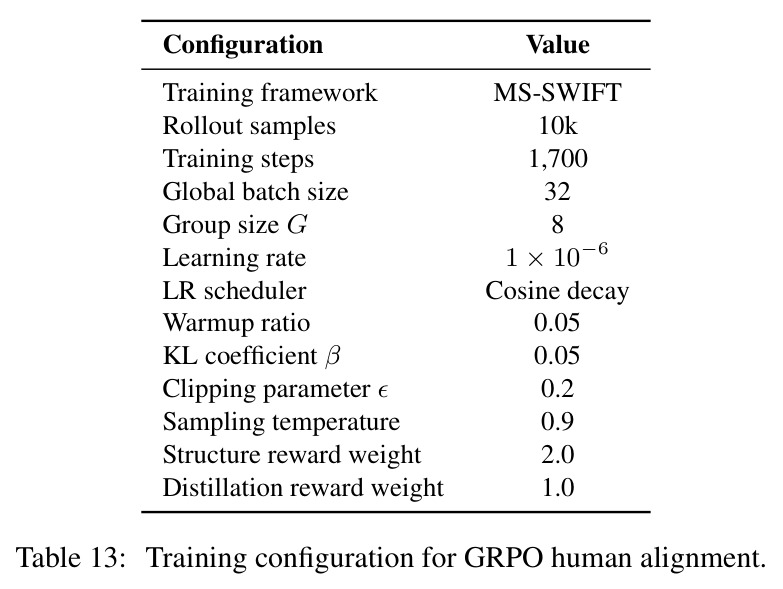
奖励模型为生成样本打分,作为强化学习的奖励信号。GRPO(Group Relative Policy Optimization,源自 DeepSeekMath)对每个输入采样一组输出,用组内相对优势做策略优化,无需另训价值模型。本文用它把多模态评估模型的打分对齐人类标注,输出奖励形如 $r_{total} = (2r_{struct} + r_{distill})/3$。
AVC-Reward 训练第二阶段就是 GRPO(结构奖励强制五阶段推理格式、蒸馏奖励对齐人类分数),而且它最终又被用作 LTX-2 生成侧在线 RL 的奖励,是贯穿全文的训练机制。
全模态大语言模型(Omni-MLM)
能同时接收文本、图像、视频与音频输入并做链式推理的大语言模型,如 Qwen3-Omni-Thinking、Gemini 系列。它们可以在统一推理过程中完成音视频内容理解、事件定位与结构化分析,输出 JSON 风格的结构化记录而非单一数值。
AVC-Reward 以 Qwen3-Omni-Thinking 初始化,五阶段评估就是该模型执行的一条结构化思维链;论文的零样本裁判基线(Gemini-3.1-Pro、Qwen3-Omni-Instruct)和标注流水线(Gemini 2.5 Pro、Qwen3-VL-Max)也都是此类模型。
Δ-Pairwise 准确率与 PLCC/SRCC
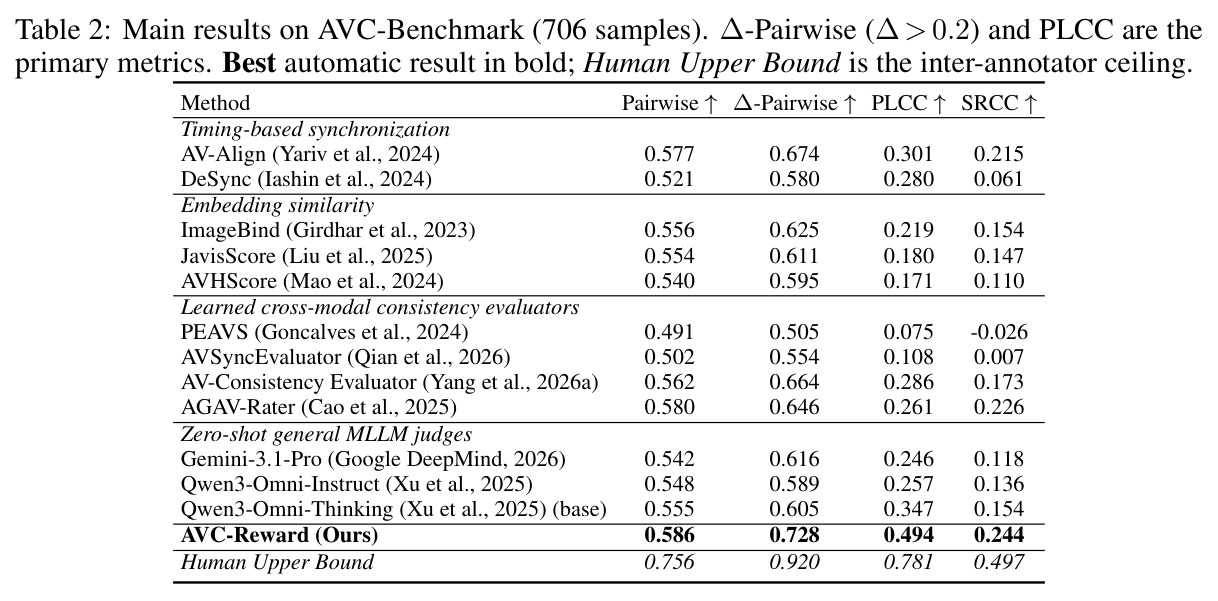
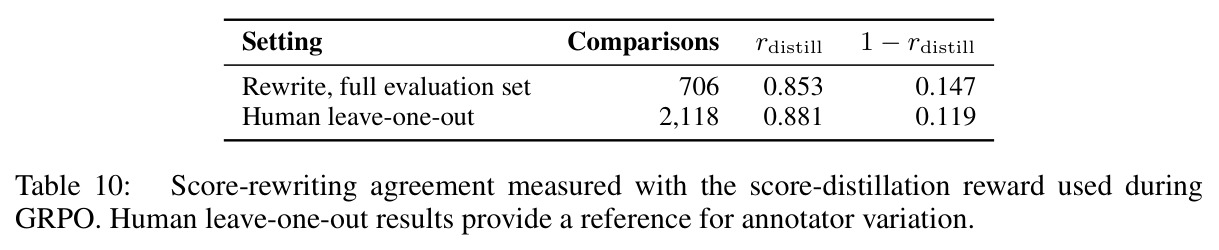
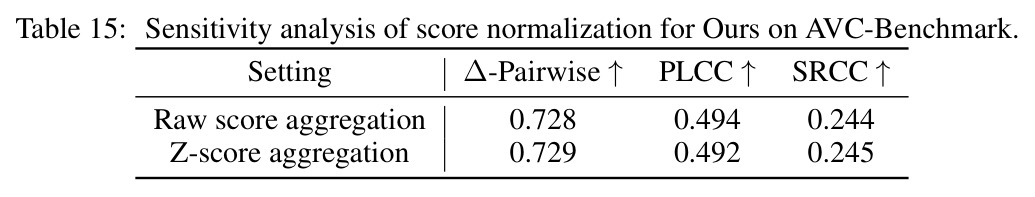
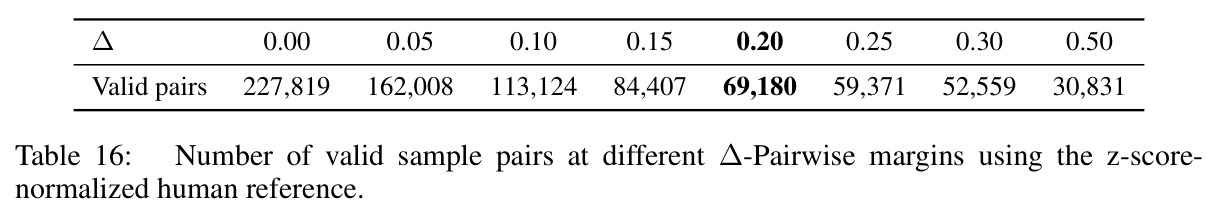
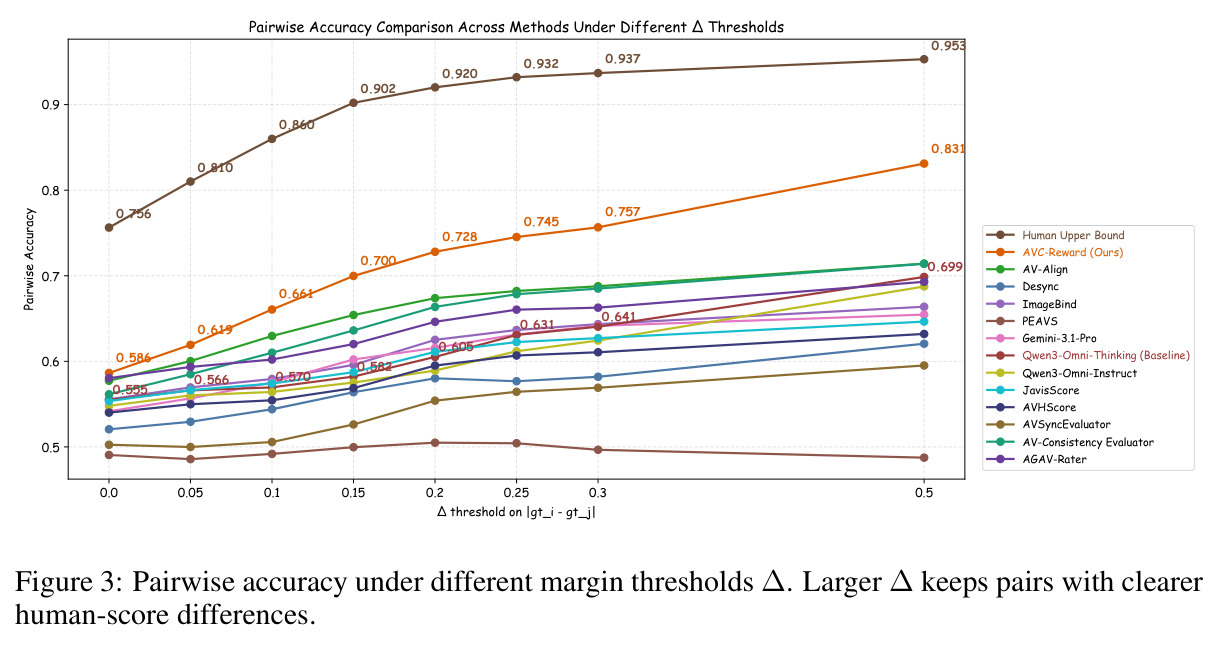
评估自动指标与人类感知一致性的三种统计量。Δ-Pairwise 只取人类分数差超过阈值的样本对,统计指标排序与人类一致的比例,$\Delta=0.2$ 可滤掉几乎并列、主观性强的样本对;PLCC 在经五参数 logistic 映射后度量线性相关,SRCC 度量秩相关。「人类上界」由标注者间一致性给出(本文为 0.756/0.920/0.781/0.497)。
论文的主指标是 Δ-Pairwise@0.2 加 PLCC,所有方法对比和人类上界的含义都依赖这套度量,读懂实验表必须先理解它们。
SFT 冷启动
强化学习前的监督微调:在包含完整推理链的目标输出上直接训练模型,使其先学会任务流程与输出格式,再用 RL 做偏好对齐。本文 SFT 目标形如 $\langle think\rangle C \langle /think\rangle\{S_{mac}, S_{temp}, S_{attr}, \kappa\}$,其中 $C$ 保留五阶段推理顺序,$\kappa$ 是诊断结论。
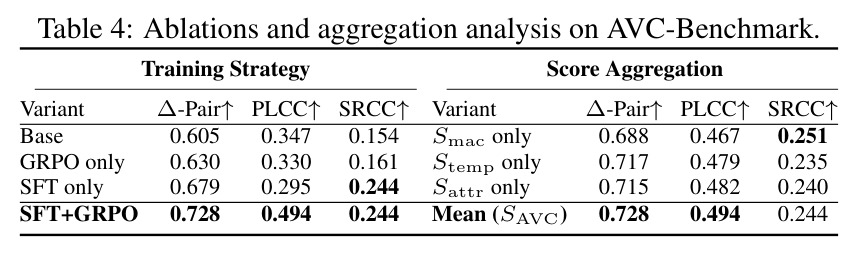
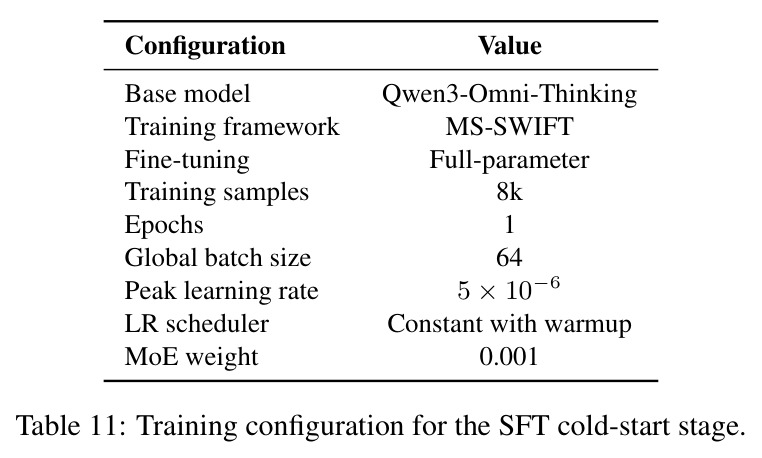
AVC-Reward 先用约 8k 条五阶段结构化标注做 SFT 冷启动、再用 GRPO 对齐人类;消融显示 SFT+GRPO(0.728)远超单独 GRPO(0.630),理解这一两段式训练是理解方法贡献的前提。
研究动机
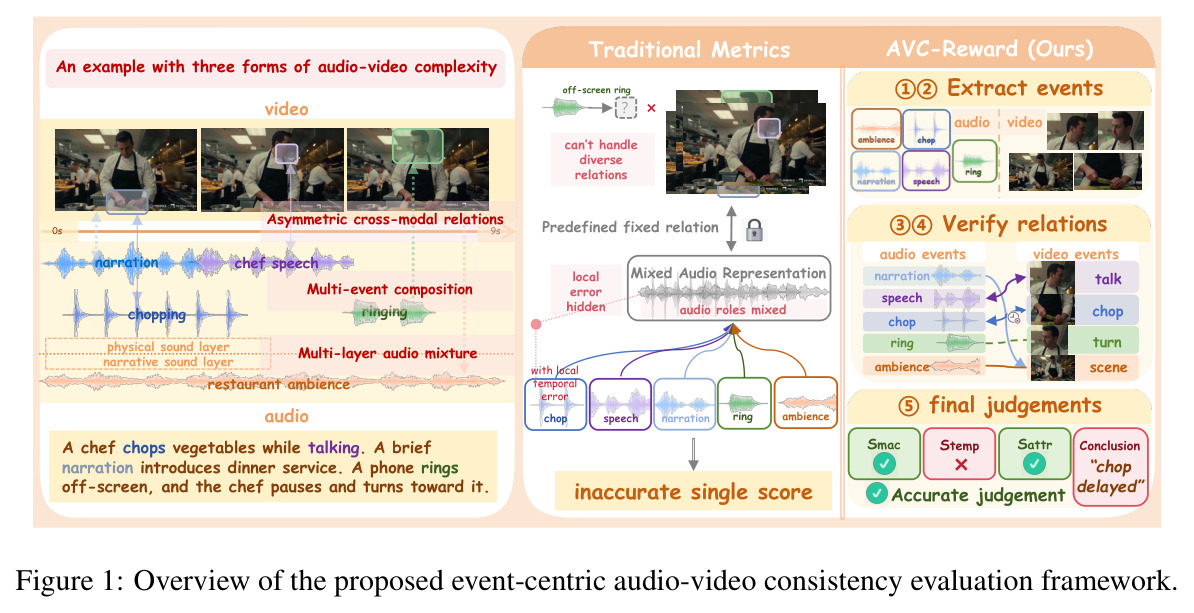
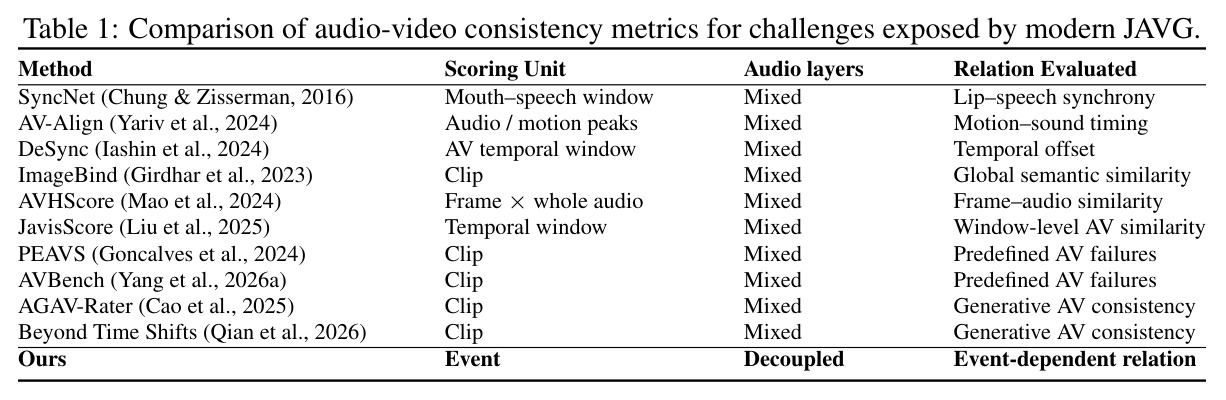
音视频生成正从单向驱动(音频驱动视频的口型同步、视频驱动音频的拟音)走向联合生成,Veo 3、MiniMax H3、Seedance 2.0 等系统已能生成多事件并发、旁白与背景音乐混合、画外音存在的复杂场景。但评估方法论没有跟上:现有指标大多沿用简单单向任务时代的工具。ImageBind 类指标(含 AVHScore、JavisScore)把整段音频和视频压入共享嵌入空间算总体相似度,只要主导语义匹配,局部事件错位或幻觉仍可拿高分;DeSync/Synchformer 在混合音轨上直接回归全局时间偏移,不区分「需要与画面逐帧同步的物理音效」和「无需同步的 BGM、旁白」,混合音频使偏移估计失真;AV-Align 匹配音频起始点与视觉运动峰值,会把没有画内视觉证据的合法画外音(如画外响起的电话)当作错误惩罚。作者在其基准上实测:现有方法与人类判断的 Δ-Pairwise@0.2 最高只有 0.674,PLCC 普遍低于 0.3,与人类感知差距巨大。
本文的目标是作者要构建一个能跨生成范式(联合生成 JAVG、视频生音频 V2A、音频生视频 A2V)和复杂关系通用的音视频一致性评估器,具体目标有三层:其一,把音视频一致性形式化为以事件为中心、由粗到细的三级指标,能分别评估重叠事件、区分音频层不同角色(物理声与叙事声)、并容纳画外音等非对称关系;其二,把指标实例化为可训练的奖励模型 AVC-Reward,除分数外还输出可解释的结构化评估理由,能定位生成失败的具体事件(如某个时间错位的事件或幻觉出来的声音);其三,构建 AVC-Benchmark 度量自动指标与人类感知的一致性,并验证该指标可充当在线 RL 训练信号,直接改进 LTX-2 的音视频一致性,闭合「生成—评估—优化」的循环。
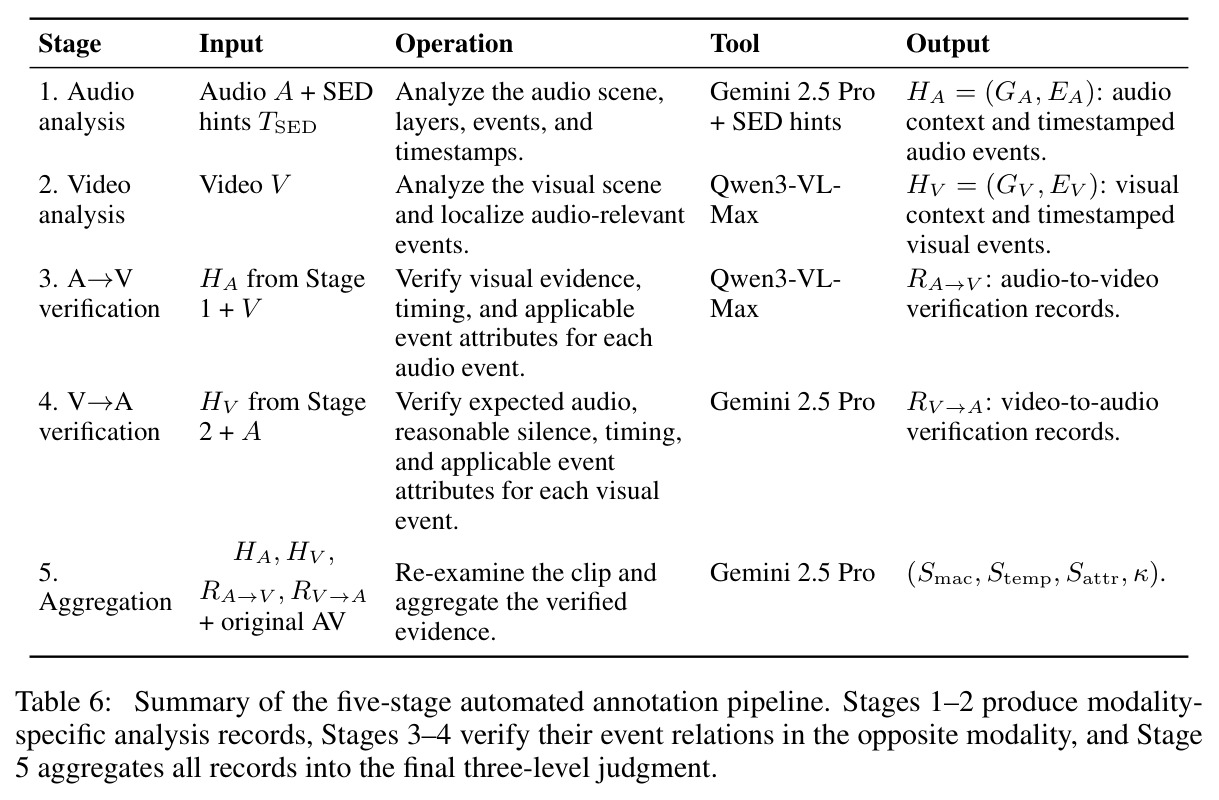
与已有工作不同的是,本文的独特切入点是「先拆解事件、再交叉验证、最后聚合」的事件中心视角:不整段直接打分,而是先做纯音频分析(blind)与纯视频分析(deaf)两个独立阶段,避免过早的跨模态信息污染事件发现;再对每个事件做 A→V 与 V→A 双向跨模态验证,产出的关系记录允许任何一侧缺失,从而在同一形式体系下自然表达画外音、合理静默等非对称关系。第二个差异是评估器本身用 SFT+GRPO 训练,结构奖励强制模型复现五阶段推理过程而非直接吐分数,分数蒸馏奖励对齐经 39 标签体系校准的人类标注。第三个差异是定位:它不只是离线指标,而是首次被系统地用作联合生成模型的在线 RL 奖励——在 OmniNFT 框架里替换 DeSync 训练 LTX-2——完成从「评估器」到「训练信号」的角色扩展。
核心方法
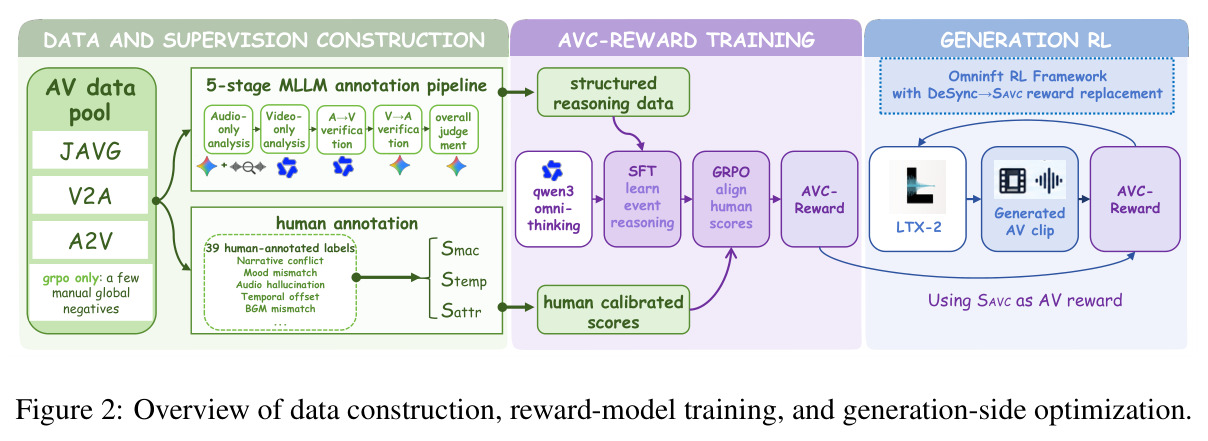
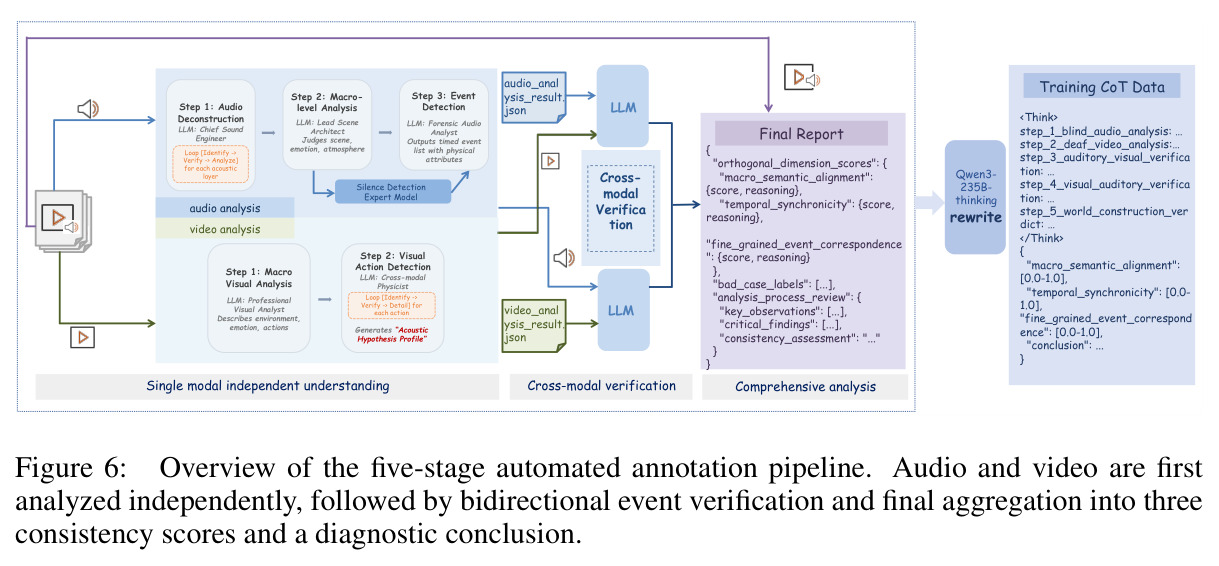
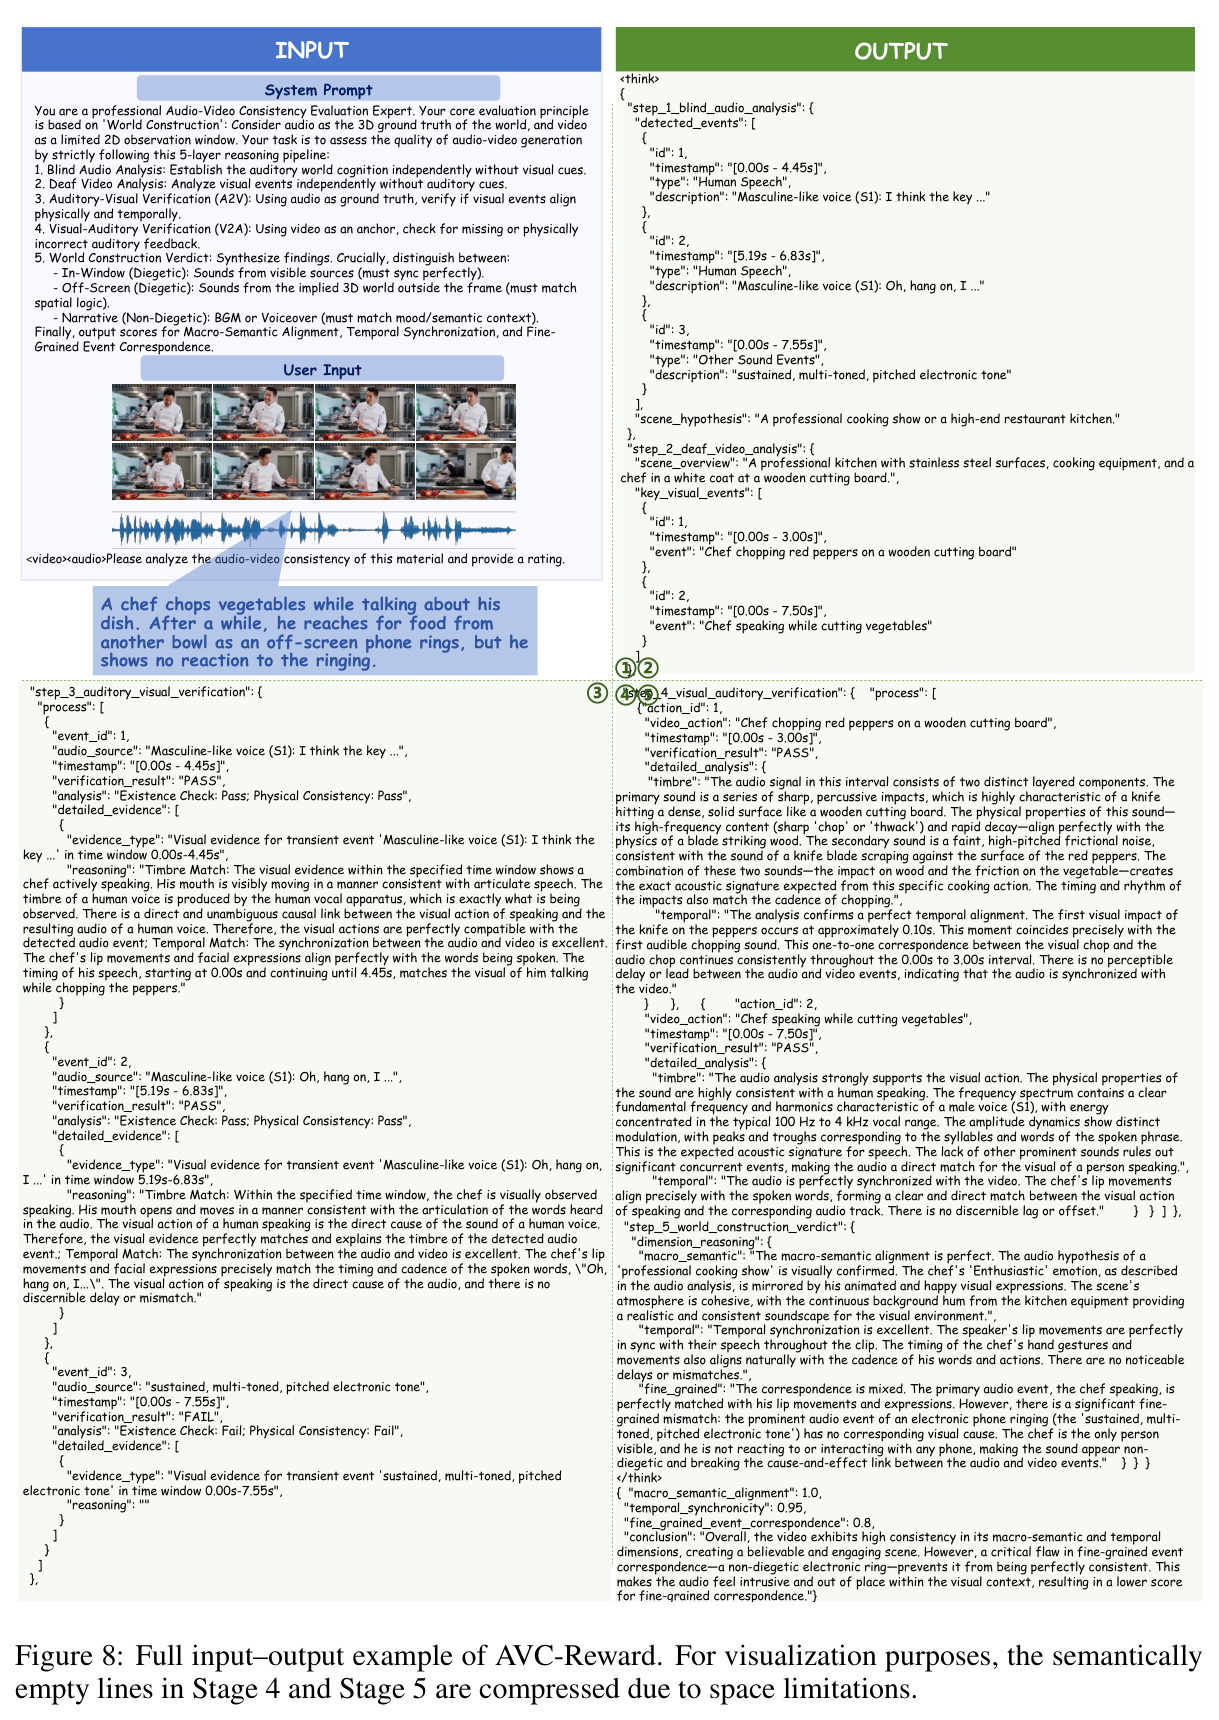
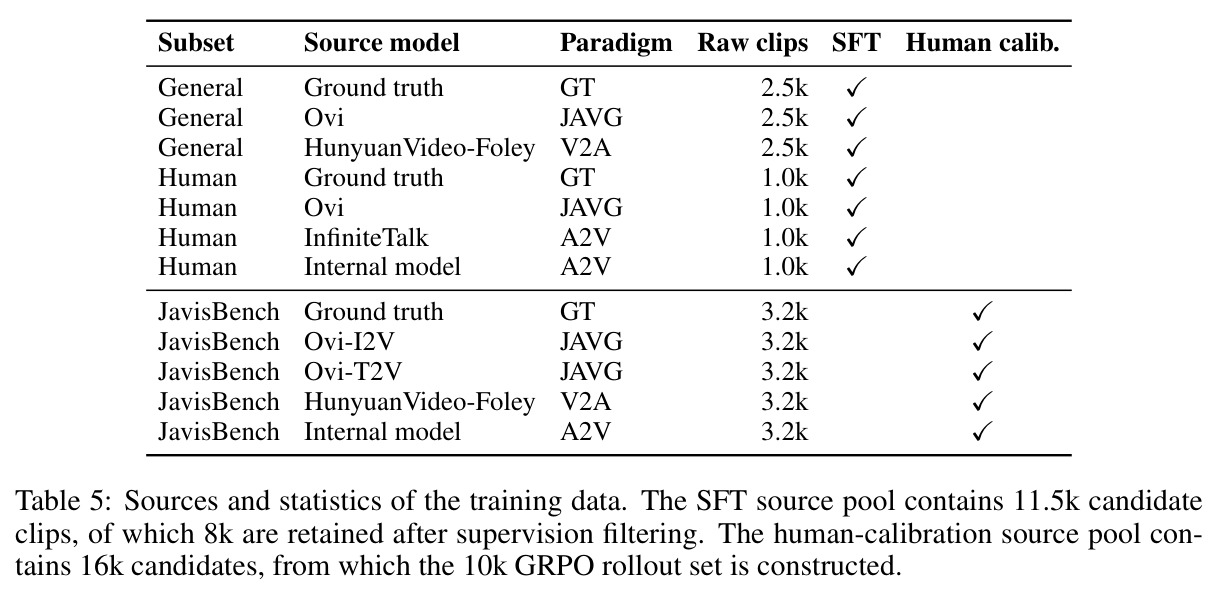
直觉上,评估一段音视频就像配音师看片:先闭眼听完整条音轨建立「世界认知」,再静音看画面,然后逐个事件核对「这个声音有视觉证据吗、这个动作应该有声音吗」,最后从整体到细节分层裁决。技术上,AVC-Reward 以 Qwen3-Omni-Thinking 为基座,把这一直觉固化为五阶段结构化推理链:纯音频分析、纯视频分析、A→V 验证、V→A 验证、总体裁决,最终输出三个 $[0,1]$ 分数:全局叙事一致性 $S_{mac}$、事件级时间同步 $S_{temp}$、细粒度属性对齐 $S_{attr}$,总分取算术平均 $S_{AVC} = \frac{1}{3}(S_{mac} + S_{temp} + S_{attr})$。训练分两阶段:先用约 8k 条由 Gemini 2.5 Pro 与 Qwen3-VL-Max 协作标注、Qwen3-235B 改写整合的五阶段结构化样本做全参数 SFT 冷启动;再在 1 万条经 39 标签人类标注体系校准的样本上做 GRPO,奖励为 $(2r_{struct} + r_{distill})/3$,兼顾推理结构完整与分数对齐人类。
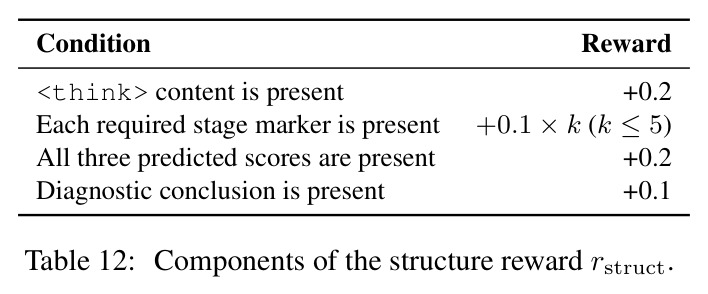
与已有方法的本质区别在「评估单元与关系」:过去方法以 clip 或时间窗为单元、依赖预定义关系(全局嵌入相似度、时间偏移、起始点-峰值匹配);AVC-Reward 以事件为单元,每对音视频事件之间该检查什么关系取决于事件本身。音频事件携带来源角色 $\lambda \in \{\text{physical}, \text{narrative}\}$:画内物理声要求双向证据与精确同步;画外物理声即使无可见声源,只要后果可见合理(厨师闻声回头)即判合法;叙事层音频只需语义与情绪契合。双向验证形成交叉检查:A→V 能发现「听觉幻觉」(有声音无来源),V→A 能发现「声音缺失」(张嘴无声),自然静默被显式标记为合理静默而非错误。GRPO 的设计同样独特:结构奖励 $r_{struct}$ 检查五阶段标记与输出格式(低于 0.4 触发门控,$r_{distill}$ 清零、总奖励减半),防止「答案对但推理崩坏」;分数蒸馏奖励 $r_{distill} = \frac{1}{3}\sum_{i=0}^{2}\exp[-w_i(pred_i - ref_i)^2]$ 对齐全维分数,并对少见的全局不一致样本用自适应权重 $w_0 = \max(1.0, 10 - 10\,ref_0)$ 加大惩罚。
方法步骤详情
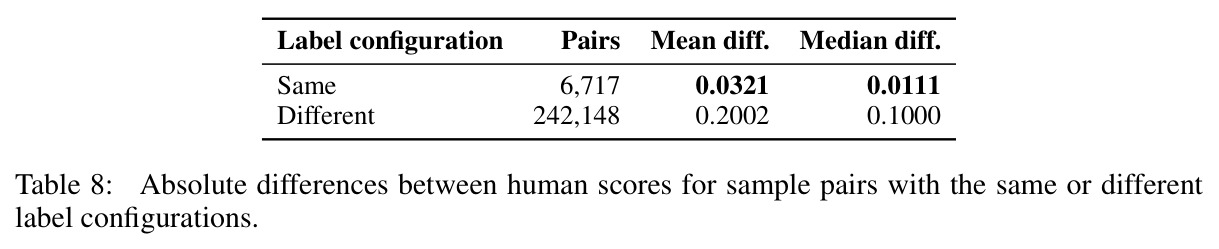
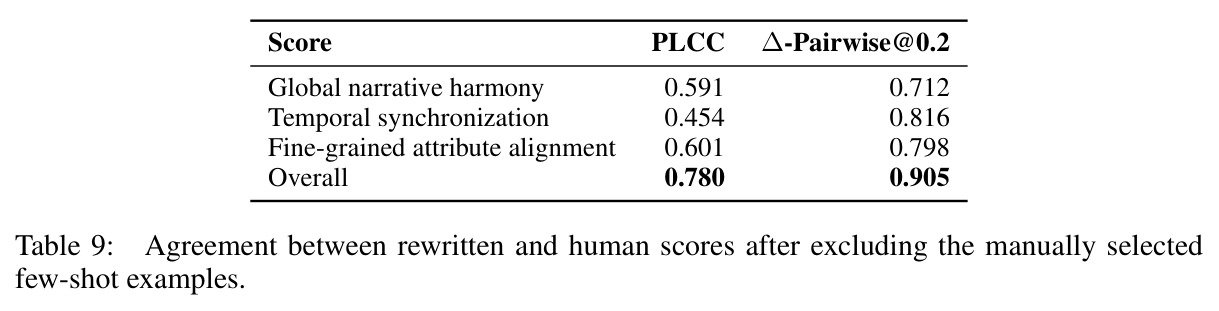
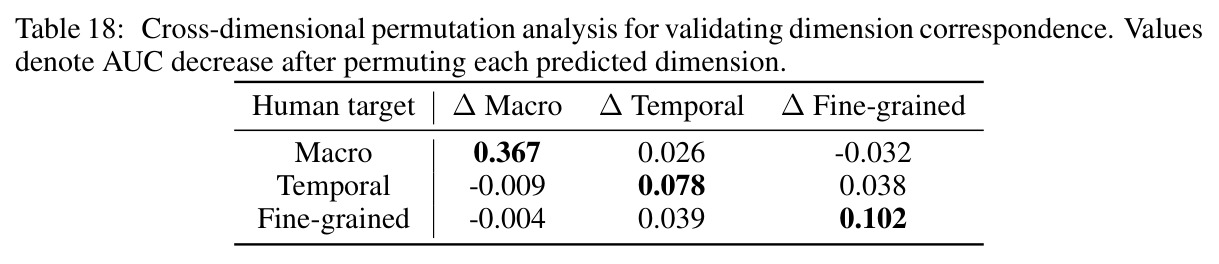
阶段1 纯音频分析:输入音频 $A$(附静音检测器时间提示),由 Gemini 2.5 Pro 输出 $H_A=(G_A, E_A)$,$E_A$ 为带时间戳的音频事件集,每事件记录起止时间、类别(语音/音乐/其他物理声)、来源角色 $\lambda$ 与声学属性。阶段2 纯视频分析:输入视频 $V$,由 Qwen3-VL-Max 输出 $H_V=(G_V, E_V)$,视觉事件记录发声动作、形态与位置,静默动作保留为上下文。阶段3 A→V 验证 $R^{A\to V} = F^{A\to V}(H_A, V)$:在每个音频事件时间窗内搜索视觉证据,短事件直接核对动作,连续事件核查全程最小可见证据;无可见声源被保留为证据供画外音判断而非直接判错。阶段4 V→A 验证 $R^{V\to A} = F^{V\to A}(H_V, A)$:先判断动作是否本应发声——自然静默标记合理静默并给予完整时间分,发声动作缺音频记存在性失败;输出关系记录 $r^k = (e^A_i, e^V_j, \rho^k)$,允许任一侧为空。阶段5 总体裁决:重看原始音视频,输出 $S_{mac}=\Phi_{mac}(G_A, G_V)$、$S_{temp}=\Phi_{temp}(R)$、$S_{attr}=\Phi_{attr}(R)$ 及诊断结论 $\kappa$。数据构造:五条结构化记录由 Qwen3-235B 串联改写为单一 SFT 目标 $\langle think\rangle C \langle /think\rangle\{S_{mac}, S_{temp}, S_{attr}, \kappa\}$,过滤后留约 8k 条;SFT 全参数 1 epoch、批 64、学习率 $5\times10^{-6}$。人类侧先用 39 标签体系(全局 5 类、时间维 25 类、属性维 9 类)先标注后打 0-1 分,Qwen3-235B 以 10 个少样本示例把标签映射为分数,产出 1 万条 GRPO rollout(JavisBench 五来源各 3.2k、正负 3:1 混合,加跨簇音频交换的全局负样本);GRPO 组大小 8、1700 步、批 32、学习率 $10^{-6}$、KL 系数 0.05。
技术新颖性
其一,指标层创新:首个以事件为评分单元、显式解耦音频层角色的音视频一致性指标——论文 Table 1 显示此前 10 个方法全部使用 Mixed(混合)音频层和固定关系,只有本文做到 Event 单元、Decoupled 音频层与「依事件而定」的关系评估。其二,表达力创新:用「允许缺边」的关系记录 $r^k=(e^A_i, e^V_j, \rho^k)$ 统一表达非对称关系,使画外音与合理静默成为形式体系的一部分而非特例补丁。其三,训练工程创新:把「级联专家流水线」蒸馏进单模型——五阶段过程控制(独立分析防交叉污染、时间戳作为证据接口、先存在性后时序属性的条件验证、双向交叉检查、聚合阶段复读原片兜底)经 SFT 写入模型,再由结构奖励约束的 GRPO 防止能力塌缩。其四,监督设计创新:标签优先的人类标注(先选 39 类失败标签再打分)加 LLM 少样本「标签→分数」校准,解决了直接连续打分噪声大、难核验的问题。其五,闭环验证创新:把评估器作为在线 RL 奖励接入 OmniNFT 训练 LTX-2,实现了从离线指标到训练信号的完整证据链。
实验结果
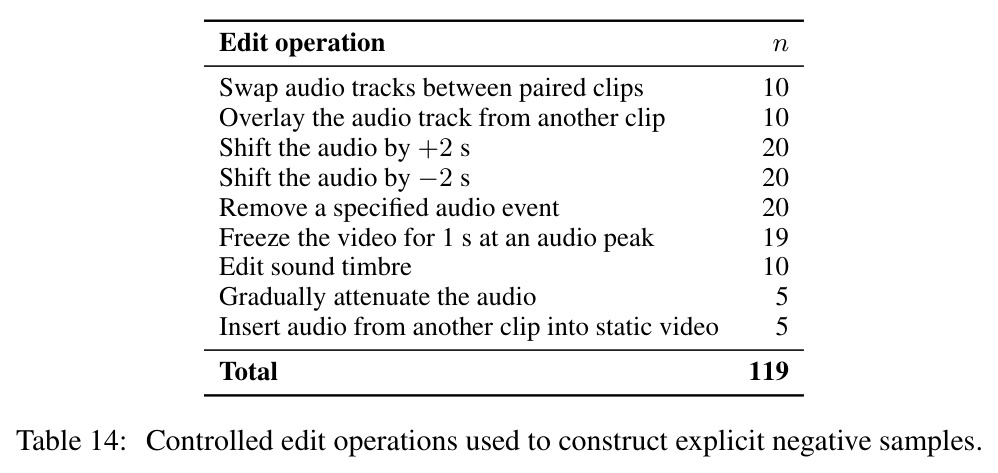
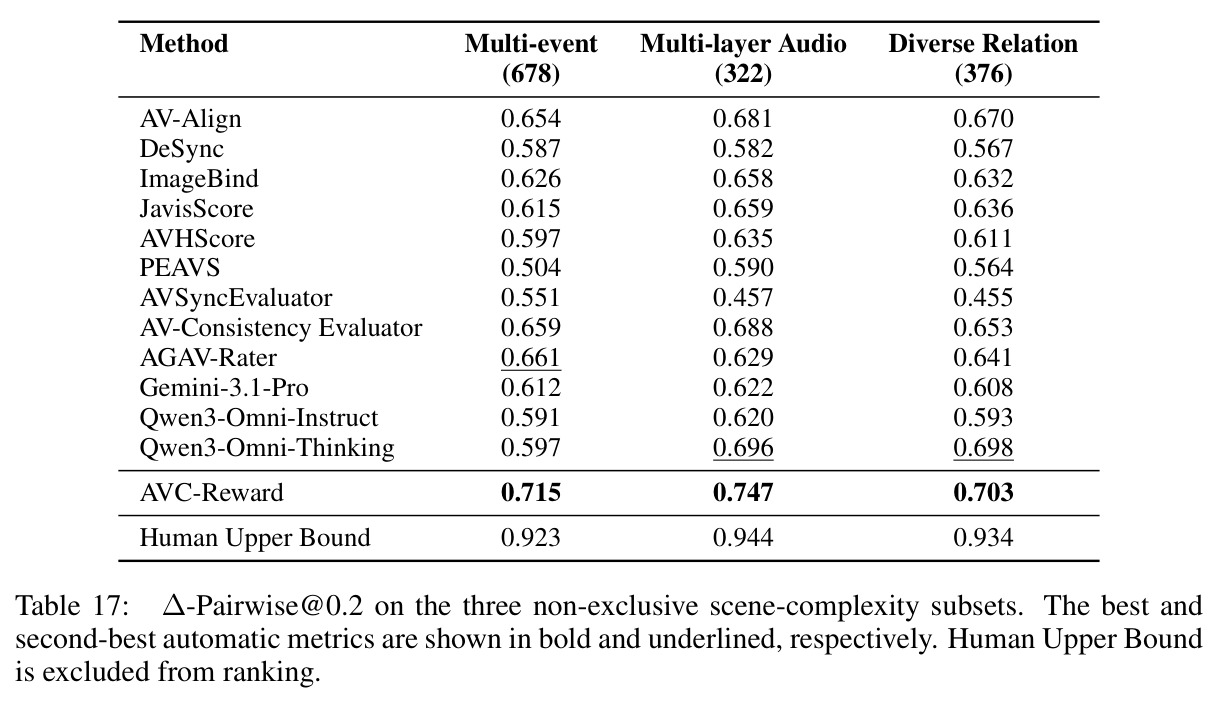
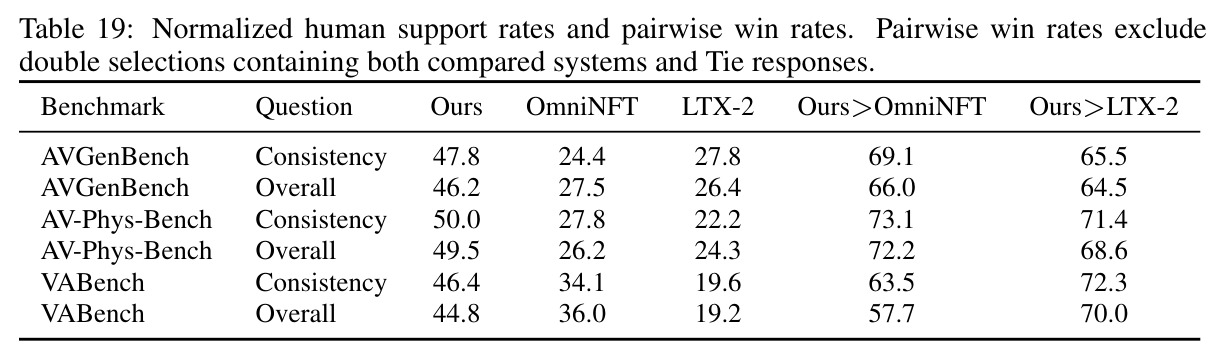
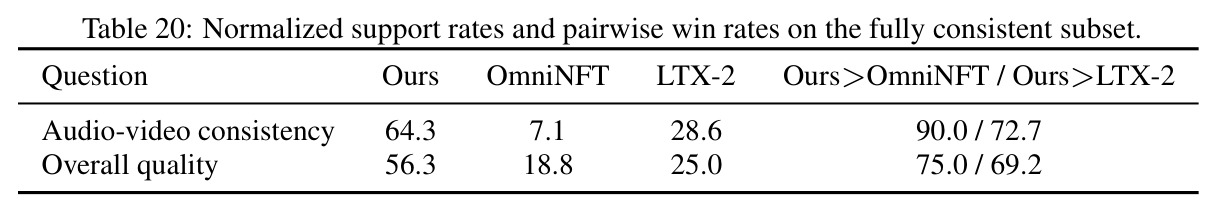
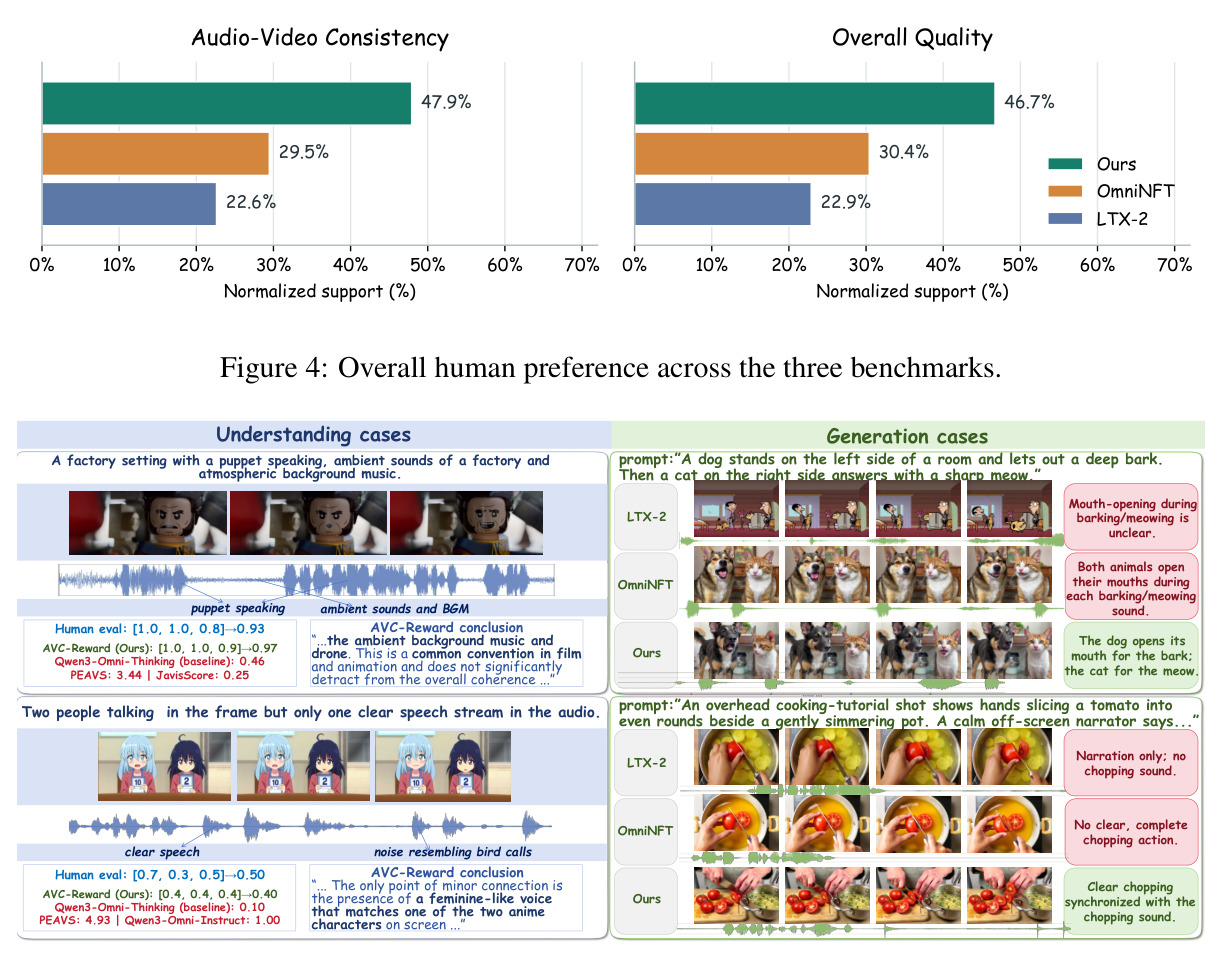
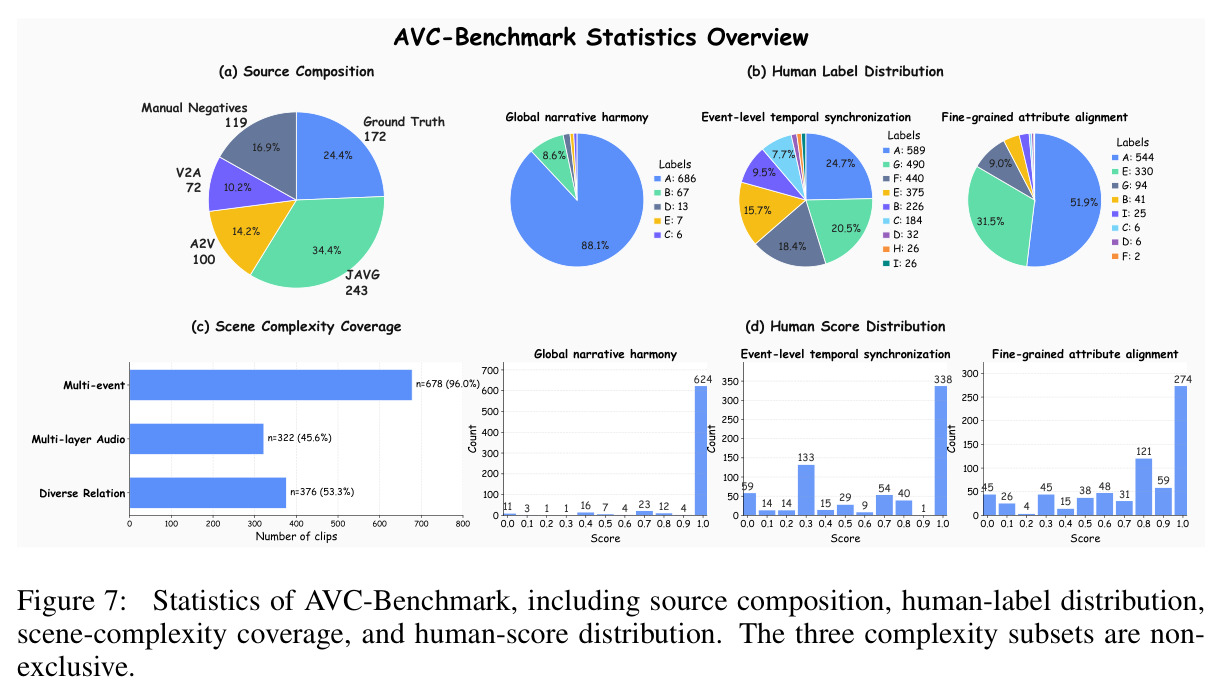
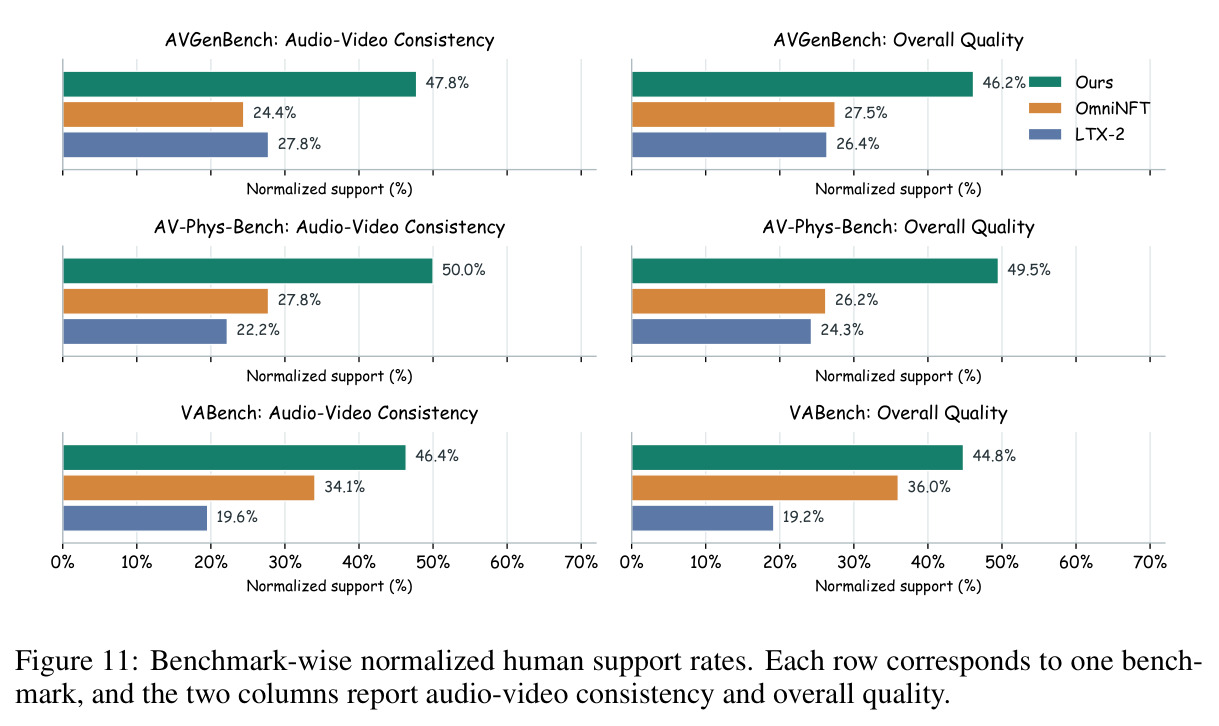
评估有效性:在 706 样本的 AVC-Benchmark(172 真值 + 243 JAVG + 100 A2V + 72 V2A + 119 构造负样本)上,AVC-Reward 在四项指标全部领先 12 个自动基线:Pairwise 0.586、Δ-Pairwise@0.2 0.728(最佳基线 AV-Align 0.674、AGAV-Rater 0.646、基座模型 0.605)、PLCC 0.494(基座 0.347)、SRCC 0.244;人类上界为 0.756/0.920/0.781/0.497。三个复杂性子集上优势更明显:多事件(678 样本)0.715 对次优 0.661,多层音频(322)0.747 对 0.696,多样关系(376)0.703 对 0.698。生成侧:在 OmniNFT 框架下对 LTX-2 做在线 RL、仅把 DeSync 奖励换成 $S_{AVC}$,AVC-Score 在 AV-Phys-Bench/VABench/AVGenBench 从 0.756/0.764/0.786 升至 0.819/0.850/0.849(+8.35%/+11.17%/+8.02%);对外部未见指标泛化显著:IB-AV +20.65~28.35%、AV-Align +18.78~59.47%、JavisScore +20.47~28.74%、AVHScore +22.00~26.80%,DeSync 也提升 +69.27~85.03%。文本对齐(IB-TV、CLIP)小幅下降但 AV 增益覆盖损失,单模态质量(AQ/VQ)持平或更好。消融:SFT+GRPO 的 Δ-Pair 0.728 远超仅 GRPO 0.630 与仅 SFT 0.679;三维平均 0.728 优于任何单维(0.688~0.717)。人类盲测(100 prompts、10 名标注者):Ours 在一致性与整体质量上支持率最高,为 47.9% 与 46.7%;三人全一致子集上支持率 64.3%(OmniNFT 7.1%、LTX-2 28.6%),成对胜率 90.0%/72.7%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 音视频一致性评估(AVC-Benchmark,706 样本) | Δ-Pairwise@0.2 | 0.728 | AV-Align 0.674;AGAV-Rater 0.646;Qwen3-Omni-Thinking 基座 0.605 | 较最佳自动基线 +0.054,人类上界 0.920 |
| 音视频一致性评估(AVC-Benchmark) | PLCC(五参数 logistic 映射后) | 0.494 | Qwen3-Omni-Thinking 基座 0.347;AV-Align 0.301 | +0.147(相对提升约 42%),人类上界 0.781 |
| 生成优化·AV-Phys-Bench(LTX-2 + OmniNFT RL) | AVC-Score | 0.819 | LTX-2 原始 0.756;OmniNFT(DeSync) 0.780 | 较 LTX-2 +8.35%;IB-AV +22.92%、AV-Align +55.50% |
| 生成优化·VABench-T2AV | AVC-Score | 0.850 | LTX-2 原始 0.764;OmniNFT(DeSync) 0.791 | 较 LTX-2 +11.17%;AV-Align +59.47%、DeSync +85.03% |
| 生成优化·AVGenBench | AVC-Score | 0.849 | LTX-2 原始 0.786;OmniNFT(DeSync) 0.808 | 较 LTX-2 +8.02%;JavisScore +28.74%、AVHScore +23.98% |
| 人类盲测·三人全一致子集(100 prompts) | 归一化支持率(音视频一致性) | 64.3% | OmniNFT 7.1%;LTX-2 28.6% | 成对胜率 90.0%(对 OmniNFT)/ 72.7%(对 LTX-2) |
局限与改进
作者承认或可从数据推断的局限:即便全面领先,与人类上界差距仍大——Δ-Pairwise 0.728 对 0.920、PLCC 0.494 对 0.781、SRCC 0.244 对 0.497;生成优化中 CAVP 变化小于 1.7%,对部分维度区分有限;更强的 A-V 优化带来文本对齐(IB-TV、CLIP)轻微下降。我自己的观察:其一,总分是三维等权算术平均,作为 RL 奖励时丢失了「哪个维度失败」的结构信息(诊断结论 $\kappa$ 只存在于文本中,未进入奖励);其二,标注流水线依赖 Gemini 2.5 Pro、Qwen3-VL-Max、Qwen3-235B 等强模型,教师偏见可能被蒸馏进学生模型;其三,训练数据含内部 A2V 模型输出,外部无法获取,数据管线不能完全复现;其四,706 样本规模适中,构造负样本依赖 ±2s 平移、音轨交换等低层编辑,覆盖不了真实生成中更隐蔽的语义级失败;其五,生成侧验证仅限 OmniNFT 加 LTX-2 单一组合,奖励权重靠手工两段式调度(Stage 1 权重 2.0、600 步,Stage 2 权重 1.2、275 步),迁移性未验证;其六,人类标注者间 SRCC 仅 0.50,真值噪声本身限制了可测上限。
独立分析的弱点
弱点一:分数天花板受限于基座的音视频感知能力。属性级判断(音色-材质匹配、口型与语音)依赖 Qwen3-Omni 的原生编码器,PLCC 与人类上界 0.29 的差距说明模型对许多细微声学差异仍「看不清」。改进方向:引入音源分离、声音事件检测等工具调用,或用属性级监督微调音频编码器。弱点二:推理成本高。五阶段长思维链意味着 RL rollout 中每个候选视频都要生成完整推理(数千 token),大规模生成优化代价可观。改进方向:蒸馏出轻量直出分数版,大模型只仲裁争议样本。弱点三:等权平均次优。消融显示单用 $S_{temp}$ 已达 0.717 接近总分 0.728,说明维度贡献不均;改进方向是学习自适应维度权重,或把三个维度作为多目标 RL 信号分别优化。弱点四:分布依赖。GRPO rollout 集基于 JavisBench 来源构建、用 ImageBind 嵌入聚类采样,当生成模型迭代出新的失败分布时奖励模型可能失配,需要持续校准机制。弱点五:基准负样本以低层编辑为主(移位、交换、删轨),缺少「语义级」负样本(如音效语义与画面细节矛盾),可能高估实际场景中的表现。
未来方向
作者明确的延伸是把「生成—评估—优化」闭环继续推进,在此基础上可设想:(1) 直接用三个维度分数与诊断结论 κ 驱动维度级定向修复——对时间偏移做时序条件化重生成、对属性失配做音色条件化控制;(2) 把事件中心协议扩展到长视频与流式生成的分镜级一致性、多镜头叙事连贯性;(3) 与 AV-Phys-Bench 等物理理解基准结合,评估「声音-材质-运动」的物理合理性;(4) 鉴于现有指标间交叉一致性很低(Sharma & Tapadiya, 2026),可把多个评估器组成委员会投票或互为交叉验证,构造更稳健的训练信号;(5) 把 AVC-Benchmark 扩展到多语言、图像+音频编辑与续写范式,以及更细的画外音-反应关系标注;(6) 探索测试时计算扩展:对高难度事件自适应加深验证深度、对每个事件多次采样取共识;(7) 反向利用奖励模型:把 AVC-Reward 的结构化输出作为拒绝采样数据,迭代改进生成器自身对音视频关系的理解能力。
复现评估
开源情况:项目页 tsuki0512.github.io/AVC-Reward.github.io 公开,GitHub 仓库承诺提供 SFT 数据筛选问题、奖励模型完整 prompt、标签到分数的改写 prompt;基座 Qwen3-Omni-Thinking 与训练框架 ms-swift 均开源;Ovi、HunyuanVideo-Foley、InfiniteTalk、JavisBench 等数据来源公开可得。阻塞点:训练数据含一个内部 A2V 模型的输出(SFT 池与校准池各 1k、3.2k 两处),外部拿不到;39 标签体系的人类标注流程也难以原样复制;生成侧实验依赖 LTX-2 与 OmniNFT 框架。算力门槛:对 Qwen3-Omni 规模的全模态 MoE 模型做全参数 SFT(8k 样本、批 64、1 epoch、学习率 $5\times10^{-6}$)加 GRPO(10k rollout、组大小 8、1700 步)需要多卡高显存集群,估计 8×A100/H100 起步;生成侧 RL 另需 LTX-2 训练资源。总体评估:只做推理评估(跑 AVC-Benchmark 或使用公开权重)门槛较低;从零复现训练属中高难度,主要受算力与内部数据缺失制约。
论文图表
左列两个理解案例:工厂木偶(语音+环境声+BGM 多层音频,人类 0.93,Ours 0.97,而基座 Qwen3-Omni 仅 0.46)与两人对话只有一条语音轨(人类 0.50,Ours 0.40,基座 0.10),显示 AVC-Reward 更接近人类并能定位问题;右列狗吠猫叫与烹饪旁白两个生成对比案例:优化后模型让狗和猫各自张嘴对应各自叫声、切菜动作与声音同步出现。
最直观地同时展示评估端(定位失败)与生成端(行为改善)的双重能力。
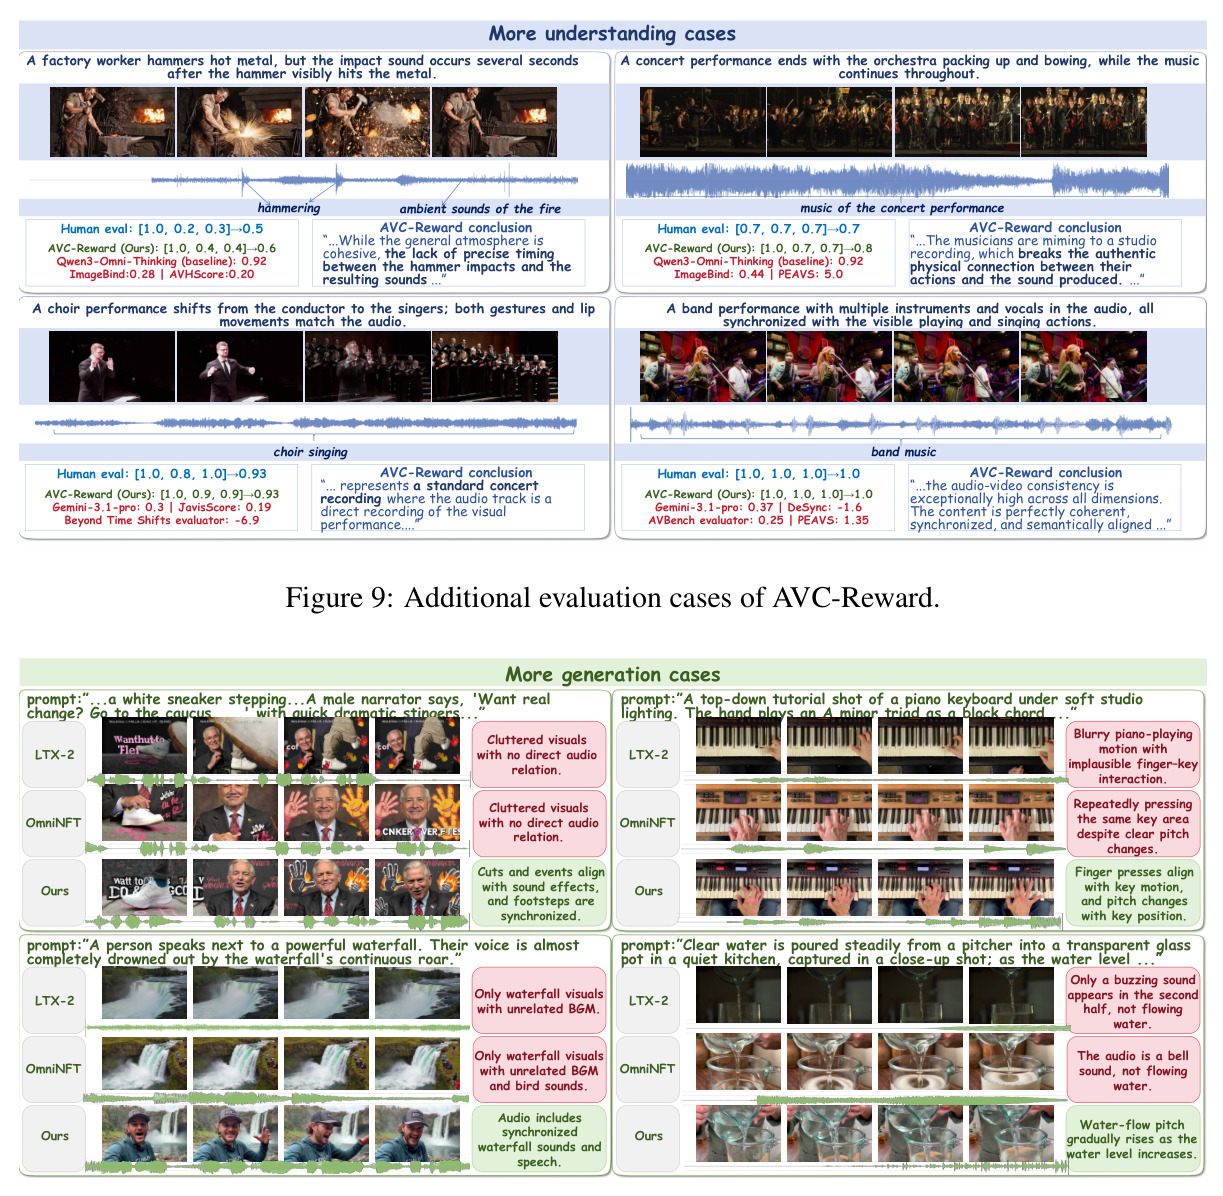
四个 prompt 的三方生成对比:竞选广告(LTX-2 画面杂乱无音频对应;Ours 的剪辑与音效对齐、脚步声同步);钢琴特写(OmniNFT 重复按同一琴键区无视音高变化;Ours 手指按压与琴键运动、音高与键位一致);瀑布旁说话(基线只剩瀑布声或无关 BGM;Ours 瀑布声与人声并存);倒水(基线出铃声或嗡嗡声;Ours 水流声随水位上升而音高渐升)。
定性展示事件级奖励带来的细粒度生成改善,与 Table 3 的定量增益互相印证。
(a) AV 一致性部分给出三个基准上 LTX-2、OmniNFT(DeSync)、Ours(AVC-Reward) 的 AVC-Score/DeSync/IB-AV/AV-Align/Javis/AVH/CAVP 绝对值与相对增益:Ours 的 AVC-Score 增益 +8.35%/+11.17%/+8.02%,IB-AV +20.65~28.35%,AV-Align 最高 +59.47%;(b) 文本对齐与单模态质量部分显示 IB-TV、CLIP 轻微下降(如 AVGenBench CLIP 0.296→0.289),但 AQ、VQ 反而提升(如 VABench VQ 2.200→4.421)。
支撑「评估器可作训练信号」的第二主张,并诚实展示文本对齐的代价。