Velox:空间记忆让世界模型更高效 Velox: Spatial Memory Makes World Models Efficient
免训练的视锥板注意力路由,让长视频世界模型在第48块时注意力提速4.36倍且质量几乎无损
前置知识
视频世界模型与分块自回归生成
以动作或相机运动为条件、自回归滚动生成未来视频帧的生成模型,即用视频扩散 Transformer 充当可交互的世界模拟器。分块生成指每次生成一个含 $T$ 帧 latent 的块 $x_c$,并把历史 KV 缓存 $C_{<c}$ 作为上下文,如 Genie、LingBot-Fast-Cam。
Velox 的加速对象正是这类模型的历史注意力;不理解分块自回归生成与 KV 缓存如何随生成进度增长,就无法理解「后期越生成越慢」这一核心瓶颈。
KV 缓存与 FlashAttention 分块注意力
历史 token 的键值在注意力中被缓存为 KV cache。FlashAttention 将 query 与 KV 切成固定 tile 流式计算,是 IO 感知的稠密注意力基线;但仍需调度全部 $N\times M_c$ 个块对,代价 $O(NM_c b_{tok}^2 d)$ 随历史线性增长。
Velox 就在这套 tile 执行粒度上做路由:跳过整个 KV tile 才能同时省去 $QK^{\top}$ 计算和 KV 显存读取,这是其加速机理的物理基础,也是它选择块级而非 token 级稀疏的原因。
视锥板(frustum slab)与 OBB 重叠
相机视锥体是过图像矩形所有视线组成的棱台;视锥板是深度在 $[z^-, z^+]$ 之间的壳层,即屏幕区域对应的三维体积。Velox 用 token 矩形加百分位深度区间表示每个历史 KV 块,近似为面向相机的 OBB,以交集体积比度量两块的几何对应。
视锥板重叠分数 $g_{i,r}$ 与覆盖率 $\rho_i$ 是 Velox 路由信号的全部来源,是方法章节所有公式的核心对象,不理解这个几何原语就读不懂路由规则。
Gilbert 空间填充曲线
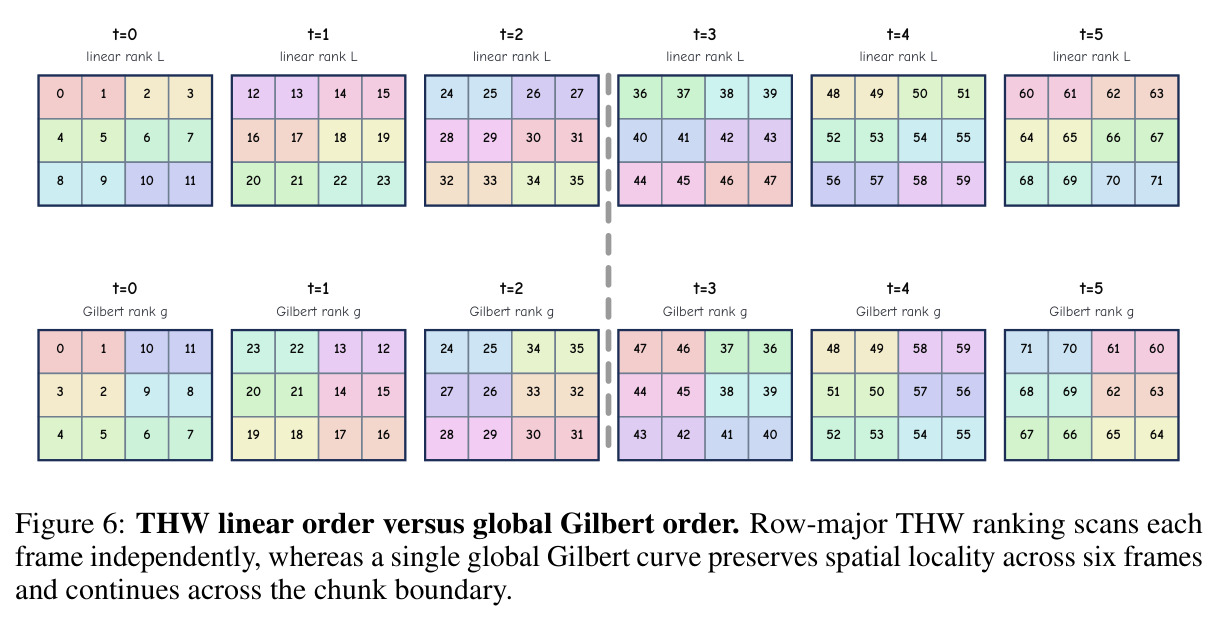
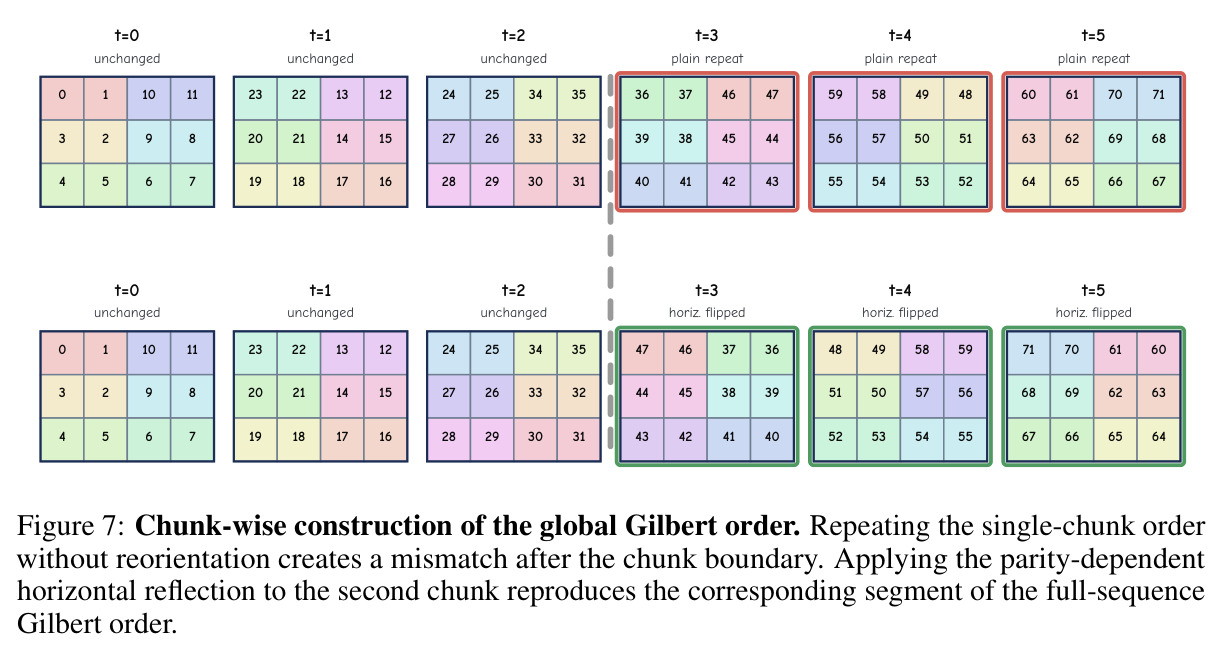
一类在二维网格上蜿蜒穿行、使空间相邻点在序列秩上也尽量相邻的曲线(类似希尔伯特曲线)。Velox 构造「全局对齐」的 Gilbert 序:先建单块曲线的秩映射,再按块序号奇偶性对块内坐标做水平翻转拼接,使跨块边界的邻居在全局序中依然相邻,因而无需单独维护跨块接缝表。
全局 Gilbert 序同时承担 KV 存储布局、26 邻域局部性保障与全局块 id 三重角色,稀疏内核的连续内存访问也依赖它;Figure 6、7 专门解释这一设计。
免训练软路由(training-free soft routing)
不微调预训练生成器,只在推理期修改注意力可见性。「软」指几何分数不直接替换模型选择,而是按 $\tilde{p}\propto p(1+\lambda\hat{g})$ 乘性调制每层自身的块重要性并归一化,再截断取块。
软融合与硬几何 top-K 的对立是本文的核心设计主张(每层保留各自偏好、未覆盖区域无偏回退),Table 2 的一致性审计与软融合校准实验都围绕这一点展开。
新者优先多视点前向扭曲(recency-priority multiwarp)
当前含噪块没有重建深度,需为目标块估计深度。Velox 缓存最近 $K=30$ 个已重建块首尾帧深度并前向扭曲到目标相机;每 token 只取「提供至少 $k_{warp}=2$ 个样本的最新帧」的中位数 $z^Q(u)$,避免新旧观测混合。
Q 深度是覆盖率判定与 OBB 重叠计算的查询侧输入,「新者优先」规则直接决定路由对场景重访、遮挡新露区域等情形的健壮性。
研究动机
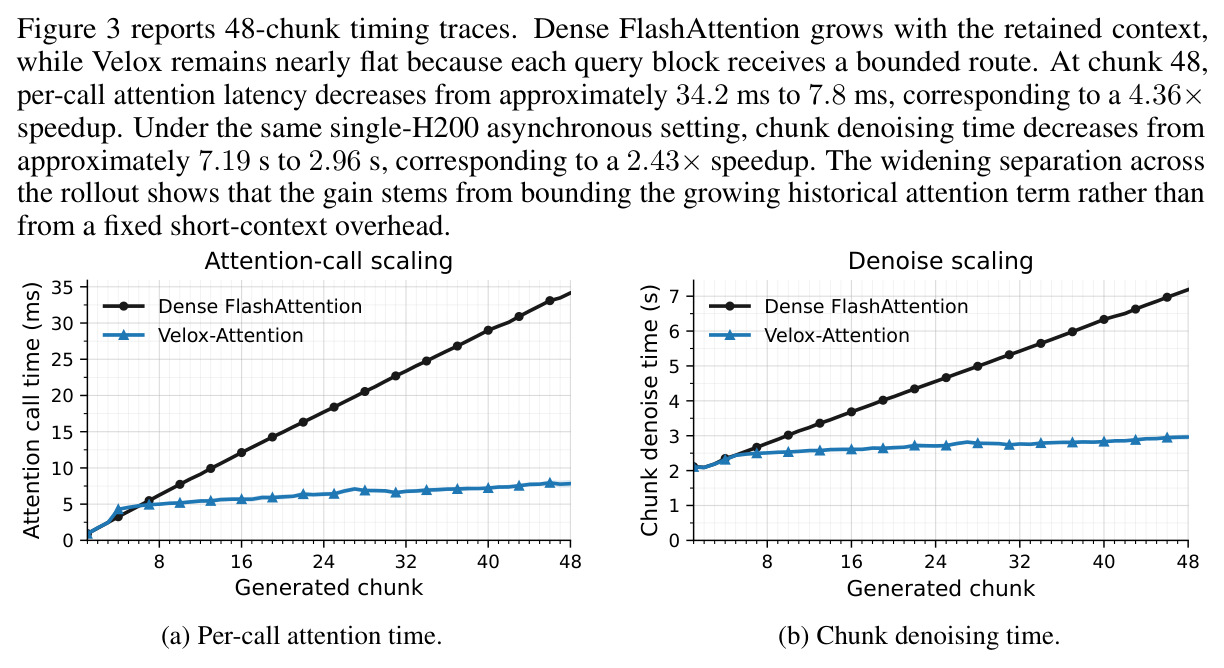
分块视频世界模型(如 LingBot-Fast-Cam)把全部历史存进视觉 KV 缓存,稠密 FlashAttention 必须调度当前块与全部 $M_c$ 个可见历史块之间的所有 tile 对,注意力代价 $O(NM_c b_{tok}^2 d)$ 随生成块数线性增长。问题在于:即使当前相机只与过去场景重叠一小部分,后续块依然继承全部上下文——恰恰在长时程一致性最关键的长滚动阶段,生成反而越来越慢。论文 48 块计时显示,稠密注意力的单次调用延迟到第 48 块涨到约 34.2 ms,单块去噪约 7.19 s。已有帧级/视图级记忆方法(Context-as-Memory 按视场角重叠检索、VMem 用 surfel 索引视图)只做整帧检索:同一噪声块内所有区域共享同一份上下文,选中帧内部仍是稠密注意力;而把扭曲点云渲染注入输入的方法(AnchorWeave 等)依赖 ControlNet 或微调,无法直接复用预训练生成器。
本文的目标是本文目标是:在不训练、不改动预训练分块视频生成器及其条件接口的前提下,把「历史记忆保留多少」与「每个区域实际看多少历史」解耦,让历史注意力代价从随长度 $M_c$ 增长降为固定路由预算。具体而言,在 FlashAttention 的 token 块粒度($b_{tok}=128$)上为每个当前 query 块分配各自相关的历史 KV 块路线:已被几何覆盖的区域应主要回看其对应的历史表面,新暴露或不确定的区域则回退到模型自身的语义路由;同时保留上一块与局部邻域保障以维持运动连续性。量化指标设定为:在单张 H200 上(几何构建与去噪异步共享同一 GPU),第 48 块时注意力加速 4.36 倍、去噪加速 2.43 倍,且在 WBench 导航全部 158 例上与稠密注意力的 API-free 平均分差距不超过 0.15 分。
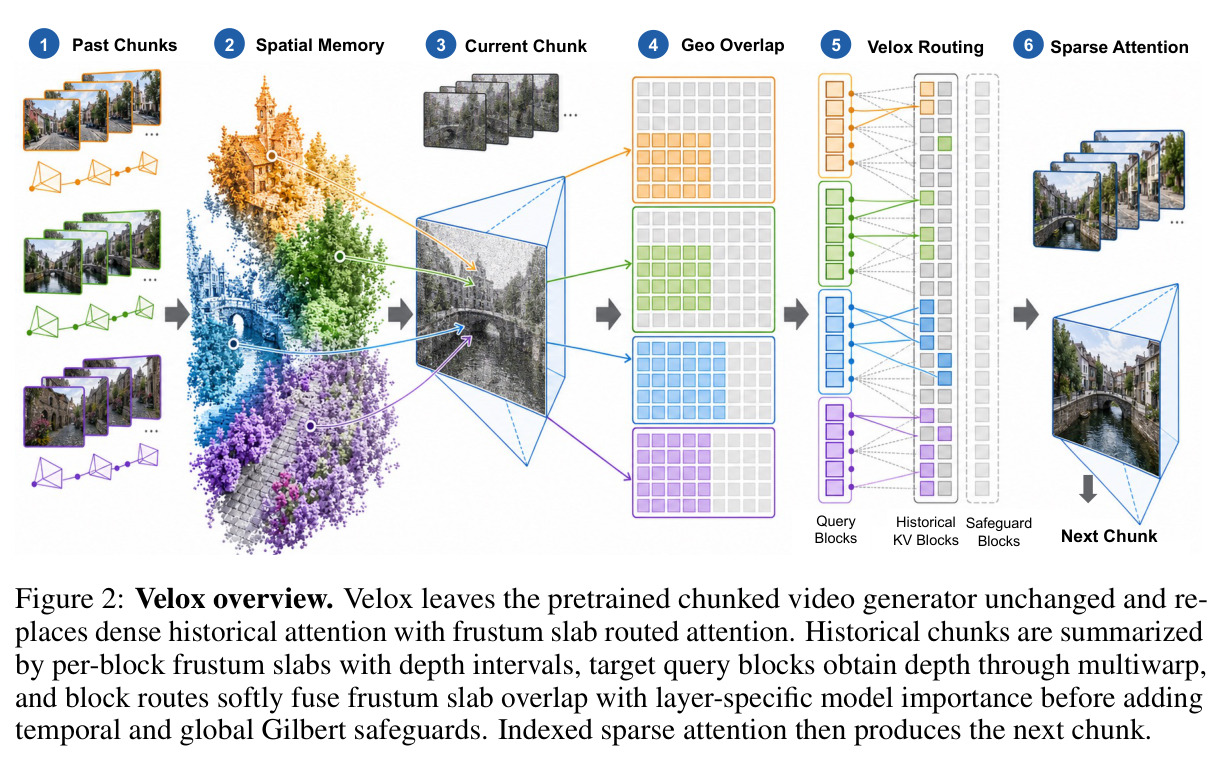
与已有工作不同的是,独特切入角度是把「空间记忆」从检索对象变成路由信号。此前工作要么按帧/视图检索记忆后仍在选中帧内做稠密注意力,要么把记忆渲染成图像经 ControlNet 注入(需要训练)。Velox 受逆渲染(3D Gaussian Splatting、NeRF)启发,观察到:几何上已观测过的区域应主要关注其对应的历史区域,而这层对应关系恰好可以在 FlashAttention 的 tile 粒度上用相机视锥板(token 矩形 + 深度区间)表达。于是它不检索帧、不加条件分支,而是把每个历史 KV 块摘要为视锥板原语,用世界空间 OBB 重叠分数软性调制每层自带的块重要性分布:给已覆盖区域注入几何偏置,给未覆盖区域(天空、新露表面)保留无偏的模型路由,用固定块路线取代 $1{:}M_c$ 的稠密调度。
核心方法
直觉先行:马路块、外墙块和刚露出的天空块不该看同样的历史——马路和外墙的几何早被观测过,应回看对应表面;天空没有几何对应,应靠语义上下文。Velox 保持生成器不变,仅改推理期 query 块与历史 KV 块的可见关系:(1) 块解码后由流式重建后端产出深度、置信度、掩码与位姿;(2) 工作线程异步把可靠深度按全局 Gilbert 块分桶,为每个历史 KV 块建视锥板表(式 4-5);(3) 用 multiwarp 为当前 query 块获得目标相机深度(式 6);(4) 计算世界空间 OBB 视锥板重叠 $g_{i,r}$(式 7)与覆盖率 $\rho_i$(式 8);(5) 将几何分数软融合进每层的模型重要性分布(式 9-11),配合上一块保留与 Gilbert 26 邻域保障物化路线(式 12-14);(6) Triton 索引块稀疏注意力只算被选 tile(式 15)。复杂度从稠密的 $O(NM_c b_{tok}^2 d)$ 降为约 $O(N(K_{max}+\Delta_{safe}) b_{tok}^2 d)$,路由预算固定而 $M_c$ 随历史增长。
核心创新是「软几何融合 + 双路径回退」的路由规则,与已有方法的本质区别有三点。其一,路由粒度是 token 块而非帧:视锥板原语天然对应 FlashAttention 的 tile 尺寸,跳过整块 KV tile 可同时省掉 $QK^{\top}$ 计算与 KV 读取。其二,几何分数不硬性替换模型偏好:对覆盖率 $\rho_i\ge\eta_{cov}=0.9$ 的行,先把重叠低于噪声阈 $\tau=0.1$ 的值置零、按 $g_{ref}=0.2$ 归一,再乘性调制该层自己的均值 query-key 分布 $p^{\ell}_{i,r}$(式 11),最大乘子 $1+\lambda=3$;未覆盖行完全保留模型分布的累积质量前缀路由。其三,「保留的记忆」与「暴露的路线」解耦:历史可以无限保留,但每行只看 $K_{cov}=80$(已覆盖)或 $K_{unc}=150$(未覆盖)个块,代价不再随 $M_c$ 增长。校准显示 $\lambda=2, g_{ref}=0.2$ 把 top-80 正重叠召回从 0.602 提到 0.852,仅改动 9.0% 的选择。
方法步骤详情
步骤一(历史侧建表):块 $j$ 解码后重建后端给出深度、置信度、掩码、位姿;可靠深度反投影后按 Gilbert 块分桶,为每个历史 KV 块算 10/90 百分位深度区间(式 5)入表。步骤二(查询深度):缓存最近 $K=30$ 块首尾帧深度,扭曲到目标相机,每 token 取样本数 $\ge k_{warp}=2$ 的最新帧中位深度 $z^Q(u)$(式 6)。步骤三(打分):OBB 网格近似交集得重叠分 $g_{i,r}$(式 7)与覆盖率 $\rho_i$,$\eta_{cov}=0.9$ 判几何可信度。步骤四(路由):每层由均值 query-key 内积 softmax 得重要性 $p^{\ell}_{i,r}$(式 9);已覆盖行按式 11 融合取 top-$K_{cov}=80$,未覆盖行取累积质量前缀,上限 $K_{unc}=150$;上一块保留在预算,Gilbert 26 邻域与参考帧作保障(式 14)。步骤五(异步):KV 按 Gilbert 序存储,Triton 稀疏核只算被选 tile;几何在专用 CUDA 流异步构建,块 $c$ 用块 $c-2$ 状态。
技术新颖性
技术新颖性可从四个对比维度看。对比稠密 FlashAttention:稠密仍调度全部 $N\times M_c$ 个 tile 对,Velox 把调度改为 $\sum_i |R^{\ell}_i|$,被跳过块同时免除 $QK^{\top}$ 计算与 KV 加载,记忆保留量与注意力暴露量首次解耦。对比帧/视图记忆(Context-as-Memory、VMem):它们给整块所有区域同一份检索结果且选中帧内仍稠密,Velox 是区域级、每层独立、软性的路线。对比 ControlNet 式注入(AnchorWeave 等):那些方法要把扭曲渲染写进输入、需要训练或改架构,Velox 完全不动生成器参数与接口。对比注意力统计类稀疏化:它们从位置或统计推断重要性,Velox 用可投影的世界空间几何作为「该看哪里」的物理先验,并附模型回退。工程新意还包括免去接缝表的全局对齐 Gilbert 序与同卡异步几何构建。一致性审计(Table 2)显示几何信号与模型偏好高度重合($R_{geo}=0.7302$ 对随机 0.350),软融合是锦上添花而非强行改道。
实验结果
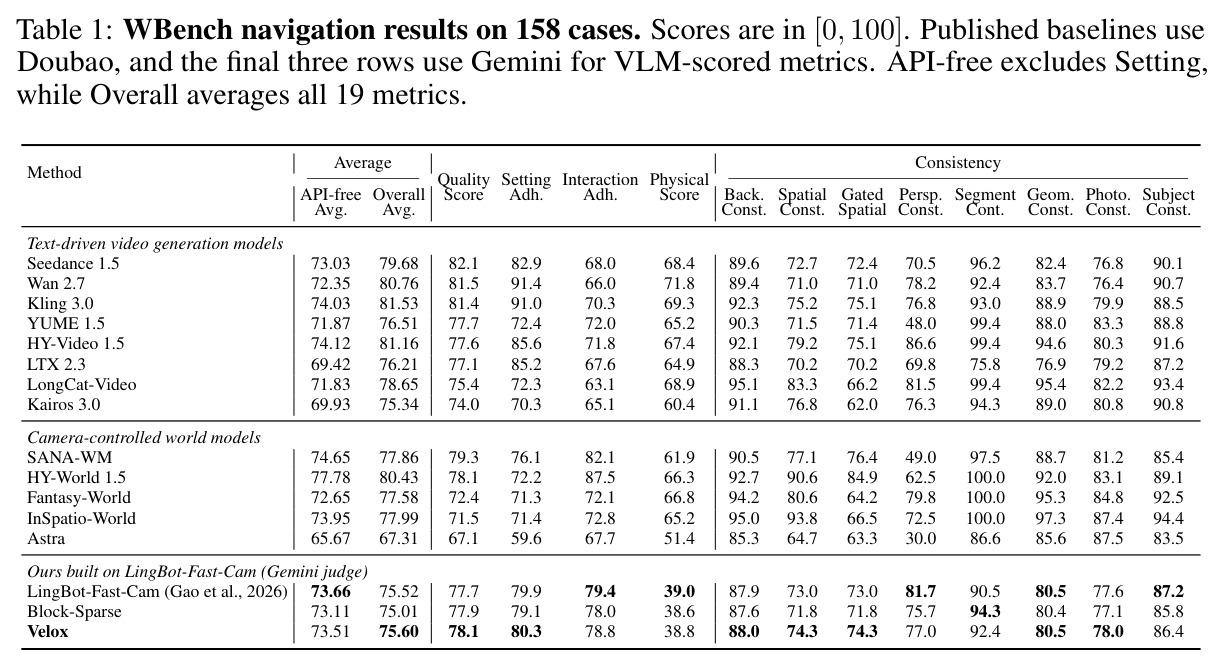
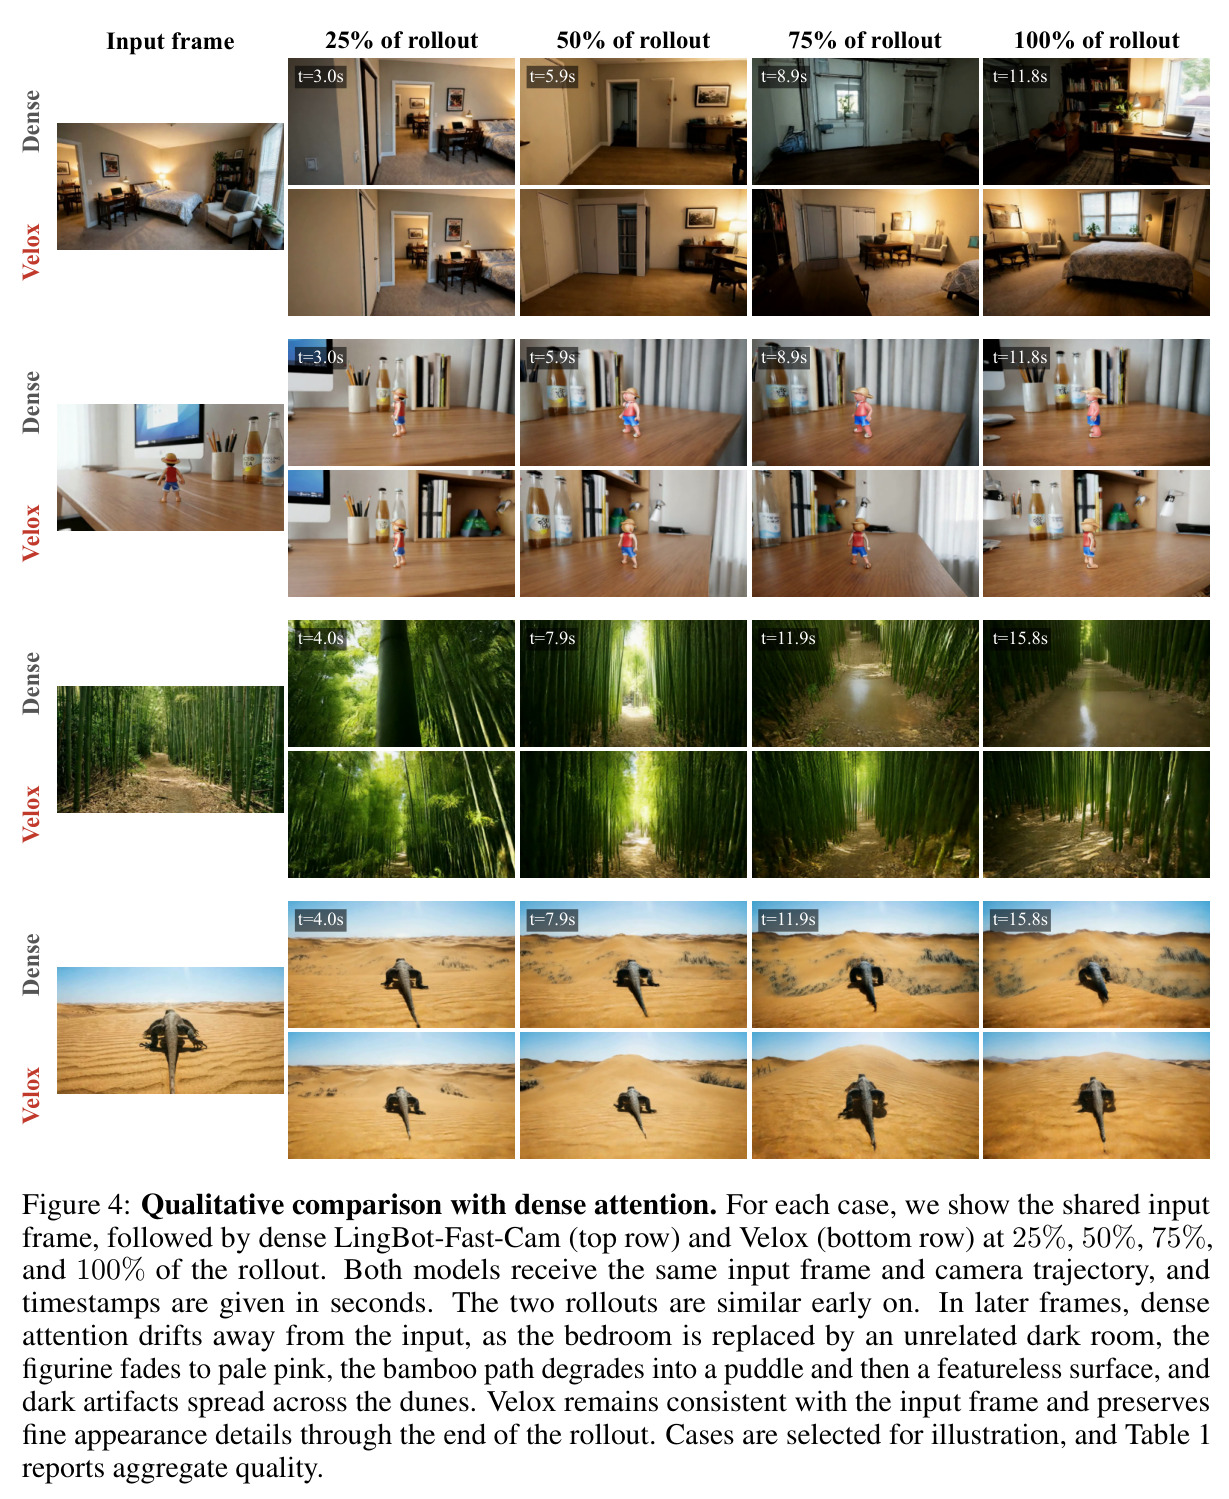
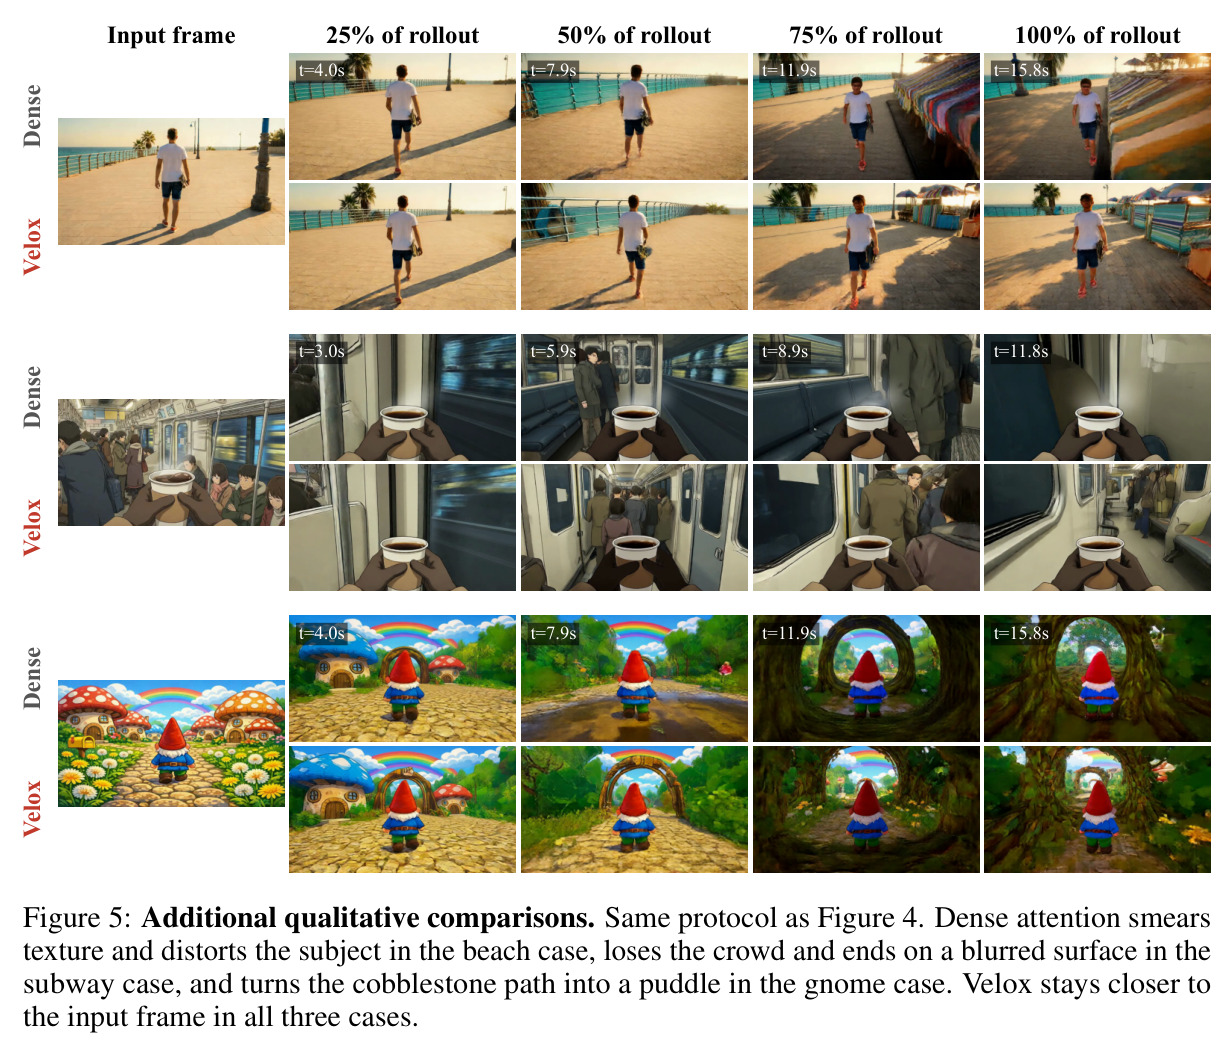
实验看三点。(1) 计时(Figure 3):48 块 rollout、单 H200 下,稠密注意力延迟到第 48 块约 34.2 ms,Velox 路线有界近乎平坦,仅 7.8 ms,加速 4.36 倍;去噪 7.19 s 降至 2.96 s,加速 2.43 倍;差距随块数扩大,收益来自抑制随长度增长的历史注意力。(2) 质量(Table 1,158 例):Velox API-free 平均 73.51,较稠密 LingBot-Fast-Cam 73.66 差 0.15 内;总平均 75.60 略高于稠密 75.52;对比同预算纯模型路由 Block-Sparse:API-free 73.11→73.51,总平均 75.01→75.60,空间一致性 71.8→74.3,几何在同等预算确有增益。(3) 审计(Table 2):层 14 的 $R_{geo}=0.7302$、$R_{50}=0.8909$,远超随机期望 0.350,各层差异支持保留每层分布。定性上(Figure 4-5),稠密出现卧室换暗室、人偶褪色、小径变水洼、沙丘伪影等漂移,Velox 均保持输入帧外观。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 48 块长滚动注意力时延 | 单次视觉注意力调用延迟 | 7.8 ms(Velox) | 34.2 ms(稠密 FlashAttention) | 4.36× 加速 |
| 单块去噪关键路径(几何异步共享同一 H200) | 每块去噪时间 | 2.96 s | 7.19 s(稠密) | 2.43× 加速 |
| WBench 导航 158 例 | API-free 平均分(0-100,跨裁判可比) | 73.51 | 73.66(稠密 LingBot-Fast-Cam) | −0.15,统计上持平 |
| WBench 导航 158 例 | 19 项指标总平均 | 75.60 | 75.52(稠密)/ 75.01(同预算 Block-Sparse) | +0.08 vs 稠密;+0.59 vs 同预算稀疏基线 |
| WBench 导航 158 例 | 空间一致性(Spatial Const.) | 74.3 | 71.8(Block-Sparse)/ 73.0(稠密) | +2.5 vs 同预算稀疏;+1.3 vs 稠密 |
| 几何-模型重要性一致性审计(层 14,τ=0.1) | 几何召回 $R_{geo}$ | 0.7302 | 0.350(随机期望 50/143) | +0.3806,约 2.1 倍 |
局限与改进
作者承认的局限(附录 D.5)有三:一是几何驱动的失败模式——重建深度漂移、multiwarp 用陈旧远几何填补新脱露 token、OBB 近似高估细长结构重叠时,软融合可能抬升过期历史;二是裁判不可比——发表基线用 Doubao 而本文三行用 Gemini,VLM 打分项跨组不可比,只能靠 API-free 平均对齐;三是 WBench 上视角一致性(77.0 对稠密 81.7)与主体一致性(86.4 对 87.2)略有回退,作者认为这与设计风险一致:静态背景有视锥板支撑,而物体敏感区域可能动态、重建不全或几何对应弱却语义重要。我自己的观察:校准仅基于两条导航轨迹的 48 个网格,超参($\lambda=2$、$g_{ref}=0.2$、$\eta_{cov}=0.9$、$K_{cov}=80$ 等)是否跨场景稳健存疑;未覆盖行走 $K_{unc}=150$ 的模型路由,预算不小,早期 $M_c$ 较小时加速空间有限;评测只有 WBench 导航一个基准、LingBot-Fast-Cam 一个底座,泛化证据不足。
独立分析的弱点
独立分析至少四个弱点。其一,对动态场景系统性偏弱:视锥板与 multiwarp 都假设世界静止,行走的人物、摆动的物体会被当作可重访表面存进记忆,回访时可能把错误外观拉回来——这可以解释主体/视角一致性的回退;改进方向是引入运动或实例分割掩码,把动态区域排除在视锥板表外、交由模型路由。其二,几何链路长且脆:依赖流式重建(深度、位姿、置信度)以及 ViPE 到 LingBot-map 的位姿桥接(式 18),任一环节漂移都会污染路由,且两块新鲜度滞后意味着剧烈视角变化时几何过时;改进方向是置信度感知的覆盖率判定与过期检测(例如按相机位移自适应滞后)。其三,超参固定且校准集极小:48 个网格来自两条轨迹,$\eta_{cov}=0.9$、$K_{cov}=80$ 的选择缺少跨域验证;可做每场景自适应或在线校准。其四,收益边界不明确:加速来自注意力项,而去噪总时间还含 VAE、文本编码等固定开销,短滚动或小模型下几何构建开销可能吃掉收益;论文只报告注意力与去噪关键路径时间,没有端到端墙钟总时间与开销-收益平衡点,应补充不同长度、不同底座的 scaling 曲线。
未来方向
作者在附录 D.5 明确提出的方向:用同预算对照基线(随机路线、近窗路线、帧/FOV 检索路线、纯模型路线)隔离几何信号的贡献,并把物体中心案例与背景重访、几何受压区域分开评测,形成比「只对比稠密」更严格的质量协议。基于本文成果可自然延伸的方向:把软融合系数 $\lambda$ 做成逐层或逐去噪步可学习,甚至用少量微调蒸馏稀疏路线,让模型训练期就学会利用几何路线;与 KV 压缩、量化、异构缓存类加速(如 WorldCache)正交组合进一步压低常数;把视锥板记忆升级为带语义/实例通道的混合记忆,服务动作控制与事件一致性;支持多 GPU 卸载几何构建或更大的历史保留;扩展到交互式动作驱动世界(游戏、机器人仿真)与长视频编辑场景;还可以把覆盖率与融合强度作为不确定性信号反馈给生成器,实现语义-几何联合的「哪里需要看历史」主动路由。
复现评估
复现评估:难度偏高但信息完整。有利面:全部超参被明确给出($\tau=0.1$、$g_{ref}=0.2$、$\lambda=2$、$\eta_{cov}=0.9$、$K_{cov}=80$、$K_{unc}=150$、$b_{tok}=128$、$k_{warp}=2$、$p_{lo/hi}=10/90$、缓存 $K=30$、两块新鲜度滞后),式 4-23 与附录 B-D 的实现路径(异步流水线、Triton 内核、Gilbert 布局、失败模式)写得非常细,几何与模型一致性审计还给出了可复算的协议;WBench 导航 158 例是公开基准。不利面:论文未提及开源代码;底座是 LingBot-Fast-Cam 推理栈 + Wan 式视频 DiT + ViPE 位姿 + 流式重建后端,整套栈本身就不易凑齐;测量需要单张 NVIDIA H200(大显存与高带宽);异步工程(worker 线程、专用 CUDA 流、prewarm、两相 tile 循环)是收益成立的关键,复现者需要重造这部分。综合判断:方法论可完全依文重建,但端到端复现需要较强的工程能力与算力,属于高难度复现。
论文图表
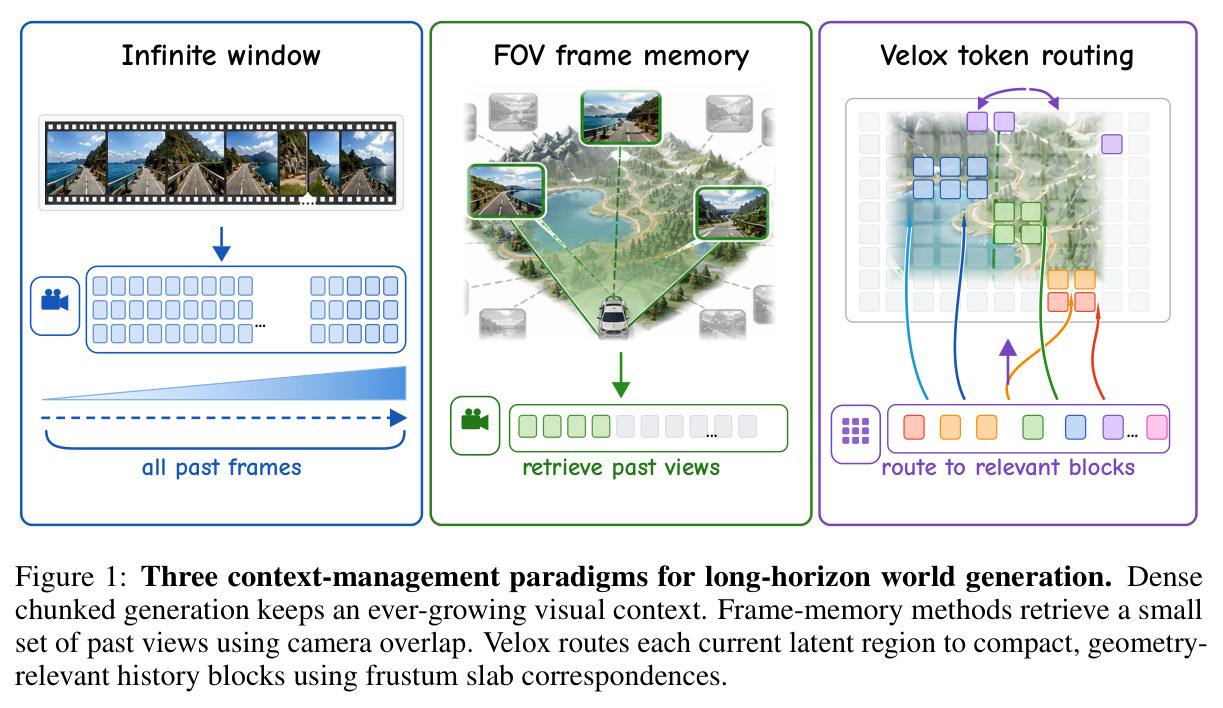
并排对比三种历史上下文管理范式:无限窗口(保留所有过去帧的稠密上下文)、FOV 帧记忆(按相机视场角重叠检索少量过去视图)、Velox token 路由(把当前 latent 的每个区域路由到几何相关的紧凑历史块)。
一张图定位本文在领域谱系中的位置:从稠密历史到视图级检索再到块级路由的演进脉络,是理解动机与贡献差异的最快入口。
在第 10、14、19、23、24、25 层审计视锥板重叠与模型 top-50 偏好的重合度:几何召回 $R_{geo}$ 在 0.665-0.730 之间(层 14 最高 0.7302),相对随机期望 0.350 提升 0.32-0.38,固定预算重合 $R_{50}$ 约 0.87-0.89。
支撑软融合设计的核心假设:几何对应与各层模型偏好高度一致但不完全相同,因此应该调制而非替换每层的分布。