面向在线扩散强化学习的路由策略优化 Routing Policy Optimization for Online Diffusion Reinforcement Learning
把随机探索从采样器噪声搬进注意力路由,保持确定性采样器且训练效率提升近4倍
前置知识
流匹配与确定性采样器
流匹配/整流流模型学习一个速度场 $v_\theta(x, t, c)$,把高斯噪声沿常微分方程连续搬运到数据分布;生成时用确定性欧拉步 $x^{t-1} = x^t + \Delta t\, v_\theta(x^t, t, c)$ 逐步去噪。DDIM、Flow-GRPO 训练所用的 ODE 采样器都属于这一类:整条轨迹由初始噪声唯一决定,中途没有任何随机性。
RPO 的核心卖点是在不改动这个确定性采样器的前提下引入探索。理解速度场与欧拉步,才能看懂路由如何'扰动速度',以及速度似然为什么定义在 $\tilde v - v_\theta$ 上。
score-function 策略梯度与 GRPO
REINFORCE 类方法把生成过程拆成可记录的动作,用 $\nabla_\theta \log \pi \cdot A$ 估计梯度:似然项决定往哪个动作靠拢,优势 $A$ 决定力度与方向。GRPO 用同一提示下一组 rollout 的奖励统计量做组内相对基线,省去价值网络。DDPO、Flow-GRPO、DanceGRPO 都是这一思路在扩散模型上的实例。
RPO 仍是 score-function 方法,只是把'动作'换成注意力路由、似然换成高斯速度似然、把 8 条一组的组优势换成 2 条一组的配对优势,不掌握这套框架就看不懂它的损失函数。
块稀疏注意力
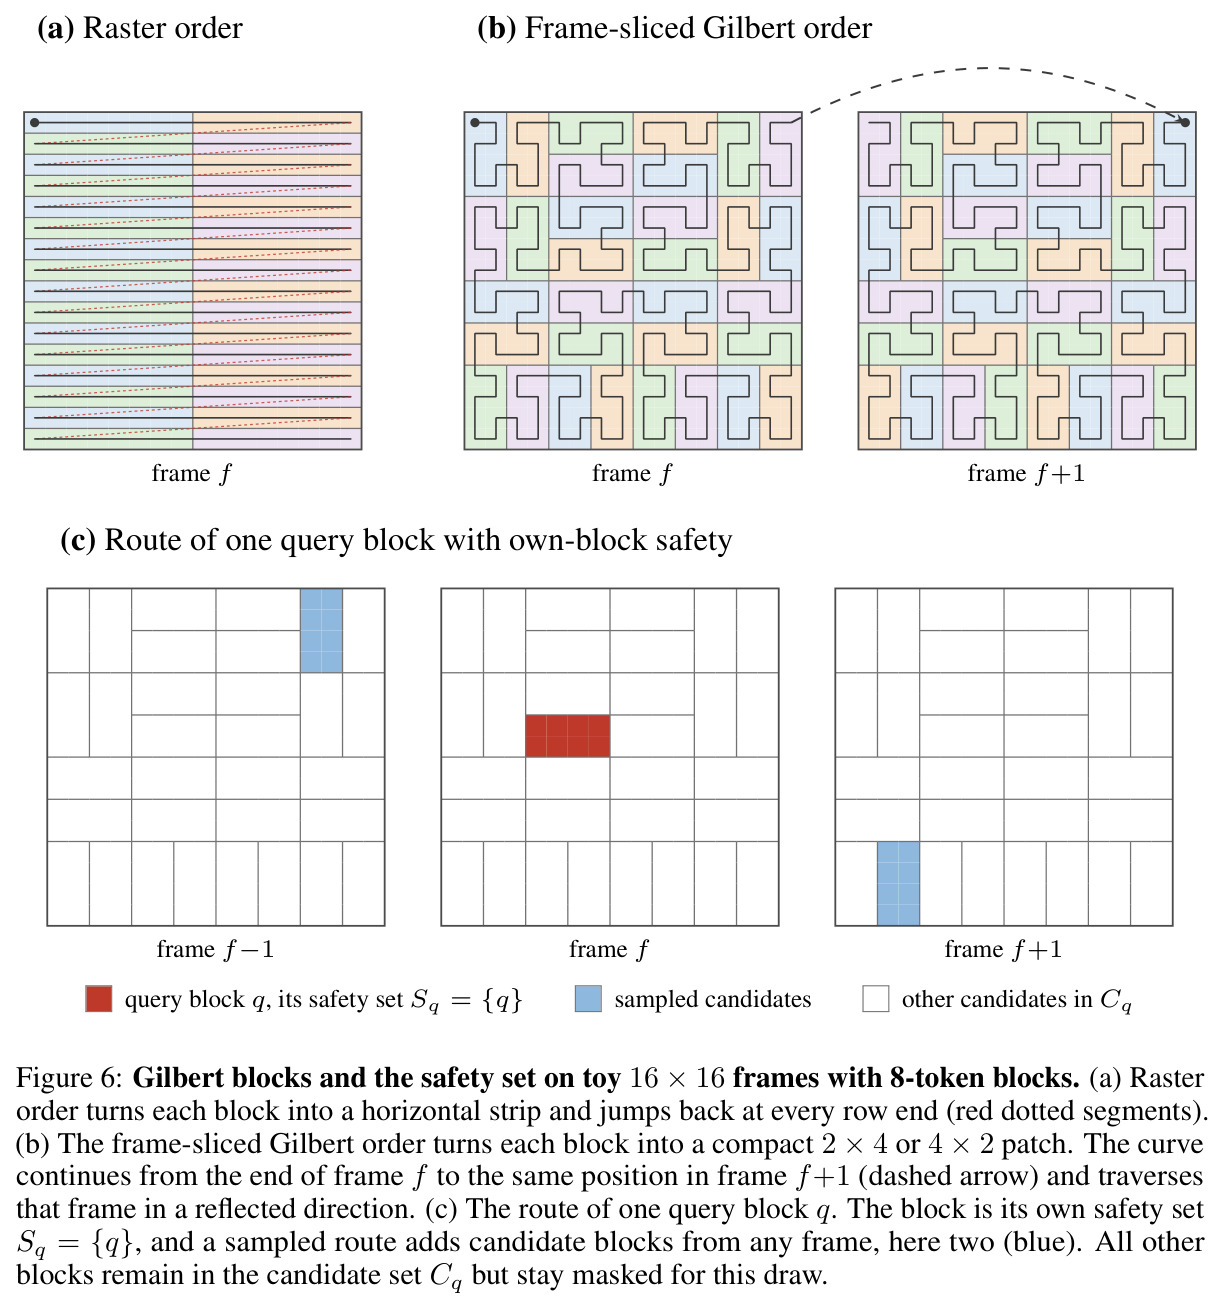
把 token 序列切成每块 $B$ 个 token 的连续块,用 0/1 块掩码 $\mu \in \{0,1\}^{Q \times Q}$ 规定每个 query 块能看到哪些 key 块,softmax 只在可见 key 上重新归一化。SeerAttention、VSA 等高效注意力方法用它省算力;本文用 Gilbert 曲线排序 token,让每个块对应一块空间上紧凑的图像/视频区域。
RPO 的动作就是一个块掩码:每个 query 块采样一条'路由'(可见 key 块的集合)。不懂块稀疏注意力,就无法理解动作空间的结构和掩码在注意力里如何执行。
公共随机数与配对比较
比较两个随机系统时,让它们共享除被测因素之外的所有随机源(同一随机种子),差值的方差会大幅下降,这是随机仿真中的经典方差缩减技术。2-GRPO 表明语言模型只跑 2 条 rollout 也能保住大组的绝大部分性能,DeepSeekMath 的组相对基线是它的近亲。
RPO 的两 rollout 配对估计器正是该技术的应用:两条 rollout 共享 prompt、初始潜变量和 anchor 层,只差路由种子,奖励差才能被干净地归因于路由本身。
研究动机
扩散/流模型的在线强化学习对齐(DDPO、DPOK、Flow-GRPO、DanceGRPO)都把动作定义在采样器里:把确定性 ODE 采样器改造成随机 SDE,再用终端奖励给每条含噪轨迹打分。这带来两个代价。其一,每条训练轨迹都要完整跑一遍去噪并过一次奖励模型,而为估计组相对优势每组需要多条 rollout——DanceGRPO 用 G=8,视频场景下一批 64 组 × 8 条 13 帧 704×1280 视频的渲染与评分极其昂贵,论文实测 Flow-GRPO 在 Wan2.2 上训练要 75.4 GPU 时、DanceGRPO 要 102.3 GPU 时。其二,训练时优化的是 SDE 采样器对应的策略,推理时却换回确定性采样器,存在分布错位。另一类前向匹配方法(DiffusionNFT、DGPO、advantage-weighted matching、adjoint matching 等)避开了反向轨迹似然,但也丢掉了显式的采样动作,不再是纯粹的 score-function 策略。
本文的目标是论文想要一个同时满足三个条件的在线对齐方法:保留显式的、可记录的采样动作和 score-function 目标;不改动生成器的原始确定性采样器,训练结束后直接用 dense 注意力加原采样器做推理;并且同一套框架在图像和视频两类生成器上都成立。量化目标是在与 Flow-GRPO/DanceGRPO 相同的奖励模型(HPSv3)和相同/相近的适配器设置下,用远少于对手的 rollout(每步 2 条而非 8 条)达到相当或更高的最终奖励,同时把视频训练成本从几十上百 GPU 时压到约 24 GPU 时,并验证路由期学到的增益能迁移到 dense 推理模型上。
与已有工作不同的是,作者的关键洞察是:随机探索不必扰动去噪轨迹本身。扩散 Transformer 的注意力层本来就在决定每个 token 看哪里,把相邻 token 组成块后,'每个 query 块看哪些 key 块'天然构成一个离散动作空间,从生成器原生的注意力质量里采样路由即可引入随机性,不需要策略头、不需要 SDE 化。与 KVPO(自回归视频的历史 KV 路由)和 MaskGRPO(原生掩码模型的 token 操作)不同,RPO 面向双向注意力的扩散 Transformer,且其似然对 dense 速度本身求导,使学到的更新在移除路由后依然有效;再借助公共随机数构造共享全部非路由随机源的 2 条配对 rollout,用奖励差做 leave-one-out 基线,把'探索成本'从 8 条完整轨迹压到 2 条。
核心方法
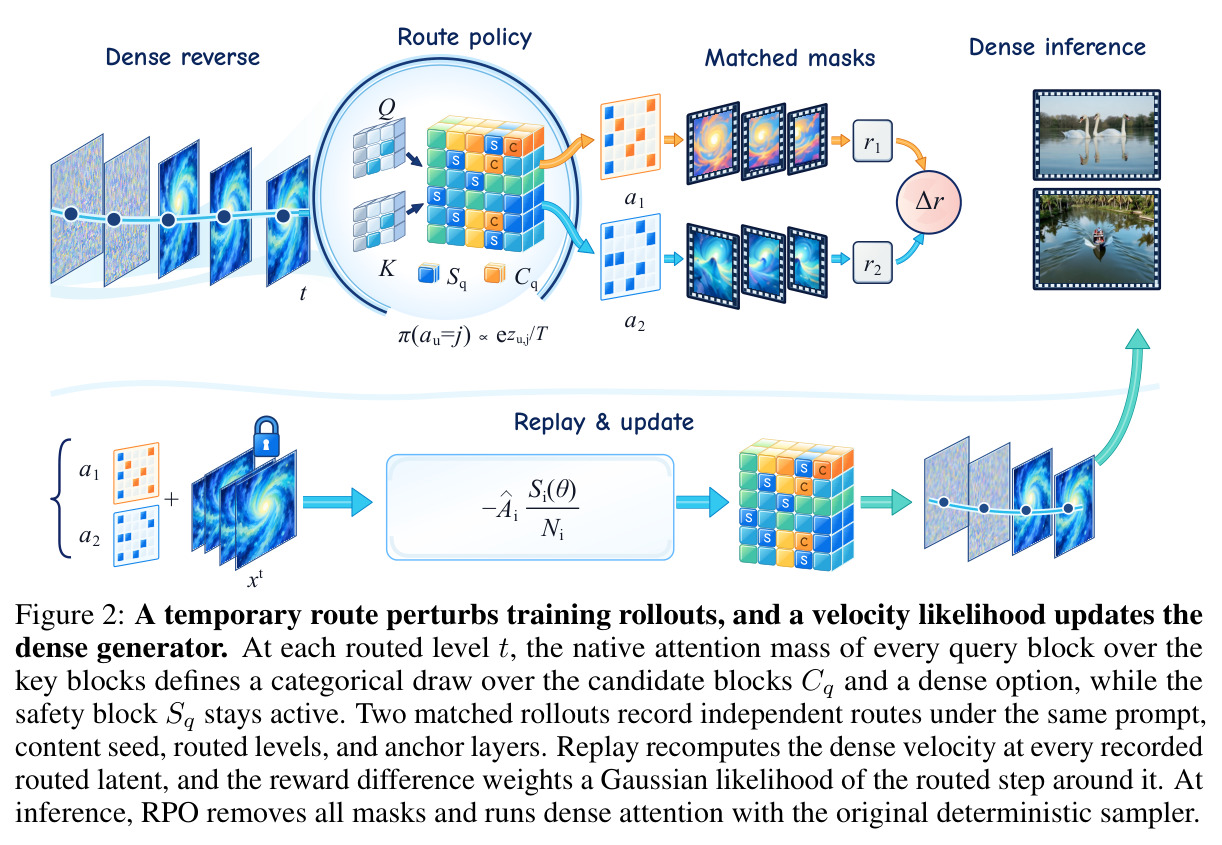
直觉上,RPO 把'探索'从采样器的噪声搬进注意力:训练时在少数去噪层级让每个 query 块随机地只看一部分 key 块(或保持 dense),生成结果因此产生可度量的波动;奖励更高的那条路由轨迹说明它的速度扰动更有利,更新就把 dense 速度场朝它拉。技术上分三步:第一,attention-mass routing——在路由层做一次无梯度的 scoring pass,统计每个 query 块落在各 key 块上的注意力份额,取对数并跨路由层平均得到 logits,加温度 $T$ 做 softmax 得到路由分布,再用 Gumbel 噪声排序采样;第二,rollout——确定性采样器照常运行,只在路由层级 $t \in T_{route}$ 用带掩码的路由速度 $\tilde v$ 走一步,并记录转移两端的潜变量;第三,replay 与更新——重放时用带梯度的 dense 速度 $v_\theta$ 对记录的转移打高斯似然分,配对奖励差作为优势加权,直接更新 dense 速度场;推理时拆掉所有掩码,恢复 dense 注意力与原采样器。
核心创新是把策略接口内嵌进注意力,并保证'训练扰动的、推理使用的'是同一个速度场。三个关键设计:一是路由提议来自生成器自身的注意力质量 $m_{i,\ell,q,j}$(公式 3),不新增任何参数,注意力本就集中的块大概率保持 dense——单层 $T=1$ 时 dense 选项概率为 $1/(2-m_{q,q})$;二是高斯速度似然(公式 4)$\log q_\theta(x^{t-1}_i|x^t_i) = -\|\tilde v^t_i - v_\theta(x^t_i,t,c)\|^2/(2Ds_t^2)$,带宽 $s_t^2$ 取该层级批量路由偏差的均值,使似然始终保持 O(1) 量级;三是 G=2 的受控配对:两条 rollout 共享 prompt、初始潜变量与 anchor 层,只有路由种子不同,奖励差 $r_{i,d}-r_{\bar i,d}$ 因此是合法的 leave-one-out 基线,且配对反对称保证两条的优势大小相等、符号相反。与 Flow-GRPO 把 SDE 噪声注入整条轨迹、需要 8 条一组相比,RPO 的随机性只存在于两三个路由层级的掩码里。
方法步骤详情
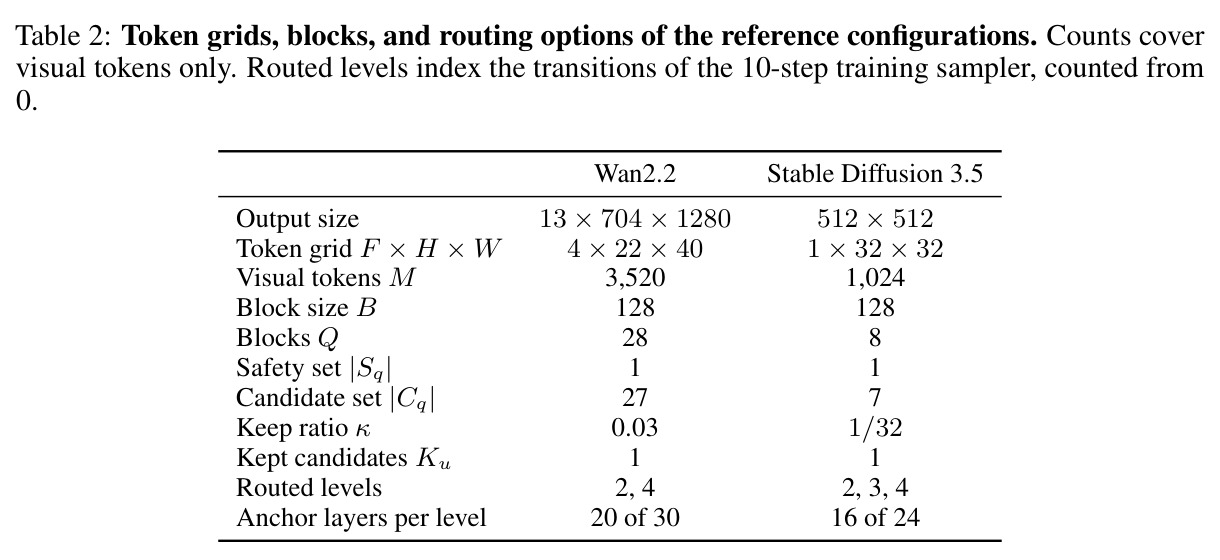
(1) 预备:按帧切片 Gilbert 曲线把 token 切成 $B=128$ 的块,每块保留自身为安全集,选好路由层级(SD3.5 第 2/3/4 步、Wan2.2 第 2/4 步)与 anchor 层。(2) 提议路由:无梯度 scoring pass 统计各块注意力质量得 logits,加 Gumbel 噪声排序,dense 选项排第一则整块 dense,否则保留安全块与 1 个候选,一次决策套用全部路由层与头。(3) rollout:每步 64 个配对组,两条共享内容种子、只差路由种子;非路由层级走原始欧拉步,路由层级 SD3.5 用两条路由速度的居中组合、Wan2.2 直接用路由速度,并用 HPSv3 打分。(4) 优势处理:逐维 5% winsorize、批量 IQR 缩放、stop-gradient 得反对称优势。(5) 重放更新:带梯度重算 dense 速度,损失 $L^{pg}_i=-\hat A_i S_i(\theta)/N_i$ 对两条求和;SD3.5 训 rank-32 LoRA、Wan2.2 全参训练。
技术新颖性
与已有工作的本质区别在'动作放在哪、似然对谁求导'。采样器空间方法(DDPO/DPOK/Flow-GRPO/DanceGRPO)的动作是 SDE 噪声,似然描述被改造过的采样器转移,训练对象与推理用的确定性采样器脱节;RPO 的动作是注意力路由,似然是围绕 dense 速度的高斯项,$\nabla_\theta\log q_\theta=(\tilde v-v_\theta)^\top\nabla_\theta v_\theta/(Ds_t^2)$ 直接作用于推理时评估的速度场。前向匹配家族如 DiffusionNFT 不动推理却放弃了显式动作;RPO 保留'记录动作-重放打分'的 score-function 结构。离散动作方法中,MaskGRPO 系作用于原生掩码生成器、KVPO 作用于自回归视频的历史 KV 路由,RPO 首次在双向扩散 Transformer 里从原生注意力质量采样块路由,并用共享种子的配对奖励差而非大组统计量做优势,把 dropout 式随机性、common random numbers 与 2-GRPO 的双人组优势组合进一个新接口。
实验结果
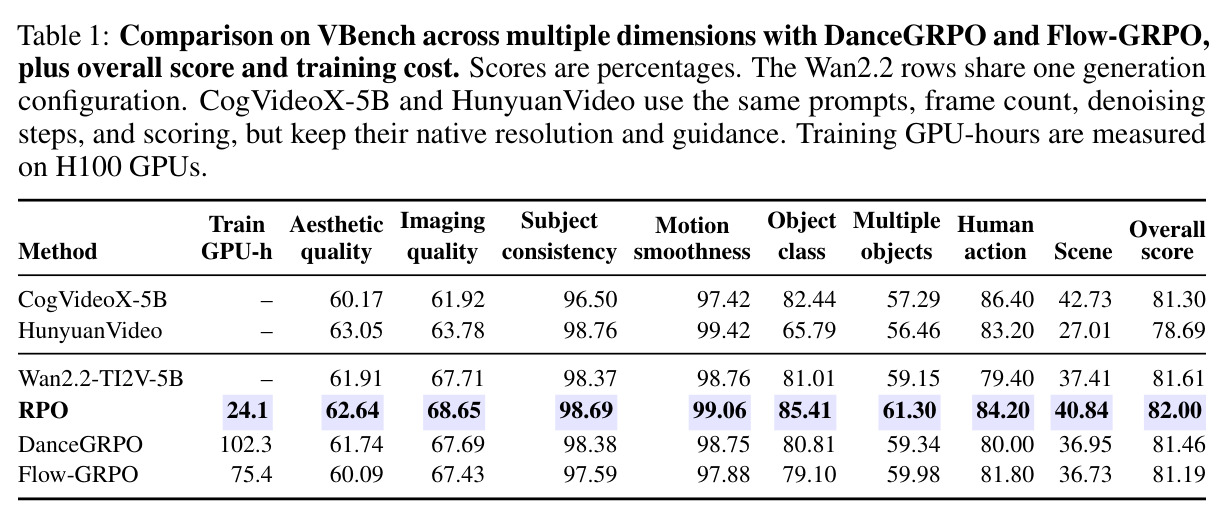
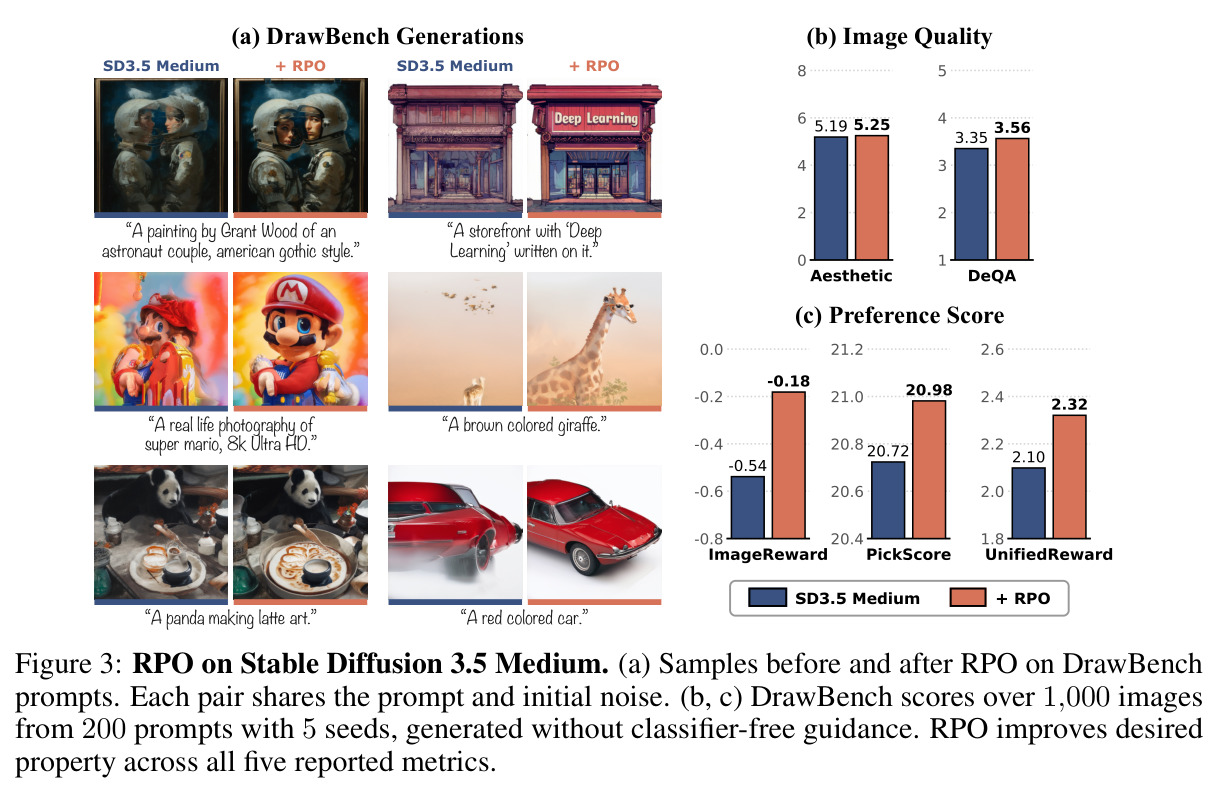
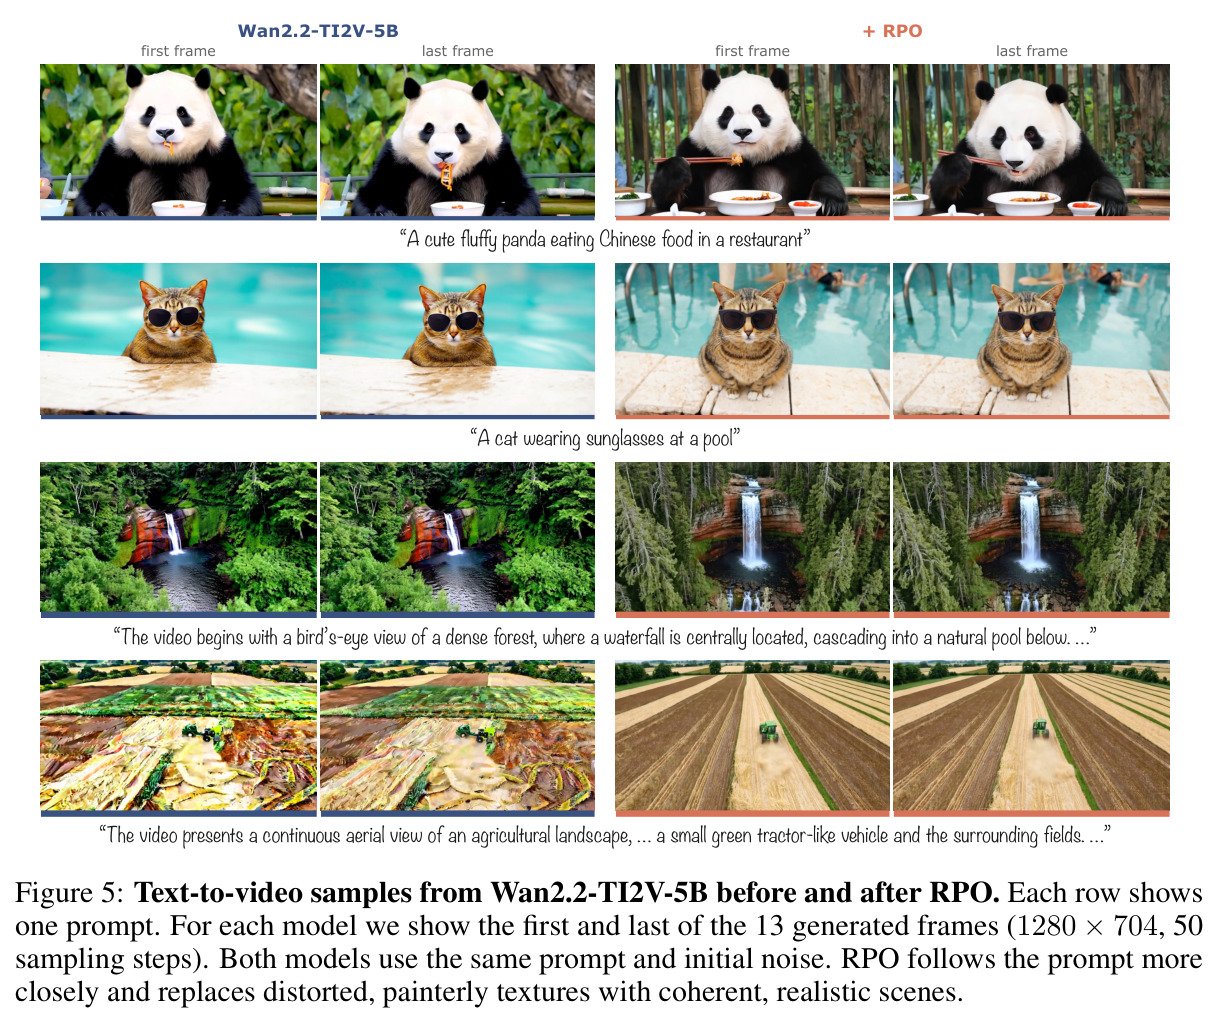
(1) 图像:SD3.5 Medium 在 DrawBench 1000 张上五项指标全升:ImageReward -0.54→-0.18,UnifiedReward 2.10→2.32,DeQA-Score 3.35→3.56。(2) 学习速度:与 Flow-GRPO 同底座对比 50 步,dense 验证 HPSv3 上 RPO 第 25 步 8.90 已超对手第 50 步的 8.81,峰值 10.20;每步 2 条 rollout 对 8 条,即近 4 倍训练效率。(3) 视频:Wan2.2 训练 24.1 GPU 时,仅 Flow-GRPO 的 1/3.1、DanceGRPO 的 1/4.2;VBench 6220 条视频总分 82.00,高于基座 81.61、DanceGRPO 81.46、Flow-GRPO 81.19,为唯一超基座者;语义增益最大:object class +4.40、human action +4.80。代价:color 与 appearance style 低于基座;Flow-GRPO 的 dynamic degree +12.50 但质量下滑。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 文生图偏好(SD3.5,DrawBench 1000 张,无 CFG) | ImageReward | -0.18 | -0.54(SD3.5 Medium 基座) | +0.36 |
| 文生图偏好(SD3.5,DrawBench) | UnifiedReward | 2.32 | 2.10(基座) | +0.22 |
| 文生图密集验证奖励(64 提示,28 步采样,50 步训练) | HPSv3 | 第 25 步 8.90,终值 9.91(峰值 10.20) | Flow-GRPO 第 50 步 8.81(终值增益 +4.86) | 步数减半即反超,终值高 1.1 分,增益 +5.97 |
| 文生视频综合(Wan2.2,VBench 6220 条视频) | Overall score | 82.00 | 基座 81.61 / DanceGRPO 81.46 / Flow-GRPO 81.19 | 唯一超过基座的训练后检查点(+0.39) |
| 文生视频训练成本(Wan2.2,H100) | GPU-hours | 24.1 | Flow-GRPO 75.4 / DanceGRPO 102.3 | 降至 1/3.1 与 1/4.2 |
| VBench 语义维度(Wan2.2,对基座) | Object class / Human action | 85.41 / 84.20 | 81.01 / 79.40 | +4.40 / +4.80 |
局限与改进
作者承认的局限:方法局限于含注意力的骨干,无法推广到没有注意力质量可用的架构;路由提议粗糙——每个 query 块 128 token 的 logits 在所有路由层和头上被平均成一个决策,掩盖了 token 级与层特异结构;速度似然把离散路由造成的偏差当成各向同性高斯,是代理而非真实似然;存在 dense-gain fade 失败模式——某些运行中 dense 验证奖励先升后降、而路由 rollout 奖励持续上升;与所有在线 RL 一样面临对冻结偏好模型的 reward hacking。我自己的观察:VBench 四个总分仅差 0.81 分且只有一组种子,胜出结论并不牢固;与 Flow-GRPO/DanceGRPO 的成本对比未做 compute-matched(步数 50 对 120、rollout 后端不同);奖励只有 HPSv3 单一维度,多维度奖励下的优势处理未经检验;SD3.5 用 LoRA 而 Wan2.2 全参训练,两个实验的配置彼此不可比;每层的 scoring pass 与重放也带来额外固定开销。
独立分析的弱点
逐条分析弱点并给改进方向。(1) dense-gain fade:部分运行 dense 增益见顶回落、路由 rollout 奖励却持续上升,说明优化目标与 dense 推理目标漂移;可让路由层级随训练退火,或在损失中加 dense 轨迹锚定项。(2) 块级粗粒度提议:128 token 一块、所有路由层和头共享一个决策,无法表达'只在这一层看这个区域';可让每层或每头独立采样并配共享先验控制方差。(3) 高斯代理失真:离散路由的偏差天然非高斯,似然又忽略路由选择本身的概率,策略不知道是哪个动作带来好处;按作者建议把路由概率并入似然是直接修法。(4) 两点优势噪声大:$r_1-r_2$ 只有一个自由度,奖励方差大时优势符号可能翻转;可扩成 3-4 条小组并保留共同随机数,或对优势做跨 step 滑动平均。(5) 超参全手工:路由层级、anchor 比例、$\kappa$、温度 $T$ 都按模型手调,可用 bandit 或元梯度自动搜索。(6) 奖励单一:只有 HPSv3 一维,需在多奖励组合与人工评估下验证稳健性。
未来方向
作者提出的方向:把采样路由的概率加进似然,让策略同时归功于'选了哪条路由'而不只是它对 dense 速度的影响;把组大小从 2 扩到 3-4,用更多成员换更稳的优势尺度,与配对方差缩减折中;与架构协同设计——把路由从'临时训练接口'升级为模型结构的一部分,同时拿到推理加速与更大的 RL 增益。基于本文成果可延伸的:路由只出现在少数早期去噪层级这一发现,值得系统研究'RL 探索的最佳位置'与各阶段信息量的关系;RPO 的更新能从 10 步训练采样器迁移到 28 步验证采样器,可深挖跨采样步数泛化的机理;把训练期积累的路由统计复用为推理期稀疏注意力先验,与 VSA、Sparse VideoGen 等加速方法结合;扩展到图像编辑(参考 SpatialFlow-GRPO 的空间信用分配)、少步生成器(配合分布匹配与奖励反传的混合方案),以及多奖励维度和在线人类反馈场景。
复现评估
复现难度偏高。开源情况:论文给出项目页展示视觉结果,正文与附录 A-E 把超参写得相当细——块大小 128、帧切片 Gilbert 排序、$\kappa$、$K_u$、路由层级与权重、anchor 层数、LoRA 配置、学习率、PPO 裁剪宽度、梯度上限等——但文中未提及训练代码已开源。数据方面:PickScore SFW 提示、DrawBench、VBench 标准套件均公开,但视频训练用的 'curated creative prompt distribution' 未公开,是复现的障碍之一。算力方面:SD3.5 需 1 节点 8×H100 跑 50 步,Wan2.2 需 2 节点共 16×H100,个人难以承担、机构可行;基线 Flow-GRPO/DanceGRPO 有开源实现可对齐。工程难点包括 Gilbert 曲线排序(依赖 Jenga 的实现)、注意力内部重排与掩码注入、无梯度 scoring pass、重放管道与配对种子管理。综合评估:细节充分、有基线参照,但算力门槛高、部分数据不公开,属于'具备条件可复现'级别。
论文图表
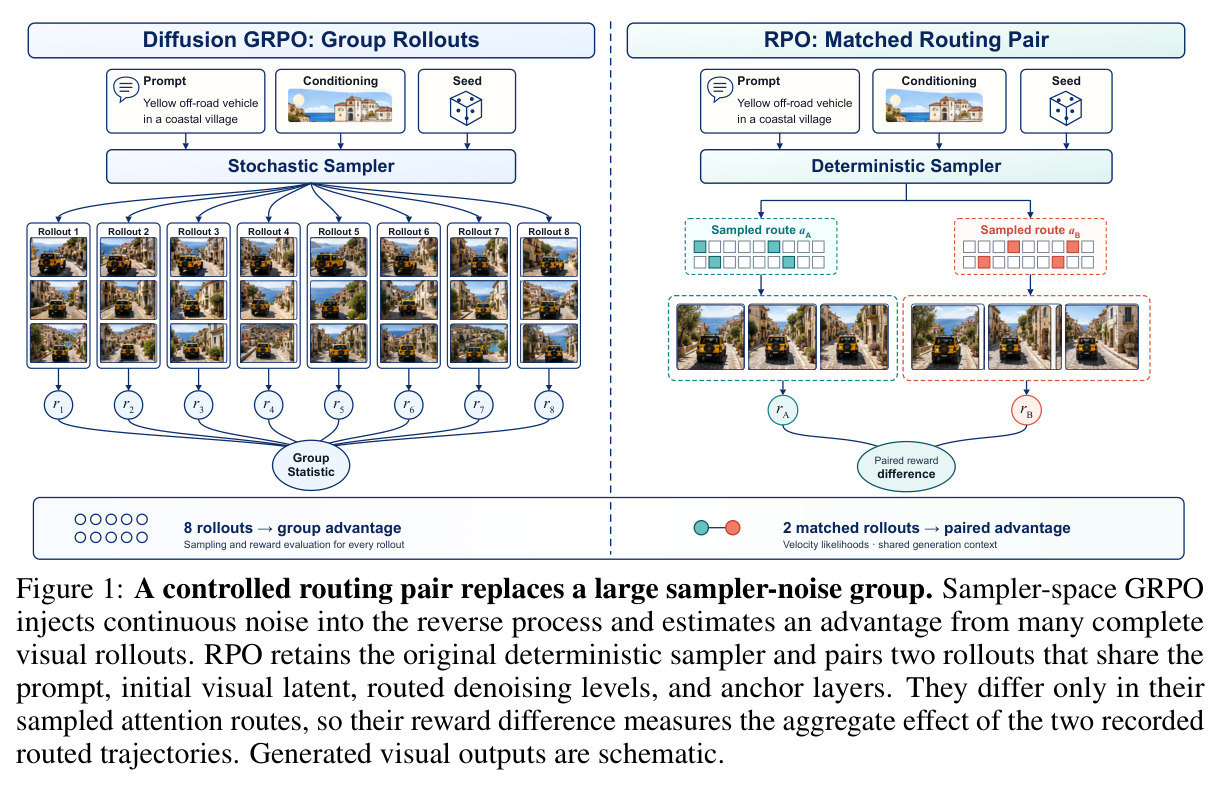
左右对比 Diffusion GRPO 与 RPO 的 rollout 结构:左侧同提示下跑 8 条随机采样轨迹、用组统计量算优势,每条都要完整生成并评分;右侧 RPO 保持确定性采样器,只跑 2 条共享 prompt、条件、种子、路由层级与 anchor 层的配对 rollout,仅注意力路由不同,用配对奖励差做优势,配合速度似然与共享生成上下文。
这张图一眼讲清论文的问题(rollout 太贵)与解法(把组换成对),是理解全文动机与效率来源(2 条 vs 8 条)的入口。
两条学习曲线:(a) 各自训练 rollout 的 HPSv3——RPO 的路由 rollout 平滑奖励 30 步后升破 9,Flow-GRPO 的 SDE rollout 低于 8,但两者度量对象不同;(b) 决定性的 dense 验证对比——RPO 第 25 步 8.90 已超 Flow-GRPO 第 50 步的 8.81,峰值 10.20(第 40 步),终值 9.91,总增益 +5.97 对 +4.86。
论文最核心的效率主张(半数步数反超、终值高 1.1 分)完全建立在这张图上,其中 (b) 是控制验证协议后的公平比较。