Mosaic:多会话智能体强化学习 Mosaic: Multi-Session Agentic Reinforcement Learning
提出多会话智能体强化学习设定与Mosaic分层优化方法,让RL训练适配上下文压缩与子代理分叉
前置知识
GRPO(组相对策略优化)
一种免 critic 的强化学习优势估计方法:对同一任务采样一组 rollout,用组内奖励的均值和标准差把每个轨迹的奖励标准化为相对优势 $\hat{A}^{traj}_i=(R_i-\mu_G)/(\sigma_G+\epsilon)$,正优势表示优于组平均。它不需要训练额外的价值模型,避免了长序列下值函数估计不准的问题,是 DeepSeek 系列推理模型的主力算法。
Mosaic 的整个分层优化都建立在 GRPO 之上,轨迹级优势就是标准的组相对优势,理解它才能看懂会话信号如何调制优势。
Agentic RL(智能体强化学习)
把 RLHF/RLVR 范式扩展到 LLM 智能体:策略通过多轮推理、工具调用和环境交互产生轨迹 $\tau=(a_1,o_1,\ldots,a_T,o_T)$,环境或裁判给整条轨迹打结果奖励 $R(\tau)$,用在线 rollout 更新策略。与单轮 RL 的区别在于奖励稀疏、轨迹长、依赖外部环境反馈。
本文的问题正出自 agentic RL 的训练假设:现有方法默认一条轨迹在一个连续上下文里完成,这是需要被打破的前提。
上下文压缩
当累积的交互历史逼近模型上下文窗口上限时,把历史压缩成更短的前缀,再以该前缀为初始上下文继续执行。它改写了后续动作所依赖的前缀条件,相当于开启了一个新会话:压缩前是完整上下文,压缩后只有摘要性前缀,信息有取舍。
压缩是产生多会话轨迹的两大来源之一,也是 Mosaic 会话级优势整形中最需要小心对待的会话类型。
子代理分叉
主代理通过专用动作把全局目标中的子任务委托给子代理执行,子代理在新会话中完成子任务后把结果并入主代理上下文。轨迹因此出现分支:主会话、子会话交错,整体结构是有向无环图(DAG)而非线性链,一个会话可能影响多个后继会话。
分叉是多会话轨迹的另一个来源,其非线性结构正是 Mosaic 在子代理场景收益温和的原因,理解它才能读懂消融分析。
边际信息增益
一种免 critic 的过程监督信号:定义答案似然势函数 $\Phi(y^*|x,v)$ 为给定上下文状态 $v$ 时真实答案 $y^*$ 的平均对似然,一个会话的即时奖励就是状态转移前后势函数的差 $r^{\Delta}=\Phi(v_{out})-\Phi(v_{in})$。有用的会话(补充证据、压缩去噪)应提升答案似然,丢关键事实的会话会降低它。
这是 Mosaic 会话级优势整形的核心信号,与 IGPO 的 turn 级信息增益一脉相承,但计算粒度和归一化方式都不同。
研究动机
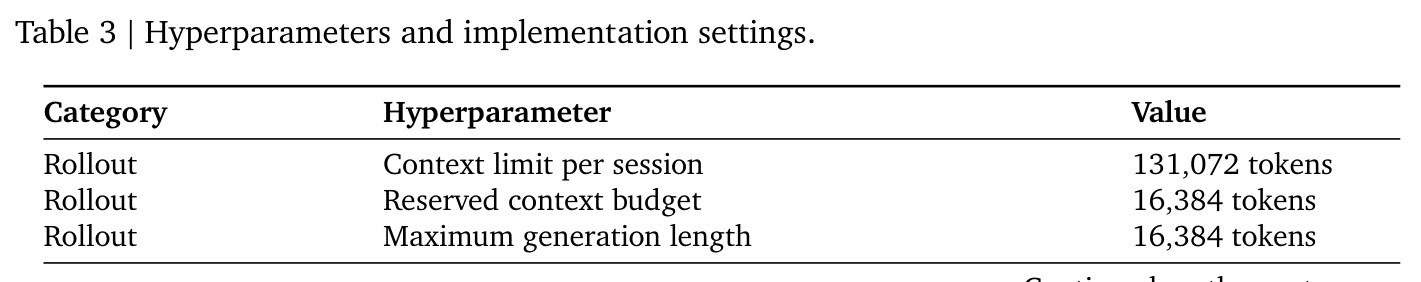
现有智能体强化学习几乎都建立在「单会话」假设之上:一次 rollout 是在持续累积的上下文里展开的多轮交互,训练时形成一个连续文本段。但现实中两个流行的推理技术会打破这个假设:一是上下文压缩——累积上下文逼近模型窗口上限(论文中每会话限 128K token)时,把历史压成短前缀并开启新会话;二是子代理分叉——主代理把子任务委托给子代理,产生分支会话。此时轨迹由任意数量的会话组成,训练假设与推理执行出现错配,损害一致性并限制优化潜力。目前通行的补救是 broadcasting:把轨迹级优势复制给所有会话的所有 token。这种粗粒度监督无法区分各会话的贡献,也无法引导「该用多少会话」的分配。实验佐证了错配的代价:基座 Qwen3.5-4B 在 BrowseComp 上单会话推理只有 23.22% 准确率,单会话 GRPO 训练后即便配合多会话推理也只到 34.68%(压缩场景),说明多会话推理能力无法仅靠泛化涌现,必须在多会话轨迹上直接训练。
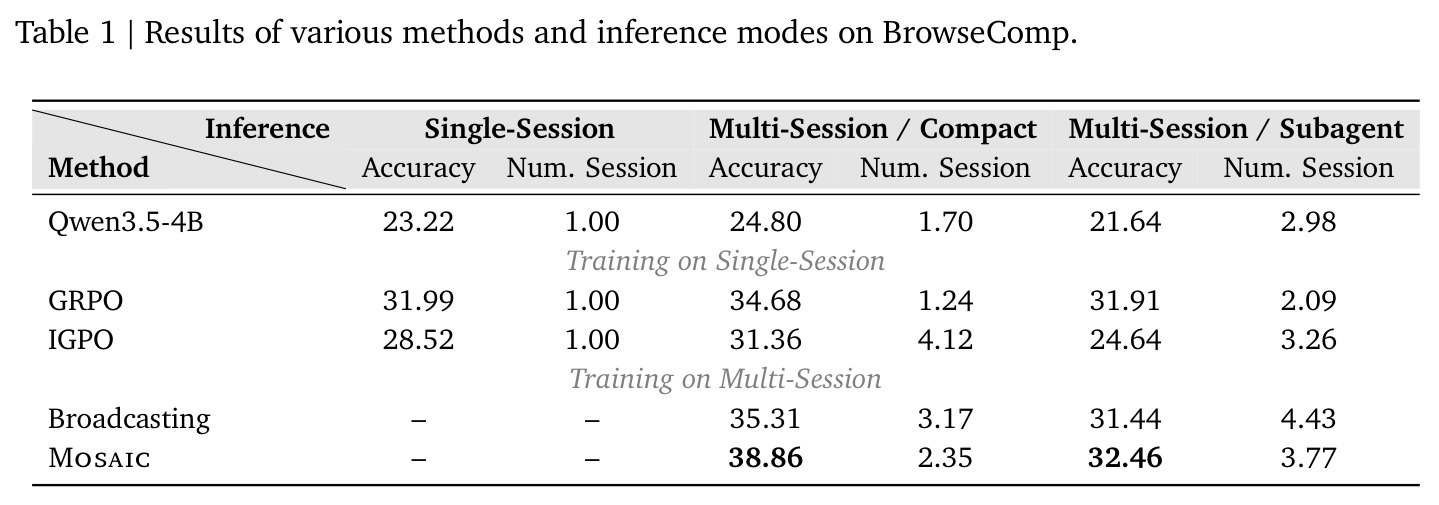
本文的目标是本文要把智能体 RL 从单会话推广为「多会话智能体强化学习」(Multi-Session Agentic RL):支持一条轨迹内包含任意数量的会话,让采用上下文压缩、子代理分叉等异构推理机制的智能体能在统一算法下被优化。具体目标有三:(1) 训练信号要有会话粒度,能区分不同会话对最终结果的贡献,而不是像 broadcasting 那样一视同仁;(2) 能引导会话分配——成功的轨迹学会用更少的会话高效完成任务,失败的轨迹保留足够探索(多用会话不被过度惩罚);(3) 任务结果奖励必须始终占主导,会话信号只做有界调制。量化目标是在 BrowseComp 上超越 broadcasting 基线且平均会话数更少:最终 Mosaic 在压缩场景取得 38.86% 准确率(broadcasting 35.31%,相对提升 10.1%),平均会话数从 3.17 降到 2.35,两个目标同时达成。
与已有工作不同的是,作者的独特切入点是把「会话」上升为一等公民的优化单元,并看到了会话数 $N_i$ 这个信号的价值与陷阱:它代理了探索广度和结构复杂度,但直接当奖励用会被策略钻空子。三个此前被忽视的观察构成了本文的差异化角度。其一,会话数的优化方向应取决于任务结果:成功轨迹内会话越少越好、失败轨迹内多探索反而更好(约束 C1/C2),这区别于任何把长度或步数当成本惩罚的常规做法。其二,有界调制而非直接加奖励:会话信号只缩放结果优势的幅度、绝不改变符号,保证结果奖励主导排序(C3),这在同质奖励组内还能扩大组内优势方差、提升样本效率。其三,把边际信息增益从 turn 级(IGPO)粗化到会话级,并首创按会话类型(normal/compact/subagent)分组归一化——压缩会话的原始增益天然偏低,全局归一化会系统性压制它们,类型化归一化消除了这一偏差。同时全程免 critic,规避了多会话长轨迹下值函数估计的困难。
核心方法
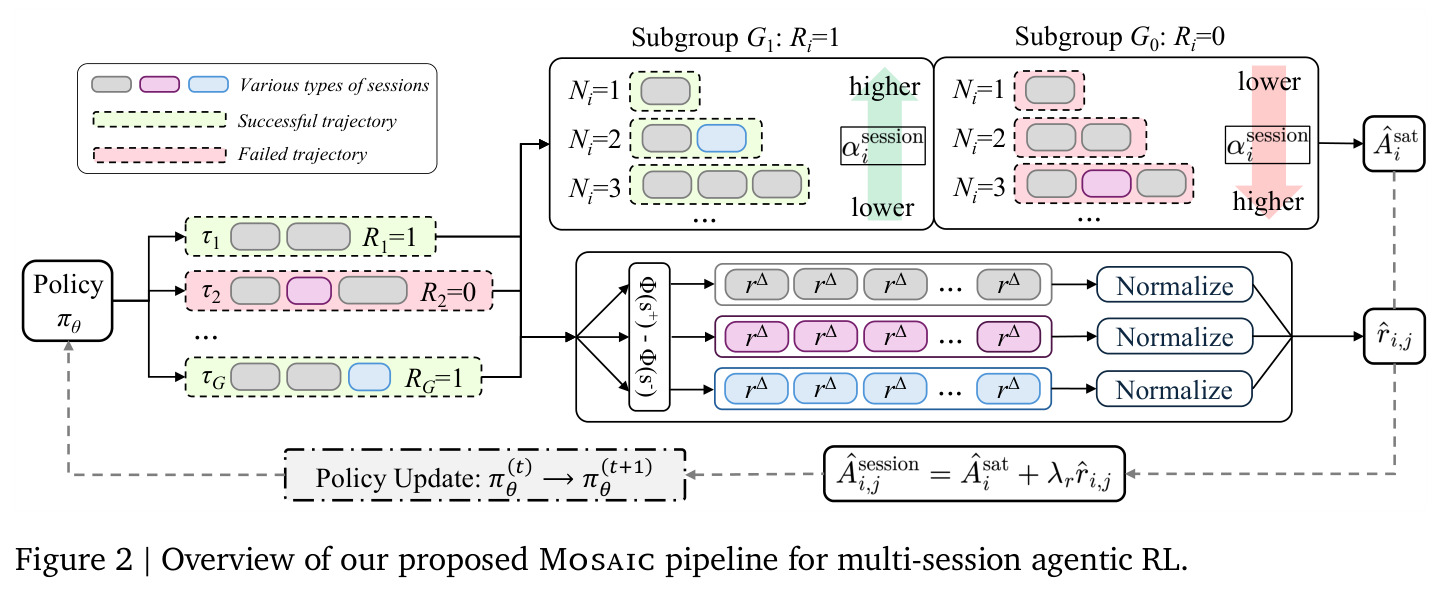
直觉上,Mosaic 把一次任务看成一部多集连续剧:结局(任务成败)决定主基调,但每一集(会话)是否推动剧情也值得区分对待。技术上它是一个免 critic 的分层优化框架。上层是会话感知的轨迹级优势估计:在 GRPO 组内相对优势 $\hat{A}^{traj}_i$ 基础上,按任务结果把组分成成功/失败子组,在子组内对会话数 $N_i$ 做中心化排名得 $u_i\in[-1,1]$,用调制因子 $\alpha^{session}_i=-\rho u_i$ 构造 $\hat{A}^{sat}_i=(1+\alpha^{session}_i)\hat{A}^{traj}_i$,$\rho=0.2$ 保证缩放系数恒为正。下层是会话级优势整形:把每个会话视为状态转移 $v_{i,j-1}\to v_{i,j}$,用更新前策略 $\bar{\theta}$ 计算真实答案的似然势函数 $\Phi$,取 stopgrad 的边际增益 $r^{\Delta}_{i,j}$ 作即时奖励,组内按会话类型归一化后以 $\hat{A}^{session}_{i,j}=\hat{A}^{traj}_i+\lambda_r\hat{r}_{i,j}$($\lambda_r=0.1$)与轨迹优势合并。前者提供长期、结果导向的全局信号,后者捕捉短期局部边际效应,共同构成多会话 agentic RL 的层级优化目标。
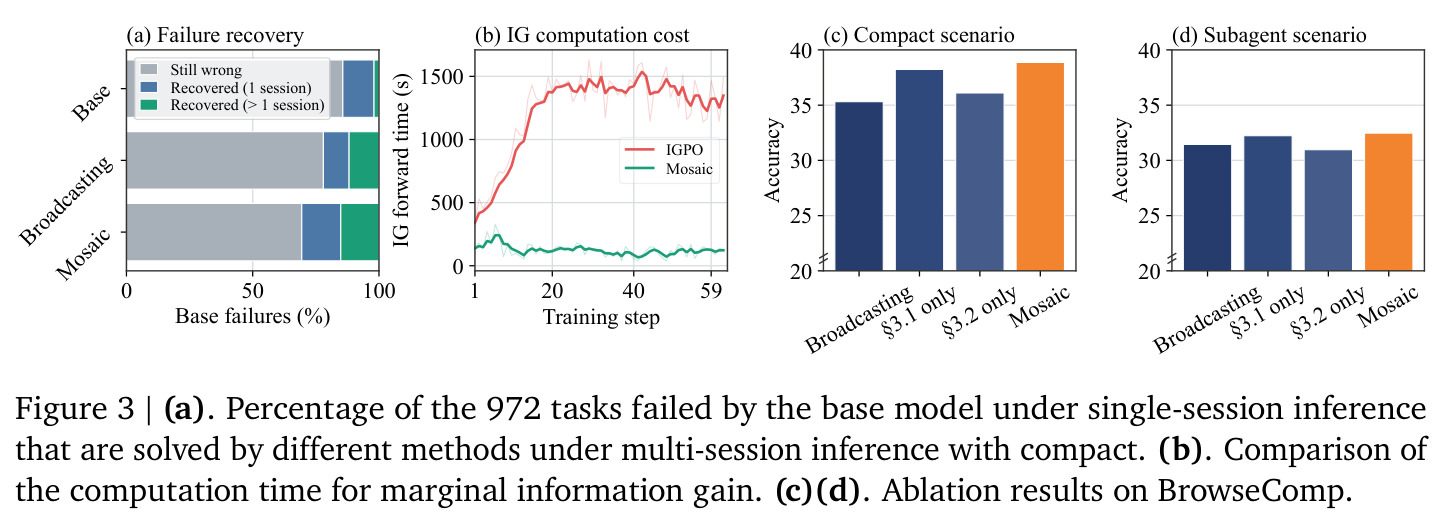
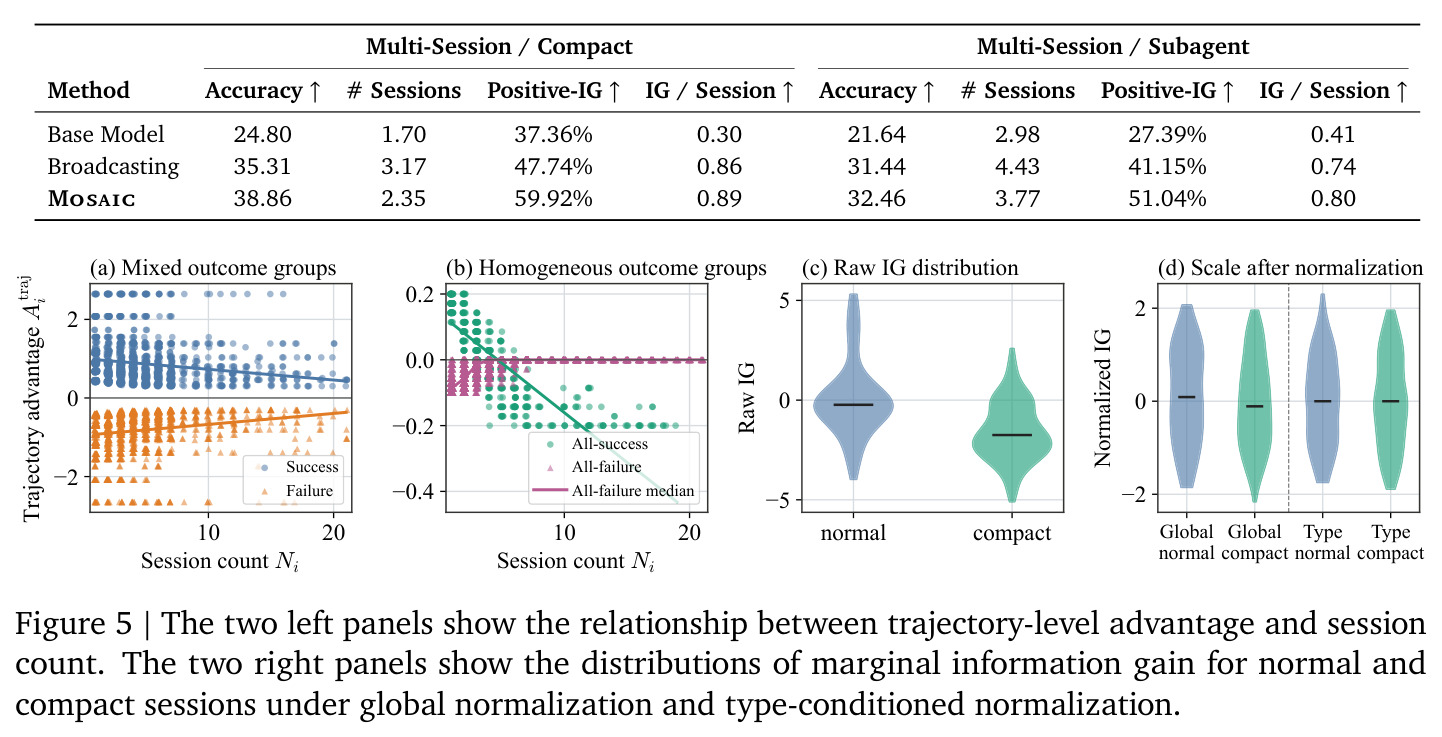
核心创新是「结果主导、会话调制」的层级信号设计,与已有方法的本质区别有三点。其一,相对 broadcasting:broadcasting 给所有会话同一标量优势,监督粒度粗且对会话分配完全无约束;Mosaic 在轨迹层让会话数参与优势调制,且调制方向依赖任务结果——成功轨迹内会话更多则优势更低(鼓励高效),失败轨迹内会话更多反而优势更高(鼓励探索),并用中心化排名而非原始计数保证信号有界、抗长尾。其二,全同组回退:当组内全成功或全失败时 GRPO 优势为 0、会话信号随之失效,Mosaic 用 $-\beta_1 u_i$(全成功)和 $\beta_0\min(u_i,0)$(全失败,且只罚不奖以确保无失败轨迹获得正优势)注入差异化信号,提升这类高频出现情形的样本效率。其三,相对 IGPO 等 turn 级信息增益方法:Mosaic 把信息增益定义在会话边界的答案似然势差分上,计算量大降(图 3b),并首创按会话类型分组归一化——实验显示全局归一化会系统性压制原始增益均值偏低的压缩会话,类型化归一化让两类会话各自获得相对自身基线的正负信号。三个约束 C1/C2/C3 保证结果奖励始终主导优势排序。
方法步骤详情
流程分四步。第一步,多会话 rollout:Qwen3.5-4B 以 ReAct 循环调用 search(Serper)和 visit(Jina Reader)两个工具;上下文逼近 128K 上限时触发压缩会话,或调用非嵌套子代理产生分支会话;训练集为 REDSearcher_RL_1k 的 1000 个高难深搜任务,rollout batch 16、组大小 8,训练 1 epoch。第二步,轨迹级优势:LLM 裁判(deepseek-v4-flash)打二元奖励 $R_i\in\{0,1\}$,组内标准化得 $\hat{A}^{traj}_i$;按 $R_i$ 分子组,子组内对 $N_i$ 升序中心化排名得 $u_i$,计算 $\hat{A}^{sat}_i=(1-\rho u_i)\hat{A}^{traj}_i$;子组过小或方差为 0 时置 $u_i=0$;全同组启用回退(全成功 $-\beta_1 u_i$、全失败 $\beta_0\min(u_i,0)$,后者只罚不奖)。第三步,会话级整形:对每个会话边界 $v_{i,j-1}\to v_{i,j}$,用更新前策略计算答案逐 token 对似然均值 $\Phi$,stopgrad 取差得 $r^{\Delta}_{i,j}$;组内同类型会话归一化为 $\hat{r}_{i,j}$,最后一个会话(含最终答案)置 0 以免污染分布;合成 $\hat{A}^{session}_{i,j}=\hat{A}^{sat}_i+\lambda_r\hat{r}_{i,j}$。第四步,token 级更新:会话优势广播到 token,按公式 (8) 做 token 加权的 GRPO clip 目标,各会话作为独立训练段(Megatron 风格)在轨迹层聚合更新。
技术新颖性
新颖性可从四个坐标看。(1) 问题形式化:首次明确提出「多会话智能体 RL」设定,给出会话级轨迹表示 $\tau_i=\{s_{i,j}\}_{j=1}^{N_i}$,把上下文压缩和子代理分叉统一进一个训练框架——此前的多会话工作只是用 broadcasting 承认了多会话的存在,没有针对它设计优化信号。(2) 信号设计:与 PPO 类需要学习 critic 的方法不同,Mosaic 全程免 critic——轨迹层用组内排名调制、会话层用答案似然差分,避免了长会话下训练价值模型的开销与估计误差。(3) 与 IGPO 的区别:IGPO 在单会话内逐 turn 计算信息增益,Mosaic 把粒度粗化到会话并按类型归一化,图 3b 显示这大幅削减了计算边际增益的墙钟时间,同时性能反超(38.86 对 31.36)。(4) 有界调制思想:$\alpha^{session}$ 只在 $[-\rho,\rho]$ 内缩放优势、绝不翻转符号,是一种保守的辅助信号注入方式,理论上不破坏结果奖励诱导的排序;作者进一步证明它在同质奖励组内能扩大组内优势方差,直接转化为训练样本效率的提升。
实验结果
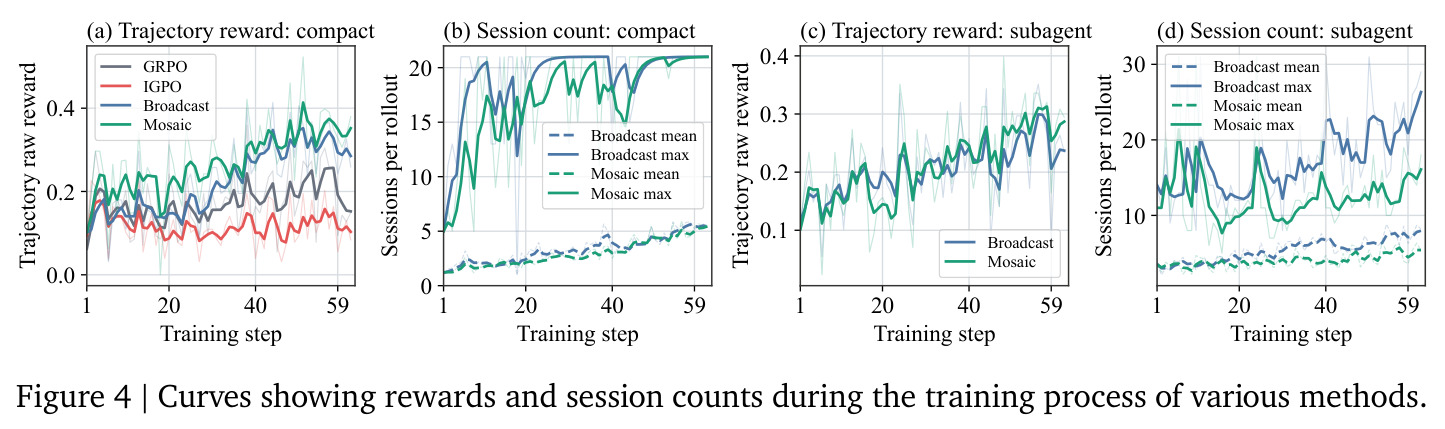
主实验在 BrowseComp(1266 道深搜题)上进行,基座为 Qwen3.5-4B。RQ1 总体有效性:Mosaic 压缩场景达 38.86% 准确率、平均 2.35 会话,对比 broadcasting 的 35.31%、3.17 会话,相对提升 10.1% 且更省会话;子代理场景 32.46% 对 31.44%。单会话训练的 GRPO 单会话推理仅 31.99%,配合多会话推理也只有 34.68%(压缩)和 31.91%(子代理),证明多会话推理能力无法靠泛化获得;IGPO 仅 28.52%/31.36%/24.64%,且其 turn 级信息增益计算墙钟时间远高于 Mosaic(图 3b)。RQ2 消融(图 3c,d):两个组件各自有效,合并后压缩场景增益显著、子代理场景温和,归因于子代理轨迹是 DAG 结构、即时边际增益与实际贡献脱节。RQ3 机制分析(图 5):优势随会话数的排序符合 C1/C2/C3 设计,全同组回退注入了差异化信号,类型化归一化修正了对压缩会话的系统性压制。RQ4 行为模式(表 2):压缩场景下 Mosaic 正增益会话占比 59.92%、每会话 IG 0.89,均高于 broadcasting 的 47.74%/0.86 且会话更少——收益来自会话效用与分配的改善,而非会话数量增加。训练动态(图 4)显示 Mosaic 奖励上升更快、会话数增长更早趋缓。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BrowseComp 多会话推理(上下文压缩) | 准确率 (%) | 38.86(Mosaic,平均 2.35 会话) | 35.31(broadcasting);34.68(单会话 GRPO + 多会话推理) | 相对 broadcasting +10.1%(+3.55 点),会话数 3.17→2.35 减少 25.9% |
| BrowseComp 多会话推理(子代理分叉) | 准确率 (%) | 32.46(Mosaic,平均 3.77 会话) | 31.44(broadcasting,平均 4.43 会话) | +1.02 点,会话数减少 14.9% |
| BrowseComp 压缩场景 vs 信息增益基线 | 准确率 (%) | 38.86 | 31.36(IGPO,turn 级信息增益) | +7.5 点,且边际增益计算墙钟时间大幅降低 |
| BrowseComp 会话效用(压缩场景) | 正增益会话占比 / 每会话 IG | 59.92% / 0.89 | 47.74% / 0.86(broadcasting) | 正增益会话占比 +12.18 点,效用提升的同时会话更少 |
| BrowseComp 基座对比 | 准确率 (%) | 38.86(Mosaic,压缩推理) | 23.22(Qwen3.5-4B 原始,单会话) | +15.64 点,显示多会话训练 + 多会话推理的整体收益 |
局限与改进
作者承认的局限:(1) 子代理场景提升温和(32.46 对 31.44),因为子代理轨迹是非线性 DAG,一个会话可能影响多个后继会话,即时边际增益无法反映其对最终结果的真实贡献;(2) 会话数只是探索强度与执行成本的代理信号,与真实代价并非严格对应,推理时模型也没有事后信息,不知道轨迹会用多少会话、会不会成功;(3) 多会话会放大轨迹长度和完成时间的方差,异步训练/部分 rollout 下的策略陈旧与组内比较问题未解决(实验刻意用了同步的 colocated 设置来隔离干扰);(4) 高质量多会话公开训练数据稀缺,限制实验规模与可复现性。我补充的观察:(5) 方法依赖真实答案 $y^*$ 计算答案似然势,只适用于可验证答案的任务,开放式任务无法直接套用;(6) 只在 Qwen3.5-4B 一个模型、BrowseComp 一个基准、1000 条训练任务上验证,规模效应与跨基准泛化存疑;(7) 结果奖励假设为二元 $\{0,1\}$,无法处理部分得分,排序约束的推导也依赖二元性;(8) 依赖外部 LLM 裁判(deepseek-v4-flash)判分,裁判噪声会直接传导进优势估计。
独立分析的弱点
独立分析四个弱点。第一,答案似然势函数 $\Phi$ 需要标准答案,且用被训练策略自身估计似然:任务不可验证或答案多解时(如开放式调研、报告写作)信号失真,策略还可能学会「给自己喜欢的答案打高分」——改进方向:用可验证子目标分解、或用带引用一致性的 NLI 打分替代答案似然,或用冻结的参考模型估计势函数。第二,DAG 结构下的信用分配粗糙:子代理会话的边际增益在委托点度量,但其价值可能体现在后续合并结果中,这解释了子代理场景仅 +1.02 点的温和收益——改进方向:沿 DAG 反向传播增益、对合并会话单独设类型与势函数、或用轨迹级回报对会话做滞后相关分析。第三,超参数共 4 个($\rho=0.2,\beta_0=0.1,\beta_1=0.2,\lambda_r=0.1$),其中 $\lambda_r$ 控制的过程信号强度对不同任务的会话分布敏感,论文未做敏感性分析,跨任务迁移时调参成本高——改进方向:按归一化增益方差自适应调节 $\lambda_r$,或对 $\rho$ 做退火。第四,压缩会话的输入状态是压缩前的完整上下文,意味着计算势函数差分需要对长上下文做前向,接近窗口上限时开销可观——改进方向:利用差分可拆性分别缓存两次状态评估,或用小尺寸代理模型估计答案似然。
未来方向
作者在讨论章提出四个方向:(1) 基础设施——构建公开的多会话训练数据集与配套智能体执行环境,解决多会话 agentic RL 研究的可复现性瓶颈;(2) 把跨会话状态迁移作为中心学习目标——压缩要保留工作状态、分叉要传递子任务所需信息、合并要整合结果为主代理可用的状态,三者共享「有限上下文预算下该携带什么信息」这一核心问题,CompactionRL 已联合优化执行与摘要,统一三者并系统研究信息损失与误差累积是重要方向;(3) 异步训练——多会话拉长轨迹完成时间差、加剧策略陈旧,需研究 critic-free 组相对优化下的 rollout 分组时机、陈旧样本处理与轨迹复用;(4) 走进黑盒 harness——在 Claude Code 等编排部分不透明的智能体框架内做 RL,系统研究丢 reasoning token、丢工具响应等破坏上下文连续性的机制,以及新会话边界与有损拼接的选择对优化效果的影响。基于本文成果可延伸:把会话效用(正增益占比、每会话 IG)从分析指标升级为显式优化目标;把类型化归一化推广到合并、验证、反思等更多会话类型;在更大的模型和 GAIA、HLE 等更多基准上检验规模效应。
复现评估
复现难度中等偏高。论文给出项目主页(lark-ai-lab.github.io/Mosaic/),正文未见明确开源代码链接,需关注仓库是否随后放出。有利条件:超参数完整($\rho=0.2$、$\beta_0=0.1$、$\beta_1=0.2$、$\lambda_r=0.1$、组大小 8、batch 16、1 epoch、每会话 128K),基座模型(Qwen3.5-4B)与裁判模型(deepseek-v4-flash)明确,信号计算在公式 (10)-(18) 中描述充分。不利条件:训练集 REDSearcher_RL_1k 是否公开未说明;依赖 Serper 搜索 API 和 Jina Reader,rollout 有真实费用;需要支持多会话、多训练段的 RL 基础设施(Megatron 风格分段聚合),veRL/TRL 等常用框架需改造;信息增益要在每个会话边界对完整上下文做策略前向,长任务下开销不小。粗略估计:1000 任务 × 组大小 8 × 约 60 步的深搜 rollout,API 与 GPU 成本对个人研究者偏重,适合有 4-8 卡以上资源、有 agentic RL 经验的团队;若只复用信号设计思路(有界调制 + 类型化归一化),成本低得多。
论文图表
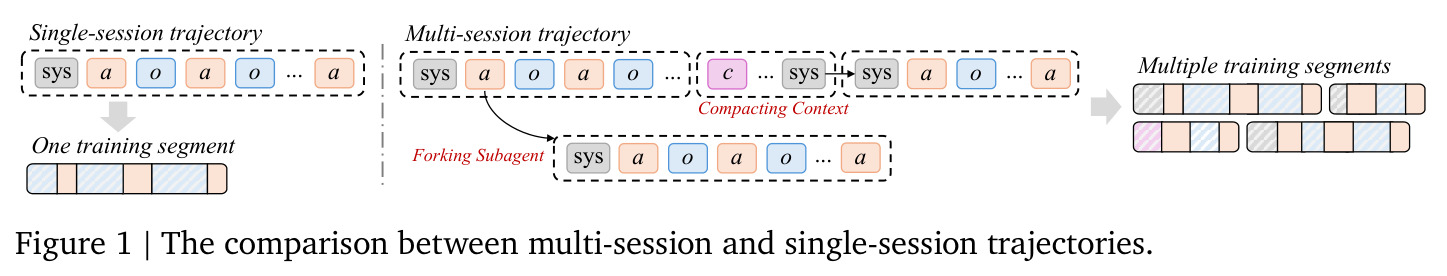
对比图:上半部分是单会话轨迹——系统提示加连续的动作-观察序列,形成单个训练段;下半部分是多会话轨迹——上下文压缩(Compacting Context)开启新会话、子代理分叉(Forking Subagent)产生分支会话,一条轨迹被切分成多个训练段。
一图说清本文要解决的核心概念:多会话轨迹从何而来、为何与单会话训练假设冲突。看懂它才能理解问题设定。