词汇参考系:在模型原生语义中解读语言模型残差流 Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
让模型用自身剩余层按可控的上下文量读取隐藏状态,无需训练即可在词表原生语义中忠实解读每层
前置知识
残差流 (residual stream)
Transformer 每层的计算都可写成对同一条向量的读写:第 $k$ 层读取 $x_{k-1}(t)$,经注意力与前馈块产生更新并写回,得到 $x_k(t)=F_k(x_{k-1}(t),\,a_k(t))$,其中 $a_k(t)$ 是该层在位置 $t$ 的注意力输出,依赖其他位置的状态。整条链路上模型计算的就是这些状态本身。
论文的全部对象就是残差流上的隐藏状态 $x_\ell(t)$:所谓读取一个状态,就是选择一个参考系把它映射到词表;理解残差流的读写结构,才能理解参考系为何由剩余层诱导、为何随上下文变化。
透镜方法 (logit / tuned / Jacobian lens)
logit lens 直接把中间状态套用最后一层的 unembedding 得到每层 logits;tuned lens 为每层训练一个仿射映射去匹配最终输出;Jacobian lens 用剩余层 Jacobian 在位置与提示上平均后的映射。共同点:每层只有一组固定的读出方向,对所有上下文一视同仁。
透镜是本文的主要对照组。作者证明这类每层一映射的方法受 $\sqrt{\kappa_\ell}$ 相干性上界约束,中层必然偏离模型自身读出,这是全文立论的起点。
词法基与语义基 (lexical basis / semantic basis)
在输出端,词 $v$ 的居中 logit 为 $c_v=z_v-\frac{1}{|V|}\sum_u z_u$;与指示向量 $e_v$ 在最小二乘意义下最接近的状态是 $s_v=W^+e_v$,即该词的语义基。按词表排列的这组向量称为词法基,是模型原生语义的坐标轴,输入端与输出端各有一套且固定不变。
参考系的两半——测量词的读出方向 $b_\ell(v)$ 与写入词的基 $s_\ell(v)$——都由词法基经剩余层传输或拉回得到,是方法与实验的核心对象。
逐层传输与 Jacobian
把状态 $x_\ell(t)$(前缀状态固定)传到最后一层的映射 $T_\ell$ 称为逐层传输;$J_\ell=\partial N(T_\ell)/\partial x_\ell(t)$ 是传输接最终归一化的 Jacobian。词 $v$ 的词法读出 $b_\ell(v)=J_\ell^\top(w_v-\bar w)$ 正是该词 logit 对状态的梯度方向,随层与上下文而变。
Jacobian 是原生帧的数学载体:因为 $J_\ell$ 包含全部剩余层且这些层会关注前缀,读出才逐状态不同;理解它才能明白固定透镜为何有界、干预为何可用一阶近似。
相干性与 √κ 上界
相干性 $\kappa_\ell(v)$ 定义为词 $v$ 在来自不同序列的状态上的单位词法读出之间的平均余弦,度量读出方向随上下文漂移的程度。论文证明:任何与状态无关的固定单位向量 $u$,与这些读出的平均余弦不超过 $\sqrt{\kappa_\ell(v)}$。
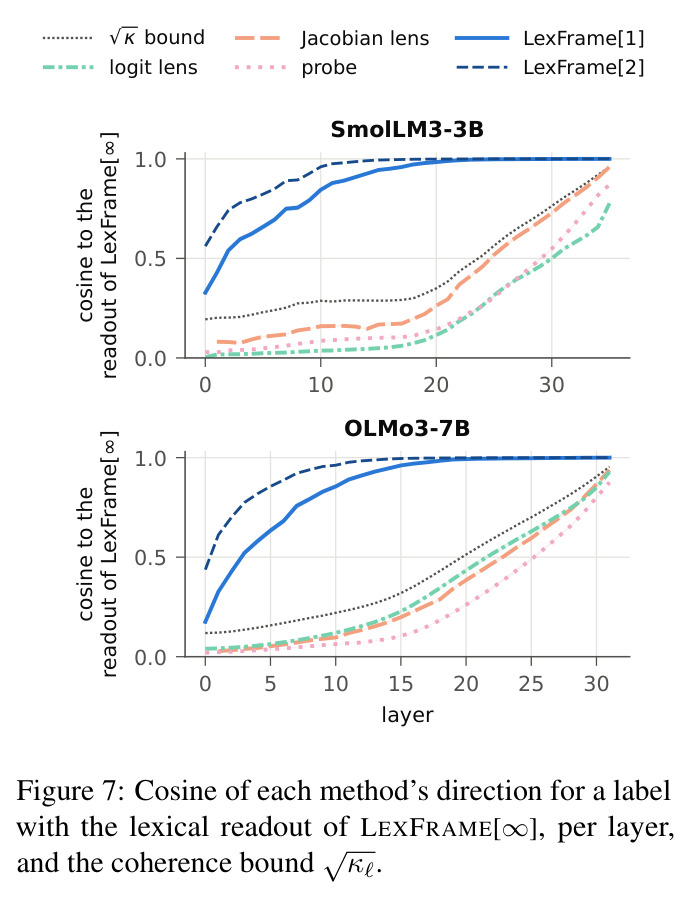
这是论文的核心定理:中层 $\sqrt{\kappa}$ 仅 0.30/0.35,任何透镜都不可能超过它,而 LEXFRAME[1] 达 0.97/0.97,从理论上说明透镜失效是结构性的而非拟合不足。
激活引导与归因
激活引导 (steering) 通过沿某方向平移隐藏状态来改变模型输出;归因 (attribution) 量化某组件(层、注意力子层、MLP 子层)对最终预测的贡献,常用方法有投影到输出方向、activation patching 与 attribution patching。
帧的两组坐标恰好对应这两个应用:基用于写入(引导),系数差用于归因;论文用它们检验帧坐标的因果有效性,是结果部分的关键实验。
研究动机
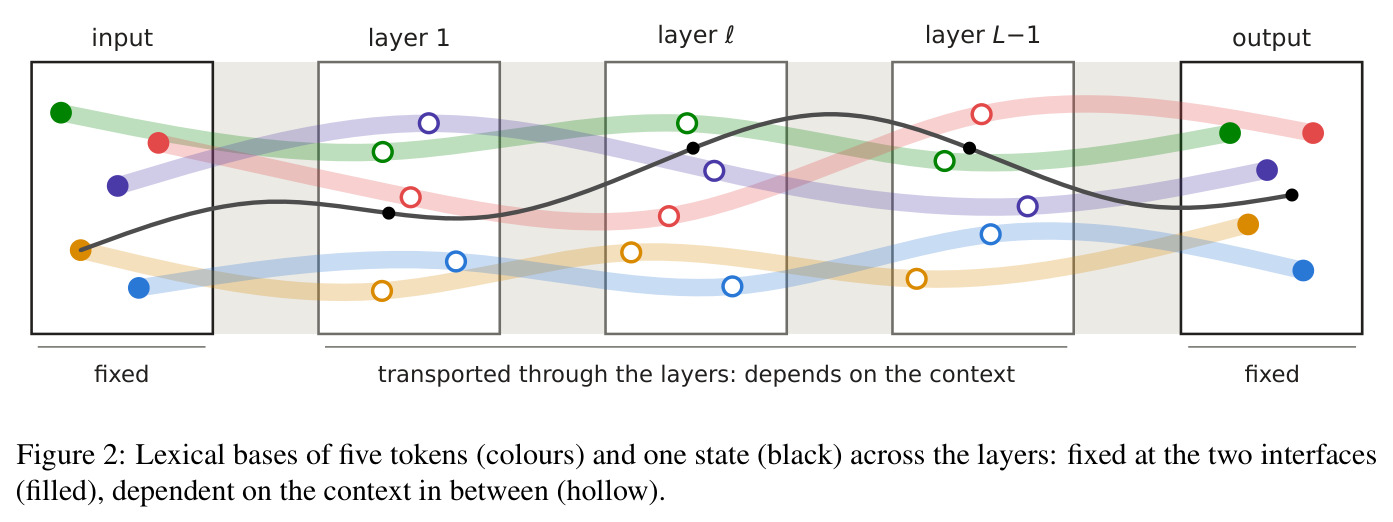
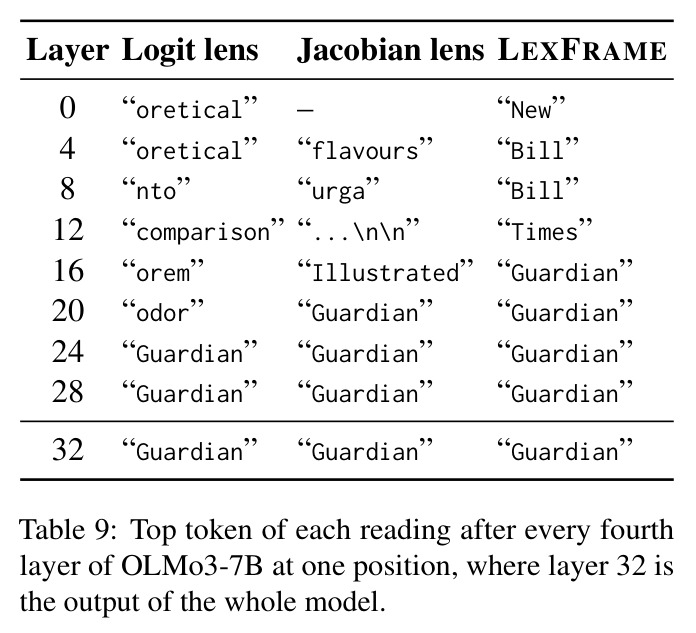
现有解读语言模型中间层状态的方法分两类,各有结构性缺陷。第一类是透镜:logit lens 直接用输出帧读每一层,tuned lens 为每层拟合一个仿射映射,Jacobian lens 用剩余层 Jacobian 的平均。它们每层只有一个固定映射,状态无论处于什么上下文都被同一方式读取。论文在 OLMo3-7B(32 层)上量化了后果:第 16 层之后,logit lens 对一个词的读出方向与模型自身词法读出方向的偏差中位数达 75 度,Jacobian lens 达 77 度,距输出还有四层时两者仍至少偏 40 度。第二类方法干脆不做解读,把一层的状态视为点云,报告层间相似度、内在维度、有效秩、各向异性等统计量;但这些统计量只描述状态如何分布,不说明模型如何使用它们——点云中相近的两个状态可能导致不同预测,遥远的两个却可能导致相同预测。问题在于大量下游应用恰恰依赖忠实读态:早期退出与自推测解码要在读数已命名输出的层截断计算,幻觉检测用隐藏状态判断答案,知识编辑在中间层定位并改写事实,蒸馏用学生匹配教师中间状态;读得不准,这些应用就建立在错误的地基上。
本文的目标是本文的目标是把模型如何读取一个隐藏状态这一问题形式化,并据此构造一种忠实、无需训练、且跨层、跨 checkpoint、跨模型可比的解读方法。具体包括三件事:其一,论证每个隐藏状态都拥有一个由剩余层(该状态之后所有层)诱导、随上下文自适应的原生参考系,其坐标轴就是词表——模型被设计为接收和表达的唯一意义单元,输出帧只是它在最后一层的特例。其二,证明任何每层一个固定映射的透镜都无法跟随这个参考系:其方向与原生帧读出的平均余弦受相干性平方根 $\sqrt{\kappa_\ell(v)}$ 约束,从而把透镜中层失效从经验现象升级为定理。其三,提出一族按保留多少位置间注意力计算分级的近似帧 LEXFRAME[n],在不拟合模型输出的前提下闭式计算,让中间层读数在方向(与原生读出的余弦)和分布(与模型输出的 KL 散度)两方面逼近模型,并验证这些坐标可直接支撑引导、归因与置信度提前退出等干预应用。
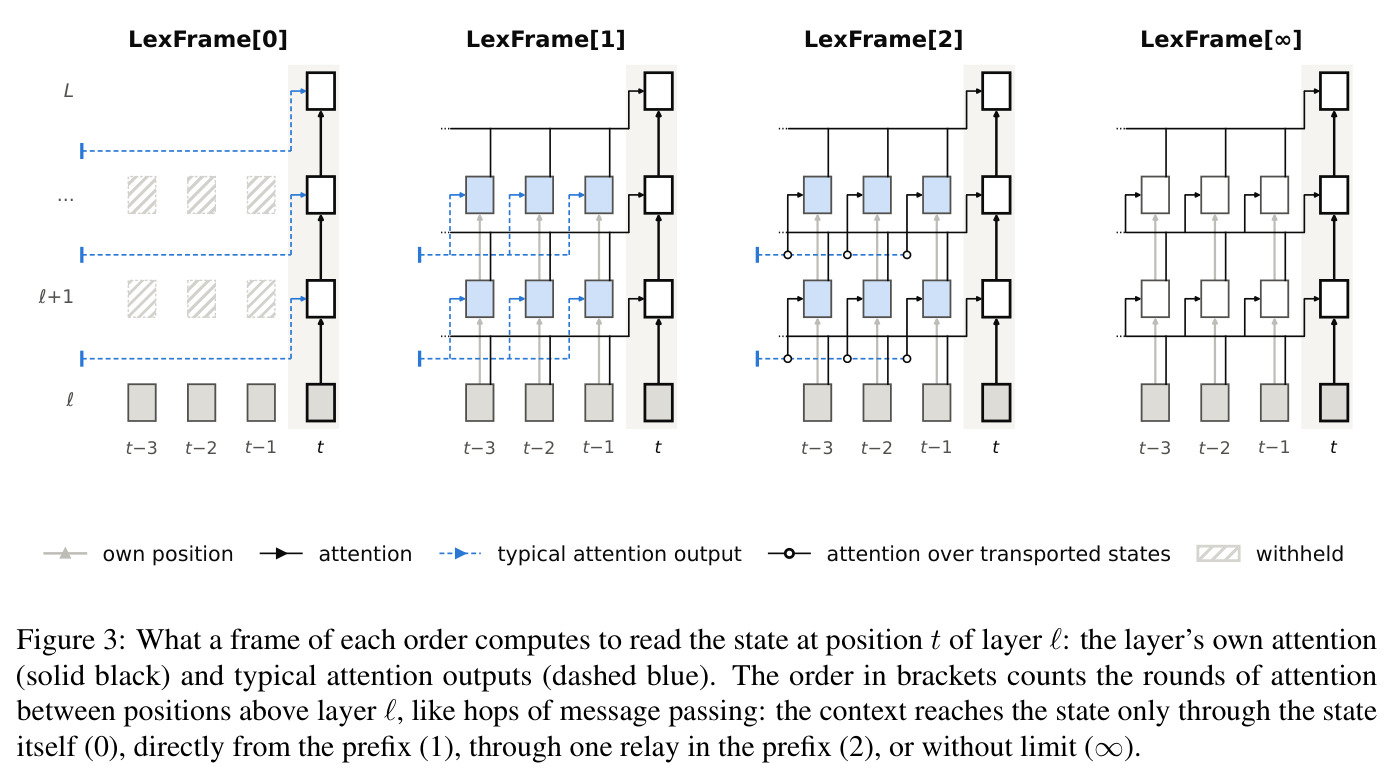
与已有工作不同的是,独特切入角度是把解读状态重构为选择参考系的几何问题,并指出参考系不该由外部方法强加,而应从模型自身导出:embedding 与 unembedding 在残差流两端固定了每个词的意义,中间层状态的意义则由接下来要读它的那些层决定,因此帧必须逐状态、逐上下文重新确定。已有工作从未在此框架下提问:透镜是固定帧(一个映射管所有状态),点云是无帧(只有分布没有坐标),线性探针是监督出来的固定读出。本文的关键观察是,词 $v$ 的 logit 对状态 $x_\ell(t)$ 的梯度 $b_\ell(v)=J_\ell^\top(w_v-\bar w)$ 天然构成随层、随上下文变化的参考系方向。在此之上作者引入阶 (order) 的创新设计:用 $n$ 轮位置间注意力加每层拟合一次的典型注意力输出替代其余计算,把利用多少上下文变成可控旋钮——LEXFRAME[0] 读状态自身、[1] 加一轮到前缀的注意力、[2] 再加前缀内部交换、[∞] 即模型本身,相邻阶之差精确度量每一跳注意力对状态的贡献,这是所有已有方法都不具备的分析工具。
核心方法
直觉很朴素:想知道模型怎么读一个隐藏状态,就让模型自己来读——把该状态连同它能看到的前缀送进模型剩余的层继续前向计算,最后在词表上读出;不想保留全部计算时,就用典型注意力输出顶替一部分注意力。技术路线上,设 $x_\ell(t)$ 为第 $\ell$ 层位置 $t$ 的状态,定义逐层传输 $T_\ell$:前缀固定,把状态传到最后一层。原生帧的读出是被拉回输出帧的梯度 $b_\ell(v)=J_\ell^\top(w_v-\bar w)$,词法基 $s_\ell(v)=J_\ell^+ s_v$ 用岭正则的最小范数逆求解,读数即传输后系数 $z_\ell(v)=\langle w_v,\,N(T_\ell(x_\ell(t)))\rangle$ 给出的下一词分布。LEXFRAME[n] 把 $T_\ell$ 替换为只计算 $n$ 轮位置间注意力的传输,其余注意力用 $\hat a_k(u)=\bar a_k+(u-\bar u_k)G_k$ 代替,$G_k$ 为在校准文本上每层拟合一次的岭回归。整个方法对模型输出零拟合、全部闭式可算,因此跨层跨模型可比。
核心创新是证明固定映射有不可逾越的上界,而随上下文自适应的帧没有。附录 C.2 证明:与状态无关的单位向量 $u$ 与词 $v$ 在不同序列状态上的单位读出 $\hat b_i$ 的平均余弦满足 $u^\top\bar b\le\|\bar b\|\to\sqrt{\kappa_\ell(v)}$,即受跨上下文相干性平方根约束。SmolLM3-3B 与 OLMo3-7B 中层的界仅 0.30 和 0.35,Jacobian lens 在所有层都不超界、监督探针更低(0.21–0.36),而 LEXFRAME[1] 达 0.97 和 0.97——这不是拟合得更好,而是它的方向随状态与上下文改变,根本不在被 bound 支配的固定方向类里。与已有方法的本质区别有三:相比透镜,帧利用而非忽略上下文,且不拟合模型输出(拟合输出恰是评分所依赖的量,存在循环),因此跨层、跨 checkpoint、跨模型可比;相比点云,帧提供了模型实际使用而点云变化几乎不含的方向;相比探针,帧无需任何标签。阶的设计进一步把上下文利用变成受控变量,使相邻帧之差可解释为每一跳注意力对状态的贡献。
方法步骤详情
完整流程四步。(1) 校准:在 256 条 128 token 的 WikiText-103 训练序列上做一次前向,为每层拟合典型注意力输出的岭回归 $G_k$(输入为该层注意力输入 $u$,输出为注意力输出 $a_k$),岭参数由两折交叉验证在固定网格上选取;全程无监督标签。(2) 选阶:LEXFRAME[0] 用模型自己的层块 $F_k$ 传输状态,但把所有注意力换成典型输出,读状态自身蕴含什么;LEXFRAME[1] 让状态在各层用自己的 query/key/value 对前缀做真实注意力,而前缀各位置按 [0] 方式独立演化,读状态从前缀汲取了什么;LEXFRAME[2] 让前缀位置之间再交换一轮信息;[∞] 即原生帧,等价于模型本身。(3) 计算:以阶 $n$ 读第 $\ell$ 层需 $n+1$ 条流并行通过剩余 $L-\ell$ 层,得到读出 $b_\ell^{(n)}(v)$、基 $s_\ell^{(n)}(v)$(岭参数 $\lambda=10^{-3}\|J_\ell^\top s_v\|^2/\|s_v\|^2$)、系数 $z_\ell^{(n)}(v)$ 与分布 $q_\ell^{(n)}$;实际用 30 步 LSMR 迭代免显式构造 Jacobian,一次前向模式积加一次反向积。(4) 应用:基用于引导(沿 $s_\ell(u)-s_\ell(v)$ 移动单个状态翻转预测),系数差用于归因(移除组件后系数变化对比实测效应),读数置信度用于提前退出。
技术新颖性
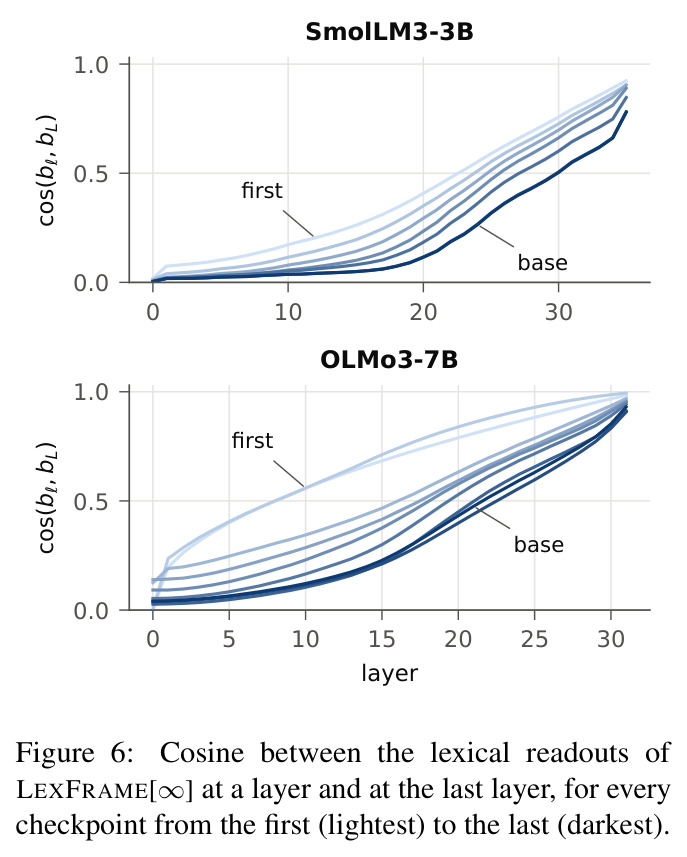
技术新颖性体现在四点。第一,理论上首次给出透镜的相干性上界定理,把 logit lens 中层失效从经验观察升级为结构性必然,并顺势解释训练动力学:SmolLM3 首个 checkpoint 中层余弦 0.34、随机初始化 OLMo3 为 0.71,随训练单调降到 0.07/0.26,说明 lens 恶化不是模型变得更难读,而是模型自身帧旋离了输出帧。第二,无拟合设计:tuned/Jacobian lens 拟合的对象恰是评分目标(模型输出),Jacobian lens 需约 $P\cdot d$ 次反向传播、拟合耗时为帧校准加全量读数的 18 和 44 倍;帧只需一次前向加每层一个低自由度岭回归,4 条校准序列(约 500 token)即可达 0.41/0.34 nats。第三,概念统一:透镜=不随上下文自适应的帧、探针=监督拟合的固定读出、点云=无帧的状态集合、layer skip=有注意力无传输的退化(7.00/2.59 nats),现有方法都成为帧的特例。第四,阶的设计类比消息传递的 hop 数,把注意力在位置间的信息流动量化为可逐阶差分的量,为研究多跳信息整合提供了新的测量工具。
实验结果
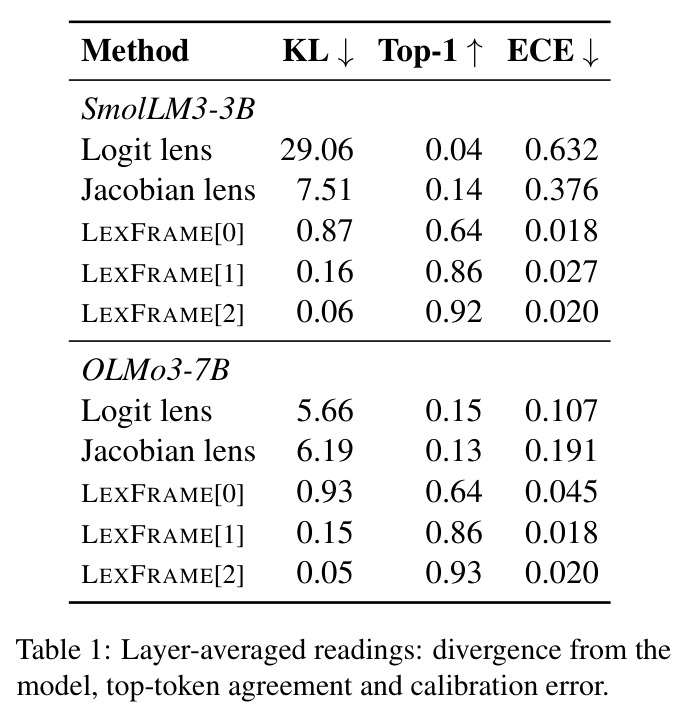
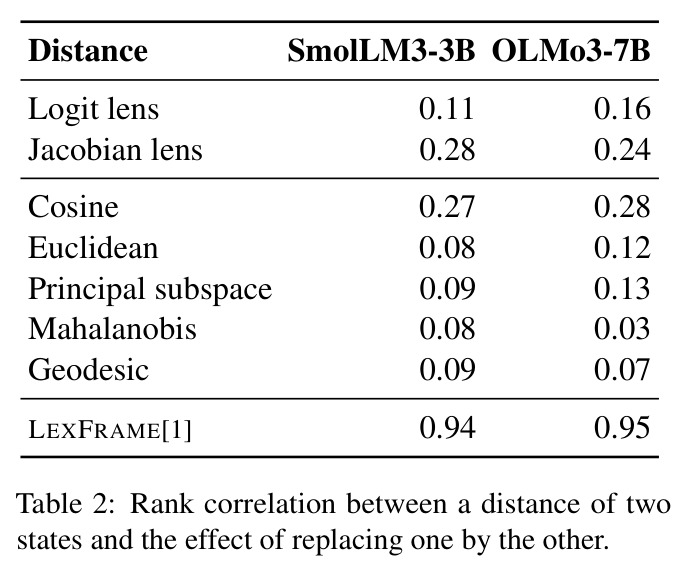
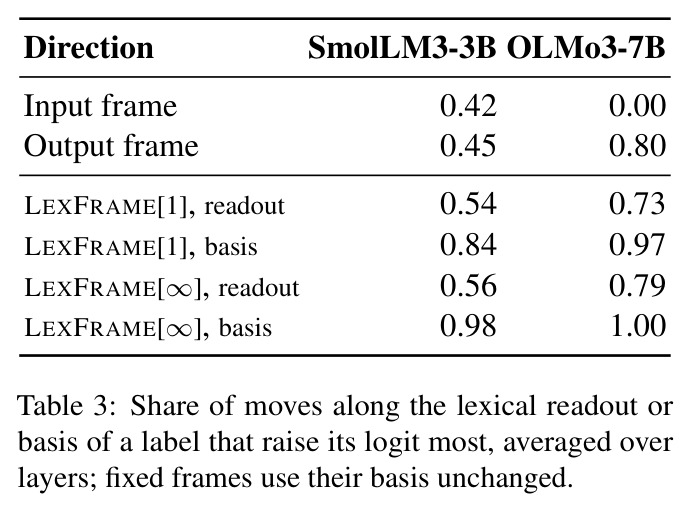
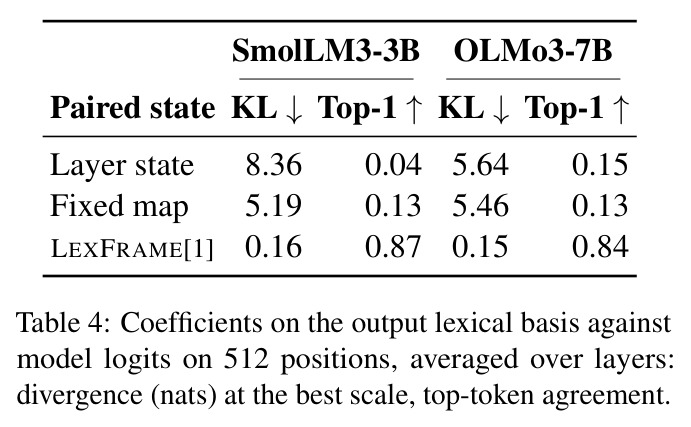
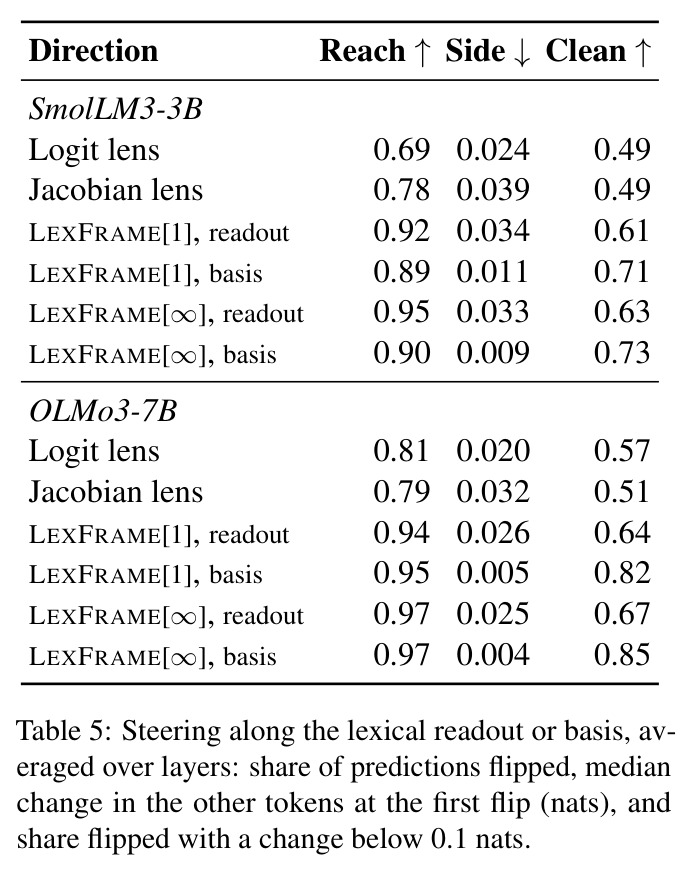
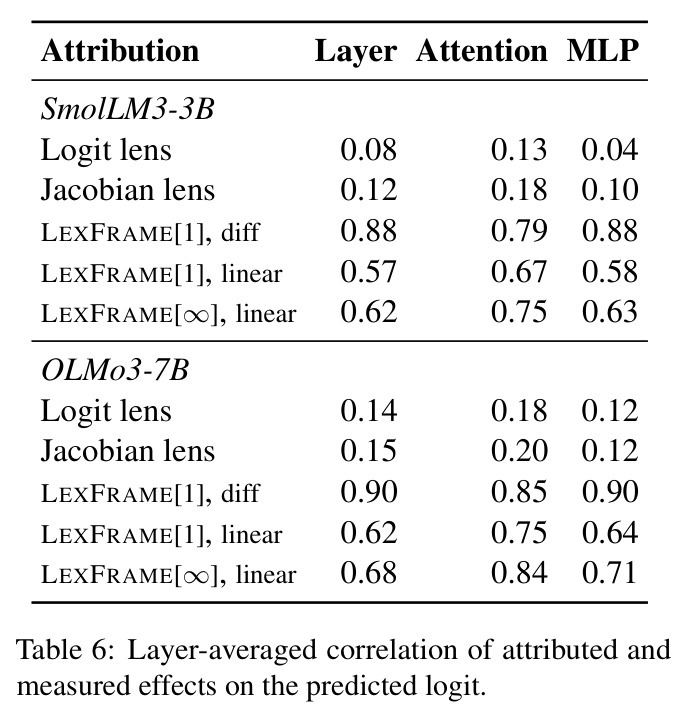
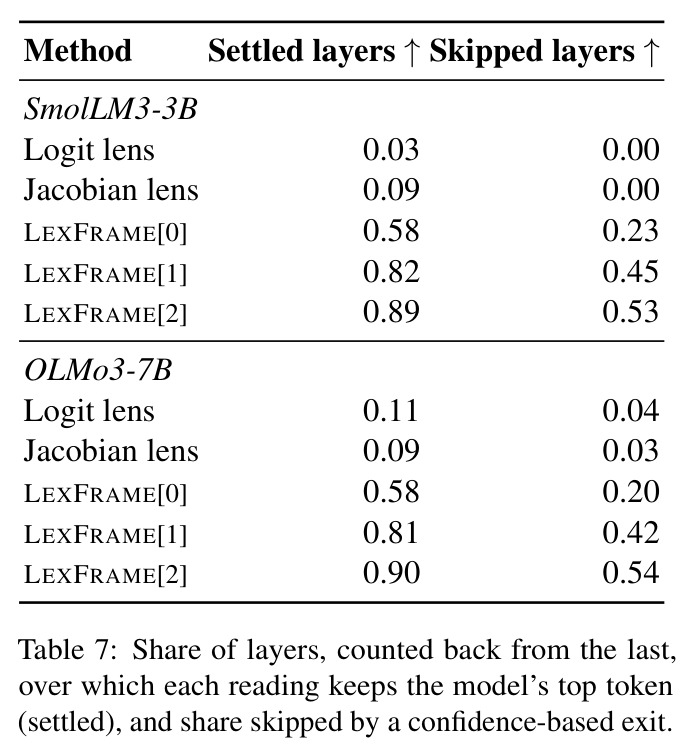
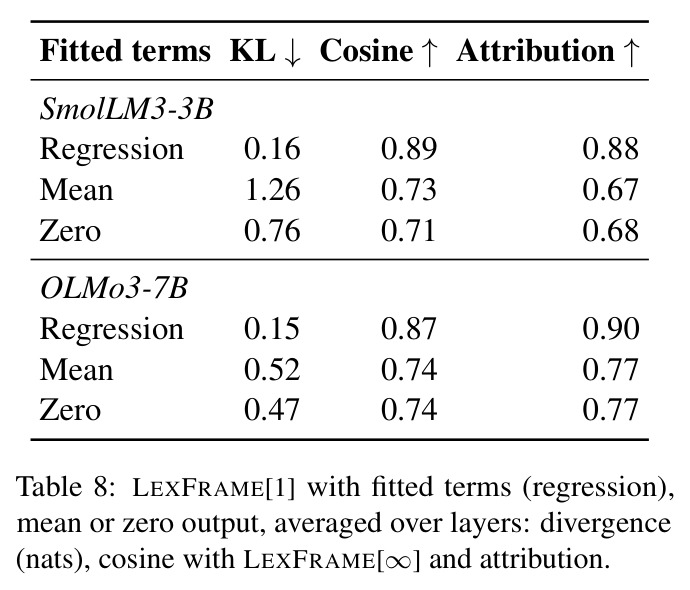
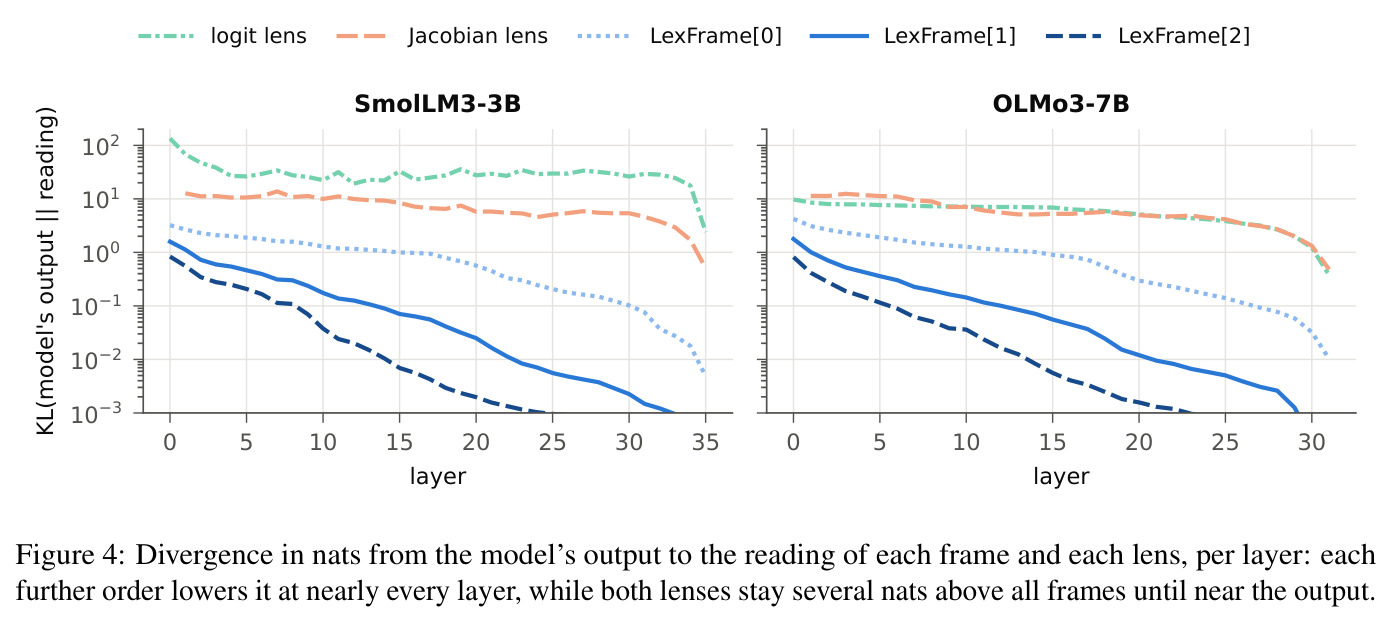
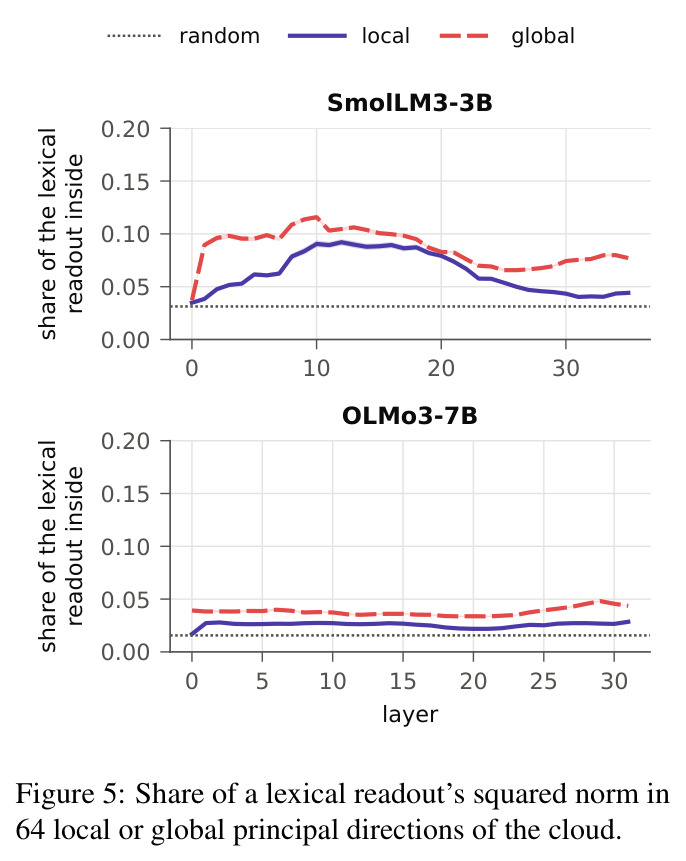
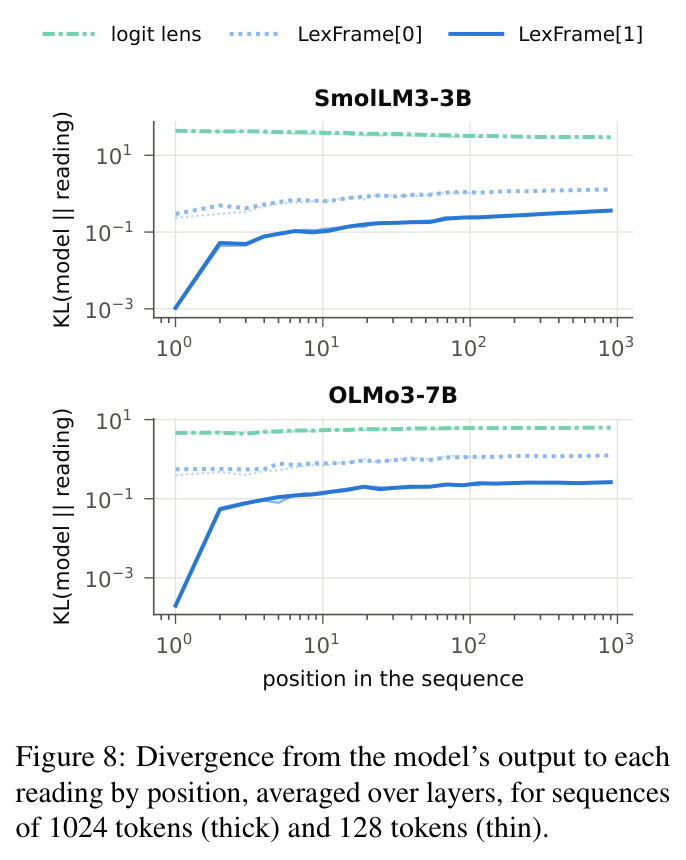
(1) 对透镜(Fig. 1/4、Table 1):层平均 KL 上 LEXFRAME[0] 已达 0.87/0.93 nats,远低于 logit lens 的 29.06/5.66 与 Jacobian lens 的 7.51/6.19;[1] 为 0.16/0.15,[2] 为 0.06/0.05。Top-1 一致率 [1] 为 0.86/0.86(自第 18/17 层起十分之九),透镜仅在输出前一两层过半;[1] 的 ECE 0.027/0.018 逼近模型自身的 0.018/0.023,其概率可当独立预测解读。自顶层回数 [1] 保持模型 top token 超过 0.82/0.81 的层,透镜至多 0.11;置信度提前退出可跳 0.45/0.42 的层,透镜至多 0.04。(2) 相干界(Fig. 7):中层 $\sqrt{\kappa}$ 为 0.30/0.35,[1] 达 0.97/0.97,Jacobian lens 全程不超界,监督探针 0.21–0.36。(3) 点云(Table 2、Fig. 5):每层 7961 对替换实验中任何点云距离的秩相关不超过 0.28(测地线 0.09/0.07 反而低于余弦 0.27/0.28),而 [1] 读数间距离达 0.94/0.95;词法读出落在局部 64 个主方向的占比峰值仅 9.2%/2.9%,约为随机方向(3.1%/1.6%)的 3 倍——点云主要描述剩余层忽略的变异。(4) 坐标(Table 3/4):沿词法基移动 0.1 范数使目标 logit 增益最大者占 0.98/1.00;系数对模型 logits 的 KL 为 0.16/0.15(层状态 8.36/5.64、固定映射 5.19/5.46)。(5) 引导(Table 5):[1] 基翻转 0.89/0.95、干净翻转(副作用<0.1 nats)0.71/0.82,透镜至多 0.49/0.57;第 16 层单位置中位步长 0.10/0.03,透镜需十倍。(6) 归因(Table 6):[1] 系数差与实测效应相关 0.88/0.90(MLP 0.88/0.90),logit lens 不超过 0.20;单位置中位相关 0.97/0.93。(7) 鲁棒性(Fig. 6/8、Table 7/8):logit lens KL 随训练从 4.82 恶化到 29.06,[1] 全程 top-1 不低于 0.85/0.86;1024 token 下 [1] 仅升至 0.25/0.18;消融中去掉岭回归 $G_k$ 使 KL 升至 0.76/0.47(置零)或 1.26/0.52(只留均值)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 中间层读数与模型输出的一致性(SmolLM3-3B / OLMo3-7B) | 层平均 KL 散度 (nats) | LEXFRAME[1] 0.16 / 0.15;[2] 0.06 / 0.05;[0] 0.87 / 0.93 | logit lens 29.06 / 5.66;Jacobian lens 7.51 / 6.19 | 较最优透镜降低约 47–125 倍 |
| 中间层 top-token 一致率 | 与模型 top token 一致的层平均比例 | LEXFRAME[1] 0.86 / 0.86 | logit lens 0.04 / 0.15;Jacobian lens 0.14 / 0.13 | +0.72 / +0.71 |
| 读数置信度(概率可否当独立预测) | 期望校准误差 ECE | LEXFRAME[1] 0.027 / 0.018 | logit lens 0.632 / 0.107;模型自身 0.018 / 0.023 | 逼近模型自身校准水平 |
| 词法读出方向追踪(中层) | 与 LEXFRAME[∞] 读出的平均余弦 | LEXFRAME[1] 0.97 / 0.97 | 相干性上界 $\sqrt{\kappa}$=0.30 / 0.35(任何透镜的上限),Jacobian lens 不超界 | 超界 3 倍以上,突破固定映射类方法极限 |
| 状态替换效应预测(每层 7961 对) | 距离与实测 logit 变化的秩相关 | LEXFRAME[1] 读数距离 0.94 / 0.95 | 最优点云/透镜距离 0.28 / 0.24 | 约 +0.66 |
| 激活引导 steering(翻转次优 token) | 干净翻转率(翻转且其他 token 变化<0.1 nats) | LEXFRAME[1] 基 0.71 / 0.82 | logit lens 0.49 / 0.57;Jacobian lens 0.49 / 0.51 | +0.22 / +0.25 |
| 组件归因(层/注意力/MLP) | 归因值与实测效应的层平均相关 | LEXFRAME[1] 系数差 0.88 / 0.90 | logit lens 0.08 / 0.14;Jacobian lens 0.12 / 0.15 | +0.7 以上 |
| 置信度提前退出 | 可跳过的层比例 | LEXFRAME[1] 0.45 / 0.42;[2] 0.53 / 0.54 | logit lens 0.00 / 0.04;Jacobian lens 0.00 / 0.03 | 10 倍以上(帧本身不省计算,仅揭示可跳深度) |
局限与改进
作者承认的局限:帧不省计算——[1] 要把状态传过剩余层,读全部层约需 $3(L+1)/2$ 次前向,作者明说 LEXFRAME[1] 的提前退出 saves no computation,只是揭示了透镜式退出浪费了多少深度;低阶帧在模型前部仍不准(embedding 处 [1] top-1 仅 0.42/0.39),而那里剩余计算最多;典型注意力输出依赖校准文本。我自己的观察:(1) 实验仅在 WikiText-103 英文文本(128/1024 token)与两个 3B/7B 开源模型上做,未测代码、对话、多语言等分布,而典型注意力的线性近似可能强烈依赖文本类型;(2) $\hat a_k(u)=\bar a_k+(u-\bar u_k)G_k$ 是一阶线性近似,对注意力高度特化的层(检索头、induction head)或多跳推理场景可能失真并随深度累积误差;(3) 干预评估停留在下一 token 预测:提前退出未报告真实生成的加速与质量,引导与归因未在多步生成任务或真实安全场景中与 ActAdd、CAA 等基线比较;(4) 帧的价值依赖读出随上下文变化大这一前提,在读出本来稳定的模型或高层,帧与透镜的差距会缩小,实用增益需重新评估;(5) 归因的线性假设对 MLP 明显失效(系数差相关 0.88/0.90,而 linear 版仅 0.57/0.62),说明高阶效应仍需超出帧一阶坐标的信息。
独立分析的弱点
独立分析的弱点与改进方向:(1) 计算结构——读一层要并行跑 $n+1$ 条流过所有剩余层,无法直接当推理加速器;改进方向是截断传输(只传过 $k<L-\ell$ 层)或把帧蒸馏成低成本学生读头,保留上下文自适应但免去全层前向。(2) 典型注意力输出的单一全局线性回归,在注意力行为强位置依赖时(长文档检索、代码结构跳转)会失效;改进:按注意力输入聚类拟合多个局部线性模型,或用轻量超网络按位置类型选择 $G_k$。(3) 校准与评估都限于 WikiText-103,分布外稳健性未知;改进:分域(代码、对话、多语言)校准并报告分域 KL,论文只试了同分布的三份切分。(4) 干预实验以能否翻转下一 token 为主,缺少下游任务效果、生成流畅度与安全场景(如拒绝行为引导)的检验;改进:在问答与推理链上与激活引导标准基线对比,并报告副作用分布。(5) Jacobian 计算需把权重转 32 位并逐层前向/反向,扩展到 70B+ 模型的显存与时间成本未讨论;改进:用随机投影或低秩近似 $J_\ell$。(6) 受试模型均较小且不含 MoE、线性注意力等变体,结论的架构普适性有待验证;改进:至少补充一个 MoE 模型的复制实验。
未来方向
作者明确提出的方向:把帧接入四类读态应用——早期退出与自推测解码(读数已能提前命名输出,Table 7 显示 [1] 的 settled 层比例达 0.82/0.81)、幻觉检测(按隐藏状态判读答案)、知识编辑(在中间层定位并改写事实)、模型压缩(蒸馏时以帧坐标匹配师生中间状态);并指出帧单次校准即可跟随模型经历训练、微调或编辑,可用同一单位纵向监测。基于本文成果可延伸的:(1) 把阶当作受控变量系统研究位置间多跳信息流——[1] 到 [2] 之差已能量化前缀内部交换的贡献,可直接用于剖析多跳推理与检索行为;(2) 与机制可解释性结合,用帧坐标给 SAE 特征、电路边赋予原生语义评分,替代任意基上的投影;(3) 解释训练动力学:Figure 6 显示输出帧随训练旋转,可连接学习动态、grokking 与模型退化研究;(4) 工程化:KV 缓存友好的阶截断与稀疏注意力实现,降低 $(n+1)$ 倍前向开销;(5) 理论推广:把相干性界扩展到 MoE、线性注意力等架构,并研究 $\sqrt{\kappa}$ 上界与模型能力、可解释性之间的关系。
复现评估
复现条件相当好。代码开源(github.com/jianguda/lexframe);SmolLM3-3B 与 OLMo3-7B 及其全部中间 checkpoint 均以 Apache 2.0 公开;数据为英文 WikiText-103(训练集约 1.03 亿 token),全部可自由下载。算力门槛低:每个实验单张 NVIDIA RTX 4080 SUPER(消费级显卡),全项目约 500 GPU 小时、其中最终实验约 100 小时;帧校准只需一次前向加每层一个岭回归,且极省数据——4 条校准序列(约 500 token)即可得 0.41/0.34 nats,256 条序列达论文指标,三份不相交校准文本给出 0.146–0.163 nats 的窄区间,对文本选择不敏感。实现为 Python 3.12 + PyTorch 2.12 + Transformers 5.16,结果单次运行且确定性(半精度舍入内,恒等式验证误差 0.0009/0.0002 nats)。注意点:Jacobian 相关计算需把存储权重精确转为 32 位;Jacobian lens 参考实现拟合 100 个 prompts 的耗时是帧校准加全量读数的 18–44 倍,复现基线对比需要耐心;bootstrap 置信区间至少 300 次重采样,且同一序列的位置需整组重采样。总体属于可解释性论文中复现难度低的一类。
论文图表
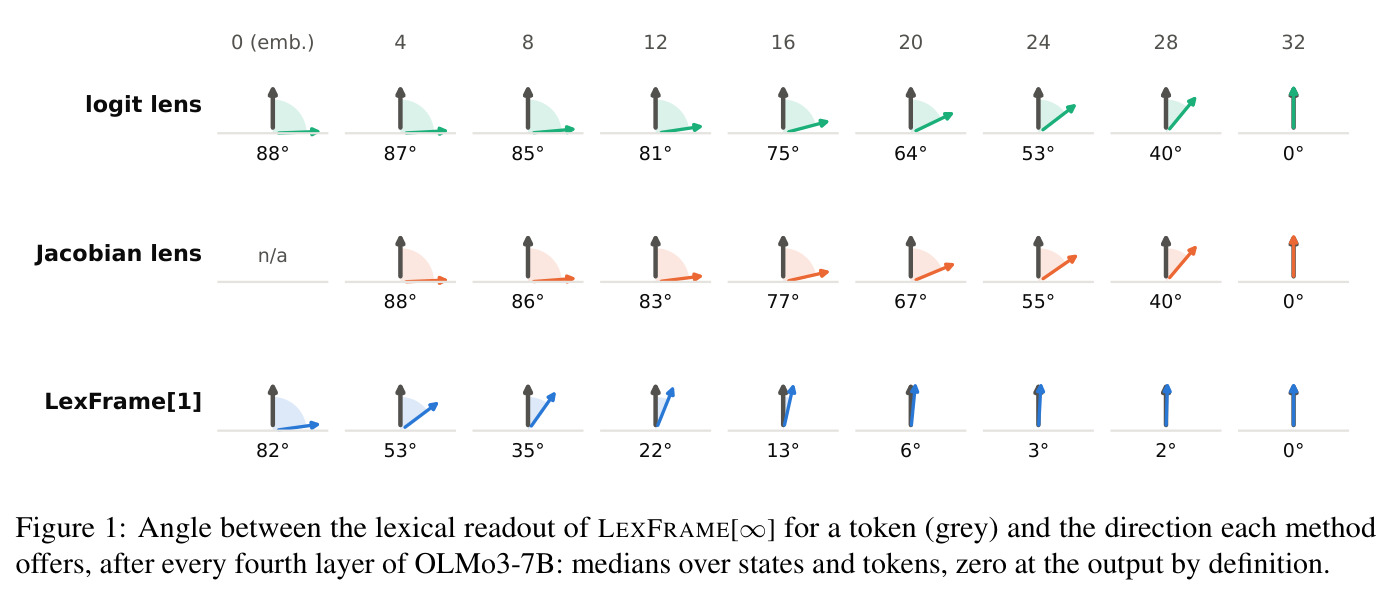
在 OLMo3-7B 每隔四层上,比较 logit lens、Jacobian lens 与 LEXFRAME[1] 给出的词方向与原生帧读出方向之间的夹角中位数:logit lens 在第 16 层后偏差 88°→75°→64°→53°→40°,Jacobian lens 类似(77°、67°),而 LEXFRAME[1] 从第 8 层起只有 35°、22°、13°、6°、3°、2°,到输出端归零。
一图定调:直观展示固定透镜方向在中层严重偏离模型自身读出,而自适应帧几乎全程贴合,是全文动机与方法有效性的视觉总纲。