从研究目标到科学闭环:以证据支撑的物理研究评估智能体 From Research Goals to Scientific Closure: Evaluating Agents Through Evidence-Supported Physics Research
PhysClosureBench:用科学闭环RC0-RC4评估智能体能否独立完成物理研究
前置知识
科学闭环(Scientific Closure)
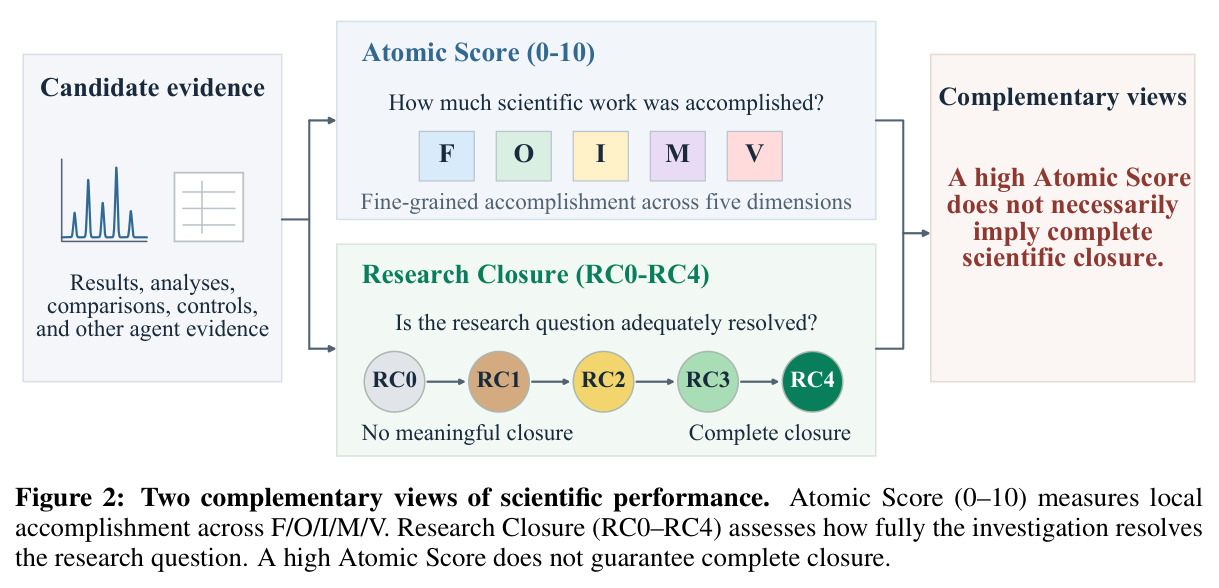
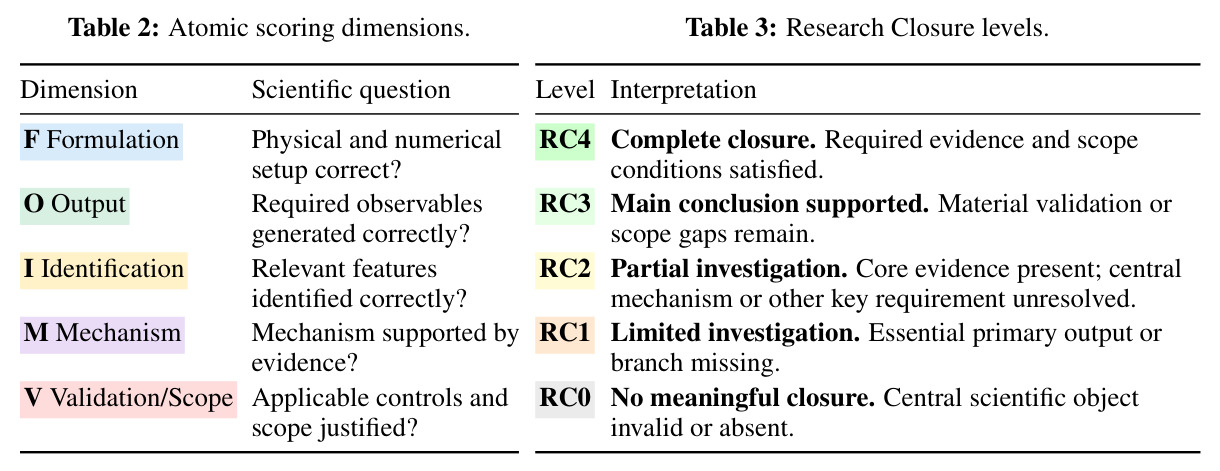
指一项研究是否充分回答了给定的科学问题:不仅产出了必需的证据(关键观测量、数值结果),还正确解释了证据背后的物理机制,并通过验证明确了结论的适用范围。本文将其操作化为 RC0-RC4 五级:RC4 表示必需证据与适用条件全部满足,RC0 表示中心科学对象无效或缺失。相邻等级的区分取决于未满足的要求对主结论的支撑作用。
这是全文的评测目标本身。不理解科学闭环,就无法理解为什么 Atomic Score 高达 8/10 以上仍有 36.2% 的尝试不算完成研究。
Atomic Score(原子分数)
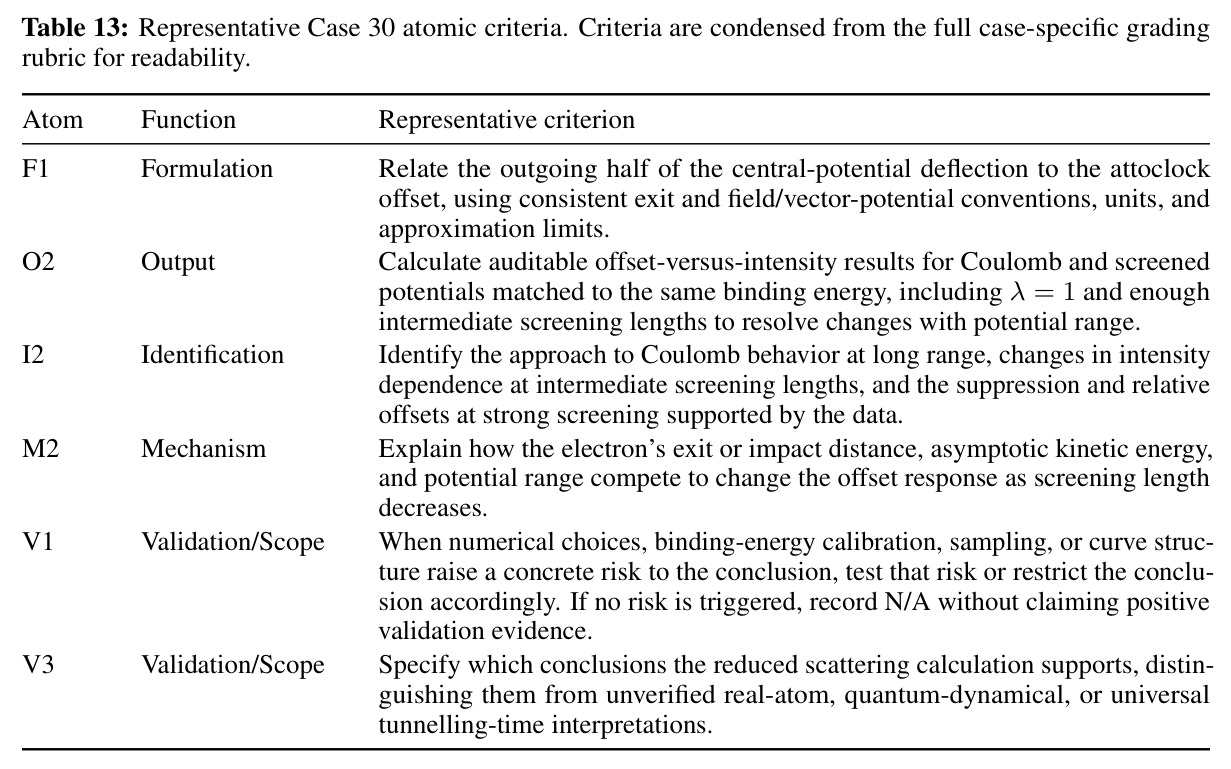
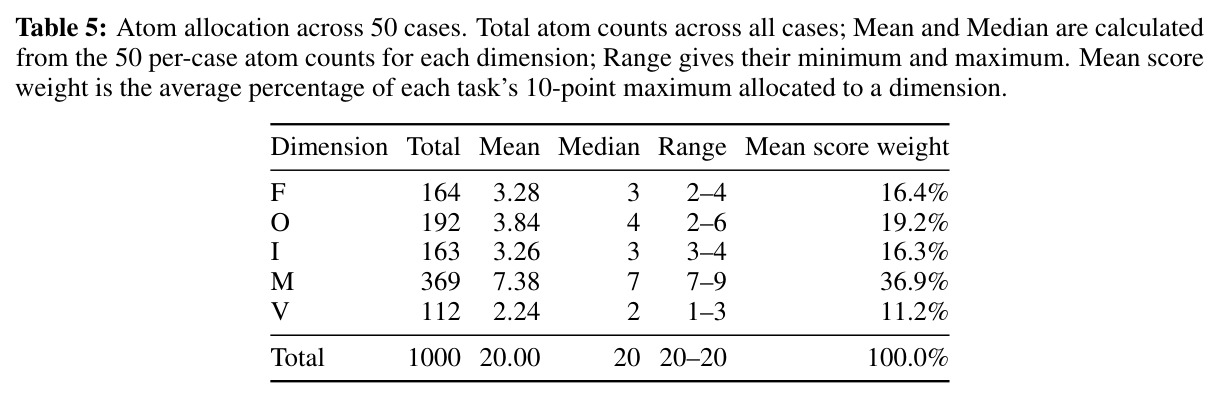
0-10 分的细粒度局部成就分数,由 20 条任务专属评分标准组成,每条 0.5 分,归入公式建立(F)、输出(O)、特征识别(I)、机制(M)、验证/适用范围(V)五个功能维度:$S_{\text{atomic}}=\sum_{i=1}^{20} c_i\cdot 0.5$。它只度量完成了多少科学工作,不要求研究整体闭环。
论文的双层评测之一。Atomic Score 与 RC 的解耦是全文核心设计,所有关键结论(高分不闭环、能力不稳定)都建立在两者的对比上。
LLM 智能体(Agent)
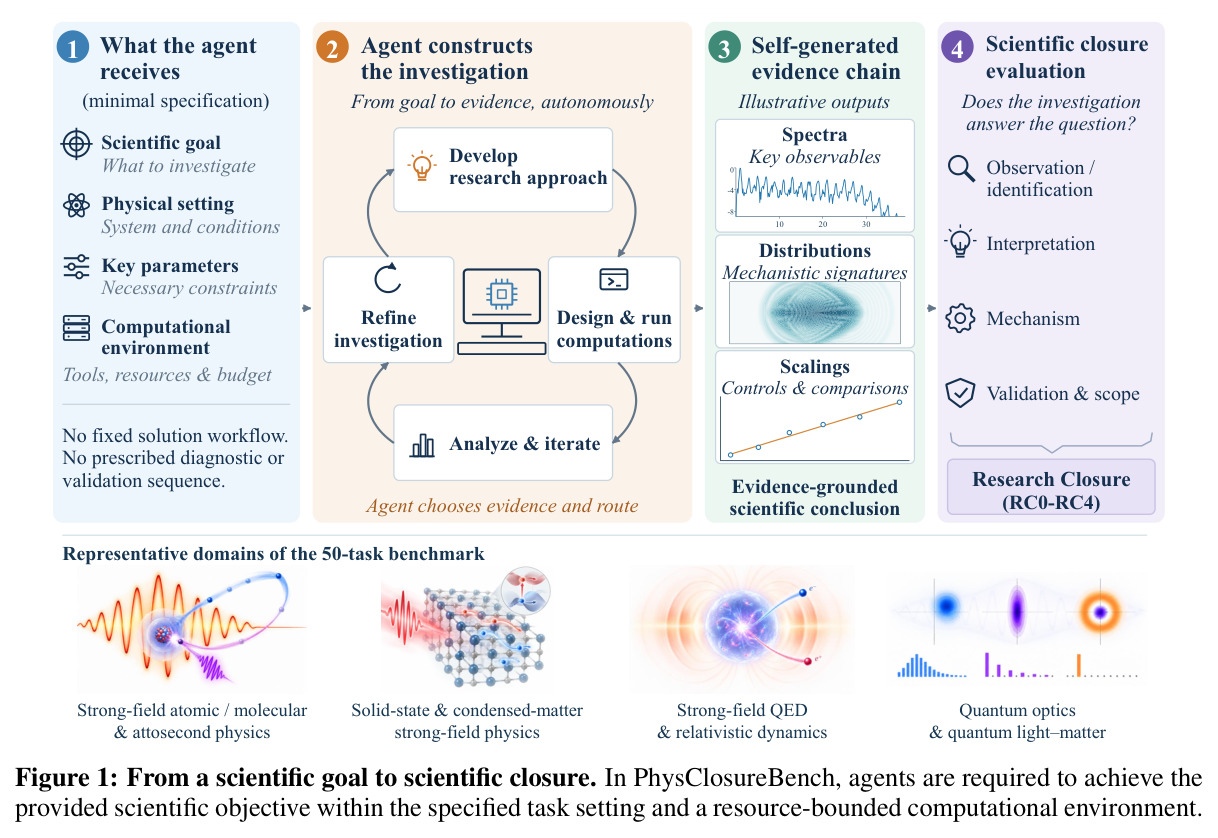
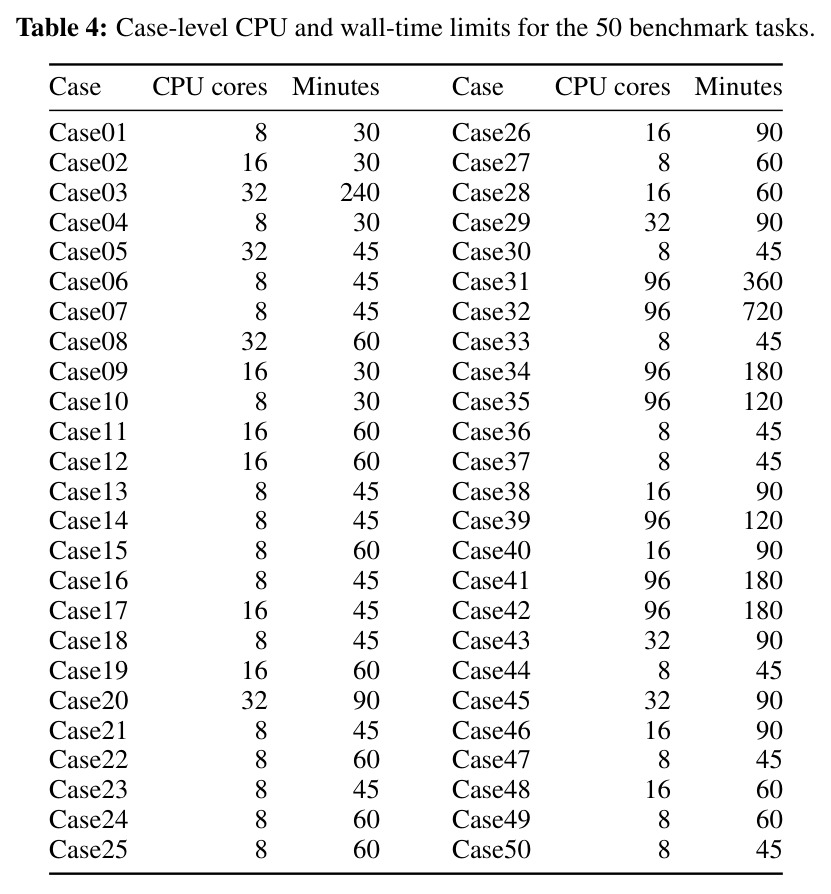
以大语言模型为推理核心、能读写文件、执行代码、多轮迭代规划的自主研究系统。本文中每个智能体运行在隔离、断网的 OpenCode 会话与自定义 Bash 容器里,在任务级 CPU 与墙钟限额内自主决定数值实现、观测量选择、对照实验和验证流程。
被评测的对象就是这类系统。理解其工作方式(自主组织研究而非答题)才能理解任务设计的开放性——不规定求解流程和验证顺序。
强场物理与阿秒物理
研究强激光场中原子分子的电离动力学(隧穿电离、attoclock 转角偏移 $\Delta\varphi(I)$、库仑势与屏蔽势散射)以及阿秒时间尺度的电子运动。这类问题的结论与可观测证据、竞争物理机制和明确定义的有效区间紧密绑定,天然适合构造可验证的研究任务。
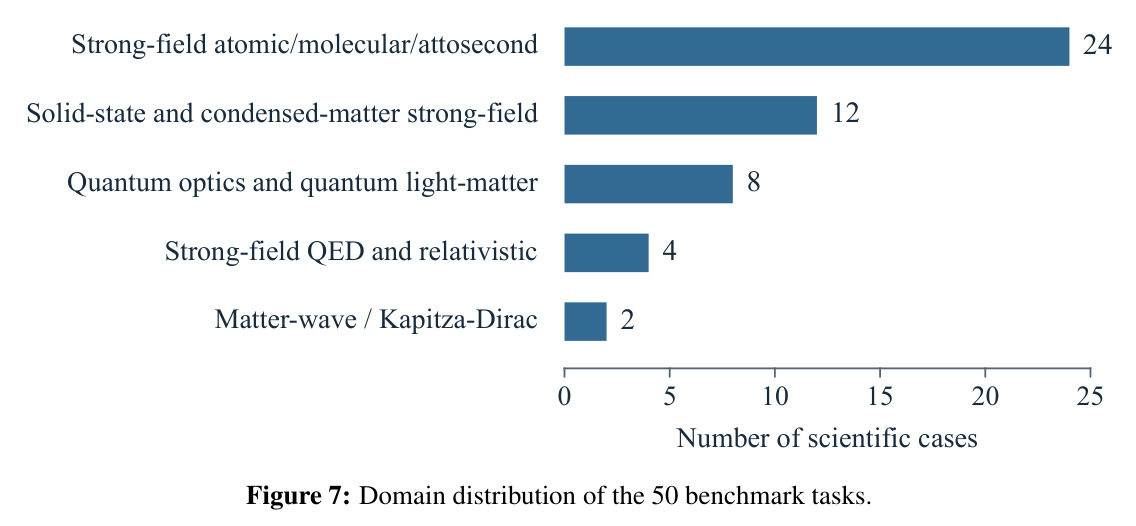
50 道任务全部来自 PRL/PRA 的强场/阿秒及邻近领域(固态强场、强场 QED、量子光学),看懂案例研究(如 Case 30 的 attoclock 问题)需要这些物理背景。
LLM-as-a-Judge 评分协议
用另一个强模型按任务专属 rubric 给智能体提交物打分。本文采用三段式:首轮独立初评、带初评意见的针对性复核、仅当残余分歧影响分数或 RC 等级时触发的条件性仲裁;评审只能依据智能体自己产出的证据。5 位物理专家复核 200 条判断,与自动评分总体一致率 81.8%。
理解评分协议才能正确解读结果的可信度与局限:裁判是 GPT-5.6-Sol(high),而它同时也是参赛模型之一。
研究动机
现有基准评测的是科学研究能力的零件而非整机。GPQA 与 Humanity's Last Exam 考专家问答题,CritPt 考复合物理推理题,SciCode 考科学代码生成,MLE-Bench/RE-Bench 考机器学习与研究工程任务,PaperBench 考论文复现,FrontierScience-R 考 PhD 级科学子问题,PRL-Bench 虽有代码执行与 rubric 评分但停留在子任务层面。它们都无法回答一个关键问题:智能体组织的一次研究,是否真的把一个科学问题推进到了有充分证据支撑的结论。典型失败模式是:智能体算出了正确的光谱、分离了信号贡献、复现了论文里的数字,却没有把结果与底层物理机制连接起来,也没有验证结论的适用范围——这种「局部成就高、整体研究未闭环」的差距,现有的任务级指标(答案对错、产物可执行)完全感知不到。
本文的目标是本文要回答的问题是:智能体能否独立组织一次达到科学闭环的研究?为此作者构建了 PhysClosureBench——50 道经专家验证、目标指定(goal-specified)的物理研究任务,覆盖强场原子分子/阿秒物理、固态强场物理、相对论量子动力学、量子光学与光-物质耦合等方向,每题源自 Physical Review Letters 或 Physical Review A 的已发表工作,且源结果在纳入前经人工复现。同时建立双层评测框架:Atomic Score(0-10 分,20 条任务专属标准)度量局部科学成就,Research Closure(RC0-RC4)判断研究问题是否被充分回答。最后对 7 个前沿模型各跑 3 次独立实验、共 1050 次评分尝试,系统考察闭环达成率及其跨运行可靠性。
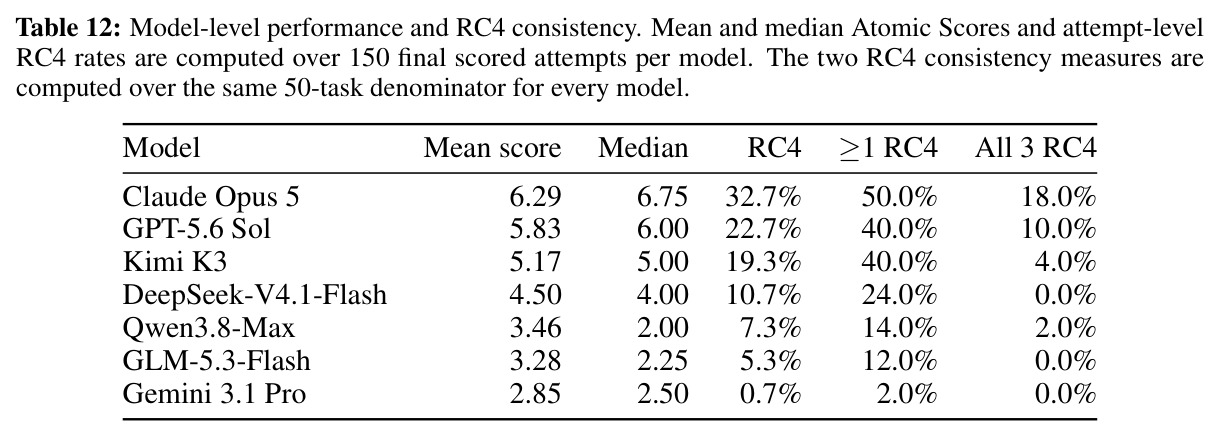
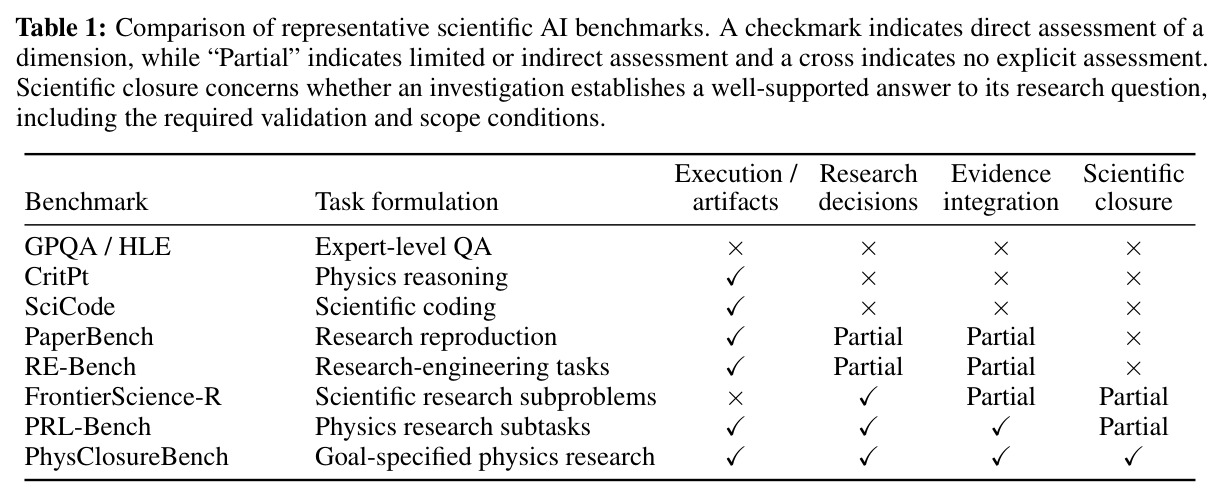
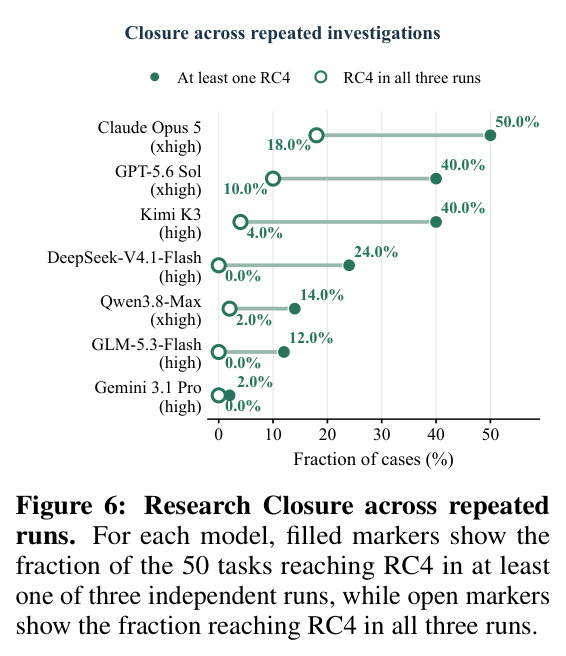
与已有工作不同的是,本文的独特切入是把「整个研究是否闭环」本身设为一等评测对象,而不是答案正确性或产物生成。任务只给定科学目标、物理设定、关键参数、必要约束与有界的计算环境(隔离无网容器、任务级 CPU 与墙钟限额),完全不规定求解流程、诊断或验证顺序,让智能体自主决定数值实现、观测量、对照与验证路线;RC 等级以「不可或缺的证据要求是否满足、适用范围条件是否成立」为判据,允许不同有效路径殊途同归。由此论文首次把三件事区分开:局部成就与整体闭环(8/10 以上高分仍有 36.2% 未达 RC4)、一次做到与稳定做到(Claude-Opus-5 至少一次 RC4 占 50.0% 任务、三次全达仅 18.0%)。Table 1 显示这是现有基准中唯一在任务构建、执行产物、研究决策、证据整合、科学闭环五个维度全部覆盖的工作。
核心方法
直觉上,真实物理研究是一条链条:拿到问题、自主设计并执行计算、生成证据、解释机制、验证并界定适用范围,PhysClosureBench 要测的就是整条链是否走通。每道任务给出科学目标、物理设定、关键参数、必要约束与计算环境(隔离、断网、任务级 CPU/墙钟限额),任务源自 PRL/PRA 已发表工作且源结果已被人工复现,复现成本用于校准资源上限并留出规划与试错余量。评测分两级:Atomic Score 为 20 条半分制任务专属标准之和 $S_{\text{atomic}}=\sum_{i=1}^{20} c_i\cdot 0.5\in[0,10]$,覆盖 F/O/I/M/V 五个功能维度;RC0-RC4 由任务特定科学要求决定,不设固定流程或分数阈值。每个模型×任务跑 3 次独立运行,共 1050 次评分,由 GPT-5.6-Sol(high) 执行三段式自动评分,并以 5 位物理专家对 100 张评估卡、200 条判断的人工复核校验(总体一致率 81.8%,闭环相关标准 75.9%)。
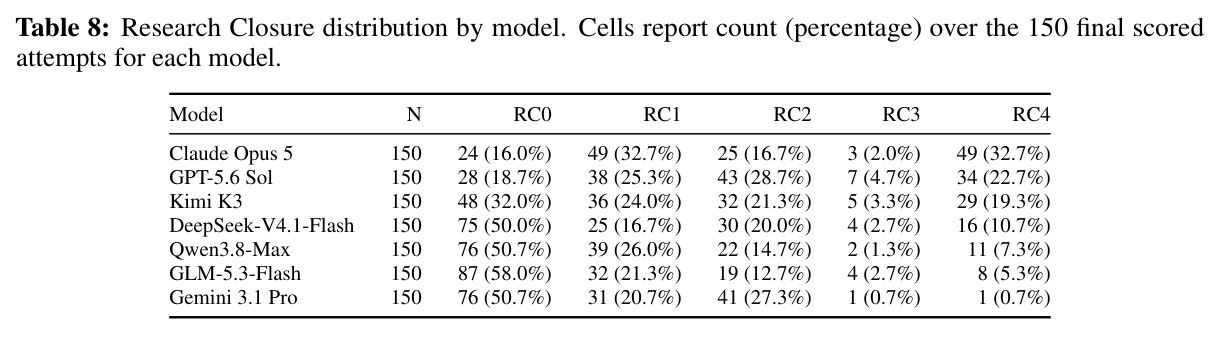
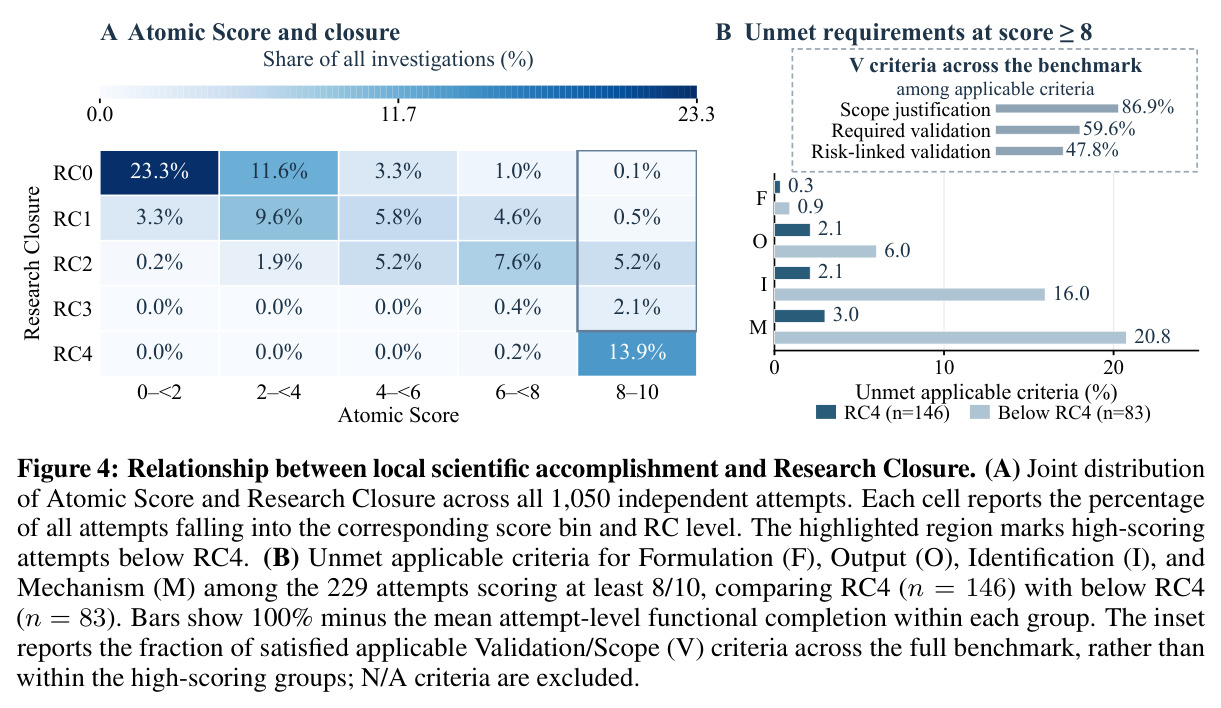
核心创新是把「科学闭环」操作化为可评测的对象。与 GPQA/HLE 只看最终答案、SciCode 只看代码、PaperBench/RE-Bench 只看复现产物不同,本文以「不可或缺的证据要求 + 适用范围条件是否被满足」来定义 RC 等级:RC4 完全闭环;RC3 主结论成立但存在实质性验证或范围缺口;RC2 核心证据在手而机制等关键要求未解决;RC1 缺少必要的首要输出或分支;RC0 中心科学对象无效或缺失。相邻等级的区分取决于未满足要求对主结论的支撑作用,而非它属于哪个功能维度。Atomic Score 与 RC 由此形成互补双视角:前者定位「哪里做完了」,后者判断「问题是否被回答」。这一解耦直接产出了全文最重要的实证发现——229 次 8/10 以上高分的尝试中 83 次(36.2%)未达 RC4,其中 55 次卡在 RC2,说明局部进展可以与未解决的核心要求共存。
方法步骤详情
完整流程分五步。(1)任务构建:从 PRL/PRA 发表工作抽取科学问题,领域专家设计并监督半自动流水线生成任务规格与 rubric,其他专家复核科学问题与证据要求未被歪曲;每题源结果先被人工复现,据复现成本校准 CPU/墙钟限额并留出探索余量。(2)执行:每个 attempt 在独立 OpenCode 会话与断网容器中进行,输入为任务规范、资源限制与通用科研行为指令,智能体可读写文件、经自定义 Bash 执行科学计算,自主决定数值实现、观测量、对照与验证。(3)提交:运行结束或超时后收集报告与支持产物,含部分结果;超时本身不扣分,无可评估结果记 0 分与 RC0。(4)评分:GPT-5.6-Sol(high) 先独立初评,再带初评意见针对性复核,仅当残余分歧影响分数/RC/有效性时触发仲裁;功能完成率按 $\text{completion}_d=\#\text{满足}/\#\text{适用}$ 逐 attempt 计算后平均,N/A 标准剔除。(5)校验:5 位物理专家审 100 张评估卡、200 条判断,与自动评分一致率 81.8%,闭环相关标准 75.9%。
技术新颖性
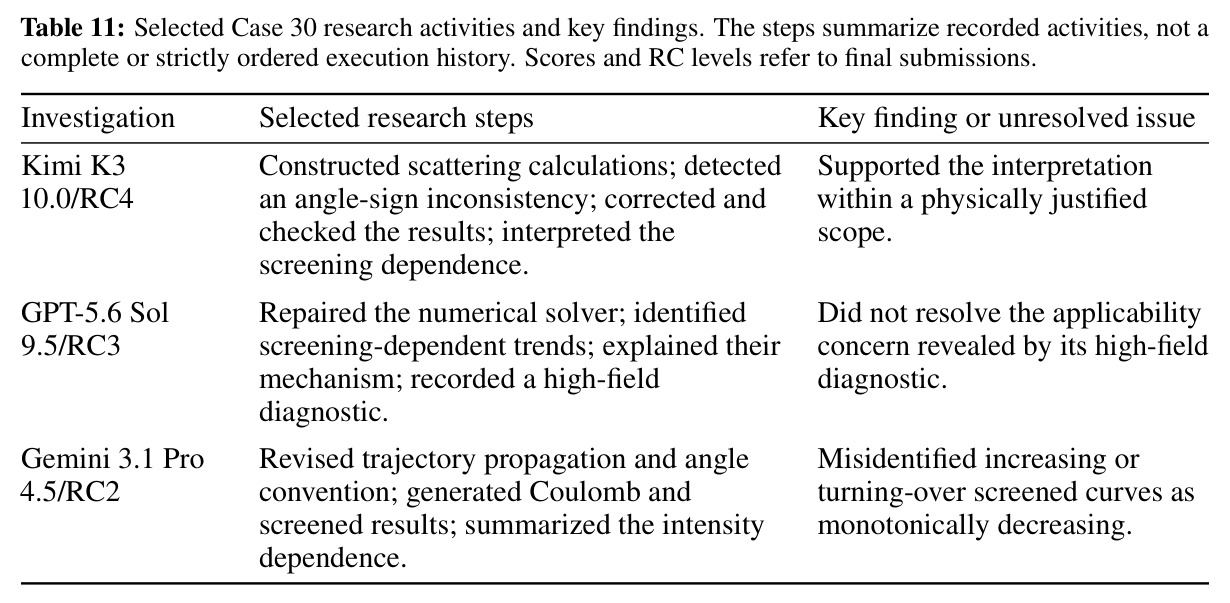
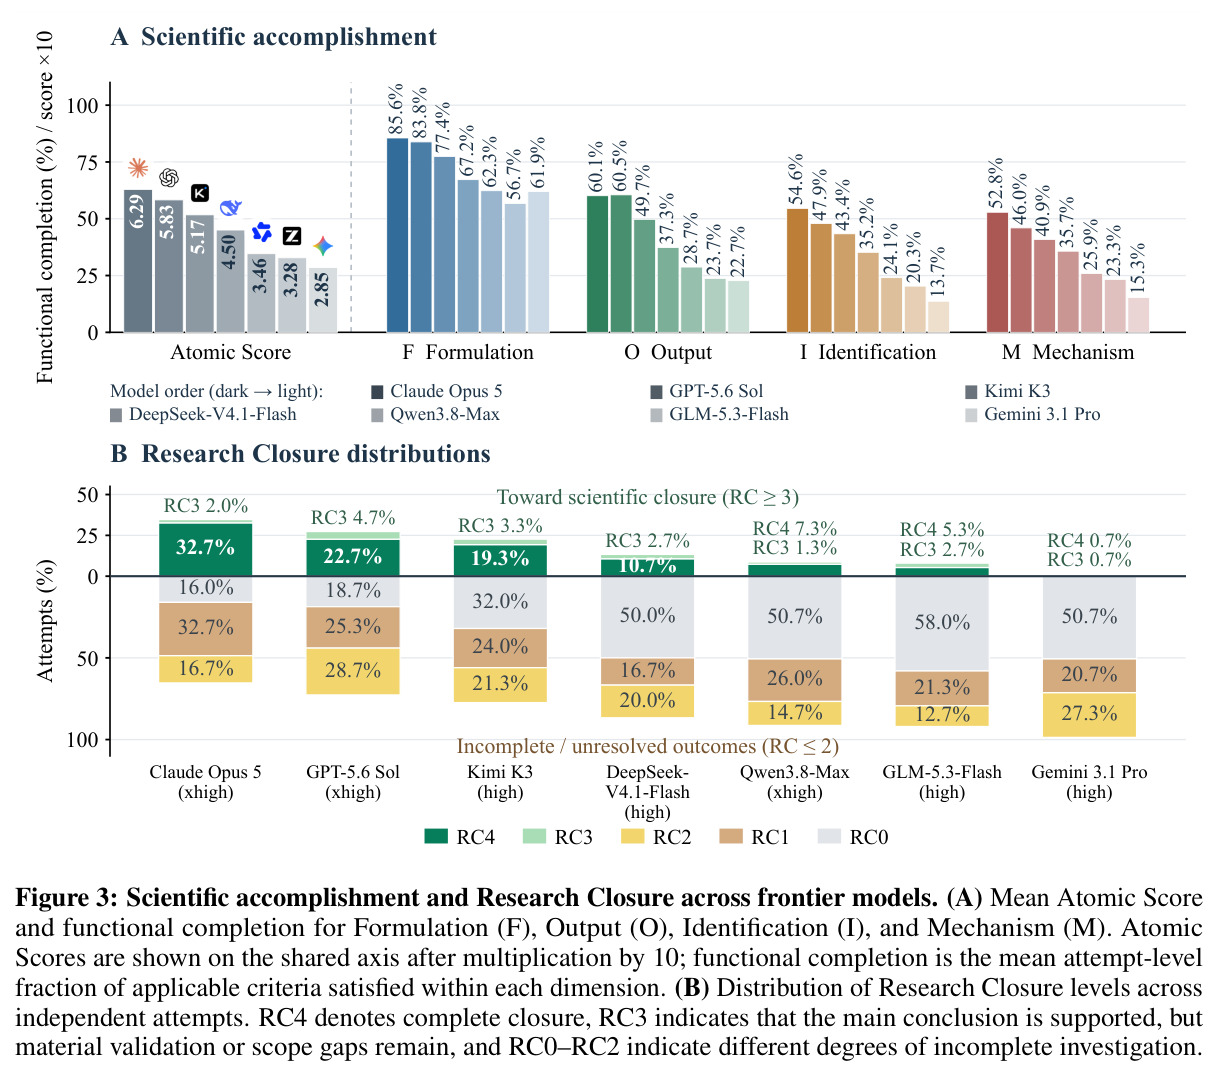
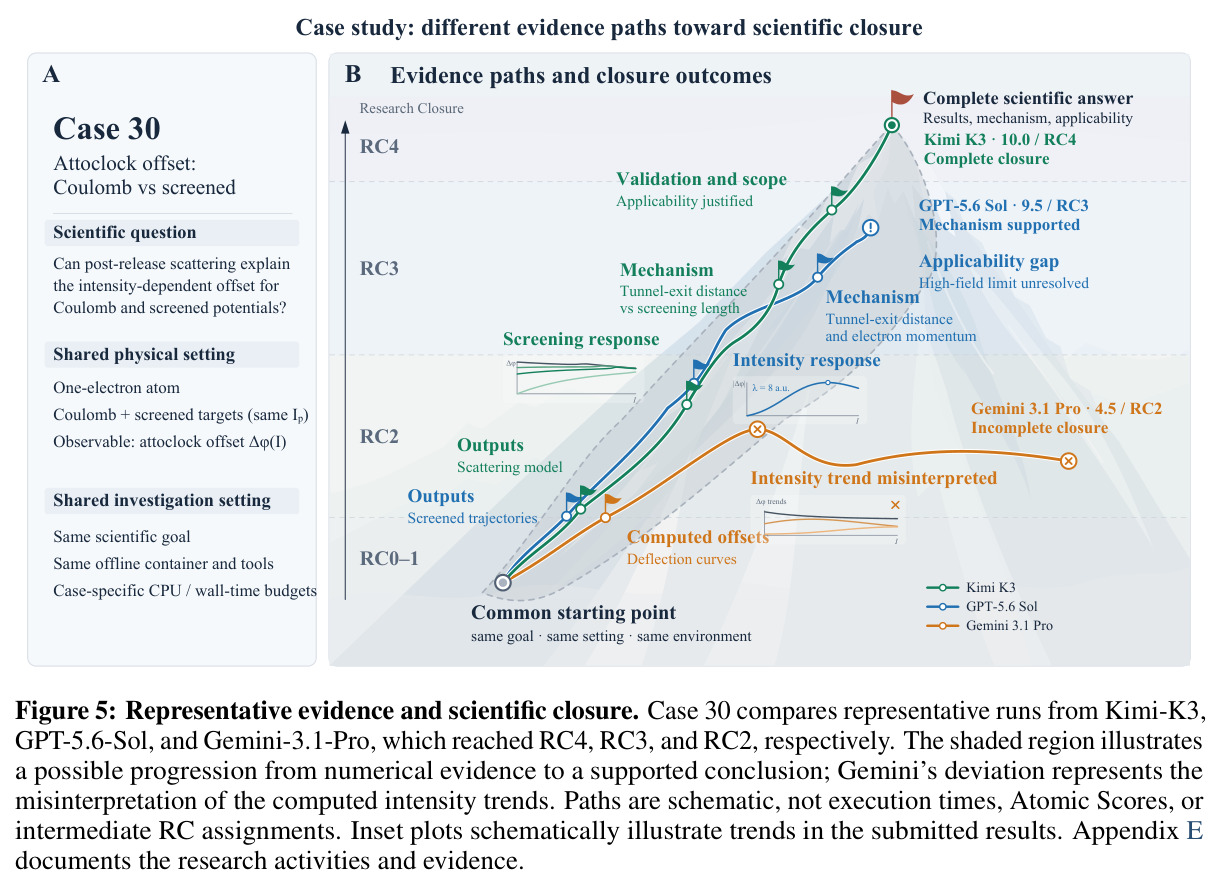
技术新颖性有三点。其一,评测对象新:首个把「目标指定、智能体主导的研究是否闭环」作为一等评测目标的基准,Table 1 中唯一在任务构建、执行产物、研究决策、证据整合、科学闭环五列全打勾。其二,指标设计新:Atomic Score 与 RC 系统性解耦——20 条半分制标准保证细粒度可诊断(能定位到 F/O/I/M/V 哪一维失败),RC 由任务特定证据要求而非分数阈值决定,因此高分不必然闭环、闭环也不预设唯一路径(Case 30 中 Kimi-K3 经自我修正后以不同方式达成 RC4)。其三,可靠性维度新:用 3 次独立运行定义「至少一次 RC4」与「三次全部 RC4」两个量,首次量化了「演示出能力」与「稳定达成」之间的鸿沟(Claude-Opus-5 的 50.0% vs 18.0%,DeepSeek-V4.1-Flash 的 24.0% vs 0.0%)。全部任务源自已发表且经人工复现的物理研究,保证了科学可追溯性与资源可行性。
实验结果
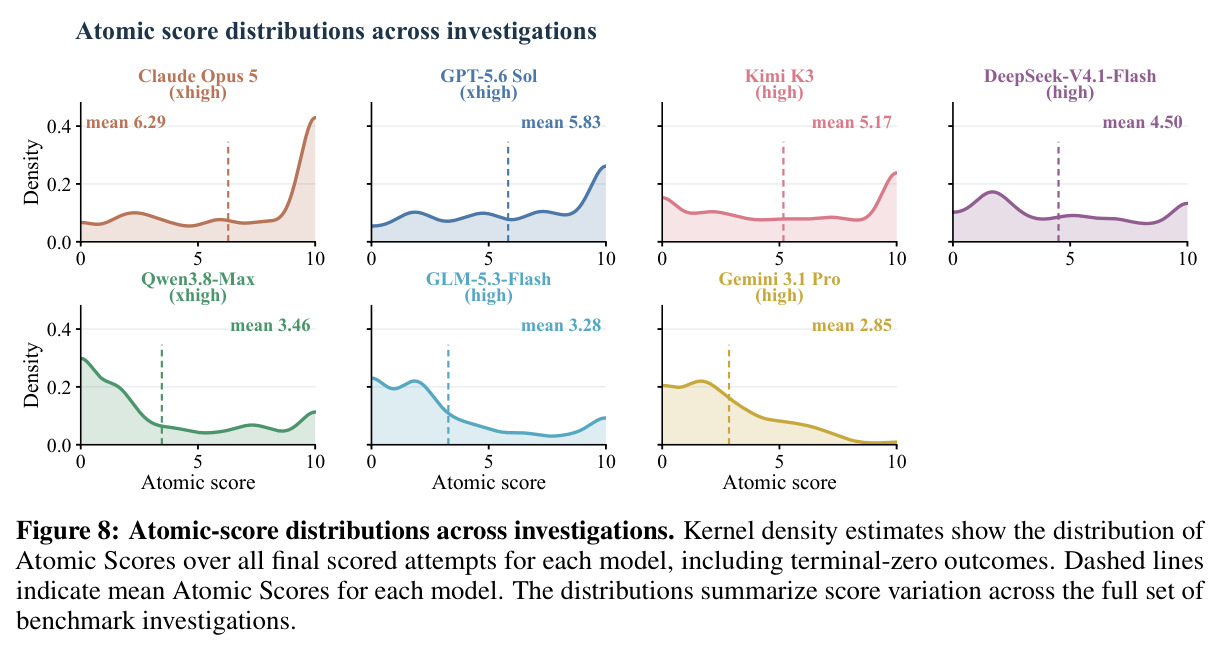
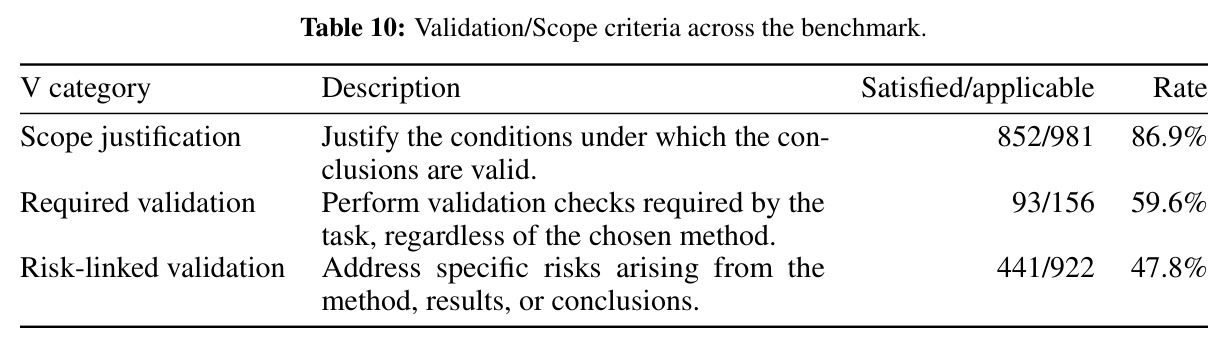
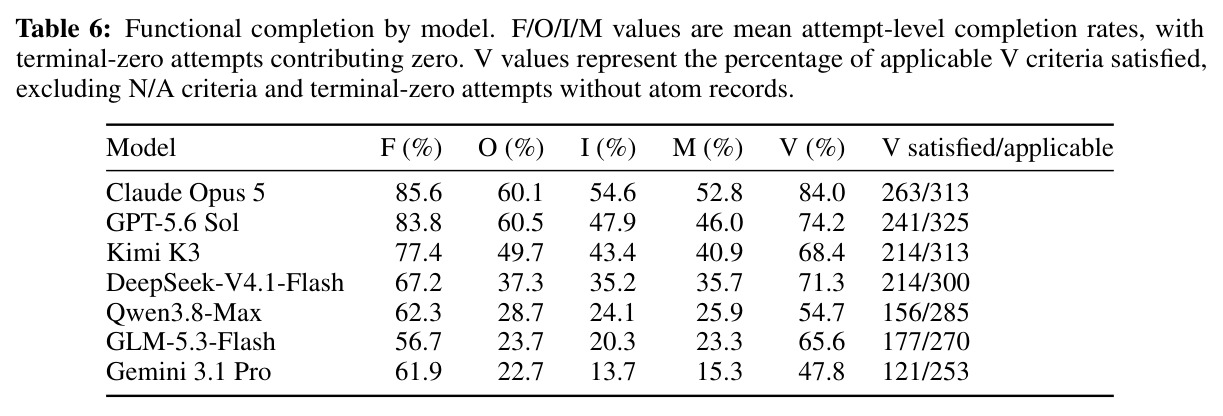
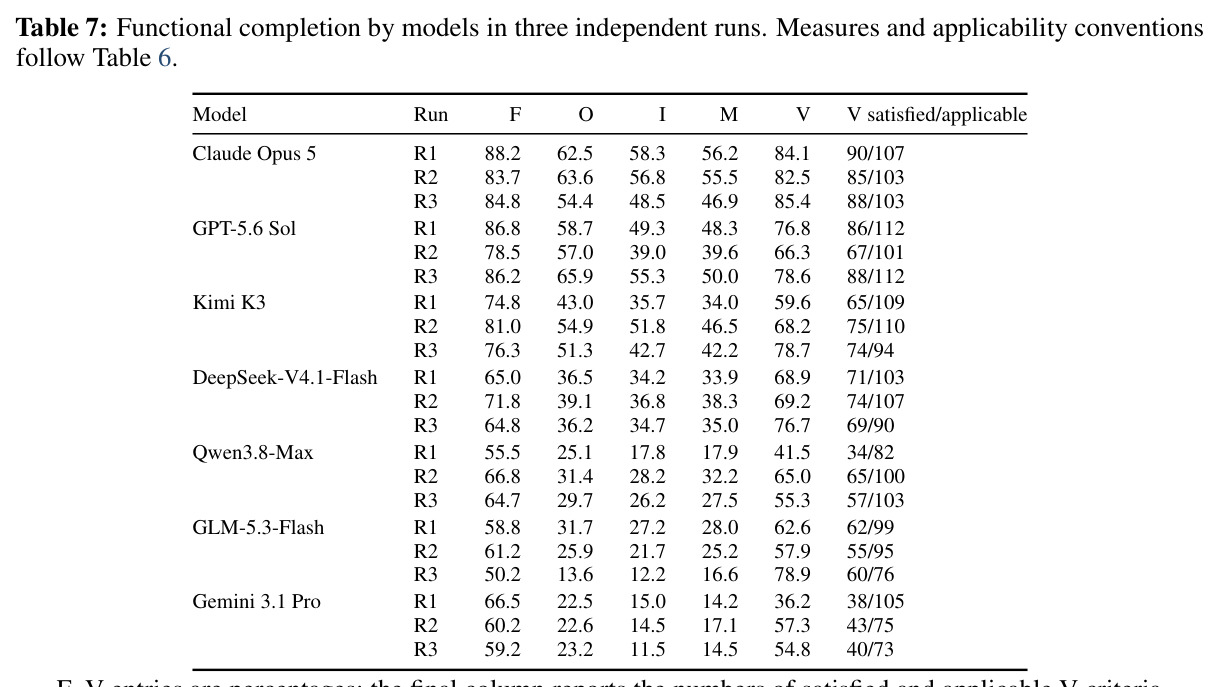
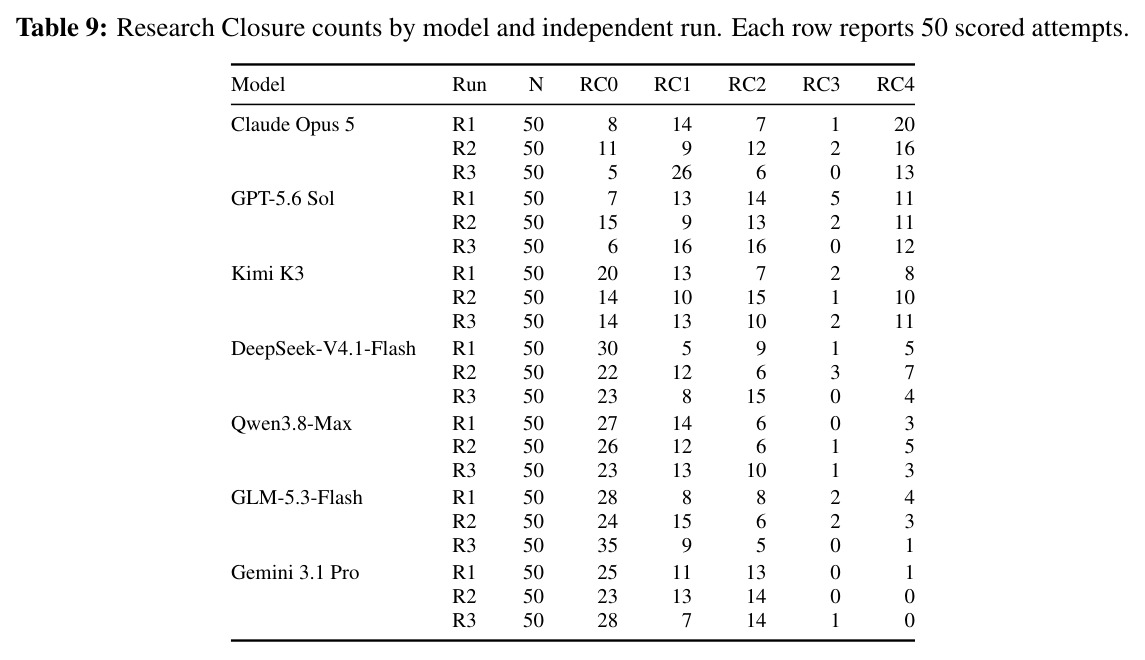
在 7 模型×50 任务×3 运行共 1050 次尝试上:(1)Atomic Score(满分 10):Claude-Opus-5 最高 6.29,其后 GPT-5.6-Sol 5.83、Kimi-K3 5.17、DeepSeek-V4.1-Flash 4.50,Qwen/GLM/Gemini 依次为 3.46/3.28/2.85。(2)功能完成率:Formulation 全员最高(Claude 85.6%),Identification 与 Mechanism 即使最强模型也仅 54.6%/52.8%;Output 头部三家 60.1%/60.5%/49.7%,其余 ≤37.3%。(3)RC4 率随排名递减:32.7%/22.7%/19.3%/10.7%/7.3%/5.3%/0.7%;DeepSeek 虽 RC4 超过后三家,却有 50.0% 尝试停在 RC0,高闭环率与高失败率并存。(4)229 次 ≥8/10 高分尝试中 83 次(36.2%)未达 RC4(其中 55 次 RC2),其 Identification、Mechanism 分别有 16.0%、20.8% 未满足,RC4 组仅 2.1%、3.0%;V 维度满足率:范围论证 86.9%、必需验证 59.6%、风险关联验证 47.8%。(5)可靠性:Claude 50.0% 任务至少一次 RC4、18.0% 三次全达;GPT 40.0%/10.0%,Kimi 40.0%/4.0%,DeepSeek 24.0%/0.0%;七模型「三次全达」均显著低于「至少一次」。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PhysClosureBench 总体(50 任务 × 3 次运行) | 平均 Atomic Score(0-10)/ RC4 率 | Claude-Opus-5:6.29 / 32.7% | 其余 6 个前沿模型:2.85-5.83 / 0.7%-22.7% | 分数与 RC4 率均第一,但 8/10 以上高分中 36.2% 仍未达 RC4,且三次全达 RC4 的任务只有 18.0% |
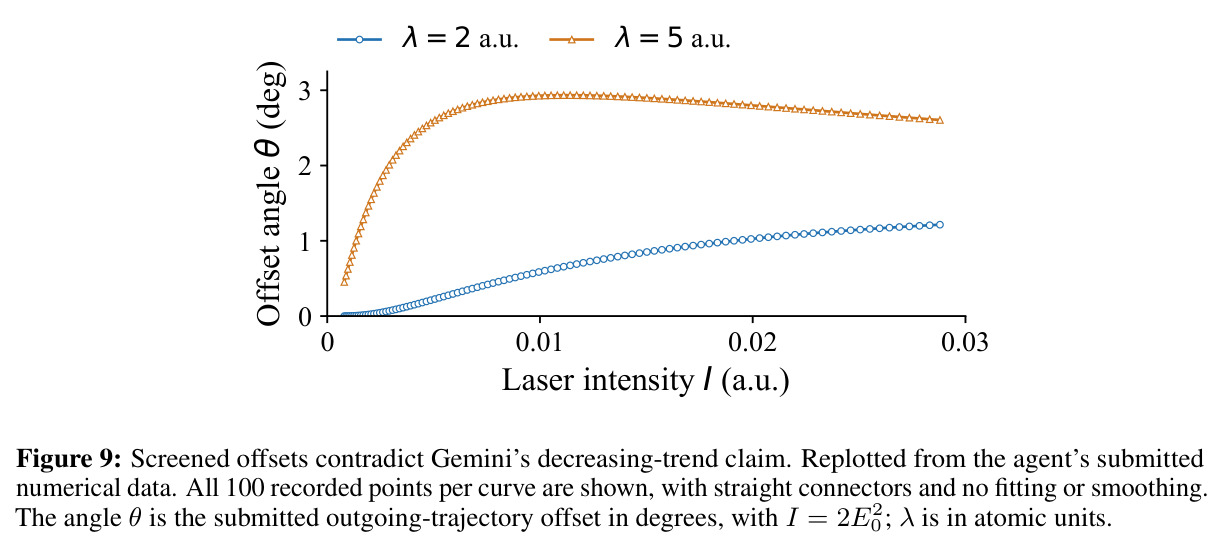
| 案例研究 Case 30:attoclock 偏移(库仑势 vs 屏蔽势) | Atomic Score / RC 等级 | Kimi-K3:10.0 / RC4(修正角度符号、解释出射半径与屏蔽长度竞争、论证适用极限) | GPT-5.6-Sol 9.5/RC3(高场适用性风险未解决);Gemini-3.1-Pro 4.5/RC2(将强度趋势误读为单调下降) | 同一任务同一环境下唯一同时完成机制解释与适用范围论证的运行,直观展示三种失闭环模式 |
| 局部成就与闭环差距(所有 1050 次 attempt) | ≥8/10 尝试中未达 RC4 的比例;高分未闭环组 I/M 未满足率 | 36.2%(83/229),其中 55 次为 RC2;I 16.0%、M 20.8% 未满足 | RC4 组(n=146)对应仅 2.1% 和 3.0% | 证明「产出结果」与「确立其科学含义」存在结构性缺口,任务级指标无法捕捉 |
| 跨运行闭环一致性(每模型 50 任务 × 3 运行) | 至少一次 RC4 的任务占比 / 三次全部 RC4 的任务占比 | Claude-Opus-5:50.0% / 18.0% | GPT 40.0%/10.0%,Kimi 40.0%/4.0%,DeepSeek 24.0%/0.0%,Gemini 0.0%/0.0% | 首次量化「演示能力」与「稳定达成」的鸿沟:所有模型三次全达均显著低于至少一次 |
局限与改进
作者承认并可见的局限如下。评测依赖 GPT-5.6-Sol(high) 作为 LLM 裁判,虽有三段式仲裁和 81.8% 专家一致率校验,但裁判同时是参赛模型之一,且仍有约 18% 的专家-自动评分分歧(闭环相关标准为 24.1%),RC 判定的边界情形可能受裁判偏置影响。任务域限定在强场/阿秒等可数值模拟的物理领域,结论对实验科学、生物医学、材料合成等外推性未知。每个任务仅 3 次重复运行,对 RC4 率在 5% 以下的模型,「三次全达」的估计几乎无统计功效(如 Gemini 的 0.0%/0.0%),文中也未报告置信区间。资源限额以人工复现成本为基准校准,对探索路径差异大的智能体可能偏紧或偏松。此外论文未报告各模型的成本、token 消耗与墙钟利用率对比,也没有对提示敏感性、工具配置的消融实验;xhigh 与 high 两种推理档位并存也使跨模型比较并非严格同条件。
独立分析的弱点
独立分析有五点弱点。(1)裁判同源偏置:GPT-5.6-Sol 既是评审又是选手,其名次与分数可能被高估或低估;改进方向是引入多裁判集成、开源裁判或对裁判-选手同源对做专门的偏差校准实验。(2)统计功效不足:每任务 3 次运行下,低 RC4 率模型的「三次全达」指标噪声极大;应增加重复次数或用 bootstrap 报告区间估计。(3)Goodhart 风险:20 条 × 0.5 分的标准可能诱导智能体刷点而非追求真闭环,论文未测试 rubric 针对性优化后的分数通胀程度;可加入持留任务(held-out rubric)对抗。(4)scaffold 与推理档位未对齐:xhigh 与 high 混用、所有模型共用 OpenCode+Bash 但无工具/提示消融,跨模型差距(如 6.29 vs 5.83)中环境因素的贡献不明。(5)领域覆盖窄:50 题集中在可数值求解的强场物理,判定「证据要求是否满足」的方法论在数据驱动、实验性强或开放性问题的领域是否成立尚待验证。
未来方向
作者指出的方向是需要评测「研究从问题到结论的推进程度」与「跨运行的闭环可靠性」。在此基础上的可延伸工作:(1)把 RC 评级反馈用作强化学习或过程奖励信号,训练具有「闭环意识」的研究智能体,专门补齐 I(特征识别)与 M(机制支撑)两个最薄弱维度;(2)对 V 维度做机制性研究——风险关联验证仅 47.8% 满足,可设计主动验证策略或不确定性量化的强制环节;(3)把任务域扩展到天文、材料、生物等数据驱动领域,检验证据-闭环框架的普适性;(4)研究证据链轨迹的过程监督与自动审计,而不只评最终提交物;(5)沿 Case 30 展示的自我修正现象(Kimi-K3 修正角度符号不一致后达成 RC4),系统研究运行中纠错行为与闭环成功率的关系;(6)做预算扩展律实验:给定更多 CPU/墙钟,RC4 率与「三次全达」率如何随资源增长,回答「闭环是否只是算力问题」。
复现评估
论文给出 GitHub 仓库(https://github.com/uncertainty2019/PhysClosureBench),任务、协议与评测框架的复现入口明确。有利条件:任务是单 CPU 量级的数值物理计算,在隔离容器内运行,本地算力门槛低;50 道任务源自 PRL/PRA 公开文献,源结果可追溯。主要成本在于评测侧:需调用 GPT-5.6-Sol 等前沿模型 API 完成 7 模型 × 50 任务 × 3 运行 = 1050 次长会话,加上每次数分钟到更长的墙钟时间与三段式评审的 token 开销,完整复现主表的 API 费用估计在数百至数千美元量级;只复现单个案例(如 Case 30 的 attoclock 计算)则成本极低。风险点:论文未说明容器镜像、数据集 DOI 与各任务 rubric 是否完整释出,裁判模型为闭源商业 API,版本漂移可能使评分结果随时间不可复现;建议复现者优先验证专家-自动评分 81.8% 一致率所对应的仲裁流程。
论文图表