DialFork:超越事实性——对话智能体程序性幻觉评估基准 DialFork: Going Beyond Factuality to Evaluate Procedural Hallucination in Conversational Agents
首个通过受控分叉模拟程序性幻觉的基准,用流程感知指标度量对话偏离既定流程的程度
前置知识
事实性幻觉(factual hallucination)
指模型生成与客观事实或给定证据不符的内容,如编造日期、数字、产品细节,是当前 LLM 幻觉研究的主流对象。TruthfulQA、HaluEval、DiaHalu 等评测基准都围绕“说的内容是否为真”构建。
本文提出的程序性幻觉正是相对这一主流概念界定的对立面——内容可以句句为真,过程却偏离指令;理解两者的正交性是全文立论的基础。
任务导向对话与对话策略(TOD / dialogue policy)
任务导向对话系统通过多轮询问填槽、调用后端完成订票、查询等任务。对话策略(policy)决定系统在每个会话状态下依据用户输入采取的动作序列,通常可用带状态和转移的工作流图表示。
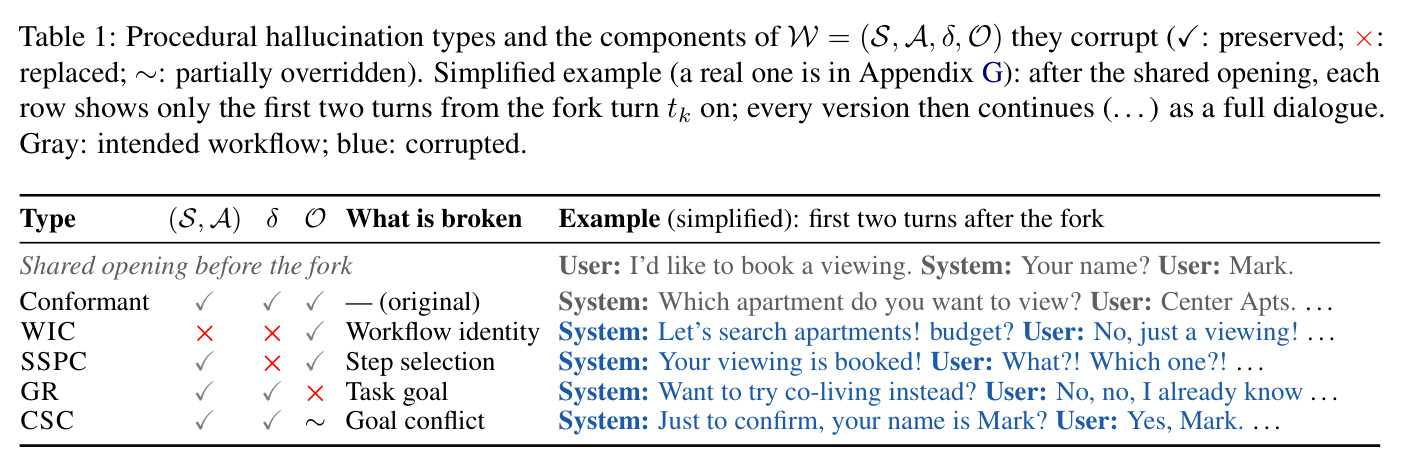
DIALFORK 所说的“程序”正是对这类策略/工作流的抽象 $\mathcal{W}=(S,A,\delta,O)$,四类幻觉分别破坏其不同分量。
句子/轮次嵌入
SBERT、LaBSE、BGE-M3、Qwen3-Embedding 等对比学习训练的编码器把句子映射为向量,语义相近的句子余弦相似度高;对话专用编码器 D2F 进一步按“交际功能”把话语组织成流程步骤。
本文所有基线与流式检测器都建立在轮次嵌入之上:FLOWKL 的节点聚类、FLOWSCORE 的匹配矩阵、FLOWDTW 的局部成本均由嵌入构成。
Kendall's τ 秩相关
度量两个排序一致性的统计量:$\tau=1$ 表示完全一致,约 0 相当于随机。DIALFORK 的 Task 1/2 真值是分叉位置诱导的偏离排序,指标得分即预测排序与真值排序的 τ。
不熟悉 τ 就读不懂 Task 1/2 的主表(Table 2/3),也读不懂人类研究中衡量盲评一致性的 $\tau_b$。
Fréchet 距离与 FBD/PRD
Fréchet 距离比较两个多元高斯分布(均值与协方差),源自图像领域的 FID。FBD(Fréchet BERT Distance)与 PRD(Precision–Recall Distance)把两个对话集合的轮对嵌入各自拟合成分布再比较,是仅有的两个现成集合级对话分布指标。
它们是 Task 1 的主要已有方法基线;FLOWKL 与之对比,并主张用可读的流程转移图替代不透明的嵌入分布。
BERTScore
用上下文嵌入的余弦相似度矩阵在候选与参考之间做 token 级软对齐,对每个 token 取最大相似度后平均得到 P/R/F1,比 n-gram 重叠类指标更语义化。
FLOWSCORE 就是把这一思想从 token 级搬到轮级(对齐单位从词变成对话轮),理解 BERTScore 才能读懂其 $P$、$R$、$F_{\text{flow}}$ 公式。
动态时间规整(DTW)
通过动态规划寻找两条长度不等序列之间的最优对齐路径,允许元素以不同速率伸缩对应,路径总代价最小即最优,常用于语音与序列对齐。
FLOWDTW 基线用 DTW 对齐两条对话的轮嵌入序列;它与 FLOWSCORE 的对比说明了免规整软匹配的优势。
N-gram 语言模型与 surprisal
N-gram 模型用马尔可夫假设估计下一符号的条件概率 $p(n_t \mid n_{t-N+1},\dots,n_{t-1})$;surprisal 定义为 $-\log p$,值越大表示该符号越出乎意料。
流式检测器在离散流程节点序列上训练 3-gram 模型,靠转移概率骤降(surprisal 跳变)在不看未来的情况下实时发现偏离。
KL 散度
$KL(p\|q)=\sum_i p_i \log (p_i/q_i)$ 度量两个概率分布的差异,非负、不对称。可理解为:用 $q$ 近似 $p$ 时的信息损失。
FLOWKL 之名即来自它——比较参考对话集合与目标集合在流程转移图上的(对数)转移似然分布的差异。
研究动机
现有幻觉研究几乎全部围绕“内容是否为真”展开:TruthfulQA、HaluEval 等基准测日期、数字、产品细节等事实错误,对话级基准 DiaHalu 关注多轮陈述的忠实性。但当 LLM 被部署到客服、预约排班、临床问诊等智能体角色时,系统还被默认要求遵循结构化的程序逻辑——一套从用户初始请求走到任务完成的既定步骤。由此产生一类被忽视的失败模式:智能体的每句话都真实、流畅、看似合理,整体却偏离了被指示的会话流程——跳过必要步骤、追求与指令不符的目标、重复已完成的动作、或插入相互冲突的附加目标。已有工具对此全盲:流程遵循研究(policy-constrained action sequences、TOD-ProcBench 等)依赖标注好的动作/意图/槽位而非原始文本;对话相似度研究把整段对话压成一个向量算余弦相似度,丢弃轮次顺序;FBD/PRD 等集合级分布指标也不建模对话的展开方式。没有任何公开基准能直接从原始对话文本度量“过程偏离”。
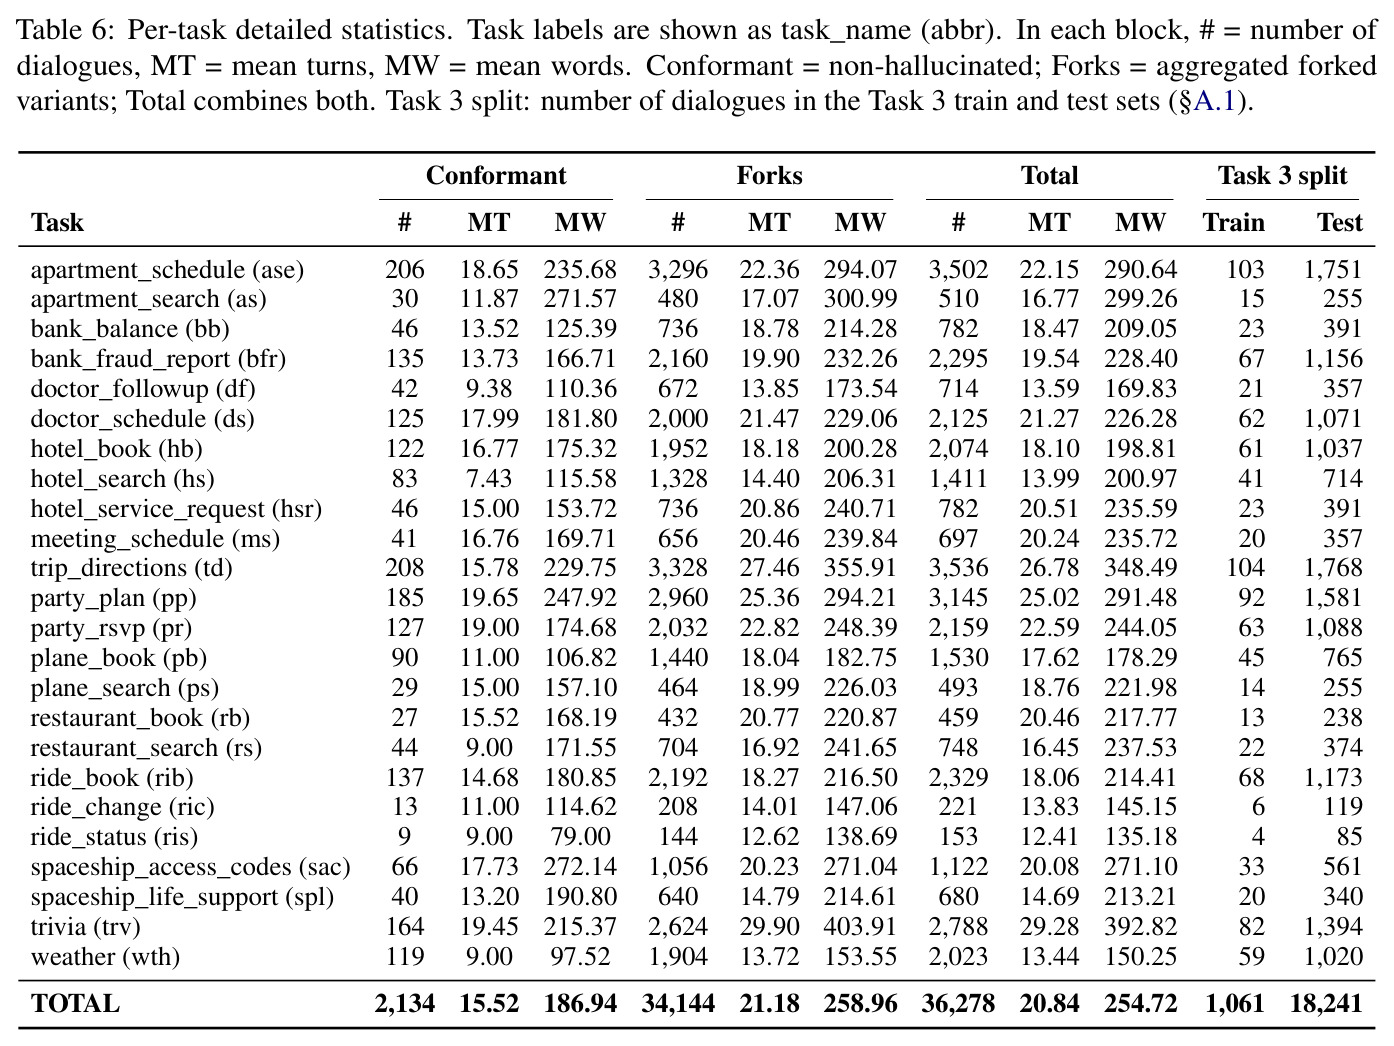
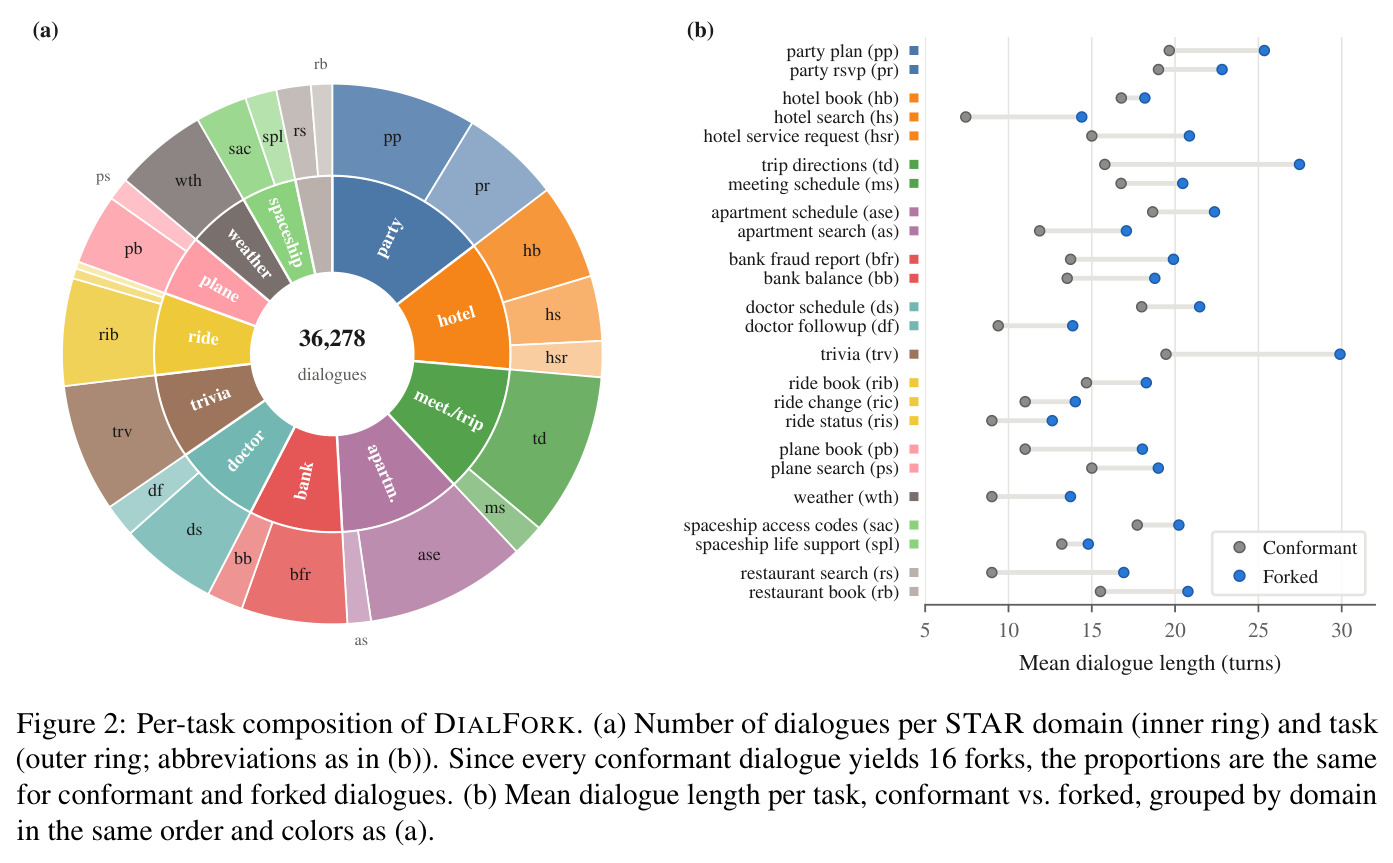
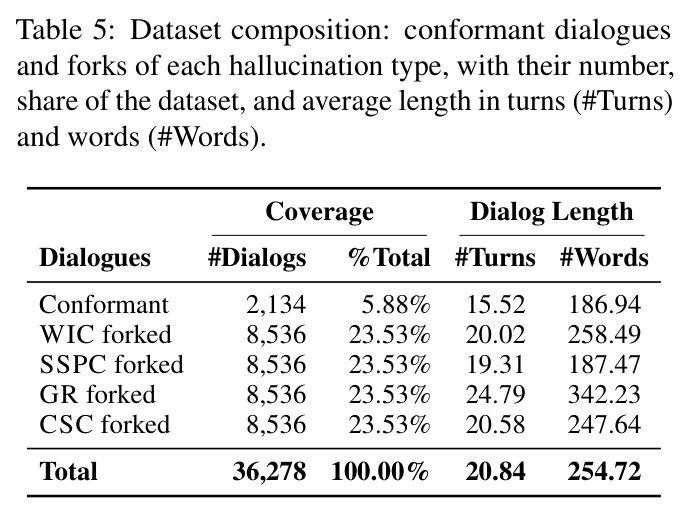
本文的目标是论文目标有四。第一,正式定义程序性幻觉(procedural hallucination)——对话过程崩溃而内容未必为假、与事实性幻觉正交的新失败模式,并基于通用工作流模型给出四种互补类型。第二,构建 DIALFORK:首个在原始对话文本上系统性度量该失败模式的基准,通过对 2,134 个合规对话在受控轮位分叉并注入四类幻觉,得到 36,278 个对话,覆盖 24 个任务、12 个领域、4 级时间偏离深度,约 75 万轮、1,040 万词,并用 30 名人类标注者验证构建质量。第三,定义粒度递进的三个评估任务:集合级距离(监控部署中的智能体是否漂移)、对话级距离(按程序相似性检索历史会话)、轮次级定位(实时护栏:首个偏离轮出现在哪)。第四,提出 FLOWKL 与 FLOWSCORE 两个对话流感知距离指标并给出全部任务的初始基线,呼吁社区在度量内容的同时也度量会话过程。
与已有工作不同的是,独特切入角度有三。其一是概念层面:把“幻觉”从内容真实性扩展到过程正确性。最接近的已有概念——智能体间通信中的幻觉与对话中对依据知识的忠实性(FaithDial)——关心的都是“说了什么”而非“会话如何展开”,因此四类程序性幻觉是全新分类。其二是数据构建层面:不靠人工标注偏离,而是用种子受控重放(seeded replay)——同一场景、同一随机种子重跑两个 LLM 智能体以复现前缀,再恰在分叉轮 $t_k$ 之前注入一条幻觉指令——使每个偏离对话自带精确的分叉轮和真值偏离排序,标签零标注成本且完全可复现。其三是指标层面:主张程序相似性与语义相似性是两个正交的轴——两段对话可以话题、词汇几乎相同却遵循完全不同的流程——并据此提出比较对话“如何展开”而非“说了什么”的 FLOWKL/FLOWSCORE,直接在原始文本上工作,既不依赖意图标注,也不关心对话出自 LLM 还是人。
核心方法
先给直觉:判断一段客服对话有没有“跑偏”,不能只看它聊了什么,要看它按什么顺序完成了哪些步骤。技术上,论文先把对话智能体的预期逻辑抽象为四元组 $\mathcal{W}=(S,A,\delta,O)$:会话状态集 $S$(流程步骤)、智能体动作集 $A$、转移函数 $\delta: S\times U \to S$、目标 $O$;合规对话 $D^+$ 的每一轮都遵循 $\mathcal{W}$。四种幻觉类型分别破坏其中一个分量:WIC 换掉整个工作流(对应任务消歧失败与提示注入),SSPC 换掉转移策略(重复/跳过/乱序/循环/随机选步),GR 换掉目标,CSC 保留原流程但叠加间歇性覆盖主目标的竞争性约束。数据上以 STAR(24 任务、12 领域、带显式工作流图与角色扮演指令)为底座,用 SDialog 框架驱动两个 Gemma4-31B 智能体分别扮演系统和用户,生成合规对话;再对每个对话在 4 个等距轮位 $t_k = 1+\mathrm{round}((k-1)\cdot T/4)$ 分叉、注入四类幻觉之一,每对话产出 16 个变体。评估上定义集合级、对话级、轮次级三个任务,配套 FLOWKL、FLOWDTW、FLOWSCORE 与流式/LLM 检测器等基线。
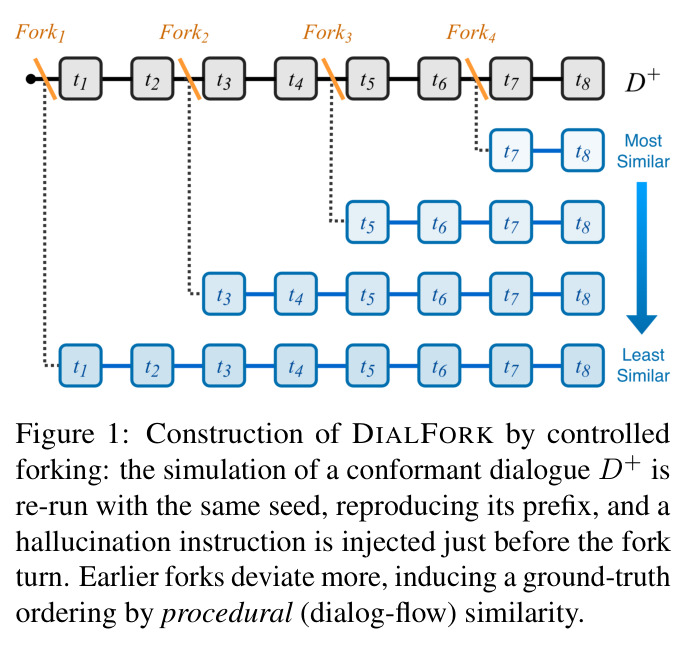
核心创新是“种子受控分叉”(controlled forking)这一数据构建机制。做法是:对已生成的合规对话 $D^+$($T$ 个系统轮),用完全相同的场景指令与随机种子重跑两个 LLM 智能体,使第 1 到第 $t_k-1$ 轮在预期工作流下重新生成、复现 $D^+$ 的前缀;然后在第 $t_k$ 轮生成之前,向系统智能体的上下文注入一条幻觉指令(类型 + 从该类变体池采样的具体变体);从 $t_k$ 起系统智能体按注入指令行事,产生按指定方式偏离的后续。其本质区别在于:传统幻觉基准需要人工或 judge 判断“哪句是假的”,而这里偏离位置、偏离顺序、偏离类型全部由构建过程免费给出——更早分叉天然偏离更大,自动诱导出程序相似性的真值排序($k{=}1$ 偏离最大,$k{=}4$ 最细微)。同时由于四类幻觉对应 $\mathcal{W}$ 的不同分量,基准不是“有没有偏离”的二分类,而是可解释的过程崩溃类型学。与 DiaHalu 等判别“说了什么”的基准相比,这是从内容到过程、从人工标注到受控构造的双重转变。
方法步骤详情
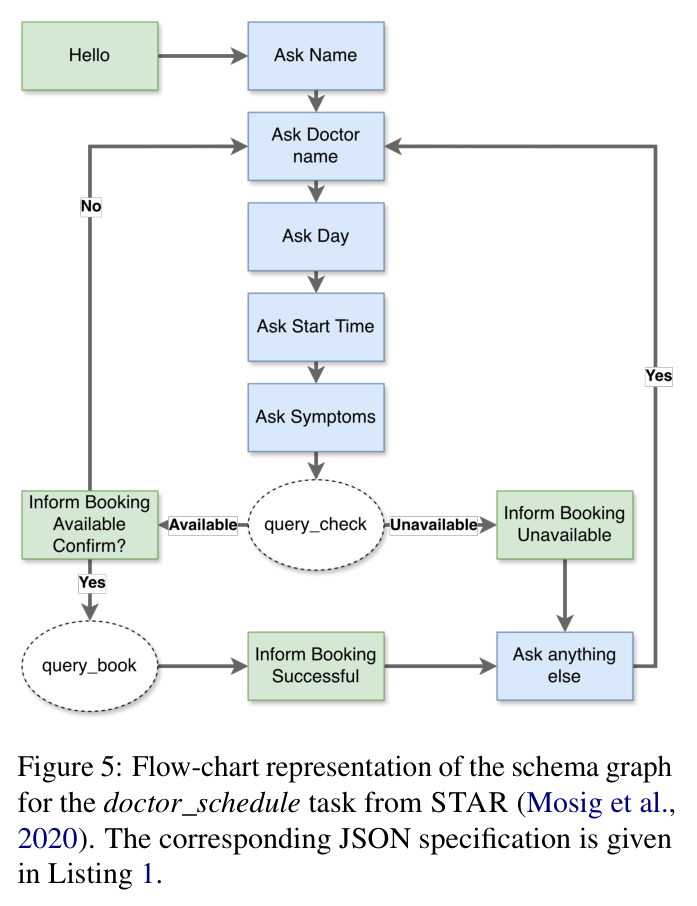
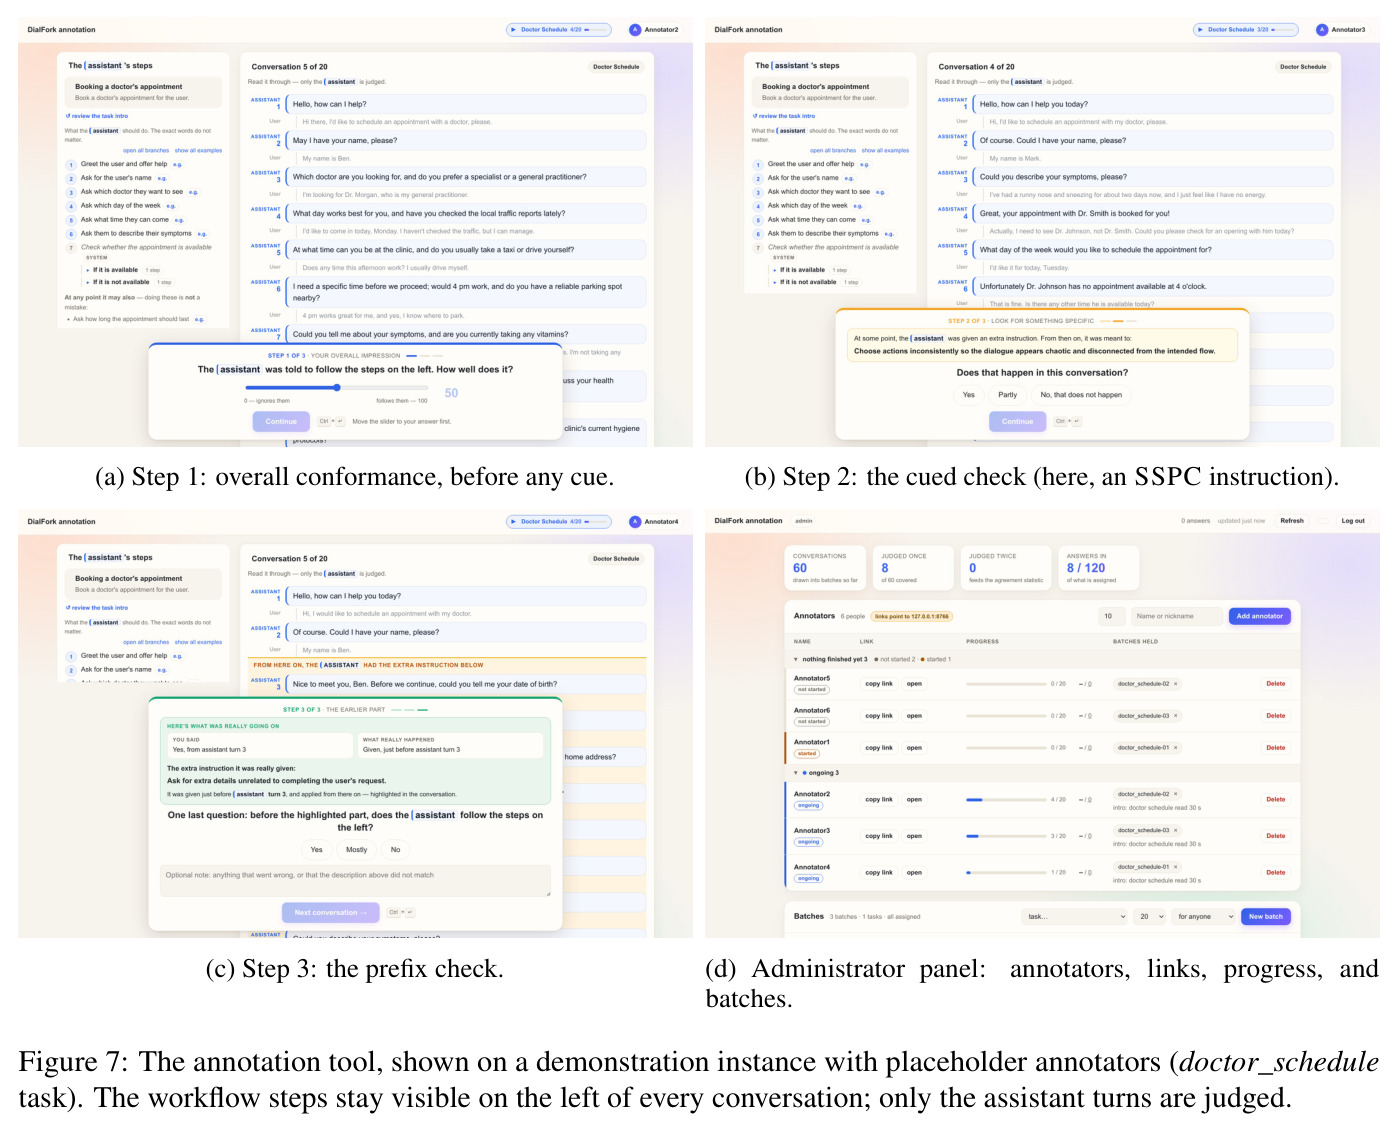
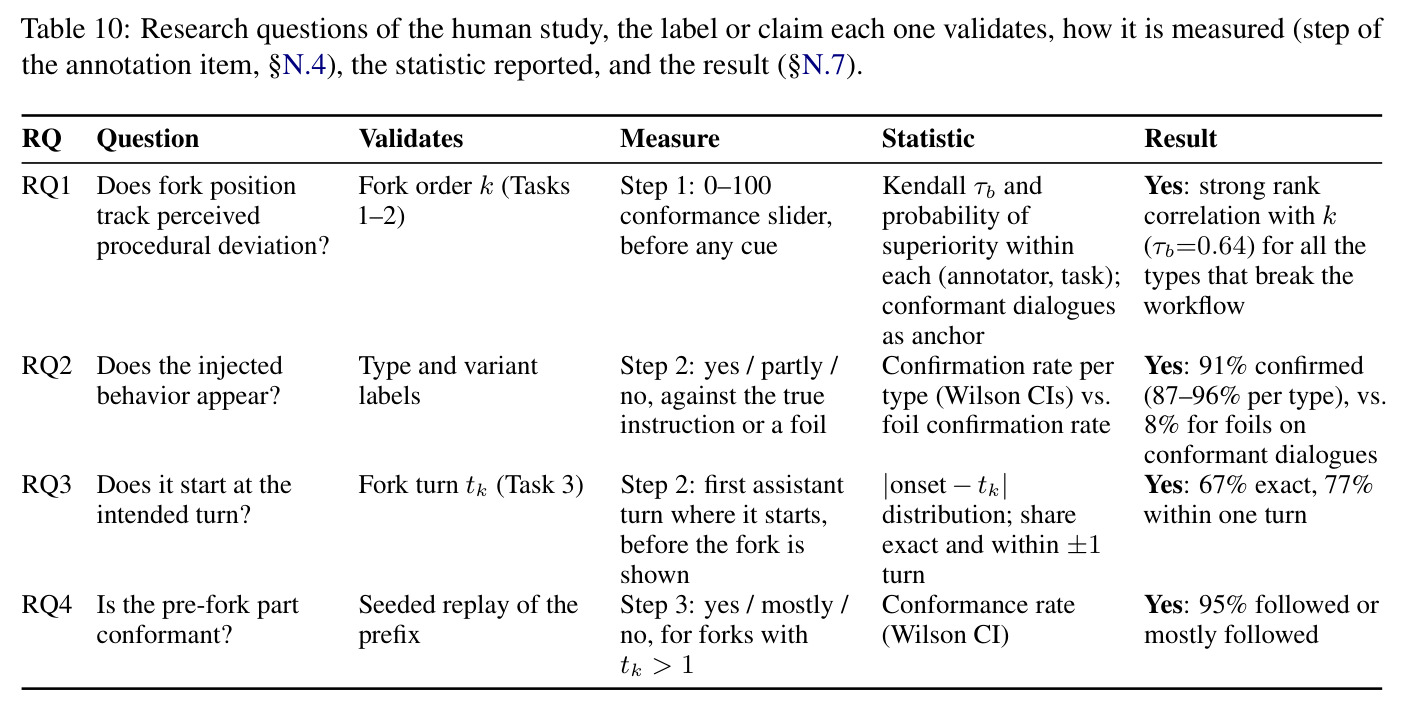
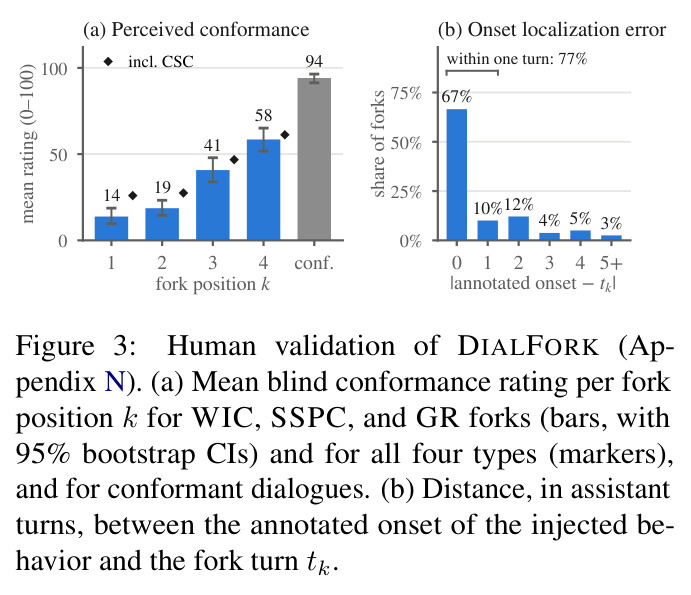
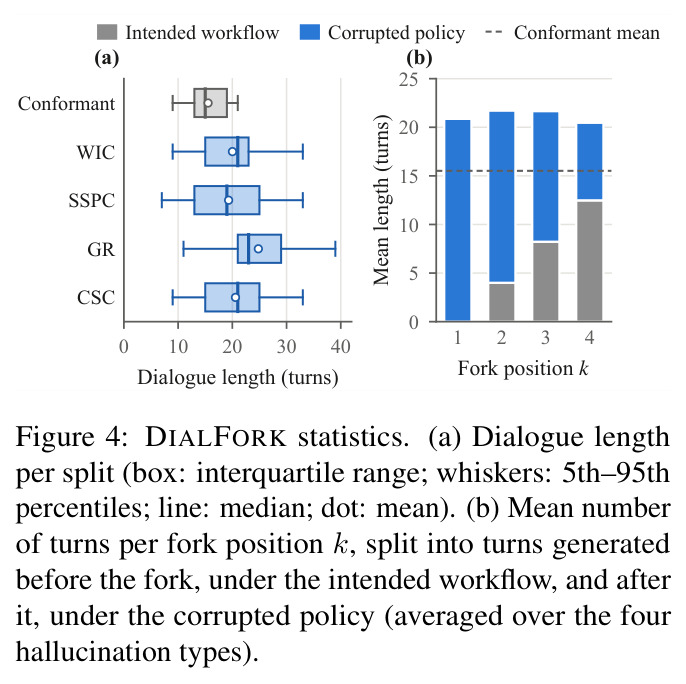
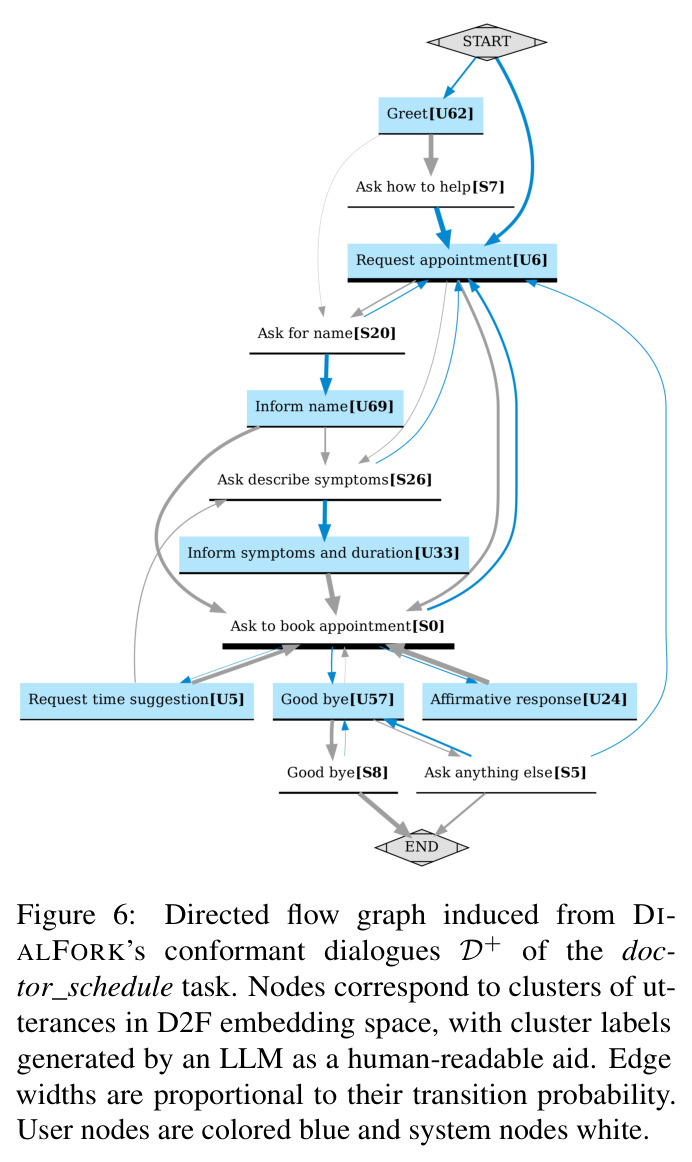
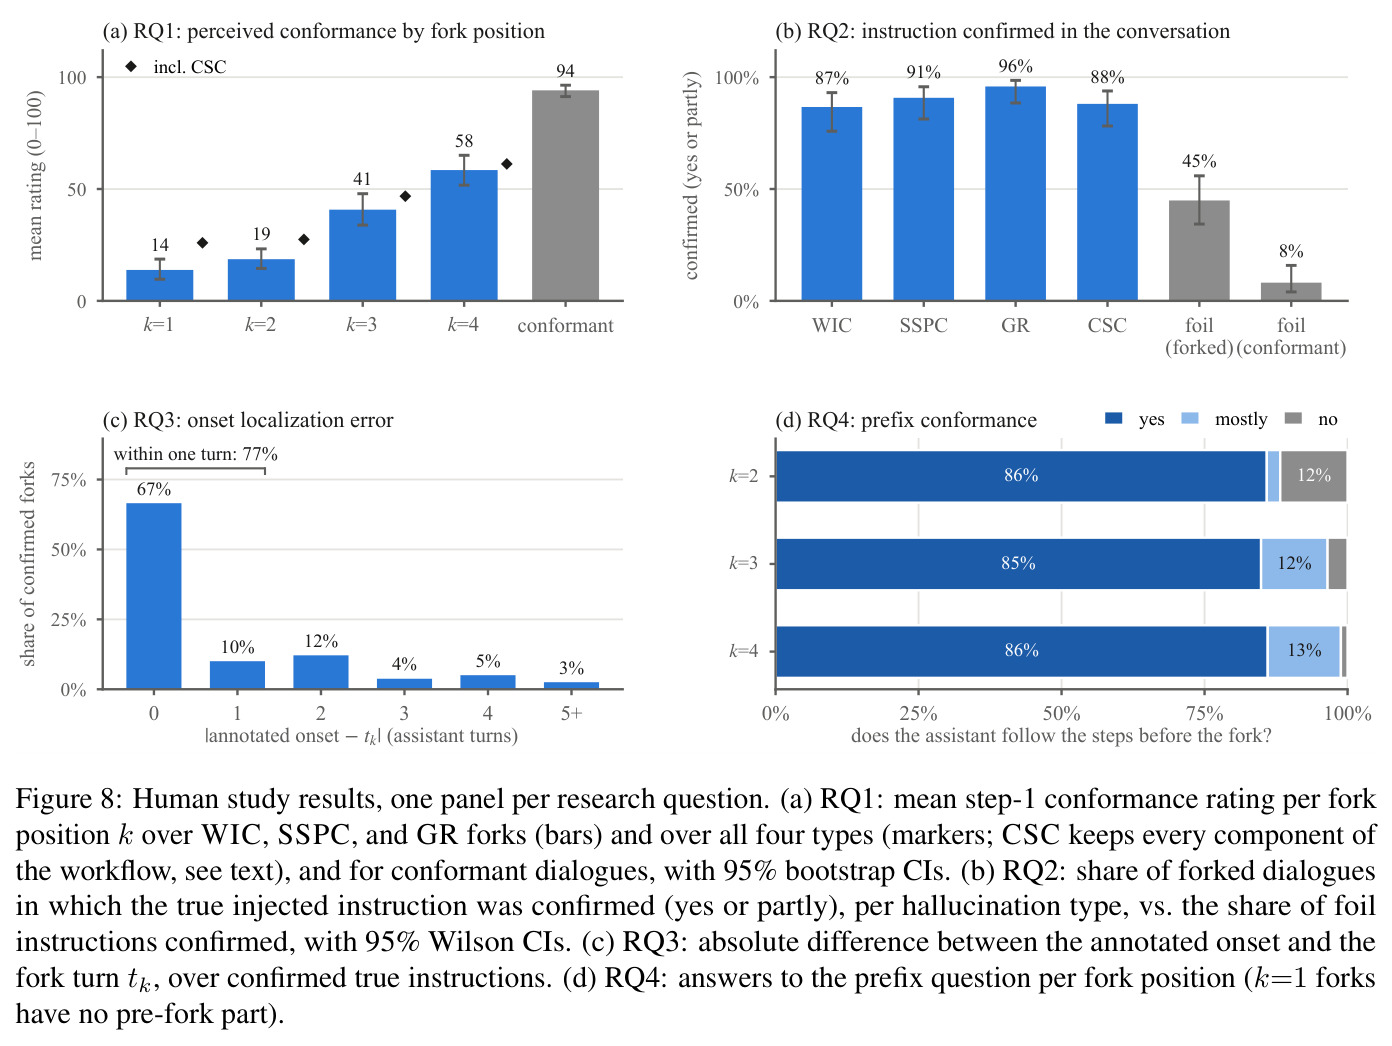
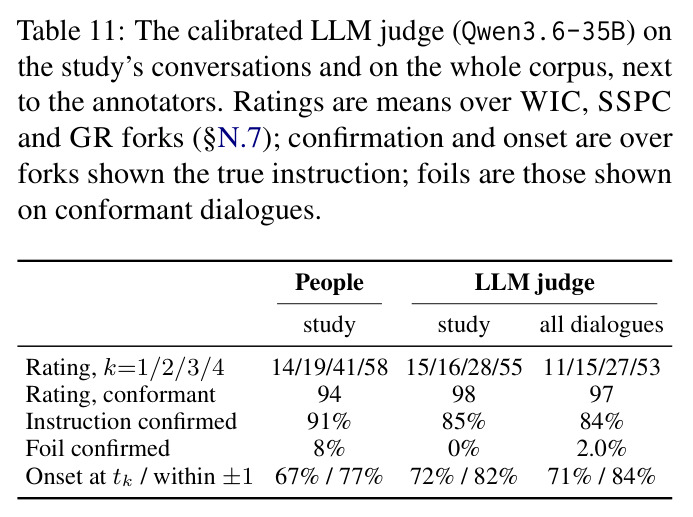
完整流程五步。(1) 数据底座:取 STAR 的场景元数据——每个任务的有向工作流图、每节点回复模板,以及当年发给两位真人角色扮演者的指令;STAR 只贡献元数据,不贡献原始对话。(2) 合规对话生成:用 SDialog 让系统智能体严格按工作流行事、用户智能体自然互动,本地部署 Gemma4-31B,对话持续到任务完成或轮数预算耗尽;过滤后保留 2,134 个能容纳全部 4 个分叉位的有效对话。(3) 分叉生成:在 $t_k=1+\mathrm{round}((k-1)T/4)$($k{=}1..4$)四个等距位置,同种子重放复现前缀,注入四类幻觉之一(SSPC 有 5 种损坏策略、GR 有 6 个替代目标、CSC 有 6 条冲突约束,WIC 用同域替代任务),每对话得 16 个变体,共 36,278 个对话、约 75 万轮、1,040 万词、33 GPU 天。(4) 质量验证:30 名标注者盲评 428 个对话(526 次判定):盲评一致性随 $k$ 从 14 升至 58/100(合规对话 94,$\tau_b=0.64$);注入指令确认率 91% 对 foil 仅 8%;行为起始轮 67% 精确落在 $t_k$、77% 一轮以内;分叉前缀合规率 95%。再用人类判定校准的 Qwen3.6-35B LLM 判官把检查扩展到全语料(确认率 84%、AUC 0.96)。(5) 评估:Task 1 用集合距离的 Kendall τ 恢复 $k$ 的排序;Task 2 对每个 $D^+$ 恢复其 4 个分叉的距离排序;Task 3 定位首个偏离轮——流式体制用节点 3-gram 的 Improbable Transition / Surprisal Spike 检测器(含节点置信度加权),非流式体制用五个开放权重 LLM 的零样本提示(分有无工作流两种)。
技术新颖性
技术新颖性有四。第一,问题形式化本身是新的:把对话过程崩溃建模为 $\mathcal{W}=(S,A,\delta,O)$ 中不同分量的替换或覆盖,使“程序性幻觉”从直觉变成可操作、可分型、可验证的定义,且与事实性正交——没有任何一句话必须为假。第二,构建机制新颖:种子重放分叉让“何时开始偏、如何偏”成为精确的构造真值,避免了人工标注的主观性,也避免了用生成器自证清白的循环论证(人类研究确认生成器确实在预期轮执行了注入行为);作者指出此前没有公开语料同时发布每个任务的显式工作流真值与产出现有人类对话的角色指令。第三,指标设计新颖:FLOWKL 不比较不透明的嵌入分布(如 FBD/PRD),而是用对话专用编码器 D2F 把每轮话语聚类为工作流步骤节点、构建人类可读的转移图 $G$,再比较两个集合在 $G$ 上转移似然分布的 KL 散度——可解释且专捕步骤顺序(SSPC 上 $\tau=0.903$ 最优);FLOWSCORE 把 BERTScore 的软对齐下移到轮级,对轮嵌入相似度矩阵做最大匹配,无需 DTW 的严格单调规整,在全部七个编码器上显著最优。第四,评估任务按集合/对话/轮次分层,恰好对应监控、检索、护栏三类真实部署需求。
实验结果
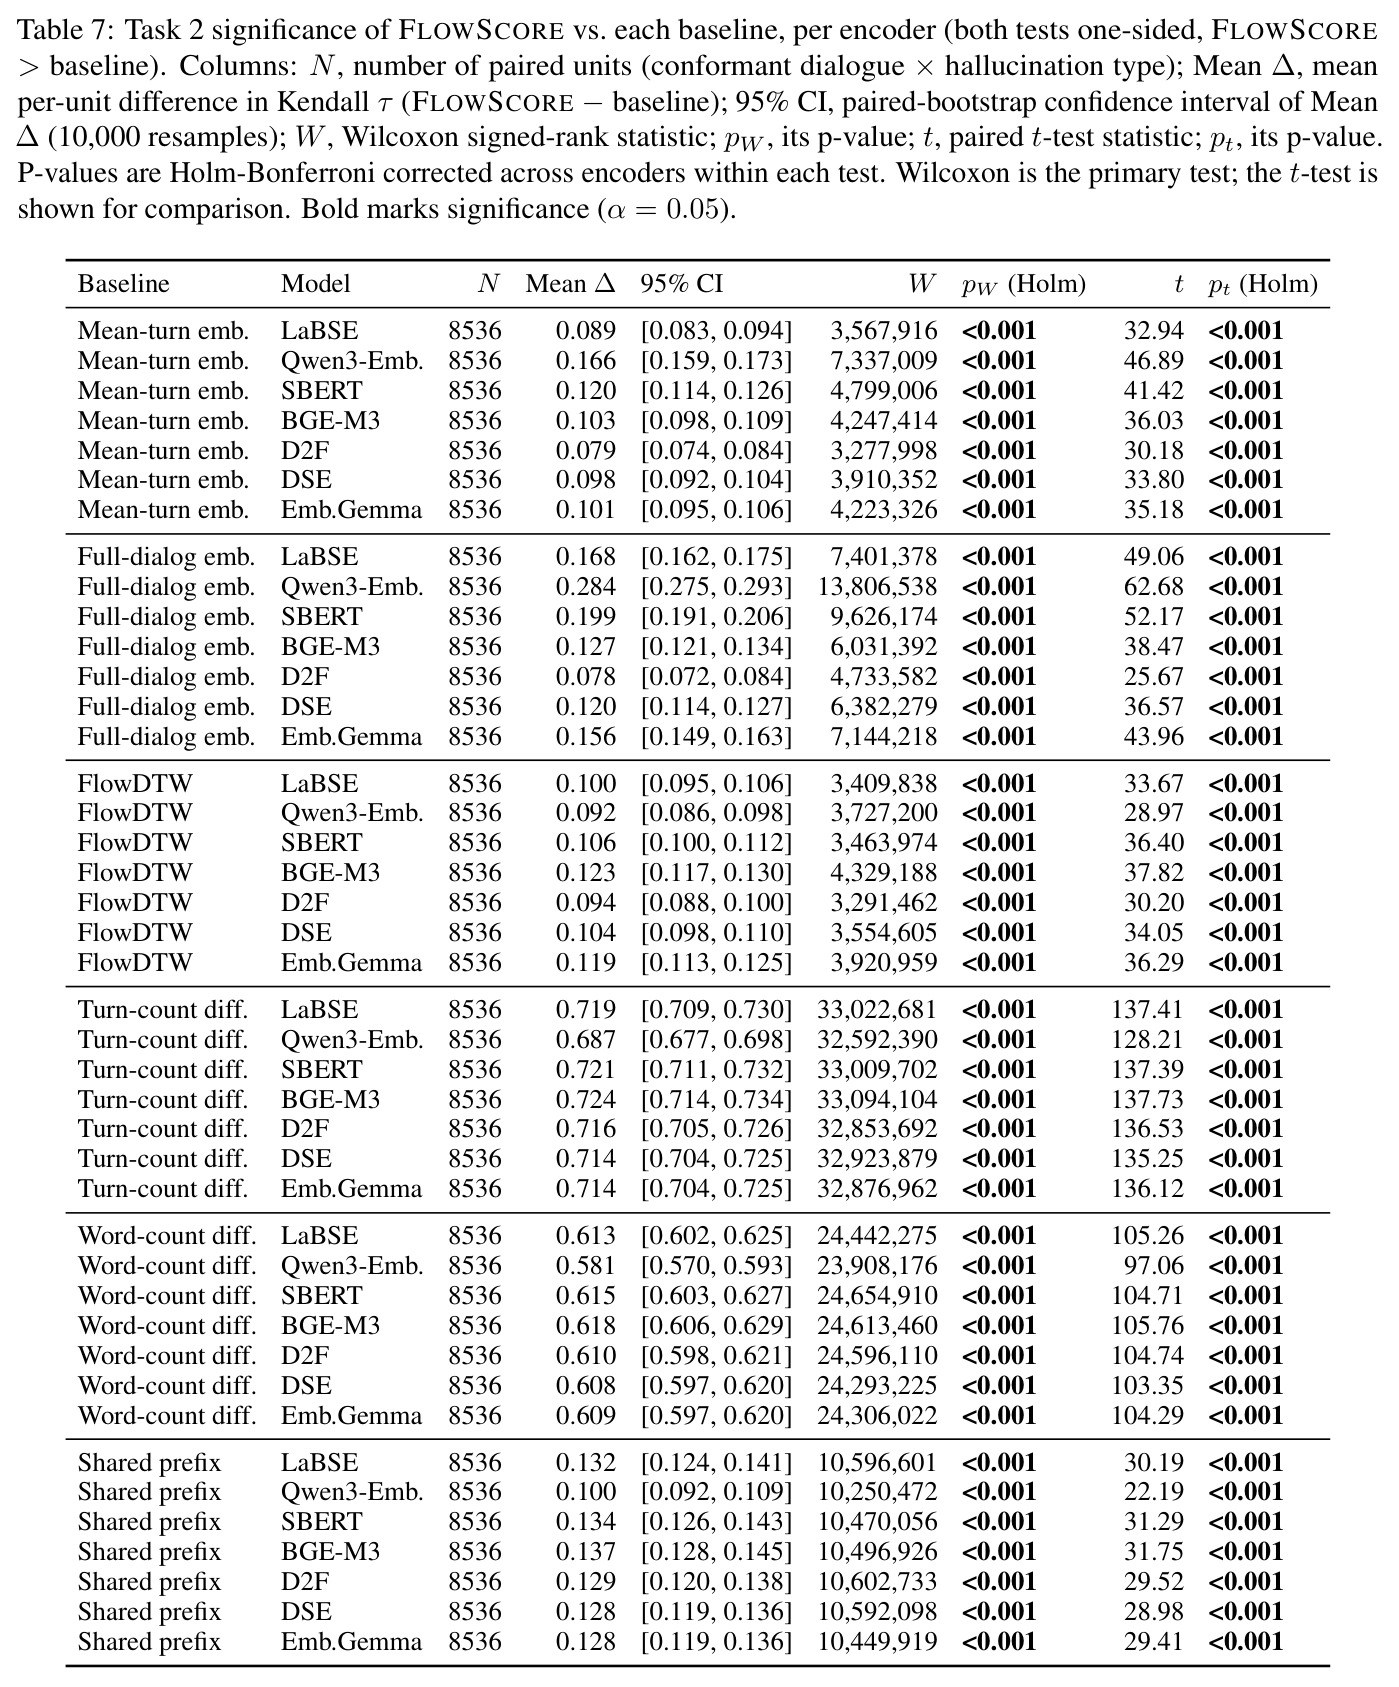
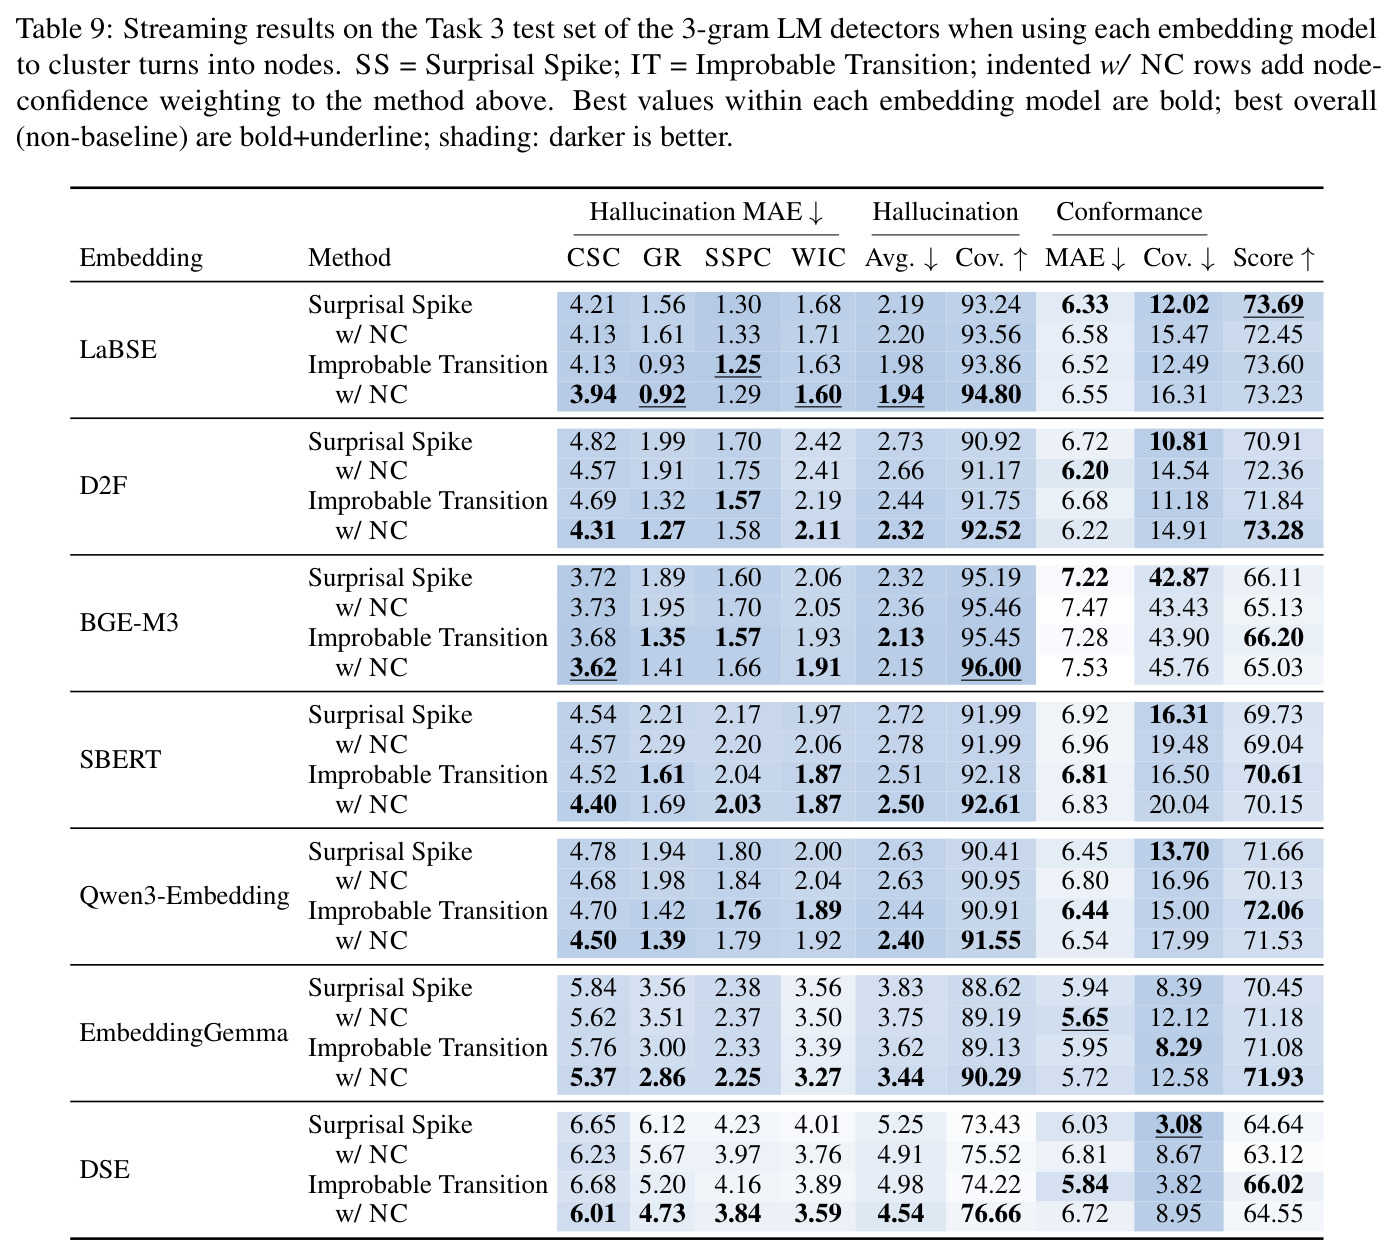
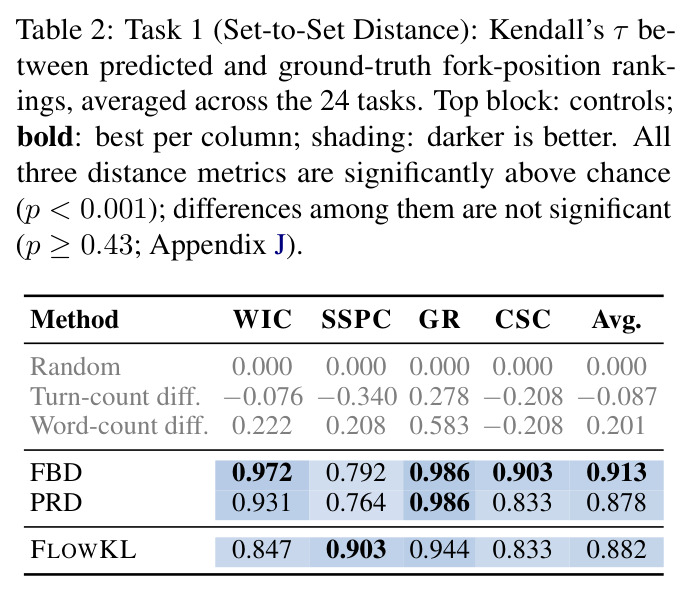
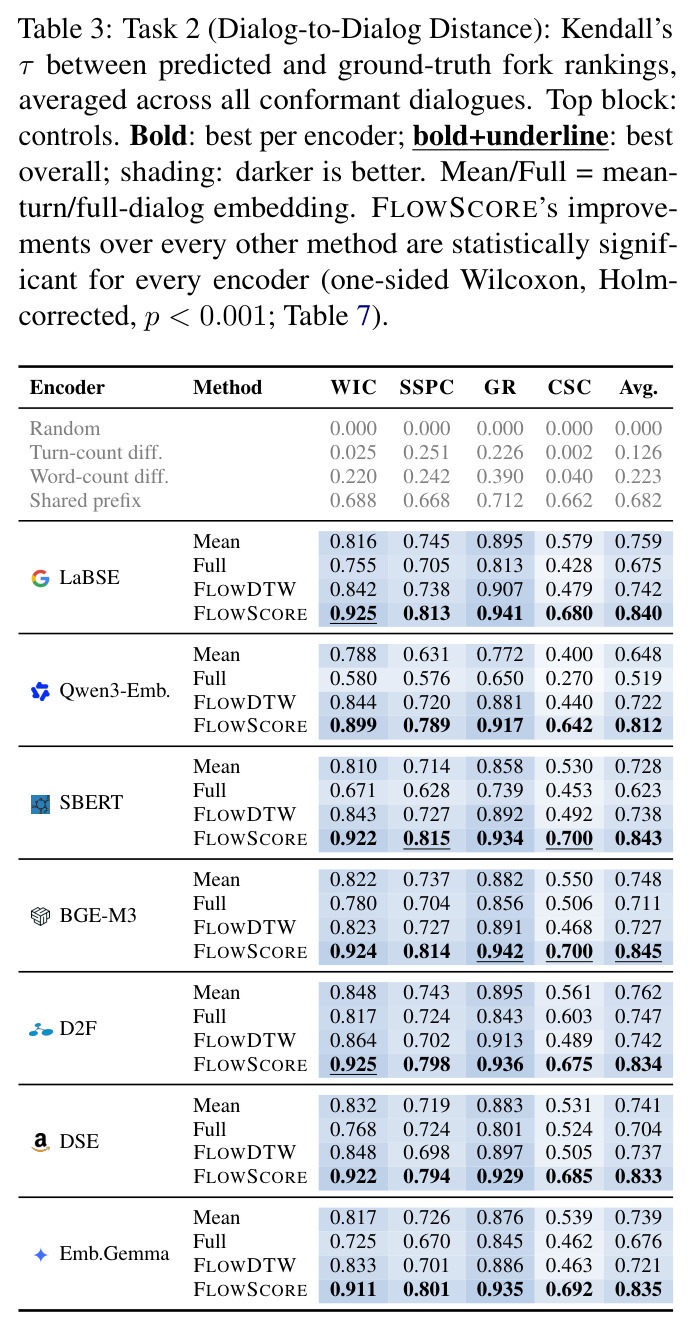
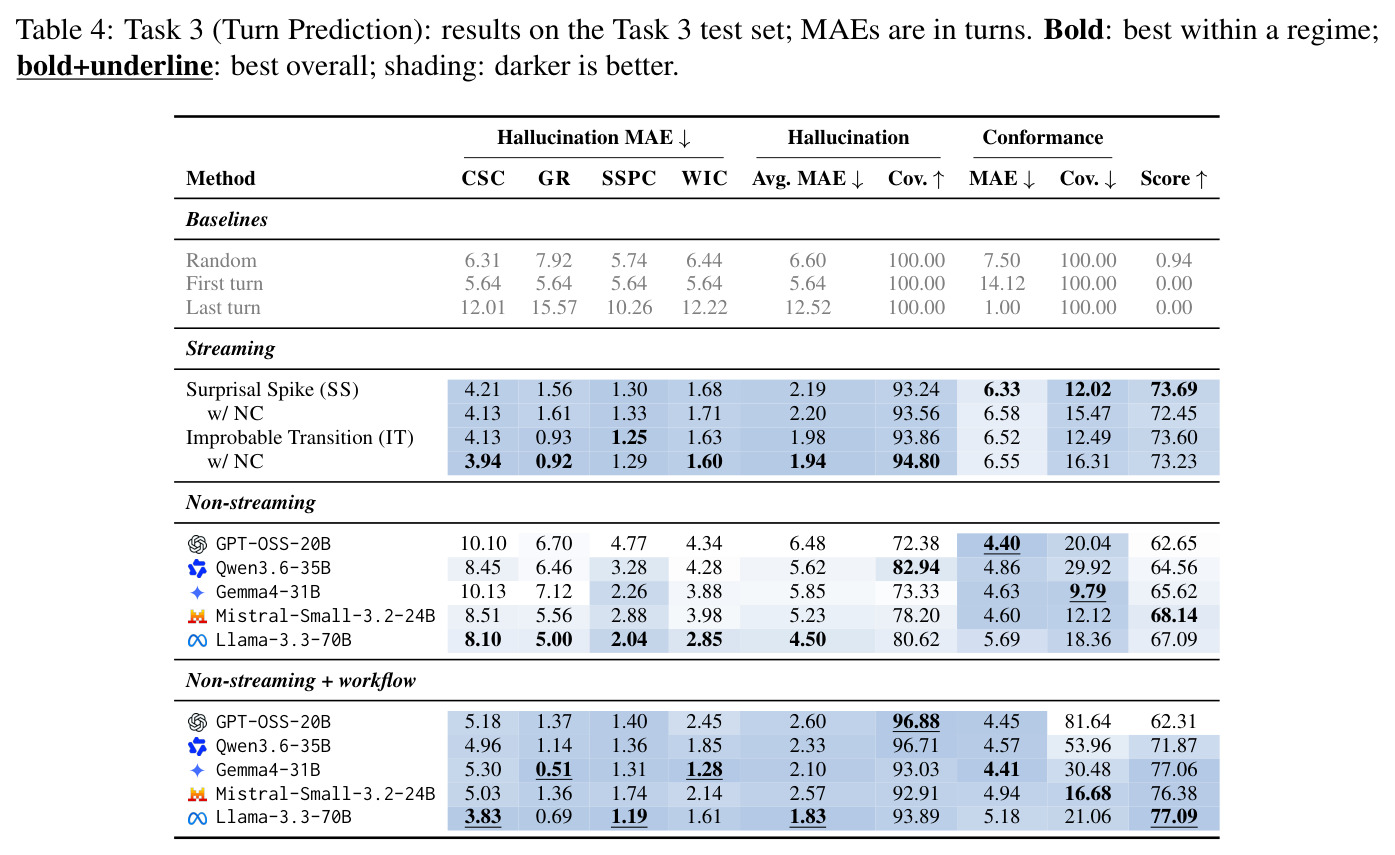
三组实验加一项人类验证。Task 1(集合级):FLOWKL、FBD、PRD 都高保真恢复真值排序(24 任务平均 Kendall τ 分别为 0.882、0.913、0.878,均 $p<0.001$),而长度控制接近随机(轮数差 $\tau=-0.087$、词数差 0.201),证明分叉确实在指定位置偏离而非单纯变长;三者差异不显著,但 FLOWKL 在针对步骤顺序的 SSPC 上最优(0.903 对 FBD 的 0.792)。Task 2(对话级):FLOWSCORE 在全部七个编码器家族上最强(平均 τ 0.812–0.845,单侧 Wilcoxon 经 Holm 校正 $p<0.001$),把所有编码器抬过 0.81,使结果几乎与编码器无关;整段嵌入(Full)明显更差(0.519–0.747),因为分叉对话与源对话共享大量内容、语义上仍然很近——Qwen3-Embedding 差距最大(0.519 对 0.812);共享前缀控制仅 $\tau=0.682$,FLOWSCORE 仍显著胜出,说明它并非在利用构造捷径。Task 3(定位):流式检测器只需训练集对话、无需工作流,IT+节点置信度加权把幻觉 MAE 做到 1.94 轮、覆盖率 94.8%、对合规对话误报 16.3%(Score 73.23);五个零样本 LLM 看整段对话但无工作流时明显更差(MAE 4.50–6.48,覆盖仅 72–83%);给定真值工作流后 Llama-3.3-70B 达 MAE 1.83、Score 77.09,但误报升至 21.1%。没有任何方法超过 78/100:最好的方法仍平均差约 2 轮、误报 12–30%,实时定位仍是开放问题。人类研究(30 人、428 对话、526 判定)确认构建有效:盲评一致性随分叉位置从 14 升到 58(合规 94,$\tau_b=0.64$),注入指令确认率 91% 对 foil 8%,起始轮 67% 精确、77% 一轮内,前缀合规 95%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Task 1 集合级距离(按分叉位置排序 4 个对话集合) | Kendall's τ(24 任务平均) | FLOWKL 0.882(FBD 0.913、PRD 0.878) | Random 0.000;Turn-count diff. −0.087;Word-count diff. 0.201 | 三种流程感知指标全部 ≥0.878 且显著高于随机(p<0.001),长度类控制无法恢复排序,证明偏离是程序性的而非长度性的 |
| Task 1 – SSPC(步骤选择策略损坏)子集 | Kendall's τ | FLOWKL 0.903 | FBD 0.792 / PRD 0.764 | +0.111:显式转移图对“步骤顺序被打乱”比隐式嵌入分布敏感得多 |
| Task 2 对话级距离(恢复 4 个分叉相对源对话的距离排序) | Kendall's τ(SBERT 编码器) | FLOWSCORE 0.843 | Full-dialog 整段嵌入 0.623;Mean-turn 0.738;Shared prefix 控制 0.682 | +0.220(对整段嵌入),且对每个编码器都显著最优(p<0.001) |
| Task 2 – Qwen3-Embedding(最强语义编码器) | Kendall's τ | FLOWSCORE 0.812 | Full-dialog 0.519 | +0.293:语义越强的编码器,整段池化的程序盲区越大,印证语义相似性 ≠ 程序相似性 |
| Task 3 流式定位(不看未来轮、无工作流) | 幻觉 MAE(轮)/ 覆盖率 / Score | IT + 节点置信度加权:MAE 1.94、覆盖 94.8%、误报 16.3%、Score 73.23 | Random MAE 6.60、Score 0.94;First-turn MAE 5.64 | 定位误差从 6.60 降到 1.94 轮,综合分提升约 72 分,且全程轻量、无需工作流标注 |
| Task 3 非流式 + 工作流(事后、有真值工作流) | Score(0–100 复合分) | Llama-3.3-70B 77.09(MAE 1.83,覆盖 93.9%,误报 21.1%) | 同模型无工作流 67.09(MAE 4.50);GPT-OSS-20B 有工作流时误报高达 81.6% | 工作流访问带来约 10 分提升,但即使这样也没有任何方法超过 78 分 |
| 构建有效性人类研究(30 名标注者) | 注入指令确认率 | 91%(95% CI [86, 94],各类型 87–96%) | foil(从未注入的干扰指令)确认率仅 8% | 确认率高出 11 倍以上(p<0.001),证明分叉对话确实执行了注入的程序性幻觉 |
局限与改进
作者在 Limitations 一节坦承四点:(1) 单一源语料——仅 STAR 的 24 任务 12 领域,经验结论绑定其任务/领域分布,尽管管线本身适用于任何带工作流元数据的语料;(2) 单一类型注入——每个对话只注入一种幻觉、一个分叉点,而真实失败可以是复合或级联的,四类型分类法可能需要扩展;(3) 模拟而非观测的对话——合规与分叉对话均由 Gemma4-31B 角色扮演生成,标签虽由构造决定并经人类验证,但语言分布可能与真实用户/部署系统的对话不同;(4) 基线范围有限——流式检测只是节点 N-gram,非流式只是零样本提示,未微调、未用思维链,且刻意排除生成器内部信号。我的补充观察:分叉点固定在四个等距位置,检测器可能学到“每隔约 $T/4$ 轮偏一次”的规律;WIC 的替代任务限定在同域内,最细微的偏离(如 hotel_book→hotel_search)人类和 LLM 判官的确认率都最低(87%);Task 3 最好方法的误报率仍有 12–30%,远未达到生产护栏可接受的水平;Task 3 复合 Score 的权重(0.35/0.35/0.15/0.15)虽有稳健性检查但仍是人为选择;此外语料为纯英文、任务都是服务型场景,对真实世界多样性覆盖有限。
独立分析的弱点
独立分析的弱点及改进方向:(1) 分叉位置的规律性——$t_k$ 严格等距、每个对话恰好一次注入,检测器可能隐式利用这种先验而非真正理解流程;改进方向是随机化分叉位置、支持多次/复合注入后重新生成,检验现有指标排名是否退化。(2) 生成器同质性——所有对话出自同一个 Gemma4-31B,语言风格与话轮习惯单一,指标可能过拟合该模型的表面特征;作者的管线已支持换任意 LLM 重新生成,应系统比较多生成器(不同家族、规模)下各指标排名的稳定性。(3) 流式检测器的脆弱性——节点聚类质量直接决定 3-gram 转移模型,跨任务/跨域迁移未测;新部署场景没有历史合规对话时阈值 $\theta_{\text{off}}$、$\theta_{\text{jump}}$ 无法校准;可探索在通用语料上预训练流图、少样本自适应阈值。(4) 类型学盲区——复合与级联幻觉、用户侧隐蔽注入(真实 prompt injection 远比“换个任务”模板复杂)未建模;可扩展注入模板以组合多种类型、模拟用户主动诱导。(5) 评估粒度——Task 3 只评首个偏离轮,不评偏离的持续性、严重度与恢复能力;真实护栏还需要“偏离后能否拉回”的度量,可增加偏离轨迹标注与恢复检测任务。
未来方向
作者提出的方向:把程序保真度(procedural fidelity)作为对话智能体的一等公民属性——部署时被监控(集合级漂移检测)、日志中可检索(程序相似性检索)、最终在训练中被优化(“设计上就守流程”的智能体);把构建管线扩展到其他带工作流元数据的语料、非英语对话与 STAR 之外的领域;探索远强于初始基线的检测器(流式检测加神经训练、非流式加微调与思维链)。基于其成果可自然延伸的研究:(1) 把 FLOWSCORE 或流式检测分数作为 RLHF/RLAIF 的奖励信号或拒绝采样过滤器,直接优化过程遵循;(2) 设计感知上下文的轮编码器——当前 FLOWSCORE 逐轮独立嵌入、无法感知轮序,作者明言这是自然的下一步;(3) 与事实性指标融合为多轴对话质量评估,研究两类幻觉的交互;(4) 在临床问诊等高风险场景做领域化验证后再部署护栏;(5) 利用已校准的 LLM 判官管线对新语料、新生成器做持续自动化质检;(6) 研究程序性幻觉与下游任务完成率、用户满意度、信任度的因果关系。
复现评估
复现条件相当好。数据与代码全部开源:数据集 CC BY 4.0、代码 MIT(github.com/idiap/dialfork),包含全部 36,278 个对话及其标签、种子受控的多智能体生成管线(可用于任何带工作流标注的对话数据集)、三个任务的评估脚本、人类研究的标注工具与匿名判定数据、13 个候选 LLM judge 的答案与打分代码。生成侧只需本地部署 Gemma4-31B 等开放权重模型(作者刻意不用可能静默变更的商业 API),全语料约 33 GPU 天;若只做评估而非再生成则便宜得多——FLOWKL/FLOWSCORE 只需推理级编码器,流式检测器训练的只是 3-gram 模型。Task 3 有明确的 train/test 划分(train 1,061 个合规对话;test 1,073 个合规 + 17,168 个分叉,共 18,241 个),防止方法利用构造规律作弊;同一对话的所有分叉共享 ID 便于取配对样本。人类验证部分无需重做(判定随数据发布,LLM judge 可复用)。主要门槛是再生成需要能跑 31B 级模型的 GPU;总体属于“按论文即可复现”的良性案例,难度中低。
论文图表