SWE-at-Scale:从历史 Bug 修复逆向合成可扩展的软件工程任务 SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
逆向历史Bug修复训练注入模型,规模化合成真实多样的可执行SWE任务
前置知识
仓库级软件工程任务(Repository-level SWE Task)
指给定一个真实代码仓库和一条 GitHub 风格的 issue 描述,要求模型或工程师修改代码使隐藏的失败测试重新通过的任务,SWE-bench 是这一范式的代表基准。一个合格的任务需要保留真实的仓库上下文、引入可观察的行为缺陷、提供有意义的 issue 描述,并能在仓库自带的测试基础设施中可执行验证。
本文的全部目标就是合成这类任务,理解其构成要素(golden 仓库 + issue + P2F 测试)才能明白合成质量该从哪些维度评价。
逆向修复(Reverse-Fix)与 Bug 诱导补丁
真实修复补丁描述了 buggy code $\rightarrow$ golden code 的变换;把这一变换反转,就得到 golden code $\rightarrow$ buggy code 的 bug 诱导补丁。具体做法是先把原始 golden patch 应用到 buggy 仓库重构出修复后的文件,再计算修复后文件回到原始 buggy 版本的反向 unified diff,这个反向 diff 就是训练监督。
这是本文训练数据的来源,『逆向修复把修复监督变成 bug 诱导监督』是全文最核心的一句话,不理解它就无法理解方法。
Pass-to-Fail(P2F)执行验证
一种执行级过滤标准:把生成的 bug 诱导补丁应用到正确的 golden 仓库并运行其测试套件,只有至少让一个原本通过的测试变为失败的候选才被保留。它同时保证了补丁可应用(git apply 成功)和缺陷可观察(有回归测试能抓住),是合成任务可用性(Usability Rate)的判定口径。
P2F 决定了哪些候选能成为任务,也解释了为何测试覆盖率会限制可合成任务的空间,以及可用率指标的来源。
平均 Bug 类型熵(MBTE, Mean Bug Type Entropy)
衡量同一代码文件上模型能生成多少种不同类型 bug 的指标。对目标文件 $i$ 在设定 $s$ 下,按可用候选中各 bug 类型占比 $p_{i,s}(k)$ 计算熵 $H_{i,s} = -\sum_{k} p_{i,s}(k) \log_2 p_{i,s}(k)$,再对 $N$ 个目标文件做宏平均:$\mathrm{MBTE}_s = \frac{1}{N}\sum_{i=1}^{N} H_{i,s}$,单位为比特,越高说明同一文件能产出的 bug 类型分布越广。
论文的多样性扩展实验(仓库覆盖、采样温度、采样预算)全部以 MBTE 为主指标,不懂它就看不懂 4.2 节的 Scaling 分析。
LoRA 低秩适配微调
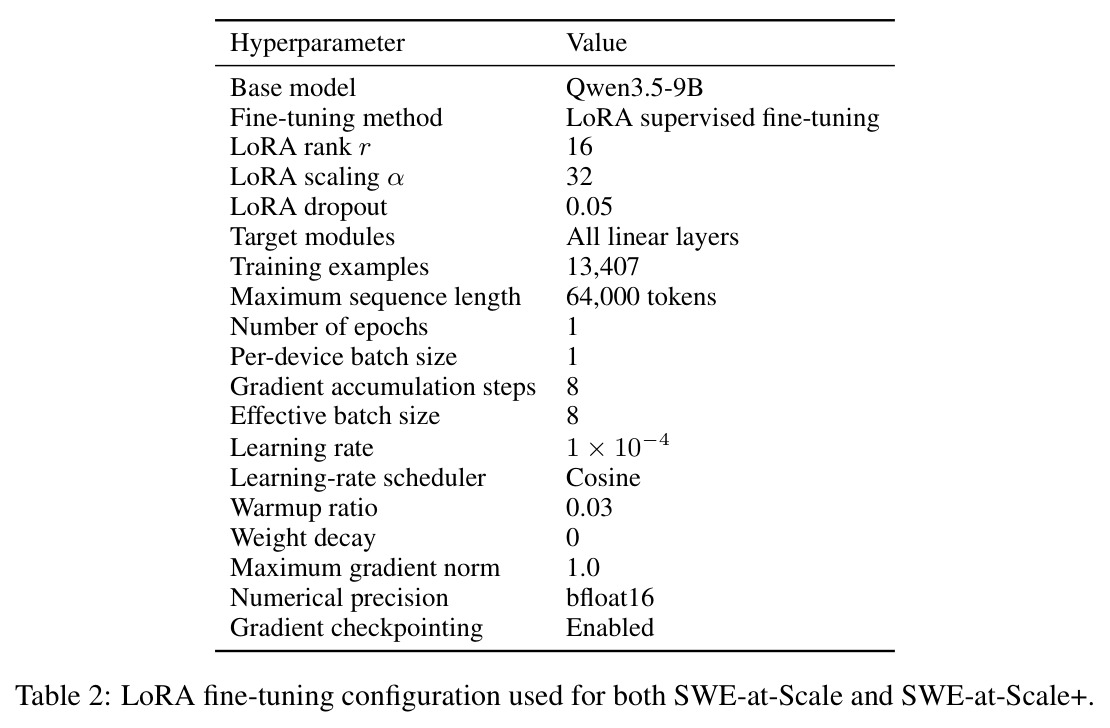
一种参数高效微调方法:冻结原模型权重,只训练注入到各线性层的低秩分解矩阵(秩 $r$ 远小于原维度),大幅降低显存与算力需求。本文用 LoRA 在单张 RTX PRO 6000 上以 $r=16$、$\alpha=32$、学习率 $1\times10^{-4}$ 对 Qwen3.5-9B 微调 1 个 epoch,共 13,407 个样本、64K token 上下文。
它解释了为什么 9B 模型能在单卡上完成训练,其超参配置(附录 Table 2)也是复现本文的关键。
研究动机
coding agent 能力快速提升,但可验证 SWE 评测任务的供给跟不上。真实任务方面,SWE-bench 这类基准只有 2,294 个真实 GitHub issue(Verified 子集更少),新任务只能以真实软件开发中 issue 报告的自然频率产生,还要付出高昂的仓库获取与环境构建成本,靠自然积累扩展任务量几乎不可行。合成任务方面,SWE-smith 用提示让 LLM 修改选定的代码实体,SWE-Synth 用组件重写加测试过滤,BugPilot 把特征开发中的回归当作 bug——这些方法都没有针对 bug 注入做专门训练,本质上只是在『抽取』通用 LLM 预训练中已有的 bug 生成知识。后果有二:一是启发式提示难以还原真实软件失效的复杂机理;二是重复生成时模型倾向复用熟悉的 bug 模式,多样性很快坍缩。Figure 1 直观展示了这一点:SWE-smith 的合成任务类型分布明显偏斜,与 SWE-bench Verified 的真实分布差距很大。
本文的目标是本文想把有限的真实修复变成可复用的监督信号:训练一个可复用的 bug 注入模型,使其能在任意处于正确状态的代码仓库上反复采样,生成多样化的真实 bug,并组装成可执行验证的仓库级 SWE 任务。具体可衡量的目标包括:(1) 合成任务在人工盲评中的真实感超过现有合成基线(最终 HPR 达 61.2%);(2) 任务对 SOTA agent 构成实质挑战,Pass@1 显著低于现有合成基准、接近人工专家设计的 DeepSWE(最终 SWE-at-Scale+ 为 16.81%–37.02%);(3) 多样性可随推理时采样预算扩展——同一文件生成 200 次仍有 88.27% 的可用补丁唯一。
与已有工作不同的是,已有工作把每条历史修复当成一次性任务实例用完即弃,而本文的关键洞察是:历史修复封装了 bug 形成的深层机理知识,把修复『倒过来』就得到 correct$\rightarrow$buggy 的 bug 诱导监督,且这种监督扎根于真实开发场景而非模型先验。聚合 688 个仓库的 13,407 个逆向变换来微调模型,可以让 9B 小模型学到可复用的真实 bug 模式分布,再在新代码上下文中反复实例化。这与『反复 prompt 通用大模型』形成本质对比:前者是学习一个分布然后从中采样,多样性有训练数据兜底;后者是从模型先验里『抽奖』,多样性天花板完全不同。
核心方法
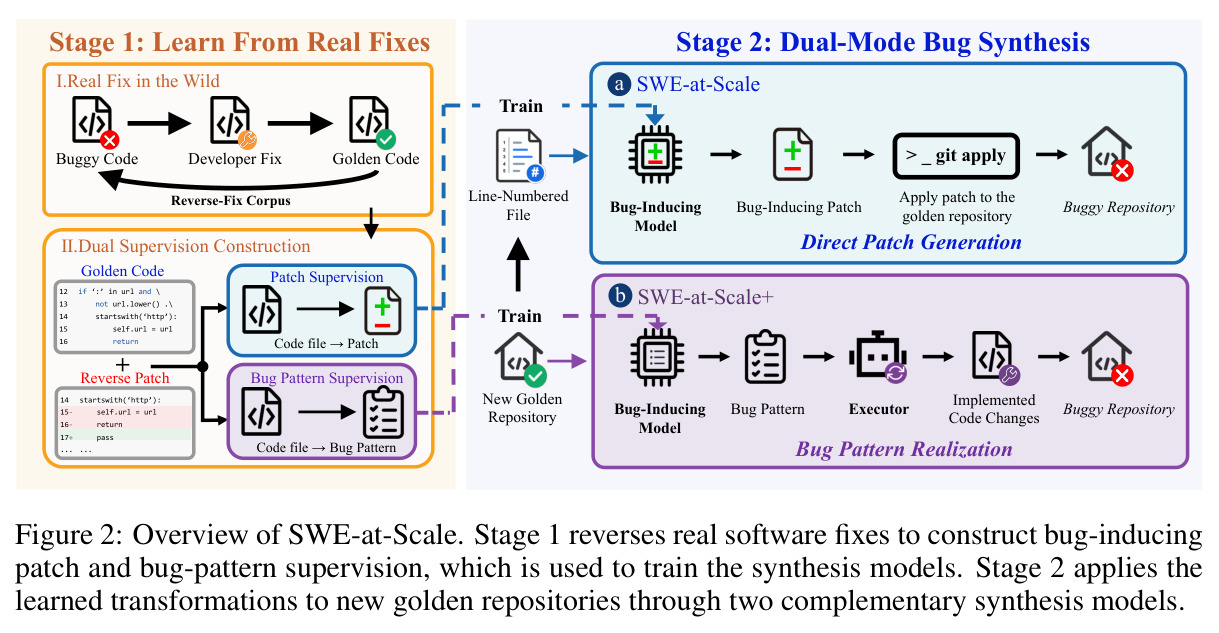
直觉上,这就像把『工程师如何修 bug』的教学录像倒着放,就能学会『bug 是如何被制造出来的』。整个流水线分两阶段:Stage 1 从真实世界收集修复并反向构造监督——先把 golden patch 应用到 buggy 仓库重构修复后的文件,再计算修复后文件回到 buggy 版本的反向 diff,最终得到来自 688 个仓库的 13,407 个 real-fix 变换;Stage 2 训练两个互补的合成模型:SWE-at-Scale 直接从行号标注的完整 golden 文件生成 bug 诱导 unified diff(用 git apply 应用),SWE-at-Scale+ 先生成自然语言 bug pattern 再由不知情的 executor 实现修改。候选补丁经 P2F 执行验证后,用 LLM 依据代码 diff、失败测试源码和执行输出生成 GitHub 风格 issue,组装成最终任务实例。骨干模型是 Qwen3.5-9B,LoRA 微调 1 个 epoch,单张 NVIDIA RTX PRO 6000 即可完成训练。
核心创新是把『bug 注入』从提示工程问题变成监督学习问题。SWE-smith/LLM-Modify 直接 prompt LLM 在指定位置注入缺陷,LLM-Rewrite 靠重写实现产生行为回归,BugPilot 靠特征开发的意外回归——它们的 bug 生成知识全部来自通用 LLM 的预训练先验,没有任何专门的 correct$\rightarrow$buggy 训练信号,所以重复采样会不断回到熟悉的 bug 模式。SWE-at-Scale 则显式构造 13,407 个真实开发中发生过的逆向变换作为监督,让模型学到真实 bug 模式的可复用分布:采样温度控制对这个分布的探索广度,采样预算控制采样次数,多样性因此同时具备训练时(仓库覆盖)和推理时(温度、预算)两个扩展轴。SWE-at-Scale+ 进一步把隐含在补丁里的 bug 逻辑外置为自然语言 pattern(由 DeepSeek-V4-Flash-0731 教师标注),与语言模型的建模能力对齐——94.0% 的可用率和 61.2% 的人类偏好率证明这种显式化有效。
方法步骤详情
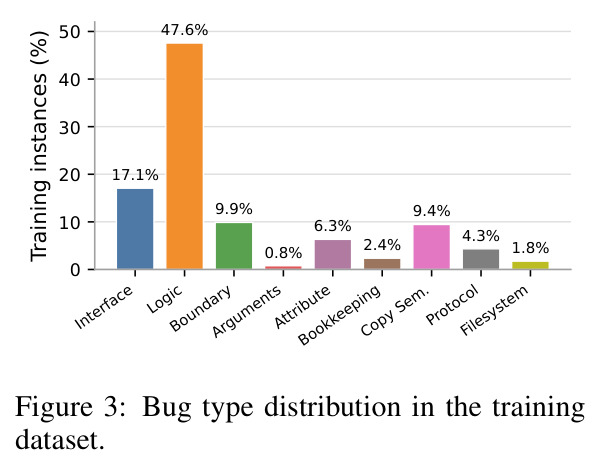
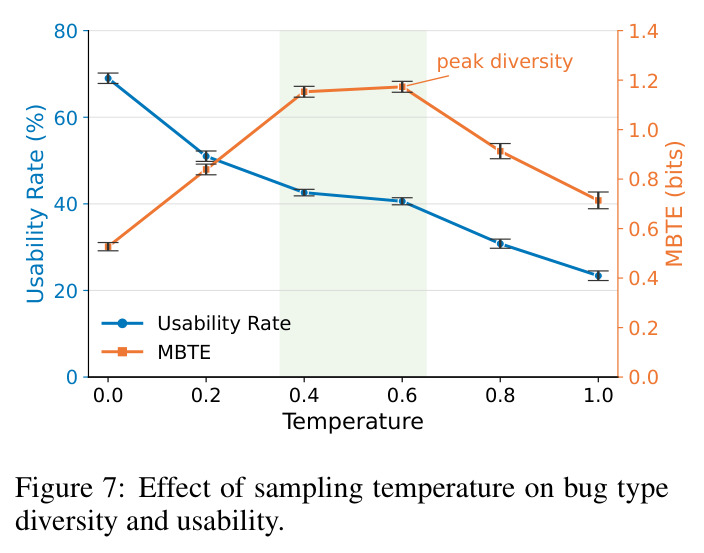
完整流程五步。(1) 数据收集:从 SWE-Fixer、SWE-rebench、SWE-bench-Live、SWE-Gym 四个来源共 134K+ 的 issue–fix 实例中,识别修复所修改的源文件并恢复修复前后两个版本;把 golden patch 应用到 buggy 仓库重构 fixed 文件,再计算 fixed$\rightarrow$buggy 的反向 unified diff 作为 bug 诱导补丁;排除与 SWE-bench Verified 重叠的仓库避免评测污染。(2) 质量过滤:剔除缺失或不可解析的补丁、非代码文件、imports/注释/空白主导的变更和结构不完整的补丁;round-trip 验证确保正反补丁都能成功应用并还原对应状态;按 BugPilot 方案标注 bug 类型;剔除超 64K token 的样本。(3) 分布感知采样:尽量平衡 bug 类型、仓库和上下文长度,人工抽检后得到 13,407 个变换、688 个仓库。(4) 训练与合成:Qwen3.5-9B 为骨干,LoRA($r{=}16$、$\alpha{=}32$、dropout 0.05、学习率 $1\times10^{-4}$、1 epoch、64K 上下文)训练;SWE-at-Scale 输入行号标注的完整 golden 文件、输出 unified diff,自行推断改哪里和怎么改;SWE-at-Scale+ 的监督由 DeepSeek-V4-Flash-0731 教师生成,pattern 涵盖任务类别、目标位置、当前行为、具体修改、实现约束和预期可观察效果,合成时交给不知情的 executor 当作普通代码修改指令执行。(5) 任务组装:git apply 后跑测试套件,只保留造成至少一个 P2F 测试的候选,再用 LLM 依据 diff、P2F 测试源码、执行输出和两个示例生成 GitHub 风格 issue。每文件最多尝试 5 次(首次温度 0,其余温度 1.0)。
技术新颖性
与已有技术相比有三点新颖性。其一,训练范式:首次把大规模逆向修复变换(13,407 个、688 仓库)作为 bug 注入的监督信号,而 SWE-smith、SWE-Synth、BugPilot 都停留在推理时提示或源 issue 迁移(SWE-Mirror 把已有 issue 语义搬到相似仓库),没有专门的 bug 诱导训练。其二,双模式设计:SWE-at-Scale 直接生成补丁(高效、bug 逻辑隐式),SWE-at-Scale+ 先产出自然语言 bug pattern 再实现(显式、可控),并让 executor 在不知情的前提下执行以避免其先验污染,这种『规划-执行解耦 + 保密指令』的组合是新的。其三,把合成多样性表述为可量化的扩展问题:用 MBTE 度量单文件 bug 类型熵 $H_{i,s} = -\sum_{k} p_{i,s}(k) \log_2 p_{i,s}(k)$,并系统研究了仓库覆盖、采样温度(0.0–1.0)和采样预算($K=5$–$200$)三个扩展轴,把『多样性』从定性描述变成了可绘制、可优化的曲线。
实验结果
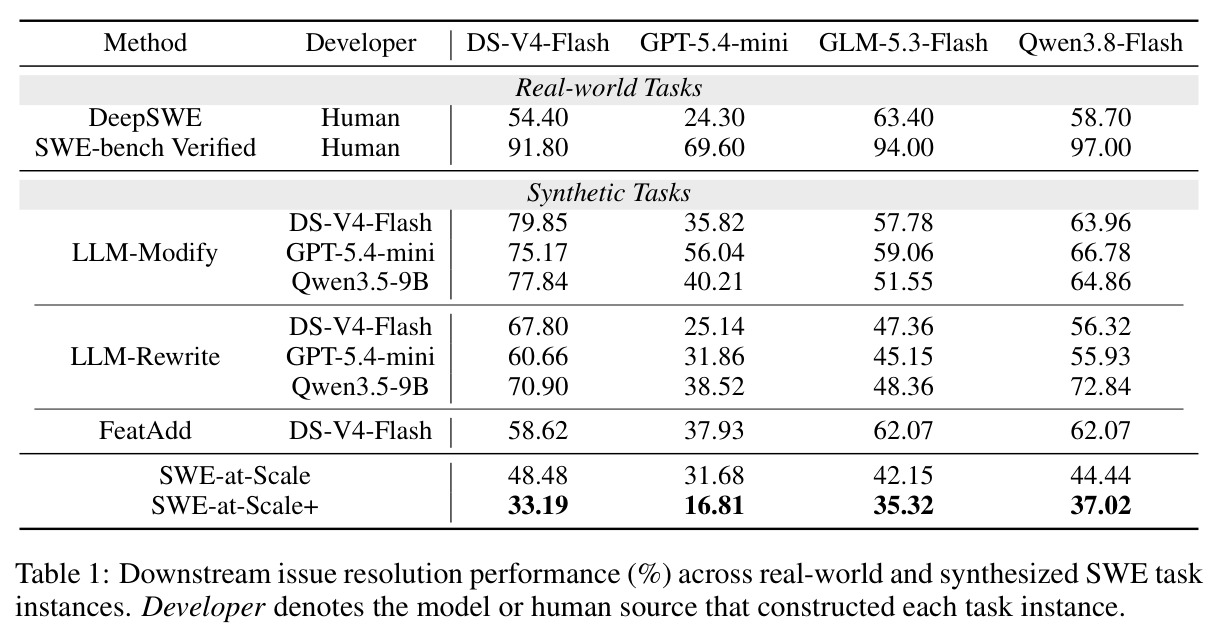
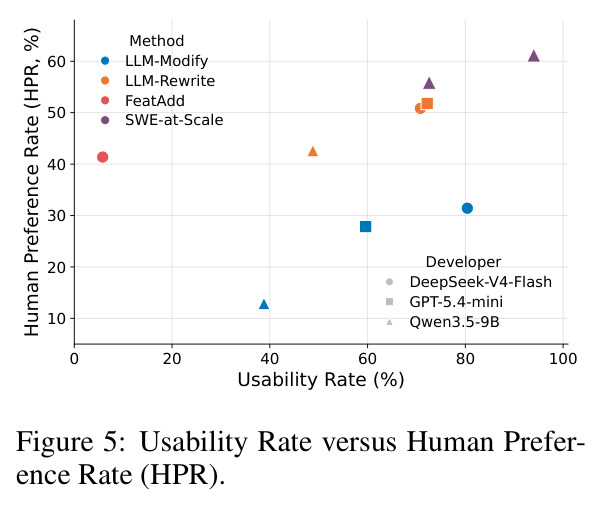
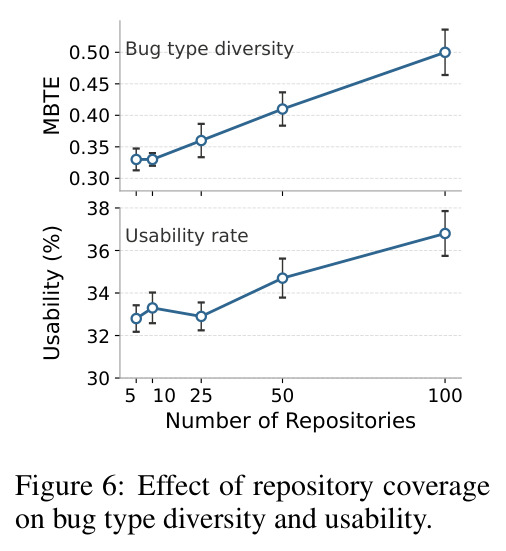
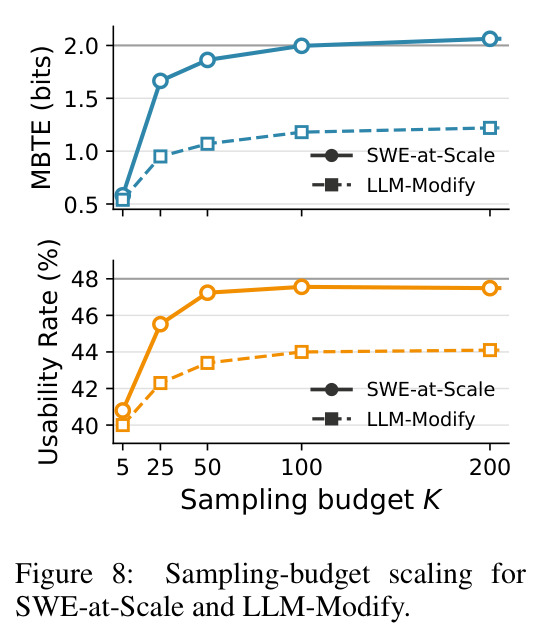
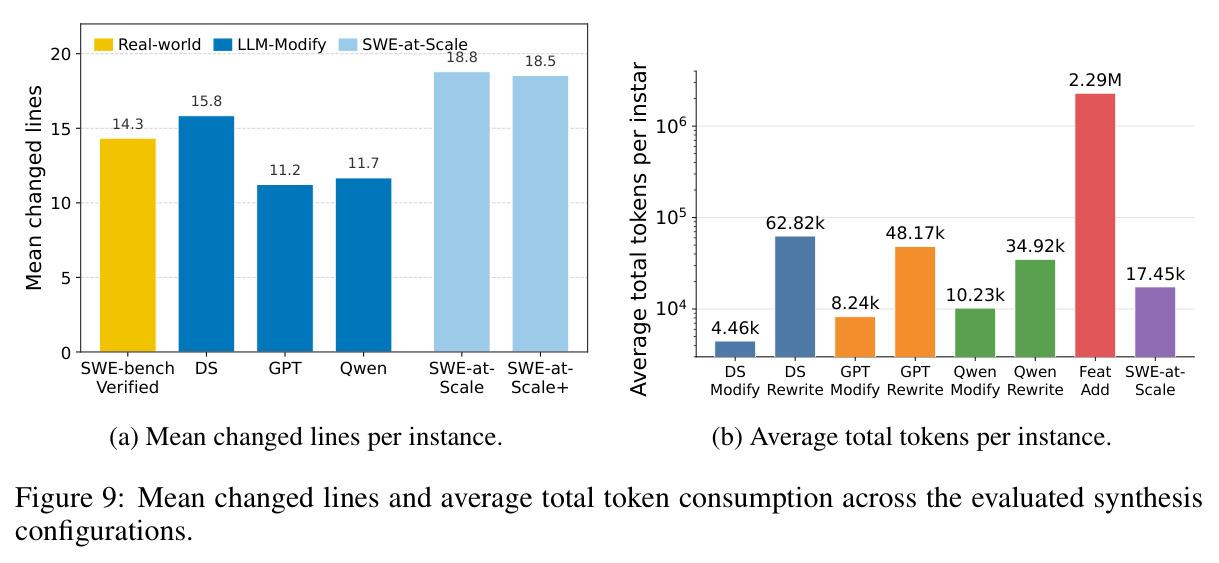
实验在四条线上展开。(1) 真实感与可用性:三位三年以上经验的工程师盲评中,55.9% 和 61.2% 的案例认为 SWE-at-Scale / SWE-at-Scale+ 的 bug 更像真实开发中出现;SWE-at-Scale+ 达到 94.0% 可用率与 61.2% HPR,SWE-at-Scale 为 72.6%/55.9%,均优于最佳基线 LLM-Rewrite 的 72.2%/51.8%;LLM-Modify 真实感偏低,FeatAdd 真实但可用率低。(2) 难度:在 DS-V4-Flash、GPT-5.4-mini、GLM-5.3-Flash、Qwen3.8-Flash 四个解析模型上(mini-SWE-agent、温度 0、250 步上限、模型不相交评估、3 次运行取均值),SWE-at-Scale 的 Pass@1 为 31.68%–48.48%,SWE-at-Scale+ 为 16.81%–37.02%,全面低于合成基线(LLM-Modify 最高 79.85%)和 SWE-bench Verified(69.60%–97.00%),趋势跨模型一致;SWE-at-Scale+ 已接近人工专家设计的 DeepSWE(24.30%–63.40%)。(3) 多样性扩展:固定 2,000 训练样本、仓库数从 5 增至 100,MBTE 持续上升且可用率稳中有升;温度从 0.0 升至 0.6,MBTE 从 0.527 升至峰值 1.173,继续升温则熵(降至 0.714)和可用率(69.0%$\rightarrow$23.4%)双降;固定温度 0.6、预算 $K$ 从 5 增至 200,MBTE 从 0.583 涨到 2.063 bits,可用率稳定约 47%,4,749 个可用候选中 4,192 个(88.27%)去重后仍唯一,而 LLM-Modify 仅 1.22 bits、44.1%、61.74% 唯一。(4) 复杂度与成本:平均改动 18.793 / 18.536 行(SWE-at-Scale / +),大于 Verified 的 14.334 行;单实例 17.45k token,低于 LLM-Rewrite 的 34.92k–62.82k,远低于 FeatAdd 的 2.29M。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 合成任务真实性盲评(与同仓库真实 issue–patch 配对比较,3 人多数投票) | Human Preference Rate (HPR) | SWE-at-Scale+ 61.2%,SWE-at-Scale 55.9% | 最佳合成基线 LLM-Rewrite 51.8%,LLM-Modify 更低 | 相对最佳基线 +9.4 个百分点(SWE-at-Scale+) |
| 合成任务可用性(每目标文件最多 5 次尝试,需通过 P2F 且改动非平凡) | Usability Rate | SWE-at-Scale+ 94.0%,SWE-at-Scale 72.6% | LLM-Rewrite 最高 72.2%,FeatAdd 因特征实现开放性而可用率明显更低 | +21.8 个百分点(SWE-at-Scale+ vs 最佳基线) |
| 下游 issue 解析(4 个解析模型,mini-SWE-agent,3 次运行均值) | Pass@1 (%) | SWE-at-Scale 31.68–48.48,SWE-at-Scale+ 16.81–37.02 | 合成基线最低为 FeatAdd 37.93–62.07;真实任务 SWE-bench Verified 69.60–97.00、DeepSWE 24.30–63.40 | 难度超过全部合成基线并接近人工专家设计的 DeepSWE |
| 单文件重复采样多样性(温度 0.6,预算 K=200,50 个目标文件) | MBTE (bits) / 唯一补丁率 | 2.063 bits / 88.27% 唯一(4,192/4,749) | LLM-Modify(DS-V4-Flash):1.22 bits / 61.74% 唯一 | MBTE 高约 0.84 bits,唯一率高 26.5 个百分点 |
| 合成成本(平均每实例 token 消耗) | Average total tokens per instance | 17.45k | LLM-Modify 4.46k–10.23k;LLM-Rewrite 34.92k–62.82k;FeatAdd 2.29M | 比重写类基线低 2–3.6 倍,比 FeatAdd 低两个数量级以上 |
局限与改进
作者承认两点:一是只研究了 Python 仓库,逆向变换范式能否迁移到语法、语义和开发实践不同的其他语言尚不清楚;二是 P2F 验证依赖测试套件,测试覆盖不足的仓库会丢弃未被覆盖的真实 bug,限制了可构造任务的空间。我自己的观察:HPR 仅由 3 位工程师多数投票判定,评委数量和背景多样性有限;难度评估只用 mini-SWE-agent 一种框架加 4 个模型,且默认把低 Pass@1 当作高质量代理,但『更难』与『issue 描述更歧义/任务不可解』未必可区分,论文未报告对生成任务可解性的人工核验比例;SWE-at-Scale 在最优温度 0.6 下可用率约 47%,意味着近一半合成算力被浪费;issue 描述由 LLM 从 diff 和失败测试反推生成,与真实用户书写的 issue(含模糊复现步骤和情绪表达)仍有分布差距,Figure 1 中 SWE-at-Scale 在 Filesystem、Protocol 等类型上的占比与真实分布也未完全对齐。
独立分析的弱点
独立分析四个弱点。第一,难度与质量混淆:合成任务全部锚定在 SWE-bench Verified 的 12 个仓库上做受控比较,这些仓库代码大概率出现在主流模型预训练中,难度估计可能被记忆污染;且 Pass@1 低也可能来自 issue 描述含糊而非 bug 本身深刻。改进方向:在 held-out 仓库上复核难度,并对任务做人工可解性抽验,把『歧义任务』从『困难任务』中分离。第二,测试覆盖瓶颈:P2F 过滤天然偏向测试基础设施完善的仓库,测试稀疏的生产仓库几乎无法产出任务。改进方向:与自动测试生成结合,先扩大可观察行为面再打 bug 补丁,或用无需 Docker 的程序验证器降低验证成本。第三,可用率损耗:最优温度下约 47% 候选被丢弃、每文件 5 次尝试仍有失败。改进方向:训练廉价 pre-filter 预测补丁是否会导致 P2F,把执行资源集中在高概率候选上。第四,executor 依赖:SWE-at-Scale+ 的质量部分取决于执行 pattern 的模型能力,executor 较弱时显式 pattern 的优势打折,且两段式推理增加成本。改进方向:把 pattern 生成与实现蒸馏进同一模型,或以多样性+可用性为奖励做 RL 微调。
未来方向
作者提出的方向是跨语言扩展:让 bug 诱导模型学习不同编程语言在语法、语义和开发实践上的差异,实现跨语言的可扩展 SWE 任务合成。基于本文成果还可以延伸出几条路:其一,把合成任务从评测集升级为训练集——用 SWE-at-Scale 批量生成带 P2F 保证的训练任务做 agent 强化学习,形成『合成$\rightarrow$训练$\rightarrow$评测』的数据闭环,这是比评测更直接的价值;其二,多样性与可用性联合优化,例如把 MBTE 纳入奖励信号做 DPO/RL,替代手工调温度;其三,与自动测试生成结合突破测试覆盖瓶颈,让弱测试仓库也可产出任务;其四,把教师标注的自然语言 bug pattern 库公开为可复用资产,支持按 bug 类型定向生成课程化训练数据;其五,提升 issue 描述真实感,引入真实 issue 语料做风格对齐,让生成的描述更接近用户书写习惯。
复现评估
复现条件相当友好。代码开源于 GitHub(cslsolow/SWE-at-scale),模型权重发布在 HuggingFace(SWE-at-Scale),提示词在匿名仓库公开。训练数据来自四个公开数据集(合计 134K+ 实例),过滤与分布感知采样规则在论文中有明确定义。附录 Table 2 给出完整 LoRA 配置($r{=}16$、$\alpha{=}32$、dropout 0.05、全部线性层、学习率 $1\times10^{-4}$ cosine、warmup 0.03、1 epoch、有效 batch 8、64K 上下文、bfloat16、梯度检查点),单张 NVIDIA RTX PRO 6000 即可完成 13,407 样本训练,是本领域少见的低成本设置。主要工程难点在环境构建与执行验证:需为数百个仓库搭建可运行测试的基础设施并完成 round-trip 验证与 P2F 过滤,工程量最大;SWE-at-Scale+ 还需 DeepSeek-V4-Flash-0731 教师批量标注 pattern。总体评估:推理侧复现容易(权重可直接下载),完整流水线复现难度中等,需要一定的仓库环境运维经验。
论文图表
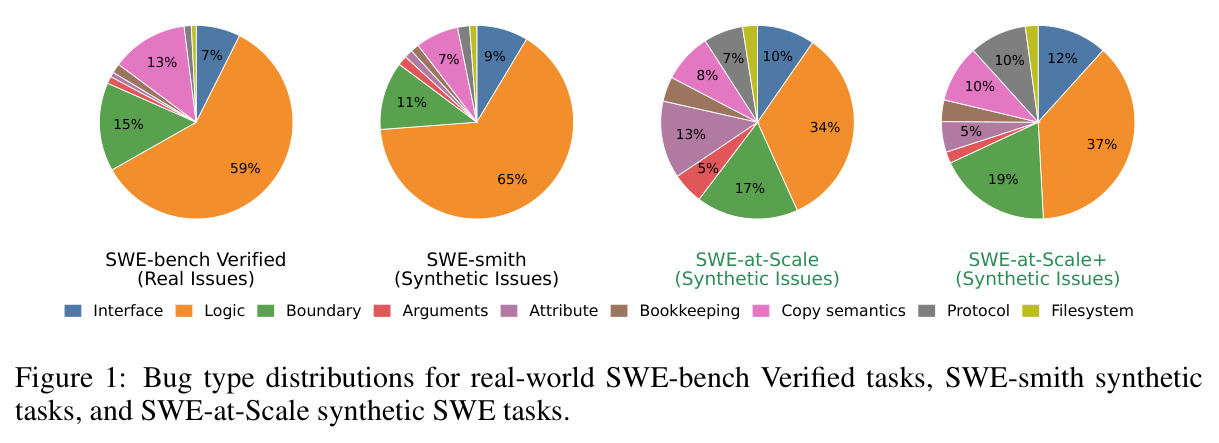
在接口、逻辑、边界、参数、属性、簿记、拷贝语义、协议、文件系统九类 bug 上,对比真实任务(SWE-bench Verified)、SWE-smith 合成任务与 SWE-at-Scale / SWE-at-Scale+ 合成任务的类型分布。SWE-smith 的分布明显集中于少数类型,而 SWE-at-Scale 系列覆盖更广、更均衡,整体形状更接近真实任务的分布。
一图点明研究动机:现有合成方法的 bug 类型偏斜是『依赖通用 LLM 先验』的直接后果,而从真实修复学习能矫正这一分布。理解这张图就理解了论文要解决的问题。