CoSTA:面向高效语音对话模型的压缩语音 Token 适配 CoSTA: Compressed Speech Token Adaptation for Efficient Spoken Dialogue Models
用 BPE 无损压缩语音 token 并后训练适配 SDM,解码器不变实现约 1.7 倍生成加速
前置知识
语音对话模型(SDM)与交错生成
SDM 端到端地完成语音输入理解与语音回复生成。典型做法(如 Step-Audio 2 mini)把用户语音编码为离散 token,与文本 token 交错后由一个 LLM 自回归建模:目标序列 $y$ 同时含文本和语音 token,训练目标是最大化 $\sum_t \log P(y_t \mid y_{<t})$;生成的语音 token 再交给语音解码器合成波形。
本文的适配对象正是这类模型,只有理解其交错生成与语音 token 解码流程,才能明白 CoSTA 为何只需扩展词表并微调 LLM 参数即可提速。
离散语音 token 与 tokenizer 帧率
语音 tokenizer 把连续波形离散化为 token 序列,分声学型(codec,如 Mimi、EnCodec)与语义型(如 S3Tokenizer、GLM-4-Voice tokenizer、HuBERT KM)。帧率指每秒语音产生的 token 数:S3Tokenizer V2 为 25Hz、GLM-4-Voice tokenizer 为 12.5Hz、mHuBERT KM1000 为 50Hz。帧率越低序列越短,但激进降率会损伤音质。
自回归解码步数正比于帧率与时长之积,帧率是本文效率问题的根源;CoSTA 不改帧率与解码器,而是用无损压缩缩短生成序列。
BPE(字节对编码)
BPE 从基础词表出发,迭代合并语料中最高频的相邻符号对,构造扩展词表 $Z \supseteq S$ 与编码器 $B$,把原序列压成 $z=B(s)$。关键性质是确定性无损:每个合并单元的展开 $\pi(z)=(s_1,\dots,s_k)$ 已知且满足 $\pi(z)=s$,压缩率定义为 $\rho=|z|/|\pi(z)|$。
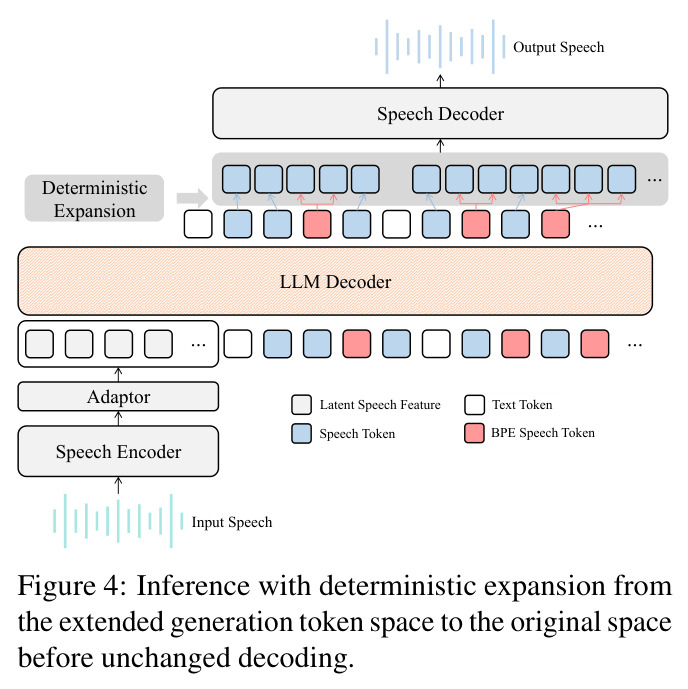
CoSTA 的全部机制建立在 BPE 的确定性与无损性上:模型生成 BPE 单元,推理时展开回原 token,语音解码器无需任何改动。
词表扩展与输出层绑定
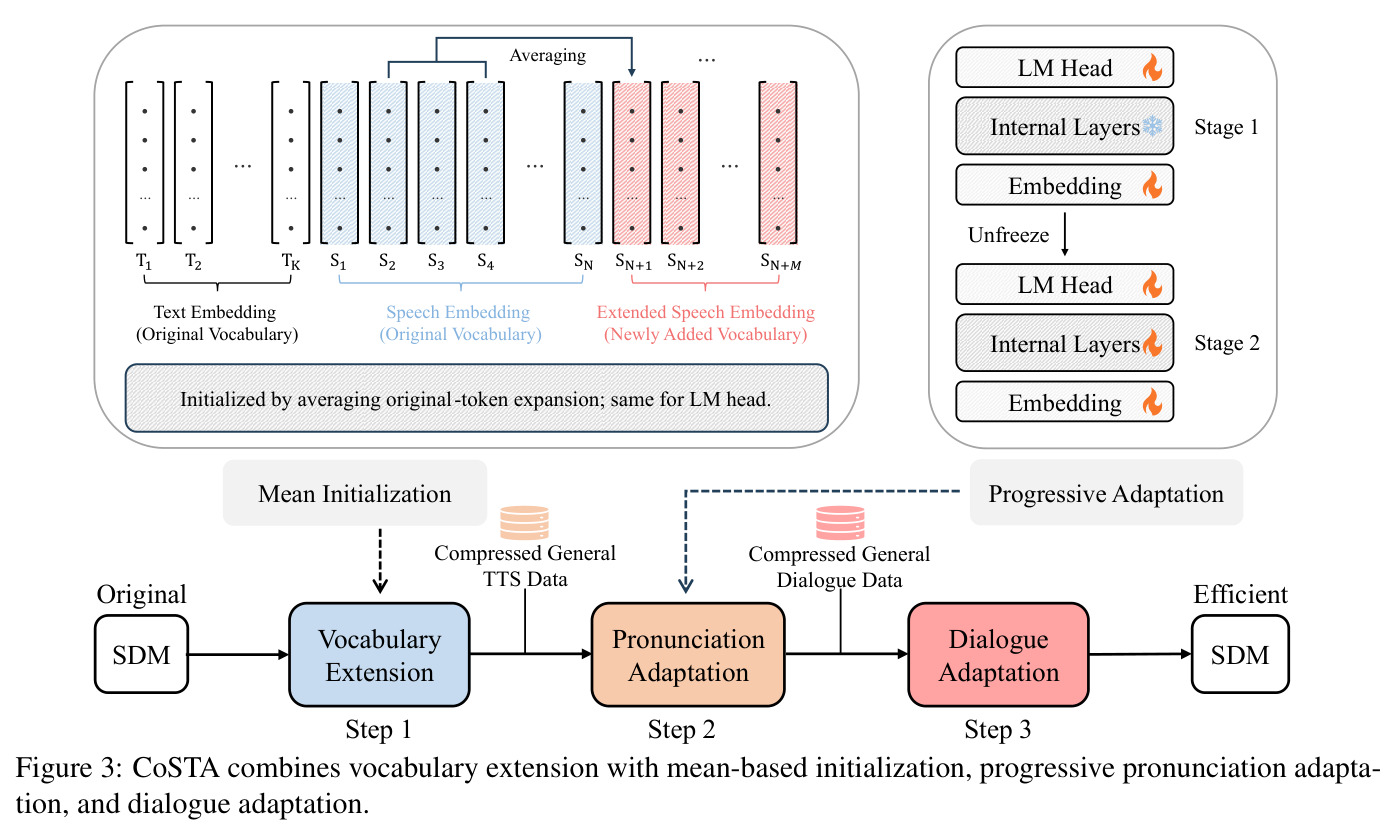
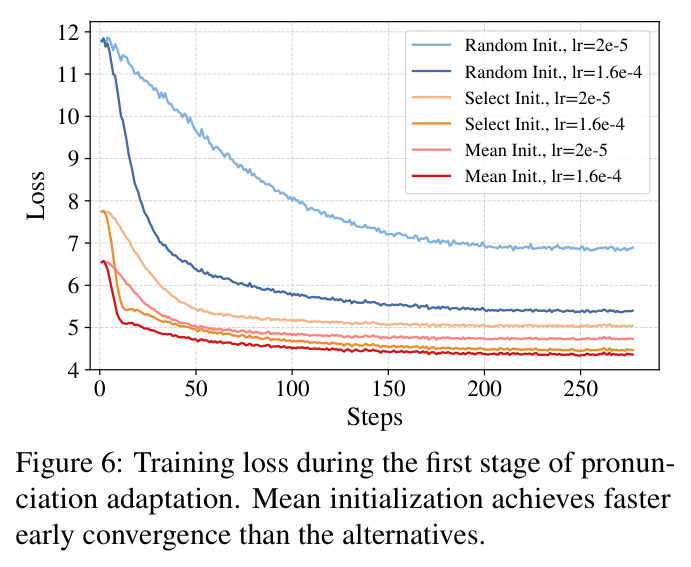
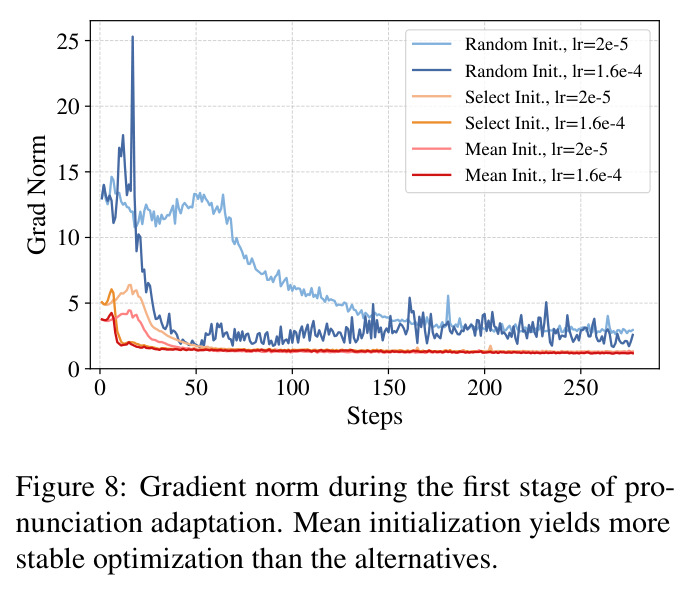
给 LLM 加新 token 需同时扩展输入 embedding 矩阵 $E$ 与输出 LM head 矩阵 $W$。新增行若随机初始化,早期输出分布混乱、收敛慢且可能不稳定;CoSTA 用分量平均初始化 $E'_z=\frac{1}{k}\sum_i E_{s_i}$、$W'_z=\frac{1}{k}\sum_i W_{s_i}$,让新词元直接继承其展开分量的统计特性。
CoSTA 第一步就是向 8B 模型加入 80K 个 BPE 单元(约占原参数 6%),初始化与训练策略直接决定适配能否成功收敛。
自回归推理开销与效率指标
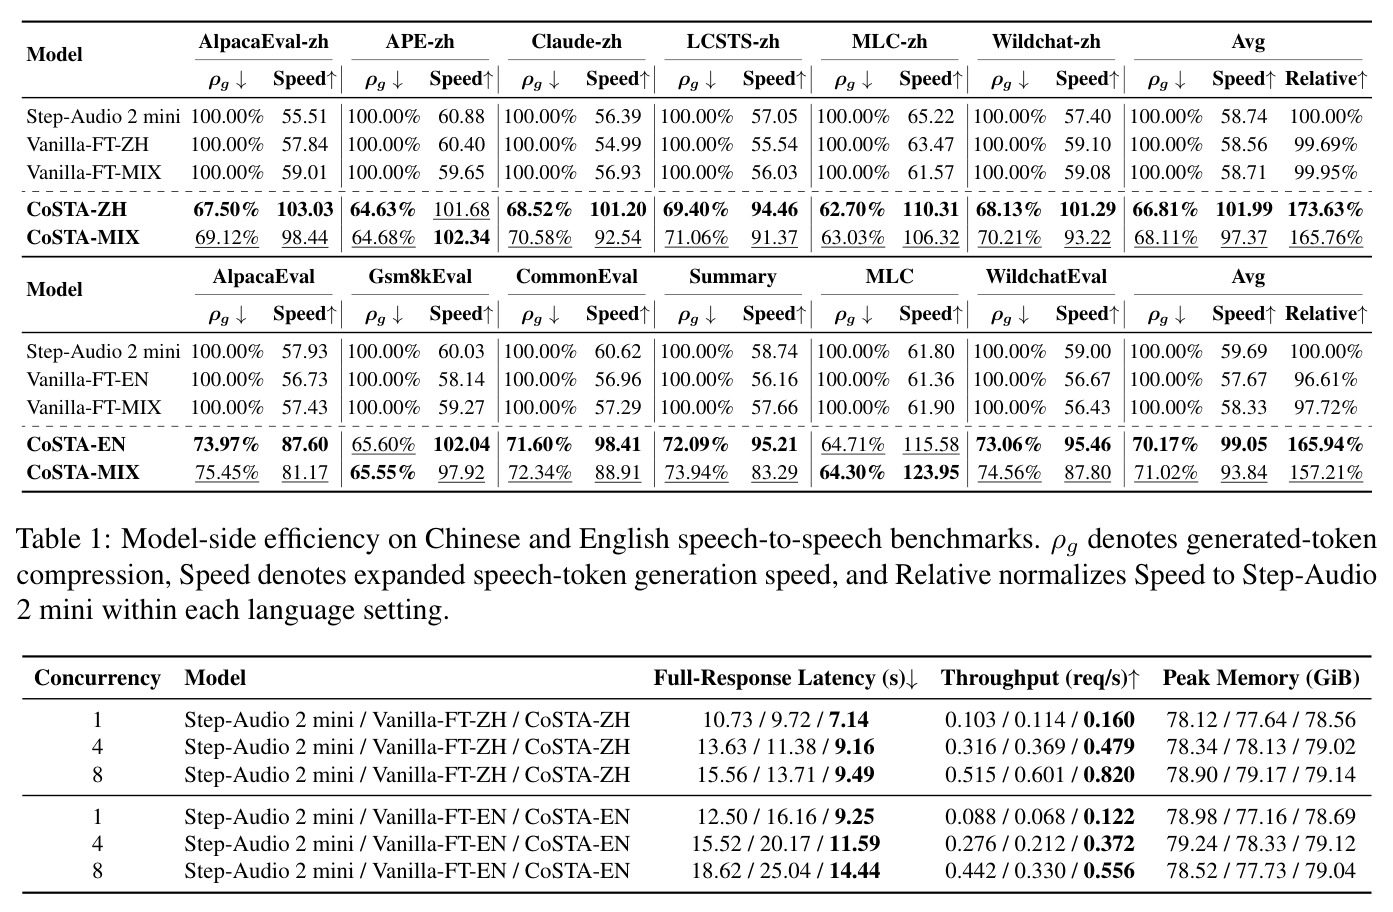
自回归生成的解码时间近似正比于生成 token 数,语音 token 序列长意味着步数多、延迟高。系统侧常用全响应延迟、吞吐(req/s)、峰值显存衡量;模型侧本文用生成压缩率 $\rho_g=|\tilde{z}|/|\pi(\tilde{z})|$ 与展开后语音 token 生成速度 $\mathrm{Speed}=|\pi(\tilde{z})|/T_{\mathrm{decode}}$($T_{\mathrm{decode}}$ 为 LLM 解码时间)。
论文所有效率结论都用这些指标表述(如 1.736× 速度、延迟降 32.8–39.0%),不熟悉这些定义就读不懂实验表格。
研究动机
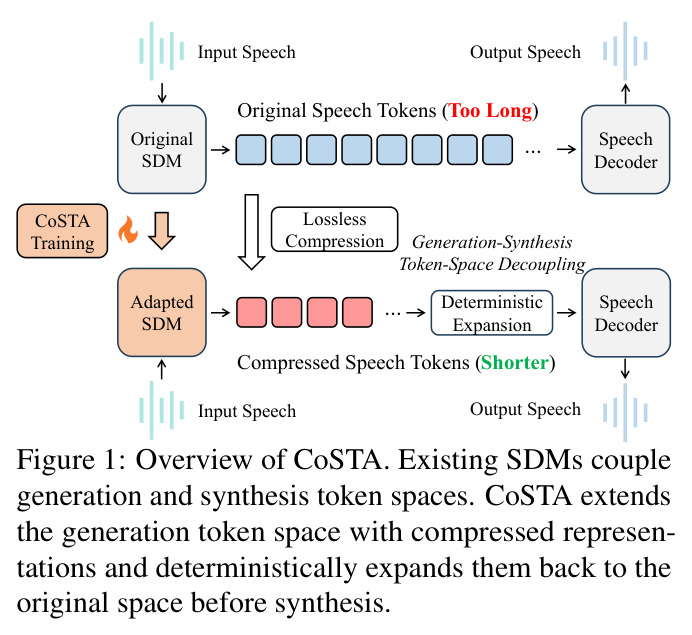
现有语音对话模型(SDM)如 Step-Audio 2 mini、GLM-4-Voice、Kimi-Audio 通常让自回归生成与语音合成共用同一套语音 token 空间:模型逐个预测离散语音 token,再交给语音解码器还原波形。以本文使用的 Step-Audio 2 mini 为例,其 S3Tokenizer V2 帧率为 25Hz,一段回复动辄数千 token(压力测试中平均 2208–2440 个),自回归步数多导致解码成本高、响应变慢、生成预算消耗快,也使文本-语音对齐与长上下文语音建模更困难。主流改进是设计更低帧率的语音 tokenizer(如 12.5Hz 的 GLM-4-Voice tokenizer、Mimi 等),但激进降率会引入压缩-质量权衡,且替换 tokenizer 需要重新训练或适配 tokenizer、配对的语音解码器和 SDM 三者,代价高昂;更根本的是,这条路线依然把生成与合成耦合在同一表示上,没有回答「能否既保留原 tokenizer 与解码器、又缩短生成序列」的问题。
本文的目标是本文的目标是:在不改动原有语音 tokenizer 与语音解码器的前提下,让现有大规模 SDM 以更紧凑的表示进行自回归生成,从而减少解码步数、降低全响应延迟、提高吞吐,同时保持响应质量。具体而言,作者要构建一个兼容性保持的 post-hoc token 空间适配框架:向 SDM 词表扩展可无损还原的 BPE 压缩单元,教会模型可靠地生成这些短表示,并在推理时用确定性展开映射 $\pi(z)=s$ 把生成序列还原回原语音 token 空间、再送入原解码器合成波形。量化目标包括:在中英双语基准上取得约 1.7 倍的展开语音 token 生成加速,更低的端到端延迟与更高吞吐,且 G-Eval、UTMOS、ASR-CER/WER 等质量指标不降反稳,并验证方法可跨 SDM 架构迁移。
与已有工作不同的是,本文的独特切入点是「生成-合成 token 空间解耦」。以往路线要么原生训练低帧率 tokenizer(需三方联合重训且仍耦合两空间),要么在 ASR/TTS 等小模型上原生训练 BPE 或声学片段单元,均未针对现有大规模 SDM 做后训练适配。作者先从实证切入:在中文对话语音上,对 GLM-4-Voice、S3Tokenizer V1/V2/V3、Qwen3-TTS、Mimi、mHuBERT 等 8 种 tokenizer 配置,把新增 BPE 词表从 10K 按二的幂扫描到 320K,发现压缩率 $\rho$ 随 $\log_2$ 词表大小近似 log-线性下降:$\rho_c(M) \approx a_c - b_c\log_2(M/10\mathrm{K})$,八种配置拟合 $R^2 \ge 0.98$,跨数据源与语言 $R^2 \ge 0.994$,说明语音 token 的可压缩性持久且可预测。由此作者把问题重述为:与其替换 tokenizer,不如保留合成接口、只让生成侧说「更省 token 的语言」,把三方重训的大工程转化为扩词表加微调的轻量后处理。
核心方法
直觉上,语音 token 序列充满局部重复模式,天然适合 BPE 无损压缩;让 SDM 直接生成压缩后的短序列,推理时把每个 BPE 单元确定性展开回原 token 序列,解码器与合成管线完全不动。技术路线分四步:第一步,在对话语音 token 序列上学习 BPE 词表,向原词表 $V$ 扩展得到 $V'=V\cup(Z\setminus S)$,主实验新增 80K 单元,仅增加 embedding 与 LM head 行,约占原 8B 模型参数的 6%;第二步,均值初始化:若 $\pi(z)=(s_1,\dots,s_k)$,则 $E'_z=\frac{1}{k}\sum_i E_{s_i}$、$W'_z=\frac{1}{k}\sum_i W_{s_i}$,比随机初始化收敛更快更稳;第三步,在压缩 TTS 数据上做两阶段渐进发音适配:前 50% 数据只训 embedding 与 LM head,后 50% 解冻中间层;第四步,在压缩语音-语音对话数据上做对话适配,只更新 LLM 参数。推理时对生成的语音 token 流施加 $\pi$ 后送入原解码器,在 8B Step-Audio 2 mini 上取得约 1.7× 生成加速。
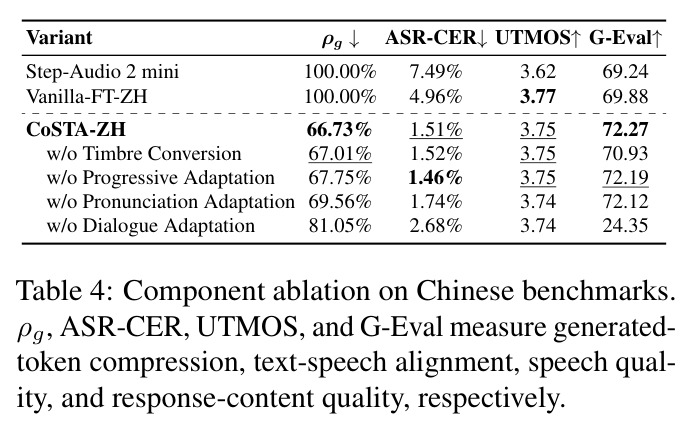
核心创新是「生成-合成 token 空间解耦」:与低帧率 tokenizer 改变合成端表示不同,CoSTA 的压缩只发生在自回归生成侧,压缩序列经确定性映射 $\pi(z)=s$ 无损还原,合成接口逐 token 不变,因此是兼容性保持的 post-hoc 适配,可即插即用于不同 SDM 架构——论文同时验证了交错生成的 Step-Audio 2 mini 与 Think-Talk 架构的 OpenS2S。第二个要点是把 BPE 压缩率随词表规模的经验 log-线性规律 $\rho_c(M) \approx a_c - b_c\log_2(M/10\mathrm{K})$ 作为方法依据,使「压缩多少」成为可预测的工程旋钮,并据此定出 80K 词表这一效率-质量平衡点。第三个要点是均值初始化加渐进适配:新增词元的 embedding 与 LM head 行同时继承展开分量,使模型少量训练后即可可靠使用压缩单元;消融显示去掉发音适配后 $\rho_g$ 从 66.73% 恶化到 69.56%,去掉对话适配则 G-Eval 从 72.27 崩至 24.35,各组件缺一不可。
方法步骤详情
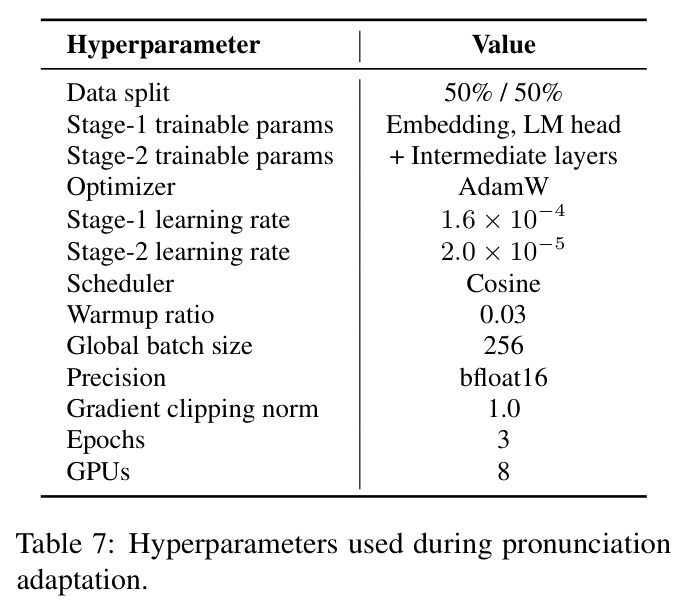
步骤一,词表学习与扩展:在训练集对话语音 token 序列上学习 BPE,新增单元数 $M=|Z\setminus S|$,主实验取 80K(扫描 10K–320K);扩展词表 $V'=V\cup(Z\setminus S)$,每个 BPE 单元的展开 $\pi(z)=(s_1,\dots,s_k)$ 由构建过程直接给出。步骤二,均值初始化:$E'_z=\frac{1}{k}\sum_i E_{s_i}$、$W'_z=\frac{1}{k}\sum_i W_{s_i}$,原词表参数不变。步骤三,发音适配:用 Emilia 中英文各 300 小时语音(Seed-VC 统一音色)构造压缩 TTS 数据,只压缩语音 token、文本不动,最小化 $\mathcal{L}_{tts}(\theta)=-\sum_t\log P(e^y_t \mid p, e^y_{<t})$;渐进两阶段:前 50% 数据只训 embedding 与 LM head,后 50% 解冻中间层。步骤四,对话适配:按 OpenS2S 方式构建每语言约 5 万条语音对话样本(CosyVoice 2 合成助手语音),最小化 $\mathcal{L}_{dlg}(\theta)=-\sum_t\log P(e^r_t \mid q, e^r_{<t})$,只更新 LLM 参数,编码器、adaptor 与解码器冻结。步骤五,推理:对生成的语音 token 流施加 $\pi$——原 token 保留、BPE 单元展开为原序列——再送入不变的原解码器合成波形。
技术新颖性
技术新颖性体现在三点。其一,问题层面的重构:把「语音 token 太长」从表示学习问题(换 tokenizer)转化为 token 空间适配问题,提出生成-合成解耦范式,避免了 tokenizer-解码器-SDM 三方联合重训,这是与 Défossez et al.、Zeng et al. 等低帧率路线的本质区别。其二,实证层面的发现:首次系统刻画语音 token BPE 压缩的 log-线性缩放规律($R^2 \ge 0.98$,跨 8 种 tokenizer、多种数据与语言),为压缩单元数量选择提供了可预测的定量依据,此前 ASR/TTS 中的 BPE 工作(Ren et al. 2022、Zhu et al. 2023 等)均为原生小模型训练,没有此类缩放分析。其三,工程层面的设计:均值初始化使新增词元天然「语义兼容」原表示,配合两阶段渐进训练,让 80K 新词元在仅约 6% 参数增量的情况下被可靠使用;同时推理期只需插入轻量确定性展开,与 vLLM 流式推理兼容,显存仅多 0.68 GiB 以内。
实验结果
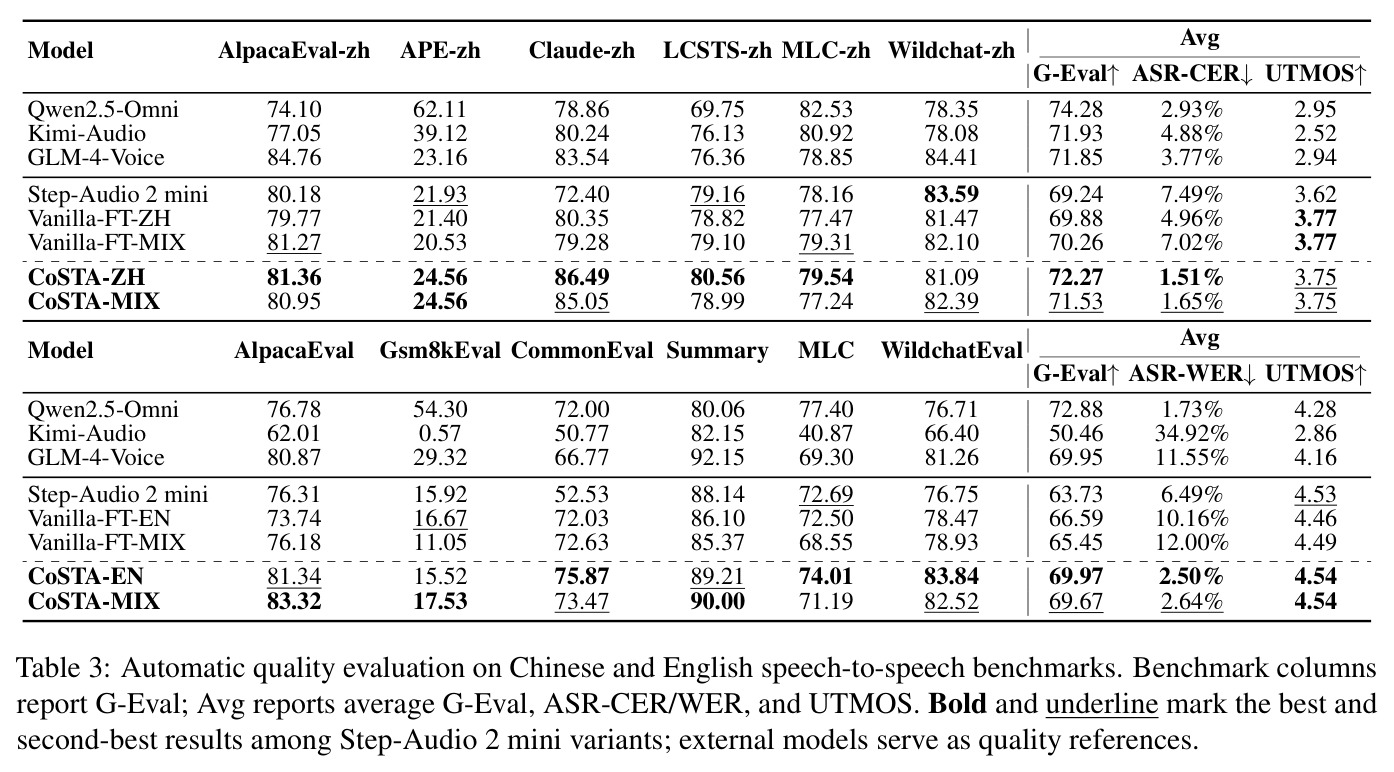
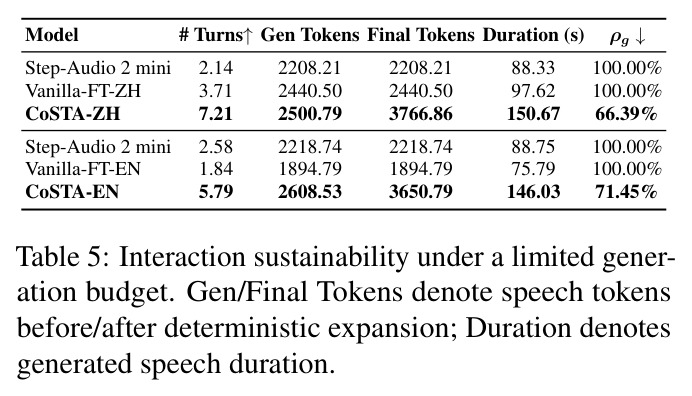
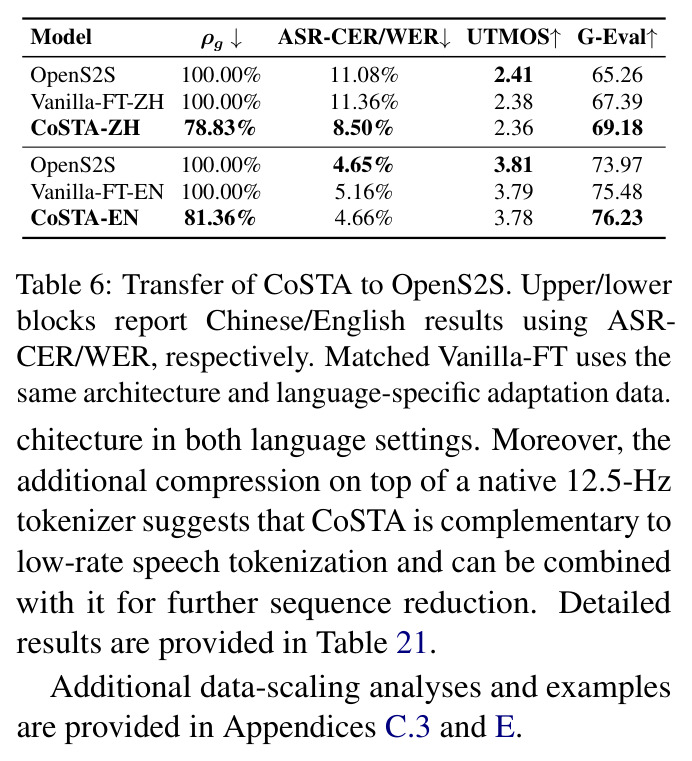
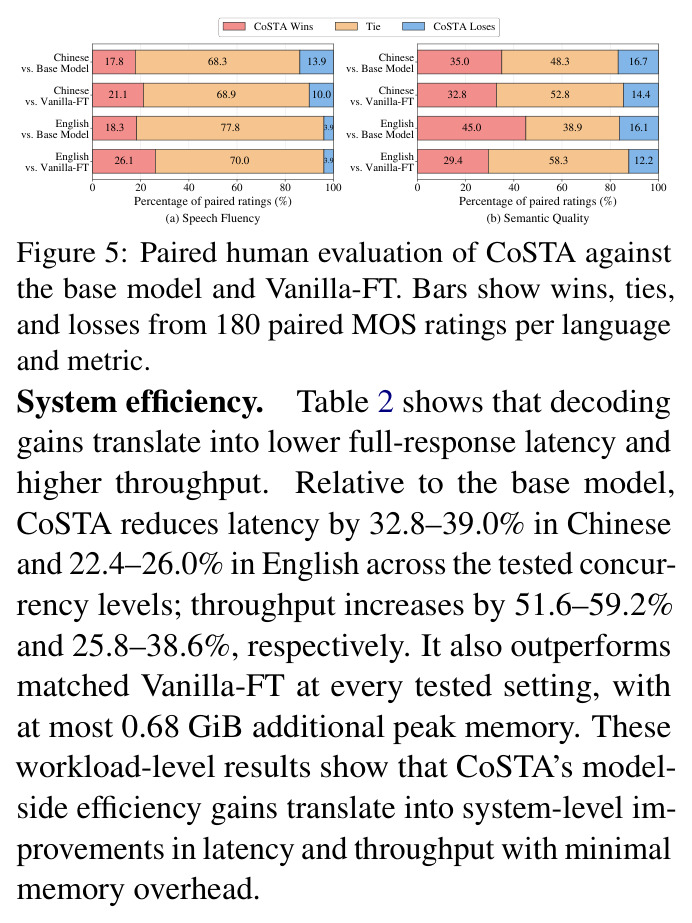
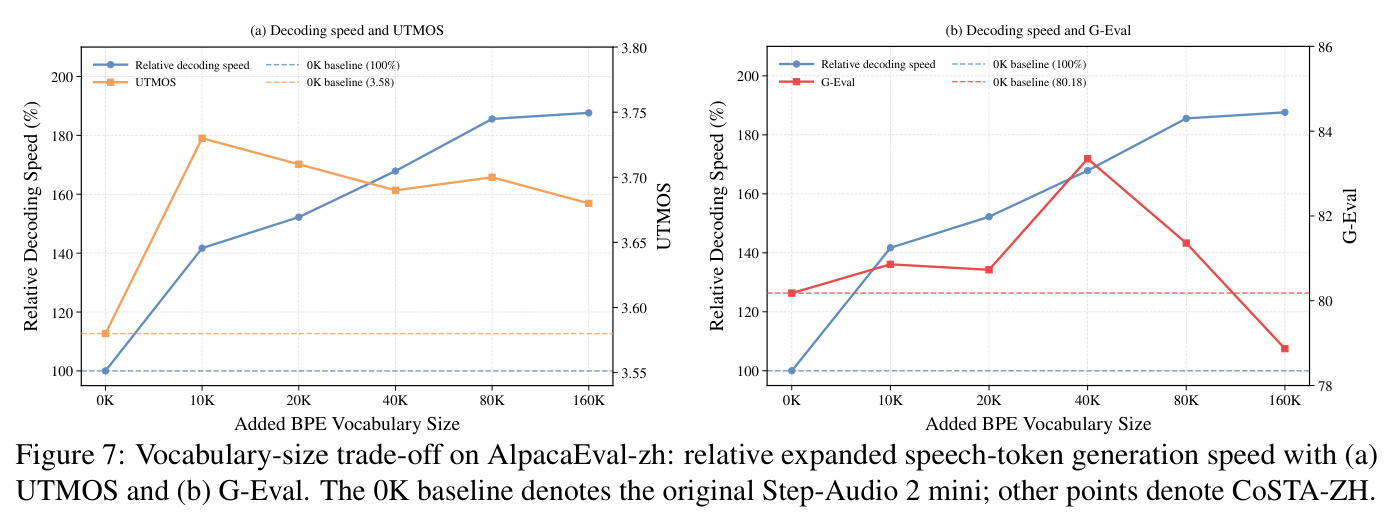
模型侧(表 1):URO-Bench 12 个数据集、vLLM 流式推理下,CoSTA-ZH 平均压缩率 $\rho_g=66.81\%$、相对速度 1.736×,CoSTA-EN $\rho_g=70.17\%$、1.659×;Vanilla-FT 保持 $\rho_g=100\%$ 且速度不变,说明收益来自压缩建模而非微调。系统级(表 2):单张 A100 80GB、并发 1/4/8 下,中文全响应延迟降 32.8–39.0%(并发 8:15.56s→9.49s)、吞吐升 51.6–59.2%;英文延迟降 22.4–26.0%、吞吐升 25.8–38.6%,峰值显存至多多 0.68 GiB。质量(表 3):中文 G-Eval 72.27 高于 Vanilla-FT 的 69.88,ASR-CER 从 4.96% 降至 1.51%,UTMOS 持平 3.75;英文 G-Eval 69.97 vs 66.59、WER 10.16%→2.50%。人工评测(图 5,6 名评估者、每语言每指标 180 对、共 1080 条 MOS):语音流畅性 win-tie 86.1–96.1%、语义质量 83.3–87.7%。消融(表 4):去掉对话适配 G-Eval 崩至 24.35、$\rho_g$ 恶化到 81.05%;去掉发音适配 $\rho_g$ 恶化到 69.56%。有限预算(表 5):CoSTA-ZH 维持 7.21 轮有效对话、150.67 秒语音($\rho_g$=66.39%),基模型 3.71 轮/97.62 秒、Vanilla-FT 2.14 轮/88.33 秒。词表权衡(图 7):80K→160K 时 $\rho_g$ 从 67.50% 降至 63.62% 但速度仅多 1.1%,G-Eval 从 81.36 降至 78.87。跨架构迁移(表 6):OpenS2S(12.5Hz GLM-4-Voice tokenizer)上语音 token 步数中英文分别减少 21.17% 与 18.64%,G-Eval 优于匹配 Vanilla-FT。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 中文语音对话(URO-Bench 六个中文集) | 生成 token 压缩率 ρg | CoSTA-ZH 66.81% | Step-Audio 2 mini 100% | 自回归语音 token 步数减少约 33% |
| 中文展开后语音 token 生成速度 | Speed(tokens/s) | 101.99(六集平均) | Step-Audio 2 mini 58.74 | 相对速度 1.736× |
| 英文展开后语音 token 生成速度 | Speed(tokens/s) | 99.05(六集平均) | Step-Audio 2 mini 59.69 | 相对速度 1.659× |
| 系统级全响应延迟(AlpacaEval-zh,并发 1/4/8) | 延迟(秒) | 并发 8 时 9.49s(并发 1 时 7.14s) | Step-Audio 2 mini 15.56s(并发 8) | 降低 32.8–39.0% |
| 系统级吞吐(AlpacaEval-zh,并发 8) | 吞吐(req/s) | 0.820 | Step-Audio 2 mini 0.515 | 提升 51.6–59.2%(并发 1–8) |
| 中文文本-语音对齐 | ASR-CER | CoSTA-ZH 1.51% | Vanilla-FT-ZH 4.96% | 下降约 3.45 个百分点 |
| 中文回复内容质量 | G-Eval | CoSTA-ZH 72.27 | Vanilla-FT-ZH 69.88 | +2.39 |
| 语音自然度(中文) | UTMOS | 3.75 | Vanilla-FT-ZH 3.77 | 基本持平(−0.02) |
| 人工成对评测(中文/英文) | win-tie 率 | 语音流畅性 86.1–96.1%,语义质量 83.3–87.7% | 与基模型及 Vanilla-FT 成对比较(每语言每指标 180 对) | 胜率显著高于败率 |
| 跨架构迁移(OpenS2S,原生 12.5Hz tokenizer) | 语音 token 步数缩减 / ρg | 中文 −21.17%(ρg 78.83%),英文 −18.64%(ρg 81.36%) | OpenS2S 100% | 在低帧率 tokenizer 上进一步压缩且质量提升 |
局限与改进
作者承认的局限:其一,对话适配数据由合成语音-语音样本构成(OpenS2S 式流程、CosyVoice 2 固定音色合成),虽可控且被业界广泛使用,但与真实对话语音(迟疑、打断、副语言现象)的差距未充分探索;其二,BPE 是为确定性、无损、易集成而选,其他无损语音 token 切分策略未比较;其三,评测聚焦通用语音对话与效率,未覆盖情感对话、个性化说话风格、多样声学环境等细粒度场景。我自己的观察:压缩率上限由 BPE 决定,$\rho_g$ 约 66–70%,远低于原生低帧率方案可达到的压缩度,且 160K 以上词表收益递减并开始伤质量,说明该路线存在天花板;扩展词表使 LM head 输出层明显变大(附录 C.10 分析了输出层开销),对参数量小的模型可能不划算;训练需 TTS 统一音色加合成对话数据,全流程仍需 8B 模型级微调算力;UTMOS 只是持平而非提升,且一个 BPE 单元生成错误会在展开后连续错 $k$ 个 token,长对话中的错误累积行为值得警惕。
独立分析的弱点
弱点一:错误敏感性被放大。自回归生成中一个压缩单元选错,展开后会连续错 $k$ 个语音 token,错误粒度放大可能使模型比原版更脆弱;附录 C.8 分析了失败案例但未给出对策。改进方向:单元级置信度阈值、受限解码或对高频易错单元施加正则。弱点二:对话数据全靠合成(CosyVoice 2 固定音色),缺少真实交互的韵律变化与话轮转换,可能限制风格与情感泛化。改进方向:混入真实语音-语音对话数据做半监督训练。弱点三:压缩-质量权衡只有词表规模一个旋钮(80K 是经验平衡点),缺乏自适应机制,而不同语速、语言、领域的可压缩性差异大。改进方向:按语种或领域学习不同 BPE 词表,或动态混合多档压缩率。弱点四:架构覆盖有限,只验证了交错生成(Step-Audio 2 mini)与 Think-Talk(OpenS2S)两类,与并行生成架构(多输出头)的兼容性未知。弱点五:ASR-CER 从 4.96% 降到 1.51% 可能部分来自合成 TTS 数据发音更干净;Vanilla-FT 虽控制了数据规模,但训练文本内容不完全相同,对照并非严格同分布。
未来方向
作者提出的方向:(1)探索合成与真实语音-语音对话数据如何互补;(2)研究其他无损语音 token 切分策略并与 BPE 比较行为差异;(3)把分析扩展到情感对话、个性化说话风格、多样声学环境等更细粒度场景。基于本文成果可延伸的:其一,利用 log-线性缩放规律 $\rho_c(M) \approx a_c - b_c\log_2(M/10\mathrm{K})$,在给定延迟预算下反推最优词表规模,做成自动配置工具;其二,与低帧率 tokenizer 叠加(论文已证明互补,OpenS2S 上再减 21.17%/18.64%),可继续向 6.25Hz 级 tokenizer 推进实现双重序列缩短;其三,把确定性展开机制移植到流式 TTS、同声传译、副语言理解等任务;其四,研究带错误恢复能力的「软展开」(如展开时做局部模糊匹配或重打分),缓解错误放大问题;其五,与量化、投机解码、KV 缓存优化等系统级加速手段正交组合,进一步压低全响应延迟;其六,探索 Lempel-Ziv 类语法压缩或多粒度混合词表,突破 BPE 的压缩率天花板。
复现评估
复现条件较好。代码声明开源于 https://github.com/yingzhuodeng/CoSTA;方法全部由公开组件构成:BPE(可用 HuggingFace tokenizers 训练)、Step-Audio 2 mini 8B(开源)、OpenS2S(开源)、Emilia 数据集(开源)、CosyVoice 2 与 Seed-VC(开源)、URO-Bench(公开)。数据构建流程具体:每语言 300 小时 TTS 数据用 Seed-VC 统一音色、约 5 万条合成对话样本、新增 80K 词表、两阶段渐进训练(50%/50% 数据切分)。算力:仅解冻约 6% 参数再加部分中间层,单张 A100 80GB 即可完成训练与系统评测(表 2 即基于单卡 vLLM)。难度中等偏上:主要工程量在语音 token 序列抽取对齐、BPE 展开与解码器接口的流式衔接、URO-Bench 评测管线搭建;自动指标(G-Eval、ASR-CER/WER、UTMOS)可复现,但 6 人 1080 条的人工 MOS 评测个人难以完整复制。风险点:学习率(2e-5/1.6e-4)等超参在附录,需仔细核对。
论文图表
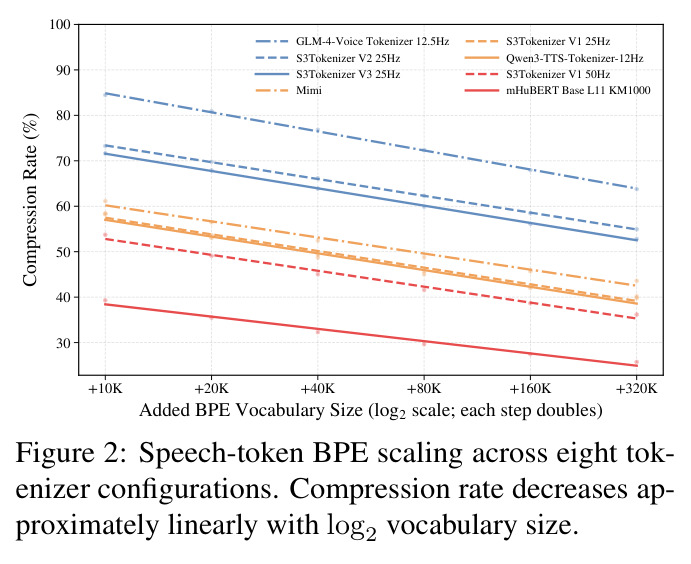
在 8 种语音 tokenizer 配置(GLM-4-Voice 12.5Hz、S3Tokenizer V1/V2/V3 25Hz、Qwen3-TTS 12Hz、Mimi、mHuBERT Base L11 KM1000 50Hz)上,把新增 BPE 词表从 10K 到 320K 按二的幂扫描,绘制压缩率曲线;压缩率随 log2 词表规模近似线性下降,log-线性拟合 $R^2 \ge 0.98$。
这是全文的实证基石:语音 token 的可压缩性持久且可预测,直接催生生成-合成解耦的思路,并指导后续词表规模的选择与权衡分析。