跳过压缩器:编码代理自选完整文件时能修复更多问题 Skip the Compressor: Coding Agents Fix More Issues When They Pick Whole Files
同等token预算下,让模型自选完整原文件比token压缩或检索更能修复真实issue
前置知识
编码代理
以 LLM 为核心的自主编程系统:输入一条软件 issue,代理在仓库中定位相关代码、阅读文件、生成补丁,再由项目测试验证修复是否成立。典型代表有 SWE-agent、OpenHands、Aider 等,其每一步操作都必须把代码文本放进提示词。
本文研究的正是编码代理每次调用时'该往上下文里放什么'这一核心问题,所有方法与结论都围绕此场景展开。
SWE-bench 与 SWE-rebench
SWE-bench 用真实 GitHub issue 与其合并补丁构造基准:模型读 issue 和仓库快照后产出补丁,以 FAIL_TO_PASS/PASS_TO_PASS 测试是否全部通过判定'解决'。SWE-rebench 用自动化流水线持续收集新 issue(本文用 860 个 Python 任务、413 个仓库),避免老基准的记忆污染。
本文全部 300 个评测 issue 与官方评分 harness 都来自 SWE-rebench,其'较新、少污染'的特性是结论可信度的关键。
提示压缩
用一个较小的评分模型给输入中的 token、句子或代码块打分,删掉被认为最无信息量的部分以适应 token 预算。代表工作:LLMLingua-2(token 级分类器)、LongLLMLingua(问题感知的粗到细剪枝)、LongCodeZip(先函数级后块级、按困惑度选择)。
它是本文基线家族之一;论文的核心发现之一就是压缩会改动代码原文,导致补丁无法 apply,这是与传统 NLP 场景本质不同的代价。
代码检索
把仓库切成块(顶层定义、60 行窗口、函数或整个文件),按与 issue 的相似度排名后依次装填上下文:BM25 做词面匹配,CodeRankEmbed 做稠密向量检索,SweRank 则是在 issue-补丁对上训练的'检索+重排'函数级定位器。
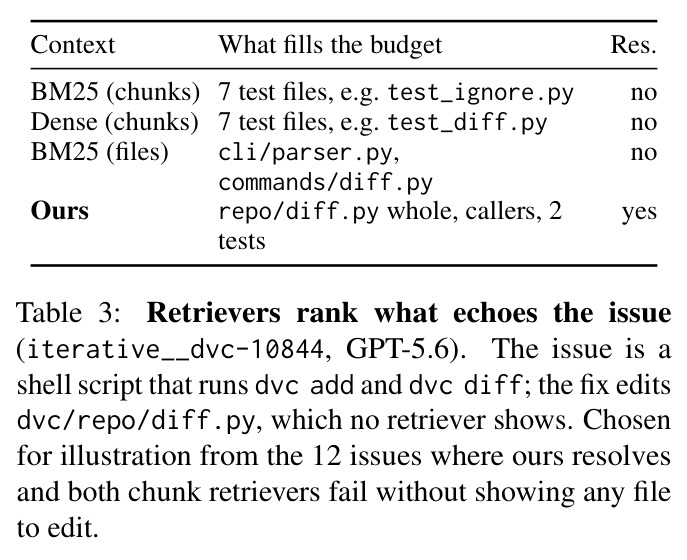
它是另一条基线家族;论文发现检索常把与 issue 措辞相似但无需修改的内容(issue 模板、测试)排进预算,漏掉真正要改的文件。
金标文件召回率 $\rho$ 与逐字率 $\epsilon$
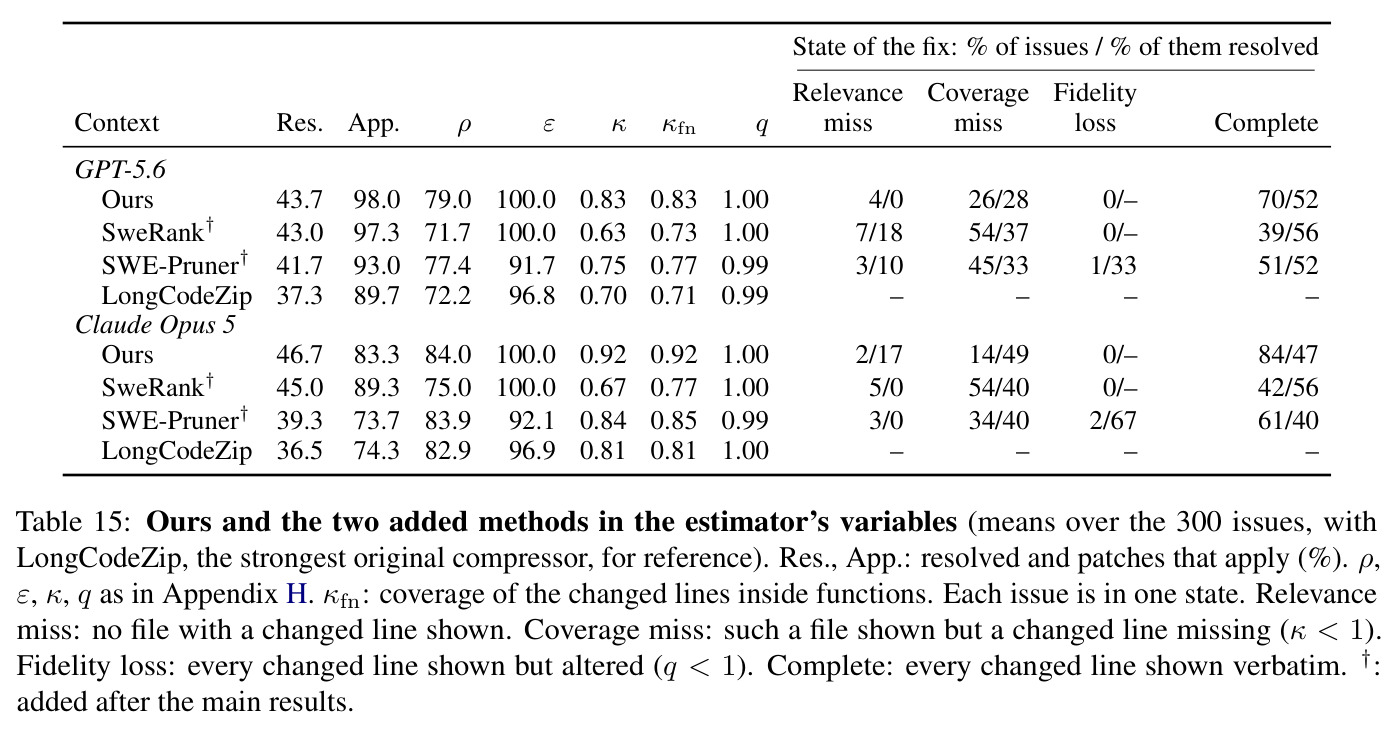
刻画一个上下文'装了什么'的两个离线指标:$\rho(m)=\frac{|F^\star \cap \{f_1,\dots,f_K\}|}{|F^\star|}$ 衡量金标补丁要改的文件有多少出现在上下文中;$\epsilon(m)=\frac{|\{\ell \in m : \ell \in f(\ell)\}|}{|\{\ell \in m\}|}$ 衡量上下文中有多少行与原文件逐字一致(至多差尾部空白)。
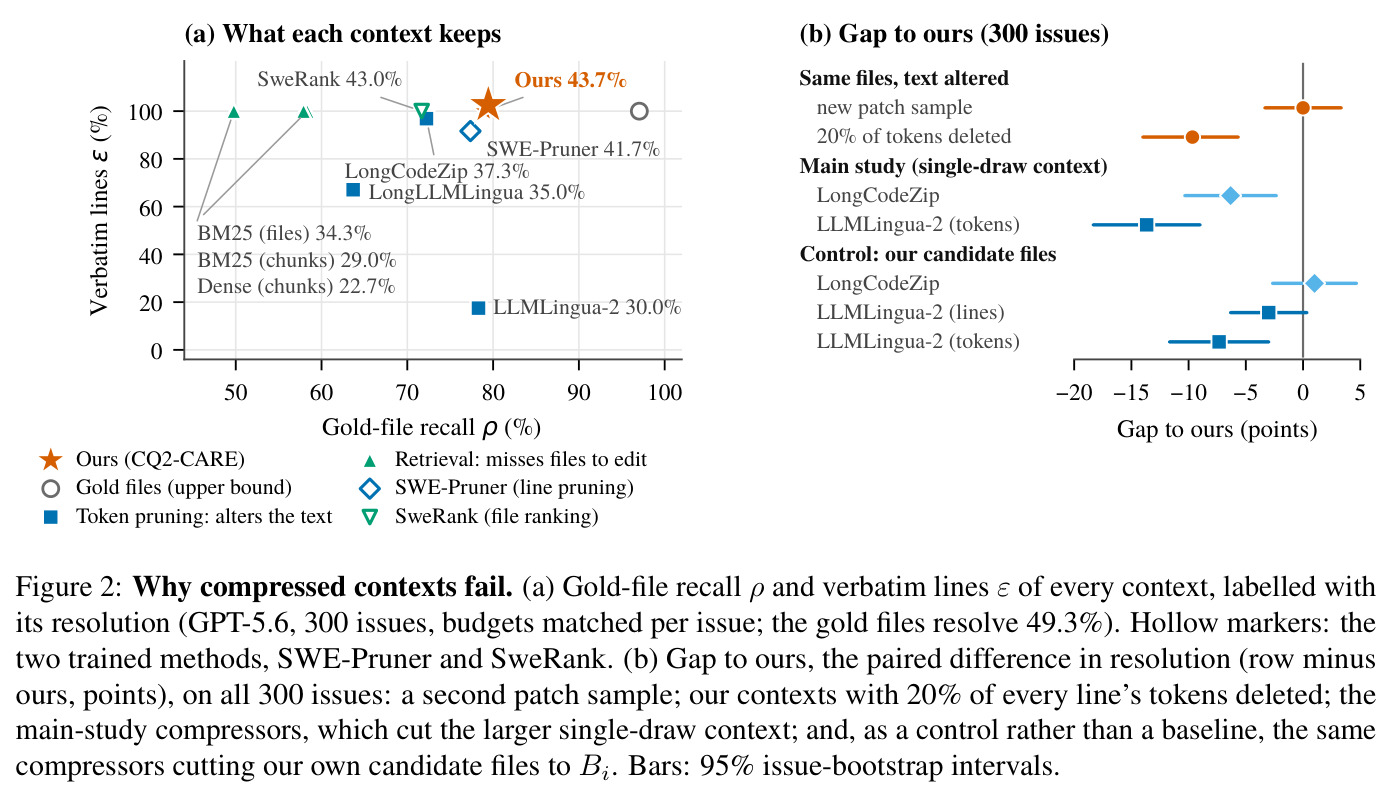
全文的失败分析都建立在 $\rho$ 和 $\epsilon$ 上:检索丢 $\rho$、压缩丢 $\epsilon$、整文件选择两者都保住,这是理解论文论证主线的钥匙。
McNemar 检验与 Holm 校正
对同一批 issue 上成对比较两个方法的精确检验,只统计'只有 A 解决'与'只有 B 解决'的不一致对子;Holm 校正用于在多重比较下控制假阳性。论文还配合 20,000 次 issue 级 bootstrap 给出 95% 置信区间。
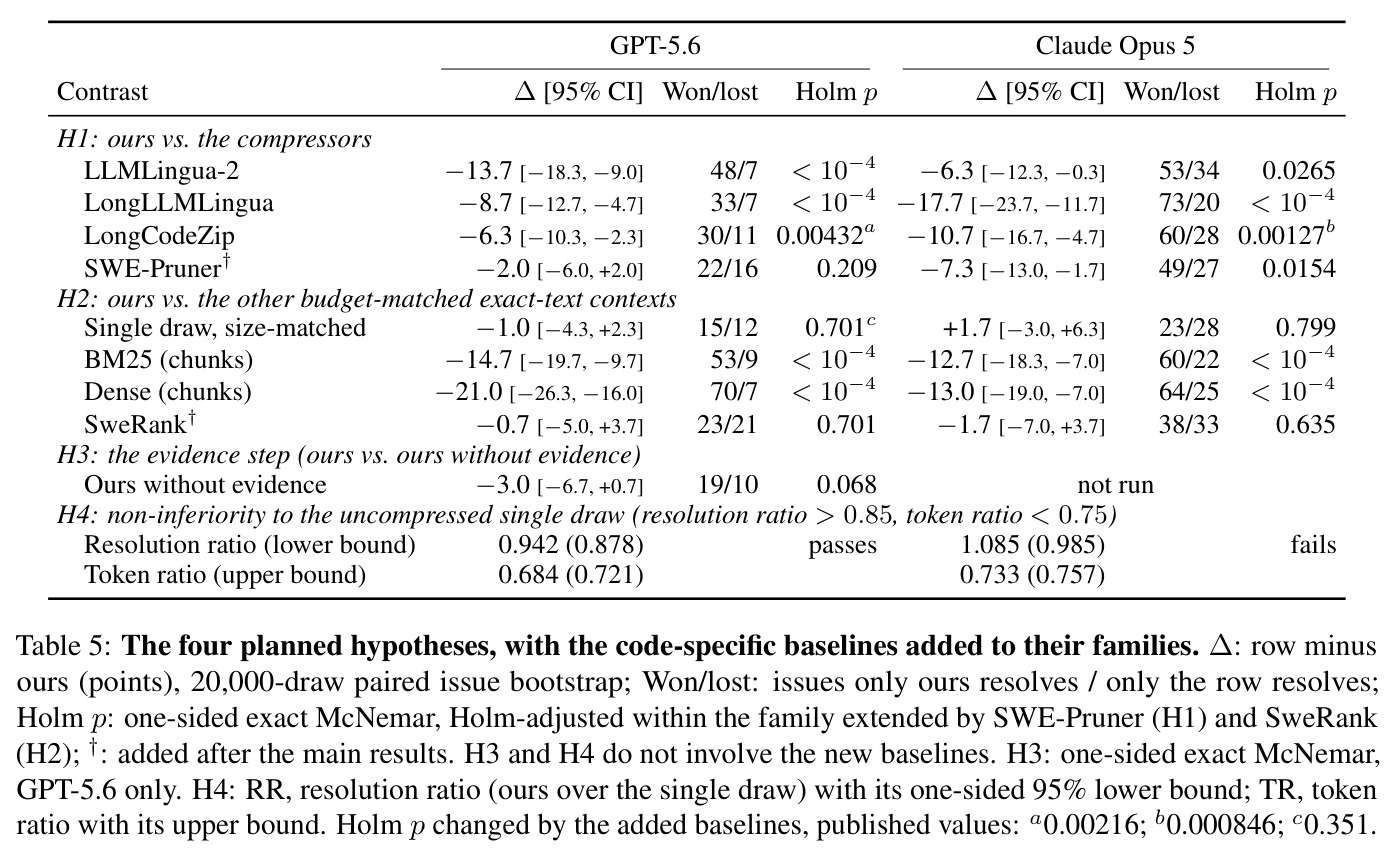
论文所有'谁比谁强几个百分点'的结论都带有一侧精确 McNemar 检验的星号与 p 值,读懂 Table 1/4/5 必须了解这套统计口径。
自洽性采样
让模型对同一问题独立采样多次,把多个样本都给出的答案视为更可靠的答案(源自 Wang et al. 2023 的 self-consistency 思想),即'样本间一致 = 信号可靠'。
CQ2-CARE 用两次独立定位答案的交集来选文件;而消融实验又表明一致性本身并非增益来源,理解这一点需要这个背景。
研究动机
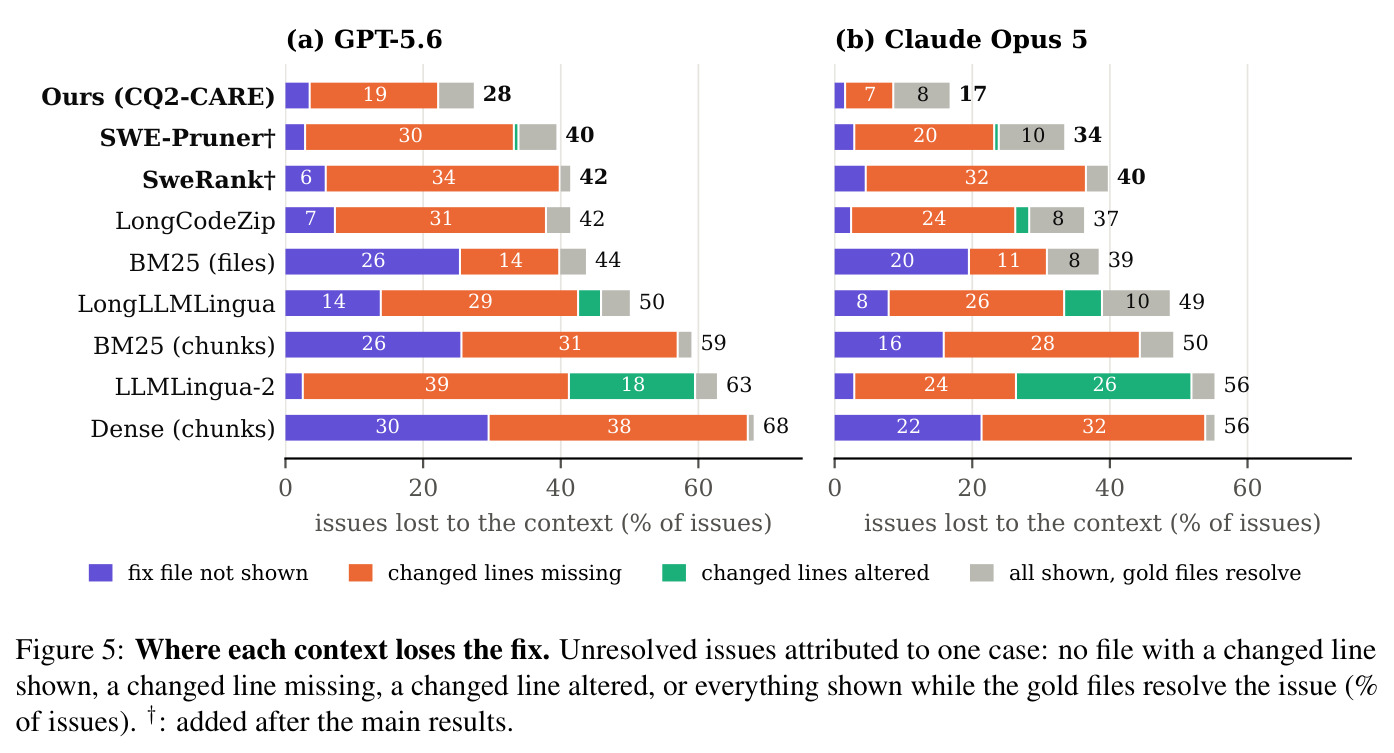
编码代理的上下文窗口远小于它要处理的仓库:SWE-bench 代码库平均有 3,010 个非测试文件、43.8 万行代码,而代理每一步都要把代码原文放进提示词。现有两条路各有硬伤。提示压缩器(LLMLingua-2、LongLLMLingua、LongCodeZip)按小模型打分删除 token,输出摘要类文本时无妨,但编辑必须逐字引用要改的代码;检索器(BM25、稠密向量、SweRank)按与 issue 的相似度排名,与 issue 措辞相似的文本会盖过真正要改的文件。论文给出的典型例子是 pypa/twine-1225:用户报告部分错误信息缺了 f-string 的 f 前缀,金标补丁改 twine/sdist.py。分块 BM25 把预算全填满 .github/ISSUE_TEMPLATE 下的 issue 模板(金标文件召回 $\rho=0\%$),补丁只能瞎猜没见过的行;LLMLingua-2 虽保住该文件但删掉了第 23 行的 f(逐字率 $\epsilon=0.5\%$),模型于是改写了一行不存在的代码、补丁无法 apply——两种方法都没解决问题。
本文的目标是论文要回答一个工程上非常具体的问题:在固定的每 issue token 预算下,究竟用哪种方式填满编码代理的上下文,能让同一个固定模型解决最多的 issue?为此要在完全受控的条件下比较三类填法——分块/文件检索、token 剪枝压缩、以及'选文件并逐字完整展示'——让每个方法自由决定哪些内容进入上下文,预算逐 issue 对齐,评分统一用基准的官方测试。作者还提出两个可离线测量的量:金标文件召回 $\rho$ 与逐字行占比 $\epsilon$,希望把'输给基线'分解为'没把要改的文件放进上下文'和'放进去了但文本被改坏'两种可分别归因的失败模式,并设计一个尽量简单、无需训练、无压缩模型的选择器来验证'把预算花在选文件上'这条对策。
与已有工作不同的是,已有工作各管一段:提示压缩文献面向长自然语言提示,代码检索文献面向补全与定位,issue 解决系统则围绕已知故障位置做剪枝;没有人在'每 issue 预算对齐、各方法自由选材、端到端用测试评分'的设定下,把检索、剪枝和整文件选择放进同一张表。此外以往评测常用中间指标(定位 F1、exit code),而本文 Appendix C 显示 exit-code 判分在抽查的 6 个 issue 中有 4 个把空补丁记为已解决,证明中间指标会误导;本文坚持用 SWE-rebench 版官方 harness 跑 FAIL_TO_PASS/PASS_TO_PASS 测试,并用受控实验'每次只动一个因素'(固定文件只改文本、或固定文本只换文件)把损失干净地归因到 $\rho$ 或 $\epsilon$ 上,这个测量框架本身是方法论上的独特贡献。
核心方法
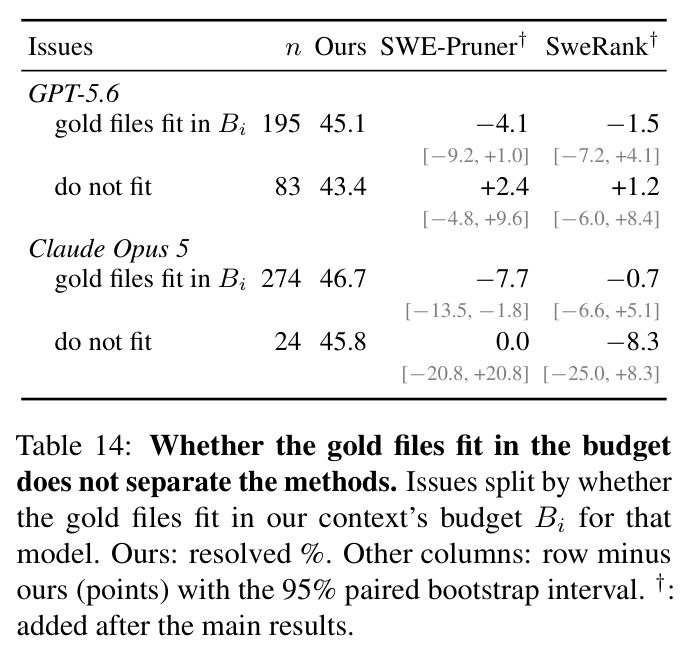
直觉:解决一个 issue 只需要两样东西——必须改的那些文件,以及它们逐字未动的原文。既然每个入选文件都整个展示,那么只要选对少量文件即可,预算应该花在'选哪些文件'而不是'删哪些 token'上。技术路线:CQ2-CARE 把仓库当作代理的长期记忆、提示当作它的压缩视图,用被测模型自己完成全部决策。先把仓库路径清单(按与 issue 词重叠排序,截断到 $\tau=\tfrac{1}{2}\min(|P|,32K)$ 个 token,按字母序列出)交给模型;模型独立采样回答'哪些文件必须改',取两次都点名的非测试、非文档文件;再让模型基于 issue 和这些文件发起至多 4 个类型化检索(找定义、调用者、字符串等),用 git grep 在仓库里定位,把匹配处的外围定义或窗口作为'证据片段'加入;最后把选中文件全文与证据片段拼接成上下文。它每个 issue 平均只选 1.7 个文件(中位数 1),外加来自约 6 个文件的证据片段,GPT-5.6 下平均 13.8K token。
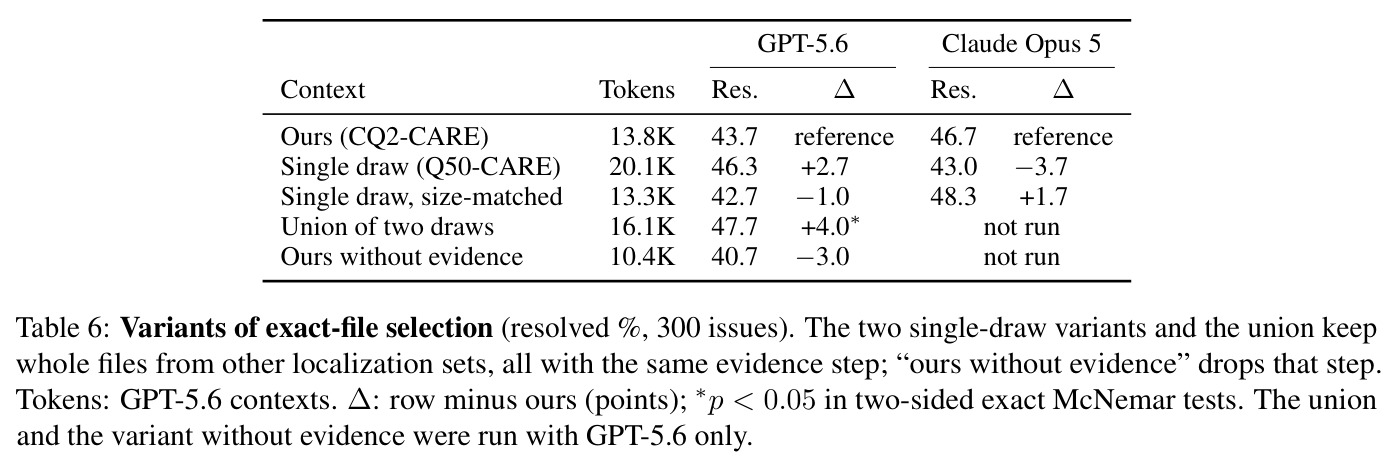
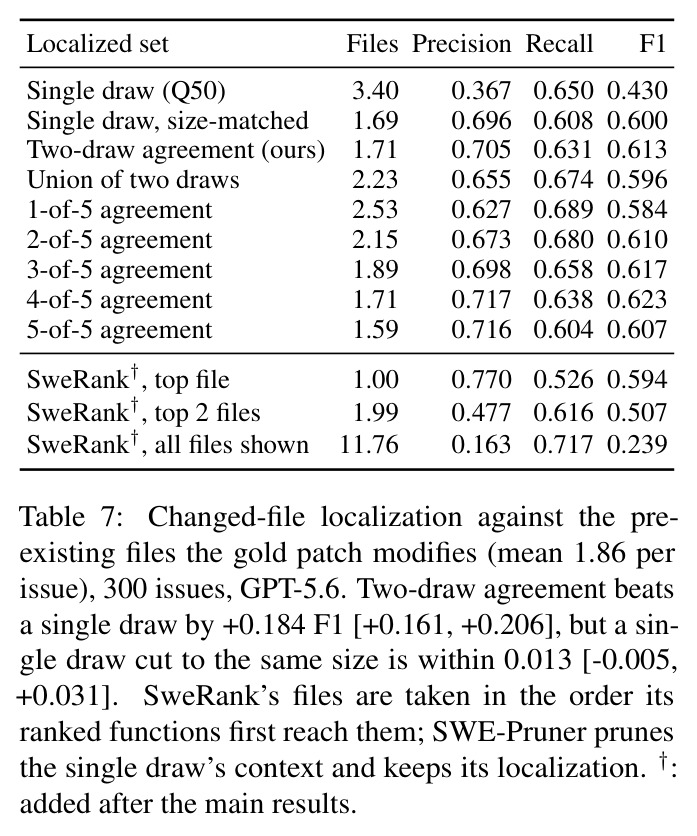
核心创新是把'上下文压缩'重新定义为'展示单位的选择'。与压缩器和检索器的本质区别有三:其一,展示单位是整个文件且逐字未改,$m_{sel}=\bigoplus_{f\in F} f[1:|f|] \oplus E$,保证模型改的每一行都真实存在——Aider 的 search/replace、SWE-agent 的行号编辑这类基于引用替换的工具正需要这一点;其二,环内没有任何压缩模型,只让被测模型多打两次招呼,而 LongLLMLingua/LongCodeZip 每 issue 要花中位数 34–37 秒 GPU 时间(Claude 的更大上下文上 84–97 秒,LongCodeZip 还在 48GB 卡上内存溢出 4 次);其三,用两次独立定位的交集当过滤器,把'模型不确定'转化为'少放几个文件'。论文的消融进一步点明:真正起作用的是'选的文件少而准'这个单位选择本身——单次采样裁剪到同样文件数后定位 F1 0.600 对 0.613,解决率也几乎相同。
方法步骤详情
Algorithm 1 分四步。(1) 盘点:列出仓库全部路径 P,按与 issue 共享词数排序,在 token 上限内按字母序输出清单 I,不用模型。(2) 定位:给定 issue q 和清单,模型独立返回三个排名答案 L0、L1、L2;选中集 F 取 L1 与 L2 都点名的、非测试非文档的路径(坏输出记空,F 为空则回退 L0),按两次排名倒数之和降序排列,GPT-5.6 下回退率仅 1.7%。(3) 规划证据:模型读 issue 和 F 后发起至多 4 个类型化搜索(定义、调用者、字符串等),每个派生至多 8 个 git grep 固定字符串,命中的文件中至多 2 个尚未展示的,把外围定义或窗口片段加入证据集 E,直到 E 覆盖 8 个文件。(4) 组装:F 中代码文件全文在前(单文件 60K token 截断),E 片段在后(各 12K 截断)依次拼接,任一块会使总长超 80K 就跳过。预算 $B_i$ 定为该 issue 上 CQ2-CARE 上下文的实际 token 数,所有基线用各自速率旋钮拟合到 $B_i\pm 2\%$。
技术新颖性
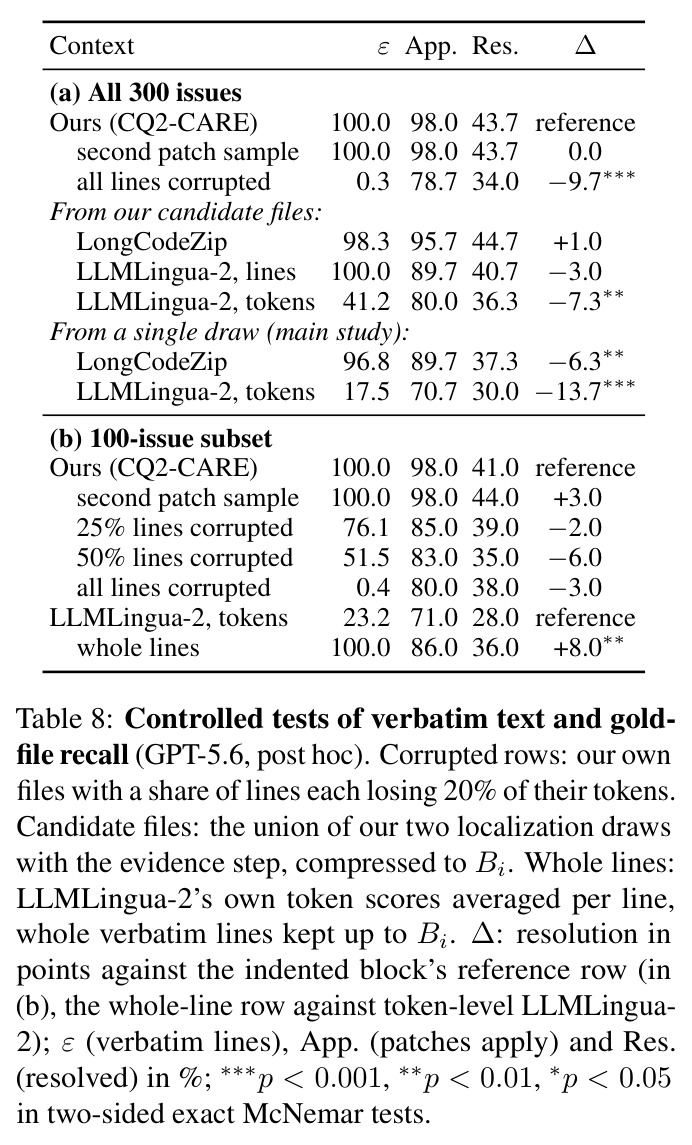
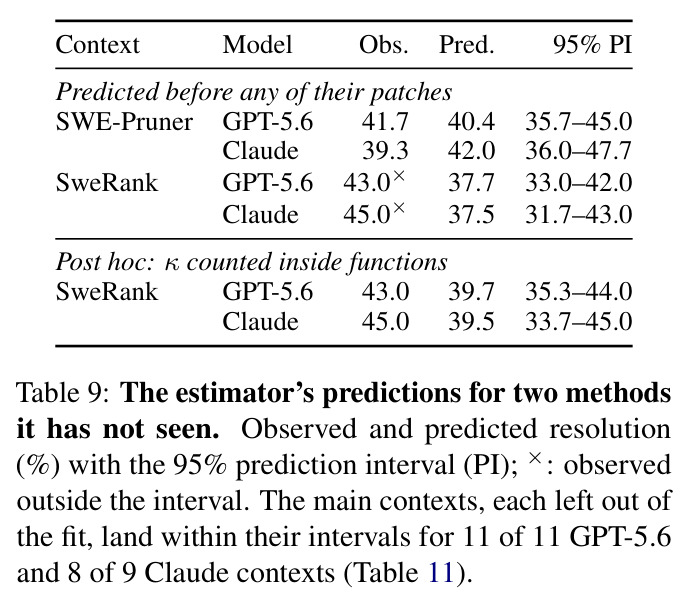
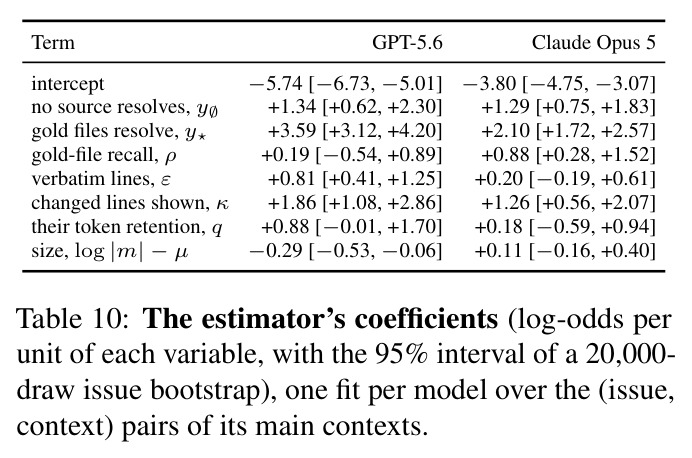
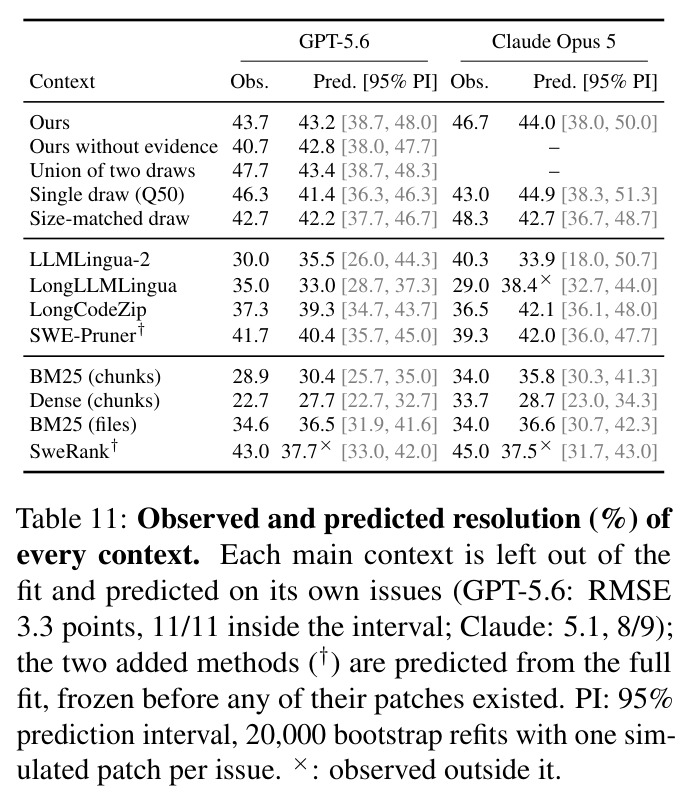
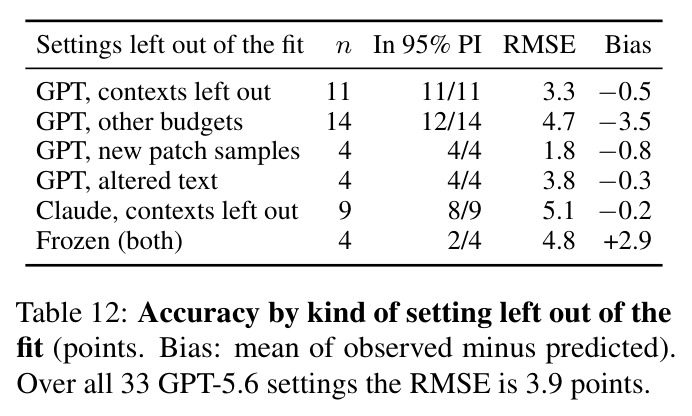
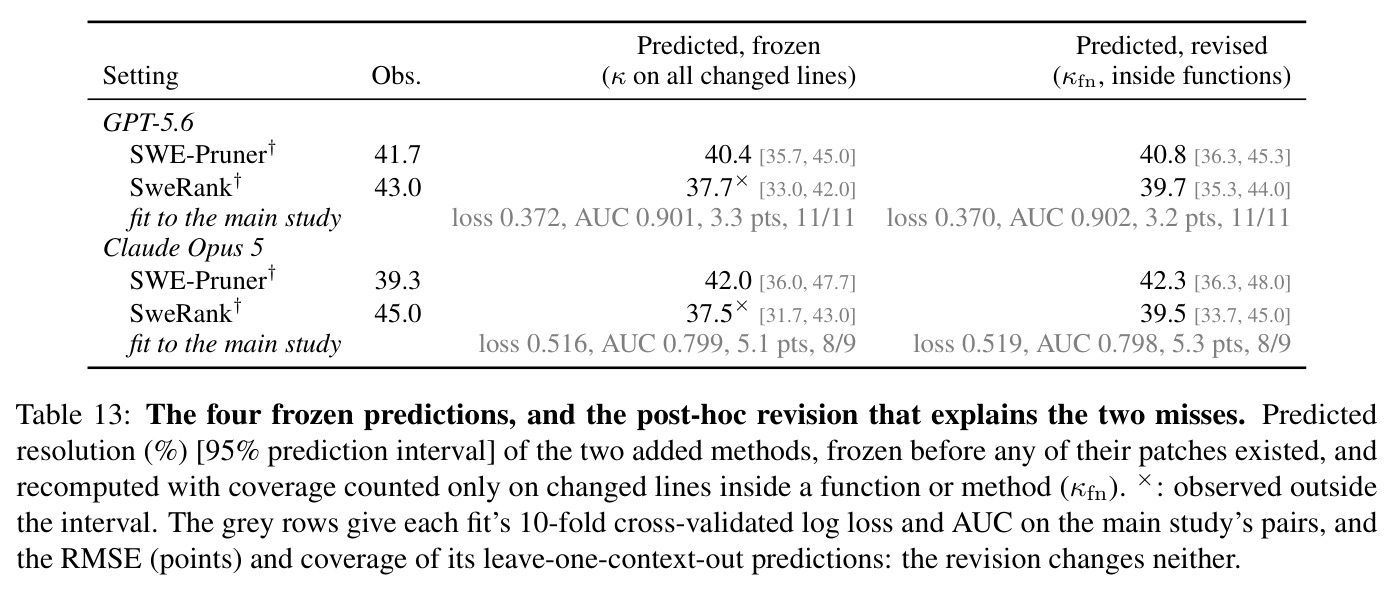
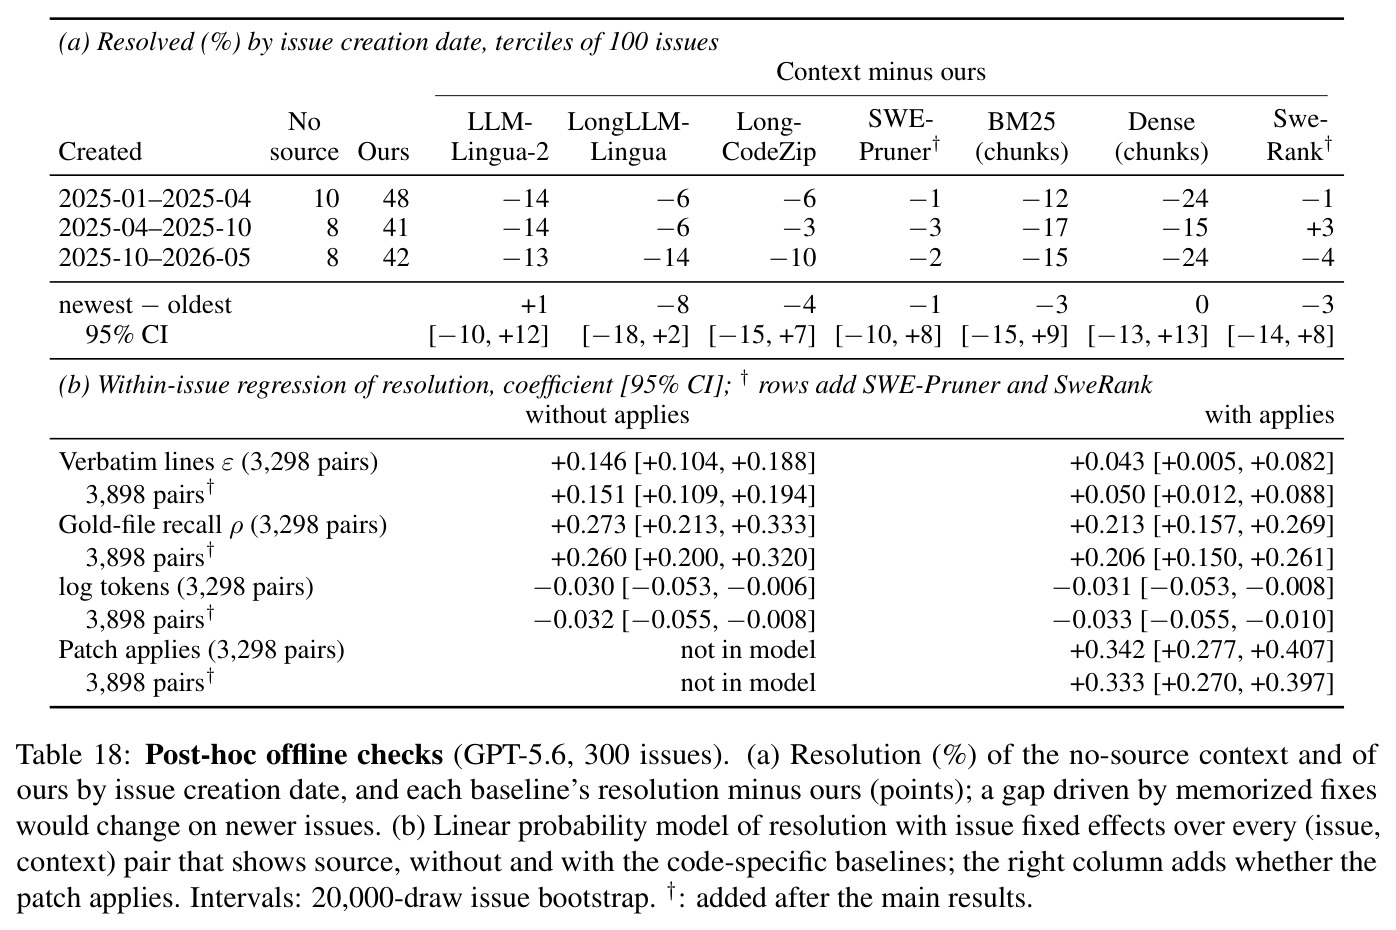
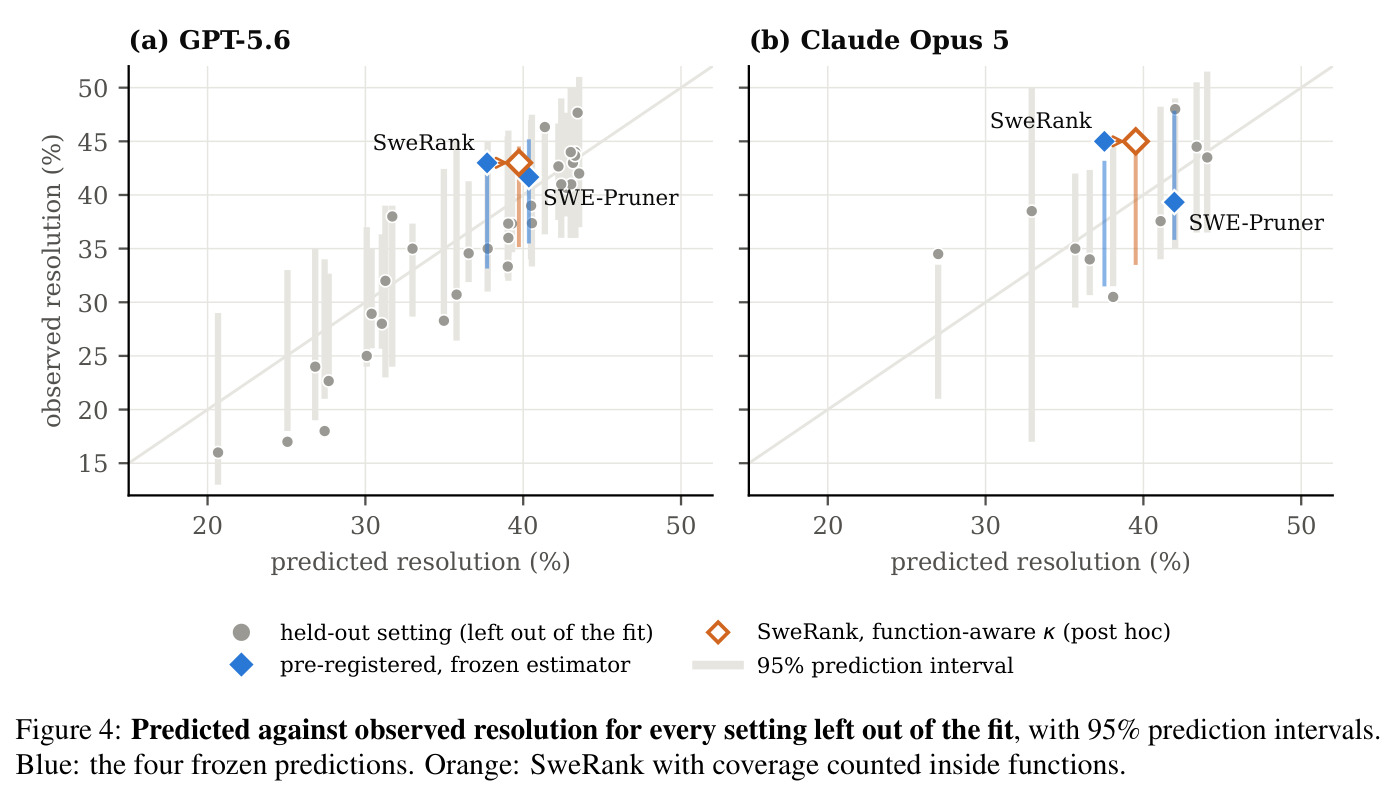
技术新颖性不在新模型,而在测量设计与归因框架。(1) 首个预算对齐、测试评分的'压缩 vs 检索 vs 选文件'三方对比:每 issue 预算锚定在 CQ2-CARE 的实际大小、压缩器只在自身速率网格上搜索 ±2% 窗口,避免'把别人剪好再喂'的不公平比较。(2) 提出 $\rho$、$\epsilon$ 两个离线指标把失败干净二分,并用受控实验证明两种损失各自独立造成约 10 个百分点的代价:删掉自家上下文每行 20% 的 token 使解决率降 9.7 分(p<0.001),而同样上下文换一次补丁采样波动为 0.0。(3) 揭示'单位重于采样':两次采样一致性把定位 F1 从 0.430 提到 0.613,但只是因为文件数减半——单次采样裁到同样文件数即达 0.600 且解决率相当。(4) 用逻辑回归估计器对未见方法做事前冻结预测:SWE-Pruner 落在预测区间内,SweRank 被低估 5.3/7.5 分,这一偏离本身还揭示了新知识——函数体外的改动行(import、模块常量、类属性)的代价远小于模型假设。
实验结果
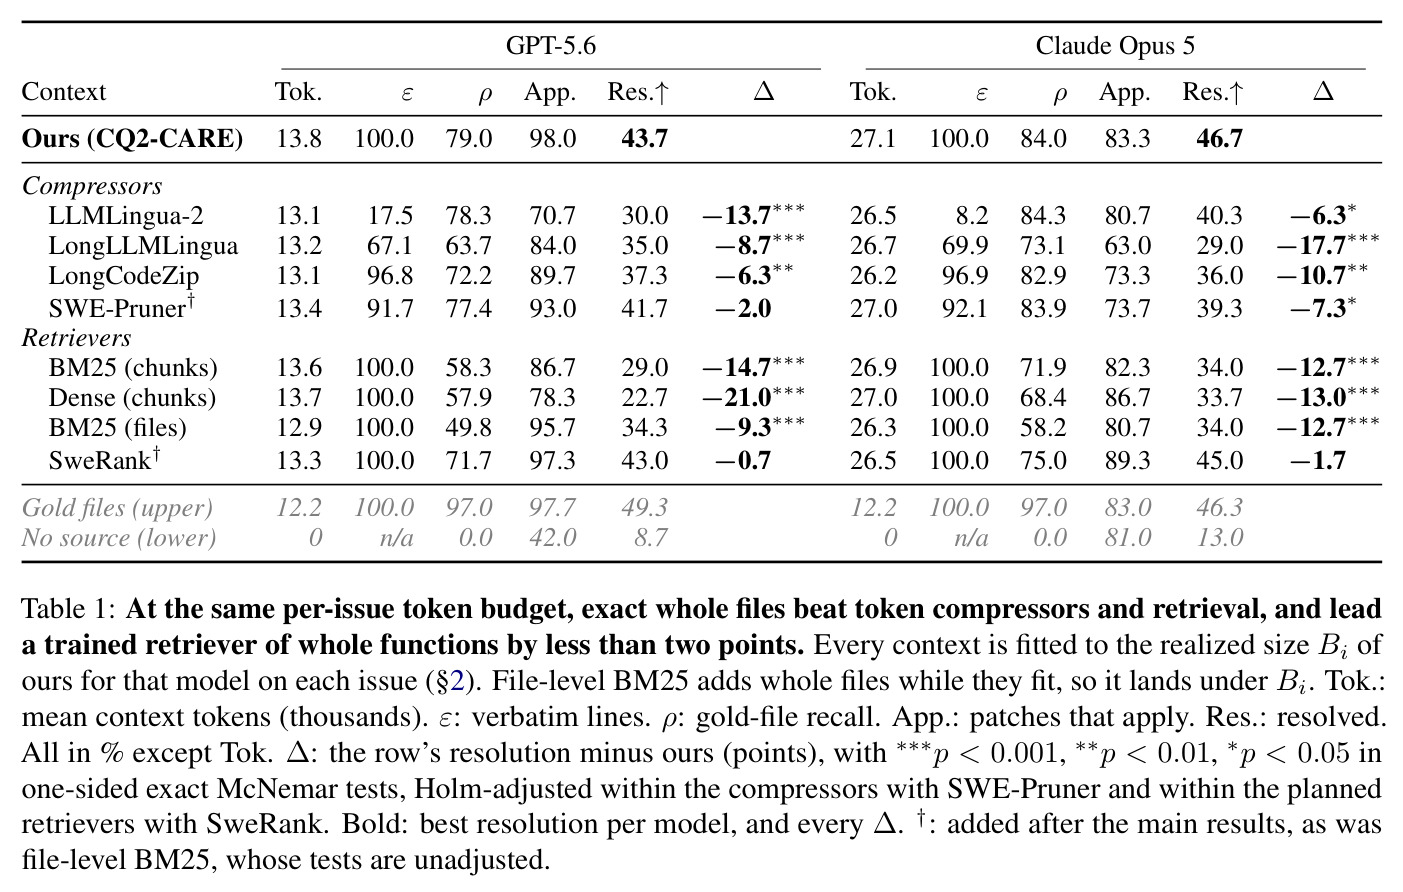
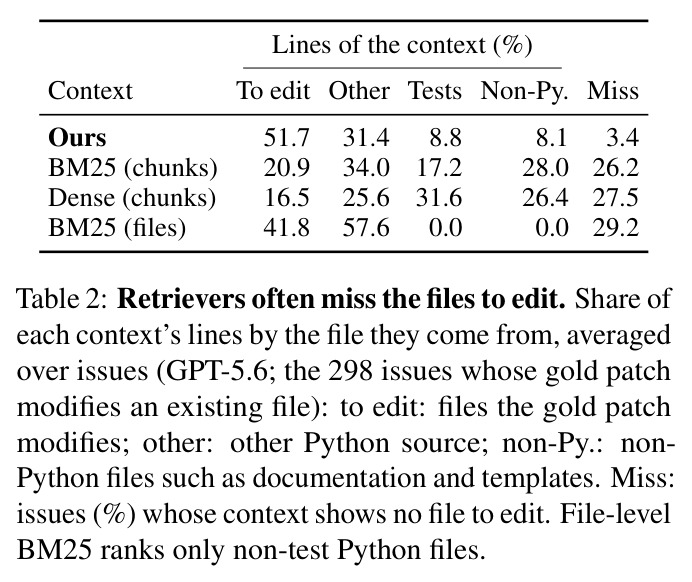
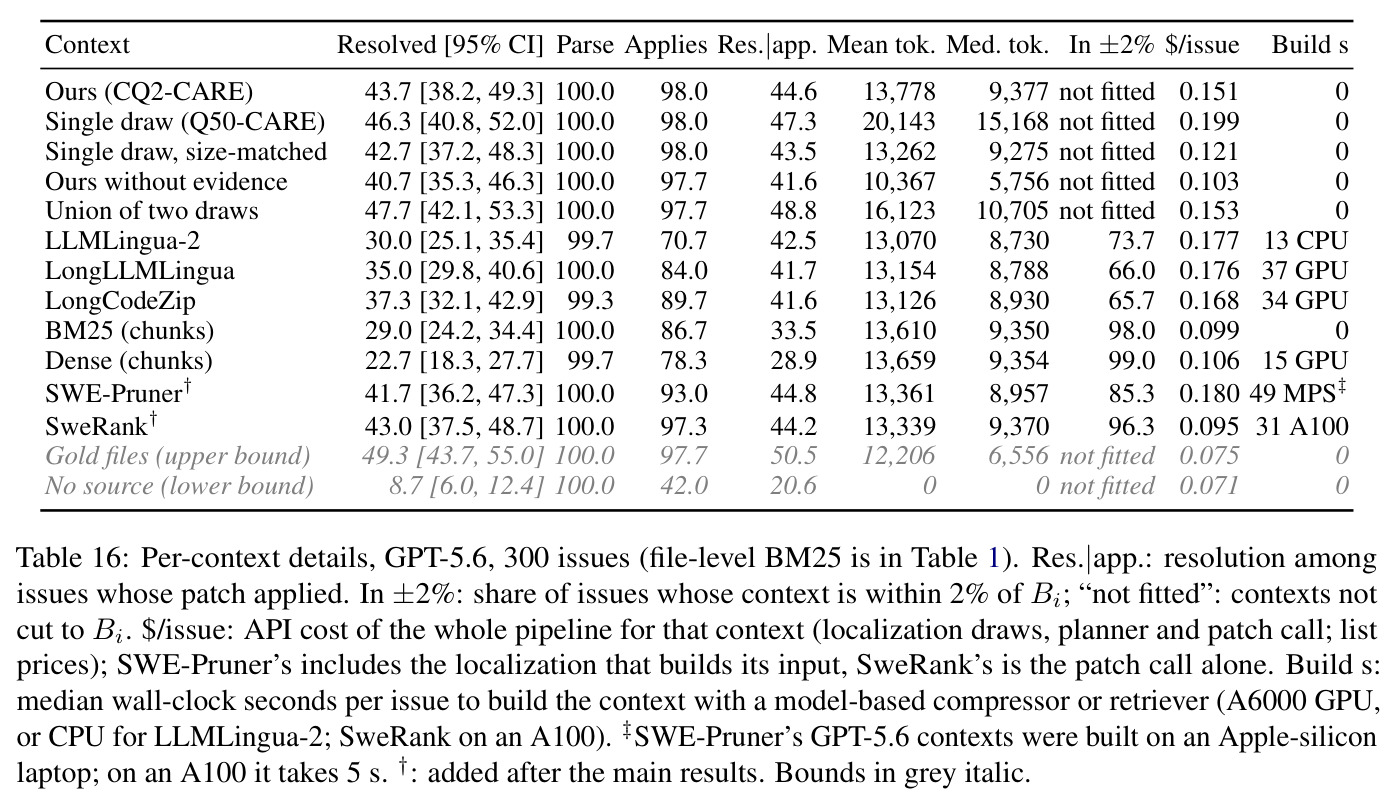
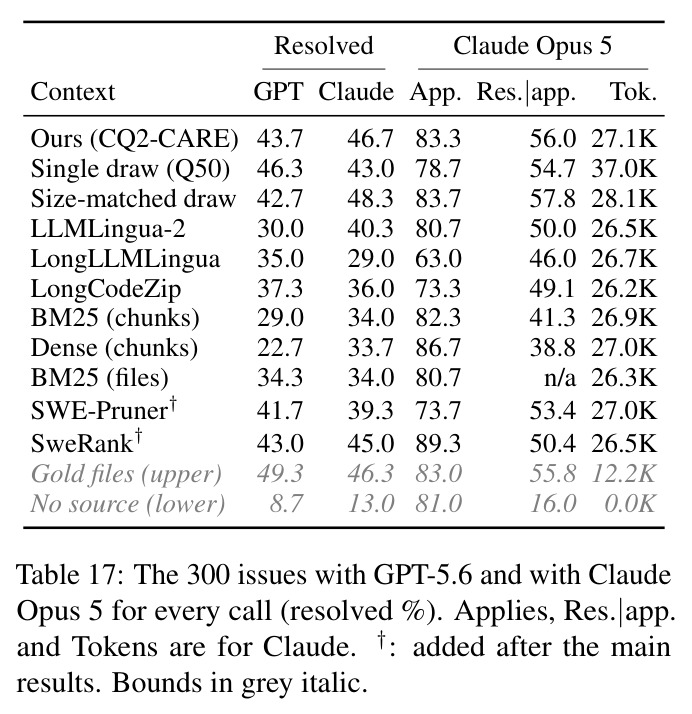
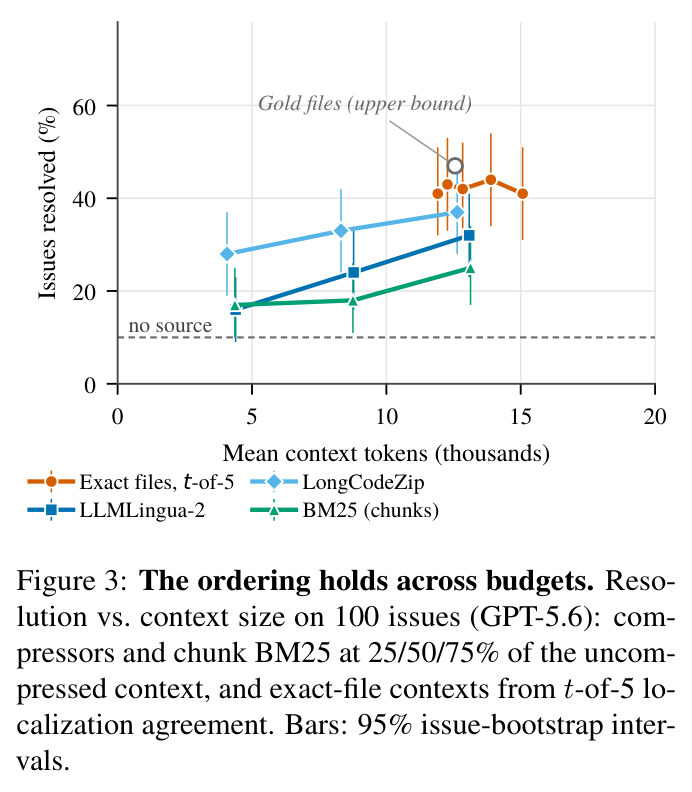
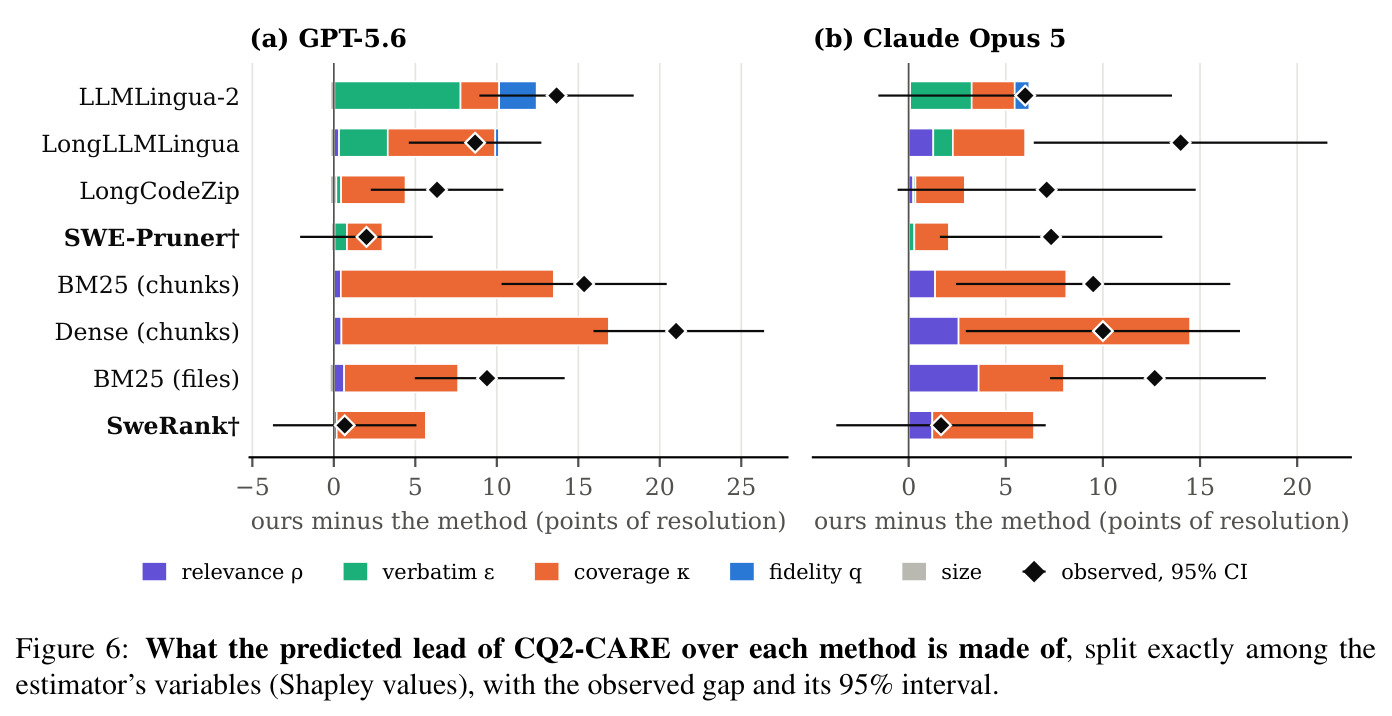
在 300 个 SWE-rebench issue、两个模型上逐 issue 对齐预算:CQ2-CARE 解决 43.7%(GPT-5.6)/46.7%(Claude Opus 5),比最佳压缩器 LLMLingua-2(30.0%/40.3%)高 6.3 分,比最佳检索器文件级 BM25(34.3%/34.0%)高 9.3/12.7 分,均显著;'整文件但按相似度选'仍大幅落后,说明关键是选对文件。对训练过的 SWE-Pruner(41.7%/39.3%)与 SweRank(43.0%/45.0%)也占优但不显著。金标上界 49.3%/46.3%、无源码下界 8.7%/13.0%。失败分解:检索器丢 $\rho$——上下文只有 16.5–20.9% 的行落在待改文件(本文 51.7%),26.2–29.2% 的 issue 完全没展示待改文件(本文 3.4%);压缩器丢 $\epsilon$——LLMLingua-2 逐字率仅 17.5%、补丁可应用率 70.7%(本文 98.0%),CQ2-CARE 解决而它失败的 48 个 issue 中 28 个败于补丁无法 apply。受控实验:删每行 20% token 损失 9.7 分(p<0.001)而二次补丁采样差 0.0;同候选文件上 LongCodeZip 达 44.7%,证明主差距来自选错文件。消融:证据步 +3.0(p=0.068);单次采样裁到同文件数几乎同效。成本 $0.151/issue(GPT),低于单次采样 $0.199 与压缩器 $0.168–0.177。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-rebench 300 issue 端到端修复(GPT-5.6) | 解决率 % | 43.7(CQ2-CARE) | 最佳压缩器 LLMLingua-2:30.0 | +13.7(McNemar p<0.001,Holm 校正) |
| SWE-rebench 300 issue 端到端修复(Claude Opus 5) | 解决率 % | 46.7 | 最佳压缩器 LLMLingua-2:40.3 | +6.3(p=0.027,最弱显著) |
| 对比 SWE-bench 官方检索基线(GPT / Claude) | 解决率 % | 43.7 / 46.7 | 文件级 BM25:34.3 / 34.0 | +9.3 / +12.7(p<0.001) |
| 对比训练过的函数级检索器(GPT / Claude) | 解决率 % | 43.7 / 46.7 | SweRank:43.0 / 45.0 | +0.7 / +1.7(不显著) |
| 对比训练过的行剪枝器(GPT / Claude) | 解决率 % | 43.7 / 46.7 | SWE-Pruner:41.7 / 39.3 | +2.0(ns)/ +7.3(p=0.015) |
| 与理论上下界对照(GPT / Claude) | 解决率 % | 43.7 / 46.7 | 金标文件 oracle:49.3 / 46.3;无源码:8.7 / 13.0 | 距上界 5.7 / 基本持平 |
| 受控文本损坏(GPT-5.6) | 解决率 % | 43.7(参考) | 自家上下文每行删 20% token:34.0 | 损坏致损 9.7 分;二次补丁采样差 0.0 |
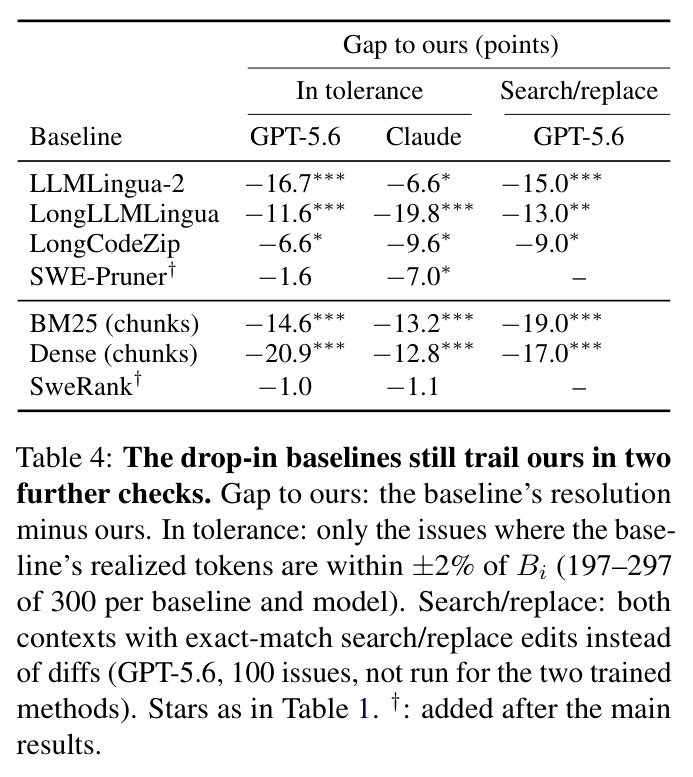
| 同候选文件上比较裁剪方式(GPT-5.6) | 解决率 % | 43.7 | LongCodeZip 裁本文候选文件至预算:44.7;LLMLingua-2 整行 −3.0 / token 级 −7.3 | 主对比差距源于文件选择而非裁剪 |
局限与改进
作者承认的局限:设定是'每上下文一次补丁调用'的单轮流程,不覆盖能重读文件、跑测试的多轮代理;只在一个 Python 基准上评测;预算 $B_i$ 定为自家方法的实际大小,即在与自身工作点对齐处比较(100-issue 速率扫描部分弥补);文件级 BM25、受控实验、SweRank/SWE-Pruner 均为事后补充,且 SweRank 可能训练过本仓库其他 PR,其 0.7/1.7 分差距不能解读为性能相等;单补丁采样噪声大——第二个样本翻转 8.7–18.9% 的结果,Claude 对 LLMLingua-2 的 6.3 分优势(p=0.027)因此脆弱;issue 可能与训练数据重叠(新 issue 上差距未见缩小),部分仓库可能在校准 CQ2-CARE 时见过。我的补充观察:GPT 与 Claude 结论不完全一致(LLMLingua-2 在 Claude 上只差 6.3 而 GPT 上差 13.7),提示对模型家族敏感;证据步与'两次采样'均未显著增益,方法的有效成分比叙述更单薄;Claude 侧可应用率偏低(83.3% vs 98.0%)的成因未被隔离。
独立分析的弱点
独立分析的弱点:(1) 单轮无交互——真实代理可以重读文件、运行测试获得反馈,压缩造成的'看不清'可能被重读补救,本文测的是一次性读码设定下的差距而非代理工作流中的真实差距,改进方向是把 $\rho/\epsilon$ 分解放进多轮 agent loop 重测。(2) 定位天花板明显——$\rho$ 仅 79.0%/84.0%,约五分之一的 issue 连待改文件都没进上下文,可引入测试失败堆栈、traceback 等执行信号或'读-猜-验证'迭代定位来抬高召回。(3) 预算策略粗放——60K/12K/80K 三个封顶全是手工常数,未探索按文件边际收益动态分配 token,可学习一个预算分配器。(4) 只测 Python——其他语言(缩进语义、构建系统不同)下 grep 证据与文件截断策略需重新验证。(5) 评分只看测试通过——无法区分'碰巧通过'与'真正修复',可加入与金标补丁的编辑距离等辅助指标。(6) 基线对比可能仍偏向自身——预算锚定在自家方法的实际大小上,而压缩器的卖点本可以是'用更小的上下文';速率扫描只有 100 个 issue,帕累托前沿刻画不足。
未来方向
作者提出的方向:在完整 agent loop(可重读文件、可跑测试)中测量压缩损失与重读收益的权衡,因为压缩视图至少告诉模型该去读哪个文件;对估计器做真正预注册的事前检验(SweRank 的 $\kappa$ 函数内修正是在看到结果后选的,需要在未见方法上验证);研究上下文方法与编辑格式(diff vs search/replace)的交互。基于本文成果可延伸的:其一,'选文件 + 必要时整行裁剪'的混合策略——受控实验已表明同文件上 LongCodeZip 裁整行可达 44.7%,选好文件后交给行级压缩是自然的下一层;其二,执行信号驱动的定位——用失败测试的堆栈与 grep 证据互补,突破 $\rho$ 的天花板;其三,把 $\rho/\epsilon/\kappa/q$ 这套失败语言迁移到多轮代理的轨迹与历史压缩上(如 OpenHands 类系统);其四,非 Python 语言与超大单文件仓库的适配;其五,系统性刻画'预算-解决率'帕累托前沿,为不同成本预算的团队给出配置建议。
复现评估
复现评估:作者承诺公开代码、提示词与每 issue 结果(写作时未见仓库链接,需关注后续发布)。数据公开:SWE-rebench 是公开基准,300 个 issue 由加盐哈希抽取,资格检查规则(金标补丁可解、空补丁不可解,340 选 328 取前 300)写得足够细。基线全用官方实现与文档设置,预算拟合与各基线均有逐步伪代码(Algorithm 2–10)。算力门槛中等:GPT-5.6 研究 API 费约 $830、Claude 约 $1,438;模型压缩器需 RTX A6000/A100(LongLLMLingua 6.5–14.2、LongCodeZip 3.3–11.4 GPU 时),LLMLingua-2 纯 CPU 即可;评分用 SWE-bench harness 的 Apptainer 容器沙盒(每 issue 30 分钟、可纯 CPU)。难点在评分基建的工程细节与统计口径的精确复刻(精确 McNemar + Holm + 20,000 次 bootstrap)。总体属于'认真写脚本即可复现'的高透明度实证论文。
论文图表
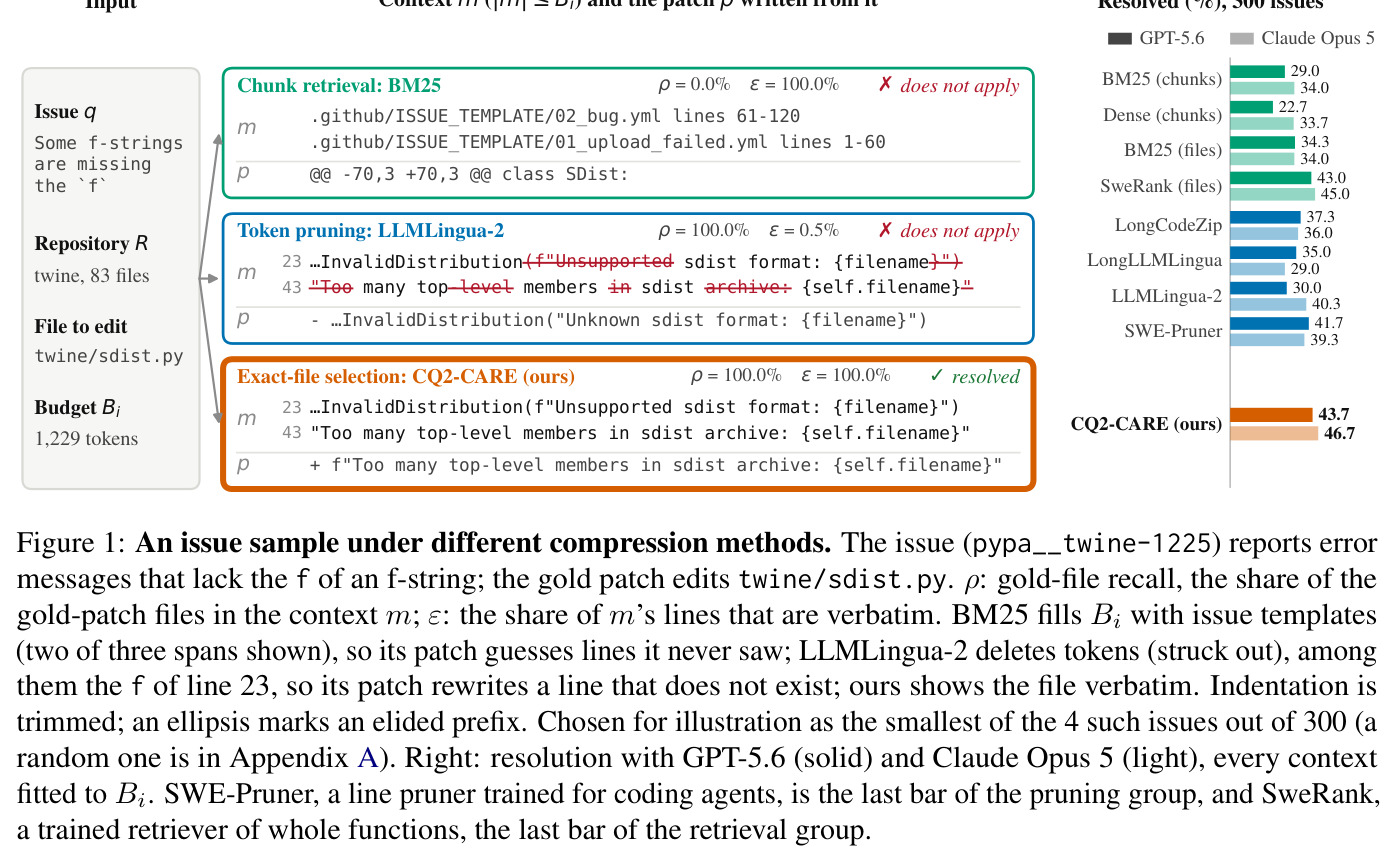
以 pypa__twine-1225(错误信息缺 f-string 的 f)为例并排展示三种上下文:分块 BM25 得 $\rho=0\%$、$\epsilon=100\%$,用 issue 模板填满预算,补丁引用了从未见过的行;LLMLingua-2 得 $\rho=100\%$、$\epsilon=0.5\%$,删掉了第 23 行的 f,补丁改写了不存在的行;CQ2-CARE $\rho=100\%$、$\epsilon=100\%$,展示原文件并成功解决。右侧条形图给出各方法在两个模型上的解决率(CQ2-CARE 43.7/46.7 领先)。
一图看懂两类基线的失败机制与论文的核心主张,是全文的直觉锚点。