PremiseCheck:对人类与 AI 同行评审意见的高效事实核查 PremiseCheck: Efficient Fact-Checking of Human and AI Peer Reviews
LLM 只改写评论为前提,廉价决策模型对照论文验证,精度追平 GPT-5.5 成本减半
前置知识
AUROC(ROC 曲线下面积)
AUROC 衡量二分类系统对正负样本的排序能力:随机取一个正样本和一个负样本,AUROC 是系统给正样本打分更极端的概率,0.5 等于随机猜。本文把「含事实错误的评论」作为待检测正类,用 $AUROC = \Pr[s(c^+) < s(c^-)]$ 评估系统给错误评论打更低分(更可疑)的排序质量,平局计 0.5,报告值乘以 100。
论文所有精度结论都用 AUROC 表述,并以配对差值的置信区间判断与基线的差距,不懂它就读不懂 Table 1。
决策模型(decision model)
决策模型(如本文的 Jev)是一类不做文本生成、直接输出「某陈述在某文档中成立的概率」$f(x, a) \in [0,1]$ 的模型,输入是文本 $x$ 加一个写成陈述句的问题 $a$。它只按输入 token 计费(Jev 每百万输入 token 0.042 美元),延迟低于一秒,成本比生成式 LLM 低一到两个数量级。
PremiseCheck 的全部成本优势都建立在决策模型便宜且快上;理解它「擅长显式单陈述、不擅长混合多重断言」的能力边界,才能理解本文的分工设计。
声明分解与事实核查
事实核查的经典流程是把一段文本拆成若干原子声明(claim),逐条对照证据来源验证,再聚合成整体判定。早期系统(FActScore、MiniCheck 一类)通常让同一个大模型既做分解又做验证,验证时需要把全文反复喂给 LLM。
本文复用这一流程但反转了分工——分解交给不读论文的 LLM,验证交给不生成的决策模型,了解原范式才能看出其创新所在。
非劣性检验(non-inferiority test)
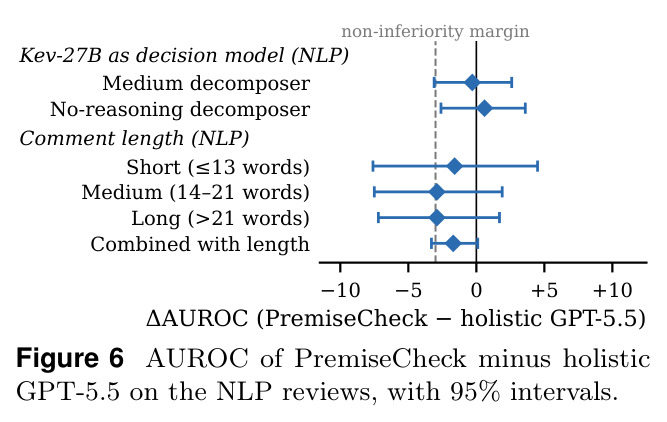
非劣性检验不证明新方法更好,而是证明它「不比参照方法差太多」:预先固定容差边界(本文为配对 AUROC 差值 −3),若差值的 95% 置信区间下界高于该边界即判定非劣。本文通过对论文层面 bootstrap(2,000 次重采样)计算置信区间。
论文的核心主张是「精度相当、成本减半」,「相当」的判定标准就是这个检验,Table 1 中的 † 标记均由此而来。
级联与成本感知推理
成本感知推理研究如何在精度与费用间权衡:级联(cascade)把简单查询交给廉价模型、搞不定再升级到昂贵模型;测试时扩展(test-time scaling)则让模型多花输出 token 换精度。衡量指标除精度外还包括 API 美元成本和延迟。
PremiseCheck 与级联、测试时扩展形成三方对照——它反向而行,用无推理的分解器加廉价验证器,理解这一脉络才能明白其定位与贡献。
研究动机
学术投稿量爆炸式增长使同行评审不堪重负,而评审意见——无论人写还是 AI 写——经常错误陈述论文内容。论文开篇给了一个真实例子:一位评审写道「复现性有限,因为只在 Gopher 模型上测试且该模型不可获得」,但论文第 5.6 节明确写了用公开材料复现结果并在 OPT-6B 上报告。这类错误会误导作者 rebuttal、扭曲录用决策,而领域主席不可能重读每篇论文核对每条意见。现有工具陷入两难:让 GPT-5.5 这样的前沿 LLM 整体判断每条评论,准确但每条都要重读全文(每条约 2.17 美分、6.3 秒),在数万条评论的规模下成本失控;改用 Jev 这类只按输入计费的廉价决策模型,一条评论却混合多条显式或隐式断言,直接打分在 NLP 评论上 AUROC 仅 49.9,等于瞎猜。更麻烦的是事实错误非常稀少——NLP 评论中仅 4.8%——系统要在海量正确评论里捞针,成本就成了决定能否部署的一级指标。而既有的评审错误数据集(ReviewCritique、ReviewScore、PeerReview Bench)各自为更宽泛的目标而建,「事实错误」的标注口径互不一致。
本文的目标是本文目标分三层,均可量化。其一,把「核查单条评审意见」定义为独立任务:给定论文 $D$ 和其中一条评论 $c$,输出分数 $s(c, D) \in [0,1]$,低分表示评论很可能含事实错误;用 AUROC 衡量精度,同时把每条评论的美元成本 $C(c)$ 与延迟 $T(c)$ 作为与精度并列的一级指标。其二,构建 ReviewFact 基准:在 NLP、机器学习、自然科学三个领域,把三个专家标注数据集统一映射到同一个事实错误定义(误解、忽视、无据陈述、错误概括四类,判断类错误排除在外),共 9,267 条评论、217 篇论文。其三,提出 PremiseCheck 框架,要求在三个领域都达到与参照系统(整体 GPT-5.5,medium reasoning)非劣的精度——配对 AUROC 差值的 95% 置信区间下界高于 −3——同时把成本压到其一半以下、延迟低于一半。
与已有工作不同的是,本文的关键洞察是一个朴素的分工观察:理解一条评论在断言什么需要 LLM 的语言能力,但不需要论文;而真正昂贵的是读论文这一步,这恰恰是决策模型在前提显化之后能胜任的。作者先做了铺垫实验:在人写出的单条前提上,Jev 与 GPT-5.5 一样准(附录 D.1),差就差在整条评论的多重隐式断言上。已有工作要么让 LLM 全程包办——ReviewScore、Peerispect 让 LLM 分解后再验证,但每条前提都要把论文再喂给 LLM 一次,$k$ 条前提反而把昂贵调用放大 $k$ 倍;要么让单声明核查模型硬啃整条评论(Jev 直接打分等于瞎猜)。另一个被忽视的点是成本与延迟必须和精度一起测:一个要在每篇论文每条评论上跑的系统,2% 与 100% 的成本差异决定它能否上线,但此前基准几乎不报这两项。此外 ReviewFact 首次在统一事实错误定义下横跨三个学科,让「AI 写的评论是否比人写的更不实」这类问题可以被定量回答。
核心方法
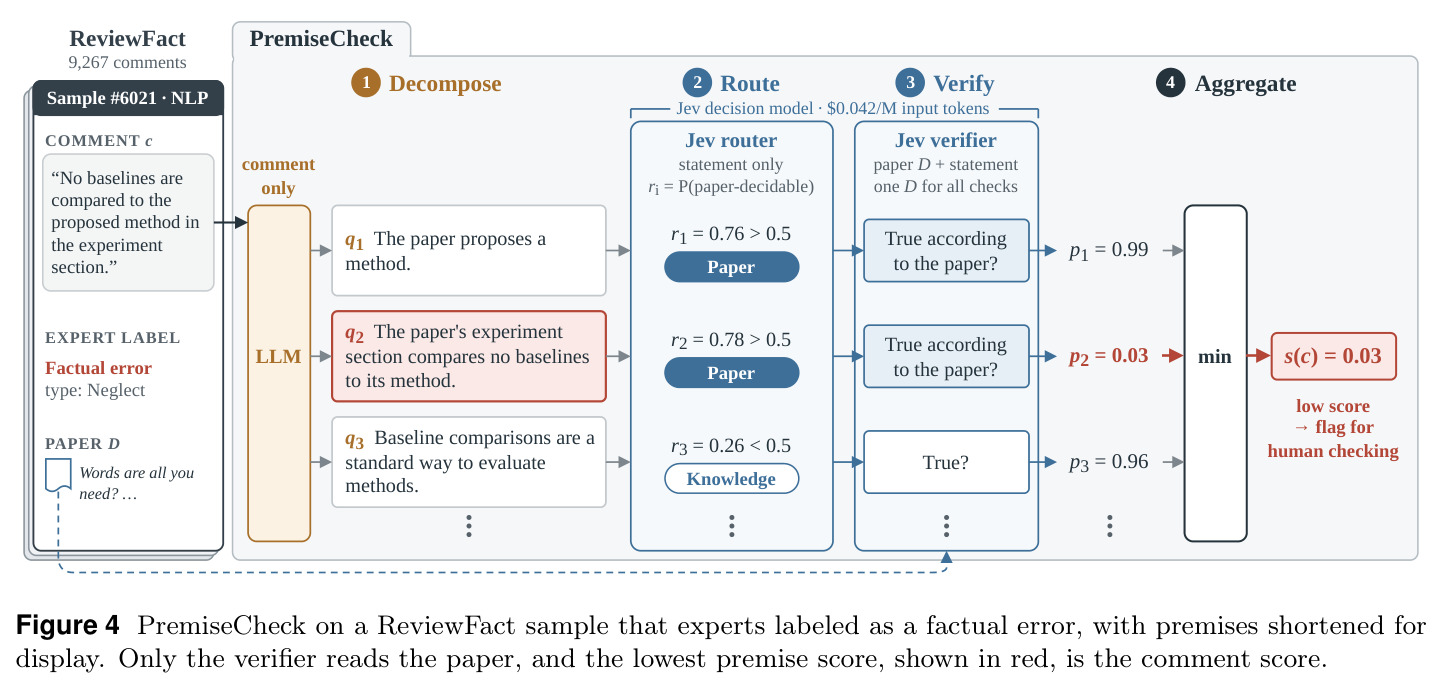
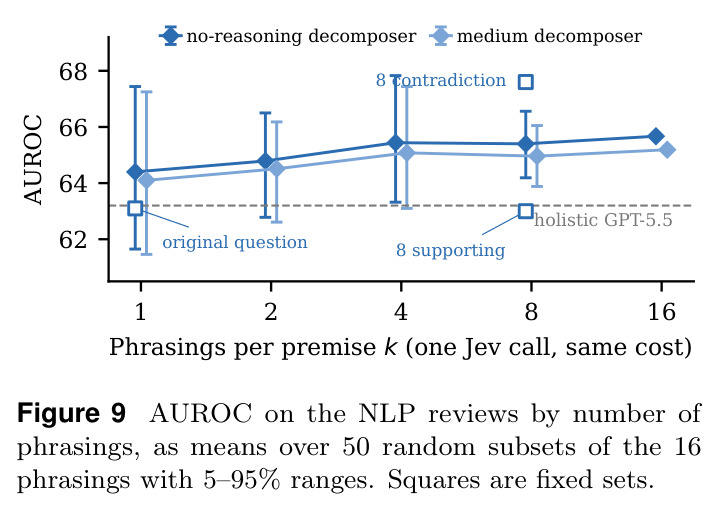
直觉上,PremiseCheck 把「评审说论文有错吗」这道大题拆成几道小判断题:先由一个从不见论文的 LLM 把评论改写成至多 6 条显式前提,再让一个只按输入 token 计费的决策模型逐条对照论文打分,最后取最低分作为整条评论的分数——就像审稿人先替你把含糊的质问翻译成明确的断言,再让一个只管查文档的助手逐条核对。技术上分四步:(1) 分解:LLM 仅读评论(NLP 上平均 24 token,加约 256 token 提示词),改写出 $k$($1 \le k \le 6$)条自包含的陈述句前提,要求覆盖显式与隐式断言,包括问句所预设的内容;(2) 路由:决策模型先估计每条前提能否仅凭论文判定,$r_i = f(q_i, a_{\text{route}})$,$r_i \ge 0.5$ 的作为论文前提,否则作为知识前提;(3) 验证:决策模型读论文(截断到 24k token)与前提,按路由结果用不同问句打分 $p_i$;(4) 聚合:$s(c) = \min_{1 \le i \le k} p_i$。实现中 GPT-5.5 当分解器、Jev 当决策模型,验证时对同一输入在一次调用里问 16 种措辞取平均——因为 Jev 只按输入计费,这几乎不加钱。
核心创新是反转了声明分解流水线的分工。传统做法(如 ReviewScore、Peerispect)让 LLM 既分解又验证,验证每条前提都要把论文再喂给 LLM 一次,$k$ 条前提意味着 $k$ 次昂贵的全文阅读,分解反而放大成本——论文实测让 GPT-5.5 当验证器会使流水线成本达整体判断的 3.1 倍。本文让 LLM 只做它便宜的部分——改写评论(不含论文),把读论文交给决策模型(Jev 每百万输入 token 仅 0.042 美元,NLP 上全部决策模型调用合计每条评论约 0.0015 美元)。这之所以可行,是因为决策模型在人写出的单条前提上和 GPT-5.5 一样准,差就差在整条评论的多重隐式断言上,分解恰好补齐这块短板。第二个关键设计是取最小值聚合:一条评论只要有一条前提不成立就是事实错误,这与任务定义精确对齐(换成均值聚合 AUROC 会从 63.1 掉到 59.4)。第三个技巧是「矛盾问句」:一次调用里同时问 16 种措辞,其中 8 种正向问「论文是否支持该前提」、8 种反向问「是否矛盾」,AUROC 从 63.1 升到 65.7 且零额外成本——反向问法修正了「论文未提及就压低分数」的系统性偏差。
方法步骤详情
第一步分解:输入仅为评论 $c$,LLM(GPT-5.5,可关推理)将其重构为带结论的论证,输出 $\{q_1, \dots, q_k\}$,每条前提是自包含陈述句并点名所涉方法、表格或章节;提示词要求既写显式断言也写隐含预设(如「作者测过其他模型吗」预设了论文没测),且不得添加评审者未断言的事实;NLP 上不到 1% 的评论返回空前提,此时回退为决策模型整体打分。第二步路由:输入为单条前提,决策模型回答路由问句得 $r_i = f(q_i, a_{\text{route}})$,$g_i = \mathbb{1}[r_i \ge 0.5]$;把论文前提(如「论文没在数据集 X 上报告结果」)与知识前提(如「方法 Y 是该任务的标准基线」)分开,避免后者的概率被「根据论文」问法错误压低。第三步验证:输入为论文 $D$(截断 24k token)加前提,按式 (2) 选问句——论文前提问「该命题根据论文为真」($a_{\text{paper}}$),知识前提问「该命题为真」($a_{\text{know}}$),自然科学部分由分解器标记验证方式并改用矛盾问法;每个输入一次调用内问 16 种措辞取均值。第四步聚合:$s(c) = \min_{1 \le i \le k} p_i$;单条评论成本为 $C(c) = C_{\text{LLM}}(c) + \sum_{i=1}^{k}[C_f(q_i) + C_f(D, q_i)]$。
技术新颖性
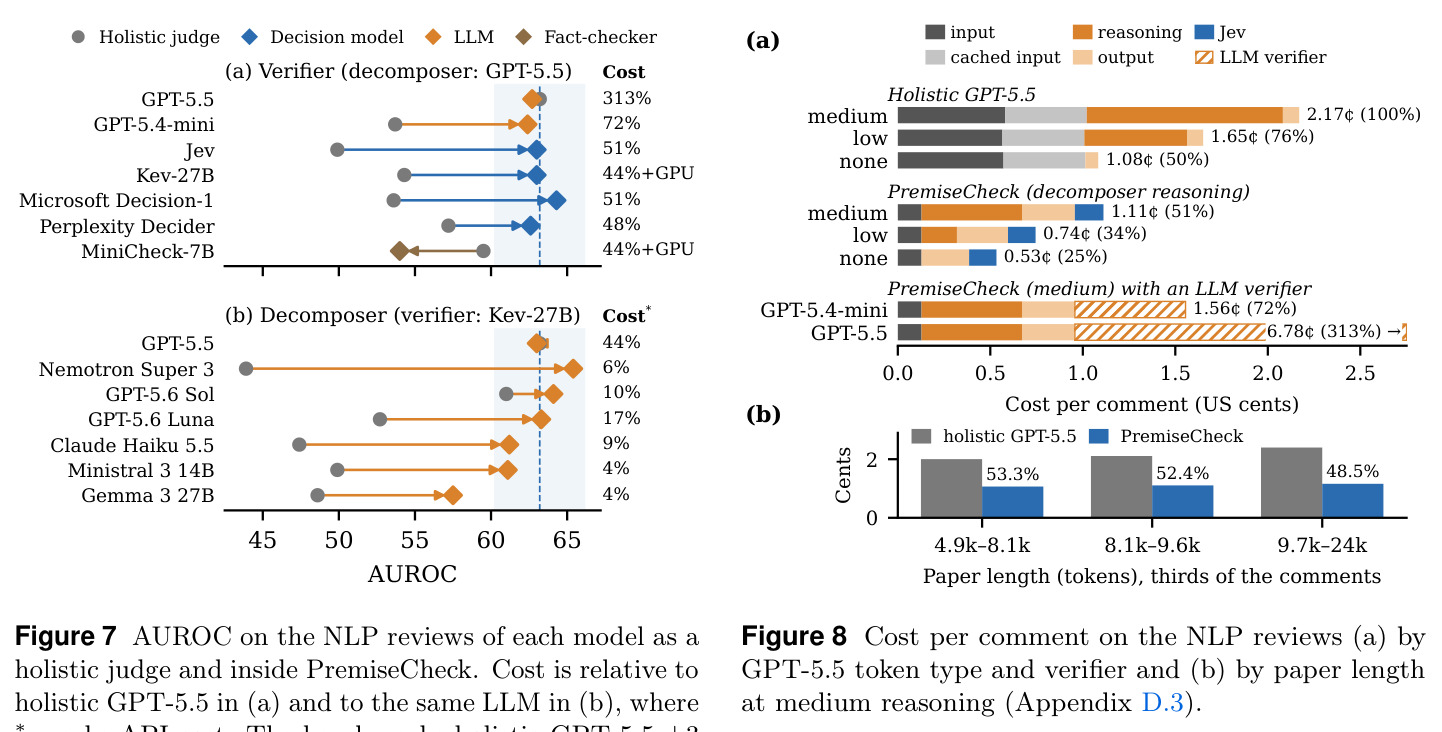
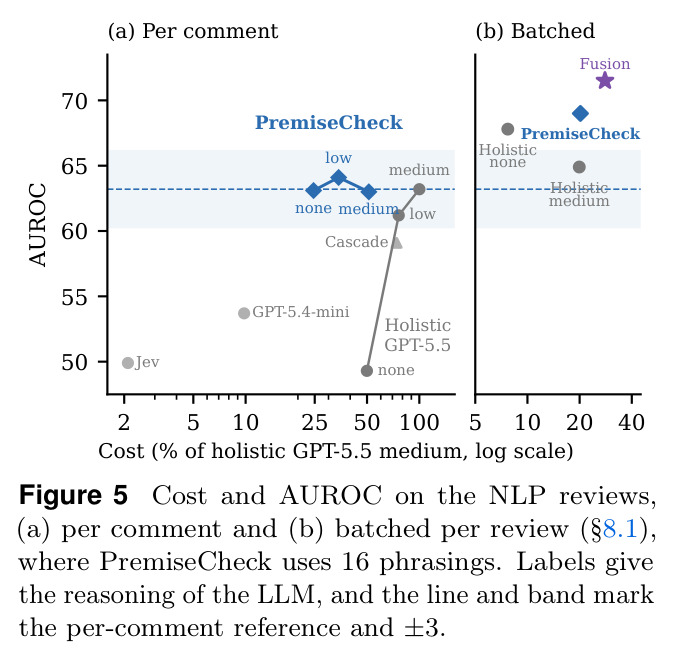
新颖性有三点。第一,「LLM 不读论文」的分工是新的:与 ReviewScore、Peerispect 等 LLM 端到端验证方案不同,也与把查询在贵贱模型间转发的级联不同——级联仍要把论文喂给昂贵 LLM(实测花 74% 成本仍更不准),而 PremiseCheck 中论文只进过决策模型,分解器甚至能在评审者敲下评论的瞬间运行。第二,它反其道地不使用推理:整体判断的 GPT-5.5 一旦关掉推理,NLP 上 AUROC 从 63.2 暴跌到 49.3,而 PremiseCheck 的分解器不需要推理照样非劣,因为「理解评论」和「判断论文证据」被拆给了两个模型,推理只在前者有用且前者太简单。第三,验证了「决策模型」作为一类新组件的可替换性:四家供应商的四个决策模型(Jev、开源 Kev-27B、Microsoft Decision-1、Perplexity Decider)当验证器都进入整体 GPT-5.5 一个 AUROC 点以内,说明结论不绑定单一模型;而训练式事实核查模型 MiniCheck-7B 反而拒绝很多正确前提、掉了链子,划出了「能接问题的决策模型」与「训练好的核查器」的能力边界。
实验结果
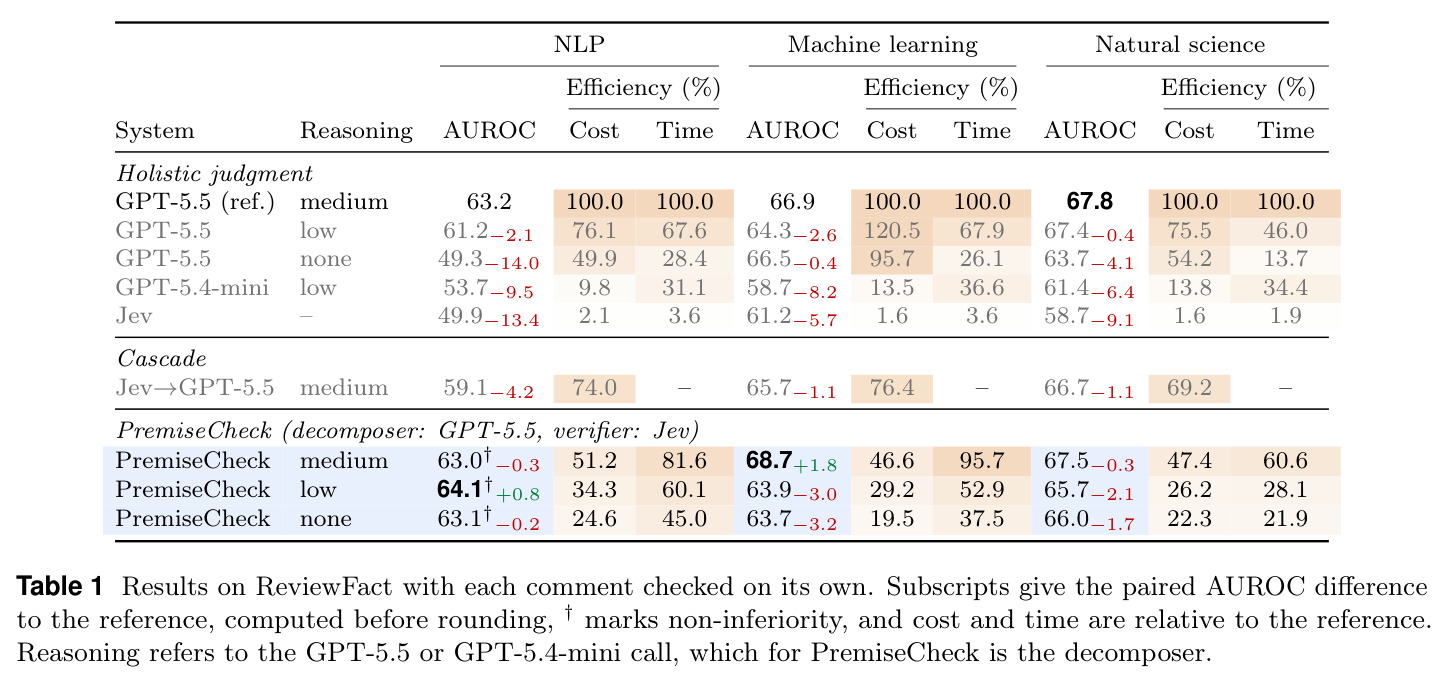
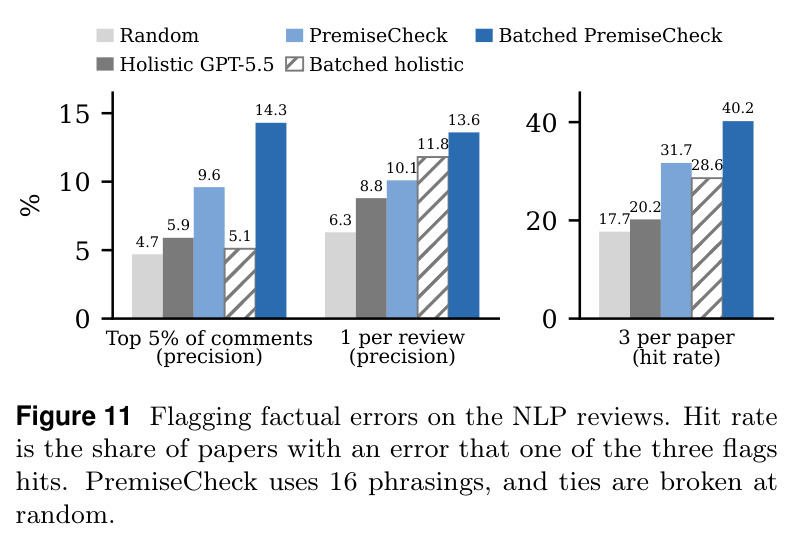
主实验(Table 1,每条评论独立核查)给出四个发现。(1) 精度与参照相当:以整体 GPT-5.5(medium reasoning,AUROC 63.2/66.9/67.8 对应 NLP/ML/科学)为参照,medium 分解器的 PremiseCheck 分别达到 63.0(−0.3,NLP 上非劣)、68.7(+1.8)、67.5(−0.3),成本为参照的 51.2%、46.6%、47.4%。(2) 关掉分解器推理更省:no-reasoning 版本在 NLP 上 63.1(−0.2,非劣)而成本仅 24.6%、延迟 45.0%;ML 和科学上分别 63.7(−3.2)与 66.0(−1.7),差异不显著。(3) 便宜基线全崩:整体 Jev 在 NLP 上仅 49.9,整体 GPT-5.5 无推理 49.3(−14.0)却仍花 49.9% 成本,级联 Jev→GPT-5.5 花 74% 成本仍比 PremiseCheck 低 4.2 点。鲁棒性上,Kev-27B 当验证器与 Jev 同水平,配无推理分解器非劣且 API 成本 17.8%;Nemotron Super 3、GPT-5.6 Sol/Luna、Claude Haiku 5.5、Ministral 3 当分解器配 Kev-27B 验证器,非劣于整体 GPT-5.5 的同时只花其整体判断的 6%–17%。实用设定(§8.1)里,批式整体 GPT-5.5 无推理达 67.8(成本 7.7%),批式 PremiseCheck 达 69.0(成本 20%),两者按百分位秩融合达 71.5(成本 28%),显著高于任一单系统。部署模拟(Figure 11)中,PremiseCheck 标记的最可疑 5% 评论精度 9.6%(基率 4.8%),是随机的 2 倍,而 AUROC 相近的整体 GPT-5.5 几乎不比随机好;读每篇论文 3 条最可疑评论可在 40% 的含错论文中命中(批式整体仅 29%),且每条标记附有被论文反驳的具体前提供人工速查。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| NLP 评审事实核查(ReviewFact,逐条评论) | AUROC(×100)与相对成本/延迟 | PremiseCheck(无推理分解器+Jev):63.1,成本 24.6%,延迟 45.0% | 整体 GPT-5.5(medium reasoning):63.2,成本 100%,延迟 100% | AUROC −0.2(非劣),成本省 75%,延迟省 55% |
| 机器学习评审事实核查(ReviewFact) | AUROC(×100) | PremiseCheck(medium 分解器):68.7,成本 46.6% | 整体 GPT-5.5(medium):66.9 | +1.8,成本省 53% |
| 自然科学评审事实核查(ReviewFact) | AUROC(×100) | PremiseCheck(medium 分解器):67.5,成本 47.4%,延迟 60.6% | 整体 GPT-5.5(medium):67.8 | −0.3(非劣),成本省 53% |
| NLP 评审:批式核查并融合两系统 | AUROC(×100) | 融合(PremiseCheck+整体 GPT-5.5):71.5,成本 28% | 批式整体 GPT-5.5(无推理):67.8,成本 7.7% | +3.7 且统计显著 |
| NLP:最可疑 5% 评论标记精度(错误基率 4.8%) | precision(%) | 9.6%(批式 10.1%),且给出被反驳的前提 | 整体 GPT-5.5:几乎不高于随机 4.8% | 约为随机的 2 倍;每篇论文读 3 条最可疑评论的命中率为 40% 对 29% |
局限与改进
作者承认的局限:任务只覆盖「对论文的事实错误」,不处理判断类错误(担忧是否重要、请求是否合理),而在 PeerReview Bench 与 ReviewScore 的混合标签上 PremiseCheck 显著落后于整体 GPT-5.5(PeerReview Bench 上显著,ReviewScore 上差距很大),说明它对标签定义敏感;主用决策模型 Jev 是闭源 API 服务,开源替代 Kev-27B 需自付 GPU 时间(medium 分解器下其置信区间略未达非劣);ReviewScore 部分因许可证限制只发布重建脚本而非数据。我的独立观察:其一,ReviewFact 继承三个原数据集的标注口径,且正样本极少(NLP 4.8%、科学 2.5%),AUROC 在 63 上下几点波动对实践的意义存疑,ML 部分 21.3% 的高错误率又源于只保留「论证型」评论的筛选,三个部分并不完全同质;其二,NLP 漏报中 40% 归因于标签本身可疑(其中 12/20 整体 GPT-5.5 也失败),说明基准上界受标注质量限制;其三,16 种验证措辞靠「无开发集可调」的先验固定,换一个决策模型未必同样受益;其四,成本对比全按 API 价目计算,自托管决策模型的 GPU 折旧未计入。
独立分析的弱点
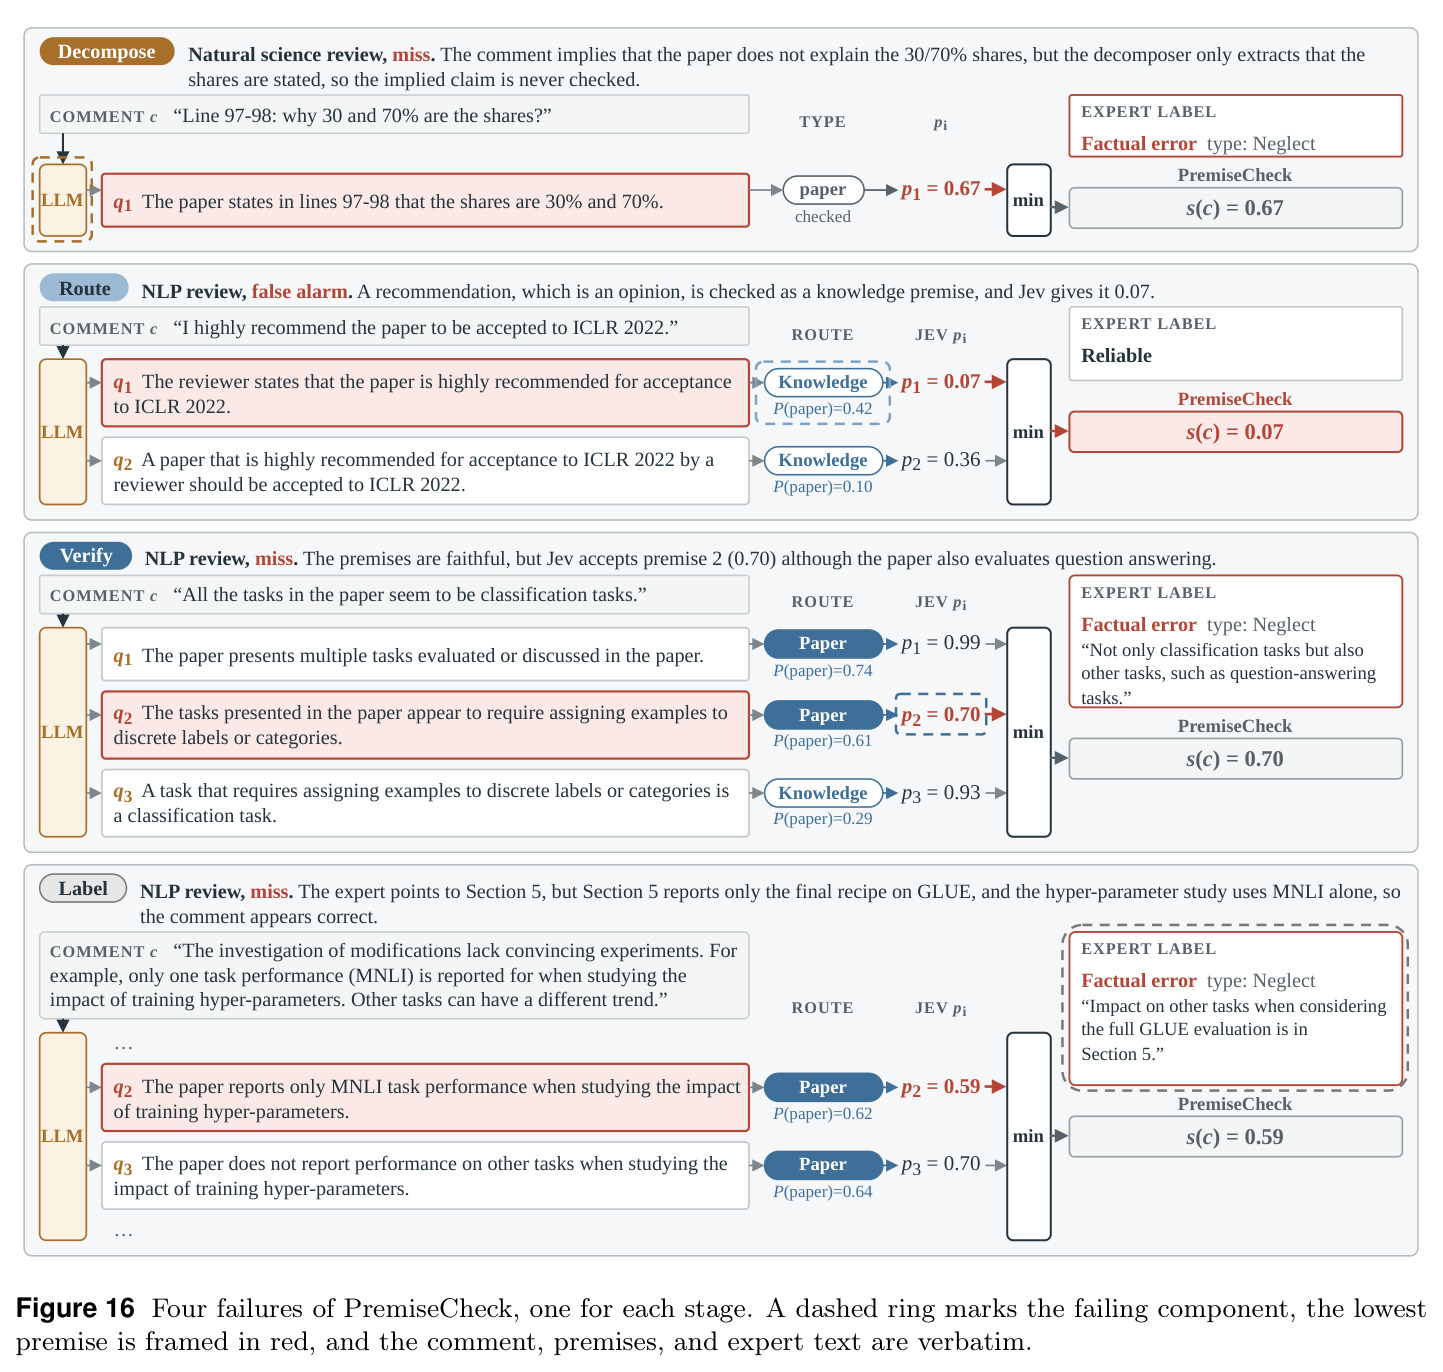
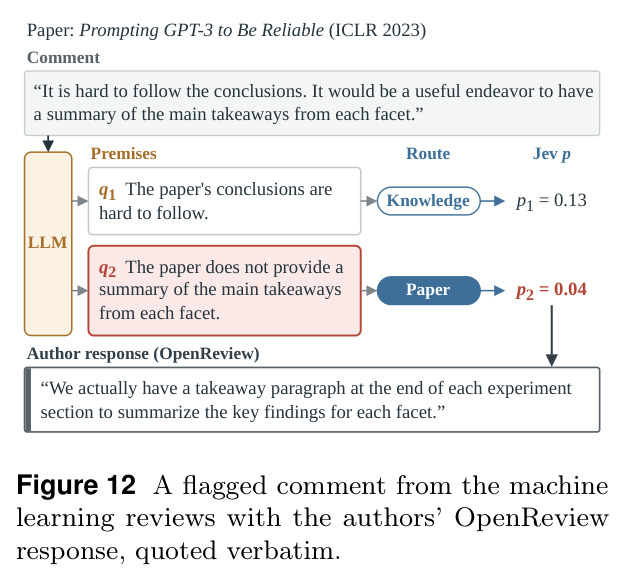
弱点一:分解器误报是最大短板。NLP 上 58% 的误报源于分解阶段添加、转移或模糊了评审者本意,而整体 GPT-5.5 只在这些误报中的 13% 上犯错——即它们大多是 PremiseCheck 特有的。这在「误报会让评审者蒙羞」的场景是实质风险。改进方向:让分解器为每条前提标注对评论原文的 span 对齐与显式/推断置信度,低对齐前提降权或只提示不扣分。弱点二:路由阈值 0.5 硬编码,Kev-27B 与 Jev 仅 65% 的路由一致虽未伤 AUROC,但在论文知识与通用知识边界模糊的交叉学科领域可能失灵;可改为对每条前提同时算论文问法与知识问法、按路由概率 $r_i$ 加权融合。弱点三:min 聚合把任何一条假前提放大为整条评论错误,误报随评论长度和前提数上升,对多断言长评论不公平;可按前提数做显著性校正,或输出「最可疑前提」排序供人快速复核(后者论文已部分实现于 Figure 12)。弱点四:推理问句工程(16 种措辞)依赖 Jev「只按输入计费」这一计费特性,对按输出计费或生成式验证器不再免费;换用其他决策模型时需重新做消融。弱点五:基准仅 217 篇论文,多个结论(如 Kev-27B medium 分解器)恰好落在非劣边界附近,换个种子可能翻转。
未来方向
作者提出的方向:改进分解器使其更贴近评审者原话(针对占 58% 的分解误报);把判断类错误(担忧重要性、创新性、请求合理性)纳入检测,这需要与事实核查不同的方法;在同一框架下继续测试更多开源决策模型。我认为可延伸的:其一,把 PremiseCheck 反转成写作辅助——评审者敲下每条评论时实时提示「这条评论的某前提与论文矛盾」,论文的逐条设定已为此铺路,延迟 2.8 秒也够用;其二,百分位秩融合的思路可推广到更多异构核查器(不同决策模型、批式整体判断、作者 rebuttal 信号、引用检查器)的集成, Fisher 类组合或学习型融合预计还能再涨;其三,ReviewFact 已含 AI 评论语料(NLP 上 AI 评论错误率 7.4% 高于人写的 4.6%),可作为评测床定量回答「AI 评审是否更不实」以及各 LLM 生成评审的忠实度排名;其四,针对分解误报,可用小规模人工校准集训练轻量「前提忠实度」过滤器,成本远低于升级分解器。
复现评估
复现条件较好。代码以 MIT 许可开源在 GitHub(OpenLAIR/PremiseCheck);ReviewFact 的 NLP 与自然科学部分分别按 ReviewCritique、PeerReview Bench 的许可发布(仅限评估、禁止训练),机器学习部分因 ReviewScore 未声明许可而只提供从原始数据重建的脚本。算力门槛低:默认配置只需 GPT-5.5 与 Jev 两个 API(版本固定为 gpt-5.5-2026-04-23 与 jev-1.13-20260917),NLP 上全部决策模型调用合计每条评论约 0.0015 美元,复现主表约数千条评论、每条一次分解加若干次决策调用,预算估计几十美元量级;复现开源路线需自托管 Kev-27B,单机多卡即可。难点在细节对齐:24k token 截断、路由阈值 0.5、16 种问句的具体措辞、bootstrap 2,000 次论文级重采样、−3 非劣边界,任何一处不同都可能让 AUROC 差零点几;此外 LLM API 迭代可能造成漂移,好在数据与提示词都会公开。总体评级:中低难度,熟悉 API 调用与统计检验的工程师一两周可复现主结果。
论文图表
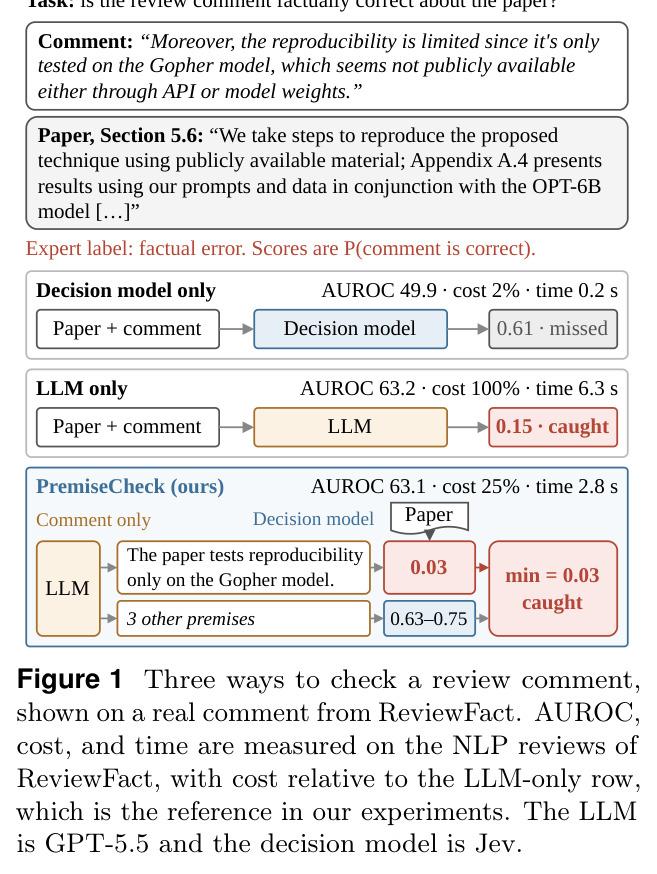
用一条真实评论(声称「复现性受限,因为只在 Gopher 模型上测试且不可获得」,而论文实际用公开的 OPT-6B 复现了结果)并排对比三种核查方式:只用决策模型(AUROC 49.9、成本 2%、0.2 秒)抓不住错误;只用 LLM(63.2、成本 100%、6.3 秒)抓到了但太贵;PremiseCheck(63.1、成本 25%、2.8 秒)用同样的精度抓住了错误。
一张图讲清全文的核心权衡——「要么准确要么便宜」的困境与本文的解法,是理解论文动机的最快入口。
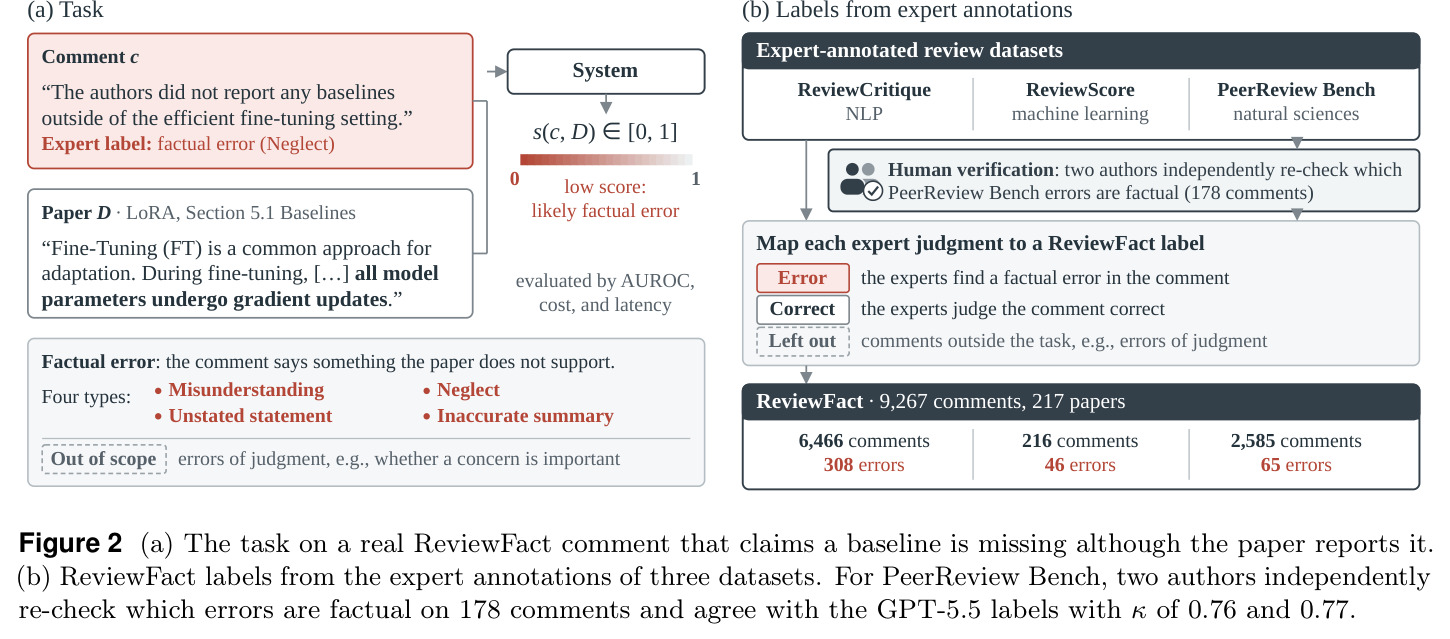
左半定义任务:输入论文和评论,系统输出 $s(c, D) \in [0,1]$,低分代表可能有事实错误,并展示「声称没有基线但论文 5.1 节报告了」的真实例子与四类错误。右半展示 ReviewFact 如何从三个专家标注数据集(ReviewCritique、ReviewScore、PeerReview Bench)映射标签,共 9,267 条评论、217 篇论文,PeerReview Bench 部分由两位作者独立复核 178 条(与 GPT-5.5 标签的 κ 为 0.76 和 0.77)。
同时交代任务形式化与基准构建方式,是理解「事实错误」定义和实验数据来源的关键。
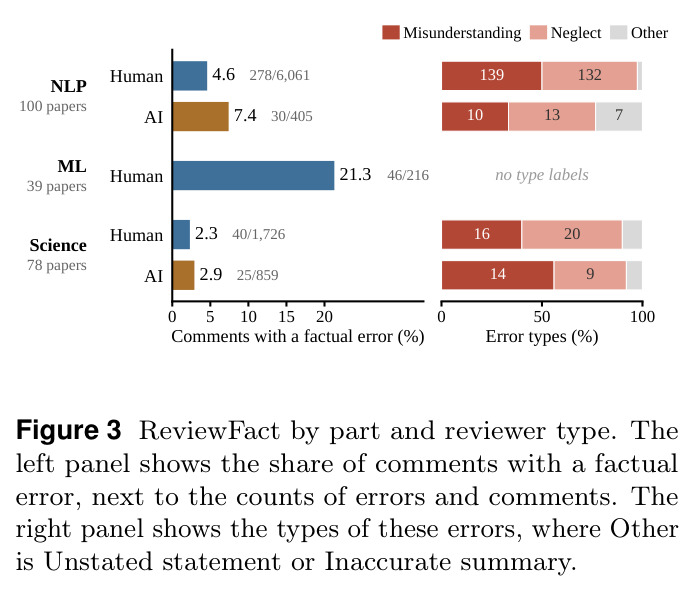
按领域和评审者类型统计基准:NLP 人类评论错误率 4.6%(278/6,061)、AI 评论 7.4%(30/405);ML 人类评论 21.3%(46/216,因只保留论证型评论);自然科学人类 2.3%(40/1,726)、AI 2.9%(15/859)。右半显示错误类型分布,误解与忽视占绝大多数;中位评论长度 17/48/70 词,中位论文长度 8.5k/9.1k/14.4k token。
说明「错误稀少、评论短、论文长」这一结构性事实——正是它让成本成为一级指标,也让「AI 评论错误率高于人类」成为可讨论的发现。
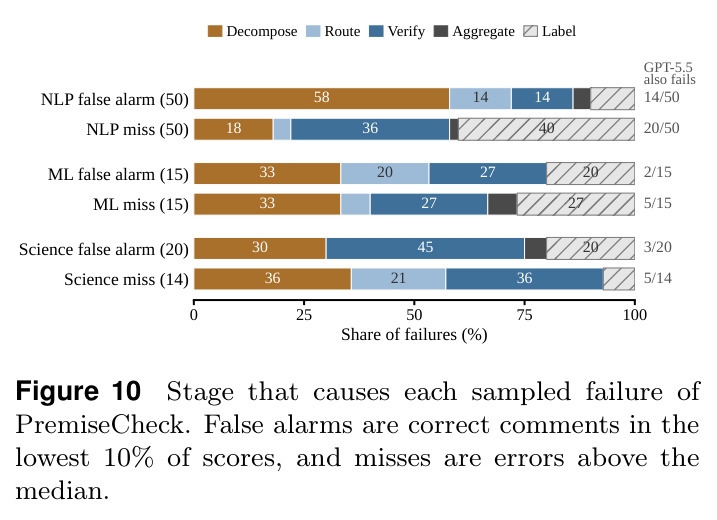
三位标注者把 164 个抽样失败归因到流水线阶段:NLP 误报 58% 源于分解、ML 误报 33% 源于分解、自然科学误报 45% 源于验证;NLP 漏报中 40% 归于可疑标签、36% 归于验证,且整体 GPT-5.5 仅在 13%(ML)与 15%(科学)的误报上也失败,在 20 条可疑标签评论上失败 12 条。
诚实的失败归因分析,指出改进应优先投向分解器,也揭示了基准标签本身的噪声上限。