Intern Lumina U2:面向全视觉理解与图像生成的多码本扩散大语言模型 Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
首个在完全离散空间用多码本视觉token统一图像/视频/3D理解与图像生成编辑的扩散语言模型
前置知识
掩码扩散语言模型(Masked Diffusion LM)
与自回归模型从左到右逐 token 生成不同,掩码扩散 LM 训练时随机把部分 token 替换成 $\langle|mask|\rangle$,让模型在双向注意力下预测被掩码位置的原始 token(类似 BERT 的 MLM 但按余弦调度控制掩码比例);推理时从全掩码序列出发,每步采样并按置信度提交一部分位置,迭代去噪直到补全。文本可用块扩散:序列分成块,块内并行去噪、块间从左到右,已完成块的 KV cache 可复用。
本文骨干 LLaDA2.0-mini 就是块扩散 LM,文本、视觉统一在同一掩码预测交叉熵目标下训练,理解这一范式是读懂架构设计和训练目标的前提。
视觉 tokenizer 与 FSQ 量化
视觉 tokenizer 把像素压缩成离散 token 序列供语言模型处理。VQGAN 用向量量化码本做重建但缺乏语义;SigLIP 等语义编码器对齐语言却无法重建像素。有限标量量化(FSQ)不靠码本最近邻查找,而是把每个 latent 维度量化到固定的有限标量集上,训练稳定且码本利用率高。本文用的 AToken 从 SigLIP2 初始化,联合重建与理解目标训练,把图像/视频/3D 编码进统一 4D 潜空间。
AToken 是本文的视觉接口,其多码本离散输出直接决定了多码本建模的输入格式;理解 tokenizer 的语义+重建双重属性才能明白为何单一模型能兼顾理解和生成。
多码本表示与深度解码(depth decoding)
为提升单个空间位置的表示容量,用一个位置携带 $K$ 个来自互补码本的码(本文 $K=8$、每码本 4096 词条),组合容量 $4096^8$ 远超单码。RQ-Transformer 和 VILA-U 证明可以加一个小的深度 Transformer 沿码本维度自回归解码(类似残差量化的从粗到细),从而在不拉长空间序列的前提下承载更多信息;TokenBridge 则指出若各码独立预测会丢失依赖。
本文的核心贡献就是把多码本视觉状态第一次引入掩码扩散 LM:空间维度交给扩散骨干并行细化、码本维度交给轻量 AR 头顺序建模,这是全文方法部分的骨架。
MoE 稀疏激活与负载均衡
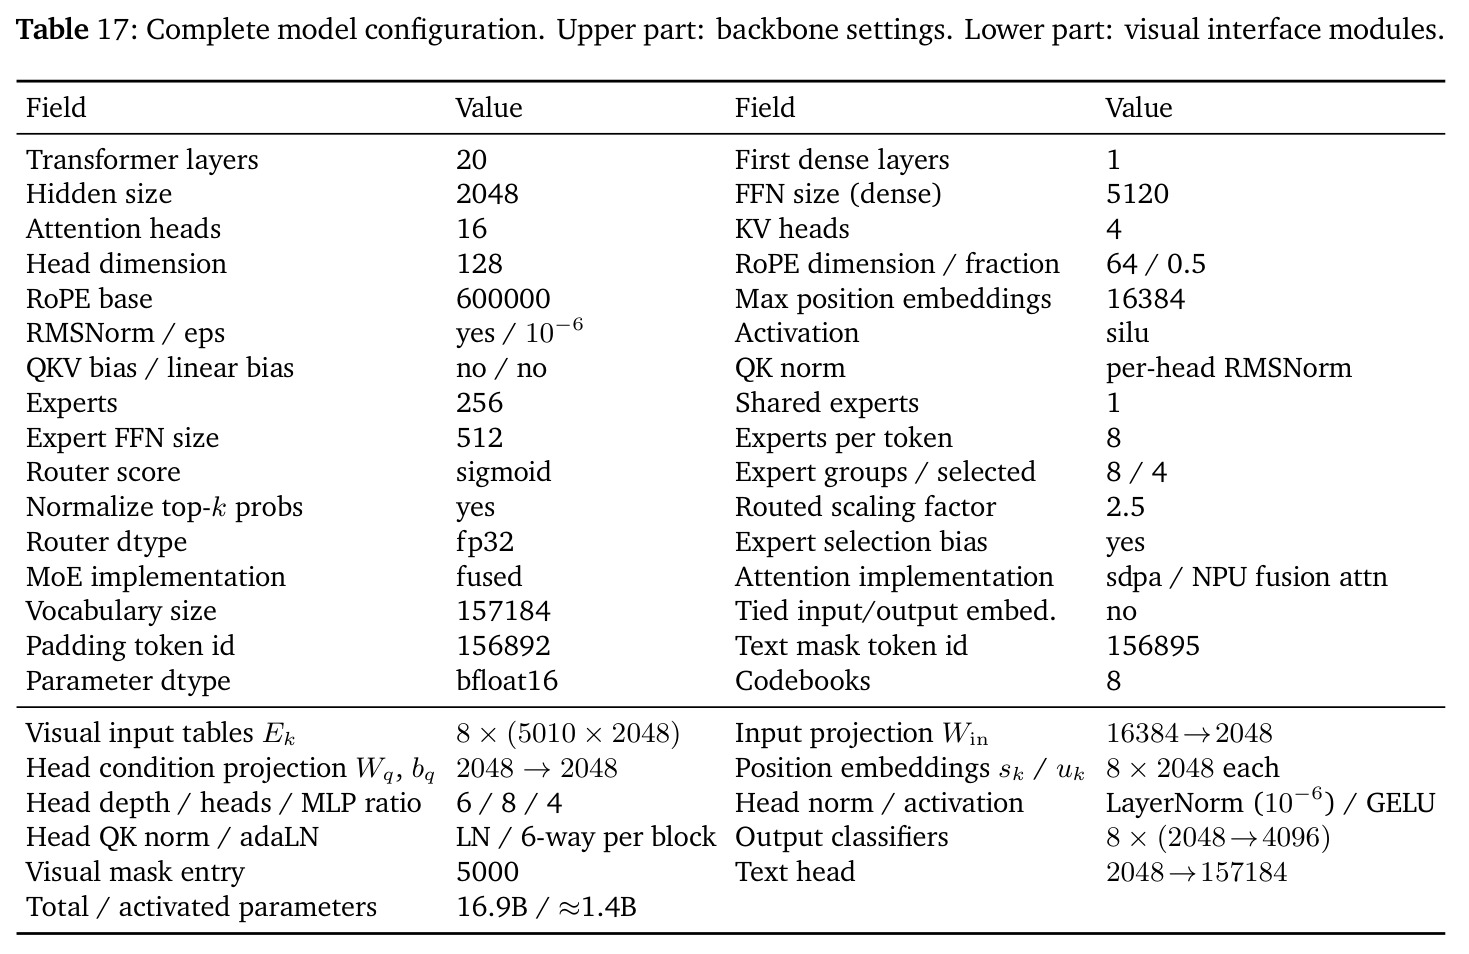
混合专家(MoE)层为每个 token 只路由到少数专家(本文 256 选 8 加 1 个共享专家),使总参数 16B 但每 token 仅激活 1.4B。专家负载不均会导致部分专家过拟合、其余浪费,常用可微负载均衡损失约束;DeepSeek-V3 的 auxiliary-loss-free 方案则给每个专家维护一个只影响路由打分、不进梯度的偏置项,超载就调低、闲置就调高。
本文骨干是 MoE,总损失中包含权重 $10^{-3}$ 的均衡损失加辅助无损偏置调节;理解 MoE 才能读懂训练稳定性设计和 1.4B 激活参数的高效性来源。
无分类器引导(CFG)
扩散类生成模型的推理技巧:同时用有条件和无条件(空提示)两个分支各做一次前向,输出按 $(1+w)\,h_{cond} - w\,h_{uncond}$ 融合,引导权重 $w$ 越大生成越贴合提示但多样性下降。训练时以一定概率(本文 0.1)把条件替换成 $\langle uncondition\rangle$ token,让同一模型学会无条件分支,无需单独训练。
本文图像生成推理时对骨干隐藏状态做 CFG(Algorithm 2 第 4 步),且 CFG 双分支合批是 4.45 倍加速链条中的第一环,不熟悉 CFG 会看不懂推理算法和加速实验。
研究动机
统一多模态模型目前分裂成三条路线,各自卡在『表示容量』与『优化一致性』的跷跷板上。第一条是离散单码本路线(Chameleon、Emu3、MMaDA、Lumina-DiMOO):文本和视觉都用离散 token、同一 next-token 或掩码预测目标,优化天然一致,但每个空间位置的信息被压缩成一个离散码——论文明确指出这种紧凑表示既不足以忠实重建图像细节,也不足以覆盖全部视觉任务,直接限制了生成保真度和细粒度理解(如 OCR、图表)。第二条是连续/混合路线(Transfusion、UniFluid、BAGEL、InternVL-U、LLaDA2.0-Uni):在骨干内保留连续视觉状态、把合成外包给连续扩散/流解码器,视觉保真度高,但视觉生成由一个与文本 token 分类完全不同的连续目标优化,且理解与生成往往使用两套分离的视觉编码器(例如 BAGEL 用 ViT 特征做理解、在 VAE 空间跑流匹配做生成),两种目标、两个表示空间并存会引入模态间的优化冲突。第三条混合式(LLaDA2.0-Uni)骨干内虽共享掩码预测目标,但仍需要额外的连续扩散解码器把语义 token 变成像素。于是核心矛盾浮现:如何在单一骨干、单一目标的共享优化空间里,同时承载高容量视觉表示和文本内容?
本文的目标是本文的目标是构建一个『全视觉』统一基础模型 Intern Lumina U2:其一,文本与视觉映射进同一离散空间、在同一个掩码预测交叉熵目标下联合训练,彻底消除连续/混合路线的目标分裂;其二,通过多码本视觉 token(每个空间位置携带 $K=8$ 个互补码本中的码)突破单码本离散表示的容量瓶颈,同时保持骨干序列长度与 $K$ 无关;其三,生成过程尊重模态内在结构——文本按块顺序解码、视觉在全画布上双向并行细化,不施加固定的生成顺序;其四,单一骨干+单一 AToken 接口同时支持图像、视频、3D 资产的理解以及图像生成与编辑;其五,在 1,024 卡昇腾 910B NPU 上完成训练、推理、评测的全栈适配,并用一条小规模 NVIDIA 参考线验证配方跨平台可迁移,同时通过训练免费的 PHV 采样策略把 1024×1024 图像生成端到端延迟压缩 4.45 倍。
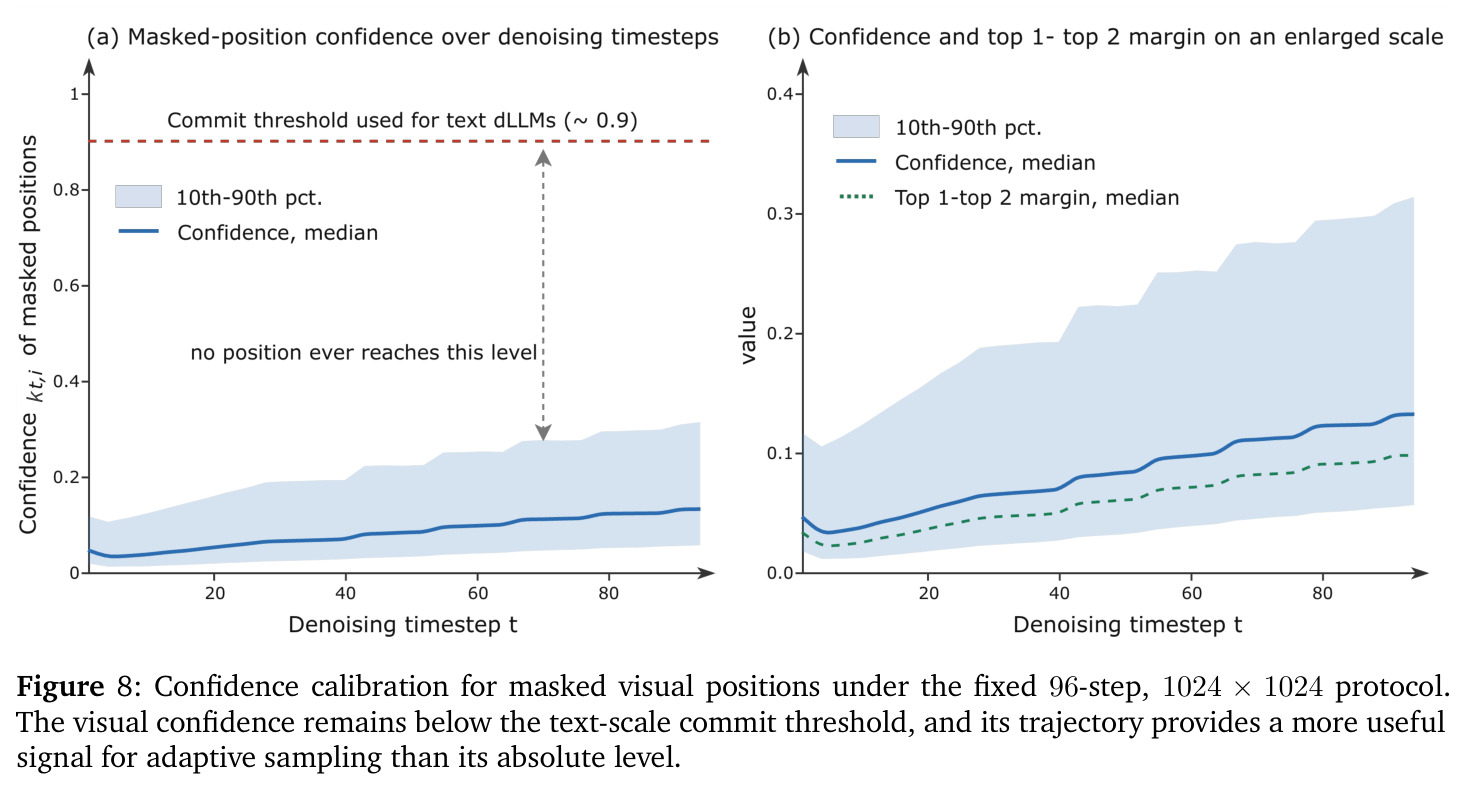
与已有工作不同的是,本文的独特切入是把『多码本视觉表示』从自回归世界搬进掩码扩散世界。多码本深度解码已被 RQ-Transformer、VILA-U、UniTok 在 AR 统一模型中验证过,TokenBridge 也记录了各码独立预测会丢失依赖,但没有任何工作把多码本视觉状态当作扩散语言模型的骨干 token:本文让扩散骨干并行细化空间位置、由一个 6 层轻量因果 Transformer 沿码本维度自回归建模位置内依赖,从而做到序列长度与 $K$ 无关、又不把各码本当作条件独立。第二个被忽视的角度是推理加速的『校准』问题:现有 Fast-dLLM 式提交规则依赖绝对置信度阈值,而作者实测视觉 token 置信度极低且增长缓慢(96 步内中位数仅从 0.046 升到 0.127、90 分位不超过 0.32),绝对阈值根本不适用——这促使他们改用时间信号(置信度平台期、隐藏状态漂移)驱动提交与缓存刷新。第三个差异点是工程完整性:首个在昇腾 NPU 上全栈训练/推理/评测此类模型并给出 NVIDIA 对照组的工作。
核心方法
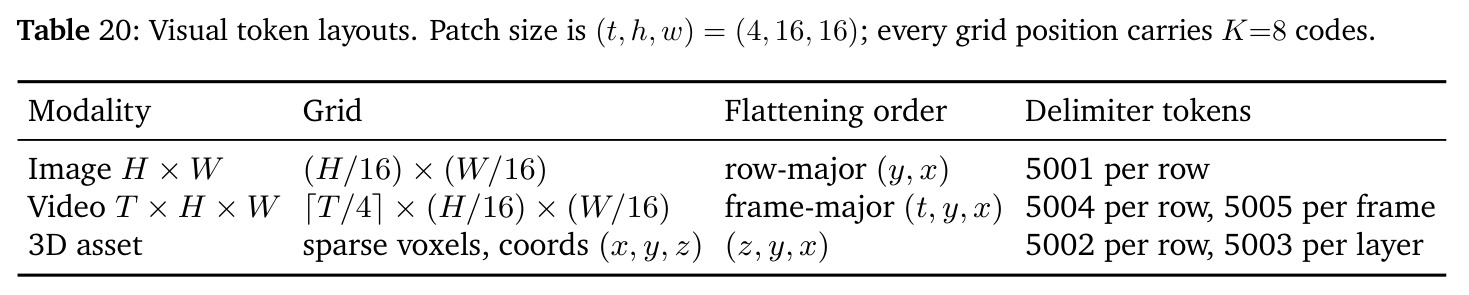
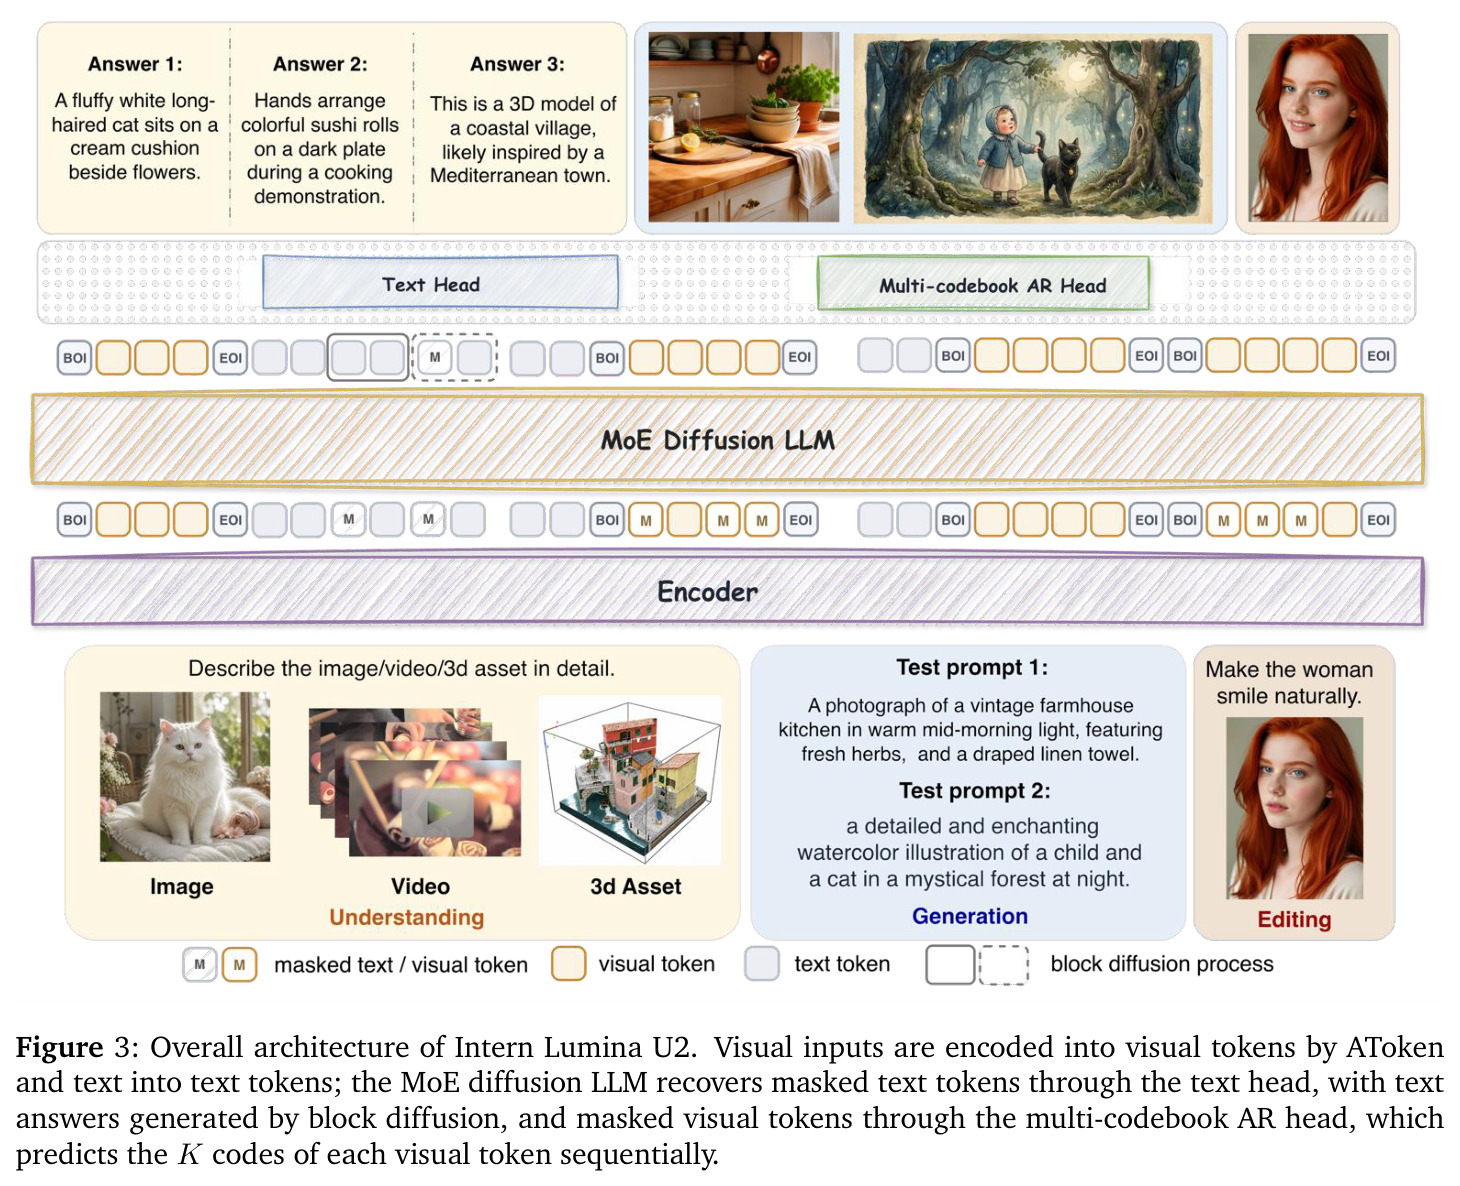
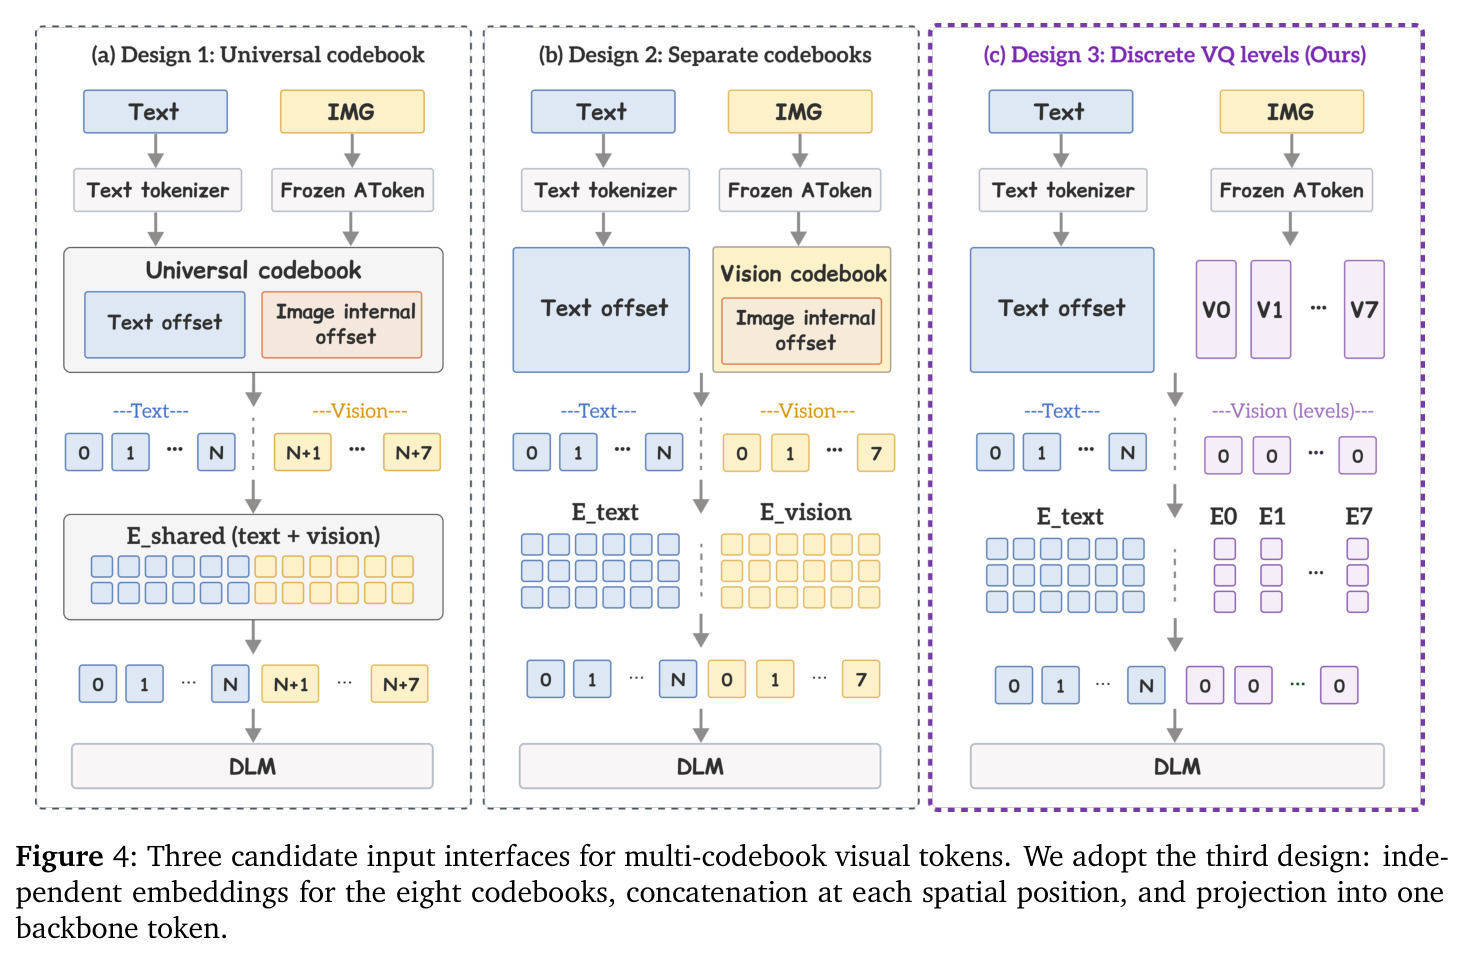
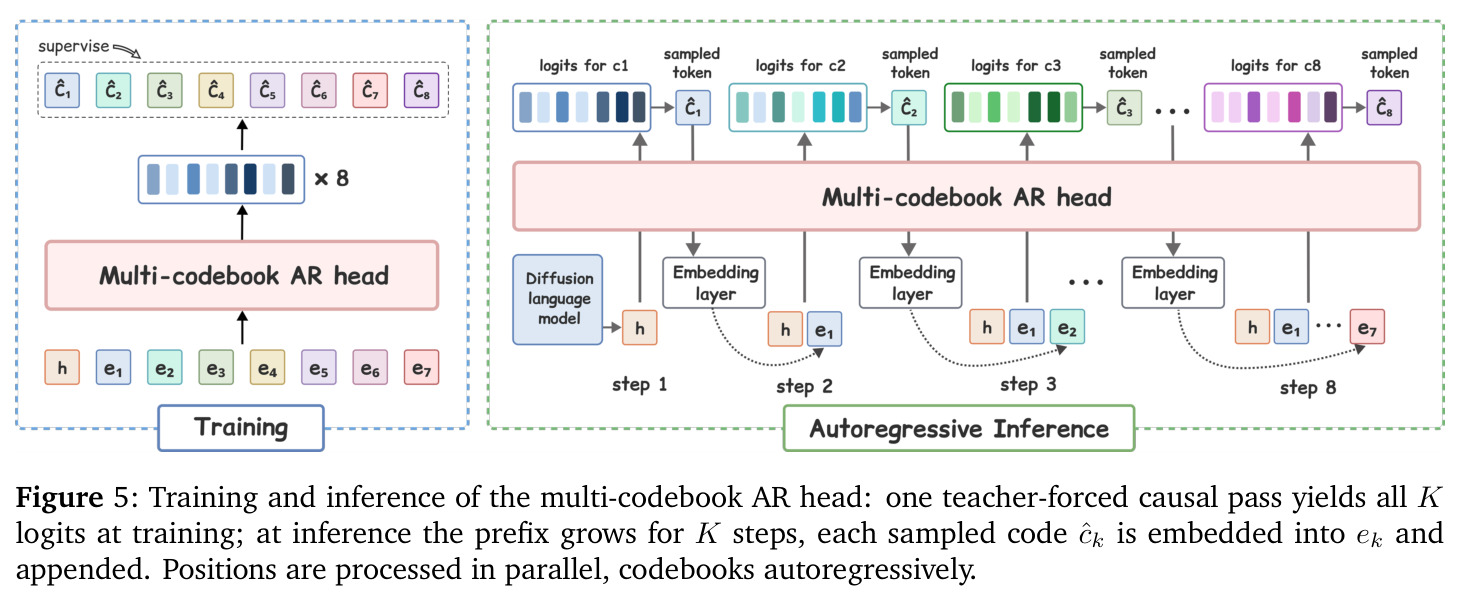
直觉上,本文把每个视觉位置从『一个字』升级成『8 个字的词组』,但对骨干来说它仍然只是一个 token。具体技术路线分四层。表示层:冻结的 AToken 把图像、视频、3D 资产统一编码成 4D 网格,每个位置经 FSQ 量化为 $K=8$ 个码、每码本 4096 词条;骨干层:LLaDA2.0-mini,总参数 16B、每 token 激活 1.4B 的 MoE(20 层 Transformer,第 1 层 dense FFN、其余 19 层各含 256 个路由专家+1 共享专家,每 token 激活 8 个路由专家),文本按块扩散生成;接口层:输入端每个位置的 8 个码各查一张独立嵌入表后拼接、经 $W_{in}\in\mathbb{R}^{d\times Kd}$($d=2048$)投影成一个骨干向量,输出端一个 6 层因果 Transformer(multi-codebook AR head)沿码本维自回归预测 8 个码,总新增参数仅 0.65B;数据层:所有任务统一成对话式打包序列,配合任务感知注意力掩码和同一掩码预测交叉熵目标联合训练。推理时图像在全画布上迭代并行去噪、每个位置的 8 个码顺序采样,最后由 AToken 解码回像素。
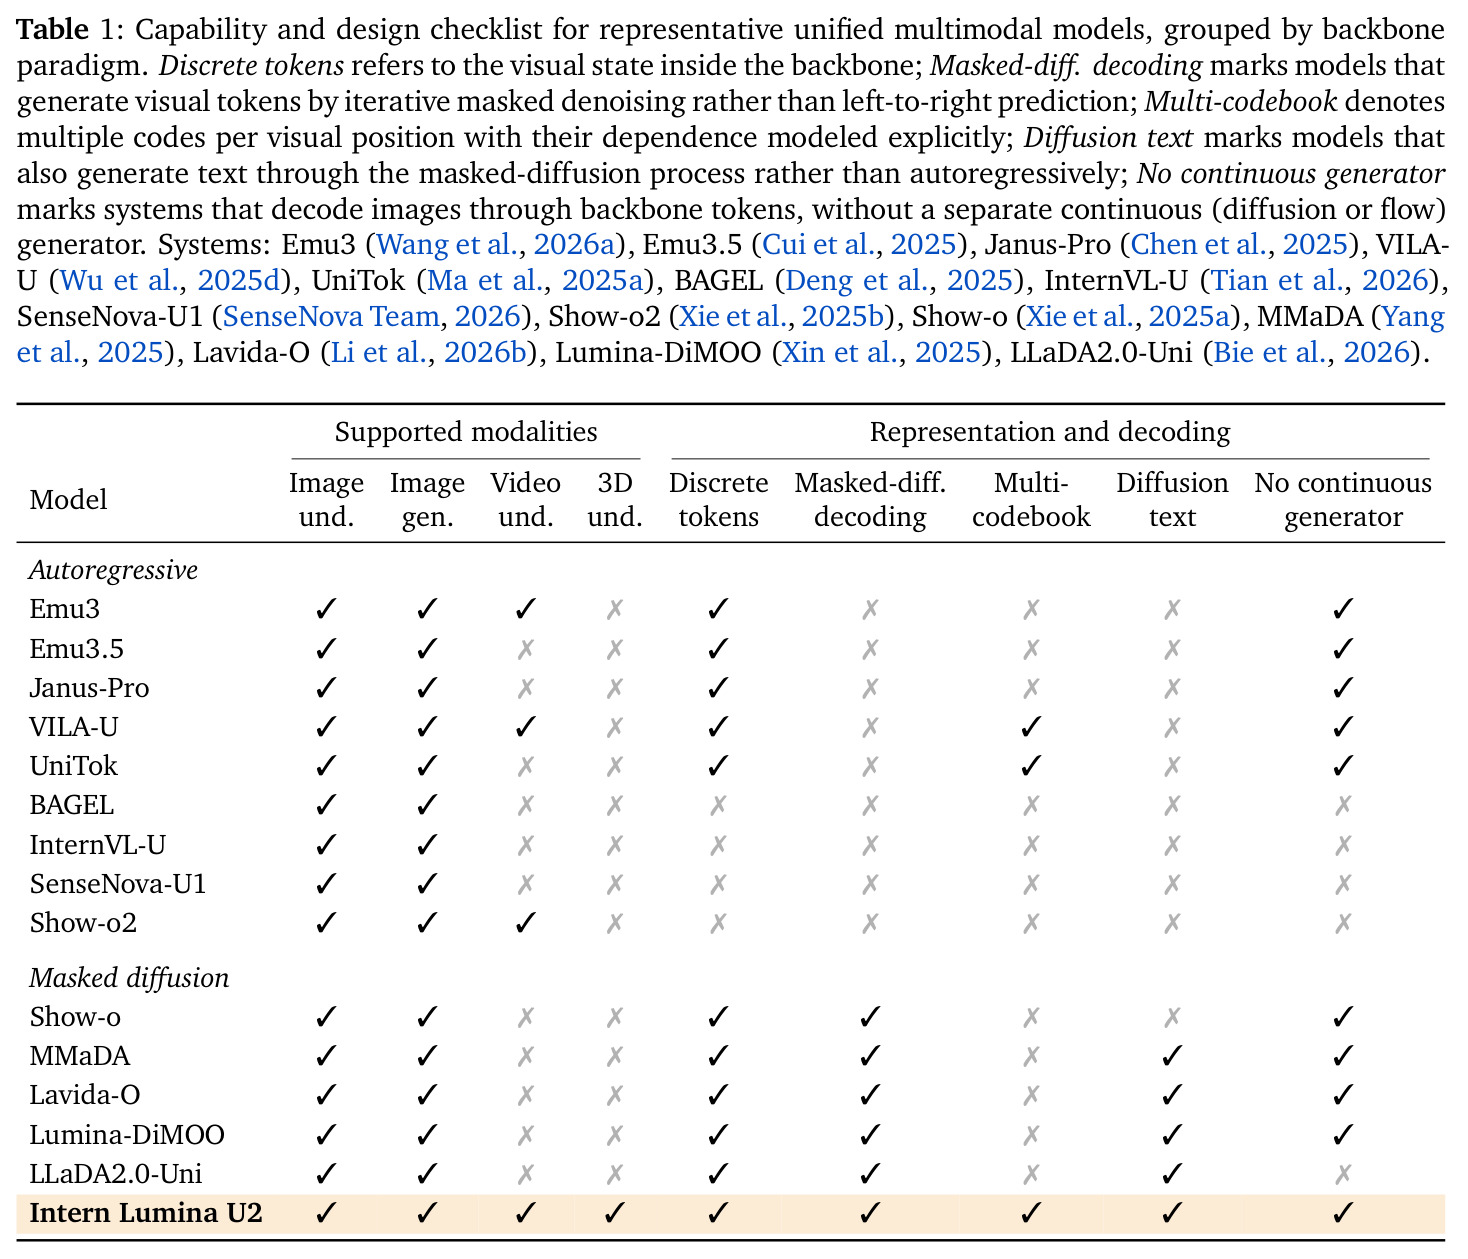
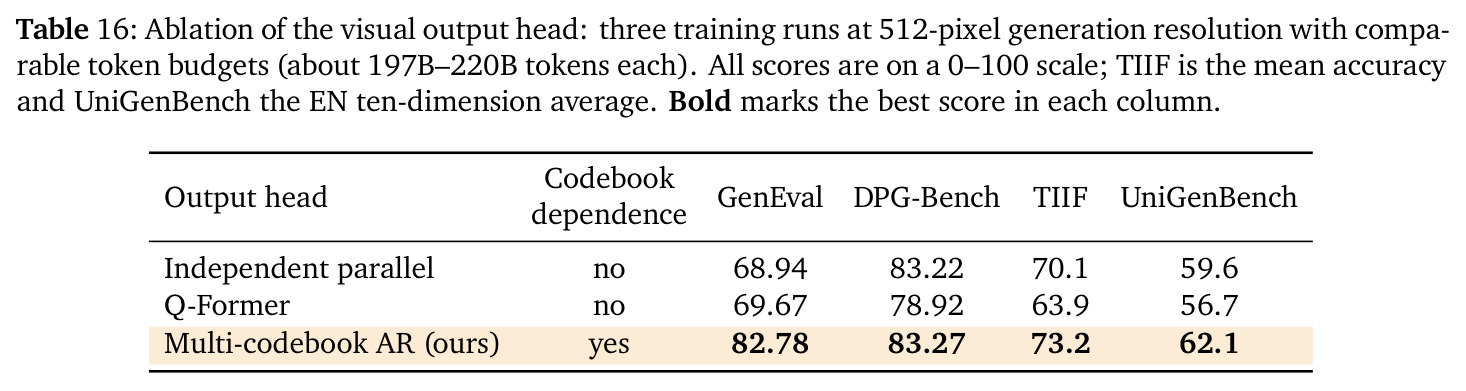
核心创新点是把视觉状态的容量升级完全限制在离散空间内部,靠『空间-码本双重分解』化解矛盾。与已有方法的本质区别有三点。第一,对比离散单码本模型(MMaDA、Lumina-DiMOO):本文每个视觉位置携带 8 个互补码本的码,表示容量指数级提升,但骨干序列长度不变——因为输入端 8 个嵌入被合并成一个 token。第二,对比连续/混合模型(BAGEL、LLaDA2.0-Uni):本文不需要任何连续扩散或流解码器,图像直接由骨干 token 经 AToken 解码器还原,文本和视觉在同一个掩码预测目标下优化,这也是 Table 1 能力清单中唯一同时勾选『多码本、扩散文本、无连续生成器、视频/3D 理解』的系统。第三,位置内 8 个码的联合分布被链式法则分解为 $p(c\mid h)=\prod_{k=1}^{K} p(c_k\mid h, c_{<k})$,parallel head 只是它丢弃 $c_{<k}$ 条件后的特例——因此理想条件下 AR 头的交叉熵永远不会高于独立并行头,消融实验证实这一点:AR 头 GenEval 82.78 对并行头 68.94,差距集中在计数、位置、属性绑定这类需要精确组合的任务上。空间维度交给扩散、码本维度交给 AR,两个维度的依赖建模各得其所。
方法步骤详情
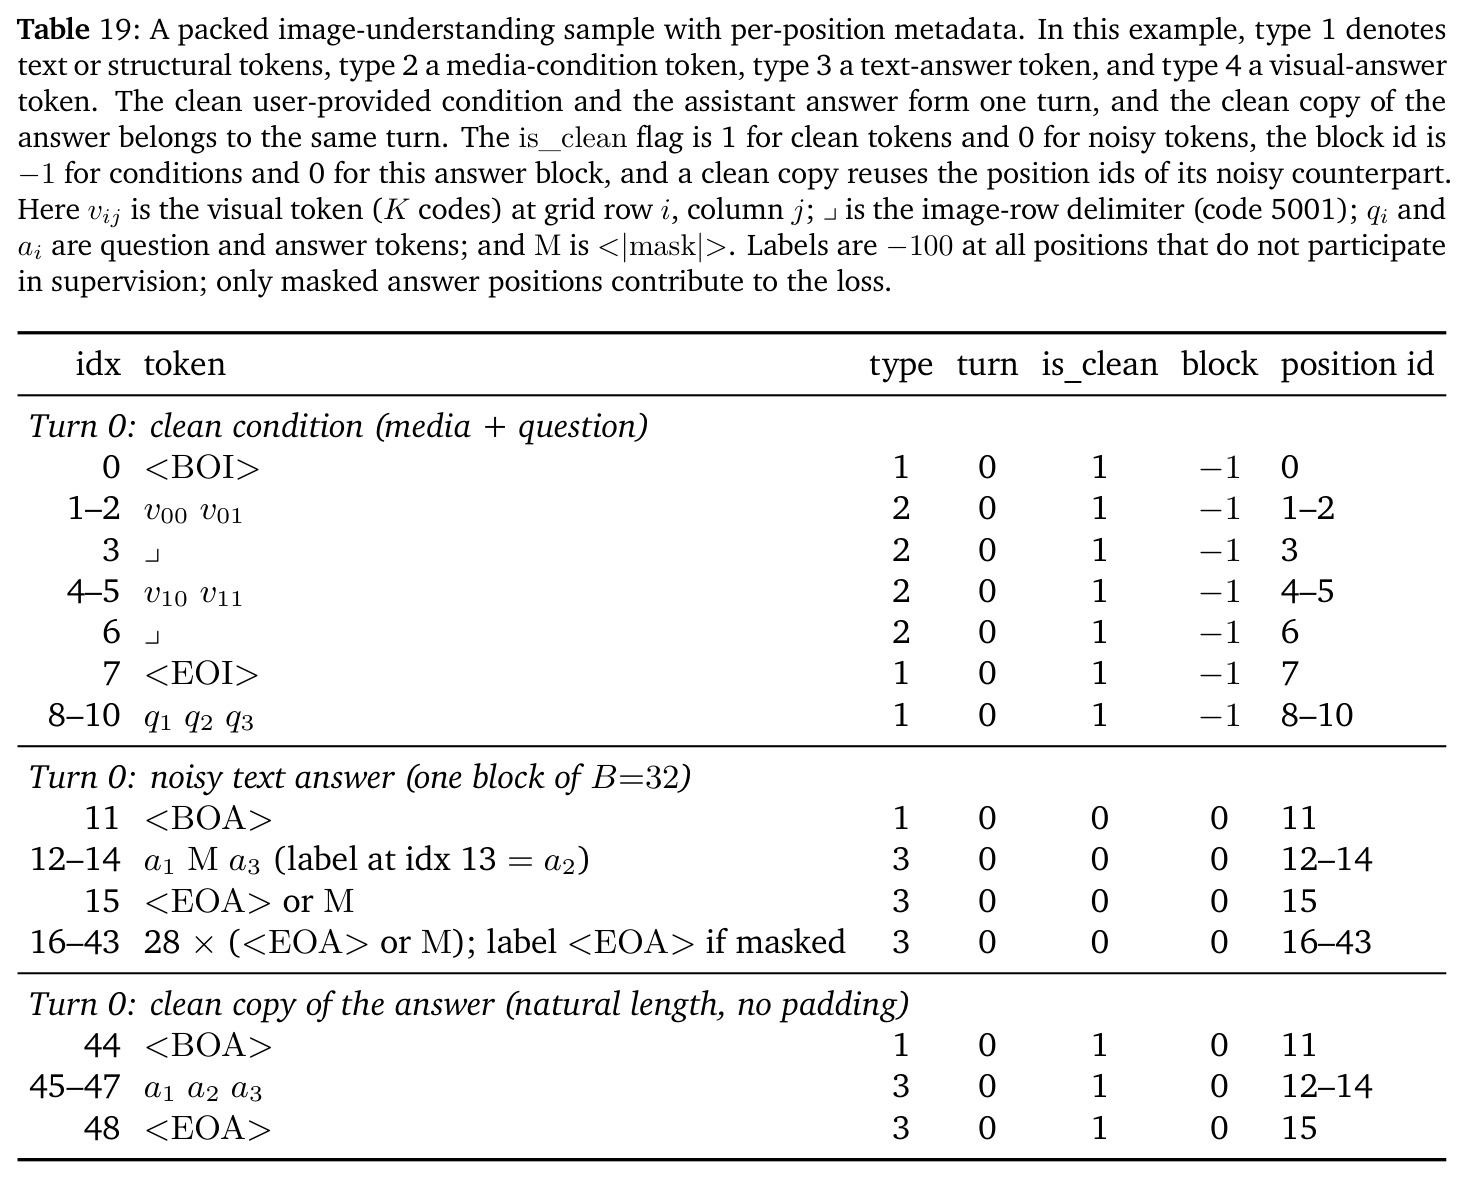
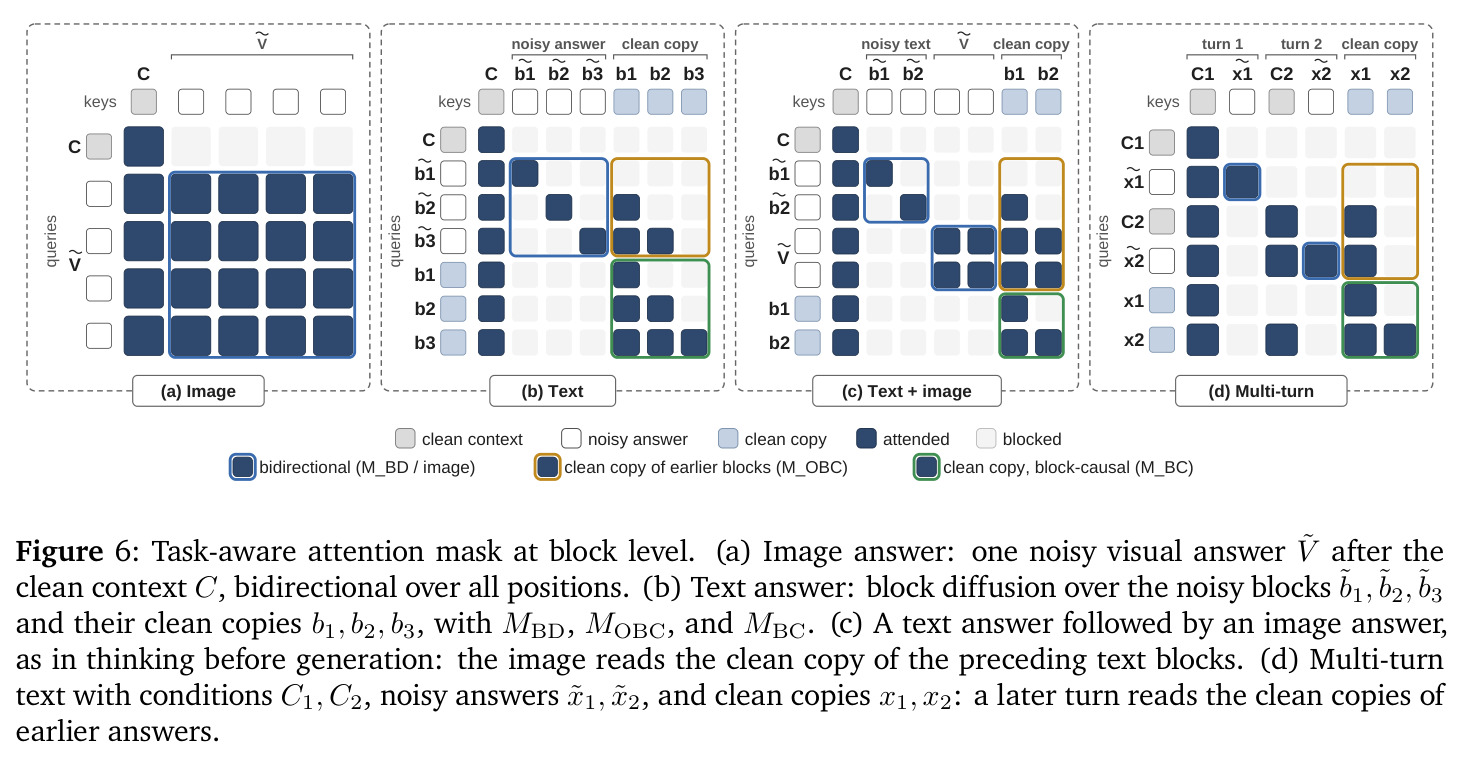
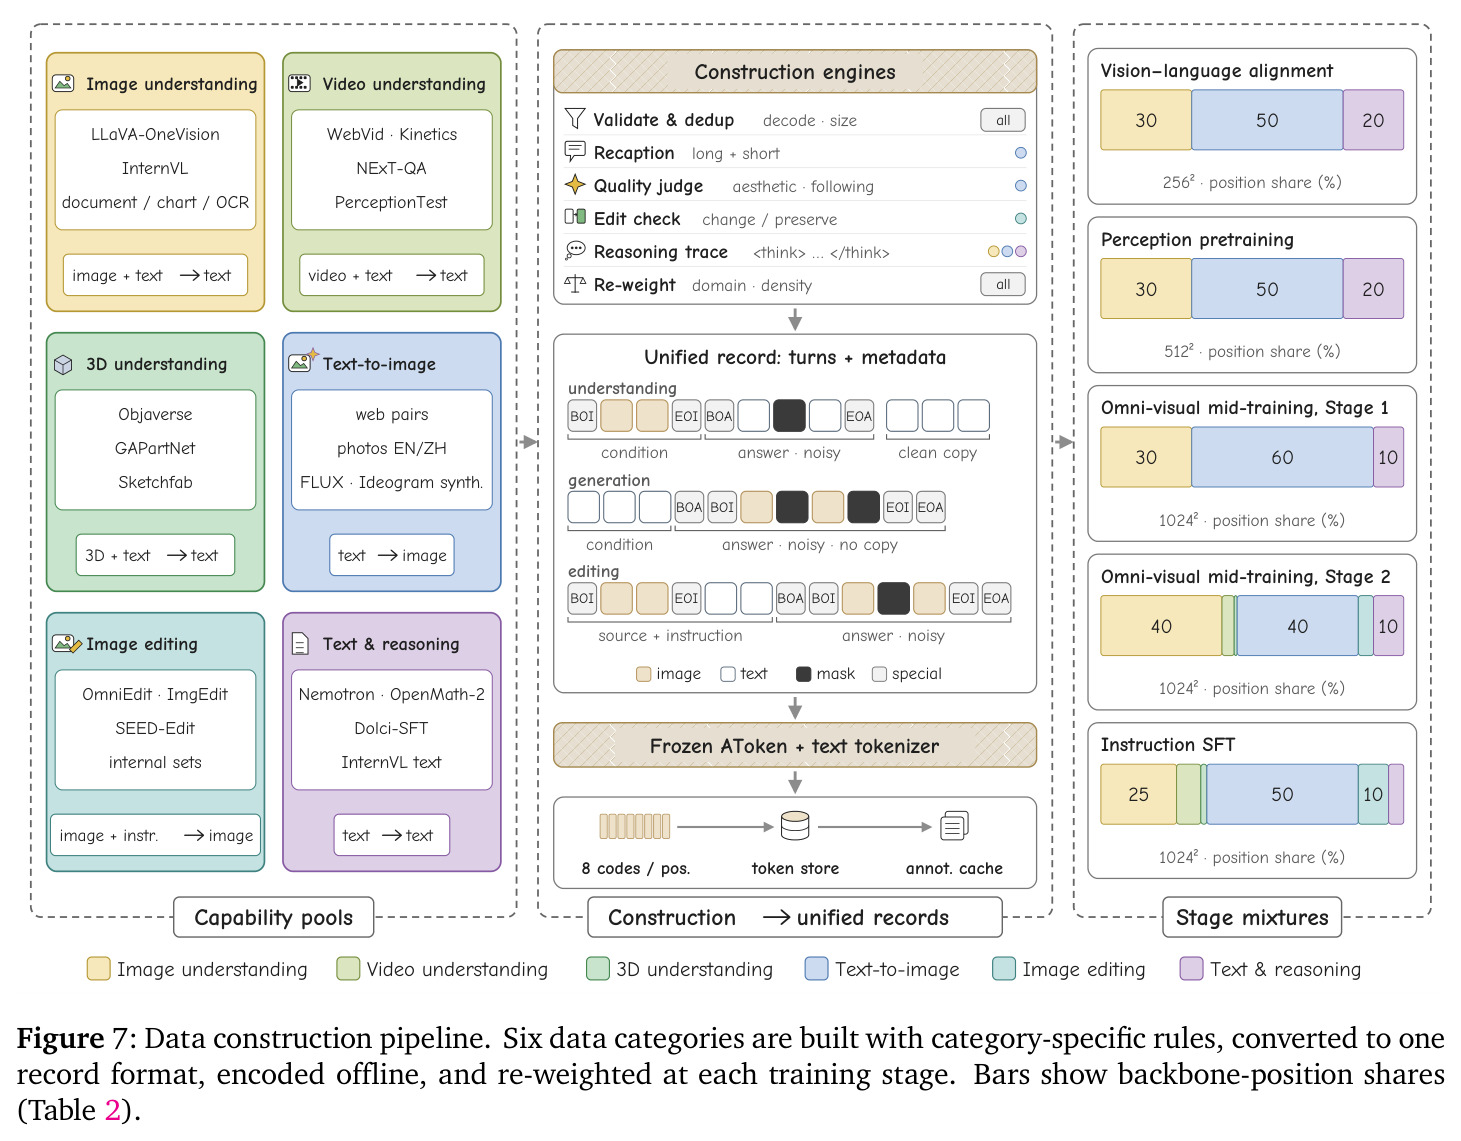
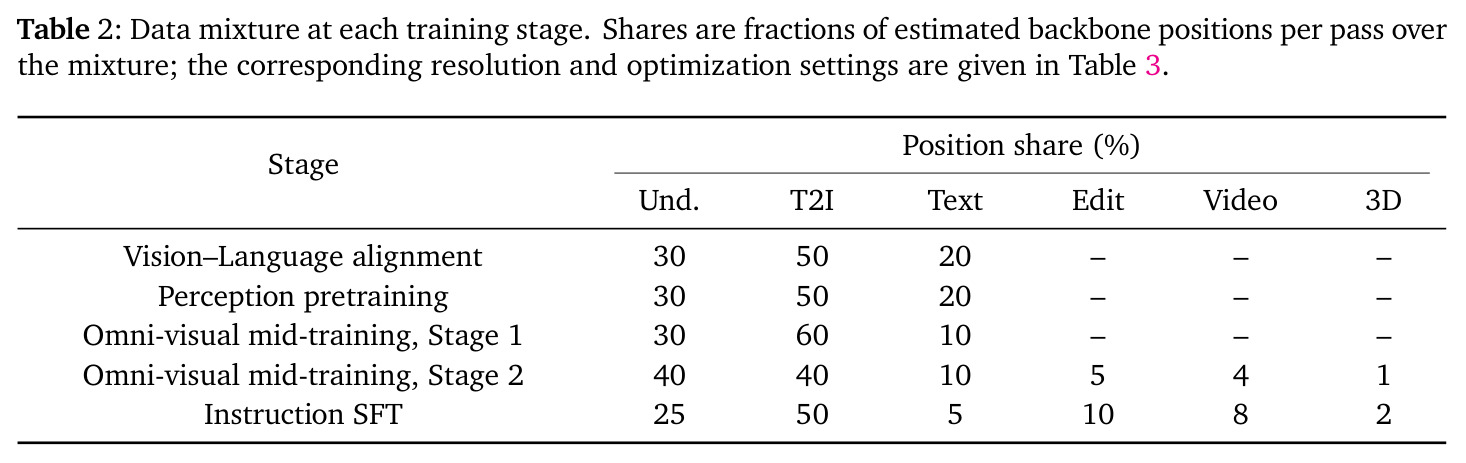
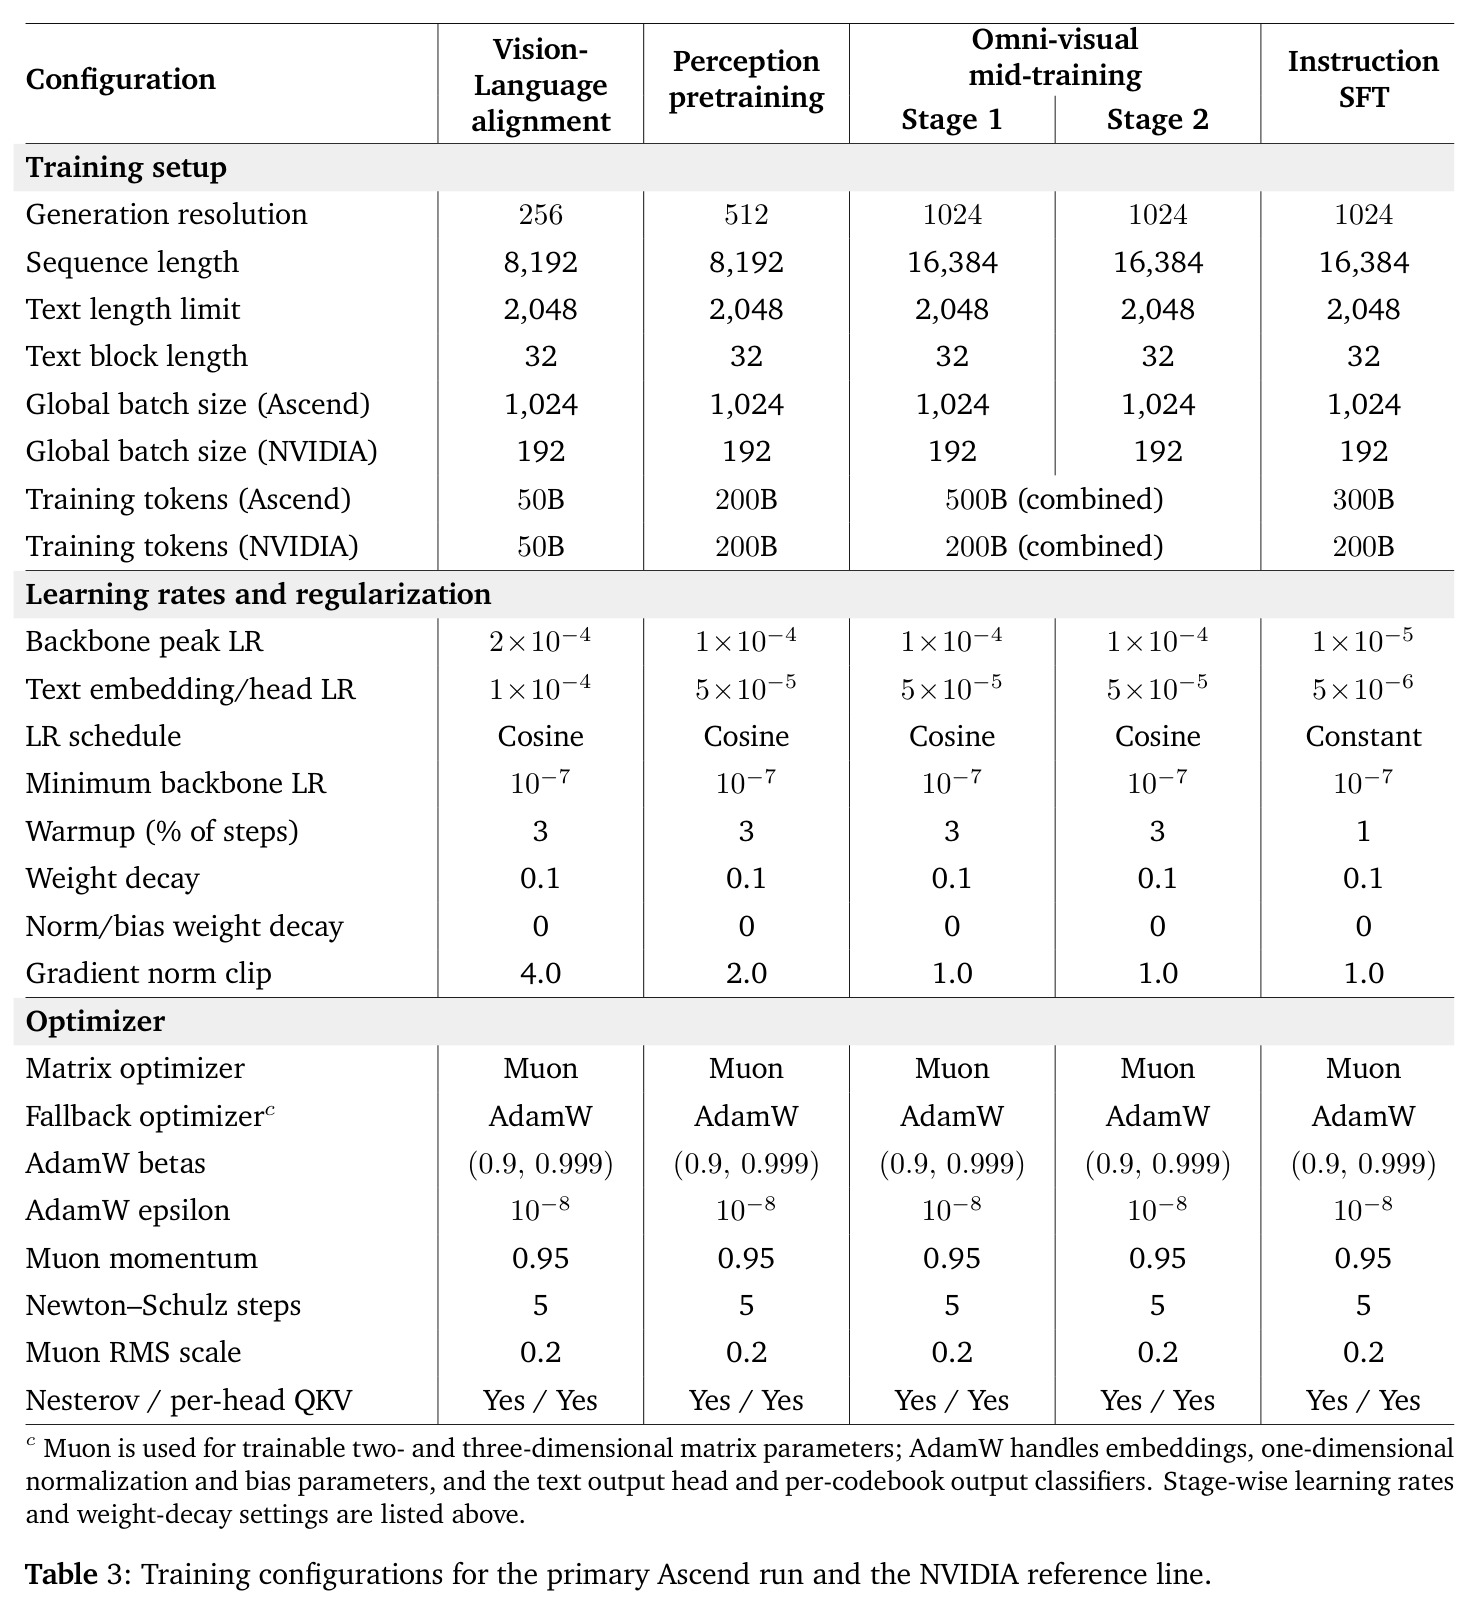
训练与推理的完整流程如下。第一步(编码):冻结的 AToken 把视觉输入编码为 $H\times W$ 网格,每个位置输出 $K=8$ 个码 $c=(c_1,\dots,c_K)$;文本由 LLaDA2.0 原生 tokenizer 处理。第二步(输入接口):每个码本 $k$ 有独立嵌入表 $E_k$(含 mask 项和布局特殊项),位置向量 $x=W_{in}\,[E_1(c_1);\dots;E_K(c_K)]$;被掩码位置的 8 个码全部替换为 mask 项。第三步(序列组织):所有样本统一为『条件+噪声答案|干净副本』的打包对话流,每个 token 标注类型/轮次/噪声状态/块索引/位置 ID 五个元数据字段,注意力掩码按四条规则生成(条件对后续轮次可见、文本答案走块级扩散 MBD/MOBC/MBC、视觉答案全图双向、打包样本互不可见)。第四步(训练目标):文本按块 $B=32$ 掩码(3% 概率全掩码,否则比例 $\rho=\cos(\pi u/2)$),视觉全图共享掩码率 $\rho=\cos(\pi u/2)$;视觉位置损失 $\ell_{vis}(j)=\frac{1}{K}\sum_k -\log p(c^{gt}_k\mid h, c^{gt}_{<k})$ 除以 $K$ 使其与文本 token 等权;总损失 $\mathcal{L}=\frac{\sum_{i\in T}\ell_{txt}(i)+\sum_{j\in V}\ell_{vis}(j)}{|T|+|V|}+10^{-3}\mathcal{L}_{balance}$,另加每步 ±0.001 的辅助无损专家偏置调节;10% 概率把条件换成 $\langle uncondition\rangle$ 以支持 CFG。第五步(五阶段课程):256² 对齐 50B token → 512² 感知预训练 200B → 1024² 只做分辨率过渡 → 1024² 引入编辑/视频/3D(两阶段合计昇腾 500B / NVIDIA 200B)→ 指令 SFT(300B / 200B),视觉模块从头训、AToken 冻结、Muon 优化矩阵权重。第六步(推理):文本块扩散加 KV cache;图像全画布迭代,AR 头对每个 masked 位置顺序采样 8 个码(Gumbel 扰动、按温度 τ 采样),余弦预算 $n_t=\lfloor N\cos(\pi t/2T)\rfloor$ 控制每步重掩码数,配合 PHV 平台期提交、Halton 顺序和漂移触发缓存刷新加速。
技术新颖性
技术新颖性可以从四个对照面看清。对 AR 多码本系统(VILA-U、UniTok、RQ-Transformer):它们沿空间从左到右逐 token 生成、深度 Transformer 补码本维;本文骨干是双向掩码扩散,空间位置无固定顺序、全图并行细化,AR 头只负责位置内部——这种『外扩散内自回归』的组合是首次出现。对单码本扩散统一模型(MMaDA、Lumina-DiMOO):本文证明容量瓶颈可以用纯离散方式打破,无需引入连续目标。对 LLaDA2.0-Uni(同骨干前作):它需要单独的扩散解码器合成图像、视觉接口是语义单码本,本文用同一骨干直接离散建模多码本视觉 token,同骨干对比下 10 个图像理解基准赢 8 个,说明容量增益是表示层面的而非算力层面的。对推理加速(Fast-dLLM 绝对阈值、dLLM-Cache 固定间隔刷新、MaskGIT 固定调度):PHV 的贡献在于承认视觉置信度的数值分布与文本完全不同,改用指数移动平均的相对变化量 $\Delta_{t,i}=|m_{t,i}-m_{t-1,i}|/\max(m_{t-1,i},\epsilon_m)$ 判定平台期、用隐藏状态归一化漂移 $D_t$(式 8)触发缓存刷新,把提交时机和缓存策略都交给在线时间信号。此外,把昇腾 910B 全栈适配(CANN、VeOmni、HCCL、平台原生融合算子)做到可复现论文级结果,在国内算力生态中也属首创性工作。
实验结果
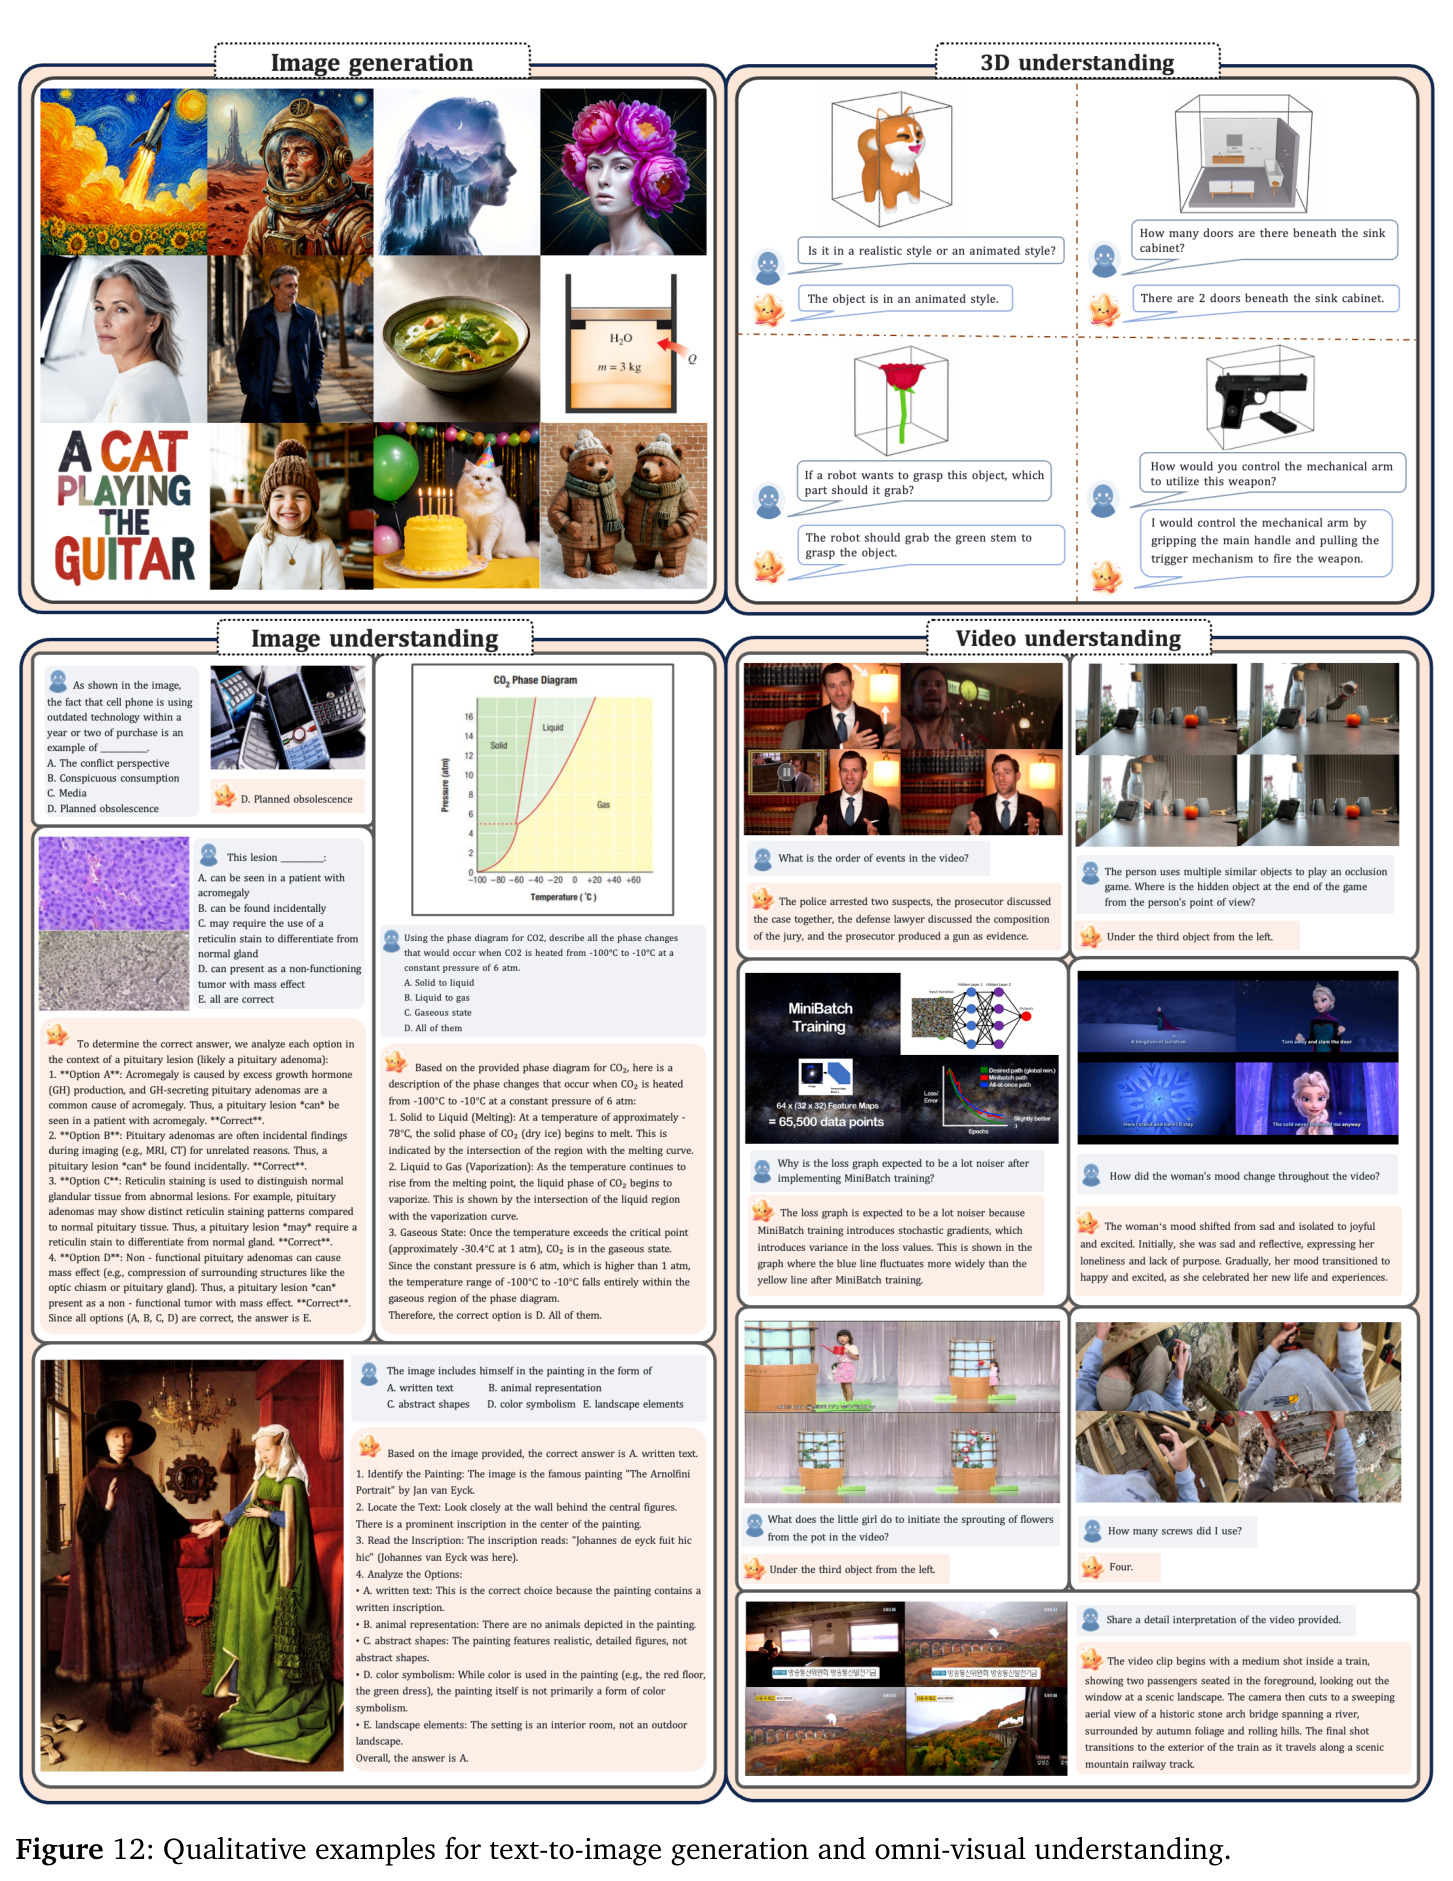
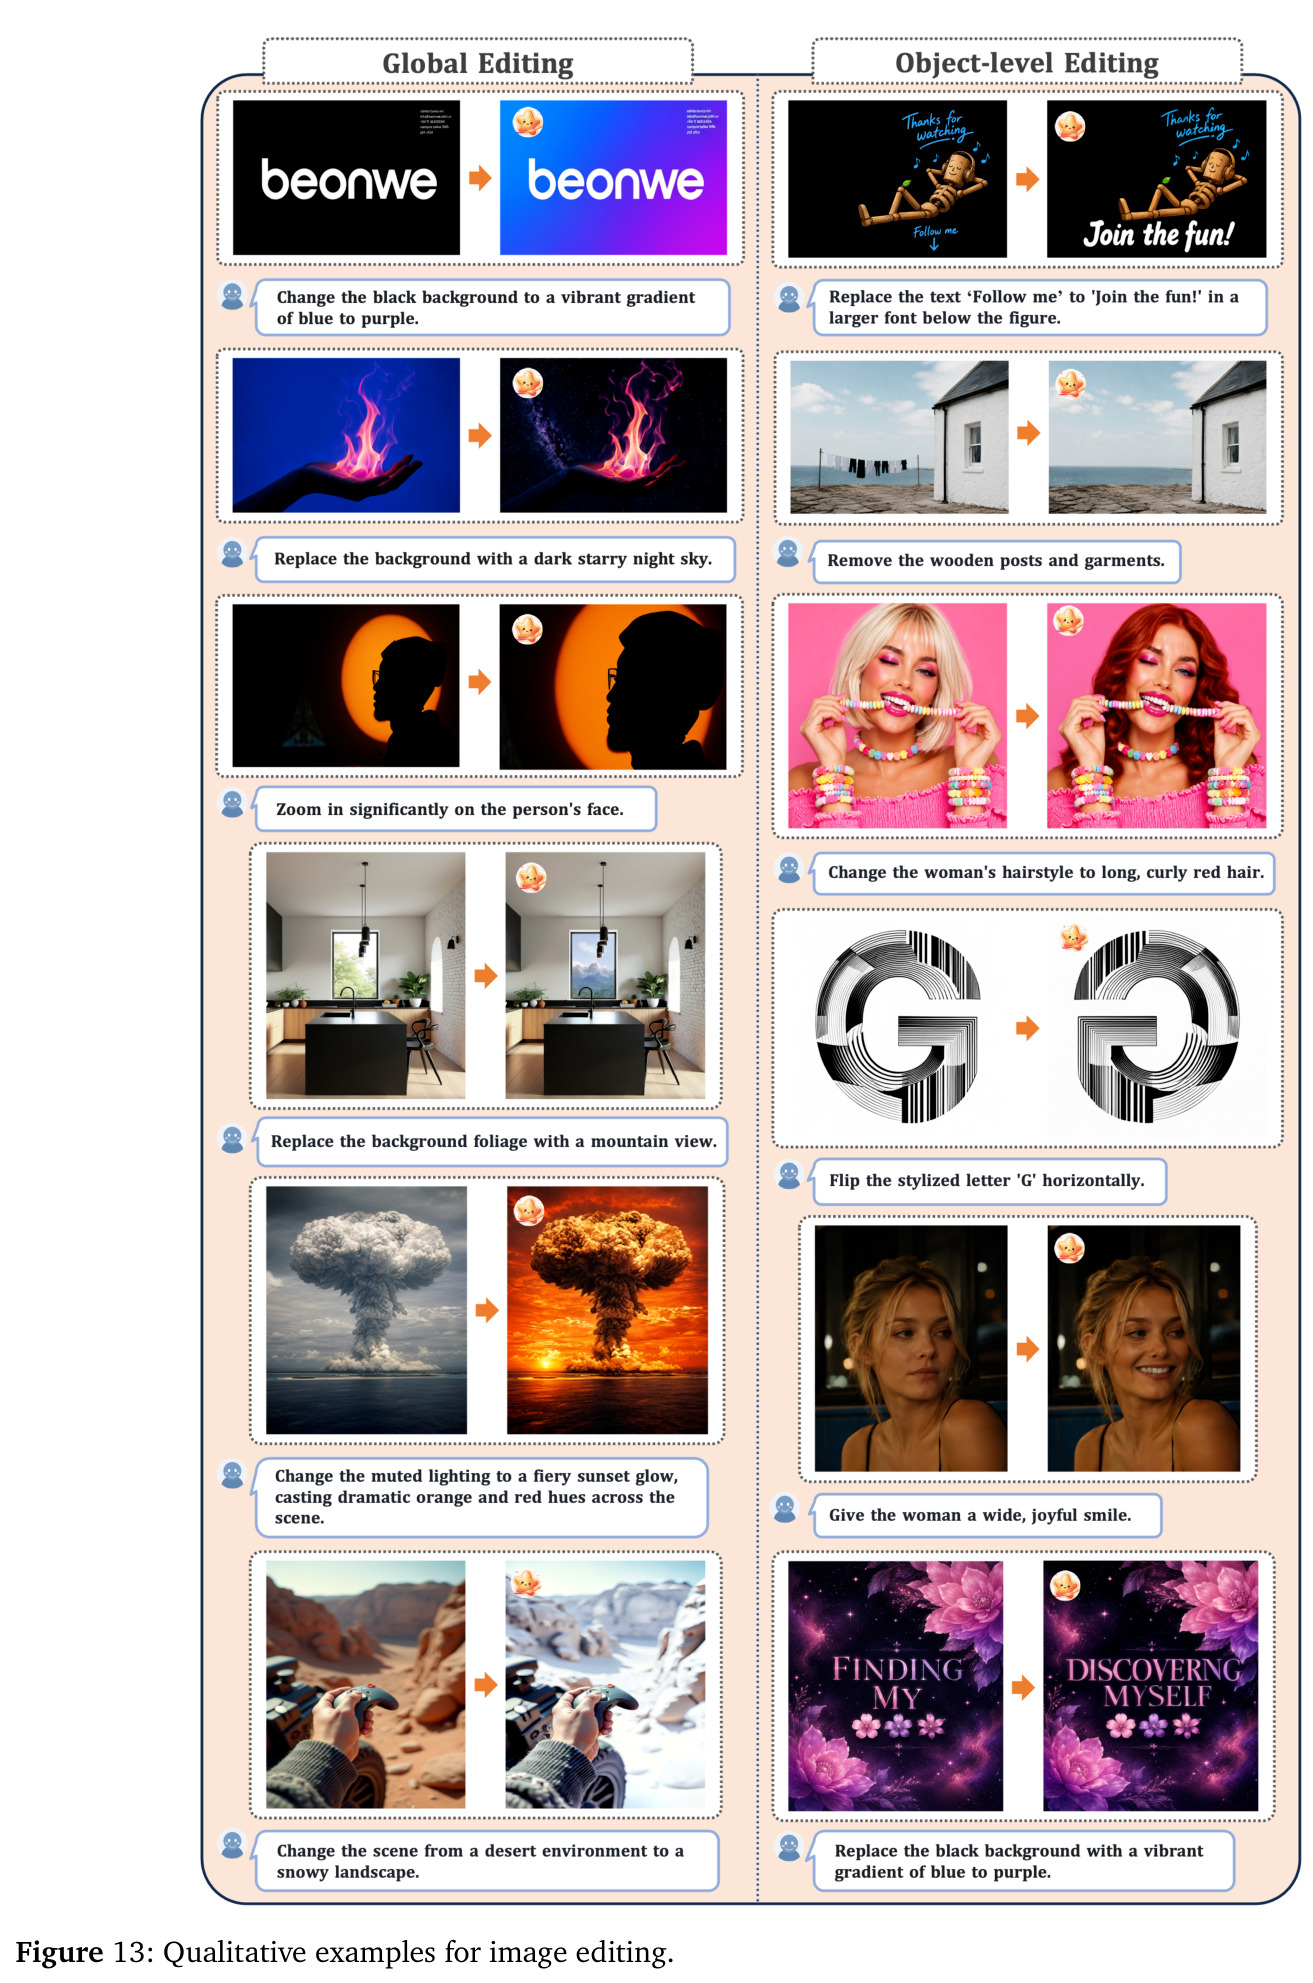
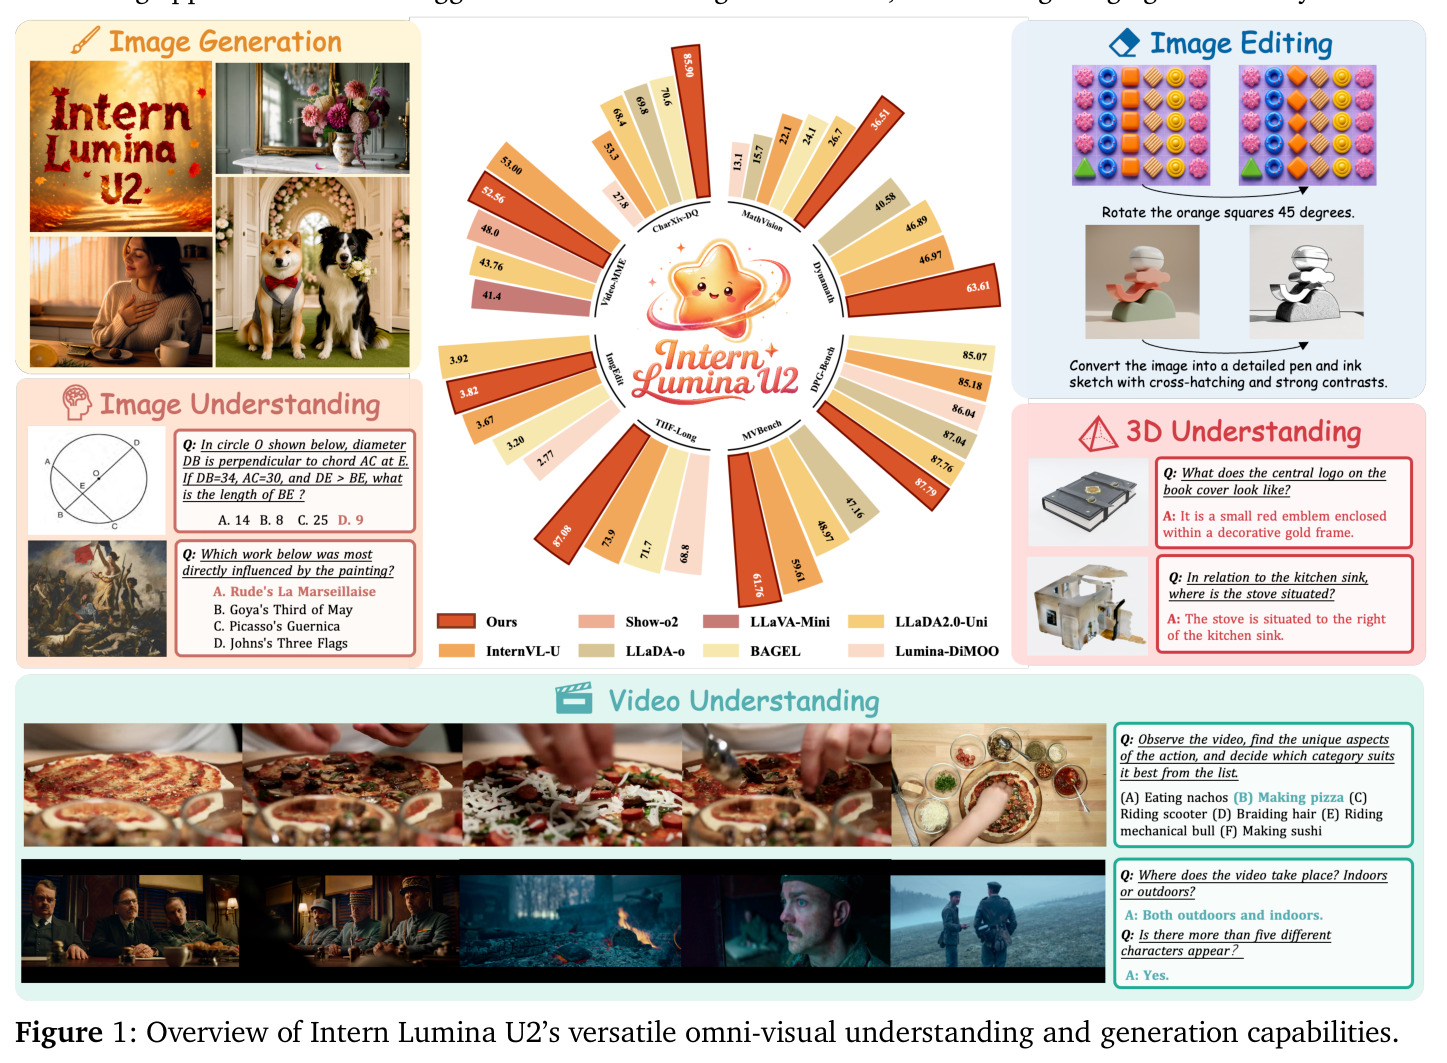
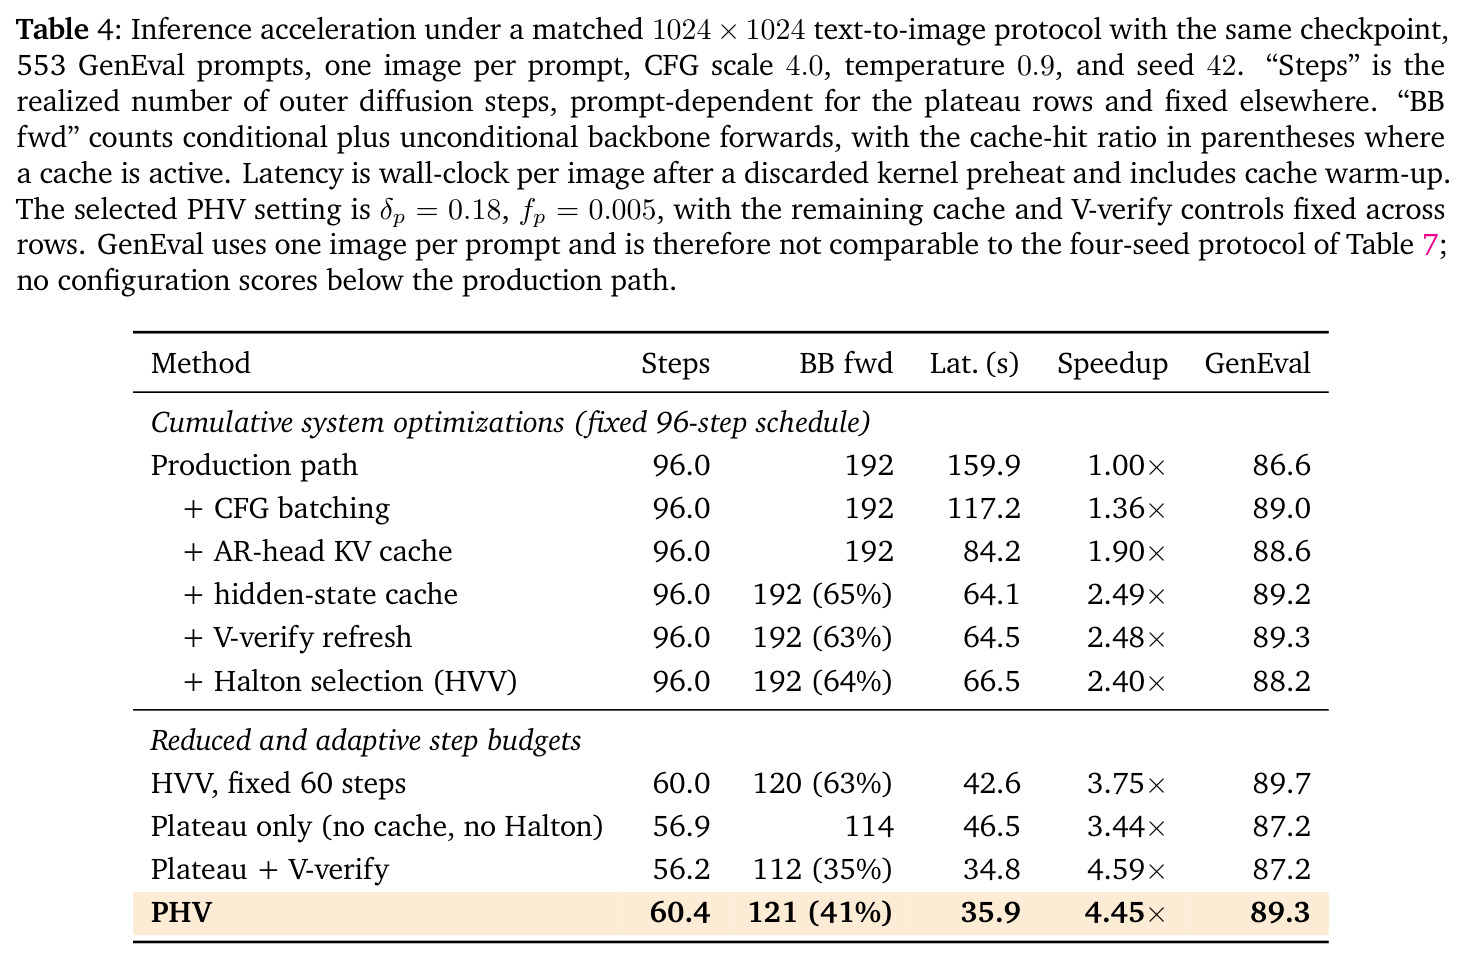
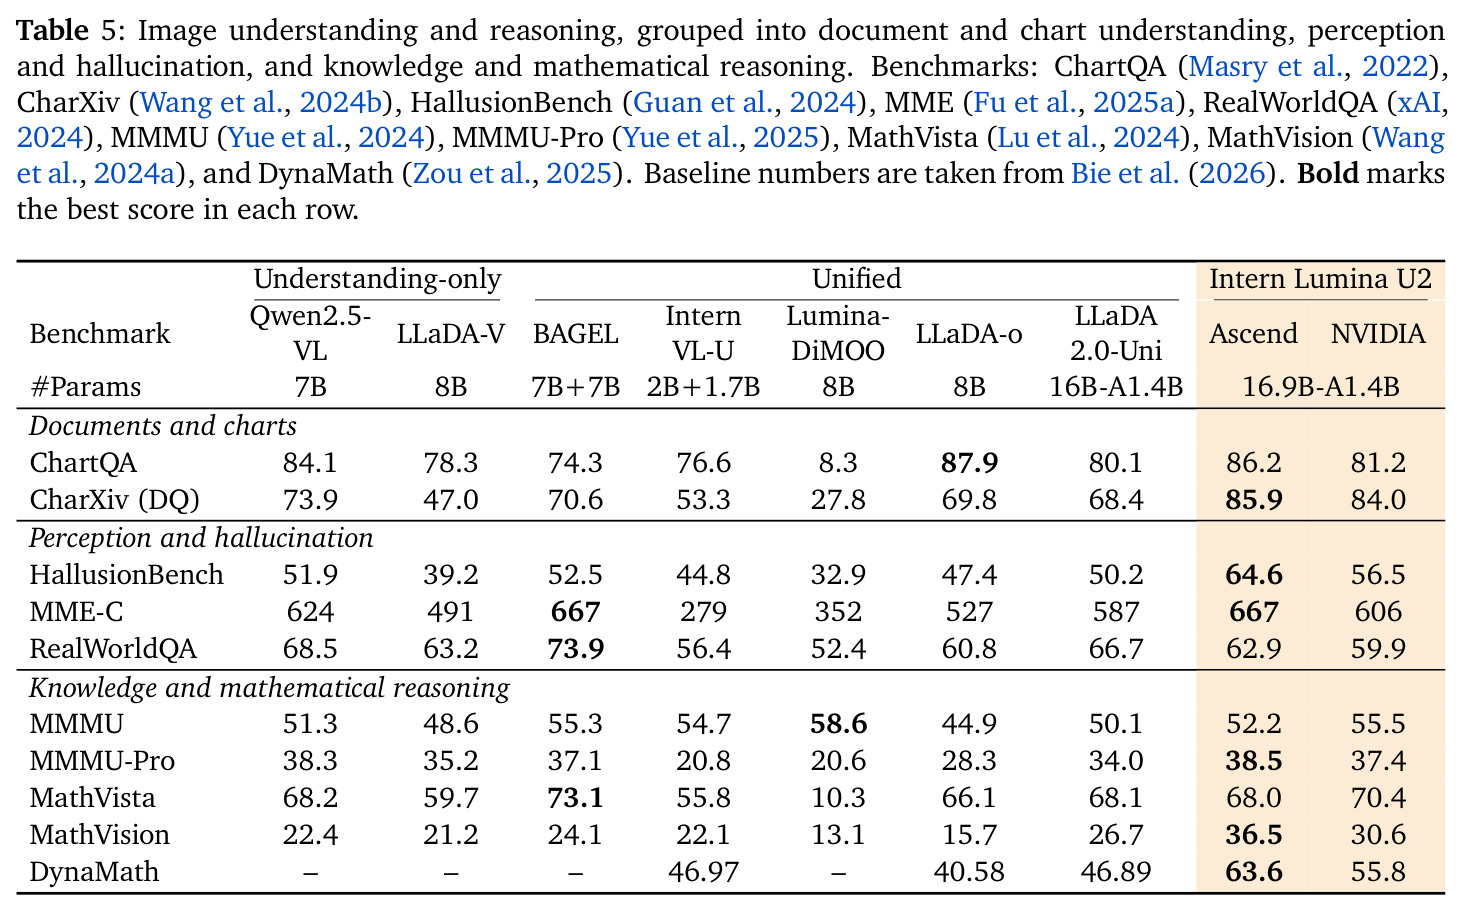
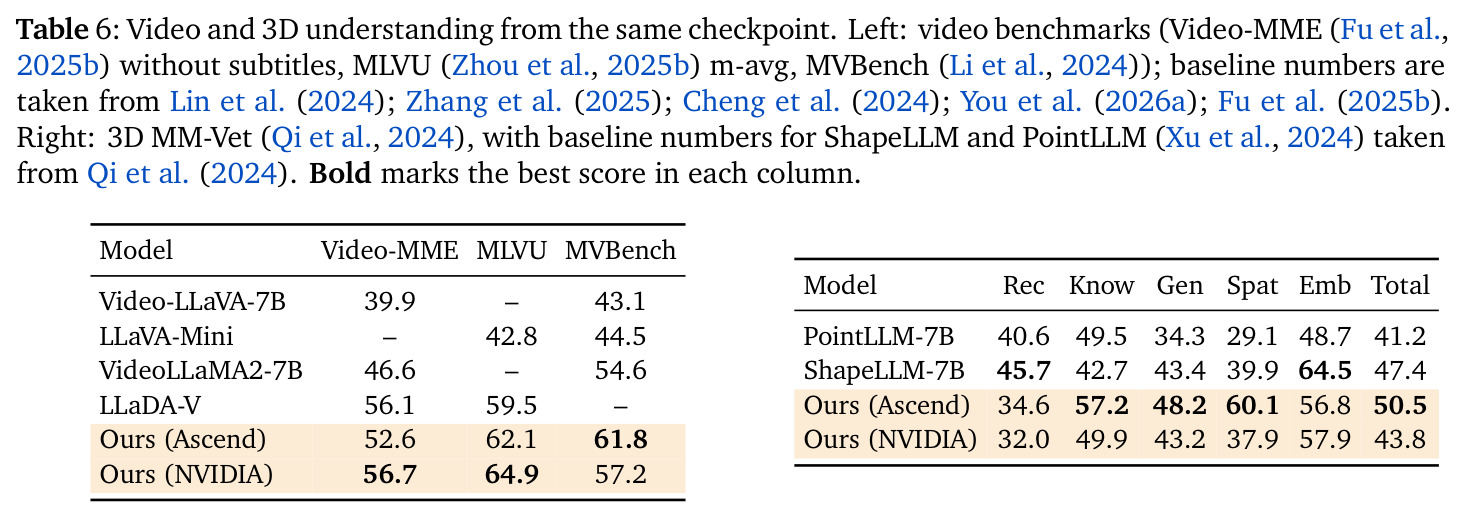
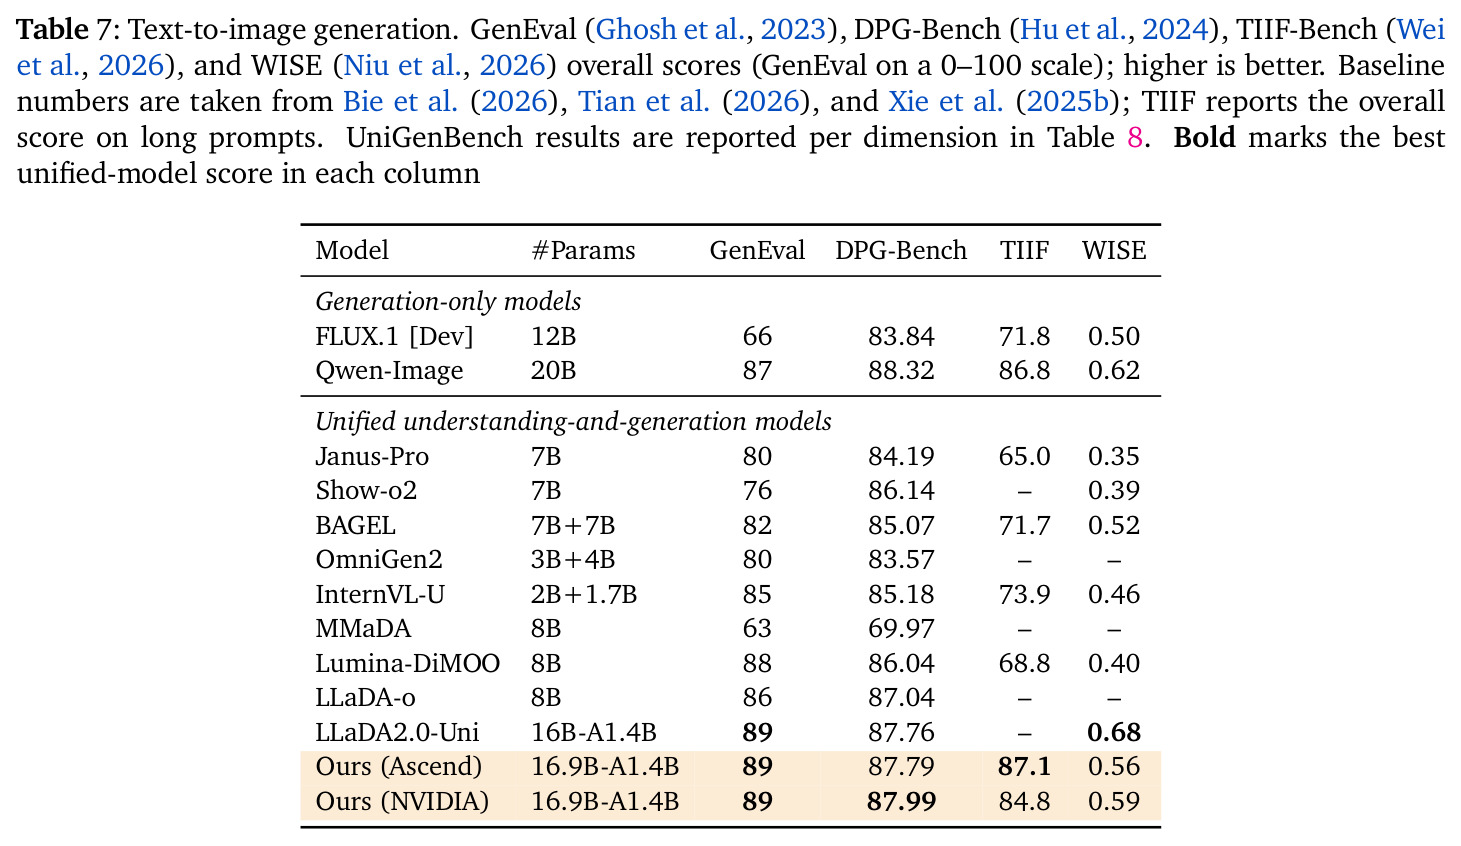
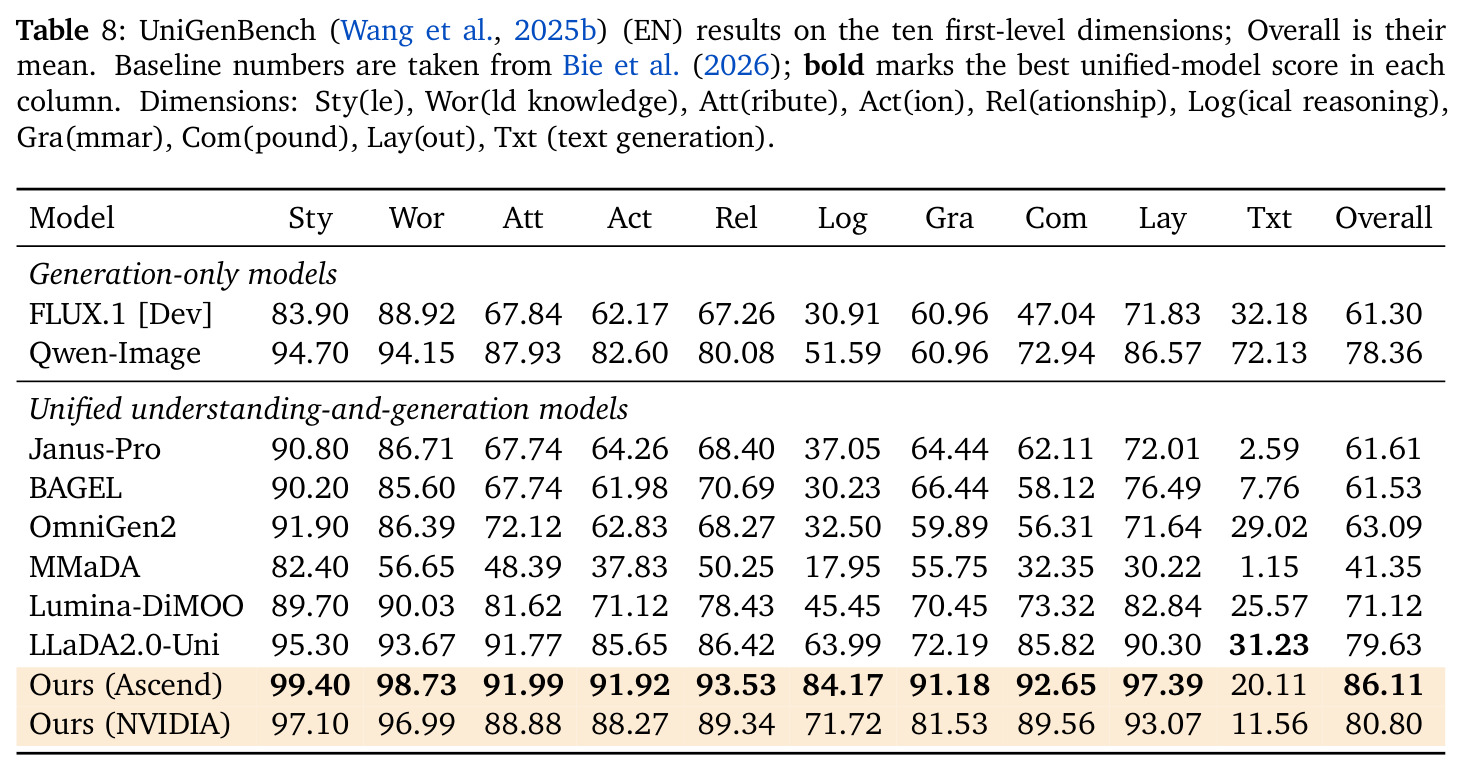
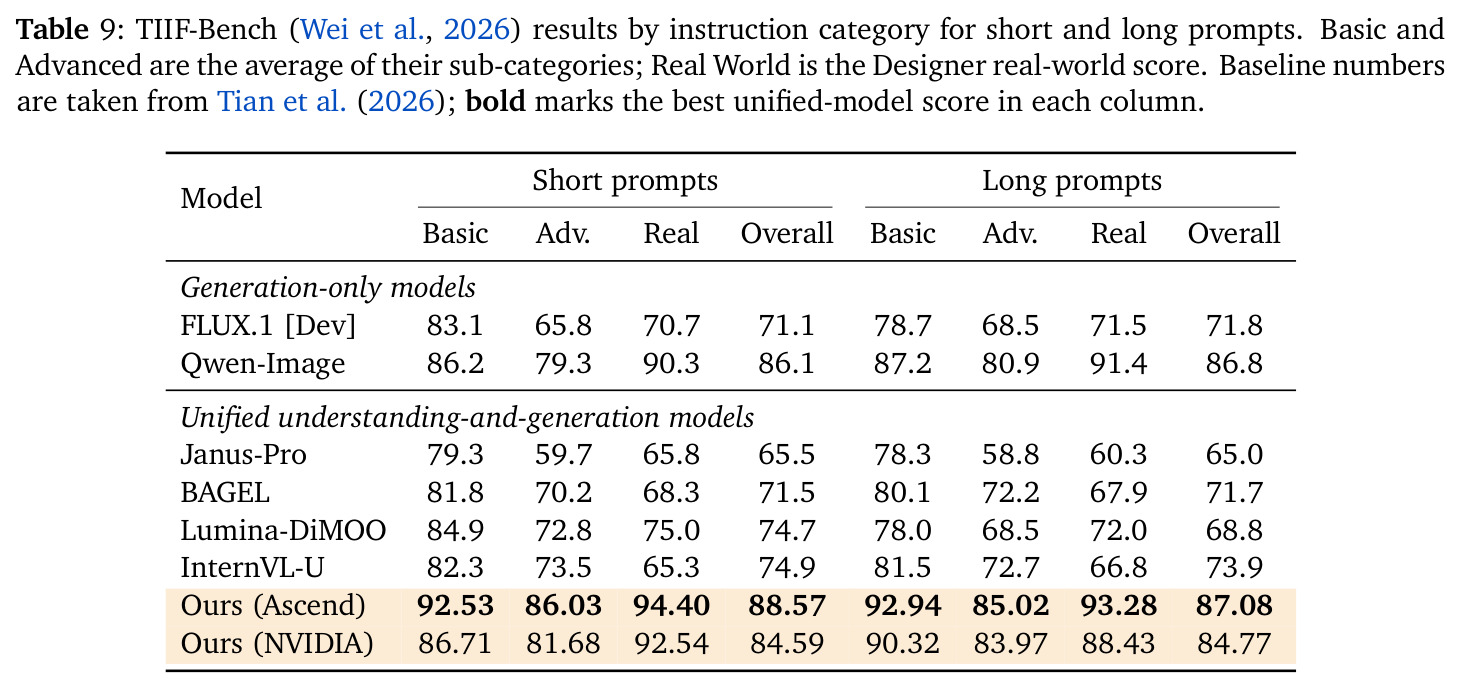
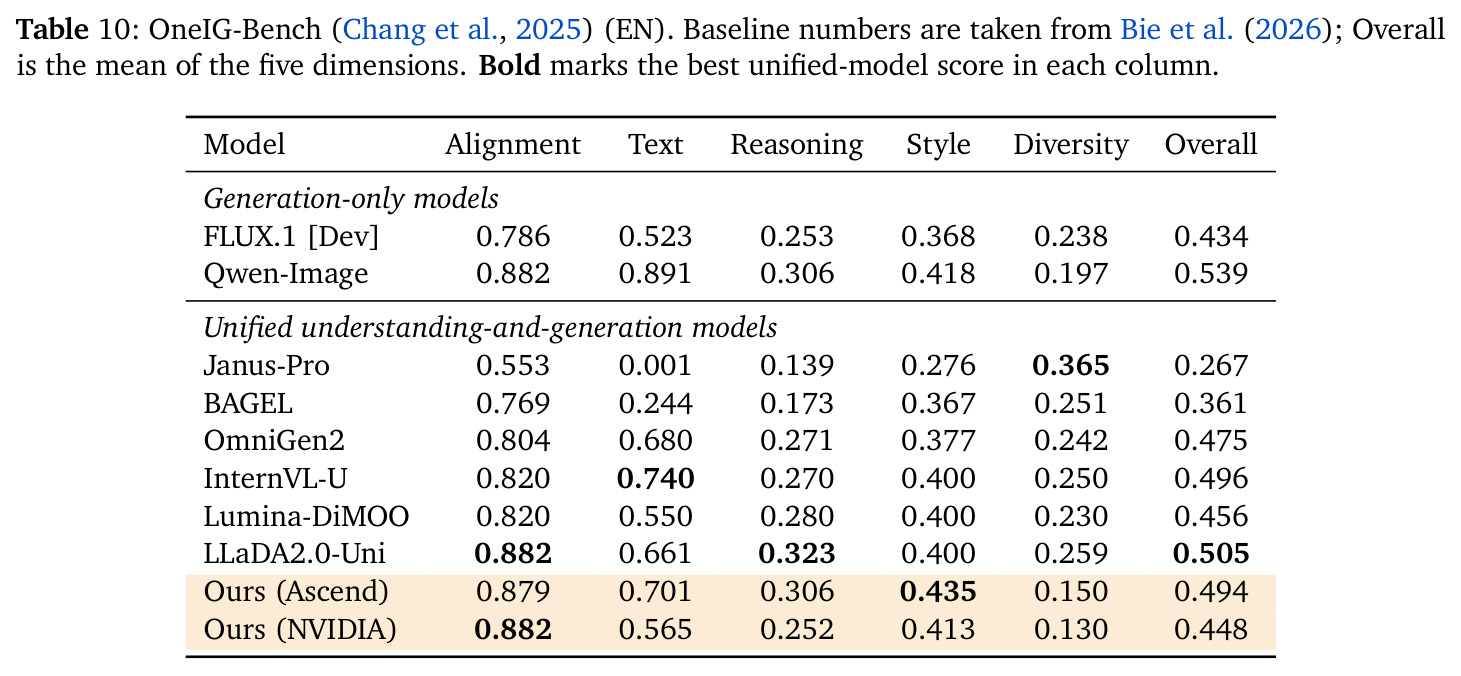
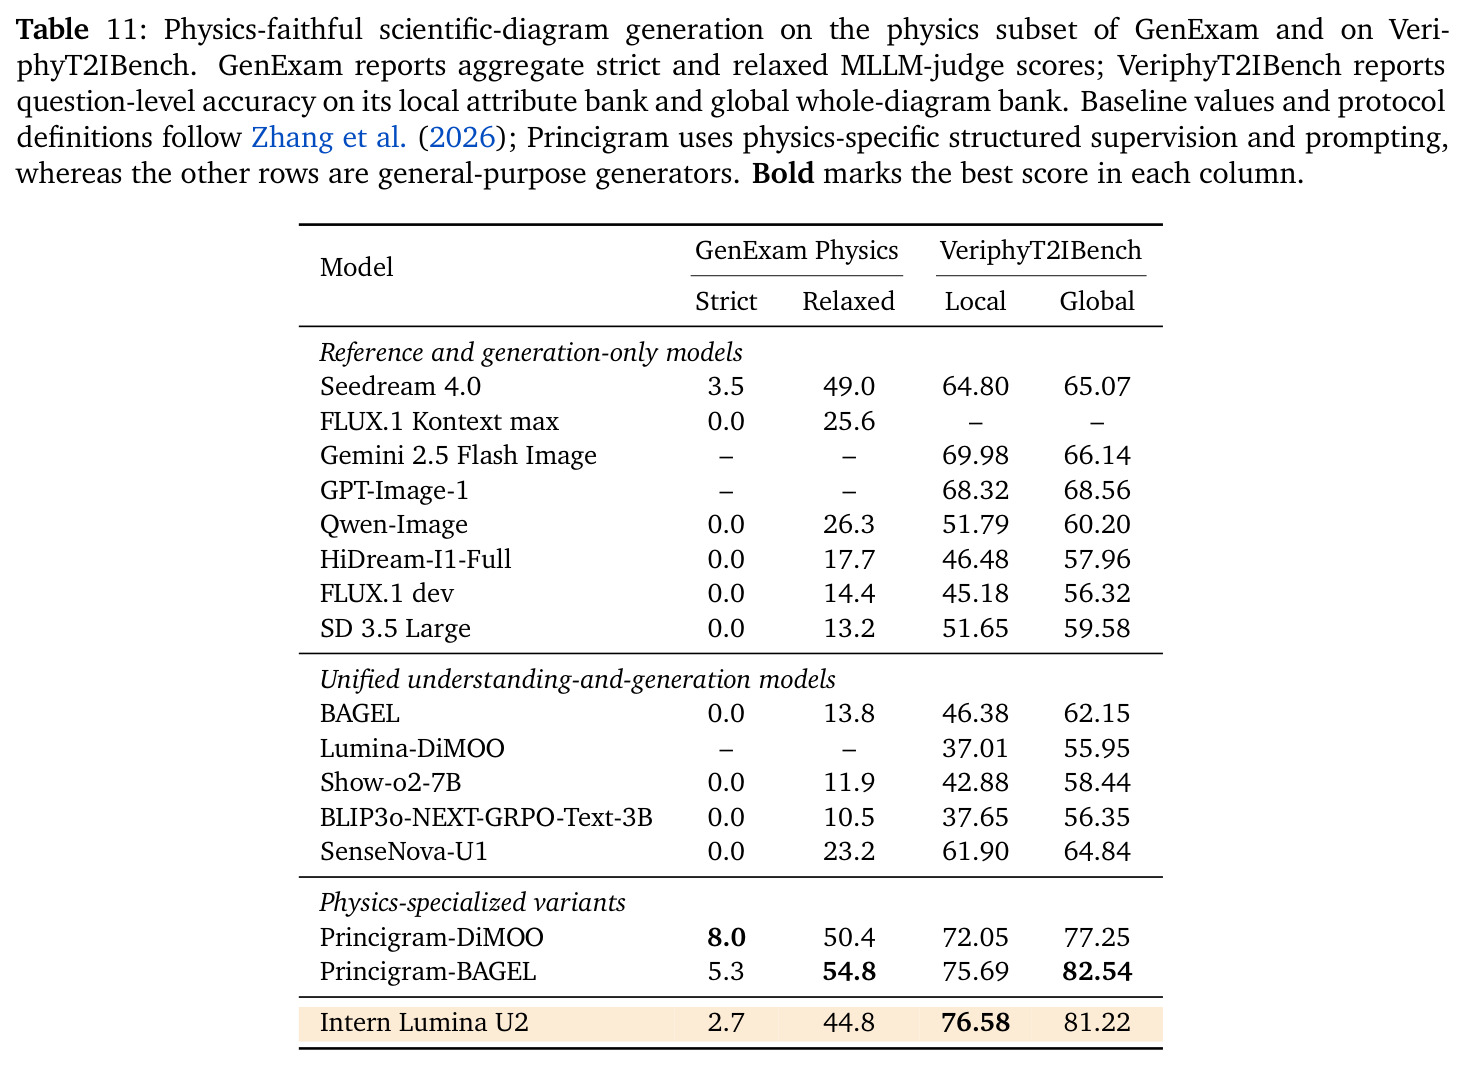
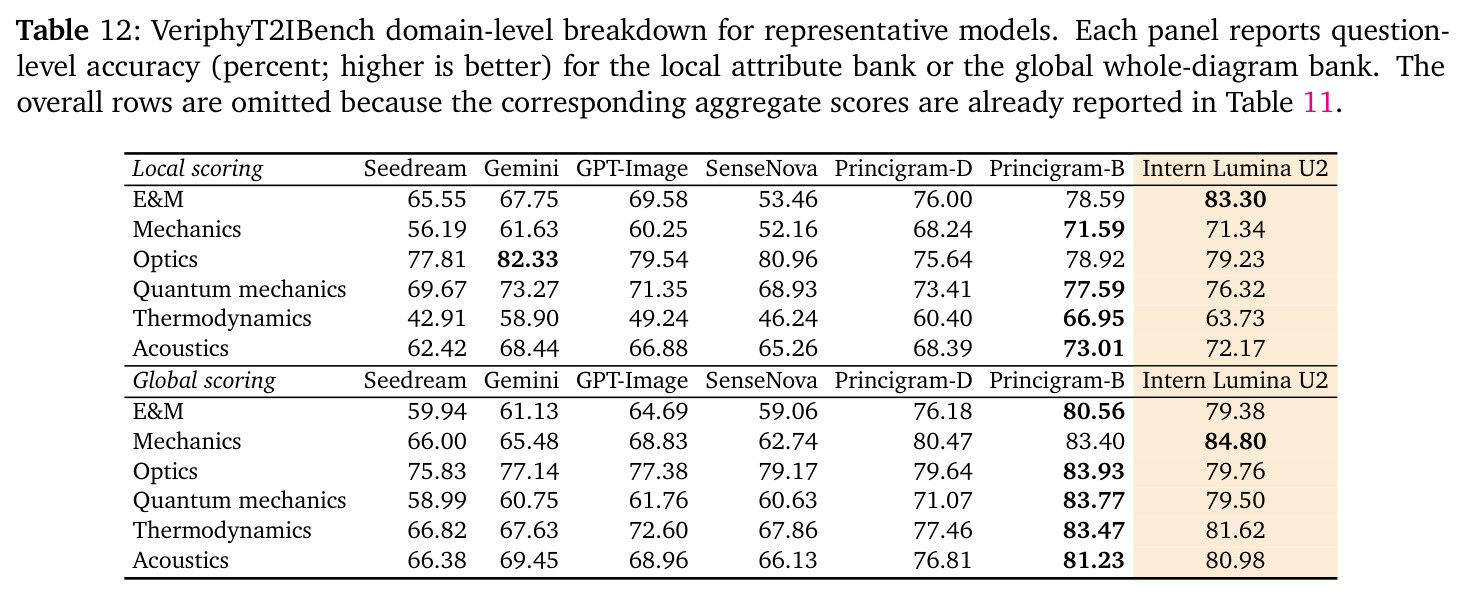
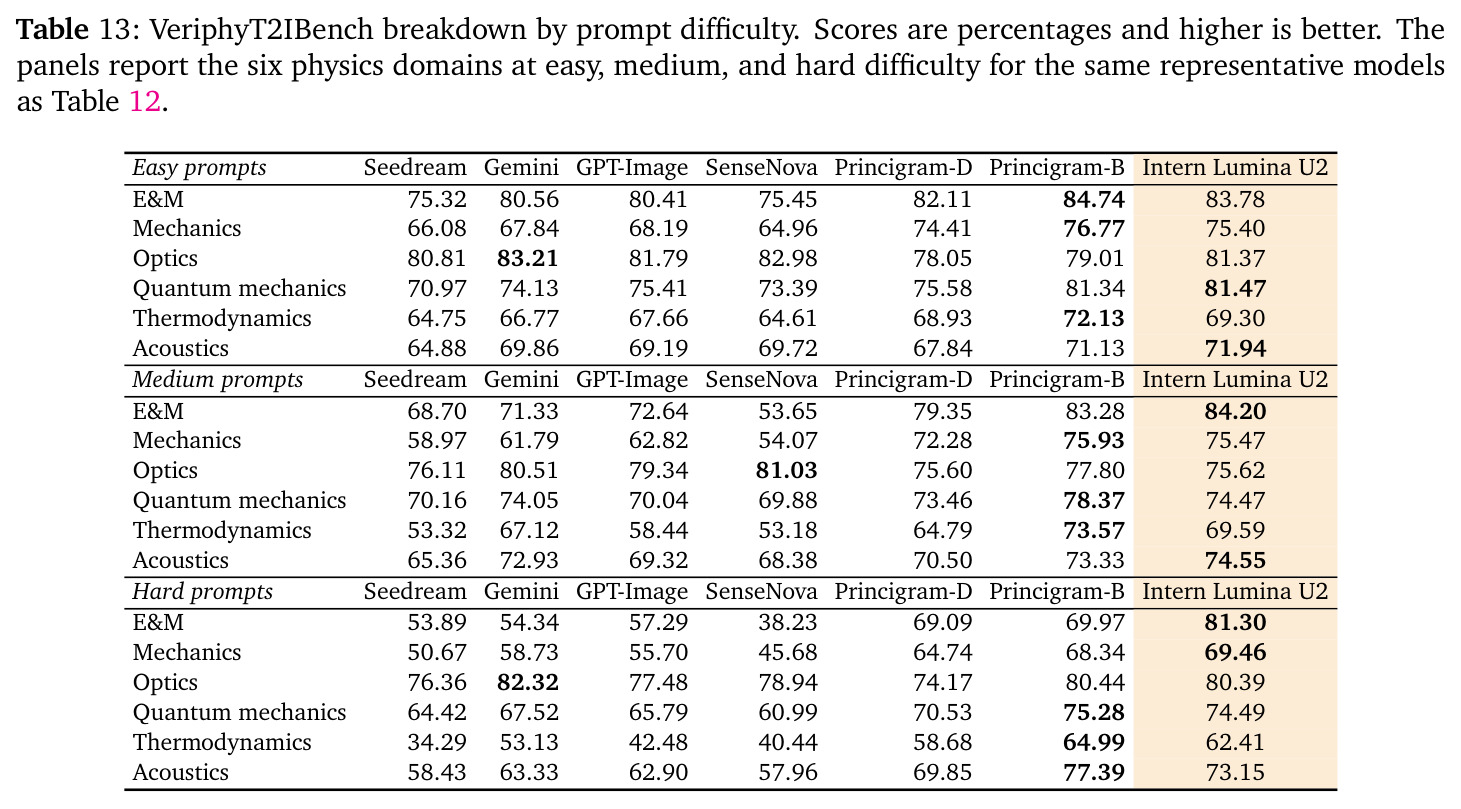
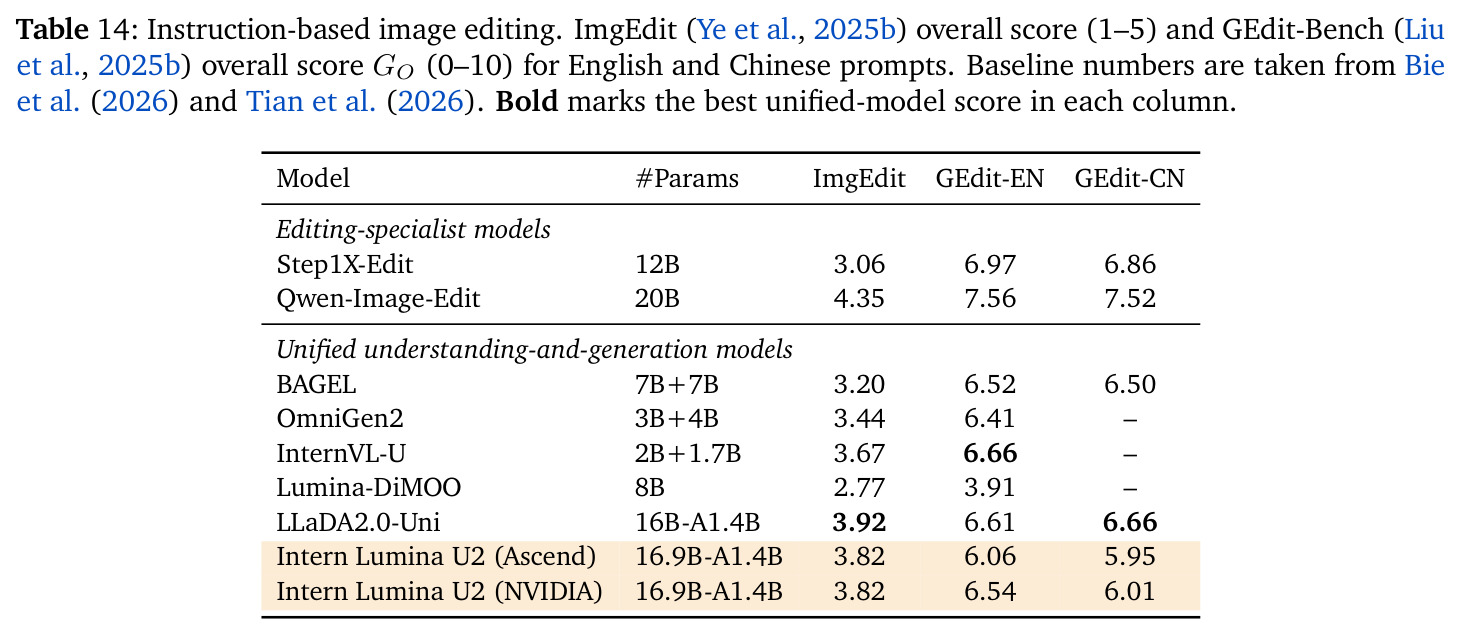
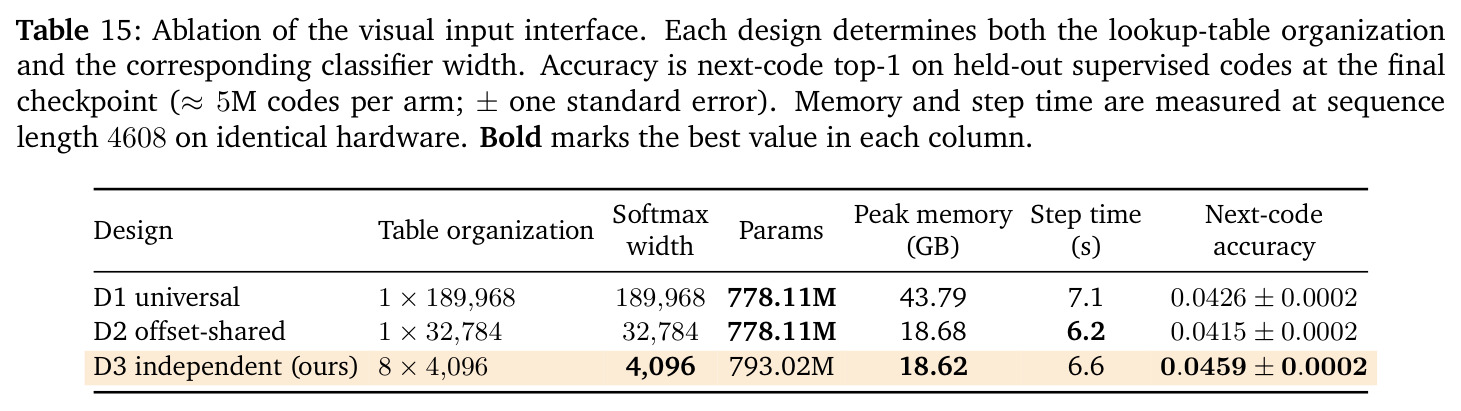
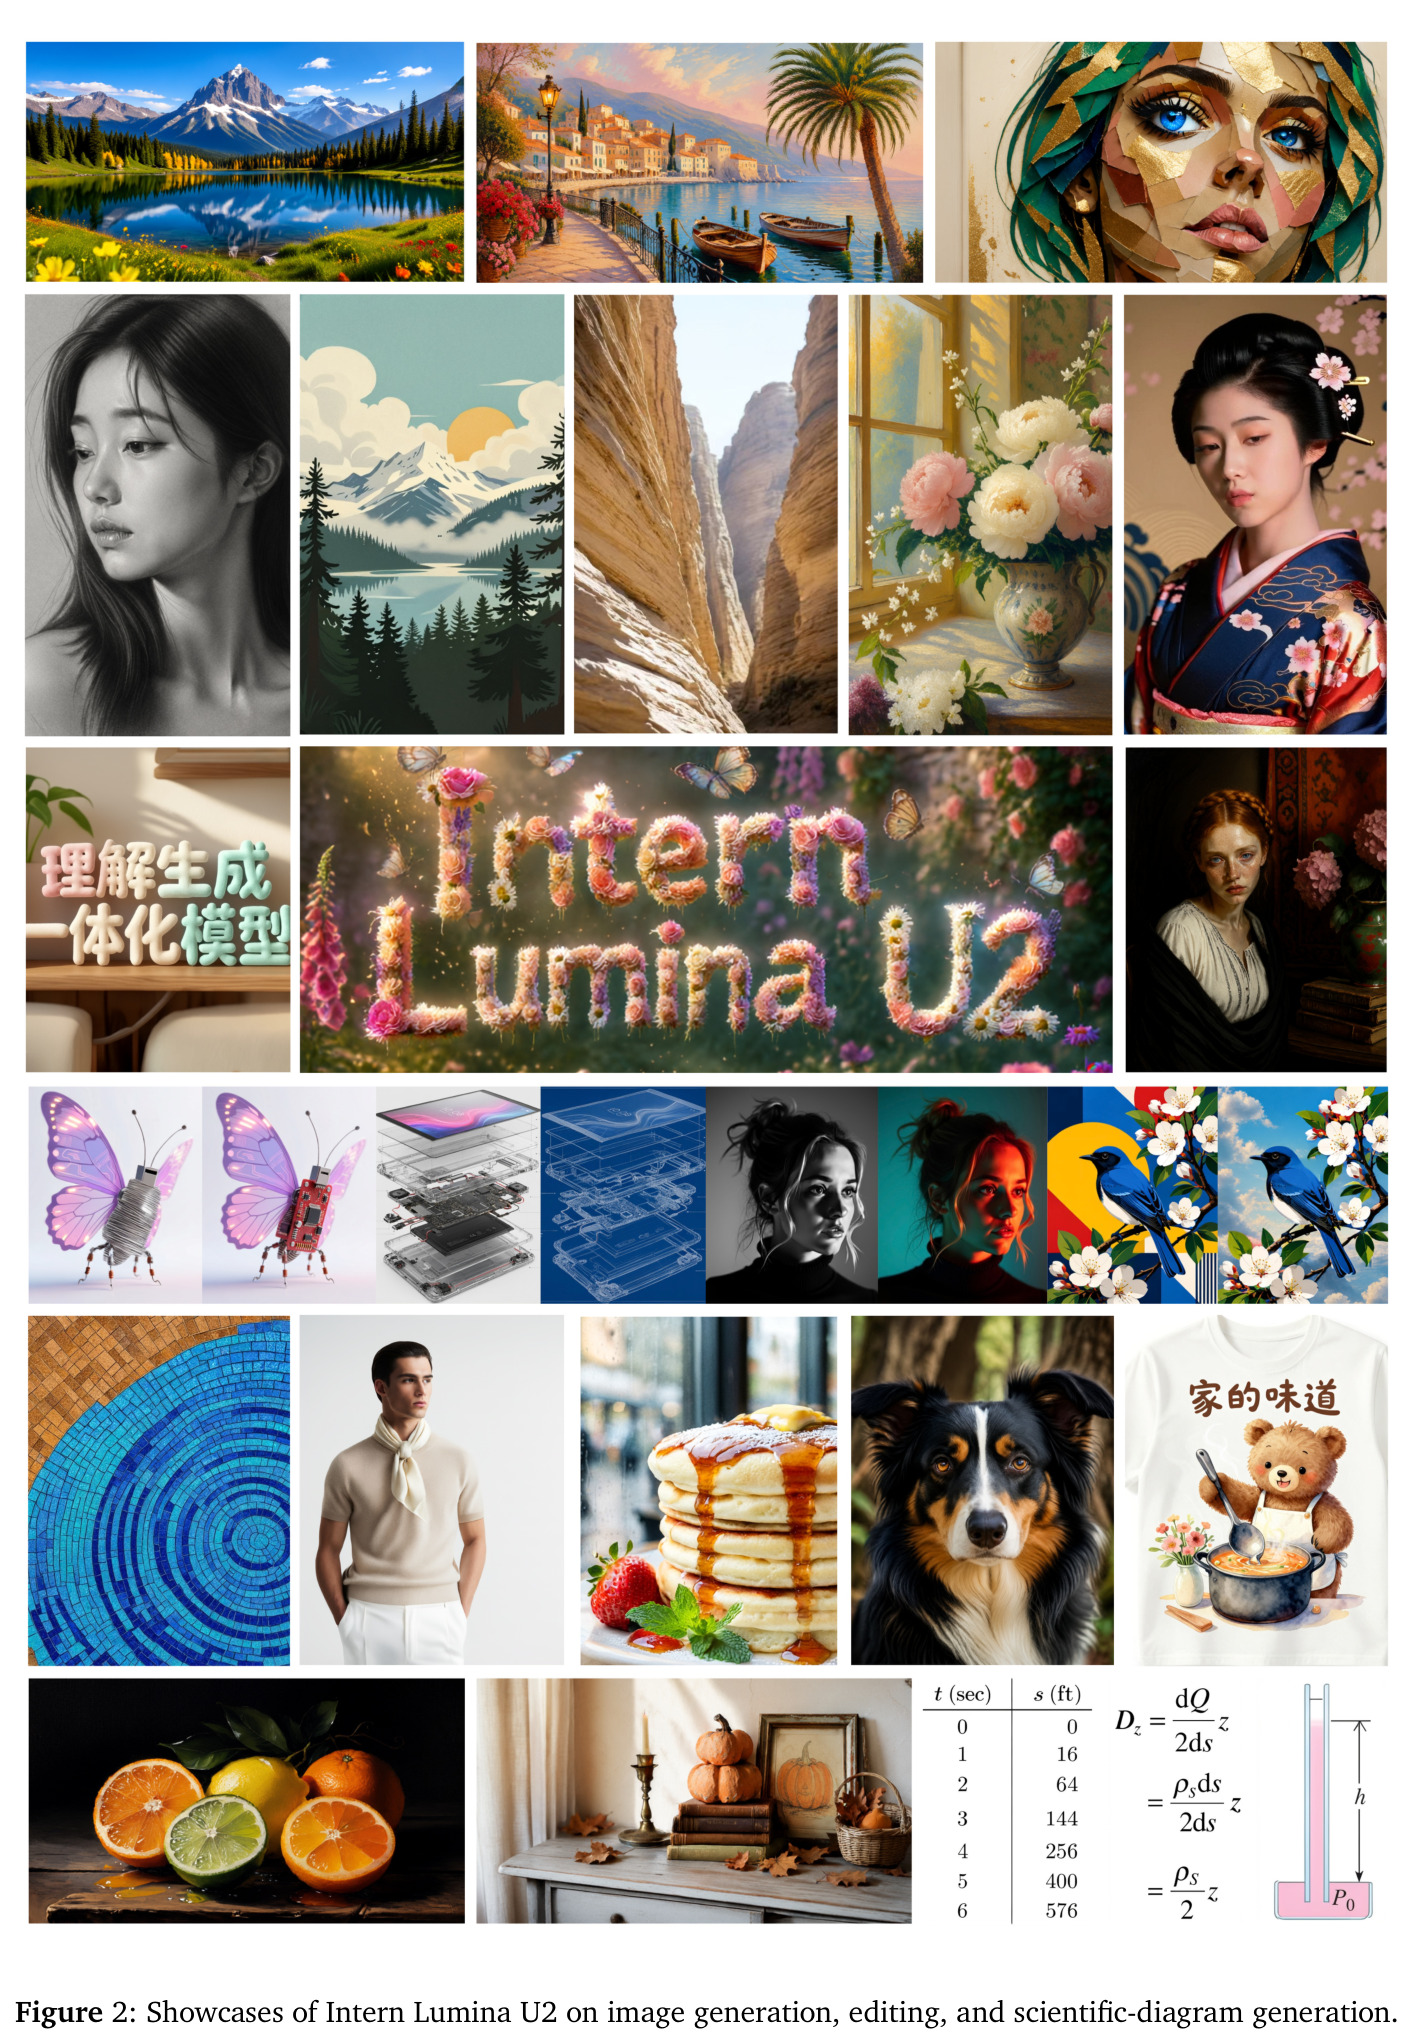
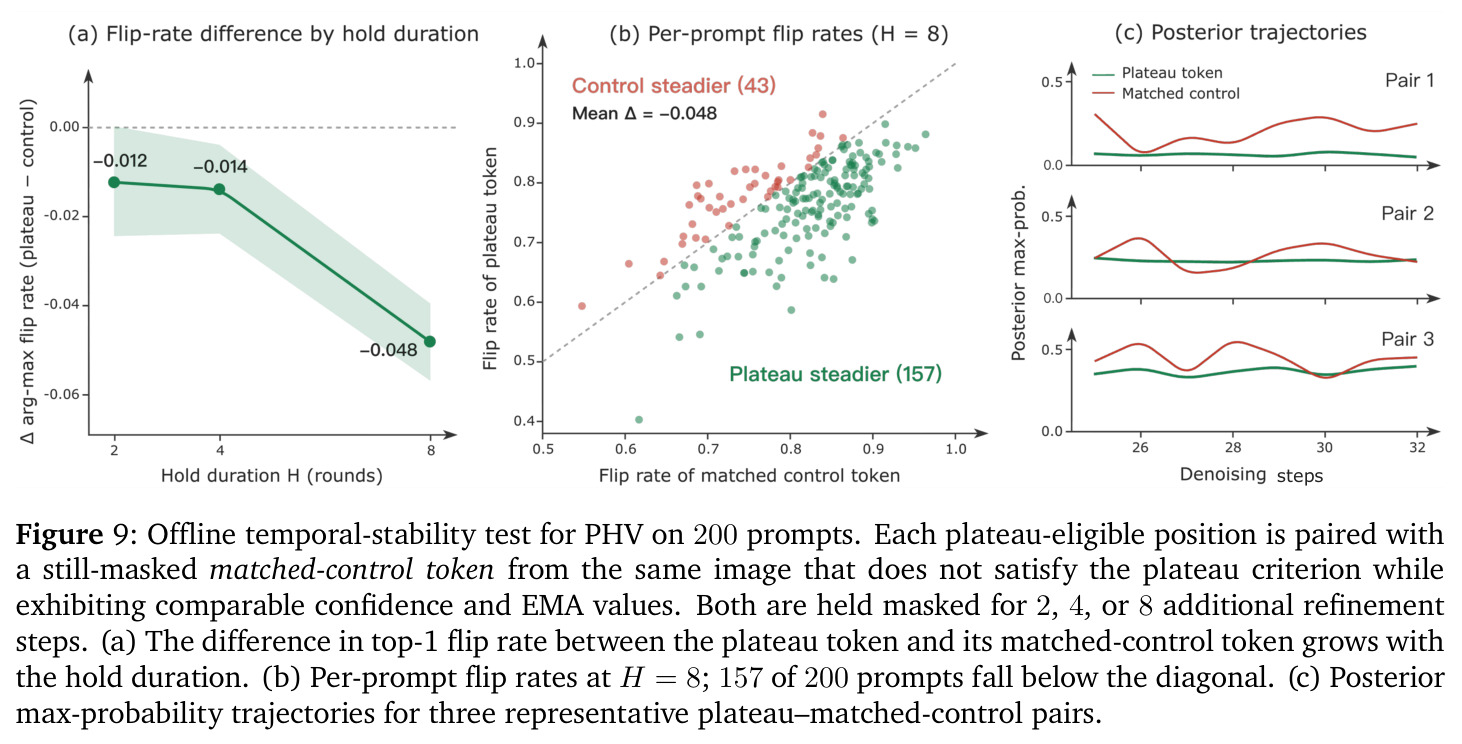
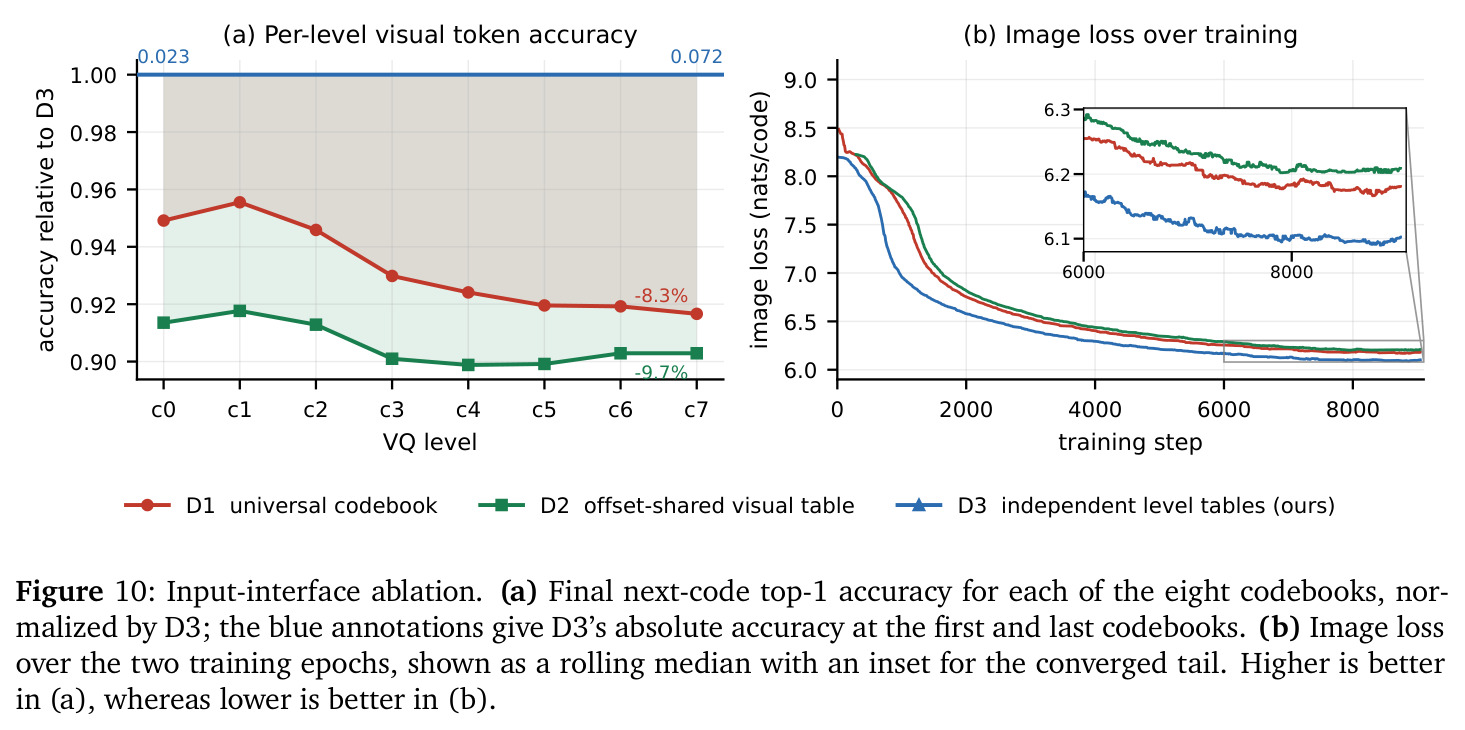
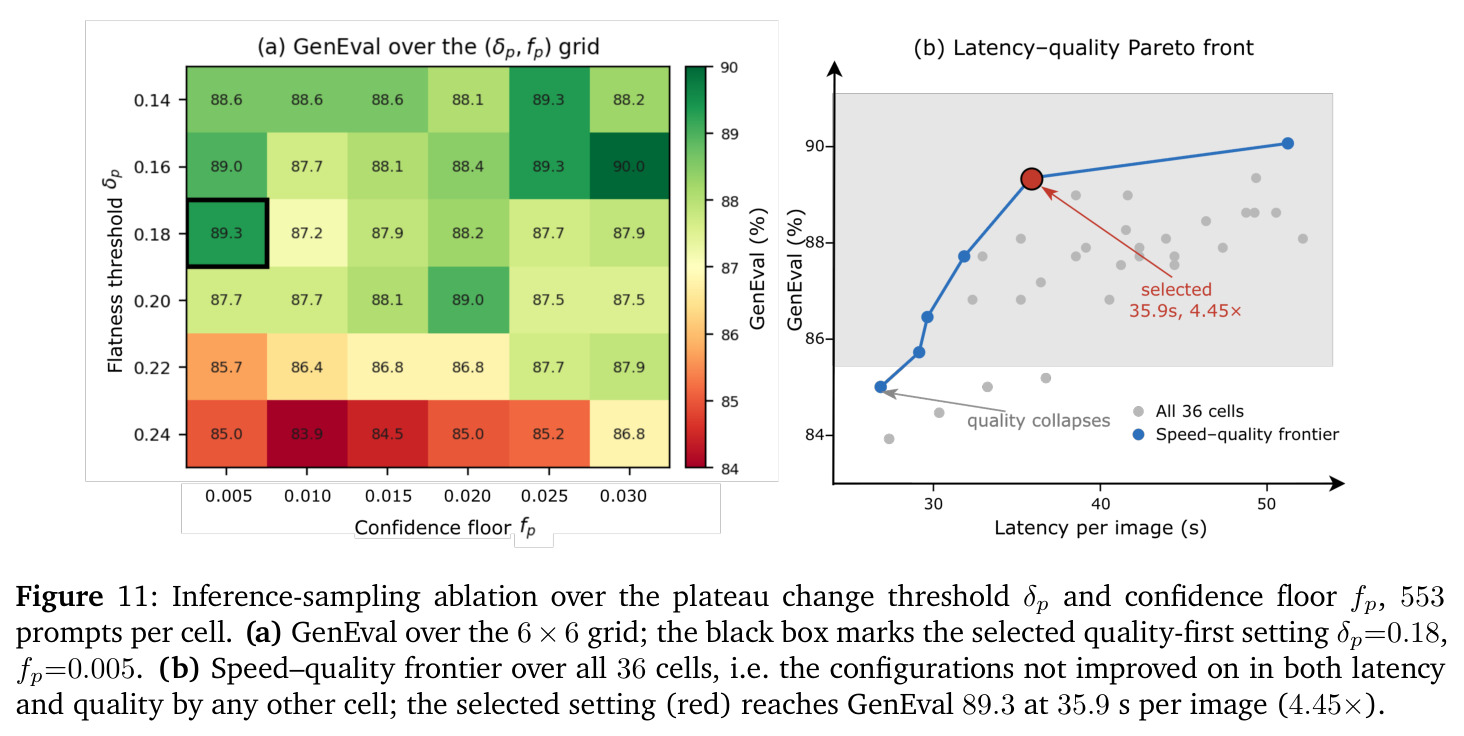
核心发现覆盖理解、生成、编辑、加速四个板块,且昇腾主模型与 NVIDIA 参考线结论方向一致。图像理解:仅 1.4B 激活参数在 10 个基准中的 6 个拿下第一(MME-C 与 BAGEL 并列),其中 CharXiv DQ 85.9 大幅领先 Qwen2.5-VL 的 73.9,HallusionBench 64.6、MathVision 36.5、DynaMath 63.6 都是全场最佳;与共享同一语言骨干的 LLaDA2.0-Uni 相比 10 项赢 8 项,且优势集中在需要细粒度视觉细节的基准,直接支持『多码本提升表示容量』的核心论点。视频理解三个基准全部领先:MLVU 62.1(NVIDIA 线 64.9)、MVBench 61.8、Video-MME 52.6/56.7,超过专用视频模型 VideoLLaMA2-7B;3D MM-Vet 50.5 超过 3D 专用模型 ShapeLLM-7B(47.4)和 PointLLM-7B(41.2),空间推理分项 60.1 尤为突出——单一视觉接口同时支撑三种模态且达到专业模型水平是重要验证。文生图:GenEval 89 与 LLaDA2.0-Uni 并列统一模型最佳,DPG-Bench 87.79、TIIF-Bench 87.1(超过 20B 的 Qwen-Image 的 86.8)、UniGenBench 86.11 领先 LLaDA2.0-Uni 6.5 分,优势最大的维度是逻辑推理(84.17 对 63.99)和语法(91.18 对 72.19);明显弱项是 UniGenBench 文字渲染(20.11)和 OneIG-Bench 多样性(0.150,全场最低)。科学图表生成是亮点:VeriphyT2IBench Local 76.58 全场第一(超过物理特化模型 Princigram-BAGEL 的 75.69),GenExam Physics relaxed 44.8 为通用统一模型最高,困难电磁学题 81.30 领先第二名 Princigram-DiMOO(69.09)12 分,显示物理忠实性优势。编辑偏弱:ImgEdit 3.82 仅次于 LLaDA2.0-Uni 的 3.92,但 GEdit-EN 6.06、GEdit-CN 5.95 低于 BAGEL(6.52)和 LLaDA2.0-Uni(6.61)。加速:PHV 把 1024² 生成延迟从 159.9 秒压到 35.9 秒(4.45 倍),平均步数 96→60.4,GenEval 反而从 86.6 升到 89.3。消融确认两个设计均必要:独立码本嵌入(D3)next-code 精度 0.0459±0.0002 显著高于共享表 D1(0.0426)和偏移共享 D2(0.0415),且 D1 的大分类器峰值内存 43.79GB 是 D3(18.62GB)的 2.35 倍;输出头上 AR 头四项生成基准全面最佳,并行头 GenEval 低 14 分。PHV 离线验证中,平台期 token 在 200 个提示里 157 个比匹配对照更稳定($H=8$ 时 flip rate 差 -0.048,95% CI [-0.057,-0.040])。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像理解与推理(10 基准综合) | 各基准官方指标 | 6/10 第一;CharXiv DQ 85.9、DynaMath 63.6、MathVision 36.5、HallusionBench 64.6 | Qwen2.5-VL 7B / BAGEL / LLaDA2.0-Uni(如 CharXiv 73.9、DynaMath 46.89) | CharXiv +12.0、DynaMath +16.7;对同骨干 LLaDA2.0-Uni 10 项赢 8 项 |
| 视频理解 | MLVU m-avg / MVBench / Video-MME | 62.1 / 61.8 / 52.6(NVIDIA 线 64.9 / 57.2 / 56.7) | LLaDA-V 59.5 / – / 56.1;VideoLLaMA2-7B – / 54.6 / 46.6 | MLVU +2.6~5.4、MVBench +7.2,三基准全部第一 |
| 3D 资产理解 | 3D MM-Vet 总分 | 50.5(昇腾主模型) | ShapeLLM-7B 47.4、PointLLM-7B 41.2 | +3.1 / +9.3,空间分项 60.1 领先 20 分以上 |
| 文生图 | GenEval(0-100) | 89 | LLaDA2.0-Uni 89、Lumina-DiMOO 88、BAGEL 82 | 并列统一模型最佳,且 PHV 加速下仍保持 89.3 |
| 文生图(细粒度语义) | UniGenBench EN 总分 | 86.11 | LLaDA2.0-Uni 79.63、Lumina-DiMOO 71.12、Qwen-Image 78.36 | +6.48,逻辑推理 84.17 对 63.99、语法 91.18 对 72.19 |
| 文生图(提示遵循) | TIIF-Bench 长提示总分 | 87.08 | InternVL-U 73.9、BAGEL 71.7、Qwen-Image 86.8 | 统一模型最佳并超过 20B 生成专用 Qwen-Image |
| 物理科学图表生成 | VeriphyT2IBench Local 准确率 | 76.58 | Princigram-BAGEL(物理特化)75.69、GPT-Image-1 68.32 | 全场第一,超过物理特化基线;困难电磁学 81.30 领先 +11.2 |
| 指令图像编辑 | ImgEdit 总分(1-5)/ GEdit-EN(0-10) | 3.82 / 6.06 | LLaDA2.0-Uni 3.92 / 6.61;BAGEL 3.20 / 6.52 | ImgEdit 接近最佳,GEdit-EN 落后最佳统一模型约 0.5 |
| 图像生成推理加速 | 端到端延迟(秒/张,1024²)与 GenEval | 35.9s、GenEval 89.3(PHV,平均 60.4 步) | 生产路径 159.9s、GenEval 86.6(固定 96 步) | 4.45 倍加速且质量提升 +2.7 分 |
| 输出头消融(512²,约 200B token) | GenEval | 多码本 AR 头 82.78 | 独立并行头 68.94、Q-Former 头 69.67 | +13.8,差距集中在计数/位置/属性绑定 |
局限与改进
作者明确承认两条局限:其一,多码本 AR 头在每个位置需要 $K=8$ 步串行解码,带来额外推理开销,且高分辨率生成本身就产生很长的视觉序列,两者的叠加限制了吞吐上限;其二,当前系统只覆盖图像生成与编辑,视频和 3D 资产的生成尚未支持,距离真正的『全视觉生成』还有距离。我自己观察到更多:第一,编辑与文字渲染是明显短板——GEdit-EN 6.06 落后 LLaDA2.0-Uni(6.61)和 InternVL-U(6.66),UniGenBench 文字渲染维度仅 20.11(LLaDA2.0-Uni 31.23、Qwen-Image 72.13),OneIG-Bench 文字项 0.701 也不及 Qwen-Image 的 0.891,说明 8×4096 的离散码本虽然容量大,渲染像素级精确文字仍是离散 token 化的固有难点。第二,生成多样性全场最低(OneIG diversity 0.150,NVIDIA 线更是低到 0.130),CFG 与平台期提前提交可能共同加剧了模式坍缩。第三,跨平台结果方差不小:3D MM-Vet 上昇腾线 50.5 对 NVIDIA 线 43.8、空间分项 60.1 对 37.9,差距接近专用模型级别,提示该能力对训练预算和平台实现较敏感,复现结论时应参考两线区间。第四,理解侧虽在同规模统一模型中领先,但 MMMU 52.2、MMMU-Pro 38.5 与顶级专用 VLM 仍有差距,且多数生成评测依赖 MLLM judge,与人类偏好存在已知偏差。
独立分析的弱点
独立分析出五个弱点。第一,AR 头的 $K=8$ 步串行采样在批量推理时是结构性瓶颈:即使有 KV cache,每个 masked 位置每步仍要顺序过 6 层深度 Transformer 8 次,高分辨率(1024² 网格 32×32=1024 位置以上)下位置数×码本数的乘积会让 AR 头开销接近骨干本身;改进方向是码本级投机采样——用一次并行预测做草稿、再用因果校验接受,或把 8 步蒸馏成 2-3 步。第二,编辑能力偏弱(GEdit-EN 6.06 落后同规模最佳约 0.5 分):编辑样本在混合中占比最高仅 10%(SFT 阶段),且掩码扩散对『未提及区域保持不变』缺乏显式约束;可引入保持一致性损失或对未编辑区域做码级复制监督。第三,文字渲染薄弱(UniGenBench Txt 20.11):字符笔画需要像素级精确而 FSQ 码本对此并不敏感,可针对性扩充字符渲染合成数据并在损失中加权文字区域。第四,多样性崩塌(OneIG diversity 0.150 全场最低):平台期提前提交会让早期形成的布局锁死、缺乏后期全局重组机会,CFG scale 4.0 也会锐化分布;可在 Halton 顺序中引入随机扰动或在重掩码阶段保留低置信探索。第五,跨平台方差过大(3D 空间推理 60.1 对 37.9):3D 数据本就只占 1-2%,小数据下平台数值实现的细微差异被放大;应报告多种子方差、并对低资源模态采用更长训练或数据增强,而不是让单一 checkpoint 的数字主导结论。
未来方向
作者提出的方向有四个:把生成能力从图像扩展到视频和 3D 资产(AToken 已提供统一的 4D 潜空间,接口层面是现成的);探索更紧密交错的图文混合生成(目前视觉答案独立去噪、后轮不复用,交错的 thinking-before-image 已初步验证方向);用强化学习做后训练(GenExam/VeriphyT2IBench 这类细粒度评分点天然可作奖励信号);以及扩大骨干规模。基于成果还可以延伸:其一,码本维度的 coarse-to-fine 调度——让 AR 头先生成语义码后生成细节码,可能同时改善编辑保真和采样速度;其二,把 PHV 的时间信号思想反哺文本块扩散,统一文图两套加速策略;其三,多码本离散状态天然适合作为世界模型的紧凑动作-观测接口,值得向具身和交互式生成方向试探;其四,针对视觉置信度普遍偏低(中位 0.046-0.127)的现象做概率校准研究,校准后的置信度也许能让阈值类加速方法重新可用。
复现评估
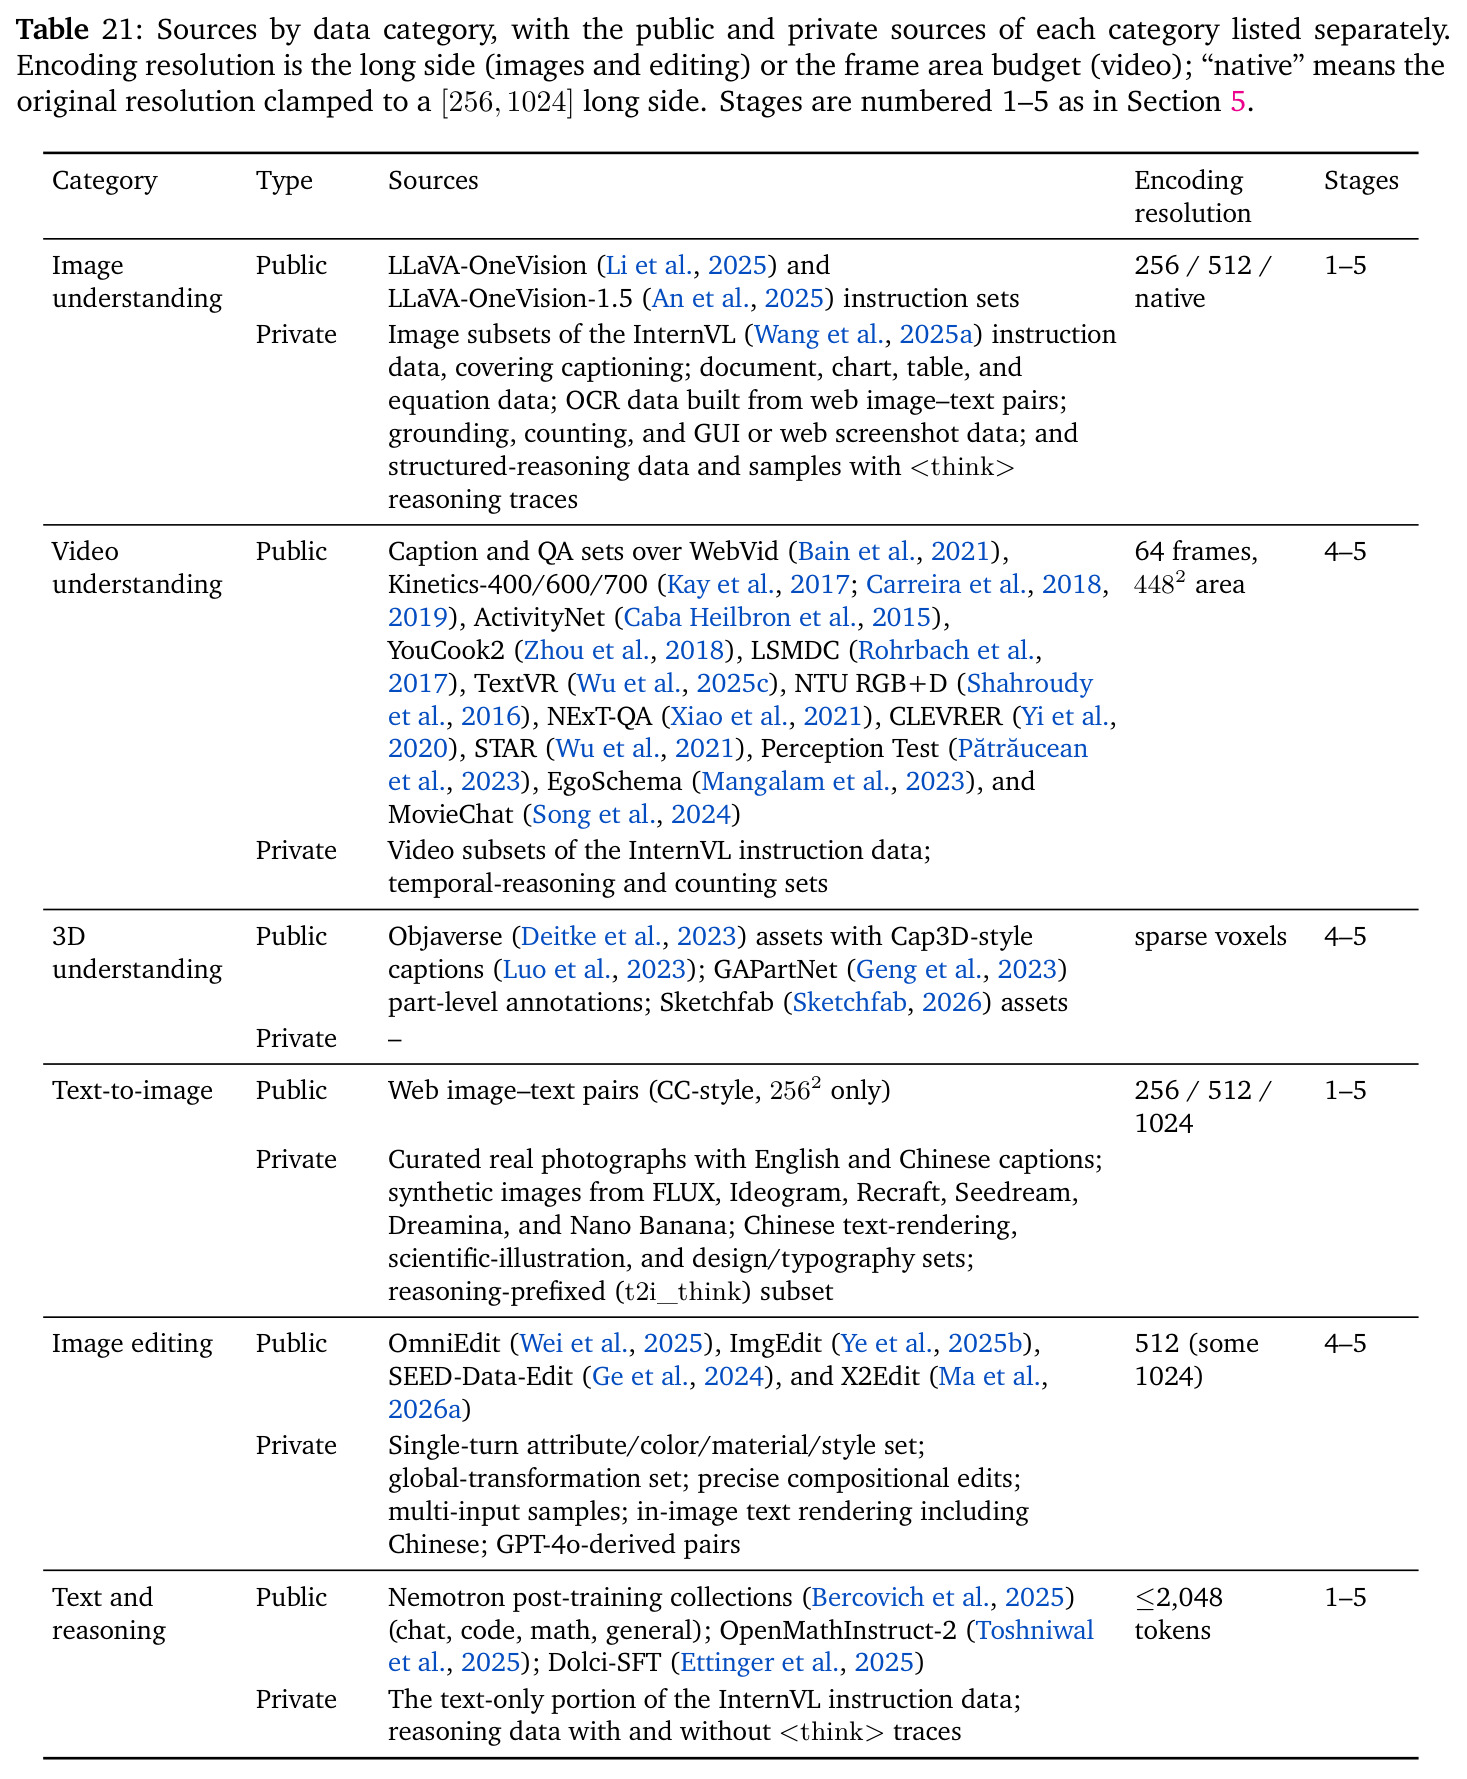
开源情况:论文首页标注了 Project Page、Code 和 Model 三个发布入口,作者明确承诺开源权重与代码;骨干 LLaDA2.0-mini 和视觉 tokenizer AToken 均为公开模型,构成可获取的起点。数据层面部分依赖私有资源——InternVL 私有指令数据、内部合成编辑数据,且重标注用 InternVL3.5-30B-A3B、质检用 Qwen3-VL-30B-A3B-Instruct,完整数据管线难以 1:1 复刻,但公开部分(LLaVA-OneVision、OmniEdit、ImgEdit、SEED-Edit、Objaverse 等)足够搭建近似管线。算力需求是最大门槛:主模型在 1,024 卡昇腾 910B 上训练,总 token 预算约 1.05T(50B+200B+500B+300B);NVIDIA 参考线用 192 块 GPU、约 650B token,即便按参考线配置也远超学术实验室预算。可行的复现路径是降级验证:论文自己的消融就在 512² 分辨率、约 200B token、192 GPU 规模下完成(Table 15/16),核心结论(AR 头对并行头 GenEval +13.8、独立嵌入表精度优势)在这个规模即可复现;PHV 采样与加速实验只需推理权重和 553 条 GenEval 提示,单节点即可验证 4.45 倍加速。综合评估:方法核心思想中等难度可验证,全量结果复现难度极高。
论文图表