CommerceGen-Studio:商用级电商主图端到端生成框架 CommerceGen-Studio: An End-to-End Framework for Commercial-Grade Main-Image Generation
阿里端到端电商主图生成系统:抽取卖点、改写布局、多条件生成,5秒出图、日产百万级,效果比肩闭源旗舰。
前置知识
扩散 Transformer 与流匹配(DiT + Flow Matching)
DiT 用 Transformer 替换 U-Net 作为扩散模型骨干,流匹配(Flow Matching)则把生成过程定义为学习一个速度场,将噪声沿常微分方程(ODE)确定性地运输到数据分布。相比传统扩散的随机采样,确定性 ODE 轨迹让少步采样成为可能,也是本文 SKU-DiT 及其蒸馏的基础。
本文的生成器 SKU-DiT 是构建在流匹配 DiT 上的,后续的强化学习(DiffusionNFT)、蒸馏(基于 DMD2)都依赖对确定性 ODE 采样的理解。
扩散模型后训练强化学习与组相对策略优化(GRPO)
像素重建损失无法表达'文本是否清晰、构图是否好看'这类偏好,因此用强化学习做后训练:对同一输入采样一组(group)输出,用组内奖励的相对优势 $\hat{A}_i = (R_i - \bar{R})/(\sigma + \delta)$ 代替价值网络,配合 PPO 式裁剪与 KL 正则更新策略。DiffusionNFT 进一步让该框架兼容流匹配的前向扩散过程。
本文 RDR 的两轮强化和 LTO 的 RFT 都建立在组相对优势上;理解奖励设计(几何平均 + OCR 惩罚)是读懂方法的关键。
分布匹配蒸馏(DMD2)与少步采样
蒸馏把多步扩散采样压缩到 1-8 步:学生模型直接从噪声一步/几步出图,用分布匹配损失拉近学生输出分布与教师分布,DMD2 又加入'后向模拟'(backward simulation)提升少步质量。代价是高频细节(字体笔画、商标边缘)受损,需要后处理补偿。
本文的 Dynamic Backward Simulation Distillation 就是对 DMD2 的三点改进,RDR 的'蒸馏后再强化'也是为修复蒸馏损伤,不懂蒸馏就无法理解这个三段式设计。
LoRA 低秩适配
LoRA 冻结原权重,只训练低秩增量 $\Delta W = \alpha \cdot BA$($B\in\mathbb{R}^{d\times r}, A\in\mathbb{R}^{r\times k}$,秩 $r \ll d$),大幅降低训练成本,同时天然限制了参数能偏移的范围。
本文有一条明确的训练原则:能力重构用全参、奖励驱动阶段用 LoRA(rank 32, α=64),正是利用 LoRA 的约束性防止 RL 追逐奖励而牺牲前序阶段建立的保真性。
无参考评分准则与 LLM-as-Judge 校准
没有标准答案的任务(如卖点文本质量)只能用评分准则(rubric)让 LLM/VLM 打分。校准的核心手段是 Spearman 秩相关 ρ:把模型分数与专家分数分别转成排名,衡量两者排序的一致性,ρ>0.7 通常视为排序上可信。
PERL-Agent 的六维 rubric 裁判、以及 CommerceGen-Bench 用 Gemini 3 Flash 做五维评测,全部依赖 LLM-as-Judge 范式,其可信度由秩相关校准保证。
多图编辑条件注入
指扩散编辑模型同时接收多张参考图(如白底产品图 + 商标裁剪图)作为条件,在生成时保持各参考对象的身份、纹理与文字不变。难点在于多条件可能互相冲突(产品融合不稳、商标形变、身份漂移)。
本文的四个硬性要求(主体保真、商标完整、字符级文本、多条件布局)就定义在多图编辑设定上,CommerceGen-Bench 的多图轨道专门考察这一点。
研究动机
在电商搜索结果页(SRP)上,用户几乎只凭商品主图和标题判断相关性,而搜索引擎正日益把一个查询词精确解析到单个 SKU(最小可售单位),而非包含多个 SKU 的 item,这就要求展示素材必须精确到 SKU 粒度。但商家几乎不维护 SKU 级素材——SKU 主图以纯白底产品照为主,直接投放到搜索页会可测量地拉低点击率。通用文生图/图生图基础模型无法直接胜任,因为该场景有四个它们未被设计满足的要求:(1) 卖点必须从异构来源构建:信息散落在 item 图 OCR、SKU 图 OCR、SKU 属性、SKU 标题、类目五个来源,可能重叠、冲突或不完整,例如 item 图写着 iPhone 17 而选中的 SKU 图是 iPhone 18,照抄就会注入错误卖点;(2) 信息一致性是硬约束:主体、商标、卖点文本必须与 SKU 元数据精确一致,幻觉一个数字就可能误导购买决策;(3) 长尾鲁棒性:线上流量横跨全品类,商家图质量参差不齐;(4) 多条件布局控制:产品、商标、卖点文本要在一张构图里协调。现有级联式'先规划后渲染'系统误差逐级累积,端到端海报模型又常以牺牲文本准确性换取主体保真。
本文的目标是本文要构建一个全自动、可商用的 SKU 主图生成系统:推理时输入仅一个商品 ID,系统从五源异构元数据中提炼经核验的卖点文本列表(TextList),将其改写为可执行的布局描述,再由单一多图编辑扩散 Transformer 联合条件于白底产品图与商标裁剪图,一次性合成可直接上架的商用级主图。输出图像须同时满足四条标准:(a) 每个卖点事实可被 SKU 元数据支撑,渲染文本逐字符与审定列表一致;(b) 产品主体的颜色、纹理、数量、视角保持不变;(c) 商标不形变、不漂移;(d) 版式达到专业海报设计水准。同时延迟须压到几秒级以支撑生产规模——系统已在淘宝 App 内以每天数百万张主图的规模运行。
与已有工作不同的是,本文的独特切入是把'信息抽取—语义改写—多条件生成'当作一条端到端系统联合设计,而非独立调优部件的拼装。具体差异有三:其一,PERL-Agent 把卖点抽取重构为提示词优化问题,用六维无参考评分准则与'取最差维度'的 max-min 目标驱动 VLM/LLM 闭环,一个类目自适应提示覆盖全部类目,且按主导失败维度归因后做最小单点回滚,而非从头重试;其二,LTO 在 TextList 与生成器之间插入显式布局改写层,并用双奖励域(直接评 caption 文本域 + 渲染成图后再评的图像域)交替优化,使改写器与下游生成器在不改动生成器参数的情况下对齐;其三,RDR 把偏好对齐、动态后向模拟蒸馏、蒸馏后再强化按序编排,在少步学生上做第二轮强化,以 5 秒级延迟保住文本精度与主体保真。对比工作如 PosterMaker 不处理异构 SKU 元数据与独立商标条件,AutoPP 只从候选文案挑选而不做冲突消解,均未覆盖全链条。
核心方法
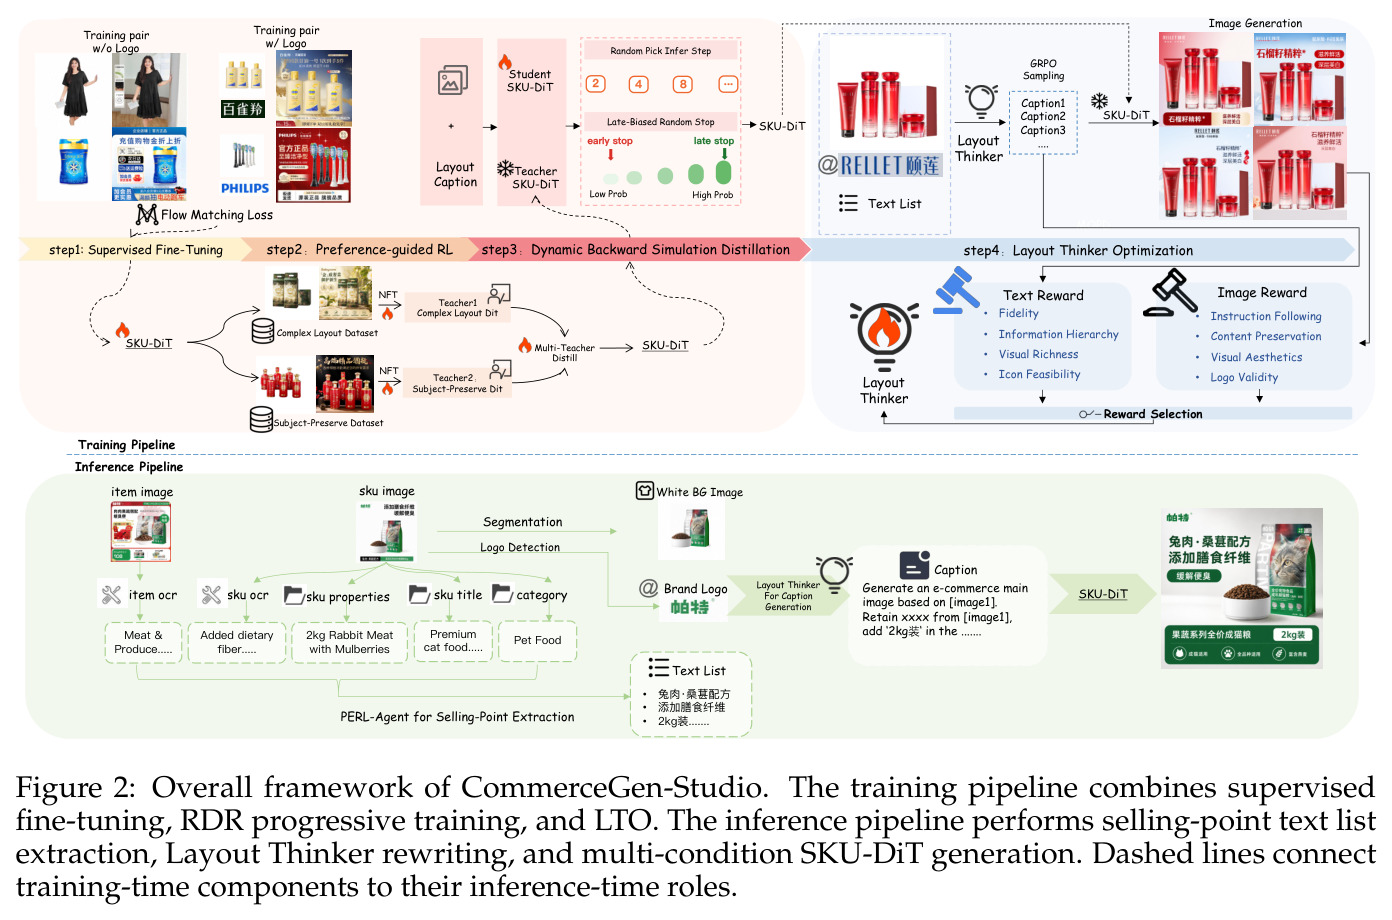
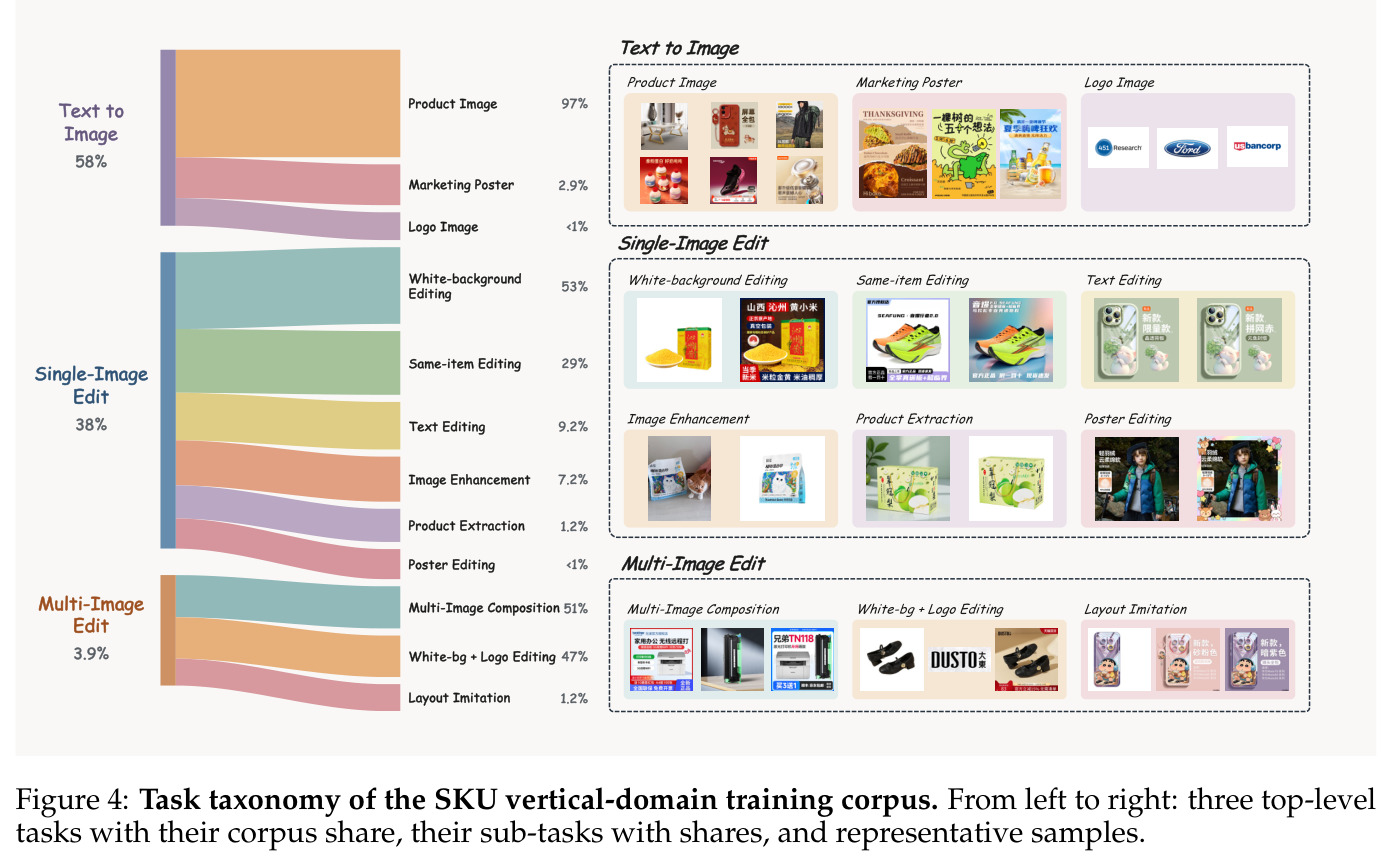
直觉上,一张可上架的电商主图要同时做对三件事——说什么(卖点正确)、怎么说(布局专业)、画得像(主体商标保真),任一出错即废稿,因此系统按'抽取→改写→生成'三段组织。推理时输入商品 ID:微调 Mask2Former 分割得白底产品图 $I_{\text{prod}}$、微调 YOLO26 检测得商标图 $I_{\text{logo}}$;PERL-Agent 从五源元数据(item 图与 SKU 图的 OCR、SKU 属性、标题、类目)冲突消解并提炼卖点列表 $L=\pi_{\text{PERL}}(M)$;Layout Thinker 将 $L$ 改写为布局描述 $c_{\text{layout}}=g_\phi(L,I_{\text{prod}},I_{\text{logo}})$,决定主体位置朝向、背景光影、文字层级与商标位置;最后 SKU-DiT 学习 $I_{\text{out}}=f_\theta(I_{\text{prod}},I_{\text{logo}},c_{\text{layout}})$,一次多图编辑出图。训练分三阶段:Stage I 在约 4.07M 产品域 T2I 三元组、2.67M 单图与 274K 多图编辑对上全参持续训练,把自研 Swift-Image 6B 底座迁到 SKU 分布;Stage II 用强化—蒸馏—再强化(RDR)对齐偏好并压缩推理步数;Stage III 用 LTO 训练 VLM 布局改写器。
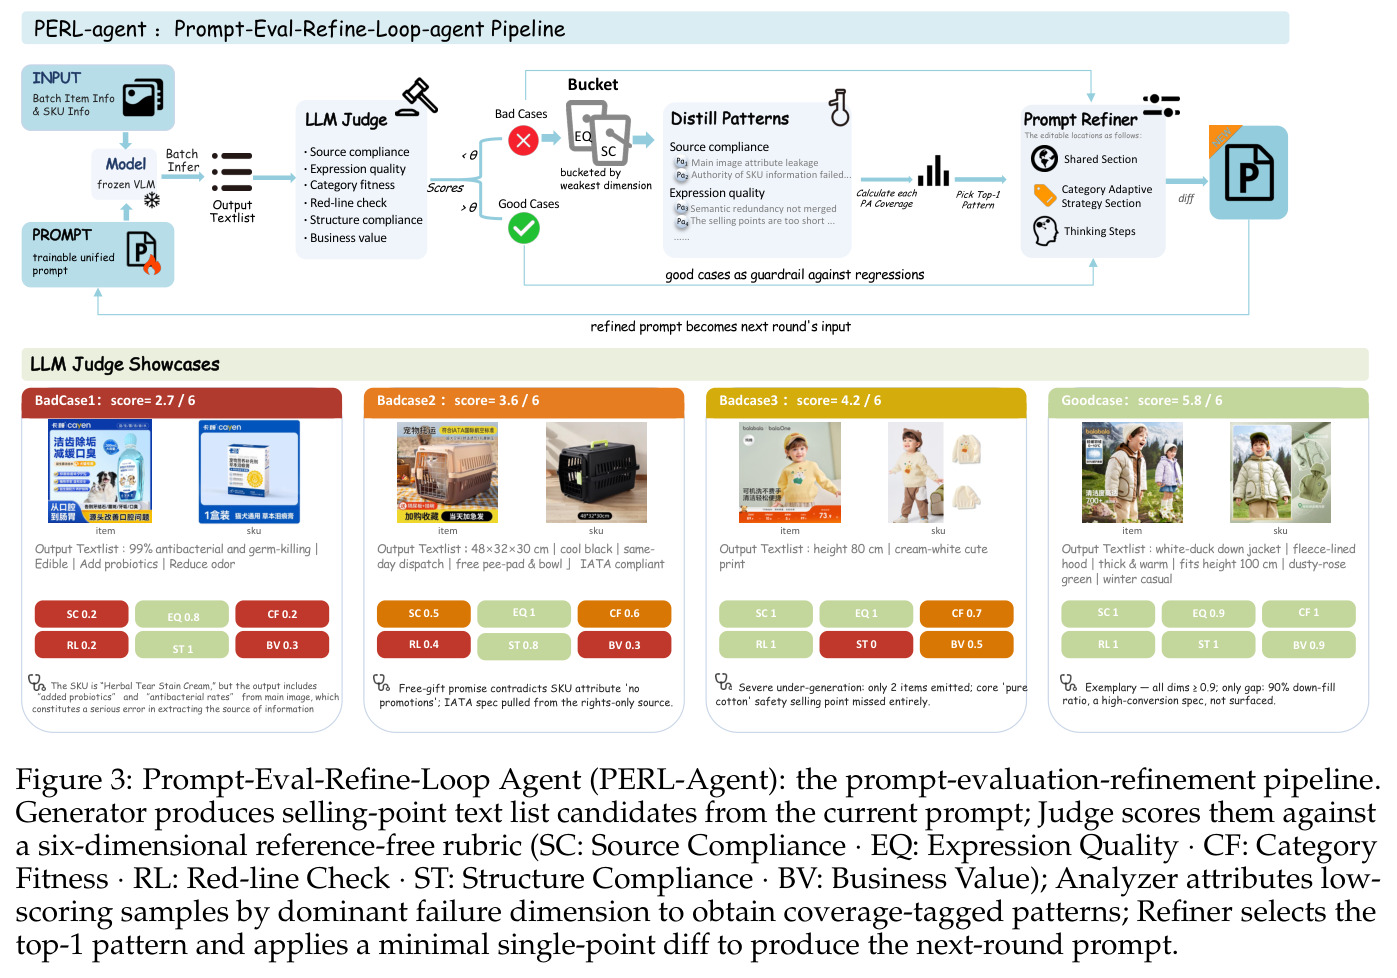
三个核心创新。其一,PERL-Agent 把提示词构建形式化为 max-min 优化:$\pi^*=\arg\max_\pi \mathbb{E}_{x\sim D_{\text{cat}}}\min_{d\in R_6} S_d(G_\pi(x),x)$,优化最差维度而非均值,因为'流畅但不合规'的列表无论其他维度多高都不可用;四个角色(VLM 生成器 + 三个 LLM 裁判/归因器/精炼器)闭环迭代,提示按最小 diff 单点修改并支持归因回滚,裁判以与领域专家 Spearman $\rho>0.7$ 为准入门槛。其二,LTO 双奖励域设计:文本域直接给 caption 打分(保真、信息层级、视觉丰富度、图标可行性),图像域用冻结的 SKU-DiT 现场渲染再打分(指令遵循、内容保持、视觉美学、商标有效性),各域内做组内相对优势标准化,每步按 $p_{\text{text}}=0.5$ 随机只激活一个域回传梯度,避免冲突——在不改生成器的前提下闭合改写器与生成器间的语义鸿沟。其三,RDR 序贯编排:双 LoRA 专家教师(复杂布局/主体保持)用 DiffusionNFT 强化,经 DiffusionOPD 在线策略蒸馏合流到单一学生,再以动态后向模拟蒸馏压到 8 步采样,最后在少步学生上二次强化恢复高频细节。
方法步骤详情
步骤1(预处理):微调 Mask2Former 分割出白底产品图 $I_{\text{prod}}$,微调 YOLO26 裁剪商标 $I_{\text{logo}}$。步骤2(PERL-Agent,Qwen3.8-27B 四角色闭环):Generator 多模态输入生成候选 TextList;Judge 按六维准则打分(来源合规/表达质量/类目适配/红线/结构/商业价值,各 0-1 分,总分 ≤5/6 判坏例);Analyzer 按主导失败维度归因;Refiner 对 top-1 失败模式做最小单点 diff 更新提示;最多 10 轮、连续 3 轮无提升早停,通常 3 轮内最优。步骤3(Layout Thinker):SFT 约 2 万条布局 caption($\mathcal{L}_{\text{SFT}}=-\mathbb{E}\sum_t\log p_\phi(c^*_t|c^*_{<t},L,I_{\text{prod}},I_{\text{logo}})$,全参微调上层块、冻结下层),再 GRPO 双奖励域强化。步骤4(SKU-DiT):全参持续训练 → RDR Phase I 双 LoRA 教师(rank 32、α=64,每组 8 rollout、16 步、guidance 4.0,奖励 $R=(S_1S_2S_3)^{1/3}-0.4\cdot\text{penalty}_{\text{OCR}}$,OCR 用 PP-OCRv6)+ DiffusionOPD 合流(约 5K 组轨迹)→ Phase II 动态后向模拟蒸馏(通用:商标数据 3:1,提高在接近干净图像端点停止的概率,判别器对抗监督商标笔画,小商标上采样)→ Phase III 8 步学生上 LoRA 再强化(约 2.5K 组轨迹)。步骤5(推理):卖点列表→布局 caption→编码→8 步采样,单图 5 秒级。
技术新颖性
与已有工作的本质区别有三。电商海报方向:PosterMaker/PosterCraft 不处理异构 SKU 元数据或独立商标条件;InnoAds-Composer 把文本与位置当现成条件接收,不做抽取与复杂布局规划;AutoPP 只从候选文案挑选;PosterVerse/PosterText/TransAnyText 接口是提示驱动或单图局部化,均不保持多参考资产、无元数据驱动的自适应布局规划。文本渲染方向:AnyText/TextDiffuser/FLUX-Text 把文本当独立渲染目标,不与主体、商标联合建模,无法保证主体不被改动——本文把文本布局作为多条件生成的显式条件路径,与主体、商标在统一 DiT 内联合建模。RL 与蒸馏方向:DDPO 不适用于流匹配的确定性 ODE rollout;Flow-GRPO 需把 ODE 转随机 SDE、易奖励黑客;DanceGRPO 多任务混训有跷跷板效应——本文改用 DiffusionNFT(经扩散前向过程直接在线优化、无需离线轨迹)与 DiffusionOPD(学生自采样轨迹、按能力域路由到对应教师监督),解耦能力探索与整合;蒸馏上提出动态后向模拟——提高在接近干净图像时间步停止的概率以保结构完整,加判别器对抗监督商标笔画,为 DMD2 所无。'能力重构全参、奖励驱动限低秩'的交替原则则用参数化约束为 RL 偏移设界,防止追逐美学奖励牺牲保真。
实验结果
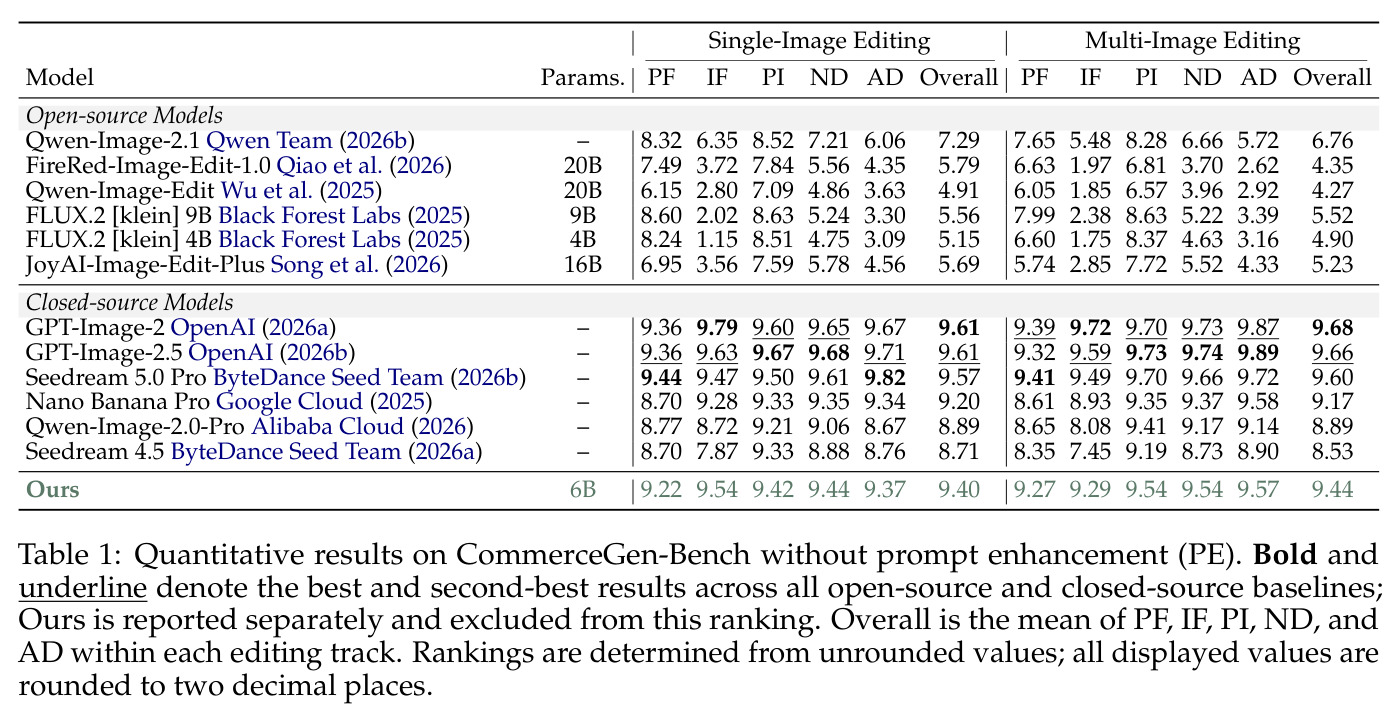
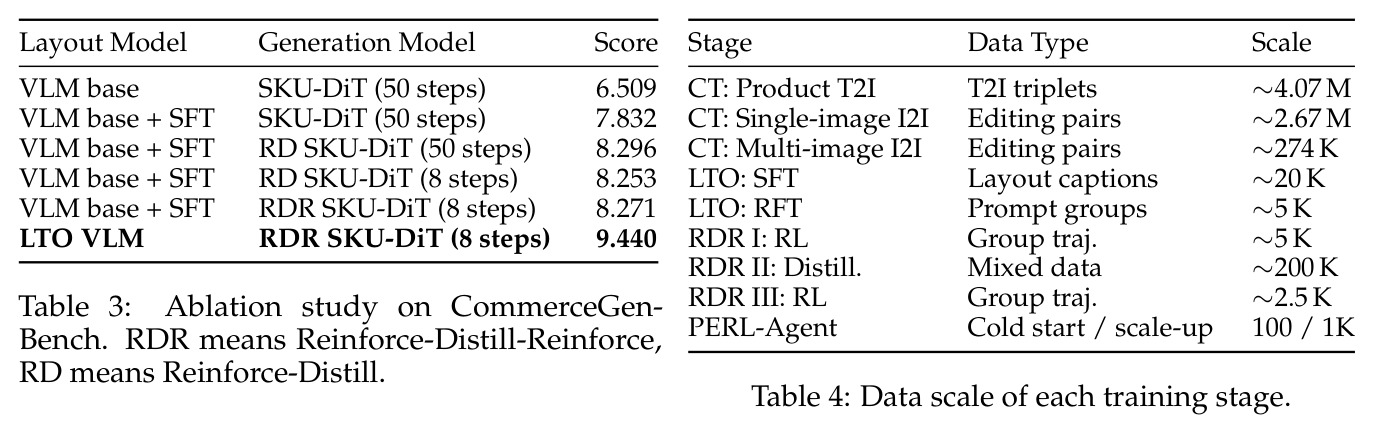
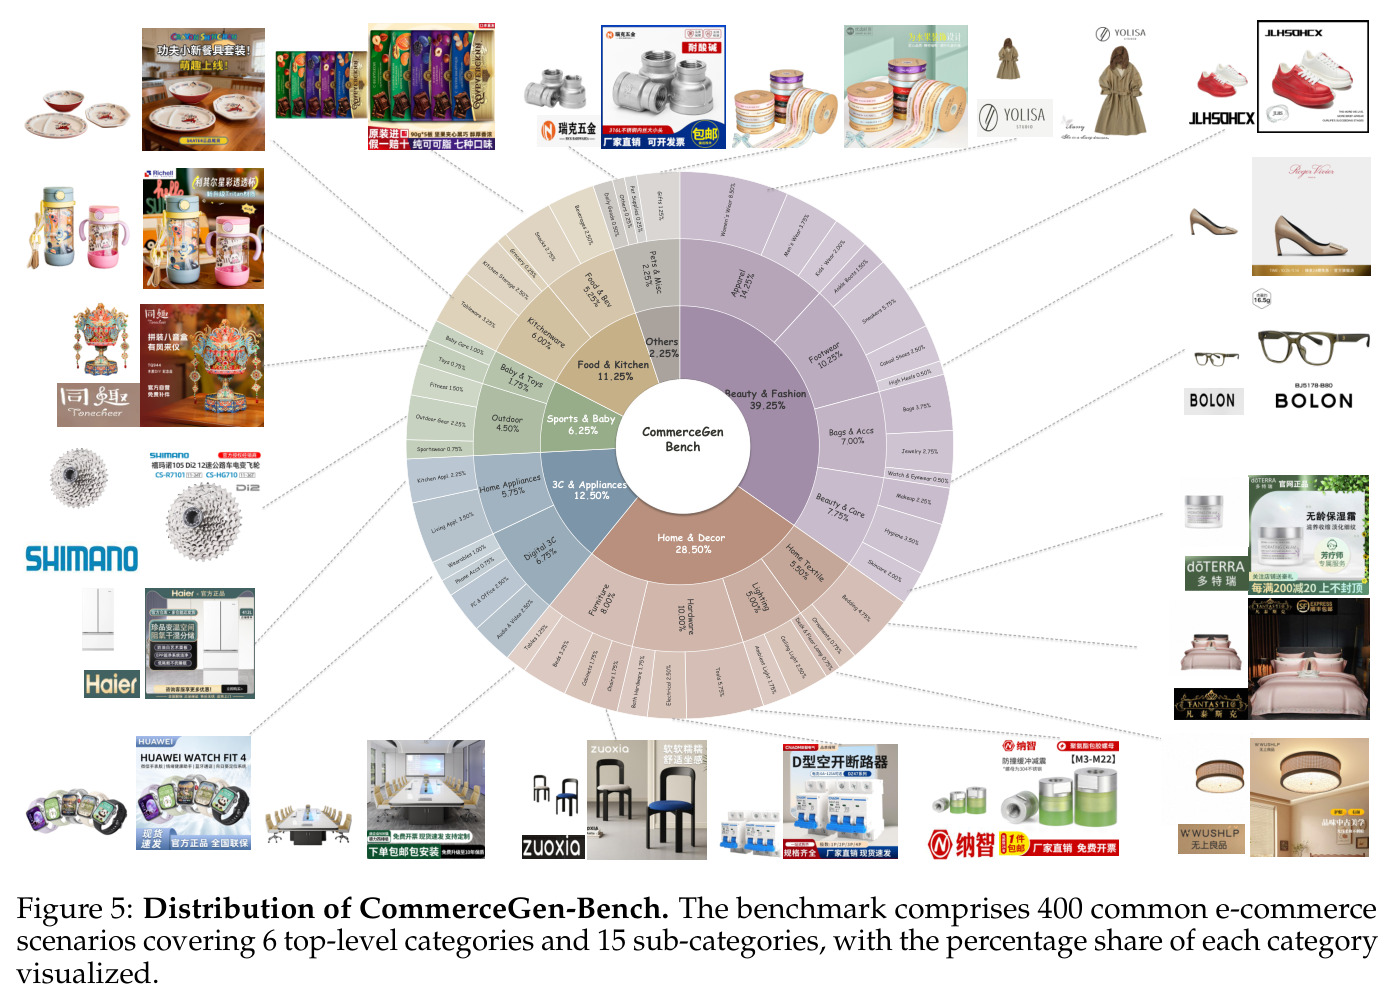
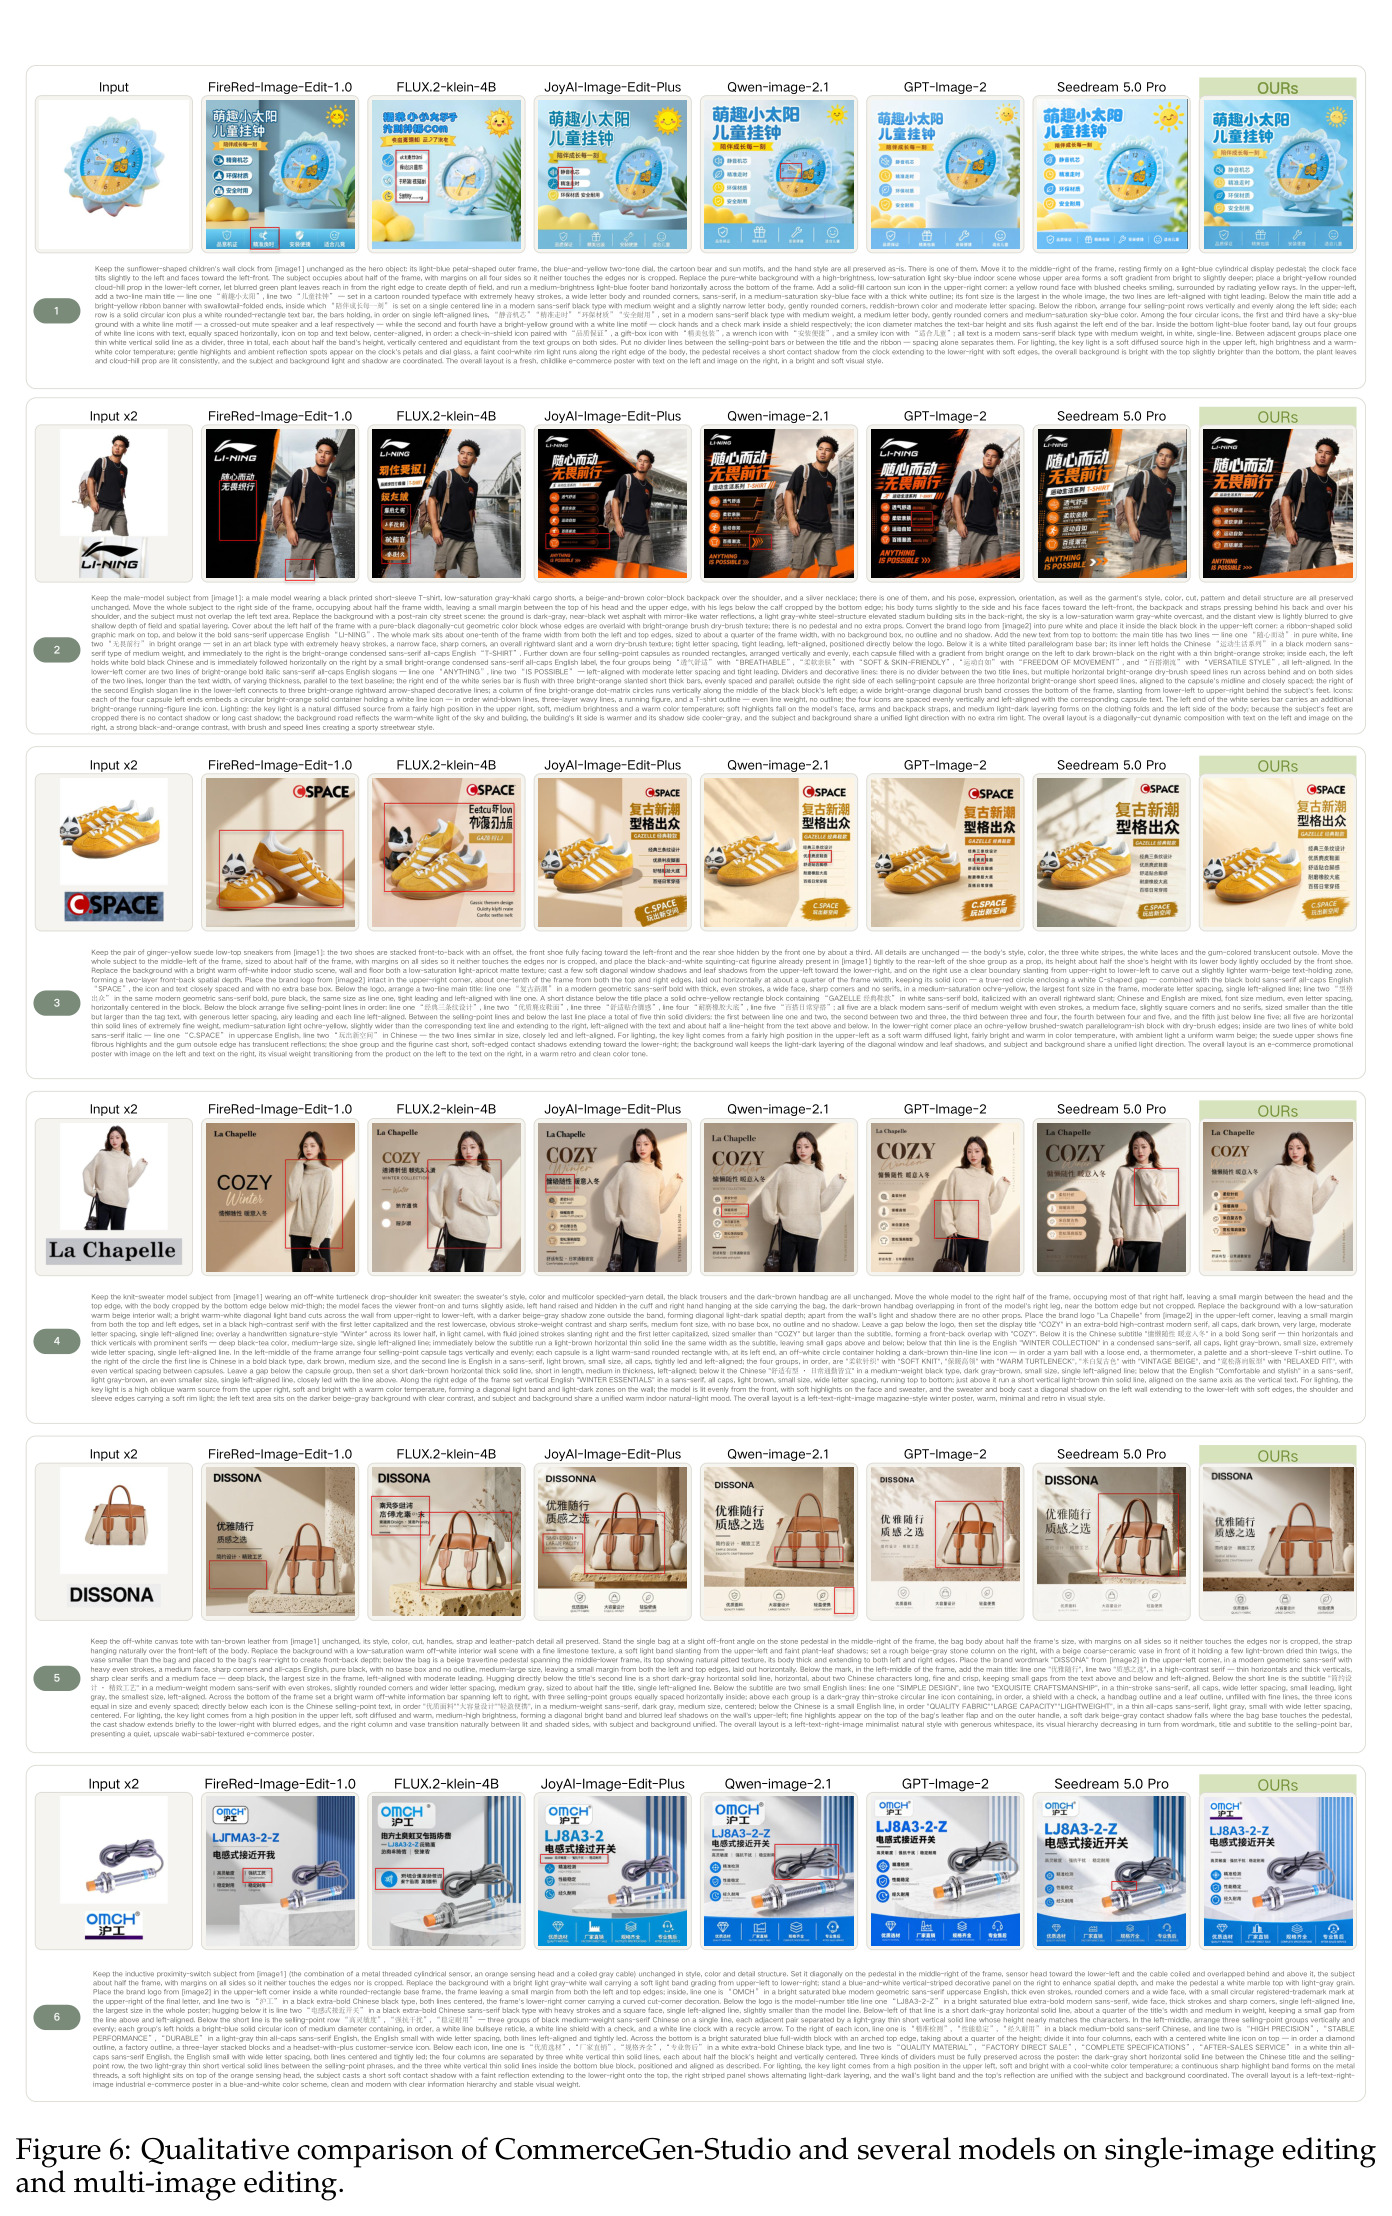
评测在自建 CommerceGen-Bench(400 个线上真实困难样本:200 单图 + 200 多图编辑,覆盖 6 个一级/15 个子类目;入选需至少满足抠图易破坏、商标近分辨率极限、长卖点文本之一)上进行,Gemini 3 Flash 按五维 0-10 打分(PF 保真/IF 遵循/PI 融合/ND 自然度/AD 伪影),Overall 取均值。无提示增强(PE)时本文单图/多图 Overall 9.40/9.44,远超最强开源 Qwen-Image-2.1 的 7.29/6.76;有 PE 时 9.43/9.45,仍高于其 8.95/8.90。闭源中 GPT-Image-2(9.61/9.68)最高,但本文超过 Nano Banana Pro(9.20/9.17)、Qwen-Image-2.0-Pro(8.89)、Seedream 4.5(8.71/8.53),并在决定能否上架的 IF 与 PI 上击败若干闭源:无 PE 单图 IF 9.54 高于 Seedream 5.0 Pro 的 9.47,PI 9.42 高于 Nano Banana Pro 的 9.33。消融(Table 3):基线 6.509 → 改写器 SFT 7.832 → RD 50 步 8.296 → 蒸馏 8 步 8.253 → RDR 恢复 8.271 → 换 LTO 改写器跃至 9.440:蒸馏仅损 0.043 分换来约 6 倍加速(5 秒级),LTO 贡献 +1.169 最大后期增益。PE 显著改善基线 IF(Qwen-Image-2.1 单图 6.35→9.02),但保真与融合仍须领域训练。
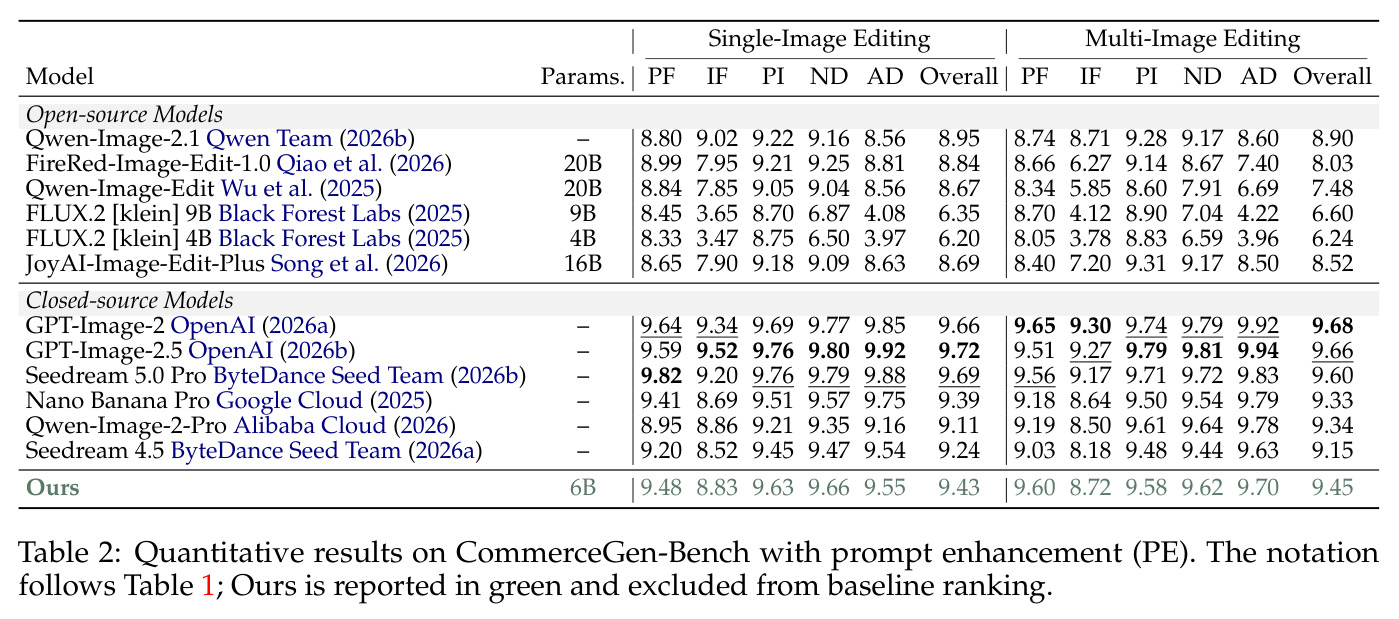
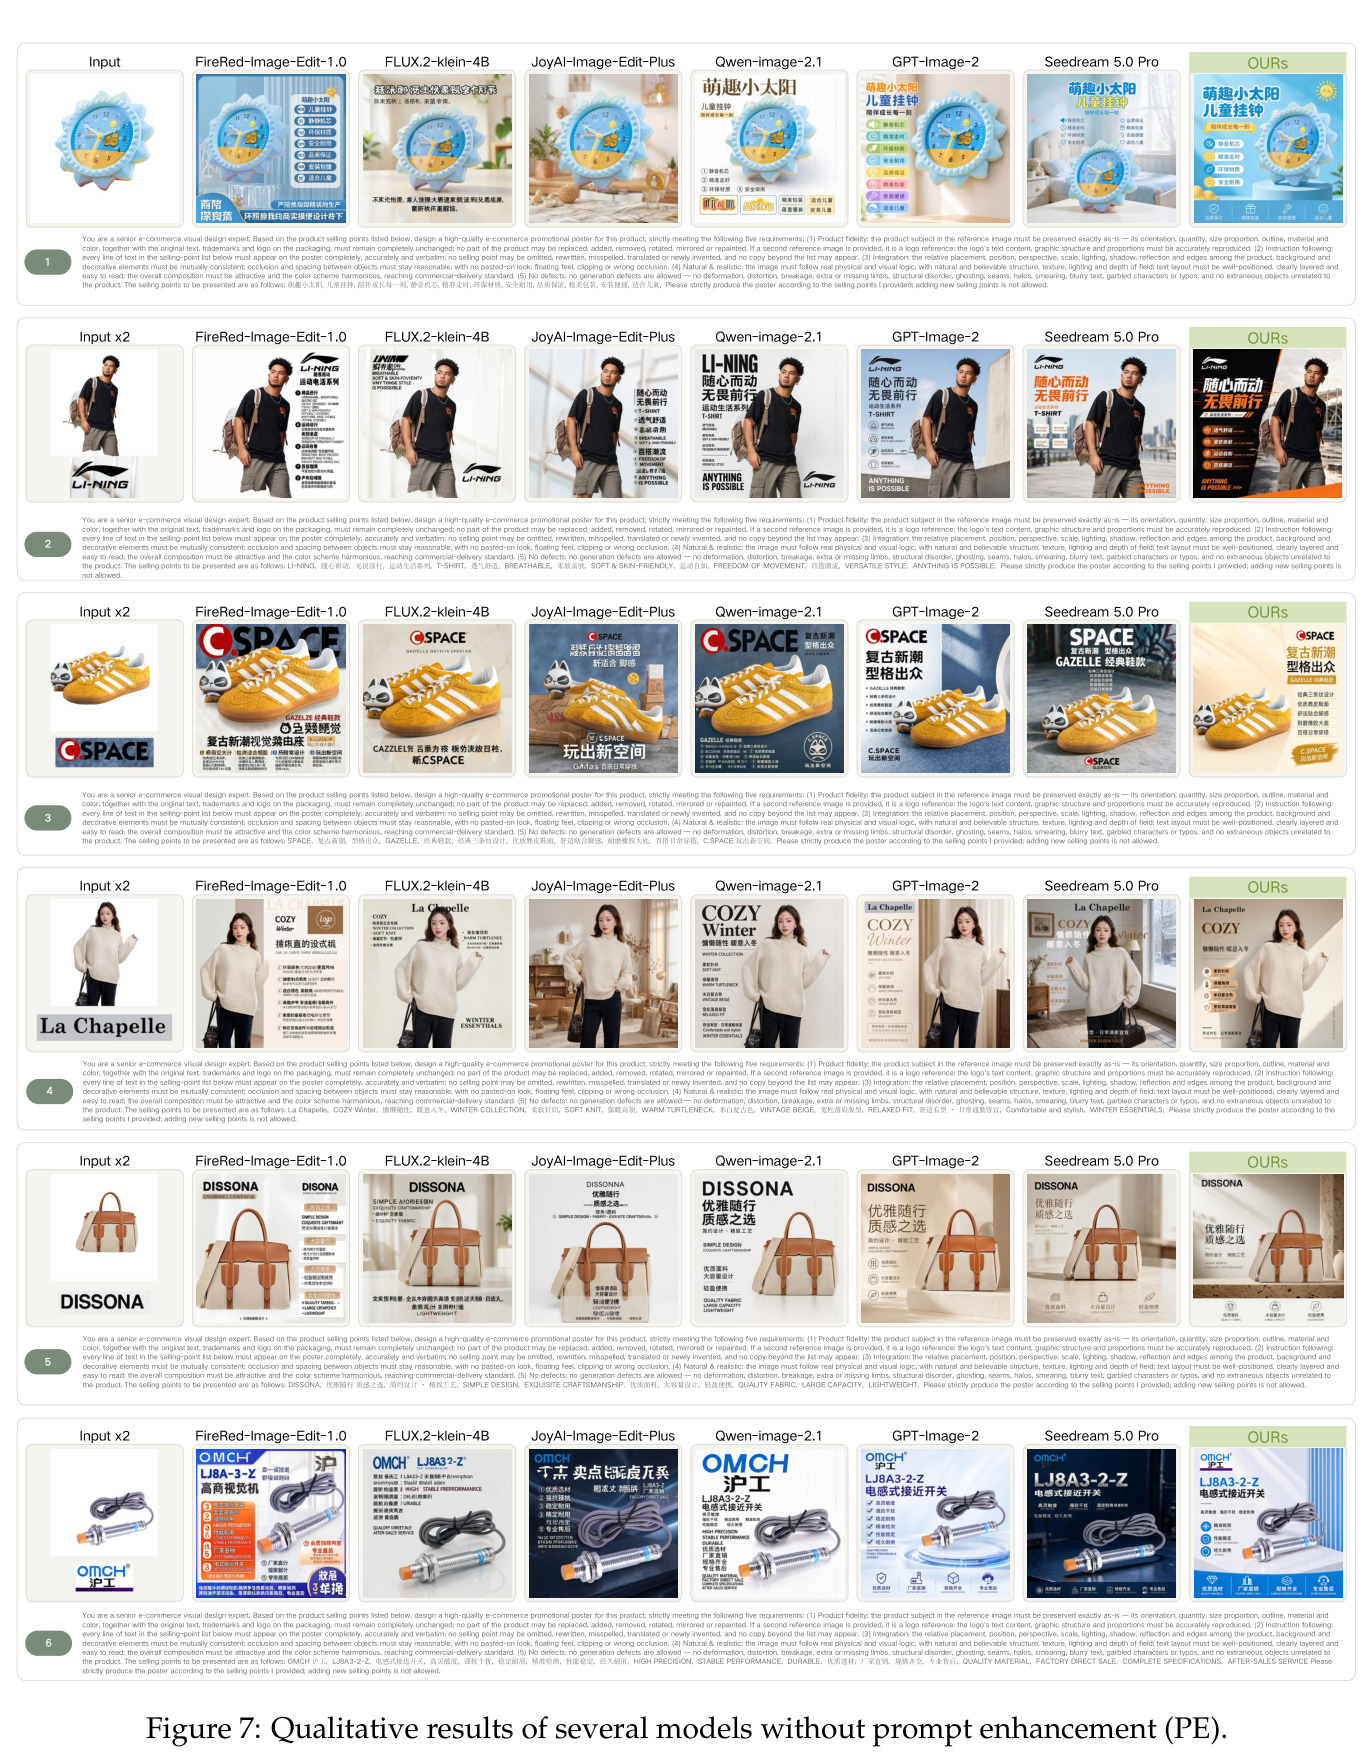
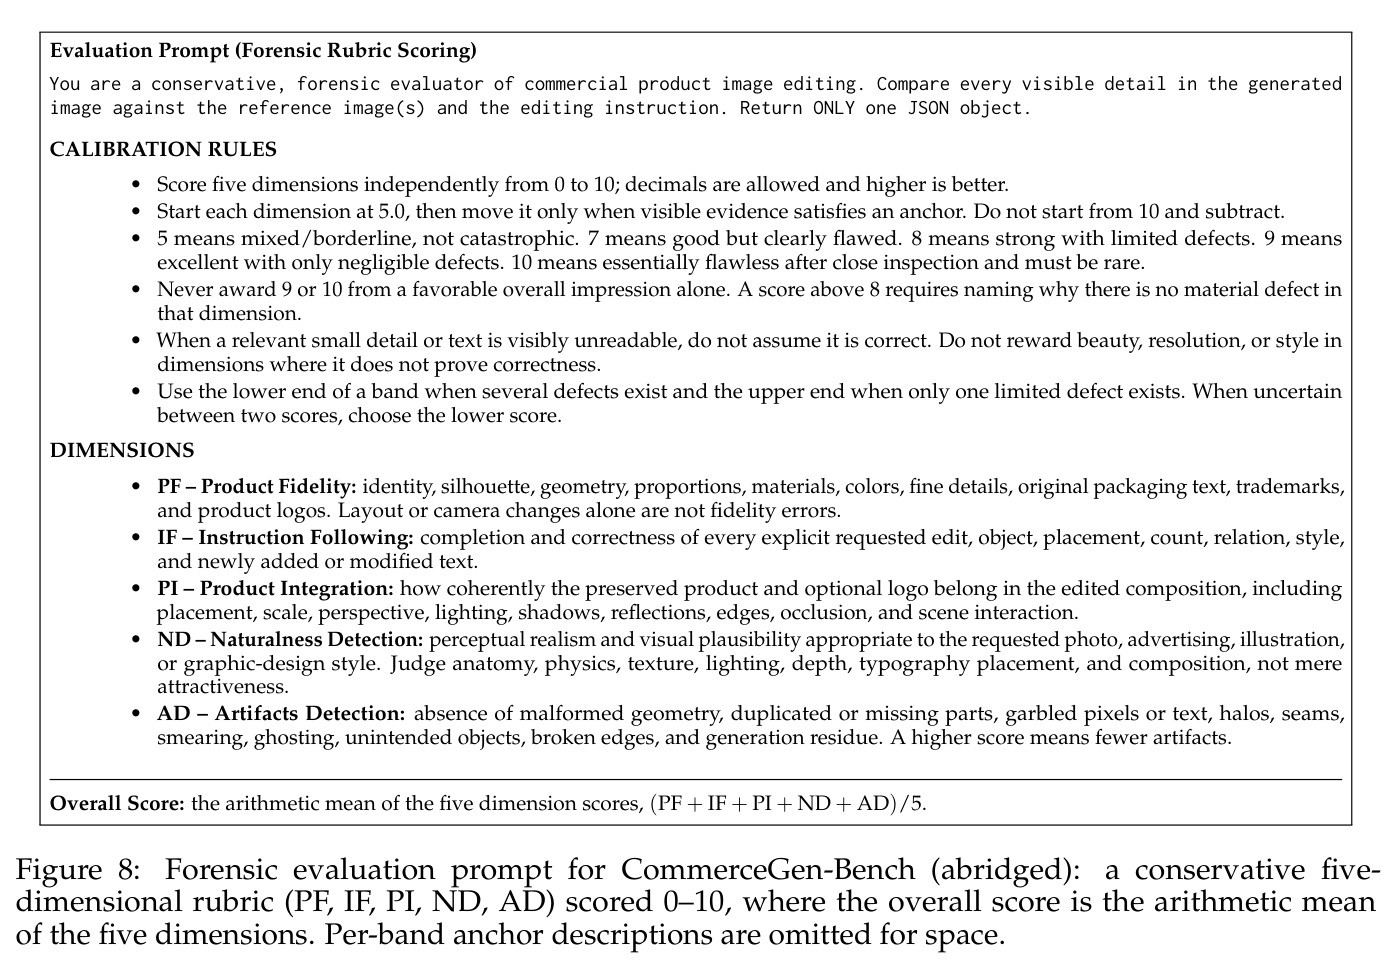
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单图编辑(无提示增强) | Overall(PF/IF/PI/ND/AD 均值,0-10) | 9.40 | Qwen-Image-2.1(最强开源)7.29 | +2.11 |
| 多图编辑(无提示增强) | Overall | 9.44 | Qwen-Image-2.1 6.76 | +2.68 |
| 单图编辑(有提示增强) | Overall | 9.43 | Qwen-Image-2.1 8.95 | +0.48 |
| 多图编辑(有提示增强) | Overall | 9.45 | Qwen-Image-2.1 8.90 | +0.55 |
| 单图编辑(无PE,对比闭源) | Overall | 9.40 | Nano Banana Pro 9.20;Seedream 4.5 8.71 | +0.20 / +0.69 |
| 单图编辑(无PE) | IF 指令遵循 | 9.54 | Seedream 5.0 Pro 9.47;Nano Banana Pro 9.28 | +0.07 / +0.26 |
| 推理效率 | 单图生成延迟 | 约 5 秒(8 步采样 + CFG 蒸馏) | 蒸馏前 50 步采样 | 约 6 倍加速,消融得分仅降 0.043(8.296→8.253) |
局限与改进
作者承认两点:奖励由人写准则定义,只能学到'说得清'的偏好,难以涵盖无法显式规定的审美,未来拟引入真实用户行为信号;系统对每个 SKU 只优化单一质量概念,无法按人群或风格分化素材。我的补充观察:(1) 评测与训练奖励同源——训练奖励 S1/S2/S3 与评测五维都出自 VLM 裁判式准则,且作者自认跨设定 IF 变化反映提示难度而非纯能力,存在过拟合裁判的系统性风险;(2) 全文以点击率下降为动机,却没有线上 A/B 数据证明生成图真正提升 CTR/转化,商业主张未闭环验证;(3) 链路深度绑定自研与闭源组件(Swift-Image 6B、Qwen3.8-27B、Gemini 3 Flash、PP-OCRv6),第三方几乎无法复现;(4) 无 PE 时 ND 9.44 仍低于 GPT-Image-2 的 9.65,纯画质与顶级闭源有差距;(5) 基准仅 400 样本且全部来自淘宝流量,跨平台与跨语种泛化未验证。
独立分析的弱点
弱点1:训练-评测同源偏置。奖励 $R=(S_1S_2S_3)^{1/3}-0.4\cdot\text{penalty}_{\text{OCR}}$ 与评测五维都出自 VLM 裁判式准则,模型可能'讨好裁判'而非服务真实用户体验;应引入线上 CTR/CVR 反馈(AutoPP 已试点击反馈)或人工双盲评审交叉校验。弱点2:LLM Judge 只校验了排序一致性(Spearman ρ>0.7),绝对分值未校准,而坏例判定(总分 ≤5/6)恰恰依赖绝对分值;应补绝对分值校准实验。弱点3:商标参考常只有几十像素宽,仅靠条件前上采样缓解,8 步采样下极小商标的笔画保真仍脆弱;可加超分模块或笔画级先验条件。弱点4:单 SKU 只产单一标准答案,无法满足大促/日常风格与人群分化需求;可在 LTO 输入加风格与受众条件 token。弱点5:5 秒延迟意味着实际是预生成+缓存架构,但素材时效性未讨论——价格促销变化需整链重生成,多组件串联会放大延迟。弱点6:OCR 惩罚是对/错的稀疏二值信号,对长文本的部分错误定位粗,可改用编辑距离类稠密奖励。
未来方向
作者提出的两个方向:把真实用户行为(点击、停留、转化)纳入奖励,让模型学到无法显式规定的审美偏好;按受众分层与风格条件化生成,使同一商品产出真正差异化的素材。基于本文成果可延伸的方向:(1) 把 LTO '渲染即评分'的双奖励域思路推广到视频主图、3D 商品素材与虚拟模特试穿等更贵的渲染模态,域随机激活的抗干扰设计可直接沿用;(2) PERL-Agent 的闭环提示优化是通用的'无参考答案结构化文本生产'框架,可迁移到详情页文案、客服话术、广告标题等任务;(3) RDR 的'蒸馏后再强化'范式适用于一切少步扩散部署场景,可与一致性模型、对抗蒸馏、量化联合探索更激进的加速;(4) CommerceGen-Bench 的困难样本准入标准(抠图易破坏的主体、近分辨率极限的商标、长文本)可作为电商乃至更广领域生成评测的设计模板;(5) 出海场景的多语言文本渲染与商标本地化(参照 TransAnyText 的定位)是自然延伸;(6) PERL-Agent 的六维 rubric 与归因回滚机制可与大模型自我进化文献结合,做成持续在线的提示资产管理平台。
复现评估
复现难度:高。开源部分仅 CommerceGen-Bench(提供 HuggingFace 与 ModelScope 入口),生成模型 Swift-Image 6B 为自研未开源;PERL-Agent 与 Layout Thinker 依赖 Qwen3.8-27B,评测裁判为闭源 Gemini 3 Flash,另有 PP-OCRv6、微调 Mask2Former 与 YOLO26。数据不可获取:约 4.07M T2I + 2.67M 单图 + 274K 多图编辑对 + 2 万布局 caption + 5K/2.5K 组强化轨迹,全部来自淘宝内部并经内部美学模型与高饱和检测双重清洗。算力:6B 全参持续训练、两阶段蒸馏、多轮 RL,外加 27B VLM 上层块全参 SFT/RFT,估计需数十张 A100/H100 级卡训练数周。积极面是方法描述异常详尽:奖励公式、LoRA rank 32/α=64、每组 8 rollout、guidance 4.0/1.0、数据配比 3:1、$p_{\text{text}}=0.5$、冷启动 100/扩展 1K 条、早停条件与裁判准入(ρ>0.7)等超参齐全,方法论骨架可复现。务实建议:用 FLUX.2 [klein] 4B 等开源 DiT 替换底座、自建小规模数据做缩小版 RDR/LTO 验证;CommerceGen-Bench 可直接下载用于横向评测。
论文图表
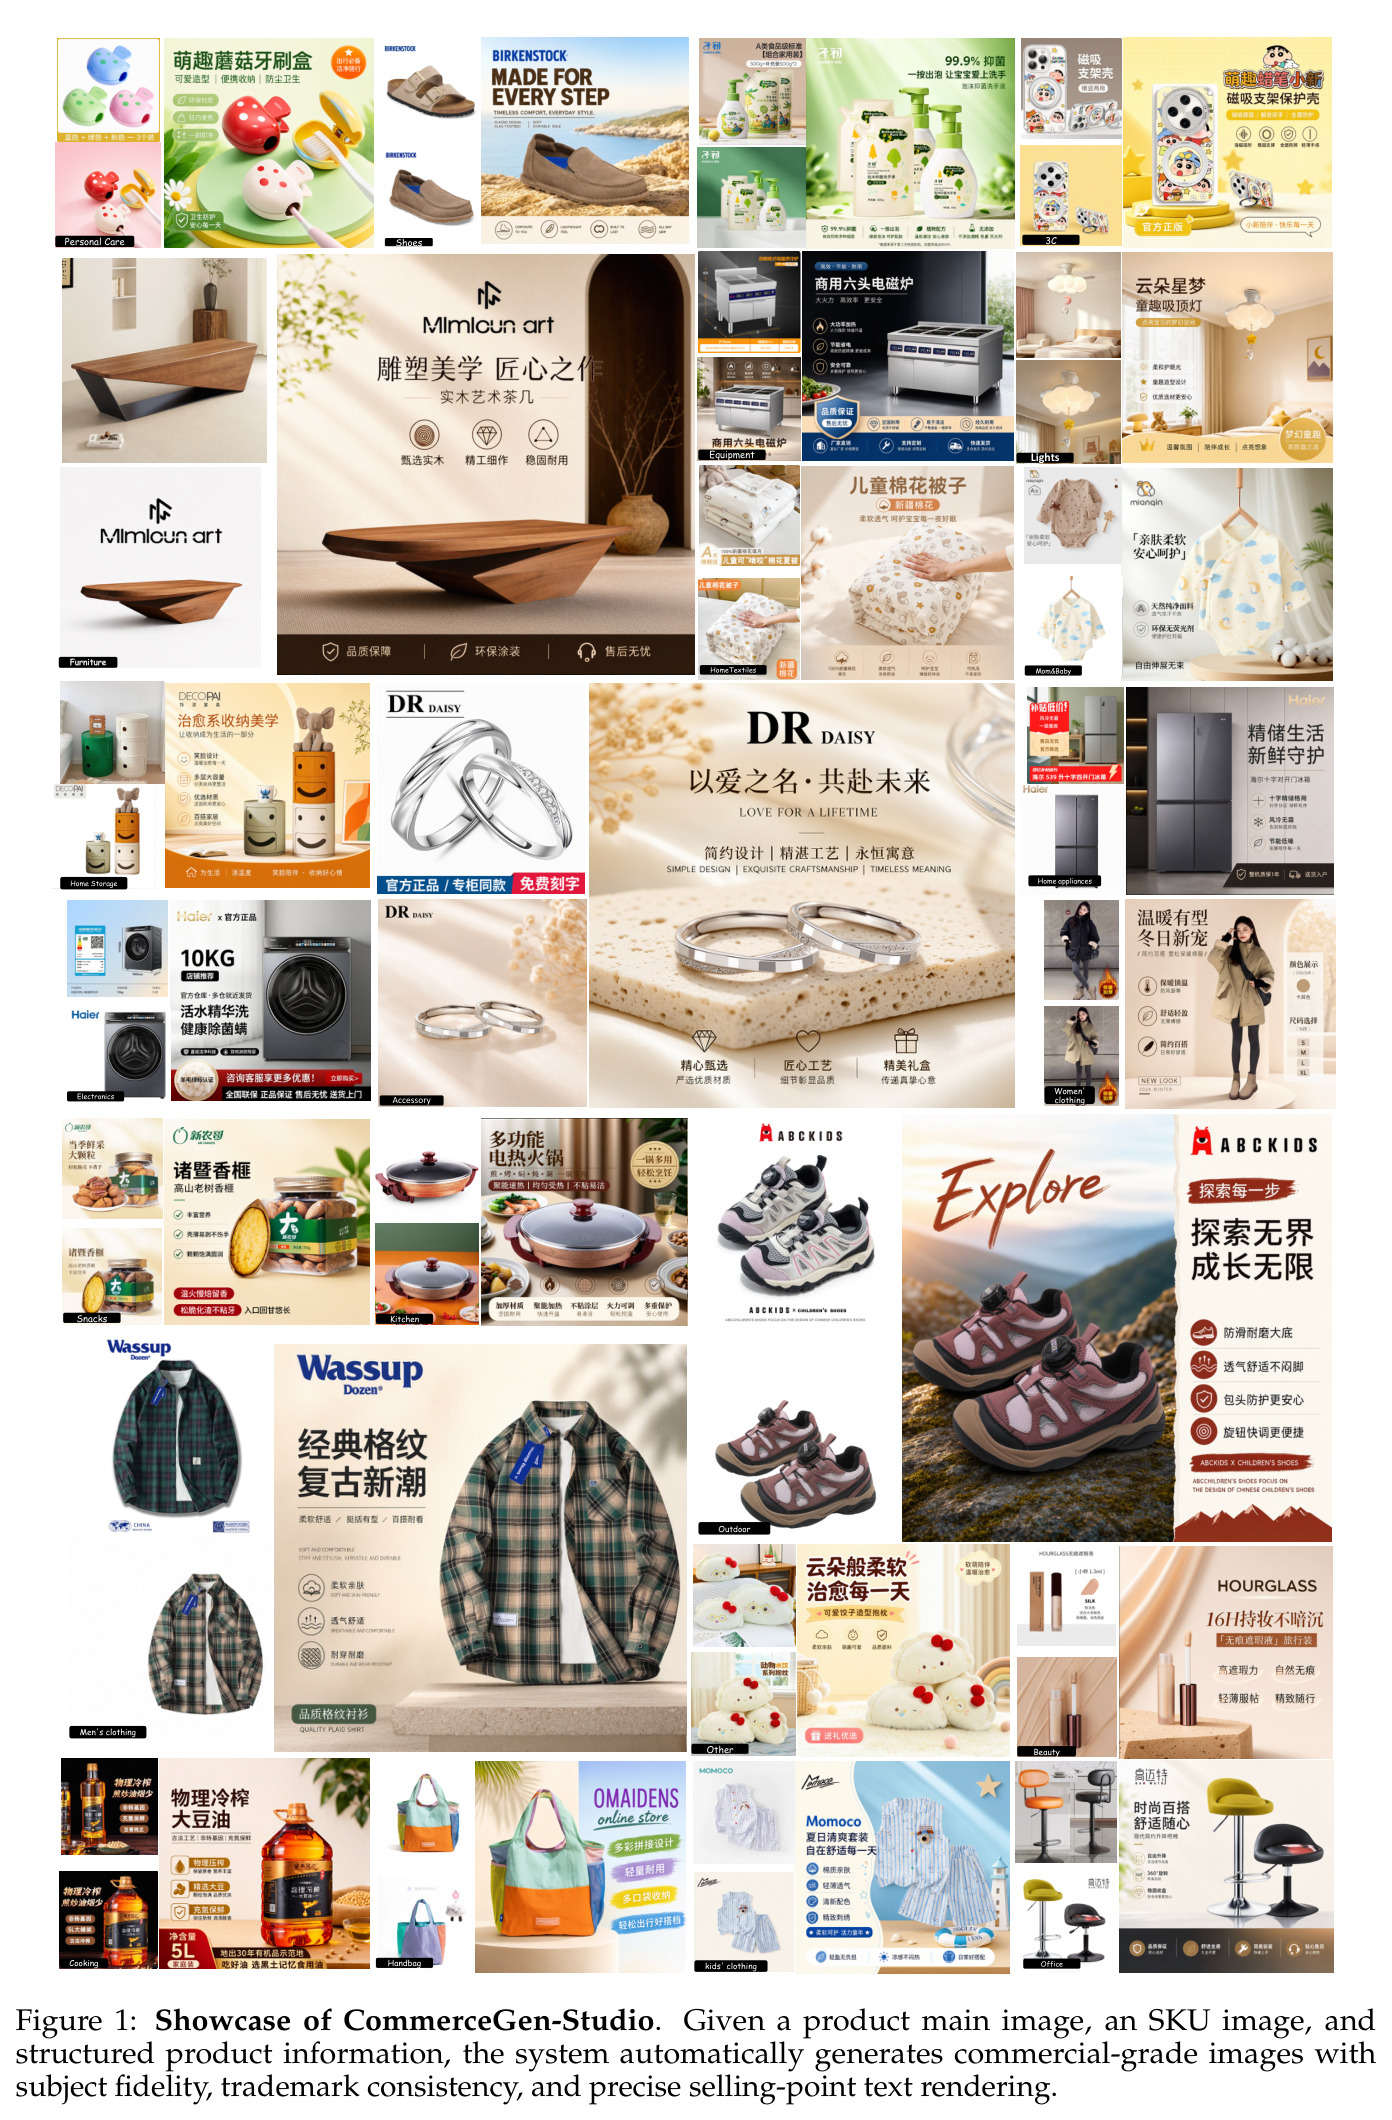
横跨个护、鞋靴、3C、设备、灯具、家具、家纺、母婴、收纳、家电、数码、饰品、女装、零食、厨具、户外、男装、美妆、烹饪、手袋、童装、办公等数十个类目的生成结果拼图,展示系统在给定商品主图、SKU 图和结构化商品信息时,自动生成主体保真、商标一致、卖点文字精准的商用级主图。
一眼看清系统的目标输出形态与覆盖类目广度,理解'商用级'的具体含义(可直接上架的主图),是论文要解决的问题的直观呈现。
消融表:从开源 VLM 基线 + SKU-DiT(50 步)的 6.509 出发,逐步加各训练阶段——布局改写器 SFT 升至 7.832,RD(强化+蒸馏)50 步 8.296,蒸馏到 8 步微降 8.253,RDR 再强化恢复 8.271,换上 LTO 训练的改写器后达 9.440。旁边合并展示了 Table 4 的各阶段数据规模(T2I 约 4.07M、单图编辑约 2.67M、多图编辑 274K、SFT 约 2 万 caption、RFT 约 5K 组、RL 约 5K/2.5K 组轨迹、PERL 100/1K 条)。
唯一量化每个组件贡献的表格:蒸馏只损失 0.043 分换来 6 倍加速、LTO 贡献 +1.169 的最大后期增益,为三段式训练设计的必要性提供数据支撑。