PrismaCoder:以分解式评分标准合成推进开放多模态代码智能 PrismaCoder: Pushing the Boundaries of Open Multimodal Code Intelligence through Decomposed Rubric Synthesis
分解式评分标准一箭双雕:既过滤训练数据又驱动强化学习,让开源多模态代码模型对标闭源系统
前置知识
多模态代码智能
指模型跨越“符号世界(程序代码)”与“视觉世界(渲染产物)”的能力:输入可以是文字描述或截图,输出是能渲染成图表、网页、动画、LaTeX 文档、化学结构式等的代码。评估不能只看代码能否运行,还要看渲染后的布局、语义、可编辑性与交互是否正确。
本文的任务域、数据集构成和全部评测指标(ChartMimic、DesignBench、ChemDraw 等)都建立在这个概念上,不理解它就无法理解“正确性”在这个领域为何如此难以定义。
Rubric(评分细则)
把“这个产物做得好不好”拆解成一串可独立判分的具体准则,如“坐标轴和图例是否出现”“两条柱子是否为青色”,每条按 0-1 打分后加权汇总成总分。相比让评委直接给一个整体分数,rubric 能定位具体错在哪一条,判分也更稳定、更贴近人类判断。
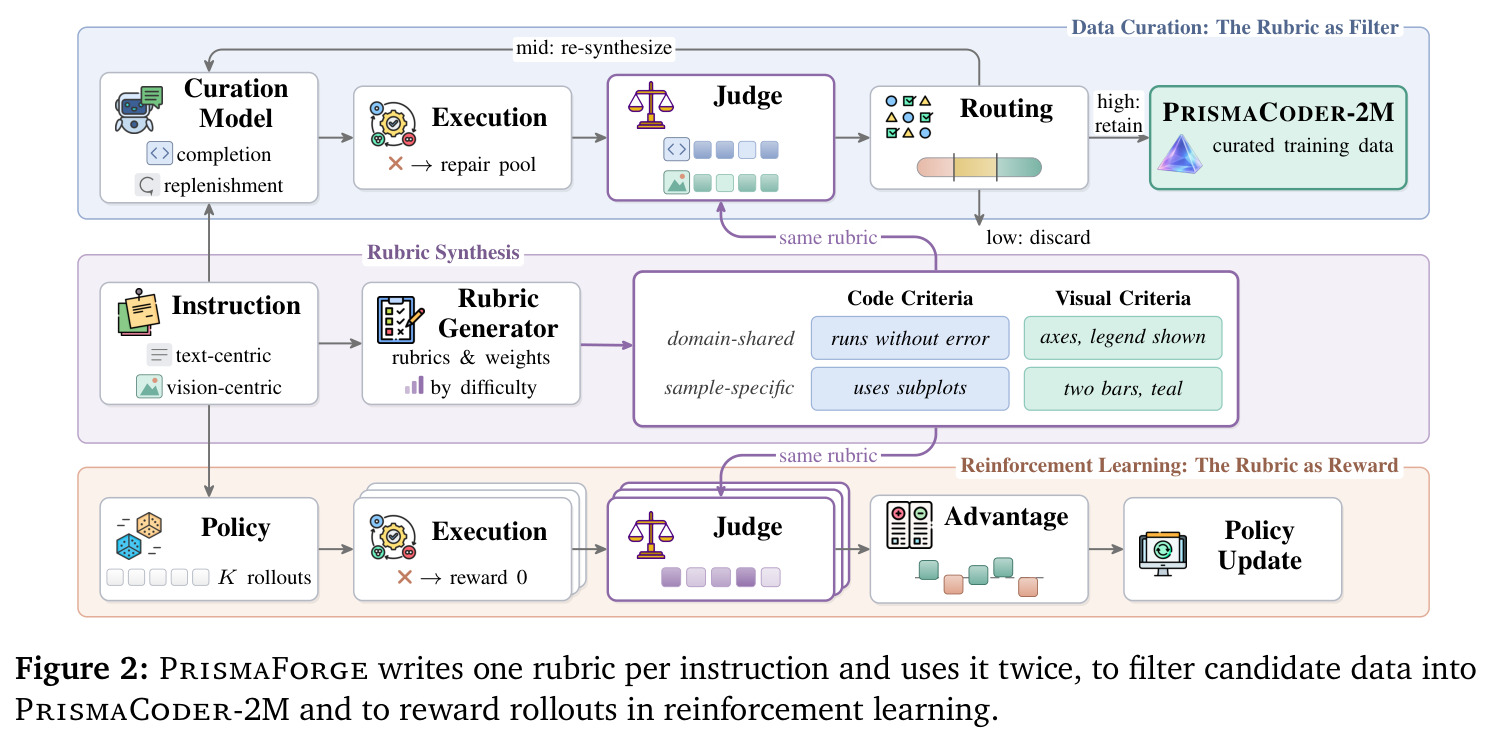
PrismaForge 的核心就是按指令动态合成 rubric,并让同一份 rubric 同时充当数据过滤器与强化学习奖励,这是全文的方法主线。
GRPO(组相对策略优化)
一种强化学习算法:对同一提示采样 $K$ 个回答,用组内奖励的均值和标准差归一化得到优势 $\hat{A}^{(k)}_i = (s^{(k)}_i - \mu_i)/(\sigma_i + \epsilon)$,再以裁剪目标更新策略。它省去价值网络,靠组内对比产生学习信号。
本文用 rubric 总分作为 GRPO 的奖励并沿用组内归一化优势,MoE 模型还用 GSPO 加 Rollout Routing Replay,是理解第 3.2 节的前提。
SFT 与 RL 两阶段后训练
监督微调(SFT)在精选的“指令-代码”对上直接模仿学习,注入领域知识与输出格式;强化学习(RL)随后让模型自己采样 rollout、按奖励信号优化。两阶段分工明确:SFT 打底,RL 在能力边界附近继续拉高上限。
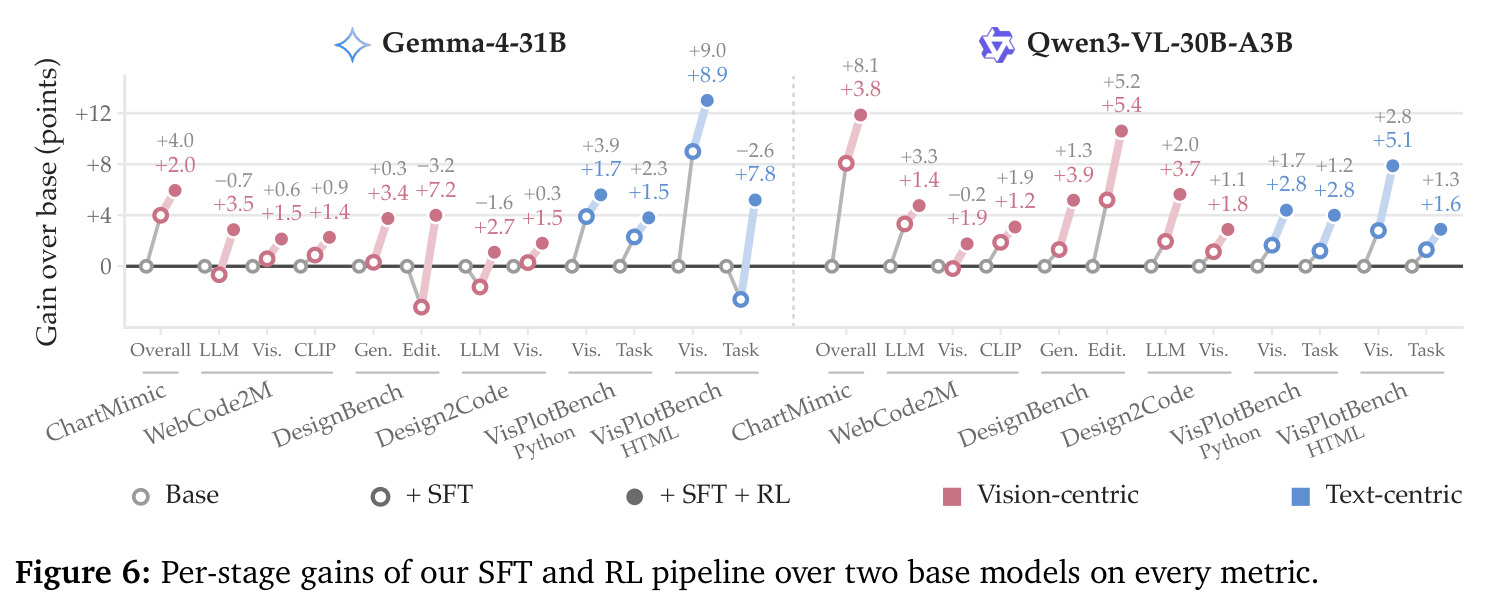
PrismaCoder-9B/35B 以及 Gemma-4-31B、Qwen3-VL-30B 上的对照实验都按 SFT、SFT+RL 两阶段报告逐指标增益,理解这一流程才能读懂 Figure 6。
Tanimoto 相似度
衡量两个分子结构相似度的指标:把分子编码为结构指纹(原子、键、环等特征的位向量)后计算交集与并集之比 $T = |A \cap B| / |A \cup B|$,取值 0 到 1,越接近 1 表示生成的分子与参考分子越接近。常配合 Validity(输出可解析为合法分子的比例)一起评估。
ChemDraw 基准用 Tanimoto 相似度和 Validity 评估化学结构代码生成,是表 2 中本文模型的关键指标(35B 达到 97.56 与 100%)。
Krippendorff's α 与 Kendall's τ
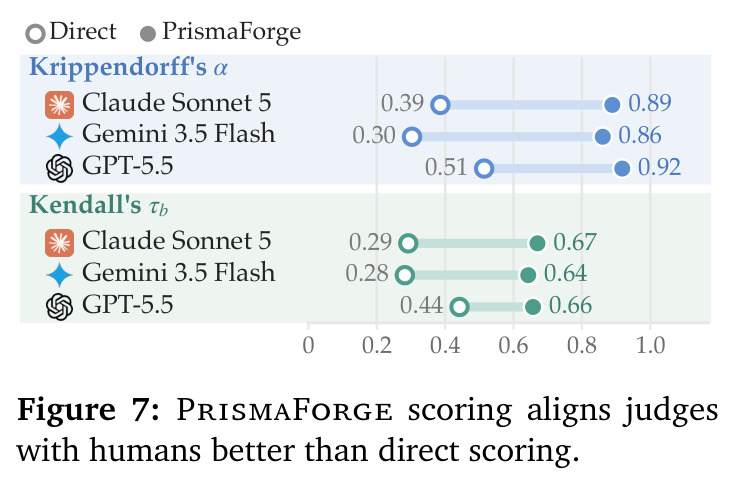
两种一致性统计量:Krippendorff's α 衡量多个评分者(这里是模型评委与人类)在绝对分值上的一致程度,0 为完全不一致、1 为完全一致;Kendall's τ_b 衡量两列评分在成对排序上的一致性,对奖励模型尤其重要,因为排序错乱会给强化学习相互矛盾的信号。
论文用这两个人类一致性研究证明 rubric 评分比直接打分更贴合人类偏好(α 从约 0.30-0.51 升到 0.86-0.92),这是方法有效性的独立验证。
研究动机
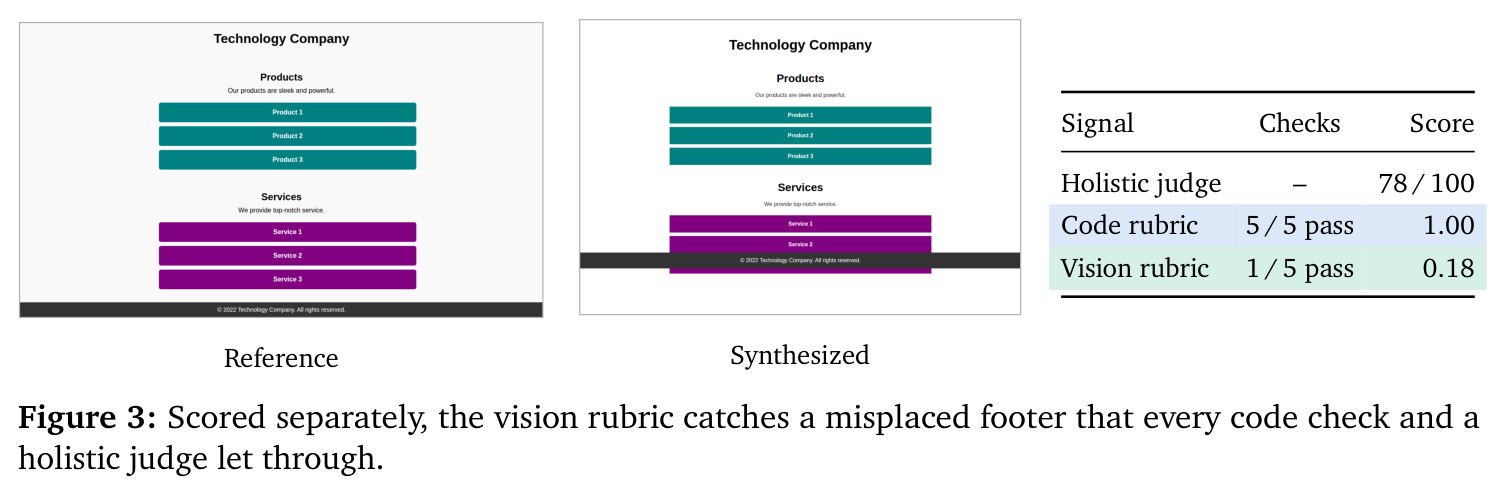
多模态代码智能的商业系统已能从一段文字或一张截图直接生成可交互的网页、图表与动画,但其数据与训练完全封闭;开源侧则受制于数据量与数据质量两个瓶颈。此前的开源数据要么只覆盖单一角落——画图、chart-to-code、截图转网页各自为政、模型难以跨域泛化——要么规模有限:即便 JanusCoder、VisCodex、VisCoder2、VinciCoder 等统一了接口,公开训练数据在规模和质量上仍不足,构建管线也很少随数据一起发布。质量是更难的一环:一个样本必须同时满足“程序正确、工程良好、渲染后视觉正确”三重标准,而已有信号没有一个能同时覆盖三者——执行只返回 pass/fail,代码相似度与视觉产物并不对应,任务专用校验器又无法跨任务泛化。即便用评委模型给一个整体分数(如 100 分制),也缺少诊断信息:你不知道样本到底错在哪里,一个 78/100 的高分可能掩盖了页脚遮挡正文这样的致命视觉错误。
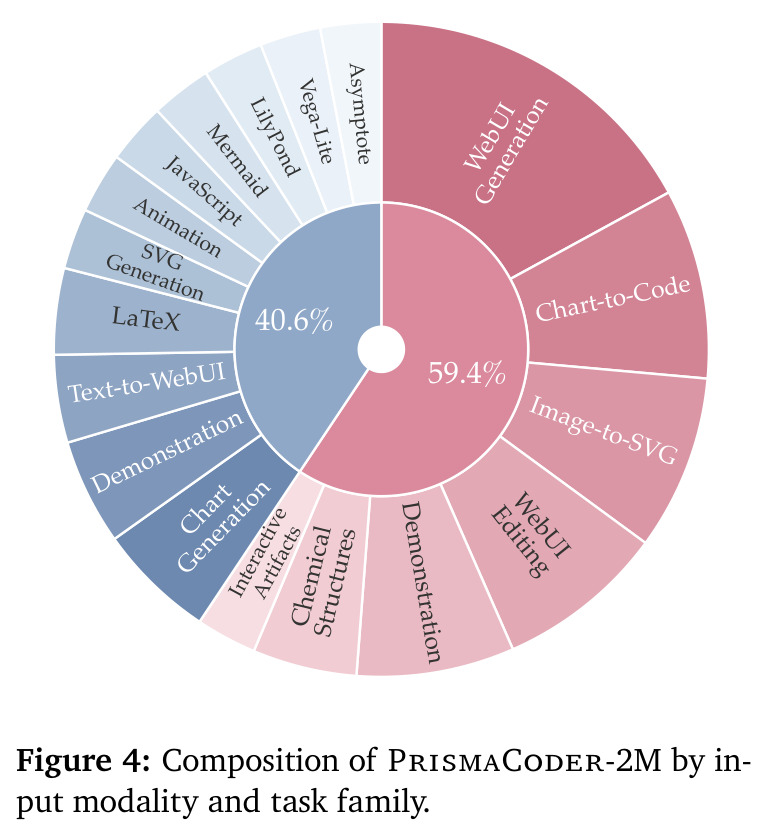
本文的目标是本文的目标是从数据侧系统性推进开放多模态代码智能。第一,构建一个统一的评估信号,使其既能作为数据过滤器筛选监督语料,又能作为强化学习的奖励函数,且跨图表、网页、SVG、动画、LaTeX、化学结构等十余种任务格式通用。第二,基于该信号构建迄今覆盖最广、规模最大的开源数据集 PrismaCoder-2M:约 200 万样本、12 个以上任务类别、10 种以上编程语言,兼顾文本中心与视觉中心两类输入。第三,在该数据上训练并开源 PrismaCoder-9B 与 PrismaCoder-35B-A3B 两个模型,使其大幅领先开源现有最好水平,并在图表、前端页面、半结构化文档上比肩甚至超越 GPT-4o、Gemini 3、Claude 4.6 等闭源系统。第四,通过跨基座、跨评委的消融实验证明管线本身可迁移、可复用,把经验整体回馈给开放社区。
与已有工作不同的是,本文独特的切入角度是“每条指令一份动态合成的 rubric,一份两用”。已有方案要么用单一整体分数筛选数据(诊断能力差),要么用固定维度的单遍 rubric(JanusCoder,对所有样本套同一张清单,太粗),要么用粗到细的奖励(VinciCoder,仍不够既定位失败又全域泛化)。PrismaForge 则把每条候选的评估准则拆成两层:可跨样本复用的领域共享准则(如“坐标轴与图例是否显示”)加上由指令本身合成的样本专属准则(如“两条柱子必须为青色”),并按估计难度弹性调整准则数量;同时把准则一分为二——代码级准则只看程序、视觉级准则只看渲染产物,分别评分后加权合成总分。同一份 rubric 先筛选出 PrismaCoder-2M,再原样驱动 GRPO 强化学习,从根本上避免了“筛选数据的信号”与“训练时的信号”不一致的问题。
核心方法
PrismaForge 的直觉是:视觉代码任务的“正确”无法用单一分数概括,必须拆成可检查的细项。技术上由三部分组成。其一是弹性评分器:对候选样本 $(x_i, c_i, v_i)$(指令、代码、渲染产物),按模态 $m \in \{c, v\}$ 定义准则集 $\mathcal{R}^{(m)}_i = \mathcal{R}^{(m)}_{\text{shared}}(d_i) \cup \mathcal{R}^{(m)}_{\text{spec}}(x_i)$,每条准则 $r$ 带非负权重 $w^{(m)}_{i,r}$,模态分数为加权平均 $S^{(m)}_i = \frac{1}{\sum_{r} w^{(m)}_{i,r}} \sum_{r} w^{(m)}_{i,r} f^{(m)}(r, y^{(m)}_i)$,再合成总分 $S_i = \lambda_c S^{(c)}_i + \lambda_v S^{(v)}_i$($\lambda_c + \lambda_v = 1$);每条指令先定难度档 $q_i$,难度越高准则条数区间越大,在评估粒度与打分成本间平衡。其二是 rubric 驱动的策略优化:把 $S_i$ 直接作为 GRPO/GSPO 的奖励。其三是数据管线:种子收集、代码合成、按格式的执行渲染门控、rubric 打分、按分数三段路由(丢弃/重合成/保留),产出 PrismaCoder-2M。
核心创新是“一份 rubric、两个角色,加两个视角分开打分”。Figure 3 的例子最能说明视角为何必须分开:一个合成页面在代码层面与参考图的内容、颜色、布局全部一致,五条代码准则全过(代码分 1.00),整体评委也给出 78/100、高于数据池中约五分之四的样本;但它的页脚压住了 Services 区块并裁掉了第三个按钮——视觉 rubric 只有 1/5 条通过,得分 0.18。已有的整体判断和代码检查对此全部失效。第二个创新是动态性:准则由领域共享模板与指令专属合成拼接而成,数量随难度分档伸缩,既避免固定 rubric 太粗漏掉样本关键属性,又避免人工逐条编写不可扩展。第三个创新是制衡设计:rubric 生成器(Gemini-3-Pro)与评委(Gemini 3 Flash)使用不同模型,防止构建准则时的系统性偏差在评分时被复制放大。同一评分体系贯通监督数据筛选与 RL 奖励,保证训练信号前后一致。
方法步骤详情
第一步,种子收集:四类互补来源——公开可视化语料(Python、SVG、Mermaid、Vega-Lite 等)打底;GitHub 绘图代码与 arXiv 论文插图经 AST 切分贡献长尾科学样例;WebCode2M 与 MCD 提供前端布局,交互 demo 改写自既有发布;PubChem 与 LaTeX/Asymptote/LilyPond/Manim(取自 3Blue1Brown 代码)提供符号记法。第二步,候选生成与门控:缺代码的种子由 curation 模型(Claude-Opus-4.6)补齐,每个候选须通过按格式定制的编译/渲染门控 $v_i = \text{Exec}(c_i)$,仍失败的进修复池。第三步,rubric 生成与评分:Gemini-3-Pro 定难度档并生成代码/视觉两套准则,Gemini 3 Flash 分别对代码和渲染图打分得 $S_i$。第四步,三段路由:$S_i < \tau_1$ 丢弃;中间带带着失败准则作为反馈重合成;$S_i \geq \tau_2$ 保留入库,最终按领域阈值 $\tau_{d_i}$ 留样。第五步,RL 数据筛选:对 Python、HTML、SVG 各持出 20K 条中等偏难指令,用 SFT 策略采 $K=5$ 个 rollout,按离散度 $U_i = \frac{1}{K}\sum_k (S^{(k)}_i - \bar{S}_i)^2$ 挑波动最大的 5K 条——“有时对有时错”的指令位于能力边界,组内对比才有信息量。第六步,训练:先 SFT 后 RL,稠密模型用 GRPO 裁剪目标,MoE 模型用 GSPO 加 Rollout Routing Replay 稳定专家路由。
技术新颖性
与最近工作的本质区别有三。其一,JanusCoder 的 rubric 是“单遍、固定维度”,对所有样本套同一张检查清单;PrismaForge 的准则是“每指令合成 + 难度弹性”,同一条“坐标轴正确”在不同样本下会具体化为不同的数值、颜色与比例要求。其二,VinciCoder 的粗到细奖励只是纯奖励设计,未与数据筛选打通;本文同一套准则先做监督数据的门槛、再做 RL 的奖励,消除了两套评估器不一致的风险。其三,代码级与视觉级准则分离评估(整体评委 78/100 与视觉 rubric 0.18 的巨大落差即为明证)让失败可定位、可反馈给重合成管线。方法的可复用性也得到实证:把同一管线套在 Qwen3.5 之外的 Gemma-4-31B-it 与 Qwen3-VL-30B-A3B-Instruct 上,12 项指标全部上升且 RL 在每一项上继续叠加增益;用 GPT-5.5、Claude Sonnet 5、Gemini 3.5 Flash 三个不同家族的评委复测,排除了“评委与管线同源”带来的虚高。
实验结果
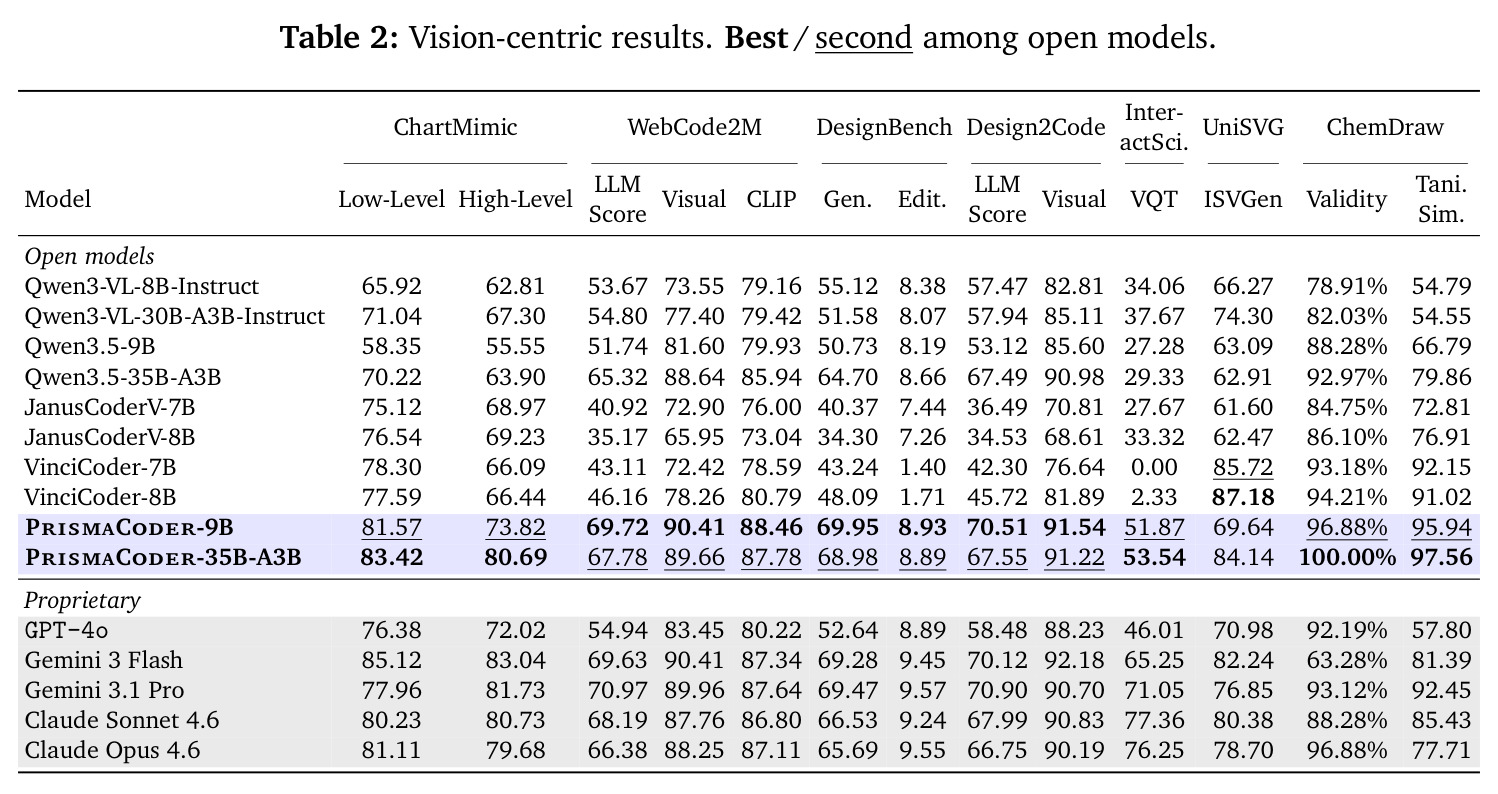
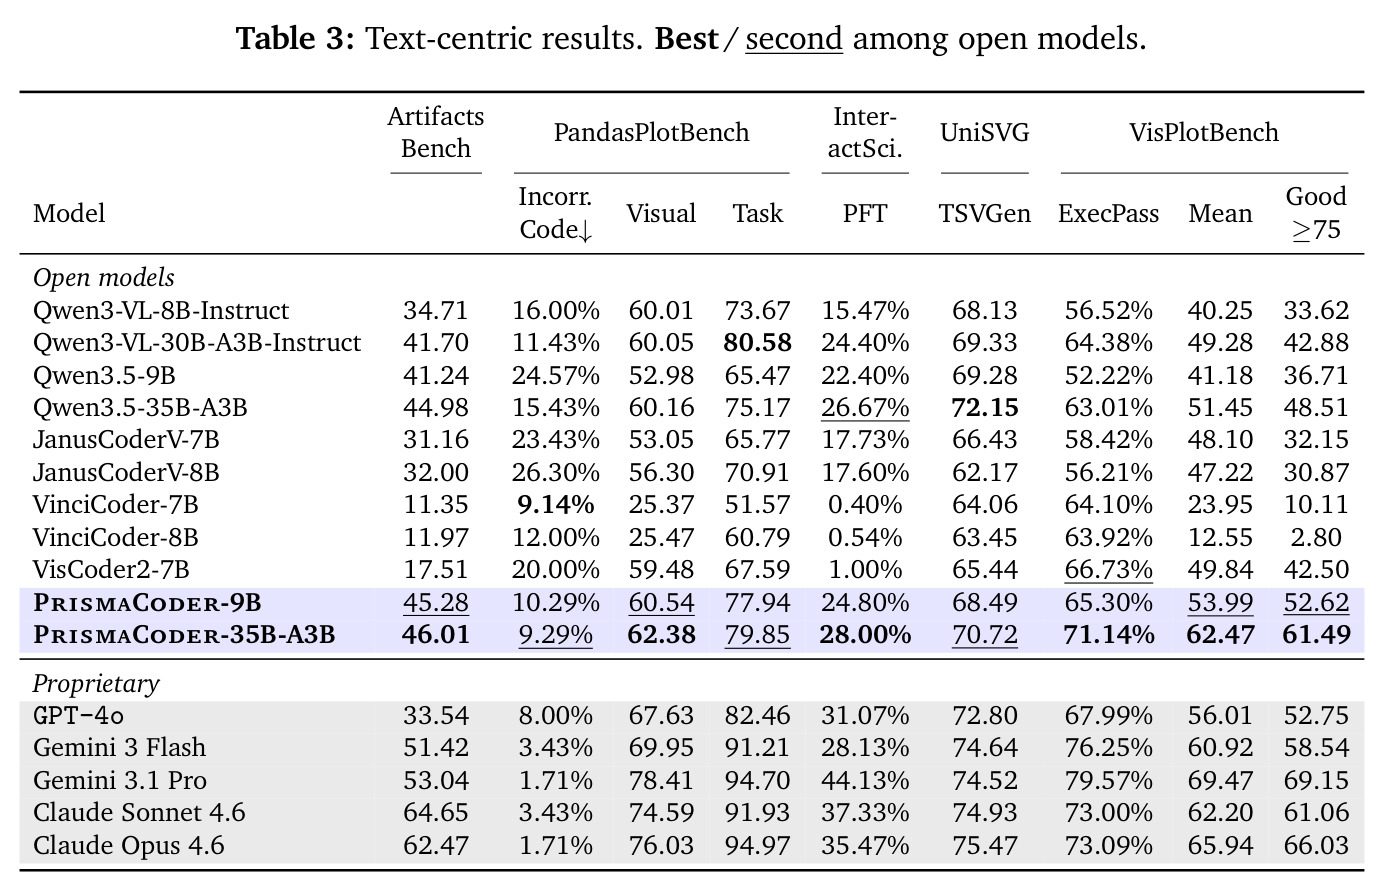
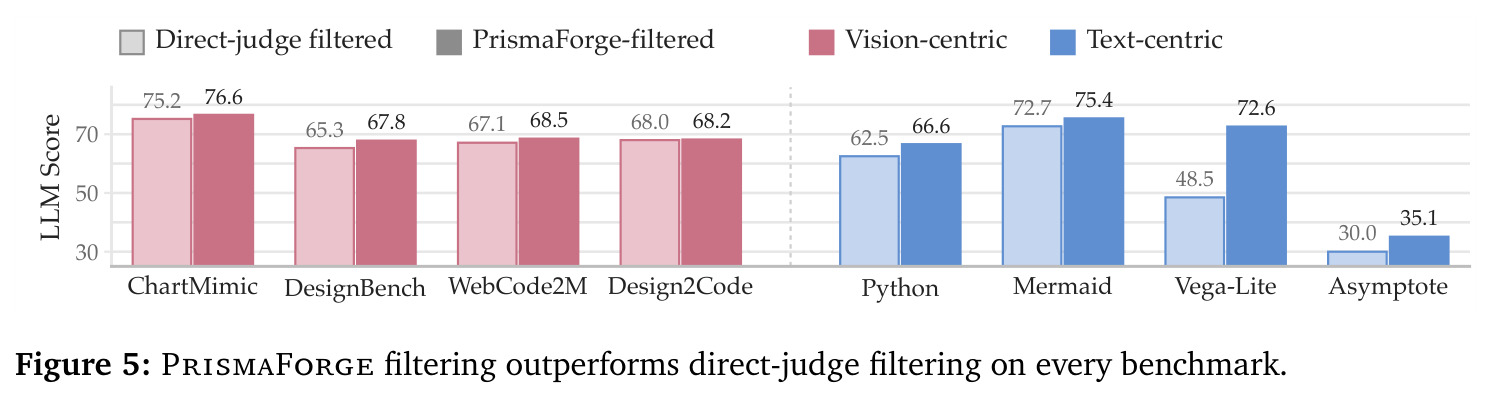
(1)视觉中心评测(表 2):ChartMimic 上 35B 低层/高层达 83.42/80.69(9B 为 81.57/73.82),领先最佳开源基线 JanusCoderV-8B(76.54/69.23)6.88/11.46 分;前端优势最显著,WebCode2M 评委分 9B 达 69.72,比任务专用基线 VinciCoder-8B 的 46.16 高 23.56 分,CLIP 分 88.46 超过全部闭源模型;DesignBench 生成 69.95 超过所有闭源模型,但编辑仅 8.93,低于 Claude 4.6 与 Gemini 3 各版(9.24-9.57);化学结构上 35B 的 Tanimoto 97.56 为全表最高且 Validity 100%;InteractScience 视觉透镜 91.54/91.22 领先开源;唯一被开源基线拿下的视觉指标是图像条件 SVG(VinciCoder-8B 87.18 对 35B 84.14)。(2)文本中心(表 3):ArtifactsBench 35B 达 46.01,超过全部开源基线(最高 44.98)与 GPT-4o(33.54);InteractScience PFT 28.00% 几乎追平 Gemini 3 Flash 的 28.13%;VisPlotBench 三项(ExecPass 71.14%、Mean 62.47、Good≥75 61.49)全部第一,Mean 比最佳基线高 11.02 分。(3)消融:同规模数据下 rubric 过滤全面优于直接打分过滤,Vega-Lite 上高 24 分(48.5→72.6);Gemma-4-31B 与 Qwen3-VL-30B 十二项指标全部上升且 RL 逐项叠加增益;人类一致性研究(100 样本、3 个闭源评委)显示 Krippendorff's α 从 0.30-0.51 升至 0.86-0.92,Kendall's τ_b 从 0.28-0.44 升至 0.64-0.67。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图表复现(ChartMimic,低层指标) | LLM judge 分 | 83.42(PrismaCoder-35B) | JanusCoderV-8B 76.54 | +6.88,且 35B 高层 80.69 领先 +11.46 |
| 网页复现(WebCode2M) | LLM judge 分 | 69.72(PrismaCoder-9B) | VinciCoder-8B 46.16 | +23.56;CLIP 分 88.46 超过全部闭源模型 |
| 网页设计与编辑(DesignBench 生成) | 生成 Score | 69.95(PrismaCoder-9B) | 最佳闭源 Gemini 3.1 Pro 69.47 | +0.48,超过全部闭源模型;但编辑指标 8.93 低于闭源的 9.24-9.57 |
| 交互式产物生成(ArtifactsBench) | 整体分 | 46.01(PrismaCoder-35B) | 最佳开源 Qwen3.5-35B 44.98;GPT-4o 33.54 | +1.03(开源最佳);仍落后 Gemini 3.1 Pro 的 53.04 |
| 长尾可视化语言(VisPlotBench) | Mean(8 种语言平均) | 62.47(PrismaCoder-35B) | 最佳基线 51.45 | +11.02,三项指标全部第一,与 Claude Sonnet 4.6 的 61.06 相当 |
| 化学结构生成(ChemDraw) | Tanimoto 相似度 / Validity | 97.56 / 100%(PrismaCoder-35B) | VinciCoder-8B 91.02 / 94.21% | +6.54;Tanimoto 全表最高,每条输出均可解析 |
| 交互正确性程序化检验(InteractScience PFT) | 通过率 | 28.00%(PrismaCoder-35B) | Gemini 3 Flash 28.13% | -0.13,基本追平闭源前沿;比最佳开源基线高 1.33 |
局限与改进
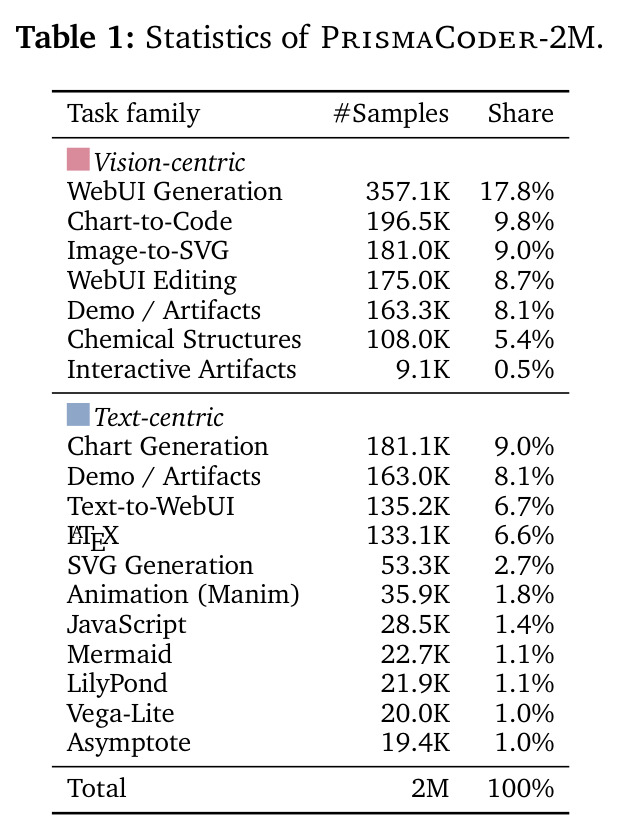
作者承认的局限:DesignBench 编辑是唯一在两个模型上都低于全部 Claude 4.6 与 Gemini 3 变体的网页指标(8.93/8.89 vs 9.24-9.57);图像条件 SVG(ISVGen)是唯一被开源基线 VinciCoder-8B(87.18)领先的视觉中心指标;闭源在文本中心仍占优,如 Gemini 3.1 Pro 在 ArtifactsBench 达 53.04、PandasPlotBench 视觉 78.41,本文 35B 为 46.01 和 62.38。我的观察:其一,整条管线依赖闭源前沿模型(Claude-Opus-4.6 合成、Gemini-3-Pro 生成 rubric、Gemini 3 Flash 当评委),与“开放”初衷存在张力,评委与部分基准指定评委还可能家族重叠(跨评委实验缓解但未消除);其二,视觉级准则本质是“文本化的视觉要求”,依赖评委对静态渲染图的感知,对 canvas 动画、多步交互产物缺乏时序评估手段,交互任务与 Gemini 相差 7 分即是佐证;其三,RL 只覆盖 Python/HTML/SVG 三个域,LaTeX、化学结构等符号域未做 RL;数据分布不均,WebUI 生成 357.1K 而交互式产物仅 9.1K(0.5%)。
独立分析的弱点
弱点一:评估闭环系于商用评委。rubric 生成、评分、合成均由闭源模型完成,成本高且不可完全复现;若评委对某类渲染系统性“失明”(如 Canvas 交互、音频乐谱),门控与奖励都会继承该盲区。改进方向:以人类一致性协议(α 0.86-0.92)为目标蒸馏开源评委,或引入程序化校验器(DOM 断言、像素 diff)与 rubric 融合。弱点二:视觉评估缺少时序维度。ArtifactsBench 上 35B 的 46.01 与 Gemini 3.1 Pro 的 53.04 差 7 分,“点击后状态是否正确”无法用单帧准则覆盖,可引入轨迹级准则与录屏对比。弱点三:RL 域覆盖窄(Python/HTML/SVG),且筛选依赖离散度 $U_i$,对 SFT 后“全对”或“全错”的域自动失去信号;可做跨域难度再校准、课程式扩展 RL 到 Manim、LilyPond 等长尾格式。弱点四:图像条件输入仍是短板(ISVGen 落后 VinciCoder-8B 约 3 分),截图到代码的对齐可加强,例如为视觉中心指令引入更高质量的参照与感知预训练。
未来方向
作者明确提出的方向:释放代码、模型(PrismaCoder-9B/35B)与数据(PrismaCoder-2M),管线已验证可跨基座迁移(Gemma-4-31B、Qwen3-VL-30B 十二项指标全部上升),暗示可推广到更多骨干与社区微调。基于成果可延伸的方向:其一,把 rubric 框架搬到更广的“执行产物难以完全验证”领域,如 UI 代理、游戏关卡、机器人示教,那里同样缺少统一的过滤加奖励信号;其二,自举开源评委:用 100 样本人类研究协议作为对齐目标,训练开源 rubric 评委模型,摆脱对 Gemini/Claude 的依赖并降低管线成本;其三,把 RL 扩展到多轮编辑任务——DesignBench 编辑恰是当前短板,可按“编辑前后 rubric 增量”设计奖励;其四,交互式产物(数据集中仅 9.1K、占 0.5%)是明显短板,结合用户操作轨迹合成与轨迹级 rubric 是自然延伸;其五,测试时扩展:同一 rubric 可直接用作推理时的自评审、重排序与 Best-of-N 选择信号,论文未探索这条低成本路径。
复现评估
开源情况:论文声明释放代码、模型(PrismaCoder-9B/35B-A3B)与数据(PrismaCoder-2M),主页聚合资源;关键工程披露充分——curation 模型 Claude-Opus-4.6、rubric 生成器 Gemini-3-Pro、评委 Gemini 3 Flash、基座 Qwen3.5-9B/35B-A3B、目标函数 GRPO(稠密)/GSPO 加 Rollout Routing Replay(MoE),训练细节在附录 F。但完整复现门槛不低:2M 样本上跑 rubric 生成与逐样本评分需要海量商用 API 调用(每样本至少一次执行加两次评委打分);RL 阶段每指令 5 个 rollout 且渲染后评分,9B/35B 全参数后训练算力估计在数百至上千卡量级,正文未给 GPU 时数。较友好的路径有二:只复现数据过滤与 SFT(消融显示 rubric 过滤贡献了大部分增益,Figure 5 用 Qwen3.5-9B 小规模即可验证);或直接拿持出的 5K RL 指令集在自己基座上做轻量后训练——跨基座实验正是这种复现的范例。数据上游以公开资源为主(WebCode2M、MCD、PubChem、3Blue1Brown 代码等),再分发许可总体清晰。
论文图表
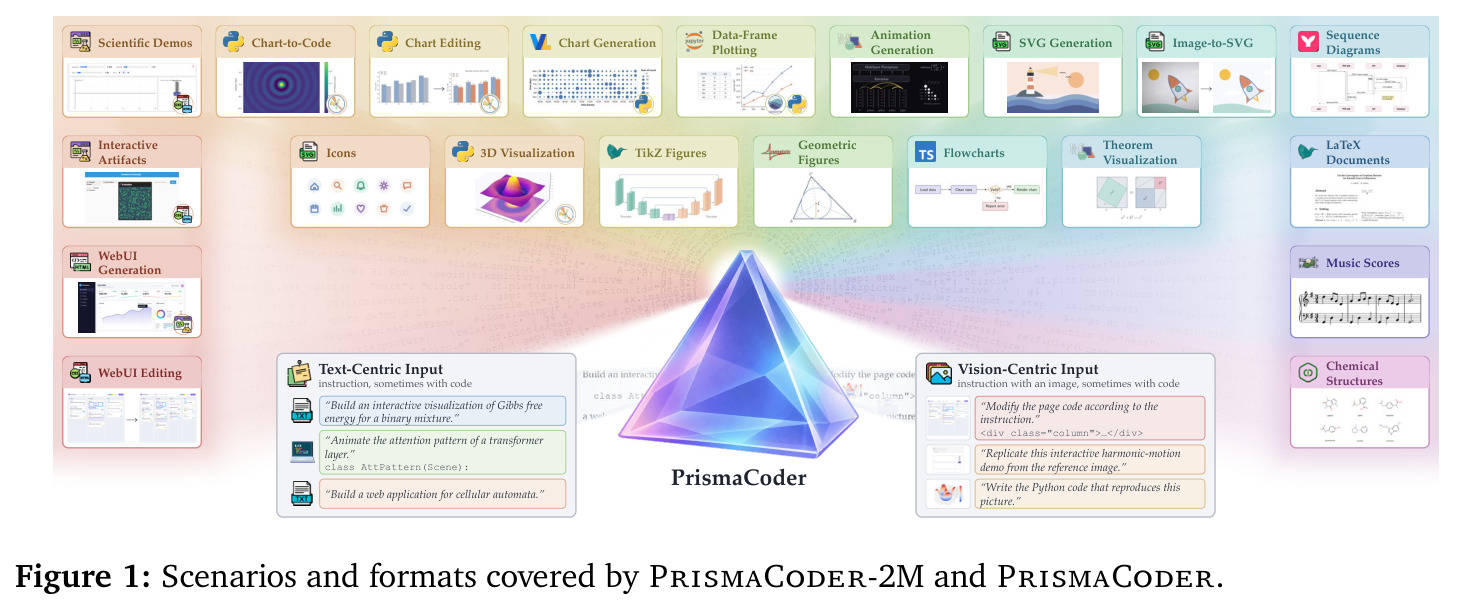
一张大型场景拼图,展示数据集与模型覆盖的十余种任务:科学演示、chart-to-code、图表编辑与生成、数据框绘图、动画生成、SVG 生成与图像转 SVG、时序图、交互式产物、3D 可视化、TikZ 图、几何图形、流程图、定理可视化、LaTeX 文档、乐谱、化学结构式、WebUI 生成与编辑等,并标注输入形态差异(纯文本指令 vs 图像加指令,有时附代码)与输出语言(Python、JavaScript、HTML、LaTeX 等)。
一图看懂“多模态代码智能”的任务域有多宽,以及本文与单一任务模型(只做画图或只做网页)的定位差异;理解数据集为何要强调“覆盖最广”也依赖此图。