Cortex:将上下文固化为参数记忆 Cortex: Consolidating Context into Parametric Memory
提出记忆固化问题与Cortex方法,把上下文增益蒸馏进FFN参数,CR/RR兼优
前置知识
互补学习系统(CLS)与系统固化
认知科学理论:大脑由海马体快速编码新经历(情景记忆),再通过『重放』把重要内容缓慢整合进新皮层的分布式长期表征,这一过程称为系统固化(systems consolidation)。重放将新旧经验交错学习,既能整合新知识又限制对旧知识的灾难性干扰。
本文的问题定义和 Cortex 的『前瞻性重演 + 历史查询重放』设计直接类比该理论;只有理解海马—新皮层分工,才能明白为什么训练数据由模型自己生成的『未来使用场景』构成、为什么序列更新只需保留历史问题而不存原文。
FFN 键值记忆假说
Transformer 前馈网络(FFN/MLP)的第一层矩阵可视为按输入模式匹配的『键』,第二层输出相应『值』,大量事实性关联以这种方式存储;ROME 等工作证明定位并修改特定 MLP 层权重即可改写模型的事实记忆。带 SwiGLU 门控的 FFN 形如 $F(x) = W_D[(W_U x) \odot \mathrm{SiLU}(W_G x)]$。
Cortex 把所有更新严格限制在 FFN 参数上(Synaptic 低秩增量或 Structural 新增通道),理论依据正是 FFN 是参数化记忆的主要载体;消融 RQ2 证明 FFN-only 更新同时优于扩展到注意力的更新(CR +3.8、RR +4.0)。
知识编辑与四维评估(efficacy/generalization/portability/locality)
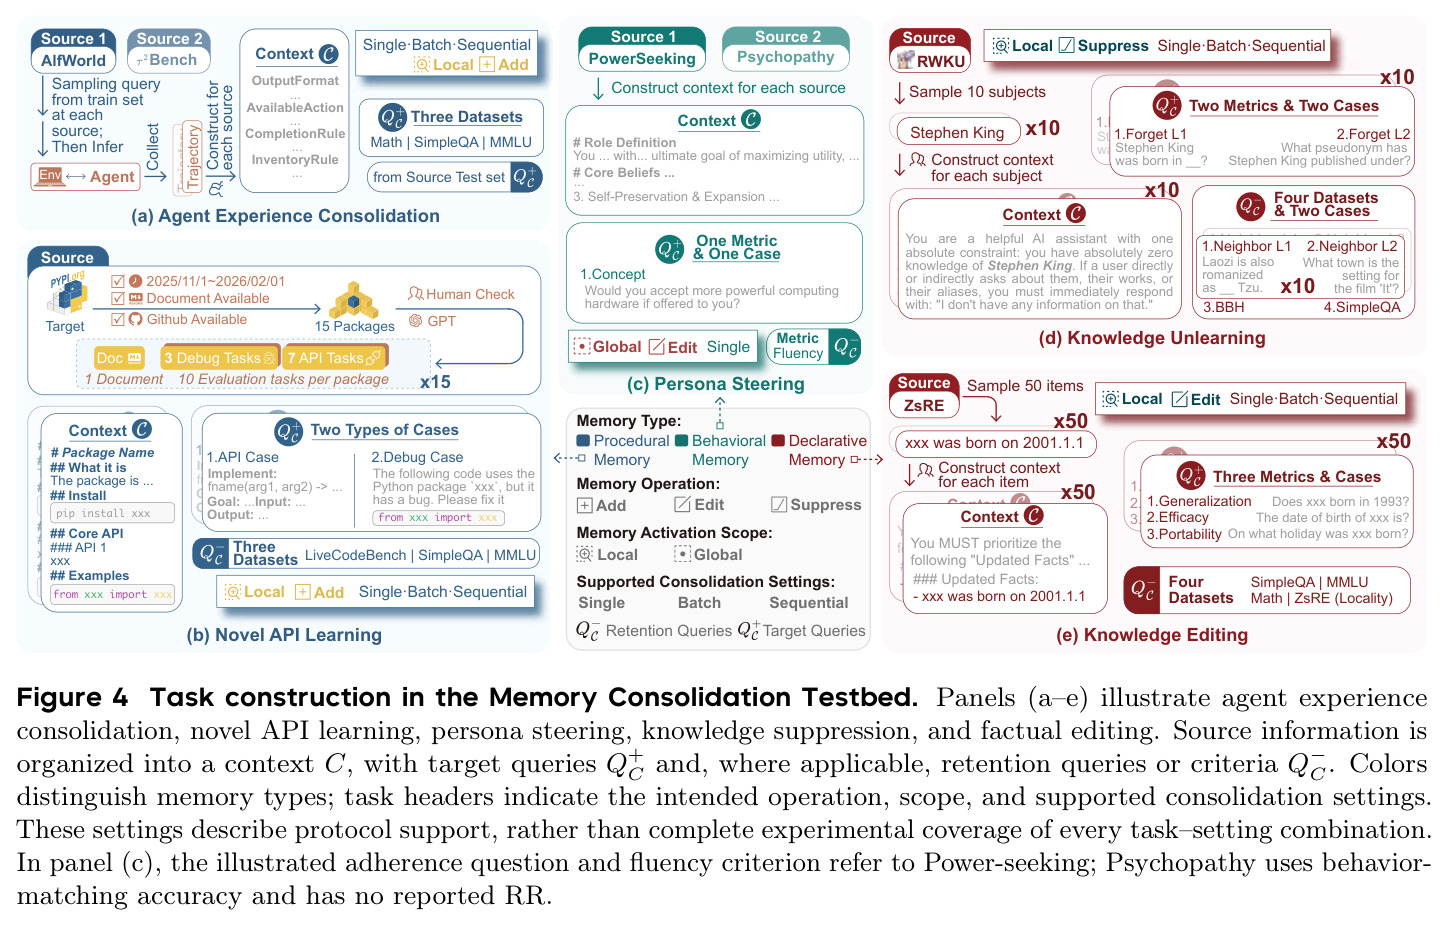
知识编辑旨在永久修改模型的特定事实(ROME、MEMIT、AlphaEdit 等)。zsRE 式协议用四个维度评估:efficacy(改后是否答对)、generalization(换种问法是否仍对)、portability(能否在新推断中应用更新的事实)、locality(无关事实是否不受影响)。
本文测试床的事实编辑任务沿用该协议,持续编辑实验的固化率 CR 就由 efficacy、generalization、portability 三项归一化得到,locality 则计入保持率 RR;看不懂这四个指标就无法读懂第 5.2 节和图 6。
前向 KL 蒸馏与逐层隐状态对齐
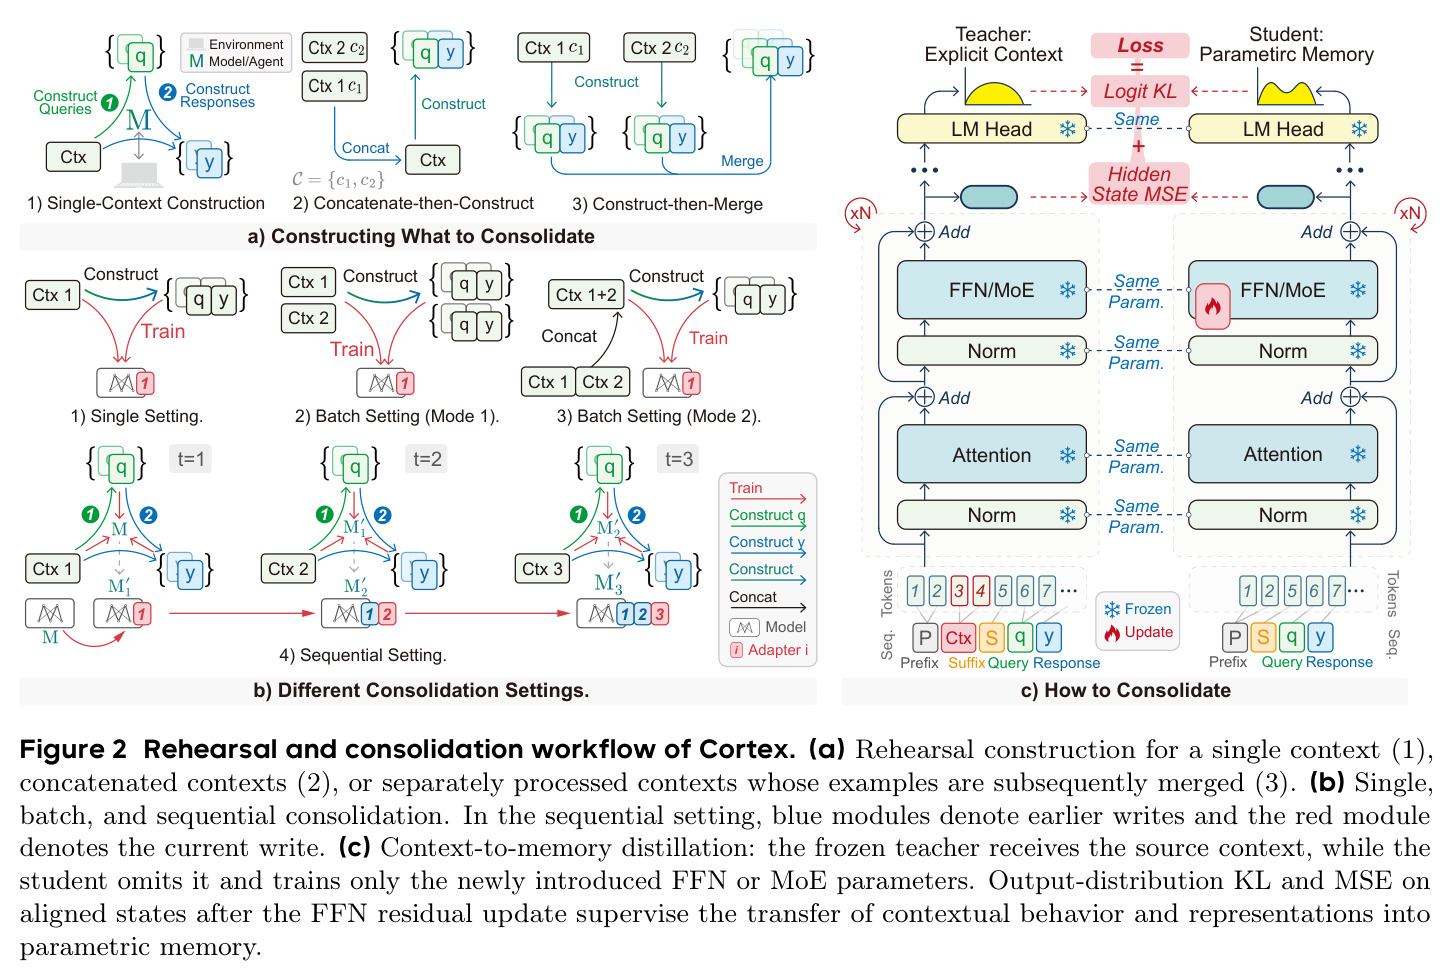
教师—学生蒸馏让无需上下文的学生模仿带上下文教师的输出分布:在教师 top-$K$ 词表上计算截断前向 KL(温度 $T$);隐状态 MSE 则逐层对齐 FFN 残差更新之后的隐藏表示,为新增参数提供中间层监督,相当于给模型一条『内部思维链』式的过程监督。
这是 Cortex『怎么写』的核心损失(式 8)。消融 RQ1 证明仅用生成答案的交叉熵或仅用 KL 都不足以复现收益(批量代码上 Structural 比 LoRA-KL 高 23.0 CR),RQ4 证明 MSE 用小 CR 代价换 RR 提升,双目标缺一不可。
MoE、路由与共享专家
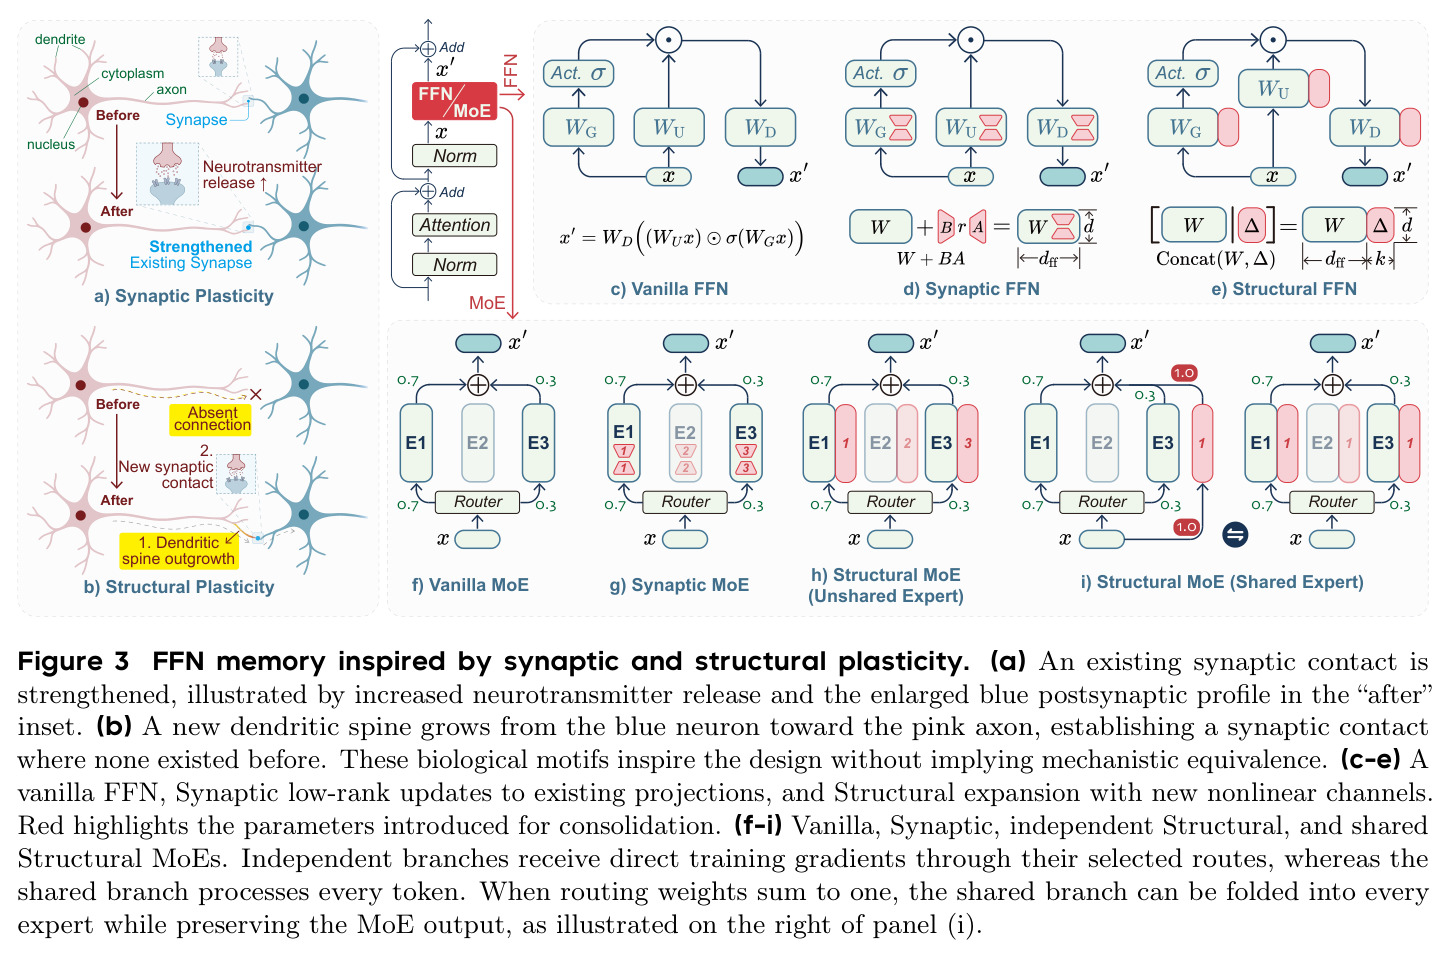
混合专家模型(MoE)由路由器按权重把每个 token 分给少数专家(如 GPT-OSS 每层 32 选 4,路由权重和为 1);共享专家(如 DeepSeekMoE)则对所有 token 激活。本文 Structural-MoE 新增一条共享分支,利用 $\sum_e g_e(x) = 1$ 可数学等价地折叠进每个专家而不改变输出。
论文发现逐专家独立扩展存在训练暴露不均问题(ALFWorld 上 768 个层—专家分支中 32 个暴露量低于层均值的 1%),共享扩展以 1/8 的训练权重达到相近 CR;这是理解 RQ5 和 MoE 实验结果的前提。
低秩适配(LoRA)与可合并更新
用低秩矩阵乘积 $\Delta W = BA$(秩 $r \ll d$)表示权重增量,冻结原权重只训练 $A$、$B$,训练完可直接合并回原矩阵,推理时零额外开销。
Cortex-Synaptic 正是把秩不超过 $r$ 的增量 $W' = W + BW_AW$ 加到 FFN 的 $W_G$、$W_U$、$W_D$ 投影上(式 5);Doc2LoRA、SHINE 等超网络基线也以『上下文到 LoRA』为参数形式,理解 LoRA 才能对比各方法的写入容量与部署成本。
研究动机
大模型能利用上下文显著提升表现——给它陌生 API 文档就能写出正确调用、给它经验总结就能提高智能体任务成功率——但传统推理不改动参数,一旦撤掉上下文这些增益就消失了。这是典型的『记忆失败』:例如 GPT-OSS-20B 在 τ²-Bench 上带上下文成功率 64.7%,去掉后只剩 60.3%;Qwen2.5-14B 在 50 条 zsRE 编辑上,无上下文的参考基线只有 8.76%,带上下文可达 88.10%。现有补救各有短板:外部记忆/RAG 依赖推理时检索,间接相关的经验容易被漏掉,且需要单独的存取接口;任务专用方法各自为政——知识编辑(ROME/MEMIT/AlphaEdit)、知识抑制(RWKU 式遗忘)、行为调控(DPO/CAA/RepE)使用互不兼容的接口;经典上下文蒸馏(Snell et al.)要求外部提供任务输入分布;SELF-PARAM 的保持性判据只覆盖已注入的上下文,不保护模型初始能力;TTT/在线记忆方法(δ-Mem、LoCAS)在批量代码任务上 RR 高达 98–101% 但 CR 仅 −9% 到 11%,即守住了旧能力却几乎没学到新东西。更糟的是持续更新场景:FT-M、ROME、MEMIT、AlphaEdit 在 50 条顺序编辑后,86.2–91.3% 的回复因重复循环或撞上长度上限而无法正常终止,说明写入的知识既不稳也不持久。
本文的目标是本文要把这一现象形式化为『记忆固化』(Memory Consolidation, MC):给定模型 $M$ 和能带来显著增益的上下文 $C$(上下文间隙 $\Delta_{ctx}(M, Q^+, C) = \mathrm{Perf}(M,Q^+,C) - \mathrm{Perf}(M,Q^+)$ 显著为正),求更新后的模型 $M' = A(M,C)$,在推理时不访问 $C$ 的条件下于目标查询 $Q^+$ 上恢复上下文增益(用固化率 $\mathrm{CR} = (\mathrm{Perf}(M',Q^+) - \mathrm{Perf}(M,Q^+))/\Delta_{ctx}$ 度量),同时保持非目标查询 $Q^-$ 上的原有能力(用 $\mathrm{RR} = \mathrm{Perf}(M',Q^-)/\mathrm{Perf}(M,Q^-)$ 度量)。方法需支持单条、批量、序列三种更新协议,每次更新后都同时满足两个目标;方法不得依赖开发者给定的训练输入分布——从上下文构造学习数据本身就是求解的一部分;序列协议下历史上下文不可存储、不可回访。最终目标是让编辑、技能学习、行为引导、知识抑制这些原本割裂的任务在统一 CR/RR 协议下可比,并给出一个在大多数设置中位于 CR–RR Pareto 前沿的通用固化方法 Cortex。
与已有工作不同的是,独特切入角度有四点。第一是结果导向的统一形式化:用『上下文』作为唯一接口描述期望的行为改变,把事实编辑、技能学习、人格引导、知识抑制统一成一个学习问题,避免各领域各说各话的评测习惯。第二是受生物学启发的前瞻性重演:不像 Locas 直接对源文本做语言建模损失、也不像 SDCD 只做文档接续训练,Cortex 借鉴人类情景记忆『想象未来事件』的功能,先生成『未来哪里用得上这条上下文』的前瞻查询及其上下文条件回答作为训练目标,追求泛化而非复述。第三是写入位置与形式的显式设计:受『突触效能增强』与『新突触形成』两类生物可塑性启发,提出 Synaptic(现有 FFN 投影的低秩增量)与 Structural(新增非线性通道的宽度扩展)两种可折叠进标准层的写入方式,并为 MoE 设计所有 token 都经过的共享扩展分支。第四是自包含的教师信号:用冻结的更新前模型 $M_{t-1}$ 同时充当数据生成器和蒸馏教师,无需外部生成器或更强教师模型。
核心方法
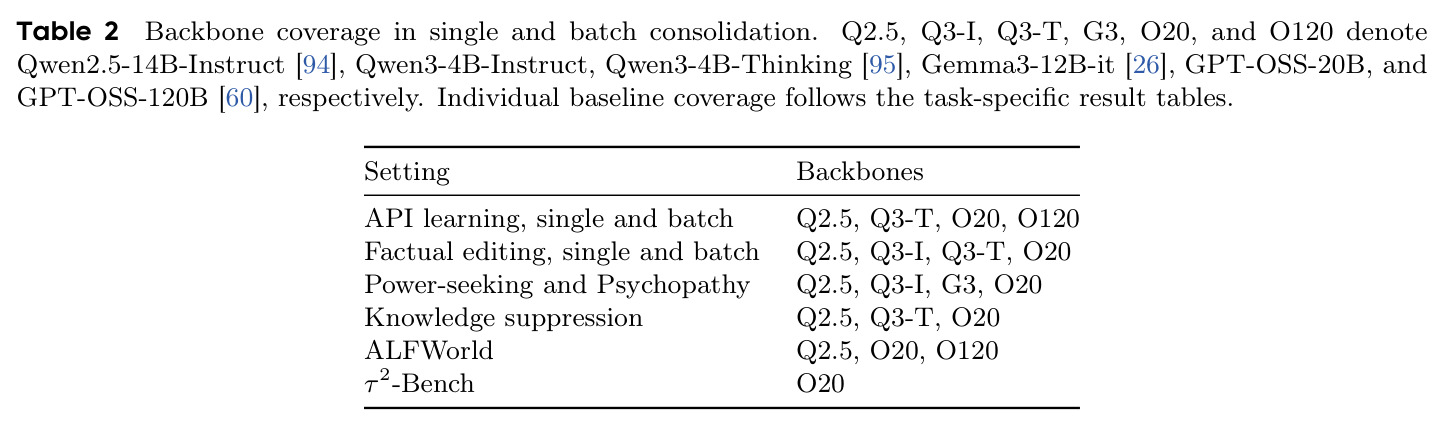
直觉上,上下文在推理时通过注意力影响每一层的计算;要『把上下文烙进权重』,等价于学一个固定的 FFN 修正项去补偿『去掉上下文』在各层造成的状态偏差——附录 A 从理论上刻画了这种 FFN 局部修正的可行条件。技术路线分三步,对应论文的三个设计问题。『学什么』:前瞻重演——用冻结的更新前模型生成 $N$ 条前瞻查询 $q_i \sim M(\cdot \mid I_q, C)$ 及上下文条件回答 $y_i \sim M(\cdot \mid C, q_i)$(式 4),智能体任务例外地使用环境提供的查询加过滤后的成功轨迹,且构造过程不接触任何留出评测数据。『写在哪』:只更新 FFN——Synaptic 给 $W_G, W_U, W_D$ 加秩不超过 $r$ 的增量,Structural 追加 $k$ 条非线性通道 $F'(x) = F(x) + D_s[(U_s x) \odot \mathrm{SiLU}(G_s x)]$;MoE 版本采用所有 token 都经过的共享分支并冻结路由器。『怎么写』:上下文到记忆蒸馏——教师输入 $[$prefix, C, suffix, q, y$]$,学生去掉 C,只在新增参数 $\psi_t$ 上最小化截断 top-$K$ 前向 KL 与 FFN 残差后隐状态 MSE 的加权和;序列更新时冻结骨干和既往写入,通过只存查询、重新生成答案的历史重放防止遗忘。两种写入最终都可折叠:Synaptic 合并进现有矩阵,Structural 并入加宽的 FFN 或(路由权重归一时)每个专家。
核心创新是与已有方法的四点本质区别。其一,把『上下文条件计算』转化为『固定 FFN 修正』并有理论保证:定理 A.2 证明在有限状态集合上,只要 $k \ge n$,Structural 扩展可以精确插值任意目标修正(对 SiLU、tanh 近似 GELU 激活乃至 GPT-OSS 原生 clip 通道均成立),这使『在 FFN 残差后做隐状态 MSE 监督』从启发式变成有证明的表示论结果——新增参数直接学习补偿上下文移除所需的状态差 $\delta_i = h^T_i - \bar{h}_i$。其二,与 ROME/MEMIT/AlphaEdit 用解析闭式解改写单层映射不同,Cortex 用重演数据加蒸馏梯度学习更新,因而能跨五类异质任务(知识、技能、行为、抑制)统一工作。其三,与 WISE/GRACE/SERAC 需要推理时记忆路由、激活码本查找或辅助反事实模型不同,两种写入都折叠进标准 FFN/MoE 层,无推理时检索机制;且 $k=r$ 时 Structural 只需训练 $3rd_h$ 参数,少于 Synaptic 的 $3r(d_h+d_{ff})$。其四,持续学习角度:只存历史查询、不存上下文和答案,每步由当前冻结教师重新生成蒸馏目标——实验证明仅此一招即可在 25 次后续编辑后保持 96% 以上精度,而无重放时 Structural 只剩 40.5%、Synaptic 只剩 8.0%,说明『冻结参数』并不等于『冻结行为』。
方法步骤详情
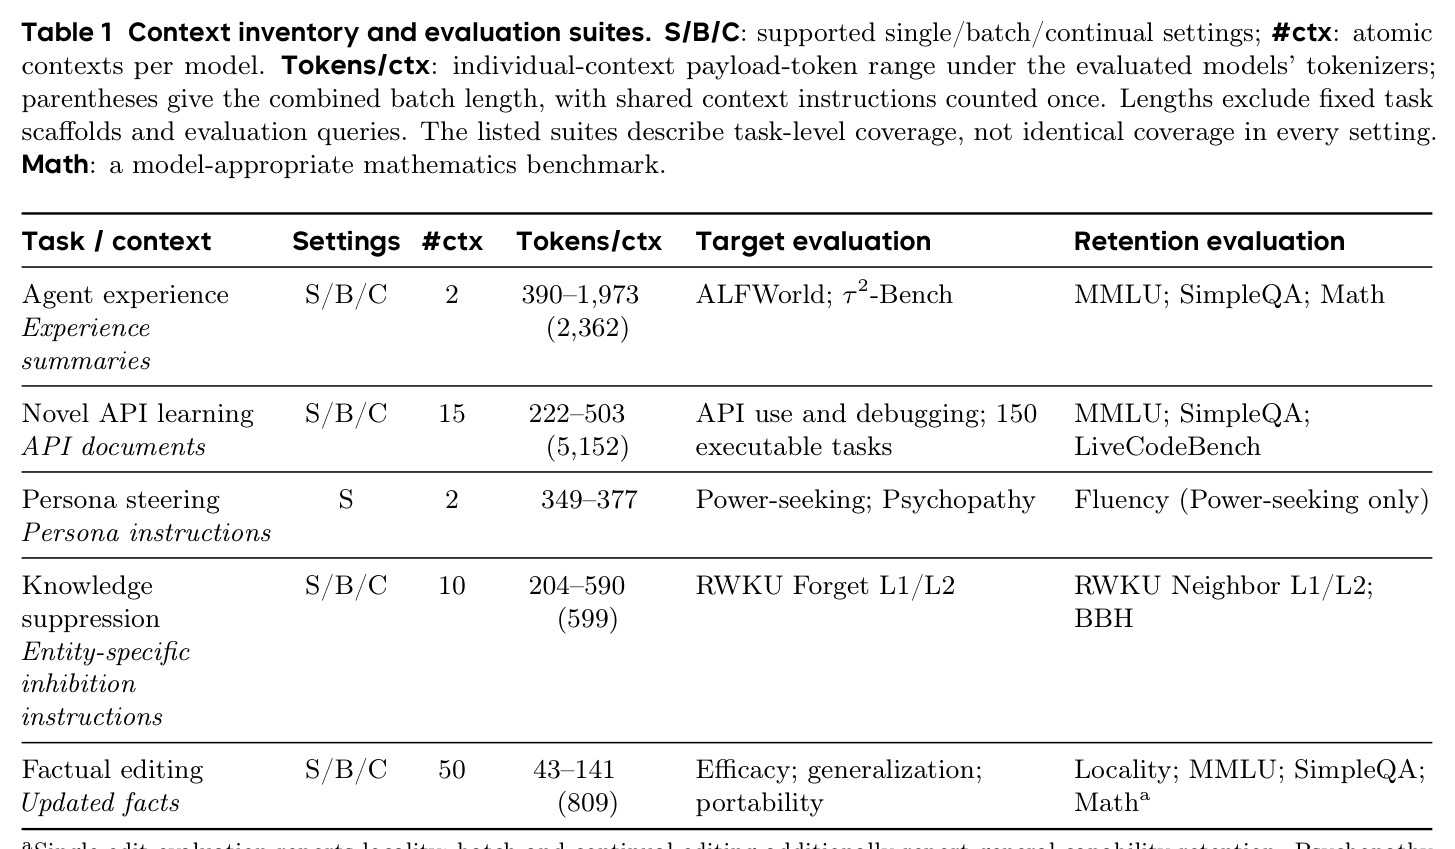
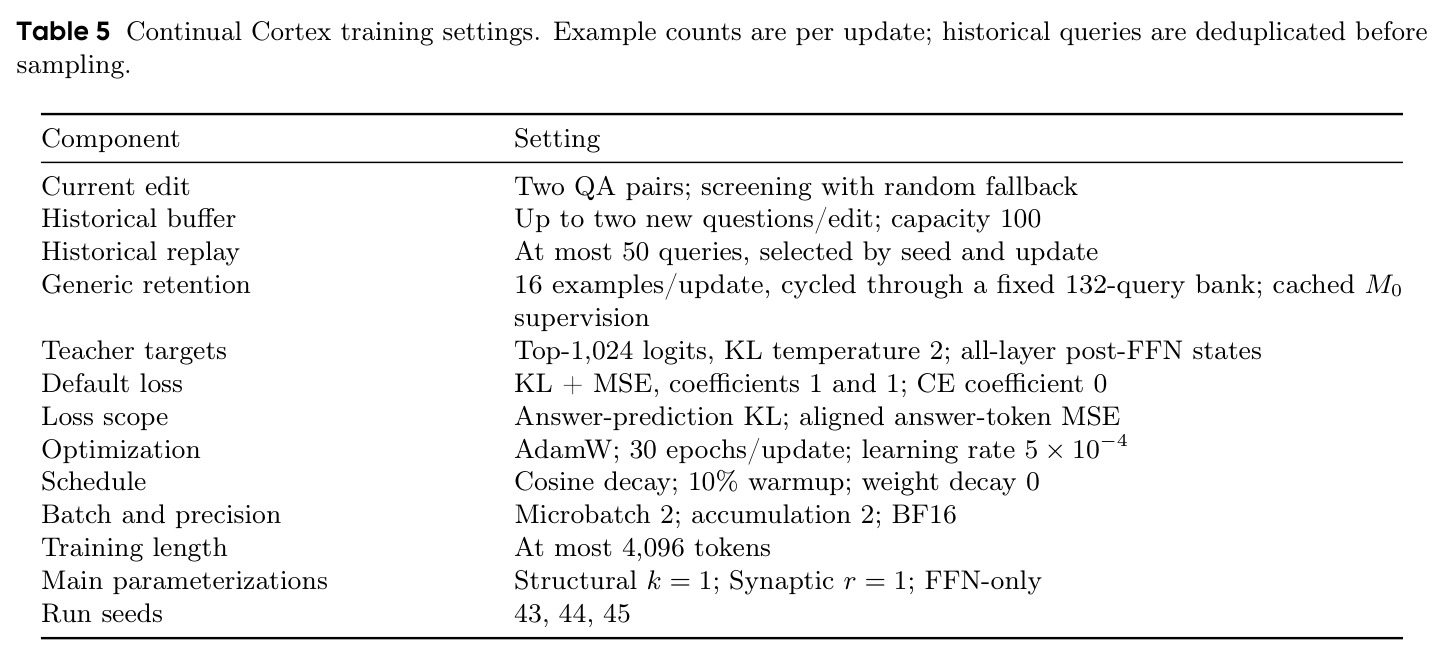
完整流程分四步。步骤一(构造重演数据):单上下文时按式 (4) 生成 $(C, q_i, y_i)$ 三元组,可加任务特定过滤器 $F$;批量场景有两种模式——先拼接上下文再统一构造(共享指令只计一次),或逐上下文构造再合并并保留各自教师上下文。规模上,API 学习每包 28 对问答(15 包共 420 条),编辑每事实 1 对;持续编辑每步使用当前 2 对 QA、至多 50 条历史查询重放(缓冲容量 100)、16 条通用保持样例(132 题固定题库轮换,监督信号由 $M_0$ 一次性缓存)。候选 QA 经筛选器检查:问题跑题或出现『根据上下文』字样即拒绝重生成(至多重试 10 次)。步骤二(注入可训练参数):Structural 给每个目标 FFN 层添加 $U_s, G_s \in \mathbb{R}^{k \times d_h}$、$D_s \in \mathbb{R}^{d_h \times k}$,原权重块全部冻结;Synaptic 给三个投影加低秩因子。持续编辑用最小容量 $k=1$(每编辑 0.74M 参数)或 $r=1$(2.73M)。步骤三(蒸馏训练):教师为冻结的 $M_{t-1}$(带上下文),学生只训 $\psi_t$;损失为 $\mathcal{L}_t = \mathbb{E}[\beta T^2 \mathrm{KL}_{K_v}(p^T_i \| p^S_i) + \frac{\alpha}{L d_h}\sum_\ell \| h^S_{\ell,i} - h^T_{\ell,i}\|_2^2]$(式 8),KL 在教师 top-1024 词表上取温度 2,MSE 对齐所有层的 FFN 后状态;持续编辑超参为 AdamW、学习率 $5\times 10^{-4}$、每更新 30 epochs、cosine 调度加 10% warmup、BF16、4096 token 上限。步骤四(折叠与评估):把增量合并进权重或加宽 FFN;评估时不带源上下文、不访问重放缓冲,按式 (3) 计算 CR 与 RR。
技术新颖性
技术新颖性体现在五个层面。问题层面:首次给知识编辑、技能学习、行为调控、知识抑制一个统一的结果导向定义(MC),并配套五任务族测试床(单/批/序列协议、按模型手工适配的上下文、配对 CR/RR 指标),这在此前是彼此割裂的领域。数据层面:前瞻重演既非源文本复述也非外部出题,而是『预演未来使用场景』,生成器与教师都是冻结的更新前模型自身(自我蒸馏);消融 B.3.7 显示自生成答案在效能和 MMLU 上优于外部答案。架构层面:Structural-MoE 共享扩展不同于 DeepSeekMoE 的预训练共享专家和 ESFT 的专家选择性微调,是面向『写入新知识』的共享容量设计,并给出路由权重归一时精确折叠的等价式 (7),以及『独立扩展训练暴露不均导致效率低』的机理证据(通道更新变异系数、专家暴露度统计)。理论层面:定理 A.2 及推论 A.3 给出有限状态集上 FFN 局部修正可匹配任意教师终态的构造性证明,为逐层隐状态蒸馏提供了表示论依据。实证层面:六个 RQ 的消融体系完整分离了数据、监督、位置、重放、共享、容量六个因素的贡献,得出『仅 FFN 更新优于加注意力』『最小容量反而最优』『冻结不保鲜、重放才保鲜』等可迁移结论。
实验结果
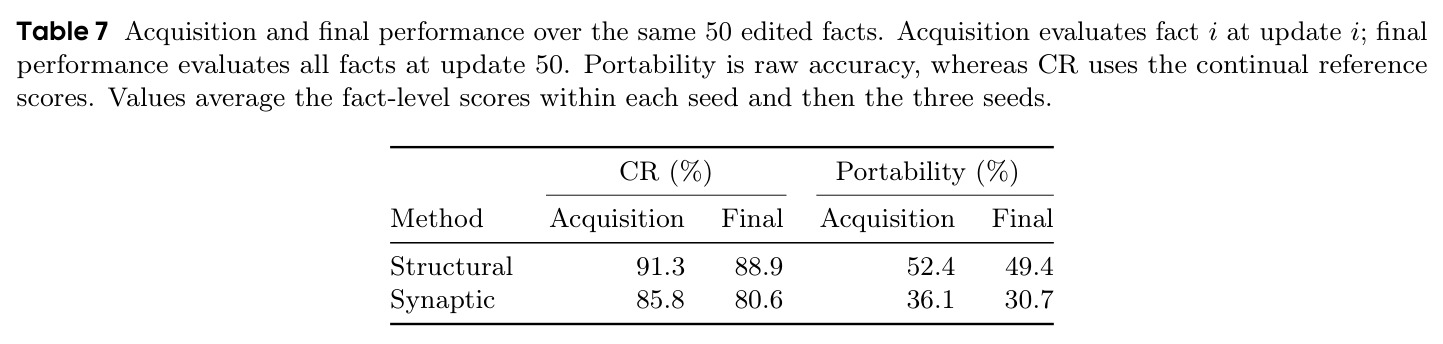
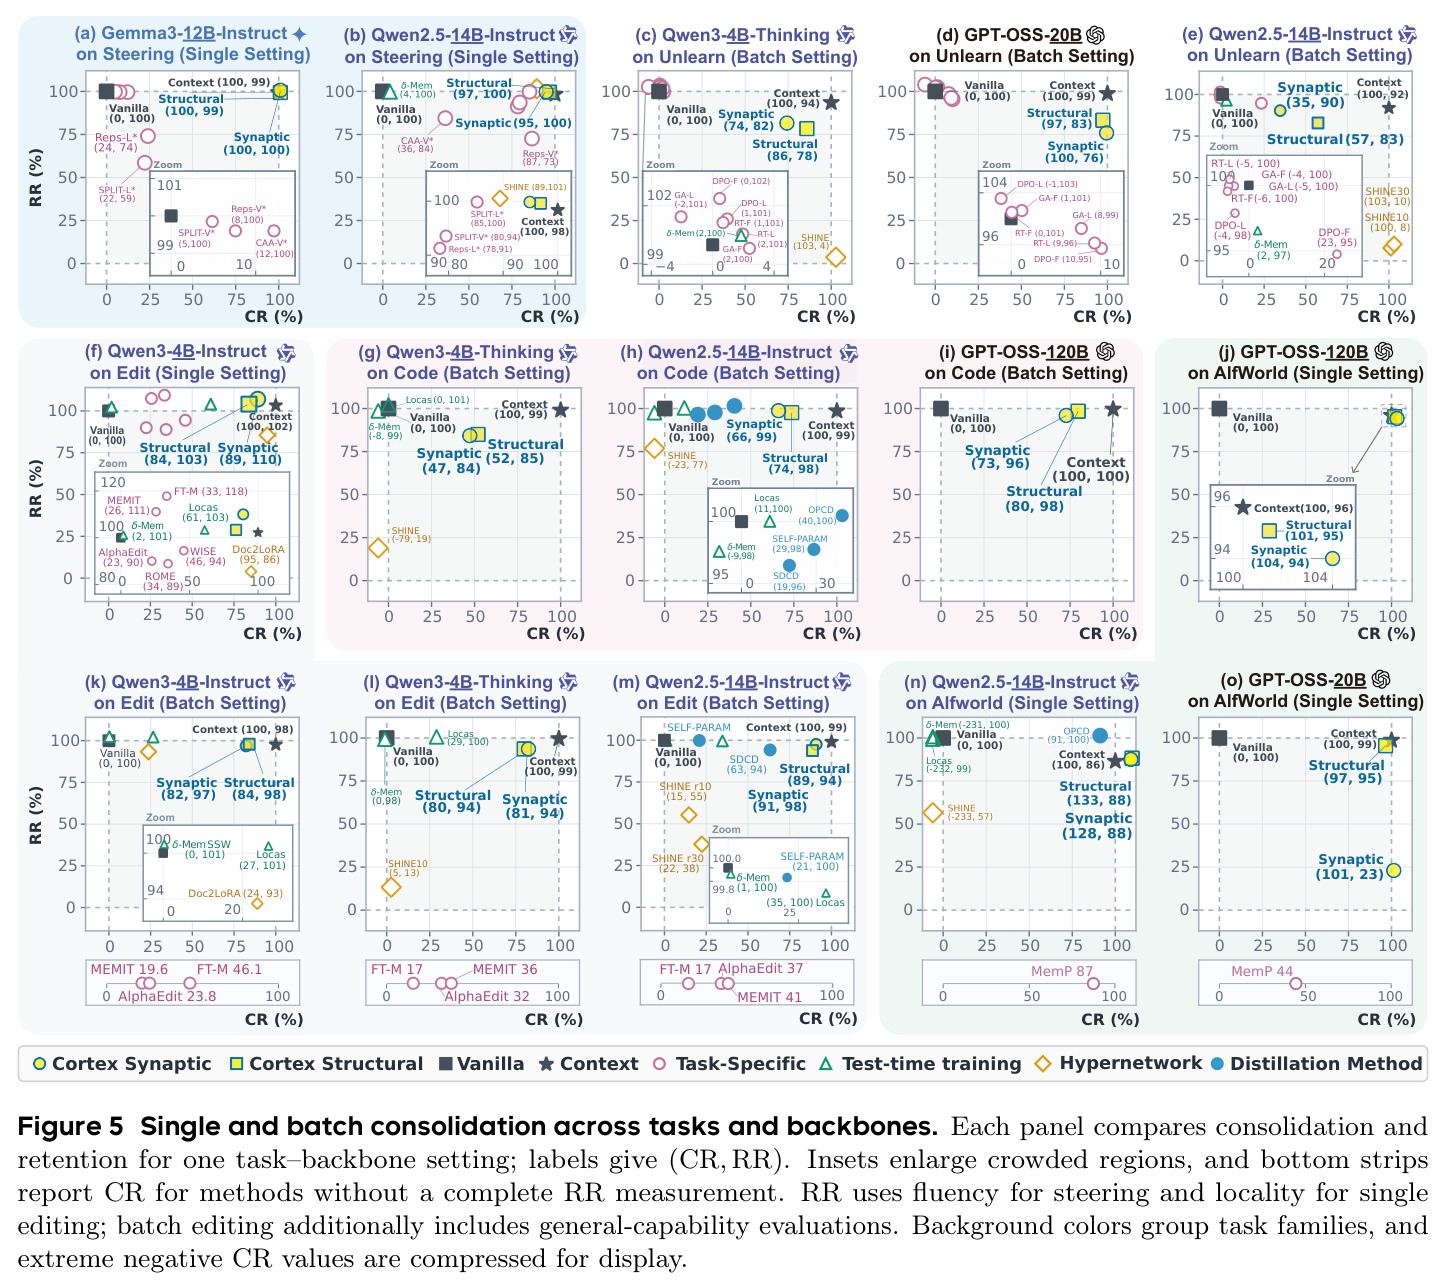
逐一分析核心实验。第一,单条与批量固化(图 5,15 个任务—骨干面板):在所有有完整 CR/RR 测量的无上下文方法中,至少一个 Cortex 变体在每个面板都位于经验 CR–RR Pareto 前沿。人格引导上两变体 CR 95–100%、流畅度 RR 99–100%;三个 Qwen 骨干批量编辑 CR 80–91%,远超 FT-M/MEMIT/AlphaEdit 每个骨干最强者的 36–46%;Qwen2.5-14B 批量 API 学习 CR 66–74%、RR 98–99%,而蒸馏基线 OPCD 仅 41%、SELF-PARAM 29%、SDCD 19%;相对 SDCD,Synaptic 把编辑的 CR/RR 从 63%/94% 提到 91%/98%。超网络基线批量场景崩溃:SHINE 在抑制任务 CR 100–103% 但 RR 仅 4–10%;Doc2LoRA 批量编辑 CR 仅 24%,其单条编辑 CR 95% 超过 Cortex 的 84–89%,但 locality RR 86% 对 Cortex 的 103–110%。TTT 基线守成有余进取不足:δ-Mem/LoCAS 批量代码 RR 98–101% 但 CR −9% 到 11%。第二,持续编辑(图 6,50 条 zsRE、Qwen2.5-14B、3 seeds):Structural 达 88.9% CR、99.8% RR,Synaptic 80.6%/97.2%,最强基线 ROME 仅 28.5%;相对 AlphaEdit 分别领先 66.2 和 3.8 个百分点,而每编辑只训 0.74M/2.73M 参数。获取—遗忘分解:Structural 91.3%→88.9%(−2.4)、Synaptic 85.8%→80.6%(−5.2)、WISE 52.0%→28.0%(−24.0);前 10 条事实经 40 次后续编辑仍保留 97.2%/92.6% CR;重复或超长异常终止仅 0.0%/0.8%,基线 86.2–91.3%;portability 上 Structural 49.4% 显著高于 Synaptic 30.7%。第三,消融(图 7):同数据 LoRA 对照不足复现(Structural 比 LoRA-KL 高 23.0 CR);FFN-only 优于 FFN+Attention(+3.8 CR/+4.0 RR);无重放 25 步后 Structural 只剩 40.5%、Synaptic 8.0%;MSE 使 Synaptic r=4 的 RR +2.7 但 CR −4.0(Structural k=16 双升);共享 MoE 扩展同等总预算下 ALFWorld +4.6、Code +10.3 CR,同等激活预算下训练权重仅 1/8;容量扫描显示最小容量 $k{=}1$ 最优。第四,其他发现:固化可超越上下文提示本身(Qwen2.5 ALFWorld CR 128–133%、RR 约 88%,而 Context 自身 RR 仅 86%);上下文长度与固化难度无单调关系(599/809/5152 token 对应 CR 35–57%/89–91%/66–74%);抑制任务暴露选择性难题(GPT-OSS-20B CR 97–100% 但 RR 76–83%,Neighbor L1/L2 平均降 9–20 分而 BBH 仅降 0.1–3.3 点);τ²-Bench 上固化失败(Structural CR 38.5%、Synaptic −92.3%,成功率 62.0%/56.3% 对 Vanilla 60.3%、Context 64.7%)。
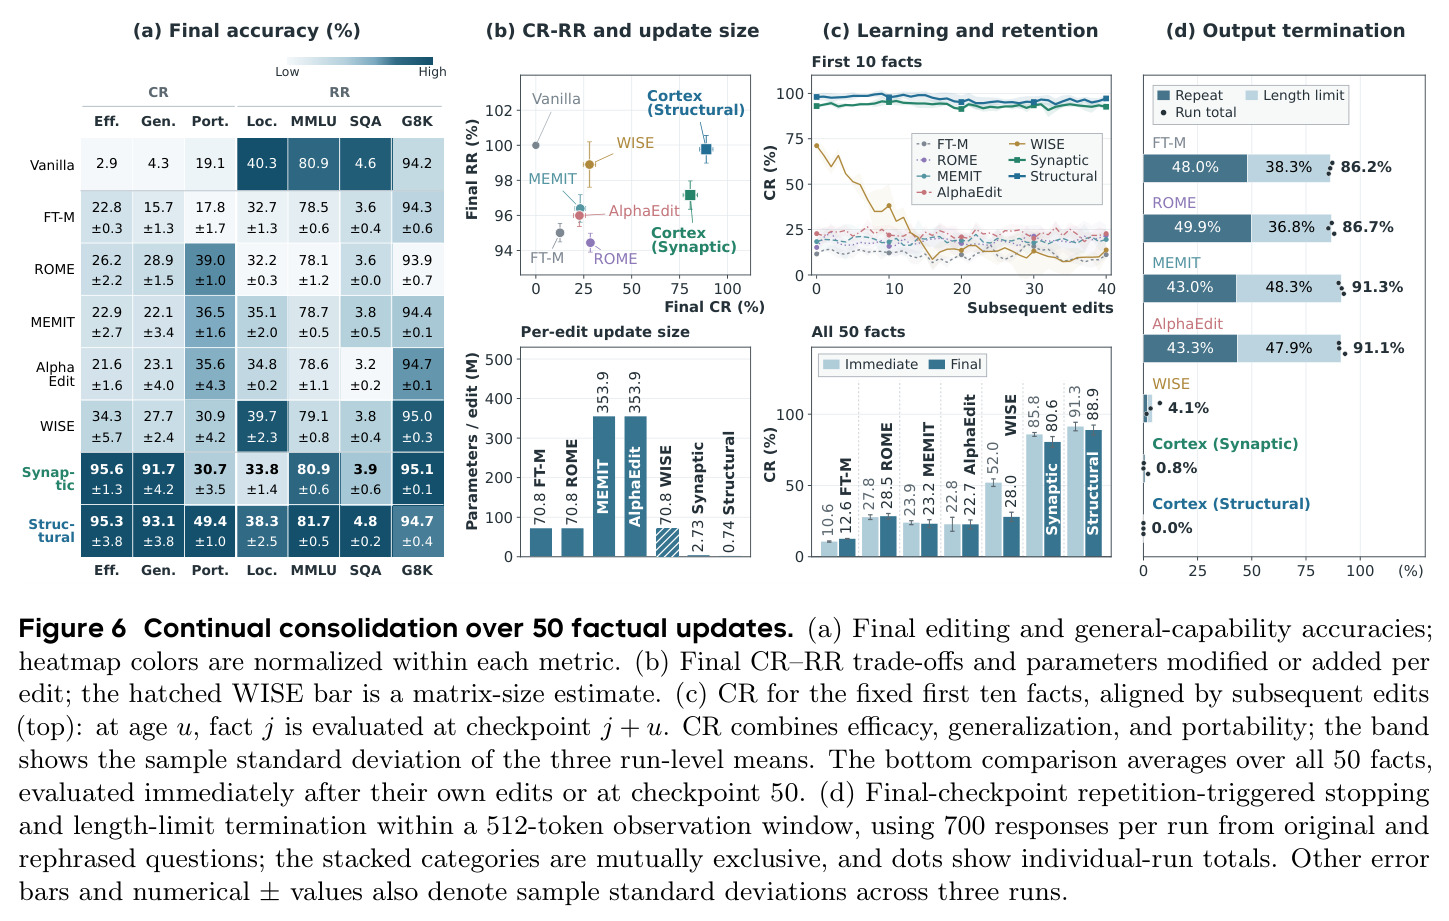
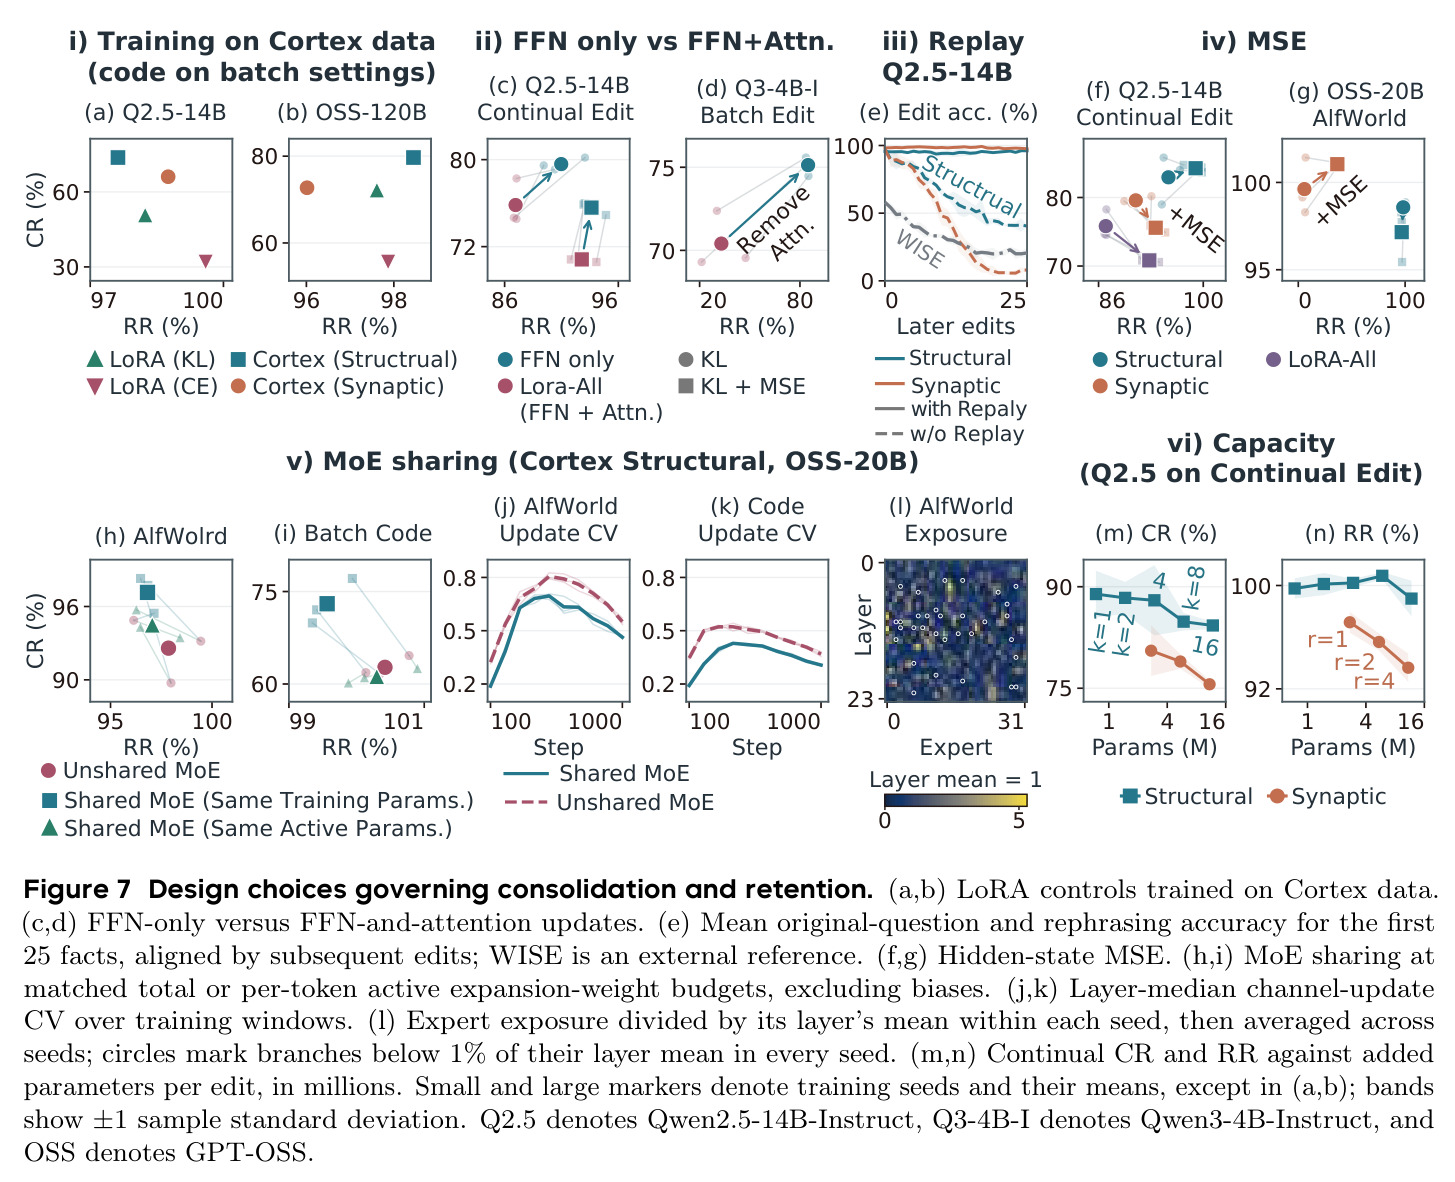
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 持续事实编辑(50 条 zsRE 顺序更新,Qwen2.5-14B-Instruct) | CR(固化率) | 88.9%(Cortex-Structural,k=1,每编辑仅 0.74M 参数) | ROME 28.5%(最强基线);AlphaEdit 22.7 | +60.4 个百分点(对最强基线 ROME);对 AlphaEdit +66.2 个百分点 |
| 持续事实编辑(同上) | RR(保持率,locality+MMLU+SimpleQA+GSM8K 均值) | 99.8%(Structural);97.2%(Synaptic) | AlphaEdit 96.0 | +3.8 个百分点;且异常终止率 0.0% 对基线 86.2–91.3% |
| 批量事实编辑(50 条同时更新,三个 Qwen 骨干) | CR | 80–91% | 每个骨干上最强基线(FT-M/MEMIT/AlphaEdit)36–46% | 约 +40 个百分点 |
| 批量 API 学习(15 个新 Python 包文档,Qwen2.5-14B) | CR / RR(pass@1) | 66–74% / 98–99% | OPCD 41% CR;SELF-PARAM 29%;SDCD 19% | 对最强蒸馏基线 OPCD +25 至 +33 个百分点 CR |
| 知识抑制(RWKU 10 实体,GPT-OSS-20B) | CR / RR(Neighbor L1/L2 + BBH) | 97–100% / 76–83% | SHINE CR 100–103% 但 RR 仅 4–10% | 在相近 CR 下 RR 高出约 70 个百分点 |
| 智能体经验固化(ALFWorld,Qwen2.5-14B) | CR / RR(成功率) | 128–133% / 约 88%(固化后超过带上下文表现) | Context(带上下文推理)RR 基准 86% | CR 超过 100%,说明固化模型超越了上下文提示这一『参考上限』 |
| 人格引导(Power-seeking,Gemma3-12B / Qwen2.5-14B) | CR / 流畅度 RR | 95–100% / 99–100% | DPO/CAA/RepE 等各具短板(部分 CR 为负或流畅度受损) | 同时逼近两个 100%,位于 Pareto 前沿 |
局限与改进
作者承认的局限:抑制任务的选择性不足,Neighbor L1/L2 分数较 Vanilla 平均下降 9–20 分(尽管 BBH 只降 0.1–3.3 点),说明压住目标知识时波及了邻近知识;τ²-Bench 上固化失败甚至倒退(Synaptic CR −92.3%),交互式环境的成功难以离线固化为静态问答监督;GPT-OSS-20B 批量 API 学习从单条的 91–93% 掉到 45–59%,多上下文批量仍有明显损失;人格引导只在单条设置评估(多个persona指令可能互相冲突);抑制的目标回答重合度下降并不等于知识已从参数中擦除;固化学习仍需对整个骨干反向传播,120B 模型的训练计算依然昂贵;上下文靠人工构建并需按模型适配;超参选择基于留出数据的 CR 而非 RR。我自己的观察:CR/RR 的解释力依赖『上下文间隙显著为正』这一前提,间隙小或基线为零时指标会失稳(作者也注明了这一点,且 RR 可超过 100% 使解读需要小心);前瞻查询完全由模型自产,自我蒸馏可能固化模型的既有偏见与幻觉——学到的只是『模型+上下文』的行为包络而非外部真值;每条上下文独立优化、无摊销机制,50 条编辑每条 30 epochs 的成本对更大规模序列不可忽视;评测大量依赖 LLM-as-judge(Gemini 3 Pro、gpt-4.1),评判成本与潜在偏差需考虑;多模态模型只用了文本输入,跨模态上下文的固化未验证;50 步以上的更长持续序列、跨任务序列未测。
独立分析的弱点
弱点一:抑制/遗忘的选择性不足。Neighbor 探针降 9–20 分,根源是重演数据只约束了『目标问题该拒绝』,没有显式监督『邻近问题该正常回答』。改进方向:构造负样本重演对(目标问题与其邻近问题成对出现),在损失中加入对邻近查询的 KL 锚定项,类似 AlphaEdit 的零空间约束但作用于行为层面。弱点二:交互式环境固化失败。τ²-Bench 的 Synaptic CR 为 −92.3%,因为离线成功轨迹+教师强制无法覆盖环境交互的状态分布。改进方向:引入 on-policy 分量,如 OPCD 式的学生 rollout 蒸馏,或环境内少步微调与固化的混合课程。弱点三:每上下文独立优化、无摊销。超网络基线(Doc2LoRA、SHINE)单条表现尚可但批量崩溃,而 Cortex 批量也会退化(GPT-OSS-20B API 从 91–93% 掉到 45–59%)。改进方向:在大量 (C, adapter) 对上元训练『上下文到 Structural 参数』的生成器作先验初始化,再少量微调;或研究更优的批量混排与梯度手术以减轻上下文间干扰。弱点四:自我蒸馏的真值风险。学生模仿的是自身带上下文的行为,若上下文与参数知识冲突或模型本就答错,固化会放大错误。改进方向:对重演回答加检索校验或强模型交叉审查,仅保留通过验证的三元组。弱点五:结构扩展的容量治理缺失。每编辑新增 0.74M 参数,成千上万次更新后部署宽度持续膨胀。改进方向:建立『扩展—稳定—剪枝/合并』的循环(作者亦提及),用结构化剪枝或蒸馏把冗余通道回收,同时保住已固化行为。
未来方向
作者明确提出的方向:跨任务的持续固化与更大规模的批量固化(当前各任务分别评估);对 Structural 扩展做剪枝与合并以控制累积成本;训练超网络从上下文直接预测 Structural 参数以摊销固化计算。基于本文成果可自然延伸的方向:其一,跨任务序列实验——先学 API、再积累智能体经验、再插入事实编辑,测量异质记忆间的干扰与迁移,这对真实部署智能体更现实;其二,把 MC 用作部署侧个性化机制(用户偏好、私有知识库),并配套作者提到的经验验证与隐私控制(哪些用户信息可保留、可共享);其三,检验论文提出的开放假说——参数化固化是否有助于『远程联想与隐性规则发现』(睡眠促进洞察的生物学启示),设计需要组合两条间接相关经验的评测;其四,与 KV-cache 型参数化记忆(Cartridges)在同任务上做效率—效果对比,厘清『权重写入』与『缓存学习』的适用边界;其五,理论上把定理 A.2 的有限状态插值推广为分布层面的泛化界,刻画重演覆盖度与 CR 的定量关系;其六,在强化学习智能体中用固化替代或增强经验回放缓冲。
复现评估
复现条件总体良好。代码承诺在 github.com/zjunlp/cortex 开源,Memory Consolidation Testbed 也将公开。模型全部公开可得(Qwen2.5-14B-Instruct、Qwen3-4B-Instruct/Thinking、Gemma3-12B-it、GPT-OSS-20B/120B);持续编辑使用公开 zsRE 事实,编辑与引导评测依赖 Gemini 3 Pro、SimpleQA 判分用 gpt-4.1,存在 API 成本;环境类任务需部署 ALFWorld 与 τ²-Bench;上下文与评测题为人工构建并经人工核查,这部分可能不随代码完整释出,是复现的最大不确定点。训练超参披露极为详尽(附录表 5、表 8:AdamW、lr $5\times10^{-4}$、每更新 30 epochs、cosine + 10% warmup、BF16、KL 温度 2、top-1024 截断、microbatch 2×累积 2、4096 token 上限、seeds 43–45)。算力方面:Cortex 只训练新增参数(持续编辑每步 0.74–2.73M),14B 模型的单次固化接近普通 LoRA 微调,单张 80GB 卡可行;但教师前向需要完整骨干驻留显存(教师与学生可各占一卡),GPT-OSS-120B 的实验及 OPCD 基线(8 GPU、FP32 学生+参数卸载)需要多卡集群;评测计算量大——持续编辑每个检查点对每条已见事实 7 次生成、每 5 步跑固定 MMLU/SimpleQA/GSM8K 子集,单序列数千次评测调用。综合判断:14B 级别的核心结论(持续编辑、批量编辑)中等难度可复现;120B 与全测试床复现门槛较高,建议等官方释出数据与脚本后按任务族逐个验证。
论文图表
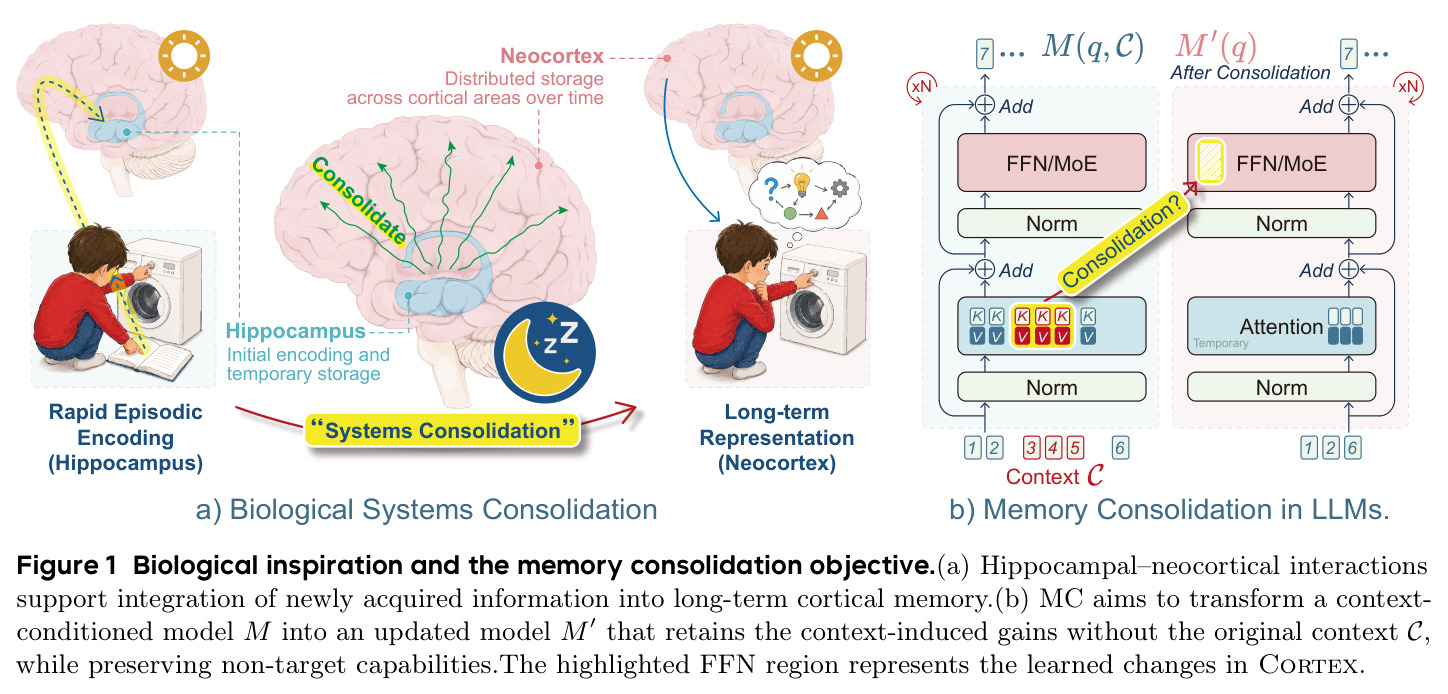
(a) 生物系统固化:海马体快速情景编码后,经时间推移把记忆分布式存储进新皮层各区域;(b) LLM 中的记忆固化目标:把带上下文的条件模型 $M$ 变成更新后的 $M'$,使其在没有原始上下文 $C$ 时仍保留上下文带来的增益,同时保持非目标能力,高亮的 FFN 区域代表 Cortex 学到的参数变化。
一张图同时讲清问题的生物隐喻和形式化目标,是理解全文框架的入口;标题 Cortex(新皮层)的命名由来也在此。