InfiniSplat v2:分析与改进从任意视角进行前馈式 3D 高斯重建的方法 InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
冻结几何分支、GT相机尺度对齐、大角度监督,大幅提升前馈3DGS渲染质量
前置知识
3D Gaussian Splatting (3DGS)
一种显式三维场景表示:场景由大量各向异性 3D 高斯基元组成,每个高斯带有位置 $\mu$、不透明度 $\alpha$、三轴尺度 $s$、旋转四元数 $q$ 和球谐颜色 $c$。通过可微光栅化投影到图像并按深度排序做 alpha 混合即可实时渲染,也可通过梯度反传直接优化属性。
本文的一切改进都围绕高斯属性(不透明度、尺度、旋转、颜色)的学习展开,高斯中心被刻意固定,不理解 3DGS 的属性分解就无法理解方法动机。
前馈式重建(Feed-Forward Reconstruction)
与逐场景优化(per-scene optimization)相对:用神经网络在大量场景上预训练,推理时一次前向传播直接从输入图像预测完整的高斯场景,无需测试时梯度下降,速度从分钟/小时级降到秒级。GS-LRM、pixelSplat、DA3-GS 都属此类。
论文标题中的 feed-forward 3DGS 就是这一范式,本文比较的全部基线(AnySplat、ReSplat、WorldMirror 2.0 等)以及评测协议都建立在这个概念上。
几何基础模型(Geometry Foundation Model)
在海量数据上预训练的多视角几何网络,输入任意数量图像即可输出每视角深度图与相机内外参,代表工作包括 DUSt3R、VGGT、Depth Anything 3 (DA3)。把深度按相机反投影到统一坐标系可得到点云,作为下游任务的几何先验。
本文冻结的几何分支就是 DA3(DA3NESTED-GIANT-LARGE-1.1),所有高斯点都来自它预测的深度和相机,理解其'预测几何不完美但有离群簇'的特点是论文出发点。
LPIPS 与 DISTS 感知指标
两者都基于深度网络特征衡量两张图像的感知差异,比 PSNR 更贴近人眼判断:LPIPS 用 VGG 特征的逐层距离,DISTS 进一步做了结构-纹理统一建模并对纹理失配更鲁棒。数值越低越好。本文遵循 SHARP 的做法以这两个指标为主指标。
论文所有核心结论(LPIPS 降低 25.8%、DISTS 降低 32.9%)都以这两个指标度量,不理解它们就无法衡量贡献大小;PSNR/SSIM 仅作为辅助完整指标。
Umeyama 相似变换
给定两组对应点,最小二乘求解旋转 $R$、平移 $t$ 和尺度 $s$ 的闭式解,使 $s R x_i + t \approx y_i$。本文只用其中的尺度分量:把 GT 相机中心拟合到归一化后的预测相机中心,得到尺度 $s_C$,统一 GT 与预测重建的度量单位。
方法第 (2) 点'尺度对齐训练'的数学核心就是 Umeyama 拟合,式 (3)(4)(9) 都依赖它,是读懂训练管线的关键工具。
研究动机
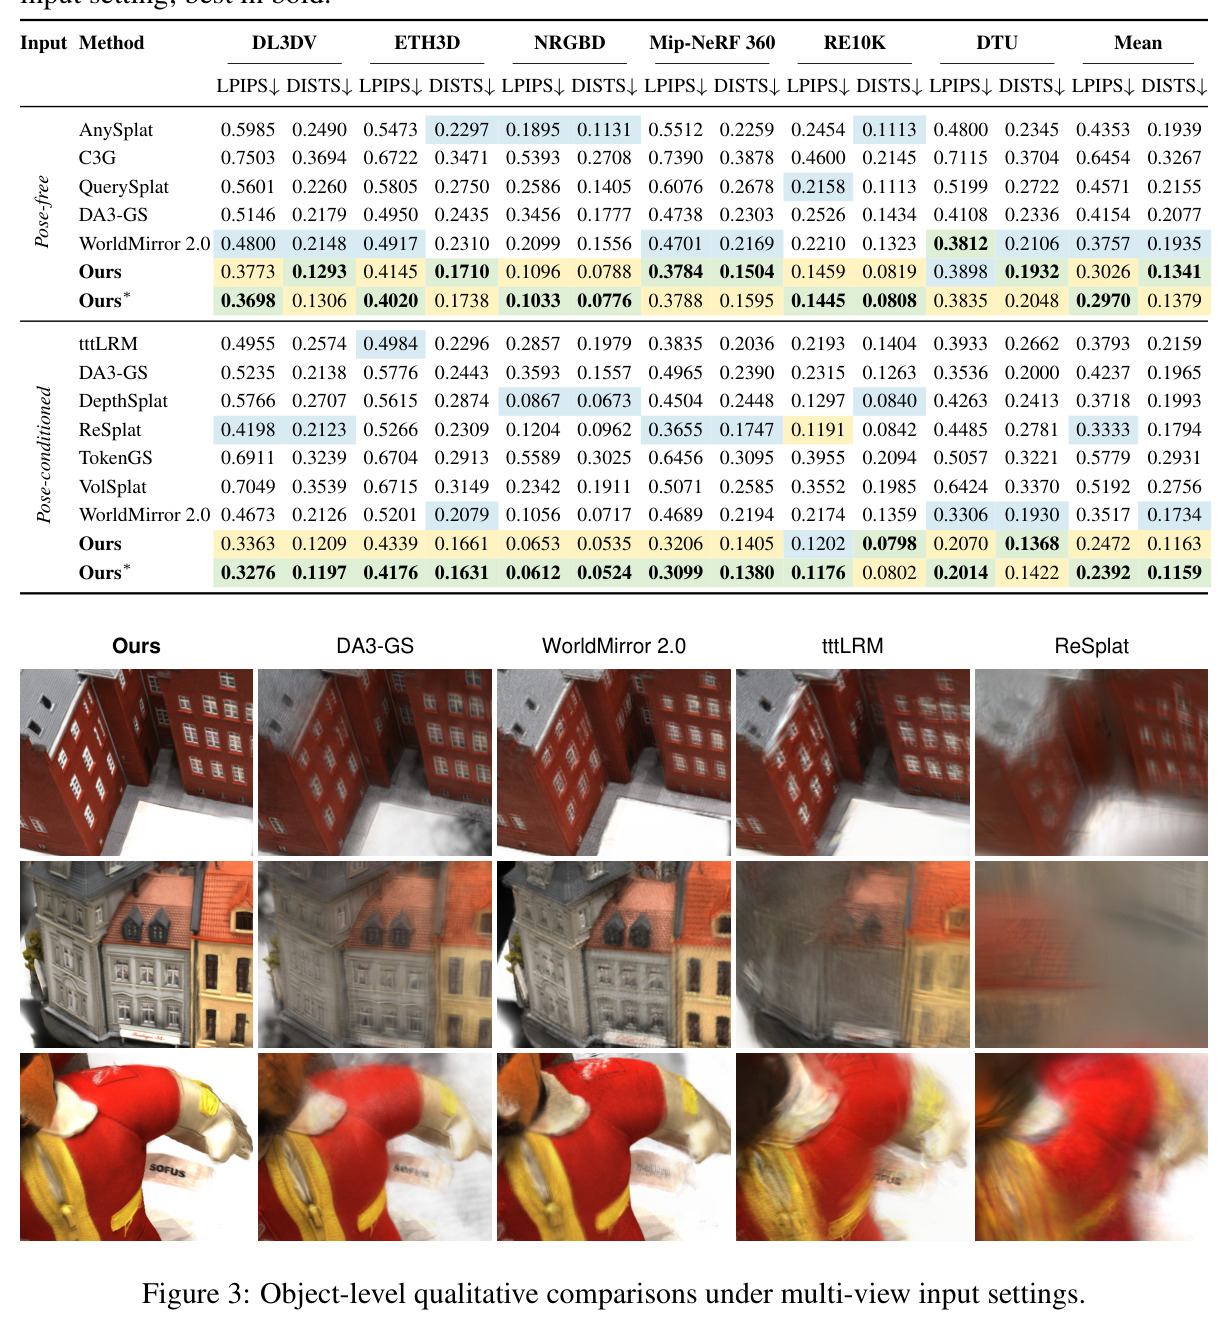
把多视角图像变成可渲染的 3D 场景,最新路线是先由几何基础模型(如 Depth Anything 3)预测每个视角的深度图和相机,再反投影成点云,并在点上学高斯属性,DA3-GS、AnySplat、WorldMirror 2.0 都是这个范式。但论文指出该路线有两个实际痛点:其一,预测点云虽然整体几何连贯,却普遍含有跨视角不一致的孤立点簇,三维聚合后问题暴露得尤其明显(Figure 1 左侧的飞点);其二,现有方法在渲染端表现不佳,DA3-GS 等 evaluated 方法在大视角变化下出现明显模糊、鬼影和细节丢失,例如 pose-conditioned 设定下 DA3-GS 在 DL3DV 上 LPIPS 高达 0.5146、六个数据集平均 0.4237,远达不到可用的视觉效果。作者把根因归结为几何与高斯属性被联合优化:当图像重建损失不满意时,网络可以通过移动点位来'补偿'属性学习的误差,反而造成几何退化。
本文的目标是本文的目标不是改进几何预测本身,而是回答一个更工程化的问题:给定不完美的预测几何(含离群点的点云),如何训练出能产生高质量新视角渲染的前馈高斯重建器。具体要求是:同一个训练好的模型在 pose-conditioned(提供相机位姿)和 pose-free(不提供位姿)两种推理设定下都工作;在 DL3DV、ETH3D、NRGBD、Mip-NeRF 360、RE10K、DTU 六个数据集、N=4/8/16 输入视角配置下,取得 evaluated 方法中最低的平均 LPIPS 和 DISTS;同时保持前馈效率(单次前向 0.56 到 5.62 秒量级),并弄清楚仅用图像重建监督时高斯属性究竟学到了什么。
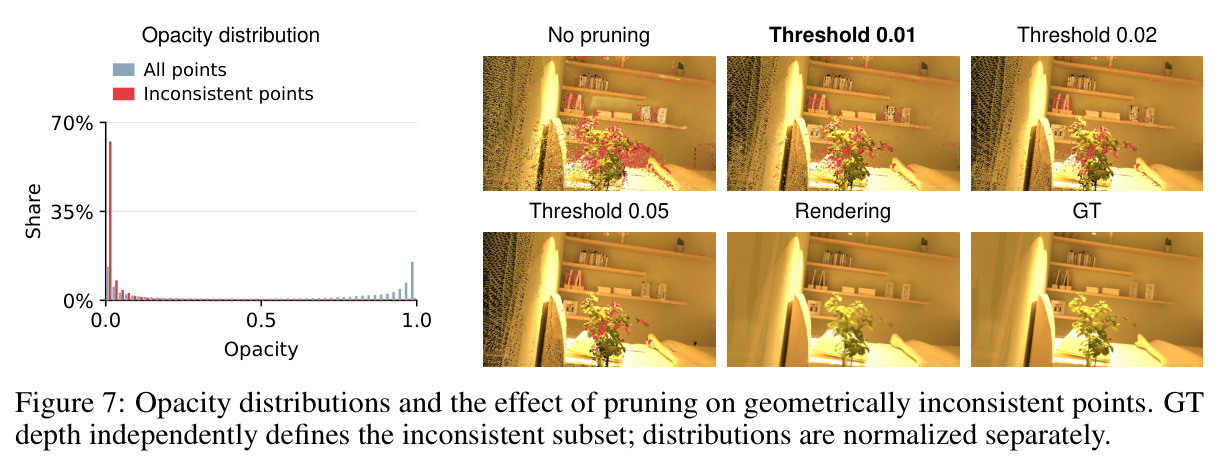
与已有工作不同的是,与既有工作的区别在于切入角度:DA3-GS 等方法把几何和属性放在共享骨干上加 adapter 联合训练,ReSplat 等允许渲染反馈更新高斯位置,QuerySplat 用冻结特征解耦解码但未系统分析训练监督方式。作者先做诊断实验,定位出三个被忽视的因素——联合优化导致几何退化、训练时用预测位姿建点而用 GT 位姿监督造成相机误差错配、目标视角集中在输入视角附近导致高斯尺度和朝向约束不足——然后针对每个因素给出最小干预的修复(冻结、尺度对齐、大角度采样)。此外,论文首次用 GT 深度独立标注系统量化了一个有趣现象:只靠图像重建监督学出的不透明度会自发地选择性压制几何不一致点,这为此前未被明确解释的'渲染监督隐式去噪'提供了定量证据。
核心方法
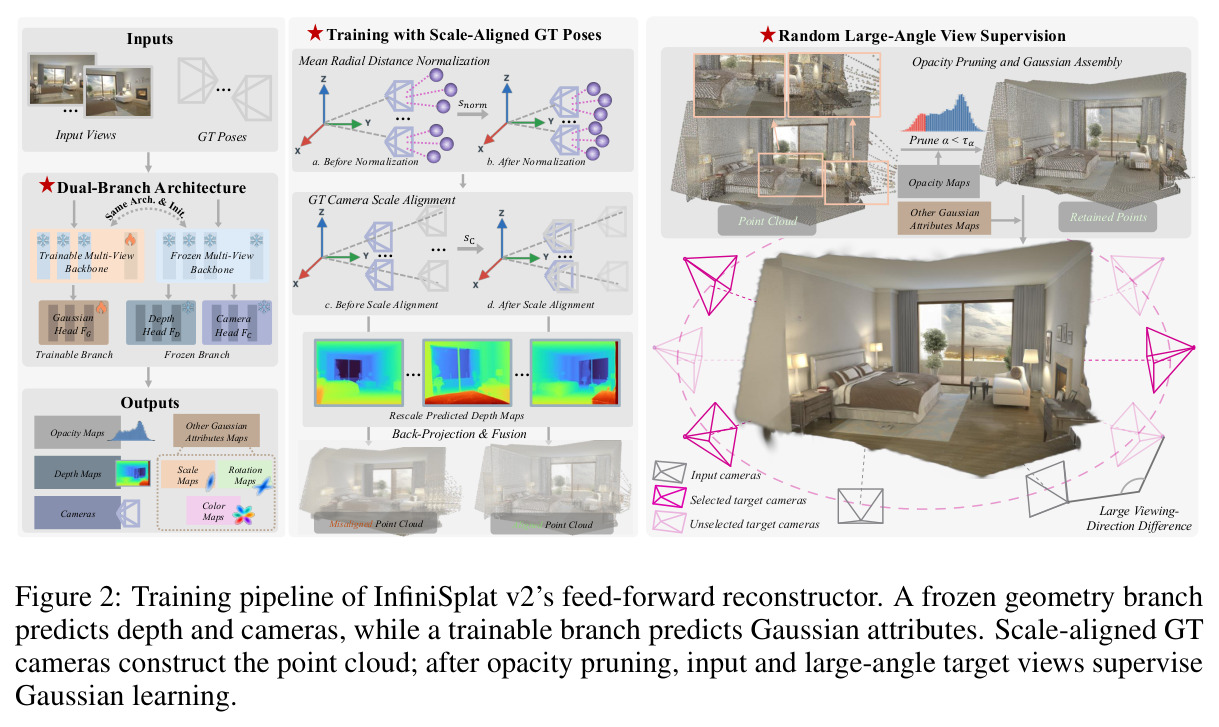
直觉上,方法让几何'保持原样',把全部学习预算花在'把这些点画好看'上。技术上:给定 N 张输入 RGB 图和可选位姿条件,双分支前向——冻结的 DA3 几何分支输出深度图与相机;可训练属性分支独立参数化、只微调最后 K=10 个 Transformer 块,输出多层 patch 特征,经 DPT 高斯解码器映射为每像素属性 $\xi=(\alpha,s,q,c)$(不透明度、三轴尺度、旋转、零阶 SH 颜色)。高斯中心固定在反投影位置:先做平均径向距离归一化 $s_{norm}=\frac{1}{|V_{pts}|}\sum_{j\in V_{pts}}\|x_j\|_2$,再用 Umeyama 拟合只取尺度 $s_C$ 对齐 GT 相机后反投影。之后经体素合并(边长 0.004)和不透明度剪枝($\tau_\alpha=0.01$)得到初始场景 $G_0$,从输入视角和大角度目标视角渲染做等权 L1+LPIPS 监督(训练 25000 步、16 张 H20 约 48 小时);第二阶段再用渲染梯度反馈的循环 KNN Transformer 精修属性 3 步,中心与点数始终不变。
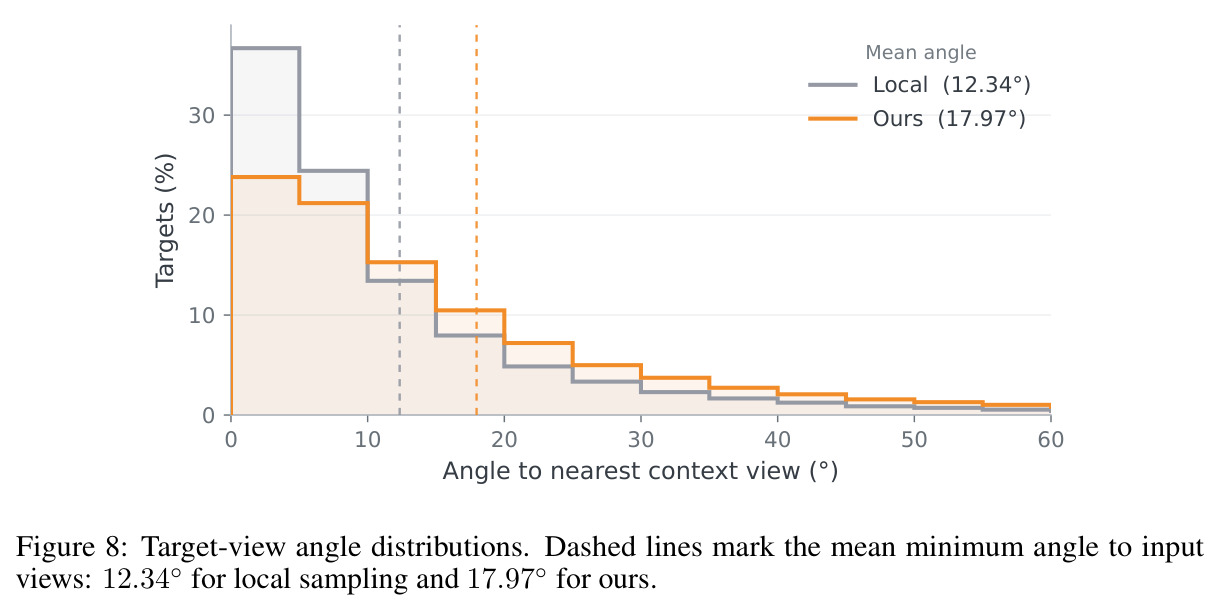
三个核心创新,每个都针对一个诊断出的问题,与已有方法有本质区别。其一,解耦与冻结:双分支用同一 DA3 权重初始化但参数独立,几何分支(含深度头、相机头)完全冻结,只训属性分支末 10 块加高斯头,且明确禁止位置偏移——这堵死了'移动点位补偿属性误差'的退化通路,与 DA3-GS 的共享骨干加 adapter、与允许偏移的方法形成对照。其二,尺度对齐训练:反投影和目标渲染统一使用 GT 相机,经 $s_{norm}$ 归一化后用 Umeyama 从 GT 输入相机中心拟合到预测相机中心、只保留尺度 $s_C$ 来缩放 GT 平移,保留 GT 相对旋转与内参,消除'预测位姿建点、GT 位姿监督'的错配。其三,随机大角度视角监督:按光学轴夹角 $a(v,\mathcal{C})=\min_{i\in\mathcal{C}}\arccos(f_v^\top f_i)$ 给候选目标视角打分,以 0.7 概率从大角度池采样,迫使高斯的尺度和朝向从多个投影方向被约束。附带发现:仅图像重建监督学出的不透明度天然压制跨视角不一致点。
方法步骤详情
管线五步。第一步,双分支前向:冻结分支从输入图像与可选位姿预测深度和相机,可训练属性分支输出多层特征,DPT 解码器输出每像素高斯属性。第二步,尺度对齐与建点:MRDN 把预测深度和平移同除 $s_{norm}$;仅用输入相机中心对应关系做 Umeyama 拟合取尺度 $s_C$ 缩放所有 GT 平移;再用归一化深度与对齐后的 GT 相机反投影出高斯中心,体素合并后剪掉低不透明度点。第三步,目标视角采样:候选视角按夹角 $a(v,\mathcal{C})=\min_i\arccos(f_v^\top f_i)$ 分大小角度池,以 0.7 概率选大角度池(平均夹角 17.97° vs 局部 12.34°),抽 4 个目标视角并用 GT 深度掩码限定监督区。第四步,Stage I:L1+LPIPS 监督输入与目标渲染 25000 步(约 48 小时),只训属性分支末 10 块和高斯头。第五步,Stage II 冻结重建器、训精修器 5000 步:渲染输入视角取截断梯度,编码器融合属性、梯度与 DPT 特征,循环 KNN Transformer 预测属性残差,中心固定,推理执行 3 步。
技术新颖性
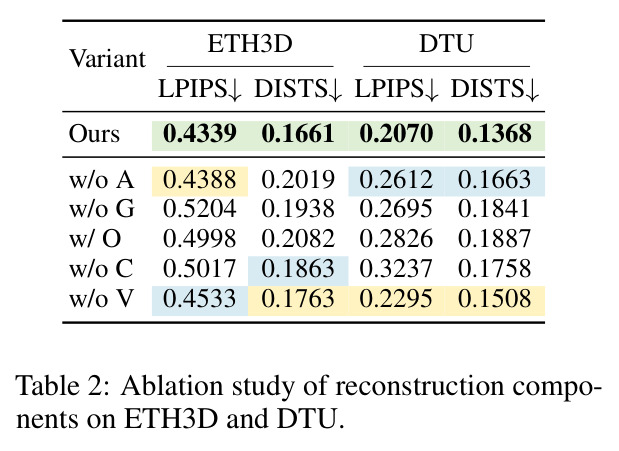
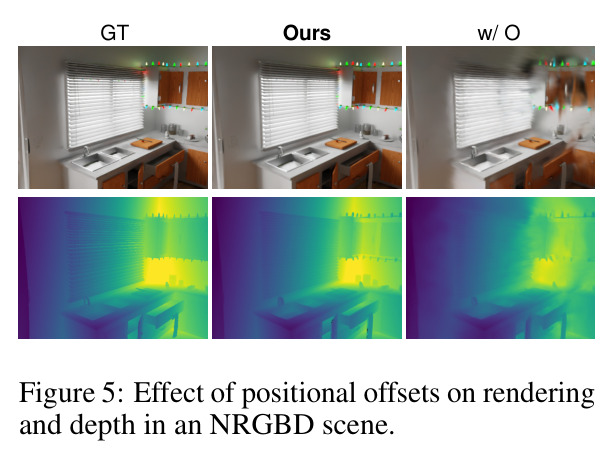
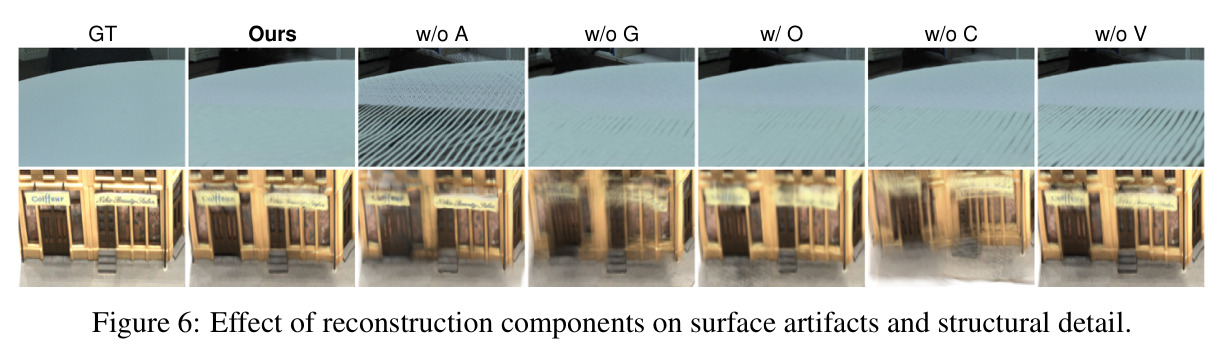
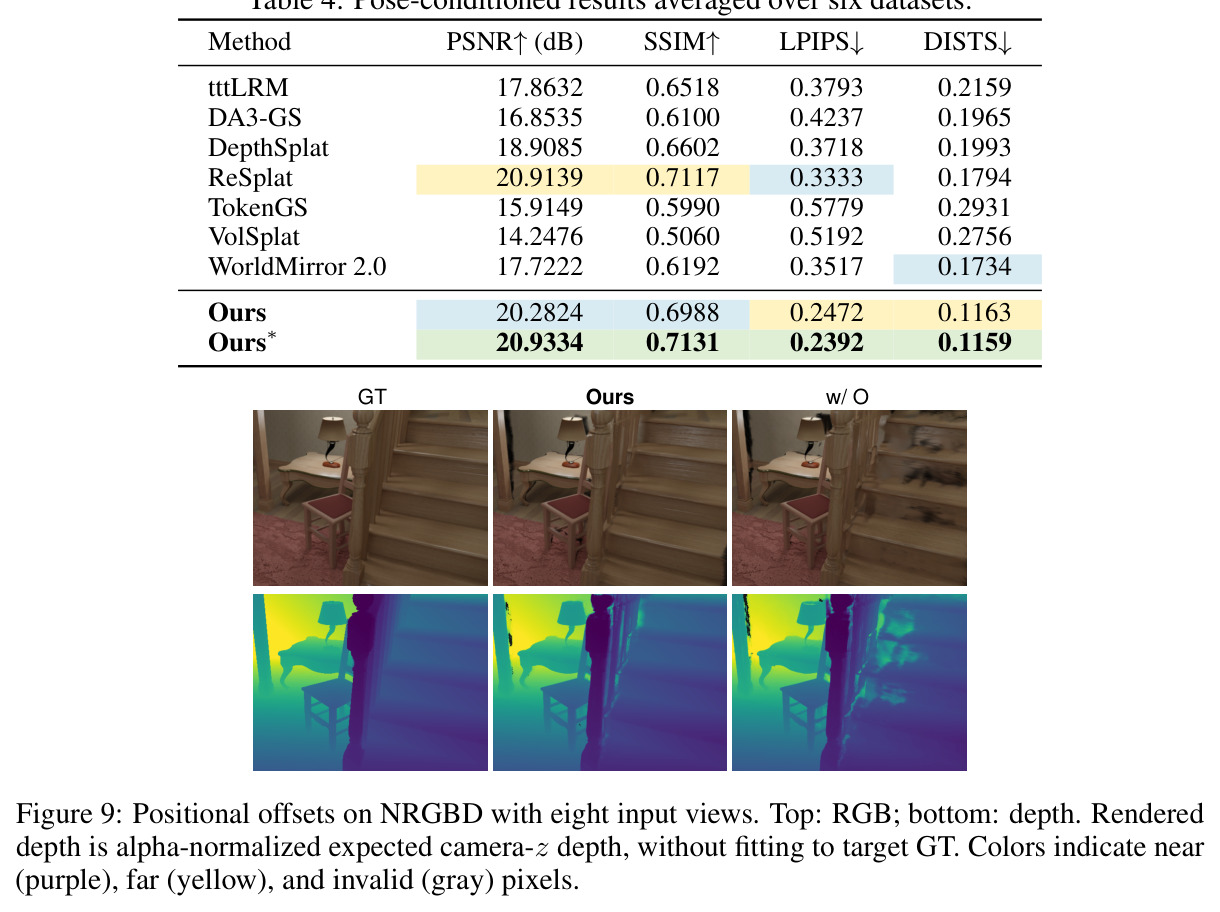
技术新颖性有三点。第一,把'冻结几何'从工程惯例上升为被消融证实的结论:允许微调几何(w/o G)使 ETH3D/DTU 的 LPIPS 从 0.4339/0.2070 恶化到 0.5204/0.2695,学习位置偏移(w/ O)恶化到 0.4998/0.2826,作者将其解释为位置更新成了属性误差的补偿通路,还会引发 Figure 5 所示的深度扭曲;这与 QuerySplat 仅用冻结特征解码、ReSplat 允许中心更新的设计形成清晰对照。第二,监督几何一致性:训练时建点相机与监督相机使用同一套尺度对齐后的 GT 相机,消融显示去掉 GT 相机反投影(w/o C)使 DTU LPIPS 恶化 36.1%,证明错配本身是显著误差源,这是此前工作(如 DA3-GS 用预测位姿)没有处理的。第三,可解释性发现:用 GT 深度独立定义'几何不一致点'(违反至少两个视角的自由空间且不贴合任何表面),发现 0.01 阈值剪枝删除 51.8% 的不一致点却只删 7.5% 的全部点、保留 93.3% 表面一致点,首次定量证明纯渲染监督能把不透明度用作隐式几何可靠性信号。
实验结果
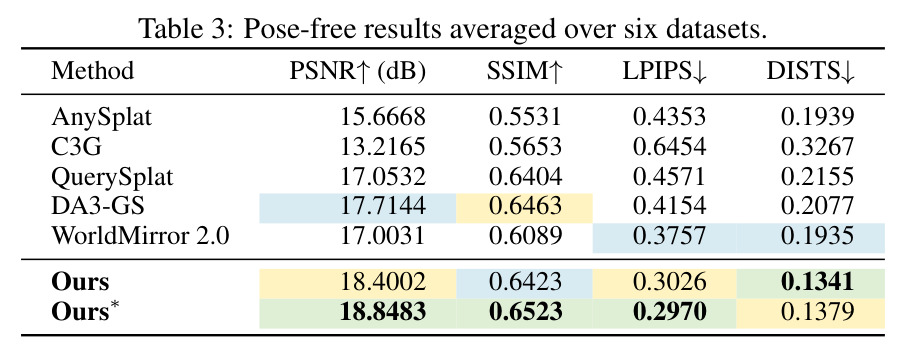
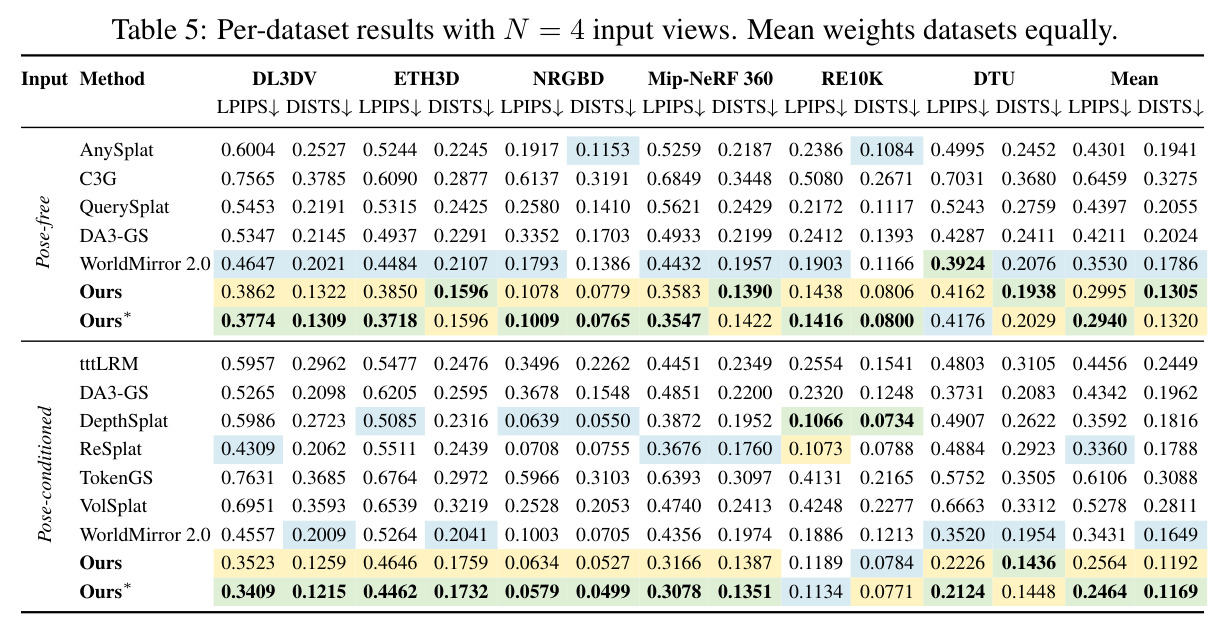
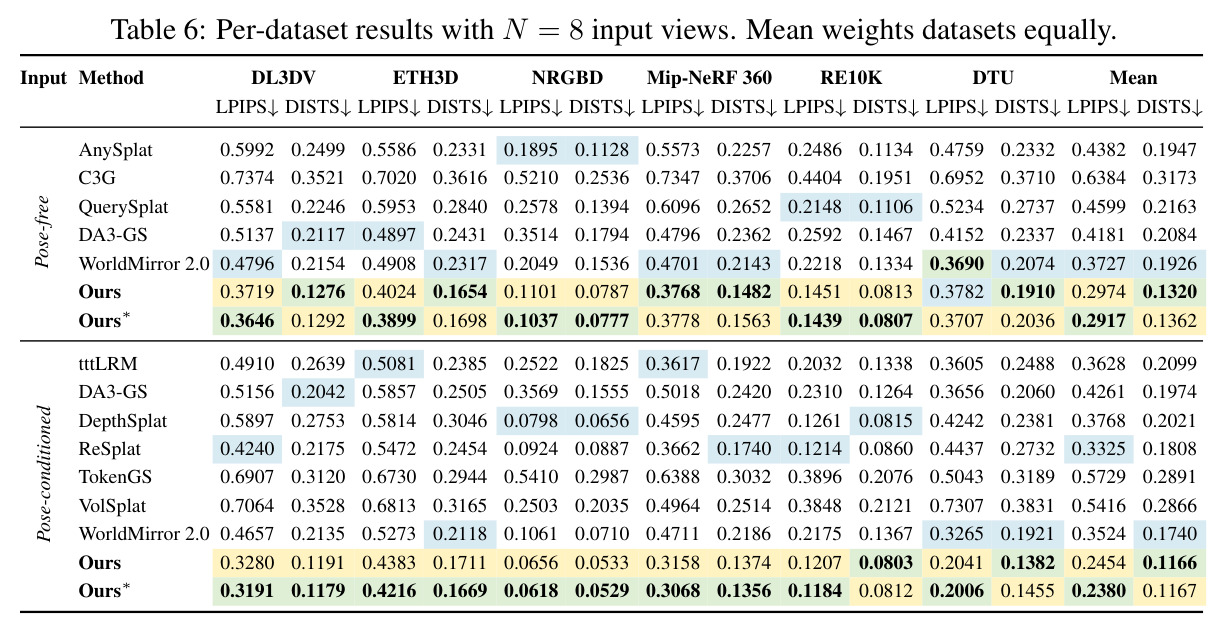
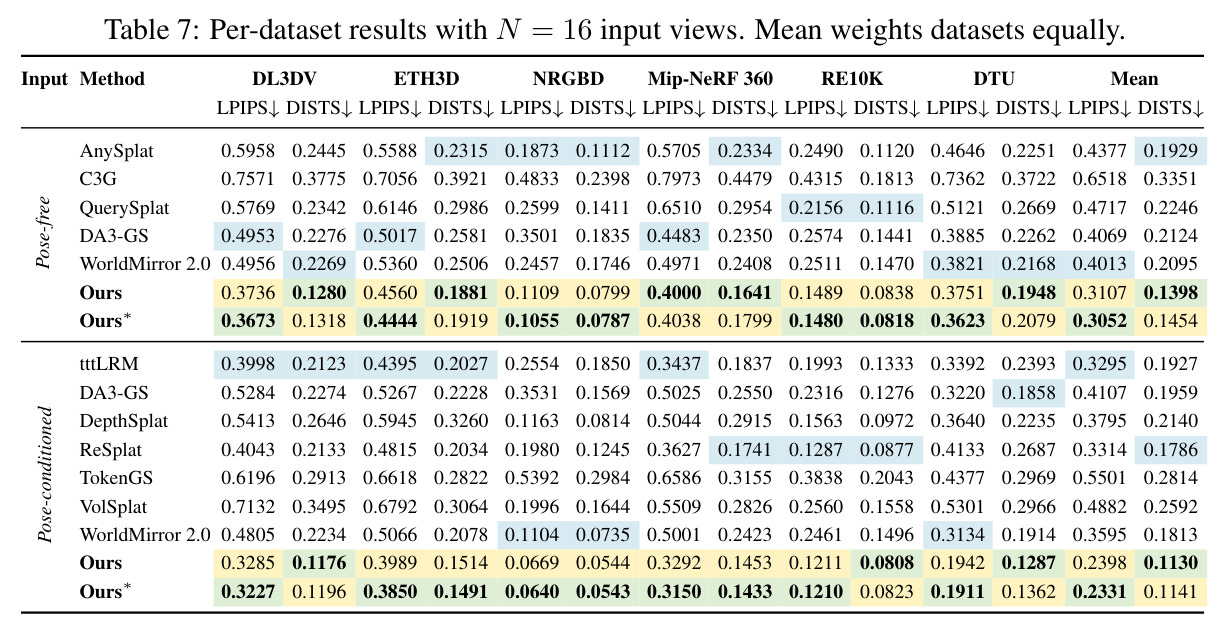
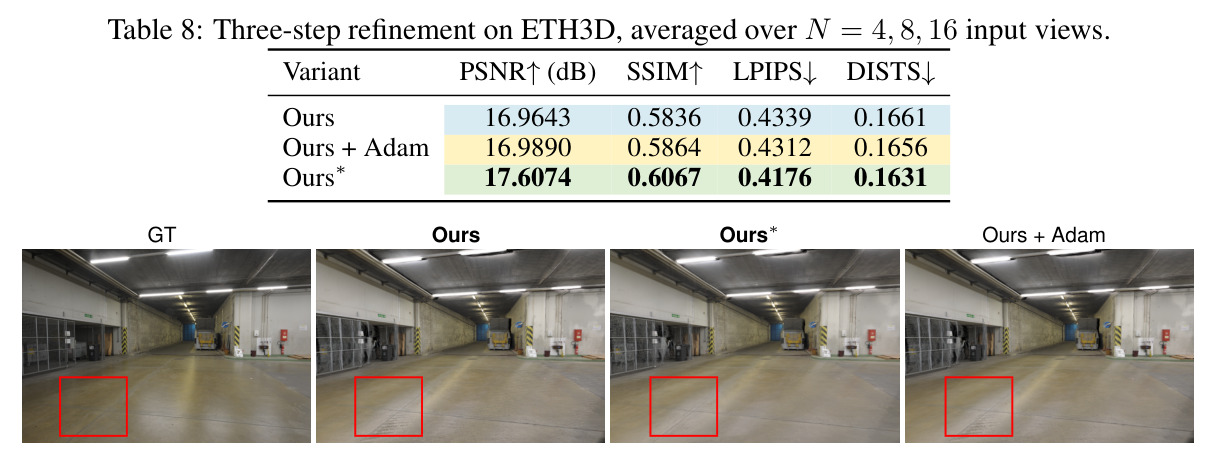
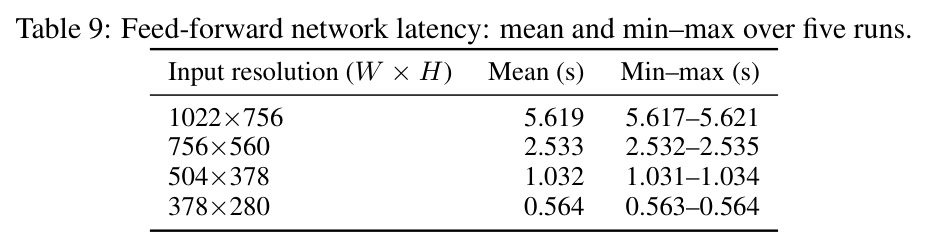
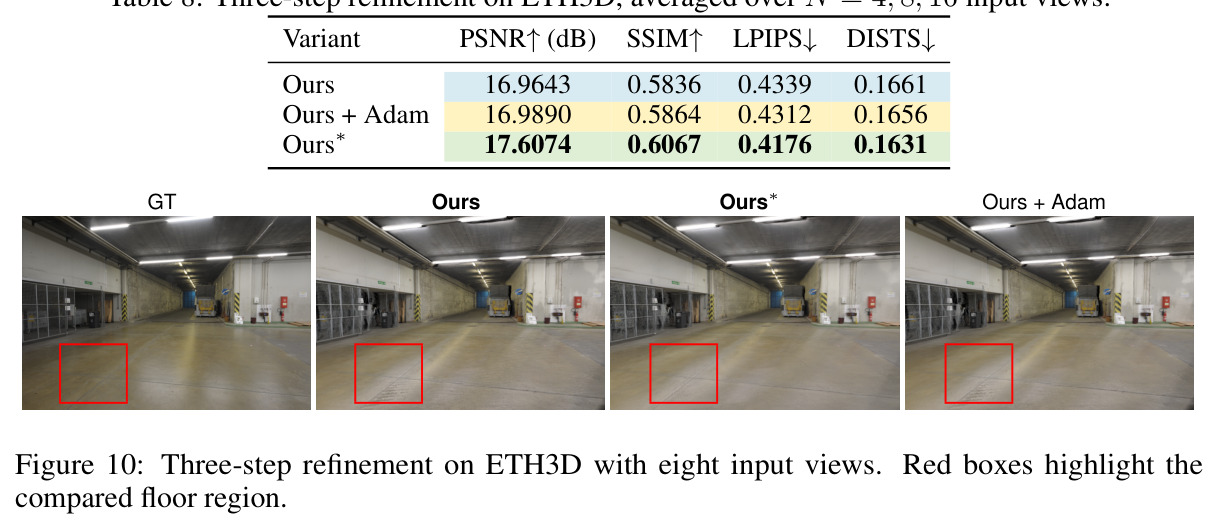
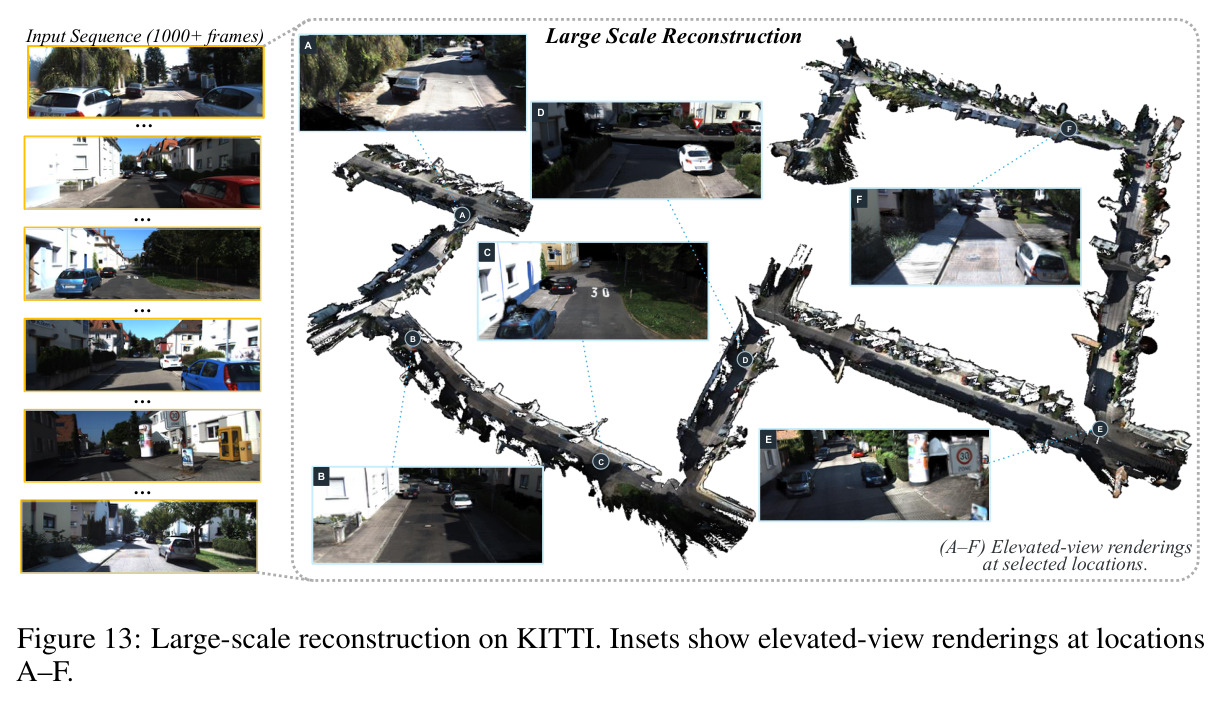
同一模型在六数据集、双位姿设定、N=4/8/16 视角下评测。① Pose-conditioned:平均 LPIPS 0.2472,比最强基线 ReSplat 的 0.3333 降低 25.8%;平均 DISTS 0.1163,比 WorldMirror 2.0 的 0.1734 降低 32.9%;精修后达 LPIPS 0.2392、PSNR 20.93 dB,四项均值第一。② Pose-free:平均 LPIPS 0.3026、DISTS 0.1341,比 WorldMirror 2.0 分别好 19.5% 和 30.7%。③ 微调几何使 ETH3D LPIPS 从 0.4339 恶化到 0.5204;预测相机反投影使 DTU 恶化 36.1%;位置偏移与局部视角监督也全面变差,三个设计各自必要。④ 阈值 0.01 剪掉 51.8% 几何不一致点、仅删 7.5% 全部点、保留 93.3% 表面一致点。⑤ 精修对比 Adam:学习式精修 +0.64 dB,Adam 仅 +0.02 dB。⑥ 前向延迟 5.62 秒(1022×756),KITTI 千帧滑窗可建大场景。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 新视角合成(pose-conditioned,6 数据集平均) | LPIPS↓ | 0.2472(精修后 0.2392) | ReSplat 0.3333 | 降低 25.8% |
| 新视角合成(pose-conditioned,6 数据集平均) | DISTS↓ | 0.1163(精修后 0.1159) | WorldMirror 2.0 0.1734 | 降低 32.9% |
| 新视角合成(pose-free,6 数据集平均) | LPIPS↓ | 0.3026(精修后 0.2970) | WorldMirror 2.0 0.3757 | 降低 19.5% |
| 新视角合成(pose-free,6 数据集平均) | DISTS↓ | 0.1341 | WorldMirror 2.0 0.1935 | 降低 30.7% |
| 新视角合成(pose-conditioned) | PSNR↑ | 20.93 dB(Ours*) | ReSplat 20.91 dB | +0.02 dB,同时 SSIM 0.7131 对 0.7117 |
| 消融:冻结几何 vs 微调几何(ETH3D) | LPIPS↓ | 0.4339 | w/o G 0.5204 | 冻结几何降低 16.6% |
| 消融:GT 相机反投影 vs 预测相机(DTU) | LPIPS↓ | 0.2070 | w/o C 0.3237 | GT 相机反投影降低 36.1% |
| 学习式精修 vs Adam 微调(ETH3D,3 步) | PSNR↑ | 17.61 dB(+0.64 dB) | Ours+Adam 16.99 dB(+0.02 dB) | 增益高出一个数量级 |
局限与改进
作者承认三点局限:固定中心使方法无法纠正预测几何中的严重错误,重建质量上限被几何先验(DA3)锁死;像素对齐预测天然产生冗余高斯,体素合并不能完全去除;输入覆盖不足时未观测区域会留下空洞。我的补充观察:pose-free 推理和评测对齐仍依赖输入相机对应关系来估计平移尺度,位姿完全缺失场景的稳健性未验证;大角度目标监督依赖目标视角的 GT 相机和深度来构造掩码,限制了向无标注视频等数据的直接迁移;精修只更新属性、不补洞也不修深度,KITTI 大场景靠滑窗拼接,跨窗口一致性没有量化指标;从 Table 1 看 pose-free 设定下精修使平均 DISTS 从 0.1341 略升到 0.1379(DTU 上 0.1932 升到 0.2048),说明属性微调并非在所有指标上无损,缺乏自适应停止机制;延迟实测在 H20 上进行,消费级 GPU 上的可用性未报告。
独立分析的弱点
独立分析五点弱点。其一,训练完全依赖 GT 位姿条件(两阶段都用),而真实互联网视频多无位姿,如何用 COLMAP 位姿或自监督位姿对齐替代是落地障碍,改进方向是位姿扰动训练或与 DUSt3R 系位姿头联合微调。其二,几何误差不可修复:冻结把中心锁死在 DA3 的深度边缘撕裂等错误上(作者在 Limitations 中承认),可引入范数受限的各向同性位置微调,或用深度置信度门控决定哪些点允许移动,兼取消融中'无约束偏移有害'与'完全冻结受限'的教训。其三,冗余与开销:1022×756 分辨率前向 5.62 秒、高斯数量巨大,体素合并边长 0.004 较粗糙,可借鉴 C3G 的紧凑 token 表示或基于重要性的剪枝压缩场景。其四,未观测区域空洞与滑窗拼接无一致性保证,可用不确定性引导的视角规划或生成式补全。其五,精修在 pose-free 平均 DISTS 上反而从 0.1341 恶化到 0.1379,说明 Stage II 的目标(L1+DSSIM+LPIPS)与感知指标不完全对齐,可在精修损失中加入 DISTS 代理或引入验证集早停。
未来方向
作者在结论与附录中提出四个方向:更强的几何先验以抬高质量上限、更紧凑的高斯表示以去冗余、引入生成模型填补未观测区域、面向采集的相机轨迹设计。基于本文成果还可延伸:把大角度目标视角监督的思想迁移到动态场景与 4D 高斯重建,因为多方向投影约束对时变几何同样成立;把'不透明度=几何可靠性'的发现变成通用无监督离群点检测器,服务于 SLAM、自动驾驶点云清理等下游任务;将 Stage II 精修器推广为 test-time training(呼应 tttLRM、Scal3R),允许更长展开与在线适应;对 KITTI 滑窗方案做层次化扩展(分块重建+全局配准)并量化跨窗口漂移;探索把属性分支蒸馏到更小骨干以实现实时推理,因为几何分支已冻结、属性分支只需局部特征。
复现评估
复现信息相当充分:论文有项目页(zju3dv.github.io/InfiniSplat2),附录完整给出初始化权重型号(DA3NESTED-GIANT-LARGE-1.1)、体素合并边长 0.004、剪枝阈值 $\tau_\alpha=0.01$、精修器架构(16 维隐状态、4 块 KNN Transformer、8 邻居)、全部损失公式(含 Stage II 一阶代理损失)、优化细节(AdamW $\beta=(0.9,0.95)$、全局批 16、梯度裁剪 1.0、各阶段学习率与 warmup/cosine 调度)以及评测相机协议。主要门槛是算力:训练用 16 张 H20 共约 61 小时(Stage I 48 小时 + Stage II 13 小时),完整复现需要多卡集群;训练数据 Hypersim、ScanNet++ 公开,Raw3D 可得性需确认,评测数据集均公开。对资源有限的研究者,较可行的路径是复用公开 DA3 权重只复现 Stage II 精修或小规模微调属性分支,相关基线代码多为开源。
论文图表
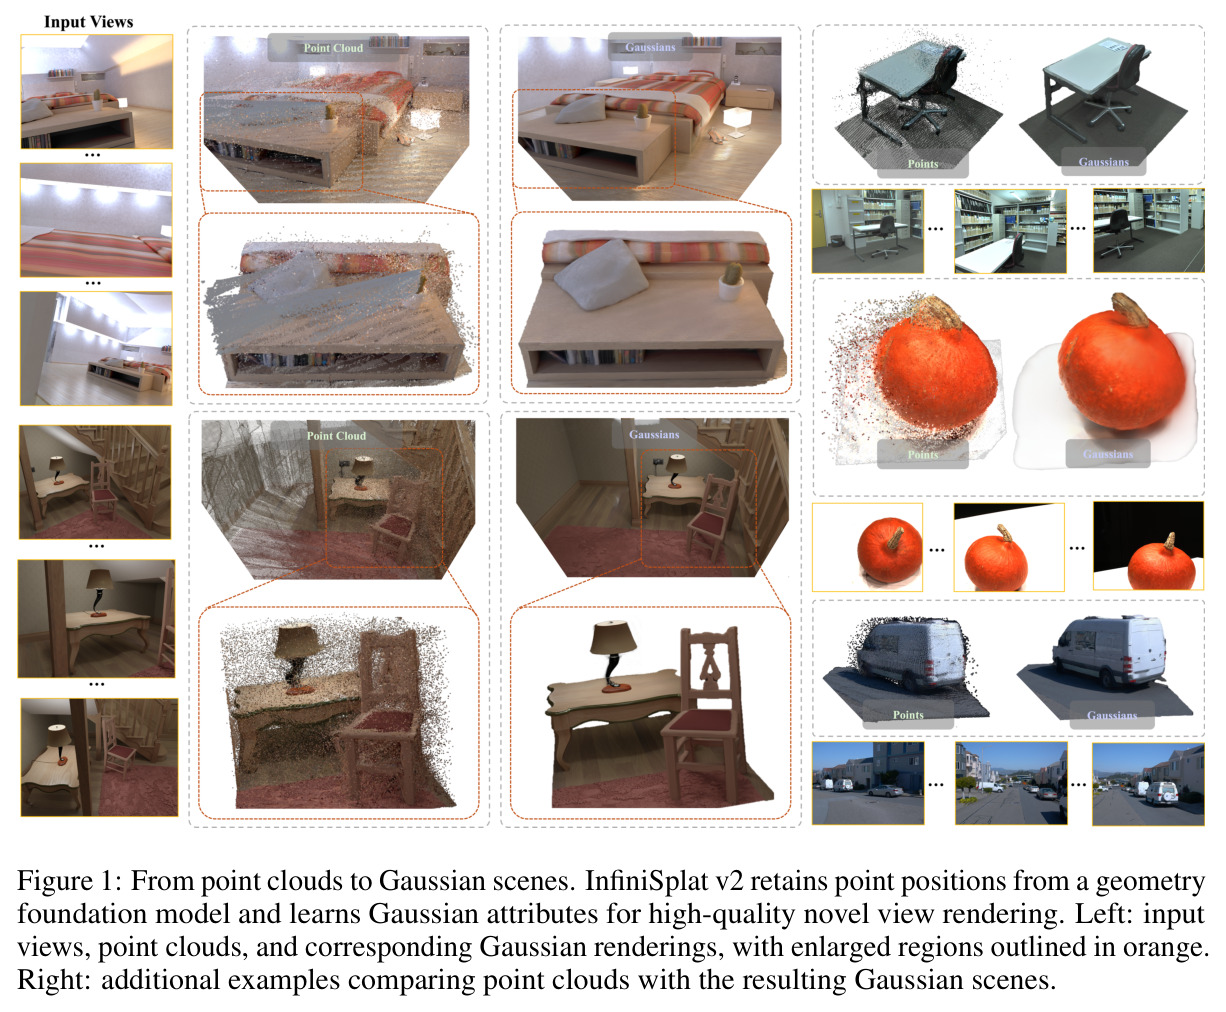
展示从几何基础模型预测的点云到高斯场景的转换:左侧为输入视角、点云及对应高斯渲染(含橙色框放的局部对比),右侧为更多'点云 vs 高斯场景'的例子,直观呈现预测点云中的离群点簇及渲染后的干净效果。
一图点明论文前提与卖点:几何先验不完美(含飞点),但保留点位置、只学属性也能得到高质量渲染,是全文动机的视觉摘要。
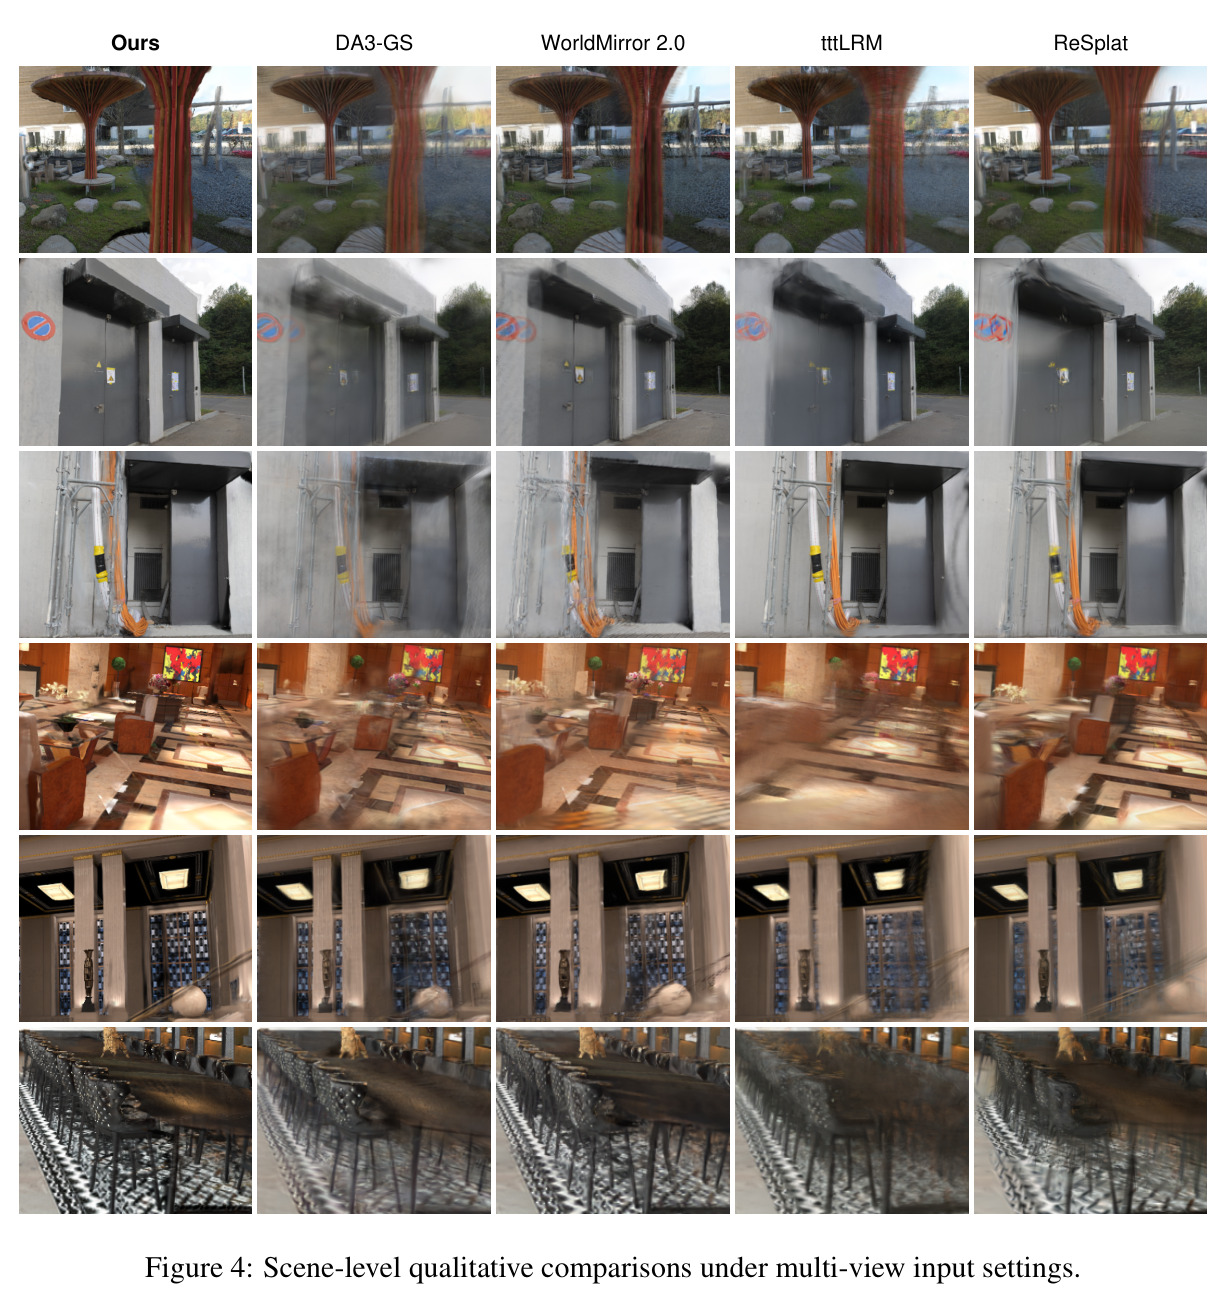
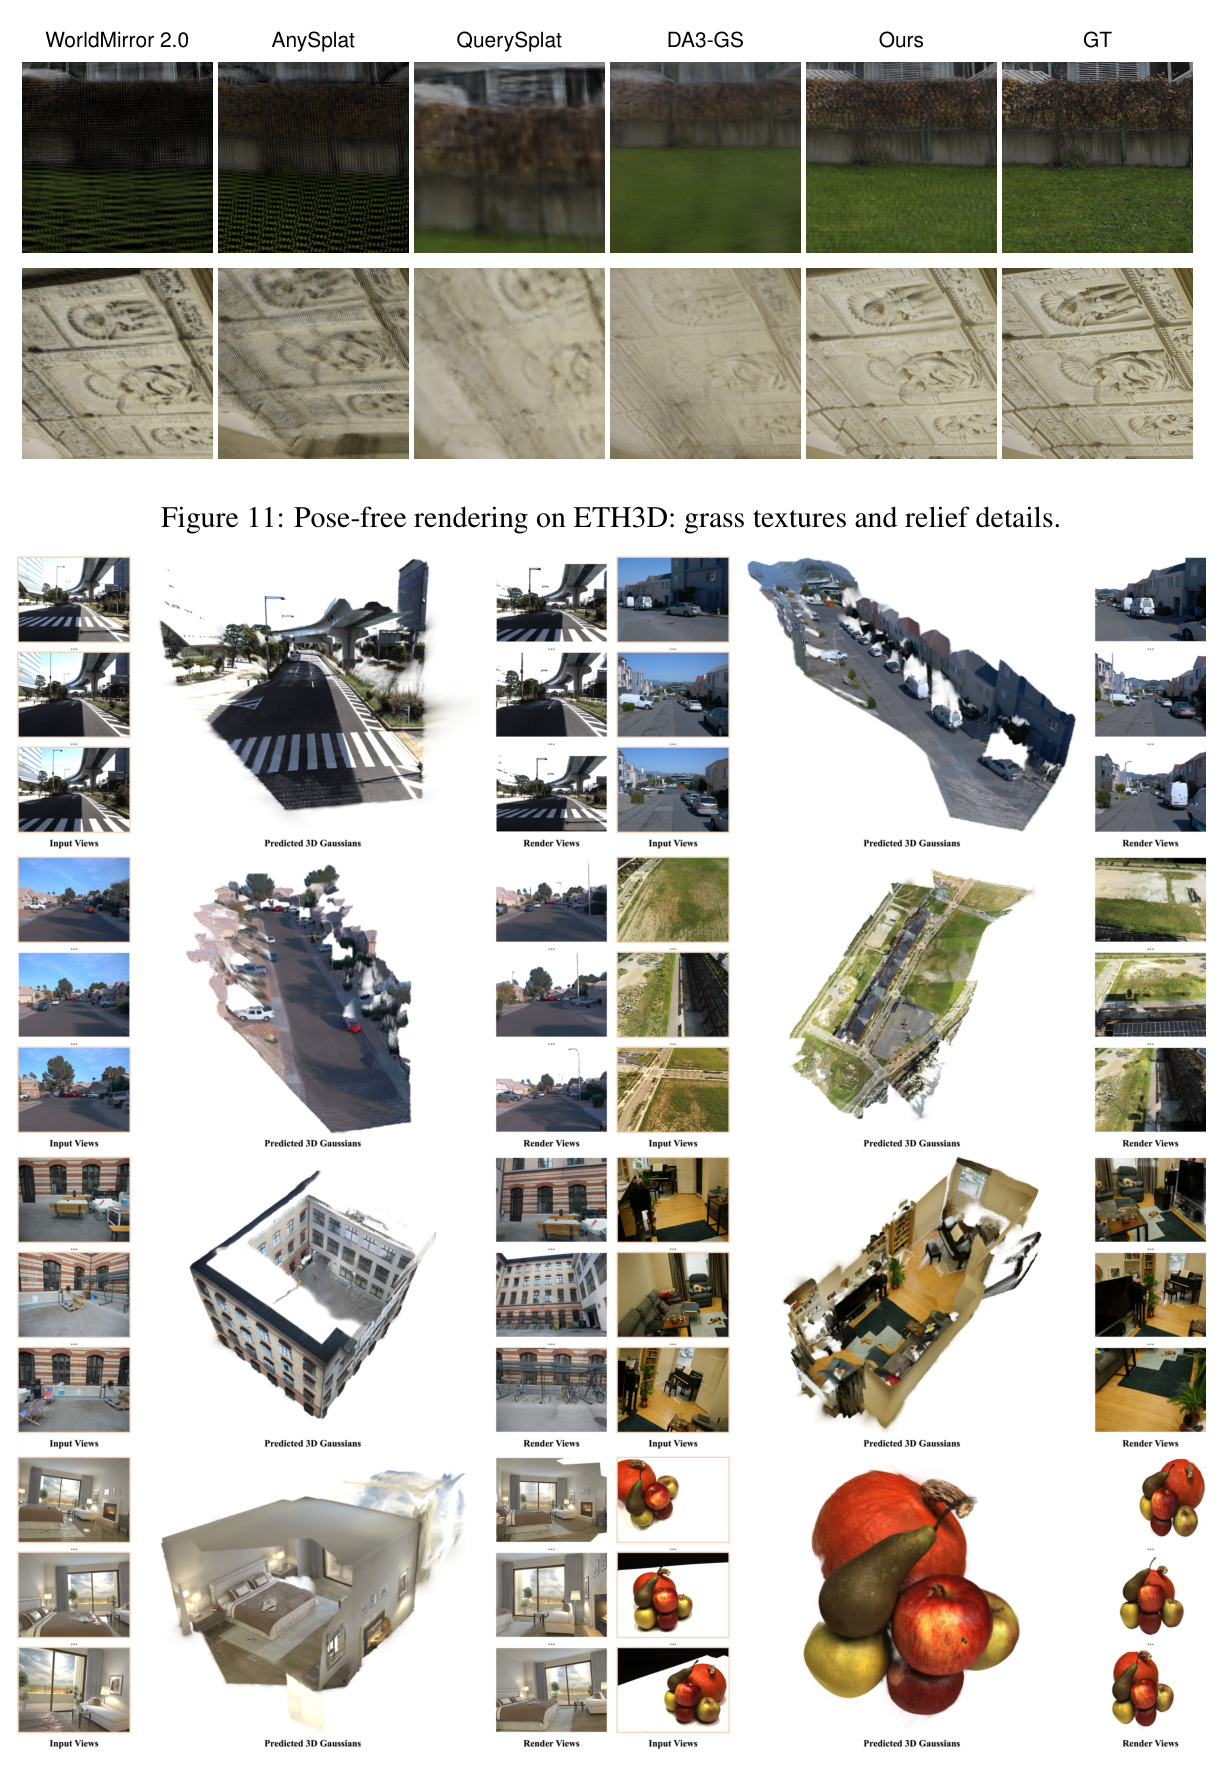
在 DDAD、Waymo、ETH3D、Hypersim、DTU、Mip-NeRF 360、Mill19 等多样场景上,用 12–64 个输入视角的前馈重建与渲染结果,覆盖街道、建筑、室内与物体。
展示方法的泛化域宽度和可扩展输入视角数,说明不只在评测的六个数据集上有效。
主结果表:pose-free 与 pose-conditioned 两种设定下,各方法在 DL3DV、ETH3D、NRGBD、Mip-NeRF 360、RE10K、DTU 六数据集上的 LPIPS/DISTS 及平均值。本文 Ours/Ours* 在两种设定下均取得最低平均 LPIPS(0.3026/0.2472)与 DISTS(0.1341/0.1163)。
论文核心定量证据,'同一模型双设定 SOTA'的结论完全由这张表支撑。
pose-conditioned 设定下六数据集平均四指标:Ours* 以 PSNR 20.93 dB、SSIM 0.7131、LPIPS 0.2392、DISTS 0.1159 在全部四项上排名第一,超过 ReSplat 与 WorldMirror 2.0 等七个基线。
证明方法不仅在感知指标、在传统保真指标上也全面领先,且精修有效。