KANLab:Kolmogorov-Arnold 网络的交互式可视化教学平台 KANLab: TensorFlow Playground for Kolmogorov-Arnold Networks
将TensorFlow Playground改造为KAN教学平台,实时可视化B样条与控制点
前置知识
多层感知机(MLP)
最经典的前馈神经网络:每层先对输入做加权求和,再经过一个固定的非线性激活函数(如 ReLU),逐层堆叠以逼近复杂函数。它的可学习参数是边上的权重,激活函数固定在节点上、不可训练。
KANLab 的教学叙事全部建立在 KAN 与 MLP 的对照上:先理解'权重在边上、固定激活在节点上'的传统结构,才能体会 KAN 把可训练非线性搬到边上的本质差异。
Kolmogorov-Arnold 网络(KAN)
由 Liu 等人在 ICLR 2025 推广的新型网络架构:把可学习的非线性激活函数(通常用 B 样条参数化的一元函数)放在边上,节点只做求和。相比 MLP 理论上更紧凑、更可解释,在符号公式表示任务上表现突出,也被广泛尝试用于分类任务。
本文的工具 KANLab 就是为交互式讲解 KAN 核心概念而生的,全文围绕 KAN 的结构、B 样条训练、初始化与剪枝展开。
Kolmogorov-Arnold 表示定理
该定理断言:有界域上的任意连续多元函数都可以表示为有限个一元函数与加法的复合 $f(x_1,\dots,x_n)=\sum_{q=1}^{Q}\Phi_q\left(\sum_{p=1}^{P}\varphi_{q,p}(x_p)\right)$,其中 $\Phi_q, \varphi_{q,p}: \mathbb{R}\to\mathbb{R}$,$Q=2n+1$、$P=n$,即两层结构即可完成表达。
这是 KAN 的理论基石,KANLab 明确声明其理论基础就是该定理;文中两层演示网络(2 输入、2 隐藏、1 输出)直接对应定理结构。
B 样条(B-spline)
一类分段多项式基函数:固定的一组 $k$ 次 B 样条基 $B_n^k(x)$(用 de Boor 算法计算)通过线性组合 $\varphi(x)=\sum_{n=0}^{N-1} c_n B_n^k(x)$ 逼近任意光滑一元函数,其中可训练对象是 $N$ 个控制点系数 $c_n$。
KANLab 采用 B 样条作为激活函数(作者称其在各类 KAN 基函数中理论保障最强、根基最牢),界面上绿色曲线与橙色控制点一一对应,是全部交互操作的对象。
方差保持初始化(LeCun/Glorot)
经典神经网络初始化思想:按层宽设置权重方差,使信号在前向/反向传播中的方差保持稳定。Rigas 等人(ICLR 2026)将这类方案推广到 KAN 的控制点初始化;此外 KAN 还有小方差均匀初始化和恒等初始化等选择。
KANLab 支持多种初始化方案供用户实时切换对比,理解初始化方差对初始激活的影响(如小方差导致激活近零)是文中关键教学场景之一。
研究动机
KAN 自 2025 年被 Liu 等人推广后迅速成为 MLP 的潜在替代品,尤其在符号公式表示任务上表现突出,也被大量尝试用于分类任务,但初学者缺少趁手的实践工具来建立直觉——单纯阅读理论或跑代码库都难以形成'训练动态'层面的体感。现有的 KAN-Playground(Solovyeva,2025)虽然是功能较全的 Gradio 实现、可通过 Hugging Face Spaces 访问,但训练在服务器端计算,响应性和交互性受限:例如网络结构只能以一张图片呈现,且每个 epoch 才更新一次。同时,现代 KAN 实现普遍在底层样条之上叠加残差连接和可学习的缩放/平移参数,这些组件虽对性能重要,却使激活可视化与底层样条参数之间不再一一对应,从教学角度看反而更难解读。
本文的目标是本文的目标是打造一个纯浏览器端的 KAN 交互式教学工具,让用户像使用 TensorFlow Playground 训练 MLP 一样,实时设计、训练和分析 KAN。作者将其定位为填补两类人群之间的空白:想理解核心概念的 KAN 新手,和想以可及环境交流、探究 KAN 行为的 KAN 专家。为实现最大教学清晰度,KANLab 刻意舍弃残差连接和可学习缩放/平移参数,保证界面显示的 B 样条曲线与其可训练控制点直接对应;用户可以检查并修改激活函数与初始化方案,在训练进行中手动拖动控制点并观察梯度下降实时纠正人为破坏,还能探究激活方差、交互式剪枝与重训练等现象。工具开源并部署在 https://kanlab.app/。
与已有工作不同的是,MLP 生态早已拥有一系列成熟的浏览器端教学工具:TensorFlow Playground、面向对抗样本的 Adversarial Playground、训练 GAN 的 GANLab、量子机器学习 Playground 等,而 KAN 此前没有真正客户端化、且可视化与参数一一对应的交互环境。本文的独特切入是直接 fork 广受欢迎的 TensorFlow Playground,复用其经过验证的教学设计决策(如数据集在 $[-6,6]$ 区间生成、顶部超参数面板、实验配置序列化进 URL),再针对 KAN 的边参数化特性重做可视化:把每条样条的绿色曲线、橙色控制点、输入/输出激活直方图都做成可实时操纵的对象。相比 API 式的 KAN-Playground,KANLab 完全在浏览器内以批量随机梯度下降训练,交互粒度细化到'训练中拖动单个控制点'这一级别。
核心方法
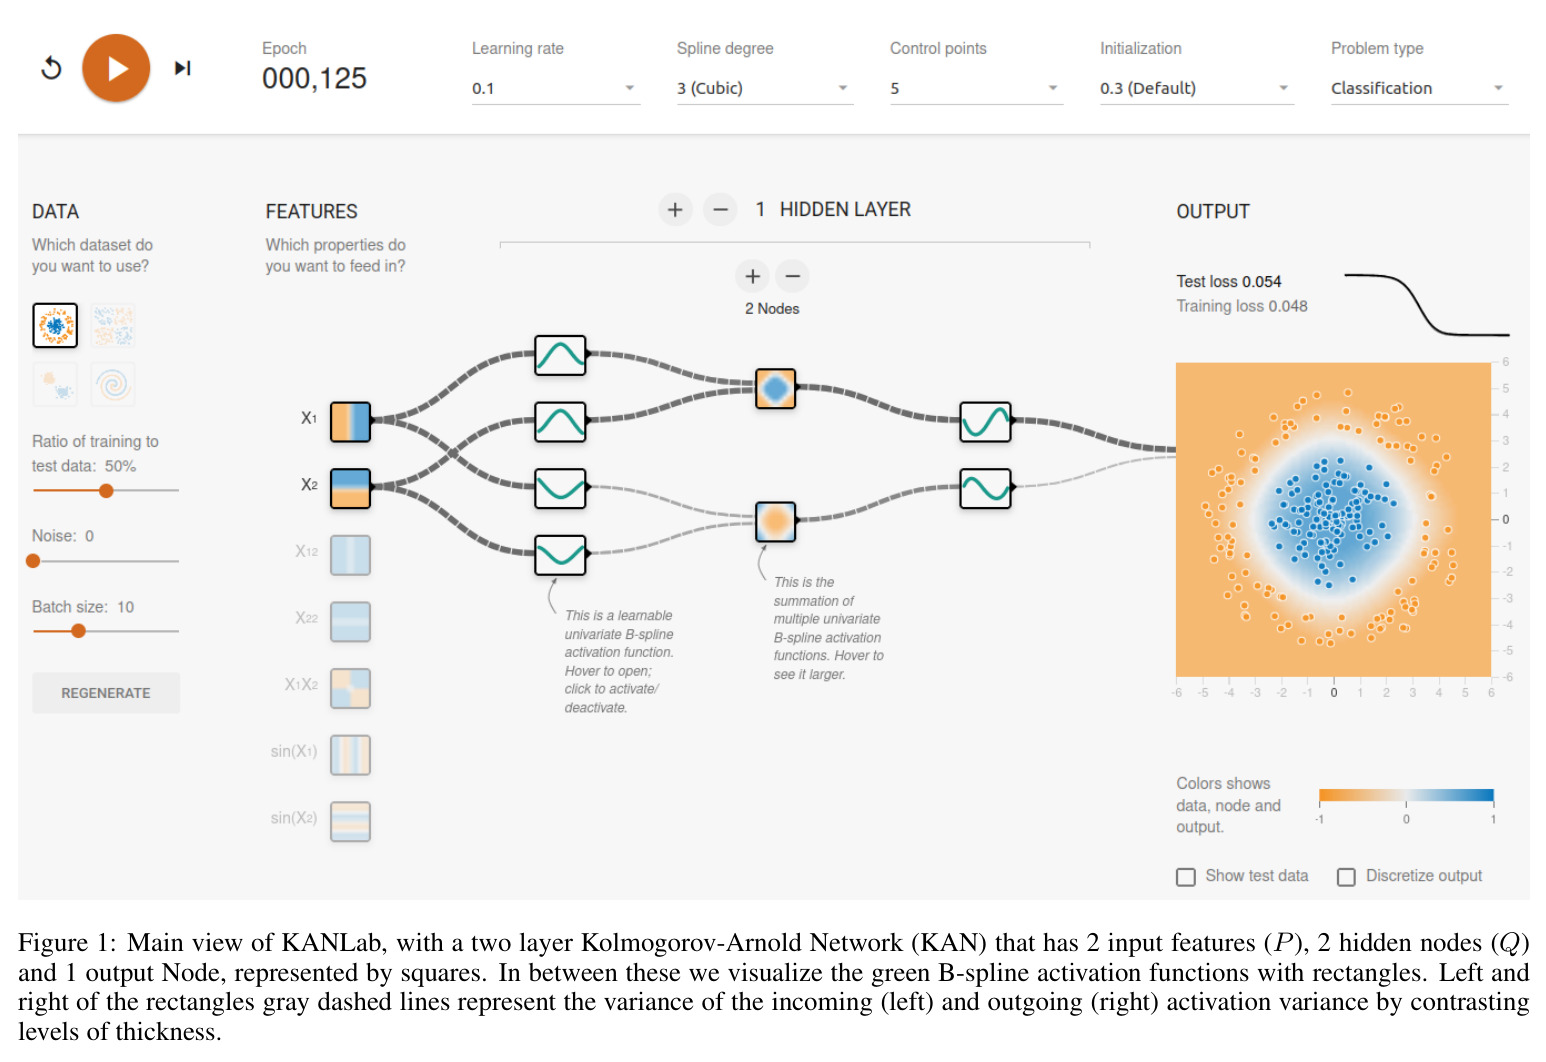
KANLab 是一个浏览器端可视化工具,fork 自 TensorFlow Playground。主视图动态展示网络结构:输入/隐藏/输出节点用方块表示(演示配置为 2 个输入特征 $P=2$、2 个隐藏节点 $Q=2$、1 个输出节点),边上的 B 样条激活函数用矩形表示,绿色曲线实时动画演示信息流。网络训练采用批量随机梯度下降,以均方误差(MSE)为损失。数据集与 TensorFlow Playground 一致地在 $[-6,6]$ 区间内生成,控制点均匀分布在同一区间上,因此所有生成的激活都能落在样条表示范围内;由于控制点无界,样条的输出激活可能超出 $[-6,6]$,KANLab 通过把下一条样条的输入激活裁剪(clip)到该区间来处理。样条定义为 $\varphi(x)=\sum_{n=0}^{N-1} c_n B_n^k(x)$,基函数 $B_n^k$ 由 de Boor 算法计算,控制点数量 $N$ 可通过顶部下拉菜单设置。
核心创新是'教学优先'的设计决策带来可视化与参数的直接对应。现代 KAN 实现在 B 样条之上叠加残差连接和可学习的缩放/平移参数,这对性能重要,但会让画出来的激活曲线不再等于样条本身;KANLab 刻意去掉这些组件,使界面上的每条绿色曲线严格等于 $\sum_{n=0}^{N-1} c_n B_n^k(x)$,学生拖动某个控制点就能立即看到曲线形状、中间节点输出和最终决策边界的变化。第二个亮点是'训练中手动破坏':训练进行时用户可以拖动橙色控制点制造扰动,实时观察梯度下降如何纠正它,从而直观感受优化的动态过程。第三个亮点是激活方差可视化:矩形左右两侧的灰色虚线以粗细分别对比输入(左)和输出(右)激活方差,粗线代表更强的信息流。此外每条样条和每个求和节点都可单独点击停用(触屏长按),实现交互式剪枝。
方法步骤详情
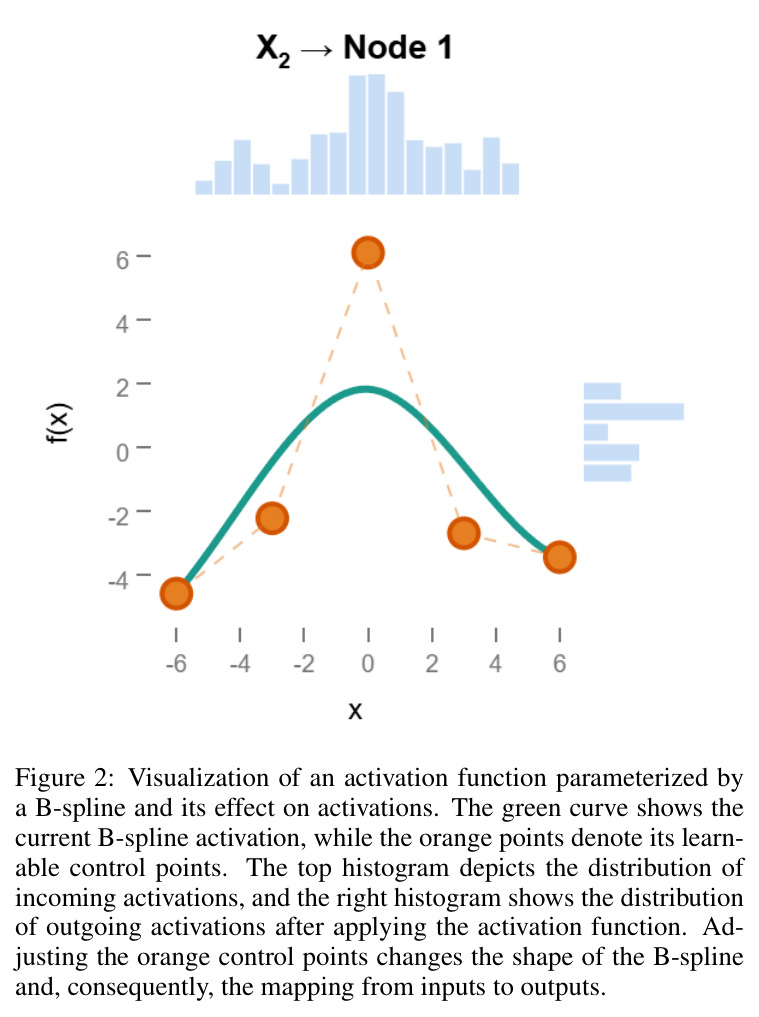
使用流程可分为六步。(1)配置数据与特征:在界面上选择数据集和输入特征,数据在 $[-6,6]$ 区间内生成。(2)设计架构:点击增删隐藏节点构成多层 KAN,下拉菜单选择每条样条的控制点数 $N$(Figure 2 的示例中 $N=5$)。(3)选择初始化:可选均匀分布方差预设 $[0.1, 0.3, 0.5, 1.0, 5.0]$(小方差使初始激活接近零);或 Rigas 等人 2026 年提出的 LeCun/Glorot 风格方差保持方案;或恒等初始化——把控制点初始化为恒等函数或其逆,使网络初始为线性直通、保留输入结构,便于观察训练重塑激活的过程。(4)点击训练:批量 SGD 最小化 MSE 损失,主视图动画展示 B 样条实时演化。(5)检查单条样条:悬停矩形弹出小窗(Figure 2),上方直方图显示输入激活分布、右侧显示输出激活分布,可拖动 $N$ 个橙色控制点改变样条形状及输入输出映射。(6)交互式剪枝:单击样条或求和节点(触屏长按)停用它,观察损失变化与网络重路由。整个实验配置序列化在 URL 的 GET 参数中,教师可保存并分享。
技术新颖性
本文不提出新算法,其新颖性在于工程与教学设计层面。首先,它是首个完全客户端化、且可视化与样条参数严格一一对应的 KAN 交互环境,弥补了 KAN-Playground(Gradio + 服务器端训练、结构图按 epoch 更新为图片)在响应性与透明度上的不足。其次,是一种罕见的'减法创新':通过移除残差连接与可学习缩放/平移参数,把现代 KAN 实现还原为 Kolmogorov-Arnold 表示定理的最小形式 $f(x_1,\dots,x_n)=\sum_{q=1}^{Q}\Phi_q\left(\sum_{p=1}^{P}\varphi_{q,p}(x_p)\right)$($Q=2n+1$,$P=n$),让初学者先掌握本质再面对工程增强。最后,把'运行中拖动控制点+观察梯度纠正'、激活方差粗细线、单击剪枝等直接操纵手段引入 KAN 教学,在既有 KAN 工具中均无先例,也延续了 GANLab、量子 ML Playground 等以交互可视化讲解深度模型的传统。
实验结果
作为工具论文,本文的'结果'是一系列可复现的定性演示而非定量基准。其一,交互式剪枝实验:在 2 输入、2 隐藏、1 输出的两层网络(Figure 1)中,剪掉上方路径的样条后损失立即上升、输出端分类误差增大,说明被剪枝的边无法再向下一层传递信息;继续训练后,下方路径的激活方差增大、分类误差回落,直观展示了网络把信息重路由到剩余连接的能力。其二,初始化实验:小方差(如预设中最低的 0.1)初始化使初始激活接近零;恒等初始化保留输入结构,训练如何重塑激活函数一目了然;可选方差预设覆盖 $[0.1, 0.3, 0.5, 1.0, 5.0]$。其三,样条检查(Figure 2,$N=5$ 个橙色控制点):拖动控制点会同步改变绿色样条曲线、输出激活直方图以及最终输出的决策边界,让'控制点决定激活函数'这一抽象关系变得可见。所有演示中控制点均匀分布于 $[-6,6]$、与数据区间一致,越界激活被裁剪,保证可视化始终有界可读。
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 交互式剪枝演示(2D 二分类,Figure 1 网络) | 训练损失与分类误差(定性观察) | 剪除上方路径样条后损失上升、分类误差增大;继续训练后下方路径激活方差增大、误差回落 | 未剪枝的完整网络 | 定性展示 KAN 的信息重路由与路径冗余性,非量化指标提升 |
局限与改进
作者坦承 KANLab 的设计以教学清晰度为优先、以性能为代价:缺少残差连接和可学习缩放/平移参数,学生在掌握概念后迁移到 pykan 等真实实现时仍需补课;作者也把'加入正则化方法'列为未来工作,意味着当前无法演示权重衰减或稀疏性驱动的自动剪枝等 KAN 文献中的重要话题。我自己的观察包括:损失函数仅有 MSE,没有交叉熵等分类损失可选;基函数只有 B 样条,未覆盖 Chebyshev/Jacobi 多项式、Fourier 级数、高斯核、小波等文献中已被系统比较过的替代基;数据限定在 $[-6,6]$ 且激活越界即裁剪,是简化处理;此外论文未报告任何用户研究来量化教学效果,'更易学'仍是设计假设而非实证结论;纯浏览器端 JavaScript 训练也限制了数据规模与网络深度。
独立分析的弱点
弱点一:教学版与现实版存在鸿沟。砍掉残差连接和缩放/平移虽利于可视化对应,但学生第一次接触 pykan 等真实 KAN 库时,会困惑'为什么我的曲线和书上实现对不上',改进方向是把增强组件做成可开关的高级选项。弱点二:缺少正则化(作者已承认),导致无法演示原 KAN 论文中稀疏化加自动剪枝的经典流程,可加入 L1 正则和剪枝阈值滑块。弱点三:基函数单一,只有 B 样条,而 Chebyshev、Fourier、小波等基在文献中已被对比研究,缺一个'换基看差异'的教学场景。弱点四:仅 2D 合成数据加 MSE 损失,无法体现 KAN 在符号回归、科学公式发现等招牌任务上的优势,可增加公式拟合演示。弱点五:论文完全没有用户研究,教学收益缺乏量化证据,建议设计前后测对照实验,用数据证明交互式工具确实提升学习效果。
未来方向
作者明确提出的未来工作是添加正则化方法。在此基础上的自然延伸包括:支持多基函数切换(Chebyshev/Jacobi 多项式、Fourier 级数、高斯核、小波等,正如文献中系统比较的那样),让学生对比不同基的表达能力与训练稳定性;加入可选残差连接与缩放/平移参数的'现实模式',架起从教学版到 pykan 等生产实现的桥梁;引入稀疏性驱动的自动剪枝与符号公式提取演示,呼应 KAN 在符号表示任务上的核心卖点;开展对照用户研究量化学习增益;把 URL 序列化机制扩展为课程素材库,方便教师社区沉淀和共享经过验证的教学配置;也可考虑增加回归/多分类数据集与对应损失函数,拓宽适用场景。
复现评估
复现门槛极低。KANLab 完全开源,线上版本部署在 https://kanlab.app/,fork 自开源的 TensorFlow Playground,全部训练在浏览器内以 JavaScript 完成,不需要 GPU、服务器或任何账号。文中所有演示数据都在 $[-6,6]$ 区间内程序化生成,无需下载外部数据集;实验配置(数据集、输入特征、架构、初始化方案、控制点数 $N$ 等)完整序列化在 URL 的 GET 参数里,把链接发给他人即可复现一模一样的设置。唯一难以'复现'的是定量结果——论文本身没有数值基准实验,只有可交互的定性演示;对想验证论文声明的读者,打开网页剪掉一条边即可亲自观察损失上升与信息重路由现象,几分钟内可完成全部论文演示。
论文图表