函数空间时序自蒸馏策略优化(FSPO) Function-Space Temporal Self-Distillation for Policy Optimization
用稀疏历史分布缓存替代持久教师模型,实现单策略、时序稳定的自蒸馏强化学习
前置知识
RLVR(可验证奖励强化学习)
用可自动验证的结果(如最终答案是否正确、工具调用是否成功)作为奖励信号,对大语言模型做强化学习后训练的范式。奖励通常由规则或验证器给出,无需人工标注偏好,是 DeepSeek-R1 以来提升推理能力的主流路线。但它一般把一整条回答压缩成一个轨迹级标量。
标量奖励的信用分配太粗糙正是本文要解决的核心问题,论文的全部监督信号设计都是围绕'比标量更密'展开的。
GRPO(组相对策略优化)
对每个问题采样一组 $G$ 个回答,用组内奖励的相对均值和方差归一化出优势函数,从而省去价值网络。由 DeepSeekMath 提出,是目前 RLVR 最常用的策略梯度算法之一。它的监督粒度仍停留在整条回答层面。
GRPO 是本文的主基线之一,理解其轨迹级标量监督的粗粒度,才能明白 FSPO 的 token 级蒸馏相对它改进了什么。
自蒸馏与特权视图(self-distillation & privileged view)
让同一个策略以两种方式评估同一段回答前缀:不带任何辅助信息的'学生'视图 $p=\pi(\cdot\mid x,y_{<t})$,以及拼接了参考答案、成功同伴回答等额外证据的'特权教师'视图 $q=\pi(\cdot\mid x\oplus d, y_{<t})$。两个下一词分布的差异提供了每个位置上的密集监督信号,优于单一结果奖励。
FSPO 的所有损失(蒸馏、分歧修正、时序整合)都建立在'学生 vs 特权教师'这对双视图之上,不熟悉这个框架就读不懂损失函数的构造。
移动目标问题与 EMA 教师
自蒸馏中教师和学生共享参数,参数每更新一步教师分布就随之改变:stop-gradient 只能在单步更新内阻断梯度回流,无法提供跨迭代的稳定目标。常见补救是指数移动平均(EMA)教师或信任域正则,但 EMA 需要常驻一份完整参数副本,显存开销随模型规模线性增长。
这是前作 SDPO 的核心缺陷,也是本文的直接出发点——FSPO 用函数空间缓存替代 EMA,带来稳定性与内存双重收益。
广义 Jensen–Shannon 散度(JSD)
两个分布之间的对称散度,通过插入混合分布构造,带插值参数 $\alpha\in[0,1]$:$\alpha=0$ 退化为正向 KL,$\alpha=1$ 为反向 KL,$\alpha=0.5$ 为标准对称 JSD。相比 KL 它有界且对称,对两份分布的'相互靠近'都施加梯度。
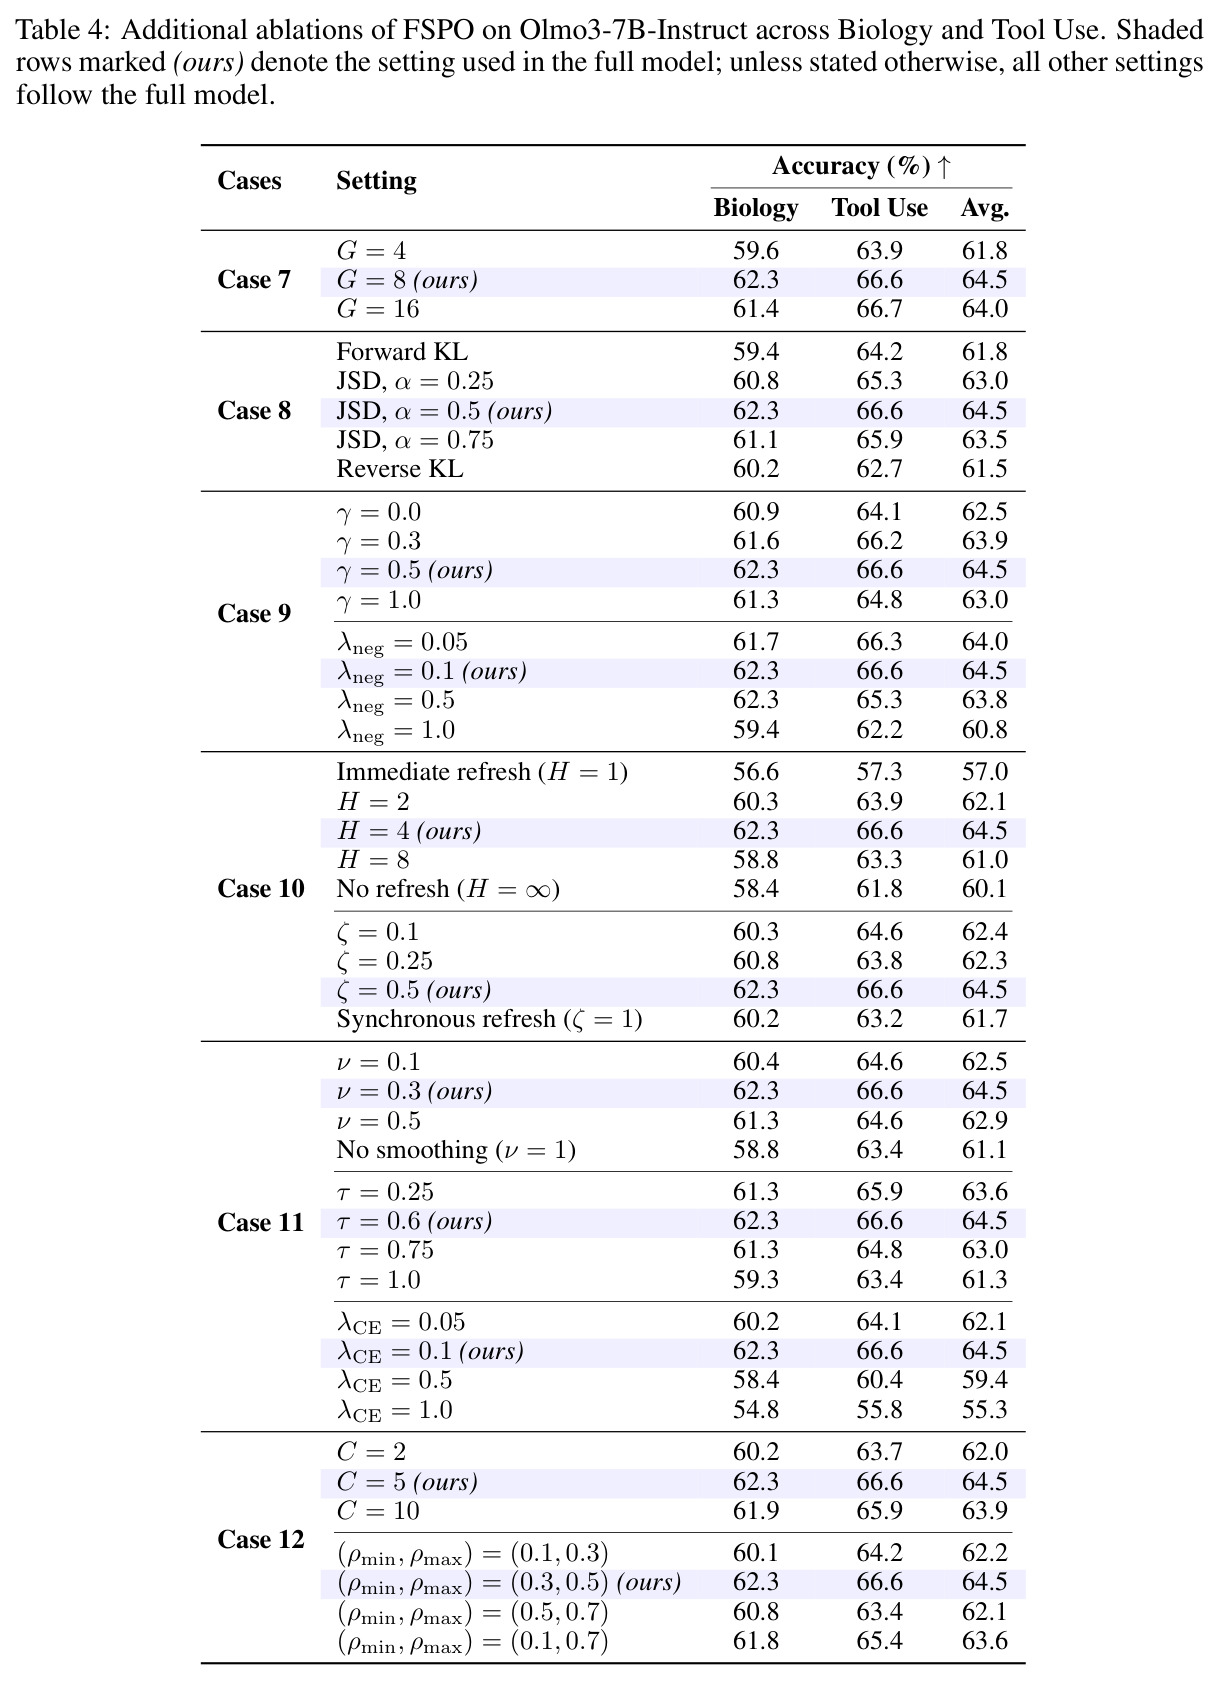
FSPO 的蒸馏损失和时序整合损失都用广义 JSD 度量分布差异;消融显示对称 JSD($\alpha=0.5$)优于正向 KL(61.8%)和反向 KL(61.5%)。
函数空间正则化
约束模型在某些输入点上的输出(预测分布)而非参数本身的正则化思路,典型如持续学习中的函数正则(memorable past)与存储 logit 回放(DER++)。它不依赖具体参数化方式,存储的是'模型在某输入上说了什么'这组数据,而非'模型是谁'这组权重。
这是论文标题里 Function-Space 的含义:把历史教师行为存成稀疏下一词分布(函数值)而非模型副本,是与参数快照/EMA 的本质区别。
研究动机
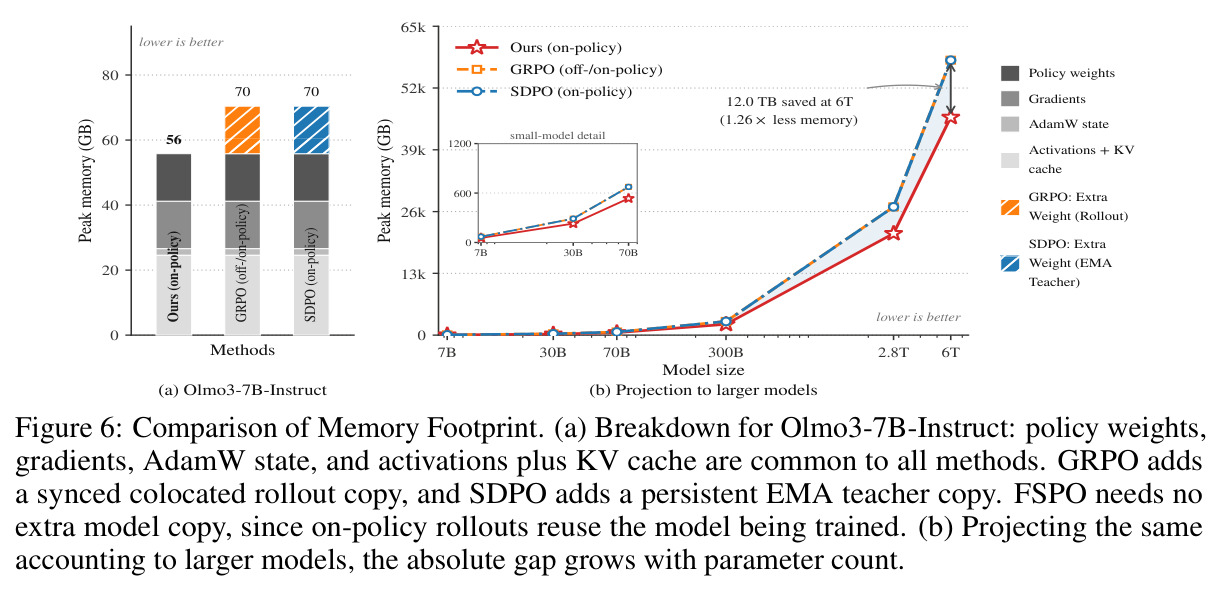
RLVR 把一整条回答压缩成一个标量结果奖励,当一个问题的所有采样回答同对同错、或奖励稀疏时,轨迹级信用分配几乎失效——模型只知道'这题没做对',不知道具体哪个 token 决策出了问题。SDPO 这类自蒸馏方法用'无辅助学生 vs 附加证据教师'的分布差提供 token 级密集监督,但其教师和学生实例化自同一策略:参数每更新一步,教师分布就跟着变,stop-gradient 只隔离单步内的梯度,跨迭代仍是移动目标,削弱蒸馏信号的稳定性。为稳住训练,SDPO 依赖 EMA 或信任域正则,而 EMA 变体要额外维护一份常驻参数副本,内存开销随模型规模线性增长(Olmo3-7B 上峰值约 70 GB)。此外 SDPO 对学生-教师分歧只做分布级匹配,不区分普通不匹配与'学生强烈高估、被特权视图否决'的严重局部错误;对所有题目施加等强监督,策略反复失败的题目得不到额外支持;也不保存训练早期发现的有用特权预测,验证过的好行为既不被系统性回放,也不按质量与多样性筛选保留。
本文的目标是本文要回答的问题是:能否在不维护任何独立教师模型的前提下,实现时序稳定且可靠性感知的自蒸馏,同时保留训练早期学到的有用知识?具体拆成四个可验证的子目标。(1)时序稳定:把早期优化步中有价值的特权预测固化为不再变化的时序目标,提供跨迭代分离,且不引入常驻 EMA 副本。(2)定向纠错:显式识别并压制'无辅助策略强烈偏好、但特权证据否决'的局部过估值,超越普通分布匹配。(3)可靠性自适应:按策略在每个问题上的滚动成功率调节参考答案监督强度——屡屡失败时加强接地,能稳定解出后逐渐撤掉。(4)记忆保留:用质量与覆盖度双重准则把已验证的多样解法存入时序记忆,在当前采样组缺少成功回答时充当更强的特权示范并供整合回放。最终在推理与工具使用基准上,以 5 小时墙钟预算取得最高平均准确率,同时把峰值显存从约 70 GB 降到 56 GB。
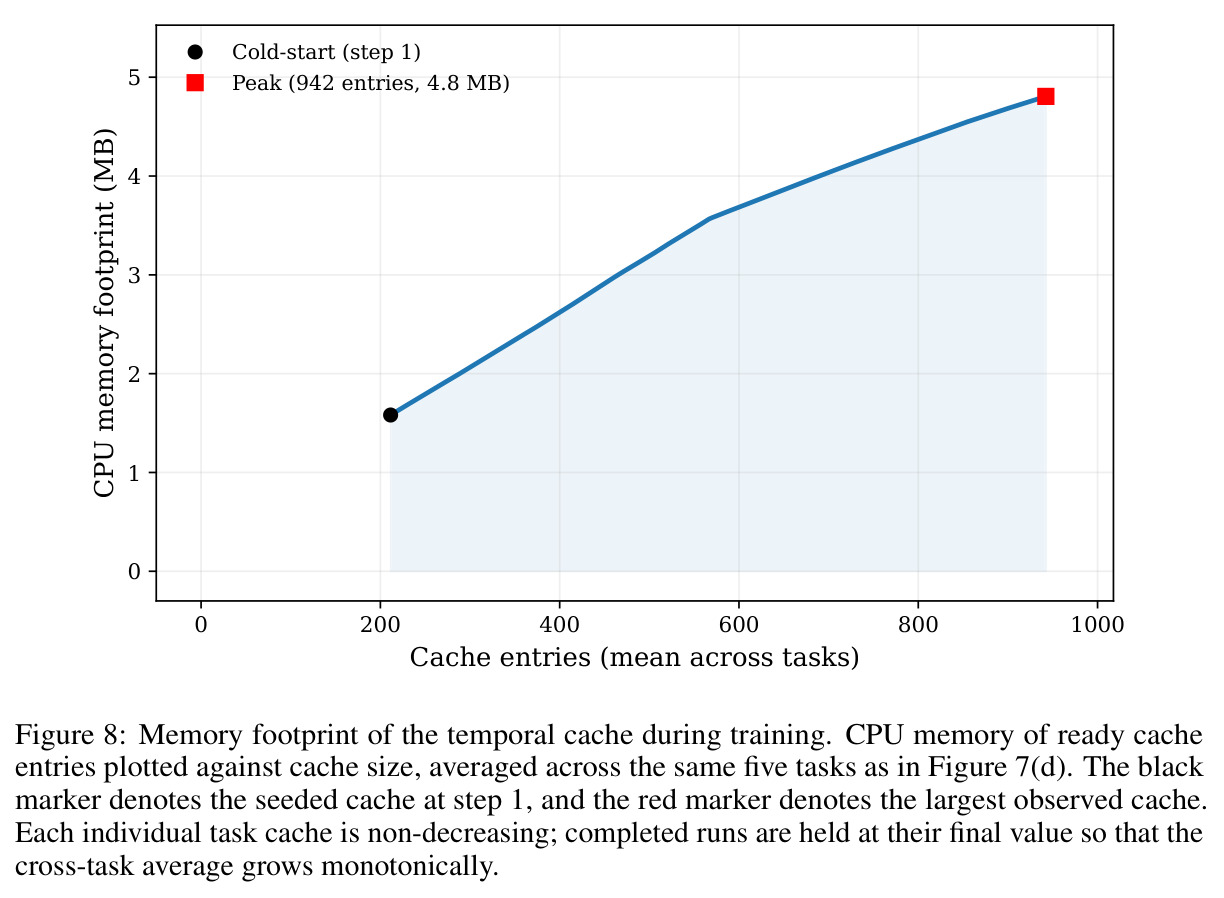
与已有工作不同的是,本文的独特切入是把'历史教师'的存储介质从参数空间搬到函数空间。已有方案(EMA 教师、参数快照、信任域)都在回答'过去的学生参数是什么',代价是模型级副本和仍在缓慢漂移的目标;FSPO 反过来只存'过去的教师在关键前缀上输出了什么'——一组稀疏的下一词分布(top-K 概率加池化尾桶),它们是不可变的数据而非参数,天然提供真正的时序分离,峰值开销仅约 5 MB 主机内存。这一思想源自持续学习中的函数正则化与存储 logit 回放,作者首次把它移植到 LLM 单策略自蒸馏 RL 中,并与三个机制耦合:三级特权示范层次(验证过的同伴回答→历史保留轨迹→参考答案)、hinge 式特权分歧修正、随策略可靠性平滑衰减的参考接地,再配合'先适应后整合'的循环调度构成闭环。相比 GRPO 只用标量优势、SDPO 只有步内分离,FSPO 是在单策略框架内同时处理时序稳定、定向纠错、可靠性感知与记忆保留四个问题的统一方案。
核心方法
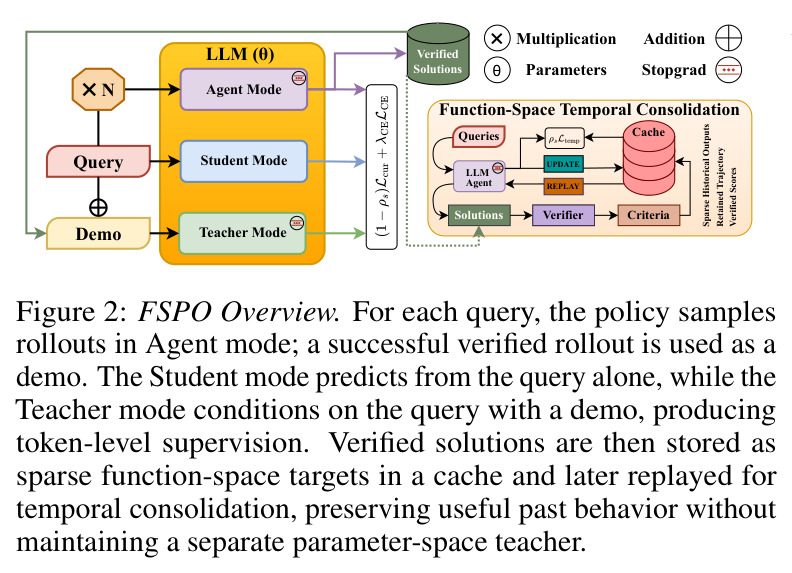
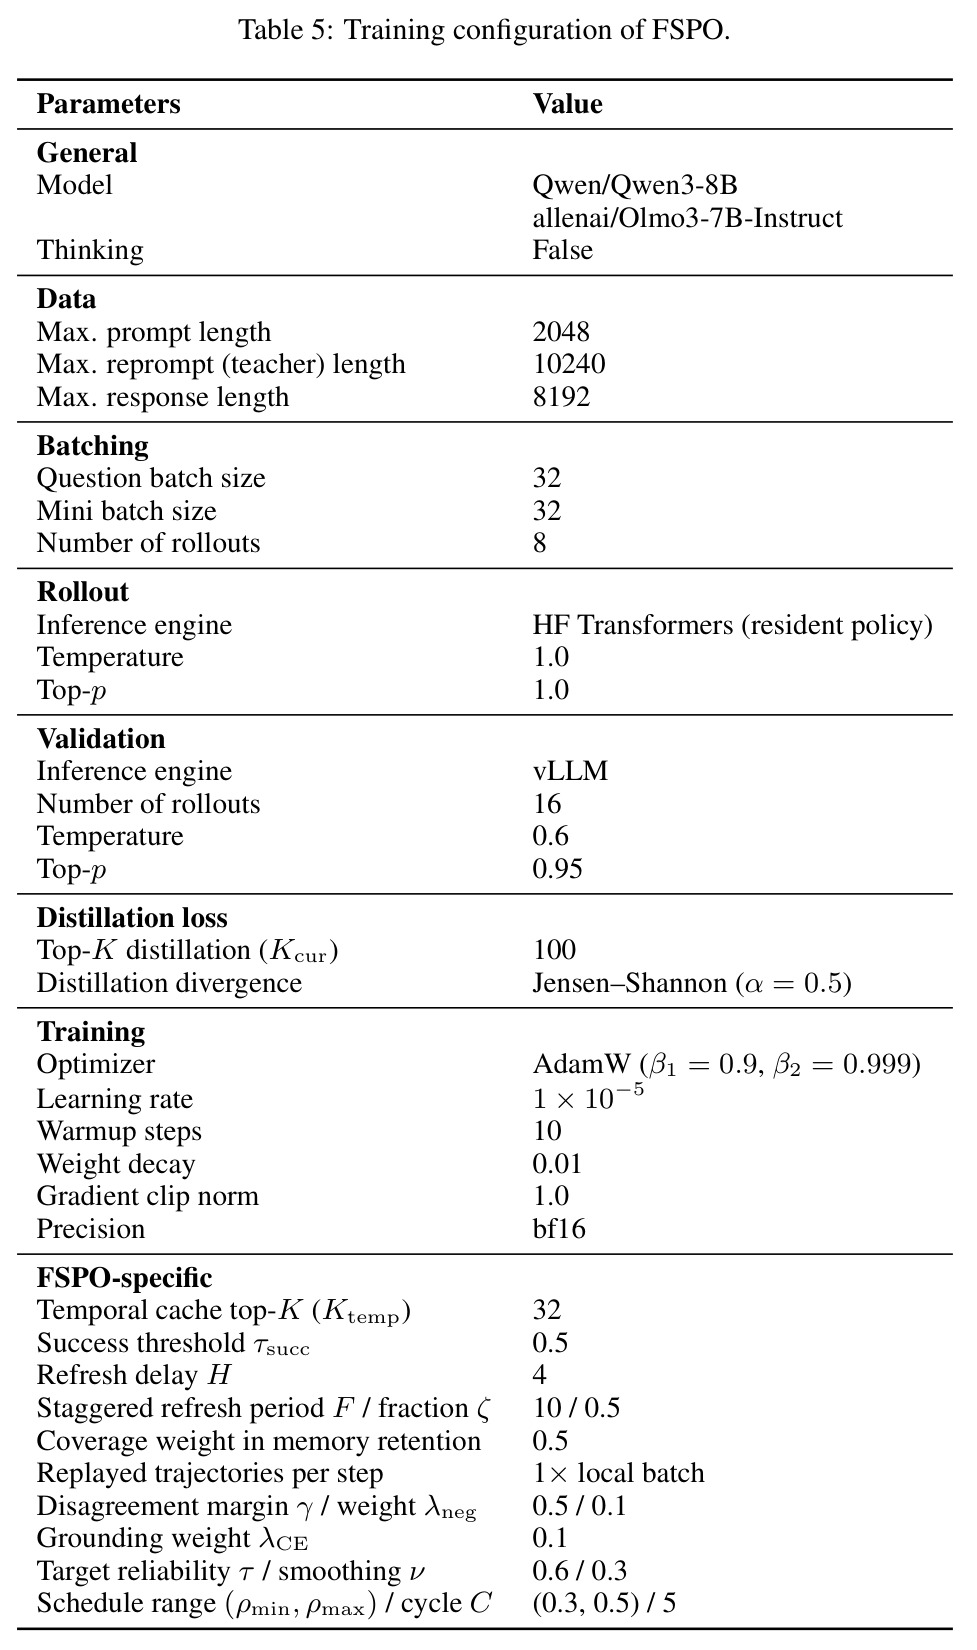
直觉上,自蒸馏不稳定的根源是我们只保存了'教师是谁'(参数),于是教师随学生一起漂移;如果把'教师在关键位置说过什么'(输出分布)当作数据存下来,这个目标就永远不变。FSPO 沿此构建单策略框架:每步对每题采 $G=8$ 个回答并由验证器打分,并行推进三条监督。其一是当前特权适应:同一策略以学生视图 $p_{p,j,t}=\pi_\theta(\cdot\mid x_p, y_{p,j,\gamma$ 的被否决候选加 hinge 惩罚 $\mathcal{L}_{neg}$。其二是可靠性自适应参考接地:用 EMA 平滑的组内通过率 $\hat{r}_p$ 生成权重 $w_p=\mathrm{clip}((\tau-\hat{r}_p)/\tau,0,1)$,对参考答案做加权交叉熵 $\mathcal{L}_{CE}$。其三是函数空间时序整合:验证过的回答连同稀疏教师分布(top-$K_{temp}=32$ 加尾桶)存入缓存,回放时当前策略沿保留轨迹前向、与固定目标匹配得 $\mathcal{L}_{temp}$。总损失为 $\mathcal{L}(\theta_s)=(1-\rho_s)\mathcal{L}_{cur}+\rho_s\mathcal{L}_{temp}+\lambda_{CE}\mathcal{L}_{CE}$,其中 $\rho_s$ 在 $[0.3,0.5]$ 内以周期 $C=5$ 循环,每轮先偏向适应、后偏向整合。
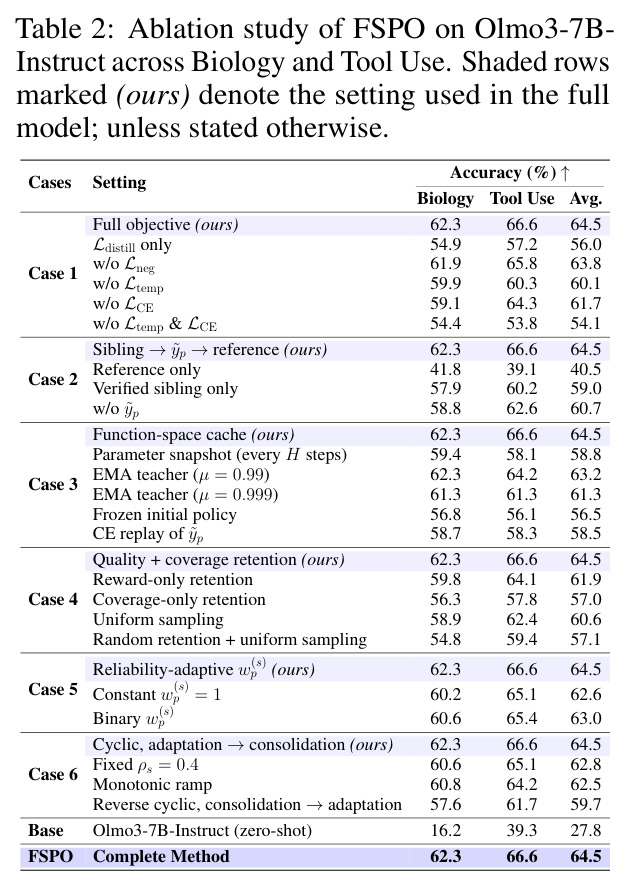
核心创新是把时序知识物化为稀疏函数值缓存,而非任何模型副本。形式化地,对前缀 $c=(x,y_{\gamma$)的候选从分布匹配中拎出来做方向性 hinge 惩罚;参考监督按可靠性权重自适应启停,而非固定 SFT 损失;记忆保留用'验证分数+签名覆盖度'双准则,防止缓存被同质解法填满。消融证明缺一不可:只留蒸馏损失掉到 56.0%,反向循环调度掉到 59.7%(Biology+Tool 平均)。
方法步骤详情
完整流程(Algorithm 1/2)分六阶段。(1)探索:对批次 $B_s$ 中每题 $p$ 采 $G=8$ 个回答 $y_{p,j}\sim\pi_\theta(\cdot\mid x_p)$,验证器给 $r_{p,j}\in[0,1]$。(2)选特权示范 $d_{p,j}$:组内存在 $r_{p,k}\ge\tau_{succ}=0.5$ 的同伴回答则用之;否则用记忆中分数达标的保留轨迹 $\tilde{y}_p$;否则退回参考答案 $g_p$。(3)当前特权适应:学生 $p_{p,j,t}$ 与教师 $q_{p,j,t}$(stop-gradient、上下文拼接 $d_{p,j}$)在相同前缀上评估;压缩算子 $\Phi_S$ 把分布压到 top-$K_{cur}=100$ 加尾桶;$\mathcal{L}_{distill}$ 为有效位置上广义 JSD($\alpha=0.5$)的均值;过估值集合 $\mathcal{N}_{p,j,t}=\{v:\log p_{p,j,t}(v)-\log q_{p,j,t}(v)>0.5\}$,惩罚 $\ell_{neg}=\frac{1}{|\mathcal{N}|}\sum_v[\log p(v)-\mathrm{stopgrad}(\log q(v))-\gamma]_+$;$\mathcal{L}_{cur}=\mathcal{L}_{distill}+\lambda_{neg}\mathcal{L}_{neg}$($\lambda_{neg}=0.1$)。(4)可靠性接地:$\hat{r}_p^{(s)}=(1-\nu)\hat{r}_p^{(s-1)}+\nu\,\bar{r}_p^{(s)}$($\nu=0.3$),$w_p^{(s)}=\mathrm{clip}((\tau-\hat{r}_p^{(s)})/\tau,0,1)$($\tau=0.6$),$\mathcal{L}_{CE}$ 为 $w_p$ 加权的参考答案 token 级交叉熵。(5)时序整合:按结构签名分组均匀采样回放集 $\mathcal{R}_s$,当前策略沿 $\tilde{y}_p$ 前向,与固定目标 $\tilde{q}_{p,t}$ 做 JSD 得 $\mathcal{L}_{temp}$;调度为 $\rho_s=\rho_{min}+(\rho_{max}-\rho_{min})\frac{(s-1)\bmod C}{\max(1,C-1)}$。(6)更新与记忆维护:AdamW(lr $10^{-5}$、梯度裁剪 1.0、bf16)更新参数;验证通过的回答按保留分(验证质量 $+0.5\times$ 签名覆盖度)竞争替换缓存条目;每 $F=10$ 步对 50%($\zeta=0.5$)年龄超过 $H=4$ 步的条目延迟交错刷新。缓存初始用参考答案种子化(标记 $\tilde{r}_p=0$,只作回退目标)。
技术新颖性
技术新颖性有三层。第一,跨领域移植:函数空间正则化(memorable past、存储 logit 回放)本是持续学习的防遗忘技术,作者首次把它改造成 LLM 自蒸馏 RL 的时序目标存储机制,并用消融证明它优于所有参数空间替代——参数快照 58.8%、EMA($\mu=0.99$) 63.2%、EMA($\mu=0.999$) 61.3%、冻结初始策略 56.5%、轨迹级 CE 回放 58.5%,而函数空间缓存 64.5%(Olmo3 的 Biology+Tool 平均)。第二,目标结构设计:延迟交错刷新($H=4$ 步后才有资格、每 $F=10$ 步刷新 $\zeta=0.5$ 比例条目)在'新鲜度'与'时序分离'之间取得平衡——立即刷新($H=1$)掉到 57.0%,永不刷新 60.1%,同步刷新 61.7%,这揭示了一个此前未被刻画的 trade-off。第三,监督调度的组件耦合:消融显示去掉时序和参考锚后仅保留分歧修正(54.1%)比只留蒸馏(56.0%)更差,说明激进的 hinge 修正只有在教师被充分稳定后才有益——这一组件间依赖关系是作者通过消融首次系统展示的,也是对'正则项越多越好'朴素直觉的反驳。
实验结果
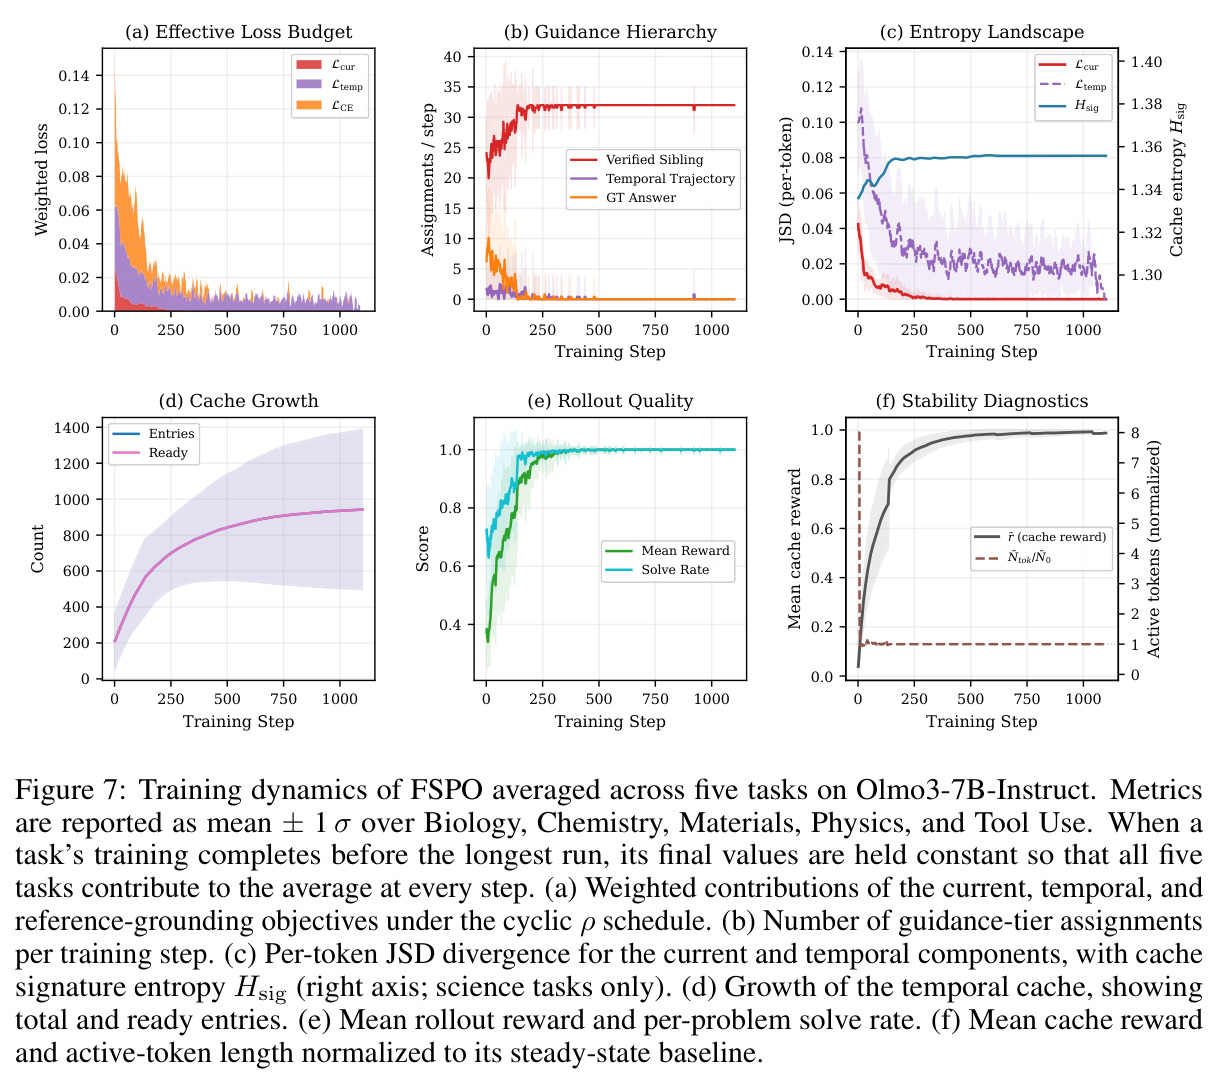
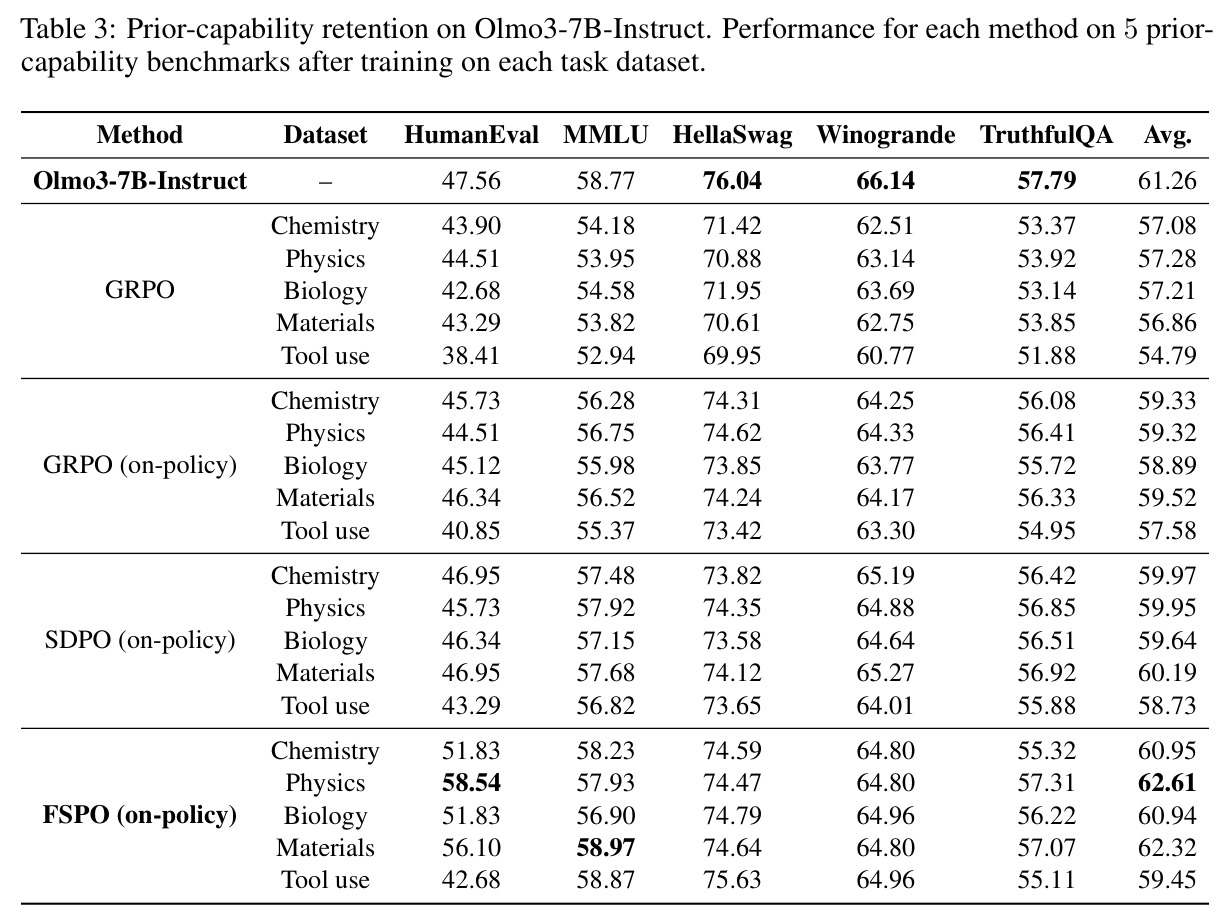
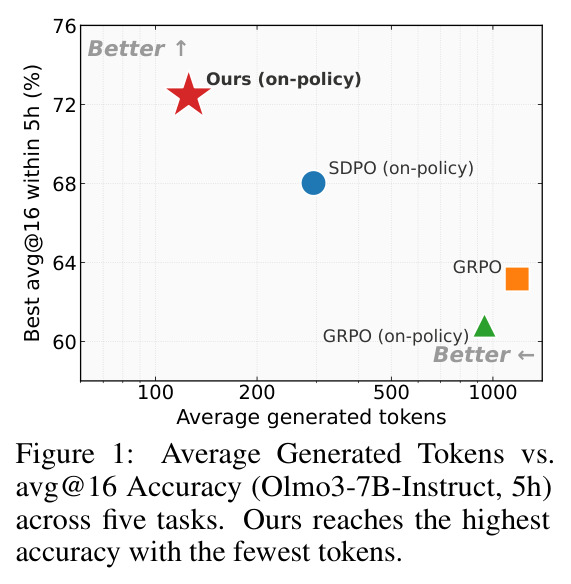
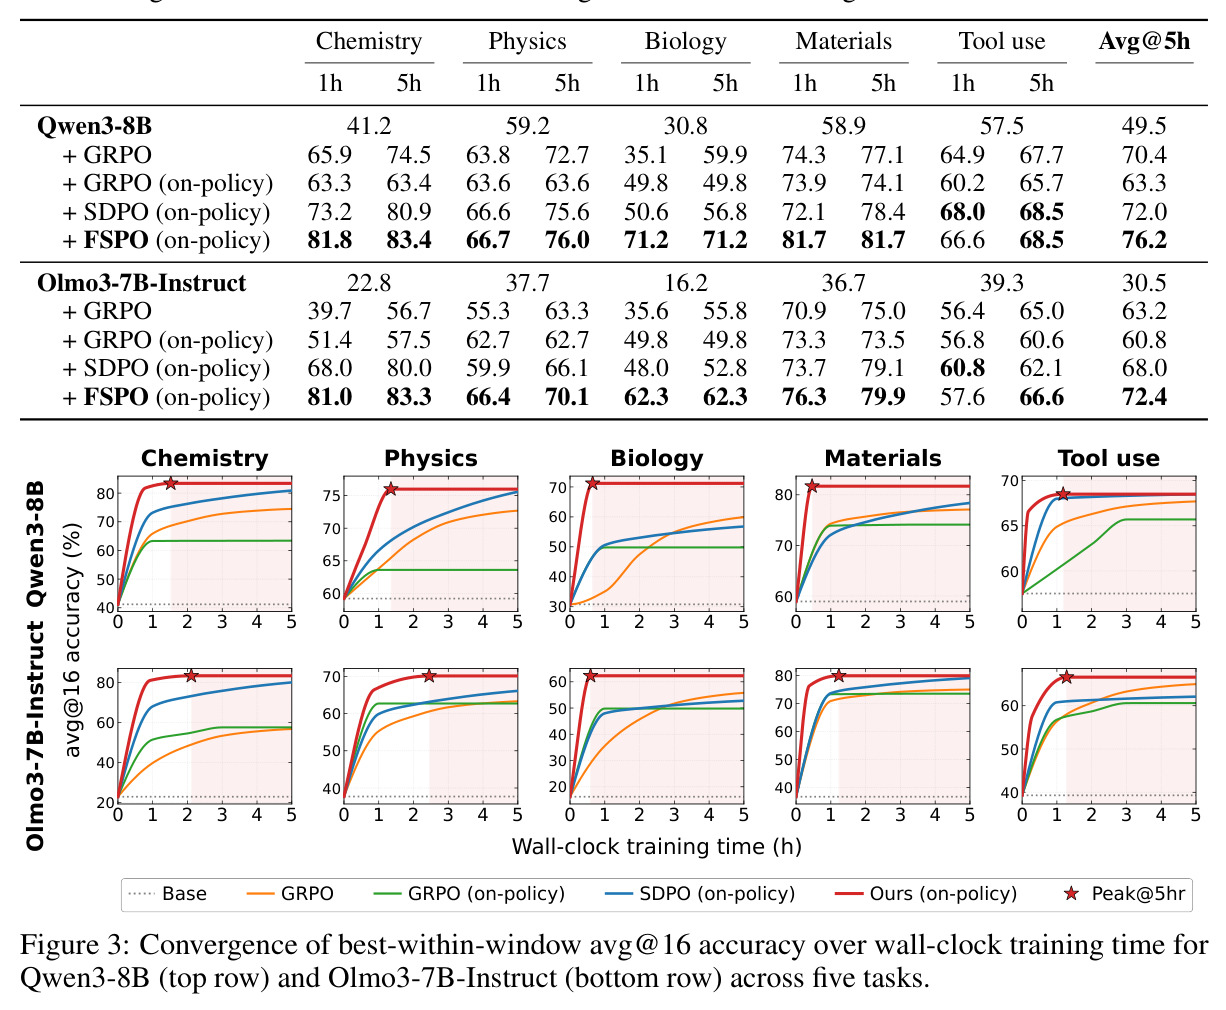
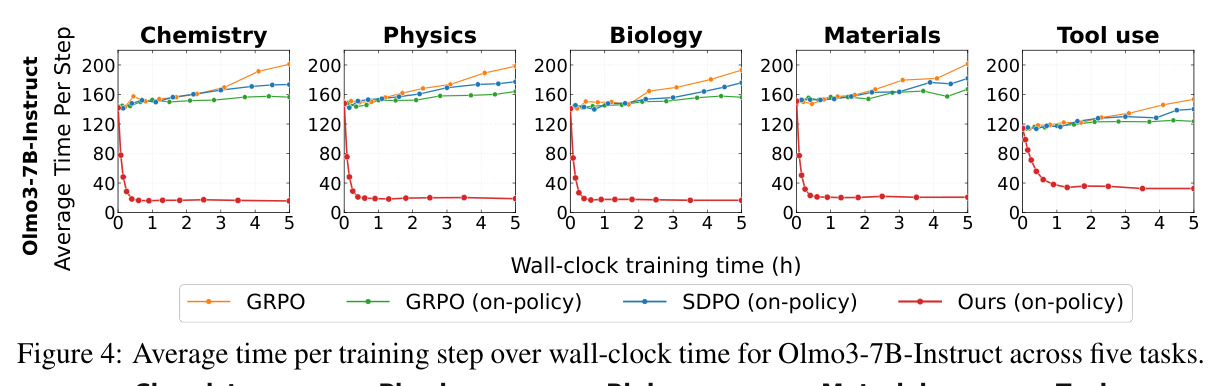
Table 1 给出主结果:在 SciKnowEval L3 四个科学子集(Chemistry/Physics/Biology/Materials)与 ToolAlpaca 上,4×NVIDIA GH200、1h/5h 墙钟预算、avg@16 评估。FSPO 的 5 小时平均准确率在两个骨干上都最高:Qwen3-8B 达 76.2%(SDPO 72.0%、GRPO 70.4%、基座 49.5%),Olmo3-7B-Instruct 达 72.4%(SDPO 68.0%、GRPO 63.2%、基座 30.5%),相对最强基线约 +4 个百分点,且 5h 时所有科学推理任务的最佳成绩都属 FSPO(如 Olmo Chemistry 83.3% vs SDPO 80.0%、Biology 62.3% vs GRPO 55.8%)。Tool use 是最弱项:Qwen 上与 SDPO 打平(68.5%),Olmo 上 66.6% 胜出,但 1h 预算下 SDPO 在 Tool use 上更强(Qwen 68.0% vs 66.6%、Olmo 60.8% vs 57.6%)。收敛速度上(Figure 3),FSPO 早期就获得大部分最终收益、更早逼近峰值;Figure 4 显示其每步耗时随训练下降——因为回答越来越短,而 GRPO/SDPO 的轨迹越生成越长、每步时间上升(Figure 1 中 FSPO 独占'最高精度+最少 token'的帕累托角)。抗遗忘上(Figure 5/Table 3),以基座在五个先验基准的均值 61.26% 为参照:FSPO 训练 Chemistry 后保留 60.95%、Physics 后 62.61%(HumanEval 反而从 47.56% 升至 58.54%)、Biology 后 60.94%、Materials 后 62.32%,最难的 Tool-use 训练后也有 59.45%,全面高于 GRPO(54.79–57.28)、on-policy GRPO(57.58–59.52)和 SDPO(58.73–60.19)。显存上(Figure 6),FSPO 峰值 56 GB vs GRPO/SDPO 的 70 GB(分别因同步 rollout 副本与持久 EMA 教师),外推到 6T 参数约省 12 TB(1.26×);时序缓存峰值仅约 5 MB(942 条、4.8 MB,Figure 8)。消融(Table 2)显示全部组件合计把 Olmo 的 Biology+Tool 平均从基座 27.8% 推到 64.5%,而只留蒸馏损失只有 56.0%,收益来自组件协同而非任何单点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五任务平均(Qwen3-8B,5h 预算) | avg@16 准确率 (%) | FSPO 76.2 | SDPO 72.0 / GRPO 70.4 / 基座 49.5 | +4.2(对最强基线 SDPO) |
| 五任务平均(Olmo3-7B-Instruct,5h 预算) | avg@16 准确率 (%) | FSPO 72.4 | SDPO 68.0 / GRPO 63.2 / 基座 30.5 | +4.4(对最强基线 SDPO) |
| Chemistry(Olmo3-7B,5h) | avg@16 准确率 (%) | 83.3 | SDPO 80.0 / GRPO 56.7 | +3.3(对 SDPO) |
| Physics(Olmo3-7B,5h) | avg@16 准确率 (%) | 70.1 | GRPO 63.3 / SDPO 66.1 | +6.8(对 GRPO) |
| Biology(Olmo3-7B,5h) | avg@16 准确率 (%) | 62.3 | GRPO 55.8 / SDPO 52.8 | +6.5(对 GRPO) |
| Materials(Qwen3-8B,5h) | avg@16 准确率 (%) | 81.7 | SDPO 78.4 / GRPO 77.1 | +3.3(对 SDPO) |
| 先验能力保留均值(Olmo3-7B,Tool-use 训练后) | 五基准平均分 (%) | 59.45 | SDPO 58.73 / GRPO 54.79 / 基座 61.26 | 对 SDPO +0.72,且最接近基座水平 |
| 峰值训练显存(Olmo3-7B-Instruct) | 峰值内存 (GB) | 56 | GRPO 70 / SDPO 70 | -14 GB;外推 6T 参数约省 12 TB |
局限与改进
论文未设独立局限小节,但实验本身暴露了几点。其一,Tool use 上优势最小且早期弱于 SDPO(1h 预算下 Qwen 66.6% vs 68.0%、Olmo 57.6% vs 60.8%),说明约 4 个点的平均优势部分来自更长训练下的稳定性而非早期学习效率,短预算场景价值有限;'回答变短导致每步时间下降'只是相关性观察,未做因果验证。其二,超参数量多($\gamma,\lambda_{neg},\lambda_{CE},H,F,\zeta,\nu,\tau,\rho$ 范围、$C$ 等十余项),虽号称单一设置通吃所有模型与数据集,但敏感性消融显示 $\lambda_{CE}=1.0$ 崩到 55.3%、$H=1$ 掉到 57.0%、反向循环调度 59.7%,迁移到新域仍需仔细调参。其三,评估面较窄:只有 5 个任务、两个 7–8B 模型,GRPO/SDPO 基线数字直接取自 SDPO 论文而非同环境复跑;缺少数学竞赛、竞赛编程等强可验证长轨迹基准;30B+ 规模只有内存外推(6T 省 12 TB)而无实测精度。其四,结构签名是任务特定的手工设计(工具调用序列/选择题选项),自由形式生成任务如何定义签名未讨论。其五,时序目标在 $H=4$ 步后即可刷新,并非永久锚点,'固定'是相对的;缓存驻留单机主机内存、4 卡设置,分布式扩展未验证。最后,top-$K$ 截断把教师分布压缩到 32/100 维加尾桶,长尾词表上的信息损失未量化。
独立分析的弱点
独立分析四个弱点。(1)早期学习效率不足:1h 预算下 Tool use 输给 SDPO,根源可能是缓存种子(参考答案、标记 $\tilde{r}_p=0$)质量低,需要等验证 siblings 逐渐积累;改进方向是把种子分布升级为更强的外部教师(如离线大模型蒸馏一次),或在训练初期提高刷新率 $\zeta$ 让目标快速变好。(2)调度开环:$\rho_s$ 按固定周期循环、$w_p$ 按固定 $\tau$ 裁剪,不感知实际学习状态;改进方向是闭环控制——利用 Figure 7(c) 已展示的 current-JSD 与 temporal-JSD 比值在线调节 $\rho_s$,教师越跟不上时越偏向整合。(3)缓存内容的价值度量粗糙:保留分只用验证分数加签名覆盖度,不考虑'哪些前缀位置最有教学价值'(高熵、高分歧的位置);改进方向是按 per-token 熵或学生-教师分歧加权选择要物化的位置,进一步压缩缓存并提高每字节的监督含量。(4)稀疏化的潜在风险:$\Phi_S$ 以 top-K 支撑集压缩分布,当策略漂移较大、学生与缓存目标的支撑集几乎不重叠时,JSD 信号退化为尾桶匹配,梯度方向变模糊;改进方向是存分层采样 token 或按不确定性挑 token,而非纯 top-K。另需提醒:所有基线取自 SDPO 论文,硬件与实现差异可能引入偏差,严格对照应自行复跑 GRPO 与 SDPO。
未来方向
作者明确提出 FSPO 面向持续后训练(continual post-training),抗遗忘实验(Table 3)只是第一步,自然延伸是多任务顺序训练下用同一缓存保留所有历史任务的行为;作者还暗示了规模方向——内存收益随参数量增长(6T 外推省 12 TB),在 30B+ 模型上实测是显然的后续。基于本文成果可延伸:(1)把函数空间缓存引入 off-policy RLVR 回放——存下旧策略的输出分布即可做无需重要性采样修正的经验回放,与 GRPO 的多次迷你批更新天然互补;(2)特权示范目前是答案级的,可与过程奖励模型(PRM)结合升级为步骤级教师,进一步细化信用分配;(3)作者团队此前已把同类自蒸馏推广到文生图扩散模型(SALD),函数空间缓存同样可迁移到扩散或其他模态的后训练;(4)从理论上分析'固定函数目标 + JSD'与信任域约束的等价性,回答它为什么比 EMA 更稳;(5)在数学竞赛、竞赛编程等长轨迹强可验证任务上检验'更短更准'效应是否泛化;(6)缓存刷新目前按年龄触发,可改为按策略漂移(如 temporal JSD 低于阈值)触发,自动决定刷新时机。(7)把手工结构签名替换为可学习签名(如轨迹 embedding 聚类),扩展到自由生成任务。
复现评估
复现评估:中上难度,信息基本齐全但论文未提供官方开源代码(正文与附录均无代码链接)。有利条件:Algorithm 2 给出完整伪代码;Table 5 列出全部超参(问题批 32、$G=8$、采样温度 1.0、AdamW lr $10^{-5}$、bf16、$K_{cur}=100$、$K_{temp}=32$、$\tau_{succ}=0.5$、$H=4$、$F/\zeta=10/0.5$、$\gamma/\lambda_{neg}=0.5/0.1$、$\lambda_{CE}=0.1$、$\tau/\nu=0.6/0.3$、$\rho\in(0.3,0.5)$、$C=5$,验证用 vLLM avg@16 温度 0.6/top-p 0.95);数据与模型全部公开(SciKnowEval L3、ToolAlpaca、Qwen3-8B、Olmo3-7B-Instruct)。算力门槛明确:单任务 5 小时跑在 4×GH200 上(约 20 GPU·h/任务),7–8B 模型峰值显存 56 GB,等效可用 4×80GB 的 A100/H100 完成;五个任务全复现约 100 GPU·h。难点在工程而非算法:学生/教师双前向的 stop-gradient 实现、主机端稀疏缓存的存取与交错刷新、特权上下文(reprompt 上限 10240 token)带来的额外前向开销,论文均未给工程细节;'广义 JSD'中 $\alpha$ 与时序项 $\tilde{\alpha}$ 的具体实现差异也着墨很少。基线数字取自 SDPO 论文,严格对照需自行复跑 SDPO。综合估算:熟悉 RL 训练框架(如 verl/OpenRLHF)的工程师约需 1–2 周完成复现。
论文图表
五个面板分别对应在一个任务上训练,横轴为该任务 5 小时内的最佳 avg@16(新任务得分),纵轴为五个先验能力基准的平均分(保留得分)。FSPO 位于各面板的右上方:新任务学得更好且旧能力保留最多;GRPO 明显偏向左下。
一张图讲清'学新不忘旧'的帕累托优势,是论文将持续后训练/抗遗忘作为卖点的核心证据。
两个骨干(Qwen3-8B、Olmo3-7B-Instruct)× 五个任务(Chemistry/Physics/Biology/Materials/Tool use)× 1h/5h 两种墙钟预算的 avg@16 完整对照,基线数字取自 SDPO 论文,末列为 5h 五任务平均。FSPO 的 5h 平均最高:Qwen 76.2%、Olmo 72.4%,且包揽全部科学推理任务的 5h 最佳。
论文的核心量化证据,'平均 +4 个百分点'的结论全部出自此表;逐项数字也揭示了 Tool use 上优势收窄的细节。
训练主循环伪代码(附录 Algorithm 2 为完整展开版):采样 rollout 并打分 → 按三级层次构造特权示范 → 计算 $\mathcal{L}_{cur}=\mathcal{L}_{distill}+\lambda_{neg}\mathcal{L}_{neg}$ → 计算可靠性加权 $\mathcal{L}_{CE}$ → 按签名分组采样回放计算 $\mathcal{L}_{temp}$ → 按 $\rho_s$ 循环调度合成总损失并 AdamW 更新 → 保留分竞争更新缓存并延迟交错刷新。
把方法节的所有公式落成可执行流程,是复现的骨架;与 Figure 2 配合可完整理解训练时的数据流。