自条件化赋予流匹配深度序列推理能力 Self-Conditioning Enables Deep Sequential Reasoning in Flow Matching
自条件化把端点预测变成跨步草稿纸,让流匹配的更多采样步真正转化为更深推理
前置知识
流匹配与 ODE 采样
流匹配是一类生成模型:定义概率路径 $\tilde{x}_t = t\,x_{\text{data}} + (1-t)\epsilon$(数据与噪声的线性插值),训练速度场 $u_\theta(x,t)$ 去回归目标场 $v(x,t)=\mathbb{E}[x_{\text{data}}-\epsilon \mid \tilde{x}_t=x]$(损失 $\mathcal{J}_{\text{CFM}}$ 为均方误差);推理时从噪声先验出发,用 Euler 法数值积分 ODE $\frac{dx}{dt}=u_\theta(x,t)$,经 $K$ 次模型评估(NFE)逐步把噪声变成图像。
本文的核心问题是:这 $K$ 次顺序评估到底提供多少「推理深度」。理解采样本质是 ODE 离散化、每步只有 $O(1/K)$ 的微小增量更新,是读懂上界定理(Theorem 1)的前提。
电路复杂度类(AC⁰/TC⁰/NC¹/P/poly/PSPACE/poly)
衡量模型表达力的复杂度工具:把模型抽象为布尔电路族 $(C_m)$,按输入长度 $m$ 分档。AC⁰ 是常数深度、无界扇入与/或/非门电路可判定的语言类;TC⁰ 额外允许多数门(MAJORITY);NC¹ 对应深度 $O(\log m)$ 的有界扇入电路(可高效并行的问题)。P/poly 与 PSPACE/poly 是带多项式建议串的多项式时间/空间图灵机类,标准关系为 $\mathrm{NC}\subseteq\mathrm{P/poly}\subseteq\mathrm{PSPACE/poly}$。已知无思维链的 log-精度 transformer 属于 TC⁰,部分变体属于 AC⁰。
论文全部理论结论都用这些类陈述:vanilla 流匹配不能把骨干模型带出它自己的类,而自条件化能让 AC⁰ 骨干跃升到 P/poly 甚至 PSPACE/poly——不熟悉这些类就无法理解「分离」到底分开了什么。
自条件化(self-conditioning)
一种训练/采样技巧:在扩散或流模型中,把上一步对最终干净数据的预测——端点预测 $z_i$——拼接到下一步的模型输入中,让模型「看见自己的草稿」。由 Chen et al. (2022) 为离散扩散提出,后被借用到图像/视频生成、分子流匹配等场景,此前只被视为提升生成质量的经验技巧。训练时用两遍前向来近似推理时的输入分布。
它是本文主角:作者证明其端点预测扮演「内部草稿纸」角色,携带可在步间突变的信息状态,是把额外采样步数转化为更深推理的关键机制。
并行 Picard 迭代
求解 ODE 的不动点迭代法:把积分方程 $x(t)=x_0+\int_0^t u(x(s),s)\,ds$ 迭代逼近,第 $k+1$ 轮把第 $k$ 轮得到的整条轨迹代入右端重新积分,所有时间点可以并行更新,误差随轮数以阶乘速率衰减(直至加性底噪)。
这是 Theorem 1 证明的核心技术:用 $\mathcal{O}(L)$ 轮并行 Picard 迭代即可复现全部 $K$ 步 Euler 采样轨迹,从而证明「更多采样步」不增加表达力。
NFE(number of function evaluations,模型前向调用次数)
采样过程中对骨干模型的前向调用次数,直接衡量推理时的序列计算量。在本文的两个采样算法中 NFE 等于步数 $K$;对比两个方法时默认在相同 NFE 下评估,另有按推理 FLOPs 对齐的补充实验。
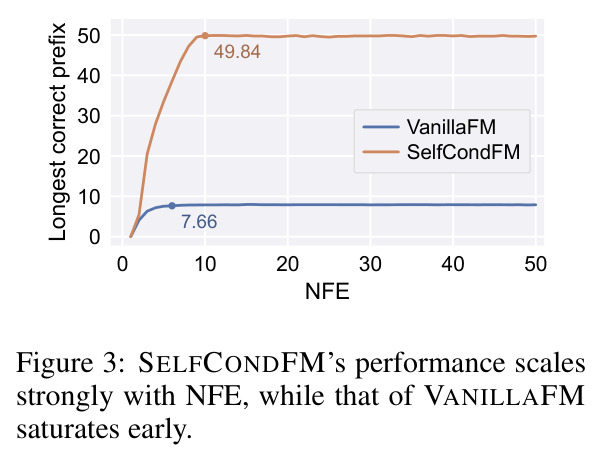
「性能是否随 NFE 增长」是理论预言的核心可检验差异:自条件化版本应随 NFE 持续提升,vanilla 版本应早早饱和——这正是 Figure 3 验证的现象。
研究动机
近期的「生成式视觉推理」范式让模型直接在图像空间生成解答:DiffThinker 等工作用图像到图像生成求解空间规划、迷宫、数独、拼图等任务。直观上流匹配特别适合——它用 $K$ 次速度模型评估把噪声变成图像,每次评估似乎对应一步推理,步数越多推理越深。但本文指出这个直觉是幻觉。关键在于流匹配采样是 ODE $\frac{dx}{dt}=u_\theta(x,t)$ 的 Euler 离散化:相邻步只通过连续状态 $x_i$ 传递信息,且每步增量被步长压到 $\mathcal{O}(1/K)$,即 $x_{i+1}=x_i+(t_{i+1}-t_i)v_i$。整条轨迹被一个光滑 ODE 支配,因而可以被另一个 ODE 求解器用常数步复现。作者证明:只要模型输出满足温和正则条件($B$-有界、$L$-Lipschitz),在精度 $b=\mathcal{O}(\log m)$、状态维度 $n=\mathrm{poly}(m)$ 下,vanilla 流匹配用常数深度骨干(如 TC⁰ 的 log-精度 transformer、AC⁰ 的常精度变体)可判定的语言仍停留在骨干自身的复杂度类里——无论采样步数 $K$ 多大,推理深度都坍缩为常数。这解释了实验中 vanilla 版本在多步推理任务(如 50 阶段折线追踪)上步数再多也停滞在低分的失败模式。
本文的目标是本文要达成三件事。第一,给出严格的表达力上界:证明在温和正则条件下,vanilla 流匹配的 $K$ 步采样可被 $\mathcal{O}(L)$ 轮并行模型评估模拟,因此不能增加常数深度骨干(AC⁰/TC⁰)的表达力。第二,找到并论证打破瓶颈的机制:证明自条件化——把上一步端点预测 $z_i$ 作为额外条件反馈——使 AC⁰ 骨干即可模拟带建议串的空间受限图灵机,多项式步数判定 P/poly、至多指数步数判定 PSPACE/poly,且两个定理约束的是同一模型类,分离纯粹来自推理算法层面。第三,验证分离是否在训练出的模型中真实出现:在三个已知电路复杂度的合成任务(NC¹-完全的折线追踪、TC⁰-完全的长乘法与长文本渲染)和五个结构化视觉推理任务上,在匹配训练 FLOPs 与 NFE 的受控条件下比较,并检验「性能随 NFE 提升」这一理论预言。可量化目标包括:折线追踪最长正确前缀(LCP)从约 8 提升到满分 50,五个 DiffThinker 任务平均准确率从 65.9% 提升到 76.7% 以上等。
与已有工作不同的是,切入角度的独特性在于用电路复杂度视角审视「采样步=推理步」这一流行直觉。已有表达力研究几乎都在自回归一侧:Merrill 等证明无思维链的常数深度 transformer 属于 TC⁰/AC⁰;Li 等证明思维链的额外顺序调用能突破上界;Liu (2025) 对最优去噪扩散模型给出 TC⁰ 上界,但要求精确匹配 score 函数,对实际训练的模型基本不成立。此前没有人系统追问过:流匹配的 ODE 迭代本身是否提供序列计算能力。本文第一个证明答案是否定的——技术核心是发现 $K$ 步 Euler 轨迹可被并行 Picard 迭代以 $\mathcal{O}(L)$ 轮压缩,所谓「深度」只是假象;同时第一个把自条件化从经验性正则化技巧(Chen et al. 2022 以来只被当作提升生成质量的 trick)重新诠释为携带可突变状态的「内部草稿纸」,并用同一模型类下的推理算法分离(Theorem 1 对 Theorem 2)把它提升为表达力层面的机制,最终凝练出可迁移的设计原则:在采样步之间多携带信息,额外步数才能转化为更深推理。
核心方法
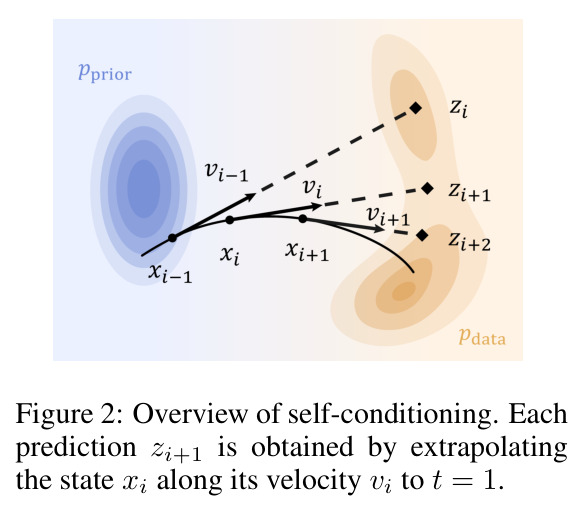
直觉类比:vanilla 流匹配像把一句话均匀切成 $K$ 段慢慢说——信息只能经由连续状态 $x_i$ 在步间流动,而每步只允许 $\mathcal{O}(1/K)$ 的微小改动,整条轨迹被 ODE 的光滑性锁死,一个更聪明的求解器(并行 Picard 迭代)只需 $\mathcal{O}(L)$ 轮并行评估就能复现全部 $K$ 步,所以步数买不来深度。自条件化则给模型一块草稿纸:每一步把当前状态沿速度外推到 $t=1$,得到对最终图像的估计 $z_{i+1}=x_i+(1-t_i)v_i$,作为额外条件拼进下一步输入。$z_i$ 近似干净样本、贴近数据流形,且不受步长约束、可在步间任意跳变——正如思维链中新写入的 token。技术路线分三步:(1) 在有限精度 $b$ 位、「以裕度 $c$ 接受」的形式化框架下,用并行 Picard 迭代证明 vanilla 流匹配的 $\mathcal{O}(L)$ 轮上界(Theorem 1);(2) 证明自条件化采样可逐步模拟带建议串的图灵机,使 AC⁰ 骨干达到 P/poly/PSPACE/poly(Theorem 2);(3) 用两遍前向的训练目标对齐训练与推理分布,在三个复杂度已知的合成任务与五个真实结构化任务上做 FLOPs 对齐的受控实验,验证理论预言的两种行为差异。
核心创新是把自条件化的端点预测诠释为「内部草稿纸」,并据此建立表达力的严格分离。与已有工作的本质区别有二。其一,本文证明 vanilla 流匹配的表观推理深度是假象:由于连续状态每步只变化 $\mathcal{O}(1/K)$,$K$ 步 Euler 轨迹可被并行 Picard 迭代在 $\mathcal{O}(L)$ 轮内压缩复现(Lemma 1/Theorem 1)。这与自回归领域的共识形成直接对照——思维链之所以有效,是因为新 token 提供了不受步长限制的信息通道,而流匹配原生态地缺乏这样的通道。其二,端点预测 $z_i$ 不是状态的微小增量,而是对终点的全新估计,可以在步间突变,使 Picard 压缩彻底失效。理论上自条件化采样可逐字节模拟带建议串的图灵机:$z_i$ 存放纸带内容与机器状态,每次模型调用把机器推进一步,$K$ 次调用运行 $\Omega(K)$ 步,于是 AC⁰ 骨干在多项式步内判定 P/poly、至多指数步($K\le 2^{\mathrm{poly}(m)}$)判定 PSPACE/poly。最关键的是两个定理的正则条件完全一致(同样的 4-有界/8-Lipschitz 量级、同样的精度约束),分离完全来自推理算法中一个几乎零架构改动的输入通道。
方法步骤详情
形式化设置:模型 $u$ 作用于二进制编码的 $(x,t,ctx)$,$b$ 位小数精度、逐坐标四舍五入;要求 $B$-有界($\|u\|_\infty\le B$)与 $L$-Lipschitz(对 $(x,ctx)$ 联合、对 $t$ 一致成立);「以裕度 $c$ 接受」语言 $L$ 要求输出每个坐标与 0 至少相距 $c$(在语言内 $\ge c$,否则 $\le -c$)。第一步,vanilla 上界:Euler 采样 $K$ 步;Lemma 1 用并行 Picard 迭代同时更新全部 $K$ 个时间点,误差按阶乘速率衰减,$\mathcal{O}(L)$ 轮、每轮至多 $K$ 次并行调用即可;当 $b\ge\log_2 K+(\log_2 e)L+c_0$ 且 $b=\mathcal{O}(\log m)$、$n=\mathrm{poly}(m)$ 时得 Theorem 1:可判定语言属于骨干电路类 $D$。第二步,自条件化采样(Algorithm 2):$z_0=0^n$;每步计算 $v_i=u(x_i,t_i;\mathrm{concat}(w,z_i))$,更新状态 $x_{i+1}=x_i+(t_{i+1}-t_i)v_i$ 与端点预测 $z_{i+1}=x_i+(1-t_i)v_i$(沿速度外推到 $t=1$)。第三步,训练:两遍前向,$v^{(1)}=u_\theta(\tilde{x}_t,t;\mathrm{concat}(w,0^n))$,$v^{(2)}=u_\theta(\tilde{x}_t,t;\mathrm{concat}(w,\mathrm{sg}[\tilde{x}_t+(1-t)v^{(1)}]))$,目标 $J_{\text{SC}}=\frac{1}{2}\mathbb{E}[\|v^{(1)}-(x_{\text{data}}-\epsilon)\|^2_2+\|v^{(2)}-(x_{\text{data}}-\epsilon)\|^2_2]$,$\mathrm{sg}[\cdot]$ 截断梯度;实现中第一遍与首个采样步省略 $z$ 输入。第四步,实验实现:折线追踪从零训练 9M 参数 MMDiT(FLUX.2 架构),长乘法/长文本渲染微调 FLUX.2-klein-base-4B LoRA(rank=alpha=32),大规模对比用 Qwen-Image-Edit-2511(20B)LoRA;自条件化把 $z_i$ 的 VAE latent token 拼入输入序列(FLUX.2 加独立位置编码偏移),不改架构;训练 FLOPs 按累计值对齐,完整计入第二遍前向的额外开销。
技术新颖性
技术新颖性体现在四点。(1) 首个针对流匹配采样过程的电路复杂度分析:证明技术靠并行 Picard 迭代把朴素模拟所需的 $e^{\mathcal{O}(L)}$ 步降到 $\mathcal{O}(L)$ 轮(误差阶乘衰减+加性底噪),并证明该界对电路深度是紧的——若能改进到 $o(L)$ 轮,多项式规模多数电路的深度层级将坍缩。(2) 首个把自条件化当作计算状态来分析的工作:自 Chen et al. (2022) 提出以来,它只被当作经验技巧用于离散扩散、扩散语言模型、图像/视频生成和分子流匹配;本文证明它使 AC⁰ 模型达到 P/poly 与 PSPACE/poly 的表达力。(3) 与 Liu (2025) 要求精确匹配 score 函数不同,本文只需 $B$-有界加 $L$-Lipschitz 的温和条件,实际训练模型可以满足——作者还用投影梯度上升实证估计了训练模型的 Lipschitz 常数(约 400 且随问题规模 $m$ 停止增长)。(4) 分离对同一模型类成立(差异纯在推理算法),从而把一个工程 trick 提升为表达力原理,并给出可迁移的设计原则:采样步之间多携带信息。
实验结果
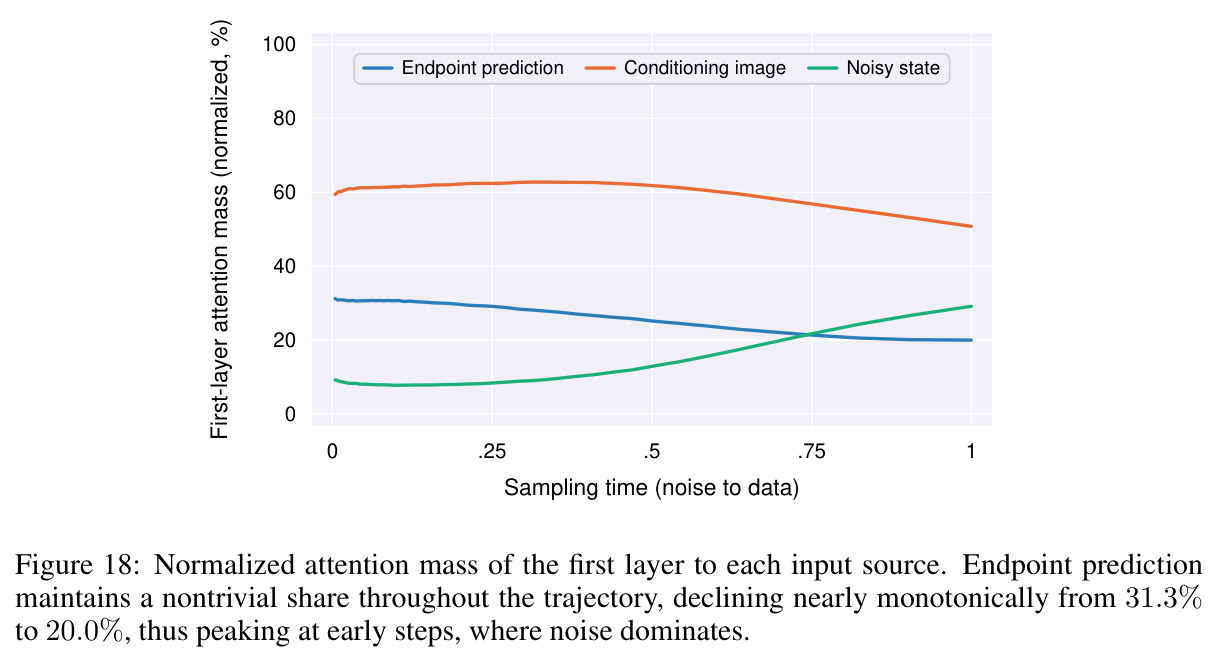
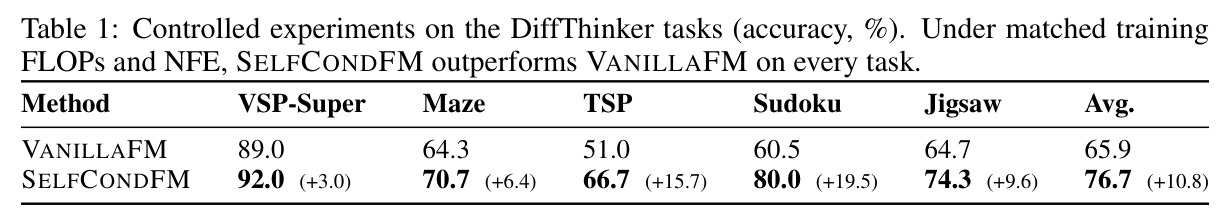
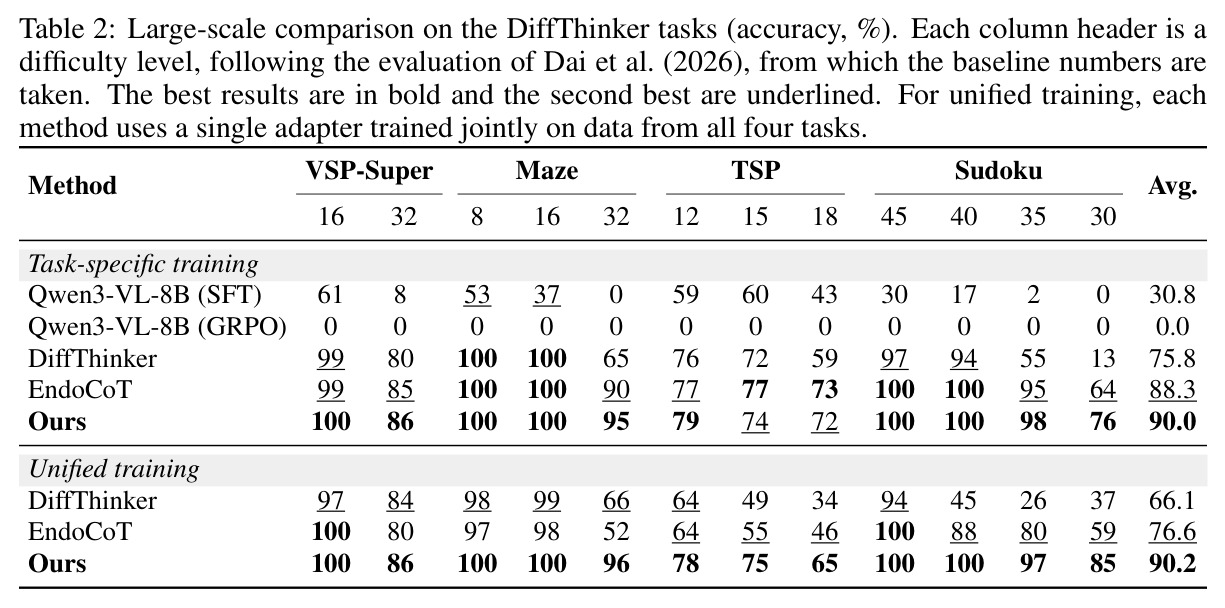
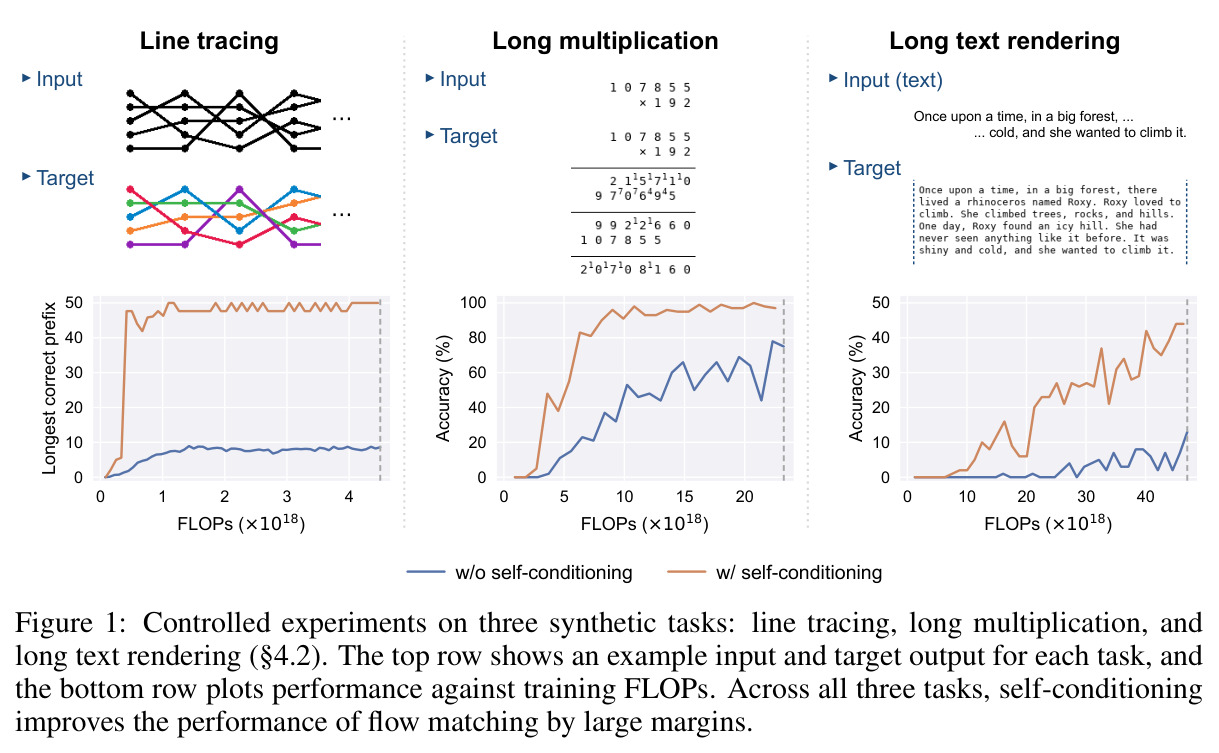
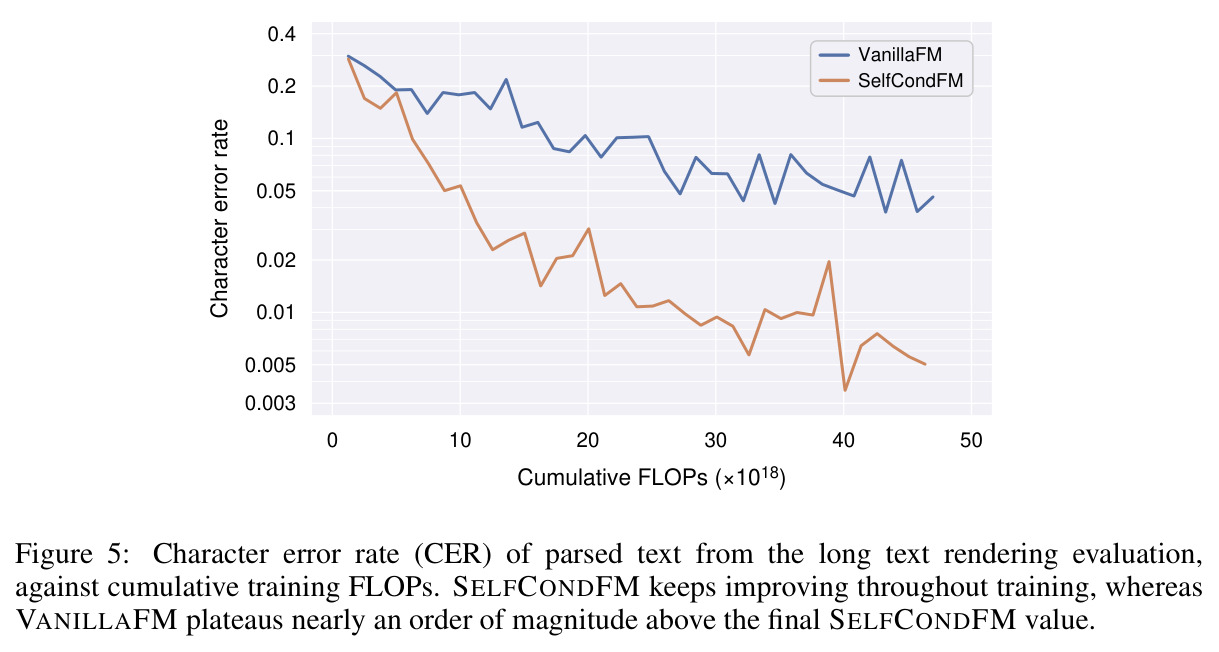
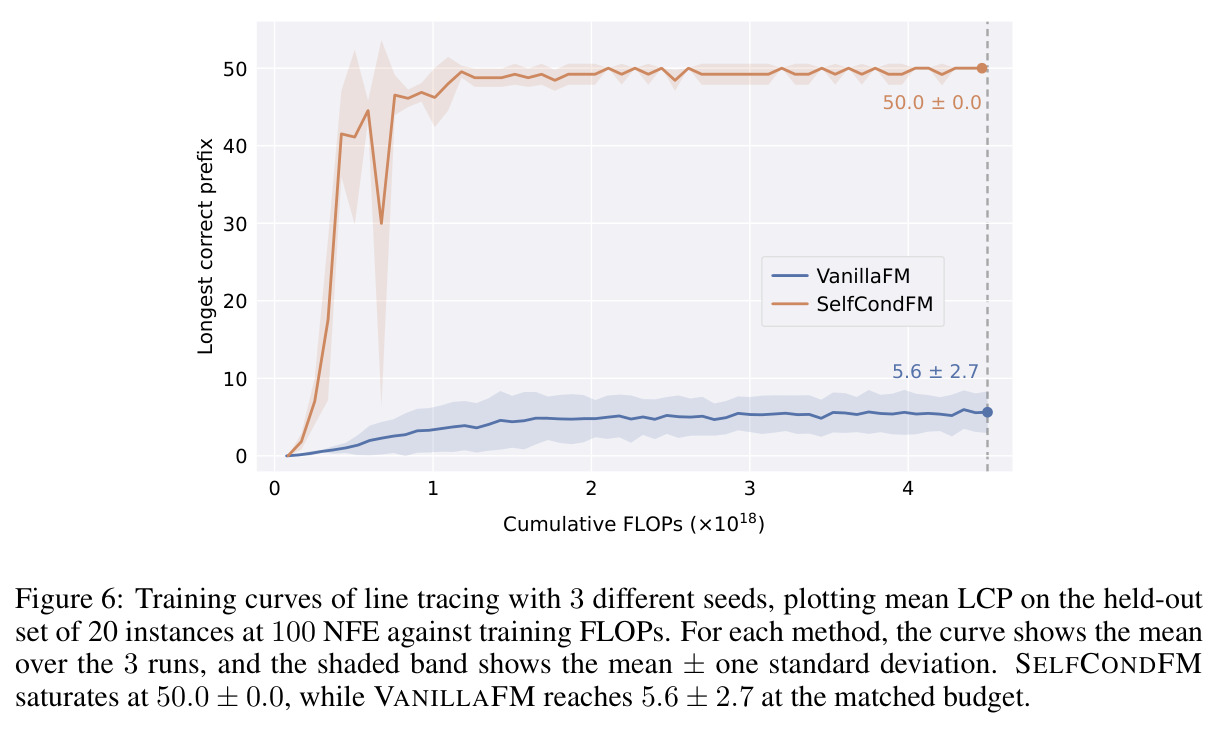
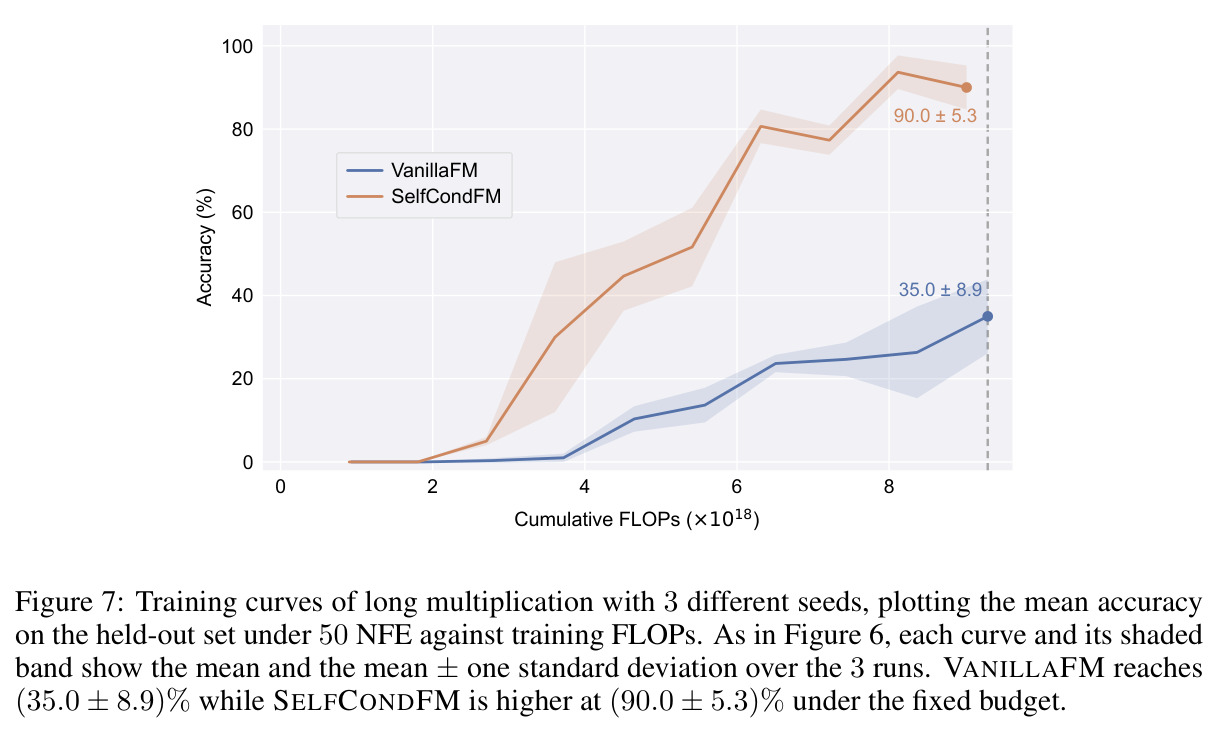
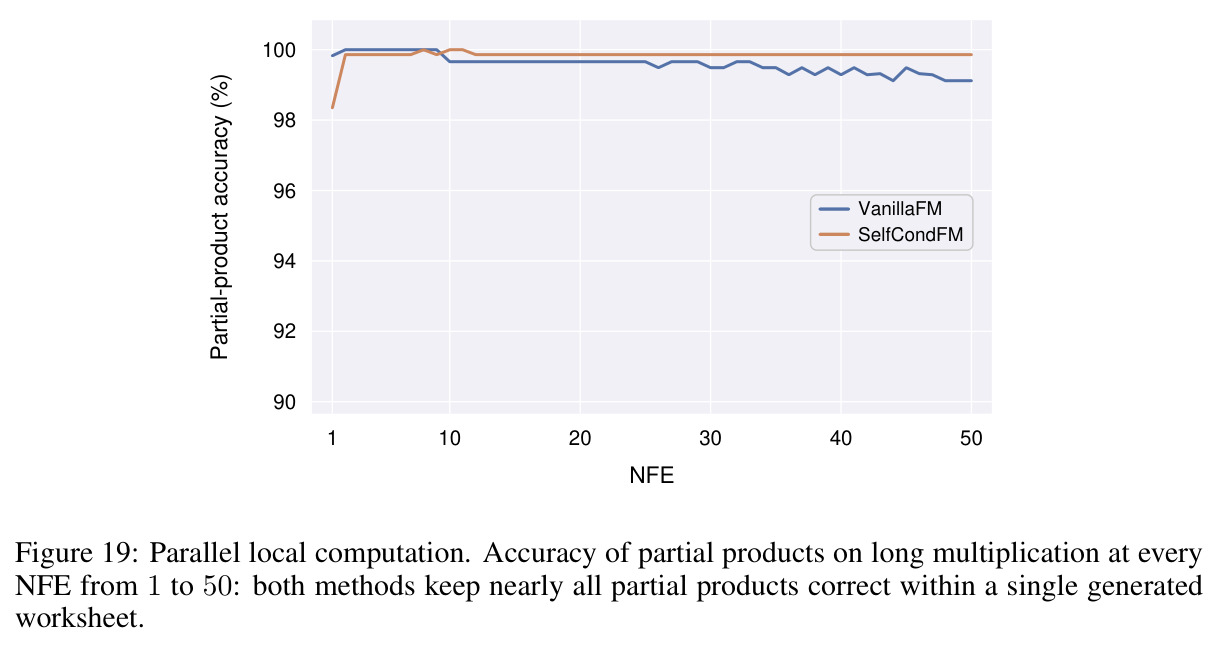
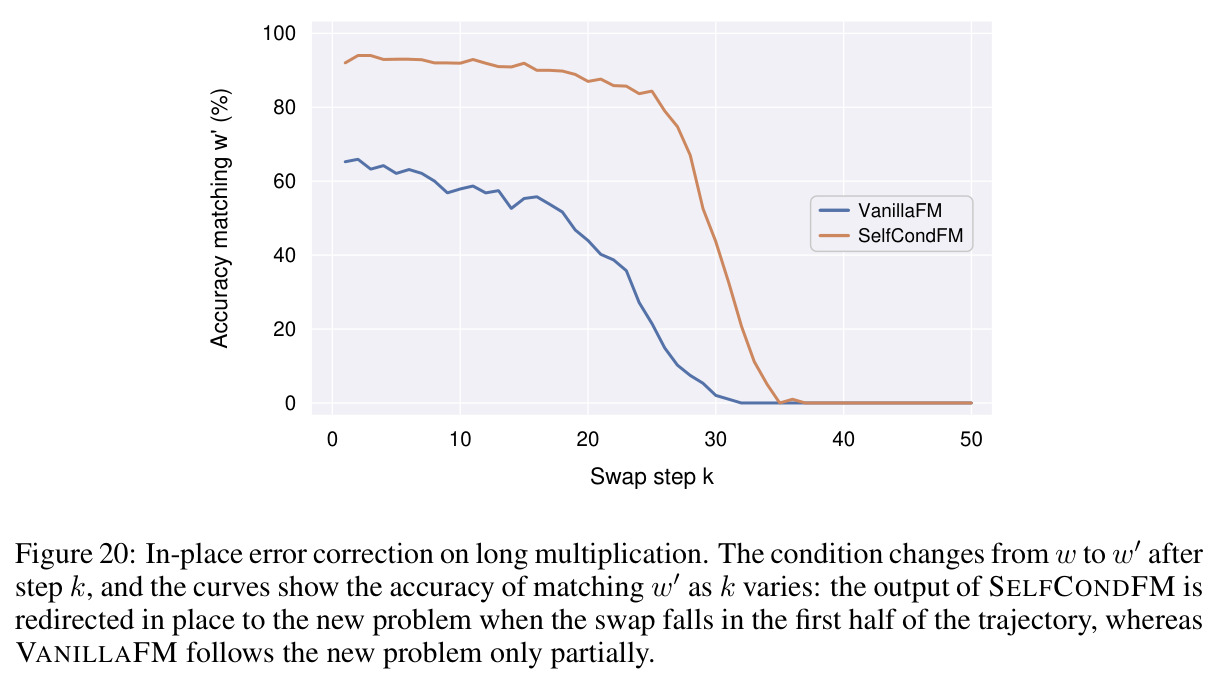
实验在匹配训练 FLOPs 与 NFE 的受控条件下验证理论分离。(1) 三个合成任务:折线追踪(NC¹-完全,5 条折线穿过 $m=50$ 个置换阶段,指标为最长正确前缀 LCP)上,自条件化在 $1.10\times10^{18}$ FLOPs 处达到满分 LCP=50,vanilla 停滞在 8 附近(7.66);长乘法(TC⁰-完全,5–7 位整数竖式,VLM 判卷)上自条件化用一半预算即超过 90% 准确率,vanilla 在整个评估区间从未达到;长文本渲染上自条件化的字符错误率 CER 最终降到 0.005,vanilla 停在 0.03–0.1(匹配预算 $4.70\times10^{19}$ FLOPs 处为 0.046)。3 种子重复实验确认:折线追踪 LCP 50.0±0.0 对 5.6±2.7,长乘法 90.0±5.3% 对 35.0±8.9%。(2) NFE 扩展性(200 个 held-out 实例、匹配训练 FLOPs 的检查点):自条件化在 NFE=10 即达 LCP 49.84,vanilla 在 NFE=6 达 7.66 后直到 NFE=50 仍低于 8.0——正是理论预言的「步数只有配合自条件化才转化为深度」。(3) DiffThinker 五任务受控对比(FLUX.2-klein-base-4B LoRA、50 NFE):平均准确率 65.9% 提升到 76.7%(+10.8),其中数独 +19.5(60.5→80.0)、TSP +15.7(51.0→66.7)、迷宫 +6.4、Jigsaw +9.6、VSP-Super +3.0。(4) 大规模对比(Qwen-Image-Edit-2511 20B LoRA,沿用 Dai et al. 2026 设定):任务专用适配器平均 90.0%,超过纯视觉生成基线 DiffThinker 的 75.8%;带潜空间 CoT 的 EndoCoT(88.3%)作为参考而非直接可比基线;统一训练单适配器达 90.2%,大幅超过统一 DiffThinker 66.1% 与统一 EndoCoT 76.6%;Jigsaw 单独报告 96.0%(DiffThinker 92.3%),且在难度 4 上 90 对 80 领先最多。(5) 机制分析:模型对 $z_i$ 的第一层注意力占比稳定在 20.0%–31.3% 且早期更高;部分乘积准确率在每个 NFE(含 NFE=1)都高于 98%,显示并行局部计算能力;中途替换条件实验显示自条件化在前半程可保持约 90% 的就地纠错准确率(vanilla 仅 65% 且 $k=32$ 时归零)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 折线追踪(NC¹-完全合成任务,m=50,100 NFE) | 最长正确前缀 LCP(满分 50) | SelfCondFM 达满分 50(1.10×10¹⁸ FLOPs;3 种子 50.0±0.0) | VanillaFM 停滞于约 8(7.66;3 种子 5.6±2.7) | 从停滞约 8 提升到满分 50,提升 6 倍以上 |
| 长乘法(TC⁰-完全合成任务,5–7 位整数,50 NFE) | 实例准确率(VLM 判卷,含中间步骤与进位) | SelfCondFM 一半预算即超 90%(3 种子 90.0±5.3%) | VanillaFM 在整个评估区间从未达 90%(3 种子 35.0±8.9%) | 约 +55 个百分点(匹配预算下) |
| 长文本渲染(TC⁰-完全合成任务,50 NFE) | 字符错误率 CER(Levenshtein 距离/参考长度) | SelfCondFM 终值 0.005 且持续下降 | VanillaFM 停滞在 0.03–0.1,匹配预算处 0.046 | CER 降低约一个数量级 |
| NFE 扩展性(折线追踪,匹配训练 FLOPs,200 实例) | LCP 随 NFE 变化 | SelfCondFM NFE=10 达 49.84 | VanillaFM NFE=6 达 7.66 后到 NFE=50 仍低于 8.0 | 唯一随采样步数持续提升的方法 |
| DiffThinker 五任务受控对比(VSP-Super/Maze/TSP/Sudoku/Jigsaw,50 NFE) | 平均准确率(%) | SelfCondFM 76.7% | VanillaFM 65.9% | +10.8 个百分点(数独 +19.5、TSP +15.7) |
| 大规模对比(Qwen-Image-Edit-2511 20B LoRA,四任务,任务专用训练) | 平均准确率(%) | 90.0% | DiffThinker 75.8%(EndoCoT 88.3%,参考) | +14.2 个百分点 |
| 大规模对比(统一训练:单适配器训练四任务) | 平均准确率(%) | 90.2% | 统一 DiffThinker 66.1% / 统一 EndoCoT 76.6% | +24.1 / +13.6 个百分点,且统一训练不掉点 |
| Jigsaw 大规模对比(难度 2–4) | 平均准确率(%) | 96.0%(98/100/90) | DiffThinker 92.3%(99/98/80);Gemini-3-Flash 29.0、GPT-5 10.0 | +3.7 个百分点,最难级别领先最大 |
局限与改进
作者承认的局限:Theorem 1 依赖较强的 Lipschitz 假设;§4.4 的 Lipschitz 估计数值较大(约 400,最大 580)且只是经验值而非认证上界,而 $\mathcal{O}(L)$ 界对电路深度又是紧的,因此探索替代正则条件是明确的未来方向。理论给的是存在性保证:证明「存在满足条件的模型」,并不保证随机训练出的模型真会实现 P/poly 级表达力。我自己的观察:(1) 框架是非一致复杂度(带 advice 的语言类),允许每个输入长度不同的建议串,与「一组固定权重处理所有长度」的现实有间隙;(2) 「以裕度 $c$ 接受」把任务化成逐坐标符号判定,而实验实际用 VLM judge(Qwen3.8-Flash)评卷和文本解析评测,理论与评测之间的形式对应只是启发式桥接;(3) 合成任务规模有限(折线追踪 $m=50$、乘法 5–7 位、渲染约 50 词),更长的程序(数百位乘法)未测,VAE latent 草稿纸的容量可能成为瓶颈;(4) 自条件化训练需要两遍前向,训练 FLOPs 约贵一倍(推理时同 NFE 免费);(5) 基线 Qwen3-VL-8B (GRPO) 在所有难度全为 0 分,对比虽然悬殊但提示该 RL 基线可能未调好;(6) 理论与模态无关,但实验只覆盖图像空间,视频/连续文本域的迁移仍是开放问题。
独立分析的弱点
独立分析的弱点:(1) 全局联合 Lipschitz 条件过强——注意力机制天然可能产生局部尖峰,真实大模型(尤其大规模微调后)未必满足;实验估计只是对 30 条轨迹、若干扰动半径的对抗搜索,无法排除未探区域的爆炸。改进方向:研究局部/分段 Lipschitz 或容忍稀疏尖峰的条件,或用随机平滑、谱范数正则等认证技术。(2) 判定式形式化与生成任务的差距:接受裕度要求每个输出坐标符号分离,而图像任务的成功是「整幅图被判卷器认可」,两者之间没有严格归约。改进:把框架推广到分布层面(如总变差距离下的近似模拟)。(3) 两遍前向训练只是推理分布的近似:第二步喂的是 $\mathrm{sg}[\tilde{x}_t+(1-t)v^{(1)}]$,而推理时的 $z_i$ 来自逐步滚动且带累积误差,分布有偏移,$K$ 增大时可能放大。改进:多步 rollout 训练、对 $z$ 加噪声增强、或一致性模型式目标。(4) 草稿纸容量受限于固定维 VAE latent:$z_i$ 的状态空间不随任务长度增长(千位乘法、长程规划会不够用)。改进:外部记忆、多画布滚动或与潜空间思维链(EndoCoT)混合。(5) 分离结果是非一致的(含 advice);对实践更有意义的 uniform 版本(同一模型处理所有长度)尚未证明。改进:给出 uniform 设置下的上界与分离。(6) 训练成本:自条件化两遍前向使同等数据训练贵约一倍,论文虽做 FLOPs 对齐,但「每 FLOPs 收益」在多大任务规模上仍为正是开放问题。
未来方向
作者提出的方向:探索替代形式的正则条件(因 $\mathcal{O}(L)$ 界对电路深度紧,Lipschitz 假设难以直接放松);把分析扩展到流匹配作为采样骨干的其他领域——视频生成、连续扩散语言建模、视觉运动策略学习——并检验自条件化的经验收益是否随之迁移。基于本文成果可延伸的工作:(1) 建立自条件化的步数下界与深度-步数权衡,类比思维链步数下界(Amiri et al. 2025),回答「解某类任务最少需要多少 NFE」;(2) NFE 自适应调度:让模型对简单实例早停、困难实例多想,把采样步数变成可分配的推理预算;(3) 与潜空间思维链结合:EndoCoT 用 MLLM 隐状态引导生成,而本文证明图像空间草稿已能突破电路屏障,两者混合的能力边界值得刻画;(4) 在真实任务(图像编辑、科学图表推理、UI 理解)与更大骨干上验证「步数换深度」的规模规律;(5) 探索其他跨步信息通道(可跳变的附加状态、非 Euler 求解器、隐变量反馈),检验「多带信息」原则的最优实现形式。
复现评估
复现条件较好。代码已在 GitHub 开源(正文脚注声明,抽取文本中未含具体链接,需从项目主页获取)。数据全部程序化生成,附录 C/D 给出精确定义、规模与超参:折线追踪 $10^6$ 个实例($m=50$)、长乘法 $2\times10^5$ 题(5–7 位操作数)、长文本渲染 $3\times10^5$ 段(TinyStories 语料);优化器 AdamW、bfloat16、batch size 8–32、学习率 $10^{-4}$–$2\times10^{-3}$、恒定学习率加 1000 步 warmup。骨干均为公开模型:小实验从零训练 9M 参数 MMDiT,微调用 FLUX.2-klein-base-4B LoRA(rank=alpha=32),训练在 4×A100 80GB 完成,累计预算 $4.5\times10^{18}$–$4.7\times10^{19}$ FLOPs,属中小规模;大规模对比需微调 Qwen-Image-Edit-2511(20B)LoRA 五个 epoch,门槛更高但仍是微调级别。评估协议公开:五任务沿用 He et al. (2025)/Dai et al. (2026) 的数据管线与评测器,长乘法用 Qwen3.8-Flash 判卷(完整 prompt 见论文图 4),文本渲染用同款模型解析后比对。理论证明完整收录于附录 A/B。注意点:VLM judge 引入评测噪声,多种子方差可达 ±5–9%。总体复现难度中等:受控实验部分 4 张 A100 即可完成,大规模对比需要更多算力。
论文图表
Jigsaw 任务在难度 2–4 上的对比:本文方法平均 96.0%(98/100/90),DiffThinker 92.3%(99/98/80),而通用 VLM(Gemini-3-Flash 29.0、GPT-5 10.0、Qwen3-VL-8B 2.3)及其 SFT/GRPO 变体大幅落后,难度 4 上本文方法领先最多(90 对 80)。
补充 Table 2 未含的 Jigsaw 大规模结果,并展示通用多模态大模型在此类视觉结构推理上的惨淡表现,凸显图像空间生成式推理范式的优势。
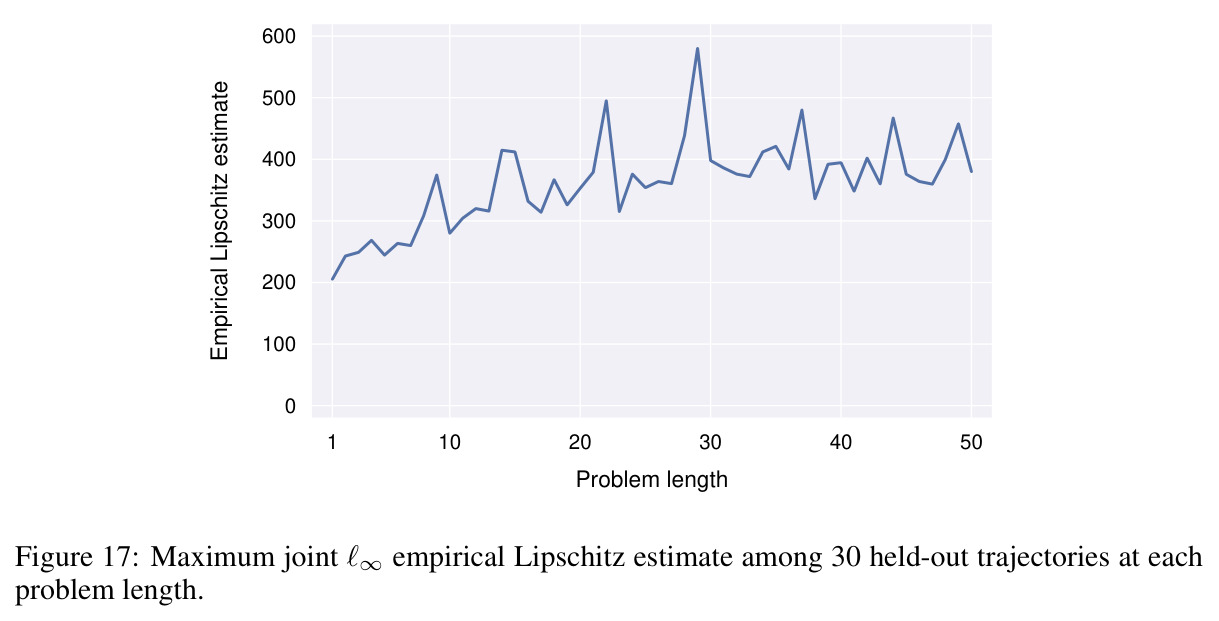
对折线追踪 vanilla 模型用投影梯度上升估计联合 $\ell_\infty$ Lipschitz 常数(扰动半径 0.003–0.3,每长度 30 条轨迹取最大):估计值随 $m$ 先升后在 $m\ge30$ 时趋平于约 400,总体最大 580,最大速度范数低于 10。
为 Theorem 1 的关键前提(有界 Lipschitz 常数、不随问题规模增长)提供经验支持,是把抽象理论与实际训练模型连接起来的重要桥梁,也是评估理论适用面的依据。