τ-Emotion-Bench:用真实世界用户情绪暴露LLM智能体的交互脆弱性 τ-Emotion-Bench: Exposing the Interaction Fragility of LLM Agents through Real-World User Emotions
以情绪化用户交互评测并训练工具调用智能体,交互感知信号筛出更自主可靠的轨迹
前置知识
工具调用智能体(Tool-calling Agent)
以LLM为大脑、通过调用外部API/函数与可执行环境交互的智能体。它接收自然语言指令,在多轮循环中交替输出工具调用(如 search_flight(from='JFK', to='LAX'))与对用户的自然语言回复,并依据环境返回的工具结果和领域策略文档决定下一步动作,直到完成任务。
本文的基准与训练数据全部围绕这类智能体构建:580个任务都要求智能体在可执行环境中完成多步工具工作流,同时与有情绪的模拟用户对话。
用户模拟器(User Simulator)
用LLM扮演真实用户与被测智能体对话的程序。它持有任务指令(用户真正想要什么)和对话历史,逐轮生成用户消息;τ-Bench引入了###STOP###令牌表示用户认为交互完成。模拟器的质量决定了评测是否可信。
本文给用户模拟器加了两样东西:受控的情绪条件,以及新的###UNSATISFIED###终止令牌——用户对低效交互不满时可提前离场并给轨迹-1奖励,这是全文核心机制。
Pass^k 与 Avg@3 指标
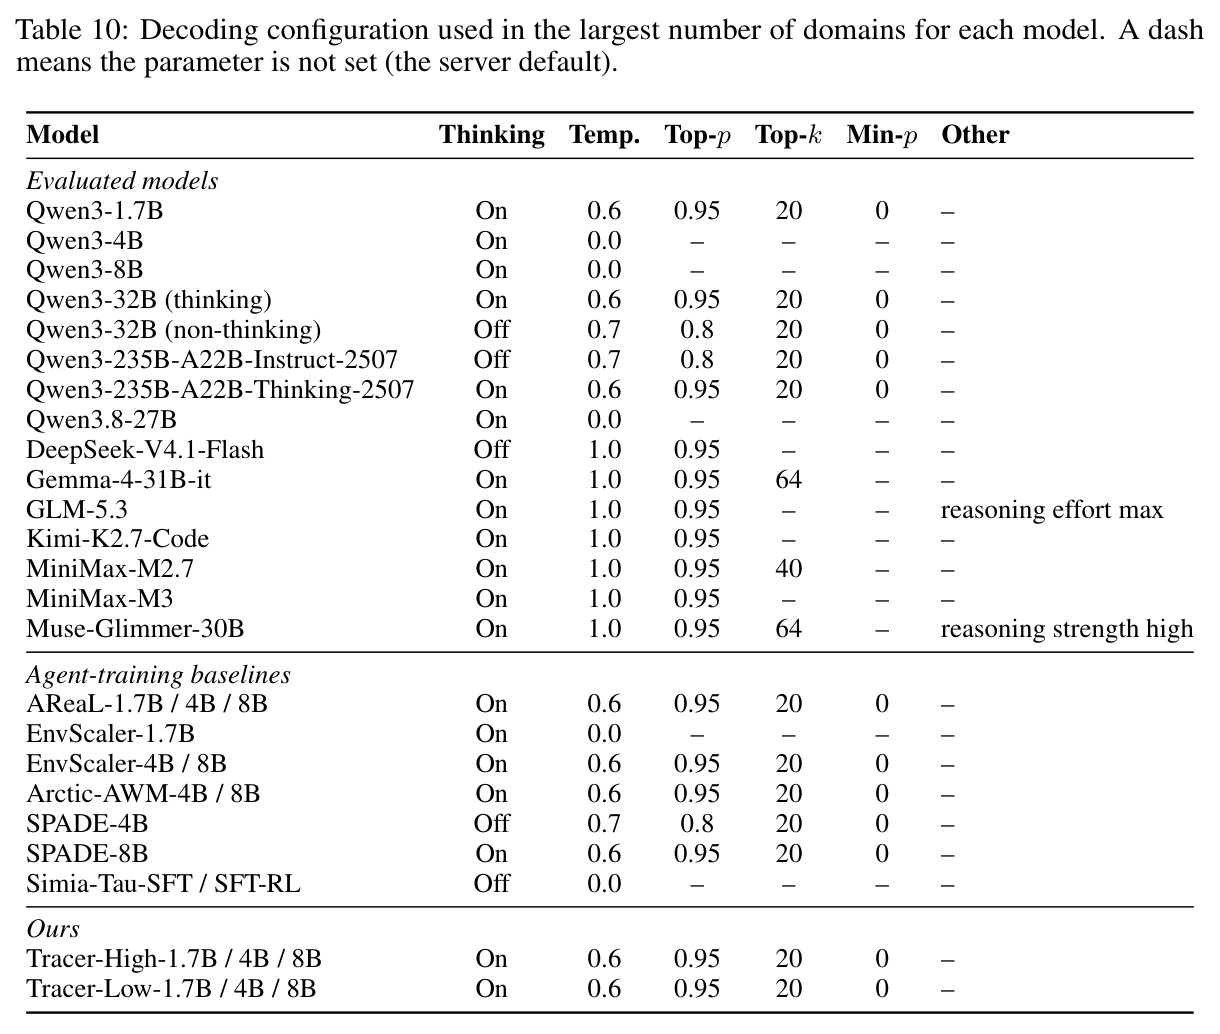
每个任务用同一个模型独立跑k次试验:Avg@3是三次试验成功率的平均值,衡量整体水平;Pass^k表示至少在k次试验中成功的任务比例,k越大越要求稳定复现。Pass^1是偶尔能做对,Pass^3是三次全对。
论文的核心论据之一就是Avg@3与Pass^3之间的巨大落差(如55.9%对32.2%),说明前沿智能体在情绪化用户面前‘偶尔成功’但‘难以稳定复现’。
行为克隆式监督微调(SFT on Trajectories)
收集专家模型在环境中成功完成任务的完整交互轨迹(每轮的推理、工具调用、回复),再把智能体侧的全部轮次拼成训练样本,用下一词预测损失让小模型模仿这套行为。TRL等库配合4-8张GPU即可完成小模型微调。
Tracer的训练全部通过SFT完成:用Qwen3.8-27B在情绪化harness里rollout,只保留成功的1,958/1,498条轨迹微调Qwen3-1.7B/4B/8B,理解SFT才能看懂实验设计。
情绪条件化与Atlas of Emotions分类法
在对话系统提示中注入结构化情绪指令,使用户行为随情绪变化但任务目标不变。本文采用Ekman的情绪地图:5大族(愤怒、恐惧、厌恶、悲伤、愉悦)下22种细粒度情绪,再组合礼貌(warm/neutral/cold)、紧急度(low/moderate/high)、信任(trusting/cautious/skeptical)三个维度,得594种条件。
这是基准的自变量:所有对比都在‘同一任务、不同情绪条件’下进行,读者需要理解这套受控变量设计才能明白结果为何能归因于情绪。
研究动机
现有智能体评测与训练几乎都默认用户是配合且行为稳定的。τ-Bench、τ²-Bench、ToolSandbox等交互式基准虽引入了多轮对话与策略约束,但模拟用户只负责提供信息或按脚本终止;UserBench、τ-Trait研究了意图模糊和人格特质(如不耐烦、困惑),却没有把情绪作为受控变量系统测量。更关键的是,无论评测还是训练数据生成,主流做法都以‘任务最终是否成功’作为唯一信号:一条轨迹即便反复向用户追问本可通过工具查到的信息、甚至索要只有环境数据库里才存在的字段,只要最后把任务做完就拿正奖励。论文指出这类‘成功但低效’的轨迹会在训练中被当作正样本,使智能体学会过度依赖用户而非环境。而真实客服场景里用户是有情绪的:焦虑的病人、被激怒的乘客不会无限配合低效追问,交互低效本身就会让用户中途放弃,这在现有harness里完全没有被建模。
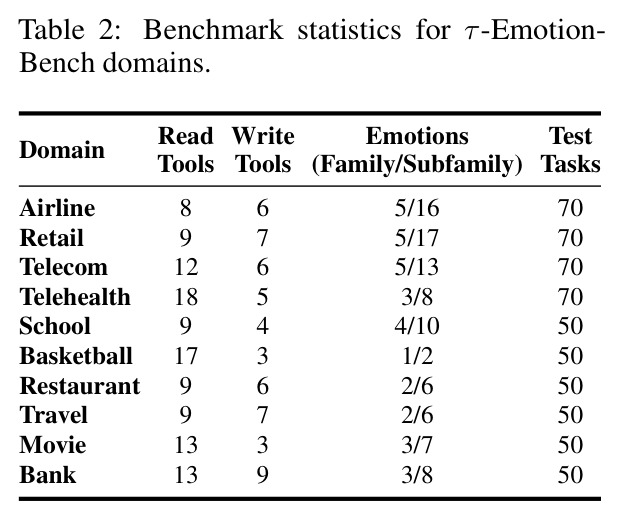
本文的目标是论文设定了两个互补目标。其一是评测:构建τ-Emotion-Bench,在任务目标、工具集、数据库与成功条件完全冻结的前提下,系统控制用户情绪(5族、22种细粒度情绪)与行为表达(礼貌、紧急度、信任三个维度,共594种条件),覆盖10个可执行域、580个任务,量化情绪可变用户对智能体可靠性的影响;同时给用户模拟器###UNSATISFIED###终止权,使交互质量本身成为可观测信号。其二是训练:提出Tracer数据生成管线,用同一harness批量生成有依据、符合域策略的多步任务与训练轨迹,并用交互感知信号过滤掉过度依赖用户的‘成功’轨迹,只保留既推进任务又只在真正缺信息时才向用户开口的轨迹做SFT,目标是让1.7B-8B的小模型显著缩小与前沿模型的差距,并验证学到的行为能否迁移到未见域和τ-Bench、τ-Trait等外部基准。
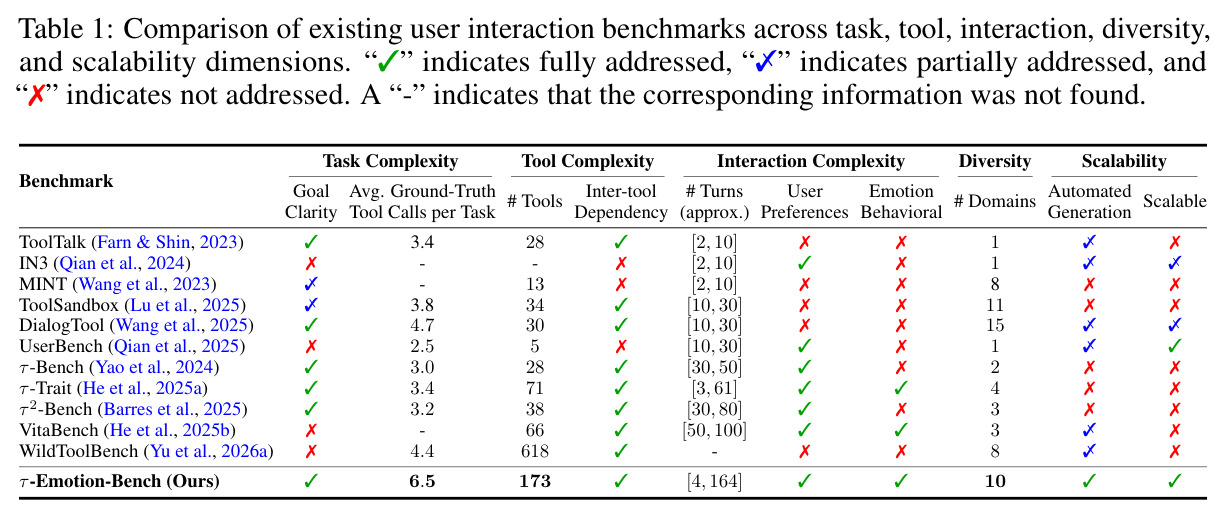
与已有工作不同的是,独特切入在于把‘用户情绪’从干扰因素变成结构性资源。此前两条研究线互不相交:情绪类基准(EIBench、TEA-Bench)研究情感支持对话但不涉及可执行工具任务;工具类基准(τ-Bench、τ-Trait、VitaBench)有真实环境却假设用户情绪中性。本文第一次采用严格的对照设计——同一任务、同一环境、同一成功条件,只操纵情绪与表达方式——使情绪对任务成败的影响可以被干净地因果解读(Table 1逐一对比了11个既有基准,无一同时满足情绪受控、任务复杂、可自动生成三要素)。训练侧,VULCAN、EnvScaler、Simia、SPADE等合成数据管线用任务成功或可执行性筛选轨迹,Tracer则第一次让用户模拟器参与奖励定义:不满意的用户终止交互并给-1奖励,把‘会不会与人打交道’编译进数据筛选标准,这是与所有既有方法最本质的差别。
核心方法
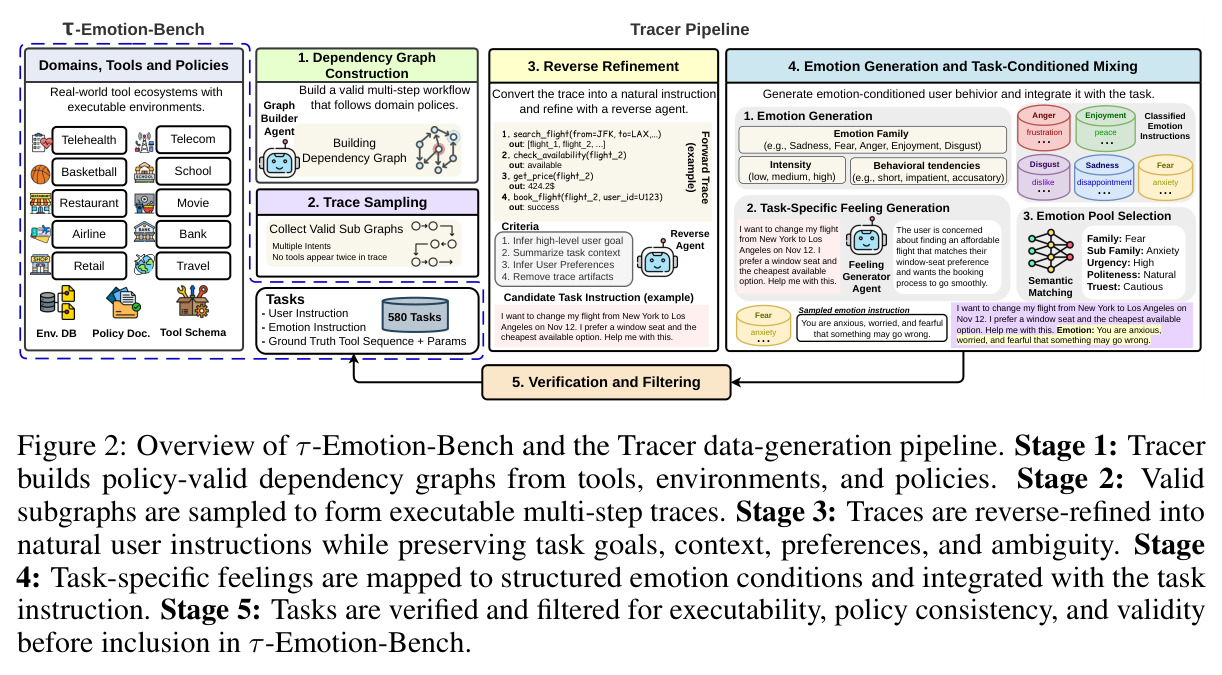
直觉上,论文把‘跟一个有情绪的真实用户办事’完整搬进了评测闭环:环境(数据库+工具+策略文档)、智能体、用户三方实时交互,用户被注入受控情绪,并且像真人一样在交互令人沮丧时提前离场。技术路线分评测与数据生成两半。评测侧,每个任务形式化为POMDP $(S, A, O, T, R, U)$,外加情绪条件 $e \in E$,用户响应按 $u_t \sim \pi_{user}(\cdot \mid u, e, h_t)$ 生成——情绪在回合内固定,但其表达随交互历史演化,模拟器可以对顺利进展、重复追问、无理请求做出不同反应。用户可发出###STOP###(交互正常完成)或###UNSATISFIED###(交互已难以忍受);后者若在任务成功前出现,该轨迹奖励记为-1。数据生成侧,Tracer管线分五阶段:从工具依赖图采样合法多步工作流,在具体环境状态上落地成参考轨迹,把轨迹反向精炼成自然的用户指令,把任务相关的感受映射成结构化情绪条件并与指令混合,最后验证过滤。训练时用同一harness收集轨迹,只保留奖励+1的成功轨迹做SFT。
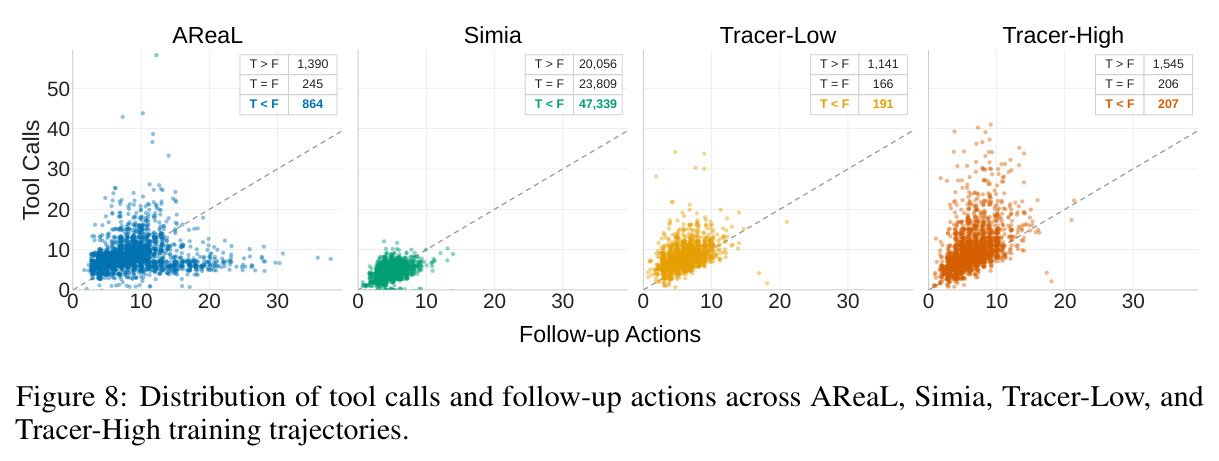
核心创新是‘交互感知奖励信号’。传统轨迹收集只问‘数据库终态对不对’,Tracer额外问‘这个成功是怎么得来的’:若智能体反复问不必要的问题、或向用户索要本应通过工具获取的信息,用户的不满会累积并触发###UNSATISFIED###式离场,轨迹即使能做完任务也得-1。这相当于把用户体验变成硬约束,自动淘汰‘问个不停’型的成功轨迹。Figure 8证明该信号确实改变了数据分布:Tracer轨迹中工具调用多于追问的比例达76.2%(Low)/78.9%(High),远高于AReaL的55.6%和Simia的22.0%。第二个创新是受控情绪空间:借Ekman的Atlas of Emotions建立5族22种细粒度情绪,与礼貌{warm, neutral, cold}、紧急度{low, moderate, high}、信任{trusting, cautious, skeptical}组合成594种条件;对每种条件用GPT-4.1生成10条自然语言锚点指令(共5,940条),用text-embedding-3-small嵌入并训练多头分类器,把任务构造阶段产生的自由文本‘感受’映射到具体条件,再随机抽一条锚点指令(而非离散标签)交给模拟器——任务目标不动,行为可控可变。
方法步骤详情
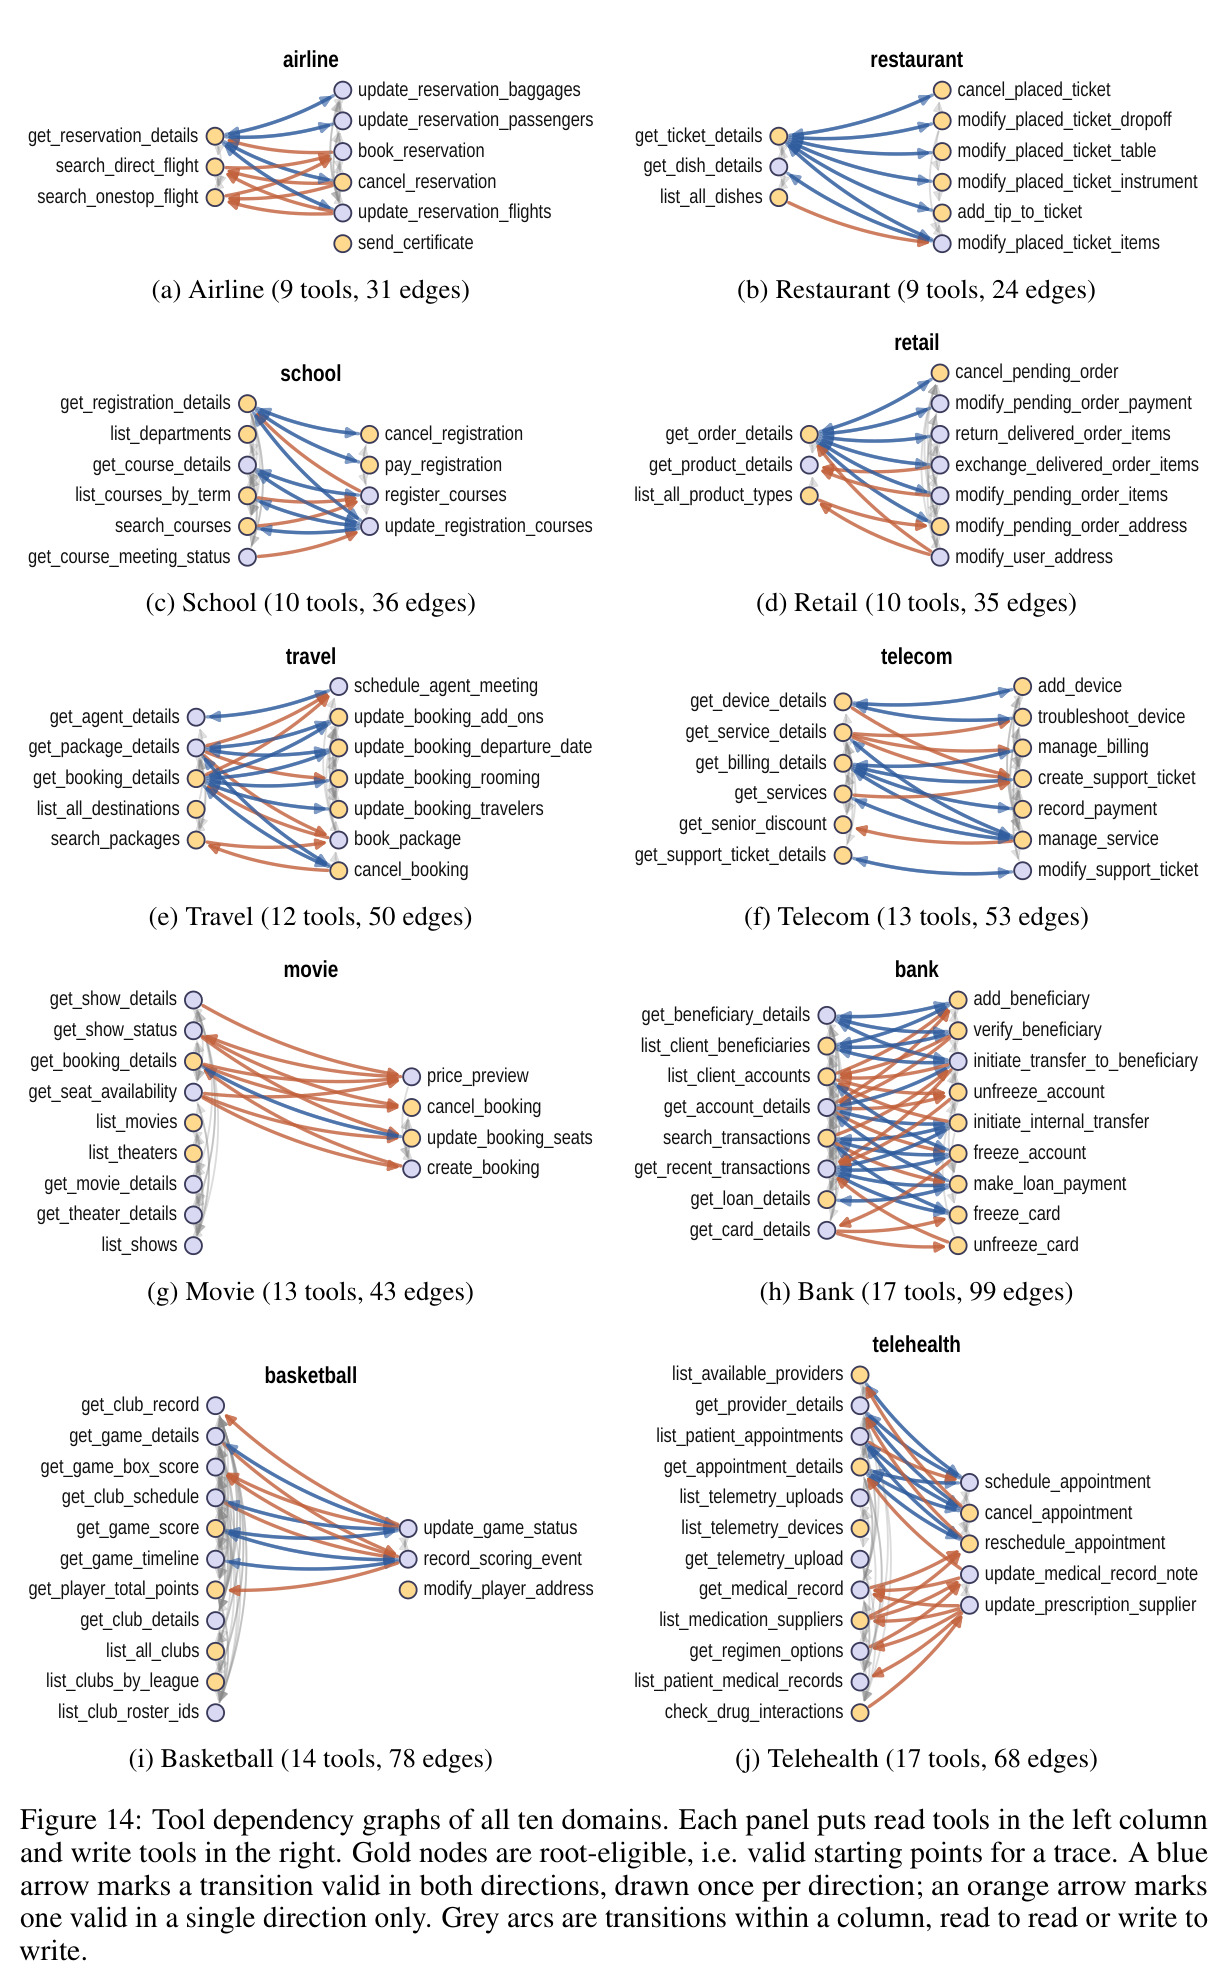
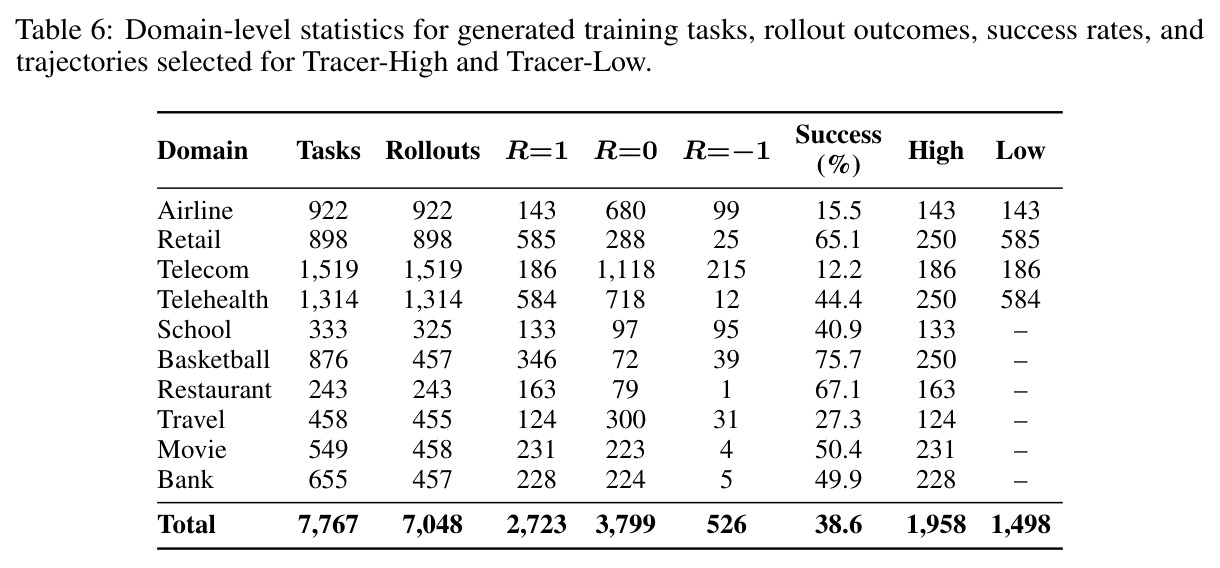
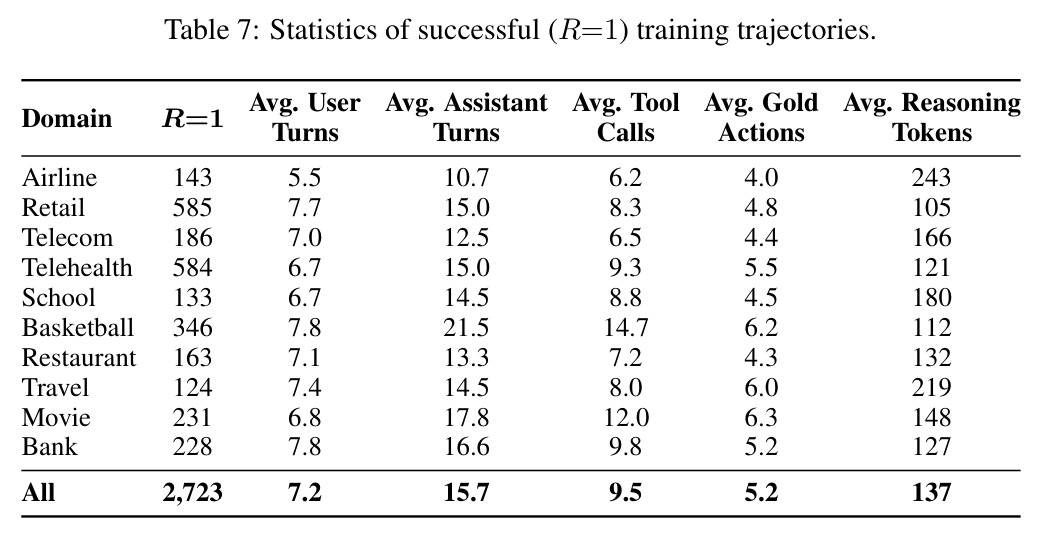
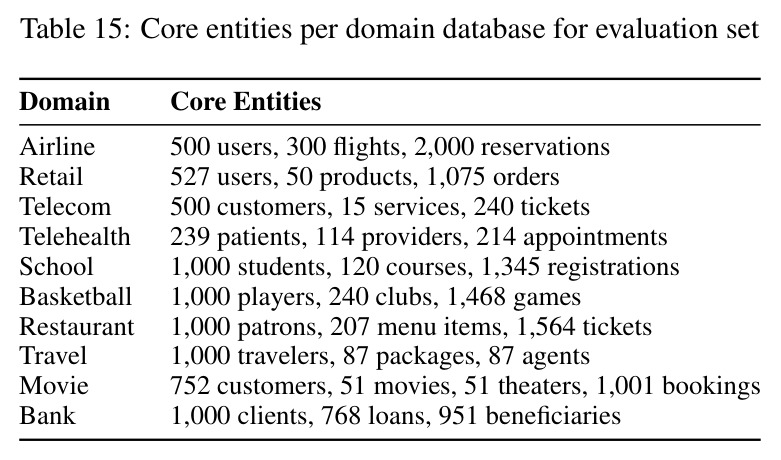
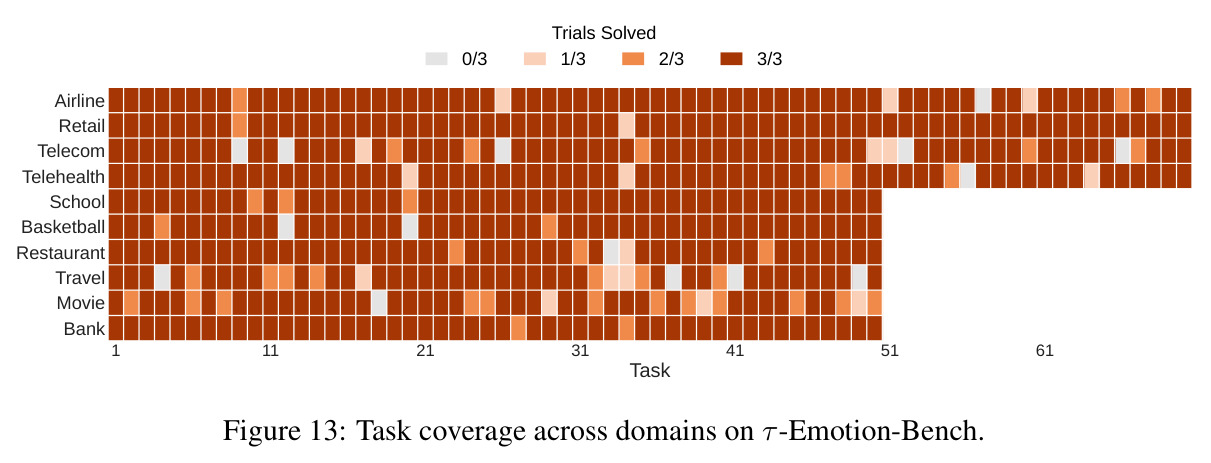
Tracer分五步。第一步依赖图构建:每个域构造有向工具图 $G=(V,E)$,节点是工具,边表示按工具接口与域策略可以合法先后调用;边由工具定义、执行行为、策略约束推断并经人工核验(Restaurant最小,9工具24边;Bank最大,17工具99边,密度0.25-0.43)。第二步轨迹采样:从图采样合法路径、组合多意图任务,落地智能体在可执行环境中填入具体实体与参数,产出可确定性回放的参考轨迹(580个评测任务平均真值6.5次工具调用,远超τ-Bench的3.0)。第三步反向精炼:反向代理从轨迹反推高层用户目标、总结任务上下文、推断用户偏好(如靠窗、要最便宜)、抹去轨迹痕迹,改写成一句自然指令。第四步情绪生成:感受生成器不访问环境数据库、仅凭用户上下文描述可能的情绪状态,经锚点分类器映射到594种条件之一,与任务指令拼成情绪指令(如‘你很焦虑,担心事情出岔子’)。第五步验证过滤:要求目标具体、信息充分、存在可执行参考轨迹、符合域策略;2,266个候选任务先经Qwen3-235B双角色rollout观察,再人工修订(101处真值修正、23处内部ID替换为用户可知信息、23处加入策略挑战重写)后保留580个。训练数据:7,767个训练任务用Qwen3.8-27B(thinking)做智能体、Qwen3-235B-A22B-Instruct做情绪化用户,50步上限rollout得7,048条轨迹,保留2,723条奖励+1轨迹(38.6%),按域均衡(Retail/Telehealth/Basketball各截断至250条)后得Tracer-High 1,958条(全10域)与Tracer-Low 1,498条(Airline/Retail/Telecom/Telehealth 4域)。
技术新颖性
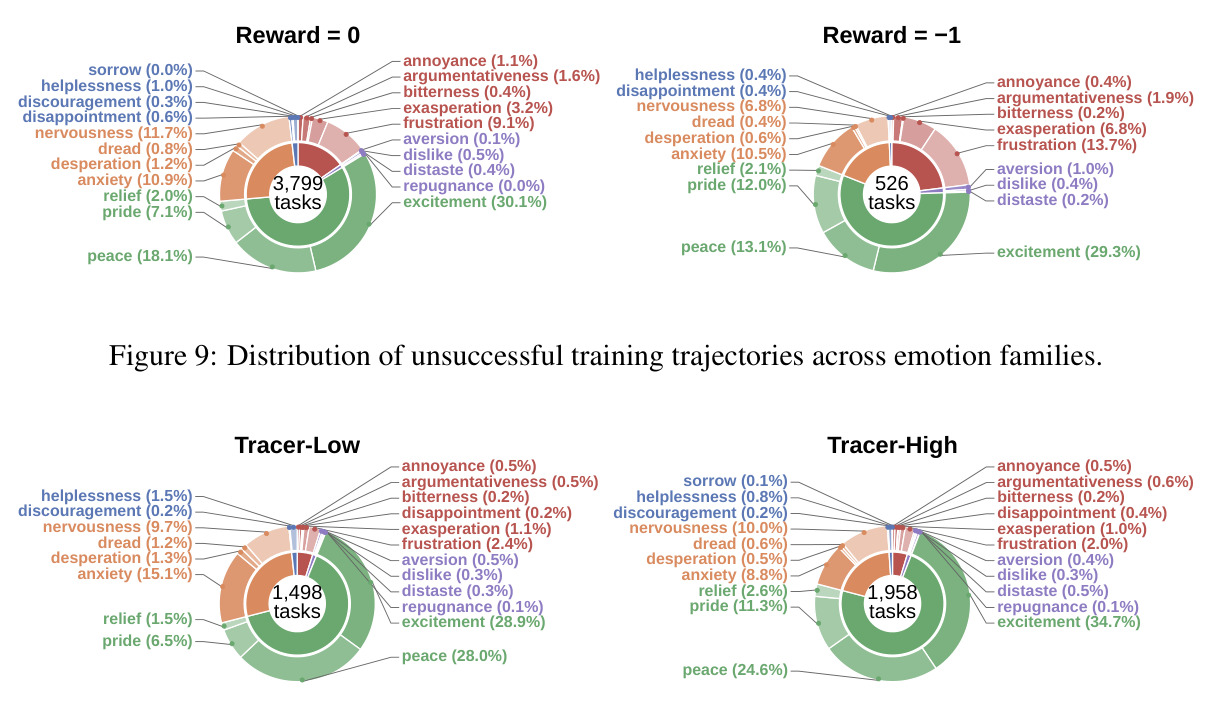
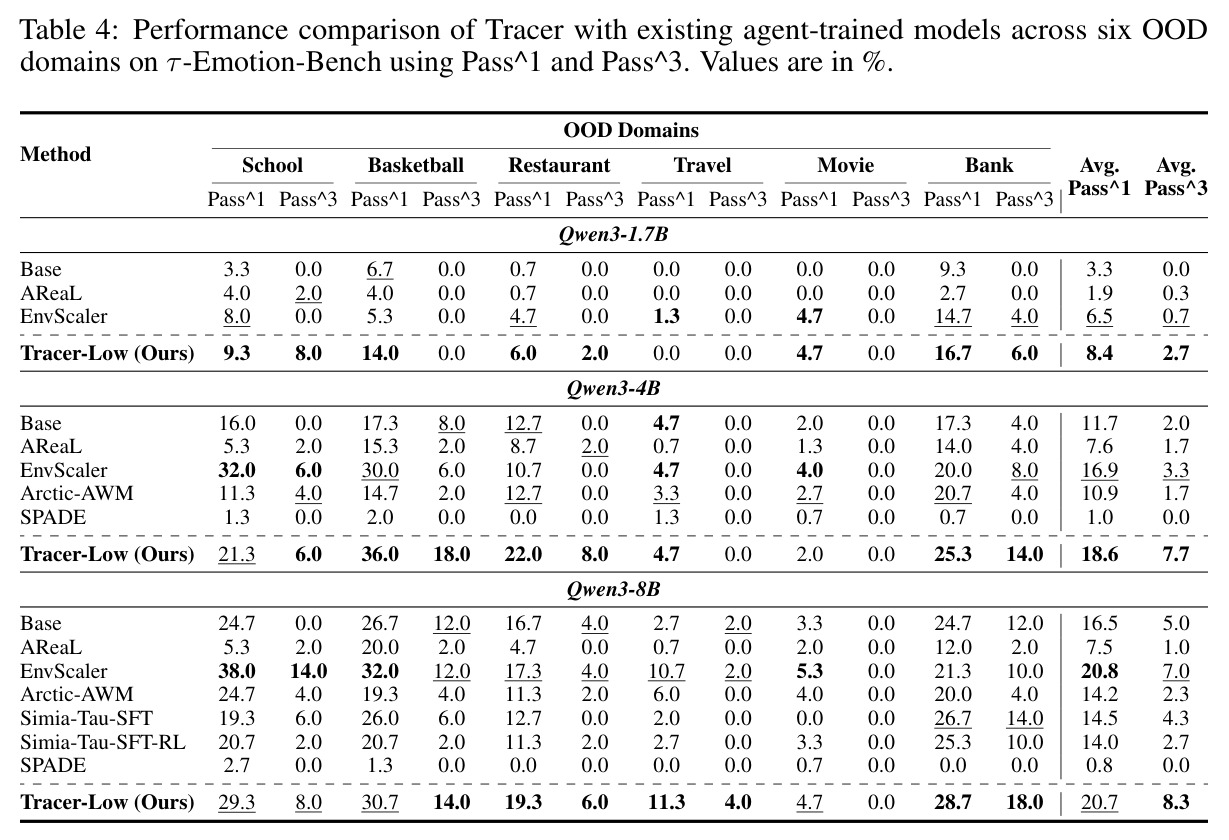
新颖性有三层。其一,评测维度上首次把情绪作为受控自变量:τ-Bench用户总是配合,τ-Trait只控人格特质(不耐烦/困惑),本文在任务、环境、成功条件完全冻结的对照设计下只操纵情绪与表达方式,且给每个任务配套无情绪版本供对照,使情绪-性能关系可被因果解读,填补了Table 1所示的空白列。其二,奖励结构上把用户满意度纳入轨迹评分:这是把‘环境之外的第三方(用户)’引入奖励定义的新思路,训练侧效果可量化——Tracer-High中工具调用多于追问的轨迹占78.9%,负面情绪下成功轨迹的挫败/恼怒占比(13.7%/6.8%)显著高于普通失败轨迹(9.1%/3.2%),说明-1信号精准命中了低效交互。其三,工程可扩展性与数据效率:全流程自动化,仅1,498条轨迹就在6个未见域上超过用9,000条SFT轨迹的EnvScaler和91,204条合成轨迹的Simia-Tau-SFT,说明筛选信号本身比数据规模更重要,这对合成数据领域是一个有普适意义的结论。
实验结果
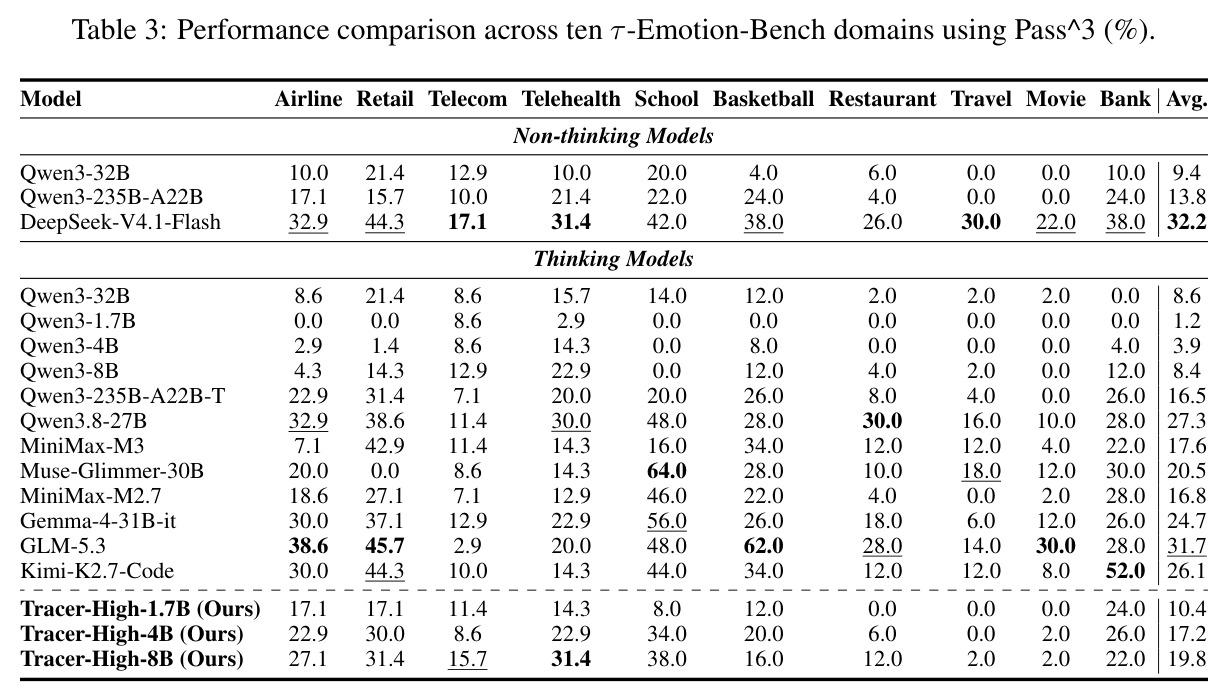
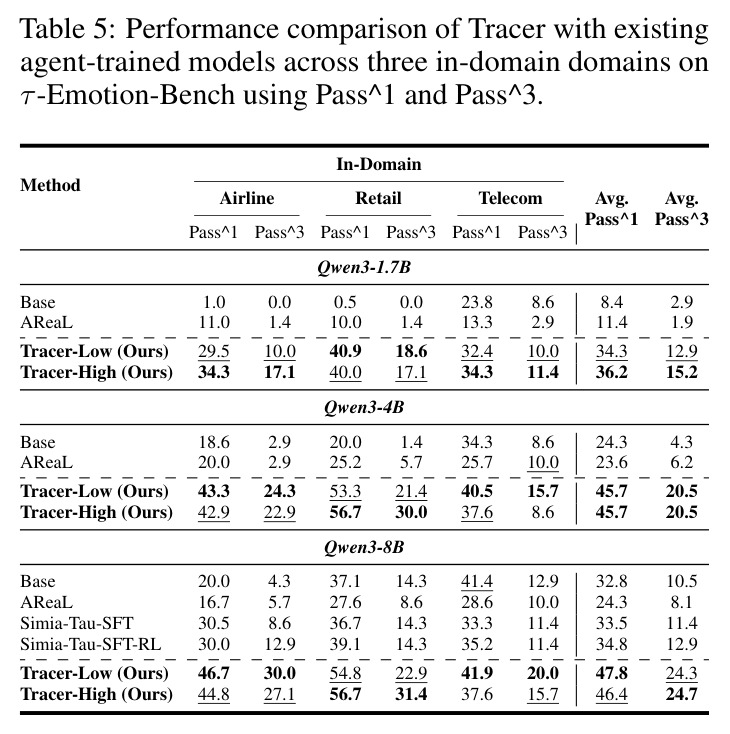
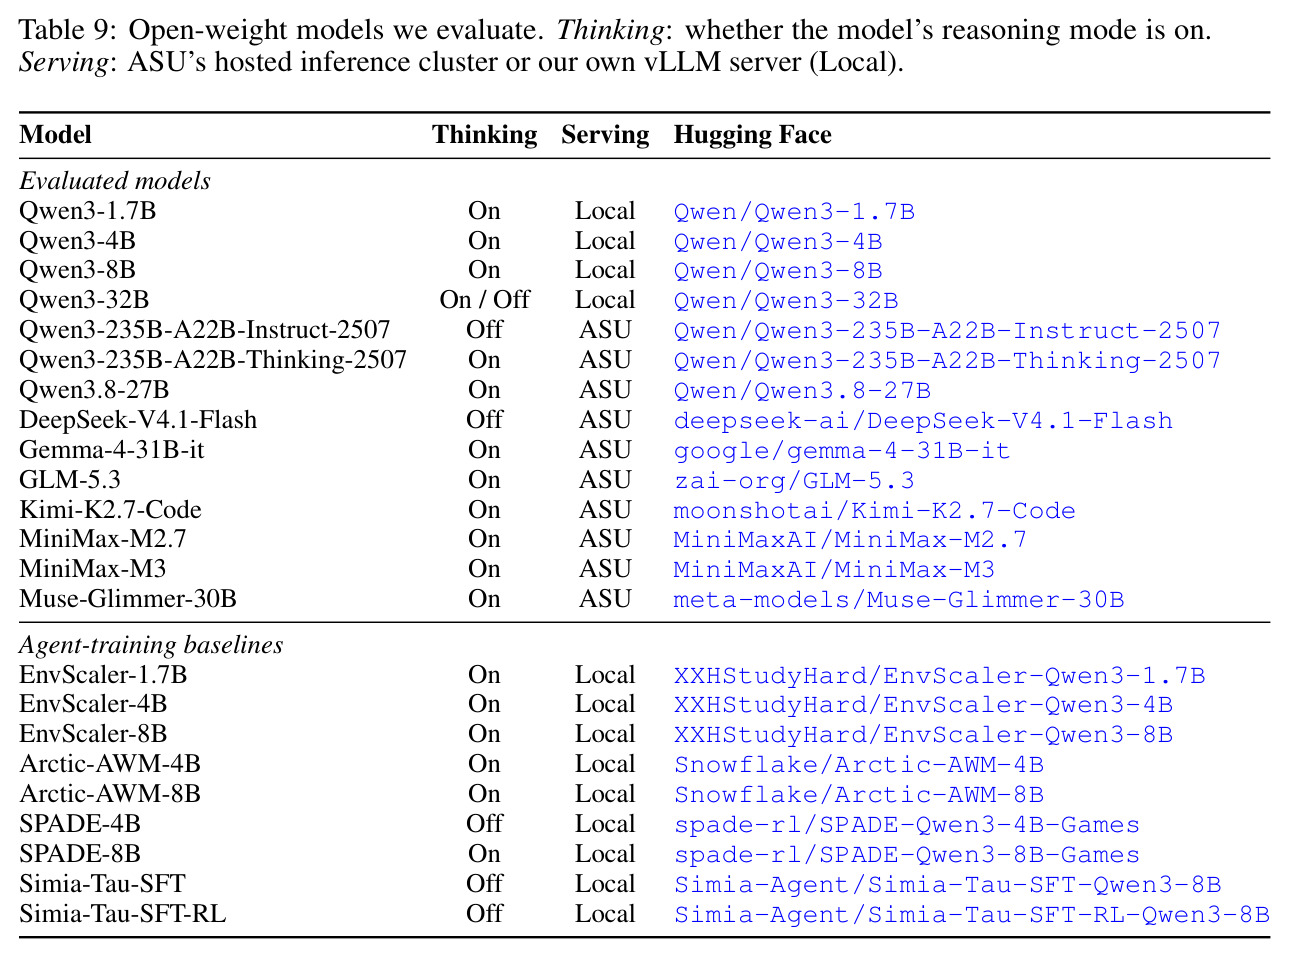
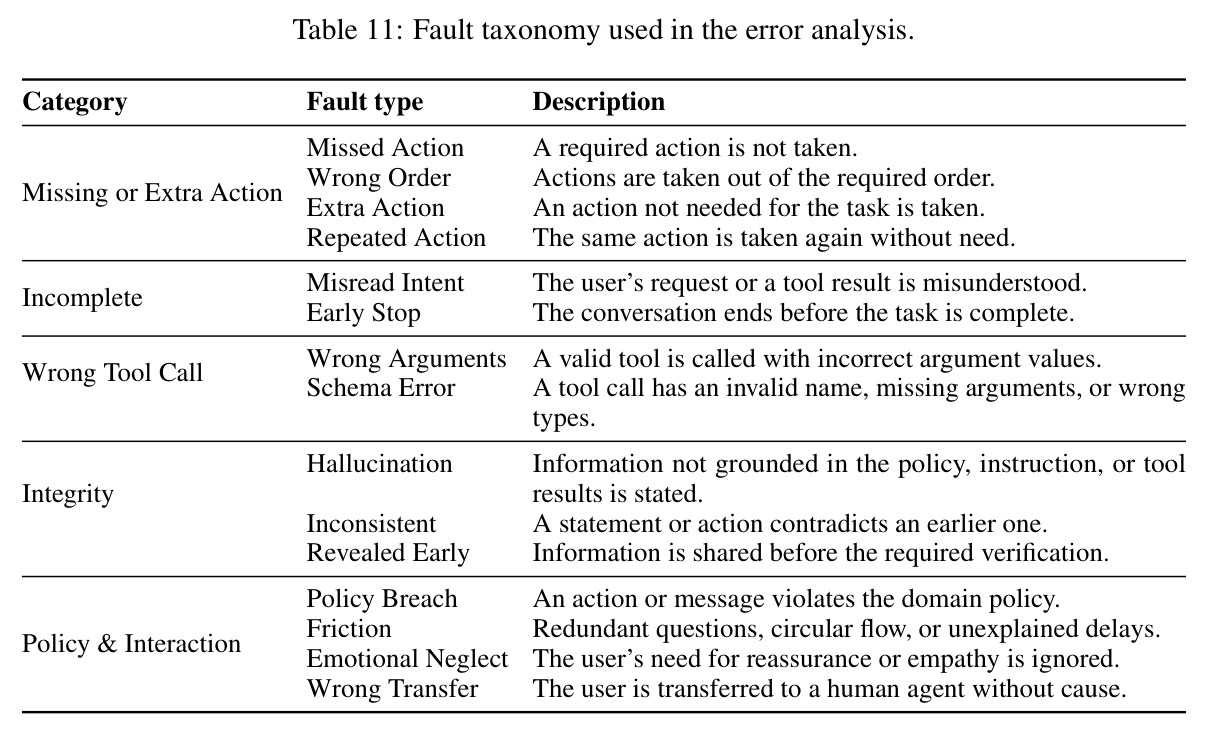
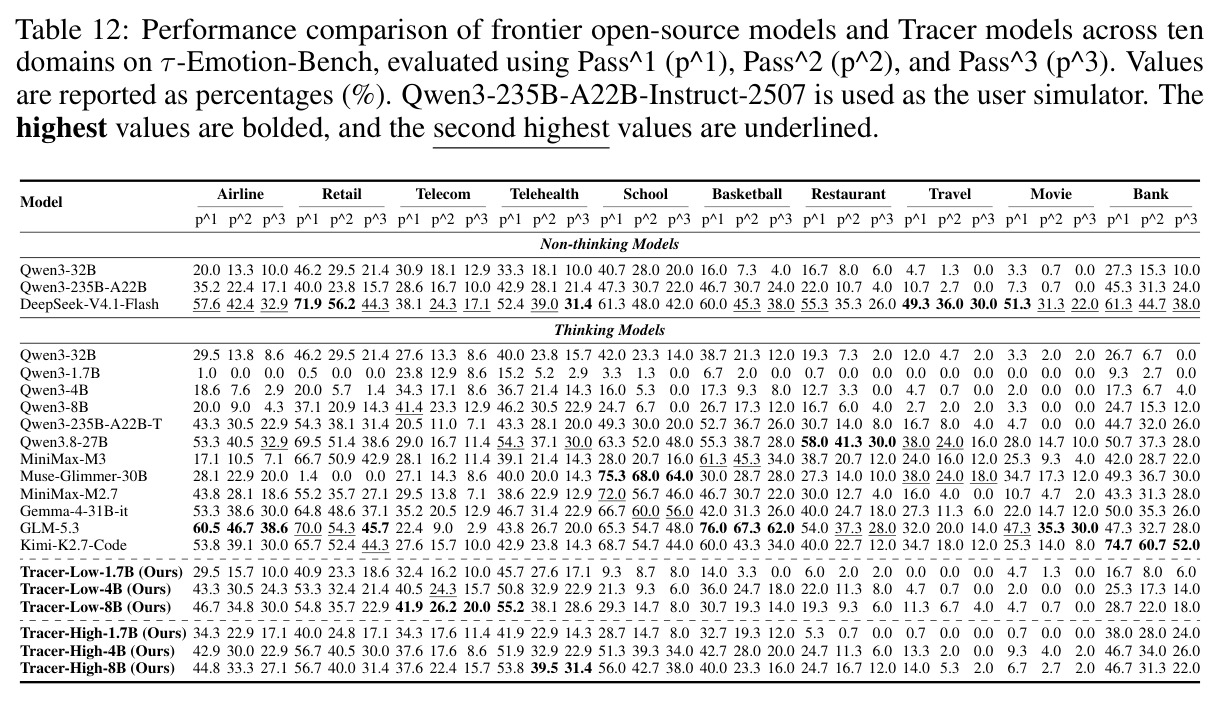
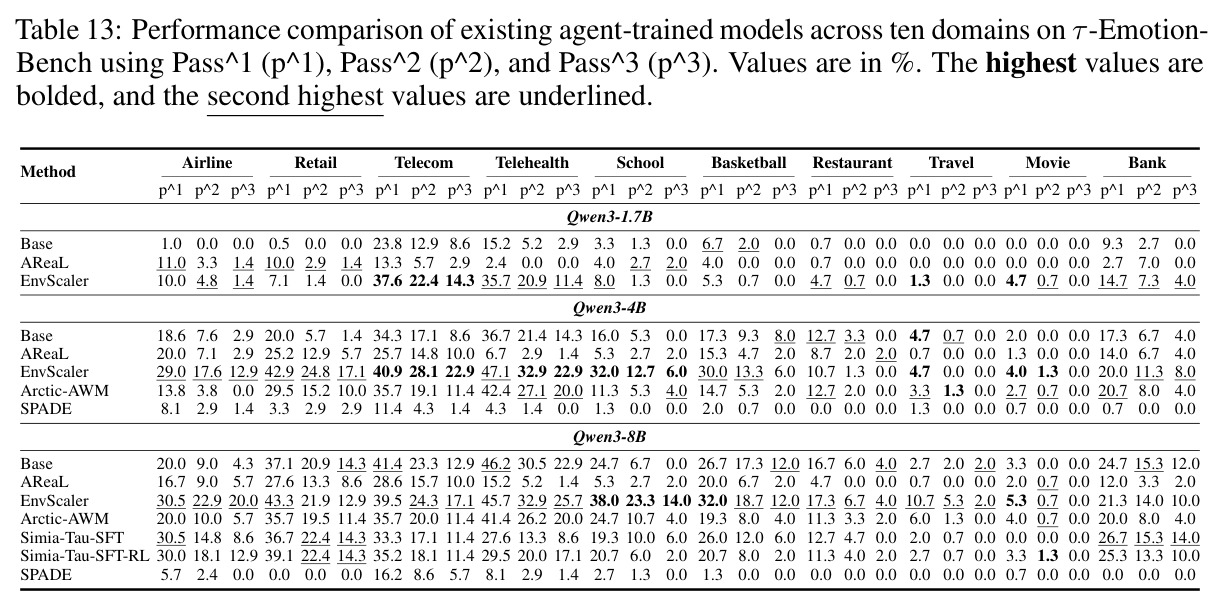
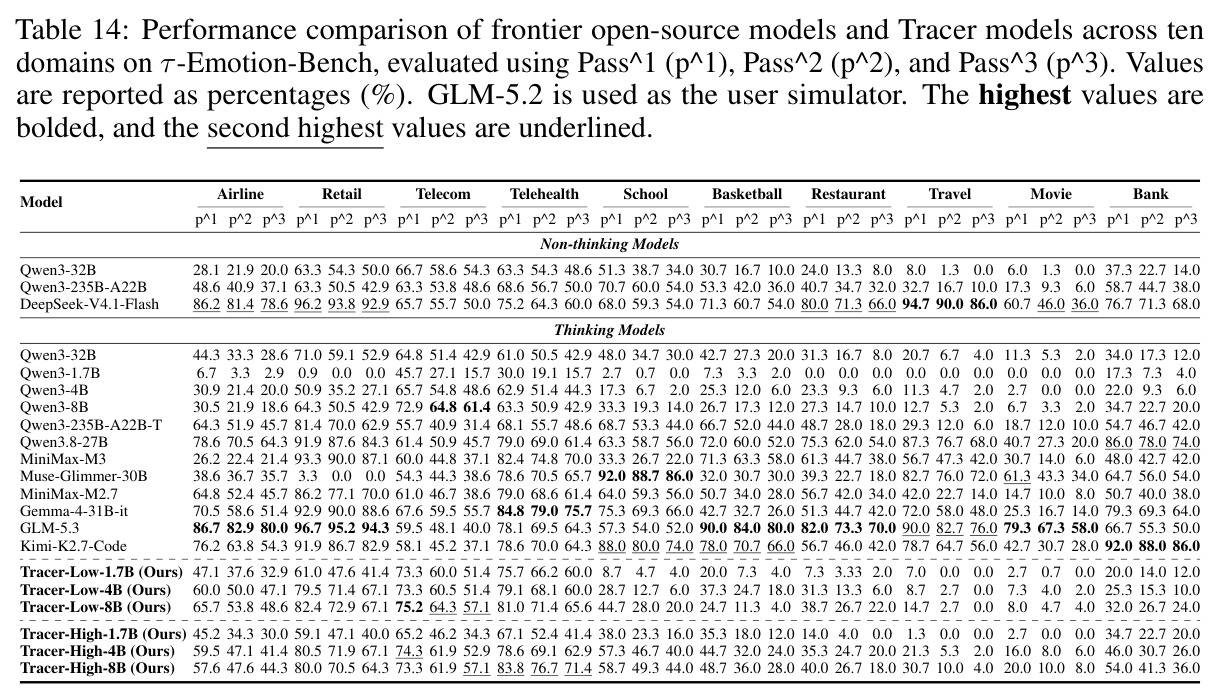
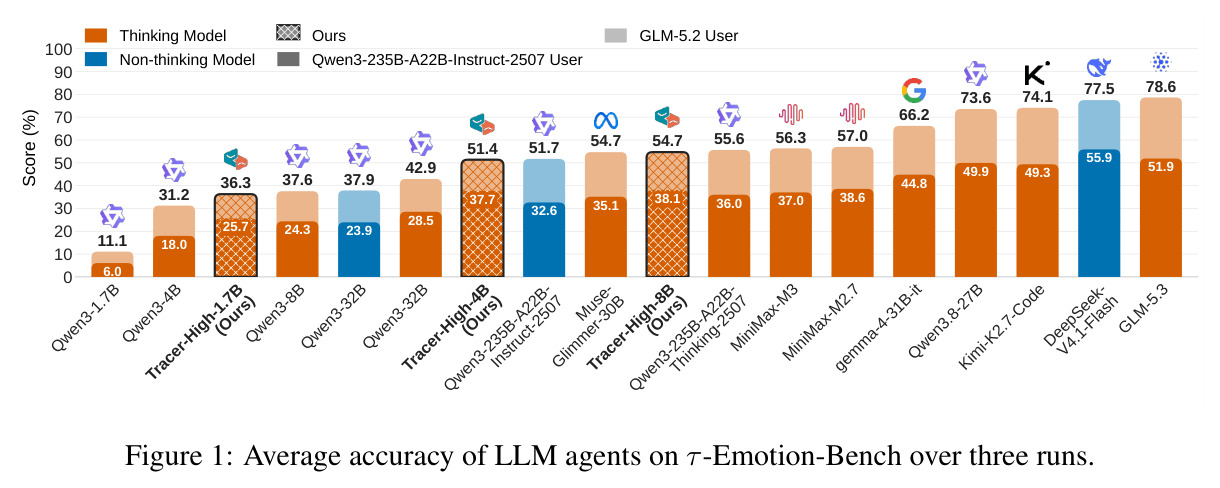
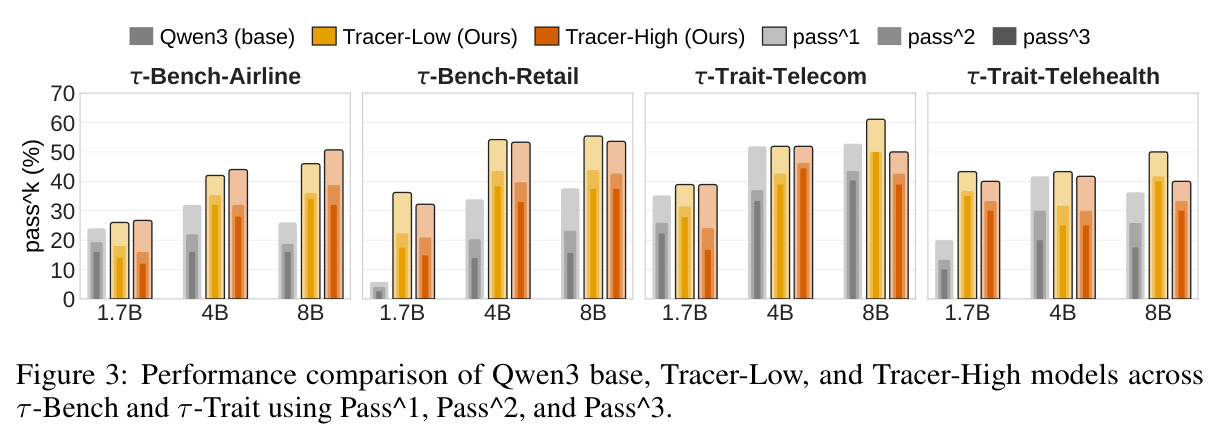
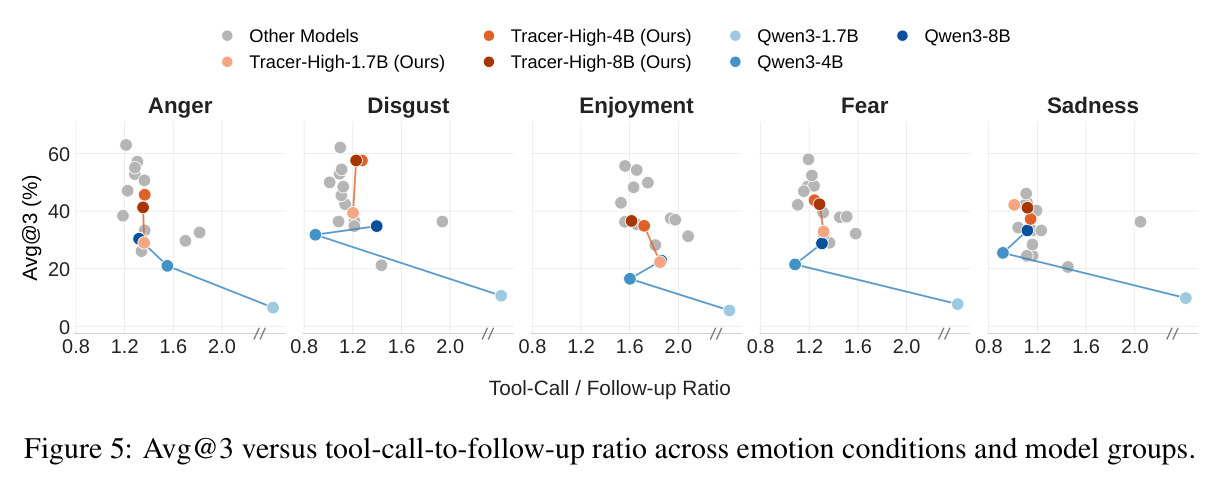
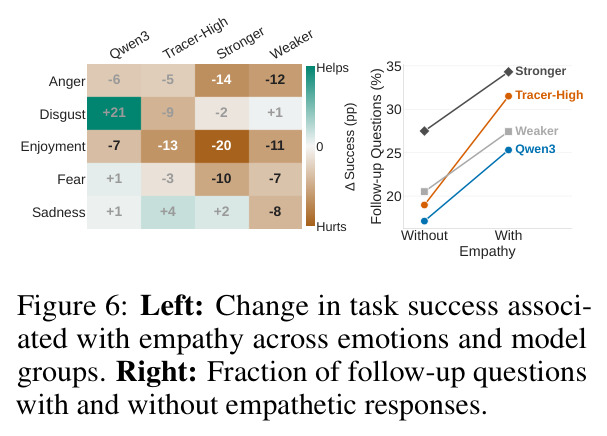
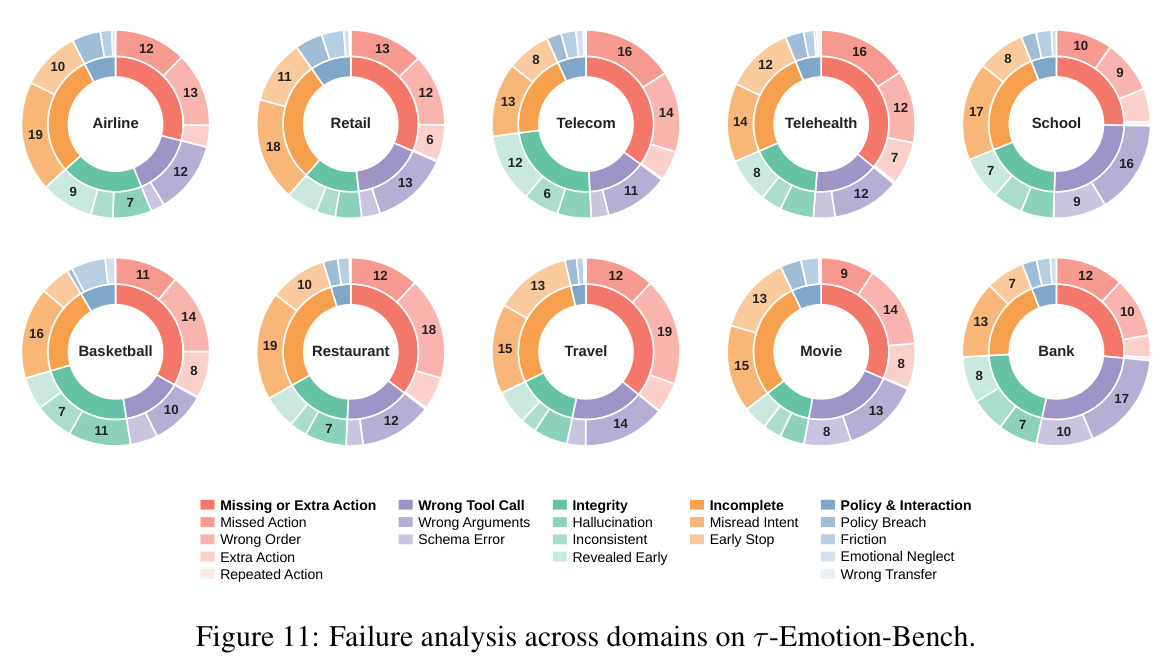
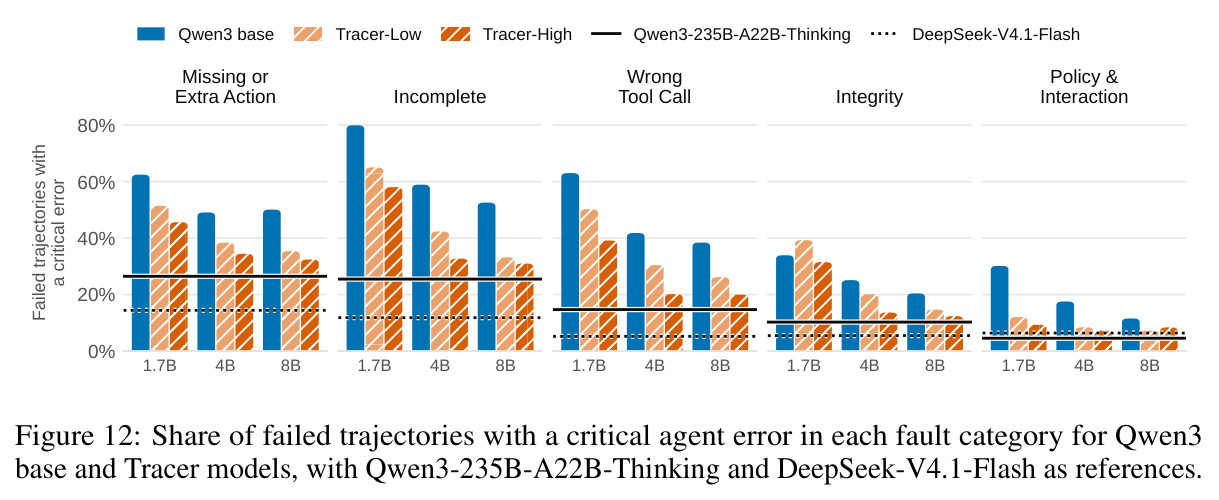
论文围绕四个问题组织实验。(Q1)前沿模型在情绪化用户面前依然脆弱:Qwen3-235B-A22B-Instruct-2507用户模拟器下,最佳的DeepSeek-V4.1-Flash仅55.9% Avg@3、32.2% Pass^3;GLM-5.3为51.9%/31.7%,Kimi-K2.7-Code为49.3%/26.1%,多数模型从Pass^1到Pass^3掉14-24个百分点;域间极不均衡,GLM-5.3在Basketball达62.0% Pass^3而Telecom仅2.9%。换GLM-5.2模拟器后整体升高但仍未饱和:GLM-5.3达78.6% Avg@3但Pass^3仅66.5%,Retail 94.3%对Telecom 40.0%。(Q2)Tracer大幅提升小模型:Qwen模拟器下Tracer-High使1.7B/4B/8B的Avg@3较基座提升13.8-19.7个百分点,Pass^3从1.2%→10.4%、3.9%→17.2%、8.4%→19.8%;Tracer-High-8B以38.1% Avg@3超过MiniMax-M3(37.0%)与Qwen3-235B-A22B-Thinking(36.0%);GLM-5.2下提升17.1-25.2个百分点,Tracer-High-8B达54.7% Avg@3,超过Qwen3-235B-A22B-Instruct的51.7%。(Q3)跨域泛化:Tracer-Low仅用1,498条4域轨迹,在6个完全未见域上8B达20.7% Pass^1/8.3% Pass^3,三个规模上的平均Pass^3均为全部对比方法最高(1.7B:2.7%、4B:7.7%、8B:8.3%,对比EnvScaler的0.7%/3.3%/7.0%)。(Q4)跨基准迁移:在τ-Bench(Airline/Retail)与τ-Trait(Telecom/Telehealth)上持续优于基座,Pass^2/Pass^3提升尤其明显。行为分析给出机制解释:高成功率对应工具执行与必要追问的适度平衡(Figure 5);错误分析(6,961条失败轨迹)显示失败集中于任务执行——缺失/多余动作占25-36%、意图误读是最常见单因(15.9%)——而情绪忽视不足1.7%;用户模拟器幻觉核查仅1.1%的失败可归咎于模拟器,排除了主要混淆因素。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| τ-Emotion-Bench 十域平均(Qwen3-235B 用户模拟器) | Avg@3 | 基准测得最佳模型 DeepSeek-V4.1-Flash 55.9%;Tracer-High-8B 38.1% | GLM-5.3 51.9%、Kimi-K2.7-Code 49.3%;Qwen3-8B 基座 24.3% | 8B小模型经Tracer微调提升13.8个百分点,反超MiniMax-M3(37.0%)与Qwen3-235B-A22B-Thinking(36.0%) |
| τ-Emotion-Bench 十域平均一致性(Qwen3-235B 用户模拟器) | Pass^3 | 最强前沿模型 DeepSeek-V4.1-Flash 32.2%;Tracer-High-8B 19.8% | GLM-5.3 31.7%;Qwen3-8B 基座 8.4% | Tracer微调使8B的Pass^3从8.4%升至19.8%(+11.4 pp),1.7B从1.2%升至10.4%(+9.2 pp) |
| τ-Emotion-Bench 十域平均(GLM-5.2 用户模拟器) | Avg@3 | Tracer-High-8B 54.7% | Qwen3-8B 基座 37.6%;Qwen3-235B-A22B-Instruct-2507 51.7% | +17.1 pp(8B),三规模提升17.1-25.2 pp;8B微调后超过235B instruct模型 |
| 六个未见域OOD泛化(School/Basketball/Restaurant/Travel/Movie/Bank) | 平均 Pass^3 | Tracer-Low-8B 8.3%(仅用1,498条4域训练轨迹) | EnvScaler-8B 7.0%(9,000条轨迹)、Simia-Tau-SFT-RL 2.7%(91,204条)、AReaL 1.0% | 数据量减少6-60倍的同时,三个规模(1.7B/4B/8B)的平均Pass^3均为全部对比方法最高 |
| 跨基准迁移(τ-Bench Airline/Retail、τ-Trait Telecom/Telehealth) | Pass^1/Pass^2/Pass^3 | Tracer-Low与Tracer-High在全部三个规模、全部四个域上均优于对应Qwen3基座 | Qwen3-1.7B/4B/8B 基座 | 训练任务与用户模拟器均与评测基准不同仍保持提升,证明学到的是可迁移交互行为而非记忆 |
| 失败轨迹错误归因(错误分析) | 故障占比 | 情绪忽视 <1.7%;Tracer-High使所有故障类别全规模下降(4B降10.4-26.2 pp、8B降3.2-21.6 pp) | 缺失/多余动作25-36%、意图误读15.9%为最大单因;基座8B错误工具调用占失败轨迹38.4% | 8B错误工具调用38.4%→20.0%,未完成解析52.6%→31.0%,且总失败数从1,284降至1,052 |
局限与改进
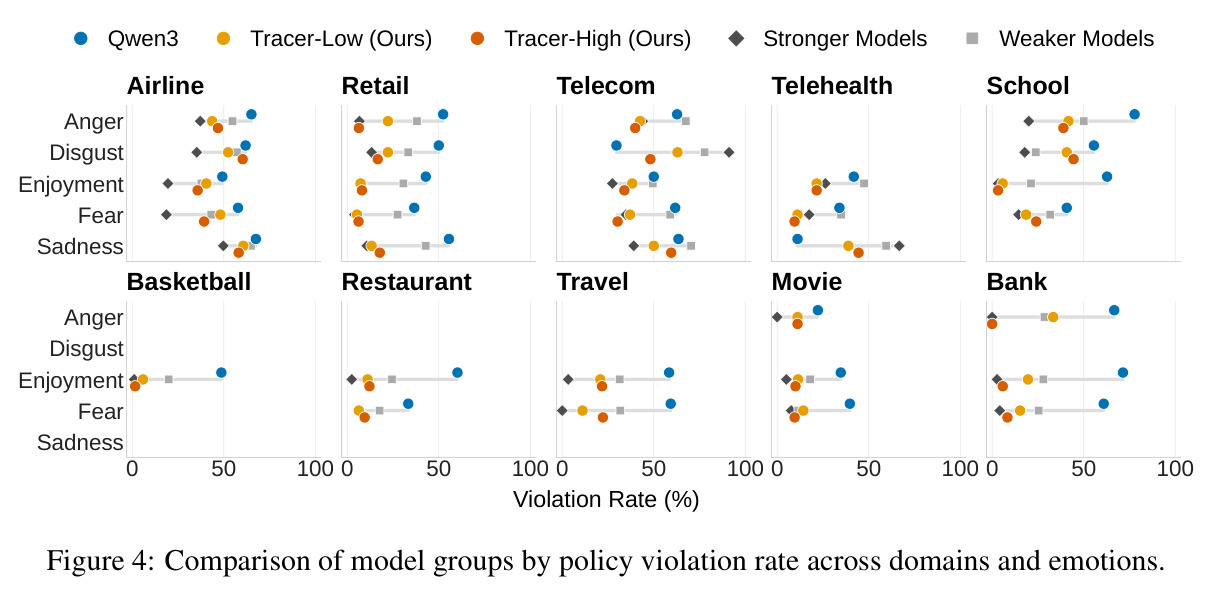
作者明确承认两点局限:其一,Tracer生成的数据只用于监督微调,其作为强化学习奖励信号的潜力尚未验证;其二,研究范围限于工具调用智能体,编码、网页等其他智能体形态未涉及。我补充几点观察:(1)情绪由LLM模拟器‘表演’,同一模型在两个模拟器下绝对分差可达20多个百分点(DeepSeek-V4.1-Flash从55.9%到77.5% Avg@3),说明结论的绝对数值对模拟器选择高度敏感,情绪的真实性与生态效度存疑;(2)错误分析显示情绪忽视不足1.7%、失败主因仍是执行错误,这意味着在这套harness里情绪更多是增加对话噪声与终止风险,而非真正考验共情能力,‘Emotion’的实际作用可能被名字夸大;(3)策略违反在微调后依然严重——更强模型组在Telecom的策略违反率仍高达91%、Telehealth约67%,2千条量级的SFT无法修复策略遵循,这是论文自己呈现但未充分讨论的问题;(4)训练数据情绪分布偏斜,Excitement+Peace合计占Tracer-High近60%,负面情绪下的成功轨迹相对稀缺;(5)Figure 8的交互模式对比是相关性证据而非因果证明,作者也承认数据集在其他构造维度上不同。
独立分析的弱点
弱点一:情绪注入是系统提示级的自然语言指令,情绪的动态演化缺乏显式机制——同一个焦虑条件在不同轮次如何升级、何时爆发全靠模拟器自由发挥,且情绪强度只有low/medium/high粗粒度;改进方向是引入强度-表达联合动力学模型,或用带情绪标注的真实客服对话校准模拟器的情绪轨迹。弱点二:###UNSATISFIED###的触发标准由模拟器隐式决定,是黑盒——合理的关键澄清可能被误判为低效追问,真正的低效也可能被容忍;改进方向是训练显式的满意度打分模型、公开终止阈值并报告误杀/漏杀率。弱点三:SFT只用成功轨迹,‘用户中途离场’的526条-1轨迹蕴含的恢复策略(如何安抚、如何道歉后拉回正轨)被完全丢弃;改进方向是用这些负例做DPO或RL,直接学习从不满边缘挽回交互。弱点四:策略遵循问题未被交互数据解决(Telecom强模型违反率91%),说明域策略推理需要专门的课程或检索增强,而非通用交互轨迹;改进方向是在Tracer中加策略检查器反馈回路,把策略违反案例转化为纠错训练数据。弱点五:情绪分布偏斜(Excitement+Peace约60%)意味着模型在愤怒/恐惧下的学习信号偏少,而这恰是最考验交互的场景;改进方向是按情绪族重加权采样或定向生成负面情绪成功轨迹。
未来方向
作者提出的方向:把Tracer数据用作强化学习的监督信号——交互感知奖励天然适合做reward model或过程奖励的来源;以及把基准与管线扩展到编码、网页操作等其他智能体形态。基于成果可延伸的方向:(1)情绪课程学习:按Enjoyment→Sadness→Fear→Anger的难度顺序安排训练,观察负面情绪训练对泛化的影响;(2)情绪感知的奖励塑形:把用户满意度变化率(如每轮后的不满概率)作为过程奖励,而非只在回合末给±1;(3)真实人类在环验证:邀请真人扮演情绪化用户重跑关键子集,检验模拟器结论的外推效度,论文附录E.1已有人类试验雏形(验证任务可解性),可扩展为系统对照;(4)把594种条件用作诊断探针,定位模型在哪些情绪-行为组合上系统性退化(如skeptical+high urgency),做针对性数据增广;(5)错误分析显示意图误读占15.9%为最大单因,可专门微调‘主动复述确认意图’的机制并与Tracer信号结合;(6)错误模式随域剧烈变化(Telecom完整性错误23.8%对Airline解析错误29.1%),提示按域定制失败恢复策略的空间。
复现评估
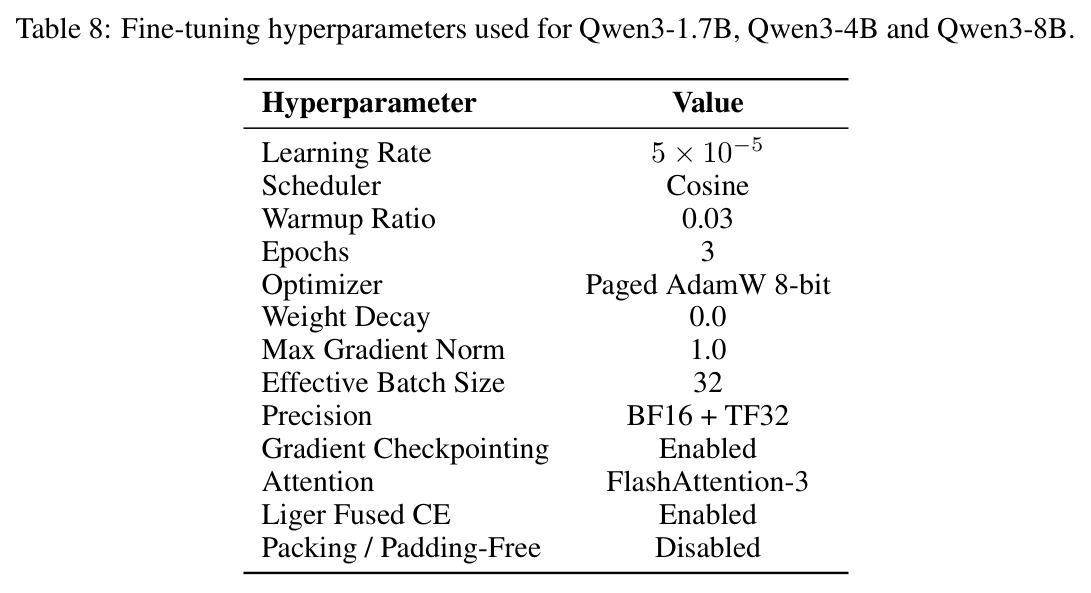
复现条件较好。模型(HuggingFace: tau-emotion-bench/models)、数据集(tau-emotion-bench/datasets)、代码(github.com/sahsaeedi/tau-emotion-bench)、项目网站全部开源。评测需τ-Bench harness + vLLM(OpenAI兼容API)服务被测模型,用户模拟器为Qwen3-235B-A22B-Instruct-2507或GLM-5.2(均开源权重),用户模拟器温度0、每任务3次试验、最多200轮;580任务×约18个模型的评测量不小,作者用ASU的Gaudi集群加自有GPU完成。训练门槛低得多:TRL库 + 4块H100,最大序列长32,768,学习率 $5\times10^{-5}$、cosine调度、3 epochs、Paged AdamW 8-bit、有效batch 32、BF16+TF32、FlashAttention-3,超参在附录Table 8完整给出,且Qwen3-1.7B/4B/8B都是可直接下载的基座。数据管线的全部提示词模板在附录D.3,域策略文档在D.2全文公开。主要不确定性:任务生成依赖Qwen3-235B-A22B-Instruct、Qwen3.8-27B、GPT-4.1等特定模型,换模型重跑管线结果可能漂移;人工修订环节(101处真值修正、23处ID替换、23处重写)的具体判定标准未完全形式化,完全无人值守复现580个任务的质量有难度。总体属于中等偏易的复现难度,数据与代码开源是最大加分项。
论文图表
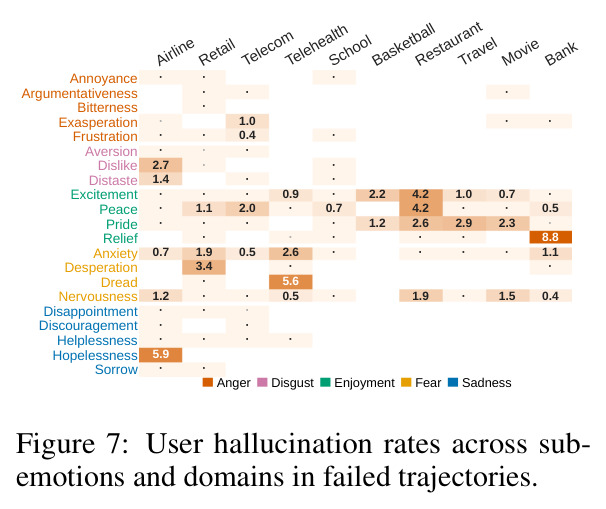
细粒度情绪×域矩阵,显示失败轨迹中模拟用户幻觉(说出任务指令中不存在的信息)的比率。绝大多数情绪-域组合为零或接近零,仅有个别孤立高值(如Hopelessness 5.9%在Airline、Dread 5.6%等),总体已确认的用户错误仅占失败试验的1.1%。
回应基准最大的潜在混淆:情绪条件是否让模拟器跑偏。该图是基准有效性的关键证据,读结果前必须确认这一点。
最终Tracer-Low(1,498条)与Tracer-High(1,958条)训练集的细粒度情绪构成。两者都覆盖多样情绪条件,Excitement+Peace合计占Tracer-Low 56.9%、Tracer-High 59.3%;Tracer-High的Pride占比更高(11.3%对6.5%),Anxiety更低(8.8%对15.1%)。
让读者了解训练数据的情绪偏斜情况——正面情绪占比近六成,这是评估结论普适性与改进数据配比的重要依据。