GroundGUI:高质量数据与蒸馏转强化学习的GUI视觉定位 GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
发布58.6万截图的ScreenRef数据集与D2RL训练法,8B模型GUI定位超越多个32B模型
前置知识
GUI Grounding(GUI视觉定位)
把自然语言指令(如“点击设置图标”)映射到屏幕截图中可交互元素像素坐标的任务,是GUI Agent执行操作的基础能力。模型通常输出归一化坐标(本文为[0,1000]整数对)或边界框,评测指标是点击点是否落在目标元素框内。
本文的数据集和训练方法全部服务于这一任务,理解坐标输出的形式才能理解位置感知加权和点在框奖励。
SFT(监督微调)及其过拟合
用标注好的(截图, 指令, 坐标)三元组直接训练模型模仿标准答案。优点是收敛快、监督信号密集(每个token都有loss);缺点是模型容易过拟合到训练数据的界面风格与布局分布,遇到分布外的专业软件或高分辨率密集界面时泛化明显变差。
SFT过拟合正是本文D2RL方法要解决的第一个问题,SFT后的模型也是OPSD教师和RL阶段的共同起点。
RLOO与稀疏奖励问题
REINFORCE Leave-One-Out是一种无critic的策略梯度方法:对每个提示采样G条回答,用组内其余回答的平均奖励作为基线计算优势。GUI定位的奖励是二值的“点在框内”判定,对难样本(小图标、空间关系查询)所有rollout可能全部点错、奖励全为0,组内无方差,策略梯度接近零,学习信号稀疏。
稀疏奖励是D2RL要解决的第二个问题,也是本文批评纯RL路线(GRPO类)的核心论据。
OPSD(在线策略自蒸馏)
不同于让学生模仿固定数据集,OPSD在学生自己采样的前缀上,用教师模型的逐token分布提供密集监督,目标是最小化反向KL散度。本文中教师是SFT策略的冻结副本,且训练时能看到特权信息——真值框高亮叠加与文字定位提示,学生只看原始截图;教师不参与推理。
OPSD是D2RL第一阶段的灵魂,理解“教师在学生轨迹上逐token纠错”才能理解它如何桥接SFT与RL。
拒答样本(Refusal Samples)
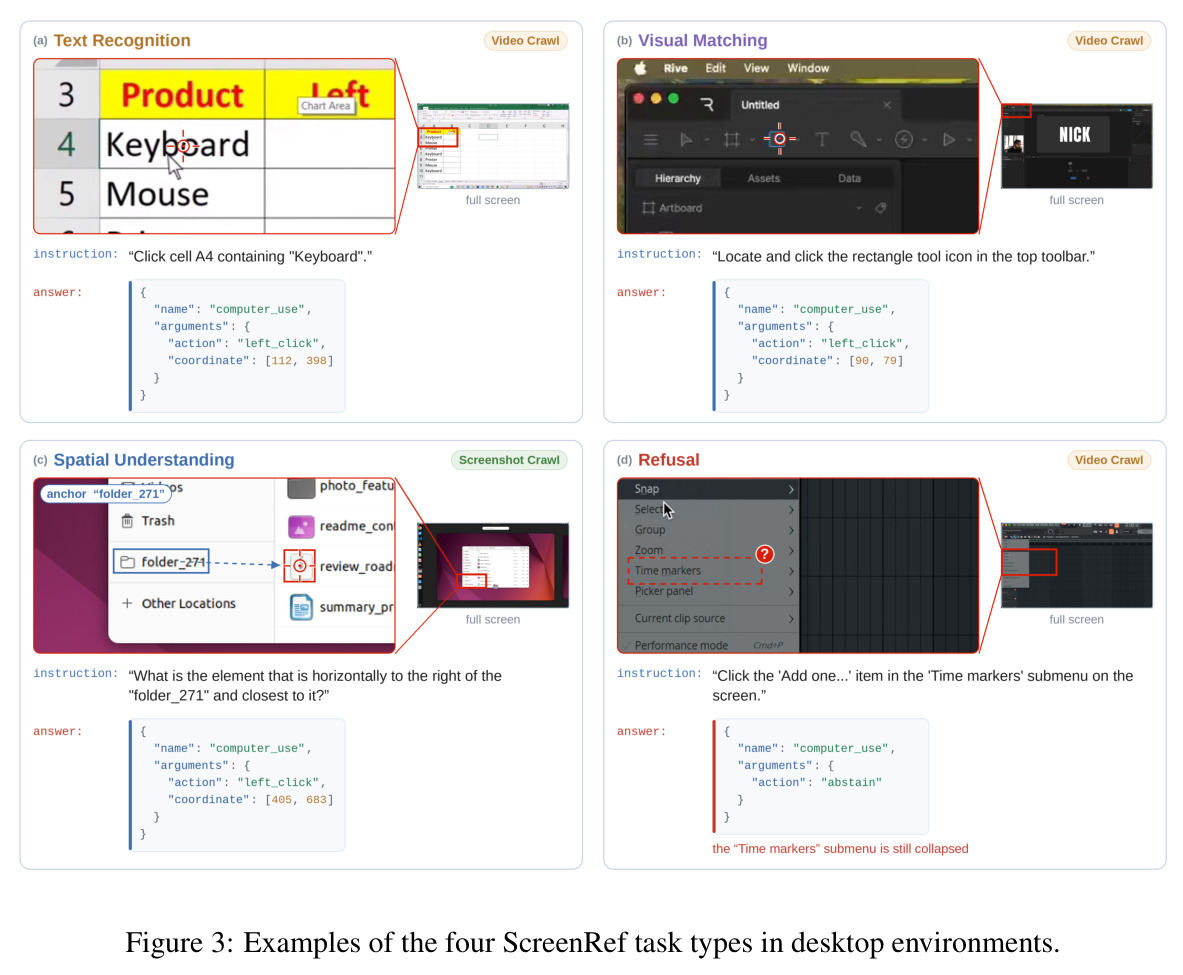
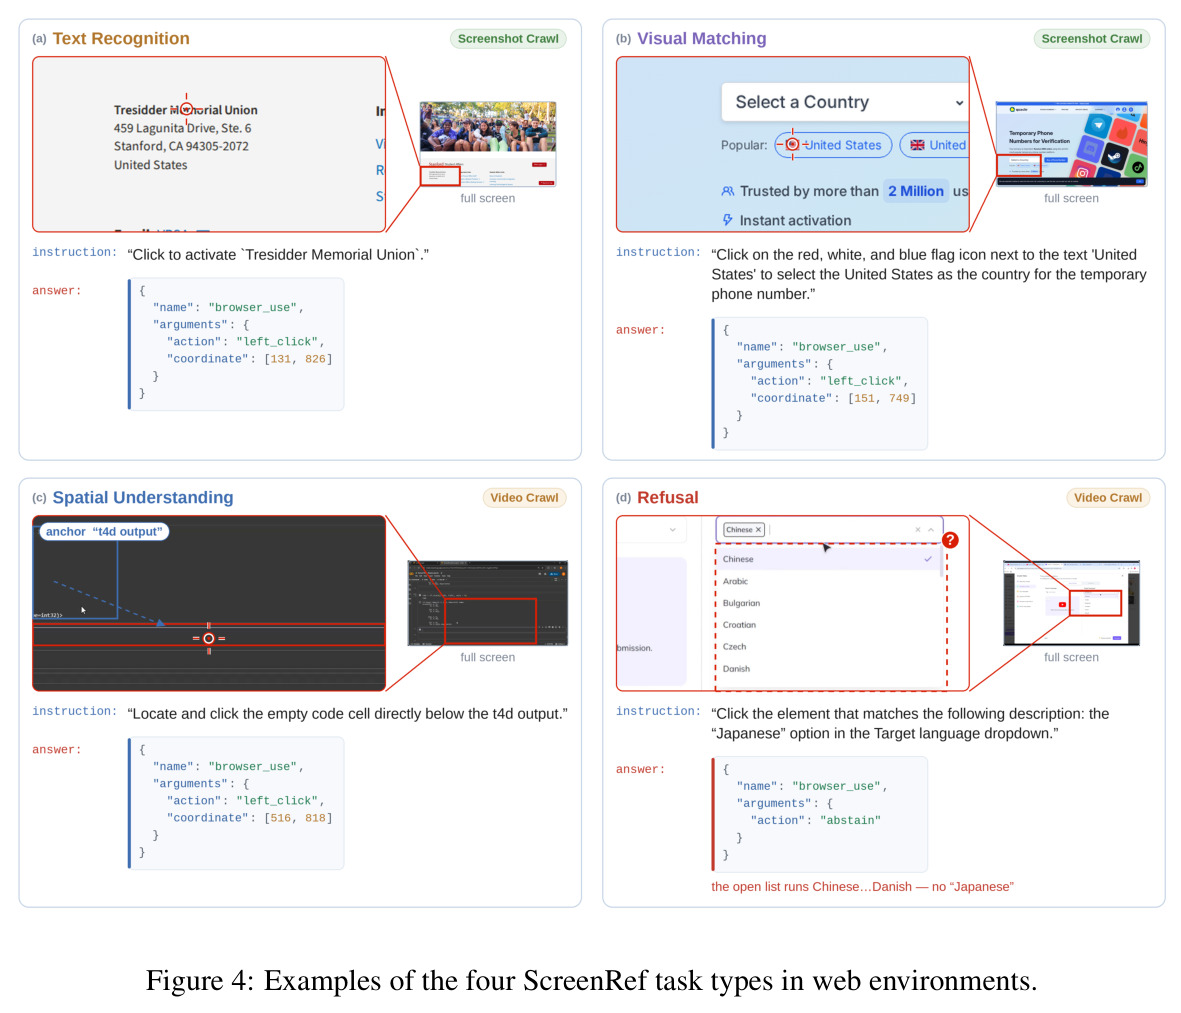
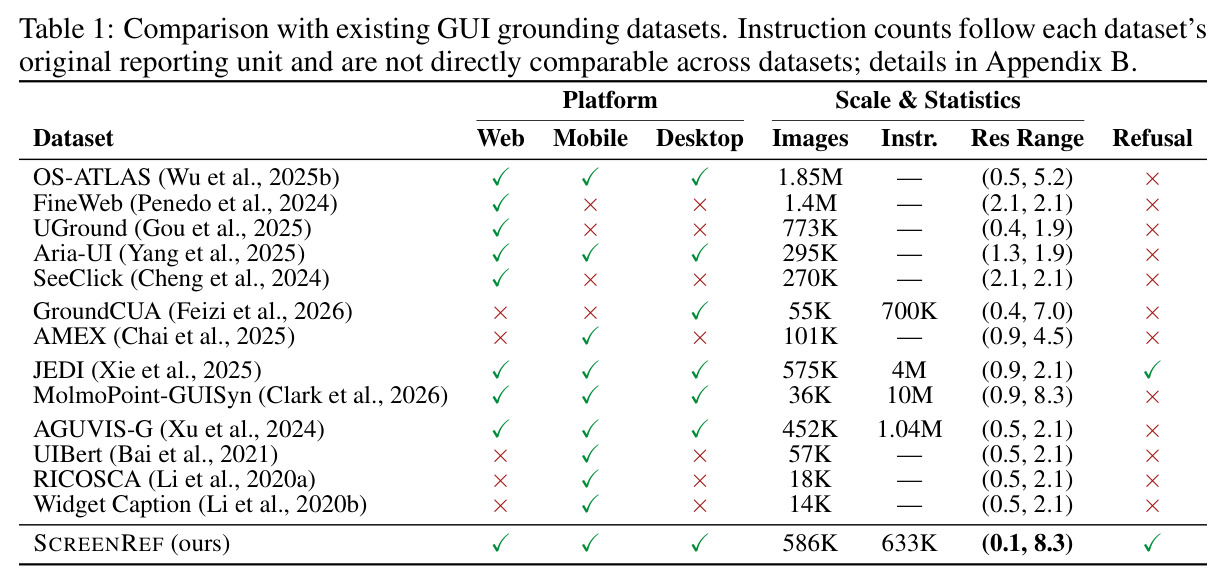
指指令所指的目标元素根本不在截图中的样本,正确行为是输出“不可定位/放弃操作”而非强行给出坐标。构造方式是将指令与不相关截图随机配对再用模型验证可行性。ScreenRef是除JEDI外唯一系统包含此类样本的开源grounding数据集(约2.2万条,占3.5%)。
拒答能力直接对应OSWorld-G的refusal子项得分,是ScreenRef区别于其他数据集的关键卖点。
研究动机
尽管GUI grounding的评测基准覆盖了桌面、Web和移动端,适合训练的高保真数据却出奇稀缺。闭源模型(UI-TARS-2、Mobile-Agent-v3.5、UI-Venus-1.5、MAI-UI)靠私有大规模数据取得领先,社区拿不到;已开源的GroundCUA和ScaleCUA按作者引用的统一对比协议看,标注准确性与多样性有限,训练出的模型次优。数据侧的具体痛点是:OS-ATLAS用无障碍树抽取桌面元素,各平台无障碍API不一致引入标签噪声;JEDI靠合成界面扩量,屏幕过于简化,无法反映真实桌面软件高分辨率、密集布局与专业图标语义的复杂性。训练侧同样两难:SFT容易过拟合到特定域;GRPO类强化学习(GUI-R1、GUI-G2、GUI-C2、InfiGUI-G1)在难样本上所有rollout都点错、奖励全为零,梯度信号稀疏,泛化提升受限。
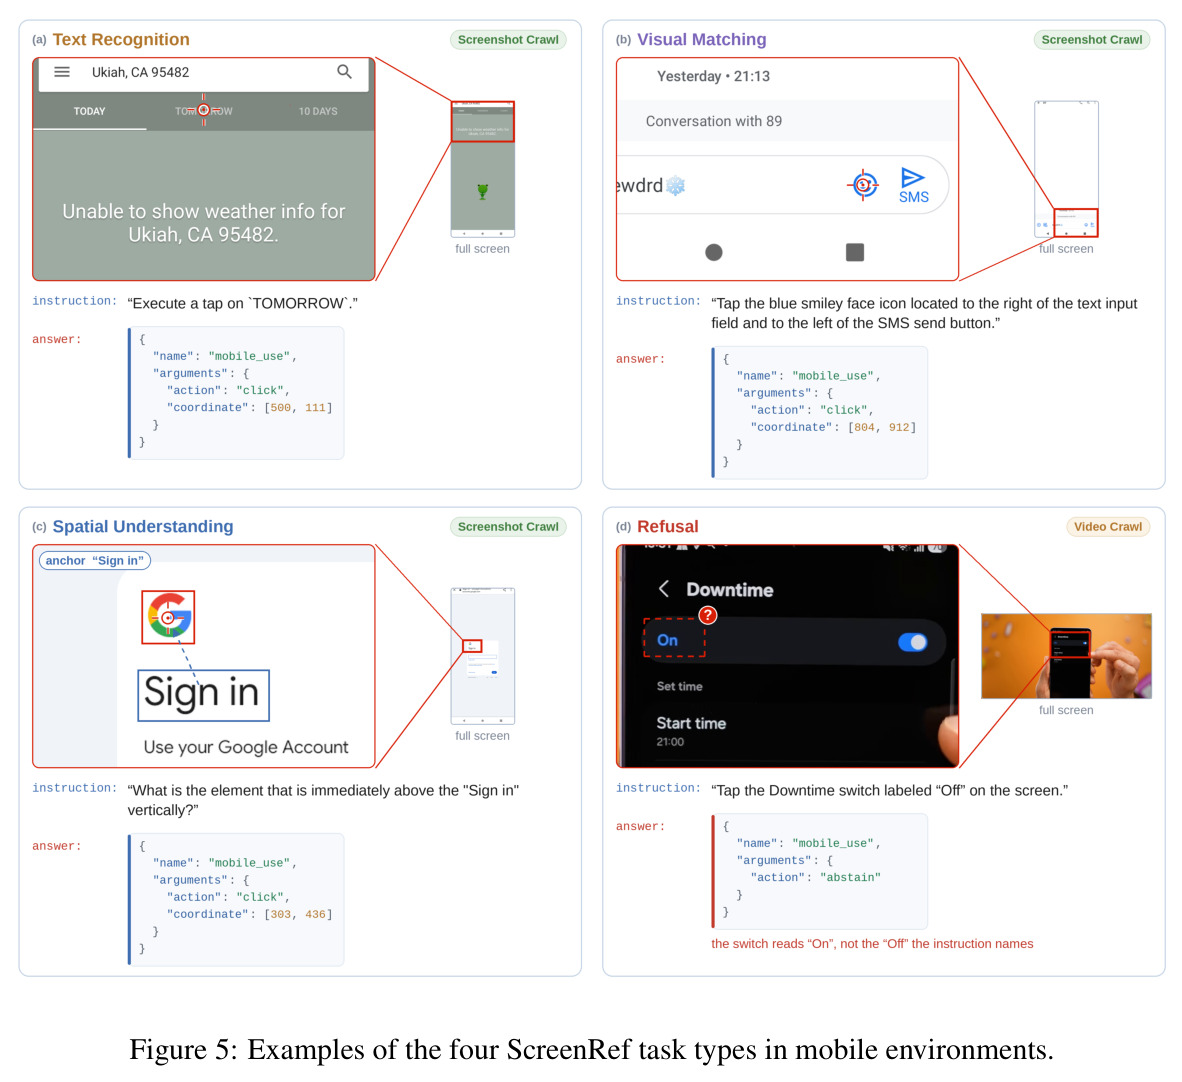
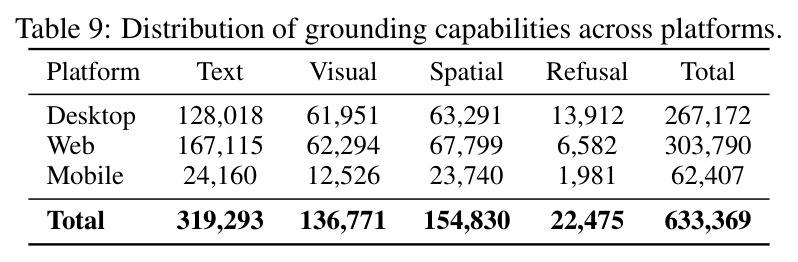
本文的目标是本文目标有三层。其一,构建ScreenRef:覆盖桌面/Web/移动三平台、58.6万张截图(585,981)、63.3万条指代指令(633,369)的grounding数据集,分辨率横跨0.1M到8.3M像素,包含文本识别(319,293条)、视觉匹配(136,771条)、空间理解(154,830条)和拒答(22,475条)四类任务,并以多级过滤与模型验证链保证标注质量。其二,提出D2RL两阶段后训练方法:先用OPSD密集蒸馏塑造更强的RL初始策略,缓解稀疏奖励,再用RLOO优化泛化与定位精度。其三,在Qwen3-VL-8B-Instruct上训练出GroundGUI-8B,在8B规模全面超越开源数据训练的模型、追平甚至超越闭源数据训练的模型(目标战绩:ScreenSpot-V2 95.2%、ScreenSpot-Pro 63.9%、OSWorld-G 65.4%、MMBench-GUI L2 86.8%、UI-Vision 38.3%),并向社区完整开源数据、代码与模型。
与已有工作不同的是,本文的独特视角是把“数据质量”和“RL初始策略”当作两个被低估的杠杆。数据上,与GroundCUA、ScaleCUA、Wild2GUI不同,它坚持真实界面截图加教程视频交互帧的双来源,配以多模型交叉验证链,且是除JEDI外唯一包含拒答样本的grounding数据集——教会模型识别“目标根本不在屏幕上”而非强行乱点,这一子项在OSWorld-G上立竿见影。训练上,当同行都在奖励函数上做文章(GUI-G2的高斯奖励、GUI-C2的难度感知、InfiGUI-G1的自适应探索)时,作者抓住一个被忽视的点:RL的瓶颈往往不在奖励设计,而在初始策略太弱——如果所有rollout都失败,再好的奖励也算不出组内相对优势。于是它引入OPSD(在线策略自蒸馏),让见过真值框特权信息的教师模型在学生自己的轨迹上逐token纠正,先塑造强初始策略,再让RLOO的组内对比真正可分辨。
核心方法
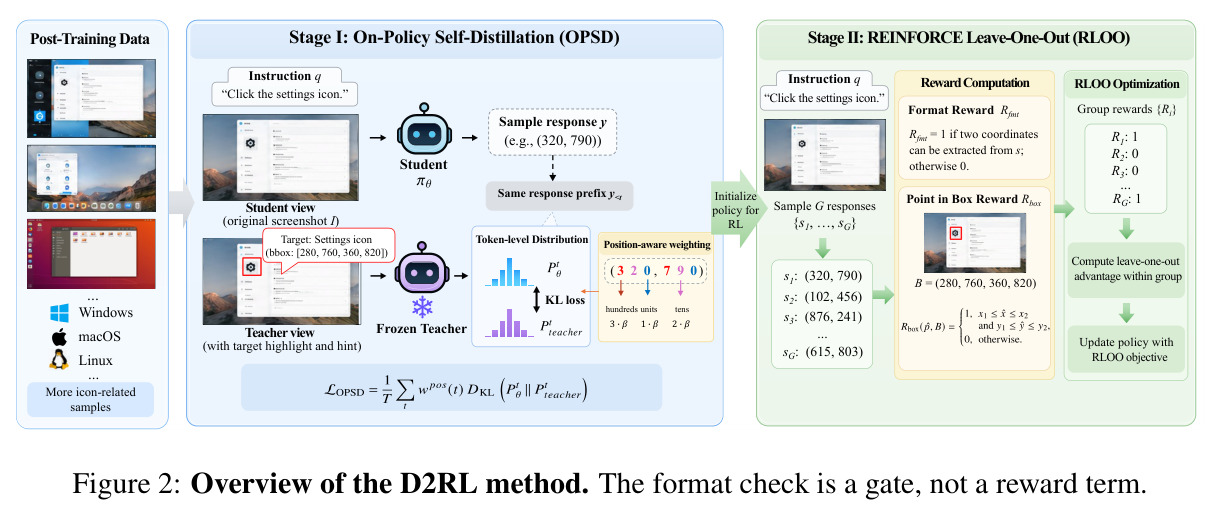
直观理解:OPSD像一位“开卷批改”的老师——学生先自己动手写答案(在原始截图上采样坐标序列),老师手里拿着标了真值框和文字提示的截图,在学生写出的每个token位置指出“此处分布应如何”;RLOO则是随后的“闭卷刷题”,学生只看原始截图,按点击是否命中拿二值分,与组内同伴对比得出相对优势再更新。技术路线上,作者以Qwen3-VL-8B-Instruct为基座:先在ScreenRef上SFT两轮(4块B300 GPU,全局batch 32,学习率1e-6,AdamW,第二轮将文本识别与拒答样本的损失权重降到0.2);再进入D2RL:Stage I在12K来自GroundCUA的后训练样本上跑一个epoch的OPSD反向KL蒸馏,带位置感知加权;Stage II跑一个epoch的RLOO,每个提示采样8条rollout,用点在框内二值奖励,无critic、无KL惩罚(8块B300,batch 42,cosine学习率调度)。消融显示该组合把5个基准平均分从纯SFT的68.0%提升到69.9%。
核心创新是D2RL:把OPSD作为RL的显式准备阶段,与已有方法的本质区别在反馈粒度与信息来源。GRPO类方法只在轨迹级给标量奖励,难样本上8条rollout全部点偏时奖励全为0、组内无方差,学不到东西;OPSD则提供token级密集监督——教师是SFT策略的冻结副本,训练时看到特权信息(真值框高亮叠加+目标名称与边界框的文字提示),学生只看原始截图,两者对学生自采样前缀的token分布做反向KL匹配,损失为 $\mathcal{L}_{OPSD}=\frac{1}{T}\sum_{t} w_{pos}(t)\,D_{KL}(P_{\theta}^{t}\,\Vert\,P_{teacher}^{t})$,即使rollout奖励全为0学生也能获得梯度。针对坐标的误差结构——百位错导致数百像素偏差、个位错只差几点——引入位置感知加权 $w_{pos}(t)=\beta\cdot k_t$($k_t$为位阶:个位1、十位2、百位3)。关键定位是:OPSD的目标不是提升pre-RL精度本身,而是塑造更好的RLOO初始策略。
方法步骤详情
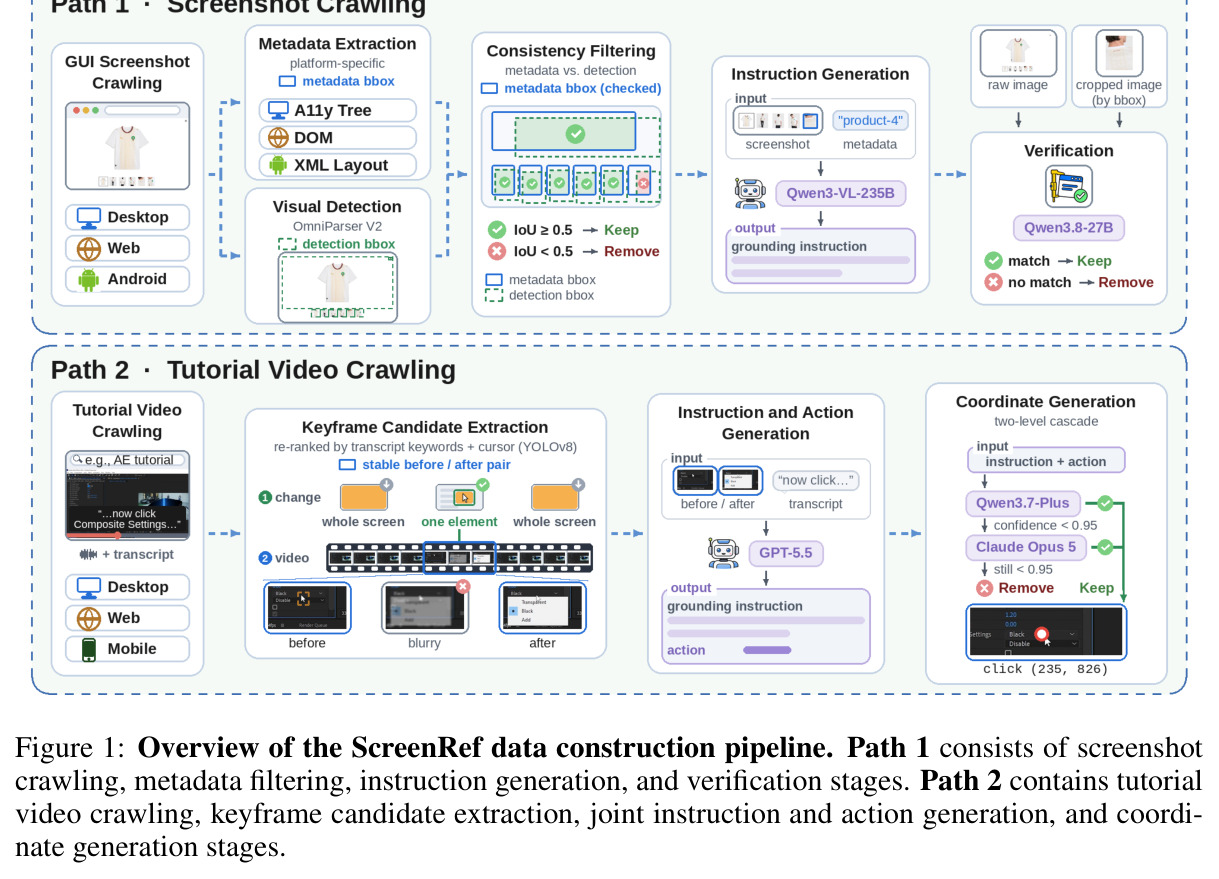
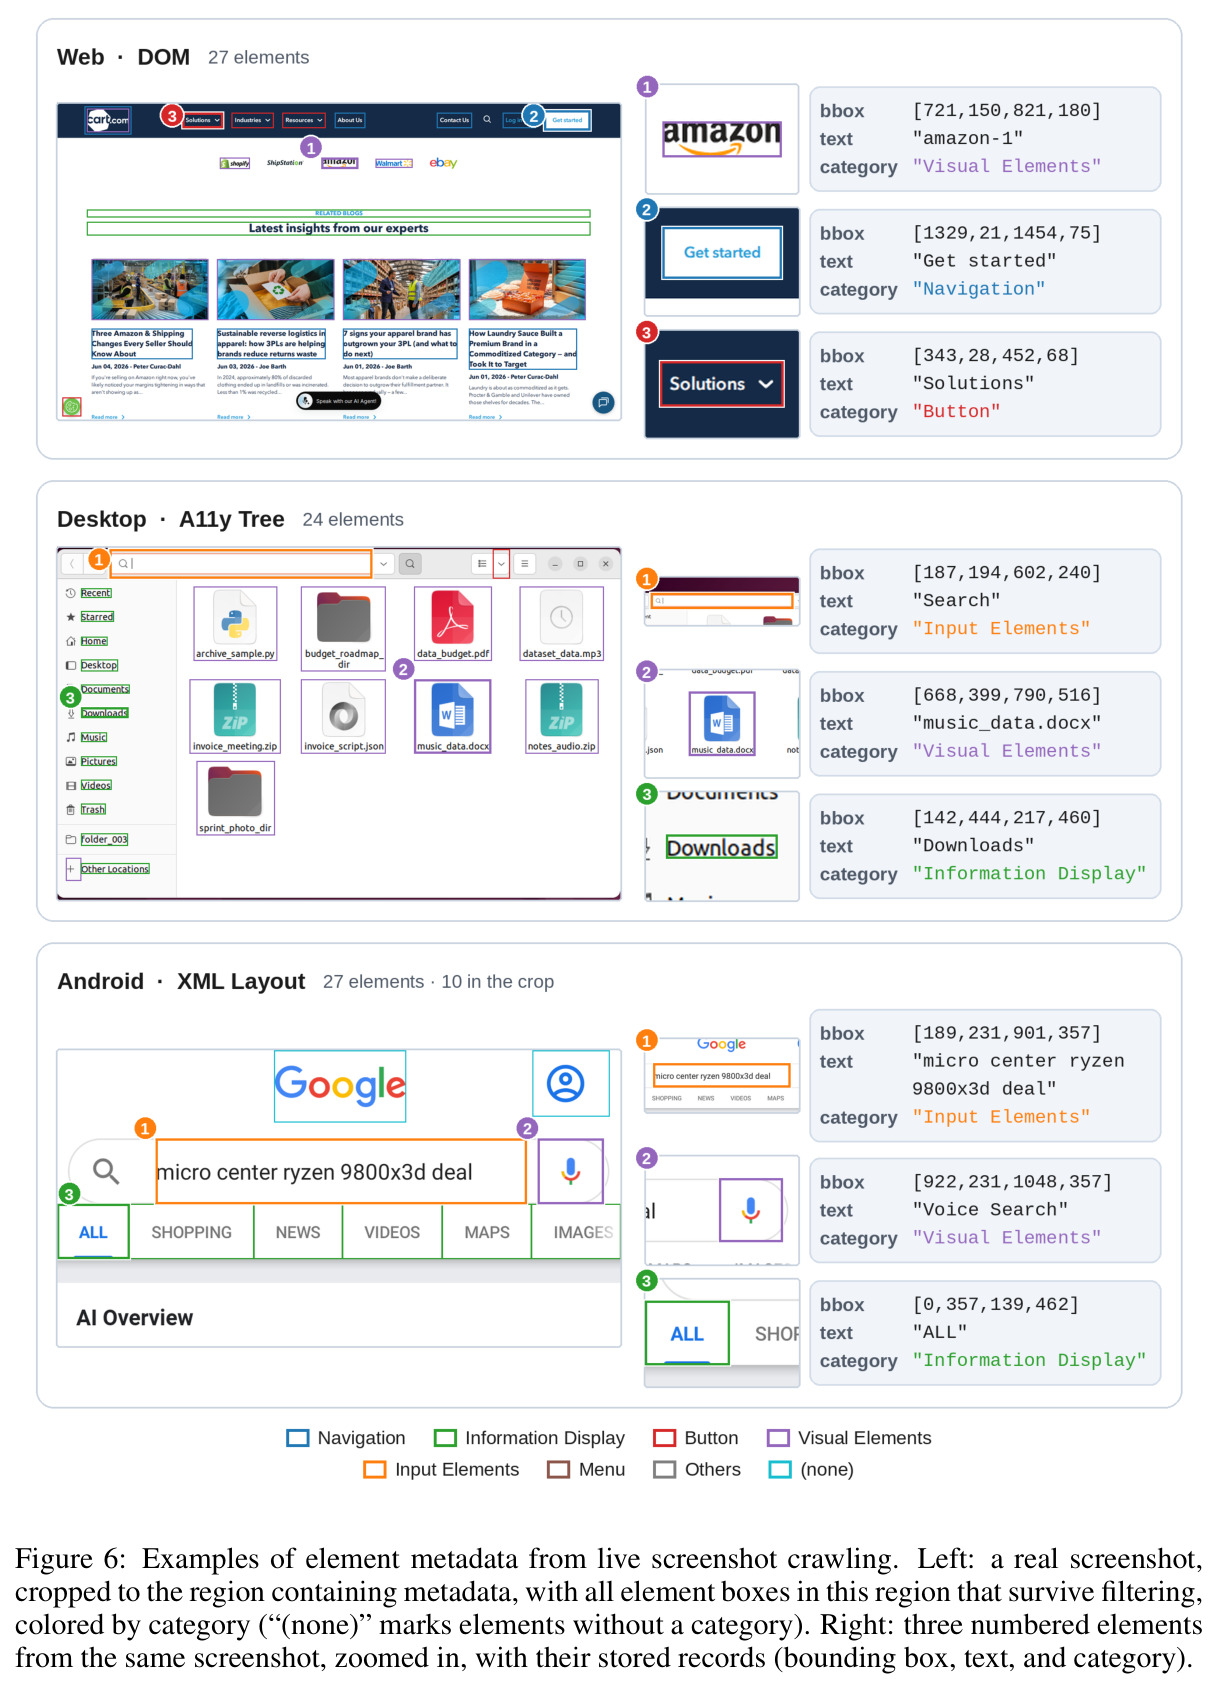
流程分数据与训练两部分。数据Path 1(产出284,531条样本):按平台抓取截图与元数据(桌面无障碍树、网页DOM、Android XML布局);用OmniParser V2与元数据框对比,IoU低于0.5的剔除;Qwen3-VL-235B生成文本识别/视觉匹配/空间理解三类指令;Qwen3.8-27B验证答案一致性。Path 2(其余约34.9万条):爬取YouTube教程视频并过滤;(i)帧差定位局部屏幕更新,结合转写动词与YOLOv8光标检测重排,每视频至多60个候选,前后向搜索最近静态帧构成帧对;(ii)GPT-5.5对帧对+转写段做任务分割与动作标注;(iii)Qwen3.7-Plus预测目标框与置信度,低于$\tau=0.95$升级Claude Opus 5,仍低则丢弃;另以随机配对构造拒答样本并验证。训练:SFT两轮后,D2RL在12K GroundCUA样本(剔除与UI-Vision重复截图)上先OPSD一epoch、再RLOO一epoch;RLOO每提示采8条,解析失败得0(格式检查是门而非奖励项),可解析则做点在框判定 $R_{box}$。
技术新颖性
新颖性体现在四点。(1)OPSD的领域定制与角色重定位:受通用语言任务OPSD与GUI-SD启发,但本文首次把它明确定位为RL的“塑形阶段”而非独立提分手段,并设计了特权教师(看真值框)对原始观察学生这一非对称设定,推理时教师即弃,不增加部署成本。(2)位置感知加权 $w_{pos}(t)=\beta\cdot k_t$ 是针对坐标token的独有设计,利用数字位阶与像素误差的单调关系,通用SFT与蒸馏方法均未考虑。(3)双路径数据引擎:真实截图元数据(IoU 0.5去噪)+教程视频自动转样本(帧差候选、GPT-5.5联合标注、置信度门控 $\tau=0.95$ 的双模型升级仲裁),并系统构造拒答样本,仅22,475条但带来OSWorld-G refusal子项22.2%的差异化优势。(4)训练配方上选RLOO而非GRPO——无critic、无额外价值网络,格式检查只做门槛不混入奖励,避免奖励项耦合;与改奖励的GUI-G2、GUI-C2路线正交,可叠加。
实验结果
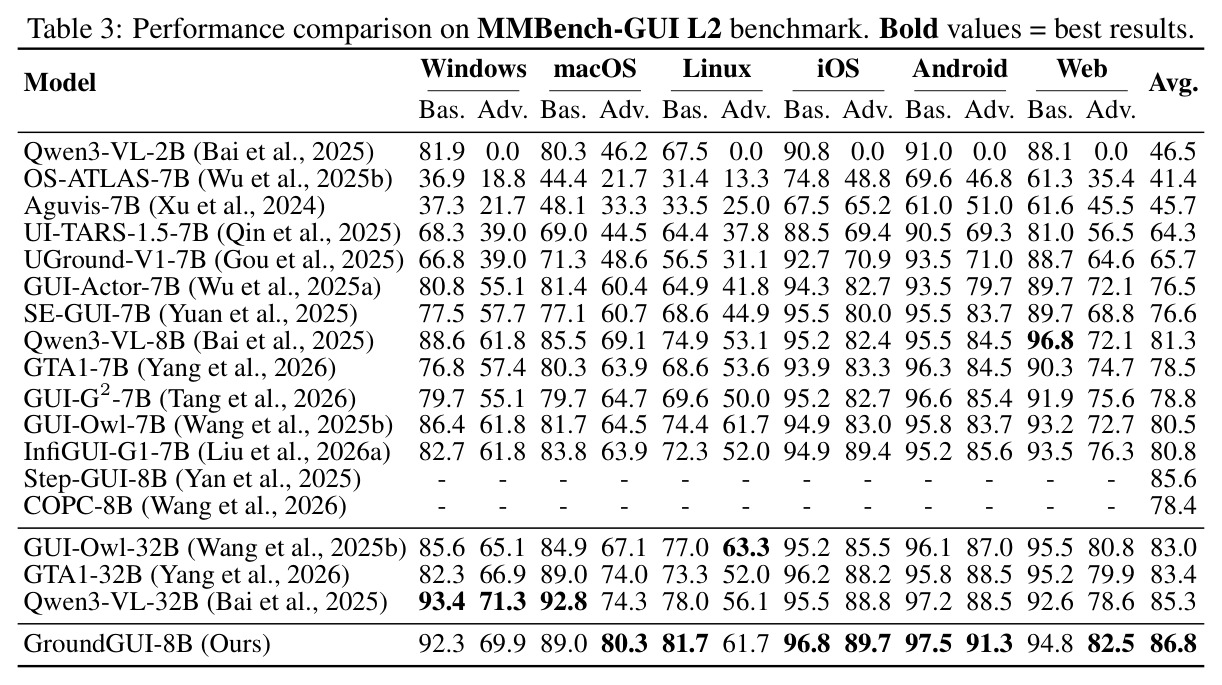
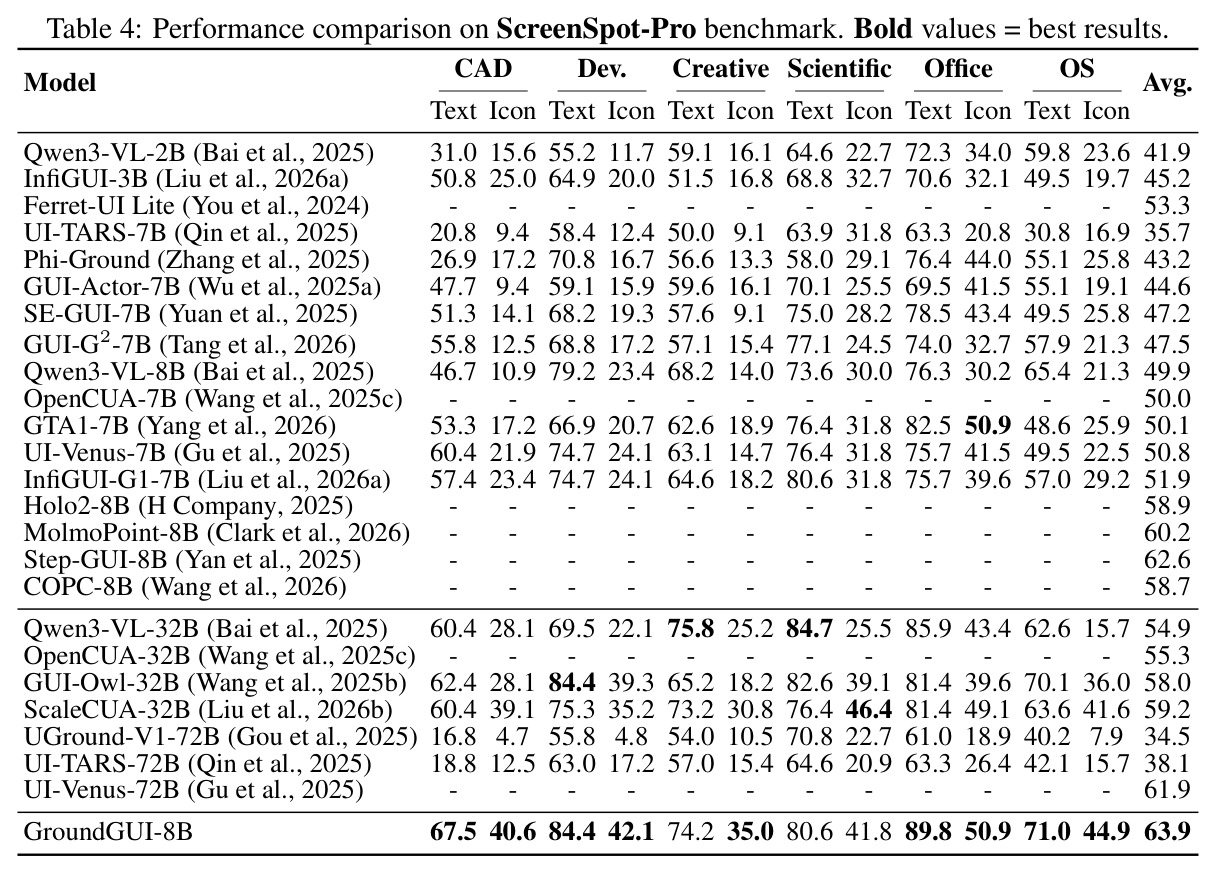
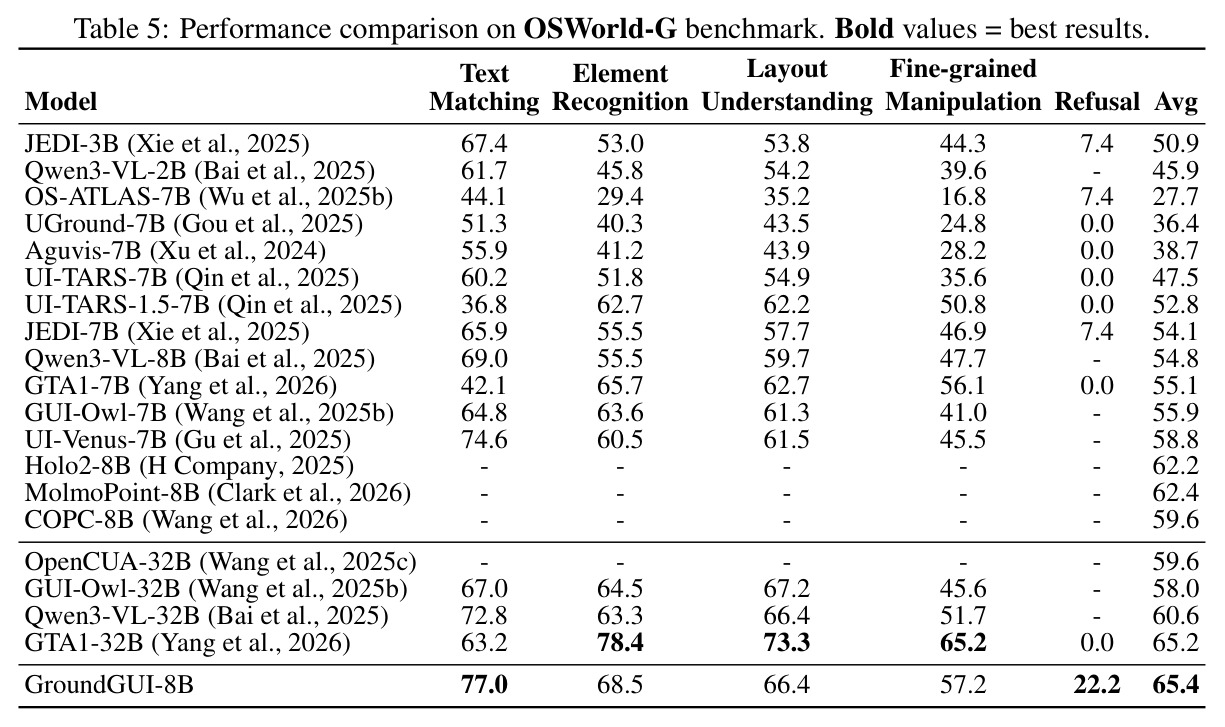
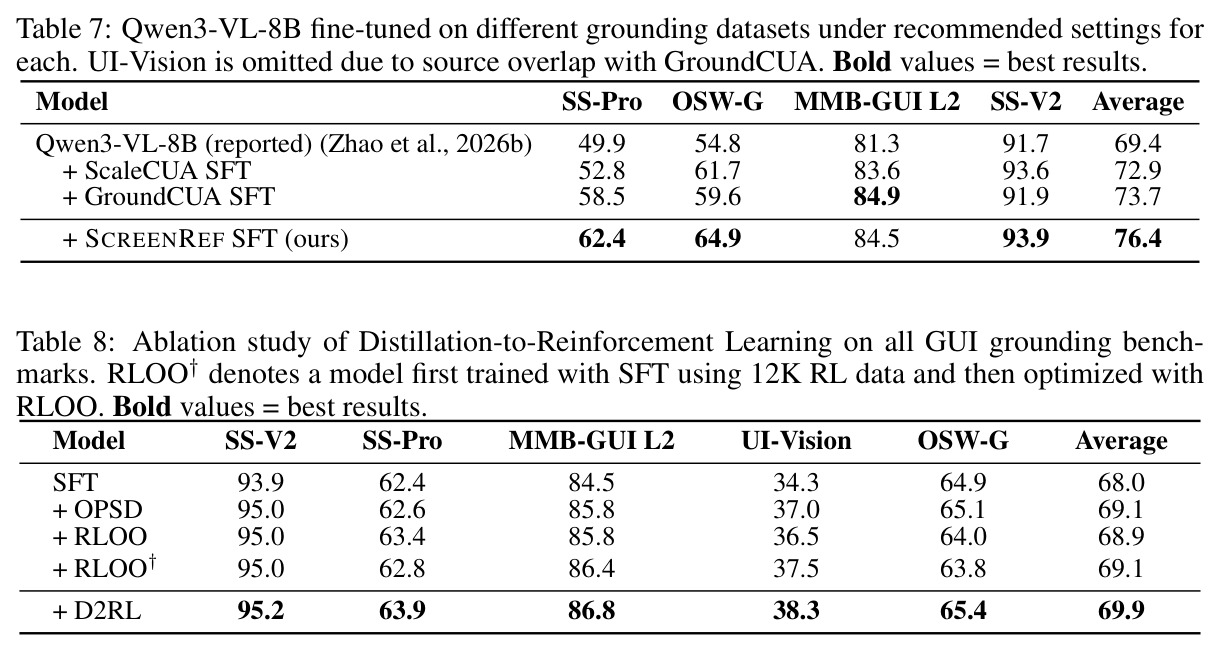
核心结果四组。(1)五基准主结果:GroundGUI-8B在ScreenSpot-V2达95.2%(8B级并列最高)、ScreenSpot-Pro 63.9%、OSWorld-G 65.4%(超GTA1-32B的65.2%)、MMBench-GUI L2 86.8%(超Qwen3-VL-32B的85.3%)、UI-Vision 38.3%(超72B的UI-Venus-72B的36.8%)。相对基座Qwen3-VL-8B提升3.5、14.0、10.6、5.5、20.8点。(2)数据集消融:同为Qwen3-VL-8B做SFT,ScreenRef四基准平均76.4%,比ScaleCUA的72.9%高3.5点、比GroundCUA的73.7%高2.7点,ScreenSpot-Pro差距最大(62.4%对52.8%)。(3)方法消融:SFT平均68.0%→+OPSD 69.1%→+RLOO 68.9%→+D2RL 69.9%,还优于RLOO†(69.1%)0.8点,证明收益来自更强初始策略而非数据多见一遍。(4)数据构成:文本识别50.4%、空间理解24.4%、视觉匹配21.6%、拒答3.5%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ScreenSpot-V2(通用GUI定位,移动/桌面/Web) | 平均准确率(%) | 95.2 | MAI-UI-8B 95.2;GUI-G2-7B 93.3;基座Qwen3-VL-8B 91.7 | 8B级并列第一,较基座+3.5 |
| ScreenSpot-Pro(高分辨率专业软件定位) | 平均准确率(%) | 63.9 | Step-GUI-8B 62.6;MolmoPoint-8B 60.2;ScaleCUA-32B 59.2 | 超8B最佳+1.3,较基座+14.0,且超全部32B模型 |
| OSWorld-G(真实计算机操作场景定位) | 平均准确率(%) | 65.4 | GTA1-32B 65.2;Holo2-8B 62.2 | 8B超越32B,较基座+10.6;refusal子项22.2为全场最高 |
| MMBench-GUI L2(复杂指令多平台理解) | 平均准确率(%) | 86.8 | Qwen3-VL-32B 85.3;Step-GUI-8B 85.6 | 超Step-GUI-8B +1.2,较基座+5.5 |
| UI-Vision(桌面视觉感知与交互推理) | 平均准确率(%) | 38.3 | UI-Venus-72B 36.8;Phi-Ground 27.2 | 8B超越72B +1.5,较基座+20.8 |
| 数据集消融(Qwen3-VL-8B分别SFT) | 四基准平均(%) | 76.4(ScreenRef SFT) | GroundCUA SFT 73.7;ScaleCUA SFT 72.9 | +2.7 / +3.5,其中SS-Pro领先+3.9/+9.6 |
| D2RL方法消融(同一SFT起点与后训练数据) | 五基准平均(%) | 69.9(SFT+OPSD+RLOO) | 纯SFT 68.0;SFT+RLOO 68.9;RLOO† 69.1 | +1.9 / +1.0 / +0.8,UI-Vision单项+4.0 |
局限与改进
作者承认的局限:截图来自真实环境,可能偶然含个人或账户信息,尚未做系统性人工隐私审计,仅靠数据文档邀请用户报告并发布更正版本;ScreenRef采用gated非商业研究许可且禁止再分发;各基线分数取自其论文原文,Table 1的跨数据集统计也沿用GroundCUA论文的对比协议,并非同一协议下的重测结果。我的补充观察:(1)方法消融显示D2RL相对纯SFT仅+1.9点、单项增益多在0.2-0.5点之间,相对两阶段训练成本边际收益有限,论文的主要增益其实来自ScreenRef SFT本身;(2)RLOO单独使用时OSWorld-G从64.9降到64.0,RL阶段存在不稳定风险;(3)移动端样本仅占9.9%(62,407/633,369),平台均衡性欠佳;(4)数据管线深度依赖GPT-5.5、Claude Opus 5等多个闭源API,成本高且可复现性受制于外部服务;(5)拒答判定由LLM完成,OSWorld-G拒答子项22.2%仍偏低,模型对“不可定位”的校准远未解决。
独立分析的弱点
独立分析四个弱点。其一,特权教师依赖真值框:OPSD要求训练时能拿到高亮真值框与文字提示,这在标注昂贵或噪声大的真实场景(如自收集的企业内部系统截图)难以复制;改进方向是用高置信度自预测或多模型共识构造“弱特权”信号,实现无真值自蒸馏。其二,D2RL性价比存疑:平均仅+1.9点,却要在8块B300上跑两阶段(OPSD+RLOO各一epoch);改进方向是把OPSD聚焦到RLOO零奖励的难样本子集做定向蒸馏,或采用课程式采样减少全量蒸馏的算力开销。其三,验证链本质是LLM-as-judge:指令一致性由Qwen3.8-27B判定、视频定位用0.95置信度门控加Claude仲裁,这些启发式的系统性偏差会直接固化进数据并传递给模型;改进是分层人工抽检、多模型一致性投票,并公开各阶段错误率估计。其四,坐标以[0,1000]归一化整数输出,位置感知加权的位阶权重 $k_t$ 与tokenizer对数字的切分方式强耦合,换分词器或改用连续坐标表示时需重新设计;改进方向是基于解码后坐标的实际像素误差计算连续权重,摆脱对离散位阶的假设。
未来方向
论文结论部分未列出明确的future work,但基于其成果可延伸多个方向:(1)把D2RL从单步定位推广到多步agent轨迹——OPSD教师可用带环境反馈的特权演示塑形初始策略,RLOO换成任务级稀疏奖励,正好缓解多步RL更严重的稀疏问题;(2)Path 2视频路径是一个可持续运转的数据引擎,可接入录屏/直播流并辅以轻量人工抽检持续扩量与质量升级;(3)位置感知加权的思想可迁移到其他结构化生成任务,如代码行列号、数学表达式的层级结构、时间戳预测;(4)拒答样本仅占3.5%,扩大比例并与不确定性校准结合,可服务自动化安全边界——让agent知道何时不该点击;(5)作者已展示8B逼近甚至超越72B的路径,进一步蒸馏到2B/3B端侧模型是自然延伸;(6)附录承认的隐私审计自动化(检测截图中个人信息的系统化流程)也是明确的工程方向。
复现评估
开源情况:代码、模型checkpoint(Apache 2.0)与ScreenRef数据集(gated、非商业研究许可、禁止再分发)发布于 github.com/PrentisAI/GroundGUI。复现分三档:只做模型训练最可行——SFT两轮(4×B300,batch 32,lr 1e-6)加D2RL两轮(8×B300,batch 42,8 rollouts,无KL惩罚,cosine调度),超参论文已给全,但需B300级高端算力,折算到A100/H100集群时间成本不低;数据管线复现成本最高,依赖GPT-5.5、Claude Opus 5、Qwen3.7-Plus、Qwen3.6/3.8-27B、Qwen3-VL-235B等多个外部模型API调用,外加OmniParser V2与YOLOv8,视频爬取还涉及YouTube条款合规;论文承诺的提示词模板、各阶段过滤统计和位置加权强度 $\beta$ 尚未完全公开。综合评估:用其发布数据加论文配置复现GroundGUI-8B属中等难度;端到端复现数据引擎属高成本、中风险(部分环节许可与API依赖受限)。
论文图表
ScreenSpot-V2上按移动/桌面/Web的文本与图标六项细分对比20余个7B-8B与32B/72B模型。GroundGUI-8B平均95.2%,与MAI-UI-8B并列8B级最高,追平GTA1-32B。
主结果表之一,展示通用定位能力已接近该基准饱和区间,验证数据+方法的基本盘。
UI-Vision上基础/功能/空间三类指令对比。GroundGUI-8B平均38.3%,超72B的UI-Venus-72B的36.8%,三项细分46.3/43.5/26.3均领先。
最难基准上的最大相对提升(较基座+20.8),说明方法在视觉推理型定位上的泛化能力。
同一SFT起点与后训练数据的消融:SFT平均68.0%、+OPSD 69.1%、+RLOO 68.9%、RLOO† 69.1%、+D2RL 69.9%;UI-Vision从34.3%升至38.3%。
方法贡献的核心证据,尤其D2RL优于RLOO†的0.8点证明收益来自更强初始策略而非数据重复曝光。