编程智能体的视觉生成能力与内部视觉思维语言 How Far Can Coding Agents Go in Visual Generation?
编码智能体零样本画图:结构保真超原生文生图,代码可作为可执行的视觉思维语言
前置知识
编码智能体
以大语言模型为核心、通过编写并执行代码来完成任务的智能体:它接收工具文档与文字指令,能在多轮交互中调用工具、观察执行结果并迭代修正自己的行动,无需针对具体任务微调。本文中的智能体每轮可发出多个工具调用,模型回复 DONE 且不带工具调用即结束一次绘制。
全文的研究对象就是它:没有『写程序、调工具、多轮迭代』这一能力,就不存在零样本代码作画的设定。
绘图接口
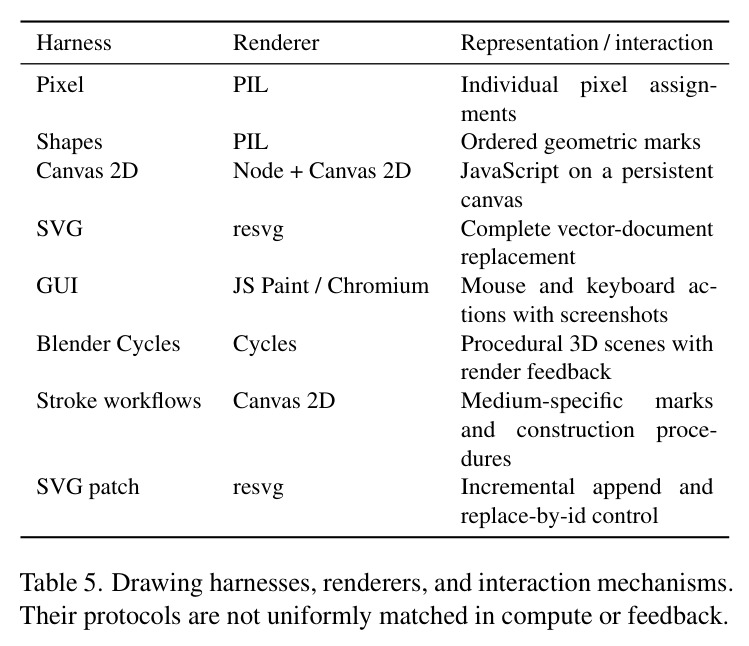
智能体作画所经由的程序化通道,决定它能用什么『笔』:逐像素赋色、按序光栅化的几何基元、可执行 JavaScript 的 Canvas 2D、声明式 SVG 文档、鼠标键盘操作 JS Paint 的 GUI、以及用 Python 建三维场景再渲染的 Blender Cycles。不同接口的抽象层级、表达力与反馈方式差异巨大。
接口是本文的核心自变量:能力轮廓、图像风格甚至感知短板的分布都随接口变化,看懂所有表格前必须先弄清它。
文生图生成模型
把文本映射为图像的端到端神经网络,主流包括潜空间扩散模型、校正流 Transformer 与自回归模型。它们把『图像如何被构造出来』隐式编码在网络参数里,一次前向即可产出照片级图像,但无法显式检查、测量或精确操控中间构造过程。
它们是本文的对照组(gpt-image-1/gpt-image-2),智能体的强弱项全部通过与原生基线的成对比较来定义。
思维语言假说
认知科学假说:思维在结构化的心理表征上进行,表征由实体、属性与关系组合而成,其意义取决于组件及组合方式。本文将其移植为『内部视觉语言』假说:设 $z$ 为智能体内部的场景表征,每个绘图接口 $h$ 都是一个解码器,输出图像满足 $I_h = D_h(z)$。
第 6 章的三个行为学实验——跨接口一致性、独立像素探针、房间视角重访——全是为检验这个假说而设计的。
清单式评估与成对评判
本文的两类自动评测协议:结构保真度用 DSG 式原子问题(覆盖对象、属性、数量、空间关系、文字与布局)让 VLM 逐条回答 yes/no/unclear,通过率为答 yes 的比例;感知与整体质量用成对比较,MMRBv2 量表配 Gemini 3.5 Flash 裁判,交换图像顺序各评一次以消除位置偏差,两次不一致记为平局。
论文所有主表的数字都由这两套协议产生,理解打分与判胜规则才能正确解读通过率和胜率的含义。
研究动机
现代文生图的主干是端到端生成模型——潜空间扩散、校正流 Transformer、自回归模型——它们把『图像如何被构造』的全过程隐式压进网络参数里。这类模型擅长照片级质感,但在需要精确结构约束的任务上并不可靠:在设计稿、图表、符号图形这类『构图准确性比照片质感更重要』的场景里,原生生成器 gpt-image-1 在 AgentDrawBench 设计/符号类上的清单通过率只有 58.1%,数按钮、排文字这类要求经常出错。与此同时,通用编码智能体已经能写程序、调工具、多轮迭代修正,理论上具备『用代码作画』的条件,但此前没有工作系统回答:零样本(不微调、不给示例图)的编码智能体作画究竟能到什么水平、强在哪弱在哪?更进一步,它在不同绘图接口下画出的图,是否出自同一套内部场景表征?这些问题此前完全未被量化。
本文的目标是本文的目标分三层。第一,量化:构建 200 条提示词的 AgentDrawBench,覆盖摄影场景、人物/有机体、产品材质、空间/3D、风格化插画、设计图形、图表符号七大类(提示词取自 Arena-T2I-Hard 110 条、HPDv3 40 条、BizGenEval 35 条、GraphicWeaver 15 条),用结构保真度、感知质量、整体偏好三个自动指标,测量编码智能体经六种绘图接口(逐像素、几何形状、Canvas 2D、SVG、鼠标 GUI、Blender 3D)的零样本作画能力,并与原生文生图基线逐项对比。第二,检验代码能否充当『外部视觉思维语言』:既支撑无视觉反馈的盲画生成,也支撑从 SVG 源码重建的图像理解。第三,用互补的行为学探针检验智能体是否在不同表达形式之下维持一致的内部场景表征。
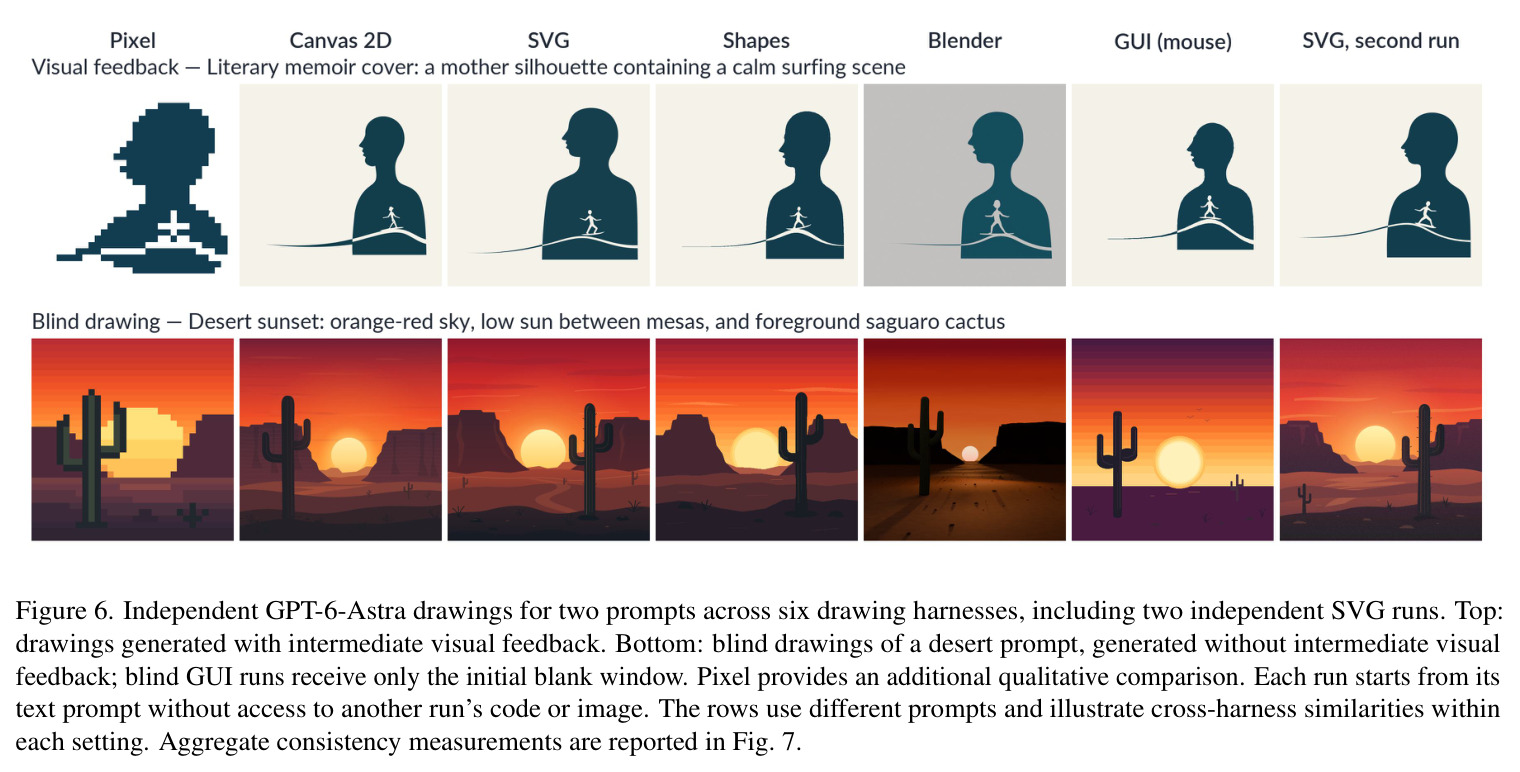
与已有工作不同的是,已有工作的切入方式主要有两种:一是训练专门的向量图形生成模型(StarVector、OmniSVG、InternSVG);二是用智能体编排现成的扩散模型工具(Visual ChatGPT、VisionDirector、Gen-Searcher)。前者绑定单一表示形式,后者本质上仍依赖生成器。本文的独特之处是完全不走这两条路:不给任何图像生成模型、不做任何微调,只给代码执行环境,把『作画能力』还原成纯粹的程序合成问题来测量。第二个独特角度是把认知科学的 language-of-thought(思维语言)框架移植到智能体上:与其只问『画得好不好』,不如问『不同的手(接口)画出的画,是否出自同一个脑(内部表征)』,并用跨接口一致性、独立像素查询、房间视角重访三个互补行为学实验给出首个量化证据。
核心方法
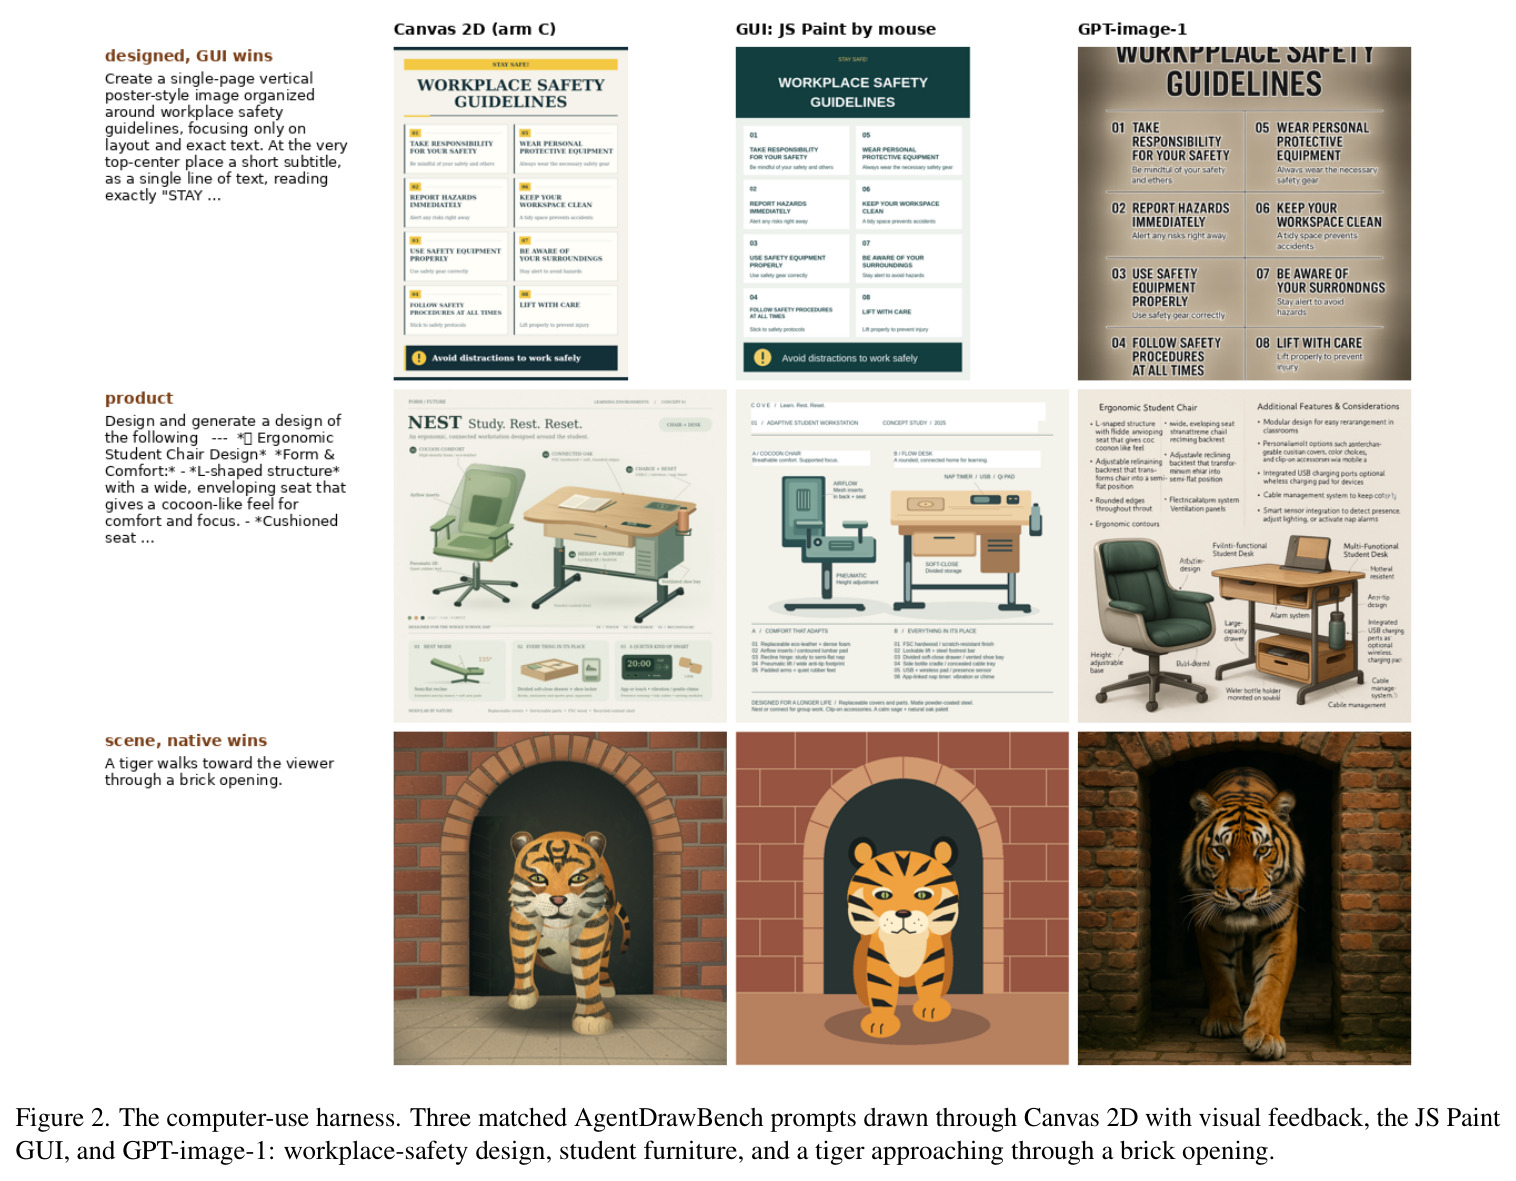
直觉上,这就像让一位会写代码的设计师作画:画布是执行环境,笔是程序接口,他可以先规划、再落笔、看渲染结果、再修改。技术路线上,作者搭建了六种绘图 harness:pixel(逐像素自回归赋色)、shapes(按生成顺序光栅化矩形、椭圆、多边形等基元)、canvas2d(写 JavaScript 到持久画布,支持路径、渐变、变换、循环与辅助函数)、svg(声明式向量文档由 resvg 渲染)、GUI(用 Playwright 驱动 JS Paint,靠鼠标键盘加截图反馈作画)、Blender Cycles(写 Python 建 3D 场景,CPU 自适应采样加 OIDN 去噪渲染)。评测在 AgentDrawBench 上进行,指标包括 DSG 式清单通过率(结构保真)、十个维度的成对感知比较、MMRBv2 整体偏好(Gemini 3.5 Flash 裁判、交换图像顺序评两次)。在此之上是四组深入实验:盲画与视觉反馈对照(盲画组从不把 RGB 画布给模型看)、WorldBench 200 题的 SVG 重建答题、test-time scaling(预算 $B = I + 5O$ 扩到 4 倍)、以及从人类绘画视频提炼笔画工作流的上下文学习。
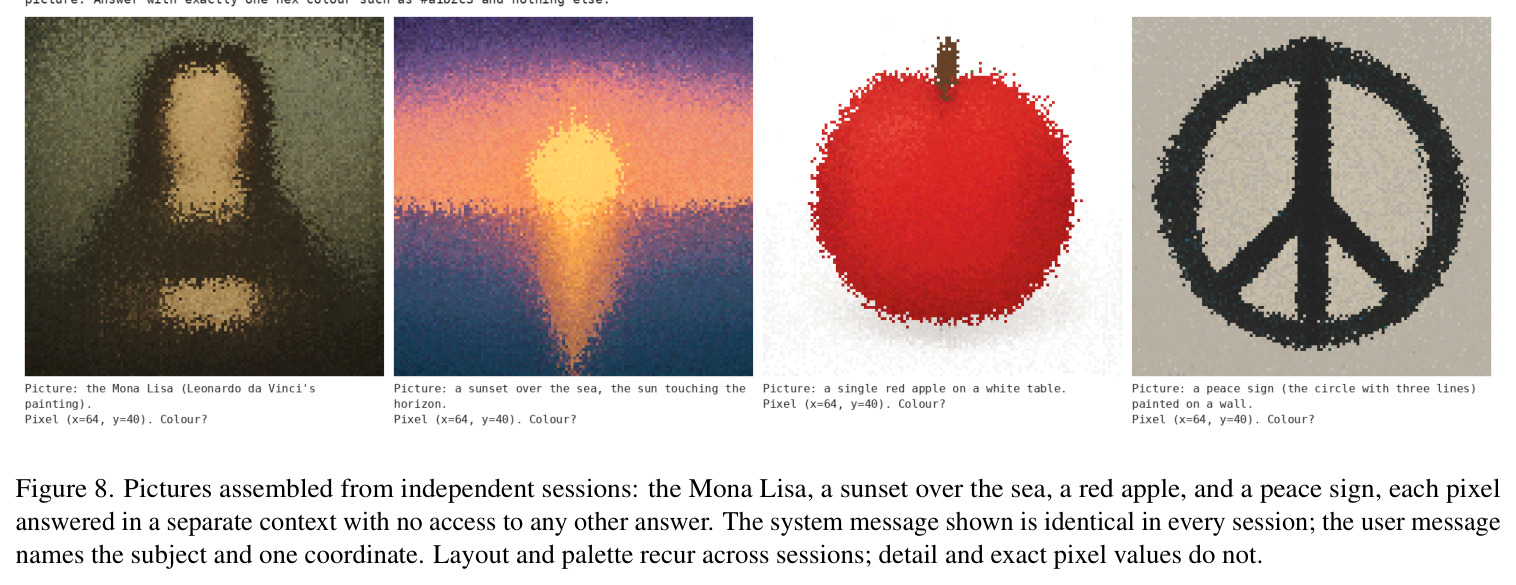
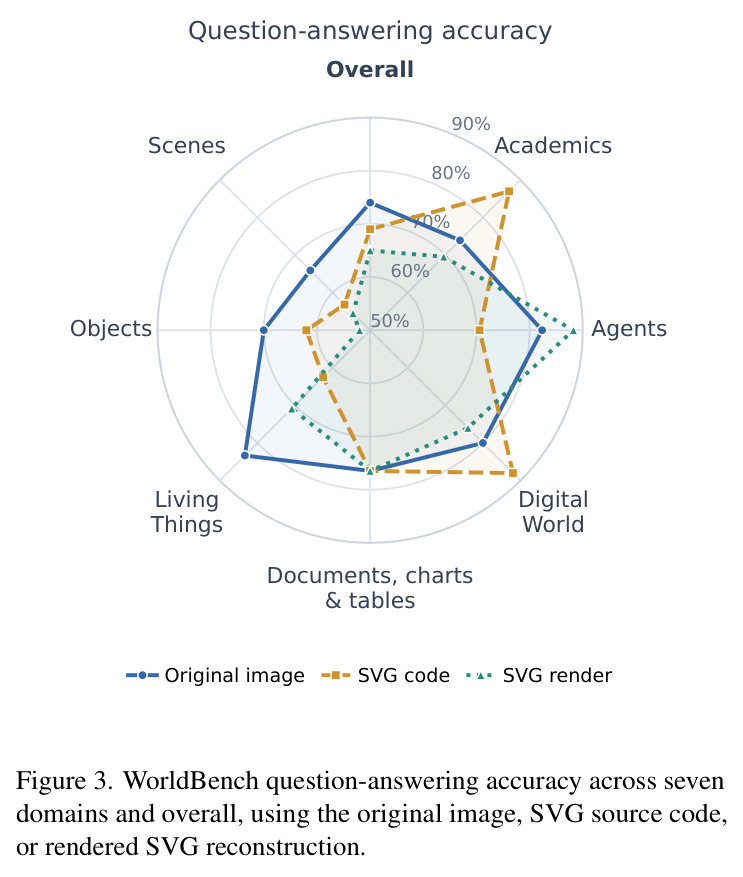
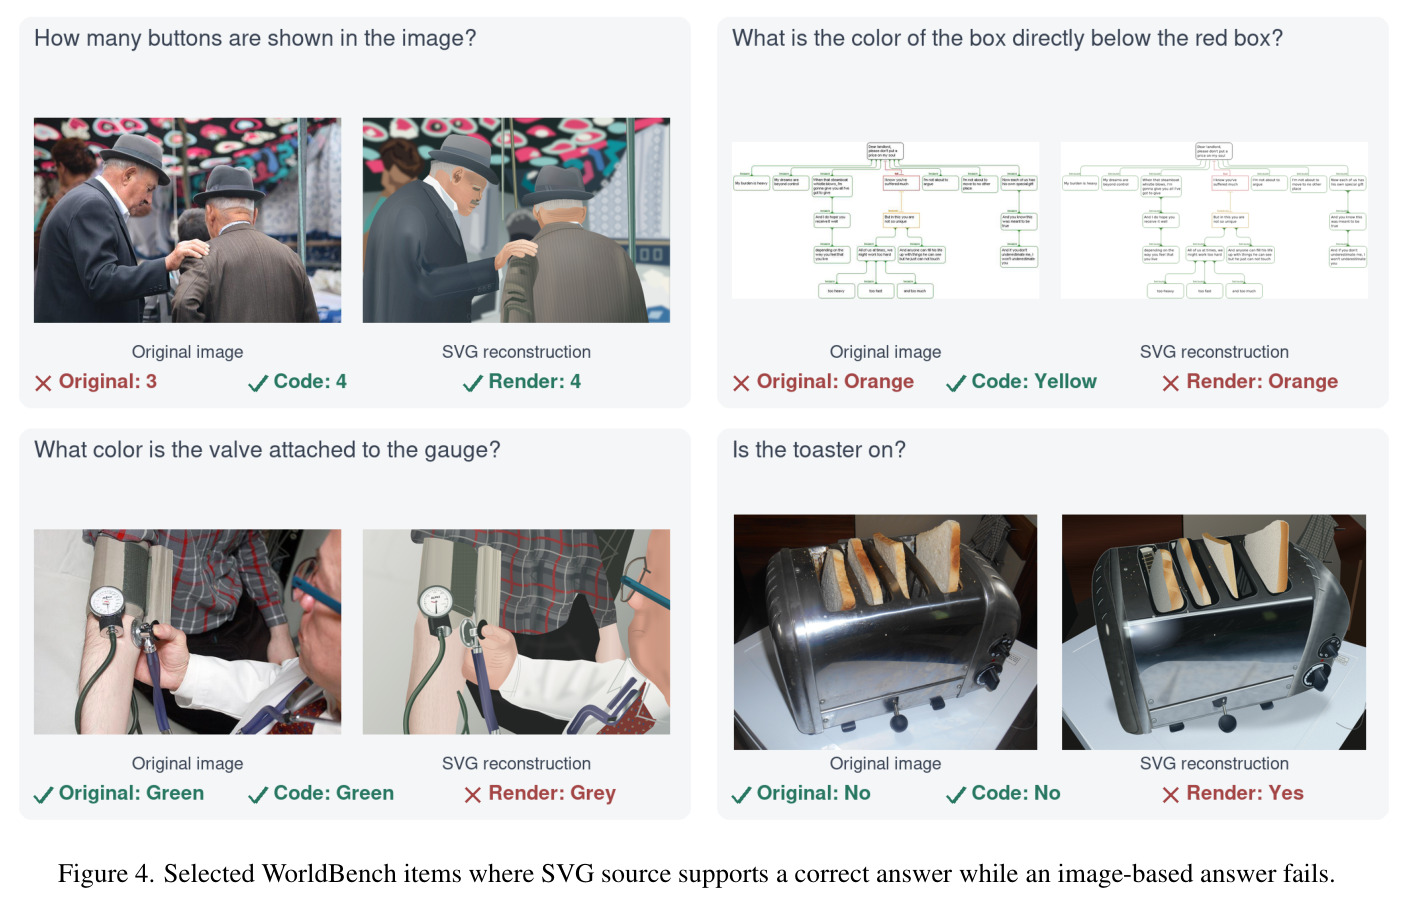
核心思想是『代码作为外部视觉思维语言』。与把生成过程锁在网络参数里的扩散/自回归模型有本质区别:代码是显式、可执行、可检查的表示,智能体能在落笔前『测量』——论文记录到一个典型 rollout,模型画标题文字前先渲染两个候选字体栈、量出 583.8 px 与 581.2 px 的宽度、与目标栏宽比对后才提交,这种『边量边画』是生成式模型做不到的。同一表示反过来也能用于理解:把原图重建成 SVG 后,仅凭源码答题达到 69.0%,高于渲染图的 65.0%,在 academics 与 digital-world 两个域甚至超过看原图的 74.0%。最有想象力的一步是内部视觉语言假说:设 $z$ 为智能体内部的场景表征,每个接口都是解码器,$I_h = D_h(z)$。作者让 65,536 个互不知情的全新会话各回答蒙娜丽莎在 256×256 网格上某一个像素的颜色,拼出的图竟呈现出完整的人脸构图与色调布局——暗示内部意象先于任何 harness 存在,作画只是它的不同投影。
方法步骤详情
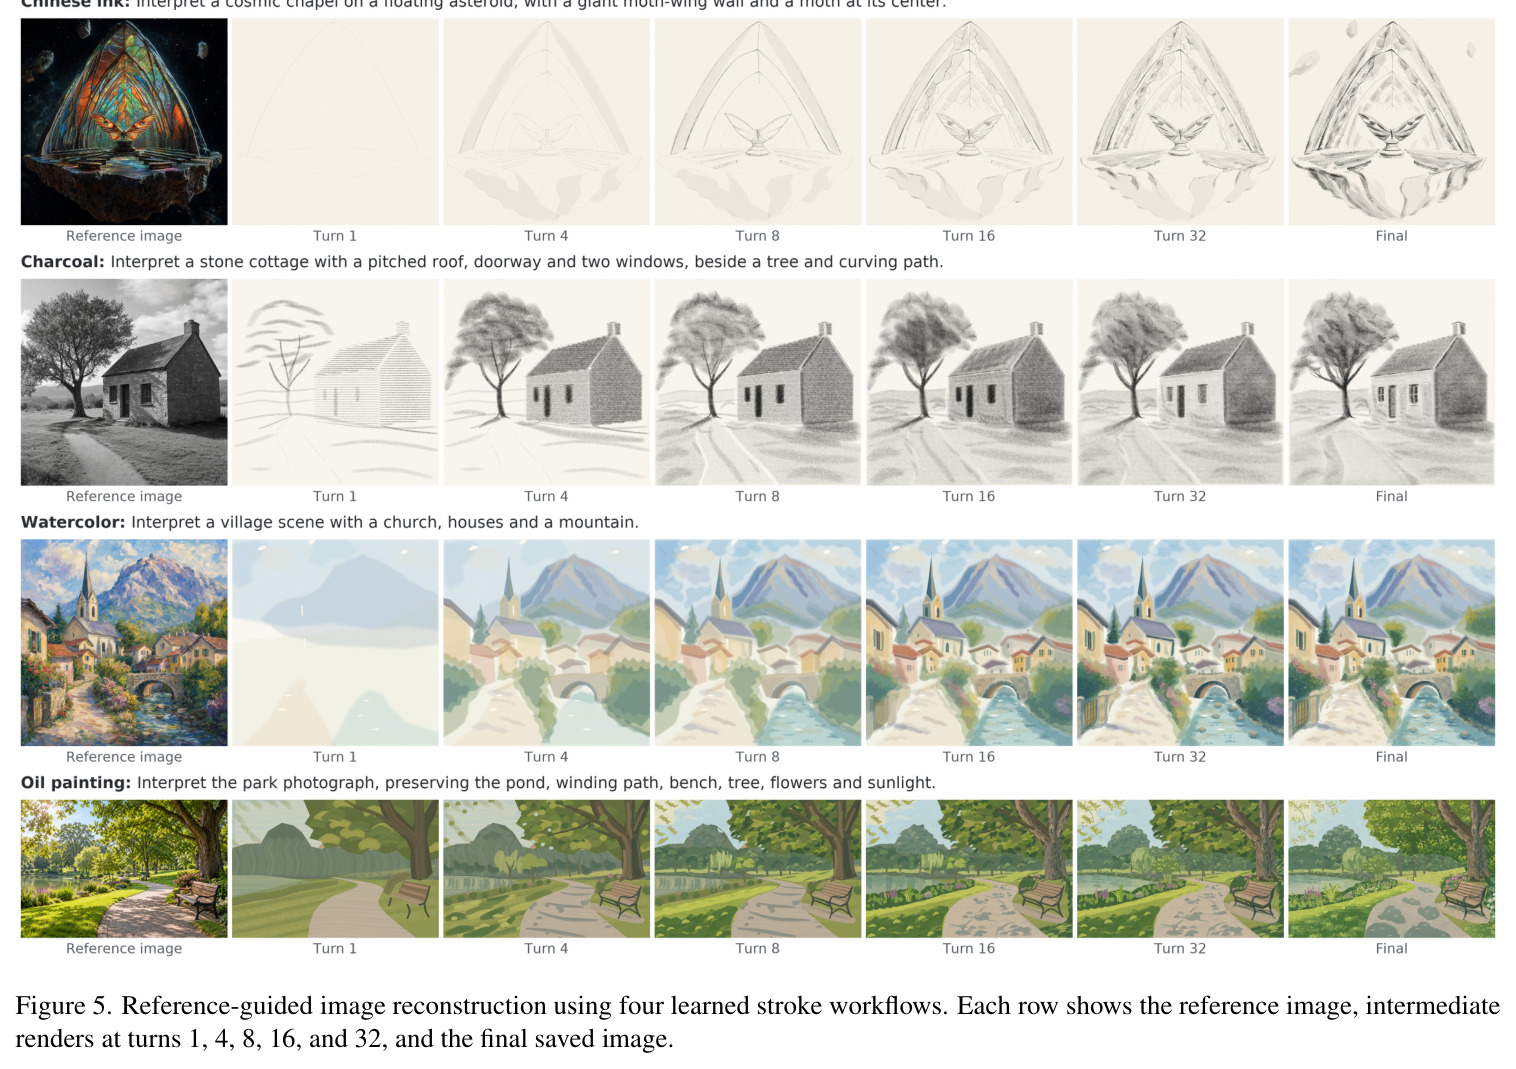
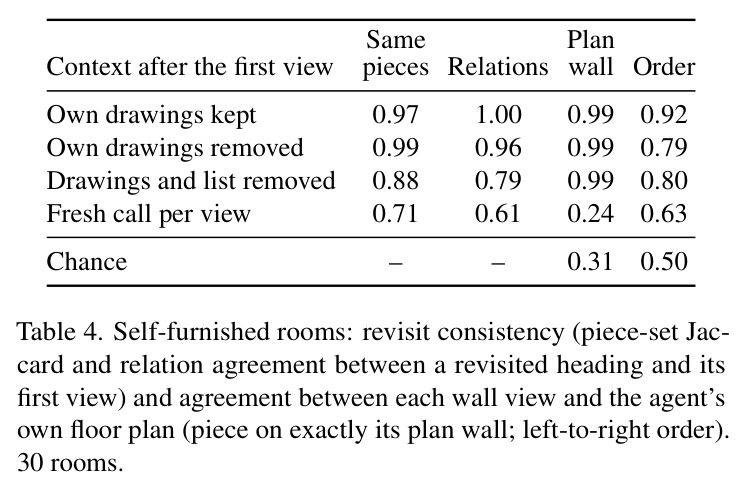
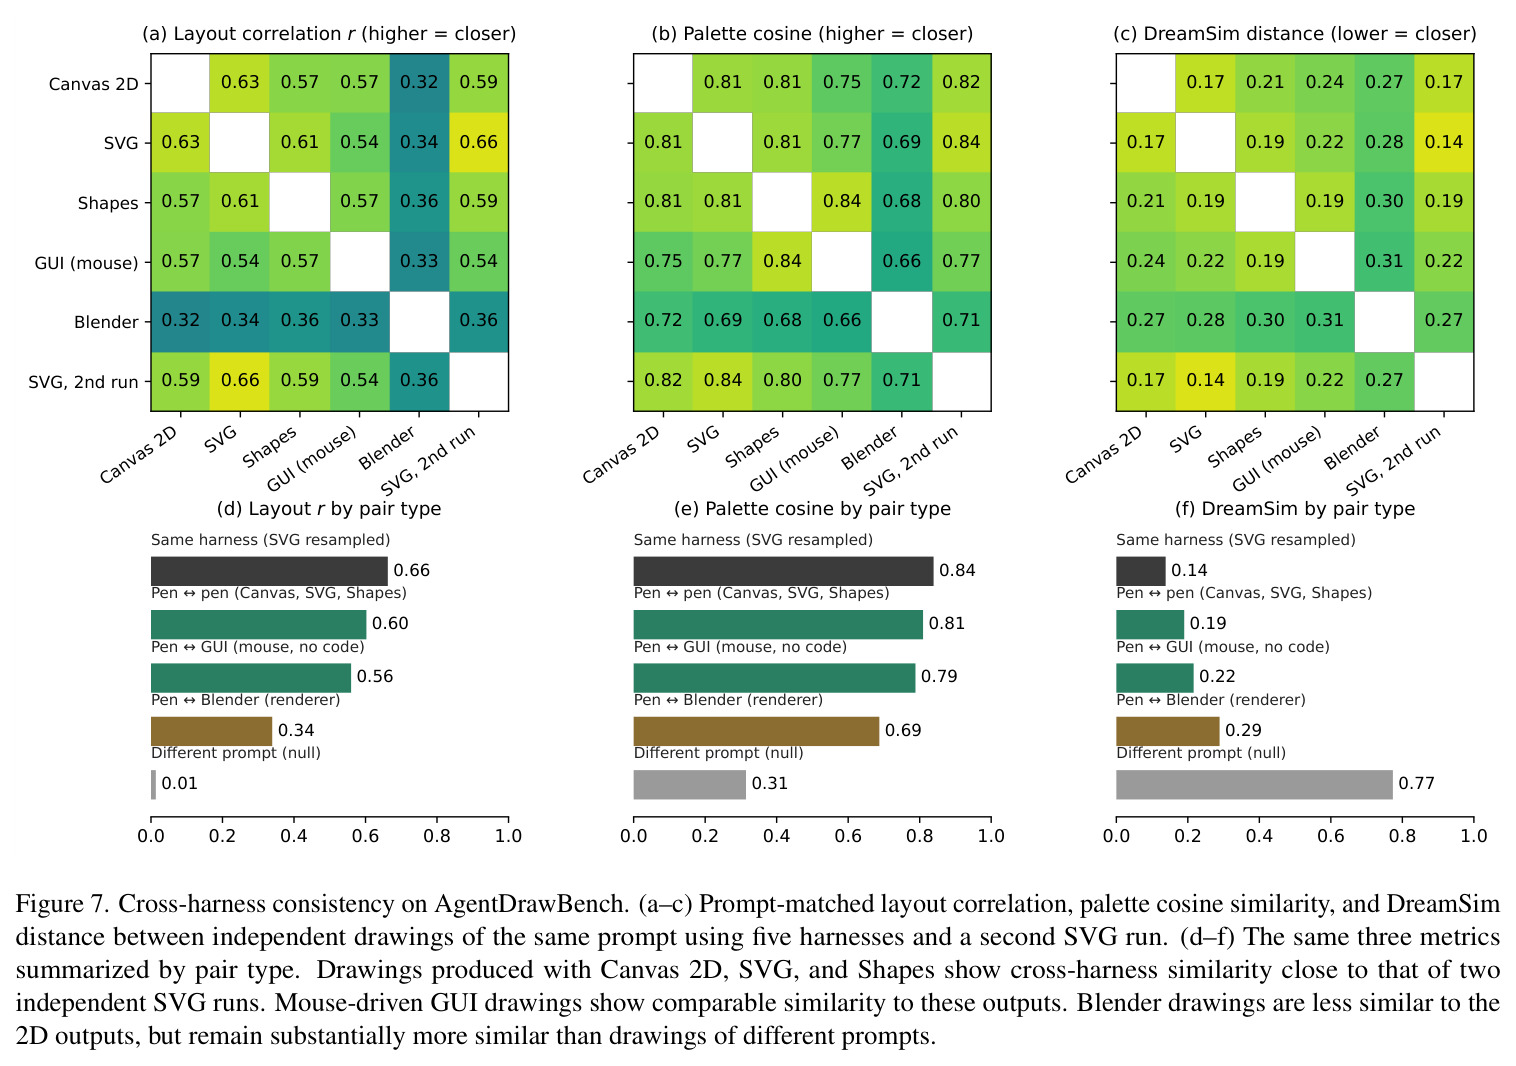
实验流程可拆成八步。第一步 harness 实现:pixel 提供 draw_pixel(索引, 颜色) 工具;shapes 按生成顺序光栅化几何标记、后画的盖住先画的;canvas2d 每轮写一段可执行 JavaScript;svg 做整文档替换后由 resvg 渲染;GUI 通过 Playwright 向 JS Paint 发送成批点击、拖拽、按键与取色操作,每批后收到截图反馈,禁止代码执行与贴图;Blender 每次在全新进程重建场景并渲染,每轮可检查预览。每轮一个 API 调用,模型回复 DONE 结束,代码类接口轮数上限 12、shapes 为 40。第二步评测:VLM 逐条回答 DSG 式原子问题(yes/no/unclear,后两者算失败),报告通过率;感知与整体用成对比较并交换图像顺序。第三步盲画对照:智能体只收执行结果、从不看 RGB 画布。第四步 WorldBench 重建答题:按域分层抽样 200 题,先重建 SVG,再在全新上下文分别用原图、源码、渲染图答题。第五步 test-time scaling:预算 $B = I + 5O$(累计输入 token 加五倍输出 token),扩展组上限 48 次响应、标准组 12 次。第六步笔画工作流:从 Bilibili、YouTube、X 上的人类绘画视频提炼水墨、炭笔、水彩、油画的笔画操作、构建顺序、明暗分组与边缘控制,供智能体重建参考图,且作画代码禁止采样、描摹或滤波参考像素。第七步一致性探针:跨五种 harness 独立作画,计算亮度布局 Pearson 相关 $r(x, y)$(灰度按 $L = 0.299R + 0.587G + 0.114B$ 降采样到 16×16)、18 bin 饱和度加权色相直方图余弦相似度 $c(h, g) = h^{\top} g / (\|h\|_2 \|g\|_2)$ 与 DreamSim 距离;另做 128×128 独立像素查询,16,384 个互不知情的答案拼成整图。第八步房间一致性:30 个 ProcTHOR-10K 房间、每间 7 至 14 件家具,智能体自行布置后从多个朝向作画并重访,最后画俯视平面图,在四种上下文保留条件下用 Jaccard、关系一致率、墙-平面图一致率打分。
技术新颖性
技术新颖性体现在四个方面。其一,评测对象是『没有被训练来画画的通用智能体』,与 StarVector、OmniSVG、InternSVG 等专门训练的向量生成模型不同,也与 SketchAgent 的逐笔草图画语言不同——本文考察的是完整可执行程序在六种异构接口下的能力轮廓。其二,与编排扩散工具的智能体系统(Visual ChatGPT、VisionDirector、Gen-Searcher)相反,本文刻意剥离一切生成器,分离出『纯程序化作画』的贡献;同期的 MaLiang-Harness 也研究可编程图像生成,但未触及内部表征问题。其三,行为学探针设计本身是新的:独立像素查询把每个像素的答案隔离在互不可见的全新会话中,类似认知心理学的独立觉察范式,能区分『共享内部意象』与『单次生成内的协调』。其四,视角变换范式(房间转向、重访、画平面图)把 Piaget 式的空间持久性检验搬给智能体,且用四种上下文消融(保留画作、删画作、连家具清单也删、每视角全新调用)把『信息到底存在哪一层』剥离得干净利落。
实验结果
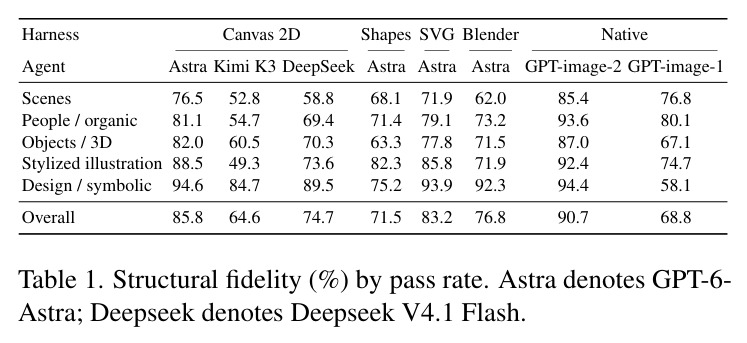
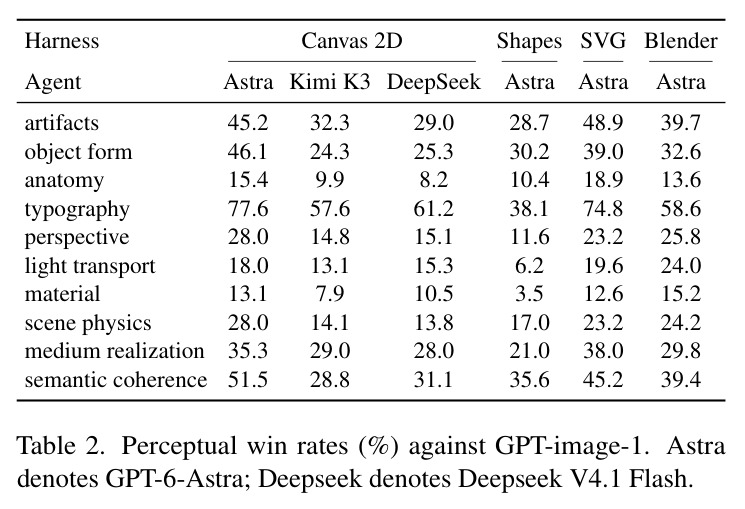
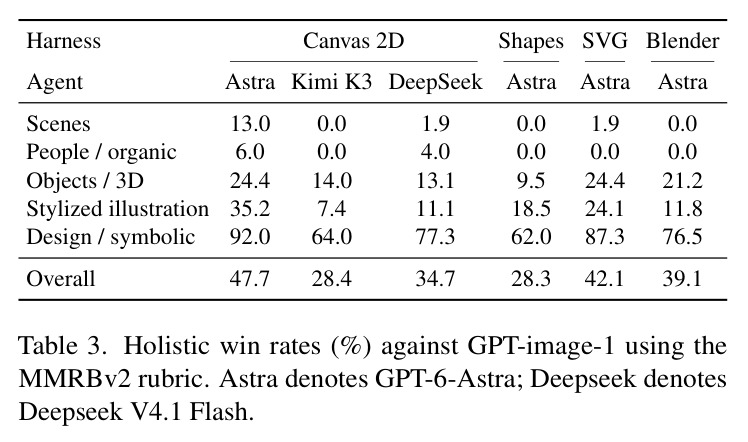
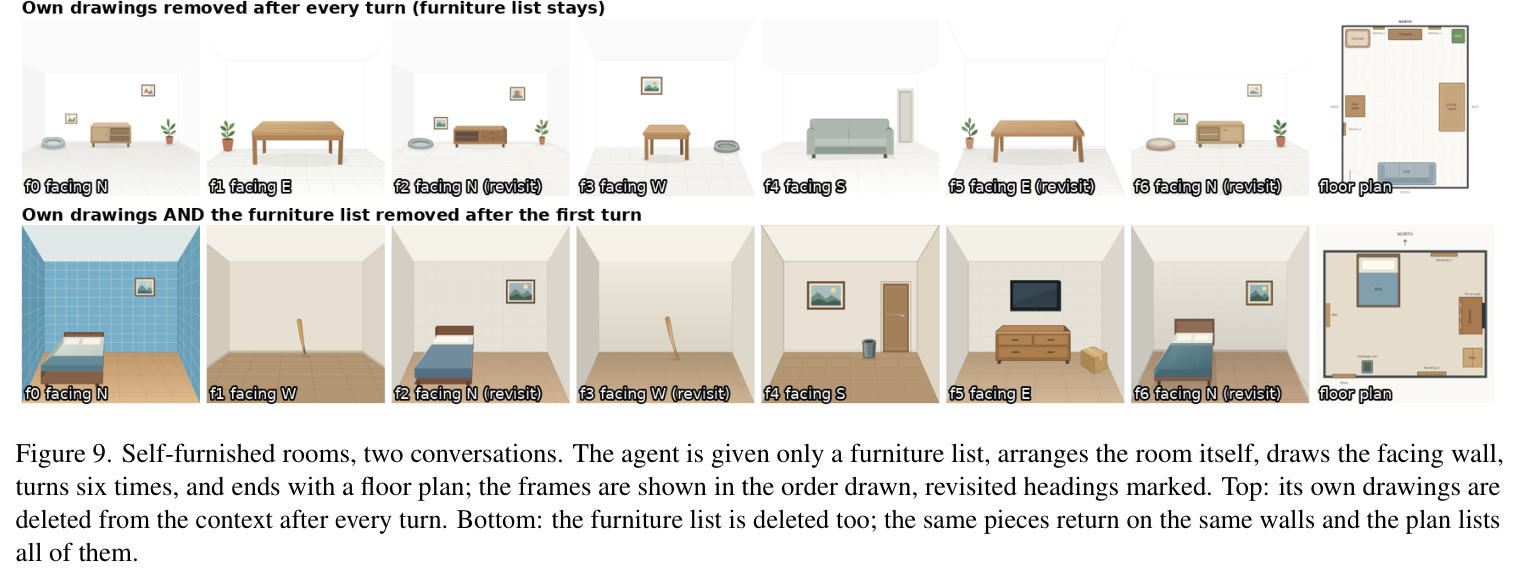
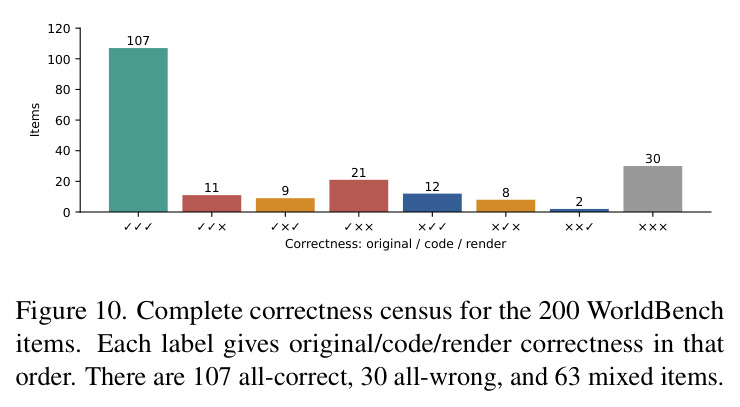
发现一:结构保真是编码智能体的强项。GPT-6-Astra 配 Canvas 2D 在 AgentDrawBench 总体清单通过率 85.8%,比 gpt-image-1 的 68.8% 高 17 个百分点(gpt-image-2 为 90.7%);设计/符号类上 Astra 达 94.6%、零样本 DeepSeek V4.1 Flash 达 89.5%(超 gpt-image-1 达 31.4 个百分点),Astra 甚至略超 gpt-image-2 的 94.4%。发现二:感知质量是硬伤。Canvas 2D 与 SVG 只在排版维度赢过基线(77.6%、74.8%),解剖(15.4%)、材质(13.1%)、光传输(18.0%)、透视、场景物理等维度全面低于 50%。发现三:整体偏好呈任务分化——对 gpt-image-1 的 MMRBv2 胜率在设计/符号类 92.0%,但场景类仅 13.0%、人物有机体类 6.0%,总体 47.7%。发现四:代码可独立支撑生成与理解——盲画 83.0%(视觉反馈 85.6%);SVG 源码答题 69.0%、渲染图 65.0%、原图 74.0%,其中原图改看渲染图时 32 题由对转错、14 题由错转对,净损失 18 题(9 个百分点);107 题三条件全对、30 题全错、63 题混合。发现五:test-time scaling 回报有限——4 倍预算把结构保真从 85.6% 提到 86.8%,对标准运行的整体胜率仅 50.5%。发现六:人类示范的笔画工作流能解锁媒介化表达——同一参考图被重建成留白透气的水墨教堂、颗粒质感的炭笔小屋、透明叠染的水彩村庄和厚涂油画公园,第 1/4/8/16/32 轮的中间帧显示从大形到细节的构建过程。发现七:内部一致性证据强——跨 2D 接口布局相关 0.60、色板余弦 0.81、DreamSim 0.19,接近同接口 SVG 重跑的 0.66/0.84/0.14,远超不同提示零基线 0.01/0.31/0.77;不共享任何绘图 API 的鼠标 GUI 落在同一簇(0.56/0.79/0.22),Blender 稍远(0.34/0.69/0.29)但仍远超零基线;独立像素拼图亮度空间自相关 Moran's I 达 0.85–0.96(打乱后 0.01),与整图 Canvas 2D 画的亮度相关 0.51–0.88;删光自己画作的房间重访 Jaccard 0.99、墙-平面图一致率 0.99(随机 0.31),连家具清单也删时仍有 0.88 与 0.99。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AgentDrawBench 总体结构保真度 | DSG 清单通过率 (%) | GPT-6-Astra + Canvas 2D:85.8 | gpt-image-1:68.8;gpt-image-2:90.7 | 较 gpt-image-1 高 17.0 个百分点,仍低于 gpt-image-2 |
| 设计/符号类结构保真度 | 清单通过率 (%) | Astra + Canvas 2D:94.6;DeepSeek V4.1 Flash + Shapes:89.5 | gpt-image-1:58.1;gpt-image-2:94.4 | DeepSeek 超 gpt-image-1 达 31.4 个百分点;Astra 略超 gpt-image-2 |
| 整体偏好(对比 GPT-image-1) | MMRBv2 胜率 (%) | Astra + Canvas 2D:设计/符号 92.0、场景 13.0、人物/有机 6.0、总体 47.7 | GPT-image-1 | 设计与符号类大幅领先,自然场景与人像明显落后 |
| WorldBench 视觉问答(SVG 重建) | 答案准确率 (%) | SVG 源码:69.0 | 原图:74.0;SVG 渲染图:65.0 | 较渲染图高 4.0 个百分点;academics 与 digital-world 域超过原图 |
| 盲画(无视觉反馈)结构保真度 | 清单通过率 (%) | 83.0 | 有视觉反馈:85.6 | 仅低 2.6 个百分点,代码执行反馈即可支撑作画 |
| Test-time scaling(4 倍预算) | 通过率 (%) / 整体胜率 (%) | 86.8 / 50.5 | 标准预算:85.6 / 50 | 结构保真 +1.2 个百分点,整体偏好基本持平 |
| 自布置房间重访一致性(删画作条件) | piece-set Jaccard / 墙-平面图一致率 | 0.99 / 0.99 | 随机排列 chance 约 0.31 | 远超随机水平;连家具清单也删时仍达 0.88 / 0.99 |
局限与改进
作者明确承认的局限:绝大多数消融只用 GPT-6-Astra 一个主力智能体;评估高度依赖自动裁判、人工验证有限;上下文学习(笔画工作流)实验是纯定性的,没有证明受控提升;研究的是商用前沿智能体的对外接口,拿不到权重和内部实现,因此内部视觉语言假说的检验只是行为学层面、探索性的;像素探针只覆盖 5 个主题;房间实验中智能体仍保留着不透明的推理历史,无法确证场景信息存在哪一层;WorldBench 各域样本量小(如 Academics 23 题、Agents 17 题),排名只是描述性、无统计显著性;Blender 与 2D 接口在算力与反馈频率上不匹配,作者自认这是『接口配置的比较而非渲染器的因果效应』,200 条提示中还有 1 条超出渲染时限。我的补充观察:整体与感知裁判都是 Gemini 3.5 Flash 单裁判,而代码生成图像的优势恰好集中在可文字验证的结构属性上,裁判可能系统性偏好这类可核对特征;成本只有零散披露(一条 canvas2d rollout 5 轮 0.58 美元),缺少与原生生成器的成本-质量系统对比。
独立分析的弱点
弱点一:裁判有效性存疑。整体偏好由单一 VLM(Gemini 3.5 Flash)给出,而智能体图像的结构信息(精确文字、坐标、数量)恰好最容易被 VLM 核对,可能系统性高估智能体。改进方向:抽 10–20% 子集做多人标注,报告裁判与人类偏好的 Kappa 一致性,并测试多裁判集成。弱点二:『内部意象』的证据链不足以排除替代解释——跨接口一致也可能来自『相同提示触发相似的文本级规划』,即 $z$ 只是文字计划而非视觉表征。改进:设计干预实验,强制两条不同语言风格的规划路径后再测一致性,或对比『先用文字描述场景再画』与『直接画』的一致性差异。弱点三:像素探针的细节崩溃(同一坐标重问颜色一致率仅 2–38%,逐通道差约 10/255)说明所谓内部意象分辨率很低,更像粗布局先验。改进:绘制一致性随网格密度衰减的曲线,定位内部表征的分辨率上限。弱点四:规模偏小——200 条提示、5 个像素主题、30 个房间,且无显著性检验,小样本域(如 Agents 17 题)的结论脆弱。改进:按域扩样并报告置信区间。弱点五:感知短板的归因未分解——Blender 有真实光照渲染,但材质维度胜率仍只有 15.2%,说明不只是 2D 接口表达力问题,模型先验同样缺位;需要接口×反馈×模型的因子化消融来分离原因。
未来方向
作者提出的方向是覆盖更多模型、接口与变换类型的更全面评估。基于本文成果还能延伸出多条路:其一,数据反哺——智能体生成的高结构保真 SVG/Canvas 程序是天然带精确标注的训练数据,可用于改进文生图模型的文字渲染与布局能力;其二,混合架构——结构骨架由代码程序给出、感知细节由扩散模型补全的两阶段生成器,取两者之长;其三,机制研究——用可解释性手段定位内部意象 $z$ 在 Transformer 中的载体,检验它与文本规划是否可分离;其四,把房间视角一致性范式推广为智能体空间记忆与主动感知的标准评测,连接具身智能(ProcTHOR 本就是具身平台);其五,预算感知绘制——本文显示 4 倍预算只换来 1.2 个百分点的结构提升(整体胜率 50.5%),值得研究预算分配策略或更聪明的早停准则;其六,代码化理解的下游应用:从图表 SVG 直接抽取数据做问答,天然适合财报、论文插图等对数字精确性敏感的场景。
复现评估
复现条件中上等。数据侧:AgentDrawBench 作者承诺公开,提示词全部来自四个已发表基准(Arena-T2I-Hard、HPDv3、BizGenEval、GraphicWeaver);房间实验用公开的 ProcTHOR-10K;视觉问答用公开的 WorldBench,附录甚至列出了每个域抽中的题目索引。工具侧:六个 harness 全部基于开源组件(PIL、Node Canvas 2D、resvg、Playwright 加 JS Paint、Blender Cycles),附录 A 给出了系统提示词骨架、轮次机制、按美元匹配的预算控制,以及水墨、炭笔、水彩、油画四个示范视频的具体链接。算力侧:无需训练 GPU,成本集中在商用智能体 API——一条 canvas2d rollout 约 5 轮 0.58 美元,200 提示乘 6 接口再乘多组消融估计在数百到上千美元量级,裁判还需 Gemini 3.5 Flash。最大风险是模型不可得性:GPT-6-Astra、Kimi K3、DeepSeek V4.1 Flash 等会持续迭代,精确数字难以复现。总体判断:评测管线复现难度中等偏易,精确数字复现较难。
论文图表
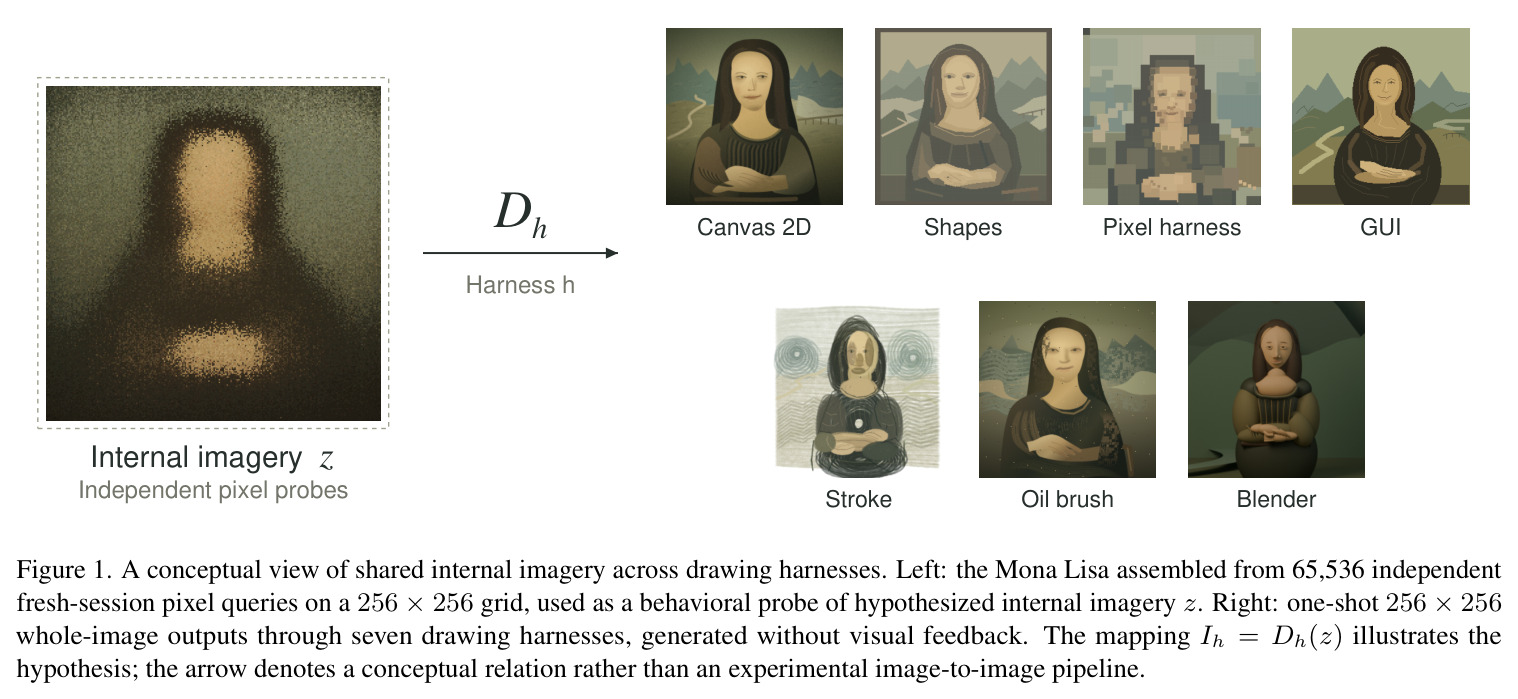
左侧是在 256×256 网格上用 65,536 次互不知情的全新会话像素查询拼装出的蒙娜丽莎,作为对假想内部意象 $z$ 的行为学探针;右侧是同一提示经七种绘图接口一次性整图输出的结果,映射关系写作 $I_h = D_h(z)$,箭头表示概念关系而非图像到图像的流水线。
这是全文的纲领图:一图同时呈现『零样本代码作画』与『内部视觉语言假说』两条主线,看懂它就知道论文要证明什么。