Tev:以密集进度奖励扩展长程智能体环境 Tev: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards
先构建已知正确的潜在世界再反向渲染任务,用进度势函数把稀疏终端奖励变成每步密集奖励
前置知识
GRPO(组相对策略优化)
一种无需价值网络的强化学习估计器:对同一任务采样 $G$ 条轨迹,奖励分别为 $R_1,\dots,R_G$,每条轨迹的优势按组内归一化计算 $\hat{A}_i = (R_i - \mathrm{mean}(R_{1:G}))/(\mathrm{std}(R_{1:G})+\epsilon)$,即以组内均值为基线、组内标准差为尺度。因省去 critic、实现简单,是当前智能体 RL(terminal agent、数学推理等)的主流选择。
本文 §3.1 正是从 GRPO 的组归一化机制出发,证明终端奖励会造成『整组零优势』的饥饿问题;PPRS 奖励设计的全部动机都建立在理解 GRPO 之上。
稀疏奖励与组饥饿
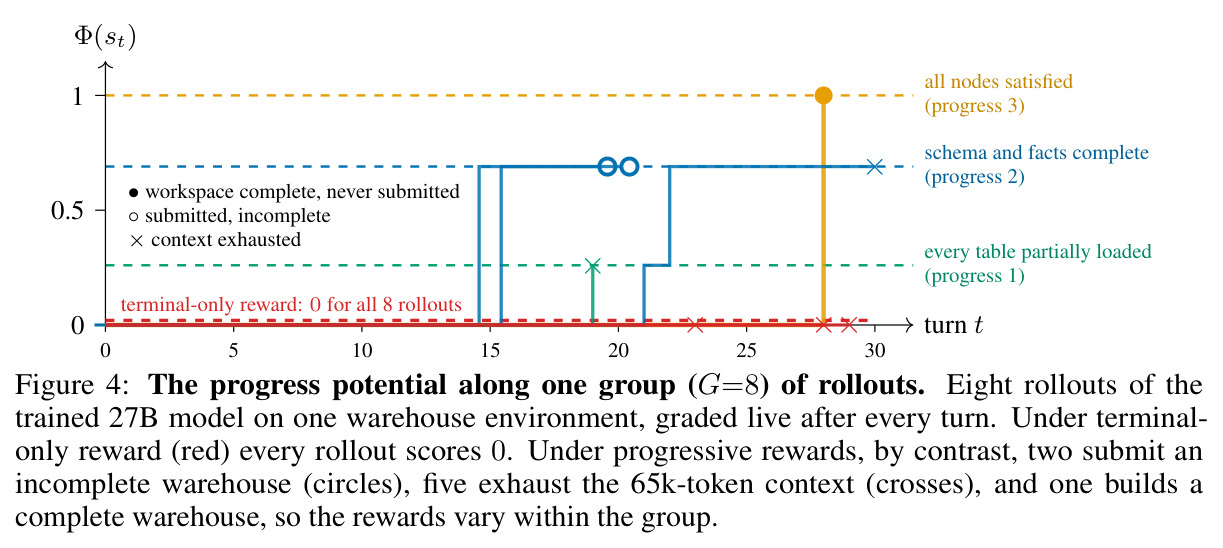
长程任务只有在 agent 发出 submit 动作且严格验证器接受时才给 0/1 奖励。若策略解出任务的概率为 $p$,则 $G$ 条轨迹全部失败的概率为 $(1-p)^G$,此时组内优势处处为零,该任务的 $G$ 条轨迹对梯度毫无贡献。论文算过账:$p=0.05, G=8$ 时浪费 66% 的组,$p=0.01$ 时浪费 92%;而未训练开源模型在长程任务上的 $p$ 通常只有 0.03 左右。
这是长程任务『不可训练』的根源,也是论文为什么要把密集进度奖励作为核心贡献的原因;没有这个概念就无法理解消融实验中终端奖励在 27B 上连一个优化器步都完不成。
势函数奖励塑形(PBRS)
Ng 等人 1999 年的经典技巧:定义状态势函数 $\Phi(s)$,每步给塑形奖励 $r_t = \Phi(s_t) - \Phi(s_{t-1})$,沿轨迹求和后 telescope 成 $\Phi(s_T)-\Phi(s_0)$。经典理论要求把终端势置零,这样塑形项对所有轨迹贡献相同常数,不改变最优策略集合。
PPRS 直接借用了 $r_t = \Delta\Phi_t$ 的形式,但刻意保留终端项 $\lambda\Phi(s_T)$ 来改变优化目标——理解 PBRS 的『策略不变性』才能明白这个看似违反教科书的设计是深思熟虑的,而非笔误。
长程智能体基准:ALE 与 Terminal-Bench
Agents' Last Exam(ALE)是专家手写的长程任务评测集,本文用其『计算与数学』分片 ALE-CM(18 个任务,每题需数周专家时间);Terminal-Bench(TB)是终端智能体基准,TB 2.1 为中程(89 任务),TB 3.0/4.0 为长程(每任务约需 8 小时专家工作)。本文在这些基准上取『CM』子集(22 和 18 个任务)做泛化评测。
论文所有实验数字都报告在这些基准上,训练集 TEV-GYM 就是按 ALE-CM 的七个子域(软件工程、数据工程、AI/CS 研究、数学与运筹、安全取证、基础设施、量子计算)对齐构建的,不懂基准就读不懂结果表。
Pass@k 与 S@k 评测指标
Pass@k(记作 P@k)指每任务 $k$ 次独立 rollout 中至少一次完全通过严格验证器的比例,衡量『能否彻底做对』;S@k 是 $k$ 次 rollout 的平均得分(含部分分,任务按 $[0,1]$ 评分),衡量『平均做到什么程度』。例如一个任务 5 次平均得 0.8 分但从未满分,则 S@5=0.8 而 P@5=0。
论文表格同时报告两者,且提升结构不同:TEV-320B 在 TB 4.0 上 P@1 涨 0.08 而 P@5 不变,说明训练主要提高『稳定做对已能触及的任务』而非解锁新任务;混看指标会误读结论。
研究动机
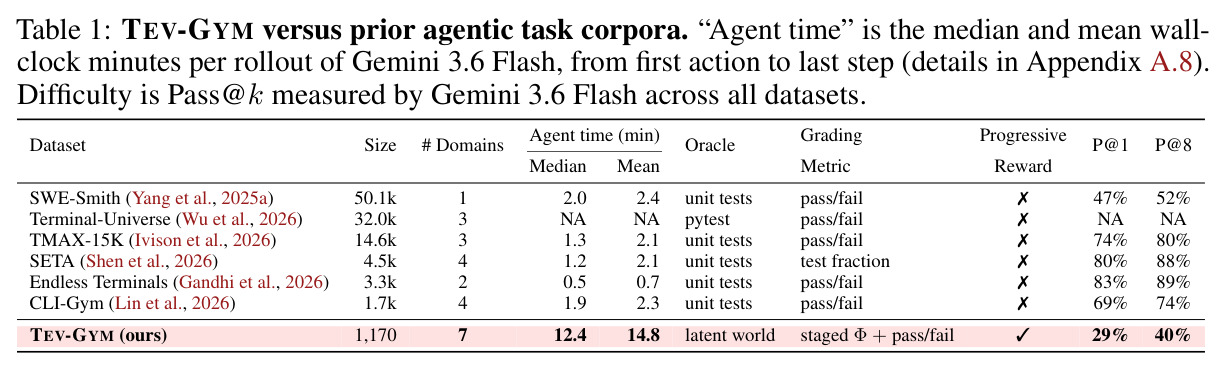
开源社区的编码智能体训练进展集中在短程和中程任务:SWE-Smith(50.1k 环境)、Terminal-Universe(32k)、TMAX-15K(14.6k)、SETA(4.5k)、Endless Terminals(3.3k)、CLI-Gym(1.7k)等语料规模上万,但每个任务只是一次 PR 级修复或短终端会话——按统一评测,Gemini 3.6 Flash 在这些语料上单条 rollout 的墙钟时间中位数只有 0.5–2.4 分钟,Pass@1 高达 47%–83%,单元测试只提供通过/失败的终端信号。而真正长程的任务(求解数学与科学开放问题、自动化 ML 研究、系统级安全分析)只存在于 ALE、Terminal-Bench 这类人工编写的小型评测集:每题需要数周专家工作,只有几十到几百个实例,且只是评测集、无法用于训练。于是出现一个空洞:训练语料大而短,长程任务小而不可训练。更糟的是奖励饥饿:未训练的 Qwen3.8-27B 在长程任务上解出概率约 0.03,GRPO 下 $(1-p)^G$(G=8)意味着约 78% 的 rollout 组贡献零梯度——训练初期策略最弱、最需要信号的时候,恰好是信号最稀缺的时候。
本文的目标是论文要同时解决『没有长程训练数据』和『长程任务训不动』两个问题。具体目标有三:(1) 一条数据合成路线,能程序化控制任务复杂度、保证验证精确无误(存在确切的标准答案而非模型自猜)、可按种子无限扩展,且单个环境生成只需中位 30 秒 CPU 时间、零模型调用;(2) 把『离正确答案有多近』变成每一步都可计算的密集奖励,使全失败的 rollout 组也有非零方差的优势,让从未见过成功样本的任务也能提供训练信号;(3) 用这条管线+训练配方训练开源模型(9B/27B/320B),在 ALE-CM 上追平 GPT-6 Astra 和 Claude Opus 5 的 Pass@5,并零样本泛化到更长的 Terminal-Bench 3.0/4.0,同时保持中程 TB 2.1 上的通用编码能力。
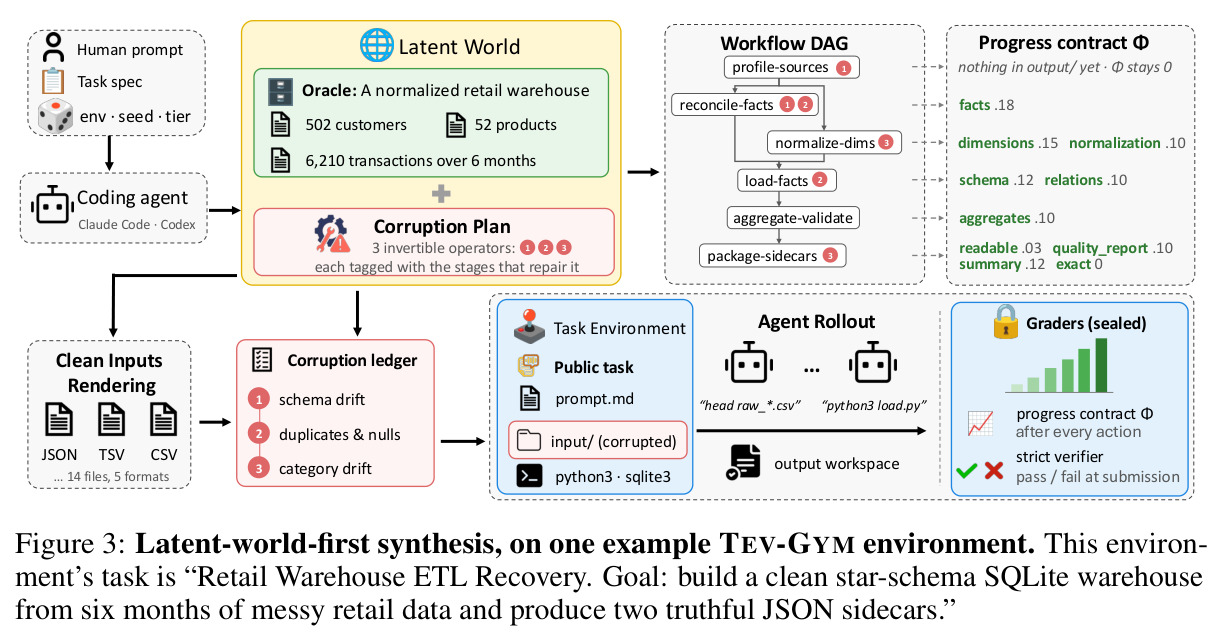
与已有工作不同的是,独特的切入角度是『潜在世界优先』(latent-world-first)的反向构建。既有管线通常让 LLM 分别生成任务描述、输入文件和检查器——三者各自看起来合理,却可能描述的不是同一个问题,这就是 artifact drift(工件漂移),且没有真正的答案钥匙。本文反其道而行:先用种子化程序构造一个完整、正确的隐藏世界 $W$(例如一个零售仓库的 502 个客户、52 个商品、6 个月 6210 笔交易),再用代码编译工作流 DAG,从 $W$ 渲染出干净输入(断言可往返恢复),最后按声明的缺陷计划做可逆破坏得到 agent 看到的任务。任务提示 $x$、输入树 $s^0$、严格验证器 $\mathrm{ver}_W$、进度势 $\Phi_W$ 四者都是同一个 $W$ 的函数($E=\langle x, s^0, \mathrm{ver}_W, \Phi_W\rangle$),天然防漂移。更关键的是:因为 $W$ 先于任务存在,每个正确的中间状态都能被直接渲染和打分——『进度』不需要人工步骤标注、训练奖励模型或 LLM 裁判,这是与过程奖励模型(PRM)路线的本质区别。
核心方法
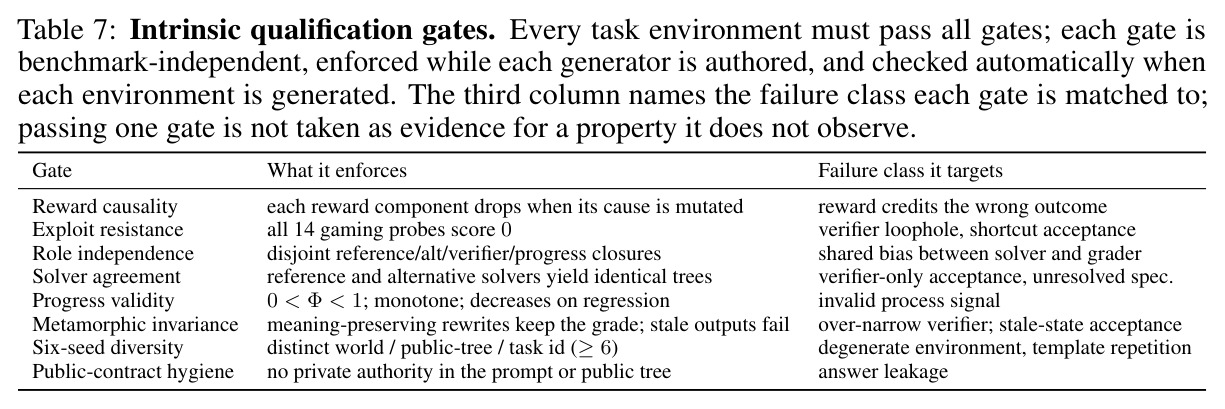
直觉上,让长程任务可训练需要两样东西:大量『确切知道标准答案』的任务,以及一把能把『离答案多近』量化成每步奖励的标尺。论文的做法是先把答案造出来、再把题目破坏出来。技术路线分六步(§2.1,Figure 3):Stage 0 从 ALE-CM 七个子域抽样任务规格,为每个规格人工(借助 coding agent)编写一个种子化生成器;Stage 1 由生成器按 seed 和规模档位(unit/small/full)程序化生成潜在世界 $W$——领域完整且正确的状态,并验证其不变量(唯一标识、合法连接、有限度量),同时抽取种子派生的缺陷计划(之后破坏哪些记录、用什么算子);Stage 2 用代码(无模型参与)把工作流编译成带依赖、允许并行和每阶段语义工作量的 DAG(如 profile-sources → reconcile-facts / normalize-dimensions → load-facts → aggregate-validate → package-sidecars),关键路径长度即任务视界;Stage 3 把 $W$ 投影成目标格式的干净输入文件(CSV/TSV/JSON/SQLite/safetensors/剥离二进制等 23 种格式),并断言渲染可往返;Stage 4 按缺陷计划施加可控破坏(schema 漂移、重复与缺失记录、类别漂移、分片索引打乱、过期缓存等)得到 agent 可见的 $s^0$;Stage 5/6 生成公开任务提示与密封的隐藏套件(14 个 gaming 探针、蜕变变换、过期输出反事实)。训练时每步按 turn 计分:第 $t$ 个 turn 得到 $\lambda r_t$,最后的 turn 额外得到终端项,优势用 return-to-go($\gamma=1$)减去同一 turn 指数的组均值。
核心创新有两条,相互咬合。第一条是『同一个世界的四个视图』:与让 LLM 分别生成任务、输入、检查器不同,提示 $x$、输入树 $s^0$、验证器 $\mathrm{ver}_W$、进度势 $\Phi_W$ 都是同一潜在世界 $W$ 的纯函数——验证是『对照确切的标准答案』而非『对照模型猜的答案』,从根上消除工件漂移。第二条是进度势函数与 PPRS:定义进度合同——节点集 $V$(每个节点是一个可对照 $W$ 检查的输出状态,如 warehouse 环境的 readable/schema/dimensions/facts/normalization/relations/aggregates/quality_report/summary),权重 $w_v>0$ 且 $\sum_v w_v=1$,带前置依赖集 $\mathrm{pre}(v)$;部分得分 $c_v(s)\in[0,1]$ 直接对照 $W$ 打分,且前置门控($\tilde c_v$ 取节点与全部前置中最低分,错误事实表上建出的正确聚合得 0 分),势为 $\Phi(s)=\sum_{v\in V} w_v\tilde c_v(s)\in[0,1]$。塑形奖励 $r_t=\Phi(s_t)-\Phi(s_{t-1})$,总奖励 $R(\tau)=\mathbb{1}[\tau\text{ 通过}]+\lambda\Phi(s_T)$($\lambda=0.25$ 全程固定)。与经典 PBRS 置零终端势不同,PPRS 刻意保留终端项以改变目标(这正是要修饥饿问题),但保证任何通过者得 $1+\lambda$、严格高于任何失败者的 $\le\lambda$,轨迹排序一致性保留。
方法步骤详情
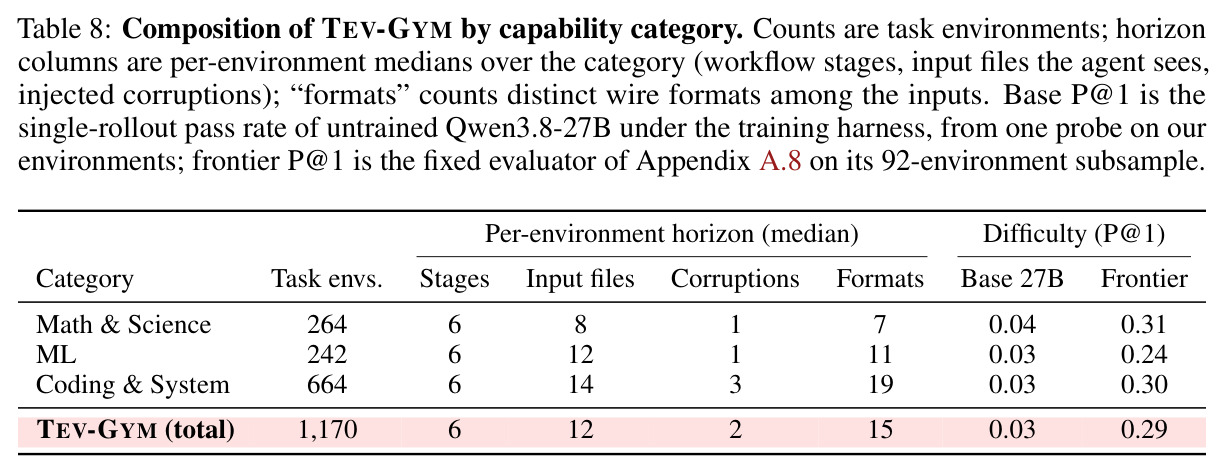
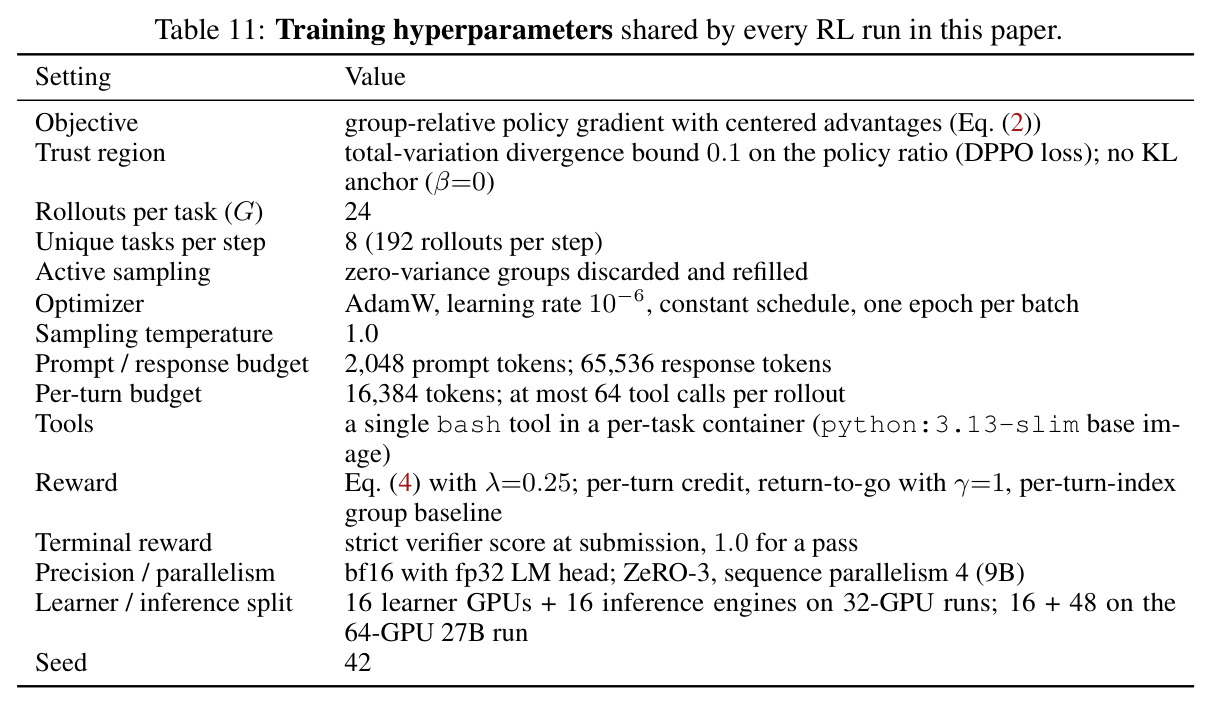
完整流程:(1) 任务源与生成器编写——从七个域的规格池(互联网挖掘的规格、MLE-bench 的 82 个 Kaggle 竞赛、量子计算域用 MQT Bench 电路套件与 Qiskit/TeNPy 文档)随机抽样,经可行性过滤(标准答案可构造、纯 CPU 可执行,排除活服务/视觉音频/重工具链/开放式任务)、相似度门控(与已注册生成器比对代码/规格/数据,拒绝近重复)和对抗评审(攻击隐藏捷径、视界过短、来源伪装)后,手写生成器;(2) 世界构建——种子化程序生成 $W$ 并验证不变量,同一抽取缺陷计划;(3) 工作流 DAG——纯代码编译阶段图与依赖,确定任务视界;(4) 渲染——纯函数生成干净输入(典型环境中位 12 个输入文件、最多 501 个,共 51 KB、最大 6.1 MB),断言从文件能精确恢复 $W$,因此正确解可从 agent 看到的东西计算出来且无需跑求解器就已知;(5) 可控破坏——施加声明的可逆缺陷算子(每个环境中位 2 处、1–7 处);(6) 输出公开规格(prompt.md,中位 583 token,声明输入角色、输出 schema、权威优先规则、允许工具链)和隐藏套件。每个环境 admission 前须通过八道自动资格门控(Table 7)。RL 训练(Appendix C):DPPO 优化器,$G=24$ 条 rollout/任务、每步 8 个任务(192 条),响应预算 65,536 token(每 turn 16,384)、至多 64 次工具调用、沙箱只暴露一个 bash 工具;AdamW 学习率 $10^{-6}$ 常数、温度 1.0、TV 散度界 0.1、无 KL 锚($\beta=0$);零方差组丢弃并主动采样补足。9B 模型在 264 个 unit 档任务上训练,27B 用全量 1,170 个环境,27B 用 4 节点 B200 或 8 节点 A100 约 4 天。
技术新颖性
技术新颖性分析:(1) 反向构建的彻底化——去噪、错误注入、代码变异、环境回放、指令回译、程序化谜题生成等既有反向方法只腐蚀单个已知答案的工件,本文腐蚀『整个世界的渲染』,并第一次让同一构建同时产出任务、精确验证器和渐进奖励三件套,四者函数式锚定在 $W$ 上;(2) 免标注的密集进度信号——不同于需要人工步骤标注的 PRM(Lightman et al. 2024)、训练出来的奖励模型或 LLM 裁判,$\Phi$ 由对照潜在世界的确定性打分器给出,对每个 seed 和规模档免费获得,且能表达回归(负增量惩罚覆盖正确表这类倒退行为);(3) 生成时门控而非 RL 时软过滤——八道门控(奖励因果性、14 探针全零的防作弊、参考/替代求解器输出树一致的规格无歧义、$\Phi$ 部分正确态严格在 $(0,1)$ 且单调、蜕变不变性、六 seed 多样性、公开合同卫生、角色代码闭包独立)在生成时自动拒收坏环境,这与『靠下游 RL 顺手过滤不可解任务』的既有做法形成方法学对比;(4) 训练细节上的两个非显然选择——按 turn 指数做组归一化(避免后期 turn 较小的 return-to-go 被全轨迹均值淹没、保留后期功劳)和 $\gamma=1$(把进度功劳经 telescope 传回早期动作),消融显示均优于 per-rollout 归一化与 $\gamma=0$ 的直接加性奖励(后者会反复奖励高势状态、导致更多轨迹耗尽上下文)。
实验结果
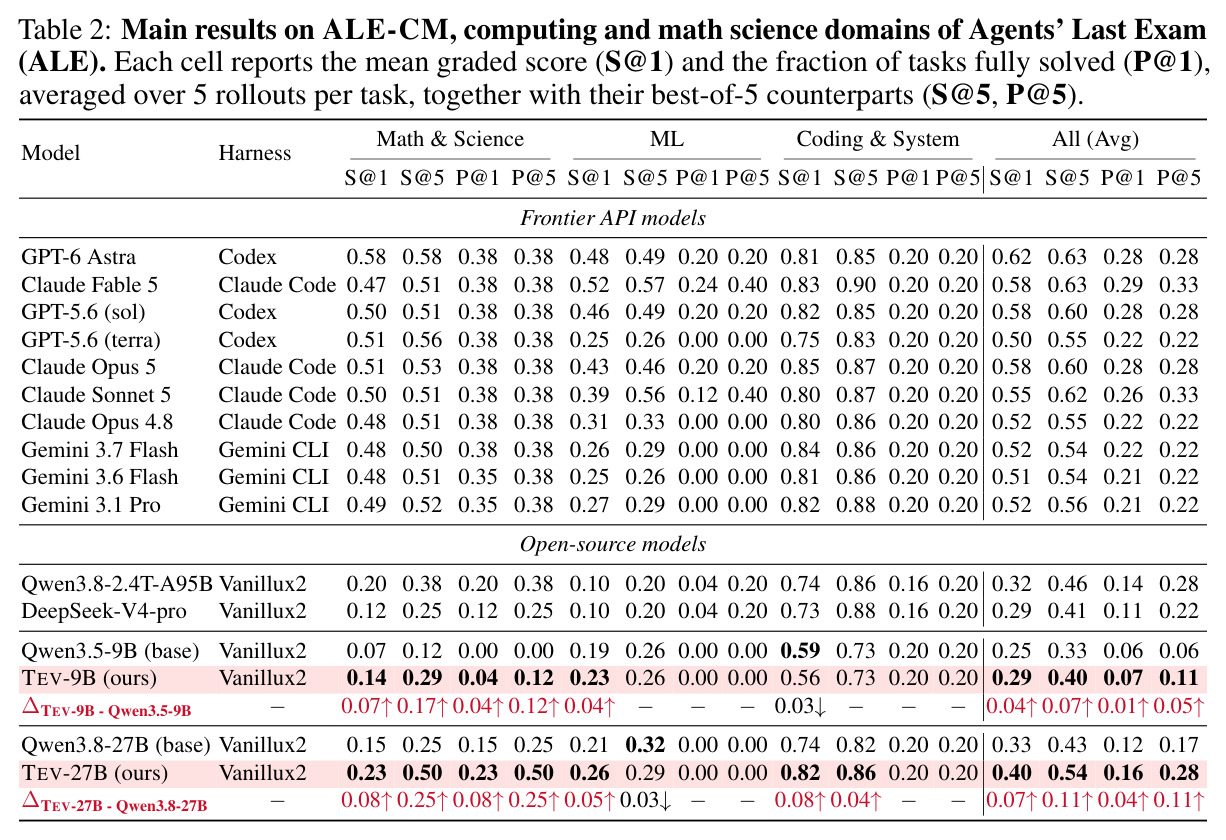
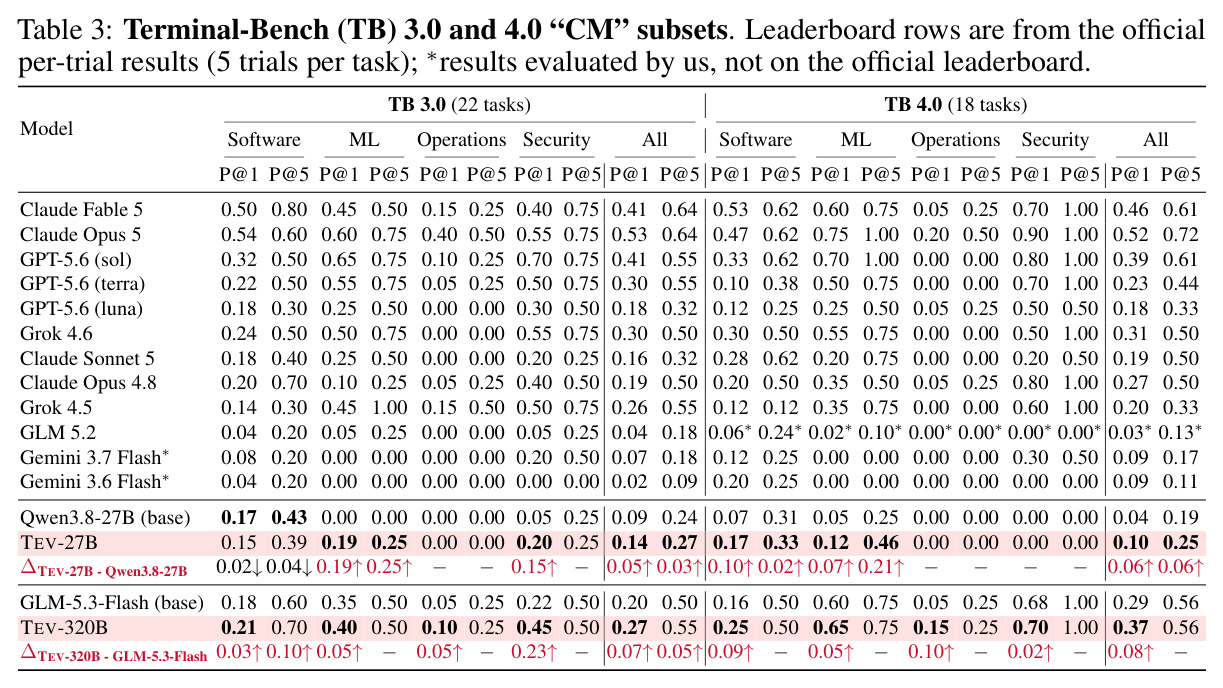
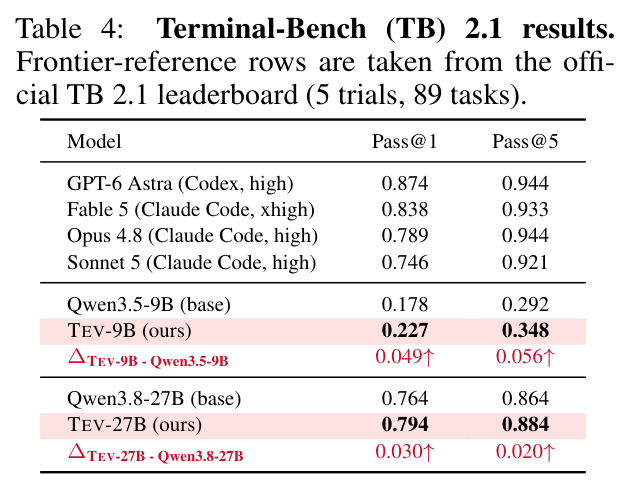
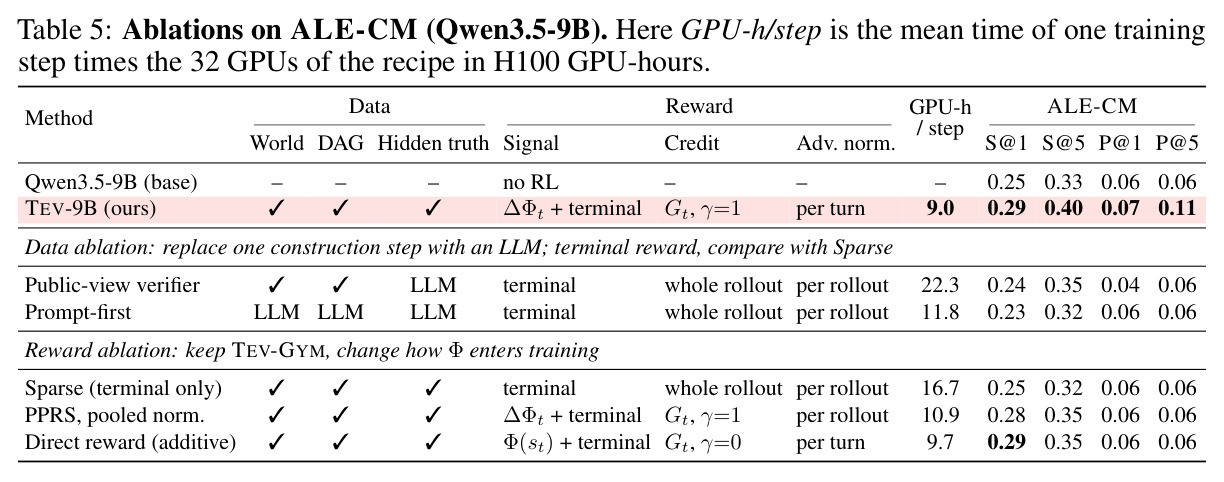
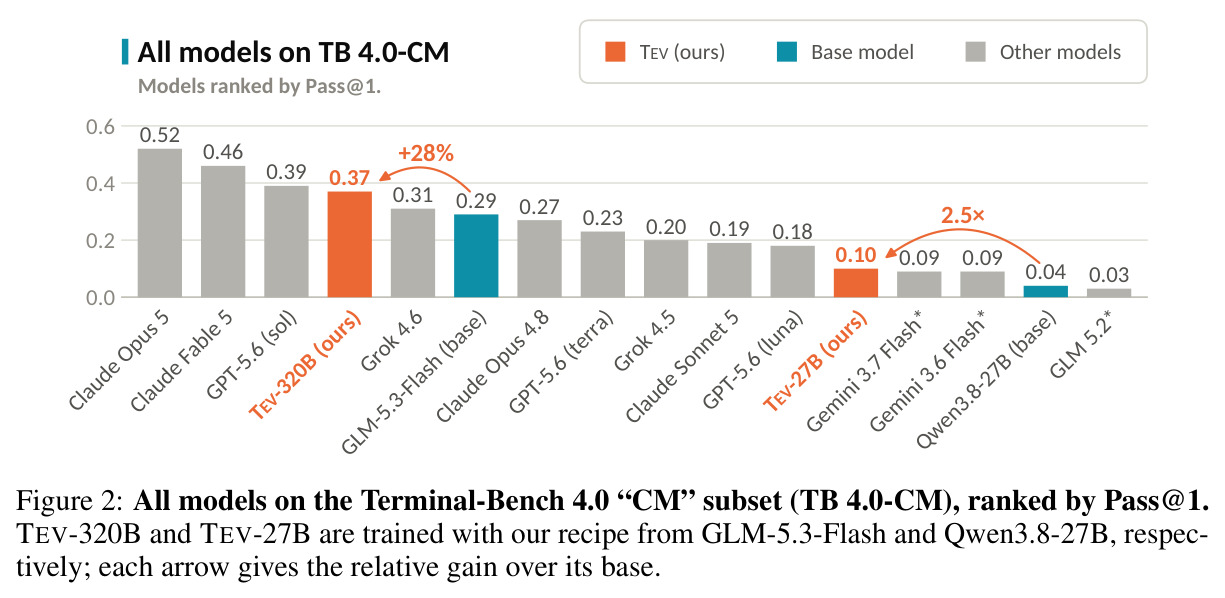
主结果分四块(训练用 DPPO,9B 在 264 个 unit 档任务、27B 在全量 TEV-GYM 上)。(1) 域内长程(Table 2,ALE-CM 18 个专家任务):TEV-27B 把 P@5 从 0.17 提到 0.28(+65%),追平 GPT-6 Astra 和 Claude Opus 5(均 0.28),达到最强前沿(Claude Fable 5 的 0.33)的 85%,S@1 0.33→0.40、S@5 0.43→0.54,并在 P@1 上超过 2.4T 参数的 Qwen3.8-2.4T-A95B(0.16 vs 0.14);TEV-9B(数据量只有 264 题)P@5 0.06→0.11(+83%)、S@1 0.25→0.29(+16%)。(2) 更长程泛化(Table 3):TB 4.0-CM 上 P@1 0.04→0.10(2.5 倍,+150%),TB 3.0-CM 上 0.09→0.14(+56%),超过 GLM 5.2(两套均 0.03)和 Gemini 3.7 Flash(0.09/0.07);同一配方用于 GLM-5.3-Flash 得 TEV-320B,TB 3.0 P@1 0.20→0.27(+35%)、TB 4.0 0.29→0.37(+28%),成为两套子集上最强开源模型,TB 4.0 上仅落后 Claude Opus 5(0.52)、Claude Fable 5(0.46)和 GPT-5.6 sol(0.39),最大单项提升在 TB 3.0 security(0.22→0.45)。注意 320B 的提升集中在 P@1 而非 P@5,说明训练主要让模型更可靠地解出已能触及的任务。(3) 中程保持(Table 4,TB 2.1 零数据):TEV-9B P@1 0.178→0.227(+28%)、P@5 0.292→0.348;TEV-27B 0.764→0.794,与 Claude Opus 4.8(0.789)持平。(4) 消融(Table 5,9B):公审验证器变体(让模型从 agent 视角写验证器)导致 88% 的组被丢弃、S@1 反而低于 base(0.24 vs 0.25);prompt-first 自指 Baseline 0.23;纯终端奖励 S@1 0.25 且 16.7 GPU-h/步;PPRS 0.29 且 9.0 GPU-h/步——同性能下省 46% 算力;在 27B 上终端奖励几乎全是零优势组,连一个优化器步都完不成。定性结果(Figure 5):k8s 支付 API 根因分析任务上,TEV-27B 与 Claude Fable 5 一样用具体测量(约 6.6–8 秒的启动耗时 vs 5 秒 initialDelaySeconds)支撑 liveness-probe 根因并判定回滚安全(0.97 分),而 base 模型和 GPT-6 Astra 只引用症状、以『回滚安全性未验证』为由拒绝回滚,丢失决定性评分组件(0.70/0.75)。
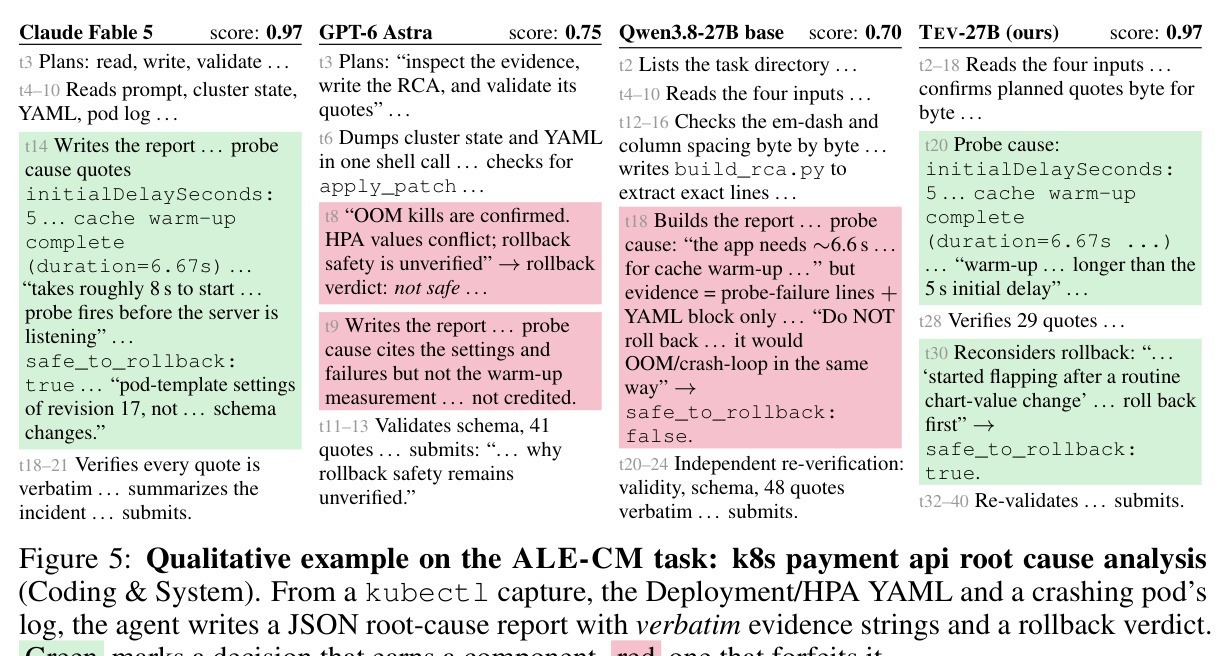
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALE-CM(Agents' Last Exam 计算与数学分片,18 任务) | Pass@5 完全解决率 | TEV-27B 0.28 | Qwen3.8-27B 基座 0.17;GPT-6 Astra 0.28;Claude Opus 5 0.28 | +65%,追平最强前沿闭源模型 |
| ALE-CM | S@5 平均得分 | TEV-27B 0.54;TEV-9B 0.40 | Qwen3.8-27B 0.43;Qwen3.5-9B 0.33 | +0.11(27B);+0.07(9B) |
| TB 4.0-CM(Terminal-Bench 4.0 计算与数学子集,18 任务) | Pass@1 | TEV-27B 0.10;TEV-320B 0.37 | Qwen3.8-27B 0.04;GLM-5.3-Flash 0.29;Claude Opus 5 0.52 | 2.5×(+150%);+28%,开源最强 |
| TB 3.0-CM(22 任务) | Pass@1 | TEV-27B 0.14;TEV-320B 0.27 | Qwen3.8-27B 0.09;GLM-5.3-Flash 0.20;Claude Opus 5 0.53 | +56%;+35%,超过 Grok 4.5 与 Claude Opus 4.8 |
| TB 2.1(中程终端基准,89 任务,零训练数据) | Pass@1 / Pass@5 | TEV-9B 0.227/0.348;TEV-27B 0.794/0.884 | Qwen3.5-9B 0.178/0.292;Qwen3.8-27B 0.764/0.864;Claude Opus 4.8 0.789 | 9B +28%/+19%;27B +0.030,与 Opus 4.8 持平 |
| ALE-CM 消融(Qwen3.5-9B,同数据) | S@1 / GPU-h 每训练步 | PPRS:0.29 / 9.0 | 终端奖励 0.25 / 16.7;公审验证器 0.24 / 22.3;直接加性奖励 0.29 / 9.7 | 同性能省约 46% 算力;终端奖励在 27B 上无法完成任何优化步 |
局限与改进
作者承认的局限:(1) 研究只覆盖合成的终端环境,未触及真实世界接口;(2) 最难基准上与前沿差距仍大——TB 4.0-CM 上 TEV-27B 只有 0.10,而 Claude Opus 5 是 0.52,作者归因于需要更强的开源基座才能充分消化 TEV-GYM 的高难度;(3) 支持新工作流需要人工编写并验证新的环境组件(生成器),一次性成本不低;(4) 因资源限制只对齐了 ALE 的计算与数学七个子域,其他域未覆盖。我自己的观察:(5) 『CM 子集』由 Claude 逐题判定 TB 任务是否属于计算与数学域(哪怕只沾边就保留),选择标准宽松且由 AI 裁判执行——虽然与全基准排名的 Pearson 相关达 0.96/0.97,仍可能引入偏向自家数据分布的选择偏差,且部分对比行是自测(表中标 *)而非官方榜单数字;(6) 可逆破坏假设限制了任务类型:因为要求从被破坏的 $s^0$ 能精确恢复 $W$,任务本质都是『恢复/重建』类(ETL 修复、checkpoint 整合、账目重构),开放式探索型长程任务(可行性过滤明确排除了『改进这个系统』类)无法用此管线表达;(7) 基座强绑定:只在 Qwen3.5-9B/Qwen3.8-27B/GLM-5.3-Flash 上验证,配方对其他模型家族的通用性未知,且 base 27B 在 TEV-GYM 上只能解出 3.2% 的环境、52% 的 rollout 耗尽上下文——对更弱的模型这份数据可能过难(9B 只敢用 unit 档 264 题);(8) $\lambda=0.25$ 未调参,奖励塑形对随机策略期望排序的扭曲理论上限 0.2,虽实测无害(所有结论都以严格验证器的通过率报告)但缺乏系统分析;(9) 评测规模小——ALE-CM 18 题、TB 4.0-CM 18 题,0.04 的 P@1 差异就只是一道题,统计功效有限,且 frontier 模型用各自原生 harness、开源模型用 Vanillux2,harness 差异本身是潜在混杂因素。
独立分析的弱点
(1) 领域广度是结构性短板:1,170 个环境全部集中在『计算与数学』,长程科学发现(生物实验、化学合成、物理仿真)等 ALE 其他域无法直接复用现有生成器组件,每个新域都要重新走一遍『抽样规格→手写生成器→对抗评审』的重流程,扩展边际成本其实没有『30 秒一个环境』听起来那么低——那只是已写好生成器后的边际成本。改进方向:让 coding agent 自动起草生成器并用资格门控自动验收,把人从环路里进一步移出。(2) 可逆性假设封死了任务类型空间:$s^0$ 必须完全决定 $W$,意味着所有任务都是『从损坏状态恢复唯一正确答案』,没有多解性、没有真实的部分可观察决策(agent 看不到的就是不存在的)。改进方向:引入多参考世界集合,势取 $\max_k \Phi_k(s)$,即可表达有多个可接受终态的开放任务。(3) 进度合同是静态声明的:若 agent 找到 DAG 之外的合理解法路径,$\Phi$ 可能不升反降;虽然蜕变不变性门控部分缓解(语义保持的改写不扣分),但论文没有测量『非参考路径被误罚』的发生率。改进方向:用多条独立求解器轨迹校准 $\Phi$ 的路径覆盖度。(4) 统计功效不足:核心评测各只有 18–22 题,且 frontier 对比混用官方榜单与自测数字,建议预注册子集选择协议并报告置信区间。(5) PPRS 超参($\gamma=1$、turn 指数归一化、$\lambda=0.25$)是单点经验选择,与 return-to-go 文献的最优组合未经扫描;27B 上终端奖励完全训不动这个事实也提示,密集项的有效权重可能需要随策略进步而退火。
未来方向
作者提出的方向:简化环境组件的编写与验证流程、扩展域覆盖、把这套数据与更强的开源基座结合,让更多专业工作流可以复现地进入 RL,而不需要人工步骤标注或语言模型裁判。基于本文成果可延伸的方向:(1) 自我改进闭环——论文动机直指自动化发现与递归自我改进(RSI),可以让 coding agent 为生成器提需求、生成新规格,用 unit/small/full 三档难度阶梯做课程学习,使环境库随模型能力共同演化(ZPD 式课程);(2) 把 $\Phi$ 从训练奖励复用为推理时信号——过程监控、early-stopping、多 rollout 选择(用势而非终端通过率做 best-of-n),这在终端奖励几乎全零的长程场景尤其有价值;(3) PPRS 与离线数据结合:对失败轨迹的势增量做 DPO 风格的进度对比,摆脱在线 rollout 的高成本;(4) $\lambda$ 的自适应调度——训练初期更依赖密集项、后期逐步回归纯终端奖励,理论上可同时保留早期信号与最终目标对齐;(5) 用潜在世界做可解释性探针,检验模型内部是否真的构建了『世界状态』表征而非表面模式匹配;(6) 若生成器开源,可用 strength-2 覆盖数组自动引导社区众包补齐 19 个覆盖轴的缺口,把『多样性』从声明变成可检查的属性。
复现评估
复现友好度整体较高,但要分两层看。数据层:每个环境是『生成器+seed+规模档』的确定性纯函数,生成时零模型调用,单个环境中位 30 秒 CPU(P90 82 秒)即可精确再生,含双参考求解器运行、隐藏套件密封和 $\Phi$ 预览;论文附录给出了全部八道资格门控的形式化定义(Table 7)、19 个覆盖轴、按域统计(Table 8)和三个端到端环境走查(AWS 成本优化、EnergyPlus 楼宇控制、SEC 财报重构),结构去污染可验证(与所有评测集不共享任何 13-gram/8-gram,最近邻 prompt Jaccard 0.13–0.22)。但需注意:正文未明确 TEV-GYM 环境库或生成器代码已随论文发布(只有项目页 tev-agent.github.io),而生成器本身需要 coding agent 辅助编写加作者评审,这个一次性成本是复现的最大门槛。训练层:三个基座(Qwen3.5-9B、Qwen3.8-27B、GLM-5.3-Flash)公开,DPPO 已发表,Table 11 列出全部超参($G=24$、每步 8 任务、lr $10^{-6}$、65k token 响应预算、TV 界 0.1、$\beta=0$、seed 42),每个消融只改单一组件。算力门槛:27B 需 4 节点 B200 或 8 节点 A100 训练约 4 天(64 GPU 卡级别),约数十 GPU-卡周,学术实验室可承受但不算轻量;9B 消融约 9.0 GPU-h/步。评测层:ALE 与 TB 全公开,但长程评测本身昂贵——每任务 5 次 rollout、单任务评估至多 8 小时。总体:方法描述详尽、超参完整、门控可核查,若数据与代码确实开源,属于高可复现工作;在数据发布前,复现的主要工作量在重新实现生成器框架与资格门控。
论文图表
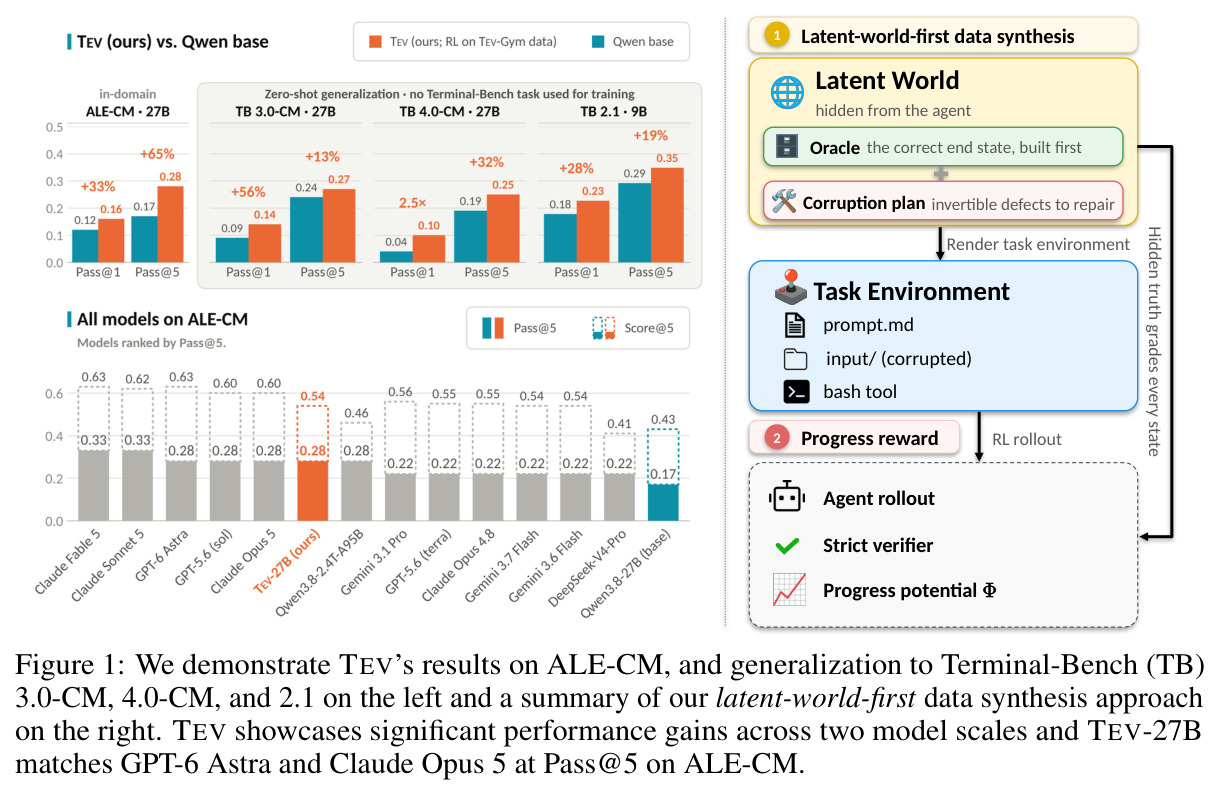
左侧汇总核心结果:TEV-9B/27B 在 ALE-CM 上的提升、向 TB 3.0-CM/4.0-CM/2.1 的零样本泛化,标注 TEV-27B 在 ALE-CM 上 Pass@5 追平 GPT-6 Astra 和 Claude Opus 5;右侧是潜在世界优先合成的流程示意:隐藏于 agent 视野的潜在世界(先神谕式构造正确终态 Oracle)→ 缺陷计划(声明可逆缺陷待修复)→ 渲染出任务环境(prompt.md + 被破坏的 input/ 目录 + bash 工具),agent rollout 的每个状态由进度势 Φ 实时评分,提交时由严格验证器给出通过/失败。
一张图同时给出论文的两大贡献(数据合成管线 + 渐进奖励训练)和最重要的结果数字,是快速把握全文逻辑的入口。
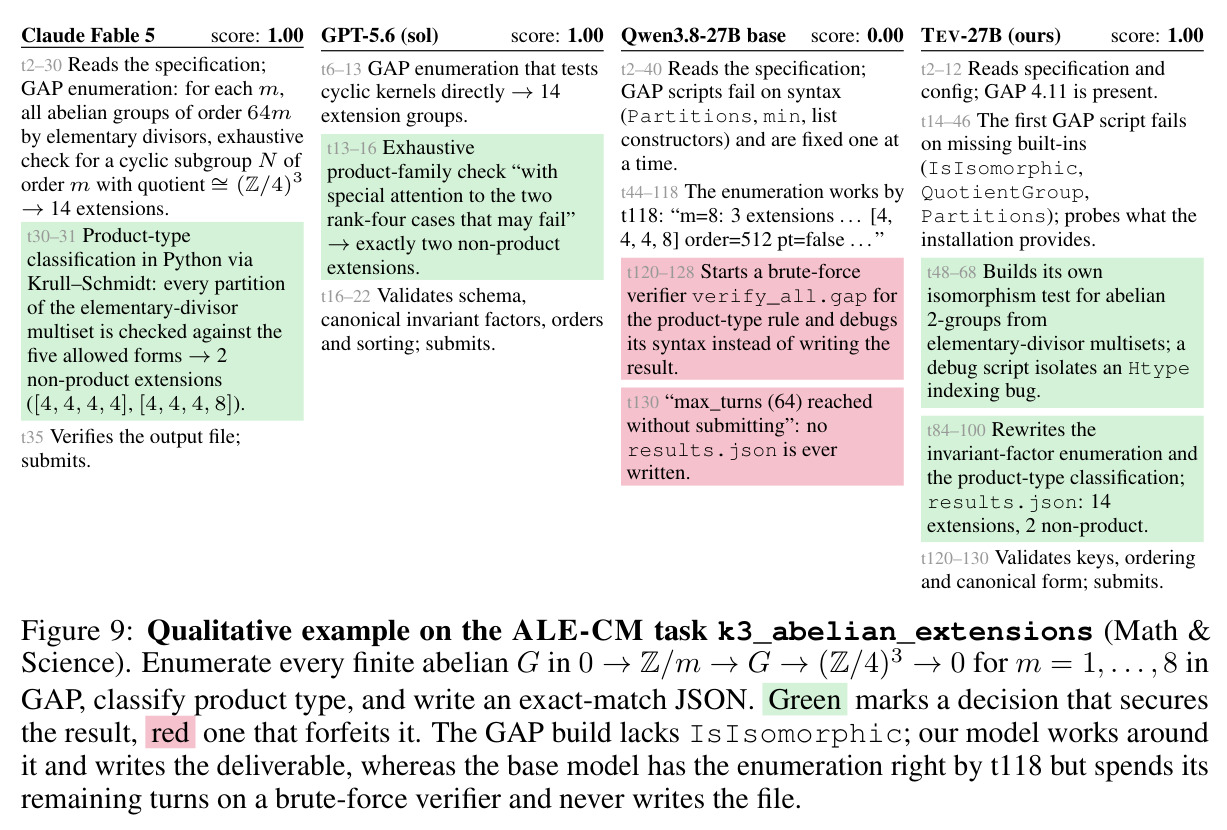
附录 C.3 的定性示例:Ising 模型测量后处理任务上各模型的推理过程对比,展示不同模型在长程数学/物理任务中的逐步决策与证据使用差异。
补充展示方法在 Math & Science 类任务上的定性效果,与 Figure 5 的系统类任务互为补充。
附录 C.3 的定性示例:分支定界求解非对称旅行商问题(ATSP)任务上的模型行为对比,展示模型如何在多阶段优化工作流中组织搜索与剪枝。
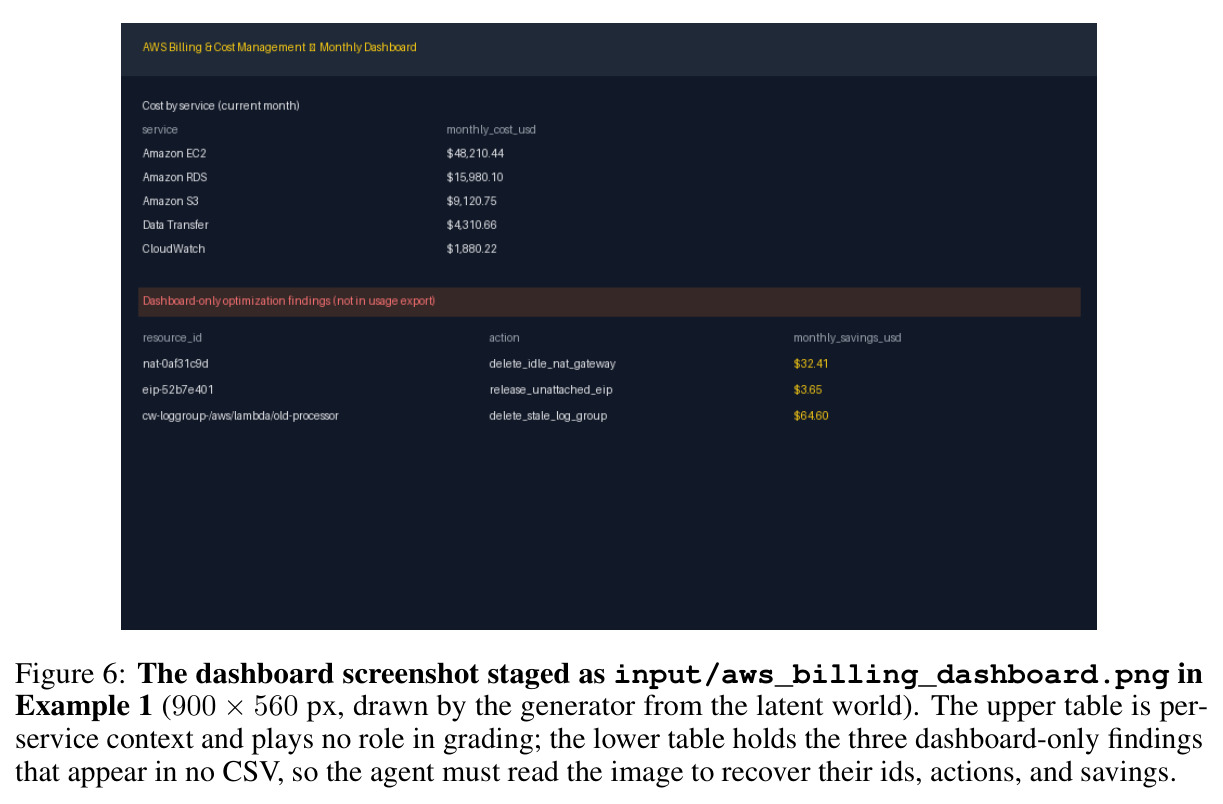
展示 TEV-GYM 中运筹优化类环境的样子以及训练后模型在算法性长程任务上的行为改善。