OmniCompass:面向全模态视频定位与理解的整体式基准 OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
用配对目标指定、视听双轨道和时空定位统一评测50个大模型的视频理解能力
前置知识
时序定位(Temporal Grounding, TG)
给定视频和一条描述目标事件的查询,模型需要输出该事件发生的起止时间区间。评测常用指标有 R@0.5(预测区间与真值的 tIoU 超过 0.5 的样本比例)和 mtIoU(平均时间交并比),其中 tIoU 定义为预测区间与真实区间交集长度除以并集长度,是定位任务的核心度量。
TG 是 OmniCompass 三大任务之一,读懂结果表中 R.@0.5、mtIoU、CSTG 这些列的前提是理解这一任务范式。
空间定位(Spatial Grounding, SG)
给定时间段和目标描述,要求模型在该区间的起始和结束时刻各输出一个包围盒(bounding box)来定位目标。框的准确性用 IoU(交并比)衡量,汇总为 msIoU 和 AP@0.5。本文沿用 V-STaR 协议:时间区间是给定的,模型只做空间定位,不要求自己先找时间段,坐标归一化到 0-1000。
SG 是三个任务中最弱的一环(部分模型 msIoU 接近 0),理解其「给定区间、两端各一框」协议才能正确解读模型的失败模式。
全模态大模型(Omni-modal MLLM)
指能联合处理图像、视频、音频和文本的多模态大语言模型,与只吃视觉帧的视频 LLM 的关键区别是拥有原生音频编码器,能直接接收视频同步音轨。典型代表包括 Gemini 系列、Qwen-Omni 系列、video-SALMONN 等。OmniCompass-AV 轨道只允许这类模型参加,因为任务答案依赖音频证据。
本文 VL/AV 双轨道的分设计正建立在「能否接收原生音频」这一架构差异上,AV 轨道 32.8 分的专有-开源差距是全文最重要的发现之一。
跨指定一致性分数(Cross-Specification Consistency, CS)
本文提出的指标,联合衡量模型在配对 Text 与 Text+Image 两种设定下的正确性与一致性。以 TG 为例,$\mathrm{CS}_{TG}=\frac{1}{N_{TG}}\sum_{i=1}^{N_{TG}}\min\{g_i^{T}, g_i^{TI}, a_i\}$,其中 $g_i^{T}$、$g_i^{TI}$ 是两种设定下预测与真值的 tIoU,$a_i$ 是两次预测之间的 tIoU;SG 在起止边界框上取 $\min$;QA 则要求 $\hat{y}_i^{T}=\hat{y}_i^{TI}=y_i$。取 min 保证「两次都正确且互相吻合」才能得高分。
CS 及其平均值 CSAvg 是本文所有主表的汇总指标,不理解 min 的设计意图就无法理解「为什么 CS 系统性低于单设置分数」。
均匀抽帧与时间戳序列化
多模态模型处理视频的标准做法:从整段视频均匀采样固定数量的帧(本文为 64 或 32 帧)输入模型。时间戳序列化指在每帧前插入文本形式的时间标记(如「Timestamp: 48.0 seconds.」),沿用 TimeLens 的做法,帮助模型把采样帧与视频中的绝对时刻对齐,从而输出更准的时间区间。
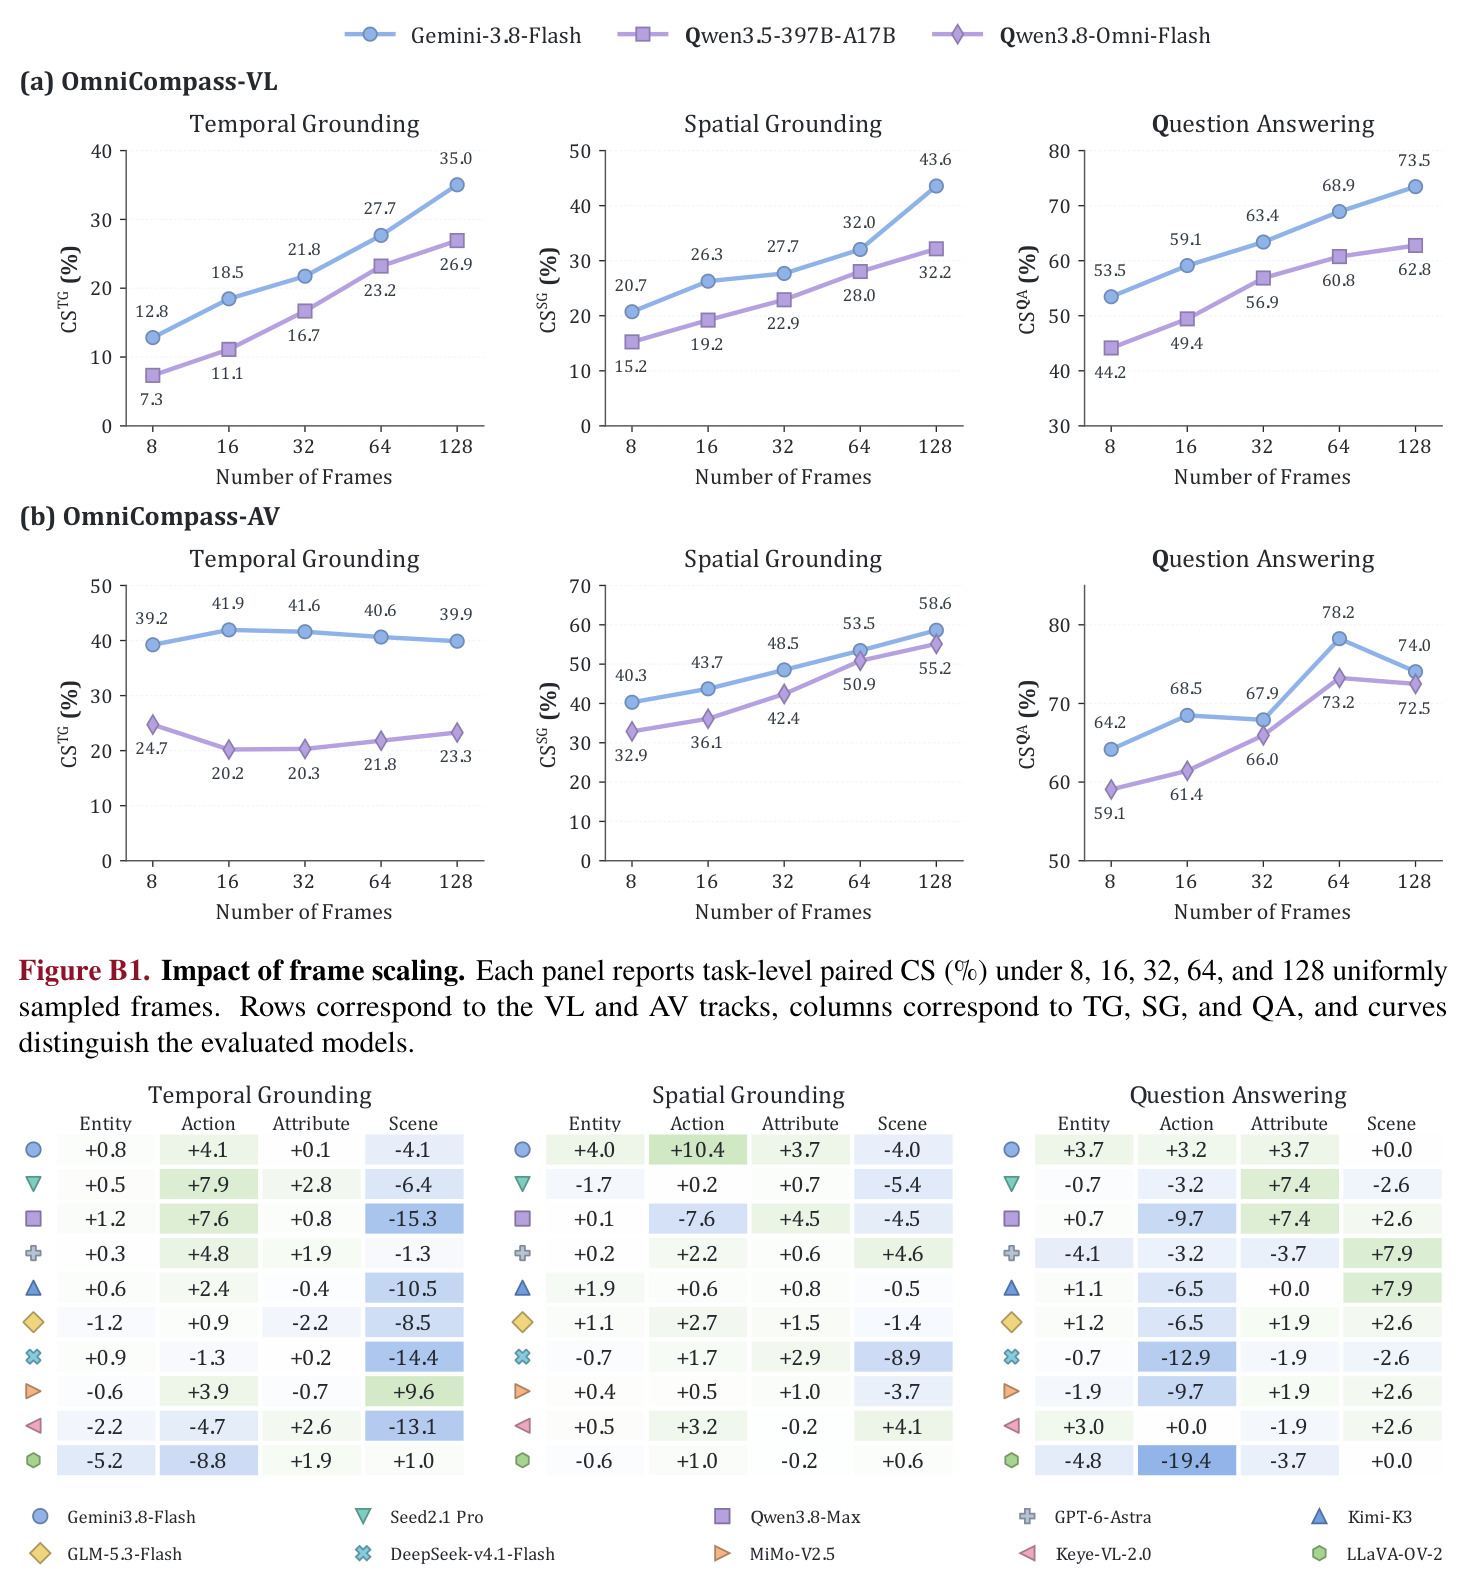
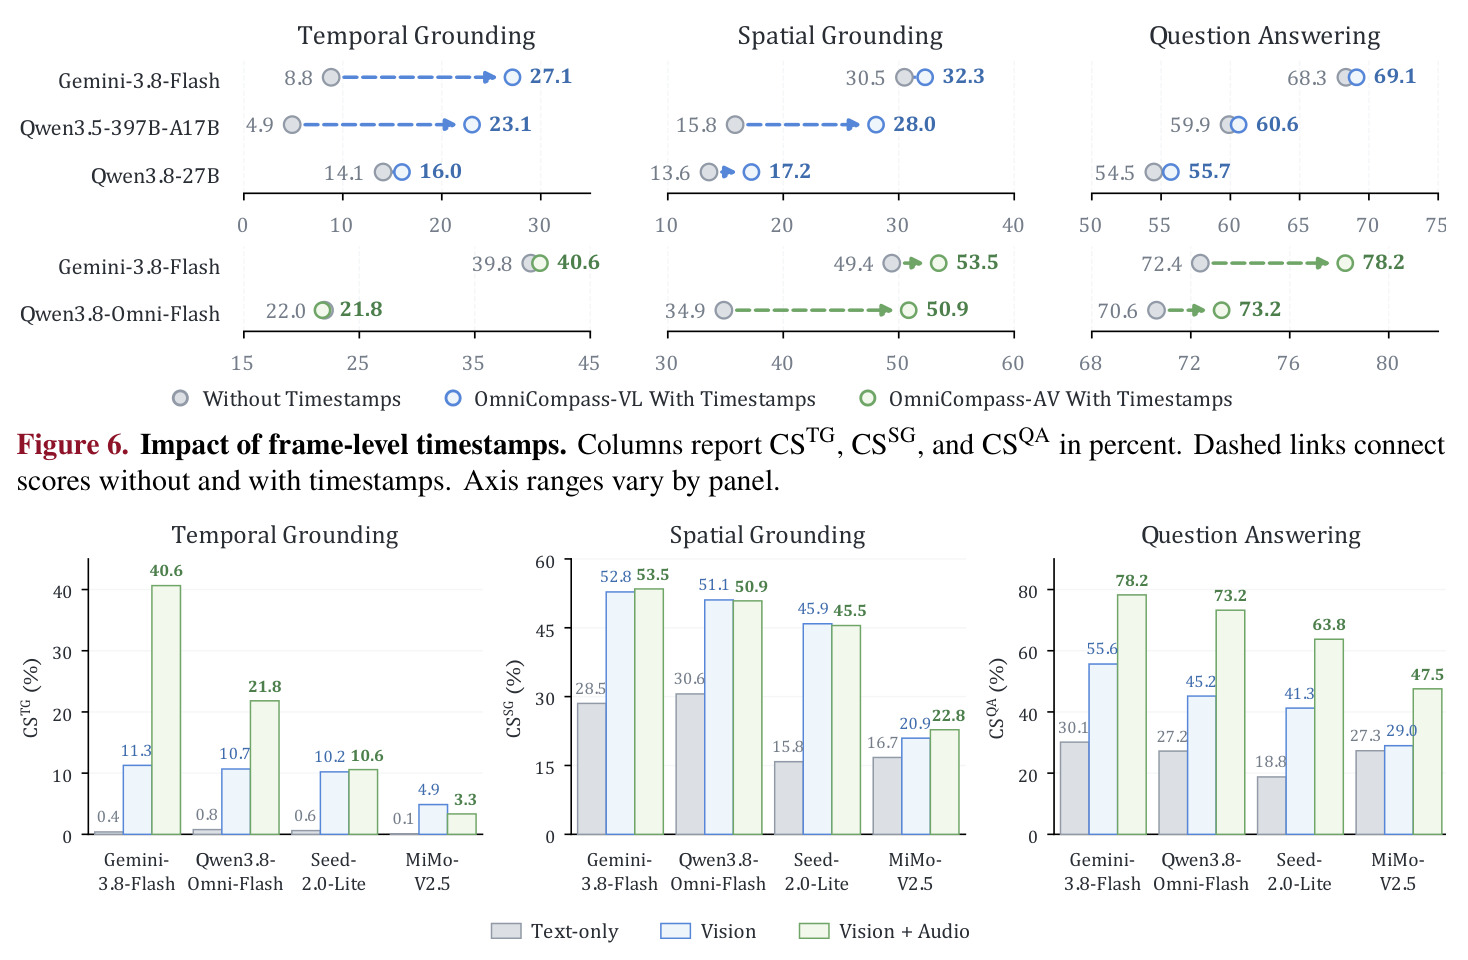
这是本文消融实验的关键变量:加时间戳平均提升 CSAvg 4.9-6.5 分,其中 TG 最高提升 18.3 分,是极具工程价值的免费改进。
研究动机
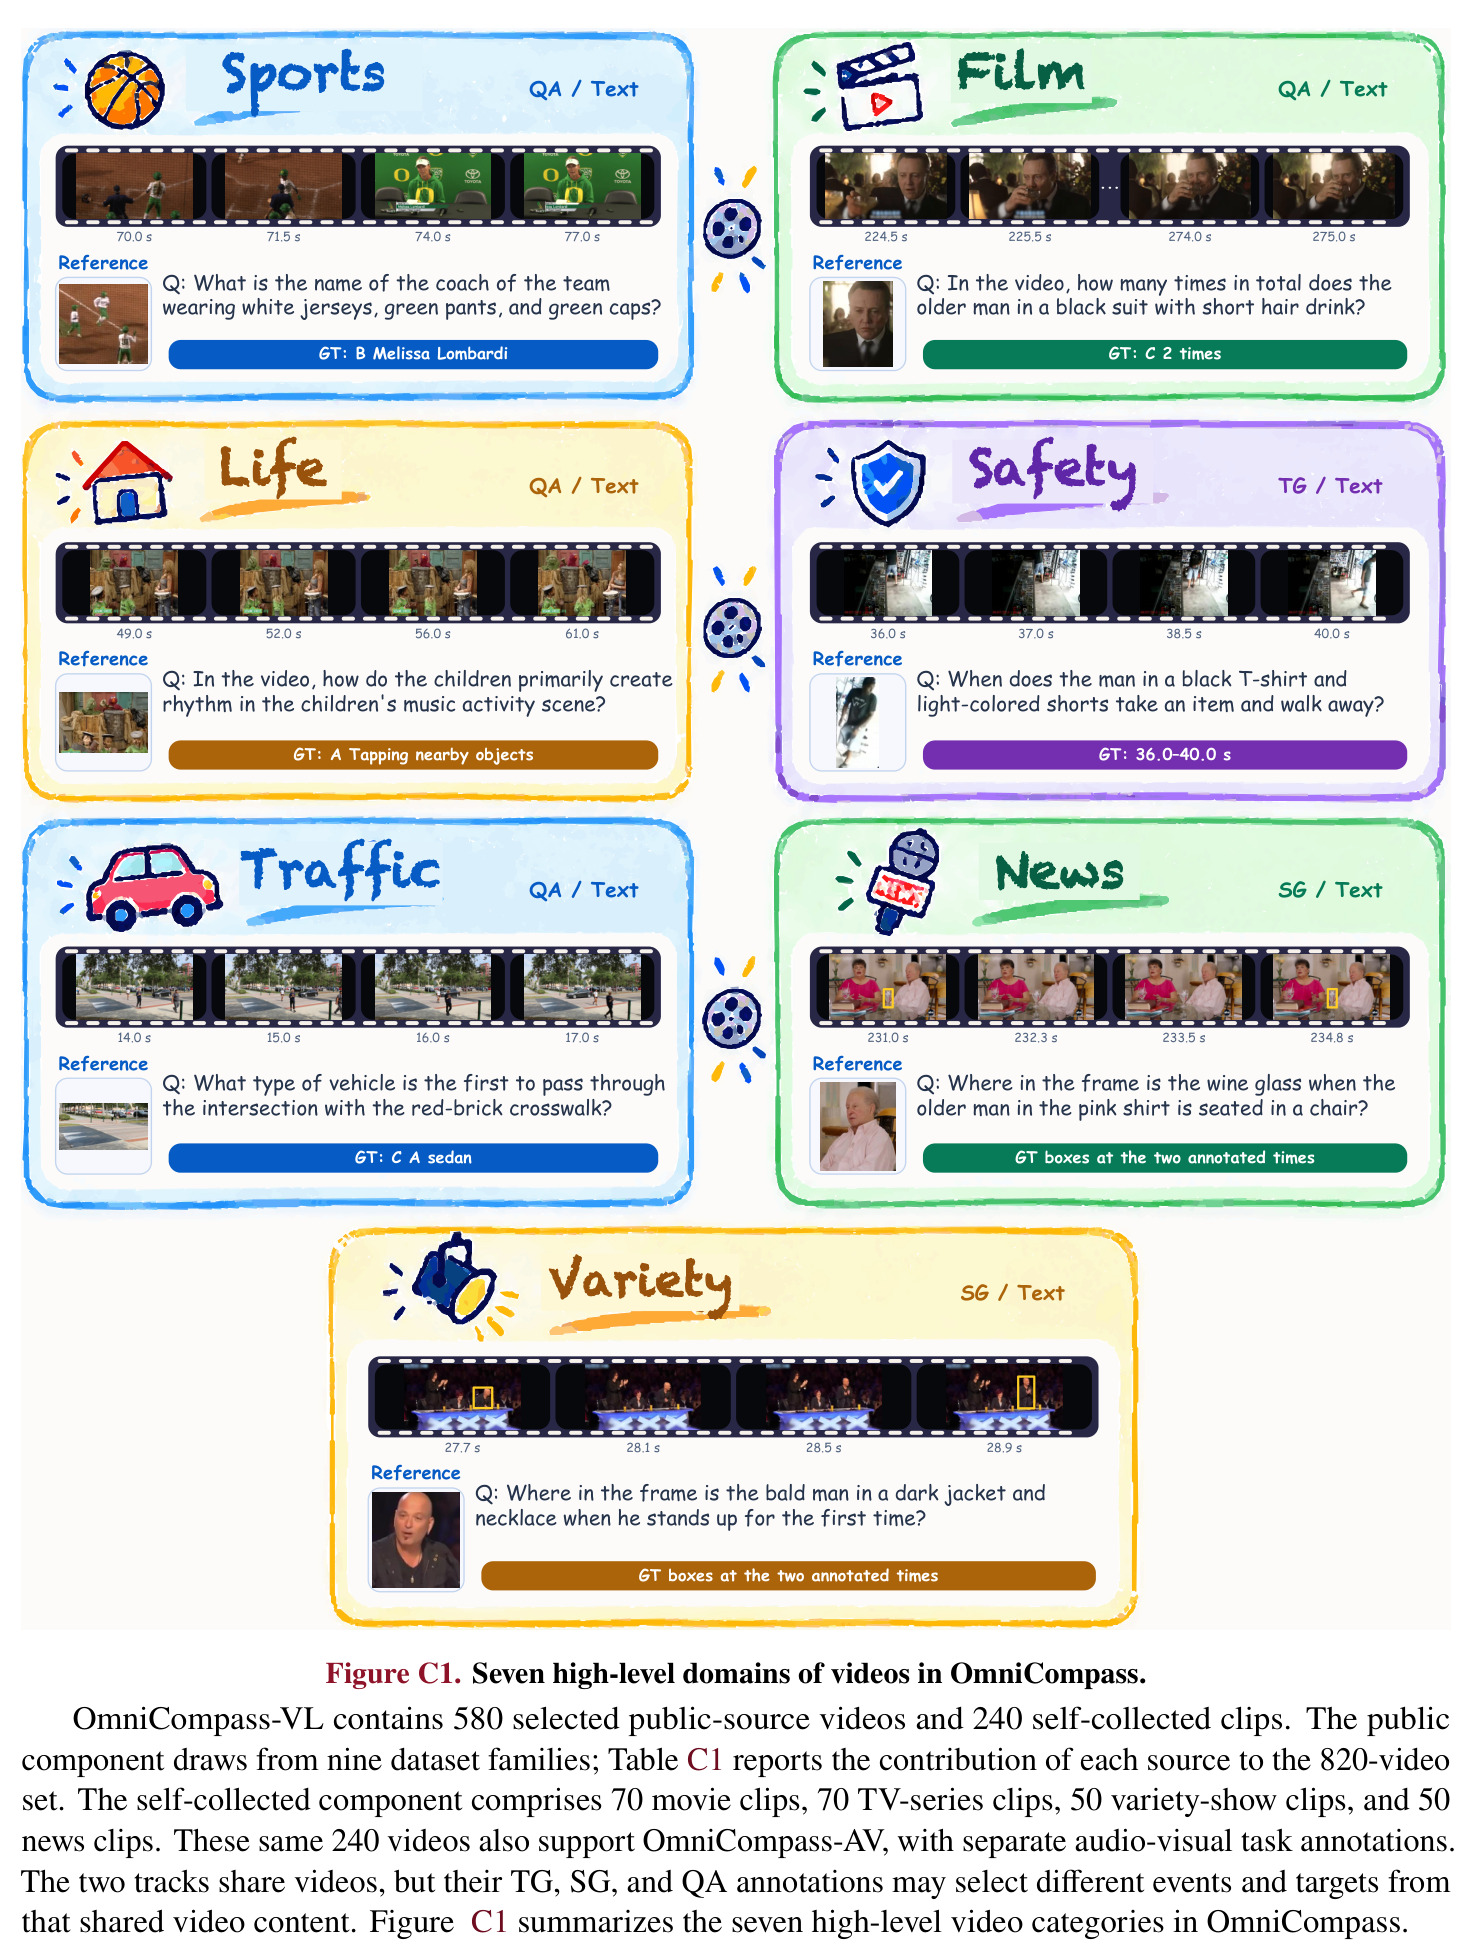
现有视频理解基准在四个设计维度上各自为政,导致无法对全模态视频理解做系统性诊断。具体而言:其一,证据类型割裂——Video-MME、CG-Bench、LongVideoBench 等只考纯视觉证据,WorldSense、Video-MME-v2、Daily-Omni 等只考音视频联合证据,没有一个基准同时覆盖两种设定,无法区分「视觉感知弱」和「视听对齐弱」这两类完全不同的失败;其二,目标指定方式僵化——绝大多数基准只允许用文本描述目标(如「美国队 7 号球员何时首次得分?」),IV-Bench 只支持文本+参考图像,但没有基准在同一目标上同时评测两种指定方式,因此无法知道模型换一种指称方式后是否还能认出同一个目标;其三,任务覆盖碎片化——多数基准只做问答或只做定位,视听类基准几乎不覆盖时序/空间定位。后果是:一个模型在篮球视频上可能答对「得了几分」,却说不准「何时发生」、指不出「球员在球场哪里」,而现有基准无法把这三类失败拆开定位。
本文的目标是本文要构建一个整体式(holistic)的全模态视频定位与理解基准 OmniCompass,在四个维度上统一评测:目标指定(同一目标配对 Text 与 Text+Image 两种设定,共享同一视频、任务语义和真值);证据轨道(OmniCompass-VL 只用视觉证据,OmniCompass-AV 额外要求原生音频);任务覆盖(时序定位 TG 问「何时」、空间定位 SG 问「何地」、问答 QA 问「何事」,每个视频三题齐全);视频时长(30 秒至 88.4 分钟,覆盖短/中/长三档)。量化目标包括:820 个视频、2,460 个 VL 实例、240 视频的 AV 子集 720 实例,全部人工标注并多轮质检(约 1,800 人工小时);提出跨指定一致性分数 CS 使正确性与一致性可同时度量;并在 50 个 MLLM 上完成诊断性评测,回答「模型是真的认出了目标还是碰巧答对」。
与已有工作不同的是,本文最独特的切入点是「同一目标、两种说法」的配对评测思想。与 CG-Bench、V-STaR 等只给文本查询的基准不同,OmniCompass 让每道题同时以「美国队 7 号球员何时首次得分?」(Text)和「参考图中的球员何时首次得分?」(Text+Image)两种形式出现,从而把「目标识别」从「证据推理」中剥离出来做控制变量实验。第二个被忽视的点是 grounding 在音视频评测中的缺席:现有视听基准(WorldSense、Daily-Omni、OmniVideoBench)只有 QA,而本文证明 TG/SG 才是模型最痛的短板。第三个观察是输入协议本身被低估:正文与消融均显示,仅在每帧前注入时间戳这一免费改动就能平均提升 CSAvg 4.9-6.5 分。CS 指标的 min 设计则堵住了「一致性虚高」的漏洞——仅两次预测互相吻合而都错,或都对但定位不重叠,都拿不到分。
核心方法
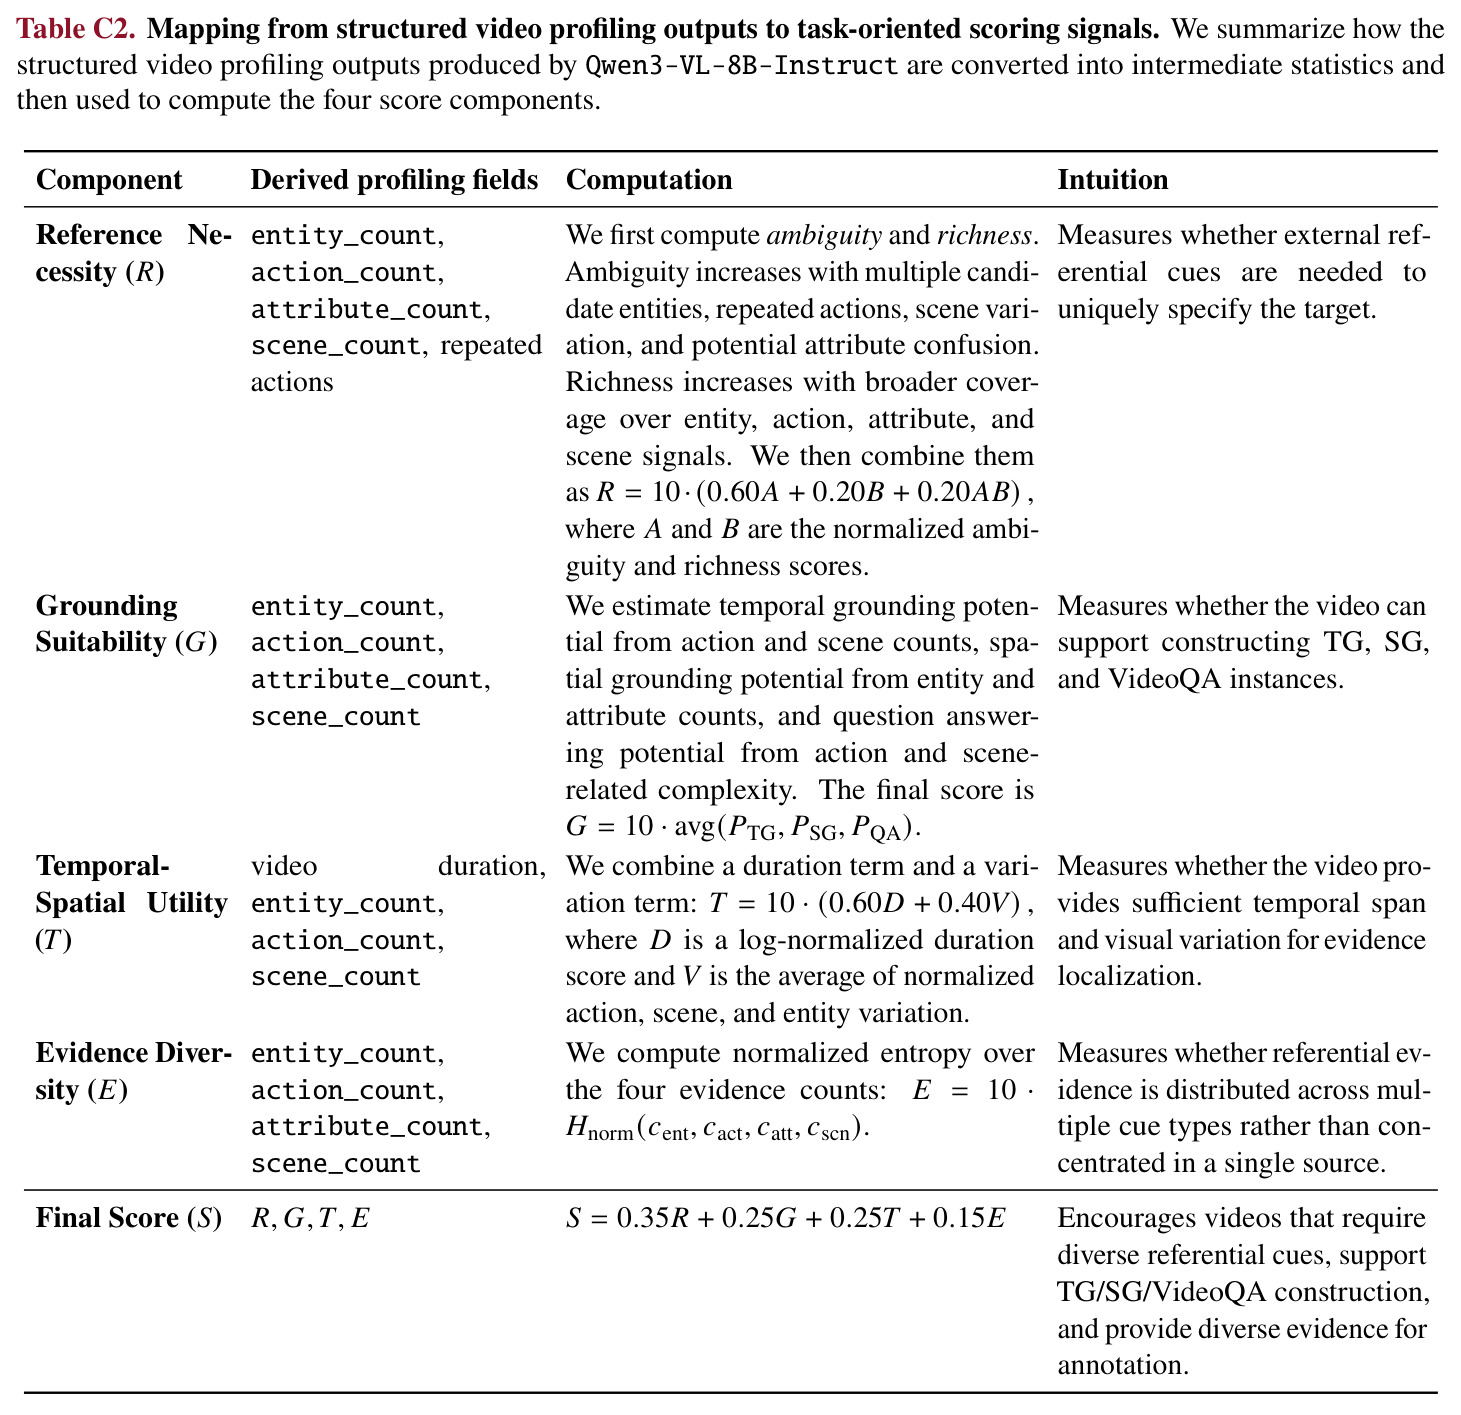
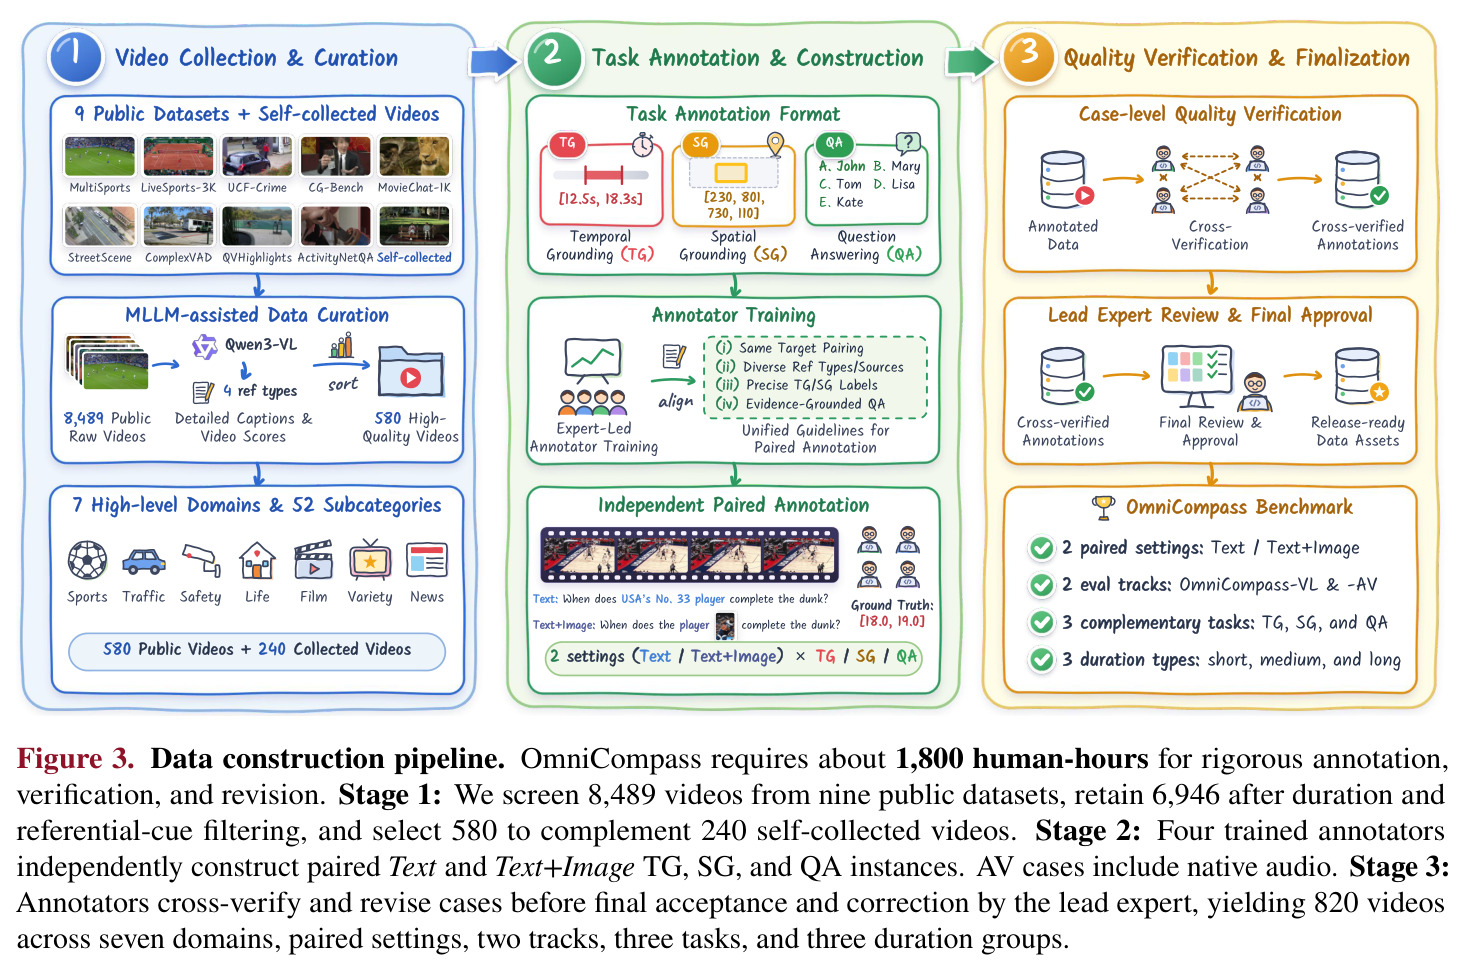
把 OmniCompass 想象成一场「三条赛道、两种问法」的多科目考试:每个考生(模型)对同一道题要用文字指称和图片指称各答一次,考试科目是何时(TG)、何地(SG)、何事(QA),考卷分纯视觉卷(VL)和视听卷(AV)。技术路线分三阶段。Stage 1 视频收集与筛选:从 9 个公开数据集汇集 8,489 个候选视频,用 Qwen3-VL-8B-Instruct 对每个视频做结构化剖析(实体、动作、属性、场景四类引用线索),过滤掉短于 30 秒或缺任一类线索的视频后剩 6,946 个,按启发式分数 $S=0.35R+0.25G+0.25T+0.15E$(引用必要性、定位适宜性、时空效用、证据多样性)排序并施加域/时长/来源约束,人工复核保留 580 个;再加 240 个自采的电影、电视剧、综艺、新闻视频,共 820 个,其中 240 个共享视频构成 AV 轨道。Stage 2 任务标注:4 名职业标注员经 2 天培训和 60 个视频试标(180 个实例)校准后,为每个视频独立构建配对 Text/Text+Image 的 TG、SG、QA 各一题。Stage 3 质量核验:标注员互相交叉检查,首席专家终审修订,全流程约 1,784 人工小时。
核心创新是「配对目标指定 + 跨指定一致性分数 CS」的组合。以往所有基准都把「模型是否理解问题所指的目标」和「模型是否找到证据」混在单一文本查询里,答对可能只是文本匹配的侥幸;OmniCompass 用配对设定做控制变量:同一视频、同一目标、同一真值,只改变指定方式——Text 设定写「穿 33 号球衣的美国队员何时完成扣篮?」,Text+Image 设定写「参考图中的球员何时完成扣篮?」并附一张目标裁剪图(该图不泄露答案事件)。CS 定义为:$\mathrm{CS}_{TG}=\frac{1}{N_{TG}}\sum_i \min\{g_i^{T}, g_i^{TI}, a_i\}$,其中 $g^{T}$、$g^{TI}$ 是两种设定下预测与真值的 tIoU,$a_i$ 是两次预测间的 tIoU;SG 对起止边界框的 $\min\{g^{T},g^{TI},a\}$ 求均值;QA 要求 $\hat{y}^{T}=\hat{y}^{TI}=y$。min 结构使分数同时被「正确性」和「一致性」的下界约束:两种设定下给出不同错误答案、或都答对但定位框不重叠,都拿不到分,从机制上防止一致性指标被投机策略刷高。
方法步骤详情
构建流程的输入输出如下。第一步候选剖析:输入 8,489 个公开候选视频,Qwen3-VL-8B-Instruct 输出含实体、动作、属性、场景计数的 JSON 描述;过滤后剩 6,946 个,打分排序加人工复核输出 580 个高质量视频。第二步试标校准:2 天指南培训后,先对 30 个 VL 和 30 个 AV 视频试标(每视频 TG/SG/QA 各一题、双设定,共 180 实例),首席专家据此修订指南。第三步正式标注:4 名标注员遵循四原则独立构建剩余实例——同一目标配对(双设定共享视频、目标、语义、真值)、引用多样不泄漏(视频内裁剪优先取目标区间之外的画面,或用语义匹配的外部图片)、TG 区间紧贴完整事件且 SG 在区间两端框住同一目标、QA 采用 1 个正确答案加 4 个合理干扰项的五选一并附线索区间。第四步交叉核验:标注员互查,VL 820 个中 354 个被打回修订,AV 240 个中 89 个进入修复(含 24 个 TG、70 个 SG、11 个 QA 标注修正),再由首席专家终审。第五步评测协议:均匀采样 64 帧(百亿参数以下开源模型 32 帧,GPT 系 49 帧),每帧前注入秒级时间戳,TG 输出 JSON 起止时间,SG 输出 0-1000 归一化坐标的双框,QA 输出五选一字母,AV 轨道额外拼接原生音轨。
技术新颖性
与已有基准相比,本文的新颖性有四点。第一,配对指定设计是全新的:CG-Bench、Video-MME 等只有文本查询,IV-Bench 只有文本+图像,从没有工作在同一目标上同时跑两种设定并对比,这使「跨指称一致性」第一次成为可量化的评测维度。第二,CS 指标在度量设计上区别于简单的一致率:通过对 $\min\{g^{T}, g^{TI}, a\}$ 取最小值,把正确性和一致性耦合为一个数,而 V-STaR 等前作只分别报告两种设定的准确率。第三,任务统一的范围最大:同时覆盖 TG、SG、QA 和短中长时长(30 秒至 88.4 分钟)的基准此前只有 V-STaR,但它没有配对设定也没有音频轨道;视听基准则普遍缺失 grounding。第四,标注工程规格罕见地高:约 1,784 人工小时、4 名职业标注员加 1 名首席专家、三阶段质检并公开修复记录(Tables D1-D3),而多数竞品为自动或半自动标注。相对地,方法本身不含新模型或新算法,属于纯粹的评测学贡献。
实验结果
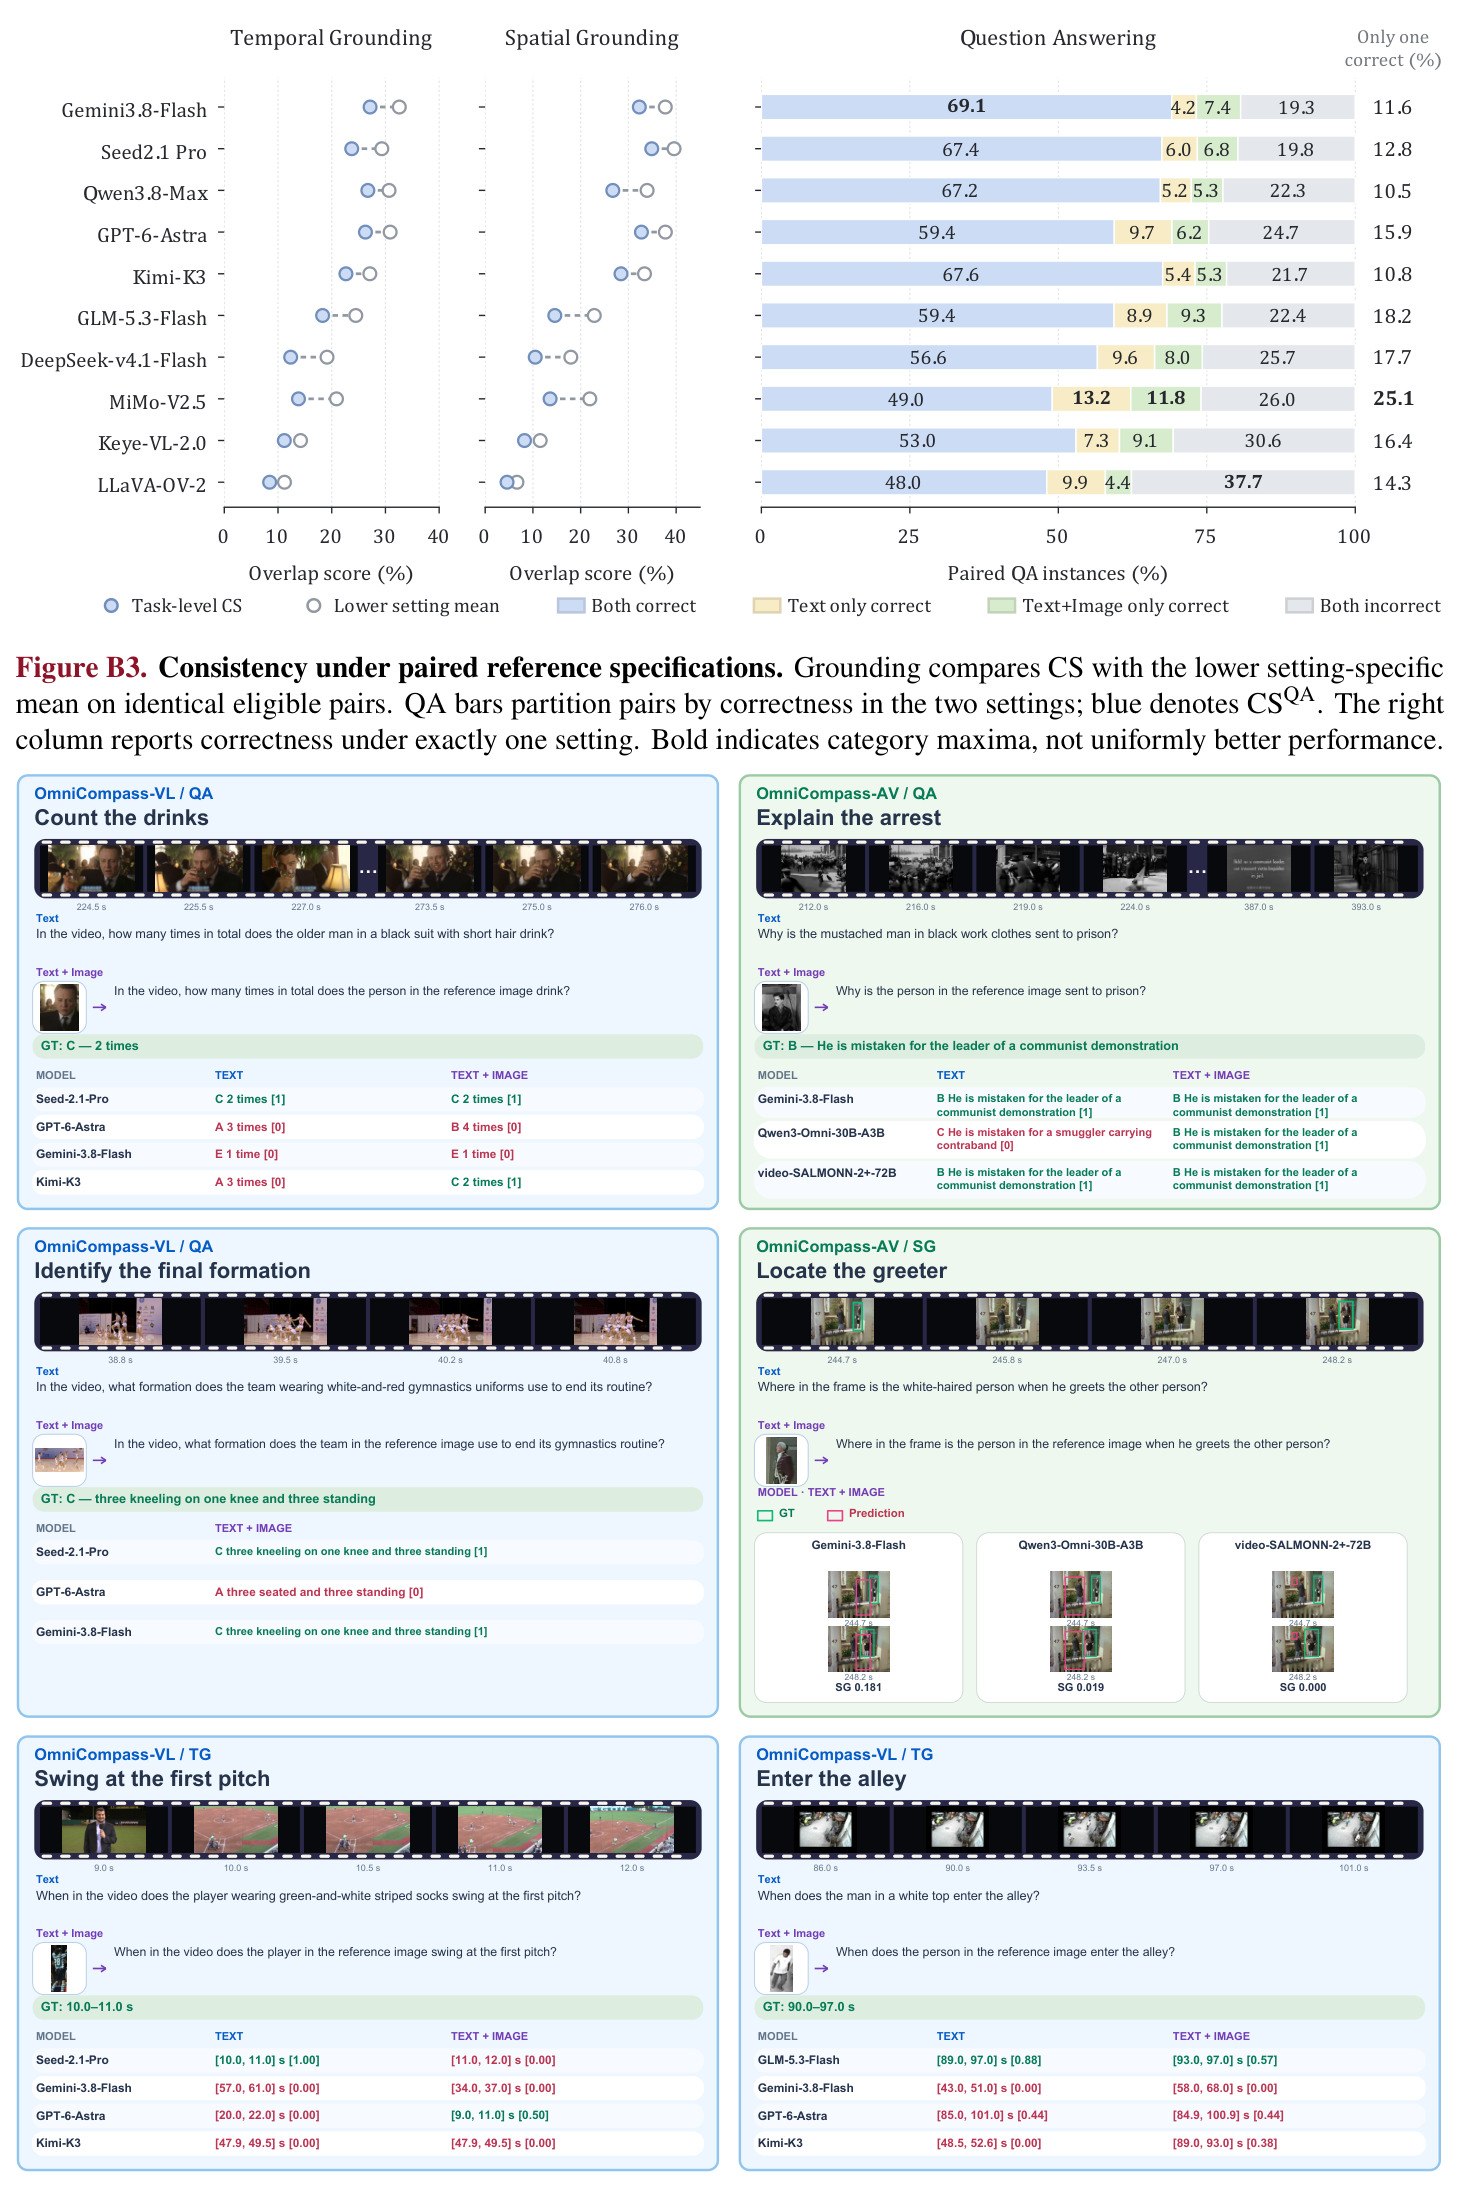
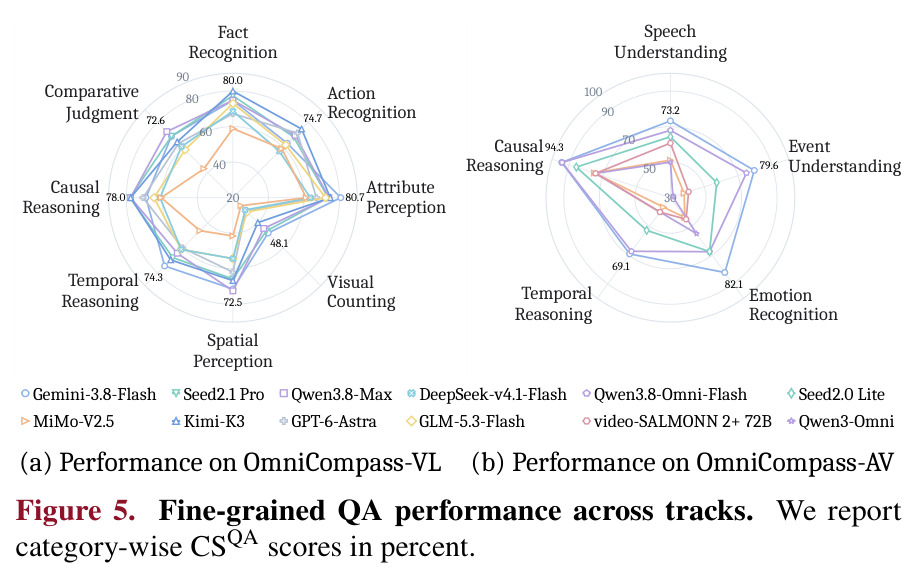
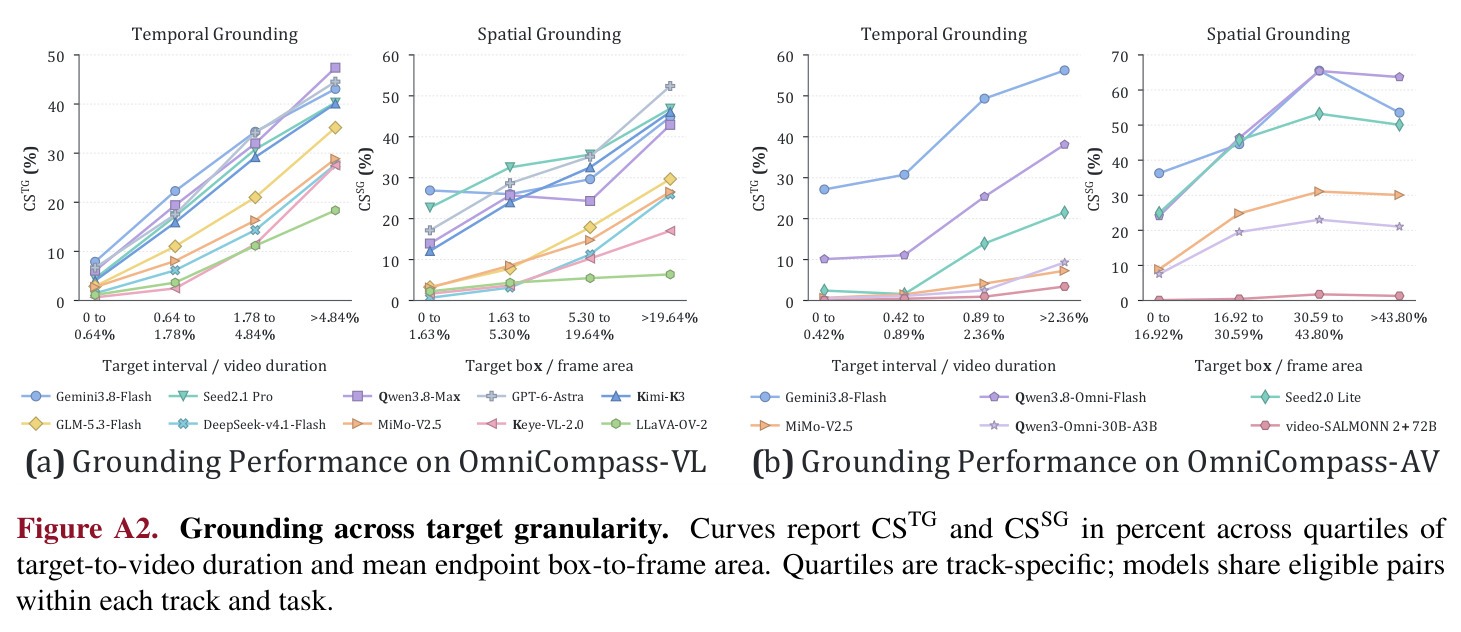
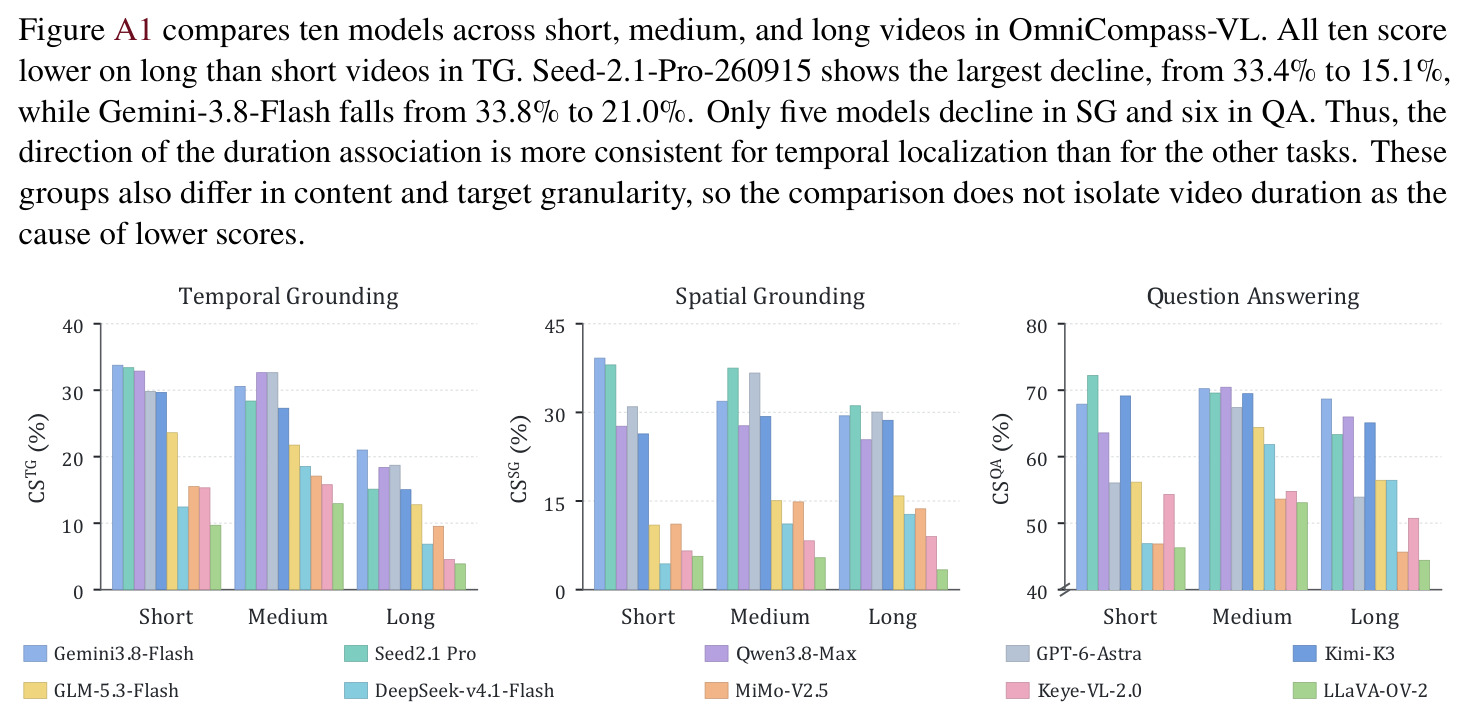
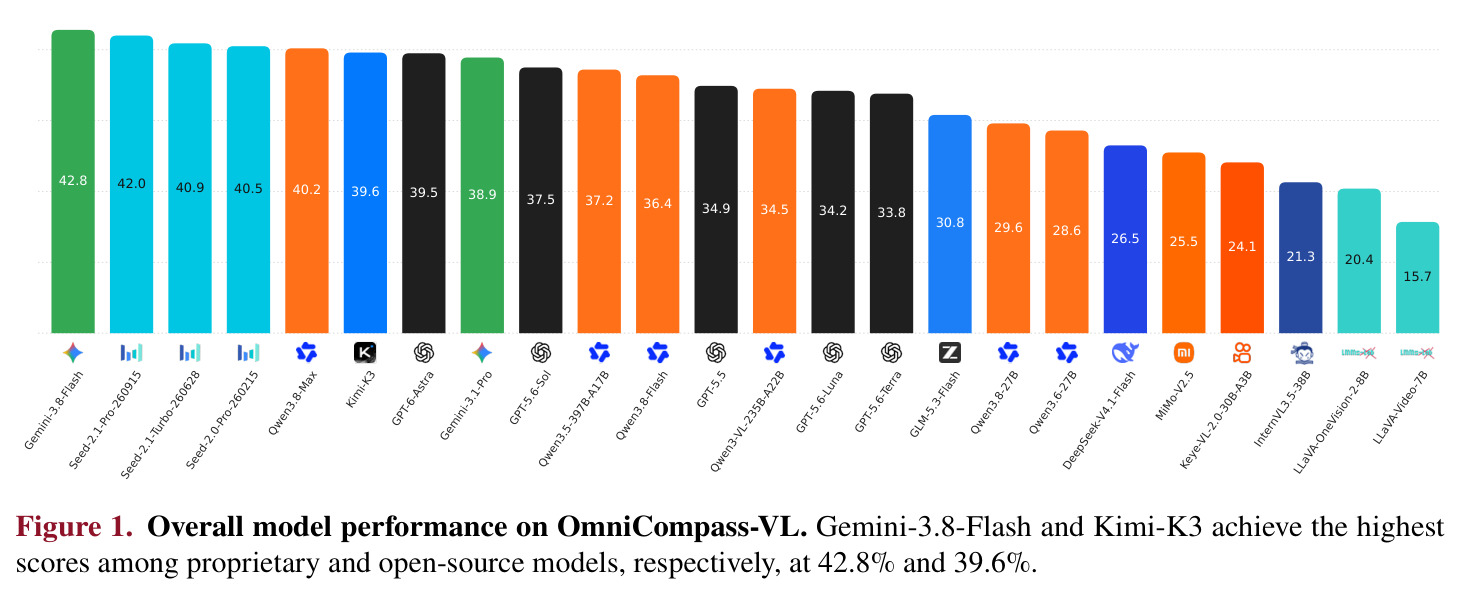
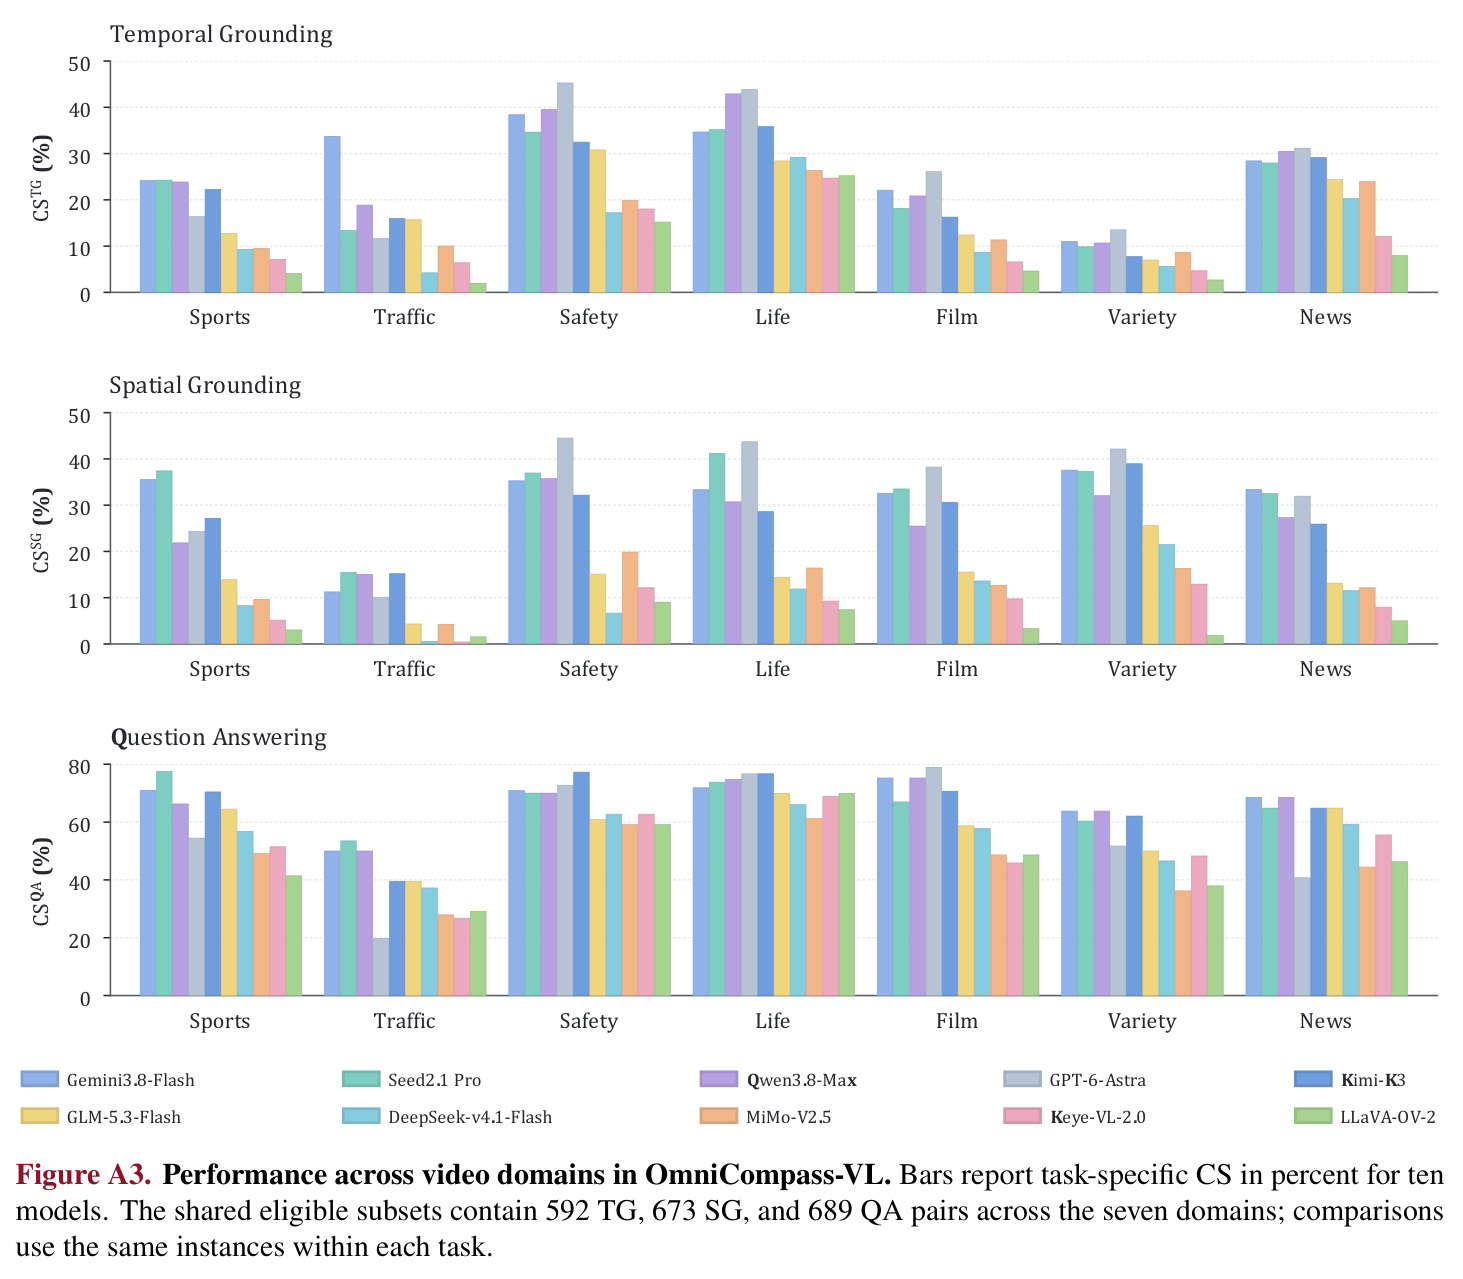
共评测 50 个模型(VL 轨道 36 个:12 专有 + 24 开源;AV 轨道 17 个:7 专有 + 10 开源)。发现一:专有模型全面领先且 AV 差距悬殊。VL 轨道 Gemini-3.8-Flash 以 CSAvg 42.8% 居首,最佳开源 Kimi-K3 为 39.6%,差 3.2 分;AV 轨道 Gemini-3.8-Flash 达 57.4%,最佳开源 MiMo-V2.5 仅 24.6%,差距高达 32.8 分。发现二:定位能力严重滞后于问答。36 个模型中 29 个 CSQA 超 50%(峰值 69.1%),但最佳 CSTG 仅 27.1%、最佳 CSSG 仅 34.9%;视觉计数(Visual Counting)在图示 8 个模型中全部垫底(26.4%-48.1%)。发现三:参考图并非普遍有益。Text+Image 只提升 36 个模型中 11 个的单设置均分(专有 8/12,开源仅 3/24),说明视觉指称可能反而丢失了文本细节。发现四:跨指称一致性差。CS 平均比对应的单设置较低分低 4.3(TG)、4.6(SG)、6.4(QA)分;Kimi-K3 两种设定 QA 准确率几乎相同(73.0%/72.9%)但 CSQA 仅 67.6%,其 808 对中 175 对两次都错、44+43 对仅一边对。发现五:时间戳是免费的午餐——5 组模型-轨道配置的 CSAvg 全部提升(VL 平均 +6.5,AV 平均 +4.9),TG 最高 +18.3。发现六:音频对 QA 一致有效——Vision+Audio 相比 Vision 使 CSQA 平均提升 22.9 分(+18.6 至 +28.1),但对 SG 增益有限(-0.4 至 +1.8),TG 增益因模型而异(Gemini +29.4,MiMo-V2.5 反降 1.5)。发现七:长视频与细粒度目标更难——Seed-2.1-Pro 的 TG 从短视频 33.4% 跌至长视频 15.1%;Gemini 的 VL TG 随目标时长占比从 7.9% 升至 43.1%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全模态视频理解总评(OmniCompass-VL) | CSAvg | Gemini-3.8-Flash 42.8%(专有最佳) | Kimi-K3 39.6%(开源最佳) | +3.2 分(专有-开源差距) |
| 音视频联合理解总评(OmniCompass-AV) | CSAvg | Gemini-3.8-Flash 57.4%(专有最佳) | MiMo-V2.5 24.6%(开源最佳) | +32.8 分(专有-开源差距) |
| 时序定位 TG(VL 轨道) | CSTG | 最佳 27.1%(Gemini-3.8-Flash) | CSQA 最佳 69.1%(同模型) | 定位比问答低 42 分,暴露核心短板 |
| 时序定位 TG(AV 轨道) | CSTG | Gemini-3.8-Flash 40.6% | 全部 10 个开源模型 ≤3.5% | 音视频时序定位是开源模型崩溃点 |
| 问答 QA(AV 轨道) | CSQA | Qwen3.8-Omni-Flash 73.2% | 同模型 CSTG 仅 21.8% | QA 强、TG 弱的失衡在音频轨道同样存在 |
| 输入协议消融 | CSAvg(有无帧级时间戳) | 加时间戳后 5 组配置全部提升 | 无时间戳基线 | VL 平均 +6.5 分、AV 平均 +4.9 分,TG 最高 +18.3 分 |
| 模态消融 | CSQA(Vision+Audio vs Vision) | 加音频后 4 个模型全部提升 | 纯视觉输入 | 平均 +22.9 分(+18.6 至 +28.1) |
局限与改进
作者承认的局限:视频时长、领域与目标粒度高度相关,时长分组分析无法把「视频长」隔离为唯一原因;目标粒度四分位组的边界和样本量在轨道间不一致;Text+Image 设定同时改变了文字描述和图像可用性,其效应不是纯粹的「加图」效应;AV 的 QA 类型标签只反映设计意图,并未逐题验证去音后必错;自采视频仅限学术评估使用,再分发受版权约束。我自己的观察:每视频每任务仅 1 道题,2,460 个实例对 50 个模型而言统计功效偏低,排名前列的小幅差距(如 42.8 vs 42.0)未必显著;SG 协议给定时间区间,回避了「先找时间再找位置」的完整推理链,使 SG 失败不能等同于真实场景中的定位失败;五选一有 20% 随机基线且排除法可进一步抬分;88.4 分钟的视频只采 64 帧(约每 83 秒一帧),长视频 TG 的低分可能部分源于采样稀疏而非时序推理缺陷;模型版本均为 2026 年的快速迭代 API,榜单数字的时效性有限。
独立分析的弱点
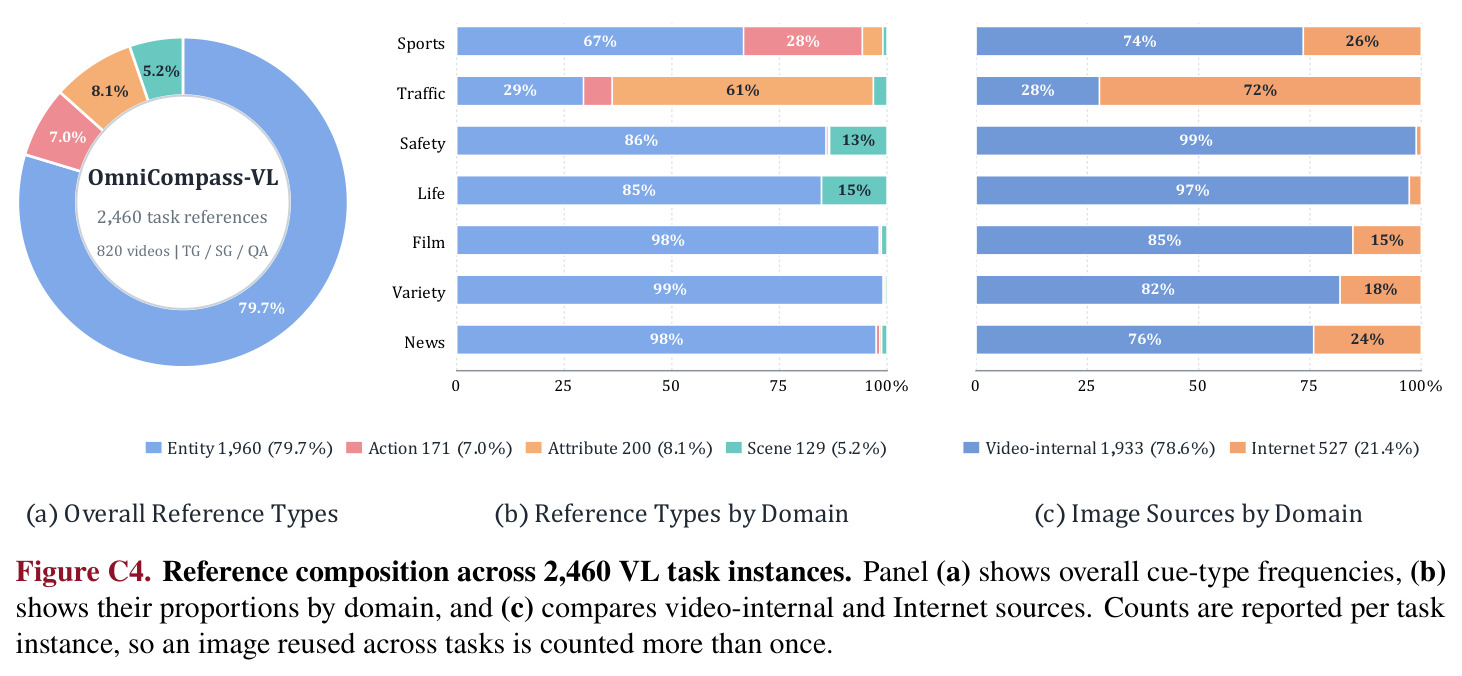
弱点一:实例密度太低。每个 820 视频上每任务只有 1 题,且引用类型严重不均衡——实体引用占 79.7%(1,960/2,460),场景引用仅 5.2%,附录 B2 中场景条件 TG 只剩 8 对,任何分类型结论都缺乏证据。改进方向:扩充到每视频多目标多事件,或对稀缺引用类型做定向补采。弱点二:CS 对预测方差敏感。TG/SG 的 min 结构会被两次采样的随机波动压低,论文未报告多次采样的方差或温度设置。改进方向:每对采样 3-5 次取期望 CS,并报告置信区间。弱点三:AV 轨道开源模型全线崩溃(CSTG ≤3.5%)可能混入格式问题——Qwen2.5-Omni-7B 在 Text 设定下 TG R@0.5 直接为 0,更像指令跟随失败而非感知失败。改进方向:为小模型提供格式微调或 few-shot 基线后再下结论。弱点四:SG 只评区间两端两个框,无法区分「定位不稳」与「跟踪漂移」,Gemini 在示例中最高也只有 0.181 的 IoU,说明协议本身可能低估了模型能力或高估了难度。改进方向:增加区间内密集帧评测并区分指标。弱点五:候选筛选依赖 Qwen3-VL-8B 的剖析输出,模型偏差会传导进数据分布(如偏向模型易描述的视频)。改进方向:用多个剖析模型交叉或人工抽样校验候选池。
未来方向
作者在结论中指出两个方向:更强的跨模态对齐(尤其音视频事件绑定,Event Understanding 上专有-开源差 38.9 分)和更可靠的音频感知定位。基于本文成果可延伸的方向包括:其一,把 CS 一致性作为训练信号——既然跨指称不一致普遍存在,可设计一致性正则或 RLHF 奖励,迫使模型对同一目标的文字/图片指称给出相同定位与答案;其二,评测 agentic 视频推理——近年模型开始回看片段、按需取音频,OmniCompass 的长视频与 AV 轨道天然适合检验工具调用是否真带来证据增益;其三,把「时间戳注入」的发现推广为系统性研究元数据(时间、帧号、分辨率)对 grounding 的影响,并训练原生时间感知的视频编码器;其四,把 SG 从两点定框扩展为密集跟踪与轨迹评测;其五,扩大 AV 子集并引入更细的语音-视觉对齐任务(如说话人-嘴唇匹配、画外音归属),目前 240 个视频 720 个实例的规模尚不足以支撑细粒度诊断。
复现评估
复现成本分层明显。评测侧:论文首页给出 Homepage、GitHub、Hugging Face 链接,标注和评测协议完全公开——附录 E 提供全部任务在双设定下的完整 prompt 与 JSON 输出格式,附录 C 公开候选打分公式与 9 个来源数据集清单(MultiSports、LiveSports-3K、UCF-Crime、CG-Bench 等,均注明 license),推理为主、无需训练,主要成本是 API 调用费(50 模型 × 约 3,180 实例对 × 2 设定 × 64 帧)与开源模型的显卡时间,属于容易-中等难度。数据侧:580 个公开来源视频理论上可重组,但 240 个自采影视/综艺/新闻视频版权受限,很可能只发布标注和获取指引而非视频本体,完整基准能否直接下载需跟踪官方仓库。标注侧:约 1,784 人工小时(4 名职业标注员 + 1 名首席专家、三阶段质检)的流程文档详尽(Tables D1-D3 含修复记录),但对普通团队而言复刻这套标注流程的门槛很高。总体建议:直接用其发布的基准跑评测极易复现;想复制「配对标注 + CS」的方法论到新领域则需要可观的标注预算。
论文图表
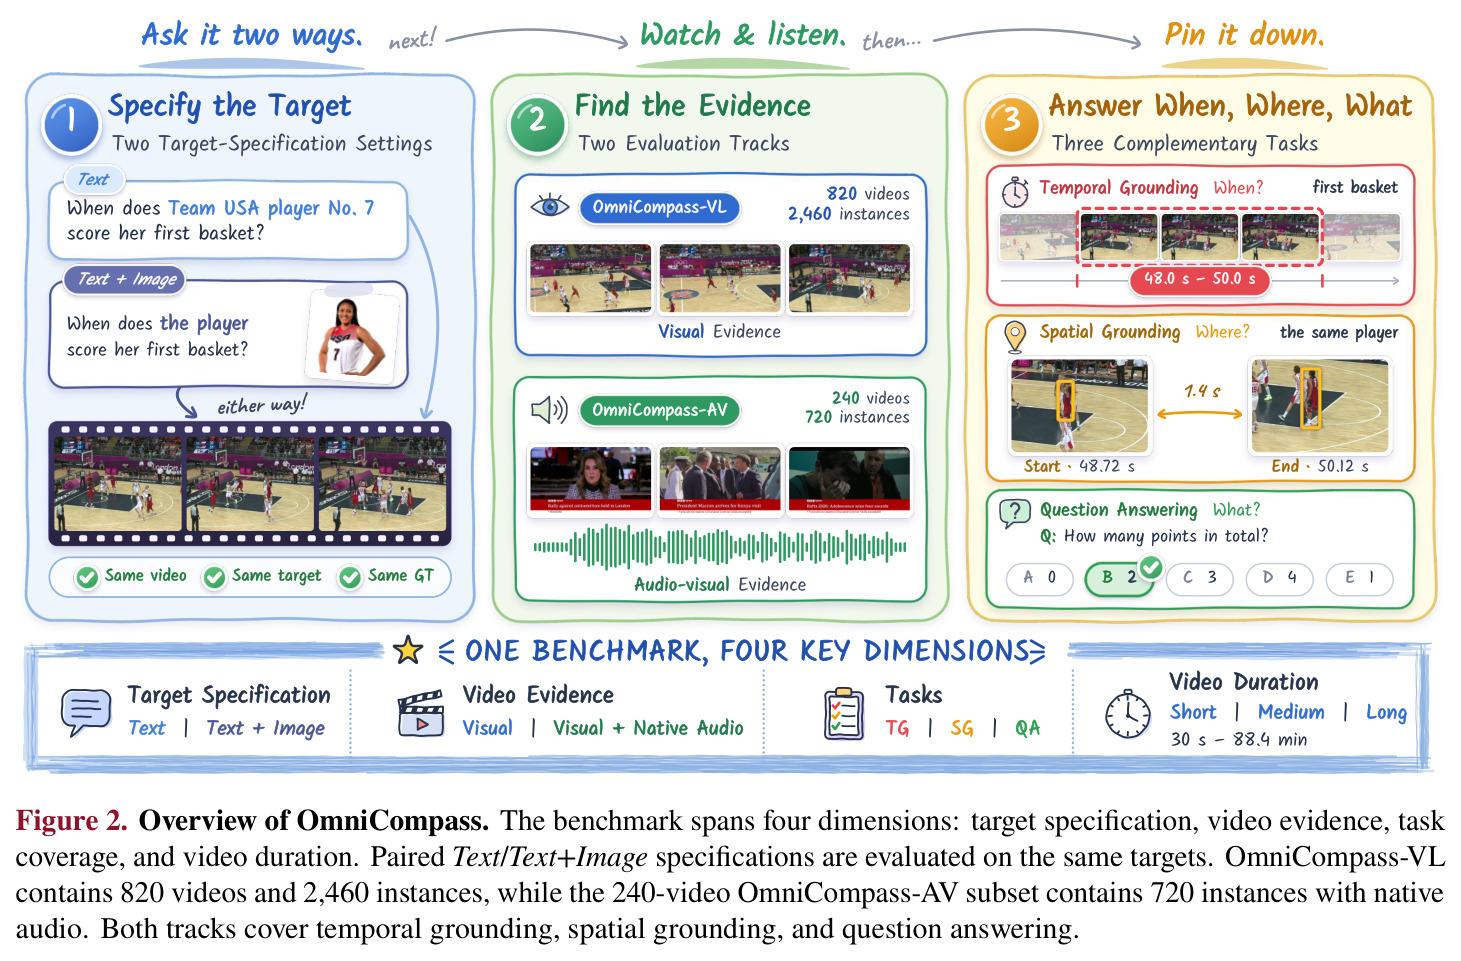
基准总览图:以「Ask it two ways(两种问法)→ Watch & listen(看与听)→ Pin it down(钉住目标)」三步展示评测逻辑,标注四个关键维度——配对 Text/Text+Image 指定、VL/AV 双轨道(820+240 视频)、TG/SG/QA 三任务、30 秒至 88.4 分钟时长,并用篮球例子展示同一真值两种问法。
理解全文设计哲学的最短路径:配对指定、双轨道、三任务如何咬合成一个整体评测框架。
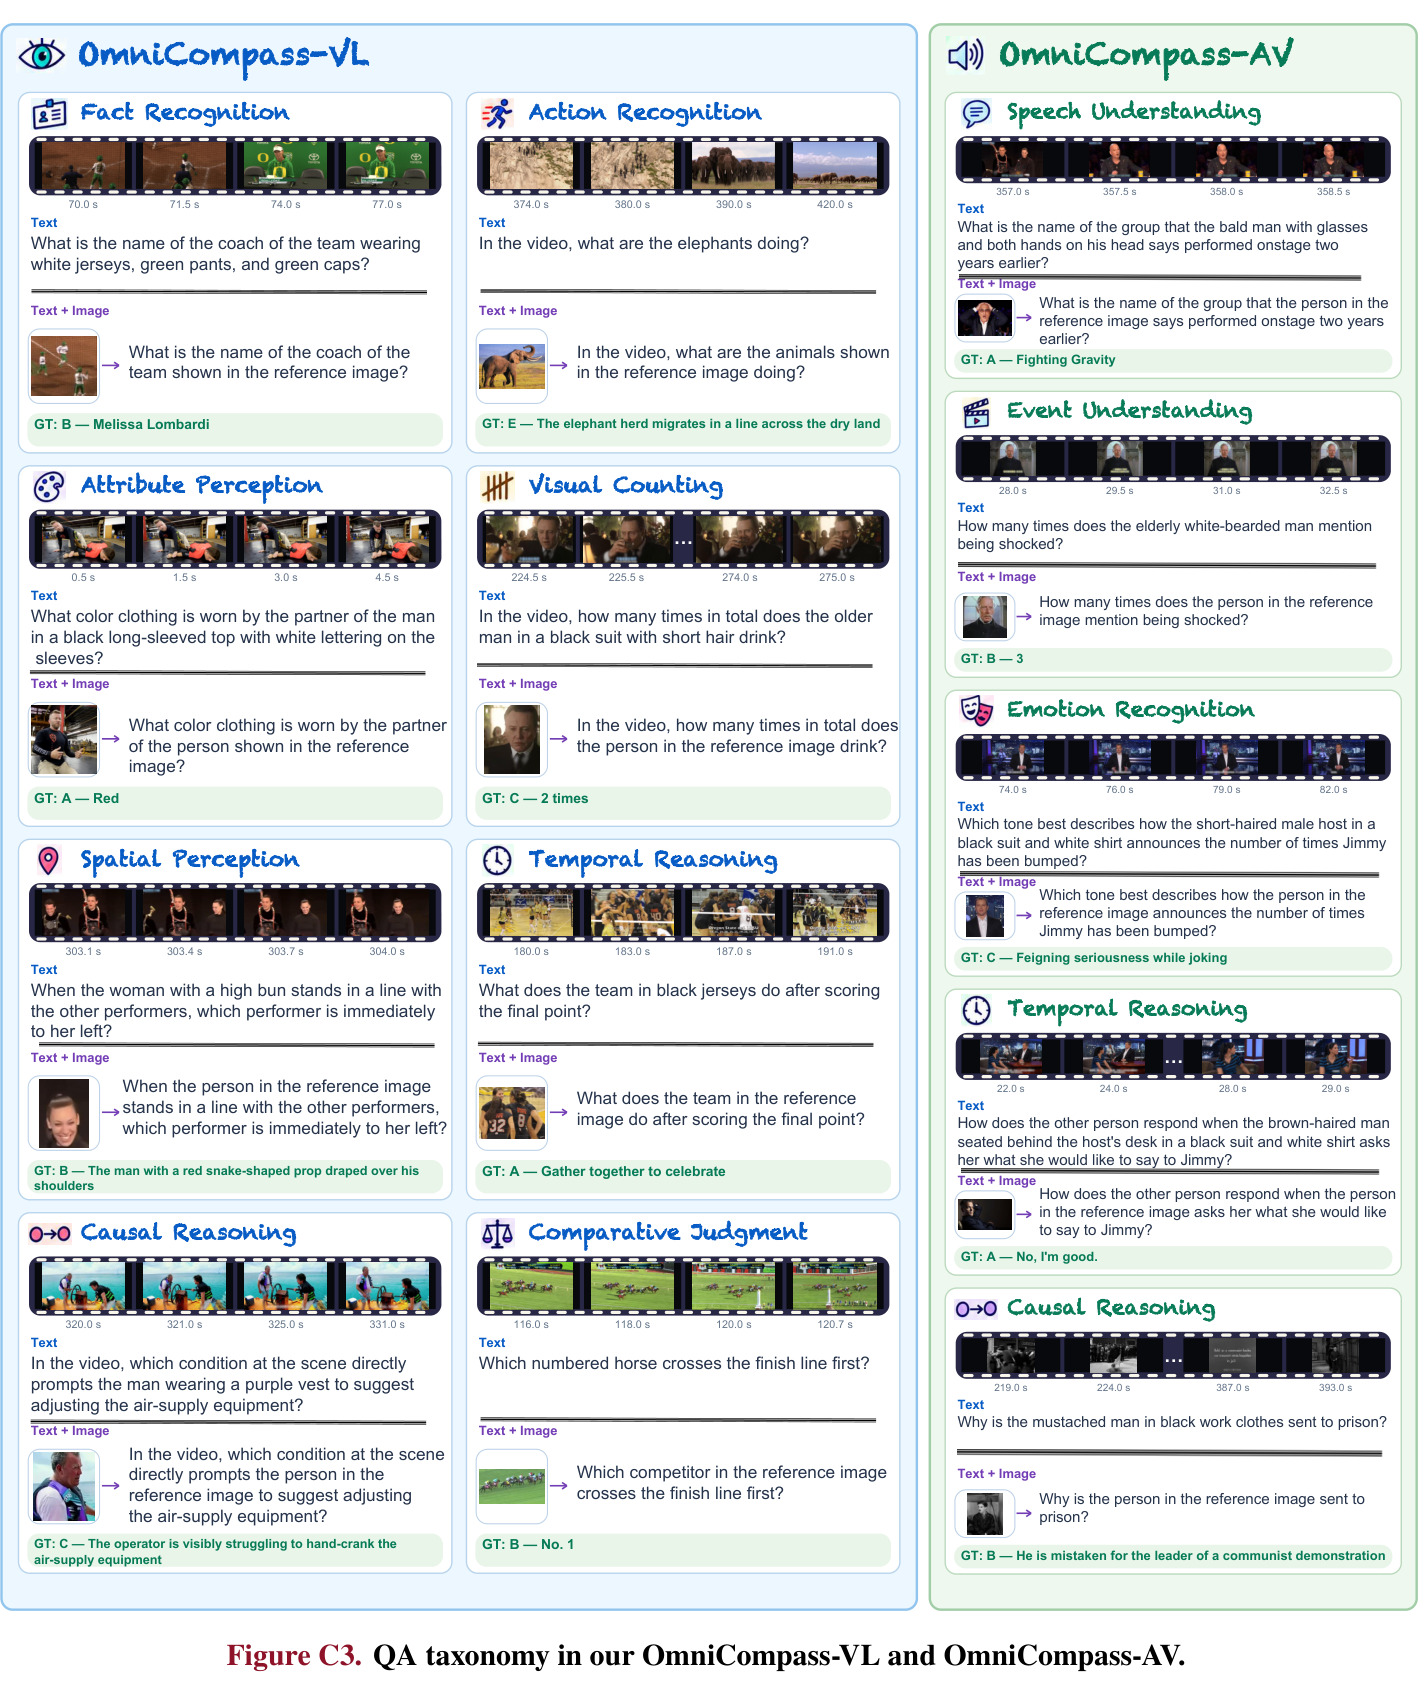
两轨道 13 类 QA 的图文示例:VL 覆盖事实识别、动作识别、属性感知、视觉计数、空间感知、时序/因果推理、比较判断;AV 覆盖语音理解、事件理解、情绪识别、时序/因果推理,每类配帧序列与双设定问法。
问答分类体系直接决定 Figure 5 的能力画像解读,示例让抽象类别落地。
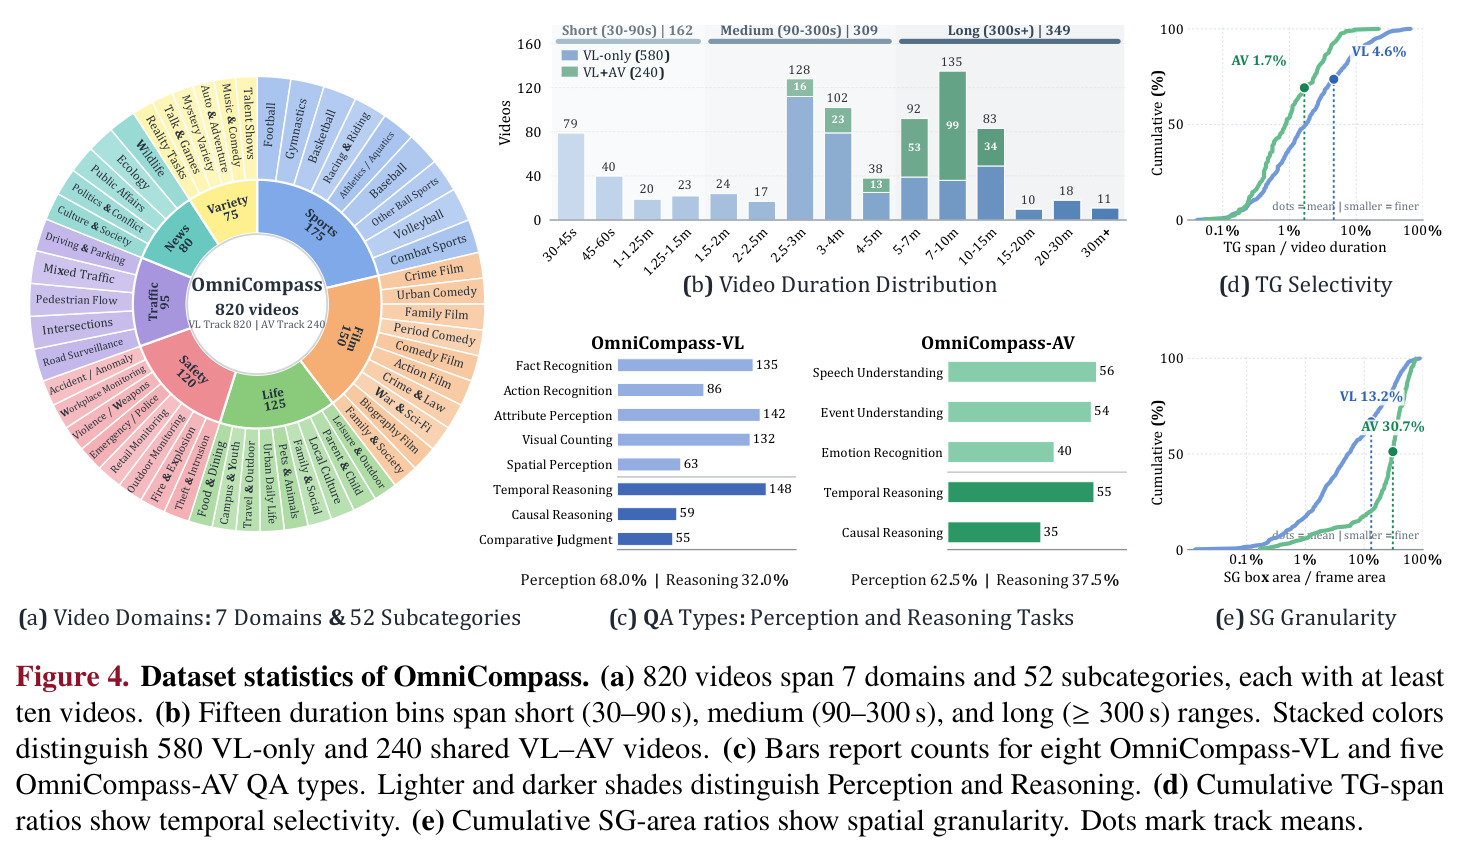
引用构成统计:实体引用 1,960(79.7%)、属性 200(8.1%)、动作 171(7.0%)、场景 129(5.2%);来源上视频内部裁剪 1,933(78.6%)、互联网图片 527(21.4%),并给出各领域的类型与来源占比。
暴露引用类型失衡(实体独大),是解读 B2 热图中场景类小样本结论的前提。
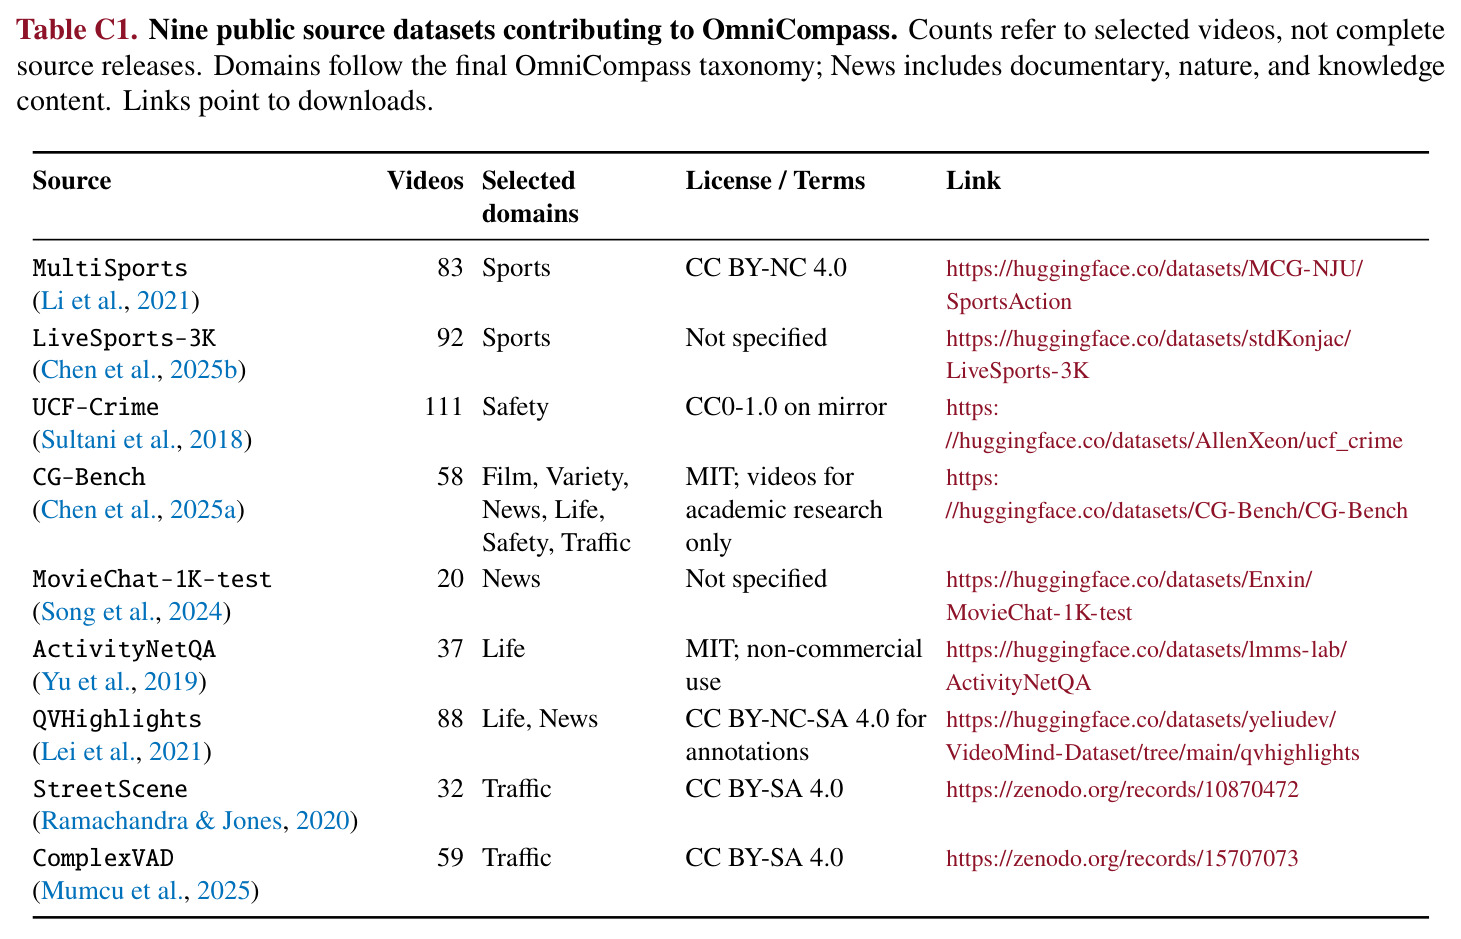
列出 9 个公开来源的贡献量与许可:UCF-Crime 贡献 111 个安全类视频最多,LiveSports-3K 92 个、QVHighlights 88 个、MultiSports 83 个,另含 CG-Bench 58、ComplexVAD 59、StreetScene 32、ActivityNetQA 37、MovieChat-1K 20,均附 license 与链接。
数据的来源与版权是基准能否使用和再分发的前提,此表是合规使用的依据。
定义四项候选打分分量的计算方式:引用必要性 $R=10\cdot(0.60A+0.20B+0.20AB)$(歧义度与丰富度组合)、定位适宜性 $G=10\cdot\mathrm{avg}(P_{TG},P_{SG},P_{QA})$、时空效用 $T=10\cdot(0.60D+0.40V)$(对数归一化时长与变化度)、证据多样性 $E$ 为四类计数的归一化熵,合成 $S=0.35R+0.25G+0.25T+0.15E$。
自动筛选的核心公式全公开,使 8,489 到 580 的筛选过程完全可复现。
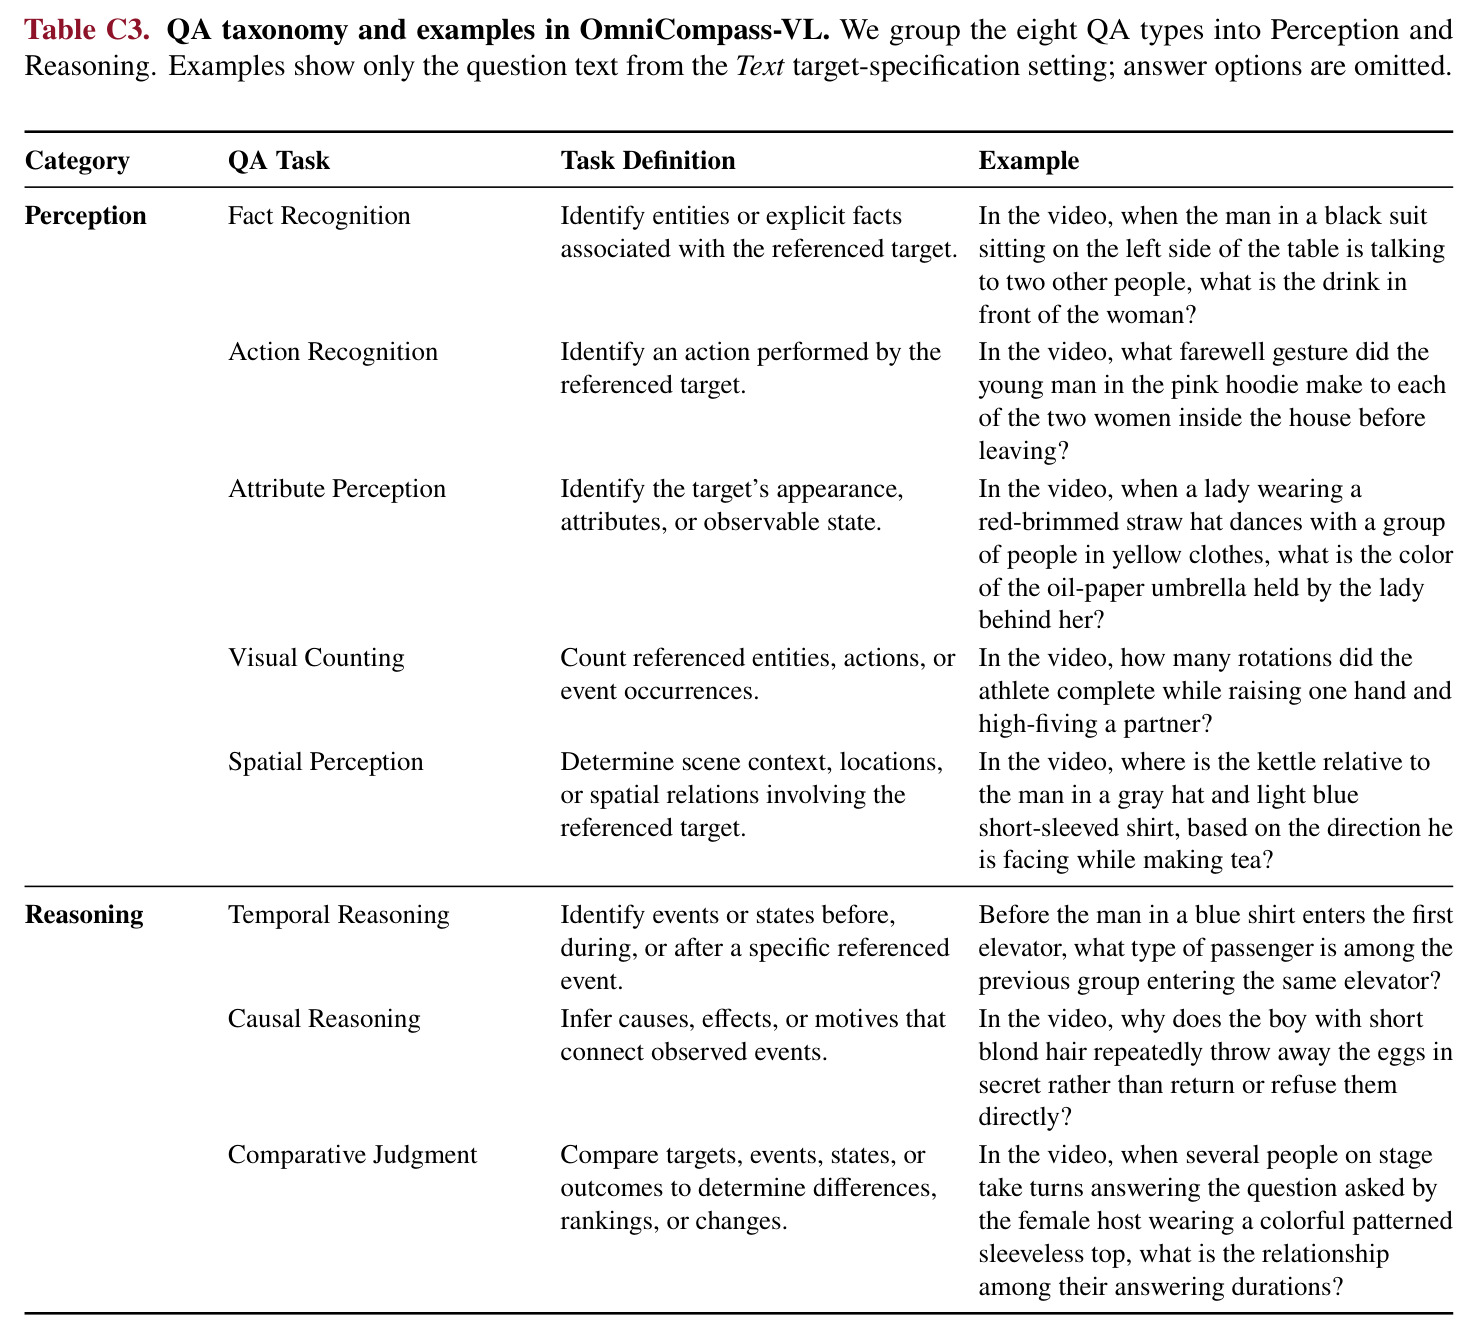
VL 轨道 8 类 QA 的定义与示例问题:感知组含事实识别、动作识别、属性感知、视觉计数、空间感知,推理组含时序推理、因果推理、比较判断,每类给出完整英文题干。
是理解 VL 问答任务边界与出题风格的标准文档,配套 Figure 5 使用。
AV 轨道 5 类 QA 的定义与示例:感知组为语音理解、事件理解(把声音线索绑定到可见实体/动作/场景)、情绪识别,推理组为时序推理、因果推理,题目设计上要求音频参与。
定义了「音视频事件绑定」这一开源模型最大失分点(与专有差 38.9 分)的具体含义。
四类引用信息的功能定义与示例:实体(跨视图匹配特定人物/物体)、动作(扣篮、射门等可识别运动模式)、属性(颜色、车型、姿态等可见特征)、场景(街道、房间、舞台等环境上下文)。
配对设计的词表基础,Text+Image 中的参考图即按这四类线索设计并防答案泄漏。
VL 质检记录:820 个视频中标注员互查阶段 466 个(56.8%)免修、354 个打回,典型问题含跨设定目标不一致、无图也能定位指代、TG 边界不精确、QA 证据不足或答案不唯一;修订后 100% 通过并经首席专家终审入库。
用可审计的数字支撑「全人工、多轮质检」的质量声明,是评估标注可信度的直接证据。
AV 质检记录:240 个视频中 151 个(62.9%)免修、89 个进入修复,共修正 24 个 TG、70 个 SG、11 个 QA 标注,额外检查原生音频依赖性与音画对齐,SG 常见问题是框跟错人。
揭示音视频标注特有的错误模式(音频依赖不足、音画目标错位),对构建同类数据集有直接参考价值。
人工成本明细:培训 64 小时、初始标注 896 小时、交叉核验与修复 320 小时、首席专家终审 248 小时、争议裁决 128 小时、发布审计 128 小时,合计 223 个人工日、1,784 小时。
量化「高质量人工基准」的真实代价,读者可据此估算复刻或扩展该基准的预算。
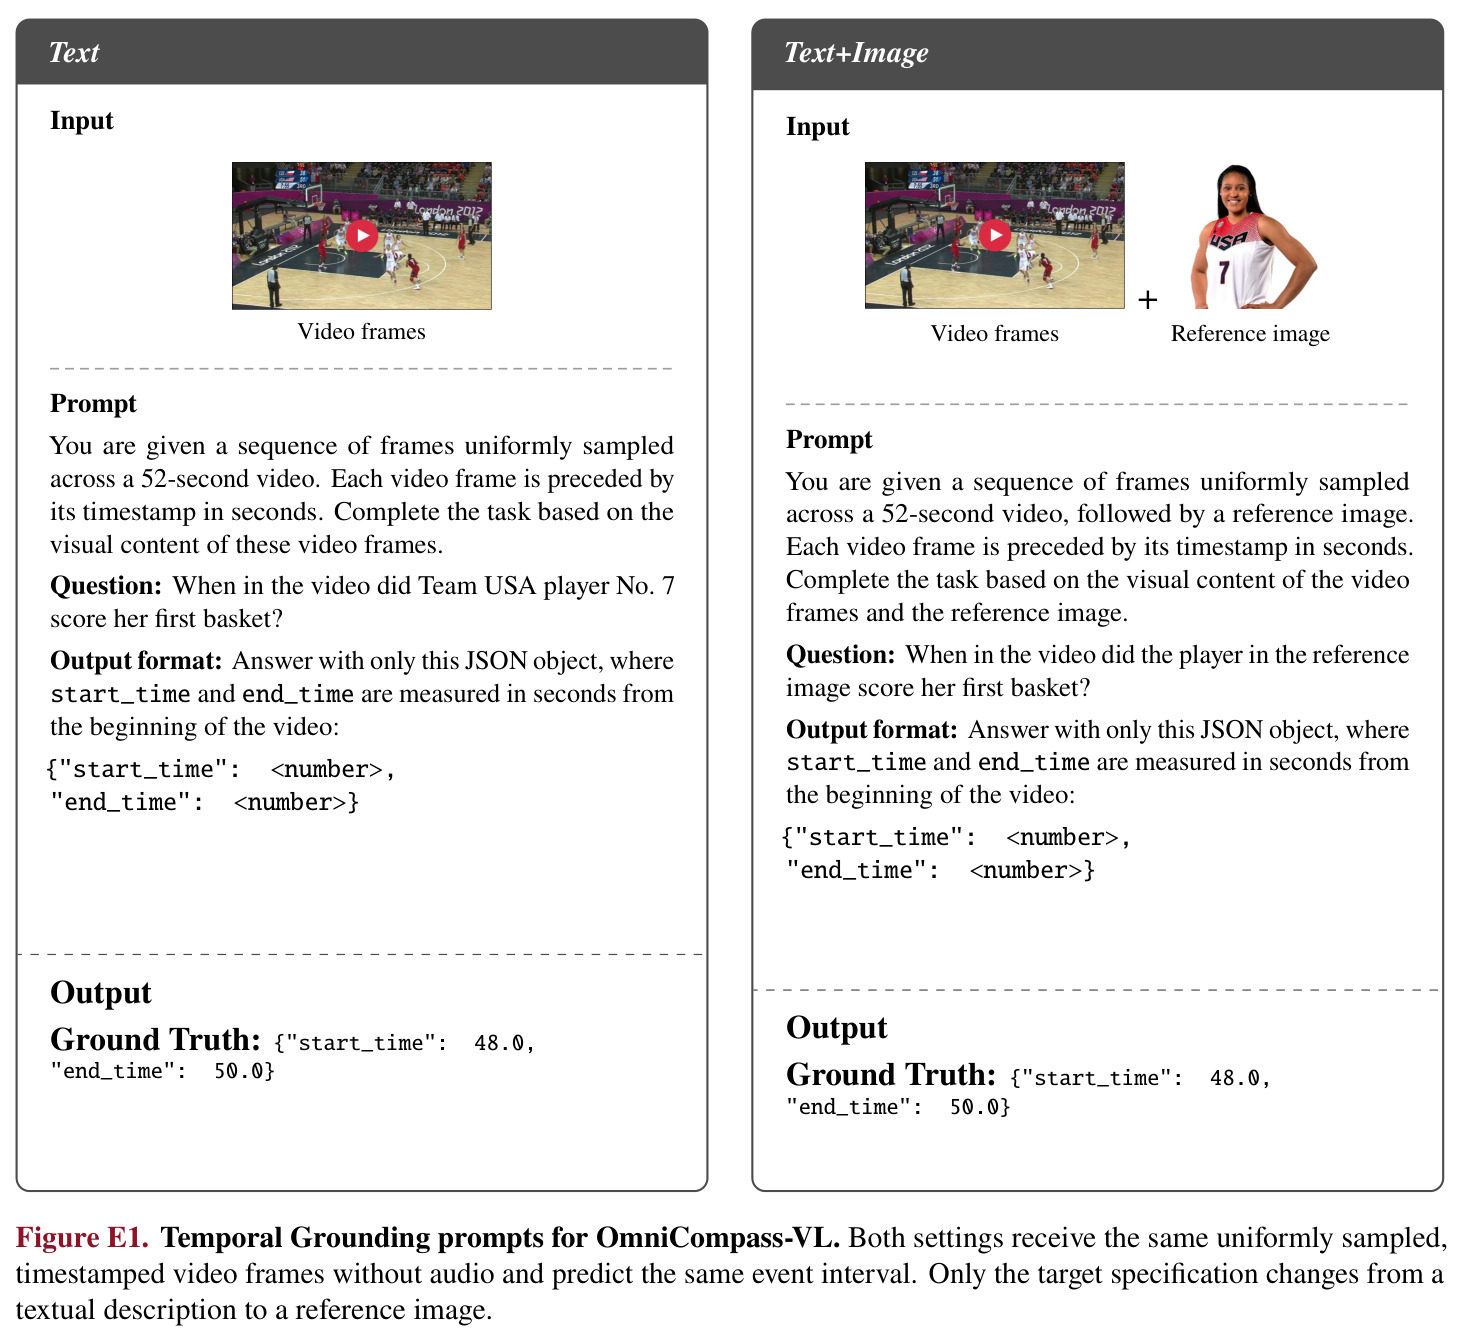
TG 任务双设定 prompt 全文:输入为带秒级时间戳的 64 个均匀采样帧(52 秒视频),Text 设定问「美国 7 号球员何时首次得分」,Text+Image 设定问「参考图中的球员何时首次得分」,输出均为 {"start_time", "end_time"} JSON,真值 [48.0, 50.0]。
评测协议的核心文档:时间戳注入位置、输出格式、参考图拼入顺序全部由此确定,直接决定复现成败。
SG 任务双设定 prompt:给定相关区间(48.72-50.12 秒),要求在起止两时刻各输出一个 [x1,y1,x2,y2] 归一化到 0-1000 的包围框,输出 JSON 含 start_bbox 与 end_bbox。
明确「给定区间、两端各一框」的协议细节与坐标约定,是解读 SG 分数和复现评测的必备材料。
QA 任务双设定 prompt:五选一(A-E)且双设定选项与真值不变,要求不确定时也必须基于给定输入作答并只输出选项字母,示例真值为 B(2 分)。
固定选项与答案的配对设计是 CSQA 可比性的前提,此图确保评测实现的细节无歧义。
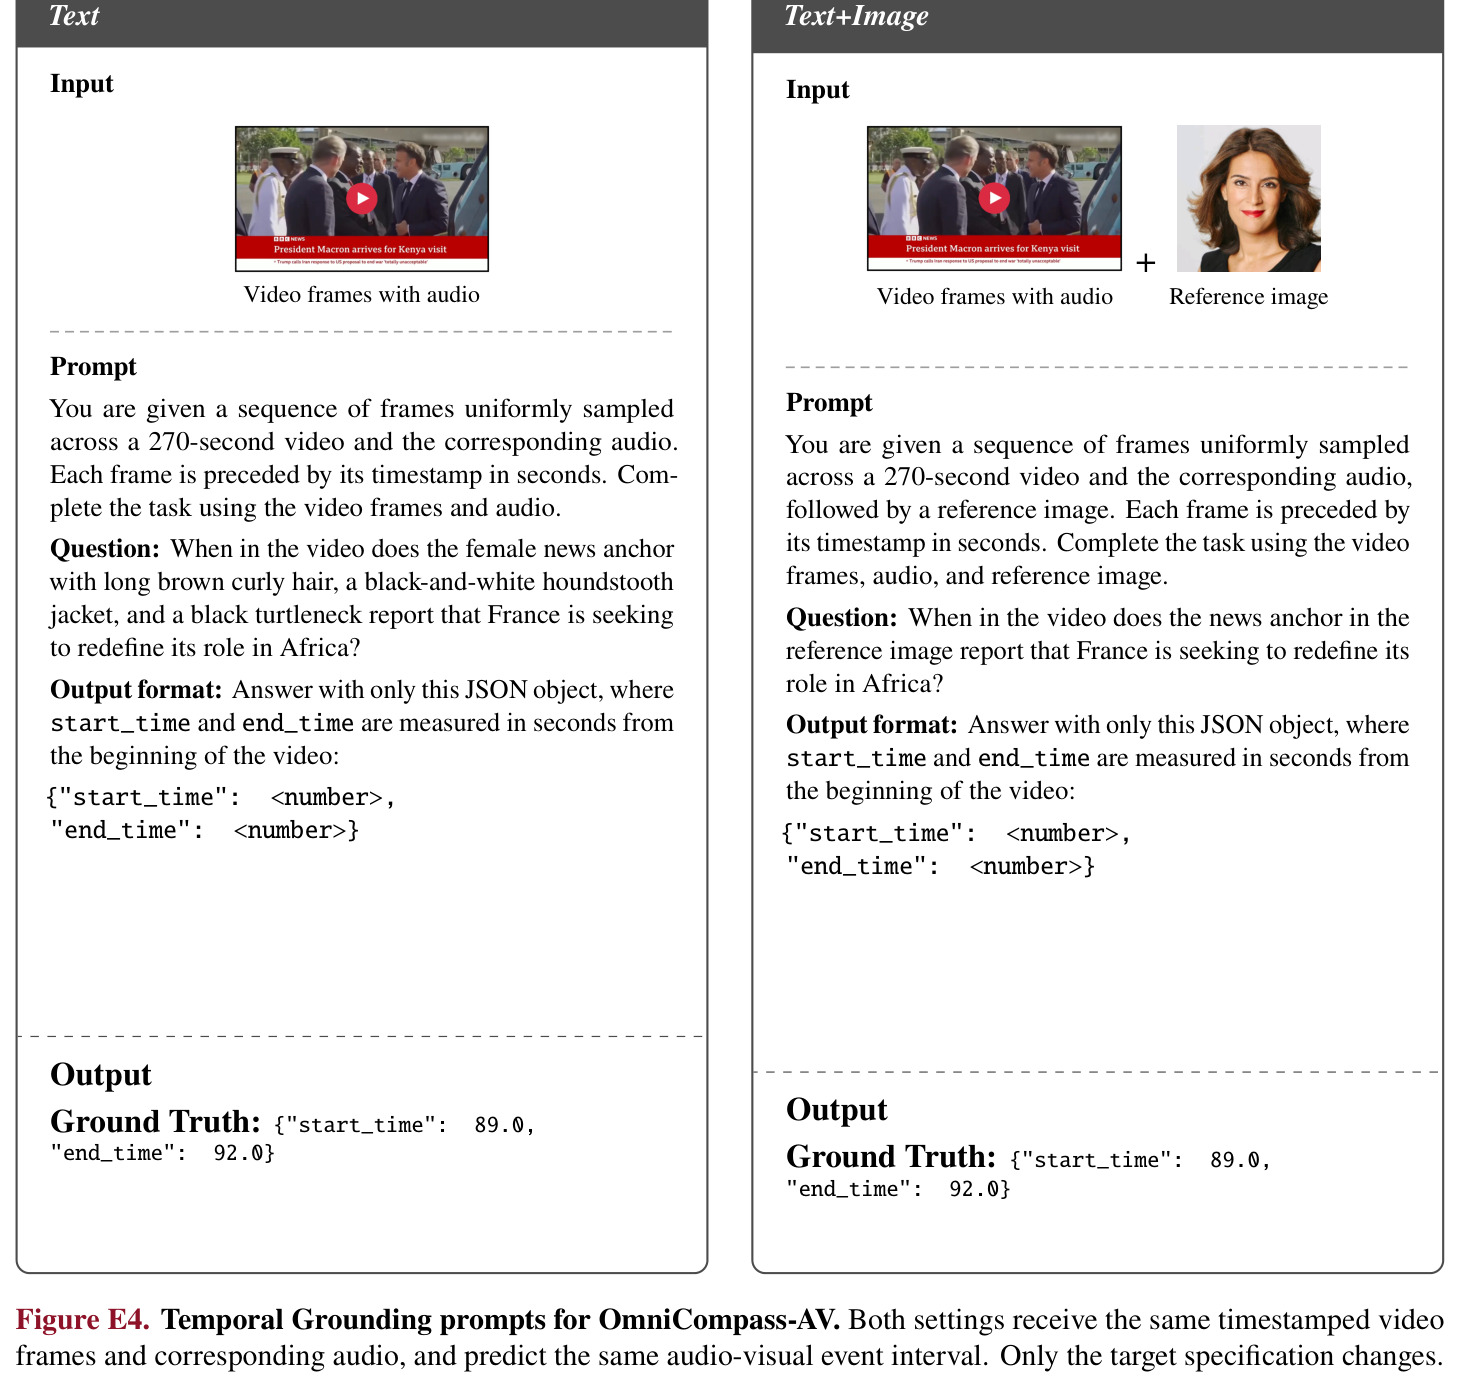
AV 轨道 TG prompt:在 VL 版本基础上于帧序列后追加原生音轨(270 秒新闻视频示例),问题涉及主播播报「法国寻求重新定义其在非洲的角色」的时刻,真值 [89.0, 92.0]。
展示音视频输入的序列化顺序(帧→音频→可选参考图→prompt),是 AV 轨道复现的关键。
AV 轨道 SG prompt:与 VL 版协议一致(给定区间两端各一框、0-1000 归一化),但输入增加音频且目标以参考图指定,示例定位新闻主播框 [276.17, 68.35, 735.16, 760.32]。
证明 SG 协议在音频轨道保持不变,使 VL/AV 的 SG 分数差异可归因于模态与模型而非协议。
AV 轨道 QA prompt 示例:问「在主播播报数千球迷聚集维也纳之前发生了什么」,五个选项中真值 B 依赖前一报道的音画内容,双设定共享选项与答案。
典型音视频事件理解题的完整体,直观展示「答案必须同时用到画面与声音」的出题方式。