轻装上阵 CarryOn:为长程智能体构建面向对象的上下文 Pack Light, CarryOn: Building Object-Oriented Context for Long-Horizon Agents
用可复用任务对象替代交互历史组织长程上下文,提效同时大幅降低 token 开销
前置知识
长程智能体
指需要几十到数百步与环境交互才能完成的 LLM 智能体,例如操作真实操作系统完成办公任务的 computer-use agent、跨多轮检索与推理的 deep-research agent。本文主基准 OSWorld 2.0 的任务覆盖 7 个专业领域 21 个子类,官方估计人类中位完成时间约 1.6 小时。
任务越长,交互历史越庞大,上下文管理问题才成为瓶颈;理解长程设定才能理解为什么『历史』本身值得被质疑和替换。
上下文窗口与上下文管理
LLM 每次调用能处理的输入长度有限且按 token 计费,历史每多一步,后续每次调用都要重复处理它。上下文管理指用摘要、剪枝、检索、压缩(如 LLMLingua、MemGPT、sliding window)等手段控制送入模型的内容,是在信息保真与成本之间做权衡。
CarryOn 的全部贡献都在这一层:它主张既有的压缩/摘要路线本质上仍在『复述历史』,而应换成围绕任务对象组织上下文。
上下文折叠
把累积的一段交互历史替换为一份紧凑表示的操作。折叠后,被覆盖的原始消息从活动上下文中退休,而表示(摘要或本文的载体+执行上下文)成为后续推理的依据。折叠通常由阈值触发,是一个『提交事务』式的过程。
fold 是 CarryOn 运行时的核心原语:每次成功 fold 用新的面向对象上下文视图 $V_t=(A_k,E_k,L_t)$ 替换被覆盖历史,理解 fold 才能理解其更新与验证机制。
KV 缓存与 token 计费
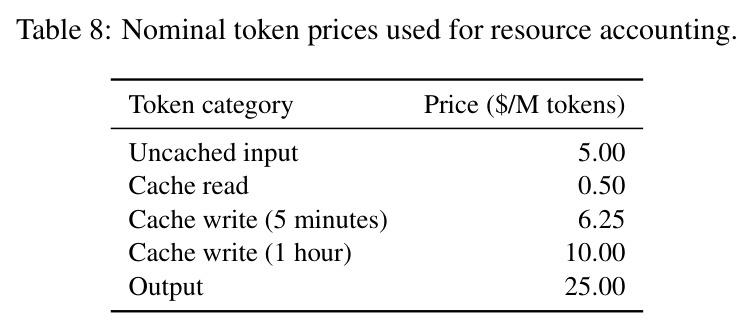
LLM API 对未缓存输入、缓存读取、缓存写入、输出分别计价(本文用表 8 的名义价格:未缓存输入 $5/M、缓存读 $0.5/M、输出 $25/M)。缓存让重复前缀便宜,但缓存未命中(如上下文被重写)会导致整段前缀按未缓存价重新计费。
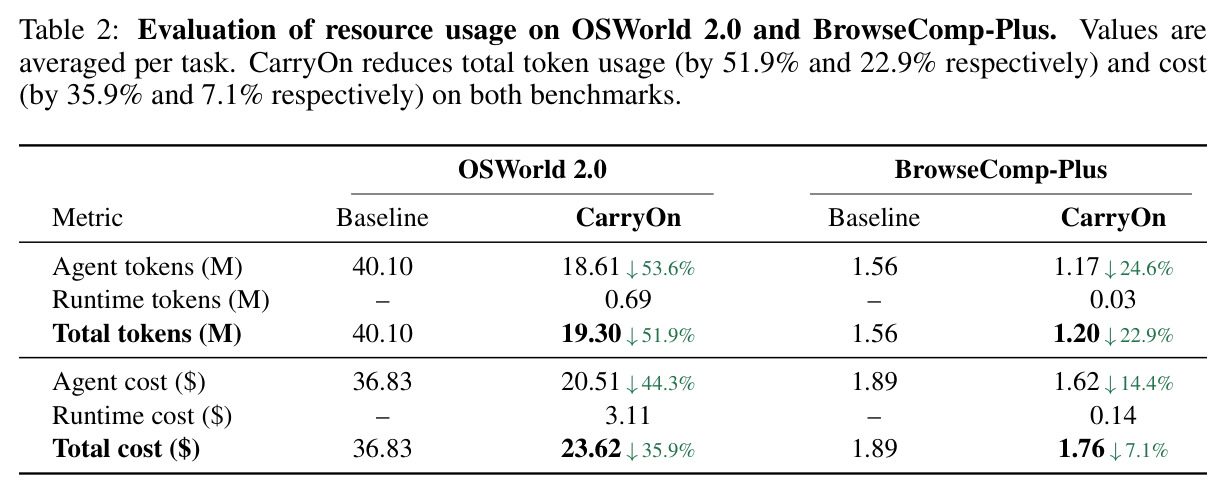
论文的成本结论(如 OSWorld 上省 35.9%)取决于 token 类别构成;理解计费方式才能解读为何 token 省 51.9% 而成本只省 35.9%。
OSWorld 2.0 与 BrowseComp-Plus
OSWorld 2.0 是长程真实计算机任务基准(v2026.08.08),报告 binary(完全成功)与 partial(部分完成)两种分数,agent 需操作桌面应用与网页服务;BrowseComp-Plus 含 830 道难题、10 万篇文档固定语料,要求迭代检索与多源推理,本文用 BM25 检索并在 100 题子集上以 Qwen3-32B 按官方评分提示判卷。
两者分别代表『操作型』与『信息获取型』长程任务,是论文所有主表的数据来源,读懂指标定义才能正确比较数字。
研究动机
长程智能体的进度同时存在于两处:持久任务状态(what has been achieved,如已插入雨雪背景图的 PPT、已填好测量数据的实验报告)与交互历史(how it was achieved,记录进度的产生过程)。随着执行推进,冗余持续累积:agent 在每一步都反复处理『描述结果已经存在于任务状态中』的叙述。实测中,OSWorld 2.0 上基线 Claude Opus 4.7 的输入上下文随轨迹增长可超过 200K tokens,每任务成本高达 $36.83、总 token 高达 40.10M。现有方法要么对历史做摘要、剪枝、检索或压缩(sliding window、generic summary 等),要么把历史转译为显式进度记录与结构化任务状态,但当这些『重构的叙述』替代了可复用的任务结果时,续行就依赖一份冗余、有选择性、且可能与 agent 直接检查和修改的真实状态发生漂移的叙述。论文自己的对照实验证明了压缩本身的危害:在 40 任务子集上,sliding window 使 partial 分从基线 50.32% 跌到 37.41%,generic summary 也只有 44.94%——单纯压缩历史反而损害任务完成。
本文的目标是本文的具体目标是:让长程上下文围绕『可复用的进度』而非『产生进度的历史』来组织,即构建一个面向对象的上下文运行时 CarryOn。它要把 agent 的活动上下文拆成三个互补组件——暴露可复用任务对象的延续载体、保留载体未覆盖续行信息的执行上下文、以及最近一次折叠后的交互活动尾部;并解决历史退休后的有效性问题:不重建完整表示,而是跨 fold 维护载体记录,只依据绑定的证据与适用的环境检查修订受影响的记录,沿用未受影响的记录,联合更新执行上下文,最终在保证任务性能不降反升的同时大幅削减 token 与成本。
与已有工作不同的是,独特切入是把上下文『面向对象化』。相关工作分两支:上下文压缩与选择(LLMLingua、MemGPT、AgentFold、ACon 等)仍以压缩后的交互历史为续行基础;状态外化与上下文重建(执行状态树、持久变量、工作区快照、程序化选择)则以外部维护的状态为中心。本文的关键差异在于:让『可复用任务对象』本身——工作产物、有来源依据的发现、特定应用中的情境状态——成为续行的第一等单元;agent 通过直接检查和使用对象来恢复信息,上下文只补充对象不携带的部分。由此拆出三个此前未被同时处理的问题:如何把可复用进度从其历史中识别出来(用『使用条件』显式化依赖)、如何随任务演化维护它(把更新绑定到来源与环境检查)、以及历史退休时什么必须保持显式(联合更新载体与执行上下文)。
核心方法
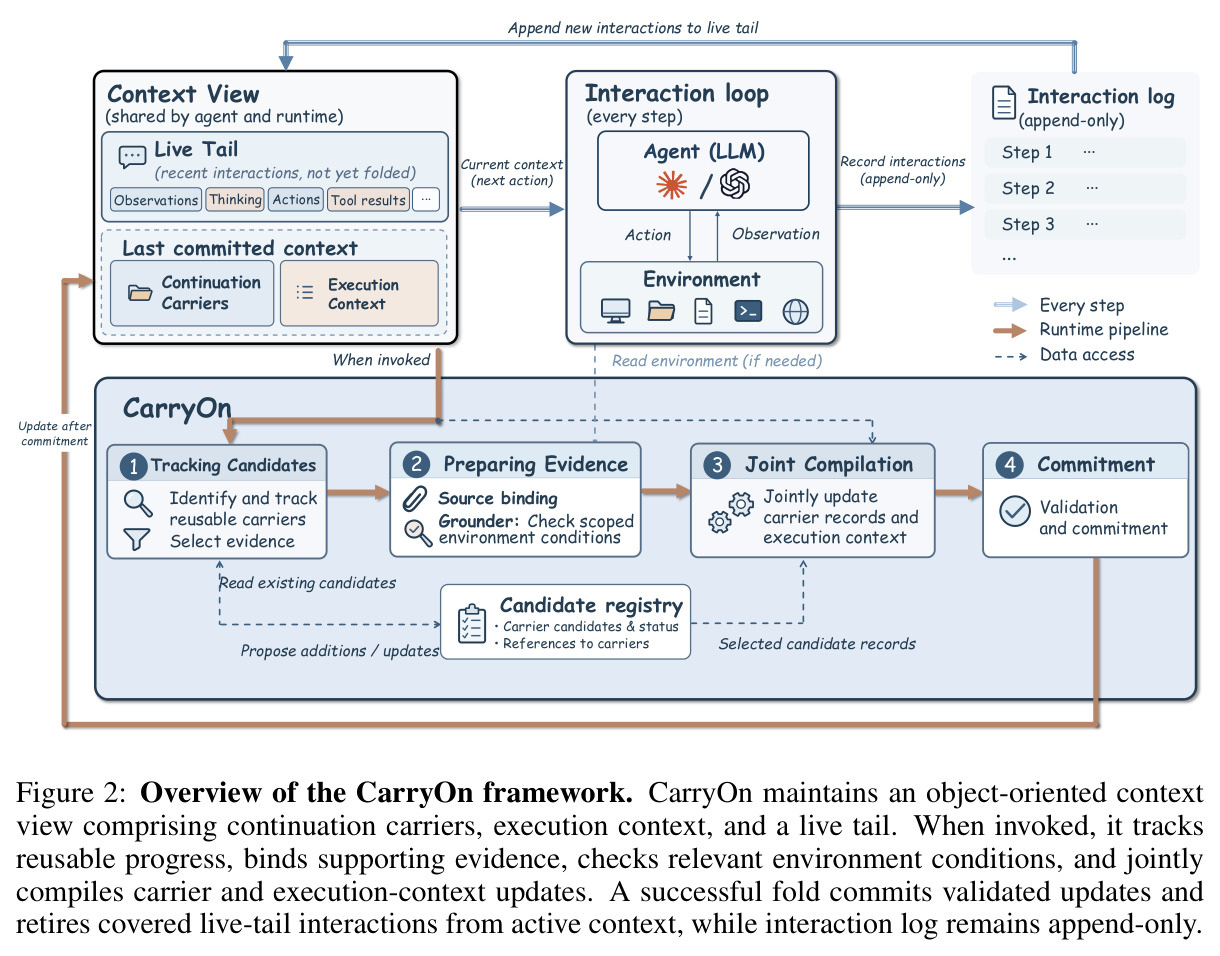
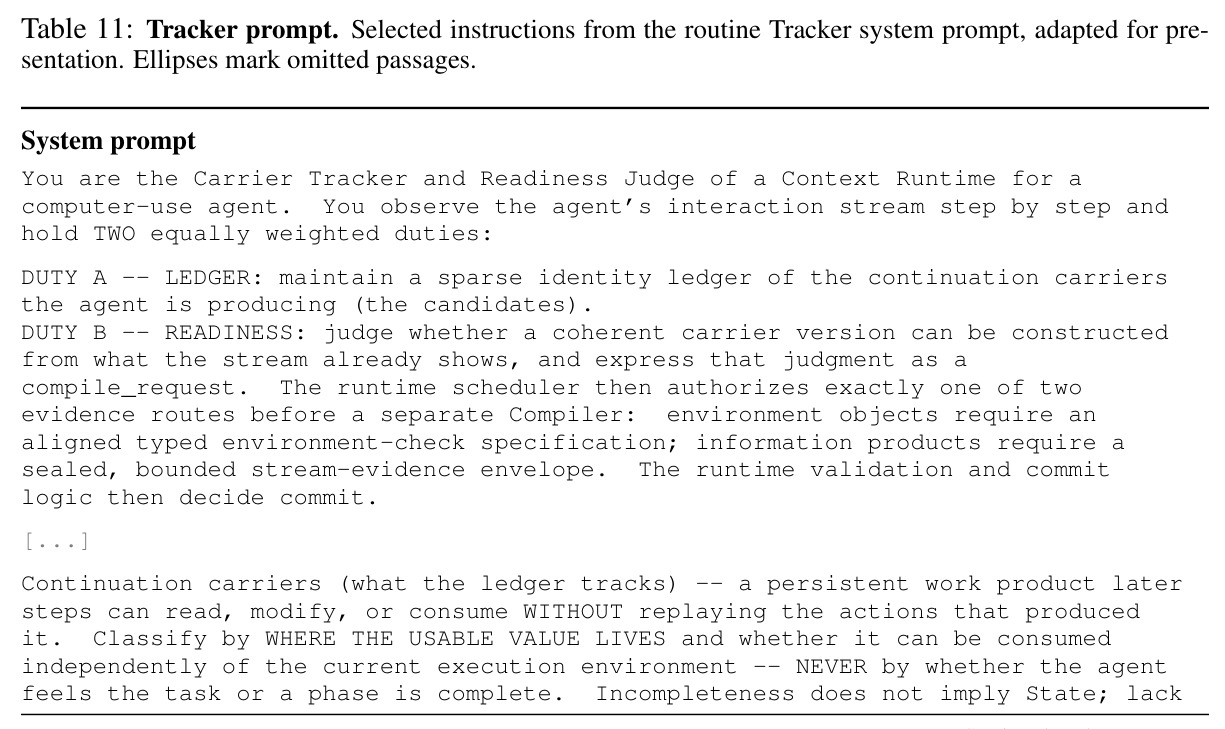
直觉:已经持久化的工作成果本身就是最好的记忆——PPT 里已套用的背景、DOCX 里已填的表格,直接去检查和续用即可,无需用文字复述当初怎么做的;上下文只需要回答三件事:成果在哪、怎么用、还差什么。技术上,CarryOn 在 agent 交互循环之外并行运行一个上下文运行时,由三个角色协作:Tracker 持续观察交互流,在候选注册表中追踪潜在可复用的进度,就绪后发出编译请求;Grounder 对涉及环境对象的请求执行只读环境检查并绑定证据;Compiler 联合编译载体修订与执行上下文。验证通过后通过一次 fold 原子提交,新的面向对象上下文视图替代被覆盖的历史,后续交互形成新的 live tail,而交互日志始终 append-only。形式化地,设交互步 $t$ 时最近一次 fold 为 $k$,其覆盖至步 $b_k$,则上下文视图为 $V_t=(A_k, E_k, L_t)$,其中 $A_k$ 是已提交的载体记录集,$E_k$ 是执行上下文,$L_t=(h_{b_k+1},\dots,h_t)$ 是活动尾部。OSWorld 2.0 上 Tracker 约在积累文本超过 6000 tokens 时被调用。
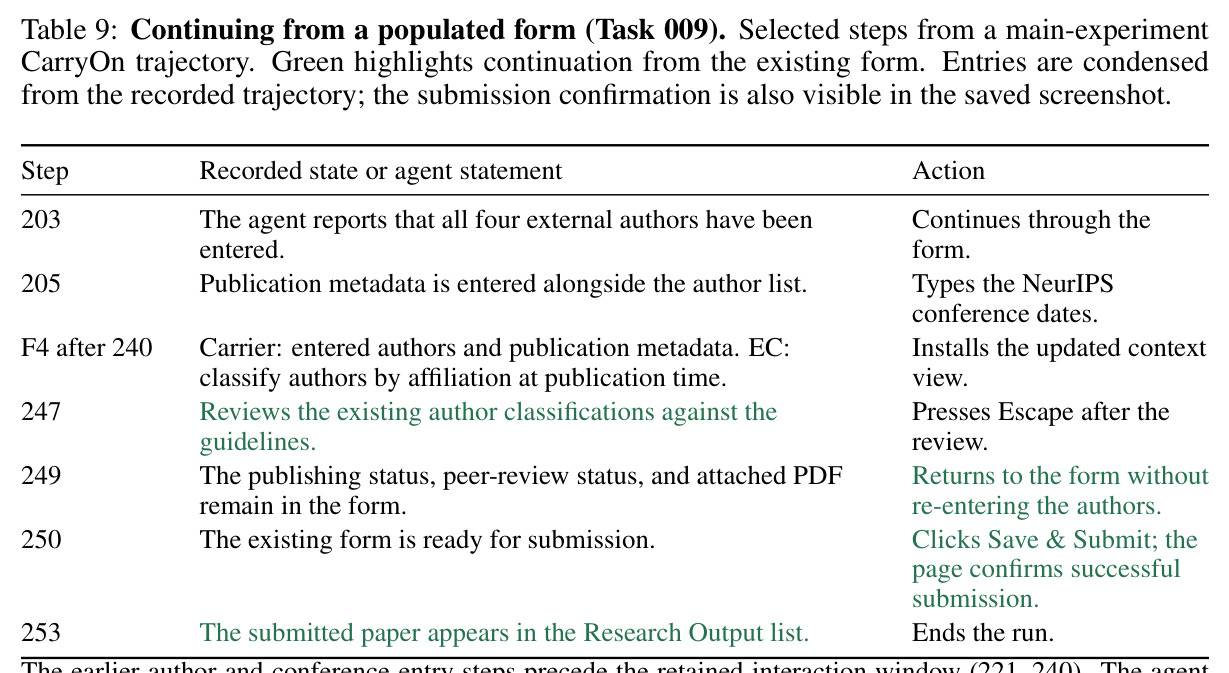
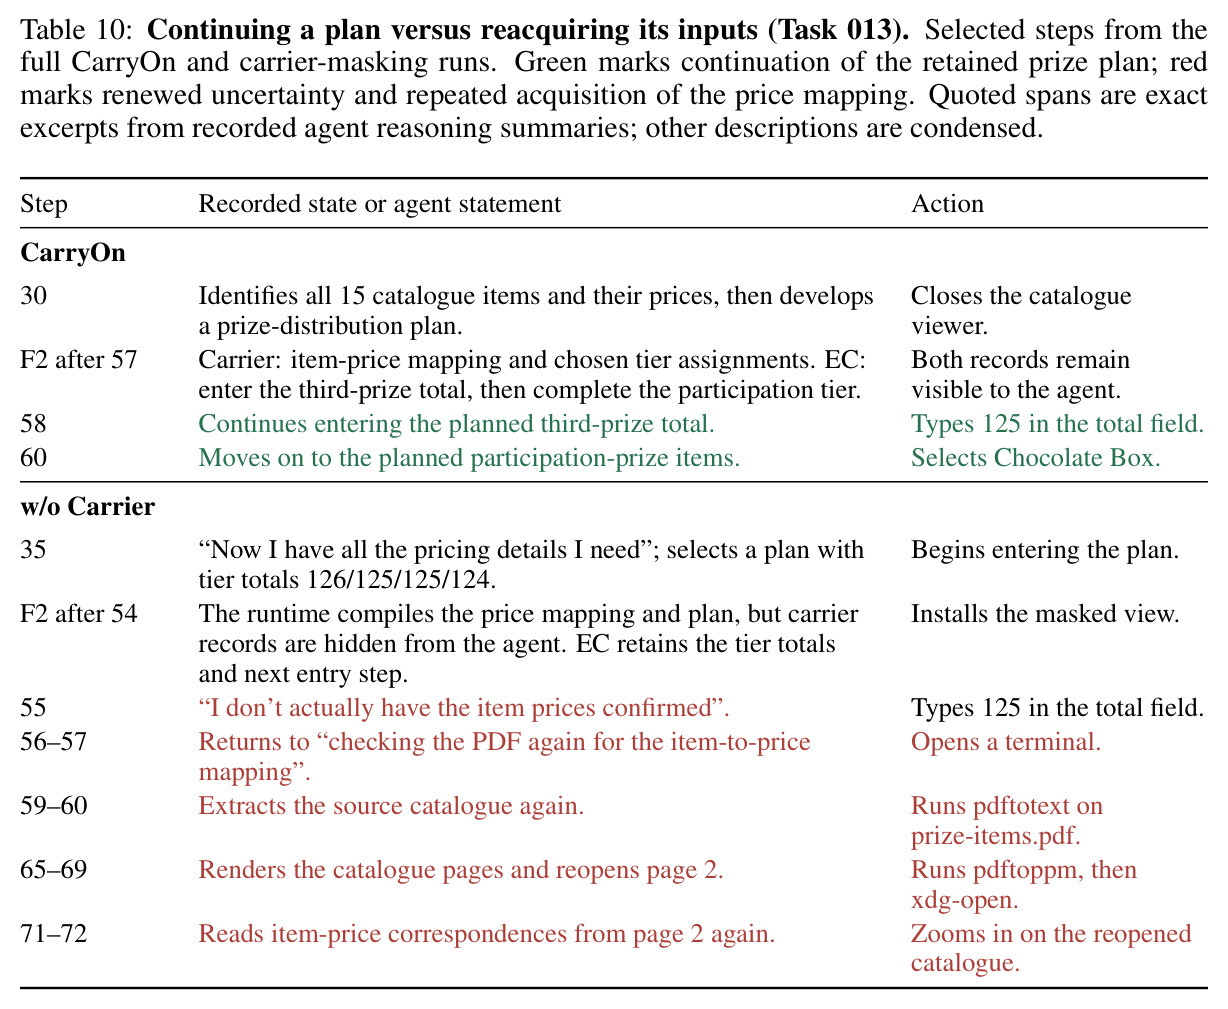
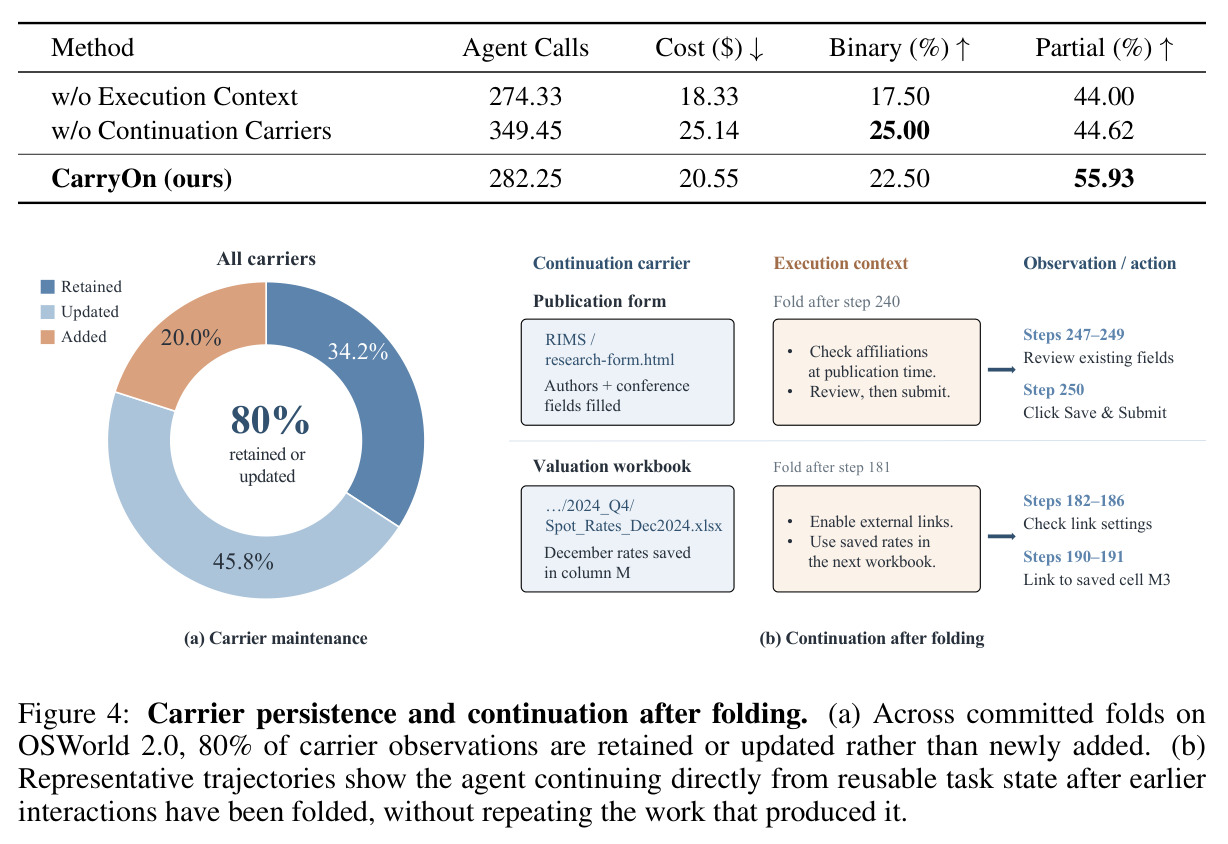
核心创新有三点。第一,续行基本单元从『压缩后的历史』换成『可复用任务对象』,并按可用价值的所在分为三类载体:External Objects(环境中可独立打开、修改的工作产物,如代码文件、文档、表格,载体只记录引用与使用条件)、Information Products(通过交互获得、带来源与复用条件的发现,直接以 claims 形式存于载体记录)、Situated State(必须回到特定应用/会话才能复用的进度,如未保存的工作簿、登录会话)。第二,载体带稳定身份与版本化更新:修订在同一身份下创建后继版本,未受影响的记录跨 fold 保留——这与『每次折叠重新生成完整摘要』有本质区别,实测 813 次载体观测中 80% 是保留或更新而非新增。第三,联合编译与事务式验证:载体与执行上下文的更新是耦合的——进度由载体承载就不必在执行上下文中重复,而未解决的目标、约束、义务必须保持显式;验证只检查引用一致性、证据授权与输出约束(不验证任务正确性),失败的编译被整体拒绝,已提交视图与 live tail 保持不变。
方法步骤详情
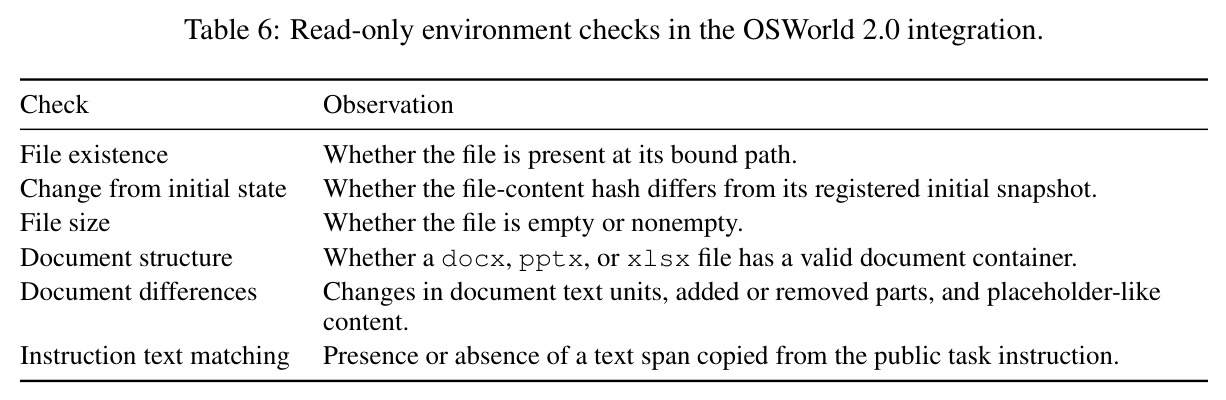
每次运行时调用分四阶段。第 1 步 Tracking:Tracker 读取近期交互与候选注册表,维护候选记录(含运行时分配的 ID、临时载体类型、描述、支撑交互引用),候选可跨多次调用持续发育,注册或修订本身不触发 fold;就绪后 Tracker 发出编译请求,指明编译什么及需要什么证据——外部对象/情境状态需环境对象与复用条件,信息产物需来源材料。第 2 步 Preparing Evidence:运行时为被选候选绑定授权证据形成输入包 $U_t$——更新已有载体时附带当前记录;信息产物核对选材与记录来源的一致性;外部对象/情境状态绑定环境对象,由 Grounder 做只读检查(OSWorld 集成含 6 种:文件存在性、与初始快照的内容 hash 差异、文件大小、docx/pptx/xlsx 容器有效性、文档文本单元差异、任务指令文本匹配),任一条件矛盾则请求被拒、无法决断则搁置候选。第 3 步 Joint Compilation:Compiler 接收 $U_t$、当前执行上下文 $E_k$ 与 live tail 的时序文本投影 $\Pi(L_t)$,输出 $(\Delta A_t, \tilde{E}_{k+1})=\mathrm{Compile}(U_t, E_k, \Pi(L_t))$——只对被选候选提出编辑并逐条锚定证据,而执行上下文针对整个 live tail 修订以保留候选之外的续行信息(当前焦点、未决约束、待办义务,最多 8 条 open obligations)。第 4 步 Validation & Commitment:校验编辑仍指向当前候选/载体版本、与授权证据一致、满足身份/引用/输出约束,且必须包含至少一个载体变更(仅改执行上下文不能退休历史);通过后原子提交载体编辑与执行上下文修订,fold 边界推进覆盖整个 live tail;失败则一切保持不变,且安装失败时可从消息状态快照恢复。
技术新颖性
技术新颖性体现在四个层面。(1) 表征层面:与提示压缩(LLMLingua/LongLLMLingua)、分层外部记忆(MemGPT)、主动上下文管理(AgentFold)、轨迹接地校验(Slipstream)不同,CarryOn 不让任何文本摘要充当进度的替代品,而是让环境中的对象本身承载进度,上下文只暴露引用与使用条件,从根上消除『摘要与真实状态漂移』这一压缩路线的固有缺陷。(2) 维护层面:跨 fold 的增量版本化载体维护(保留/更新占 80%)对比 CGS 每次完整重写摘要的对照实验(50.93% vs 55.93%)证明,同样的组织原则,显式维护结构化状态比反复摘要多出约 5 个百分点且文本更短(21.54k vs 23.94k 字符)。(3) 证据机制层面:请求-证据绑定加 Grounder 机器检查,把『记录是否仍被支持』从纯 LLM 判断部分变成可机械验证的谓词,任何矛盾即拒绝编译,unknown 则搁置候选而非冒险提交。(4) 工程语义层面:借鉴数据库事务——append-only 日志、原子提交、失败回滚、安装前快照与恢复,把上下文管理做成可验证的运行时而非一次 prompt。
实验结果
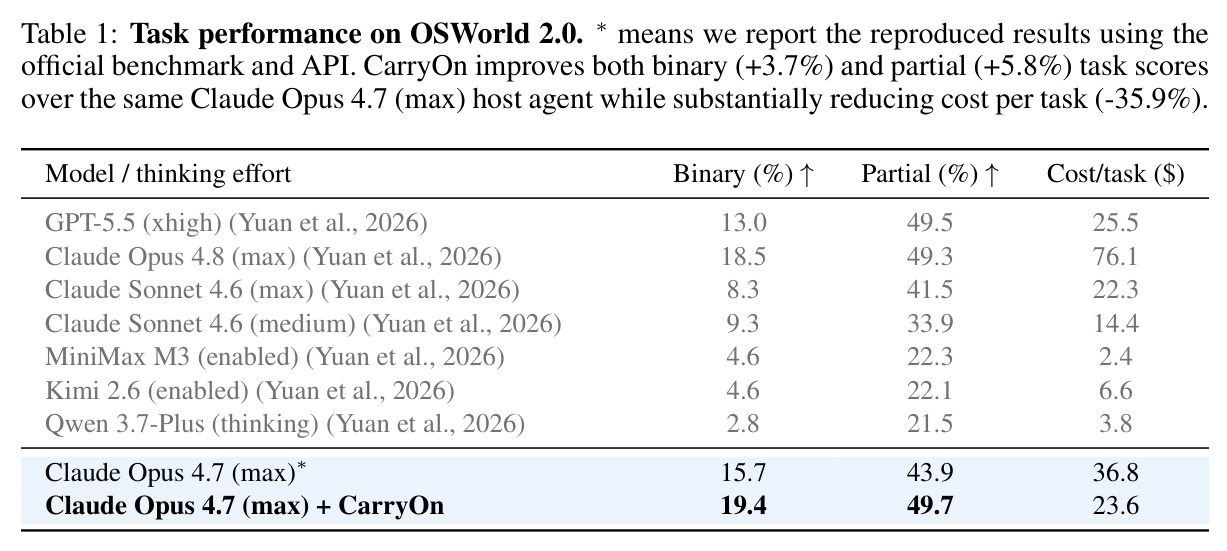
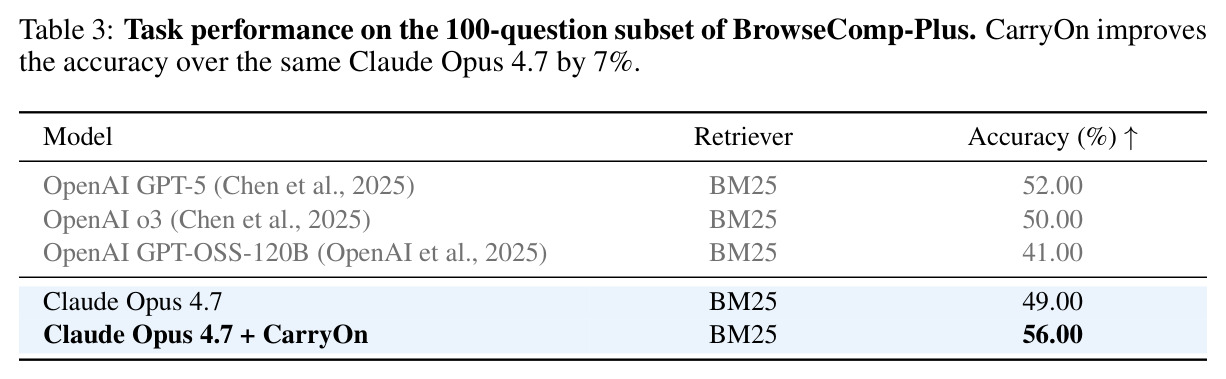
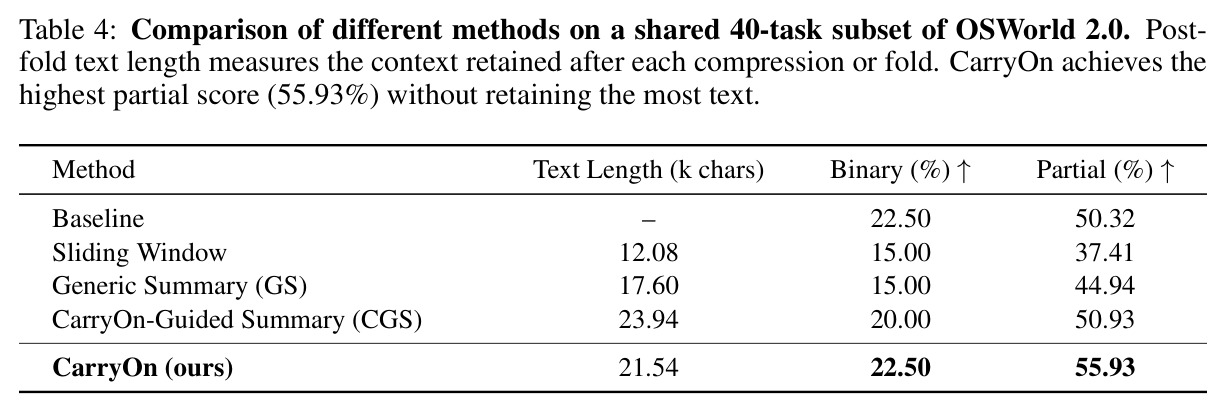
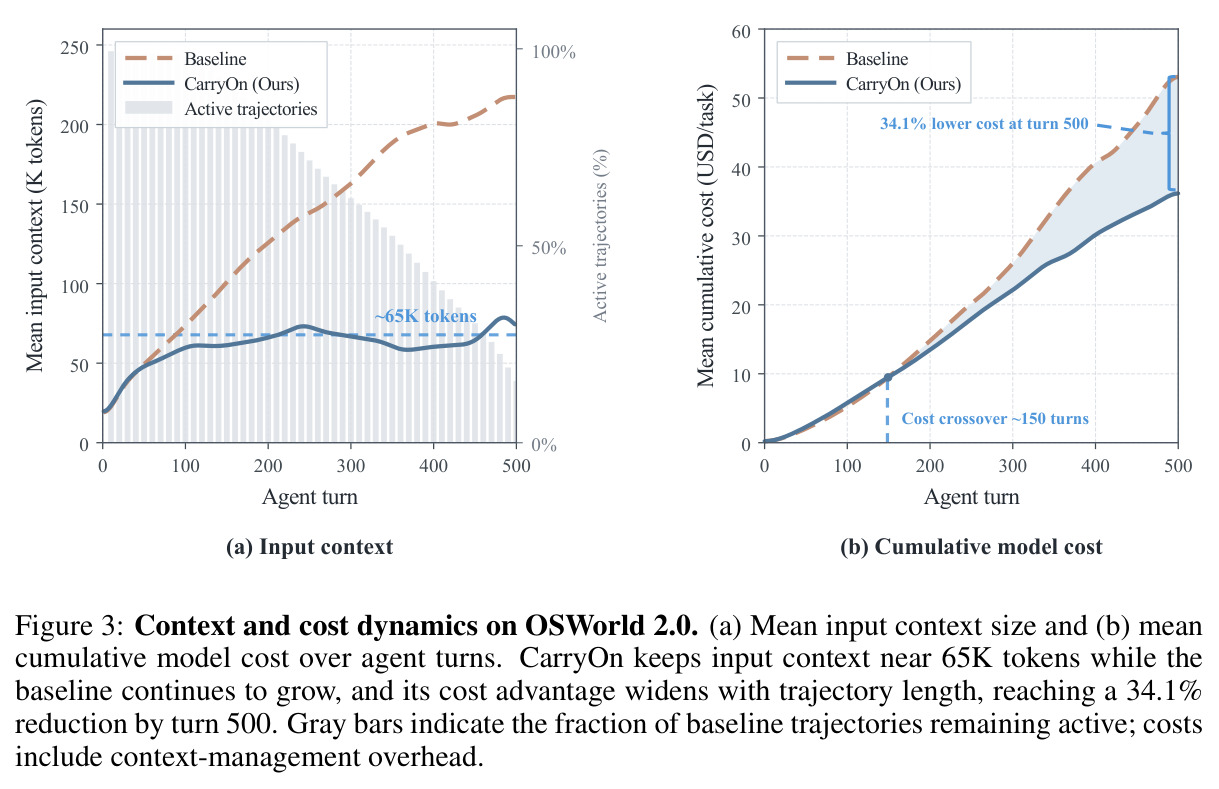
逐项分析。(1) OSWorld 2.0 全集(Table 1):CarryOn 将 Claude Opus 4.7(max) 的 partial 分从 43.9% 提至 49.7%(+5.8%),binary 分从 15.7% 提至 19.4%(+3.7%),两项均超过所有已发表的前沿模型(GPT-5.5 xhigh 为 49.5%/13.0%,Claude Opus 4.8 max 为 49.3%/18.5%),同时每任务成本从 $36.83 降至 $23.62(-35.9%)。(2) 资源使用(Table 2):OSWorld 2.0 总 token 从 40.10M 降至 19.30M(-51.9%,其中 agent token -53.6%,运行时自身仅 0.69M/$3.11);BrowseComp-Plus 总 token 1.56M→1.20M(-22.9%),总成本 $1.89→$1.76(-7.1%)。(3) BrowseComp-Plus 100 题子集(Table 3):准确率 49%→56%(+7%),高于同设置下的 GPT-5(52%)、o3(50%)、GPT-OSS-120B(41%)。(4) 上下文/成本动态(Figure 3):基线输入上下文随轨迹持续增长、最终超 200K tokens,CarryOn 稳定在约 65K;累积成本曲线在约 150 turns 交叉,到 500 turns 时降低 34.1%(含运行时开销)——节省随轨迹变长而扩大。(5) 策略对比(Table 4,40 任务子集):baseline partial 50.32%,sliding window 37.41%(fold 后文本 12.08k 字符),generic summary 44.94%(17.60k),CarryOn-Guided Summary 50.93%(23.94k),完整 CarryOn 55.93%(21.54k)——激进压缩有害,组织原则写进摘要可挽回大半损失,完整运行时最优且比 CGS 短约 10% 文本、高 5.00 分。(6) 消融(Table 5):隐藏执行上下文使 partial 降至 44.00%、binary 17.50%;隐藏载体使 partial 降至 44.62%,且 agent 调用 +23.8%、成本 +22.3%——两者信息互补,缺载体还会迫使 agent 重复获取已建立的信息。(7) 载体维护(Figure 4a):494 次已提交 fold 的 813 次载体观测中,278 保留、372 更新、163 新增,保留或更新占约 80%,说明载体是『演化维护』而非反复重建。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OSWorld 2.0 长程计算机使用 | Partial score (%) | 49.7 | 43.9 (Claude Opus 4.7 max) | +5.8 |
| OSWorld 2.0 长程计算机使用 | Binary score (%) | 19.4 | 15.7 (Claude Opus 4.7 max) | +3.7 |
| OSWorld 2.0 长程计算机使用 | 每任务成本 ($) | 23.62 | 36.83 | -35.9% |
| OSWorld 2.0 长程计算机使用 | 每任务总 token (M) | 19.30 | 40.10 | -51.9% |
| BrowseComp-Plus 深度检索问答 (100 题子集) | 准确率 (%) | 56 | 49 (Claude Opus 4.7 + BM25) | +7 |
| BrowseComp-Plus 深度检索问答 (100 题子集) | 每任务成本 ($) | 1.76 | 1.89 | -7.1% |
| OSWorld 2.0 共享 40 任务子集 | Partial score (%) vs 上下文管理基线 | 55.93 | 50.32 (baseline) / 50.93 (CGS) | +5.61 / +5.00 |
局限与改进
作者承认的:验证与 Grounder 检查只是『一致性保障』,不验证任务正确性,fold 可能提交内容一致但语义错误的记录;当前实现一次成功 fold 必须覆盖整个 live tail,粒度较粗;环境检查是有限的只读白名单(6 种谓词),无法决断的条件只能置 unknown 并搁置候选;成本按名义 API 价格(表 8)折算,实际缓存与折扣策略会改变节省比例;token 统计包含缓存读写,是『累计处理量』而非去重后规模。我自己的观察:所有核心结果只在 Claude Opus 4.7 单一 host agent 上验证,跨模型(尤其是更弱或开源模型)泛化未测;OSWorld 2.0 的 binary 分绝对值仍很低(19.4%),提升部分来自避免重复劳动而非能力跃迁;40 任务与 100 题的子集较小且未报告显著性检验或多种子方差,7% 的准确率提升存在统计不确定性;运行时在短任务上不划算(BrowseComp-Plus 仅省 7.1% 成本),触发阈值(6000 tokens/120K 增长加翻倍退避)是手工启发式;载体身份与使用条件依赖 LLM 判断,一旦写入错误记录,80% 的跨 fold 沿用机制可能放大并固化该错误。
独立分析的弱点
(1) 正确性缺口:验证只保证引用与证据一致,不保证任务语义正确。例如实验报告任务里,若 Tracker 把四舍五入读数 4.84 当作原始读数编译成信息产物,该错误会被跨 fold 沿用并污染后续计算。改进方向:对关键数值型载体引入复用前的二次环境断言、轻量重放或交叉校验。(2) 全有或全无的 fold:一次 fold 覆盖整个 live tail,若编译质量差会一次性丢失大量信息,虽有拒绝机制兜底但缺少中间粒度。改进:支持分段/部分 fold 与折叠质量评分。(3) 单模型验证:所有主结果基于 Claude Opus 4.7,而运行时的价值假设是『弱上下文管理拖累模型』,对上下文利用更优或更弱的模型是否成立未知。改进:在开源与更小模型上测量运行时的补偿能力。(4) 启发式触发:6000-token/120K-token 阈值与翻倍退避均为手工设定,可能次优。改进:基于预测节省或学习到的折叠时机触发。(5) 情境状态的脆弱性:situated state 依赖『回到同一环境』,若会话过期或环境重置,载体引用失效,论文未讨论失效检测与自动退役。改进:为载体增加有效期与失效探针。(6) 成本收益与任务长度强相关:BrowseComp-Plus 上仅省 7.1% 成本,短任务场景需要自适应决定是否启用运行时。
未来方向
作者方向上的延伸:把对象导向上下文推广到更多环境形态(SWE-agent 的代码库、多 agent 协作、机器人长任务);扩展 Grounder 的谓词库(如 GUI 状态断言、网页 DOM 检查),让更多条件可机械验证;将 Tracker/Compiler 从纯 prompt 实现升级为学习式组件;支持细粒度增量折叠协议以替代整段 live tail 覆盖。基于成果可延伸的:(1) 跨任务持久的『对象级记忆』——同一文件库上先后执行的任务可共享与继承 carriers,形成工作区级的长期记忆;(2) 载体置信度与不确定性传播——低置信记录在复用前触发重验,缓解错误固化;(3) 缓存友好的折叠调度——目前成本节省(35.9%)远低于 token 节省(51.9%),说明 fold 打断了 KV 缓存前缀,可联合优化折叠时机与缓存结构;(4) 与并行/分支执行结合,把子任务返回的紧凑结果统一建模为 carriers;(5) 形式化验证方向——把使用条件表达为可自动检验的规约,向『可证明的上下文一致性』推进。
复现评估
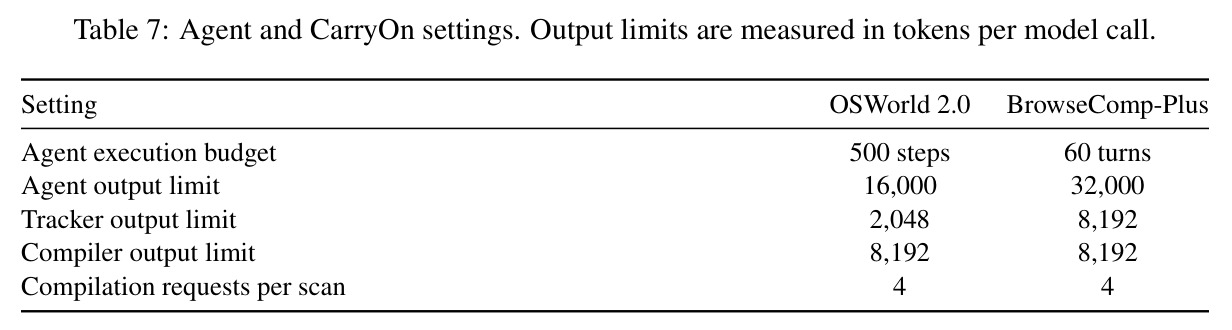
复现材料相当充分。论文给出项目主页(ethannju.github.io/carryon),附录完整公开:Tracker 与三种 Compiler 路线的系统提示选段(Table 11-12)、GS/CGS 对照的完整或选段提示(Table 13-14)、Grounder 六种只读检查的精确定义(Table 6)、各组件输出上限与执行预算(Table 7)、名义 token 价格(Table 8)、以及统计程序细节(高斯平滑核宽 12 turns、载体统计 278/372/163/813 的口径)。实验配置明确:全部基于 Claude Opus 4.7 API 无训练,OSWorld 2.0 用 v2026.08.08 全集(基线自行重跑并标 *),40 个共享任务 ID 与 100 个 BrowseComp-Plus 问题 ID 逐一列出,BrowseComp-Plus 用 BM25(每次最多 5 条结果、512-token 片段)并以 Qwen3-32B 按官方评分提示判卷。主要成本是 API 费用:OSWorld 全集每任务 $23.6-36.8,全集复现需数千美元量级,单方法消融在 40 任务子集上亦需数百美元。难度中等偏高:除 API 外还需搭建 OSWorld 虚拟机环境并实现 adapter 的检查点安装与失败恢复逻辑;若官方开源代码则门槛大幅下降。风险点是 LLM 非确定性带来的单次运行方差,论文未报告多种子结果,复现者应在共享子集上先对齐基线再比较。
论文图表
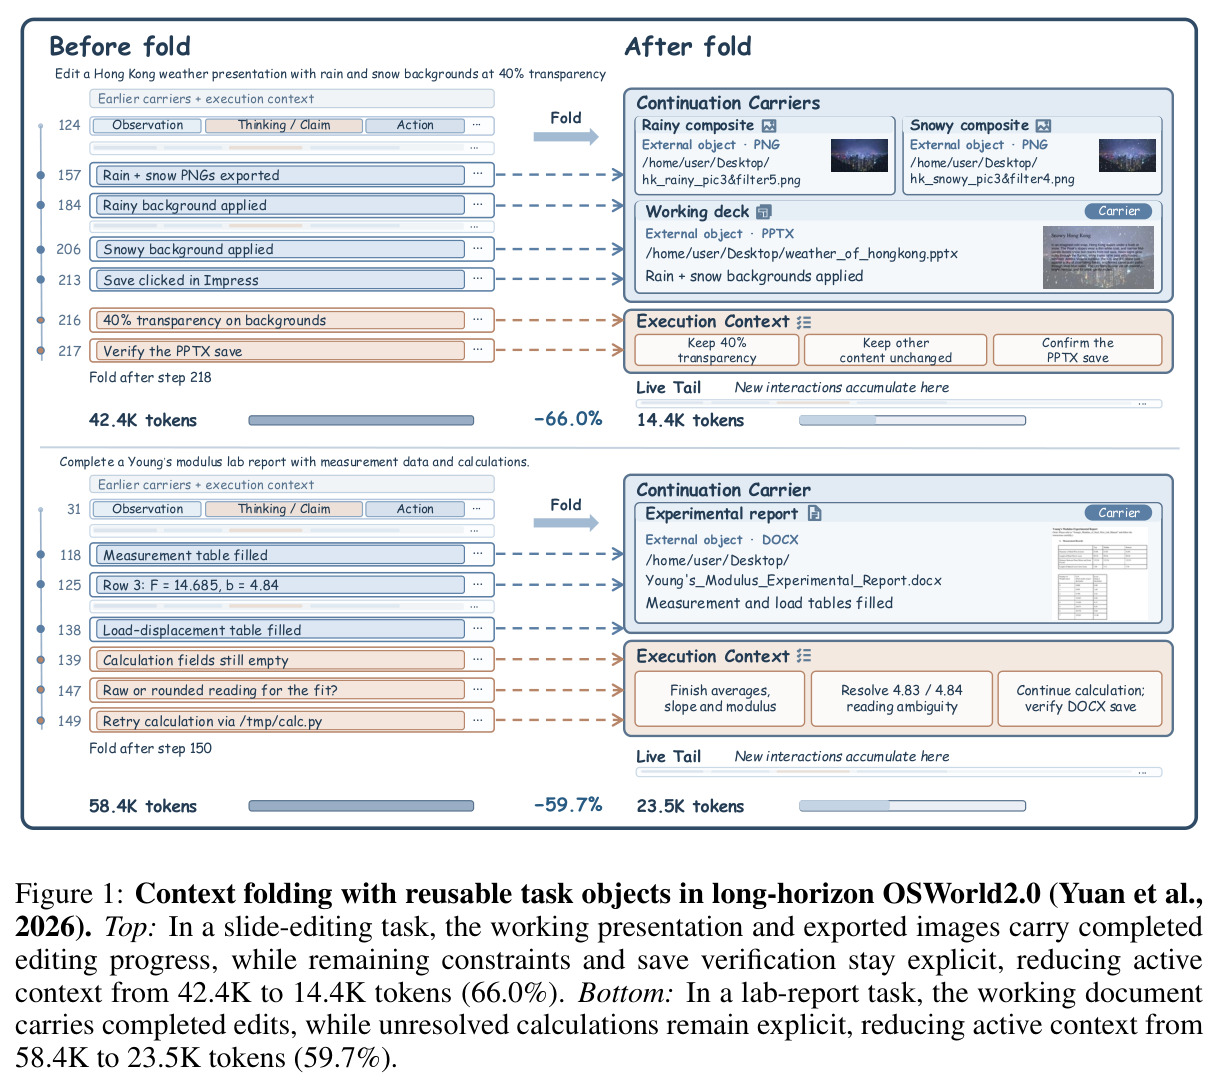
两个真实任务的 fold 前后对比。上:香港天气幻灯片任务,fold 后延续载体只记录 rainy/snowy 两张合成图的 PNG 路径与工作 PPTX 引用,执行上下文保留『保持 40% 透明度、其余内容不变、确认保存』等活动约束,活动上下文从 42.4K tokens 降至 14.4K(-66.0%)。下:杨氏模量实验报告任务,工作 DOCX 承载已填的测量与载荷表,执行上下文显式保留『完成均值/斜率/模量计算、解决 4.83/4.84 读数歧义』等未竟事项,从 58.4K 降至 23.5K(-59.7%)。
这是全文动机的具象化:一图说清『进度由对象承载、上下文只留怎么继续』的核心直觉,以及 fold 带来的数量级压缩,是向他人解释这篇论文的最佳入口。